Tlow: Flow-based Item Tokenizer for Recommendation
Nian Li, Chonggang Song, Jingtao Ding, Lingling Yi, Yong Li, Qingmin Liao(清华大学 / 腾讯 / 清华深圳国际研究生院,*共同一作) CIKM '26 · arXiv:2608.24176 · 2026-08-25 · 代码 https://github.com/wjjln/Tlow
一、研究动机与背景
1.1 从随机 ID 到 Semantic ID
传统推荐系统给每个物品分配一个随机初始化的 ID embedding,模型的核心学习目标就是把这些 embedding 学好。无论骨干是 GNN、RNN 还是自注意力,这套范式都有两个结构性缺陷:
- 参数量随物品数线性膨胀。ID embedding 彼此完全独立,没有任何共享,工业系统里上千万到上亿的物品意味着 embedding 表本身就吃掉了绝大部分参数预算,反而挤压了序列建模的模型容量。
- 冷启动。新物品交互记录极少,其 ID embedding 得不到充分训练,模型无法推荐它。
受大语言模型训练范式启发,一批工作转而基于物品的语义嵌入把物品离散化成一串 token ID(即 semantic ID),从而构造一个全局共享的 token 词表。序列推荐模型改为解码"下一个物品的 token ID 序列",用 token embedding 去建模全体物品语义空间中的原子信息。这样参数规模被词表大小而非物品数控制,冷启动也天然被解决——新物品一发布就能由其内容特征算出 token ID。
代表作 TIGER 用 RQ-VAE(residual-quantized VAE)做 tokenizer,对语义嵌入做层次化编码。
1.2 RQ-VAE 的效率瓶颈与独立 tokenizer 的两个死结
论文对现状的诊断分两层:
第一层:RQ-VAE 的码本之间强相关。 残差量化本质上是"第 $k$ 级码本量化的是前 $k-1$ 级量化后剩下的残差",因此解码第 $k$ 个 token ID 必须先解出前面所有 token ID,推理步数等于码本数,构成效率瓶颈。此外 RQ-VAE 常见的码本坍缩(codebook collapse)与冲突(conflict)使得工业落地高度依赖经验与调参。因此,追求"独立 tokenization 以支持并行解码"是自然的下一步——这个解码效率优势相对 RQ-VAE 式串行解码已经在 RPG 中被实证验证过。
第二层:现有独立 tokenizer(PQ 系)仍有两个致命挑战。 已有方法用 product quantization(PQ)直接切分语义嵌入、各段独立编码,但:
- 维度相关(Dimension correlations)。语义嵌入各维度之间存在相关性,直接违背独立 tokenization 所需的"维度独立"假设。OPQ(optimized product quantization)用一个正交变换把原空间分解成若干子空间以缓解此问题,但每个子空间内部的维度仍然相关。当维度相关时,嵌入落在一个复杂、偏斜的流形上,而独立量化却在其上强加一个网格状(grid-like)结构,量化效果自然很差。
- 分布复杂(Complex embedding distribution)。语义嵌入的分布未知且复杂,本身就会损害嵌入的语义表达能力,直接 token 化会产生很大的量化误差。具体地,这些嵌入常常高度各向异性(anisotropic),占据一个不均匀的锥形(cone)区域而非均匀铺开,使标准量化码本的拟合效率很低;在跨域或多模态场景下更甚——不同来源的嵌入会形成彼此分离的簇。
1.3 本文的赌注
Tlow 的解法非常直接:与其改造量化器去迁就复杂分布,不如先把分布本身变简单。用一个流模型(normalizing flow)把原始语义嵌入 $\mathbf{x}$ 变换成服从标准正态分布的潜嵌入 $\mathbf{z}$,一次性拿到两个好处:
- 维度独立(标准正态各维互相独立)→ 满足 PQ 独立量化的前提;
- 分布简单(各向同性、无偏斜)→ 量化误差小、码本利用充分。
然后在 $\mathbf{z}$ 上做独立 PQ,得到语义清晰、可并行解码的 token ID。
论文用 Figure 1 做了一个很有说服力的定性展示:在 Amazon Reviews 的 "CDs and Vinyl" 数据集上,对比 16-bit(即切成 16 段)的 OPQ 与 Tlow,看第一个位置 token ID 相同的专辑集合。虽然这些专辑都与 "Pop" 有关,但 OPQ 那一组混进了大量不同流派的专辑("Metal"、"British Invasion"、"Jazz"),而 Tlow 那一组语义清晰得多,绝大多数确实是 "Pop"。量化指标上,OPQ 组 #category = 225、entropy = 4.11,Tlow 组 #category = 97、entropy = 2.71,流派多样性显著更低(这里低是好事,说明同一 token 下的物品语义更纯)。
此外论文还提出一个 codebook guidance:直接对齐"token embedding 张成的空间"与"码本张成的空间",帮助 token embedding 学到更有区分度的语义。
二、方法:Tlow
2.1 任务形式化
任务设定为序列推荐:给定用户历史交互序列 $\{i_1, i_2, \cdots, i_T\}$,模型预测下一个交互物品 $i_{T+1}$,$T$ 为序列长度。
Item tokenizer 利用语义嵌入 $\mathbf{x}$ 把每个物品转换成一串 token ID,其中 $\mathbf{x}$ 由预训练模型以物品特征(标题、封面图等)为输入得到。基于 tokenization 的序列模型的目标是解码下一个物品的 token ID,与大语言模型的训练范式一致。
2.2 流模型目标
Tlow 采用多尺度架构(multi-scale,源自 Glow),把语义嵌入 $\mathbf{x} \in \mathbb{R}^{d_s}$ 变换为服从标准正态分布的潜嵌入 $\mathbf{z} \in \mathbb{R}^{d_s}$,$d_s$ 是嵌入维度。与所有流模型一样,Tlow 的对数似然目标是最小化:
$$\mathcal{L}_f = -\frac{1}{|\mathcal{X}|}\sum_{\mathbf{x}\in\mathcal{X}} \log p_{\boldsymbol{\theta}}(\mathbf{x}) \tag{1}$$
其中 $\mathcal{X}$ 是全体物品语义嵌入的集合,$\boldsymbol{\theta}$ 是可学习参数。由变量替换公式,Tlow 的概率密度函数可写成:
$$\log p_{\boldsymbol{\theta}}(\mathbf{x}) = \log p_{\boldsymbol{\theta}}(\mathbf{z}) + \log|\det(d\mathbf{z}/d\mathbf{x})| \tag{2}$$
其中 $d\mathbf{z}/d\mathbf{x}$ 是从 $\mathbf{x}$ 到 $\mathbf{z}$ 变换的 Jacobian 矩阵,$\det(\cdot)$ 表示行列式。流模型的全部工程难点就在于:既要变换足够表达力强,又要 Jacobian 行列式可以廉价计算——这决定了下面三层的设计。
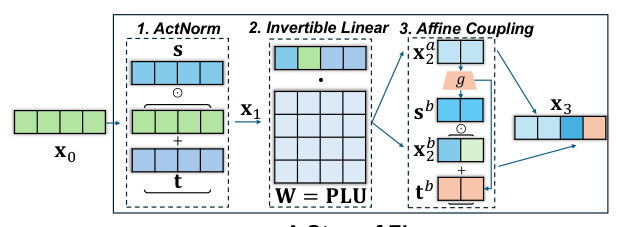
Tlow 包含多个 block,每个 block 是一个多步的 flow,每一步("A Step of Flow")由三个变换层组成:ActNorm、Invertible Linear、Affine Coupling。
2.3 A Step of Flow:三个变换层
(1)ActNorm Layer(激活归一化)。对输入 $\mathbf{x}_0 \in \mathbb{R}^d$ 做逐元素的仿射归一化以稳定训练:
$$\mathbf{x}_1 = \mathbf{s}\odot(\mathbf{x}_0 + \mathbf{t}) \tag{3}$$
其中 $\odot$ 是逐元素乘,$\mathbf{s}, \mathbf{t}\in\mathbb{R}^d$ 分别是可学习的尺度与偏置参数。由于是对角变换,其对数行列式为:
$$\log|\det(d\mathbf{x}_1/d\mathbf{x}_0)| = \sum_{j=1}^{d}\log|\mathbf{s}_j| \tag{4}$$
(2)Invertible Linear Layer(可逆线性层)。这一层是唯一让不同维度互相影响的部件——也正是"消除维度相关性"这个目标的执行者:
$$\mathbf{x}_2 = \mathbf{W}\mathbf{x}_1 = (\mathbf{P}\mathbf{L}\mathbf{U})\mathbf{x}_1 \tag{5}$$
线性矩阵 $\mathbf{W}\in\mathbb{R}^{d\times d}$ 被分解为置换矩阵 $\mathbf{P}$、下三角矩阵 $\mathbf{L}$、上三角矩阵 $\mathbf{U}$ 的乘积,以便廉价地计算行列式。$\mathbf{L}$ 的对角元固定为 1,$\mathbf{U}$ 的对角元是一组可学习参数 $\mathbf{w}\in\mathbb{R}^d$。于是:
$$\log|\det(d\mathbf{x}_2/d\mathbf{x}_1)| = \log|\det(\mathbf{W})| = \log|\det(\mathbf{P})| + \log|\det(\mathbf{L})| + \log|\det(\mathbf{U})| = \sum_{j=1}^{d}\log|\mathbf{w}_j| \tag{6}$$
即 $O(d)$ 而非 $O(d^3)$。这里值得注意的是与 OPQ 的关系:OPQ 也是学一个正交变换,但它是线性且一次性的;Tlow 的 $\mathbf{W}$ 只是整条流里的一层,与非线性的耦合层交替堆叠 $N\times M$ 次,因此整体是一个非线性可逆变换,表达力远超单个正交矩阵——这正是论文声称"OPQ 子空间内部维度仍相关"而 Tlow 能解决的机理来源。
(3)Affine Coupling Layer(仿射耦合层)。对输入 $\mathbf{x}_2$ 先劈成两半 $\mathbf{x}_2^a$ 与 $\mathbf{x}_2^b$,然后:
$$\mathbf{x}_3 = [\mathbf{x}_2^a,\ \mathbf{s}^b\odot(\mathbf{x}_2^b+\mathbf{t}^b)],\qquad [\mathbf{s}^b, \mathbf{t}^b] = g(\mathbf{x}_2^a) \tag{7}$$
其中 $g:\mathbb{R}^{\frac{d}{2}}\to\mathbb{R}^{d}$ 是一个 MLP,用 $\mathbf{x}_2^a$ 生成尺度和偏置参数来变换 $\mathbf{x}_2^b$。这是引入非线性表达力的关键,同时保持可逆与三角 Jacobian:因为前半段原样透传,Jacobian 是分块三角的,对数行列式只剩后半段的尺度项:
$$\log|\det(d\mathbf{x}_3/d\mathbf{x}_2)| = \sum_{j=1}^{d/2}\log|\mathbf{s}_j^b| \tag{8}$$
三层组合起来,一个 step of flow 的对数行列式为:
$$\Delta = \log|\det(d\mathbf{x}_1/d\mathbf{x}_0)| + \log|\det(d\mathbf{x}_2/d\mathbf{x}_1)| + \log|\det(d\mathbf{x}_3/d\mathbf{x}_2)| \tag{9}$$
2.4 多尺度架构与 tokenizer
Tlow 包含 $N$ 个 block,每个 block 包含 $M$ 个 step of flow。对第 $n$ 个 block,其输出 $\mathbf{z}_n\in\mathbb{R}^{\frac{d_s}{2^{n-1}}}$ 被劈成两半 $\mathbf{z}_n^a\in\mathbb{R}^{\frac{d_s}{2^{n}}}$ 与 $\mathbf{z}_n^b\in\mathbb{R}^{\frac{d_s}{2^{n}}}$,前者作为下一个 block 的输入,后者作为 Tlow 的部分输出(即 $\mathbf{z}$ 的一部分)。对 $\mathbf{z}_n^b$ 的对数似然估计为:
$$\log p(\mathbf{z}_n^b) = \log\mathcal{N}(\mathbf{z}_n^b;\ \boldsymbol{\mu}_n, \boldsymbol{\sigma}_n^2),\qquad [\boldsymbol{\mu}_n, \boldsymbol{\sigma}_n^2] = h(\mathbf{z}_n^a) \tag{10}$$
其中 $h:\mathbb{R}^{\frac{d_s}{2^n}}\to\mathbb{R}^{\frac{d_s}{2^{n-1}}}$ 是一个 MLP 模块,用 $\mathbf{z}_n^a$ 预测 $\mathbf{z}_n^b$ 的均值 $\boldsymbol{\mu}_n$ 与方差 $\boldsymbol{\sigma}_n^2$。把所有 block 的输出拼起来得到 Tlow 的最终输出 $\mathbf{z} = [\mathbf{z}_1^b, \mathbf{z}_2^b, \cdots, \mathbf{z}_N^b]\in\mathbb{R}^{d_s}$。注意 $\mathbf{z}_N^b = \mathbf{z}_N$,因为最后一个 block 的输出不需要再劈半;第一个 block 的输入就是 $\mathbf{x}$。于是:
$$\log p_{\boldsymbol{\theta}}(\mathbf{z}) = \sum_{n=1}^{N}\log p(\mathbf{z}_n^b) \tag{11}$$
Tlow 的总对数行列式为所有 block、所有 step 的累加:
$$\log|\det(d\mathbf{z}/d\mathbf{x})| = \sum_{n=1}^{N}\sum_{m=1}^{M}\Delta_{n,m} \tag{12}$$
其中 $\Delta_{n,m}$ 是第 $n$ 个 block 中第 $m$ 个 step of flow 的对数行列式。用 $\mathcal{L}_f$ 训练完 Tlow 后,语义嵌入 $\mathbf{x}$ 就被变换成了服从标准正态分布、各维度互相独立的潜嵌入 $\mathbf{z}$。
Tokenization:在 $\mathbf{z}$ 上做 PQ 得到 $C$ 个 token ID。具体地把 $\mathbf{z}$ 切成 $C$ 段 $[\mathbf{z}_1, \mathbf{z}_2, \cdots, \mathbf{z}_C]$,每一段独立用 K-means 编码得到对应码本 $\mathcal{C}_k = \{\mathbf{c}_k^1, \mathbf{c}_k^2, \cdots, \mathbf{c}_k^S\}$,其中 $\mathbf{c}_k^j\in\mathbb{R}^{\frac{d_s}{C}}$ 是第 $j$ 个量化码字,$S$ 为码本大小。第 $k$ 个位置的 token ID 定义为:
$$c_k = \arg\min_{j\in\{1,2,\cdots,S\}} \lVert \mathbf{z}_k - \mathbf{c}_k^j\rVert_2 \tag{13}$$
这样每个物品被 token 化为离散 ID 序列 $[c_1, c_2, \cdots, c_C]$。注意 Tlow 的量化器本身就是最朴素的 PQ + K-means,没有任何 VAE / STE / commitment loss——全部复杂度都被前置到了流变换里。
2.5 Token ID 用于推荐(并行解码)
给定所有物品的 token ID,一个序列模型(如 Transformer decoder)负责生成下一个物品的 ID,同时学一组 token embedding。token embedding $\mathbf{E}\in\mathbb{R}^{C\times S\times d_m}$ 与码本 $\mathbf{C}\in\mathbb{R}^{C\times S\times\frac{d_s}{C}}$ 一一对应,$d_m$ 是 token embedding 维度。每个物品的传统 ID embedding 被聚合后的 token embedding $\mathbf{e}\in\mathbb{R}^{d_m}$ 替代:
$$\mathbf{e} = \frac{1}{C}\sum_{k=1}^{C}\mathbf{E}_{k, c_k} \tag{14}$$
序列模型进一步编码用户历史 embedding 序列 $(\mathbf{e}_{i_1}, \mathbf{e}_{i_2},\cdots)$,输出最终隐状态 $\mathbf{h}\in\mathbb{R}^{d_m}$。沿用 RPG 的做法,与目标物品 $i_t$(token ID 为 $(c_1^t, c_2^t, \cdots, c_C^t)$)交互的对数似然为:
$$\log p(i_t|\mathbf{h}) = \sum_{k=1}^{C}\log p(c_k^t|\mathbf{h}) = \sum_{k=1}^{C}\log\frac{\exp\!\left(\mathbf{E}_{k,c_k^t}^{\top}g_k(\mathbf{h})/\tau\right)}{\sum_{j=1}^{S}\exp\!\left(\mathbf{E}_{k,j}^{\top}g_k(\mathbf{h})/\tau\right)} \tag{15}$$
其中 $\tau$ 是温度超参,第 $k$ 个投影头 $g_k:\mathbb{R}^{d_m}\to\mathbb{R}^{d_m}$ 解码下一物品的第 $k$ 个 token ID。这种解码方式之所以成立,正是因为潜嵌入 $\mathbf{z}$ 的不同段之间相互独立——$C$ 个 token 在一次前向里被并行解出,无需自回归。推荐训练损失为:
$$\mathcal{L}_{rec} = -\sum_{(\mathbf{h}, i_t)}\log p(i_t|\mathbf{h}) \tag{16}$$
2.6 Codebook Guidance:对齐两个空间
由于 Tlow 是在潜嵌入上做 token 化,量化得到的码本隐含了全体物品语义分解后的原子信息——每个码字编码一块原子语义(如 Figure 1 中的"Pop")。因此用码本来引导 token embedding 的学习是有益的。
与已有工作对每个物品或每条行为序列做独立对齐不同,Tlow 提出直接对齐 token embedding 与码本所张成的两个潜空间。token 空间 $\Phi\in\mathbb{R}^{C\times S\times S}$ 与码本空间 $\Psi\in\mathbb{R}^{C\times S\times S}$ 由各自内部的余弦相似度定义:
$$\Phi_{k,i,j} = \frac{\mathbf{E}_{k,i}^{\top}\mathbf{E}_{k,j}}{\lVert\mathbf{E}_{k,i}\rVert\cdot\lVert\mathbf{E}_{k,j}\rVert},\qquad \Psi_{k,i,j} = \frac{\mathbf{C}_{k,i}^{\top}\mathbf{C}_{k,j}}{\lVert\mathbf{C}_{k,i}\rVert\cdot\lVert\mathbf{C}_{k,j}\rVert} \tag{17}$$
这是一个很轻的设计:用"相似度矩阵"这个与维度无关的中介来对齐两个维度不同的空间($d_m$ vs $d_s/C$),避免了投影头或对比学习的额外复杂度。码本引导实现为一个简单但有效的 MSE 损失:
$$\mathcal{L}_{sim} = \mathrm{MSE}\left(|\Phi - \Psi|\right) \tag{18}$$
最终序列模型与 token embedding 由组合损失 $\mathcal{L} = \mathcal{L}_{rec} + \lambda\mathcal{L}_{sim}$ 训练,$\lambda$ 控制码本引导的强度。
整体流程小结:Tlow 是一个三阶段解耦的流水线——(a) 用 $\mathcal{L}_f$ 训练流模型(只依赖物品语义嵌入,与用户行为无关);(b) 冻结流模型,在潜空间做 PQ + K-means 得到码本与 token ID;(c) 用 $\mathcal{L}_{rec} + \lambda\mathcal{L}_{sim}$ 训练序列模型与 token embedding。
三、实验设置
3.1 数据集
使用 Amazon Reviews 的四个品类:"Sports and Outdoors (Sports)"、"Beauty"、"Toys and Games (Toys)"、"CDs and Vinyl (CDs)"。沿用已有工作的处理方式,把用户评论视为物品交互并按时间排成历史序列。跨域实验另外使用一个来自 SOTA 工作 LLM4CDSR 的处理好的数据集 "Cloth-Sports",采自 Amazon 的 "Clothing Shoes and Jewelry" 与 "Sports and Outdoors" 两个品类,其中大部分用户在两个品类上重叠。
| 数据集 | #Users | #Items | #Interactions | Avg. Length |
|---|---|---|---|---|
| Sports | 35,598 | 18,357 | 260,739 | 8.32 |
| Beauty | 22,363 | 12,101 | 176,139 | 8.87 |
| Toys | 19,412 | 11,924 | 148,185 | 8.63 |
| CDs | 75,258 | 64,443 | 1,022,334 | 14.58 |
| Cloth(跨域) | 9,933 | 3,278 | 97,741 | 10.71 |
| Sports(跨域) | 4,263 | 1,021 | 11,879 | — |
评估协议为业界通行的 leave-one-out:历史序列最后一个物品用于测试,倒数第二个用于验证。
3.2 Baseline
两大类:
- ID-based 模型(随机分配物品 ID):Caser、GRU4Rec、HGN、BERT4Rec、SASRec、FDSA、S3-Rec,分别用 CNN / RNN / Transformer 等不同架构建模行为序列。
- Tokenization-based 模型:VQ-Rec、TIGER、ETEGRec、RecJPQ、HSTU、RPG,分别用 PQ、RQ-VAE、OPQ 等不同量化技术把物品语义嵌入 token 化。
3.3 指标与实现
指标为 Recall@$k$(R@$k$)与 NDCG@$k$(N@$k$),$k \in \{5, 10\}$。全量排序(full ranking),所有物品参与打分以避免采样偏差。
实现细节:
- PyTorch 实现;训练与评估设置全部沿用 RPG,因此 baseline 结果直接取自原论文,RPG 自己重跑。
- 所有模型统一使用文本编码器 sentence-t5-base 抽取的物品语义嵌入,$d_s = 768$。
- Tlow 的 block 数与 flow 步数取 $N = 4$、$M = 4$。论文明确指出推荐性能对 block 数与 flow 数不敏感,因为 Tlow 很容易就能把语义嵌入变换成标准正态潜嵌入。
- 码本数 $C\in\{16, 32, 64, 96, 128\}$,码本大小 $S$ 固定为 256(沿用 RPG);解码温度 $\tau\in\{0.03, 0.05, 0.07\}$。
- 序列模型超参与 RPG 保持一致以确保参数量相当:2 层 GPT-2,token embedding 维度 $d_m = 448$。
关于效率,论文的立场是:Tlow 在一次前向里独立解出全部 $C$ 个 token ID(式 15),与 RPG 完全相同,因此继承了 RPG 相对 RQ-VAE 式串行解码(如 TIGER)的解码效率优势,这一点已在 RPG 论文中被实证过,本文不再重复延迟/吞吐 benchmark。
四、主要实验结果
4.1 通用序列推荐(Table 2)
| 类别 | Model | Sports R@5 | N@5 | R@10 | N@10 | Beauty R@5 | N@5 | R@10 | N@10 | Toys R@5 | N@5 | R@10 | N@10 | CDs R@5 | N@5 | R@10 | N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ID | Caser | 0.0116 | 0.0072 | 0.0194 | 0.0097 | 0.0205 | 0.0131 | 0.0347 | 0.0176 | 0.0166 | 0.0107 | 0.0270 | 0.0141 | 0.0116 | 0.0073 | 0.0205 | 0.0101 |
| ID | GRU4Rec | 0.0129 | 0.0086 | 0.0204 | 0.0110 | 0.0164 | 0.0099 | 0.0283 | 0.0137 | 0.0097 | 0.0059 | 0.0176 | 0.0084 | 0.0195 | 0.0120 | 0.0353 | 0.0171 |
| ID | HGN | 0.0189 | 0.0120 | 0.0313 | 0.0159 | 0.0325 | 0.0206 | 0.0512 | 0.0266 | 0.0321 | 0.0221 | 0.0497 | 0.0277 | 0.0259 | 0.0153 | 0.0467 | 0.0220 |
| ID | BERT4Rec | 0.0115 | 0.0075 | 0.0191 | 0.0099 | 0.0203 | 0.0124 | 0.0347 | 0.0170 | 0.0116 | 0.0071 | 0.0203 | 0.0099 | 0.0326 | 0.0201 | 0.0547 | 0.0271 |
| ID | SASRec | 0.0233 | 0.0154 | 0.0350 | 0.0192 | 0.0387 | 0.0249 | 0.0605 | 0.0318 | 0.0463 | 0.0306 | 0.0675 | 0.0374 | 0.0351 | 0.0177 | 0.0619 | 0.0263 |
| ID | FDSA | 0.0182 | 0.0122 | 0.0288 | 0.0156 | 0.0267 | 0.0163 | 0.0407 | 0.0208 | 0.0228 | 0.0140 | 0.0381 | 0.0189 | 0.0226 | 0.0137 | 0.0378 | 0.0186 |
| ID | S3-Rec | 0.0251 | 0.0161 | 0.0385 | 0.0204 | 0.0387 | 0.0244 | 0.0647 | 0.0327 | 0.0443 | 0.0294 | 0.0700 | 0.0376 | 0.0213 | 0.0130 | 0.0375 | 0.0182 |
| Token | RecJPQ | 0.0141 | 0.0076 | 0.0220 | 0.0102 | 0.0311 | 0.0167 | 0.0482 | 0.0222 | 0.0331 | 0.0182 | 0.0484 | 0.0231 | 0.0075 | 0.0046 | 0.0138 | 0.0066 |
| Token | VQ-Rec | 0.0208 | 0.0144 | 0.0300 | 0.0173 | 0.0457 | 0.0317 | 0.0664 | 0.0383 | 0.0497 | 0.0346 | 0.0737 | 0.0423 | 0.0352 | 0.0238 | 0.0520 | 0.0292 |
| Token | TIGER | 0.0264 | 0.0181 | 0.0400 | 0.0225 | 0.0454 | 0.0321 | 0.0648 | 0.0384 | 0.0521 | 0.0371 | 0.0712 | 0.0432 | 0.0492 | 0.0329 | 0.0748 | 0.0411 |
| Token | ETEGRec | 0.0175 | 0.0114 | 0.0281 | 0.0149 | 0.0404 | 0.0277 | 0.0587 | 0.0337 | 0.0209 | 0.0136 | 0.0339 | 0.0178 | 0.0309 | 0.0204 | 0.0461 | 0.0253 |
| Token | HSTU | 0.0258 | 0.0165 | 0.0414 | 0.0215 | 0.0469 | 0.0314 | 0.0704 | 0.0389 | 0.0433 | 0.0281 | 0.0669 | 0.0357 | 0.0417 | 0.0275 | 0.0638 | 0.0346 |
| Token | RPG | 0.0296 | 0.0203 | 0.0428 | 0.0246 | 0.0533 | 0.0366 | 0.0753 | 0.0437 | 0.0509 | 0.0357 | 0.0765 | 0.0440 | 0.0486 | 0.0328 | 0.0693 | 0.0395 |
| 本文 | Tlow | 0.0307 | 0.0207 | 0.0477 | 0.0261 | 0.0545 | 0.0377 | 0.0786 | 0.0454 | 0.0590 | 0.0395 | 0.0864 | 0.0482 | 0.0541 | 0.0362 | 0.0801 | 0.0446 |
| — | Impr. (%) | 3.72 | 1.97 | 11.45 | 6.10 | 2.25 | 3.01 | 4.38 | 3.89 | 11.52 | 9.70 | 9.80 | 11.36 | 9.96 | 10.03 | 7.09 | 8.52 |
加粗表示在配对 t 检验下以 $p < 0.01$ 的显著性水平优于最佳 baseline。
结论分析(why,不只是 what):
- Tokenization-based 模型整体显著优于纯 ID-based 模型(唯一例外是 RecJPQ,在 CDs 上甚至垫底)。这验证了物品 token 化对用户行为建模的价值——语义先验替代随机初始化,在稀疏数据上直接减少了需要从零学起的自由度。
- Tlow 在四个数据集的全部 16 个指标上都最优,说明"在标准正态潜空间做量化"确实带来了更好的 tokenization。
- 论文特别点出一个耐人寻味的现象:在统一使用 sentence-t5-base 语义嵌入的条件下,RPG(独立 tokenizer)并没有一致地优于 TIGER(RQ-VAE 串行 tokenizer)——在 Toys R@5、CDs 全部四个指标上 TIGER 都赢了 RPG。这正好说明"独立 tokenization"本身不是免费午餐:抛弃残差量化的层次依赖会损失精度,除非像 Tlow 这样先把嵌入变换到真正满足独立性假设的空间。这一条是全文最关键的实证支撑——它把 Tlow 的贡献从"又一个 tokenizer"提升到"独立 tokenization 路线的可行性补丁"。
- 提升幅度在 Toys / CDs 上(约 7%~11.5%)明显大于 Beauty(约 2%~4.4%)。CDs 是规模最大、序列最长(Avg. Length 14.58)的数据集,Tlow 在这里的优势最稳定。
一处需要注意的数据校对:按表内数值重算,Sports / Beauty / CDs 三个数据集的 Impr.(%) 与"Tlow 相对表内最佳 baseline"完全吻合(Sports、Beauty 对 RPG,CDs 对 TIGER);但 Toys 一列的四个百分比与任何一个表内 baseline 都对不上(如 R@5 若对 TIGER 0.0521 应为 +13.24%、对 RPG 0.0509 应为 +15.91%,而表中写 11.52%)。这是原文的一处内部不一致,不影响"Tlow 在 Toys 上全面最优"的结论,但引用该列具体提升幅度时应谨慎。
4.2 消融实验(Table 3)
设计了两个变体验证两个关键模块:
- Random z:潜嵌入 $\mathbf{z}$ 不由 Tlow 从语义嵌入变换而来,而是直接从标准正态分布采样。
- w/o $\mathcal{L}_{sim}$:去掉码本引导,即令 $\lambda = 0$。
| Model | Sports R@10 | N@10 | Beauty R@10 | N@10 | Toys R@10 | N@10 | CDs R@10 | N@10 |
|---|---|---|---|---|---|---|---|---|
| Tlow | 0.0477 | 0.0261 | 0.0786 | 0.0454 | 0.0864 | 0.0482 | 0.0801 | 0.0446 |
| w/o $\mathcal{L}_{sim}$ | 0.0449 | 0.0248 | 0.0764 | 0.0436 | 0.0826 | 0.0471 | 0.0756 | 0.0425 |
| Random z | 0.0202 | 0.0103 | 0.0623 | 0.0363 | 0.0571 | 0.0341 | 0.0147 | 0.0074 |
逐项分析:
- 去掉码本引导在四个数据集上一致掉点(R@10 相对下降 2.8%~5.6%,CDs 上从 0.0801 掉到 0.0756 最明显)。说明把 token embedding 空间与码本空间的相似度结构对齐,确实帮助 token embedding 学到语义更清晰的潜空间。这个模块很轻(一个 MSE 损失),性价比高。
- Random z 崩塌得非常彻底:Sports R@10 从 0.0477 掉到 0.0202(-57.7%),CDs 从 0.0801 掉到 0.0147(-81.6%)。这是全文最重要的一个反证——"标准正态分布"本身没有任何魔力,价值在于 Tlow 的变换是可逆的、保留了语义信息的。如果只要正态就够,随机采样也该管用;结果一败涂地,说明 Tlow 在把 $\mathbf{x}$ 变换成 $\mathbf{z}$ 的同时确实保住了行为建模所需的丰富语义。同时也可以反过来读:Random z 在 Beauty 上仍有 0.0623 的 R@10(高于多个 ID baseline),说明即使 token ID 完全随机,"token embedding 共享词表"这个结构本身也贡献了一部分收益——这一点论文没有展开,但从数据里能看出来。
4.3 跨域推荐(Table 4)
Baseline 选择当前 SOTA 跨域模型 LLM4CDSR(用 LLM 借助物品语义嵌入与层次化用户画像弥合领域鸿沟),另外加入 RPG 以验证 Tlow 在跨域 token 化上的效果。RPG 与 Tlow 的实现都是直接把两个域的物品序列混合起来训练。
| Model | Overall R@10 | N@10 | Cloth R@10 | N@10 | Sports R@10 | N@10 |
|---|---|---|---|---|---|---|
| LLM4CDSR | 0.4620 | 0.2803 | 0.4220 | 0.2637 | 0.5507 | 0.3172 |
| RPG | 0.4766 | 0.3457 | 0.4487 | 0.3353 | 0.5385 | 0.3686 |
| Tlow | 0.5558 | 0.4395 | 0.5669 | 0.4568 | 0.5312 | 0.4014 |
分析:Tlow 在 Overall 上相对 LLM4CDSR 提升 R@10 +20.3%、N@10 +56.8%,相对 RPG 也有 R@10 +16.6%、N@10 +27.1%。论文给出两条原因:其一,把物品 token 化成共享 token ID 词表并训练其 embedding,天然弥合了跨域鸿沟;其二,Tlow 变换嵌入分布的能力对跨域场景尤其有效——不同域的嵌入本来形成分离的簇,被拉到同一个标准正态空间后就能共用码本。
值得注意的负面细节:在 Sports 子域上 Tlow 的 R@10(0.5312)反而低于 LLM4CDSR(0.5507)和 RPG(0.5385),只有 N@10 领先。Cloth 子域样本量(9,933 用户 / 3,278 物品)远大于 Sports 子域(4,263 用户 / 1,021 物品),混合训练下 Tlow 的收益明显偏向大域,小域的召回被牺牲了一点。论文正文没有讨论这个跷跷板,是一个可追问的点。
4.4 多模态推荐(Table 5)
Baseline 选择当前 SOTA 多模态模型 HM4SR(用交互式与时序式 MoE 捕捉用户动态兴趣)。由于 HM4SR 使用了大量额外的 side-information(交互时间戳、物品类目、语义嵌入作为附加输入),公平起见,实验把 HM4SR 里的 ID embedding 替换成由 Tlow / RPG 生成的 token embedding $\mathbf{e}$,直接对比 tokenization 的效果。
实验在 "Sports" 数据集上进行,用先进的 CLIP 模型 OpenCLIP ViT-H/14 从各物品的商品页 URL 下载图片并生成图像嵌入。文本与图像嵌入独立 token 化,两组 token ID 合并成最终 token ID。
| Model | R@5 | N@5 | R@10 | N@10 |
|---|---|---|---|---|
| HM4SR | 0.0326 | 0.0231 | 0.0469 | 0.0277 |
| RPG | 0.0326 | 0.0216 | 0.0501 | 0.0272 |
| Tlow | 0.0343 | 0.0233 | 0.0521 | 0.0290 |
分析:RPG 的 token 化在这种"文本 + 图像混合分布"的设定下收益有限且不一致——R@5 与 HM4SR 打平(0.0326),N@5(0.0216 vs 0.0231)与 N@10(0.0272 vs 0.0277)都低于 HM4SR。这恰好印证了论文开头的诊断:多模态嵌入来自不同来源、形成分离簇,直接独立量化会失效。Tlow 完成分布变换后在四个指标上一致改善。但论文自己也承认,相对 HM4SR 的绝对提升幅度是温和的(R@10 从 0.0469 到 0.0521),并预期在模态更丰富、更异质时收益会更大——这在单域多模态设定下算是一个诚实的表述。
4.5 冷启动分组分析(Figure 3)
基于 tokenization 的模型因为聚焦物品语义,天然在冷启动上有优势。论文从用户与物品两个视角验证:用户按历史交互数(交互深度)分组,测试集物品按其在训练集中的出现频次(流行度)分组,在规模最大的 "CDs" 数据集上评估。
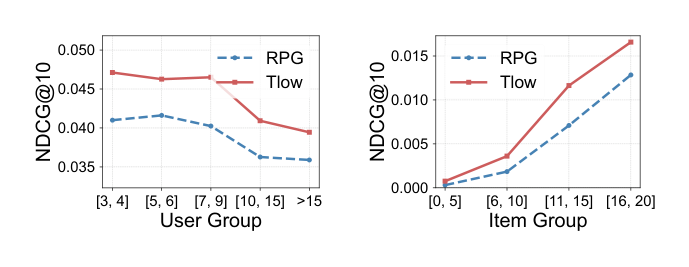
用户分组为 [3,4]、[5,6]、[7,9]、[10,15]、>15;物品分组为 [0,5]、[6,10]、[11,15]、[16,20]。结果显示 Tlow 在所有分组上都显著优于 RPG。论文的解释是:Tlow 能把任意嵌入(包括长尾物品的嵌入)都变换到标准正态分布,因此对各流行度层级的物品,其 token 化都更加充分(more comprehensive),进而对不同交互深度的用户都能做出更准确的行为建模。
这一条是 Tlow 相对残差量化路线的一个结构性论点:RQ-VAE 的码本坍缩本质上是"热门物品吃掉码字"的分布问题,而流变换是全局保测度的,长尾嵌入不会被压到码本的稀疏区。
五、线上实验
5.1 线上设置
在中国最大的社交媒体平台 微信(WeChat) 的图片推荐场景(涉及图文多模态特征)验证 Tlow。对比对象是:使用 Tlow token 化 embedding $\mathbf{e}$ 的序列模型 vs 使用随机分配物品 ID embedding 的序列模型。
- 用户行为序列长度 500,由最近点击的物品构成;
- 物品 embedding 序列送入 12 层 Transformer decoder 预测用户对下一物品的交互倾向;
- 两个序列模型都作为补充召回通路接入,与主力的 DSSM 实时召回并行。
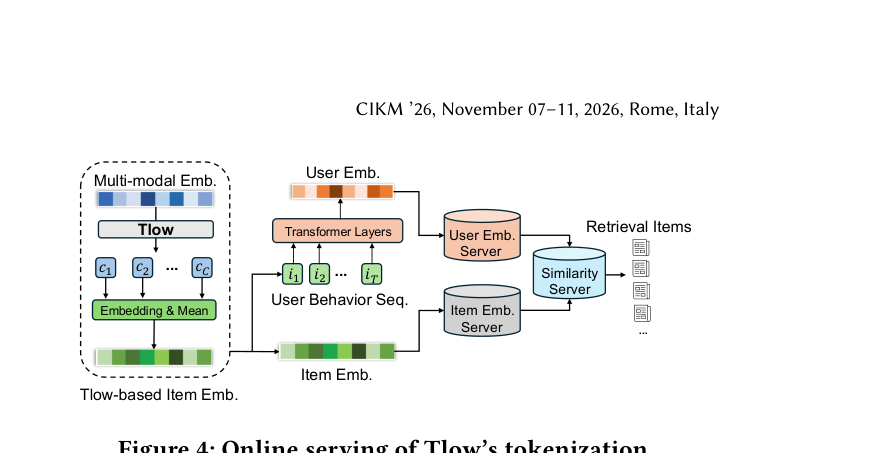
在线服务阶段,用户 embedding 与物品 embedding 存放在专用的 embedding server 中。用户访问时通过实时查找取出对应的用户 embedding,再由 Similarity Server(基于 Faiss)动态检索相似度最高的候选图片构成召回结果。
两类线上实验:
- Single-domain:只用用户点击的图片构造行为序列训练;
- Cross-domain:把用户点击的图片和文章混合起来构造行为序列训练,用于验证 Tlow token 化在跨域场景的有效性。
5.2 训练与推理成本
- Tlow 训练阶段,模型在约 100 万个物品(图片 + 文章)的嵌入上就已收敛。之后 Tlow 可以对其他未见物品做语义 token 化,因此训练时间可忽略;
- 推理效率上,单卡几分钟就能完成每天数千万新发布物品的 token 化;
- 部署配置:码本数 $C = 16$、码本大小 $S = 256$。因此 Tlow 版序列模型需要学习的 token embedding 只有 $C\times S = 4096$ 个,远少于 baseline 模型里的数千万个物品 embedding;
- Tlow 版序列模型除物品 ID embedding 外,其余参数全部用 baseline 模型的参数初始化;
- 上线 A/B 前,两个模型在完全相同的数据上训练两周,single-domain / cross-domain 场景每天分别有超过 7000 万 / 2 亿条交互记录。
5.3 线上结果(Table 6)
评估两条召回通路在全量图片语料以及"当天发布当天曝光"的冷启动图片上的转化效能。指标:
- CTR:经由该召回通路曝光的物品的点击率;
- UCTR:对所有用户经由该通路曝光物品的点击率取平均。
由于隐私考虑,全部指标只报告相对差异。
| Scenario | Overall CTR | Overall UCTR | New Item CTR | New Item UCTR |
|---|---|---|---|---|
| Single-domain | 4.79% | 10.32% | 8.46% | 11.64% |
| Cross-domain | 6.23% | 7.20% | 9.09% | 9.45% |
分析:
- 相对随机 ID,Tlow token 化在 single-domain / cross-domain 分别取得 +4.79% / +6.23% CTR;UCTR 提升更大(+10.32% / +7.20%),说明它能为更广泛的用户群体召回到潜在相关内容(而不只是让重度用户点得更多)。
- 只在每日新发布图片上评估时,优势明显更突出(CTR +8.46% / +9.09%,UCTR +11.64% / +9.45%)。原因很直白:随机 ID embedding 需要大量用户交互数据才能训好,而 Tlow 用的是图片一发布就立刻可得的固有语义特征。
除通路对比外,A/B 的核心线上指标也显著改善:
- Single-domain:24 小时整体图片 CTR +0.78%,新发布图片 CTR +1.94%;
- Cross-domain:人均图片 CTR +1.05%,同时头部账号曝光占比下降 1.15%,表明 Tlow 实质性地提升了长尾图片的曝光。
最后一条(头部曝光占比下降)是很好的补充证据:语义 token 化不仅提升了效率,还改善了生态分布,与 4.5 节的冷启动分组结论互相印证。
六、核心贡献总结
- 诊断层面:把独立(可并行解码)tokenizer 的精度短板归因到语义嵌入本身的几何与分布——维度相关 + 分布复杂(各向异性锥形、多源分簇),而不是量化算法不够好。并给出 OPQ 为何不够的机理:正交变换只做了子空间级解耦,子空间内维度仍相关。
- 方法层面:用 Glow 式多尺度 normalizing flow(ActNorm + Invertible Linear + Affine Coupling)把语义嵌入变换到标准正态潜空间,一次性拿到维度独立 + 分布简单两个性质,然后用最朴素的 PQ + K-means 就能得到语义清晰、可并行解码的 token ID。
- 训练层面:提出 codebook guidance——用余弦相似度矩阵这个与维度无关的中介,把 token embedding 空间与码本空间对齐(式 17-18),比逐物品 / 逐序列对齐更简洁。
- 实证层面:四个公开数据集全指标 SOTA;跨域、多模态、冷启动分组均有效;微信图片推荐真实线上 A/B 验证,UCTR 全局 +10.32%、新品 +11.64%,且部署成本极低(4096 个 token embedding 替代数千万物品 embedding,单卡几分钟 token 化每日数千万新品)。
七、与已归档相关工作的对比
CARD CARD: Non-Uniform Quantization of Visual Semantic Unit for Generative Recommendation(UESTC + 西南财经大学,2026-04-29)
关系:独立并发(本文未引用 CARD,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文诊断出的 root cause 高度一致——物品语义嵌入的分布本身不适配量化器的隐含假设。CARD 的表述是"传统量化器(RQ-VAE)以最小化全局重建误差为目标,隐式假设 latent 分布大致均匀,但推荐场景下热门物品挤成致密簇、长尾散在稀疏区,导致码本利用失衡并在生成端被放大";Tlow 的表述是"语义嵌入高度各向异性、占据锥形区域且维度相关,独立量化在其上强加网格结构"。两者都明确否定了"在量化阶段被动接受偏斜分布"的做法。
- 相近的技术骨架:两篇的方法流程图可以完全抽象重合——在量化之前插入一个可学习的可逆变换 $\mathcal{T}$,把嵌入重映射到一个"量化器友好"的目标分布,再做量化。CARD 的 NU-RQ-VAE 用 Kumaraswamy CDF(CARD$_K$)或 scaled logistic(CARD$_S$)把偏斜 latent 映射到近似均匀空间,量化后用 $\mathcal{T}^{-1}$ 反变换回原语义空间,并用一致性损失 $\mathcal{L}_{NUQ} = \lVert\mathcal{T}^{-1}(\mathcal{T}(\mathbf{h})) - \mathbf{h}\rVert_2^2$ 抑制数值误差;Tlow 用 Glow 式 flow 把嵌入映射到标准正态空间,可逆性由架构(三角 Jacobian)严格保证,无需额外一致性损失。
- 本文的差异与推进:三点关键区别。(a) 变换的表达力:CARD 的 $\mathcal{T}$ 是逐维独立的单调标量 CDF(每维一组可学习的 $a,b$ 或 $\alpha,x_0$),只能改变各维的边缘分布,改不了维度间的相关性;Tlow 的 flow 含 Invertible Linear 层($\mathbf{W} = \mathbf{PLU}$)与 Affine Coupling 层,是多维耦合的非线性变换,目标恰恰就是消除维度相关。(b) 目标分布不同:CARD 要均匀(服务于"码本容量均匀分配"这一假设),Tlow 要标准正态(服务于"维度独立"这一 PQ 前提)。(c) 后端量化器不同:CARD 后接残差量化(RQ),仍是串行解码;Tlow 后接独立 PQ,可并行解码——这是 Tlow 押的更大的注,也是它必须把维度相关性真正消掉的原因。
- 可比的方法 / 实验差异:数据集不重叠(CARD 用 Amazon Food / Phones / Clothing,Tlow 用 Sports / Beauty / Toys / CDs),无法直接比数字。CARD 的消融显示"去掉非均匀变换(w/o NUT)退化为标准 RQ-VAE 后所有数据集显著下降",Tlow 的 Random z 消融显示"分布正确但语义丢失时性能崩塌 57%~82%"——两个消融从相反方向共同证明了同一件事:变换必须既改造分布、又保住语义。工业验证上 Tlow 有微信线上 A/B,CARD 只有学术数据集,无 A/B。两条路线在工程上完全可以叠加:先用 flow 做多维解耦,再用逐维 CDF 做边缘均匀化。
DRQ DRQ: Decoupled Residual Quantization for Robust Semantic IDs in Recommendation(Shopee,2026-06-01)
关系:独立并发(本文未引用 DRQ,两者殊途同归)· 已加载对方精读
- 共同关注的问题:DRQ 把 SID 退化显式拆成两项,其中 Geometry Penalty(几何惩罚) 的论述与 Tlow 的问题陈述几乎逐字对应:"许多量化器通过在连续空间里铺设欧氏网格来组织空间……在 PQ 中,向量被切成固定坐标块,每块独立量化,子码本的笛卡尔积等价于原空间中一个轴对齐网格……而推荐 embedding 往往高度各向异性或集中在弯曲流形上。当一个平坦网格被强加到这种数据上时,很多码字组合落在没有真实物品居住的区域。" DRQ 还直接点名了 cone effect(各向异性/锥形效应)——与 Tlow 引用的"嵌入占据非均匀锥形而非均匀铺开"是同一个现象。两篇都认定:问题出在表示空间的几何,而非量化算法的细节。
- 相近的技术骨架:两者都采用"先在连续空间重塑表示,再做离散分配"的两阶段解耦骨架,且都刻意把量化从表示学习的训练回路里拿掉。DRQ 的阶段一是"Continuous Reshaping":去掉 STE 与 commitment loss,只用重建损失(可选 InfoNCE)训练 VAE,让潜变量在被离散化前自由扩张;阶段二冻结潜向量后跑层次 K-Means。Tlow 的阶段一是流模型(只用 $\mathcal{L}_f$),阶段二冻结后跑 PQ + K-means。两者都认为 STE 把码本学习与刚性重建目标耦合起来会扭曲连续潜流形。
- 本文的差异与推进:(a) 重塑手段的性质根本不同——DRQ 用 VAE(有损、不可逆、靠 KL 与对比损失间接塑形,重塑方向是"扩张 + uniformity"),Tlow 用 normalizing flow(可逆、精确似然、目标分布被解析地钉死为 $\mathcal{N}(0,I)$,信息理论上无损)。Tlow 的路线在"是否真的达到了目标分布"上有严格保证,DRQ 只能事后用 $K_{\text{eff}}$ 这类诊断量去测。(b) 离散端不同——DRQ 仍然是层次 RQ-KMeans(保留 coarse-to-fine 层级,论文明确说选 RQ 不选 PQ 是因为"PQ 切到正交子空间可能削弱全局语义相关性");Tlow 则直接押注 PQ 独立量化,理由是流变换后子空间之间已经真正独立——两篇对"PQ 是否可用"给出了相反的判断,而分歧点恰恰在于前置变换够不够强。这是两者最有价值的张力。(c) 目标不同:DRQ 的核心产出是诊断框架($O_\pi$ / $K_{\text{eff}}$ / Distribution Penalty / Geometry Penalty),DRQ 算法本身自称是 proof of concept,且只在 1500 万物品的自有工业数据集上做 item-to-item 检索评测、无公开 benchmark、无端到端推荐指标;Tlow 是完整的端到端方案,有公开 benchmark 与线上 A/B。
- 可比的方法 / 实验差异:无重叠数据集与指标,无法直接比数字。但 DRQ 的诊断框架可以直接用来解释 Tlow 为何有效:Tlow 通过把分布变成各向同性标准正态,同时压低了 Distribution Penalty(码字先验更均匀,$\sum_i\pi_i^2$ 更小)与 Geometry Penalty(消除弯曲流形,轴对齐网格终于与数据几何匹配)。反过来,DRQ 的结论"没有单一 tokenizer 在所有维度上占优,符号容量 / 重建保真 / 行为感知软匹配是三个相关但独立的目标",也提示 Tlow 缺一块评测:它只报了下游 Recall/NDCG,没有报码本利用率、碰撞率等 tokenizer 内在质量指标。
BlockQuant BlockQuant: Block-Sphere Vector Quantization(首尔国立大学,2026-05-19)
关系:独立并发(本文未引用 BlockQuant,不同领域的对偶解)· 已加载对方精读
- 共同关注的问题:两篇都在攻击同一个结构性失配——"正交/旋转变换 + 逐坐标(或逐块)独立码本"这套组合,其码本几何与数据的真实联合分布对不上。BlockQuant 的诊断是:EDEN 与 TurboQuant 的码本都是 coordinate-wise 1D 的,RabitQ 的码本虽在球面上但来源是 $\{-1,0,1\}^d$ 的投影,"两者都没有真正利用高维球面的更丰富几何结构";Tlow 的诊断是:OPQ 的正交变换只做到子空间级解耦,子空间内维度仍相关,"独立量化在复杂偏斜流形上强加网格状结构"。同一句抱怨的两种说法。
- 相近的技术骨架:流程图形状高度一致——变换 → 切块 → 每块用自己的码本独立量化。Tlow:$\mathbf{x}\to$ flow $\to\mathbf{z}\to$ 切成 $C$ 段 $\to$ 每段 K-means 码本;BlockQuant:$\mathbf{x}\to$ Haar 随机旋转 $R\to R\mathbf{x}\to$ 切成大小为 $p$ 的块 $\to$ 每块用球面块边缘分布解析导出的 $2^{bp}$ 个 centroid。两者都在明确推理"变换之后每一段服从什么边缘分布",并据此设计量化器。
- 本文的差异与推进:这是同一失配的对偶两侧。Tlow 改造输入分布去迎合量化器的独立假设(学一个非线性可逆映射,把真实数据变成 $\mathcal{N}(0,I)$);BlockQuant 保留旋转、改造码本几何去迎合数据分布(不学码本,直接从球面块边缘分布解析推导 centroid,并证明当块大小 $p\to d$ 时其 MSE 上界在阶与领先常数上都匹配 Shannon 下界)。由此派生出一系列差异:Tlow 的变换需要在数据上训练、码本靠 K-means 从数据学出;BlockQuant 的旋转是随机的、码本是完全 training-free 的解析构造。此外 BlockQuant 假设输入是单位球面向量(范数单独存储),失配是率失真意义上的编码效率问题;Tlow 面对的是任意的、分布未知的物品语义嵌入,失配是统计意义上的维度相关与各向异性问题。
- 可比的方法 / 实验差异:应用域完全不同——BlockQuant 评测的是 Llama-3.1-8B 的 KV-cache 量化(3.5-bit 下 LongBench-E 均分 44.03 vs 全 cache 44.15)与梯度压缩,Tlow 评测的是推荐 Recall/NDCG 与微信线上 CTR,没有任何可直接对比的数字。但两者对彼此有明确的方法论启发:Tlow 的 PQ 段内仍用 K-means 学码本,若换成 BlockQuant 式"针对已知 $\mathcal{N}(0,I)$ 边缘分布解析构造的最优块码本",理论上可以在同 bit 预算下进一步压低量化失真——Tlow 把分布变成了标准正态,恰恰使 BlockQuant 那套"已知边缘分布 → 解析最优码本"的推导可以直接套用,这是一个非常自然的组合方向。反过来,BlockQuant 依赖随机旋转来保证坐标边缘可解析,而 Tlow 说明"可学习的非线性可逆变换"是比随机旋转更强的预处理。
被剔除的近似候选与理由(防止门槛放水):
| 候选 | 剔除理由 |
|---|---|
| SA-RSQ SA-RSQ(Meituan,2026-08-24) | 主题同为量化 tokenizer,但 root cause 是"逐物品存储与表示维度强耦合 + 硬分配不可导",解法是用 Top-K masked-softmax 稀疏路由替代 arg min。改的是分配机制,不是量化前的表示分布,与 Tlow 不同构。 |
| LGRID LGRID(Kuaishou,2026-07-30) | 骨架上确实是"量化前先变换表示"(generative-disentanglement-before-quantization),但解耦目标是地理属性 vs 语义属性的可解释分槽,root cause 是属性纠缠导致不可解释与高碰撞,不是统计意义上的维度相关/各向异性;且其变换由 LLM 生成式监督驱动、不可逆,后端仍是双流残差量化(串行)。 |
| R3-VAE R3-VAE(ByteDance,2026-04-13)与 CapsID CapsID(2026-05-06) | 两者的 root cause 都是"RQ-VAE 的硬 argmax 阻断梯度 → 码本坍缩/利用率低",解法都是把硬分配换成软加权(rating 机制 / capsule 路由)。押的是"修好残差量化"这条注,而 Tlow 押的是"离开残差量化",两条路线正相反。 |
| CRAB CRAB、QuaSID QuaSID、AdaSID AdaSID | root cause 是码本的流行度偏置或 SID 碰撞判定,解法是热门 token 分裂 / 冲突排斥调制,都在码本索引层面做后处理,不触及嵌入空间的几何。 |
| Dynamic PV-S2 Dynamic PV-S2(Kuaishou,2026-08-21) | root cause 是多级残差码本的条件稀疏与随流量漂移的时效性,解法是合并码本层级 + 曝光加权动态更新。问题是"码本随时间失配",Tlow 是"码本与嵌入几何失配",不同构。 |
| RQ-FSQ RQ-FSQ(LinkedIn,2026-05-31) | FSQ 形式上也是逐维独立标量量化,看似共享"独立量化"假设;但其问题陈述是跨域用户 embedding 的存储压缩与冷启动迁移质量,对象与 root cause 都不同。 |
| SITA SITA(Kuaishou,2026-08-04) | 使用 N 个并行(独立)码本,形式相近;但问题是超长行为序列的兴趣压缩与在线存储/推理开销,SID 只是组织骨架,不是 tokenizer 质量问题。 |
| FAVE FAVE、FlowTime FlowTime | 同样使用 flow / flow-matching 这一工具,但 FAVE 解决的是生成式序列推荐的一步生成效率,FlowTime 解决的是观看时长回归的多峰分布建模。共享工具不等于共享问题,均不入选。 |
时序说明:本文 arXiv 首发 2026-08-25,上述三篇保留候选(CARD 2026-04-29、BlockQuant 2026-05-19、DRQ 2026-06-01)均早于本文 3~4 个月。经在 content.txt 中检索确认,本文参考文献 41 条中未引用任何一篇(也未出现 Kumaraswamy、rotation、RabitQ 等相关术语),因此三者对本文而言都是"本文后出但未引用"的独立并发关系,而非本文的前置工作被遗漏引用。本文实际引用且已归档的论文只有 TIGER、SASRec、HSTU、OneRec 四篇,其中前三篇是 baseline 关系,已在 DAG 中以结构化对比边登记。
八、讨论与局限性
8.1 值得借鉴的设计
- "改造数据以适配算法假设"这个思路本身。当一个方法(PQ 独立量化)在理论上很优雅、工程上很高效,但因为数据不满足其假设而失效时,除了改造算法,还可以改造数据。流模型是这类"分布搬运"任务的天然工具——可逆、精确似然、目标分布可任意指定。这个 pattern 可迁移到推荐系统中大量"假设不成立"的场景。
- 用相似度矩阵对齐两个维度不同的空间(式 17-18)。$\Phi$ 与 $\Psi$ 都是 $C\times S\times S$,与 $d_m$、$d_s/C$ 无关,因此不需要投影头就能对齐。这是一个非常轻量、可复用的对齐技巧。
- 部署成本的量级对比极具说服力:$C\times S = 4096$ 个 token embedding 替代数千万个物品 embedding,且 Tlow 在 100 万物品上就收敛、单卡几分钟 token 化每日数千万新品。对工业系统而言,这不只是效果收益,更是参数预算的重新分配——省下的容量可以全部投给序列建模。
8.2 局限与可争议之处
- 效率优势是"继承"而非"实测"。论文明确说不重复延迟/吞吐 benchmark,理由是解码方式与 RPG 完全相同、优势已在 RPG 论文中验证。这个论证在逻辑上成立,但忽略了 Tlow 自己引入的额外推理开销——每个新物品都要过一遍 $N\times M = 16$ 步 flow 才能得到 token ID。论文只给了"单卡几分钟处理数千万新品"这个定性说法,没有与 RQ-VAE encoder 的 tokenization 成本做对照。
- 缺 tokenizer 内在质量指标。全文只报下游 Recall/NDCG 与 Figure 1 的定性对比(#category / entropy),没有报码本利用率、碰撞率、重建误差、$K_{\text{eff}}$ 等 tokenizer 层面的量化指标。这使得"流变换确实让维度独立了"这个核心主张缺少直接证据——没有任何一张图/表展示变换后 $\mathbf{z}$ 的维度间相关矩阵或与 $\mathcal{N}(0,I)$ 的距离。这是本文最实质的实证空缺。
- 三阶段解耦的可扩展性隐患。流模型只用语义嵌入训练,完全不感知用户行为;训练完即冻结,码本随之固化。这意味着 token 空间的表征上限在推荐模型训练之前就被锁死,序列模型 scaling 时无法同步扩充"如何表征物品"这条路径。ETEGRec、DIG 等端到端可学 tokenizer 的路线正是在攻击这一点。论文对此没有讨论。
- Toys 数据集的 Impr.(%) 与表内数值对不上(见 4.1 节),是一处需要注意的数据校对问题。
- 跨域实验的小域退化未被讨论:Sports 子域 R@10 反而低于两个 baseline(见 4.3 节),混合训练下的域间跷跷板被回避了。
- 线上实验只对比"随机 ID",没有对比其它 tokenizer。Table 6 的对照组是 ID-based 模型,这只能证明"语义 token 化 > 随机 ID",不能证明"Tlow 的 token 化 > RQ-VAE / OPQ 的 token 化"在工业规模上成立。离线的四个 Amazon 数据集规模(最大 6.4 万物品)与微信的数千万物品差了三个数量级,这个外推缺口是存在的。
- 多模态收益温和且承认。Table 5 相对 HM4SR 的绝对提升有限(R@10 0.0469 → 0.0521),论文自己预期"模态更丰富时收益更大",属于诚实但未验证的表述。
- 超参敏感性的说法缺证据。论文声称"推荐性能对 block 数与 flow 数不敏感",但没有给出任何敏感性分析的表或图来支撑,读者只能接受这个断言。
8.3 与已有工作的定位
Tlow 明确属于 TIGER → VQ-Rec → RPG 这条 item tokenizer 演进线的最新一环,其独特性在于它是目前唯一把流模型引入 tokenizer 前置变换的工作。相比同期大量"修补 RQ-VAE"(R3-VAE、CapsID、QuaSID、AdaSID、CRAB)的工作,Tlow 押的是完全不同的注——不修残差量化,而是让独立量化真正可用。从 Table 2 揭示的"RPG 未能一致超越 TIGER"这个事实看,这条路线此前确实是欠火候的,Tlow 补上了关键一环。而与 CARD / DRQ 这两篇独立并发工作放在一起看,2026 年上半年至少有三个团队各自独立地意识到了同一件事:semantic ID 的质量瓶颈已经从"量化算法"转移到了"被量化的表示空间本身"。