从静态多级小语义码本到动态单层大语义码本¶
Kuaishou Technology(快手,北京)· Tianlu Xie, Xin Ku, Mingjie Sun, Yunhao Sha, Lixiang Wang, Peng Wang, Yiyu Wang, Wenjin Wu, Zhaojie Liu, Peng Jiang, Wenwu Ou · arXiv:2608.21012(2026-08-21)
研究动机与背景¶
生成式推荐把每个物品表示成一串离散的 Semantic ID(SID),然后让模型自回归地"生成"下一个物品的 SID 序列来完成召回。TIGER 奠定了这一范式:把内容 embedding 用 RQ-VAE 量化成层次化语义码字,再用 encoder-decoder Transformer 预测它们。此后 item tokenization 本身成了核心研究问题——标识符既要保住语义结构、又要吸收协同信号、还要保持码字使用均衡。
绝大多数 SID 方案都在"深度"方向上堆容量:用多级残差量化(residual quantization),第一级语义码近似物品 embedding,之后每一级量化上一级留下的残差来细化表示。这样做的好处是每一步的词表规模可控;代价是自回归推荐器一步只能预测一个码,并且通常要用 beam search 维护多条候选路径,每多一级就多一次串行预测、并把搜索空间再放大一层。
论文的出发点是快手线上系统里一个被量化出来的具体现象。生产环境部署的是三级 SID:SID1、SID2 做语义残差量化,SID3 是协同消歧码——它只负责区分那些在语义码下已经无法区分的物品,从而降低 full-SID 碰撞率。作者在约 15.0 亿条工业样本上统计发现:
- 全局 SID1 利用率 87.51%,全局 SID2 利用率 93.31%——单看全局,两级语义码都被"用满"了;
- 但条件利用率惨不忍睹:对每个活跃的 SID1,其下平均只用到 SID2 词表的 2.48%,中位数 1.68%,25 分位 0.50%,最大也只有 19.34%。
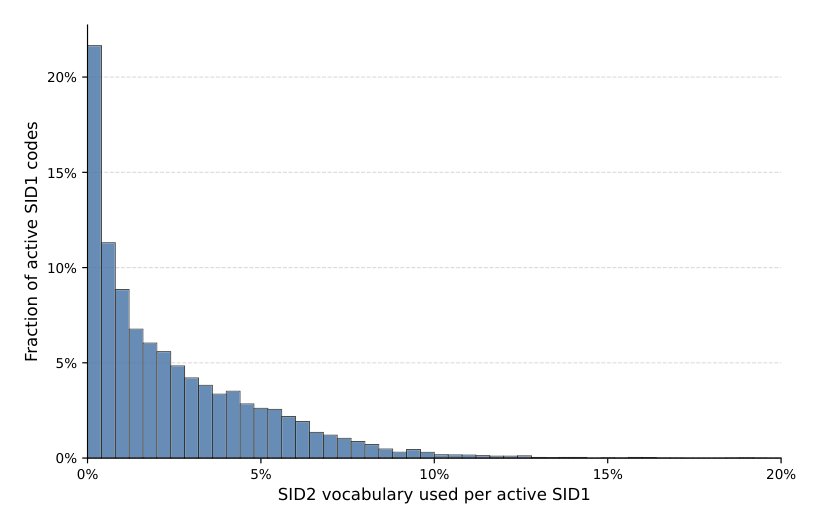
| 统计量 | 数值 |
|---|---|
| 样本量 | 1.50B |
| 全局 SID1 利用率 | 87.51% |
| 全局 SID2 利用率 | 93.31% |
| 条件利用率 最小值 | 0.02% |
| 条件利用率 最大值 | 19.34% |
| 条件利用率 均值 | 2.48% |
| 99 / 95 / 90 分位 | 10.46% / 7.32% / 5.96% |
| 75 分位 / 中位数 / 25 分位 | 3.83% / 1.68% / 0.50% |
结论很直接:SID2 撑起了一个巨大但条件稀疏的层次空间,却实实在在地要求多一步解码。这是"深度换容量"路线的结构性浪费。
已有的一条缓解路线是并行 SID 生成,但独立预测的 token 不保证能组合成合法的目录标识符:RPG 因此要用 graph-guided decoding 排除非法 SID,LLaDA-Rec 则为它的扩散解码器设计了适配的 beam search。也就是说,并行化之后仍然要付出"合法性恢复 / 约束搜索"的代价。本文选了另一个方向:从源头减少必须生成的语义码个数,从而根本不存在跨层非法组合。 受现代语言模型"大词表预测"能力的启发,作者把多级残差语义表示换成单层大语义码本,只保留一个独立的协同消歧码用于降碰撞(它不参与语义重构),把工业上典型的三码序列缩短为两码。
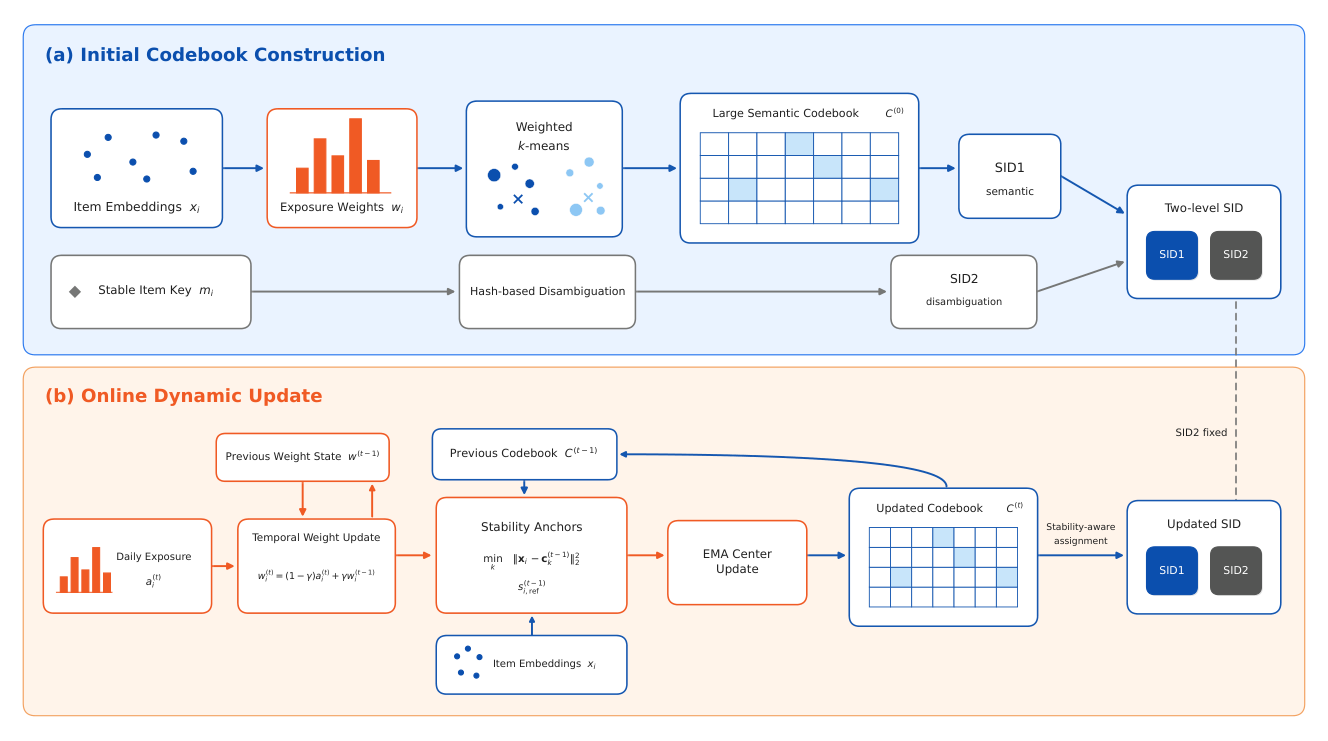
单纯的结构简化解决不了第二个问题:码本漂移(codebook drift)。线上物料池是非平稳的——新物品持续涌入、物品 embedding 在演化、曝光分布随用户兴趣与流量分配漂移。用某个固定历史窗口拟合出来的静态语义码本,其中心与划分会越来越对不上当前流量里占主导的物品。作者因此引入曝光感知的动态更新机制:维护带时间衰减的曝光权重、用指数滑动平均(EMA)更新活跃中心、并对换码行为施加曝光加权惩罚,以提升高曝光物品的分配稳定性。
第三个动机是工程上的:工业系统里直接用完整推荐链路来验证一个新码本太贵——每个候选码本都要求把全量物品重新 tokenize、再把下游生成式推荐器重训并评估。这条反馈链太长,导致码本方案没法快速迭代。作者因此构建了一套码本级离线评测框架,在不训练推荐器的前提下度量表示质量、语义码利用率、簇负载、full-SID 碰撞与时间稳定性。
三项贡献:(1) 单层大语义码本 + 独立消歧码,缩短 SID、减少自回归步数;(2) 曝光感知动态码本(时间衰减曝光权重 + EMA 中心更新 + 曝光加权换码惩罚),在"适应流量变化"与"分配稳定"之间取平衡;(3) 多维码本离线诊断框架,让候选码本在昂贵的重 tokenize + 重训练之前就能被筛掉。
核心方法 / 模型架构¶
问题形式化¶
记第 $t$ 天可用的物品集合为 $\mathcal{I}_t$。每个物品 $i \in \mathcal{I}_t$ 由一个预计算 embedding $e_i \in \mathbb{R}^d$、一个稳定物品键 $m_i$、以及一个曝光计数 $p_i^{(t)}$ 描述。语义量化使用 $\ell_2$ 归一化后的物品 embedding:
$$x_i = \frac{e_i}{\lVert e_i \rVert_2} \in \mathbb{R}^d \tag{1}$$
稳定物品键 $m_i$ 只被下面的消歧规则使用。框架产出一个两 token 的 SID:
$$s_i^{(t)} = \left( s_{i,\text{sem}}^{(t)},\; s_{i,\text{dis}} \right) \tag{2}$$
其中 $s_{i,\text{sem}}^{(t)}$ 选自大语义码本 $C^{(t)} = \{c_k^{(t)}\}_{k=1}^{K_s}$,$s_{i,\text{dis}}$ 选自规模为 $K_d$ 的消歧词表。全文把这两个位置分别称为 SID1(语义) 与 SID2(消歧)——注意这与线上三级方案里 SID1/SID2 都是语义码的命名不同。
从两个语义 token 到一个¶
原三 token 架构把物品 $i$ 表示为 $(s_i^{(1)}, s_i^{(2)}, s_{i,\text{dis}})$。给定语义码本 $C^{(1)}$ 与 $C^{(2)}$,残差量化从 $x_i$ 取第一个码、从残差取第二个码:
$$s_i^{(1)} = \arg\min_k \big\lVert x_i - c_k^{(1)} \big\rVert_2^2,\quad r_i^{(1)} = x_i - c_{s_i^{(1)}}^{(1)},\quad s_i^{(2)} = \arg\min_k \big\lVert r_i^{(1)} - c_k^{(2)} \big\rVert_2^2,\quad \hat{x}_i^{\text{RQ}} = c_{s_i^{(1)}}^{(1)} + c_{s_i^{(2)}}^{(2)} \tag{3}$$
本文把语义容量集中到一个码本上。对归一化 embedding $x_i$ 与语义码本 $C^{(t)}$:
$$s_{i,\text{sem}}^{(t)} = \arg\min_{k \in \{1,\dots,K_s\}} \big\lVert x_i - c_k^{(t)} \big\rVert_2^2,\qquad \hat{x}_i^{(t)} = c_{s_{i,\text{sem}}^{(t)}}^{(t)} \tag{4}$$
大词表在不新增一个自回归位置的前提下提升了单个语义 token 的容量——这正是"宽度 vs 深度"的取舍。
消歧 token¶
语义量化可能把多个物品分到同一个语义码。作者保留了线上系统最后一层的消歧机制。设 $g$ 是定义在稳定物品键上的固定分配规则:
$$s_{i,\text{dis}} = g(m_i) \in \{1,\dots,K_d\} \tag{5}$$
该规则是确定性的、且跨码本版本固定不变。工业实现中 $g(m_i)$ 是对物品关联键元组 $m_i$ 的稳定哈希。因此只要物品本身没变,即使它的语义分配被更新,它拿到的消歧 token 也不变。这个 token 只用于分开共享同一语义码的物品,不参与语义重构。
自回归生成¶
对用户历史 $H$,目标分解为:
$$P(s_i \mid H) = P(s_{i,\text{sem}} \mid H)\, P(s_{i,\text{dis}} \mid H, s_{i,\text{sem}}) \tag{6}$$
原架构还需要为第二个语义 token 多出一个条件因子。因此本设计把自回归预测次数从 3 次降到 2 次,同时保留了消歧阶段。
曝光感知的码本学习¶
工业流量中的物品频次极度倾斜。无权重目标对每个物品一视同仁,导致划分反映的是物料目录分布而非流量分布,高频曝光物品可能分不到足够的表示容量。为了在考虑流量的同时防止头部物品主导优化,作者对原始日曝光计数做对数压缩:
$$a_i^{(t)} = 1 + \log_{10}\left( \max\{p_i^{(t)}, 1\} \right) \tag{7}$$
对静态训练窗口,该曝光权重进入加权量化目标:
$$\min_{C, \{s_i\}} \sum_i w_i \lVert x_i - c_{s_i} \rVert_2^2 \tag{8}$$
初始语义码本用加权 k-means 训练。在加权 k-means++ 初始化阶段,记 $D_i^2 = \min_{c \in C_{\text{sel}}} \lVert x_i - c\rVert_2^2$ 为到已选中心的最近平方距离,下一个中心 $I_{\text{next}}$ 按下式采样:
$$P(I_{\text{next}} = i \mid C_{\text{sel}}) = \frac{w_i D_i^2}{\sum_j w_j D_j^2} \tag{9}$$
曝光感知的动态码本更新¶
时间曝光权重。 为每个近期观测到的物品维护一个有状态权重。若物品同时存在于历史状态与第 $t$ 天:
$$w_i^{(t)} = \gamma\, w_i^{(t-1)} + (1-\gamma)\, a_i^{(t)},\qquad 0 < \gamma < 1 \tag{10}$$
新观测物品初始化为 $w_i^{(t)} = a_i^{(t)}$;历史物品若在第 $t$ 天缺席,则权重衰减为 $w_i^{(t)} = \gamma w_i^{(t-1)}$;衰减权重低于阈值 $\varepsilon$ 的物品被移出状态。这套机制保留近期曝光历史,同时逐步遗忘不再拿量的物品。
稳定性锚点。 为了抑制不必要的换码,作者用上一版码本 $C^{(t-1)}$ 下的分配作为第 $t$ 天更新的稳定性锚点,即用旧码本对当前 embedding 编码:
$$s_{i,\text{ref}}^{(t-1)} = \arg\min_k \big\lVert x_i - c_k^{(t-1)} \big\rVert_2^2 \tag{11}$$
这些参考分配既定义了估计当日中心所用的旧划分,也提供了下面换码惩罚的锚。
中心更新与最终分配。 对中心 $k$,令 $A_k^{(t)} = \{i : s_{i,\text{ref}}^{(t-1)} = k\}$ 为它在第 $t$ 天的参考划分物品集,计算曝光加权当日中心:
$$\tilde{c}_k^{(t)} = \frac{\sum_{i \in A_k^{(t)}} w_i^{(t)} x_i}{\sum_{i \in A_k^{(t)}} w_i^{(t)}} \tag{12}$$
对至少收到一个分配的中心,更新值为 EMA:
$$c_k^{(t)} = (1-\alpha)\, c_k^{(t-1)} + \alpha\, \tilde{c}_k^{(t)},\qquad 0 < \alpha \le 1 \tag{13}$$
未激活的中心保持不变,$c_k^{(t)} = c_k^{(t-1)}$。随后针对更新后的中心,带曝光加权换码惩罚计算最终发布的语义分配:
$$s_{i,\text{sem}}^{(t)} = \arg\min_k \; \big\lVert x_i - c_k^{(t)} \big\rVert_2^2 + \lambda\, w_i^{(t)}\, \mathbb{I}\!\left( k \neq s_{i,\text{ref}}^{(t-1)} \right) \tag{14}$$
$\lambda \ge 0$ 控制"适应 vs 稳定"的取舍:惩罚项抑制高曝光物品换码,但当换码能带来足够大的量化距离下降时仍允许重分配。作者强调这一稳定性在流式训练中尤为关键——突然重分配一个高曝光物品会一次性改掉大量离散监督目标,由此产生的不连续会破坏梯度更新、阻碍模型优化。码本每天更新一次,新的语义分配与不变的消歧规则一起发布。
Algorithm 1(一次在线更新周期):
- 遍历"当前物料 ∪ 权重状态"的并集:若 $i \in \mathcal{I}_t$,计算 $a_i^{(t)}$ 并更新/初始化 $w_i^{(t)}$;否则令 $w_i^{(t)} \leftarrow \gamma w_i^{(t-1)}$。若 $w_i^{(t)} < \varepsilon$ 则移出状态。
- 对所有 $i \in \mathcal{I}_t$,用 $C^{(t-1)}$ 编码得到 $s_{i,\text{ref}}^{(t-1)}$。
- 形成参考划分 $A_k^{(t)}$。
- 对每个 $k$:若 $A_k^{(t)} \neq \emptyset$,按式 (12)-(13) 更新 $c_k^{(t)}$;否则 $c_k^{(t)} \leftarrow c_k^{(t-1)}$。
- 对所有 $i \in \mathcal{I}_t$,按式 (14) 分配 $s_{i,\text{sem}}^{(t)}$。
- 发布 $C^{(t)}$ 与 $(\text{SID1}, \text{SID2}) = (s_{i,\text{sem}}^{(t)}, g(m_i))$。
码本级离线评测框架¶
训练下游生成式推荐器仍然是推荐质量的最终裁判,但对每个中间候选码本都这么做太贵。作者因此先用一组离线指标评估码本。记第 $t$ 天的评估物品集为 $\mathcal{E}_t$,$N_t = |\mathcal{E}_t|$。
表示质量:归一化 embedding 与其重构之间的余弦相似度均值
$$R_{\text{rec}} = \frac{1}{N_t} \sum_{i \in \mathcal{E}_t} \cos\left( x_i, \hat{x}_i \right) \tag{15}$$
$\hat{x}_i$ 对本文方案是所选语义中心,对残差量化基线则是所选各级语义中心之和。除均值外还报告物品级重构相似度的 10 分位(P10)与中位数,用于刻画下尾与中心趋势。
利用率与簇负载:对词表规模 $K_\ell$ 的语义层 $\ell$,令 $q_i^{(\ell)}$ 为分配给物品 $i$ 的码,则
$$U_\ell = \frac{\left| \{ q_i^{(\ell)} : i \in \mathcal{E}_t \} \right|}{K_\ell} \tag{16}$$
令 $\sigma_i$ 表示物品 $i$ 的完整语义组(本文方案为单个语义码,残差量化基线为语义码元组),对每个被占用的组 $k$:
$$n_k = \sum_{i \in \mathcal{E}_t} \mathbb{I}(\sigma_i = k) \tag{17}$$
$\{n_k\}$ 的 95 分位与最大值刻画拥挤的语义组,变异系数(CV)度量整体负载不均衡,CV 越小越均匀。数据集若带有意义的内容类型标注,还会报告簇内类型构成。
Full-SID 碰撞:令 $G_z$ 是被分到完整 SID $z = (s_{\text{sem}}, s_{\text{dis}})$ 的不同物品集合,$Z$ 为被占用的 SID 集合,同时报告"发生碰撞的 SID 占比"与"卷入碰撞的物品占比":
$$R_{\text{SID}} = \frac{\sum_{z \in Z} \mathbb{I}(|G_z| > 1)}{|Z|},\qquad R_{\text{item}} = \frac{\sum_{z \in Z} |G_z|\, \mathbb{I}(|G_z| > 1)}{N_t} \tag{18}$$
时间稳定性:为了把"码本变化"与"特征变化"分离,用新旧码本编码同一天的 embedding,记语义码为 $q_i^{\text{old}}$ 与 $q_i^{\text{new}}$,物品级与曝光加权的变更率为
$$R_{\text{chg}} = \frac{1}{N_t}\sum_{i \in \mathcal{E}_t} \mathbb{I}(q_i^{\text{old}} \neq q_i^{\text{new}}),\qquad R_{\text{chg}}^{\text{PV}} = \frac{\sum_{i \in \mathcal{E}_t} p_i^{(t)} \mathbb{I}(q_i^{\text{old}} \neq q_i^{\text{new}})}{\sum_{i \in \mathcal{E}_t} p_i^{(t)}} \tag{19}$$
推理成本推导(Appendix A)¶
作者把一次乘加算作两次浮点运算,故 $A \in \mathbb{R}^{m\times k}$ 乘 $B \in \mathbb{R}^{k\times n}$ 约需
$$F_{\text{matmul}}(m,k,n) = 2mkn \tag{20}$$
设 $L$ 为解码层数、$d$ 为模型宽度、$h$ 为 FFN 宽度、$N$ 为 cross-attention 上下文长度;第 $j$ 步解码进入解码器的 beam 数为 $b_j$、输出词表规模为 $V_j$。cross-attention 的 K/V 每层只投影一次并缓存,共享成本为
$$F_{\text{cross-KV}} = 4LNd^2 \tag{21}$$
单步成本(含 cross-attention 的 Q/O 投影 $4b_jLd^2$、对缓存上下文的注意力 $4b_jLNd$、SwiGLU FFN $6b_jLdh$;自注意力 KV 缓存下只投影当前 token 的 QKVO $8b_jLd^2$、对前缀的注意力 $4b_jLjd$、第二个 FFN $6b_jLdh$;以及词表投影 $2b_jdV_j$)为
$$C_j = b_j L \left[ 12d^2 + 12dh + 4d(N+j) \right] + 2 b_j d V_j \tag{22}$$
对含 $q$ 个生成 token 的 SID,解码核心成本为
$$F_q = F_{\text{cross-KV}} + \sum_{j=1}^{q} C_j \tag{23}$$
去掉最后一个自回归层级后变为 $F_{q-1} = F_{\text{cross-KV}} + \sum_{j=1}^{q-1} C_j'$,其中 $C_j'$ 使用缩短 SID 的 beam 数与词表规模;报告的降幅为 $1 - F_{q-1}/F_q$,两种 SID 结构共享的计算被同时排除。KV cache 搬运单独报告(因为访存不是浮点运算):设每个缓存元素 $\rho$ 字节,cross-attention 缓存占 $2\rho LNd$ 字节,beam search 全过程的逻辑读取为
$$T_{\text{cross},q} = 2\rho L N d \sum_{j=1}^{q} b_j \tag{24}$$
自注意力缓存读取按 $2\rho L d \sum_j b_j j$ 增长;beam 选择后的 cache gather 还有依实现而定的额外访存。作者明确说明这些是逻辑访问量而非实测设备显存事务。
实验设置¶
数据集:Amazon Reviews 2014 (Beauty) 与 KuaiRec 2.0 Big Matrix。
| 数据集 | 用户 | 物品 | 交互 | 时间覆盖 |
|---|---|---|---|---|
| Amazon Beauty (5-core) | 22,363 | 12,101 | 198,502 | 1996-05 – 2014-07 |
| KuaiRec 2.0 Big Matrix | 7,176 | 10,728 | 12,530,806 | 28 个观测日 |
Amazon Beauty 用于受控的 S3–S2 静态对比;KuaiRec 提供稠密带时间戳的观看日志,既支持与曝光加权 S2(PV-S2)的静态对比,也支持独立的静态 vs 动态 PV-S2 固定日期对比。
预处理与评估:按用户时间排序;KuaiRec 保留 watch_ratio ≥ 1.0 且用户保留事件数 ≥ 5 的观看事件。Amazon 与第一组 KuaiRec 对比用 leave-two-out(最后一次交互测试、倒数第二次验证、其余训练);所有 KuaiRec 观看事件定义 leave-two-out PV-S2 基线所用的 PV 权重。由于用户的最后一次交互落在不同日历日,leave-two-out 无法在"码本更新"与"评估"之间提供统一的时间边界,因此第二组 KuaiRec 对比改用不相交的固定日期评估,两组结果分开报告。
码本尺寸:两个数据集上 S3 均为 $[256,256,256]$;S2 / PV-S2 / Dynamic PV-S2 均为 $[1024,512]$,最后一级是均衡消歧码。PV 加权与动态更新只改变语义码本的拟合方式,不改变其维度。
推荐模型:主推 OneRec-V1 与 OneRec-V2 的公开数据适配版,另报告 TIGER、RPG、SEATER、COBRA——覆盖自回归、并行、树约束、稀疏-稠密级联四类生成式推荐。OneRec 在 0.1B–0.7B 七个名义规模上评估(V1 全部使用 24 个专家、每 token 激活 2 个;V2 为 dense/GQA 结构,KV heads 固定 4)。公开数据适配版排除了生产专有特征与偏好对齐阶段。每组配对对比内,数据划分、推荐器架构、优化设置与种子全部固定,只改 SID 这一件事。
指标与重复实验:Recall@K、NDCG@K($K \in \{5,10\}$)。主结果对每个配对码本变体使用相同的三个种子 $\{7, 42, 2024\}$,报告均值与样本标准差。
主要实验结果¶
Amazon Beauty 上的静态两级 vs 三级 SID¶
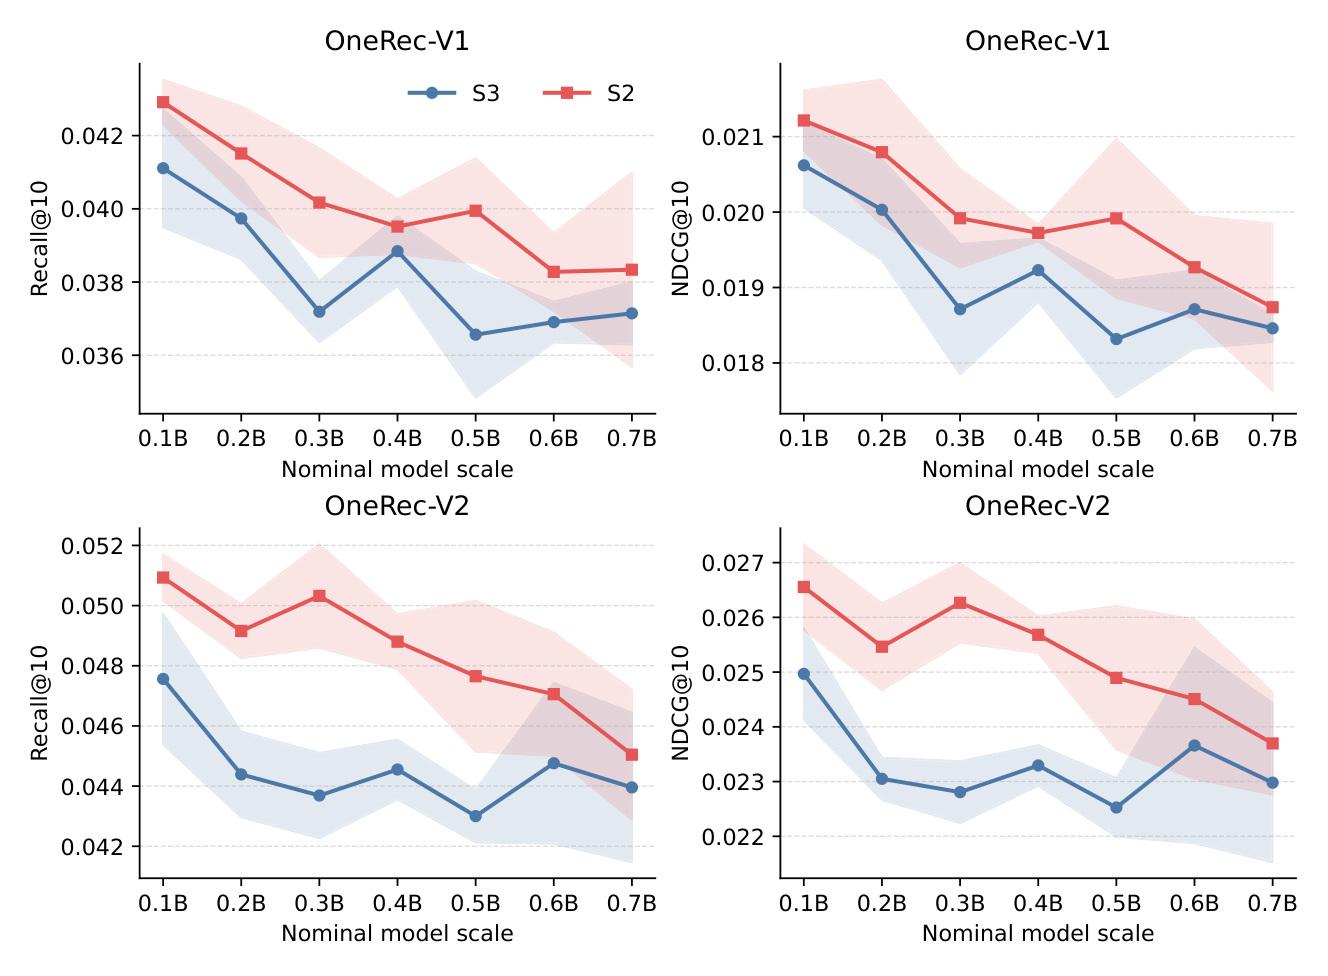
跨全部七个模型规模,S2 相对 S3 把 OneRec-V1 的平均 Recall@10 提升 5.0%、OneRec-V2 提升 8.7%;对应的平均 NDCG@10 增益为 4.1% 与 8.5%。在 Recall@10 上,S2 在每一个评估规模上都优于 S3。
| 模型 | SID | Recall@5 | Recall@10 | NDCG@5 | NDCG@10 |
|---|---|---|---|---|---|
| TIGER | S3 | 0.0369 ± 0.0078 | 0.0520 ± 0.0136 | 0.0253 ± 0.0051 | 0.0302 ± 0.0070 |
| TIGER | S2 | 0.0328 ± 0.0009 | 0.0463 ± 0.0008 | 0.0230 ± 0.0010 | 0.0273 ± 0.0010 |
| SEATER | S3 | 0.0380 ± 0.0014 | 0.0562 ± 0.0014 | 0.0256 ± 0.0009 | 0.0314 ± 0.0010 |
| SEATER | S2 | 0.0385 ± 0.0002 | 0.0584 ± 0.0008 | 0.0258 ± 0.0005 | 0.0323 ± 0.0006 |
| RPG | S3 | 0.0402 ± 0.0004 | 0.0569 ± 0.0008 | 0.0284 ± 0.0003 | 0.0337 ± 0.0005 |
| RPG | S2 | 0.0441 ± 0.0009 | 0.0646 ± 0.0006 | 0.0310 ± 0.0007 | 0.0375 ± 0.0006 |
| COBRA | S3 | 0.0062 ± 0.0003 | 0.0102 ± 0.0001 | 0.0040 ± 0.0001 | 0.0053 ± 0.0000 |
| COBRA | S2 | 0.0103 ± 0.0013 | 0.0159 ± 0.0014 | 0.0069 ± 0.0010 | 0.0086 ± 0.0010 |
OneRec 0.1B(最佳规模)的精确值:V1 S3 → S2 为 Recall@10 0.0411 → 0.0429、NDCG@10 0.0206 → 0.0212;V2 S3 → S2 为 Recall@10 0.0476 → 0.0509、NDCG@10 0.0250 → 0.0266。
结论分析:S2 对 SEATER、RPG、COBRA 都提升了 Recall@10,唯独 TIGER 用 S3 更好(0.0520 vs 0.0463)——作者如实地把这个反例写了出来。这说明"去掉一级语义码通常保持或改善推荐质量,但结果依赖于模型"。值得注意的是 TIGER 的 S3 结果方差极大(±0.0136,相对标准差约 26%),这个反例本身的置信度并不高。COBRA 在 Beauty 上整体量级远低于其他模型(Recall@10 仅 0.01 量级),提示它的公开数据适配版在这个数据集上未被充分调优。
KuaiRec 上的静态对比(leave-two-out)¶
先看离线码本质量(表 3):
| 指标 | S3 | S2 | PV-S2 |
|---|---|---|---|
| 平均重构余弦相似度 | 0.9958 | 0.9962 | 0.9939 |
| 重构 P10 / 中位数 | 0.9879 / 0.9991 | 0.9879 / 0.9996 | 0.9823 / 0.9995 |
| 语义码利用率 | L1: 100.00%,L2: 100.00% | L1: 97.56% | L1: 94.92% |
| 语义组负载 P95 / 最大 / CV | 9.0 / 256 / 3.1685 | 26.1 / 376 / 1.9938 | 34.4 / 248 / 1.6390 |
结论分析:S2 用一个语义中心就取得了比 S3 两级语义中心之和更高的平均重构相似度(0.9962 vs 0.9958),直接证明了"宽度换深度"在表示质量上不吃亏;所有语义层利用率都 ≥ 94.92%,说明 1024 的大码本没有坍缩。PV-S2 的重构相似度反而最低(0.9939)——这是预期内的取舍:曝光加权把容量倾斜给高曝光物品,牺牲了全体物品的平均重构;它换来的是负载均衡的显著改善(最大组负载 376 → 248,CV 1.9938 → 1.6390)。S3 的语义组负载 CV 最高(3.1685),因为两级笛卡尔组合的层次空间本就条件稀疏。
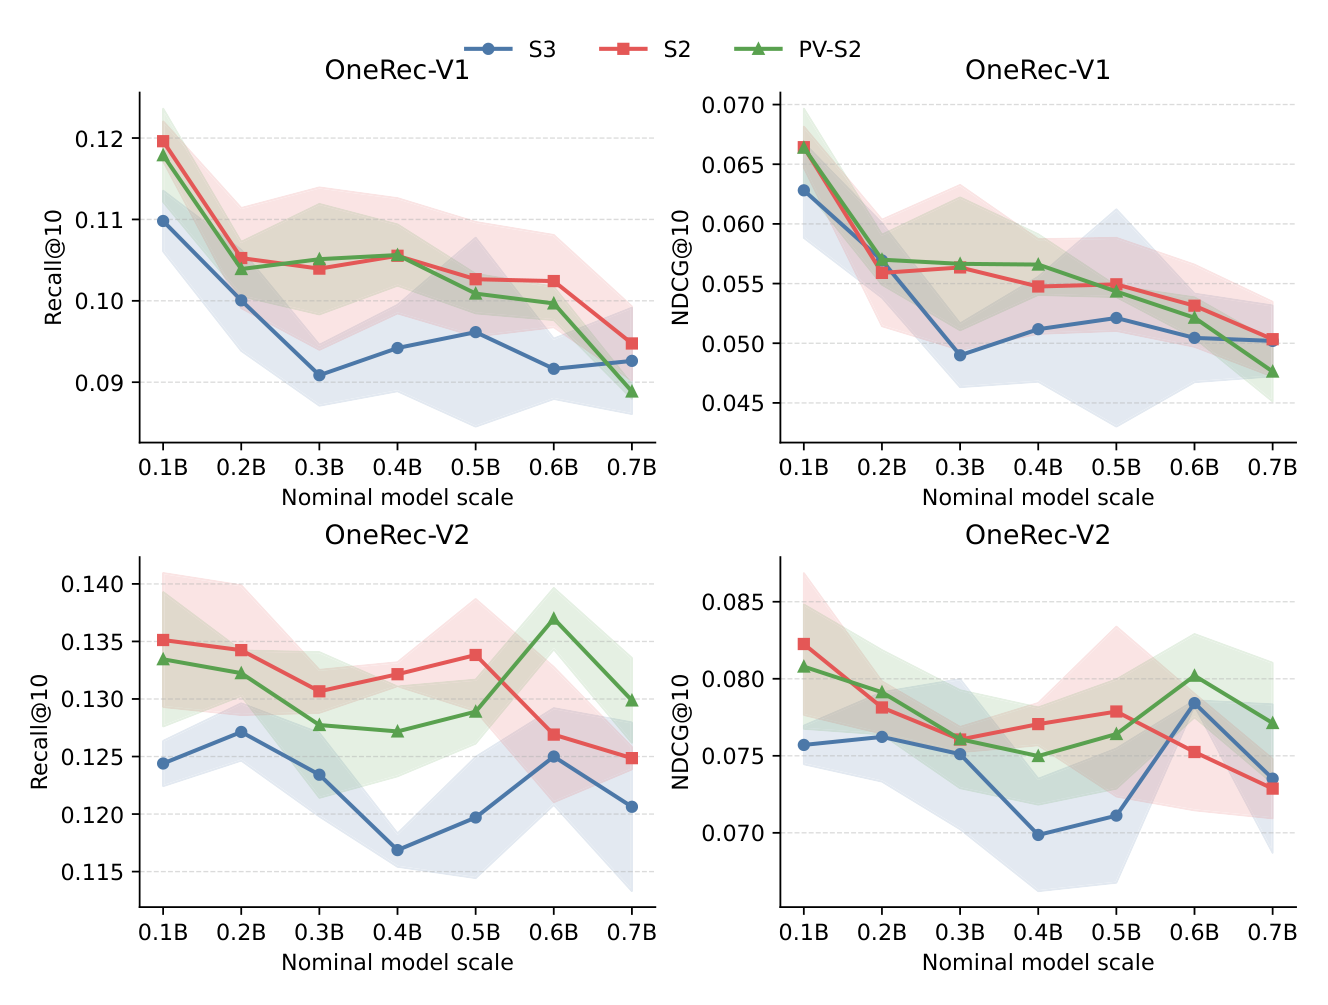
对 OneRec-V1,在七个模型规模上平均,S2 与 PV-S2 相对 S3 的 Recall@10 增益分别为 8.8% 与 7.0%,NDCG@10 为 5.1% 与 4.8%;对 OneRec-V2,Recall@10 增益为 7.1% 与 6.9%,NDCG@10 为 3.8% 与 4.8%。OneRec 0.1B 精确值:V1 的 Recall@10 从 S3 的 0.1098 提升到 S2 的 0.1196 / PV-S2 的 0.1179;V2 从 0.1244 提升到 0.1351 / 0.1335。
| 模型 | SID | Recall@5 | Recall@10 | NDCG@5 | NDCG@10 |
|---|---|---|---|---|---|
| TIGER | S3 | 0.1057 ± 0.0032 | 0.1429 ± 0.0019 | 0.0740 ± 0.0010 | 0.0860 ± 0.0006 |
| TIGER | S2 | 0.1094 ± 0.0022 | 0.1483 ± 0.0012 | 0.0761 ± 0.0027 | 0.0886 ± 0.0023 |
| TIGER | PV-S2 | 0.1087 ± 0.0028 | 0.1492 ± 0.0024 | 0.0742 ± 0.0030 | 0.0873 ± 0.0028 |
| SEATER | S3 | 0.1032 ± 0.0019 | 0.1374 ± 0.0007 | 0.0697 ± 0.0028 | 0.0808 ± 0.0022 |
| SEATER | S2 | 0.1077 ± 0.0018 | 0.1473 ± 0.0040 | 0.0729 ± 0.0019 | 0.0858 ± 0.0002 |
| SEATER | PV-S2 | 0.1069 ± 0.0022 | 0.1478 ± 0.0028 | 0.0717 ± 0.0022 | 0.0849 ± 0.0024 |
| RPG | S3 | 0.0060 ± 0.0004 | 0.0082 ± 0.0010 | 0.0046 ± 0.0003 | 0.0053 ± 0.0003 |
| RPG | S2 | 0.0060 ± 0.0004 | 0.0110 ± 0.0020 | 0.0037 ± 0.0002 | 0.0053 ± 0.0006 |
| RPG | PV-S2 | 0.0109 ± 0.0014 | 0.0172 ± 0.0017 | 0.0066 ± 0.0005 | 0.0087 ± 0.0008 |
| COBRA | S3 | 0.0998 ± 0.0008 | 0.1367 ± 0.0011 | 0.0693 ± 0.0008 | 0.0812 ± 0.0005 |
| COBRA | S2 | 0.1088 ± 0.0010 | 0.1484 ± 0.0034 | 0.0754 ± 0.0003 | 0.0881 ± 0.0009 |
| COBRA | PV-S2 | 0.1075 ± 0.0037 | 0.1486 ± 0.0030 | 0.0749 ± 0.0016 | 0.0882 ± 0.0014 |
结论分析:与 Amazon 不同,KuaiRec 上两个两级变体对表中每一个非 OneRec 模型都提升了 Recall@10,包括在 Amazon 上偏好 S3 的 TIGER。这说明"S3 更好"并非 TIGER 的固有属性,而与数据集特性有关(KuaiRec 交互稠密得多,12.5M vs 198K)。但 S2 与 PV-S2 谁都不是一致最优:曝光加权在 TIGER、SEATER、RPG、COBRA 上给出最好的 Recall@10,而在 OneRec 上偏好哪个变体随规模与指标而变。RPG 在 KuaiRec 上整体崩掉(Recall@10 仅 0.008–0.017 量级),与其在 Amazon 上表现最好形成强烈反差,说明其并行 SID + graph-guided decoding 对 SID 结构和数据集非常敏感。
固定日期的静态-动态对比¶
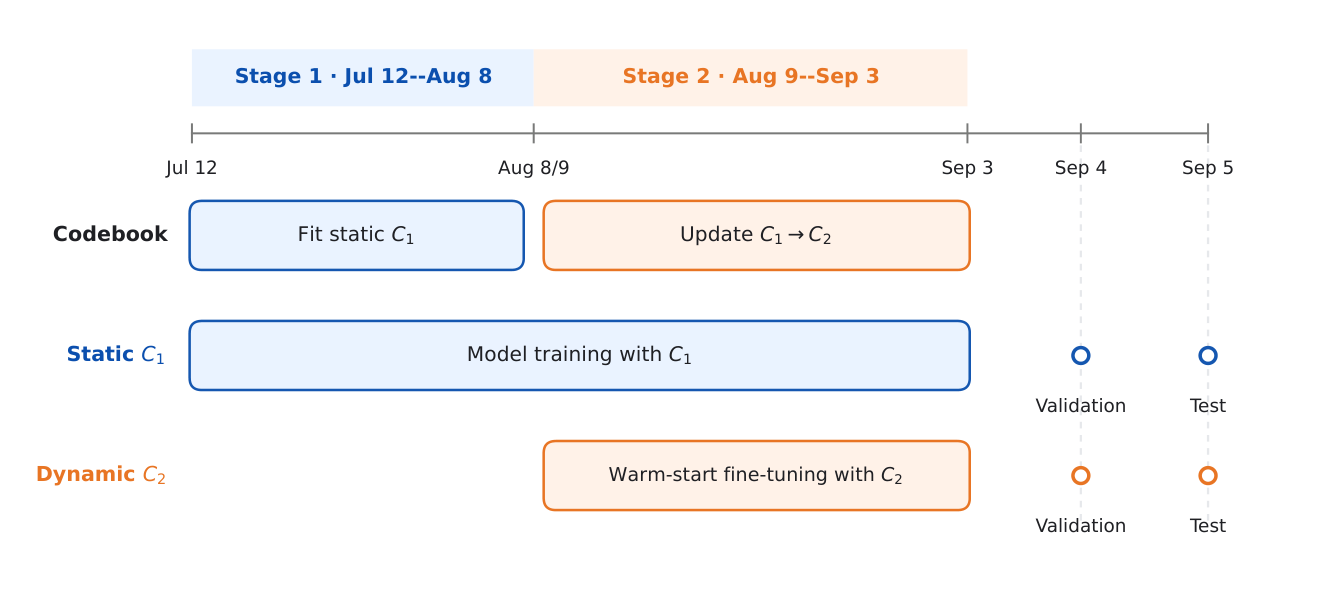
设置:静态组用 C1 在 7 月 12 日 – 9 月 3 日的目标上训练;动态组用 8 月 9 日 – 9 月 3 日的流量把 C1 更新为 C2,然后从匹配的静态 checkpoint 热启动、在同一时间段上用 C2 编码的目标微调。两组都在 9 月 4 日验证、9 月 5 日测试,且验证与测试日被排除在码本拟合之外。这个设计把"码本差异"与"训练数据/初始化差异"尽可能分离开。
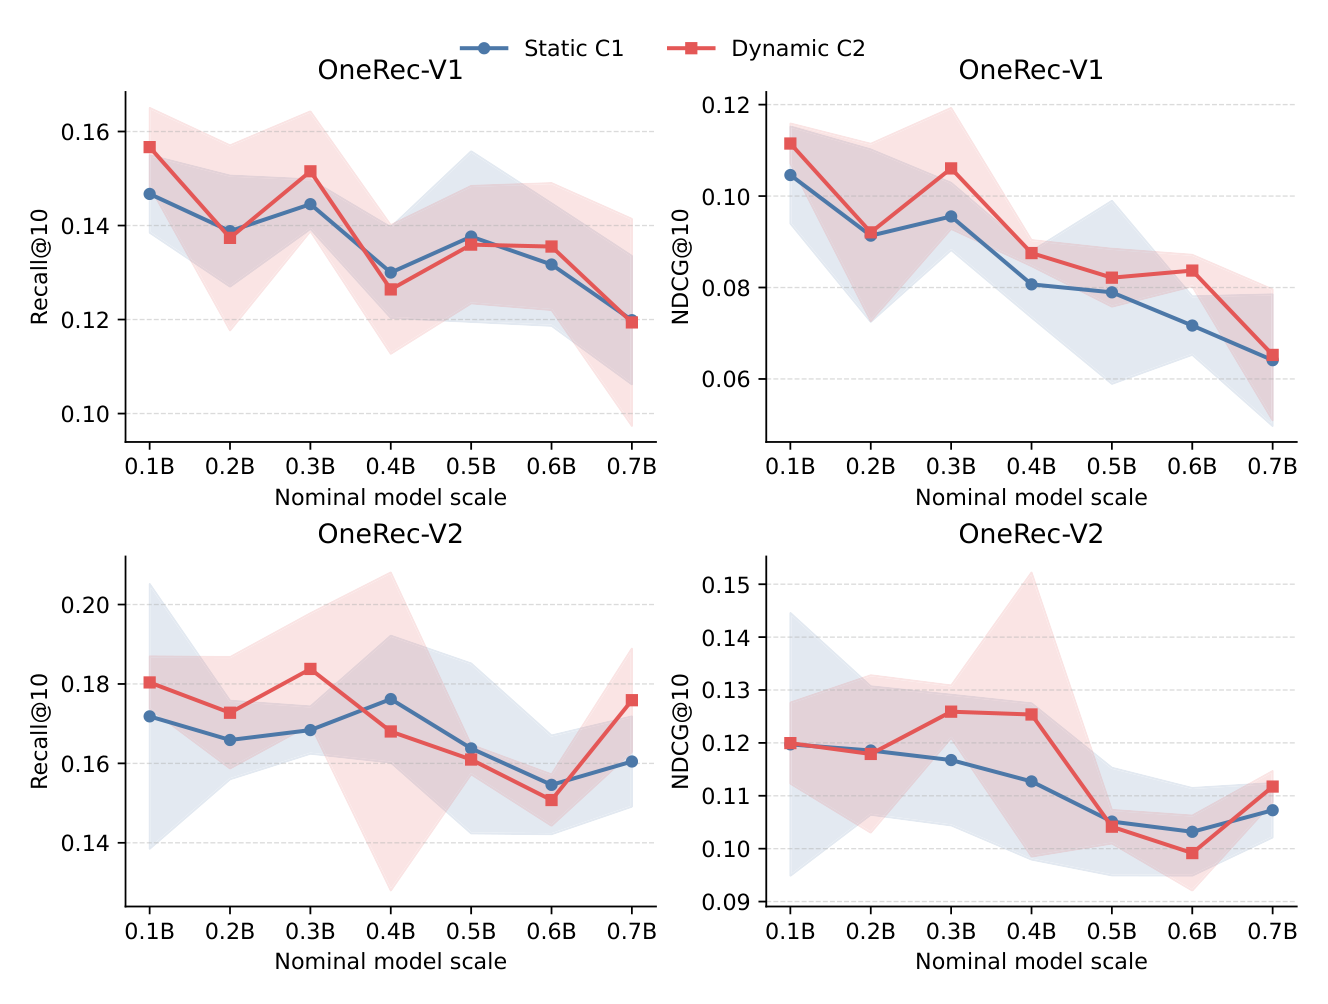
跨模型规模平均,Dynamic C2 相对 Static C1 把 OneRec-V1 的 Recall@10 提升 1.4%、NDCG@10 提升 7.0%;OneRec-V2 对应为 2.7% 与 2.7%。SEATER 的平均 Recall@10 提升 5.7%,RPG 提升 2.8%。
| 模型 | 码本 | Recall@5 | Recall@10 | NDCG@5 | NDCG@10 |
|---|---|---|---|---|---|
| TIGER | Static C1 | 0.0075 ± 0.0025 | 0.0092 ± 0.0011 | 0.0048 ± 0.0009 | 0.0053 ± 0.0004 |
| TIGER | Dynamic C2 | 0.0496 ± 0.0775 | 0.0532 ± 0.0812 | 0.0372 ± 0.0584 | 0.0383 ± 0.0596 |
| SEATER | Static C1 | 0.1484 ± 0.0014 | 0.1788 ± 0.0033 | 0.1161 ± 0.0034 | 0.1260 ± 0.0031 |
| SEATER | Dynamic C2 | 0.1570 ± 0.0106 | 0.1890 ± 0.0090 | 0.1215 ± 0.0066 | 0.1331 ± 0.0068 |
| RPG | Static C1 | 0.0356 ± 0.0238 | 0.0669 ± 0.0312 | 0.0206 ± 0.0151 | 0.0307 ± 0.0164 |
| RPG | Dynamic C2 | 0.0465 ± 0.0136 | 0.0688 ± 0.0105 | 0.0335 ± 0.0073 | 0.0392 ± 0.0073 |
| COBRA | Static C1 | 0.0704 ± 0.0086 | 0.1116 ± 0.0103 | 0.0402 ± 0.0072 | 0.0551 ± 0.0050 |
| COBRA | Dynamic C2 | 0.0892 ± 0.0061 | 0.1242 ± 0.0037 | 0.0558 ± 0.0030 | 0.0651 ± 0.0027 |
结论分析:TIGER 那一行必须谨慎解读——Dynamic C2 的 Recall@10 是 0.0532 ± 0.0812,标准差比均值还大,说明三个种子里大概率只有一个种子跑出了高分,这条"提升"不可信。相比之下 SEATER 与 COBRA 的提升幅度虽小但方差可控,是本组里最扎实的证据。作者也承认"并非每个 OneRec 规模上都有增益,但两个 OneRec 变体、SEATER、RPG 的聚合结果都是正的"。
稳定性度量:相对 C1,C2 只改变了 10,728 个物品中 46 个的 SID1,物品级变更率 0.4288%;在第二阶段活跃的物品中为 0.6418%,按第二阶段 PV 加权为 0.4383%。中心位移的均值与最大值分别为 0.004054 与 0.050005。这组数字是全文最有说服力的一处:更新确实调整了语义划分,但把下游监督目标的扰动控制在了千分之四量级,正是式 (14) 的换码惩罚在起作用。反过来看,0.43% 的换码率也意味着这次更新的"塑性"相当保守。
工业码本评测¶
在连续七天的日快照上评测工业码本。对 S2,重构用其单个语义中心;对 S3,同时报告"仅第一语义层"与"两级残差语义层累积"的重构。
| 码本表示 | Day 1 | Day 7 | 变化 |
|---|---|---|---|
| Static S3,仅第一语义层 | 0.758357 | 0.754451 | −0.003906 |
| Static S3,两级语义层 | 0.802241 | 0.798868 | −0.003373 |
| Static S2 | 0.805676 | 0.800899 | −0.004777 |
| Static PV-S2 | 0.821336 | 0.814508 | −0.006828 |
| Dynamic PV-S2 | 0.821336 | 0.826723 | +0.005387 |
结论分析:这张表把两个论点一次性讲清楚了。第一,Static S2 单个语义中心(0.805676)就超过了 Static S3 两级语义中心之和(0.802241)——工业数据上同样验证了"宽度换深度"不损失表示质量。第二,所有静态码本在七天内都在退化(−0.0034 至 −0.0068),且 PV-S2 退化最快(曝光加权码本对流量分布最敏感,流量一变它掉得最厉害);而 Dynamic PV-S2 从同一初始值出发,第 7 天升到 0.826723 而不是掉下去,相对 Static PV-S2 的 0.814508 提升 1.50%。这正面证实了"码本漂移是真实存在的、且动态更新能把它反转过来"。注意工业侧重构相似度(0.80 量级)远低于 KuaiRec(0.99 量级),说明真实物料 embedding 的分布比公开数据难拟合得多。
线上与服务评测¶
- 线上 A/B:两级 SID 系统对阵已部署的三级 SID 基线,5 天、2.5% 生产流量,主消费指标 +0.792%。
- 服务成本:跨 decoder、LazyAR、MTP 三种服务架构,估计的自回归解码 FLOPs 下降 47.93%–48.70%;单卡 QPS 提升 decoder +47.0%、LazyAR +28.57%、MTP +33.3%。该估计包含一次性的 cross-attention K/V 投影、beam 展开后的解码计算与词表投影。
结论分析:解码步数从 3 降到 2 只砍掉 1/3 的步数,却带来近 48% 的 FLOPs 下降——原因在式 (22):被砍掉的是最后一步,而 beam search 的 beam 数 $b_j$ 随步数递增,最后一步的 $b_j$ 最大,同时它的词表投影 $2b_jdV_j$ 也是最大的一项。换言之,砍掉的是最贵的那一步。但 QPS 只涨了 28.57%–47.0%,明显低于 FLOPs 降幅,说明实际服务瓶颈里访存(KV cache 搬运、beam 选择后的 cache gather)占了相当比重——作者也确实把访存单列出来、并声明是逻辑访问量而非实测。
核心贡献总结¶
- 用一次工业统计把"多级残差 SID"的结构性浪费量化了:全局 SID2 利用率 93.31%,但每个活跃 SID1 之下条件利用率只有 2.48%——大而稀疏的层次空间要付出一整步串行解码的代价。
- 单层大语义码本 + 确定性消歧码:把语义容量沿宽度堆($[1024,512]$ 替代 $[256,256,256]$),语义只占一个 token,消歧码由稳定物品键的哈希确定、跨码本版本不变、不参与语义重构。自回归预测从 3 步降到 2 步,且从源头消除了跨层非法组合。
- 曝光感知的动态码本:对数压缩曝光权重 + 时间衰减 + 稳定性锚点 + EMA 中心更新 + 曝光加权换码惩罚,实测在提升重构质量的同时只改动 0.43% 物品的 SID1。
- 码本级离线评测框架:重构质量、码利用率、簇负载(P95/最大/CV)、full-SID 碰撞、时间稳定性五个维度,让候选码本在"重 tokenize + 重训推荐器"之前就能被筛选。
- 完整的工业闭环:1.5B 样本诊断 → 公开集配对实验(3 种子、七个规模、四类推荐器)→ 工业七日码本快照 → 三种服务架构的 FLOPs/QPS → 5 天 2.5% 流量线上 A/B。
与已归档相关工作的对比¶
DACT DACT: Drift-Aware Continual Tokenization for Generative Recommendation (Fudan University, 2026-03-31)¶
关系:独立并发(本文未引用 DACT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文对准的是同一个 root cause——物品的语义/协同表示随时间漂移,静态 tokenizer 会失配;但天真地重拟合 tokenizer 会把大量物品的离散码一次性改掉,从而摧毁下游生成模型已经学到的 token-embedding 对齐。DACT 把它称为 plasticity-stability 权衡(朴素微调会导致 >90% 已有物品 token 序列变化),本文称为 codebook drift 与"突然重分配高曝光物品会一次性改掉大量离散监督目标、破坏梯度更新"。两者都明确指出:问题不是"要不要更新",而是"如何只更新该更新的那部分"。
- 相近的技术骨架:两者的方法流程图可以抽象重合成同一张——(i)用上一版码本/tokenizer 的分配作为参考锚;(ii)判定哪些物品应该换码;(iii)对不该换的施加显式稳定性约束;(iv)发布新码并让下游模型热启动微调。DACT 的 (ii) 用一个可学习的协同漂移识别模块 CDIM 输出漂移置信度 $d_i$、取 top-K 为漂移集,(iii) 对稳定集加锚定正则 $\lVert r_i^p - r_i^{p-1}\rVert^2$ 与首层分配分布的 KL 正则;本文的 (ii)(iii) 合并成了式 (14) 那一个带惩罚的 argmin——$\lambda w_i^{(t)} \mathbb{I}(k \neq s_{i,\text{ref}}^{(t-1)})$ 直接把"换码"标价,价格与曝光成正比。
- 本文的差异与推进:DACT 的漂移判定是学出来的(需要 CF embedding、模式记忆 slot、与 tokenizer 联合端到端训练),本文的是算出来的(曝光权重 + 距离阈值,纯 k-means 侧的闭式规则,无需任何训练)。这带来两点:本文的方案能每天在工业物料池上跑一遍而几乎无成本,DACT 则要按 period 重训 tokenizer;反过来,DACT 的稳定性判据用的是协同信号(共现模式变化),本文用的是曝光量——曝光高不等于协同模式没变,这是本文的一个盲点。另一个结构差异:DACT 仍然在多级 RQ-VAE 上做文章,甚至专门设计了"第一层主动适应、深层仅在第一层变化时才重分配"的分层重分配策略;本文直接把语义层级砍到只剩一层,这个分层稳定性问题就不存在了——单层码本天然没有"深层残差被浅层变化连带打乱"的问题。可以说本文的结构简化顺手消解了 DACT 一半的设计复杂度。
- 可比的方法/实验差异:两者都无法直接比数字(DACT 在 Amazon-Beauty/Toys 上以 TIGER/LCRec 为骨干做持续学习 period 评测,报告 HR@10 0.0575→0.0609 等;本文在 KuaiRec 上做固定日期评估,报告 Recall@10 +1.4%/+2.7%)。但有一个可比的稳定性数字很说明问题:DACT 抱怨朴素微调会改掉 >90% 物品的 token,本文的更新只改了 0.4288%。这个三个数量级的差距既体现了曝光加权惩罚的力度,也暴露了本文更新可能过于保守——DACT 每个 period 显式选 top-K 比例的物品做自由适应,本文则没有任何机制保证"该换的一定换到"。
CRID CRID: Beyond Semantic IDs — Encoding Business-Value Ranking into Document Identifiers (Taobao & Tmall Group of Alibaba, 2026-07-13)¶
关系:独立并发(本文未引用 CRID,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在质疑"多级 SID 的每一级都必须做语义量化"这个默认假设。CRID 指出层次化 DocID 中"靠前的码本层决定语义召回,靠后的层只是在召回集内做细粒度消歧",而把最后一级也交给语义量化会带来碰撞(事后补丁如随机 ID、Sinkhorn 平衡都只是 post-hoc remedy)并与业务目标错位;本文的工业统计给出了同一诊断的另一个侧面——第二级语义码的条件利用率只有 2.48%,它撑起的层次空间大部分是空的。两者的 root cause 都是:多级 SID 中靠后的语义层级性价比极低,应该被替换掉,而不是被优化。
- 相近的技术骨架:抽象后是同一个配方——保留前面的语义层做粗粒度聚类,把最后一级换成一个确定性的、非语义的分配规则。CRID 的最后一级是簇内按业务价值(转化率)排序得到的序数 rank;本文的最后一级是对稳定物品键 $m_i$ 的稳定哈希 $g(m_i)$。两者都强调这一构造从设计上消除/降低碰撞,且支持增量更新而不必重训码本:CRID 靠受影响簇内重排、本文靠"SID2 跨码本版本恒定不变"。
- 本文的差异与推进:分歧在于"最后一级该编码什么"。CRID 认为应该编码业务价值先验(同一语义簇内转化率可能差几个数量级,纯语义量化给它们相邻甚至相同的 DocID),并给出把检索增益分解为个性化偏好与统计先验的分析框架;本文认为最后一级应该什么都不编码——纯粹是个哈希消歧位,明确声明"不参与语义重构"。两条路各有代价:CRID 的 rank 码把业务信号灌进标识符,但业务价值会随时间变化,需要持续重排;本文的哈希码永远不变,是动态更新方案里那块"不动的地基",但也彻底放弃了在这一位上承载任何信息。另一个正交差异:CRID 保留了两级语义前缀(8192×8192),本文把语义压到一级——本文在"减少语义层数"这条轴上走得更远,CRID 在"重定义最后一级语义"这条轴上走得更远。
- 可比的方法/实验差异:CRID 在 300M 物品的淘宝搜索语料上报告 HR@20 37.28%→41.20%、全流量部署 +1.06% GMV;本文在快手推荐场景报告 5 天 2.5% 流量 A/B 主消费指标 +0.792%。CRID 的收益被归因到 3-gram full-path 层(即最后一级从语义量化切换为业务排序),本文的收益则同时来自表示质量(工业重构 0.802→0.806)与解码成本(FLOPs −48%)——这是一个有意思的对照:同样是动最后一级,一个换来了效果,一个换来了效率。
DRQ DRQ: Decoupled Residual Quantization for Robust Semantic IDs (Shopee, 2026-06-01)¶
关系:显式引用但原文未展开对比(仅在 §2.4「Codebook quality metrics」引用其诊断框架,无方法或指标层面的实验对照)· 已加载对方精读
- 共同关注的问题:两篇都认为残差量化这个结构本身是 SID 质量的瓶颈,而不是需要在其内部微调的对象,并且都认为推荐界把 tokenizer 当黑盒、只看下游 Recall/NDCG 的评测习惯是问题的一部分。DRQ 明确批评"这些系统通常把 tokenizer 当黑盒,不直接测量 tokenizer 的几何与码使用如何影响鲁棒性";本文的动机段几乎是同一句话的工程版——"直接用完整推荐链路验证新码本太贵,反馈环太长,使得线上试错不适合快速码本开发"。
- 相近的技术骨架:两者都先建一套码本级诊断指标、再用它来筛方案,而不是直接跑下游。DRQ 定义 Expected Overlap Rate $O_\pi = \sum_{i,j}\pi_i\pi_j\exp(-\lVert c_i - c_j\rVert^2/4\sigma^2)$ 与 Effective Codebook Size $K_{\text{eff}} = 1/O_\pi$,把 SID 退化分解为 Distribution Penalty 与 Geometry Penalty;本文定义重构相似度(均值/P10/中位数)、利用率 $U_\ell$、簇负载 P95/最大/CV、full-SID 碰撞率 $R_{\text{SID}}/R_{\text{item}}$、时间变更率 $R_{\text{chg}}/R_{\text{chg}}^{\text{PV}}$。两套指标高度互补:DRQ 的 $\pi_i$(码字先验使用概率)在数学上就是本文簇负载分布的归一化版本,而 DRQ 的几何惩罚(弯曲流形被平坦欧氏格子强压)恰好解释了本文"S2 单中心重构优于 S3 双中心之和"这个乍看反直觉的结果——多级残差的 Minkowski-sum 码本会把大量码字组合放在"没有真实物品居住"的区域。
- 本文的差异与推进:DRQ 的解法是保留残差层级但解耦训练(先无 STE 的 VAE 连续重塑,再事后层次 K-Means 做离散分布匹配);本文的解法是直接删掉残差层级(单层大码本 + 加权 k-means)。有意思的是两者都放弃了 RQ-VAE 的联合 STE 训练、都转向 k-means 式的显式聚类——在"神经量化器 vs 显式聚类"这个选择上两篇工业论文做了相同的判断。差异在于 DRQ 认为多级残差的 coarse-to-fine 层次对语义有用因而值得保留(它明确说选 RQ-VAE 而非 PQ 就是为了这个层次),本文则用条件利用率 2.48% 的统计直接否定了第二级的价值。此外 DRQ 有一个本文缺失的维度:扰动鲁棒性——检索时潜向量带噪,第一级语义码上的小扰动就会把物品重定向到不同的离散邻域。本文把语义容量全压到一级 1024 大码本上,码字间距必然比 256 的小码本更近,按 DRQ 的 $O_\pi$ 公式,单层大码本的期望重叠率应该更高、$K_{\text{eff}}$ 更容易被扰动吃掉——本文完全没有评估这一点,这是一个被忽略的风险。
- 可比的方法/实验差异:DRQ 与本文的实验都在专有工业数据上(DRQ 报告 Shopee 短视频的检索保持@20 0.5561→0.9999、L2 $K_{\text{eff}}$ 1555→1822;本文报告快手七日重构 0.821336→0.826723),彼此不可直接比较。但 DRQ 的一个结论直接适用于本文:它发现"基于重构的符号容量、码本利用率、重构保真度、embedding 级检索保持、行为感知软匹配之间存在权衡,这些维度不必同向改善"——本文表 3 就是这句话的实例(PV-S2 重构最差但负载最均衡,而下游指标 S2 与 PV-S2 各有胜负)。
被剔除的近似候选(问题或解法未双同构):
- SSRLive SSRLive(Taobao,2026-06-05,本文已在 §2.3 显式引用 [15]):问题陈述高度接近("静态 SID 无法刻画实时变化的内容"),但解法路径不同构——SSRLive 是在判别式粗排里额外生成一路"动态 SID"作为特征,静态 SID 与码本本身并不更新;本文是原地更新同一个语义码本的中心与分配。前者是"加一路信号",后者是"改一套划分"。已交由 related work 与 DAG 承接。
- VarLenRec VarLenRec(ECNU,2026-05-18,早于本文):同样质疑"SID 长度固定",但 root cause 是流行度-长度悖论(头部物品要短码、长尾要长码),解法是变长残差量化 + 双曲自适应——仍在深度轴上做自适应,与本文"把深度轴压到 1"方向相反。
- CapsID CapsID(2026-05-06,早于本文):软胶囊路由替代 RQ-VAE 硬 argmax + 置信度驱动变长 SID。root cause 是硬分配的梯度与表达力问题,与本文的解码步数/码本时效无关。
- CRAB CRAB(Walmart,2026-04-06,早于本文):同样用(正则化)K-means 干预码本负载,本文的曝光加权 k-means 也确实把最大组负载从 376 压到 248、CV 从 1.9938 压到 1.6390。但 CRAB 的问题是生成式推荐的流行度偏差去偏(事后拆分过热 token),本文的问题是解码成本与码本时效,负载均衡只是副产品。问题不同构。
- QuaSID QuaSID(UESTC,2026-02-28)/ AdaSID AdaSID(UESTC,2026-04-26):两者的核心问题都是区分良性重叠与有害碰撞并据此调节斥力;本文只是保留了一个确定性哈希消歧码,碰撞不是核心矛盾,也没有任何碰撞感知的学习机制。
- ChronoID ChronoID(Rochester,2026-06-12,早于本文):同样指出"SID 是时间无关的",但解法是把时间信号沿三条正交轴注入 SID 表示(绝对/相对编码、早/晚融合),而非随流量更新码本分区。问题描述层面接近,机制层面不同构。
- RecoGEM RecoGEM(快手,2026-03-12)/ PAD-Rec PAD-Rec / DaV-Gen DaV-Gen:都在降低生成式推荐的解码成本,但路径分别是 FP8 数值量化、投机解码 draft model、draft-and-verify——都不动 SID 结构本身,与本文"缩短标识符"正交(原则上可叠加)。
- FORGE FORGE(浙大/淘宝,2025-09-25):与本文第三项贡献(码本级离线评测)有部分重叠,但 FORGE 解决的是"缺公开工业级 SID benchmark 与 recipe",本文解决的是"候选码本筛选反馈环太长",且 FORGE 无动态更新、无单层大码本主张。
讨论与局限性¶
值得借鉴的设计:
- 用条件利用率而非全局利用率去审视多级码本。全局 93.31% 的 SID2 利用率会让人以为第二级"用满了",只有算出"每个活跃 SID1 之下平均只用 2.48% 的 SID2 词表"才暴露出层次空间的条件稀疏。这个诊断视角可以直接迁移到任何多级 SID 系统的审计上。
- 把"换码"标价而不是禁止。式 (14) 把稳定性做成 argmin 里的一个可加惩罚项 $\lambda w_i^{(t)}$,价格与曝光成正比。相比"冻结高频物品"这类硬规则,这个软约束保留了"收益足够大时仍可换码"的通道,且只多一个超参。
- 把不变的那一位显式隔离出来。消歧码由稳定物品键的哈希确定、跨码本版本恒定,这让动态更新只需要考虑语义那一位——动态系统里有一块"永远不动的地基",工程上极大降低了在线更新的风险面。
- 先建码本级诊断、再谈下游指标。这是任何有码本迭代需求的工业团队都该抄的工程实践:把一次"重 tokenize + 重训推荐器"的验证成本,换成一组几分钟就能算完的离线指标。
局限与争议:
- 公开集增益的置信度不足。三个种子的样本标准差经常与效果量同量级甚至更大:TIGER 在 Amazon 上 S3 的 Recall@10 是 0.0520±0.0136;固定日期对比里 TIGER Dynamic C2 的 0.0532±0.0812 更是标准差大于均值。作者没有做任何显著性检验,所有"提升 X%"都是三种子均值之差。
- 动态更新的证据链最弱。它是三项贡献里唯一没有进入线上 A/B的:线上验证的是"两级 SID vs 三级 SID"(+0.792%),动态更新只有 KuaiRec 固定日期实验与工业七日重构相似度(+1.50%)。而重构相似度是码本自身的目标函数的一个单调函数,"动态更新让重构变好"接近同义反复,它到底能带来多少下游收益仍是开放问题。
- 换码率 0.4288% 可能过于保守。46/10,728 个物品换码,意味着这次更新几乎只是把中心挪了一点点(平均位移 0.004054)。作者没有做 $\lambda$ 的敏感性分析,我们无从知道"更激进的更新是会更好还是会崩",也没有连续多天累积更新的实验(工业侧只有 7 天重构曲线,没有对应的下游指标曲线)。
- 没有评估大码本的扰动鲁棒性。把 1024 个中心塞进同一个球面,码字间距必然小于 256 中心的码本。按 DRQ 的期望重叠率框架,检索时潜向量的噪声更容易把物品推到相邻码字——这在离线重构指标上完全看不出来,但在真实召回链路里会直接变成错召回。本文的诊断框架恰恰缺了这一维。
- "宽度换深度"的可扩展性上限。单层码本意味着语义容量只能靠加大 $K_s$ 来扩,而 softmax 输出层与 beam search 的成本随 $K_s$ 线性增长;多级残差至少提供了 $K^L$ 的组合容量。本文在 $K_s = 1024$ 的量级上论证了 2 级优于 3 级,但没有回答物料池再大一个数量级时这条路线是否还成立。更根本地,码本仍然是一个离线固化的两阶段产物——先量化、再训练下游模型,两者无法端到端联合优化,码本一旦发布就限制了下游的表征空间(这正是 DIGER、ETEGRec 这类端到端可微 tokenizer 想解决的问题,本文在 related work 里提到了但没有对比)。
- 消歧码放弃了信息承载。与 CRID 把最后一级用于编码业务价值先验相比,本文的哈希消歧码是纯粹的"占位符"。在一个已经只剩两个 token 的标识符里,把 50% 的位置用于承载零信息,看起来是个可以再优化的设计——尽管它换来了动态更新时的绝对稳定。
- FLOPs 是估算而非实测。−47.93%~−48.70% 来自 Appendix A 的符号推导,KV cache 访存被单独列出且明确声明是"逻辑访问量而非实测设备显存事务"。真正落地的是 QPS 提升(+28.57%~+47.0%),它明显低于 FLOPs 降幅——这个 gap 本身值得作者展开分析,但论文没有。
工业落地价值:这是一篇标准的"生产系统改造报告",落地细节相对完整:改造对象是快手线上已部署的三级 SID;诊断基于 1.50B 生产样本;服务侧覆盖 decoder / LazyAR(OneRec-V2 的 Lazy Decoder-Only 架构)/ MTP 三种真实解码架构;线上 5 天 2.5% 流量 A/B、主消费指标 +0.792%;码本按天更新一次并与不变的消歧规则一起发布。对于任何跑着 SID 生成式召回的团队,"先算条件利用率,再决定要不要砍一级"是一个成本极低、潜在收益极高的动作。