CRID:把"业务价值排序"编码进 DocID —— 超越纯语义 SID 的生成式检索标识符设计¶
研究动机与背景¶
生成式检索(Generative Retrieval, GR)把检索问题重新表述为一个 sequence-to-sequence 的生成任务:给每个文档/物品分配一个文档标识符(Document Identifier, DocID),检索时由一个自回归模型直接"生成"目标 DocID。因此 DocID 的设计成为决定检索质量的关键因素——它决定了海量物品被离散化进 token 空间的方式,而生成模型必须学会去产出这些 token。
现有 DocID 方案覆盖多个流派:层次化 ID(TIGER、OneRec 等)、并行 ID、以及文本词项等 surrogate 表示。其中由粗到细的层次化结构(hierarchical coarse-to-fine)与 LLM 的自回归生成过程高度契合,成为工业系统的主流选择。多数层次化方案依赖离散表示学习,如 RQ-KMeans 和 RQ-VAE,把语义 embedding 量化成离散的 semantic ID。
作者指出这类基于离散表示学习的方案存在两个层次的问题:
(1)碰撞问题(Collision)。 量化会把多个物品映射到同一个 DocID,在大规模语料下尤其严重(淘宝有数亿物品)。现有的缓解手段包括随机 ID(random IDs)和基于平衡的启发式(balancing-based heuristics,如 Sinkhorn-Knopp),但都是事后补丁(post-hoc remedies)。
(2)更根本的挑战:目标错位(Objective Mismatch)。 现有 DocID 完全由语义 embedding 构造,其编码目标(语义重构 semantic reconstruction)与系统的优化目标(业务转化 business conversion)之间存在结构性错位。作者给出一个尖锐的例子:同一个语义聚类里的两个物品,转化率可能相差几个数量级,但在纯语义量化下它们会得到相邻甚至完全相同的 DocID。在淘宝这类大规模工业场景,充分优化的 embedding-based retrieval(EBR)方法天然会通过特征丰富的训练吸收点击率、转化率等业务信号,但这些信息在当前的 DocID 里完全缺失。
这个缺口被容量-语料张力(capacity–corpus tension)放大:候选池含数亿物品,但 GR 模型受延迟约束无法任意扩容,于是每个 DocID token 的信息效率变得极其关键。作者的核心论断是:造成瓶颈的是这种目标错位,而非单纯的模型容量不足。
针对上述问题,作者提出 Cluster-Ranked Identifier (CRID):一个简单却有效的 DocID 设计,把每个标识符解耦为 语义聚类(semantic clustering) 与 业务价值排序(business-value ranking) 两部分——前者捕获粗粒度的、query 级的语义相似性;后者以簇内序数排名(ordinal rank)的形式编码统计先验。这一构造从设计上消除碰撞,并支持通过簇内重排(intra-cluster reranking)做增量更新。
论文的两点贡献:
- (1) CRID 是(据作者所知)第一个把业务价值编码为语义簇内序数排名的 DocID 方案。这个刻意保持简单的设计改动放在最后一层码本上,却比更复杂的量化技术带来更大增益,同时产出天然无碰撞、无需重训码本即可增量更新的标识符。
- (2) 提出一个分析框架,把检索增益分解为 个性化偏好(personalized preference) 与 统计先验(statistical prior) 两个成分,解释了为什么业务价值排序有效,以及语义簇大小如何调控二者之间的平衡。
在 300M 物品的淘宝电商语料上,CRID 在 top-K Hitrate 上超越所有 baseline(含最强的 EBR 系统),并在全流量部署带来 +1.06% GMV 提升。
核心方法 / 模型架构¶
问题形式化¶
给定用户 query $q$ 与历史行为序列 $\mathbf{h} = (h_1, h_2, \ldots, h_T)$,GR 把检索建模为自回归生成。每个物品被分配一个 DocID $\mathbf{c} = (c_1, c_2, \ldots, c_L)$,$L$ 为码本层数。参数为 $\theta$ 的 GR 模型自回归地生成 DocID token:
$$P_\theta(\mathbf{c} \mid q, \mathbf{h}) = \prod_{\ell=1}^{L} P_\theta(c_\ell \mid c_{<\ell}, q, \mathbf{h}) \tag{1}$$
推理时用受约束的 beam search(constrained beam search)按 $P_\theta(\mathbf{c} \mid q, \mathbf{h})$ 解码出一个排序的候选 DocID 列表。
Cluster-Ranked Identifier¶
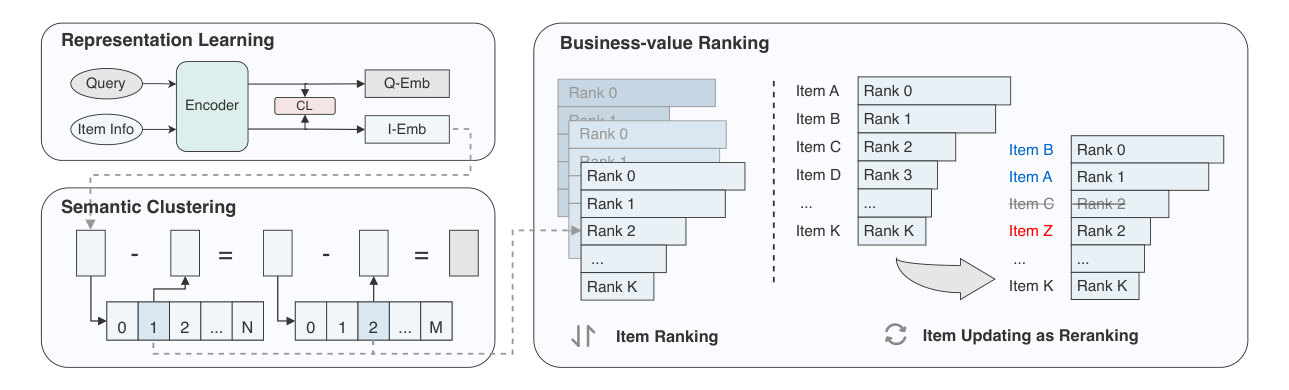
CRID 的一个关键观察是:在层次化 DocID 中,靠前的码本层主要决定语义召回(semantic recall),靠后的层则在召回集内做细粒度消歧(disambiguation)。为解决语义 DocID 与业务优化目标之间的错位,作者把 DocID 分解为语义簇前缀 $\mathbf{c}_s = (c_1, \ldots, c_{L-1})$ 与该簇内的业务价值排名 $r$。于是对候选物品 $i$,生成概率可以因子分解为:
$$P_\theta(i \mid q, \mathbf{h}) = P_\theta(\mathbf{c}_s \mid q, \mathbf{h}) \cdot P_\theta(r \mid \mathbf{c}_s, q, \mathbf{h}) \tag{2}$$
第一项捕获语义簇选择,第二项捕获簇内业务价值排名。
语义聚类(Semantic clustering)。 在搜索场景中,用户 query 提供了强语义锚点,自然地约束了检索空间。作者在 query-item 对上用对比学习(contrastive learning,Oord et al. 2018)训练物品 embedding,使语义相关的物品在 embedding 空间中被映射到更近的位置。用 RQ-KMeans 等标准方法量化后,得到的簇在 query 级语义粒度上刻画语义,足以在粗层做相关性区分,把细粒度的判别留给业务价值排名。
业务价值排序(Business-value ranking)。 语义簇在 query 级粒度上把物品分组,但同一簇内物品的业务价值可能差异极大。为编码这种差异,作者用一个业务价值统计量(如转化率 conversion rate)对每个簇内的物品排序,并把这个 rank 作为最后一级 DocID token——同一簇内所有物品共享同一套 rank 码本。这种序数编码天然地把 DocID 结构与 GR 模型的优化目标(通常是业务指标而非语义类别)对齐。
该设计有两大优势:
- (1) 天然无碰撞(Inherently collision-free):簇内每个 rank 恰好映射到唯一一个物品,由构造消除碰撞。
- (2) 增量更新(Incremental updates):新加入的物品按 embedding 距离分配到最近的语义簇,再按每日更新的业务价值统计重排,无需重训码本。
作者强调与 categorical attribute hashing / binning 策略(Xue et al. 2026, Zhang et al. 2026)的本质区别:后者把业务信号离散化进无序的桶(unordered buckets),而序数排名保留了物品之间的数值序(numerical order),使自回归模型能对"相对物品质量(relative item quality)"做泛化,而不是去死记硬背离散的类别标签。
实验设置¶
- 数据:从淘宝电商搜索场景 curated 出的 300M 候选池。
- 骨干模型:Qwen2.5-0.5B。
- 码本配置:前两级语义码本采用 8192 × 8192 的 RQ-KMeans 聚类,业务价值排名作为第三级。
- 评估指标:item-level Hitrate@K(HR@K),衡量 ground-truth 物品是否出现在 top-K 预测中。作者区分 top-K Hitrate(如 HR@20)与 deep-K Hitrate(如 HR@1000)。Hitrate 是检索阶段的合适指标,因为下游的精排会决定最终展示顺序。
- 评估样本:包含 in-search conversion(搜索场景内的转化)与 out-of-search conversion(购买物品与 query 意图属同一品类,但转化发生在搜索场景之外)。
- 表示学习细节(Appendix B):收集约 100M query-item 对,经相关性模型过滤,用 in-batch negatives 的对比学习在 128 GPU 上以 per-GPU batch 256 训练,产出 256 维物品 embedding。由于 CRID 与量化方案完全解耦,作者用 RQ-KMeans 建簇(100M 样本、batch 4M、3 epoch 的 mini-batch KMeans)。GR 训练分两阶段:DocID memorization 与 Supervised Fine-Tuning (SFT)。离线评测用 40M 样本子集。转化/点击统计均在 30 天滚动窗口内计算。
主要实验结果¶
主结果:不同 DocID 方案对比¶
Table 1 在 in-search 与 out-of-search 转化上比较各 DocID 方案。所有方法共享相同的前两级码本(8192 × 8192 RQ-KMeans 语义聚类),仅在第三级码本上施加不同策略。"Collision-free" 列表示该方案是否保证 DocID 与物品一一映射。
| 第三级策略 | 无碰撞 | In HR20 | In HR100 | In HR500 | In HR1000 | Out HR20 | Out HR100 | Out HR500 | Out HR1000 |
|---|---|---|---|---|---|---|---|---|---|
| $8192^3$ | N | 16.68% | 33.73% | 55.01% | 63.83% | 13.18% | 26.51% | 43.16% | 49.99% |
| w/ OPQ | N | 20.86% | 39.02% | 59.86% | 67.54% | 16.32% | 30.51% | 47.10% | 53.55% |
| w/ SK | N | 24.45% | 44.00% | 63.16% | 69.90% | 19.32% | 34.26% | 49.79% | 55.46% |
| w/ Tiger | Y | 37.48% | 51.83% | 66.44% | 73.15% | 30.00% | 39.96% | 52.66% | 57.99% |
| w/ FORGE | N | 37.28% | 51.60% | 66.29% | 72.50% | 29.66% | 39.99% | 51.99% | 57.40% |
| w/ CRID | Y | 41.20% | 59.02% | 76.22% | 82.25% | 32.43% | 45.71% | 59.79% | 65.50% |
对比策略包括:Sinkhorn-Knopp (SK) 平衡、OPQ 离散化,以及两种随机 ID 策略——Tiger(单调递增 ID,严格无碰撞)与 FORGE(允许每个 DocID 最多 5 个物品)。CRID 用基于 30 天转化计数的业务价值 rank 替换第三级码本。
结论:CRID 在 in-search 与 out-of-search 转化上均超越所有 baseline。相较最强 baseline,CRID 在 in-search conversion 上 HR@20 提升 3.72 个百分点,HR@1000 提升 9.10 个百分点。值得注意的是:纯语义 $8192^3$ 表现最差(HR@20 仅 16.68%),说明第三级码本继续做语义量化是低效的;而无碰撞的 Tiger 已明显好于有碰撞的 SK/OPQ,印证碰撞是 top-K 的关键损害;CRID 在无碰撞基础上再叠加业务价值序,在 deep-K(HR@500/1000)上拉开最大差距。
业务价值与无碰撞是互补的¶
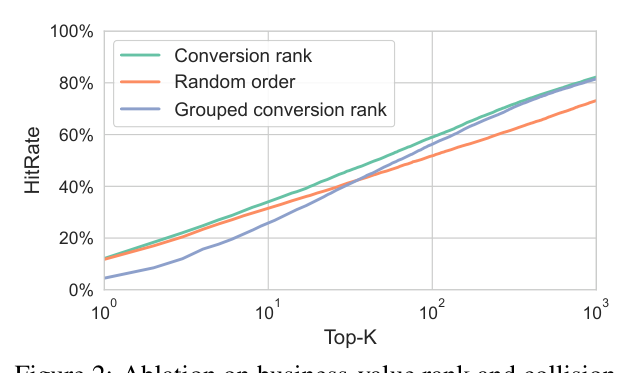
如 Fig. 2,作者把 Conversion rank 替换为 Random order 与 Grouped conversion rank(后者把连续四个物品分到同一 DocID 以模拟轻度碰撞)。Random order 导致 deep-K Hitrate 大幅下降;Grouped conversion rank 则在 top-K 上退化更明显。这证明两个属性本质且互补:业务价值主要惠及 deep-K Hitrate,而无碰撞对 top-K 性能更关键。
对业务价值定义的鲁棒性¶
Table 3 比较三种业务价值排序信号:Conversion rank、Click rank(均由 30 天累积统计得到)与一个内部业务模型预测的 quality Score-rank,并报告两两之间的 Spearman $\rho$(在含 >1 个物品的簇上计算)。
| 排序信号 | HR20 | HR100 | HR500 | HR1000 |
|---|---|---|---|---|
| Conv.-rank | 41.20% | 59.02% | 76.22% | 82.25% |
| Click-rank | 40.80% | 58.30% | 75.73% | 81.81% |
| Score-rank | 41.15% | 59.34% | 76.21% | 81.82% |
| Conv.–Click | Conv.–Score | Click–Score | |
|---|---|---|---|
| $\rho$ | 0.708 | 0.666 | 0.617 |
结论:尽管三种信号只有中等程度的 rank 相关($\rho \approx 0.6\text{–}0.7$),下游 Hitrate 差异却很有限——说明 GR 模型对具体选用哪种业务价值信号是鲁棒的。
增量更新实验¶
Table 2 在训练截止 10 天后收集的数据上评估 CRID 的增量更新能力,比较三种设置:No update(冻结码本)、Insert only(新物品分配到最近语义簇、映射到业务价值最接近的已有 rank 位置)、Full rerank(新旧物品按每日业务价值统计联合重排)。
| 设置 | Pool Coverage | Avg. Items/CRID | HR20 | HR100 | HR500 | HR1000 |
|---|---|---|---|---|---|---|
| No update | 65.08% | 1.00 | 37.86% | 54.40% | 71.60% | 77.52% |
| Insert only | 99.15% | 6.31 | 29.13% | 46.00% | 63.83% | 70.44% |
| Full rerank | 99.37% | 1.00 | 39.12% | 56.74% | 74.04% | 80.05% |
结论:Insert only 虽近乎全覆盖(99.15%),但平均每个 CRID 的物品数升到 6.31,重新引入碰撞,Hitrate 明显退化。Full rerank 既保持无碰撞映射(Avg. Items/CRID = 1.00)、又达到最高覆盖(99.37%)与全指标最佳 Hitrate,甚至超过 No update——因为 No update 的冻结码本会随物品从池中过期而逐步失效 DocID 路径,等效缩小了可检索候选集。这验证了 CRID 仅靠簇内重排即可做无重训增量更新的设计主张。
全量评测与部署¶
离线 vs. EBR(Table 4)。 部署时用生产级流水线训练 CRID,采用 32768 × 8192 的语义码本、业务价值 rank 范围 8192。Table 4 对比训练充分的 CRID-based GR 模型与最强的个性化 EBR baseline:
| HR20 | HR100 | HR500 | HR1000 | |
|---|---|---|---|---|
| In-search | +13.26% | +10.05% | -0.63% | -3.02% |
| Out-of-search | +8.00% | +7.01% | +3.75% | +2.66% |
结论:在 in-search 转化上 CRID 取得显著 top-K 增益(+13.26% HR@20),但在更深 cutoff 略有退化(-3.02% HR@1000);out-of-search 增益更明显且跨所有 cutoff 一致(+8.00% HR@20、+2.66% HR@1000)。这表明 CRID 提供了超越现有检索流水线的互补召回,且比 EBR 泛化更好。
在线部署。 GR 模型作为额外的检索通道与现有 EBR 流水线并行,构成统一的检索 + 粗排流水线。它用受约束解码,三个解码阶段分别用动态 beam size 100 / 400 / 1500(通过累积概率 cutoff 确定,以保证近乎无损的 Hitrate 覆盖,见 Appendix C)。GR 模型向精排阶段召回约 1300 个物品,满足与现有检索通道相同的延迟要求。1% 流量、30 天的 A/B 实验得到 +0.18% IPV、+0.54% order count、+1.06% GMV(整体流量)。该方法已部署到全流量。
消融与分析¶
作者用一个分析框架把 CRID 的增益归因于两个互补机制:个性化偏好泛化(personalized preference generalization)——模型利用用户历史中序列模式的能力;与统计先验泛化(statistical prior generalization)——模型对语料级业务价值统计做泛化的能力。分析分三步:先验证业务价值 rank 编码的统计先验是否有效(§4.1),再量化两成分的贡献(§4.2),最后考察语义簇大小如何影响净增益(§4.3)。
统计先验的有效性¶
作者用 Prefix N-gram Hitrate@K 评估每一级码本的预测精度:预测的前缀 N-gram 是否匹配 ground-truth 的对应前缀(DocID-level,只要 DocID 前缀命中即算 hit,不要求完整 DocID 解析到正确物品)。
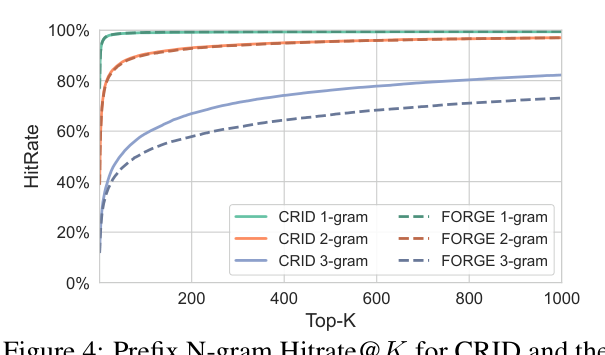
如 Fig. 4,CRID 与 FORGE baseline($8192^3$)在 1-gram、2-gram Hitrate 上相当,说明前两个语义层同等有效。但 CRID 的 3-gram(full-path)Hitrate 显著超过 FORGE(82% vs 72% @K=1000)。这个差距表明:在有限模型容量下,统计先验泛化缓解了最后一级瓶颈,通过把模型负担转移到"对相对物品质量做泛化",在细粒度语义判别上取得更大增益。
增益分解¶
作者沿两个维度切分评测集来 operationalize 两个成分。个性化偏好:按目标物品的 DocID 前缀是否出现在用户历史行为序列中,分为四组——prefix 3-gram(full-path match)、2-gram、1-gram、0-gram(no match),度量行为重叠。统计先验:把物品按业务价值 rank 分为四组——rank 0–10、10–100、100–1000、1000+。
对每组,把 Hitrate 曲线拟合成 $\log K$ 上的 logistic CDF(Fig. 3(a)),求导得到 hit-density 分布(PDF)(Fig. 3(b),多数组 $R^2 > 0.99$)。其均值 $\mu(K)$ 指示 sweet spot(该组被最好支撑的召回深度,越小越好),$\sigma(\log K)$ 刻画其离散度。
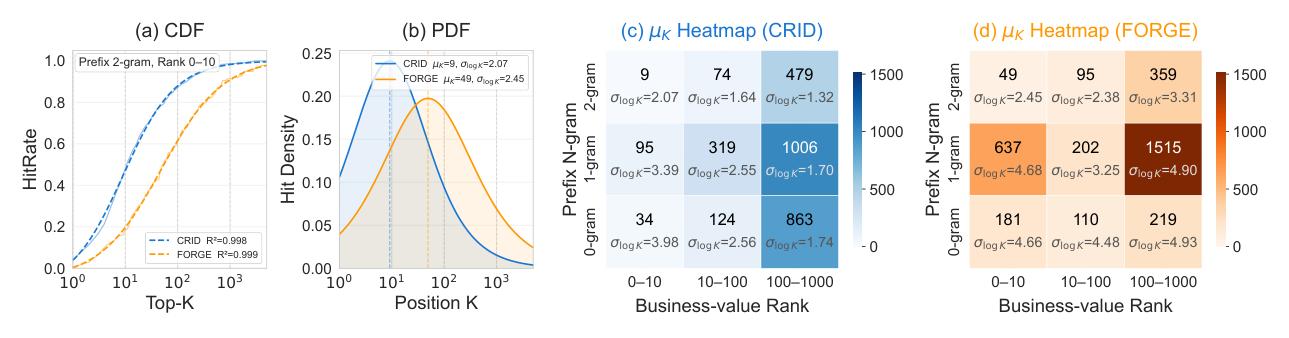
如 Fig. 3(c)(d),CRID 对 top-ranked 物品(Rank 0–10)取得显著更低的 $\mu(K)$,且跨所有组的 $\sigma(\log K)$ 一致更小,说明业务价值排序把增益集中到更浅的召回深度、且集中度更紧。在 CRID 内部,$\mu(K)$ 沿 rank 轴单调递增——这是 FORGE 中不存在的结构化模式,表明序数排名在 rank 空间上建立了一个有序的检索结构。由于 top-ranked 物品占转化的更大份额,这种把增益集中到浅 rank 的效果直接转化为整体 Hitrate 提升。
作者还指出一个异常(Appendix D):1-gram 组的 $\mu(K)$ 反而略高于 0-gram 组(即行为重叠更强反而表现更差),归因于自回归前缀偏置(autoregressive prefix bias)——beam search 给更长前缀匹配的候选路径分配更高概率质量,"挤占" 1-gram 目标的 beam slot;0-gram 组则因包含高频高特异性 query(如 "iPhone 17 Pro Max")而受影响更小。
语义簇大小的影响¶
一个朴素预期是:更大的簇(提供更多物品来排名,强化统计先验)应当一致提升性能。作者证明实际效应更微妙,源于一个与 per-group 增益相反的组成偏移(composition shift)。作者用平均语义簇大小 = 总物品数 / 语义簇数作为分析度量,评估 $8192^2$、$65536 \times 1024$ 等一系列码本配置(rank 层固定 8192),簇大小约从 5 跨到 160。
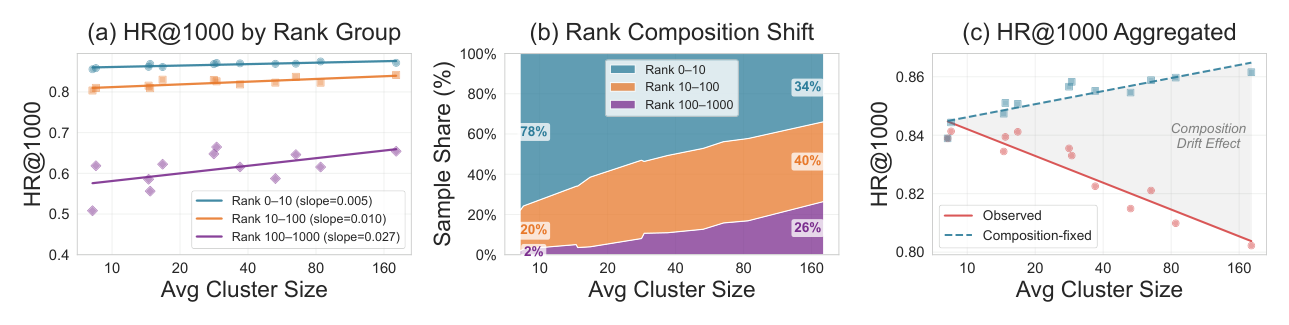
如 Fig. 5:从业务价值 rank 视角,per-rank-group HR@1000 随簇增大在所有 rank 段都上升(panel a),但加权平均反而下降(panel c)。这个反转由组成偏移驱动(panel b):簇越大,top-ranked 物品(Rank 0–10)占比从 78% 缩到 34%,稀释了整体 Hitrate。prefix N-gram 视角呈现类似模式(Fig. 8,Appendix E):更大的簇提升 per-group Hitrate,却把样本推向更弱的 prefix-match 组。
因此簇大小的净效应体现为两个维度上的对抗力量:从 rank 视角,小簇把组成推向 top-ranked 组,但削弱 per-group 统计先验;从 prefix 视角,小簇提升 per-group Hitrate,但把组成推向更弱的 prefix-match 组——从而不存在普适最优的簇大小。
前提条件与实践指导:上述结论依赖两个前提——(i)前几级的语义聚类必须足够集中以维持高 prefix-level Hitrate;(ii)优化目标需与用于排序的业务价值信号相关。二者在搜索场景中天然满足。作者据此选出针对最优 HR@1000 的配置,直接指导了生产部署选用的 32768 × 8192 码本。
核心贡献总结¶
- DocID 层面的目标对齐:首次提出把业务价值以簇内序数排名的形式编码进 DocID 的最后一级 token,用一个刻意保持简单的结构改动,同时解决了纯语义 DocID 的目标错位与碰撞两大问题,且天然支持无重训增量更新。
- 一个可迁移的分析框架:把 GR 检索增益分解为个性化偏好泛化与统计先验泛化,并给出 logistic-CDF/hit-density 的量化工具,解释了业务价值排序为何有效、以及语义簇大小如何调控二者平衡——该框架可泛化到 CRID 之外的层次化 DocID 方案。
- 强工业验证:300M 淘宝语料上超越含最强 EBR 在内的所有 baseline,全流量部署 +1.06% GMV。
与已归档相关工作的对比¶
FORGE FORGE: Forming Semantic Identifiers for Generative Retrieval in Industrial Datasets (Zhejiang University / Taobao, 2025-09)¶
关系:显式引用,本文 Table 1 已把 FORGE 作为最强 baseline 之一直接对比 · 未加载对方精读
FORGE 是本文的直接对照系统,也是 CRID 分析框架里对比 hit-density 的参照。原文报告:在共享前两级 8192 × 8192 语义码本的前提下,把第三级换成 FORGE 的"允许每个 DocID 最多 5 个物品"的随机策略后,in-search HR@1000 为 72.50%,而 CRID 达 82.25%(+9.75pp);Prefix N-gram 分析(Fig. 4)进一步显示两者 1-gram/2-gram Hitrate 几乎重合,差距完全出现在 3-gram full-path 层(CRID 82% vs FORGE 72% @K=1000)——即 CRID 的增益来自最后一级"用序数排名替换语义量化"这一处,而非前面的语义层。核心机制差异:FORGE 仍在最后一层做语义离散化并靠随机后缀缓解碰撞(不保证无碰撞),CRID 则用无碰撞的业务价值 rank,把最后一级的编码目标从"语义重构"切换到"业务转化排序"。详见 FORGE。
UniVA UniVA: Unified Value Alignment for Generative Recommendation in Industrial Advertising (Wuhan University / Tencent, 2026-05-07)¶
关系:显式引用但本文仅在 Appendix A related work 简要提及(标注为 concurrent),未做实验对比 · 已加载对方精读
- 共同关注的问题:两文指向同一 root cause——GR 的 DocID/SID 完全由语义构造,与系统的业务/商业优化目标错位,导致语义相似但商业价值悬殊的物品被映射到相邻标识符。CRID 称之为 objective mismatch,UniVA 称之为 Value Inconsistency。
- 相近的技术骨架:两者都保留前 L-1 层语义码本、把最后一级 SID token 切换为承载业务/商业信号的 token。UniVA 的 Commercial SID 让 $(s^1,\ldots,s^{L-1})=\Phi_\text{sem}$、$s^L=\Phi_\text{com}$;CRID 让前缀 $\mathbf{c}_s$ 语义、最后一级为业务价值 rank $r$。
- 本文的差异与推进:这是最尖锐的分歧点,也正是 CRID 在 Appendix A 里对 UniVA 类方法的批评所在。UniVA 的最后一级是把商业属性(优化目标 O / ROI / 行业 Industry 的组合键)离散化进 categorical buckets——CRID 明确指出这类"classify-then-bin / 属性哈希"方案得到的是无序的桶,既不能保证无碰撞、又无法在属性定义或分布变化时免重构,且缺乏物品间的序数概念。CRID 则用单一业务统计量(转化率)的簇内序数排名,显式编码一个自回归模型可泛化的数值序,天然无碰撞、可仅靠簇内重排增量更新。此外 UniVA 走的是"价值贯穿 tokenization + decoding + serving 三环节 + eCPM-aware PPO/MCTS-PPO 强化学习"的重型路线(广告域,+37.04% HR@100 offline / +1.50% GMV),而 CRID 刻意只改 DocID 一处、无需改动解码器或引入 RL(搜索域,+1.06% GMV),主张"简单的结构改动即足够"。
- 可比的方法 / 实验差异:两者数据域不同(Tencent 广告 vs 淘宝搜索),指标不可直接对齐;但机制层可比——UniVA 的价值离散化对应 CRID Table 1 中被批评的 "categorical binning" 一类,Fig. 2 的 Grouped conversion rank 消融(模拟轻度碰撞)间接印证了"分桶不如保序 + 无碰撞"。
GEM-Rec GEM-Rec: 竞价感知的生成式推荐 (Google Research, 2026-03-23)¶
关系:独立并发(本文未引用 GEM-Rec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:都针对"基于 Semantic ID 的 GR 只为语义相关性优化、忽略业务/变现价值"这一同构瓶颈。GEM-Rec 强调有机内容与赞助广告的经济约束无法被纯语义解码器处理;CRID 强调转化率等业务信号在纯语义 DocID 中缺失。
- 相近的技术骨架:两者都在共享的语义 SID 前缀之上,让最后的生成决策向业务价值倾斜,且都保留 TIGER/RQ 式的层次语义码本。
- 本文的差异与推进:机制路径截然不同。GEM-Rec 把业务价值放在推理时的 logit 调制——引入
/ 控制 token,在 beam search 时用 $\tilde{z}_c = z_c + \lambda\log(1+\mathcal{B}(c))$ 按实时 bid 调制槽位级与物品级 logit,SID 本身不编码价值(价值是解码时注入的、可通过 $\lambda=0$ 安全回退的"补丁")。CRID 恰恰相反,把业务价值结构化地烘焙进 DocID token 本身(离线 30 天转化 rank),生成时无需额外的价值调制模块。可类比 UniVA 的分类:GEM-Rec 属于"生成之后补丁式注入价值",正是 CRID 论证要避免的路线之一;但 GEM-Rec 的价值信号是实时可竞价的动态 bid,CRID 用的是离线累积的静态统计——这也暴露了 CRID 的局限(冷启动物品统计不足、单一信号)。 - 可比的方法 / 实验差异:GEM-Rec 面向"有机 + 广告混排 + 拍卖定价(First-Price)"的双市场场景并给出 allocative monotonicity 等理论性质;CRID 面向纯搜索检索、无拍卖,聚焦 Hitrate 与 GMV。二者无公共数据集,属机制层的"独立并发殊途同归"。
(附:另一近似候选 UniSGR UniSGR(Alibaba Lazada)虽同样针对"生成式检索与业务价值目标错位",但其解法是在生成 decoder 之上加一个多目标排序头 + Value-Aware Parallel MTP做 loss 级对齐,并非把价值编码进 DocID 标识符本身,技术骨架实质偏离 CRID 的"identifier-level 结构改动"主线,故未列为孪生子节。GR4AD(Kuaishou)与 UniVA 高度同类(价值贯穿 tokenization+decoding 的广告 GR),为避免重复亦不单列。)
讨论与局限性¶
核心贡献与值得借鉴的设计。 CRID 最大的启发在于"用一个极简的结构改动换取比复杂量化更大的增益":不去发明更精巧的量化器,而是承认层次 DocID 里"最后一级本就该做细粒度消歧",于是干脆把这一级从语义量化替换为业务价值序数排名。这一步同时收获三件事——目标对齐、无碰撞、可增量重排——而这三者在以往方案里往往需要各自独立的补丁(碰撞靠随机后缀、价值靠额外 ranking 模块、更新靠重训码本)。配套的 hit-density 分析框架也具方法论价值:它把"为什么有效"拆成个性化偏好与统计先验两条可量化的轴,并揭示语义簇大小上的组成偏移这一非平凡权衡,可迁移到其他层次 DocID 设计。
与已有工作的差异。 相对 FORGE/TIGER 等纯语义或随机后缀方案,CRID 的判别力来自"保序的业务信号"而非"更均衡的语义码本";相对 UniVA/GR4AD/GEM-Rec 等"价值感知 GR",CRID 的独到之处是坚持序数(ordinal)而非分桶(categorical)、坚持结构编码而非解码补丁,并论证这种简单路线在搜索场景已足够。
局限(作者自述)。 (1) 所有实验仅在淘宝电商搜索上进行;CRID 的设计不是搜索专属,但在 query 语义作用较弱的通用推荐场景是否有效仍待验证。(2) 业务价值 rank 依赖历史统计,带来潜在冷启动偏置:交互数据有限的新物品可能被分到次优 rank,直到统计累积。(3) 只用了单一业务信号;如何把转化率、点击率、预测分数等多信号融合成统一的序数排名是开放方向。(4) 受在线延迟约束,全部实验用 0.5B 模型;更大模型可能改变催生 CRID 设计的"容量-语料"平衡,scaled-up 下的有效性留待未来。