UniSGR: Unified Framework for Semantic ID Generation and Ranking¶
UniSGR 来自 Alibaba International Digital Commerce Group(阿里国际数字商业集团,即 Lazada 所属的 AIDC),是一篇工业界的生成式推荐论文。它试图回答一个正在成为 2026 年生成式推荐主线的问题:生成式检索(generative retrieval)擅长在海量物品里"生成"语义相关候选,但天生缺乏工业排序所需的细粒度多目标判别能力;如果在生成器后面简单接一个判别式 ranker,又会重新引入"生成器优化候选可信度、排序器优化最终收益"的目标错位。UniSGR 的答案是:把多目标排序模块直接长在生成式 decoder 之上,让二者共享同一套 semantic ID 表示与 decoder 隐状态,用一次前向、一个模型、一个共享表示空间同时完成"生成候选 + 多目标打分"。
研究动机与背景¶
级联架构的结构性瓶颈。 工业级推荐系统几乎都是级联流水线:候选检索 → 预排序 → 排序 → 重排。在 DLRM 时代,检索通常用双塔匹配模型实现——用户塔和物品塔各自独立编码,物品向量离线建索引,线上用大规模最大内积搜索(MIPS)在严格延迟约束下召回候选。这种级联架构的每个模块都为局部子任务优化,而非端到端的推荐目标。下游排序器只能对上游检索保留下来的候选重新排序,被上游过早过滤掉的相关物品再也无法被找回。这种分阶段解耦从根本上限制了真正端到端推荐的可能性。
生成式检索的机会与短板。 生成式检索近来成为有希望的替代范式:把推荐重新表述为自回归生成,直接生成物品标识符(通常表示为离散 semantic ID),从而给候选生成提供了更统一的视角。但现有生成式检索方法排序能力有限——它们能选出语义相关的候选,却往往缺少工业排序所需的细粒度判别力。一个直接的补救是在生成式检索之后加一个判别式 ranker,但这重新引入了目标错位:生成器被优化去产出"可信"候选,而 ranker 在一个被截断的候选集上优化最终效用,二者目标并不一致。
训练范式也是关键。 大平台包含多个业务场景,意图、行为、目标都异质。只在目标场景上训练会限制学到知识的可迁移性;而把所有数据朴素地混池又会削弱对特定场景的适配。因此 UniSGR 采用多场景预训练 + 场景特定对齐的范式,类比基础模型里的"广域预训练 + 下游适配"。
UniSGR 的提法。 基于以上视角,作者提出 UniSGR(Unified framework for Semantic ID Generation and Ranking),在单一学习框架里耦合生成式检索与判别式排序,把面向排序的监督注入 semantic ID 生成,使生成的候选更好地对齐下游业务目标。框架进一步支持多目标优化,把点击(click)、加购(add-to-cart, atc)、购买(purchase, pay)纳入同一训练过程,让 semantic ID 生成与排序朝共享的推荐目标一起优化。
四点核心贡献:
- 提出 UniSGR,一个把 semantic ID 生成与多目标排序无缝整合的统一框架,缓解传统级联架构固有的鸿沟;
- 设计两阶段训练范式(多场景预训练 + 场景特定对齐),其中 Value-Aware Parallel Multi-Token Prediction(VA-PMTP)与 Task-Aware Tokens(TAT)帮助把生成对齐到业务目标;
- 提出 STARK,一种为 semantic ID 量身定制的高效树注意力推理策略,在工业规模场景实现 200% 吞吐提升;
- 在真实电商平台上的大量离线评测和线上 A/B 验证了 UniSGR 的有效性与可扩展性。
核心方法/模型架构¶
数据编排(Data Arrangement)¶
训练数据按两阶段范式组织。
- 多场景预训练:混合多个业务场景的用户行为日志,从时序交互序列构造 next-item 生成样本。每个样本包含用户画像特征、场景/上下文特征、历史交互物品、以及下一个交互物品的 semantic ID 序列。此阶段让模型暴露于跨多场景的多样用户兴趣与物品语义。
- 场景特定对齐:样本取自目标场景,并带更丰富的行为标签。对一个用户 session,收集与不同行为类型(click / atc / pay)关联的候选目标物品。这些行为特定目标有两种用法:VA-PMTP 把它们当作带不同业务价值权重的生成目标;排序模块则用共享的生成表示去预测对应的行为标签。这一编排让生成与排序在同一 semantic ID 表示空间上被联合优化。
- 服务(Serving):输入遵循与训练相同的特征组织。Encoder 消费用户画像、行为序列、上下文特征;decoder 为候选物品生成 semantic ID;排序模块对生成的候选打分,无需再调用独立的、基于 item-ID 的排序模型。
问题形式化(Problem Formulation)¶
设 $\mathcal{U}$、$\mathcal{I}$ 为用户集与物品集。对用户 $u$,系统观测到画像特征 $\mathbf{x}_u$ 和时序交互序列 $\mathcal{S}_u = [v_1, v_2, \ldots, v_L]$,其中 $v_t \in \mathcal{I}$。每个物品 $v$ 被映射为离散 semantic ID 序列 $\mathbf{s}_v = (c_{v,1}, c_{v,2}, \ldots, c_{v,d})$,$d$ 为 semantic 层数。UniSGR 把序列推荐建模为统一的生成式检索 + 多目标排序,对齐两阶段范式:
① 多场景预训练:模型从混合业务场景数据学习可泛化的用户兴趣,充当纯生成式检索器:
$$P_\theta(v_{L+1} \mid \mathbf{x}_u, \mathcal{S}_u) = \prod_{j=1}^{d} P_\theta\!\left(c_{v_{L+1},j} \mid \mathbf{x}_u, \mathcal{S}_u, c_{v_{L+1},<j}\right) \tag{1}$$
② 场景特定对齐:预训练模型通过联合优化 value-aware next-token 预测与多目标排序适配到目标场景。给定生成的 semantic ID 与生成隐状态,模型用 BCE 损失预测 click / atc / pay 标签:
$$\hat{y}_v^{(task)} = P_\phi\!\left(y^{(task)}=1 \mid \mathbf{x}_u, \mathcal{S}_u, \mathbf{s}_v\right), \quad task \in \{\text{click}, \text{atc}, \text{pay}\} \tag{2}$$
推理服务:对齐后的模型用 beam search 解码候选,并复用生成的 semantic ID 与隐状态计算多目标分数,服务系统据此重排 Top-$K$,不再调用单独的排序模型。
Tokenizer(多模态协同 semantic ID)¶
UniSGR 先微调 Qwen3-VL 得到多模态协同物品嵌入,再用 RQ-VAE + Sinkhorn-Knopp 分配离散化成一个均衡的 3 层 semantic 码本。
协同感知表示(Collaborative-Aware Representation):对物品 $i$,把文本元数据 $T_i$ 与视觉特征 $V_i$ 一起送入 Qwen3-VL(记为 $f_\theta$),得到多模态嵌入:
$$e_i = f_\theta(T_i, V_i) \tag{3}$$
以交互过的目标物品 $i^+$ 为正样本,曝光未点击物品 $\mathcal{H}_i$ 为难负样本,in-batch 物品 $\mathcal{B}_i$ 为易负样本,用 InfoNCE 优化:
$$\mathcal{L}_{CL} = -\log \frac{\exp\!\left(sim(e_i, e_{i^+})/\tau\right)}{\sum_{j \in C_i} \exp\!\left(sim(e_i, e_j)/\tau\right)} \tag{4}$$
其中 $C_i = \{i^+\} \cup \mathcal{H}_i \cup \mathcal{B}_i$,$sim(x, y)$ 为余弦相似度,$\tau$ 为温度。量化:用 RQ-VAE 配 Sinkhorn-Knopp 均衡分配,生成 3 层 semantic 层级,码本大小 $K = 8192$。
UniSGR 框架总览¶
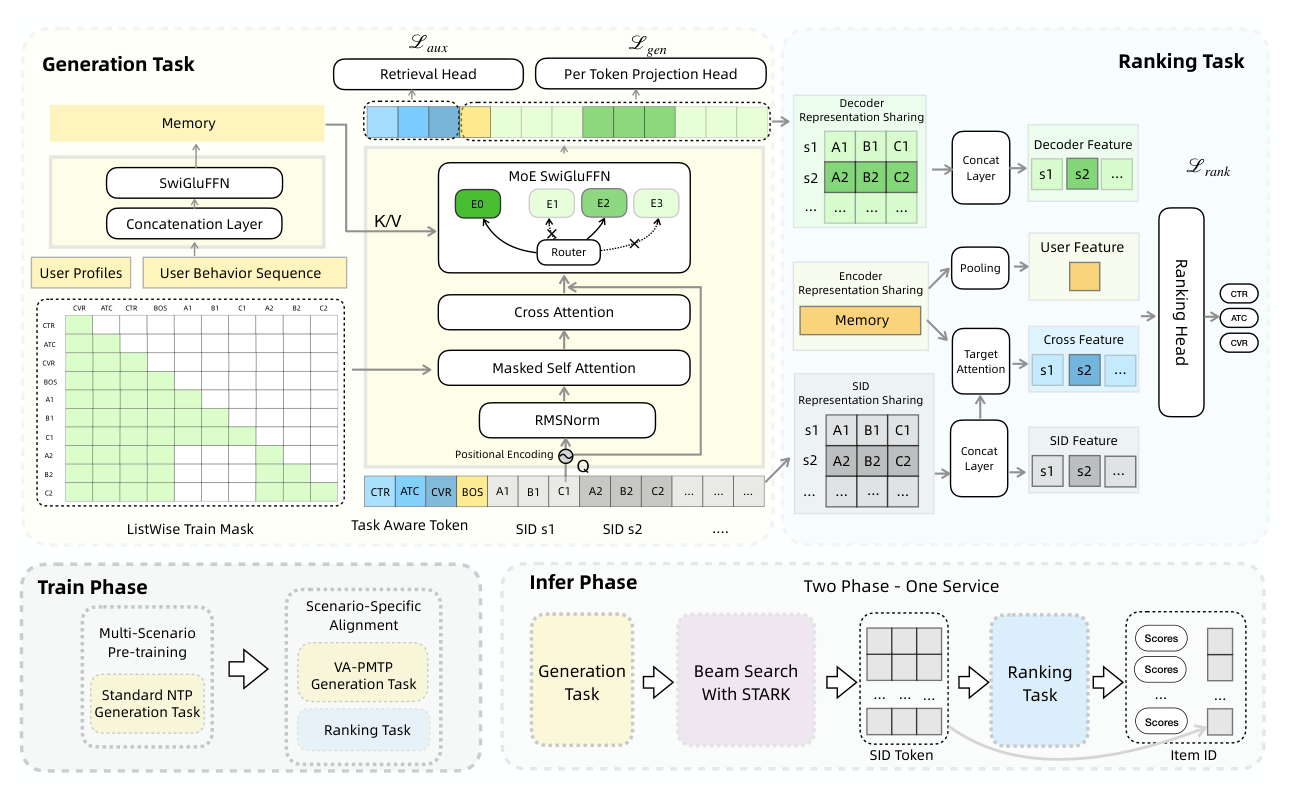
UniSGR 是一个非对称的 Transformer encoder-decoder:轻量特征 encoder + 深层稀疏 MoE decoder。
特征 Encoder(MemoryNet):处理用户画像、历史交互物品、上下文特征。它不用 self-attention,而是把用户画像经 MLP 映射后作为前缀 token 拼在行为序列前。每个历史物品由其 semantic ID 嵌入连同行为信息与位置信息共同表示,使 encoder 能同时区分物品身份与交互类型。经过位置编码、dropout、线性投影后产出一个静态 memory 表示 $\mathbf{M}$,复杂度线性 $O(L)$。这个设计有意做轻:既保留 decoder 所需信息,又规避了对长用户历史做二次方 self-attention 的开销。
稀疏 MoE Decoder:自回归生成 semantic ID token,用可学习 BOS token 初始化,并通过 cross-attention 以 $\mathbf{M}$ 为条件。decoder 给 semantic ID 嵌入加上可学习的 Token Type Embedding(TTE) 以编码其层级结构——这很关键,因为不同 semantic ID 层解码的语义不同:上层捕捉粗粒度语义簇,下层提供更细粒度的判别与物品唯一性。因此 decoder 同时学习序列级生成与层感知的语义精化。
为高效可扩展解码,采用 Grouped Query Attention(GQA) 降低 KV cache 成本,并用 shared SwiGLU-MoE 层替换标准 FFN。共享 expert 捕捉通用推荐模式,路由 expert 特化到不同语义子空间与用户兴趣模式:
$$y = \text{Expert}_{shared}(x) + \sum_{i \in \text{TopK}} g_i(x)\,\text{Expert}_i(x)$$
(上式为 MoE 输出,原文未编号。)此外用 RMSNorm 与 QK-Norm 保证训练稳定。
关键技术细节¶
两阶段训练范式¶
- 多场景预训练阶段:在多业务场景混合数据上用 Next Token Prediction(NTP)捕捉通用用户兴趣与物品语义;
- 场景特定对齐阶段:引入 VA-PMTP 与统一多目标排序模块,把生成对齐到目标场景的业务目标。
多场景预训练阶段¶
与只在单场景稀疏交互上训练相反,多场景预训练让 UniSGR 暴露于跨业务场景聚合的多样行为信号,采用 NTP 损失:
$$\mathcal{L}_{NTP} = -\sum_{j=1}^{d} \log P_\theta\!\left(c_{v_{L+1},j} \mid \mathbf{x}_u, \mathcal{S}_u, c_{v_{L+1},<j}\right) \tag{5}$$
得到的 backbone 作为后续场景对齐的稳健基础。它用广域跨场景兴趣初始化 semantic ID 生成器,对那些覆盖差、易过拟合的稀疏目标场景尤其有益。
Value-Aware Parallel Multi-Token Prediction(VA-PMTP)¶
为在目标场景中捕捉多个并发兴趣,引入 Parallel MTP(PMTP),它用一个定制的并行 mask 在同一 session 里对多个自回归 semantic-ID 目标建模:
- 同一物品内部:对所有层级的 semantic ID 之间施加因果掩码;
- 跨不同物品:强制相互不可见;
- 共享 BOS token:所有 semantic ID 都能访问同一 BOS token,用单个 BOS 统一表示多个兴趣。
进一步引入行为的业务价值权重(如 purchase > add-to-cart > click > impression),得到 VA-PMTP 损失:
$$\mathcal{L}_{\text{VA-PMTP}} = -\sum_{\tau} w_\tau \sum_{i=1}^{S_\tau} \sum_{j=1}^{d} \log P_\theta\!\left(c_{v_{L+i},j} \mid \mathbf{x}_u, \mathcal{S}_u, c_{v_{L+i},<j}\right) \tag{6}$$
其中 $w_\tau$ 是业务价值权重,$S_\tau$ 是 session 内目标 $\tau$ 对应的物品集合。相比标准 NTP,VA-PMTP 既通过并行的行为特定目标增加了目标多样性,又把生成偏置向高价值行为,产出对下游排序更有用的候选集。
统一多目标排序模块(Unified Multi-Objective Ranking Module)¶
场景对齐阶段把一个基于 semantic ID 的多目标排序模块接到生成 decoder 上。它不引入独立的 item-ID 排序器,而是复用生成过程中产出的 semantic ID 表示与 decoder 状态。
输入共享(Input Sharing):
- Semantic ID 表示共享:生成与排序共享 semantic ID 表示,拼接后的多级 semantic ID 作为候选输入喂给排序模块;
- Encoder 表示共享:生成与排序共享用户行为序列的 encoder 表示;
- Decoder 表示共享(DRS):随着 decoder 自回归解码,每一层的 semantic ID 表示逐步捕捉目标物品与用户表示之间更高阶的交互;这些 decoder 状态被排序模块复用。
模型结构:
- Target Attention:对候选 semantic ID 与行为序列 encoder 表示做 cross-attention,实现细粒度用户兴趣建模;
- PLE 多目标排序:把用户信息、semantic ID 表示、Target Attention 输出、decoder 表示作为底层输入送入 Progressive Layered Extraction(PLE)模块做多目标排序。
这一共享设计使排序损失能把面向价值的梯度反向传播到用于生成的表示上。
Task-Aware Tokens(TAT):生成-排序对齐¶
纯生成目标不会显式编码"表示应服务于哪个业务目标",而 click / atc / pay 预测需要相关但不同的偏好信号。为此提出 Task-Aware Tokens(TAT),在 decoder 输入前面拼上可学习的任务 token,让后续 semantic ID 表示以目标特定信号为条件。
引入三个可学习嵌入 $\mathbf{e}_{\text{click}}$、$\mathbf{e}_{\text{atc}}$、$\mathbf{e}_{\text{pay}}$,拼在 BOS token 之前形成增广 decoder 输入:
$$\mathbf{X}_{dec} = [\underbrace{\mathbf{e}_{\text{click}}, \mathbf{e}_{\text{atc}}, \mathbf{e}_{\text{pay}}}_{\text{task tokens}}, \underbrace{\mathbf{bos}, s_1, s_2, \ldots}_{\text{sequence tokens}}] \tag{7}$$
序列在统一因果掩码下处理:task token 遵循 click → add-to-cart → purchase 的转化漏斗顺序,所有 semantic ID token 都能注意到前面的 task token,于是目标特定信息从第一步解码就被注入。由于 task token 占据固定前缀位置,TAT 在推理时不增加额外自回归步数。
生成与排序的联合训练¶
主训练目标由生成任务和排序任务两部分构成,共同驱动端到端优化。
生成任务:记 $\mathbf{e}_{task} = (\mathbf{e}_{\text{click}}, \mathbf{e}_{\text{atc}}, \mathbf{e}_{\text{pay}})$,decoder 在 sequence token 位置执行 VA-PMTP,用交叉熵损失:
$$\mathcal{L}_{gen} = -\sum_{\tau} w_\tau \sum_{i=1}^{S_\tau} \sum_{j=1}^{d} \log P_\theta\!\left(c_{v_{L+i},j} \mid \mathbf{x}_u, \mathcal{S}_u, c_{v_{L+i},<j}, \mathbf{e}_{task}\right) \tag{8}$$
相比无 task token 的 baseline,此条件概率多了 $\mathbf{e}_{task}$,因此生成被目标特定偏好调制。
排序任务:decoder 在 $\langle bos \rangle, s_1, s_2, \ldots$ 位置的输出作为 task-aware 特征,用于 click / atc / pay 预测。排序损失是各目标损失的加权和:
$$\mathcal{L}_{rank} = \sum_{\tau} \lambda_\tau \cdot \mathcal{L}_\tau(\hat{y}_\tau, y_\tau) \tag{9}$$
其中 $\mathcal{L}_\tau$ 是对应目标的 BCE 损失。
联合优化:
$$\mathcal{L} = \mathcal{L}_{gen} + \alpha \cdot \mathcal{L}_{rank} \tag{10}$$
$\alpha$ 为平衡超参。排序损失的梯度反传穿过共享 decoder 参数,进一步强化 sequence token 位置输出表示的多目标感知能力。
Funnel-Aware Contrastive Learning(FACL):任务 token 引导¶
task token 主要通过 attention 影响下游序列表示,因而容易受弱监督与语义漂移影响。为此引入 Funnel-Aware Contrastive Learning(FACL)作为辅助信号。对任务 token 输出 $\mathbf{h}_\tau$($\tau \in \{\text{click}, \text{atc}, \text{pay}\}$),与 item ID 嵌入 $\mathbf{v}_i$ 做对比学习:
$$\mathcal{L}_\tau^{aux} = -\log \frac{\exp\!\left(sim(\mathbf{h}_\tau, \mathbf{v}^+)/t\right)}{\exp\!\left(sim(\mathbf{h}_\tau, \mathbf{v}^+)/t\right) + \sum_{j=1}^{K} \exp\!\left(sim(\mathbf{h}_\tau, \mathbf{v}_j^-)/t\right)} \tag{11}$$
其中 $sim(\cdot, \cdot)$ 为余弦相似度,$t$ 为温度。正样本随各 task token 关联的行为而定,负样本沿转化漏斗逐级变难:
- Click token:正样本为被点击物品,负样本从物品池采样,捕捉粗粒度兴趣;
- Add-to-cart token:正样本为加购物品,负样本为点击但未加购的物品,鼓励 token 把更强的购买意图与点击级兴趣区分开;
- Purchase token:正样本为购买物品,负样本为点击但未购买的物品,把 token 引向最终转化目标。
辅助对比损失:
$$\mathcal{L}_{aux} = \beta \cdot \left(\mathcal{L}_{\text{click}}^{aux} + \mathcal{L}_{\text{atc}}^{aux} + \mathcal{L}_{\text{pay}}^{aux}\right) \tag{12}$$
完整训练目标:
$$\mathcal{L} = \underbrace{\mathcal{L}_{gen} + \alpha \cdot \mathcal{L}_{rank}}_{\text{main tasks}} + \underbrace{\mathcal{L}_{aux}}_{\text{auxiliary task}} \tag{13}$$
FACL 为 task token 提供面向价值的监督,并帮助防止语义漂移。
STARK:Semantic Tree Attention with Reorganized KV Cache¶
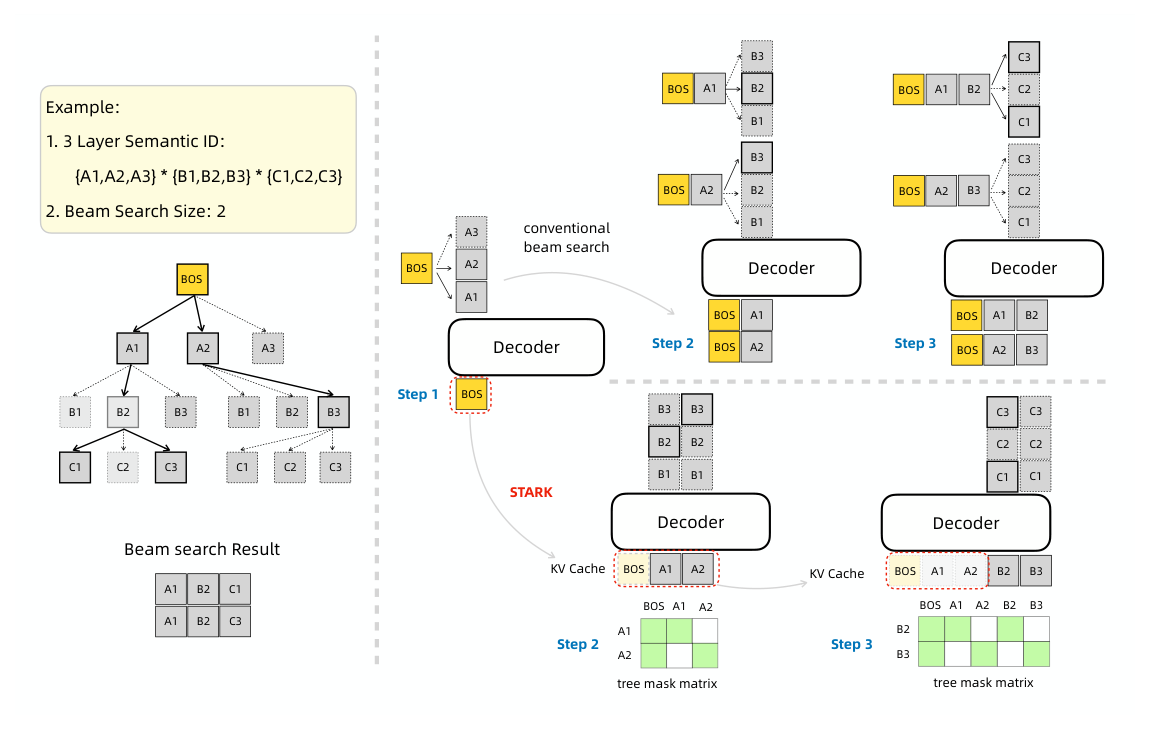
基于 semantic ID 的生成式检索通常用 beam search 自回归解码,沿解码步扩展 top-$K$ 候选序列。传统实现有严重效率瓶颈:
- KV cache 在 batch 维度上的反复复制与重排带来显著的显存带宽开销;
- 独立处理这些 batch 化候选,导致对共享前缀的注意力计算冗余;
- semantic ID 长度极短,使为长序列优化的主流注意力 kernel 因大量 padding 而严重欠利用。
受投机解码(speculative decoding)里树注意力的启发,作者提出 STARK。核心思路是用序列维度扩展替代 batch 维度扩展:每一解码步不再把 top-$K$ 候选拷成 $K$ 个独立 batch 样本,而是把候选 token 沿序列维度拼接,用一个预定义的树注意力掩码控制可见性——每个 token 只能注意到解码树里它的祖先节点和它自身。这在保持标准 beam search 结果的同时提升了效率。
形式化:设 $P^{(l)} = \{p_1^{(l)}, p_2^{(l)}, \ldots, p_k^{(l)}\}$ 为第 $l$ 层的候选路径,STARK 构造树掩码 $\mathbf{M}^{(l)}$:
$$\mathbf{M}_{i,j}^{(l)} = \begin{cases} 1, & \text{if } j \in \text{Anc}(p_i^{(l)}) \text{ or } j = i, \\ 0, & \text{otherwise,} \end{cases} \tag{14}$$
其中 $\text{Anc}(p_i^{(l)})$ 是路径 $p_i^{(l)}$ 的祖先位置集合。该掩码保证候选分支在因果上相互隔离,同时共享前缀只被计算一次。
KV cache 组织遵循相同的树拓扑:当两条候选路径共享前缀时,对应的 key/value 只存一份,由后代节点通过预计算的索引映射引用。候选扩展主要是把新选出的 semantic token 追加到树上,而非为每个 beam 复制整段前缀 cache。由于 semantic ID 深度与 beam 宽度在服务时固定,树掩码与 KV cache 重映射都能预先准备为轻量索引操作,而非重复的数据拷贝。这对"解码长度短但 beam 宽度可以很大"的 semantic ID 生成尤其有利。
Table 1:STARK 端到端延迟与吞吐对比
| Method | Batchsize | QPS | AVG Lat(ms) | P99 Lat(ms) |
|---|---|---|---|---|
| w/o STARK | 1 | 119 | 30.9 | 33.5 |
| STARK | 1 | 219 | 14.1 | 15.6 |
| STARK | 8 | 596 | 26.1 | 26.8 |
结论:STARK 在 batchsize=1 下把 QPS 从 119 提到 219(+84%),平均延迟从 30.9ms 降到 14.1ms;进一步开 batchsize=8 时 QPS 达 596,在工业规模场景实现约 200% 的吞吐提升,且完全保持标准 beam search 的解码结果,支撑生成式推荐系统的大规模部署。
实验设置¶
- 数据集:Lazada 首页"Guess You Like"场景的大规模电商推荐日志。多场景预训练用多个业务场景混合行为数据;场景特定对齐用带行为标签的目标场景日志。评测考察两件事:在给定行为目标下,ground-truth 物品是否出现在生成的 Top-$K$ 候选集中;以及排序模块是否提升生成候选上的行为预测质量。出于保密,省略用户量、物品量、精确流量规模等敏感生产统计;除特别说明外,所有方法在相同数据划分、相同 semantic ID tokenizer、相同服务约束下评测。
- Baseline:与代表性的、基于 semantic ID 的生成式推荐 baseline 对比——TIGER、OneRec、OneRec-V2,它们都把推荐表述为 semantic ID 生成。
- 指标:生成式检索用 top-$K$ 命中率 HR@$K$(目标物品出现在 top-$K$ 生成候选即命中)。多场景预训练阶段用基于点击的 HR@$K$;场景对齐阶段报告不同目标行为下的 HR@$K$:click(Clk-HR)、add-to-cart(Atc-HR)、purchase(Pay-HR)。排序模块另报 click/atc/pay 的 AUC 与 GAUC。检索实验默认报 HR@50/100/200/500。
- 实现细节:嵌入维度 $d=128$;GQA 每 4 个 query head 共享 1 个 KV head;稀疏 MoE 每 token 仅激活约 7% 参数。所有 baseline 与变体用相同嵌入与硬件。生成式检索推理用 beam search,各自回归步 beam 宽度设为 (512, 512, 1024)(对应三层码本)——最后一层用更宽的 beam 以在区分细粒度候选时扩大假设空间。
主要实验结果¶
Table 2:检索模型离线对比(基于点击的 HR@$K$,UniSGR-M ≈ 0.8B)
| Model | HR@50 | HR@100 | HR@200 | HR@500 |
|---|---|---|---|---|
| TIGER | 0.1445 | 0.2026 | 0.2698 | 0.3675 |
| OneRec-V2 | 0.1529 | 0.2126 | 0.2816 | 0.3812 |
| OneRec | 0.1538 | 0.2151 | 0.2855 | 0.3866 |
| UniSGR-M (Ours) | 0.1579 | 0.2195 | 0.2896 | 0.3913 |
分析:在相同配置下,UniSGR-M 在所有 HR@$K$ 上一致超过全部 semantic-ID 生成式 baseline。相对最强 baseline OneRec,HR@100 从 0.2151 提到 0.2195,HR@500 从 0.3866 提到 0.3913。提升虽不巨大,但意义在于——UniSGR 是在把排序目标注入同一模型的前提下,检索召回仍然不降反升,说明"共享表示 + 排序梯度反哺生成"没有牺牲纯检索能力。
Table 3:UniSGR 训练范式的行为特定命中率(Lazada "Guess You Like")
| Model | Clk HR@100 | Atc HR@100 | Pay HR@100 | Clk HR@500 | Atc HR@500 | Pay HR@500 |
|---|---|---|---|---|---|---|
| Pre-train Only | 0.1886 | 0.2276 | 0.2783 | 0.3893 | 0.4288 | 0.4768 |
| Scenario Align Only | 0.2297 | 0.2397 | 0.2573 | 0.4334 | 0.4374 | 0.4386 |
| Two-stage Training | 0.2842 | 0.3073 | 0.3408 | 0.5166 | 0.5369 | 0.5632 |
分析:这也是"两阶段训练"消融(§4.3.4)。只预训练在高价值行为(Pay)上尚可但整体偏弱;只场景对齐在 click 上还行,但因缺乏广域预训练而在 atc/pay 上很差(Pay HR@100 仅 0.2573,甚至低于只预训练的 0.2783,说明单场景稀疏数据不足以学好高价值行为)。两阶段训练在所有行为、所有 $K$ 上大幅领先(Pay HR@100 0.3408,比两个单阶段基线分别高 +22.5% / +32.5%),证实"广域预训练后再做场景对齐"的必要性。
消融与分析¶
码本大小的影响(Table 4)¶
Table 4:量化模块中不同对称码本大小的性能对比($L_1=L_2=L_3=K$)
| Model | HR@100 | HR@500 | Collision Rate |
|---|---|---|---|
| 3L2048 | 0.2917 | 0.4051 | 45.00% |
| 3L4096 | 0.3126 | 0.4360 | 31.00% |
| 3L8192 | 0.3266 | 0.4597 | 24.03% |
| 3L10240 | 0.3264 | 0.4603 | 23.58% |
分析:$K$ 从 2048 增到 8192,Clk-HR@100 从 0.2917 升到 0.3266,主要归因于 semantic 碰撞率从 45.00% 锐减到 24.03%,使细粒度物品区分更好。进一步到 10240 收益递减:Clk-HR 基本不变,碰撞率仅微降到 23.58%,且过大码本引入参数低效与深层欠利用。故采用 3L8192 作为容量与检索精度的最佳折中。
模型结构变体消融(Table 5)¶
Table 5:UniSGR 检索模块消融
| Model | HR@50 | HR@100 | HR@200 | HR@500 |
|---|---|---|---|---|
| UniSGR-M | 0.1579 | 0.2195 | 0.2896 | 0.3913 |
| w/o SwiGLU | 0.1523 | 0.2119 | 0.2813 | 0.3802 |
| w/o MoE | 0.1229 | 0.1725 | 0.2313 | 0.3183 |
| w/o Shared Expert | 0.1571 | 0.2180 | 0.2882 | 0.3883 |
分析:移除 MoE(w/o MoE)后 HR@100 从 0.2195 暴跌到 0.1725(-21%),说明稀疏 MoE 在不带来高昂算力的前提下扩展模型容量、捕捉多样用户兴趣上作用关键。用标准 FFN 替换 SwiGLU(w/o SwiGLU)在所有指标上明显下降,证实 SwiGLU 为 semantic ID 生成提供了更强的非线性表达。移除共享 expert(w/o Shared Expert)下降较小,说明共享 expert 是有益但非决定性的组件。
Scaling 行为(Table 6 / Figure 3)¶
Table 6:UniSGR 不同模型规模的性能扩展
| Model | HR@50 | HR@100 | HR@200 | HR@500 |
|---|---|---|---|---|
| UniSGR-XS (0.2B) | 0.1364 | 0.1911 | 0.2549 | 0.3489 |
| UniSGR-S (0.4B) | 0.1471 | 0.2058 | 0.2732 | 0.3705 |
| UniSGR-M (0.8B) | 0.1579 | 0.2195 | 0.2896 | 0.3913 |
| UniSGR-L (1.2B) | 0.1631 | 0.2266 | 0.2987 | 0.4018 |
| UniSGR-XL (1.6B) | 0.1655 | 0.2298 | 0.3030 | 0.4062 |
| UniSGR-XXL (2.0B) | 0.1664 | 0.2311 | 0.3048 | 0.4097 |
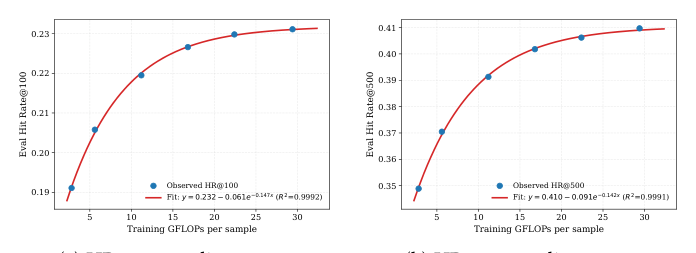
分析:更大模型一致取得更好结果,呈现清晰稳定的 scaling。相比 UniSGR-XS(0.2B),UniSGR-M(0.8B)把 HR@100 从 0.1911 提到 0.2195(+14.86%),HR@500 从 0.3489 提到 0.3913(+12.15%);继续到 1.2B/1.6B/2.0B 仍有增益。但边际增益随规模递减——如 Figure 3 拟合曲线所示,UniSGR 在中小规模区间收益最大,大规模呈饱和的幂律收敛。这提示在该电商场景下,0.8B 左右已是性价比甜点。
排序阶段辅助设计消融(Table 7 / Table 8)¶
Table 7:排序模块消融上的行为特定命中率
| Model | Clk HR@100 | Atc HR@100 | Pay HR@100 | Clk HR@500 | Atc HR@500 | Pay HR@500 |
|---|---|---|---|---|---|---|
| NTP | 0.2752 | 0.2841 | 0.3117 | 0.4962 | 0.5010 | 0.5117 |
| VA-PMTP | 0.2777 | 0.3006 | 0.3382 | 0.5107 | 0.5287 | 0.5566 |
| VA-PMTP + Ranking | 0.2903 | 0.3076 | 0.3621 | 0.5203 | 0.5380 | 0.5716 |
| VA-PMTP + Ranking + TAT | 0.2924 | 0.3141 | 0.3614 | 0.5234 | 0.5389 | 0.5754 |
| Full UniSGR | 0.2932 | 0.3176 | 0.3636 | 0.5229 | 0.5379 | 0.5728 |
Table 8:场景对齐消融上的排序性能(AUC / GAUC)
| Model | Clk GAUC | Clk AUC | Atc GAUC | Atc AUC | Pay GAUC | Pay AUC |
|---|---|---|---|---|---|---|
| VA-PMTP | 0.5513 | 0.5684 | 0.5245 | 0.5360 | 0.5340 | 0.5603 |
| VA-PMTP + Ranking | 0.5624 | 0.6218 | 0.5710 | 0.6780 | 0.5767 | 0.7662 |
| VA-PMTP + Ranking + TAT | 0.5626 | 0.6219 | 0.5697 | 0.6855 | 0.5787 | 0.7656 |
| Full UniSGR | 0.5744 | 0.6334 | 0.5901 | 0.6978 | 0.6153 | 0.7870 |
分析(逐组件):
- VA-PMTP vs NTP:VA-PMTP 相比传统 NTP,在 add-to-cart 和 purchase 上的增益明显大于 click(如 Pay HR@100 0.3117→0.3382),说明 value-aware 生成对高价值行为尤其有帮助——这正是业务最看重的部分。
- 加 Ranking 模块:在 VA-PMTP 之上加多目标排序模块,检索命中率和排序指标(AUC/GAUC)双双提升。Table 8 里 Atc AUC 从 0.5360 跳到 0.6780、Pay AUC 从 0.5603 跳到 0.7662,说明复用 decoder 状态给排序提供了丰富的交互特征。这印证了"生成-排序联合训练"的核心主张:排序模块给生成器提供直接的业务目标监督,而共享表示又让排序拿到高质量特征。
- 加 TAT:TAT 进一步改善生成与排序的一致性,把目标特定信号注入 decoder。
- Full UniSGR(含 FACL):在 click / atc / pay 上取得最好的 GAUC 与 AUC(Pay GAUC 0.6153、Pay AUC 0.7870)。作者强调:HR 与 AUC/GAUC 的一致提升说明共享 decoder 表示并非只是"多挂一个辅助头",而是改变了学到的表示空间,让候选生成与最终打分都受益。
在线 A/B 实验(Table 9)¶
在 Lazada 首页"Guess You Like"做在线 A/B,baseline 为生产级级联推荐系统。
Table 9:UniSGR 相对 baseline 的在线绝对提升
| Scenario | IPV | Transaction Count | GMV |
|---|---|---|---|
| Lazada Homepage | +3.36% | +2.17% | +5.68% |
分析:UniSGR 把 Item Page View(IPV)提升 3.36%、成交笔数提升 2.17%、GMV 提升 5.68%,在真实工业场景同时增强了用户互动与转化。GMV 提升幅度大于 IPV/成交笔数,与"value-aware 生成偏向高价值行为"的设计意图一致——不仅带来更多点击,还带来客单价/转化质量更高的成交。
核心贡献总结¶
- 架构层面统一生成与排序:把多目标排序模块直接长在生成式 decoder 上,通过 semantic ID 表示共享、encoder 表示共享、Decoder Representation Sharing(DRS)复用生成中间态,避免"生成器 + 外挂 ranker"的目标错位,且服务时不需要额外的 item-ID 排序模型。
- 两阶段训练范式:多场景预训练(NTP)建广域兴趣,场景特定对齐用 VA-PMTP(业务价值加权的并行多目标生成)+ 多目标排序把生成对齐到 click/atc/pay 业务目标。
- Task-Aware Tokens + FACL:用可学习任务前缀 token 把 click→atc→pay 漏斗信号从首个解码步注入,且不增加推理步数;漏斗感知对比学习给任务 token 提供逐级变难的负样本监督,防止语义漂移。
- STARK 推理:把 beam search 的 batch 维扩展改为序列维树注意力 + 前缀共享的 KV cache,消除冗余前缀计算与数据拷贝,工业规模吞吐提升约 200%。
与已归档相关工作的对比¶
OneRanker OneRanker: Unified Generation and Ranking with One Model(Tencent WeChat Ads, 2026-03-03)¶
关系:显式引用(UniSGR 参考文献 [22]),但原文仅在 §2.2 一句带过、无 table/机制层对比 · 已加载对方精读
- 共同关注的问题:两篇都直指生成式推荐里"生成与排序目标错位 + 表示断裂(representation fragmentation)"这一同一 root cause——generate-then-rank 会让 ranker 面对生成结果的"黑箱",而 single-stage 直接融合又让兴趣覆盖与价值优化在共享空间里互相妥协。
- 相近的技术骨架:都用可学习 task token 序列 + 因果掩码做 value-aware 多任务解耦(UniSGR 的 $\mathbf{e}_{\text{click/atc/pay}}$ 沿漏斗排列 ↔ OneRanker 的 interest task tokens + value-aware token 按 impression→click→conversion→value 排列);都复用生成阶段的 decoder 状态/KV 给排序(UniSGR 的 DRS ↔ OneRanker 的 Key/Value pass-through 输入侧一致性);都把业务价值以加权方式偏置生成分布。
- 本文的差异与推进:① UniSGR 面向电商自然推荐,"价值"是转化漏斗(purchase>atc>click),排序用 decoder 状态上的 BCE + PLE 多目标模块;OneRanker 面向广告,"价值"是 eCPM,排序用专用 R-Decoder + pairwise BPR(eCPM 标签)+ Distribution Consistency(KL)损失。② OneRanker 引入 fake item token(K-means 聚类中心)做粗粒度目标感知;UniSGR 用 Target Attention(对行为序列 encoder 表示做 cross-attention)实现细粒度目标感知。③ UniSGR 额外贡献了 STARK 树注意力推理(OneRanker 无推理层优化)与 FACL 对比监督(OneRanker 对应位置是 DC 损失)。总体上两者是同一"统一生成+排序、value-aware task token"路线在广告 vs 电商两个场景的并行实例,UniSGR 的增量在 tokenizer(Qwen3-VL 多模态)、漏斗对比学习与推理加速。
UniPinRec UniPinRec: Unifying Generative Retrieval and Ranking at Pinterest Scale(Pinterest, 2026-05-29)¶
关系:独立并发(UniSGR 未引用 UniPinRec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:都反对"检索与排序在级联里各自孤立训练"——两个阶段都从同一份用户行为历史学表征却无法共享参数/计算/信号,造成参数、算力、serving 三重冗余。目标一致:统一进一个模型,对用户只编码一次,让排序监督反哺检索。
- 相近的技术骨架:都是单一共享 backbone + 单阶段联合训练,把排序监督(逐行为 BCE)加在检索所用的用户序列表示之上;都强调"共享表示让排序成为检索之上的边际成本"。UniSGR 的 Decoder Representation Sharing(排序复用 decoder 每层状态,$O$ 复杂度低)与 UniPinRec 的跨阶段 KV-cache 共享(排序复用检索算好的历史 KV,成本从 $O(n^2)$ 降到 $O(nk)$)在思想上高度同构。
- 本文的差异与推进:① 最根本差异是"生成 vs 非生成"——UniSGR 是SID 自回归生成 + beam search(离散 semantic ID),UniPinRec 刻意不做 SID 生成,用连续 item 嵌入 + ANN 点积检索 + Masked Action Modeling(沿特征维拼接动作、随机 mask、不膨胀序列长度)做排序。② 立场相反:UniPinRec 明确把 OneRec/OneRanker 这类"端到端生成式替换整条漏斗"列为它要规避的方向(组合性差、运维控制弱),主张"用已验证组件做 drop-in 替换";UniSGR 正属于 UniPinRec 所批评的"生成式替换漏斗"阵营。③ UniPinRec 的贡献偏 serving 工程(跨进程 GPU 显存池共享 KV、FP8、Ray in-trainer join);UniSGR 的贡献偏建模(VA-PMTP、TAT、FACL)与 STARK 推理。二者是"统一检索+排序、共享表示降冗余"这一 insight 在生成式 vs 嵌入式两条路线上的独立印证。
UniVA UniVA: Unified Value Alignment for Generative Recommendation(Tencent WeChat Channels, 2026-05-07)¶
关系:独立并发(UniSGR 未引用 UniVA,两者殊途同归)· 已加载对方精读
- 共同关注的问题:都主张"商业/业务价值不该在生成之后补丁式注入,而应贯穿生成过程",并都反对"再挂一个外置 value/ranking 模块"(引入额外延迟与目标错位)。UniVA 把它归为 Value Inconsistency,UniSGR 归为生成-排序目标错位——本质都是让生成 decoder 本身承担价值/排序判别。
- 相近的技术骨架:都走 generation-as-ranking——在 SID decoder 顶部让"生成"与"打分/价值"在同一次解码内完成,避免 post-generation ranker(UniVA 的 dual-head:generation head + value head,logits 逐元素求和 ↔ UniSGR 的排序模块直接吃 decoder 状态);都用稀疏 MoE decoder(UniVA 是 MoE×MoR,UniSGR 是 GQA + SwiGLU-MoE);都对生成做业务价值加权。
- 本文的差异与推进:① 训练范式相反——UniVA 靠 eCPM-aware RL(PPO + MCTS-PPO 探索 + 离线 eCPM 模拟器 reward + value-guided personalized beam search),价值来自广告 eCPM/bid/ROI;UniSGR 是纯监督联合训练(VA-PMTP 价值加权 CE + 排序 BCE + FACL 对比),价值来自转化漏斗,无 RL。② tokenizer 处理不同——UniVA 把最后一层码本换成 commercial token(value-aware 离散化,classify-then-bin 出价分桶),把价值注入 SID 构造本身;UniSGR 的 tokenizer 是纯多模态协同 RQ-VAE(Qwen3-VL + Sinkhorn-Knopp),价值只在生成/排序阶段进入,不改 SID 结构。③ UniVA 的线上创新是 personalized trie + value-guided beam;UniSGR 的线上创新是 STARK 树注意力加速。二者是"把 value/ranking 内化进 SID 生成"这一共同 insight 的 RL 版(UniVA)与监督版(UniSGR)。
(Step 2.5 剔除记录) 以下近似候选经语义复核后未纳入孪生对比:OneRec / OneRec-V2 / TIGER——虽问题同构,但它们是 Table 2 的 baseline,结构化对比交给 DAG(见下);OneRank(OneRank,Shopee)——其 "task-specific tokens with mutual invisibility" 机制与 TAT 高度相似,但它是纯多任务排序架构(问题是 encoder-predictor 割裂),不涉及生成,problem 非同构;DSIRM(DSIRM)——把 SID 当作排序的离散特征(方向相反,非"统一生成+排序");DIG(DIG)——同模型服务检索+排序但从判别式 ranker 出发、由 ranking loss 驱动 codebook 构造,与 UniSGR 生成式优先的机制相反。
讨论与局限性¶
核心贡献与借鉴价值。 UniSGR 最值得借鉴的是它把"统一生成与排序"落到了一个可操作的表示共享闭环:不是喊口号式地"端到端",而是具体给出 SID 表示 / encoder 表示 / decoder 状态三层共享 + task token 注入 + 价值加权生成 + 漏斗对比监督的组合拳,并用 Table 7/8 逐组件证明"排序反哺生成"确实同时抬高了 HR 和 AUC/GAUC(而非零和)。STARK 是另一个高实用性的点——它把生成式检索特有的"短序列 + 宽 beam"痛点(主流长序列 attention kernel 因 padding 欠利用)用树注意力 + 前缀共享 KV 干净地解决,200% 吞吐提升对生成式推荐的工业落地是刚需级别的价值。
局限与争议。
- 离线增益偏温和:纯检索对比(Table 2)相对最强 baseline OneRec 的 HR 提升只有 ~1-2%(如 HR@100 0.2151→0.2195),主要卖点其实在于"排序能力几乎免费地长进同一模型"以及线上 GMV +5.68%,而非检索 SOTA 的碾压。
- 保密导致可复现性弱:数据集、流量规模、物品量全部保密,只有 Lazada 单场景单次 A/B,没有公开学术数据集(Amazon/MovieLens 等)验证,外部无法复现,也难以判断方法对非电商场景的迁移性。
- 多处设计缺深入消融:STARK 只有延迟/吞吐(Table 1),没有验证"与标准 beam search 结果完全一致"的实证;FACL、Shared Expert 等组件的贡献只在整体消融里体现,缺单独的敏感性分析;$\alpha$、$\beta$、业务价值权重 $w_\tau$ 等关键超参没有给出取值或调参分析。
- 表格数值口径不统一:Table 2/5/6 的 HR(纯检索,UniSGR-M HR@100=0.2195)与 Table 3/7 的行为特定 HR(两阶段后 Clk-HR@100=0.2842)、Table 4 码本消融的 HR(0.3266)分属不同实验配置,横向数值不可直接比较,论文未充分交代口径差异,读者需按各表 caption 语境理解。
与 DAG 结构化对比的配合:UniSGR 在 Table 2 显式把 TIGER / OneRec / OneRec-V2 作为 baseline 逐项对比(HR@50/100/200/500),这三条已作为结构化对比边登记进 DAG;本节的叙事对比(OneRanker / UniPinRec / UniVA)与 DAG 结构化对比互补,前者挖掘"问题+解法双同构"的并发/引用关系,后者记录论文自身声明的 benchmark 对比。