研究动机与背景¶
工业推荐普遍是 retrieval → pre-rank → fine-rank 三级漏斗:召回从十亿级(~$10^9$)商品库里拿出千级(~$10^3$)候选,粗排用廉价的逐候选打分压到百级(~$10^2$),精排用含 user–item 交叉特征在内的丰富候选特征给出最终 ~10 个结果。字节全球电商推荐(ByteDance Global E-Commerce Recommendation Foundation Team)指出,传统级联里三个阶段独立设计、独立训练、独立服务,召回内部还按业务目标拆成多个专门通道(主通道 / 发现通道 / 广告通道),由此产生四类代价:
- 工程重复:新的 user 特征、更长的行为序列、一次模型 scaling 改进,都要在每个阶段各实现、各调参、各验证、各部署一遍;
- 计算重复:同一段用户行为序列被每个阶段重复编码;
- 优化孤立:阶段间无法共享表征与监督,导致级联不一致(例如粗排丢掉了精排本会排到头部的 item);
- 容量碎片化:模型容量分散在多个专用模型中,无法作为一个整体 scaling。
作者把这看作 OneTrans(V1,arXiv 2510.26104)所解决问题的"放大版":V1 在单个排序模型内部把"特征交互模块 + 序列建模模块"统一进一个因果 Transformer(encode-then-interaction → 单栈),但这只是 model-level 统一,三个阶段仍是三个模型。V2 要做 cascade-level 统一。
统一级联有两条路线(Figure 1):(a) OneRec 式端到端生成,用一个生成模型替掉整条级联、排序器退化为 reward model;(b) 本文路线——保留级联与逐级候选缩减,只把三个阶段作为同一个 Transformer 的三个任务,共享一份缓存的用户上下文。作者选 (b) 的理由是:工业排序阶段高度依赖丰富的候选特征,去掉这些特征会显著损伤推荐质量(引 MTGR)。
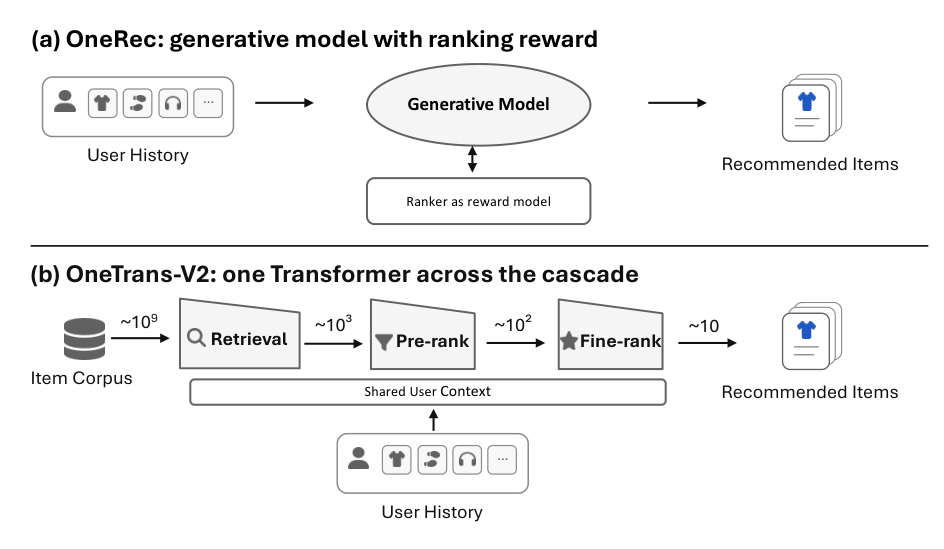
理解本文必须抓住的一点:OneTrans-V2 的"统一"是参数与训练层面的统一 + 用户序列编码的复用,不是把级联压成一次前向。服务时仍然依次跑 retrieval → pre-rank → fine-rank,候选集照样逐级收缩;各阶段的 stage token 彼此互相 mask,不读取其他阶段的中间表示。
V1 回顾(本文的架构基础)¶
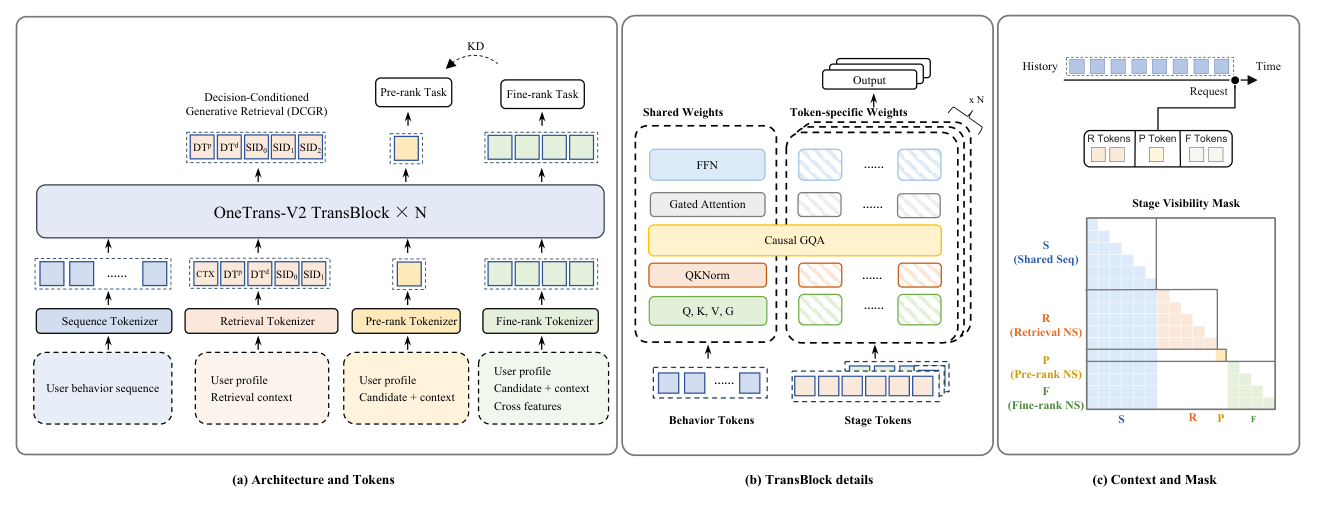
OneTrans 把行为序列事件投影为 S-token(sequential),把非序列特征经 tokenizer 变成 NS-token(non-sequential);混合参数化:S-token 共享一套 Q/K/V 与 FFN,NS-token 各自使用 token-specific 的 Q/K/V 与 FFN;因果 mask 把 NS-token 放在序列之后,使其能注意全部行为历史(等价 target attention)。V1 同时依赖金字塔裁剪与跨请求 KV cache,线上对 RankMixer+Transformer 取得 GMV/u +5.68%。
V2 的关键观察是:V1 已经把"candidate-independent 的序列建模"与"stage-specific 的异构特征交互"在结构上分开了——前者可以跨阶段共享,后者保留阶段私有。
核心方法 / 模型架构¶
输入划分与混合参数化¶
输入分两部分:candidate-independent 的用户行为序列 $\mathcal{S}$ 在整个级联共享;非序列特征集 $\mathrm{NS}_r$、$\mathrm{NS}_p$、$\mathrm{NS}_f$ 分别属于召回、粗排、精排,各由本阶段的 tokenizer 转成 token,接在共享用户上下文之后。沿用 V1 的混合参数化:行为 token 共享一套 Q/K/V/FFN;每个阶段的非序列 token(称 stage-specific token)使用自己的、token-specific 的 Q/K/V 与 FFN。
Shared Causal User Context¶
用户 $u$ 的行为序列 $\mathcal{S}=(s_1,\dots,s_L)$(也写作 $\mathcal{S}_u$)按到达顺序排列、只追加。为避免未来信息泄露,行为序列用因果注意力编码,位置 $i$ 的隐状态只汇总 $i$ 之前的行为。
Stage Visibility Mask¶
一个 request 是用户的一次推荐调用,依次由三阶段服务;一次 exposure 的 stage-specific token 属于某个时间戳的 request。规则:
- stage token 被锚定在该 request 时间戳之前最后到达的那个行为上,只能注意锚点及之前的行为前缀;
- 同一 exposure、同一阶段内的 stage token 按预定义 token 顺序做因果注意力;
- 不同阶段或不同 exposure 的 token 互相 mask;
- 行为 token 从不注意 stage token——因此用户上下文可以只编码一次,被所有阶段读取。
三个任务虽然 token 隔离,但共同优化共享的用户上下文,这是"联合训练互相增强"的唯一通道(外加共享的 embedding table)。每个阶段可独立决定 token 预算:粗排只用 1 个 token、特征子集很小;精排用多个 token 建模丰富候选特征。
任务一:Decision-Conditioned Generative Retrieval(DCGR)¶
问题:粗排/精排的候选是给定的,多目标可以共享一次前向、挂多个 head;召回不同——目标决定了生成哪些候选。若每个业务目标保留一套独立解码,碎片化依旧。
Semantic ID:沿用 TIGER/OneRec,对 item 的多模态 embedding 做 RQ-KMeans,得到三级 SID $(\mathrm{SID}_0,\mathrm{SID}_1,\mathrm{SID}_2)$,每级码本 8192;召回是宽度 $k$ 的码树 beam search,命中同一 SID 的所有 item 都返回。
决策前缀:生成 SID 之前,先预测关于"即将发生的这次交互"的几个决策(decision),组成 decision prefix。本文用四个维度,标签全部直接从日志读出:
- 购买等级 $z_{oc}$(order count):无购买 / 一次 / 多次($z_{oc}=0$ 即非转化,因此不需要单独的购买指示位);
- 发现等级 $z_{disc}$:候选类目相对用户近期行为有多"新";
- 供给类型 $z_{ad}$:自然 / 广告;
- 消费等级 $z_{aov}$(average order value):每单价值区间。
作者把它类比为"非语言形式的 chain-of-thought":中间步骤由日志监督,而不是自由生成。每个业务目标对应决策空间里的一个区域,而不是一条召回通道。
并行 vs 依赖决策:召回特征 $\mathrm{NS}_r$ 汇总为一个上下文 token CTX,接在 $\mathcal{S}$ 后。以 $\mathbf{H}=(\mathcal{S},\mathrm{CTX})$ 为条件,从 CTX 位置开始依次生成:
$$[\underbrace{\mathrm{DT}_p}_{\text{parallel decisions}},\ \underbrace{\mathrm{DT}_d}_{\text{dependent decisions}},\ \underbrace{\mathrm{SID}_0,\mathrm{SID}_1,\mathrm{SID}_2}_{\text{item}}] \tag{1}$$
$z_{oc}$、$z_{disc}$、$z_{ad}$ 只依赖用户上下文,各由一个轻量 decision head 在 CTX 位置预测,三者的 decision embedding 求和成一个并行决策 token $\mathrm{DT}_p$。求和而非串联的理由:串联必须人为规定解码顺序,而这些维度之间没有依赖可供排序;且顺序并不中性——先解码的维度会被偏袒(§7.5 Table 7 验证)。$z_{aov}$ 只在知道购买等级后才有意义(作者刻意不用单一 GMV 标签,因为它分不清"几单便宜货"与"一单贵货"),因此在 $\mathrm{DT}_p$ 之后以依赖 token $\mathrm{DT}_d$ 预测。
DCGR 目标:决策与 item 的联合分布分解为
$$P(\mathbf{z},\mathrm{Item}\mid\mathbf{H})=\underbrace{P(\mathbf{z}\mid\mathbf{H})}_{\text{Decision Modeling}}\cdot\underbrace{P(\mathrm{Item}\mid\mathbf{H},\mathbf{z})}_{\text{Decision-Conditioned Retrieval}} \tag{2}$$
其中 $\mathbf{z}_p=(z_{oc},z_{disc},z_{ad})$,$\mathbf{z}=(\mathbf{z}_p,z_{aov})$:
$$P(\mathbf{z}\mid\mathbf{H})=\prod_{j\in\{oc,disc,ad\}}P(z_j\mid\mathbf{H})\cdot P(z_{aov}\mid\mathbf{H},\mathbf{z}_p),\qquad P(\mathrm{Item}\mid\mathbf{H},\mathbf{z})=\prod_{\ell=0}^{2}P(\mathrm{SID}_\ell\mid\mathbf{H},\mathbf{z},\mathrm{SID}_{<\ell}) \tag{3}$$
所有决策与 SID 预测都用交叉熵,按式 (1) 的自回归顺序、以真实决策 teacher forcing 训练,得到召回损失 $\mathcal{L}_r$。
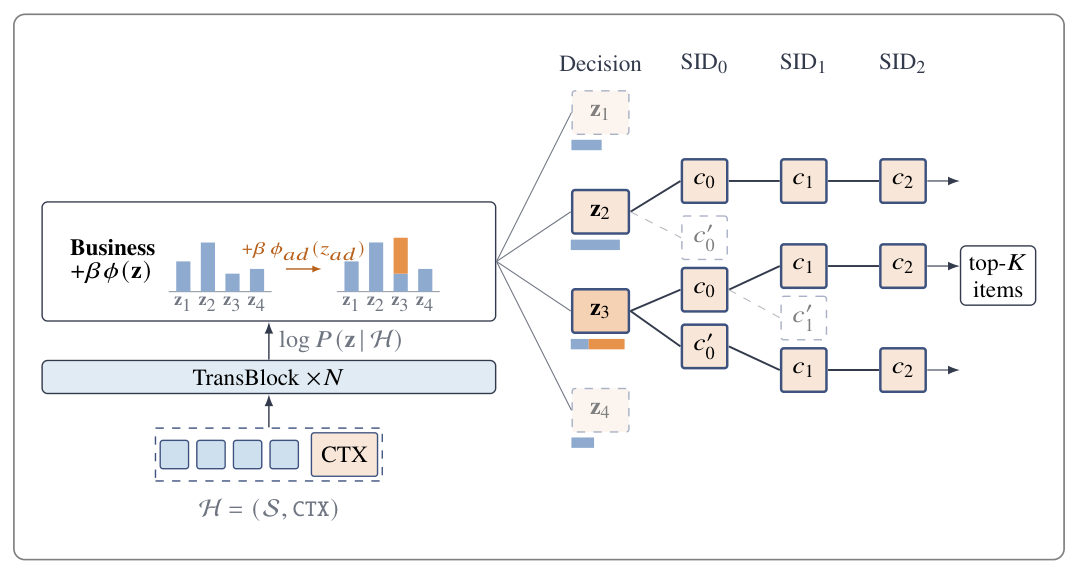
Business Steering(业务偏置):解码分三步——(1) 在缓存的用户上下文上给每个合法决策组合 $\mathbf{z}$ 打分得到 $\log P(\mathbf{z}\mid\mathbf{H})$;(2) 给每个分数加业务偏置 $\beta\phi(\mathbf{z})$;(3) beam search 把前缀扩展到 SID 码,前缀连同其码的总分为
$$\underbrace{\log P(\mathbf{z}\mid\mathbf{H})+\beta\phi(\mathbf{z})}_{\text{steered decision prefix}}+\sum_{\ell=0}^{2}\log P(\mathrm{SID}_\ell\mid\mathbf{H},\mathbf{z},\mathrm{SID}_{<\ell}) \tag{4}$$
$\phi_j$ 给维度 $j$ 的每个取值一个偏置(如给最高消费等级正偏置以引向高价值订单),$\phi(\mathbf{z})$ 是各维度偏置之和,标量 $\beta$ 控制整体强度。第一项对应分布 $q(\mathbf{z})\propto P(\mathbf{z}\mid\mathbf{H})e^{\beta\phi(\mathbf{z})}$,恰是 $\max_q \mathbb{E}_q[\phi(\mathbf{z})]-\frac{1}{\beta}\mathrm{KL}(q\,\|\,P(\cdot\mid\mathbf{H}))$ 的解——即离线 RL 中 KL 正则的策略改进步(AWR)。由于 $\phi$ 是求和,$e^{\beta\phi(\mathbf{z})}=\prod_j e^{\beta\phi_j(z_j)}$,每个业务目标在自己的维度上有独立偏置。三点性质:偏置只作用于决策项,不碰 item 项;$\beta=0$ 即模型自身排序;$\beta$ 在线可调,已被现有维度表达的目标无需重训,新目标只需加一个 decision head(无依赖则并入 $\mathrm{DT}_p$,前缀不变长)。
作者把 DCGR 定位为 Decision Transformer 家族的单步特例:决策描述的是当前这一次交互而非长序列累计回报,标签可直接从日志读出,无需 reward model、无需对日志做 off-policy 重加权;与 Multi-Game Decision Transformer 最接近,区别是后者采样一个 outcome 再条件化,而 DCGR 对每个前缀打分并把分数带入联合 beam search——"单独得分高但引不出好 item 的前缀会被淘汰"。
Item 侧引导(未部署):可进一步用 classifier-free guidance 控制"生成 item 跟随决策的强度"。训练时以小概率把决策前缀替换为空 token $\varnothing$,解码时
$$\log P(\mathrm{SID}_\ell\mid\mathbf{H},\varnothing,\mathrm{SID}_{<\ell})+w\Big(\log P(\mathrm{SID}_\ell\mid\mathbf{H},\mathbf{z},\mathrm{SID}_{<\ell})-\log P(\mathrm{SID}_\ell\mid\mathbf{H},\varnothing,\mathrm{SID}_{<\ell})\Big) \tag{5}$$
$w=1$ 退化为式 (4) 的 item 项,$w>1$ 放大决策效果,$w=0$ 忽略决策。作者明确说该扩展尚未部署、未评估。
任务二、三:判别式排序¶
Pre-rank:每个召回候选都要打分,逐候选预算最紧。只用轻量特征子集 $\mathrm{NS}_p\subset\mathrm{NS}_f$,tokenizer 把整个子集压成单个候选 token,经 stage visibility mask 读共享用户上下文,head 预测 CTR、CVR(目标集 $\mathcal{T}_p$):
$$\mathcal{L}_p=-\sum_{t\in\mathcal{T}_p}\Big[y_p^t\log\hat{y}_p^t+(1-y_p^t)\log(1-\hat{y}_p^t)\Big] \tag{6}$$
Fine-rank:只给粗排留下的候选打分,约束从吞吐转为排序保真度。沿用 V1,消费完整 $\mathrm{NS}_f$ 并保持多个 token(压成一个 token 会抹掉特征异质性)。精排实际预测的目标远多于 CTR/CVR,文中只聚焦这两个($\mathcal{T}_f$):
$$\mathcal{L}_f=-\sum_{t\in\mathcal{T}_f}\Big[y_f^t\log\hat{y}_f^t+(1-y_f^t)\log(1-\hat{y}_f^t)\Big] \tag{7}$$
模型内蒸馏(fine-rank → pre-rank):共享用户上下文给了两个排序阶段共同的表征,但它们仍各自学打分函数,可能对同一批候选排出不同顺序——粗排丢掉的候选精排永远找不回。于是以精排为 teacher、粗排为 student 做 KD。借鉴 logit standardization 的均值中心化,但把标准差换成固定温度 $\tau$:
$$p_t^T=\sigma\!\left(\frac{o_t^T-\mu_t^T}{\tau}\right),\quad p_t^S=\sigma\!\left(\frac{o_t^S-\mu_t^S}{\tau}\right),\quad \mathcal{L}_{kd}=-\sum_{t\in\mathcal{T}_p}\Big[p_t^T\log p_t^S+(1-p_t^T)\log(1-p_t^S)\Big] \tag{8}$$
teacher logit 被 detach,只由精排目标塑造。由于单模型设计,不需要单独训练、打分、刷新 teacher,也没有离线蒸馏阶段,与任务损失同一次反向传播完成。
总目标:
$$\mathcal{L}=\lambda_r\mathcal{L}_r+\lambda_p\mathcal{L}_p+\lambda_f\mathcal{L}_f+\lambda_{kd}\mathcal{L}_{kd} \tag{9}$$
关键技术细节¶
TransBlock 与 scaling 配方¶
每个 block 为 pre-norm(RMSNorm)+ 残差,分支输出乘残差系数 $\gamma=1/\sqrt{2N}$。注意力子层:QKNorm(逐 head 对 Q、K 做 RMSNorm)+ gated attention;FFN 子层:稀疏 MoE。
Algorithm 1(TransBlock 前向),输入隐状态 $X$、stage visibility mask $M$、$\gamma=1/\sqrt{2N}$:
- $\tilde{X}\leftarrow\mathrm{RMSNorm}(X)$(pre-norm)
- $Q,K,V,G\leftarrow\mathrm{split}(\tilde{X}W_{QKVG})$(一次融合投影)
- $\bar{Q},\bar{K}\leftarrow\mathrm{RMSNorm}_{head}(Q),\mathrm{RMSNorm}_{head}(K)$(QKNorm)
- $A\leftarrow\mathrm{Attn}(\bar{Q},\bar{K},V;M)$
- $X\leftarrow X+\gamma\,(A\odot\sigma(G))\,W_O$(gated attention)
- $\tilde{X}\leftarrow\mathrm{RMSNorm}(X)$
- $X\leftarrow X+\gamma\,\mathrm{MoE}(\tilde{X})$(稀疏 MoE)
-
返回 $X$
-
GQA:多个 query head 共享一个 K/V head。共享行为序列的 KV cache 只算一次、被三个任务的 stage token 读取,召回时还要广播到所有 beam,因此 KV 大小决定显存占用与访存流量;GQA 按组大小压缩 KV 且无质量损失。stage token 与行为序列只需 K/V head 数和 head 维度一致,query head 数可不同。
- 稀疏 MoE:DeepSeekMoE 式细粒度专家(窄中间维度的 SwiGLU),1 个常驻 shared expert + 若干 routed expert;router 为每个 routed expert 打分,取 top 若干,分数归一化后乘固定缩放因子。仿 DeepSeek-V3 用 sigmoid router 替代 softmax——softmax 让专家互相竞争、趋向 winner-take-all,且分数尺度与专家总数绑定;sigmoid 独立打分、尺度固定,便于扩专家数。
- Gated attention:从 QKVG 融合投影多切一片生成门控 logit,head-specific、输入相关的 sigmoid 门逐元素乘在注意力输出上、位于 value 与 output 投影之间。它控制每个 head 写回残差流的内容(而不改注意力分布),加入非线性、产生输入相关稀疏性,从而抑制 attention sink 与 massive activation、提升训练稳定性。
稳定化(μP + Depth-μP):随宽度、深度增长,激活、梯度、每步权重更新的尺度都会漂移,在一个尺寸稳定的配置到下一个尺寸可能发散。目标是让每个隐藏激活及其每步变化保持 $\Theta(1)$。宽度方向:fan-in 初始化(方差 $1/d$)已使 $Wx$ 为 $\Theta(1)$,但一次学习率 $\eta$ 的 Adam 步使每个元素变化约 $\eta$,$\Delta W x$ 是 $d$ 个与 $x$ 相关项之和,量级 $\Theta(\eta d)$,因此 μP 把每个隐藏权重的 Adam 学习率缩放 $1/d$。深度方向:残差流累加 $2N$ 个近似不相关的分支输出,$1/\sqrt{2N}$ 残差系数保持前向 $\Theta(1)$;但各分支的更新通过共享损失相关、叠加为 $\propto N$,残差系数抵消一个 $\sqrt{N}$,Adam 学习率还需再乘 $1/\sqrt{N}$。
Table 1:相对宽度 $d_0$、深度 $N_0$ 的基座模型的隐藏层规则($m_d=d/d_0$,$m_N=N/N_0$)
| 隐藏层量 | 基座模型 | 宽度规则(μP) | 深度规则(Depth-μP) |
|---|---|---|---|
| $W$ 初始化方差 | $1/d_0$ | $\times 1/m_d$(即 $1/d$) | 不变 |
| 残差系数 $\gamma$ | $1/\sqrt{2N_0}$ | 不变 | $\times 1/\sqrt{m_N}$(即 $1/\sqrt{2N}$) |
| Adam 学习率 | $\eta_0$ | $\times 1/m_d$ | $\times 1/\sqrt{m_N}$ |
两规则相乘组合,例如隐藏层学习率为 $\eta_0/(m_d\sqrt{m_N})$。另外两个随训练而非随尺寸漂移的量:注意力 logit 随 Q/K 范数增长 → QKNorm;权重范数在 Adam 下增长、有效学习率随之缩小 → 稠密参数用 AdamW 的解耦 weight decay 稳住范数。
多模态 embedding 的注入方式:既有做法 SimTier 不直接喂多模态 embedding,而是算候选与每个序列 item 的余弦相似度、做直方图作为稠密特征。V2 直接把多模态 embedding 作为每个行为 item 与候选的 side info 喂入——作者强调只有容量足够时才有收益(§7.8)。
Sequence-Native Training(SNT)¶
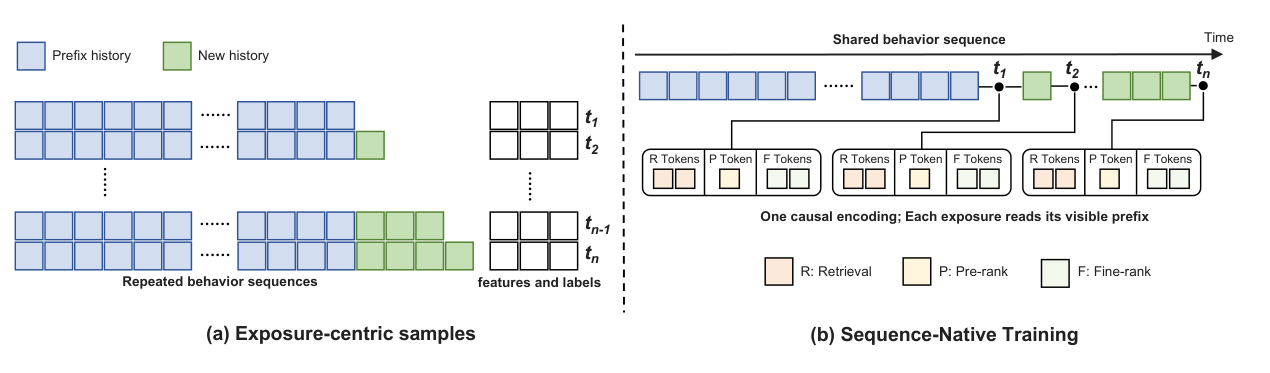
骨干变大后,训练成本的大头是编码长行为序列。传统训练每个阶段各自构造样本(每 exposure 或每 request 一条),每条都带一份序列拷贝;一个有 100 次曝光的用户,其序列被复制编码最多 100 次。RLB、MTGR 通过围绕共享用户上下文分组来减少冗余,SNT 把复用推广到跨阶段、跨请求:序列编码一次,任意 request、任意阶段的 exposure 都读它。
成立的两条性质:(1) 行为序列只追加、因果编码,整段序列的编码不变地包含每个更早前缀的编码;(2) 每个 exposure 保留自己的 request id、时间戳、task id、阶段特征和标签,但不再携带序列拷贝。样本按用户分组,一个时间窗(user window)内的所有 exposure 与该用户的一份序列一起存取。
每个 exposure 看到什么:exposure $e$ 锚定在 $\mathcal{S}_u$ 中其 request 时刻前最后到达的行为位置 $a_e$,stage visibility mask 下只看到 $a_e$ 及之前的前缀;同一 request 的 exposure 共享锚点,因此每个 exposure 恰好看到线上那一刻模型看到的内容。设 $\mathcal{S}_u^{(n)}$ 为第 $n$ 个 request 所见序列,
$$\mathcal{S}_u^{(n+1)}=\mathcal{S}_u^{(n)}\ \|\ \Delta\mathcal{S}_u^{(n+1)} \tag{10}$$
新行为只追加不插入,因此在 $\mathcal{S}_u^{(n)}$ 上定义的因果状态与锚点在 $\mathcal{S}_u^{(n+1)}$ 中依然有效。
Request 相对时间编码:锚点决定能看到哪些行为,但不决定它们"多旧"。同一份编码被不同时间的 request 读取,因此 stage token 与行为序列之间的注意力要依赖二者的时间差。采用基于时间戳的 RoPE 变体(CADET):request 时刻 $t_e$ 的 query 旋转 $t_e$,事件时刻 $t_i$ 的 key 旋转 $t_i$,对时间通道有
$$\big(R(t_e)\mathbf{q}_e^{time}\big)^{\top}\big(R(t_i)\mathbf{k}_i^{time}\big)=(\mathbf{q}_e^{time})^{\top}R(t_i-t_e)\,\mathbf{k}_i^{time} \tag{11}$$
只依赖 $t_i-t_e$,与行为在序列中的位置无关;同一 exposure 的 token 共享 request 时刻,相对旋转相消;行为自注意力不变;使用多个固定时间周期以兼顾短期与长期。key 的旋转只取决于行为自身时间戳,因此旋转后的 key 只算一次、被所有 request 与阶段复用。SNT 相对 exposure-centric 样本带来 4.4× 训练加速。
Serving 与系统优化¶
服务流程:虽然联合训练成一个 Transformer,服务仍遵循原始 retrieval → pre-rank → fine-rank 级联,每阶段只执行自己的候选侧计算。请求到来时,共享因果 Transformer 先把 $\mathcal{S}_u$ 处理成可复用的用户上下文缓存 $C_u$;召回用 $C_u$+$\mathrm{NS}_r$ 做 DCGR 解码(先对前缀加业务偏置,再对 SID 层级 beam search);粗排与精排是在同一 $C_u$ 上的非自回归打分,粗排用 $\mathrm{NS}_p$ 给召回候选打分,精排只对存活候选用 $\mathrm{NS}_f$。
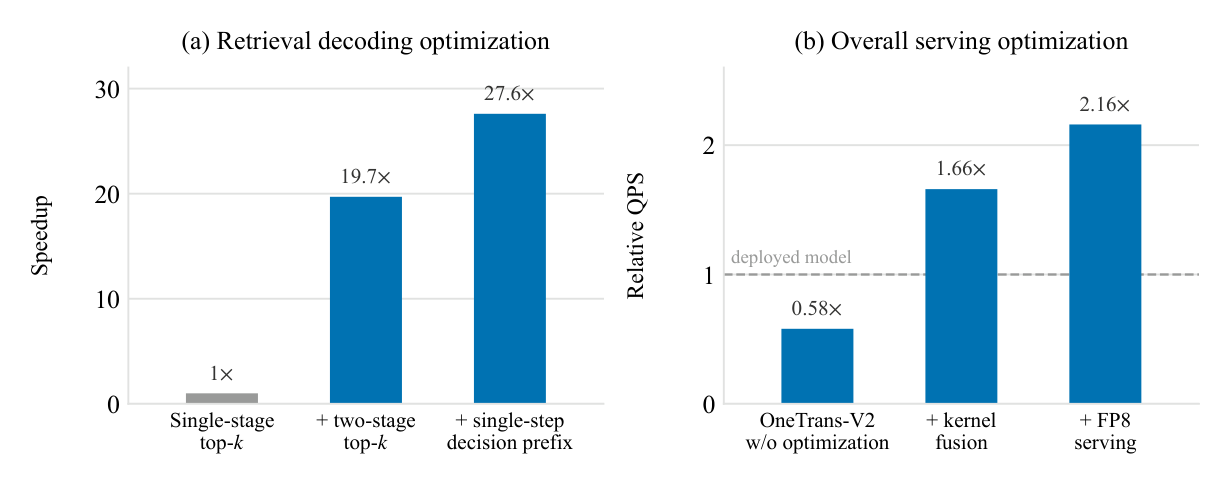
召回解码优化:(1) 决策前缀各维词表很小($z_{oc}$ 3 值、$z_{ad}$ 2 值、$z_{disc}$ 与 $z_{aov}$ 各几个值),乘积足够小,于是一次前向枚举并打分所有合法组合,把多步前缀坍缩为一步,业务偏置也在这一步作用;(2) SID beam search 中把"全部 beam×token 对的全局 top-$k$"替换为两阶段 top-$k$:先每个 beam 保留 $k$ 个最佳扩展,再在其中取全局 top-$k$,结果集完全相同,中间候选池从 beam 宽×词表缩到每 beam $k$ 个。
Kernel 融合:stage token 与共享序列之间的注意力用内置 stage visibility mask 的 FlashAttention 式 kernel,一次调用覆盖一个用户的全部候选,不 padding、不物化注意力矩阵;Q/K/V/G 投影一次无 bias GEMM,输出原地消费;QKNorm 由按偏移寻址 Q、K 切片的 RMSNorm kernel 完成;SwiGLU 的 gate 与 up 投影合并为一个 GEMM;RMSNorm kernel 保证每个 token 隐向量 16 字节对齐以发出 128-bit 向量化 load(一条指令取 8 个 16-bit 值)。
低精度服务:推荐模型有大量需保精度的浮点特征,默认 FP16;骨干因每个子层前与 Q/K 上都有 RMSNorm、激活尺度有界,因此把约占 TransBlock 2/3 FLOPs 的 SwiGLU GEMM 进一步降到 FP8;服务无反向传播,合并的 gate-up GEMM、down GEMM 与缩放残差更新可融合为单 kernel。
实验设置¶
- 数据:大规模工业推荐系统的生产日志(与 V1 同一套日志、特征快照、打标流水线,但时间窗不同,绝对数值不能与 V1 论文对比),按时间排序,特征在曝光时记录,点击/订单标签按生产中的固定窗口累积。
- 任务与指标:召回用 HitRate@M(HR@M,真实 item 的 SID 是否在 beam 返回的 top-M SID 中,M=1、10,沿用 UniSGR);粗排、精排用 CTR/CVR 的 AUC 与 UAUC(曝光加权的用户级 AUC)。两个排序阶段及其 baseline 在同样的曝光与标签上训练与评估,没有未曝光候选或采样负样本。
- 协议:沿用 V1 的 next-batch 协议,按时间流式、先预测后训练,指标按天计算后宏平均。另报 serving GFLOPs:部署配置下一次 request 的浮点开销,按所服务阶段求和(V1 报的是训练 FLOPs)。
- 模型规模:默认 OneTrans-V2L 每请求 662 GFLOPs;OneTrans-V2S 239 GFLOPs(约 V2L 的 36%)。召回 SID 三级、每级 8192;决策前缀四维、占两个 token 位置。
- 优化:稀疏 embedding 用 AdaGrad(lr 0.1,初始累加器 1.0);稠密参数用 AdamW($\beta_1=0$,$\beta_2=0.99999$,$\epsilon=10^{-5}$,weight decay 0.01;$\beta_1=0$ 时等价于带二阶矩偏差校正与解耦 weight decay 的 RMSProp);稠密与稀疏层都用全局梯度范数裁剪;BF16 训练,每卡 batch 2048、16 卡。损失权重 $\lambda_r=0.1$、$\lambda_p=1$、$\lambda_f=1$、$\lambda_{kd}=1$,温度 $\tau=0.5$;式 (8) 的中心化均值用动量 0.9999 的 EMA 维护。
- Baselines(同一特征集):
- OneTrans-GR:已部署的生成式召回,独立的纯 SID 模型(无决策前缀),在 V1 之后、以大得多的规模构建,作者称其为强 baseline;
- OneTrans-Lite:已部署的粗排模型,OneTrans 的紧凑变体;
- OneTrans(V1):已部署的精排模型;
- UniSGR、UniPinRec:两个近期"统一生成式召回 + 下游排序"的框架。复现时把 UniPinRec 的轻量排序映射到粗排、UniSGR 的多目标排序映射到精排;UniSGR 召回按原实现用外部设定的 task token;UniPinRec 召回是 ANN 而非生成式,不参与召回比较。
主要实验结果¶
离线三阶段总表(Table 2)¶
| 类型 | 模型 | 召回 HR@1 | 召回 HR@10 | 粗排 CTR AUC | 粗排 CTR UAUC | 粗排 CVR AUC | 粗排 CVR UAUC | 精排 CTR AUC | 精排 CTR UAUC | 精排 CVR AUC | 精排 CVR UAUC | GFLOPs |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 单阶段 | OneTrans-GR | 0.0545 | 0.3112 | – | – | – | – | – | – | – | – | 202 |
| 单阶段 | OneTrans-Lite | – | – | 0.7965 | 0.7080 | 0.9102 | 0.7365 | – | – | – | – | 4 |
| 单阶段 | OneTrans | – | – | – | – | – | – | 0.8084 | 0.7393 | 0.9139 | 0.7428 | 69 |
| 统一 | UniPinRec | – | – | 0.8046 | 0.7212 | 0.9113 | 0.7506 | – | – | – | – | 325 |
| 统一 | UniSGR | 0.0483 | 0.2964 | – | – | – | – | 0.7976 | 0.7209 | 0.9130 | 0.7328 | 117 |
| 统一 | OneTrans-V2S | 0.0660 | 0.3441 | 0.8053 | 0.7372 | 0.9128 | 0.7534 | 0.8171 | 0.7532 | 0.9163 | 0.7589 | 239 |
| 统一 | OneTrans-V2L | 0.0923 | 0.4053 | 0.8089 | 0.7409 | 0.9145 | 0.7596 | 0.8182 | 0.7564 | 0.9184 | 0.7682 | 662 |
GFLOPs 是各模型单独一次 request 的总算术开销(含该阶段打分的全部候选:粗排数千、精排数百),已计入 V1 的优化(同一请求的候选共享一次序列编码);作者提醒它不是吞吐代理,因为吞吐还取决于 MFU。
现有级联(OneTrans-GR + OneTrans-Lite + OneTrans)合计 275 GFLOPs/request,是对比参考。
分析:
- V2S 在略低于级联的总算力(239 vs 275)下三阶段全面超越:召回 HR@1 +21.10%(HR@10 +10.57%);精排 CTR AUC +1.08%、CTR UAUC +1.88%、CVR UAUC +2.17%。这是全文最干净的"同预算"证据——但要注意"总算力持平"不等于"每阶段持平":V2S 在各阶段的算力分配未披露,而原级联里召回独占 202 GFLOPs、精排仅 69 GFLOPs。
- V2L 花 2.4× 级联算力,把额外算力转成全部十个指标的更大增益:召回 HR@1 +69.36%;粗排对 OneTrans-Lite CTR UAUC +4.65%、CVR UAUC +3.14%;精排对 V1 CTR UAUC +2.31%、CVR UAUC +3.42%。
- 对最强 baseline 的边际(本档案标准做法):粗排上最强的是 UniPinRec(CVR UAUC 0.7506 高于 OneTrans-Lite 的 0.7365),V2S 相对它仅 CTR AUC +0.09%、CVR AUC +0.16%、CVR UAUC +0.37%,CTR UAUC +2.22% 是唯一显著项;V2L 相对它 CTR UAUC +2.73%、CVR UAUC +1.20%。粗排相对 OneTrans-Lite 的 +4.65% 很大程度上是 Lite 仅 4 GFLOPs 的算力差——UniPinRec 粗排用了 325 GFLOPs。精排上最强 baseline 就是 V1(UniSGR 在所有精排指标上都低于 V1),召回上最强是 OneTrans-GR。
- UniSGR 与 UniPinRec 在各自覆盖的阶段上都输给 V2S/V2L;UniSGR 的召回 HR@1(0.0483)甚至低于 OneTrans-GR——这部分是复现口径问题(外部设定 task token),作者也未给出 UniSGR 在自己数据上的调参细节。
在线 A/B(§6.3)¶
- 对照组:现有级联 OneTrans-GR + OneTrans-Lite + OneTrans(V1),三个独立训练、独立服务的模型;
- 实验组:一个 OneTrans-V2L(配 §5.2 的服务栈)替换这三者;用户级哈希分流,各 50% 流量。
| 指标 | 实验组 vs 对照组 |
|---|---|
| GMV / user | +9.74% |
| 用户活跃天数 | +0.25% |
| QPS(同硬件预算、三阶段端到端) | 3.2× |
尽管 V2L 每请求执行的 FLOPs 更多(662 vs 275),QPS 仍达 3.2×,来源是服务栈(kernel 融合、FP8)与"每请求只编码一次序列"两部分,§7.9 分解为 2.16× × 1.53×。
需要明确的是:这个 A/B 的对照是"含 V1 精排的整条级联",不是"V1 vs V2 的精排替换"。+9.74% GMV 同时混合了:2.4× 的服务算力、MoE/μP/AdamW/gated attention/多模态 embedding 这一整套 scaling 配方、DCGR 替代 OneTrans-GR(以及是否同时关闭发现/广告通道——§6.3 未说明)、联合训练、模型内 KD。论文没有给出任何在线分解。
消融与分析¶
所有分析默认报告 CTR,数值为相对参考配置的相对变化。
联合训练(§7.1)¶
对照组与联合模型同架构、同参数预算、同训练数据、同损失(含 KD——分开训练的粗排也从分开训练的精排接受蒸馏),因此差值只反映联合训练本身。
Table 3:粗排 + 精排联合 vs 分开训练
| 任务 | CTR AUC | CTR UAUC |
|---|---|---|
| Pre-rank | +0.09% | +0.17% |
| Fine-rank | +0.12% | +0.21% |
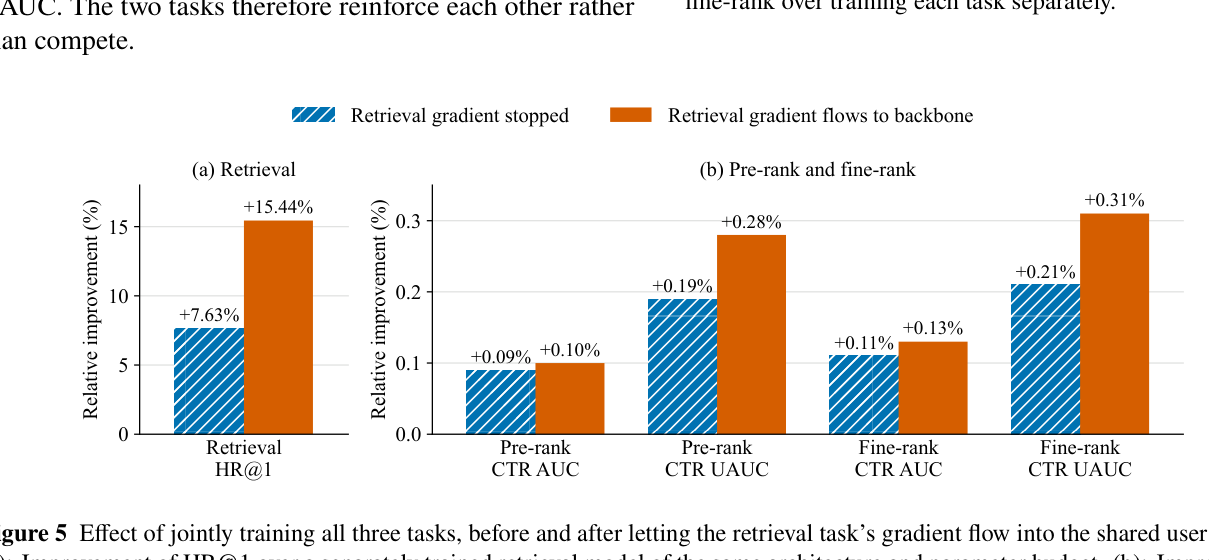
三阶段联合(Figure 5):
| 设置 | 召回 HR@1 | 粗排 CTR AUC | 粗排 CTR UAUC | 精排 CTR AUC | 精排 CTR UAUC |
|---|---|---|---|---|---|
| 召回梯度截断(不回传共享上下文) | +7.63% | +0.09% | +0.19% | +0.11% | +0.21% |
| 召回梯度回传共享上下文 | +15.44% | +0.10% | +0.28% | +0.13% | +0.31% |
召回在截断梯度时就能复用被排序任务塑造的用户上下文获益 +7.63%;放开梯度后 NTP 目标反过来强化了排序所读的上下文。召回对照与 OneTrans-GR 同骨干同算力。(截断时排序仍受轻微影响,因为 embedding table 共享。)
分析:联合训练是本文"统一"命题最直接的证据,方向一致且为正;但幅度需放到总边际里看——精排 CTR UAUC 相对 V1 的总提升为 +2.31%(V2L),联合训练只解释其中约 +0.31%(约 1/7);其余来自容量与架构配方(见下)。召回 +15.44% 相对 V2L 的 +69.36% 也只是一小部分。
蒸馏与跨阶段一致性(§7.2)¶
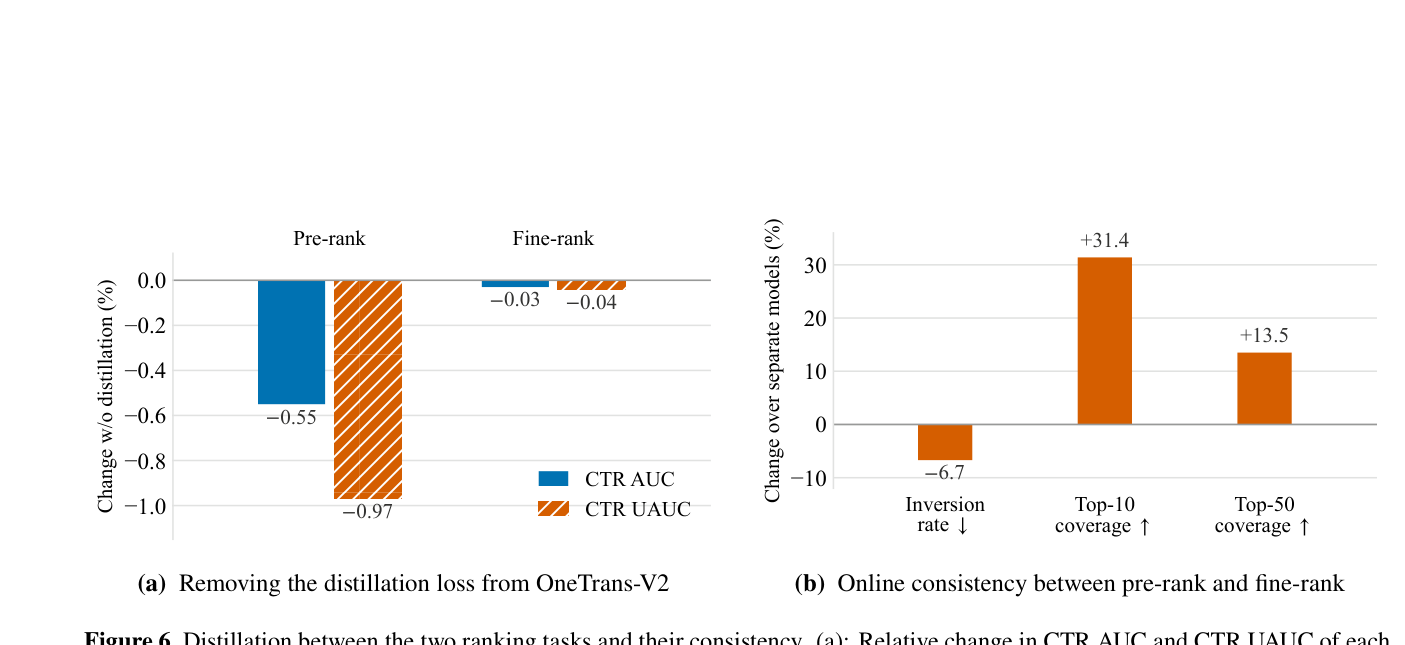
| 去掉 $\mathcal{L}_{kd}$ | CTR AUC | CTR UAUC |
|---|---|---|
| Pre-rank | −0.55% | −0.97% |
| Fine-rank | −0.03% | −0.04% |
| 线上一致性(V2 vs §7.1 的分开训练模型) | 相对变化 |
|---|---|
| 逆序率(越低越好) | −6.7% |
| Top-10 覆盖率 | +31.4% |
| Top-50 覆盖率 | +13.5% |
逆序率 = 两个任务排序不一致的 item 对比例;Top-K 覆盖率 = 粗排 top-K 中也出现在精排 top-K 的比例;均在粗排送给精排的候选上计算。
分析:KD 对粗排的贡献(−0.97% UAUC)显著大于联合训练本身(+0.28%),而 teacher 几乎不动,符合 detach 设计。但必须看清被隔离的是什么:这个消融隔离的是"有 KD vs 无 KD",而 fine→pre 蒸馏本身是 COPR、RankFlow、CoRR 一类级联里早已存在的做法;"模型内蒸馏"相对"独立 teacher 蒸馏"的增量没有被单独测——§7.1 的分开训练对照同样接受了独立精排 teacher 的蒸馏,因此"模型内"相对"模型外"的全部好处已经被包含在联合训练那 +0.17%~+0.28% 里,并且与共享上下文混在一起。一致性指标(Figure 6b)也是共享上下文与 KD 的合并效应,且只比了 CTR。
DCGR 的目标覆盖(§7.3)¶
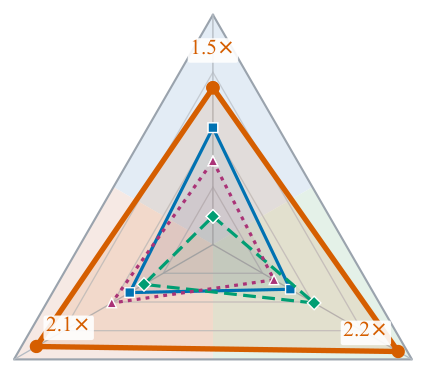
召回阶段在线 A/B(等流量):实验组中 DCGR 替换主通道的 OneTrans-GR,并关闭发现与广告通道;对照组保留三个通道。按各目标的原生指标比较:DCGR 的 GMV 是对照主通道的 1.5×、每触达用户的新类目数是发现通道的 2.2×、广告商品 GPM 是广告通道的 2.1×。
Table 4 明细:
| (a) 主通道:DCGR vs 对照主通道 | 相对变化 |
|---|---|
| 曝光 | +69.3% |
| 点击 | +74.6% |
| 订单 | +11.4% |
| GMV | +48.0% |
| 单曝光 CTR | +3.2% |
| 千次曝光订单 | −34.0% |
| 千次曝光 GMV | −13.0% |
| 曝光商品均价 | −4.4% |
| (b) vs 发现通道 | 比值 |
|---|---|
| 每触达用户的新类目数 | 2.2×(4.81 vs 2.15) |
| 覆盖对方的发现 item | 76.0% / 14.0% |
| 覆盖对方的 user–category 对 | 11.7% / 1.2% |
| 每日形成的 user–category 对 | 9.4× |
| 仅本通道触达用户的转化 | 2.8× |
| (c) vs 广告通道(广告商品) | 比值 |
|---|---|
| 曝光 | 1.8× |
| 千次曝光 GMV | 2.1× |
| 单曝光订单 | 1.7× |
| 转化率 | 2.6× |
| 客单价 | 1.2× |
DCGR 曝光中广告商品占 33.7%(对照主通道仅 4.7%),广告商品上 CTR 低约 1/3 但转化与客单价更高。
分析:作者自己明确承认这组数字是通道对通道而非系统对系统——实验组的 DCGR 承接了对照组三个通道的全部曝光,主通道 +48% GMV 主要来自"曝光量 +69.3%",单曝光效率反而下降(千次曝光订单 −34%)。因此 Figure 7 只能说明 DCGR 能覆盖三个目标,不能说明它增加了多少价值。
决策维度分析(§7.4)¶
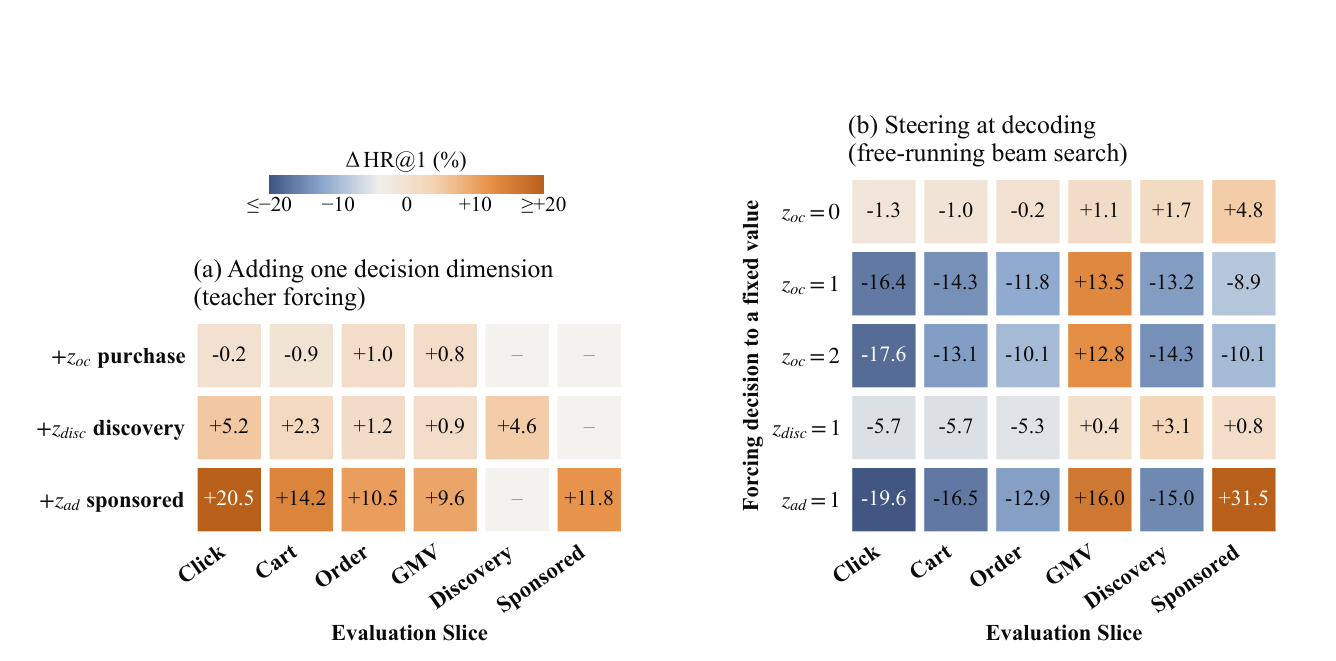
(a) teacher forcing 下给纯 SID 模型加一个决策维度的 HR@1 变化(%)
| 加入维度 | Click | Cart | Order | GMV | Discovery | Sponsored |
|---|---|---|---|---|---|---|
| $+z_{oc}$ | −0.2 | −0.9 | +1.0 | +0.8 | – | – |
| $+z_{disc}$ | +5.2 | +2.3 | +1.2 | +0.9 | +4.6 | – |
| $+z_{ad}$ | +20.5 | +14.2 | +10.5 | +9.6 | – | +11.8 |
(b) 自由 beam search 中把某个维度强制为定值的 HR@1 变化(%)
| 强制 | Click | Cart | Order | GMV | Discovery | Sponsored |
|---|---|---|---|---|---|---|
| $z_{oc}=0$ | −1.3 | −1.0 | −0.2 | +1.1 | +1.7 | +4.8 |
| $z_{oc}=1$ | −16.4 | −14.3 | −11.8 | +13.5 | −13.2 | −8.9 |
| $z_{oc}=2$ | −17.6 | −13.1 | −10.1 | +12.8 | −14.3 | −10.1 |
| $z_{disc}=1$ | −5.7 | −5.7 | −5.3 | +0.4 | +3.1 | +0.8 |
| $z_{ad}=1$ | −19.6 | −16.5 | −12.9 | +16.0 | −15.0 | +31.5 |
分析:(a) 是 teacher forcing——喂入的是真实的交互结果,作者也承认它测的是"正确决策提供的信息量"而非可部署的端到端召回精度。$z_{ad}$ 增益最大,是因为"是广告"这一条真值直接把候选限制在占 28% 交互的广告子集里;$z_{oc}$ 几乎不带 item 信息(任何切片变化 <1%)。这恰是"引入新信号 ≠ 收益来源"的典型情形:被测的收益来自把目标结果的真值作为输入,而不是来自模型预测出的前缀。(b) 证明解码器确实响应前缀(强制值会按预期方向移动检索结果),这是"可控性"的证据,而非"精度增益"的证据。全文缺少一个关键对照:同骨干、同算力下,DCGR(预测前缀、$\beta=0$)与纯 SID 召回在自由解码下的离线 HR 对比。
决策引导与前缀设计(§7.5)¶
Table 5:同一模型在召回阶段线上 A/B 中的解码期引导(相对"使用预测前缀",只统计记在 V2 召回名下的曝光)
| 对 $\mathbf{z}$ 的干预 | CTR | Orders | AOV | GMV |
|---|---|---|---|---|
| 无(预测前缀) | – | – | – | – |
| 强制 $z_{oc}=0$(click) | +8.2% | −10.4% | +5.8% | −5.1% |
| 强制 $z_{aov}$ 取最高值 | −8.1% | −33.5% | +38.9% | −7.7% |
| 业务偏置,弱 $\beta$ | +2.2% | +4.9% | +2.5% | +7.5% |
| 业务偏置,中 $\beta$ | −0.9% | −3.0% | +13.9% | +10.4% |
| 业务偏置,强 $\beta$ | −5.4% | −1.2% | +28.3% | +26.7% |
(强制 $z_{aov}$ 最高值那一行,记在 V2 召回名下的曝光下降 19.4%;其余行未记录曝光数。)
硬强制表现得像一条专门通道:拉高一个指标、损害 GMV;业务偏置则给出平滑权衡。注意 Table 5 只统计 DCGR 名下的曝光,GMV +26.7% 部分可能来自向其他通道的曝光再分配。
Table 6:第二个召回阶段 A/B,统计用户全部曝光(系统级)
| 施加的偏置 | Clicks | Orders | AOV | GMV |
|---|---|---|---|---|
| 仅购买等级 $z_{oc}$ | +8.8% | +2.4% | −2.9% | −0.6% |
| + 消费等级 $z_{aov}$,弱 | +11.4% | −5.2% | +5.9% | +0.4% |
| + 消费等级 $z_{aov}$,强 | +5.1% | −9.4% | +13.7% | +3.0% |
系统口径下,业务偏置带来的 GMV 只有 −0.6% ~ +3.0%,远小于 Table 5 的 DCGR 口径数字——这进一步说明 Table 5 与 Figure 7 的大数字含有曝光重分配成分。
前缀组织:用单一 GMV token 替代 $z_{oc}$+$z_{aov}$,按交易额加权的 HR@1 −9%;加一个独立的购买指示位 HR@1 不变(冗余)。
Table 7:串联决策 token 的解码顺序效应(早期配置:订单 a、冷启 c、发现 d 三个二值维度;HR@128,按"订单维度所处位置"平均两种排列)
| 订单维度的位置 | 加权 | Order | Cold-start | Discovery |
|---|---|---|---|---|
| 第一(acd, adc) | 0.3287 | 0.4590 | 0.0352 | 0.1437 |
| 第二(cad, dac) | 0.3267 | 0.4548 | 0.0348 | 0.1437 |
| 第三(cda, dca) | 0.3252 | 0.4520 | 0.0371 | 0.1446 |
订单维度越靠前、订单 HR 越高,冷启则在订单放最后时最好——解码顺序会偏袒先解码的目标,这是 $\mathrm{DT}_p$ 求和设计的依据。差异幅度不大(订单 0.4590 vs 0.4520,约 1.5%)。
架构分析(§7.6)¶
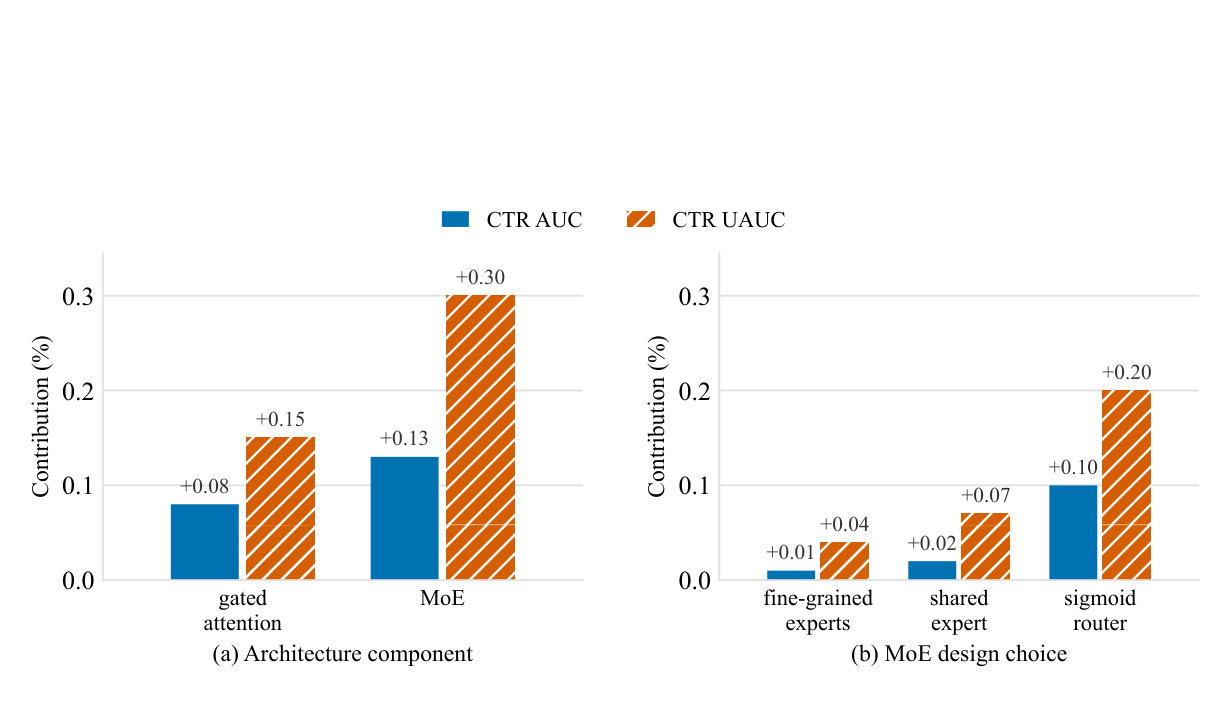
| 组件(在 V2L 上单项替换,精排) | CTR AUC | CTR UAUC |
|---|---|---|
| GQA vs 全 MHA | ≈0 | ≈0 |
| Gated attention vs 普通注意力 | +0.08% | +0.15% |
| MoE vs 算力匹配的稠密 FFN | +0.13% | +0.30% |
| 细粒度专家 vs 更少更宽的专家(同总参) | +0.01% | +0.04% |
| Shared expert vs 无 | +0.02% | +0.07% |
| Sigmoid router vs softmax | +0.10% | +0.20% |
同一配置重复运行的差异约 CTR AUC 0.006%、CTR UAUC 0.012%,大于此即可视为有意义。这些是各自独立的单项消融,不可相加。
分析:单是 MoE(+0.30%)与 sigmoid router(+0.20%)两项,就与"联合训练三阶段"(+0.31%)量级相当;加上多模态 embedding(+0.33%,见 §7.8),V2 相对 V1 的精排增益主要来自这套 LLM 式 scaling 配方,而非"跨阶段统一"本身。这些组件与"是否统一级联"正交,原则上可以直接用于一个独立的 V1 精排模型。
稳定化分析(§7.7)¶
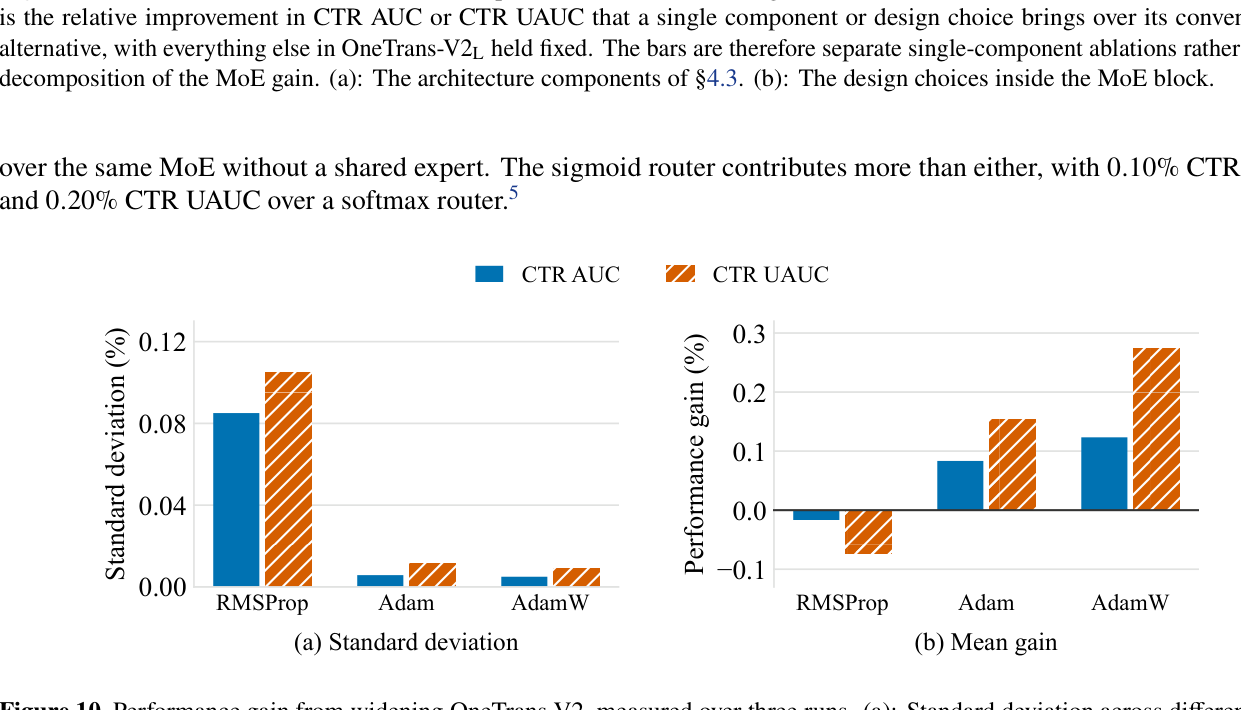
- AdamW 与 weight decay:工业常用的 RMSProp(按已部署模型调好的 lr、$\epsilon$、衰减系数)三次运行方差大,加宽模型无收益。换成 Adam(相同 lr 与 $\epsilon$,$\beta_2$=RMSProp 衰减系数,$\beta_1=0$,唯一区别是二阶矩偏差校正,防止早期更新有效学习率膨胀)后,CTR AUC 标准差从 0.085% 降到 0.006%,CTR UAUC 从 0.105% 降到 0.012%,加宽由负转为 +0.15% CTR UAUC;再加解耦 weight decay(AdamW)加宽收益近 +0.3% CTR UAUC。这是全文最有迁移价值的工程发现之一:RMSProp 缺偏差校正会吞掉 scaling 收益——而 V1 正是用 RMSProp 训练的。
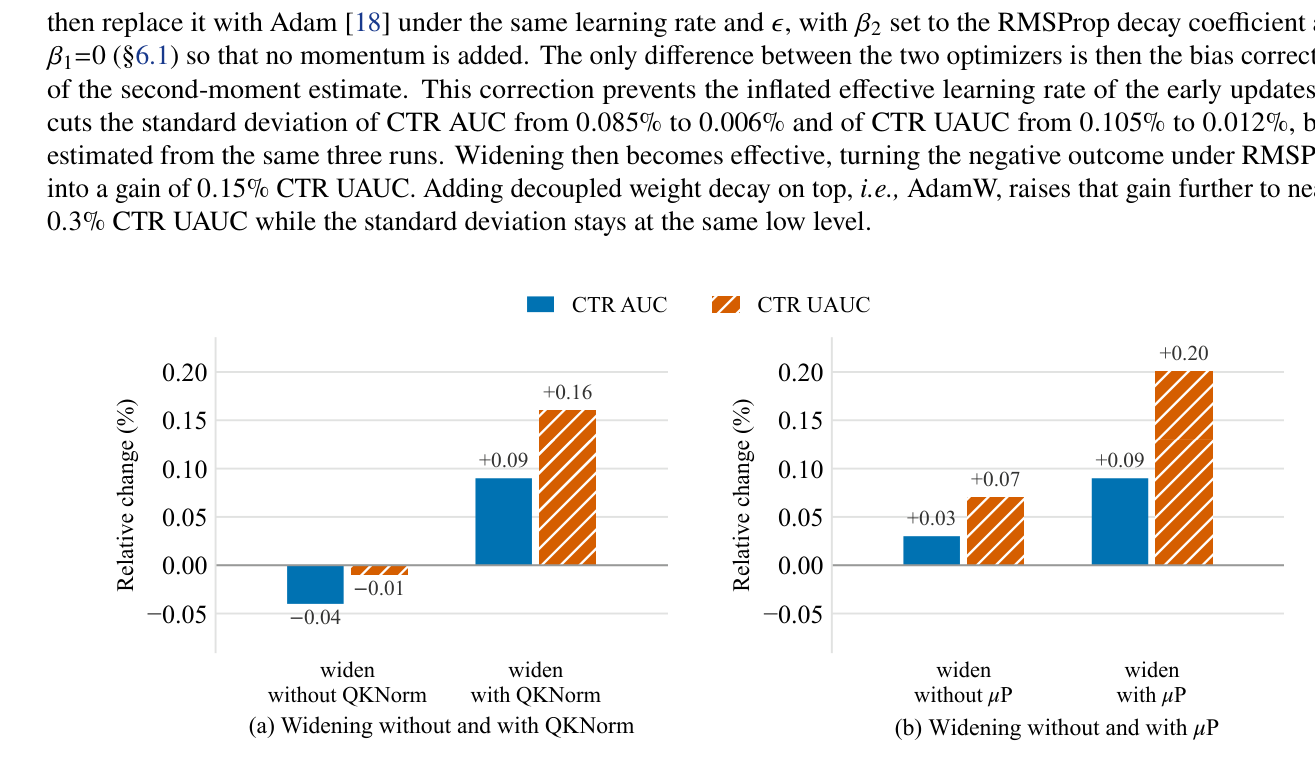
| 加宽实验(精排) | CTR AUC | CTR UAUC |
|---|---|---|
| 无 QKNorm 加宽 | −0.04% | −0.01% |
| 有 QKNorm 加宽 | +0.09% | +0.16% |
| 无 μP 加宽(沿用原宽度超参) | +0.03% | +0.07% |
| 有 μP 加宽(无需重调) | +0.09% | +0.20% |
Table 8:Depth-μP
| 设置 | CTR AUC | CTR UAUC |
|---|---|---|
| 基准深度 | – | – |
| 加深,无 Depth-μP | +0.04% | +0.05% |
| 加深,有 Depth-μP | +0.08% | +0.11% |
各面板参考不同,只能面板内比较。
多模态 embedding 与容量(§7.8)¶
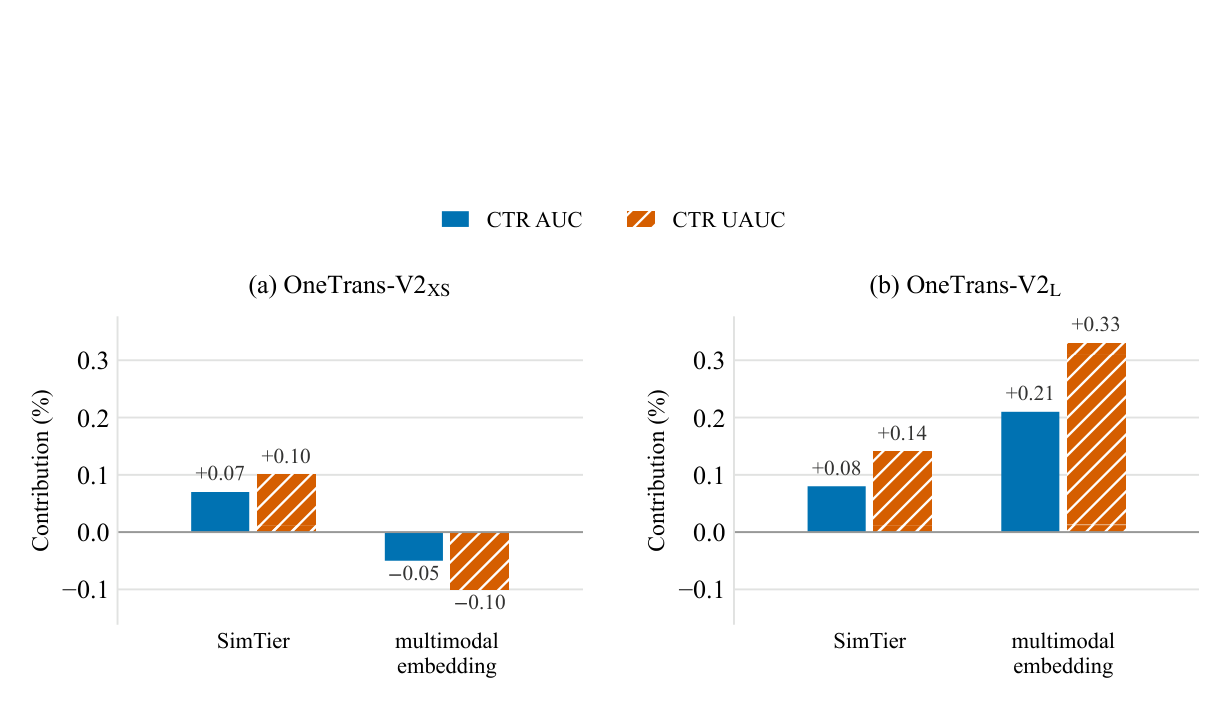
| 规模 | 注入方式 | CTR AUC | CTR UAUC |
|---|---|---|---|
| V2XS(训练成本约 V2L 的 1/46) | SimTier | +0.07% | +0.10% |
| V2XS | 直接喂多模态 embedding | −0.05% | −0.10% |
| V2L | SimTier | +0.08% | +0.14% |
| V2L | 直接喂多模态 embedding | +0.21% | +0.33% |
小模型只有 SimTier 有效、直接喂 embedding 反而有害;大模型两者都有效且直接喂更优。作者的假说:多模态 embedding 与模型自己学到的 item embedding 在不同空间,小模型没有容量学这个映射,只能靠预计算的相似度。结论:"一个规模上确立的最佳实践,到下一个规模未必仍最佳"——这是一个有价值的反直觉观察。
训练与推理加速(§7.9)¶
- SNT:4.4× 训练加速(同硬件)。窗口按天切(避免跨评估日),这限制了加速上限;按周/月切可更高(留作未来工作)。序列特征存储 −95%,同一用户的 exposure 相邻存放使非序列特征压缩率提高、存储减半。
- 召回解码:两阶段 top-$k$ 在延迟预算下吞吐 19.7×(对比的是自家单阶段实现,不是已部署召回 baseline),单请求 beam search 延迟降 2.3×;改前 top-$k$ 占召回推理时间 94%。单步决策前缀再降约 30% 延迟,累计 27.6×。
- 整体服务:在精排任务上,未优化的 V2 仅为已部署精排 0.58× 吞吐;+kernel 融合 1.66×;+FP8 2.16×。共享用户上下文(三阶段只编码一次)在整条级联上再贡献 1.53×。二者合成端到端 3.2× QPS。
分析:3.2× 中,真正属于"统一"的是 1.53×;另外 2.16× 来自 kernel 融合与 FP8,这些同样可以用在原级联的每个模型上。
核心贡献总结¶
- 级联级 One Transformer:把召回、粗排、精排表述为一个联合训练的因果 Transformer 的三个任务,candidate-independent 的用户上下文每请求只编码一次,各阶段保留原生候选特征、异构目标与服务预算;stage visibility mask 保证阶段间 token 隔离。
- DCGR:在 SID 生成前插入由日志监督的决策前缀(购买/发现/广告/客单价四维,并行求和 + 依赖串联),在线用 KL 正则意义下的业务偏置 $\beta\phi(\mathbf{z})$ 在一个生成过程内引导多个业务目标,替代多条目标专用召回通道。
- 模型内 fine→pre 蒸馏:均值中心化 + 固定温度、teacher detach,与任务损失同步反传,无需独立 teacher。
- LLM 式 scaling 配方迁移到推荐:细粒度 MoE + sigmoid router、gated attention、QKNorm、GQA、μP/Depth-μP、以 AdamW 替代 RMSProp,并给出"RMSProp 缺偏差校正会吞掉加宽收益"、"多模态 embedding 注入方式取决于容量"等可迁移经验。
- SNT:以用户终身序列为中心组织样本,跨请求、跨阶段摊销序列编码,4.4× 训练加速、序列存储 −95%。
- 生产部署:替换三阶段级联,GMV/user +9.74%、活跃天 +0.25%,同硬件 3.2× QPS。
与已归档相关工作的对比¶
SONA SONA: Yandex Music 单模型生成式推荐系统报告 (Yandex, 2026-08-11)¶
关系:显式引用但原文未展开对比(仅在 related work 一句话提及为"concurrent work")· 已加载对方精读
- 共同关注的问题:两者都针对"级联各阶段反复编码同一段用户历史、各自孤立优化"这一结构性冗余,目标都是让一次 encoder 计算同时服务召回与排序。
- 相近的技术骨架:都是"共享 encoder 每请求算一次 → 生成式 SID 召回头 + 读同一份 encoder 状态的排序模块"。SONA 的 Ranking Module 用 cross-attention 读 encoder memory $K$;V2 的粗排/精排 stage token 在 stage visibility mask 下读共享用户上下文,两者本质同构。两者也都把"大 teacher → 服务模型"的蒸馏放进训练(SONA 用离线整年训练的 Teacher Ranker 做 Rollout Distillation;V2 用同模型的精排头做 fine→pre 蒸馏)。
- 本文的差异与推进:(1) 是否保留级联——SONA 用一个 encoder-decoder 替掉 Yandex 的 15+ 召回器与粗精排,最终只剩 decoder beam + 一个排序模块;V2 刻意保留三级漏斗与逐级缩减,精排依旧消费含交叉特征的完整 $\mathrm{NS}_f$。(2) 特征——SONA 坚持不用任何手工特征,V2 恰恰以"保留各阶段原生候选特征"为核心卖点,这是两者在"统一到什么程度"上最根本的分歧。(3) 多目标——SONA 用 $n$ 个 head + 固定权重组合器;V2 在召回侧用 DCGR 的决策前缀 + 业务偏置。(4) 长序列——SONA 用 History Compression(深栈只跑近期 2048 事件);V2 用 SNT 在训练侧摊销、服务侧靠共享 KV cache。
- 可比的方法 / 实验差异:两者都没有在对方的数据上比较;SONA 的线上收益是音乐场景的 Active Users +4.53%、收听时长 +6.30%,V2 是电商 GMV/user +9.74%。两篇的共同弱点也一致:线上 A/B 都是"新系统整体 vs 旧级联整体",统一本身的收益占比都需要从离线消融中间接推断。
UniPinRec UniPinRec: Unifying Generative Retrieval and Ranking at Pinterest Scale (Pinterest, 2026-05-29)¶
关系:显式引用并作为粗排 baseline,但原文只报了 Table 2 数值、未做机制层对比 · 已加载对方精读
- 共同关注的问题:同一 root cause——检索与排序都用大 Transformer 编码同一段用户历史,参数、训练算力、服务成本三重重复;两者都选择保留漏斗而非 OneRec 式端到端替换,并强调可逐阶段 A/B 与回滚的运维可控性。
- 相近的技术骨架:都是"一个共享骨干 + 召回目标与排序目标单阶段联合训练 + 跨阶段 KV cache 共享"。UniPinRec 的候选位置注意全部 past 位置、候选之间互相屏蔽(M-FALCON 式),与 V2 的 stage visibility mask(stage token 注意锚点前缀、不同阶段/exposure 互相屏蔽)是同一个注意力模式;两者服务时都是"检索算好的用户历史 KV → 排序以 $O(nk)$ 复用"。
- 本文的差异与推进:(1) UniPinRec 的召回是 ANN 点积(sampled softmax),V2 是 SID 生成式召回 + DCGR 多目标;(2) UniPinRec 只统一检索 + 轻量 L1 排序(L2 精排是后续扩展),V2 覆盖到精排并加入 fine→pre 蒸馏;(3) UniPinRec 用 Masked Action Modeling 把动作沿特征轴拼到 item 上,不引入异构非序列特征 token;V2 沿用 V1 的混合参数化,让精排保留多 token 的异构特征交互;(4) V2 额外带 MoE/μP 的 scaling 配方与 SNT。
- 可比的方法 / 实验差异:Table 2 中 UniPinRec 粗排 CTR AUC 0.8046 / CTR UAUC 0.7212 / CVR AUC 0.9113 / CVR UAUC 0.7506(325 GFLOPs),V2S 为 0.8053 / 0.7372 / 0.9128 / 0.7534(239 GFLOPs)——除 CTR UAUC 外,V2S 对 UniPinRec 的粗排边际仅 +0.09%~+0.37%,远小于它对 OneTrans-Lite 的边际。UniPinRec 在自家生产报告的是 KV 复用 >3× 排序前向加速、e2e 延迟 −11.1%、QPS +63.6%;V2 的"共享上下文"部分贡献 1.53×,量级相近。
Multi-Decoder OneRec Multi-Decoder OneRec: Controllable Generative Retrieval for Multi-Objective Recommendation (Kuaishou, 2026-07-29)¶
关系:独立并发(本文未引用 Multi-Decoder OneRec,两者在"多路召回合并进一个生成式召回器"这一子问题上殊途同归)· 已加载对方精读
- 共同关注的问题:工业召回为不同业务目标维护多条专用通道(快手:watch-time / 互动 / 冷启;字节电商:主通道 / 发现 / 广告),建模、训练、服务随路数线性碎片化;而"单 decoder + task token"式的统一生成器又会让各目标耦合、候选重叠。两篇都要一个共享建模、同时保留对目标组成的显式控制的统一生成式召回器。
- 相近的技术骨架:都是"共享用户上下文只编码一次 → SID 自回归生成 → 目标特定的条件化 → beam search 时施加可在线调的控制"。两者都拒绝"在输入端外部喂 task token"这种轻量条件化(Multi-Decoder OneRec 批评它"只改变共同策略如何被条件化",V2 批评 UniSGR 的 task token"由外部设定而非从序列预测")。
- 本文的差异与推进:控制放在哪里完全不同。Multi-Decoder OneRec 走参数隔离路线:每个目标一个 LoRA 专家 + 独立 BOS + SID embedding 残差,梯度在共享基座处截断,推理时用配额 + 前缀屏蔽的 MD-CBS 协调多条路线、General Decoder 最后回填——本质仍是"多路",只是共享了基座。V2 的 DCGR 走决策空间路线:只有一个 decoder,目标变成决策前缀空间里的区域,控制量是一个连续的 $\beta$ 偏置(KL 正则的策略改进),没有配额、也没有目标专属参数;新增目标只需一个 decision head。前者对候选组成的控制更硬(配额精确),后者更软但更省(无额外 decoder 计算)。
- 可比的方法 / 实验差异:Multi-Decoder OneRec 对连续 watch-time 目标用 L-GBPO 策略优化(有 RL 成分),V2 的 DCGR 完全是日志监督的 teacher forcing + 推理期偏置,刻意避免 reward model 与 off-policy 修正。两篇都没有互相比较;V2 缺一个"每目标一个 decoder/专家"式的强对照,只和已部署的独立通道比了"通道 vs 通道"的原生指标。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
- "切在重复与私有之间,而不是切在阶段边界"是一个清晰、可复制的系统设计原则。它不追求把级联压成一次生成(OneRec 路线),而是承认精排的交叉特征无可替代,只把 candidate-independent 的部分共享。这让方案可以渐进落地,风险远低于端到端生成式替换。
- SNT 与 request 相对时间 RoPE 的组合很漂亮:append-only + 因果编码 ⇒ 一次编码包含所有前缀,再用时间差旋转使同一份 key 服务不同时刻的 request。4.4× 训练加速、−95% 序列存储是实打实的工程收益。
- 稳定化章节是全文信息密度最高的部分:RMSProp 缺偏差校正导致高方差、吞掉加宽收益;QKNorm、μP、Depth-μP 各自把 scaling 从"无效"变为"有效"。对任何还在用 RMSProp 训练大排序模型的团队都直接可用。
- 多模态 embedding 注入方式取决于容量的发现提醒:小模型时代的特征工程最佳实践(SimTier)在大模型下可能反成次优。
- DCGR 的形式化把"多目标召回"与 Decision Transformer / AWR 的 KL 正则策略改进联系起来,给出了一个不用 RL、不用 reward model 的可控召回方案,且 $\beta$ 可在线调,运营价值明确。
局限与争议(按本档案的判读规则)¶
- "统一三阶段"到底统一了什么:服务时仍是 retrieval → pre-rank → fine-rank 三次独立的候选侧计算,stage token 互相屏蔽、不读彼此的中间表示;实际共享的是一份用户序列 KV cache + 一套参数 + 一个训练作业。这更准确的描述是"共享 trunk 的三任务多任务学习 + 服务侧 KV 复用",与 UniPinRec、SONA 的"encoder 算一次、多头读取"是同一骨架。标题与摘要里的"unifies the entire cascade"容易被读成级联被替换,实际上级联完整保留。
- 在线 A/B 的对照是整条级联(含 V1 精排),不可分解:+9.74% GMV 混合了 2.4× 服务算力、MoE/μP/AdamW/gated attention/多模态 embedding 配方、DCGR 替换 OneTrans-GR、联合训练与 KD。没有任何"V1 精排 + 同样的 scaling 配方"或"不统一只 scaling"的在线/离线对照。按离线消融估算,联合训练对精排 CTR UAUC 的贡献(+0.31%)只占 V2L 对 V1 总边际(+2.31%)的约 1/7,而 MoE(+0.30%)、多模态 embedding(+0.33%)、sigmoid router(+0.20%)单项都与之同量级——"统一"是本文的叙事核心,但多数离线收益来自与统一正交的 scaling 配方。
- fine→pre 蒸馏的"模型内"增益没有被隔离:去掉 KD 使粗排 CTR UAUC −0.97%,但这测的是"有无 KD",而 fine→pre KD 在分离级联中早已可行;§7.1 的分开训练对照同样接受了独立 teacher 的 KD,所以"模型内 vs 模型外"的差异最多就是联合训练那 +0.17%~+0.28%,且与共享上下文不可分。一致性指标同样是合并效应,且只报 CTR。
- DCGR 的离线证据属于"引入新信号 ≠ 收益来源":Figure 8(a) 的 HR@1 增益是 teacher forcing 喂入真实交互结果得到的($z_{ad}$ 的 +20.5% 本质是"告诉模型这次是广告"),不是预测前缀带来的;Figure 7/Table 4 是通道对通道、含曝光重分配(主通道 GMV +48% 主要来自曝光 +69.3%,千次曝光订单 −34%);系统级 Table 6 的业务偏置 GMV 只有 −0.6%~+3.0%。缺少"同骨干下 DCGR vs 纯 SID 召回、自由解码"的离线对照,也缺少与"每目标独立 decoder/LoRA 专家"式强基线(如 Multi-Decoder OneRec)的比较。
- "生成式推荐设计不彻底"规则:本文不是端到端生成式推荐,召回侧的训练(teacher forcing 的 MLE)与推理(预测前缀 + 偏置)不一致是 Decision Transformer 家族的有意设计,且作者给出了 KL 正则解释,因此该降档规则不直接适用。但类比意义上,"统一"停在共享 trunk、阶段间无信息流,属于"只统一了一半"。
- 工业证据的质量:有真实的 50% 流量 A/B 与 3.2× QPS,属于实打实的工业证据;但 3.2× 中只有 1.53× 属于"统一",另外 2.16× 的 kernel 融合与 FP8 可以同样用于原级联每个模型;两阶段 top-$k$ 的 19.7× 是对自家单阶段实现、而非对已部署召回 baseline。
- baseline 复现的公平性:UniSGR 在召回与精排上都低于自家生产模型,UniPinRec 的召回被排除;两个外部 baseline 均为自行复现、映射到不同阶段,调参细节未披露。粗排对 OneTrans-Lite 的 +4.65% 很大程度是 4 GFLOPs vs 数百 GFLOPs 的算力差;对同为统一框架的 UniPinRec,V2S 的边际在 CVR 上只有 +0.16%~+0.37%。
- 只报 CTR:几乎所有消融只报 CTR 指标,而电商的核心是 CVR 与 GMV;精排实际有远多于 CTR/CVR 的目标,但只评估了这两个。
与 V1 的关系:V2 到底加了什么¶
V2 真正新增的是三件事:(i) 把 V1 的"S 共享 / NS 私有"混合参数化外推到跨阶段(S 跨阶段共享,各阶段 NS token 私有)+ stage visibility mask;(ii) DCGR 召回;(iii) SNT 训练组织。其余大头——MoE、μP、AdamW、QKNorm、gated attention、多模态 embedding——是把 LLM scaling 配方搬进 V1 骨架,与"统一"无关,但贡献了主要的离线指标增益。V1 的金字塔裁剪在 V2 中没有再出现(服务侧改由共享 KV cache 与 FP8/kernel 融合承担效率)。
工业落地价值¶
对已经有 OneTrans/HSTU 式 Transformer 精排、且召回与粗排也逐步 Transformer 化的团队,这篇给出了一条低风险的整合路径:先共享序列 encoder 与 KV cache、联合训练,保留每阶段的原生特征与候选缩减;再用决策前缀把多条召回通道收拢。最大的收益来源(从本文数据看)是"整合后才值得投入的 scaling 配方 + 服务栈优化",而非联合训练本身带来的表征增益。