SONA 技术报告:为 Yandex Music 打造的单模型生成式推荐器¶
Sona Team(Yandex,贡献者含 Daria Tikhonovich、Oleg Sorokin、Vladislav Dodonov、Mariia Ulianova、Ilya Murzin、Anna Lipkina、Viktor Yanush、Denis Burshtein、Nikolai Savushkin、Artem Matveev、Kirill Golovko 等 34 人),arXiv 2608.11015v1,2026-08-11。场景:Yandex Music 智能音箱上的 My Vibe 无限个性化音乐流。
研究动机与背景¶
工业推荐的标准形态是多阶段级联。Yandex Music 的生产级联包含 15 个以上候选生成器,加上消费数百个特征的粗排与精排模型,而这些特征本身还来自 Argus 这类大型 transformer 与 target-attention 打分器。SONA 要回答的是:能不能用一个端到端训练、端到端服务的模型把整条链路替掉,并且更好。
音乐域与短视频、电商的三点差异塑造了 SONA 的设计:消费是被动的(流持续播放而注意力在别处,反馈以 play / skip / 偶发 like 到达);重复收听是常态(回到熟悉曲目常常正是用户想要的,重复是要建模的信号而非要过滤的冗余);二者叠加成核心张力——熟悉曲目稳定支撑时长,新 favorite 的发现要更长周期才兑现。测试面是智能音箱上的 My Vibe:播放开始时用户不指定艺人、流派、心情或任何偏好,是纯推荐设置,也是按收听时长计最大的界面之一。
论文在 §2.1 把设计哲学拆成六条:一个模型同时做生成与排序;一份用户表征跨任务共享——encoder 代价每请求只付一次,作者写道"我们因此采用 Gryphon [28] 这一统一 generate-and-rank 设计作为 SONA 的架构";不使用任何手工特征(SONA 与 teacher 都只吃 logged event 字段与学出来的 SID);排序需要稠密监督(NTP 每个位置都产生目标而显式反馈稀疏,无手工特征的 ranker 必须从数据里把这些结构学回来);把一年历史压进 teacher、再稠密蒸馏进 student——请求级 NTP 数据集每条样本都要重编码整段历史只为监督少数新目标、无法覆盖数月跨度,解法是让大 ranking 模型在整年日志上自回归训练把历史压进权重,再蒸馏进只用数周窗口训练的 Ranking Module;用 Rollout Distillation 对齐生成与排序——蒸馏候选来自当前 decoder 的 rollout,信号跟随模型当下的候选分布,又因两模块共享 encoder,同时塑造它们共同条件化的表征。
Figure 1(原文首页柱状图):My Vibe 智能音箱上历代 transformer 部署的增量 A/B 提升(%),收益逐代叠加:
| 部署 | Active Users | Total Listening Time | Likes |
|---|---|---|---|
| V0 | +0.56 | +1.81 | 0.00 |
| V1 | +0.73 | +1.23 | +2.71 |
| V2 | +0.84 | +1.46 | 0.00 |
| Argus | +1.93 | +3.69 | +10.76 |
| SONA | +4.53 | +6.30 | +11.42 |
与 Gryphon / Gryphon-v2 的系统谱系关系¶
本文标题极其泛化,必须先厘清它在 Yandex Music 生成式推荐谱系里的位置。结论是:SONA 是同一支团队 Gryphon → Gryphon-v2 路线的直接后继与系统级总报告,证据三条:
- 架构继承是明写的:§2.1 说 "We therefore adopt Gryphon [28], a unified generation-and-ranking design, as the architecture of SONA",§3.5 又说 Ranking Module "following the unified generation-and-ranking design of Gryphon [28]";引用 [28] 即 arXiv 2606.08604(Gryphon v1)。
- 术语继承自 v2:"Rollout Distillation" 是 Gryphon-v2 标题里的自造术语,SONA 全文用了 3 次却没有引用 2608.06213(v2 比本文早 5 天挂出)——同一团队复用自家术语的典型痕迹。
- 决定性的数值证据:SONA 的 Experiment 4(distilled model 单独替掉整条级联)报 TLT +1.62%、Likes +7.12%、"Repeat" +15.25%、Active Users +1.41%,与 Gryphon-v2 Table 2 的线上 A/B 逐项完全一致——Gryphon-v2 报告的那次 A/B 就是 SONA 的 Experiment 4。
SONA 相对 v2 的增量因此很清晰:(a) 历史从 2,048 扩到 8,192 事件并引入 History Compression(Exp 5 相对 Exp 4 的主要差异,AU 从 +1.41% 跃到 +4.53%);(b) tokenizer 的 item 表征从 CLMR 音频嵌入换成 Qwen2.5-Omni 音频 + 元数据再协同精炼;(c)(d)(e) 补上 Teacher Ranker 设计消融、在线训练闭环工程细节、容量与数据量 scaling 曲线。v2 是"把 teacher 蒸馏进服务模型"这一个方法点的论文,SONA 则是把 tokenizer、架构、teacher、蒸馏、基础设施、五组 A/B 串成完整流水线的系统技术报告。
核心方法:SONA 架构¶
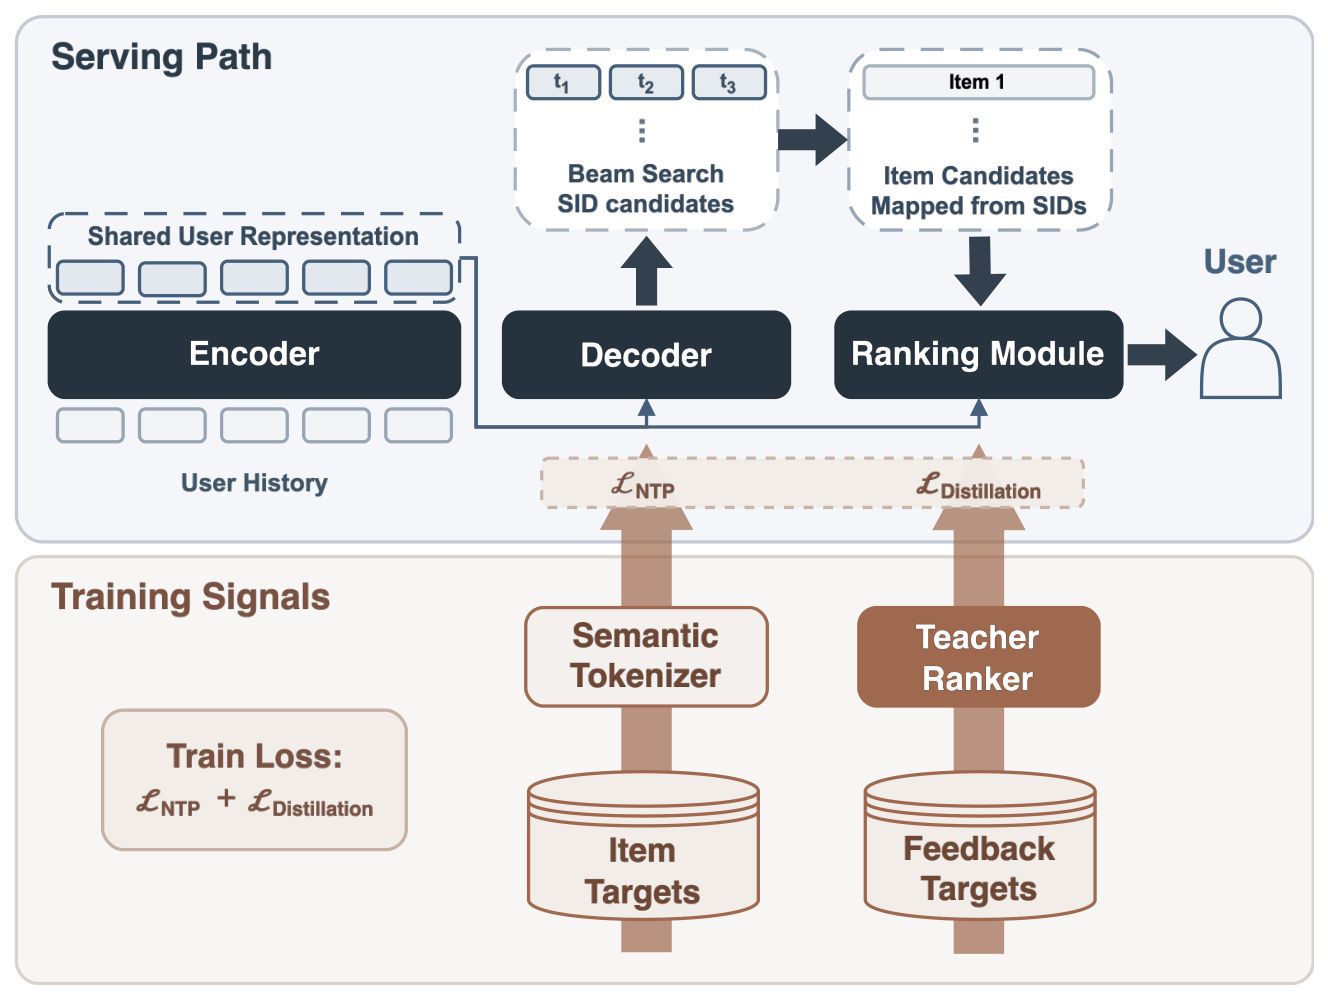
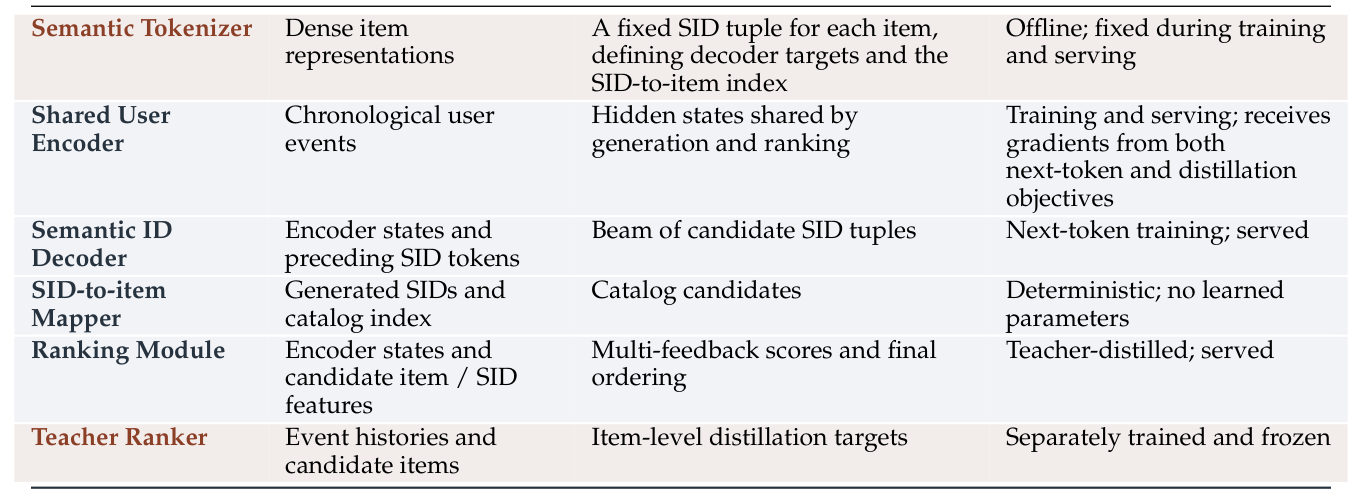
服务时 encoder 把时序事件历史编码一次,产出 decoder 与 Ranking Module 共享的表征;decoder 自回归产出一束短 SID 元组,目录索引把元组映射到一个或多个曲目,Ranking Module 用同一份 encoder 状态给展开后的候选打分排序。训练时 tokenizer 把每个目标 item 转成 SID 序列提供 NTP 目标,冻结 Teacher Ranker 给 decoder 生成的候选打分提供蒸馏目标,两个损失都回传进共享 encoder。最终配置下 tokenizer 与 teacher 只在训练期存在,服务侧只有 encoder + decoder + 确定性 SID→item 映射 + Ranking Module。各组件的消费/产出/生命周期见原文 Table 2.1:
语义 tokenizer¶
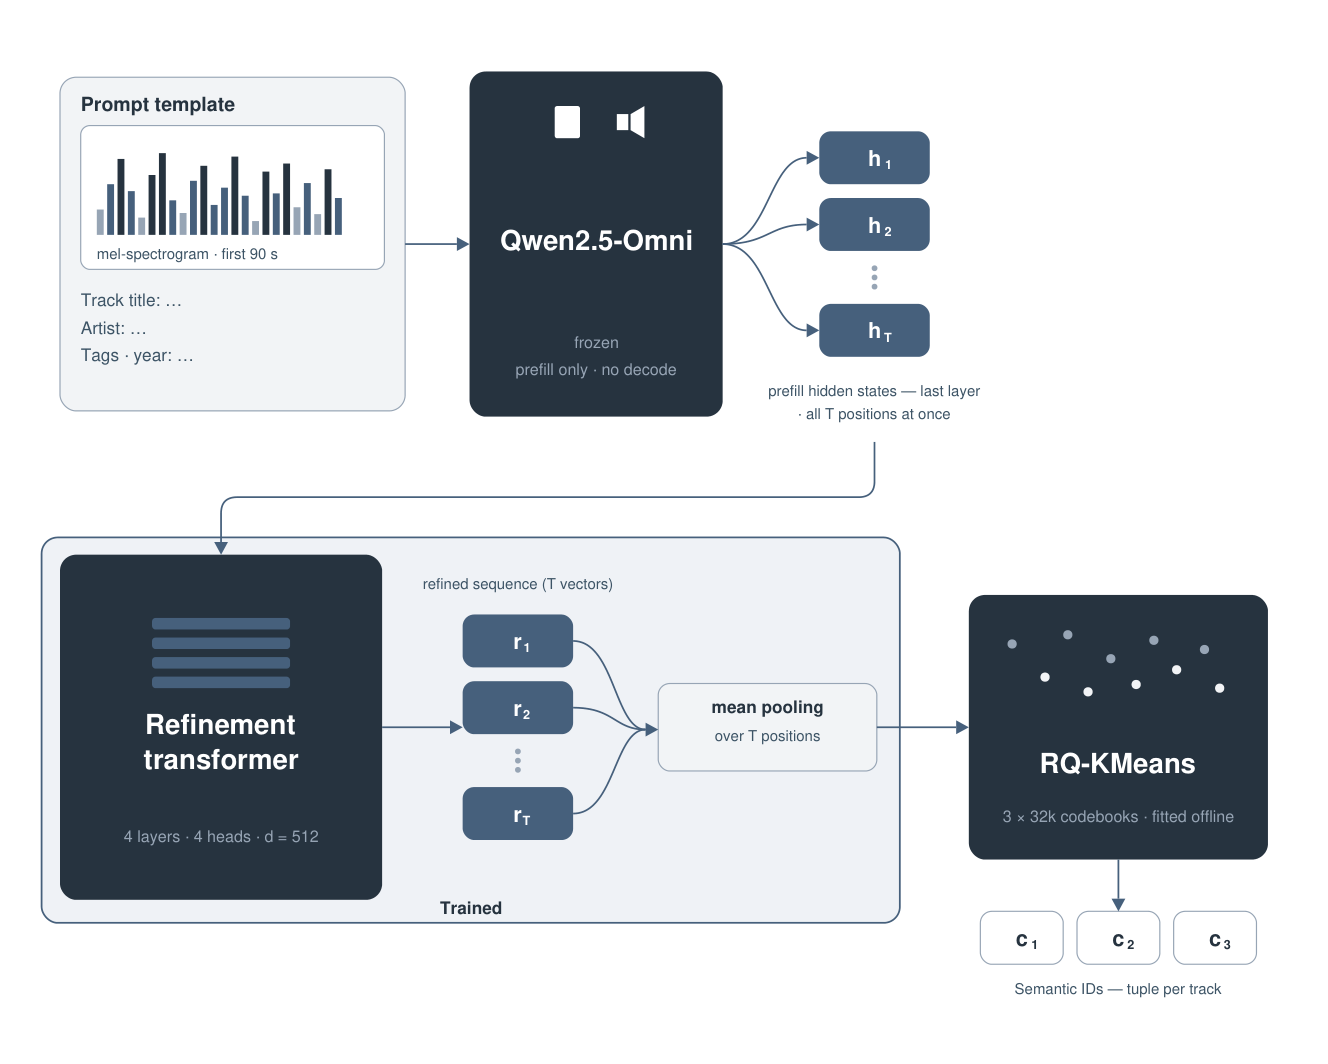
tokenizer 给每首曲目分配固定的 3 个 Semantic ID(3 个各 32,000 条目的码本),离线分三阶段构建。(1) 内容特征:冻结的 Qwen2.5-Omni 对前 90 秒音频的 mel 频谱图 + 携带标题/艺人/标签的文本 prompt 做仅 prefill、不解码的前向,取最后一层状态。(2) 协同精炼:内容特征会让"可替代性"隐而不显——听众视为可互换的曲目在内容空间未必相邻,因此一个 4 层 4 头、维度 512 的精炼 transformer(QARM 风格)在协同相关曲目对上训练,mean-pool 成 256 维 item 嵌入 $z$,损失为:
$$\mathcal{L} = \mathcal{L}_{\text{InfoNCE}} + \lambda_{\text{align}} \mathcal{L}_{\text{align}} \tag{1}$$
一个 batch 含 $m$ 个协同对,产出 $2m$ 个精炼 item 嵌入 $z_a$;每个各当一次 anchor,其配对 $z_{a^+}$ 为正样本,其余 $2m-2$ 个为负样本:
$$\mathcal{L}_{\text{InfoNCE}} = -\frac{1}{2m}\sum_{a=1}^{2m} \log \frac{\exp\!\big(\mathrm{sim}(z_a, z_{a^+})/\tau\big)}{\sum_{b \neq a}\exp\!\big(\mathrm{sim}(z_a, z_b)/\tau\big)} \tag{2}$$
对齐项把 item 嵌入拉近同一曲目内容特征的均值 $\bar h_a$:
$$\mathcal{L}_{\text{align}} = \frac{1}{2m}\sum_{a=1}^{2m}\big\| z_a - \bar h_a \big\|^2, \qquad \lambda_{\text{align}} = 0.1 \tag{3}$$
协同对来自两条互斥的流:target-wise 流收集生产推荐器的共同曝光 item 集合——因为生产推荐器不在同一次响应里放同艺人曲目,这些共现按构造是跨艺人的;NPMI 流用归一化点互信息给共听打分:
$$\mathrm{NPMI}(i,j) = \frac{1}{-\log p(i,j)} \log \frac{p(i,j)}{p(i)\,p(j)} \tag{4}$$
$p(i,j)$ 是三个月窗口内两曲目在同一用户日志里共现的概率;只保留同艺人的高 NPMI 对,故两条流不相交。
Table 3.2:tokenizer InfoNCE 目标的协同对来源
| 对来源 | 挖掘窗口 | 对数 |
|---|---|---|
| Target-wise(共同曝光,跨艺人) | 3 周 | 220–240M |
| NPMI(共听,同艺人) | 3 个月 | 20M |
(3) 残差量化:精炼后的 $z$ 用残差 K-means 映射为 SID 元组——3 层各 32,000 质心、k-means++ 初始化、欧氏距离分配,每层量化上一层残差,元组是穿过码本的粗到细路径。
用户历史表示¶
一次请求的历史是时序序列 $u = (e_1, \dots, e_T)$,$T \le T_{\max}$,训练与服务用同一套选择规则。每个事件被三个 embedder 编码:
Table 3.3:历史事件特征与三个输入 embedder 的变换
| Embedder | 源信号 | 构造方式 |
|---|---|---|
| Item | track ID、artist ID、track duration | track ID 哈希 3 次、artist ID 哈希 2 次进同一张共享嵌入表;track duration 分桶后嵌入 |
| Context | 智能音箱标志、organic-feed 标志 | 直接嵌入两个请求面标志 |
| Feedback | like 标志、played time | 嵌入 like 标志;played time 除以时长得完播率,分桶后嵌入 |
两个连续量都分桶后嵌入而非当作裸标量,完播率为:
$$\rho_t = \frac{p_t}{\max(d_t, \epsilon)} \tag{5}$$
item embedder 把 5 个哈希身份特征与时长嵌入拼接后投影到 $\mathbb{R}^d$,另两个 embedder 在宽度 $d$ 上直接嵌入并求和;事件 token 是三者之和:
$$x_t = \mathrm{ItemEmb}(e_t) + \mathrm{ContextEmb}(e_t) + \mathrm{FeedbackEmb}(e_t) \tag{6}$$
再前置一个可学 CLS token 作为全局汇总位:
$$X = [\,x_{\mathrm{CLS}}, x_1, \dots, x_T\,] \tag{7}$$
Encoder 与 History Compression¶
完整 encoder 的输出为
$$H = \mathrm{Enc}_\theta(X), \qquad H \in \mathbb{R}^{(T+1)\times d} \tag{8}$$
decoder 与 Ranking Module 消费的是每请求只算一次的共享 encoder memory $K$:完整 encoder 下 $K = H$,而 History Compression 不构造全深度的 $H$。
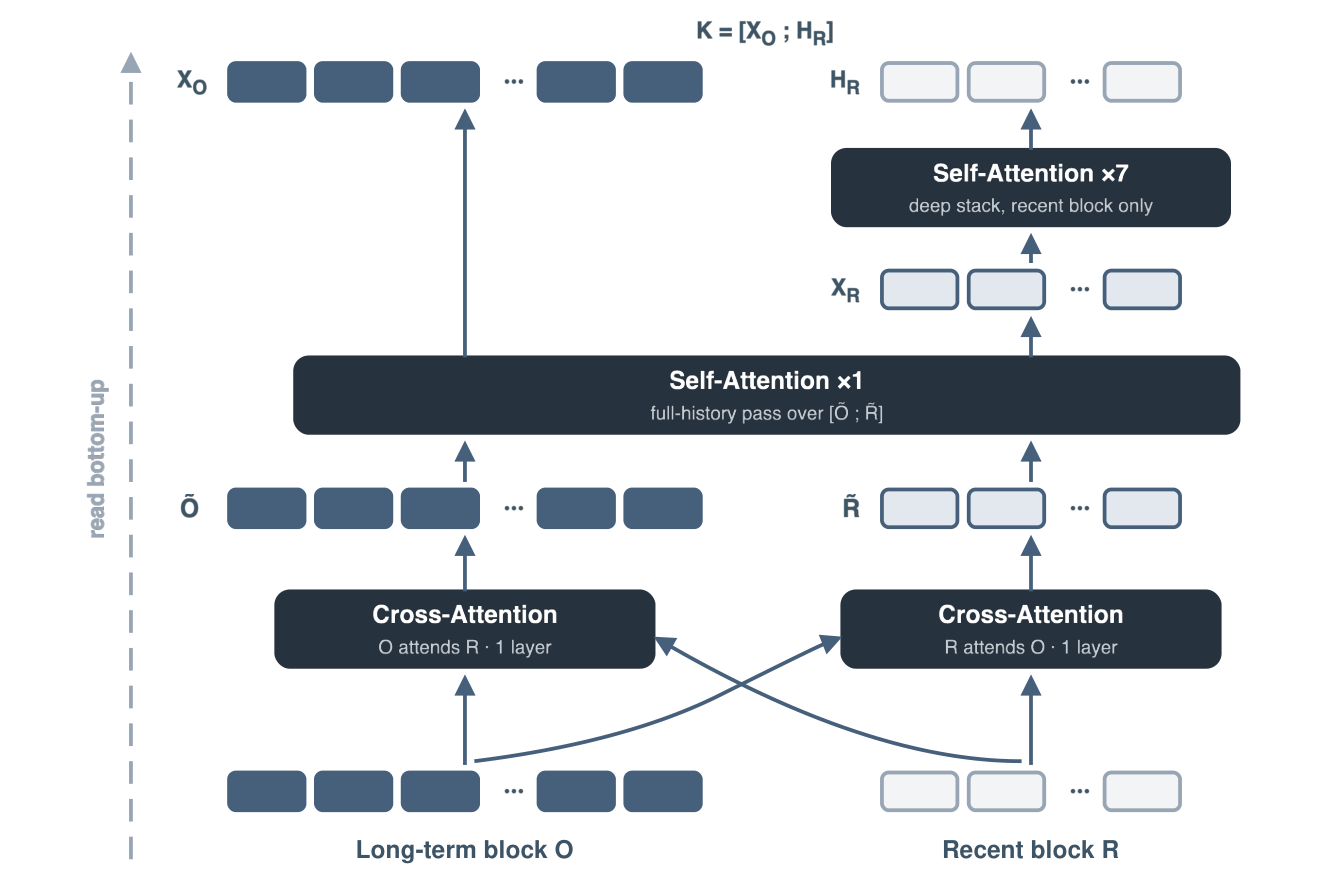
注意力代价随历史长度二次增长,长历史在服务延迟预算下的可负担性是工业用户模型的老问题。SONA 因此不均匀地花深度:把至多 $N$ 个事件切成最近 $n_r$ 个的 recent block $R$ 与前面 $n_o = N - n_r$ 个的 long-term block $O$,分四步:(1) 交叉注意力——两个单层 cross-attention 块让两块互读,得到 $\tilde O$、$\tilde R$;(2) 全历史 pass——一层 self-attention 跑在 $[\tilde O; \tilde R]$ 上得到 $X_O$、$X_R$,这是唯一一处跨整段历史混合信息的阶段;(3) 深栈只跑 recent block——7 层 self-attention(承载绝大部分容量)只在 $n_r$ 个近期事件上精炼 $X_R$ 得 $H_R$;(4) 拼接读出:
$$K = \big[\, X_O \,;\, H_R \,\big] \tag{9}$$
于是全部 $N$ 个位置下游都可见,但只有近期 $n_r$ 个携带深度编码。完整 $L$ 层 encoder 的注意力代价是 $\Theta(L N^2 d)$,而这里只在 recent block 上付深度代价:
$$\Theta\big((L\,n_r^2 + N^2 + 2\,n_o n_r)\,d\big) \tag{10}$$
作者强调节省来自容量花在哪里,而非丢弃历史。取 $N = 8192$、$n_r = 2048$,约一半推理成本保住了完整 transformer 的大部分下游表现。所有 block 用 RMSNorm 前置归一化、SwiGLU FFN、RoPE。
Decoder¶
tokenizer 把每首曲目映射为 $L = 3$ 级 SID 元组 $s(v) = (s_1(v), \dots, s_L(v))$。decoder 是码本词表上的浅层自回归 transformer(2 层),从 BOS 出发逐级生成:
$$p_\theta(s_1, \dots, s_L \mid u) = \prod_{\ell=1}^{L} p_\theta\big(s_\ell \mid s_{<\ell}, K\big) \tag{11}$$
服务时用 tokenizer trie 约束的 beam search 屏蔽非法前缀,保证每个完成的元组至少映射到一首曲目。码本不是无碰撞的(一个典型元组被少量曲目共享,这是 Semantic ID 形式化的内禀性质),因此每个元组被展开成整个碰撞类交由 Ranking Module 排序。
Ranking Module¶
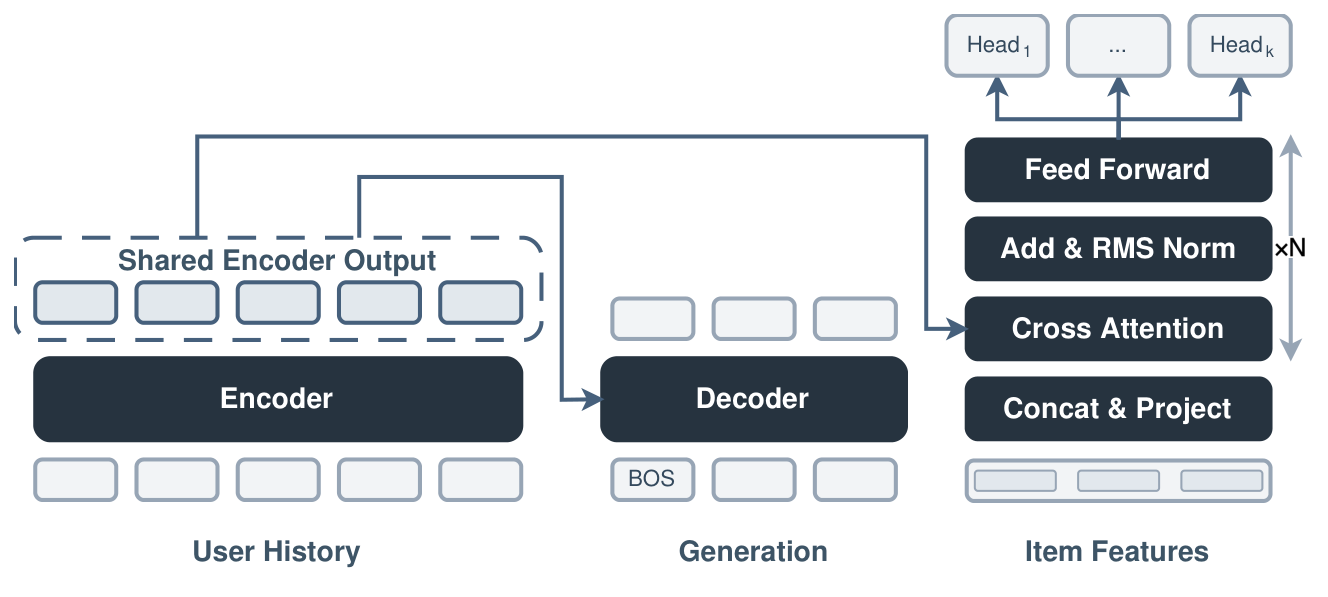
Ranking Module 用 decoder 所 attend 的同一份 $K$ 给每个候选打分,不引入第二次 encoder 前向。候选由三类特征表示:item ID、独立看待的各级 SID 码 $c_1, \dots, c_L$、及其前缀 $n$-gram;按 Coleman 等人的 unified-embedding 方案,每个特征经若干独立哈希映射进与 encoder 共享的嵌入表,取出的行拼接后投影成稠密向量 $e_i$。打分沿用 decoder 架构的前置归一化 cross-attention 栈:
$$\tilde e_i = \mathrm{CrossAttnBlocks}(e_i, K) \tag{12}$$
$$s_i = \mathrm{Head}(\tilde e_i) \in \mathbb{R}^n \tag{13}$$
每个 head 对应 Teacher Ranker 的一个 head。服务时一个固定权重组合器把 $n$ 个 head 分数塌缩成标量,展开后的候选按它排序产出最终列表。
训练框架¶
数据集设计¶
数据集是请求级的:一条样本 = 一次被服务的推荐请求,携带请求前的时序历史与该请求的 impressions(带时间戳与后续反馈)。监督:tokenizer 把每个 impression 映射成 SID 元组,正样本构成 NTP 的打包目标集 $C^+(u)$(一次 encoder 前向、多个目标);完整 impression 列表是蒸馏的一个候选源,beam-search rollout 是另一个;不在 tokenizer 目录快照里的 impression 被 mask 出损失。时序组织:初始训练把请求切成日级表由旧到新消费,在线阶段按事件序消费请求流;两阶段都沿时间向前扫,每条样本只条件于其请求之前的事件。
联合目标与 Rollout Distillation¶
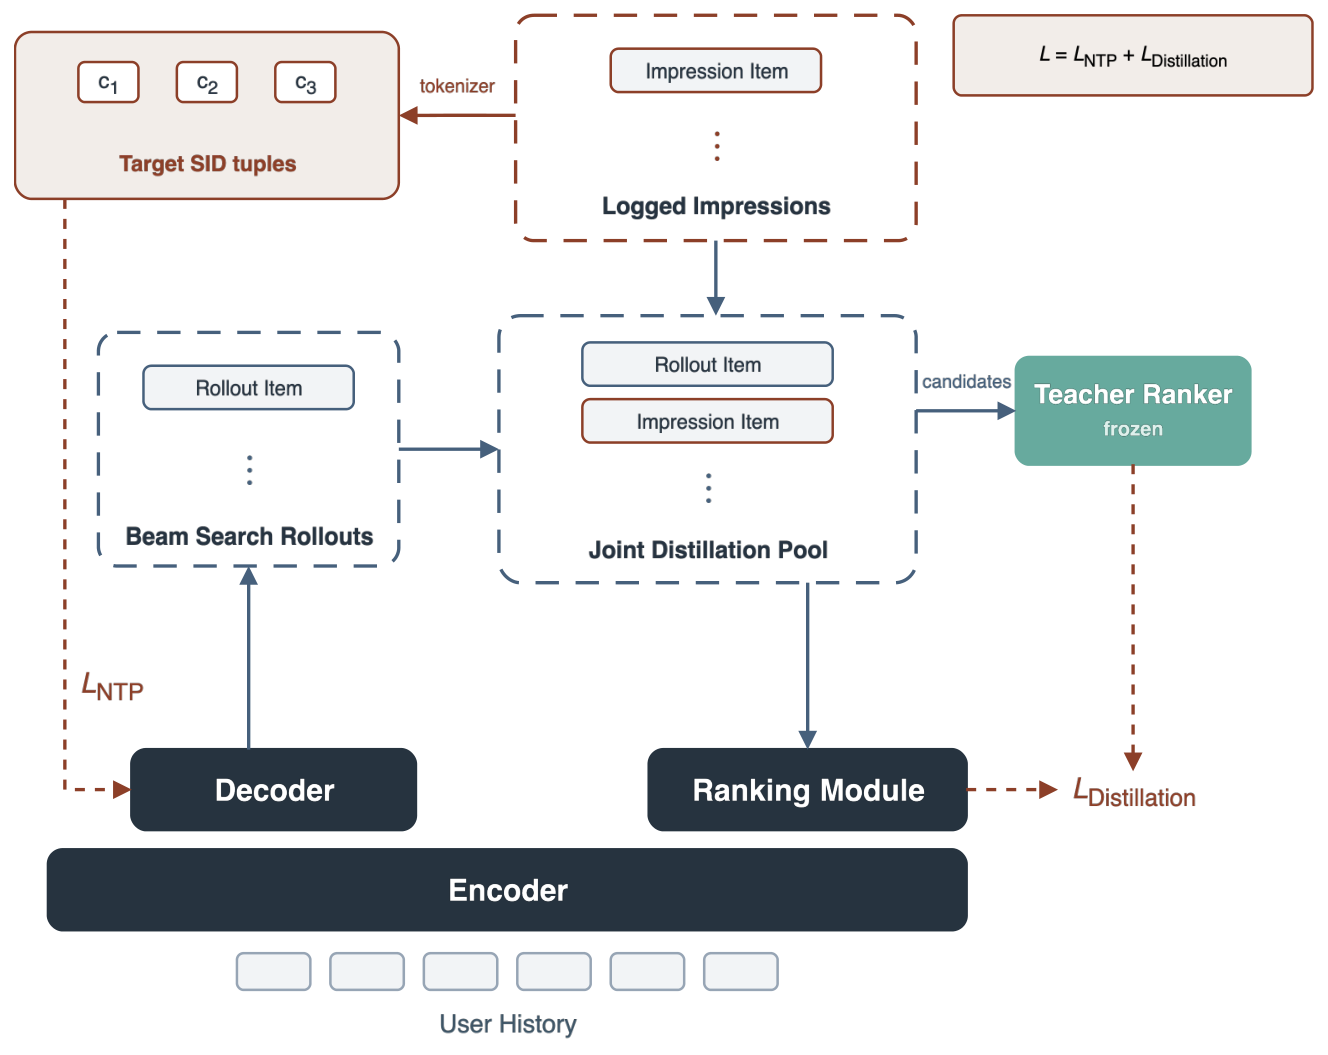
decoder 由 NTP 监督、只在每次请求的正 impression 上;encoder 每请求跑一次,每个正样本作为独立的 teacher-forcing 序列 cross-attend 共享表征。Ranking Module 由冻结 teacher 蒸馏监督:teacher 每候选暴露 $n$ 个互动分数,Ranking Module 用逐元素 MAE 回归。两个目标都回传进共享 encoder。
蒸馏对来自两个互补源:当前 decoder 的 rollout 与 logged impressions。beam search 用当前 decoder 生成 $B$ 个 SID 元组,能解析成目录 item 的构成 $\mathcal{B}$(解析失败的排除出损失),再用该请求的 logged impressions $\mathcal{I}$ 把监督拓宽到生产流量真实曝光过的 item。记 $r^h_c$、$\hat r^h_c$ 分别为 teacher 与 Ranking Module 对候选 $c$ 的第 $h$ 个 head 分数:
$$\mathcal{L}_{\text{rollout}} = \sum_{h=1}^{n} \frac{1}{|\mathcal{B}|}\sum_{c \in \mathcal{B}} \big| \hat r^h_c - r^h_c \big| \tag{14}$$
$$\mathcal{L}_{\text{impression}} = \sum_{h=1}^{n} \frac{1}{|\mathcal{I}|}\sum_{c \in \mathcal{I}} \big| \hat r^h_c - r^h_c \big| \tag{15}$$
$$\mathcal{L} = \mathcal{L}_{\text{NTP}} + \mathcal{L}_{\text{rollout}} + \mathcal{L}_{\text{impression}} \tag{16}$$
三项等权(1:1:1)。服务时的组合分数只用于重排 beam 候选,不进入任何训练损失。初始训练从随机初始化开始、按日级 chunk 时序消费(日间有序、日内打乱),走线性 warmup + decay;在线训练随后以恒定学习率消费到达的请求。FSDP 分片可训练参数,冻结 teacher 以 bfloat16 在每个 rank 上复制,不产生 all-gather 开销。
Teacher Ranker¶
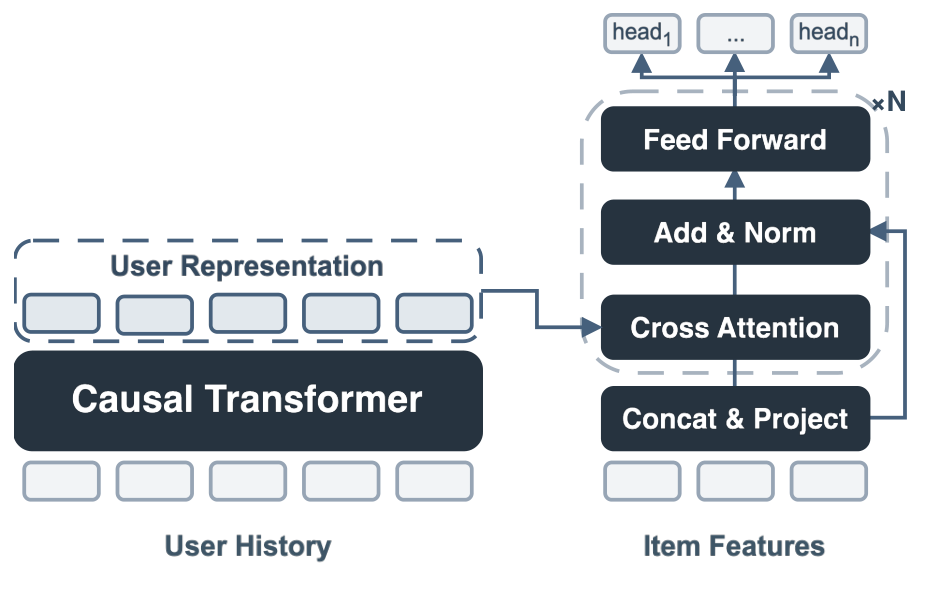
Teacher Ranker 是一个无手工特征的大型 ranker,只作为 Ranking Module 的蒸馏教师;摆脱服务侧预算后它更大且 attend 完整历史,并在线上实验中胜过生产 ranker。结构是"深度用户历史 encoder + 候选打分器"。与服务侧那一对有两点差异:encoder 是因果的(每个位置携带该点的用户状态,解锁自回归训练与时间线打包监督);不用 History Compression,深栈每层都 attend 完整历史。若干互动 head 各是收窄到标量的 MLP:一个提供主排序信号,其余是辅助反馈 head,经学到的逐 head scale 与 bias 还原成校准 logit。
数据集是时间线级的:单元是一段用户事件时间线,携带与 Table 3.3 相同的属性;预训练样本只含时间线本身、每个事件都是一个 next-item 目标,微调样本额外携带沿时间线服务出去的 impressions 与分级反馈。自回归消费:因果 encoder 在每个位置提供该点用户状态,打分器通过自定义 mask 只读到各自锚点之前的历史,一次 encoder 前向即监督整条时间线的全部目标。正是这种打包决定了可负担窗口:teacher 吃整整一年的目标事件,联合训练只消费数周。
预训练沿用 Argus 的自回归配方:每个位置从因果用户状态预测下一个互动事件,损失为 InfoNCE(in-batch 负样本混合均匀采样的尾部负样本池 + LogQ 校正),保留 encoder、丢弃预测 head。微调热启动 encoder、随机初始化挂上打分器,主目标是 pairwise:impression 映射到分级互动尺度 like > play > skip > dislike,用 logistic 损失排序时序相邻、等级不同的 impression。设 $P$ 为 $i$ 等级更高的有序相邻对集合:
$$\mathcal{L}_{\text{pair}} = -\frac{1}{|P|}\sum_{(i,j)\in P} \log \sigma\big(\mathrm{score}_{\text{pair}}(i) - \mathrm{score}_{\text{pair}}(j)\big) \tag{17}$$
对可在同一请求内构成、也可跨相邻两请求的边界,且只有推荐请求里服务出去的 impression 有资格。辅助目标是 pointwise,每个剩余 head 用 BCE 拟合一个二元反馈目标:
$$\mathcal{L}_{\text{teacher}} = \mathcal{L}_{\text{pair}} + \sum_k \mathcal{L}^k_{\text{BCE}} \tag{18}$$
自定义 cross-attention mask 用专门的 Triton kernel 实现;微调把 attend 的历史拉长到预训练长度之外(2k → 8k)。持续刷新:微调后 teacher 滚动到当下并每日在新日志会话上刷新,目标对收窄到它所监督的推荐界面以专门化信号。
训练与推理基础设施¶
训练优化:联合训练生成与排序、并在生成候选上评估冻结 teacher,三份计算共置在同一组 GPU worker 上。数据路径保持在关键路径之外(异步输入流水线预取、预处理、算 item 哈希);bfloat16 + FSDP + FlashAttention + torch.compile;数值稳定性靠 QK normalization、梯度裁剪与精调过的 warmup/decay。
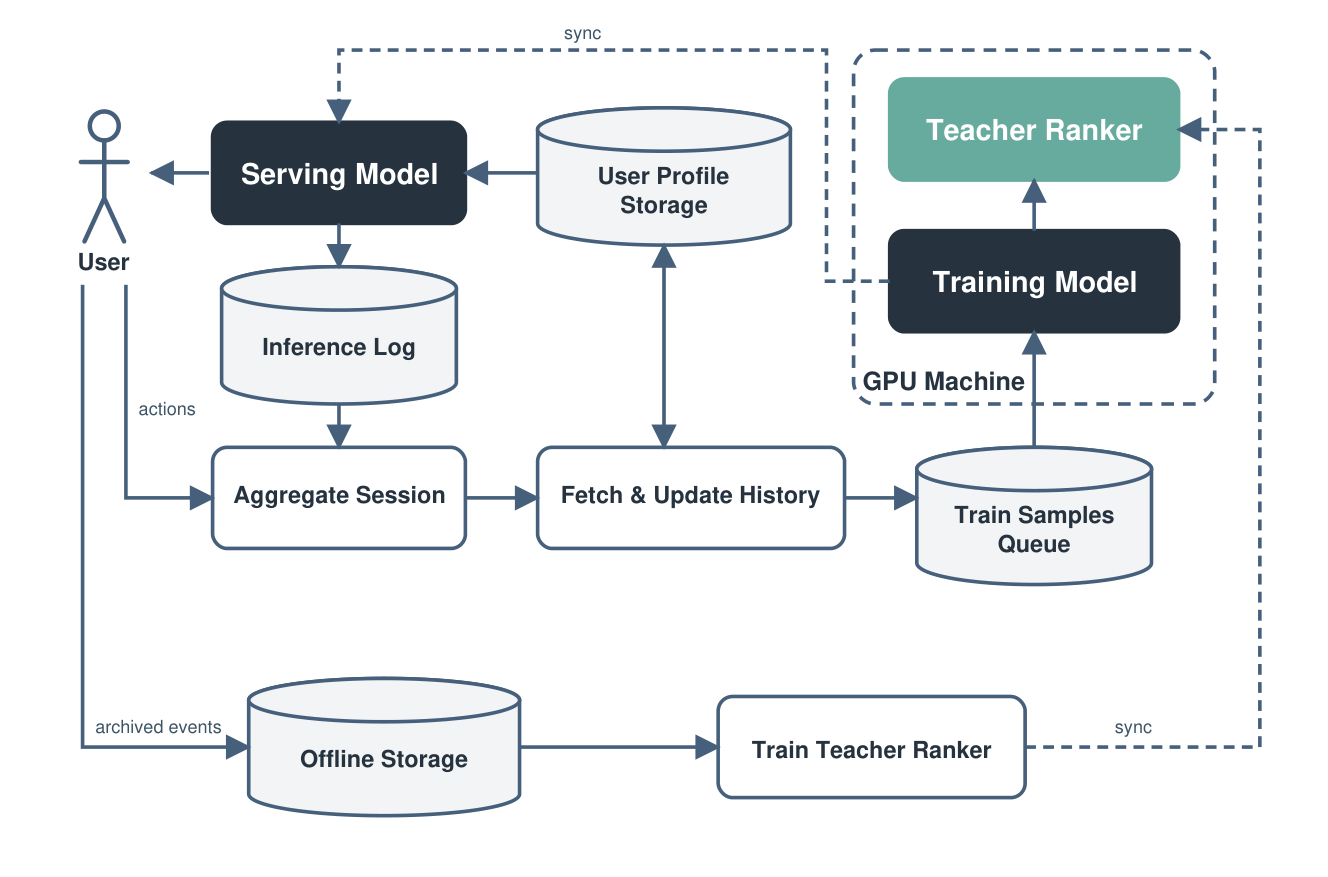
在线训练闭环:用户行为流进实时事件处理系统、按用户聚合成会话,与推理时上下文 join 后作为训练样本发出;GPU trainer 从消息队列消费并用 §4.2 的联合目标更新模型;模型每 10 分钟同步回服务,Teacher Ranker 每 24 小时刷新进 trainer。从事件发出到基于它训练的更新抵达服务,端到端中位 45 分钟、P99 60 分钟。几个工程要点:
- 会话聚合与流量过滤:会话由几分钟空闲 gap 与 15 分钟最小归因窗口关闭,该窗口同时充当正确性缓冲让 inference log 追上触发它的事件;发出的会话再过反欺诈、历史长度门控与模型黑名单(丢弃探针/评估模型的流量,否则与训练数据形成反馈闭环)。多个模型可同时注册各自的会话定义,一遍事件上并行跑多路在线更新。
- 用户画像双存储:批式重建的 KV 存储持长历史(尾部滞后),实时画像由事件流直写、持最近 72 小时且每用户上限 1000 条事件,读取时按时间戳合并去重——有界尾巴使流处理器不必持有完整 8192 事件历史。
- 历史 join 经由推理服务:训练样本只有在"展示给模型的历史 = 推理时看到的历史"时才有意义。推理服务在服务那一刻按请求 ID 写一条带截断时间戳的 inference log,聚合器按 session 标识 join 并打戳;历史本身不经事件流传播——聚合后的会话回投给推理服务,由它用与服务相同的计算重建样本。
推理优化:生成与 item 级排序由同一个 GPU worker 执行并共享编码后的用户状态,推理期 MFU 达 41%。三条路径(初始训练/在线训练/推理)共用同一套特征存储处理;Triton 的异步 CPU batcher 把变长历史补成固定形状,从而能把完整模型路径捕获成 CUDA graph;beam 1024 × 每级 32,000 logit 使 top-k 成为实质解码成本,改用 FlashInfer 的 radix 选择器;大 beam 解码产生大量"KV 长度至多 3"的单 token query,与默认 FlashAttention tile 不匹配,故用专门调过 tile 的 decoder attention kernel。
模型卡(附录 B)要点:Teacher Ranker——因果 encoder 10 层 + 打分器 6 层、隐维 1024、16 头、最大位置 8193、总参数 0.6B(嵌入表主导)、预训练 2k / 微调 8k、NIP in-batch 负样本 $2^{13}$。Ranking Module——4 层 cross-attention、FFN 4096、输出 2 个 teacher head 分数、每 prompt 32 rollout、损失权重 1:1:1。Encoder——7 层 recent + 1 层全历史 + 每方向 1 bridge、隐维 1024、16 头、FFN 2816、8192 总历史 / 2048 近期(+1 CLS)、共享哈希桶嵌入表 $2^{19}\times256$。Decoder——2 层、SID 词表 3×32,000、3 个不共享的 $\mathrm{Linear}(1024\to32000)$ 头。优化——AdamW、weight decay 0.1、裁剪 1.0、$10^{-5}\to3\times10^{-4}\to7\times10^{-5}$(3000 warmup 步)、有效 batch size 16,384。
实验设置:评估协议与指标¶
论文评估四个问题(Table 7.1 给出问题→被测模型→证据的映射):tokenizer/容量/数据量如何影响候选生成(仅 NTP 的 encoder–decoder);预训练/历史长度/打分器深度如何影响 Teacher Ranker(报 WPA);哪些选择让统一模型同时保住检索与 teacher 排序;最终配置线上是否提升互动。三个离线指标(均越高越好):
目标曲目 Recall@k——设 $n_i$ 为请求 $i$ 的目标曲目数、$m_i(k)$ 为前 $k$ 个解析出的预测中命中的目标数,指标是 $\min\{m_i(k), k\}/\min\{n_i, k\}$ 在留出请求上的宏平均;容量扫描改报匹配曝光下的训练 NTP 损失(越低越好)。
Teacher Recall@k(条件于候选生成的排序保真度)——对留出请求 $r$,decoder 产出候选池 $C_r$,Ranking Module 与 teacher 排同一个池:
$$\mathrm{TeacherRecall@}k = \frac{1}{|R|}\sum_{r \in R} \frac{1}{k}\Big| \mathrm{Top}_k\big(s^{(r)}_{\mathrm{RM}}; C_r\big) \cap \mathrm{Top}_k\big(s^{(r)}_{\mathrm{teacher}}; C_r\big) \Big| \tag{19}$$
无 Ranking Module 时由 decoder 似然提供顺序。
Weighted pair accuracy (WPA)——在时序相邻、目标权重不同的留出 impression 对上衡量互动排序,$t_i$ 为预定义目标权重、$P$ 含 $t_i > t_j$ 的对:
$$\mathrm{WPA} = \frac{\sum_{(i,j)\in P}(t_i - t_j)\,\mathbb{1}\{\mathrm{score}_{\text{pair}}(i) > \mathrm{score}_{\text{pair}}(j)\}}{\sum_{(i,j)\in P}(t_i - t_j)} \tag{20}$$
权重差越大的对贡献越大。
主要实验结果¶
候选生成(§7.2)¶
这组实验用只有 NTP 的 encoder–decoder,无 Ranking Module 也无 teacher;CLMR(对比训练的音频 encoder)提供纯音频基线。
Table 7.2:语义 tokenizer 消融(每个子表只变一个组件,共用同一留出集)
(a) 码本大小(固定 CLMR 嵌入)
| Codebook size | Recall@1000 |
|---|---|
| 3 × 8,192 | 0.8036 |
| 3 × 32,000 | 0.8111 |
(b) item 表征(固定三层 32,000 码本)
| Item representation | Recall@10 | Recall@100 | Recall@1000 |
|---|---|---|---|
| CLMR audio embedding | 0.1848 | 0.4712 | 0.8111 |
| CLMR + collaborative projection | 0.2005 | 0.4873 | 0.8139 |
| Qwen2.5-Omni + collaborative refinement | 0.2171 | 0.5362 | 0.8524 |
分析:两条轴都指向"更大码本 + 更强的多模态 + 协同精炼",但收益分布很不均匀——从 CLMR 到 Qwen2.5-Omni + 精炼,Recall@1000 只涨 5.1%,Recall@10 却涨 17.5%:tokenizer 质量主要改善 beam 头部的精度而非召回上界。只加协同 InfoNCE 残差投影提升很小,说明换掉内容特征来源比在旧特征上做协同后处理更关键。
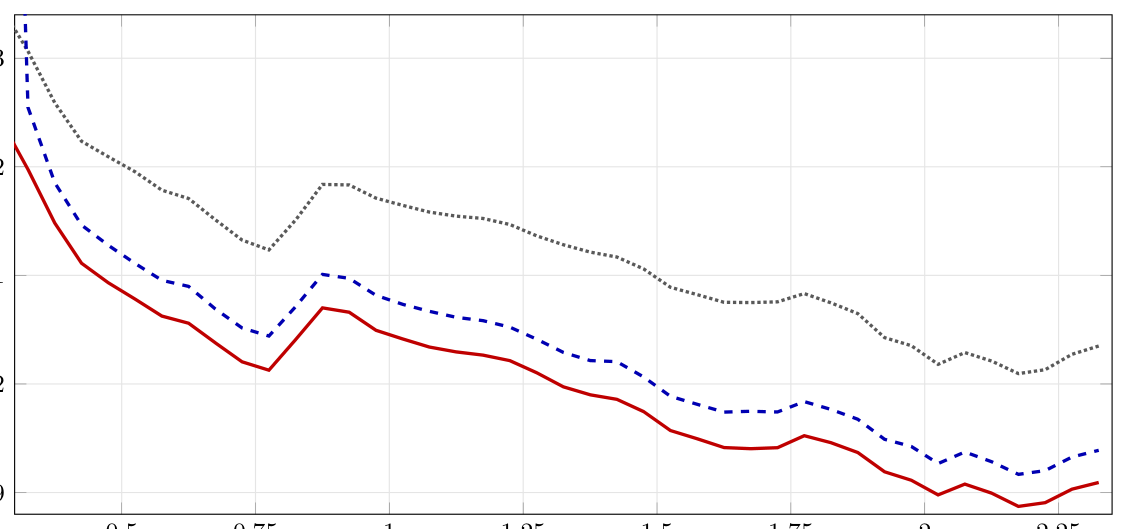
模型规模:固定层分配、数据窗口、目标与 8192 事件历史,Small / Medium / 2× Medium 的核心参数为 20M / 130M / 260M(含嵌入与输出头则为 264M / 485M / 659M)。在 0.5–2.25 billion 累计打包目标的曝光区间内,增大容量一致地降低训练 NTP 损失,三条曲线未交汇。
Table 7.3:固定 Medium 骨干与 2k 历史,训练数据窗口变化时的训练损失与召回(每次运行在自己的窗口上做一遍时序单 pass)
| Training window | Train loss | Recall@10 | Recall@100 | Recall@1000 |
|---|---|---|---|---|
| 1 week | 2.2735 | 0.1798 | 0.4979 | 0.8333 |
| 2 weeks | 2.1061 | 0.2126 | 0.5576 | 0.8640 |
| 4 weeks | 2.0800 | 0.2388 | 0.5993 | 0.8849 |
| 8 weeks | 2.0427 | 0.2519 | 0.6178 | 0.8947 |
分析:点估计随窗口增大单调改善,含 4 周到 8 周这一段。与分离的容量曲线合起来,作者称"测量范围内没有平台期",也解释了 §8 为何把 MoE、稀疏/线性注意力、跨请求持久 KV cache 列为下一步。需注意每个窗口只跑一遍,"数据量"与"优化步数"混在一起、贡献无法拆开。
Teacher Ranker 设计消融(§7.3)¶
Table 7.4:预训练消融(固定 8k 事件历史与六层候选打分器,第一行只移除 next-item-prediction 预训练阶段)
| Configuration | Weighted pair accuracy |
|---|---|
| Teacher, no pre-training | 0.6153 |
| Teacher, two-stage initial recipe (selected) | 0.6215 |
Table 7.5:打分器深度与 attend 历史长度变化时的 teacher WPA 点估计(同一留出互动标签集)
| History | Scorer depth | Weighted pair accuracy |
|---|---|---|
| 2k | 1 | 0.6080 |
| 2k | 2 | 0.6105 |
| 2k | 4 | 0.6124 |
| 2k | 6 | 0.6134 |
| 2k | 8 | 0.6138 |
| 8k | 1 | 0.6159 |
| 8k | 2 | 0.6189 |
| 8k | 4 | 0.6207 |
| 8k | 6(selected) | 0.6215 |
| 8k | 8 | 0.6219 |
分析:历史长度的边际收益系统性大于打分器深度——深度 1 上从 2k 换到 8k 带来 +0.0079,而 2k 上把深度从 1 加到 8 只带来 +0.0058;深度 6 层后基本饱和(6→8 仅 +0.0004),是明确的性价比拐点。预训练那 +0.0062 看着不大,但对照全表动态范围(跨度仅 0.0139)就知道:单独一个 NIP 预训练阶段贡献了整张消融表跨度的 45%——这正是作者称之为 load-bearing stage 的依据,也是无手工特征 transformer 得以替代生产 ranker 的关键。
统一生成与排序(§7.4)¶
固定 teacher 后,这组离线实验评估 NTP + 蒸馏联合训练的 encoder、decoder 与 Ranking Module(teacher 只提供蒸馏目标与参考分)。所有变体用 §3 的组件与 2 周训练窗口,评估 beam 固定 $B_{\text{eval}} = 1024$。
Table 7.6:围绕共享参考配置的单因子消融(参考:MAE、rollout + impressions、训练 rollout beam 32、2k 事件历史、$E=7, D=2, R=1$;† 标记的三行是同一次参考运行)
| Configuration | Target-track Recall@1000 | Teacher Recall@10 | Teacher Recall@100 | WPA |
|---|---|---|---|---|
| Distillation loss | ||||
| MAE† | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| MSE | 0.8671 | 0.5748 | 0.7329 | 0.5915 |
| Huber | 0.8679 | 0.5568 | 0.7220 | 0.5894 |
| KL | 0.8662 | 0.5452 | 0.7151 | 0.5860 |
| Distillation candidate source | ||||
| Rollouts + impressions† | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| Rollouts only | 0.8610 | 0.5618 | 0.7288 | 0.5730 |
| Impressions only | 0.8663 | 0.2983 | 0.5281 | 0.5872 |
| Training rollout beam size | ||||
| 32† | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| 64 | 0.8565 | 0.5661 | 0.7359 | 0.5901 |
| 128 | 0.8616 | 0.5762 | 0.7427 | 0.5905 |
分析:(a) 损失函数无一在三方面同时占优,故保留 MAE——实质是说"蒸馏损失的具体形式不重要"。(b) 候选来源是全表最有信息量的一组:impressions-only 检索点估计最高但 Teacher Recall@10 只有 0.2983、不到含 rollout 配置的一半;rollout-only 保住保真度却 WPA 最低(0.5730);混合方案在两个单来源各自擅长的指标上都不劣。机制清楚:logged impressions 从不包含 decoder 会生成但生产从未曝光的候选,student 因此在自己服务时的候选分布上没见过世面;纯 on-policy 候选又缺真实曝光锚定。换候选来源的影响比换损失函数大一个数量级。(c) 训练 beam 32→128 给出最高保真度点估计,但要打分的 rollout 候选数翻两番,故保留 32。
Table 7.7:Ranking Module 深度,随后是历史长度与历史编码的消融(E/D/R 分别为 encoder/decoder/Ranking Module 层数;R = – 表示无 Ranking Module、由 decoder 似然排序)
| History encoding | History length | E | D | R | Target-track Recall@1000 | Teacher Recall@10 | Teacher Recall@100 | WPA |
|---|---|---|---|---|---|---|---|---|
| Full attention | 2k | 7 | 2 | – | 0.8656 | 0.0381 | 0.1936 | 0.5478 |
| Full attention | 2k | 7 | 2 | 1 | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| Full attention | 2k | 7 | 2 | 4 | 0.8656 | 0.6005 | 0.7501 | 0.5937 |
| Full attention | 8k | 7 | 2 | 4 | 0.8722 | 0.6586 | 0.7997 | 0.6029 |
| History Compression | 8k | 7 | 2 | 4 | 0.8709 | 0.6474 | 0.7893 | 0.6033 |
分析:第一行是机制基准——没有 Ranking Module 时 decoder 似然与 teacher 的 top-10 几乎不相交(0.0381),而检索本身(0.8656)却是全表最好之一,这把"生成"与"排序"彻底解耦:beam 似然是好的提议器、却是几乎无效的 item 级排序器。加一层打分器把 Teacher Recall@10 拉到 0.5654(一个数量级以上),4 层到 0.6005,历史扩到 8k 到 0.6586。最后一行是最关键的工程取舍:History Compression 的 Teacher Recall 比全注意力 8k 低 1.7%、Target-track Recall 几乎持平,WPA 反而最高(0.6033),而推理成本约为一半。WPA 反超值得玩味:深度容量集中在近期事件上,可能更贴合 WPA 评估的"时序相邻 impression 对"这一近端目标。
线上 A/B 实验(§7.5)¶
五组受控 A/B 在 My Vibe 智能音箱流量上评估服务配置;除标 † 外所有 delta 在 $p < 0.01$ 下显著。Active Users 是主指标,每项都是相对同实验生产对照臂的百分比变化。
Table 7.8:实验 1——teacher 排序分中 likes-score 权重的影响(NTP-only encoder–decoder 生成候选、teacher 排序;每组 5% 用户;teacher attend 8k、enc–dec attend 2k)
| Metric | Pairwise only (0) | + α Likes score | + 2α Likes score |
|---|---|---|---|
| Total Listening Time | +2.05% | +2.45% | +2.28% |
| Likes | −1.03%† | +6.56% | +11.93% |
| "Repeat" Commands | +7.43% | +12.89% | +12.57% |
| Active Users | +1.51% | +1.83% | +1.53% |
| Deeply Engaged Users | +2.61% | +2.87% | +2.80% |
分析:纯 pairwise 的 Likes 是 −1.03%(不显著),加入 likes 分后 Likes 单调上升,但 Active Users 在 $\alpha$ 处达峰(+1.83%)后回落到 +1.53%——典型的多目标权衡曲线,过度加权点赞会挤压总体活跃度,故保留非零但适中的 likes 分。
Table 7.9:实验 2——Teacher Ranker 的 SID 候选特征(唯一差异是 teacher 候选特征是否含 SID;各组 4% 用户)
| Metric | Teacher without SID features | Teacher with SID features |
|---|---|---|
| Total Listening Time | +2.60% | +3.18% |
| Likes | +11.13% | +19.86% |
| "Repeat" Commands | +15.88% | +20.52% |
| Active Users | +1.98% | +2.23% |
| Deeply Engaged Users | +2.95% | +3.80% |
分析:干净的单变量线上消融——加 SID 特征后五个指标全面上行,Likes 从 +11.13% 提到 +19.86%。机制上 SID 让候选侧获得"共享前缀 = 语义/协同相近"的泛化能力,尤其惠及曝光稀疏的曲目;这也解释了 Ranking Module 为何同样保留各级 SID 码与前缀 $n$-gram。
Table 7.10:实验 3——teacher 搭配两条候选生成路径(都只用 pairwise 分以匹配打分目标;每组 3% 用户)
| Metric | Teacher Ranker | Enc–dec + Teacher Ranker |
|---|---|---|
| Total Listening Time | +1.64% | +3.63% |
| Likes | +1.48%† | −0.54%† |
| "Repeat" Commands | +4.68%† | +5.02%† |
| Active Users | +1.22% | +2.72% |
| Deeply Engaged Users | +1.83% | +4.06% |
分析:左列只替换生产 ranker就拿到 Active Users +1.22%,是"免特征 transformer 可取代吃数百特征的生产 ranker"的直接线上证据。右列连候选生成也换掉后 Active Users 翻倍到 +2.72%——即替换候选生成的增量比替换 ranker 更大。Likes 在两列都不显著(右列为负),提示纯 pairwise 目标不覆盖显式点赞,正与实验 1 互补。
Table 7.11:实验 4——蒸馏后的单模型,单独使用与再叠加 teacher 重排(都用 §4.2 联合目标训练、2k 历史、含 likes 分;各组 8% 用户)
| Metric | Distilled model | Distilled + Teacher Ranker |
|---|---|---|
| Total Listening Time | +1.62% | +4.32% |
| Likes | +7.12% | +11.81% |
| "Repeat" Commands | +15.25% | +14.93% |
| Active Users | +1.41% | +2.81% |
| Deeply Engaged Users | +2.78% | +5.11% |
分析:左列即 Gryphon-v2 论文报告的那次 A/B(数值逐项一致),证明"不服务 teacher 也能替掉生产级联"。右列同时暴露了蒸馏的代价上限:把 8k 上下文的 teacher 挂回服务路径,Active Users 从 +1.41% 翻到 +2.81%——蒸馏只收回约一半 teacher 增益。作者的应对不是把 teacher 上线(成本不允许),而是把 student 自己的上下文从 2k 扩到 8k,这正是实验 5 的主变更。
Table 7.12:实验 5——SONA 单模型替换整条推荐栈(两臂各 15% 随机用户、7 天,保留限制生产输出的硬业务规则)
| Metric | Relative change vs control |
|---|---|
| Total Listening Time | +6.30% |
| Likes | +11.42% |
| "Repeat" Commands | +17.99% |
| Active Users | +4.53% |
| Deeply Engaged Users | +7.37% |
分析:五个指标全面显著提升,主指标 Active Users +4.53%,是此前该界面最强模型 Argus 增量(+1.93%)的 2.35 倍。与实验 4 的关键差异是可用上下文(2k → History Compression 下的 8192 事件);但作者主动声明两次实验分开进行、其差值不能隔离历史长度的因果贡献——中间还夹着 tokenizer 更换、Ranking Module 从 1 层到 4 层等多处变化。
核心贡献总结¶
- 一次罕见的整链路替换 A/B,且是正向大幅提升:单模型替掉 15+ 候选生成器 + 粗排 + 精排,Active Users +4.53%、TLT +6.30%、Likes +11.42%,且是叠加在历代部署保留收益之上的增量。
- 把"训练期专用大教师"这个角色定型:teacher 不是奖励模型(无需 RL)、不是线上 ranker(无需服务),而是纯粹的偏好函数供给方;其 featureless 设计是隐藏枢纽——正因只依赖历史即可给任意 user–item 对打分,那些从未曝光、无日志特征的 rollout 候选才可能被监督。
- "一年历史压进 teacher、稠密蒸馏进 student"绕开了数据经济学约束:时间线级打包让 teacher 一次前向监督整条时间线的所有目标,而请求级 NTP 数据集连数月都覆盖不了。
- History Compression 是"长历史 vs 延迟"的实用解:深度只花在近期 2048 事件、一层跨全 8192 事件混合,约一半推理成本拿到与全注意力 8k 相当的指标。
- 完整披露了在线训练闭环(45 分钟中位延迟、10 分钟权重同步、双存储画像、经推理服务重建历史消除训练-服务偏移、模型黑名单切断反馈闭环),这类细节在同类报告里罕见。
与已归档相关工作的对比¶
OneRec OneRec Technical Report(快手,2025-06-16)¶
关系:显式引用([18],仅在"single-model generative recommenders carried this recipe into production"处一笔带过,无方法/指标层对比)· 已加载对方精读
- 共同关注的问题:root cause 一致——多阶段级联把优化目标与算力都碎片化。OneRec 量化了同一件事:serving 阶段 >50% 资源用于通信与存储,排序模型训练/推理 MFU 仅 4.6% / 11.2%;SONA 把推理 MFU 做到了 41%。
- 相近的技术骨架:几乎逐组件对应——多模态 LLM 抽内容特征(miniCPM-V-8B / Qwen2.5-Omni)→ 协同对齐 → RQ-Kmeans 三层量化 → encoder-decoder + SID 自回归生成 → 用一个额外信号源把服务级偏好注入生成模型。
- 本文的差异与推进:最后一跳是分水岭。OneRec 走 RL 后训练(P-Score 奖励模型 + ECPO + format reward);SONA 走监督蒸馏(teacher 给连续分数、逐 head MAE 回归,没有梯度穿过 beam search),§8 明确表态"只在受控对比证明贡献后才采用某训练阶段,而 RL 我们还没建立这个证据"。SONA 还保留显式的 item 级 Ranking Module,因而能区分 SID 碰撞类内部的 item。
- 可比的方法/实验差异:OneRec 报 App Stay Time +0.54%/+1.24%、OPEX 降至级联的 10.6%;SONA 报 Active Users +4.53%、延迟持平。历史处理也分道扬镳:OneRec 用四条通路(终身路径先层次 K-means 压缩再 QFormer),SONA 用单一时序序列 + History Compression。
UniPinRec UniPinRec: Unifying Generative Retrieval and Ranking at Pinterest Scale(Pinterest,2026-05-29)¶
关系:显式引用([13],在"一份用户表征跨任务共享"的设计哲学处与 [14] 并列一句带过,无方法/指标层对比)· 已加载对方精读
- 共同关注的问题:问题陈述可以互换——检索与排序都在用大 transformer 编码同一段用户历史,重复编码是低效的首要来源;统一后用户只编码一次、表征共享、信号互相正则化。UniPinRec 称之为"全栈统一",SONA 称之为"一份用户表征跨任务共享"。
- 相近的技术骨架:核心机制惊人一致——"历史编码一次($O(n^2)$),给 $k$ 个候选打分只付 $O(nk)$"。UniPinRec 靠跨进程 KV-cache 共享(预分配 GPU 显存池 + CUDA IPC handle);SONA 靠同一 GPU worker 内共享 encoder memory $K$。两者都强调统一模型必须比分开部署更便宜才值得切换。
- 本文的差异与推进:(a) UniPinRec 保留 ANN(Faiss),SONA 用 SID 约束 beam search,因此 SONA 能替掉整个漏斗而 UniPinRec 明确选择不替(理由是会丧失与既有候选源的可组合性与逐阶段运维控制)。(b) UniPinRec 用 Masked Action Modeling 拟合真实动作标签,SONA 只回归 teacher 分数:前者上限是日志标签能表达的偏好,后者上限被 teacher 锁死但能吸收整年数据。(c) UniPinRec 是 drop-in 增量替换,SONA 是一次性整栈替换。
- 可比的方法/实验差异:UniPinRec 报排序 Hit@3 相对生产 ranker +14.8%、线上 saves +0.95% / push opens +0.91%、延迟 −11.1%、QPS +63.6%;SONA 报 Active Users +4.53%、延迟持平、MFU 41%。UniPinRec 线上增益更小,但它自陈原因是离线提升被未改动的下游 ranker/blender 衰减——这恰好从反面支持 SONA"必须整栈替换才能拿到全部增益"的选择。
UniSGR UniSGR: Unified Framework for Semantic ID Generation and Ranking(阿里 AIDC / Lazada,2026-07-05)¶
关系:独立并发(本文未引用 UniSGR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:同一 root cause——生成式检索能选出语义相关候选,却缺少工业排序所需的细粒度多目标判别力;在生成器后简单外挂判别式 ranker 又会重新引入"生成器优化候选可信度、ranker 在被截断候选集上优化最终收益"的目标错位。
- 相近的技术骨架:都是在同一个 SID encoder-decoder 内挂多目标排序模块,复用生成侧表示,服务时不再调用独立的 item-ID 排序模型;都用多模态 LLM(Qwen3-VL / Qwen2.5-Omni)抽 item 表征后协同对齐、再残差量化成三层 SID。
- 本文的差异与推进:监督来源仍是分水岭——UniSGR 用真实 click/atc/pay 标签的 BCE 并用 VA-PMTP 把业务价值回灌进生成目标,SONA 只回归 teacher 分数。SONA 独有的推进是候选分布:显式混合 on-policy rollout 与 logged impressions,并量化了只用 impressions 的代价(0.2983 vs 0.5654);UniSGR 独有的则是把业务价值回灌进生成(SONA 生成侧只有朴素 NTP)与多场景预训练 + 场景对齐的两阶段范式。
- 可比的方法/实验差异:UniSGR 额外攻解码效率(STARK 树注意力,QPS 119→219、延迟 30.9→14.1ms),线上 Lazada 首页 GMV +5.68%;SONA 不优化解码本身,而是靠蒸馏把 teacher 的推理 pass 整个从服务路径删掉。两者是这条路线上标签驱动派与教师蒸馏派的对照。
被剔除的近似候选:GBLA(2606.07317,同为 Yandex,问题是长历史注意力成本、与 History Compression 动机重合,但解法是替换注意力算子而非统一系统);UniGD(2608.03150,快手搜广,同样在一个 backbone 内统一 SID 生成与判别式打分,但核心是用 CAGE 解两目标梯度冲突、场景带 query,无教师蒸馏与级联替换);UniFormer(2606.27058,统一的是"特征空间 × 任务空间"的协同 scaling,不涉及生成式候选替换级联)。
讨论与局限性¶
值得借鉴的设计。 (1) "把容量花在哪里"这个视角贯穿全文:History Compression 不丢历史而是不均匀分配深度,teacher 不上线而是把一年历史压进权重,Ranking Module 不重编码历史而是 cross-attend 已有 memory。(2) 候选分布对齐比损失函数选择重要一个数量级。(3) Table 7.7 第一行干净地钉死了"beam 似然是好提议器、坏排序器";(4) teacher 侧"长历史 > 深打分器"的对比为容量分配提供了可迁移先验。
局限与争议。
- 实验 5 与实验 4 的差值不可归因:中间同时变了历史长度、Ranking Module 深度、tokenizer 表征等多项,唯一线上证据是整体 treatment,全文最亮眼的数字拆不到组件。
- 离线主指标 Teacher Recall 存在循环性:它衡量 student 复现提供蒸馏目标的同一个 teacher 的程度,从 0.0381 提到 0.6586 在定义上就是"蒸馏成功"的同义反复;WPA 则在现有级联曝光策略下的 impression 上评估,不衡量 SONA 自己会浮现的那批 item。
- student 上限被 teacher 锁死:实验 4 已量化 gap(+1.41% vs +2.81%,蒸馏只收回约一半 teacher 增益);SONA 的应对是给 student 加上下文而非改蒸馏机制,这个 gap 是否随 student 变强而收敛并无证据。
- 所有消融都是点估计,无显著性检验、无多种子:Table 7.5 里 6 层与 8 层差 0.0004、Table 7.6 里 beam 64 与 32 差 0.0007,而 Gryphon-v2 曾提到 R@1000 运行间标准差约 0.003。
- 未全量部署,且目录覆盖率已知下降:作者明写覆盖率低于生产栈且待调查——对"把 15+ 异构召回器压成单一 beam"的系统这恰是最该担心的方向(异构召回器的隐含功能之一就是保证多样性与探索)。他们同时又称"未注意到内容探索退化",两句话存在张力。
- 只验证了一个界面:My Vibe 是纯推荐、无 query、被动消费——恰是对生成式单模型最友好的设置;带搜索与编辑运营上下文的界面能否复现留待未来。
- 方法论可扩展性隐忧仍在:SID 码本(3×32,000)在联合训练前固化,扩参时"如何表征历史"与"如何建模序列"两条路径都受这个离散接口约束;beam 仍是召回上界;训练 rollout beam(32)与服务 beam(1024)有 32 倍分布缺口。tokenizer 三层组件都冻结/离线拟合,无法与下游联合优化。
- 新颖性主要在配方而非机制:多模态 tokenizer、统一 generate-and-rank、大教师蒸馏、on-policy 蒸馏都已有先例,SONA 的贡献是把它们组装成一条真能替掉级联并显著赢的流水线。
定位。 在 2026 年"用一个模型替掉推荐级联"的密集竞赛里,SONA 是证据链最完整的一份——五组按概念顺序排列的线上 A/B(teacher 能替 ranker → enc-dec 能替候选生成 → 蒸馏能去掉 teacher → 长上下文再翻一倍)。这种"逐级替换 + 逐级验证"的叙事对工业团队比单点方法创新更有参考价值,代价是它整体上是配方级而非机制级的贡献。