Gryphon-v2:用一个模型取代整条级联——带 Rollout Distillation 的生成-排序一体化推荐器¶
Yandex(Anna Lipkina、Daria Tikhonovich、Viktor Yanush*、Mariia Ulianova、Oleg Sorokin、Vladislav Dodonov、Ilya Murzin、Denis Burshtein、Nikolay Savushkin;* 为共同一作、按字母序排列),arXiv 2608.06213v1,2026-08-06,Yandex Music 工业音乐推荐场景。本文是同一团队 Gryphon(arXiv 2606.08604)的第二版。
研究动机与背景¶
工业推荐系统的标准形态是多阶段级联(cascade):一批异构候选生成器产出候选,粗排器截断,精排器决定最终顺序。这套设计有效但代价高昂——每个阶段都要重复处理一遍用户历史,各自维护复杂的特征流水线,线上还要串起多个服务阶段。
基于语义 ID(Semantic ID, SID)的生成式推荐提供了一条端到端路径:把用户历史编码一次,直接自回归生成推荐物品的 SID。但本文指出一个关键缺口:仅靠 next-item prediction(NTP)并不能捕捉生产 ranker 优化的那种细粒度、多目标偏好——生成器的序列似然只是"这个 SID 像不像下一个被交互的物品",而生产 ranker 编码的是 like / play / skip / dislike 这一整套业务权重下的精细偏好序。
面对这个缺口,工业界已有两条路线:
- 后训练路线(post-training):在 NTP 预训练之后加对齐阶段,用 RL 把生成器对齐到服务级目标——OneRec 用学习到的偏好奖励模型做 on-policy RL,OneRec-V2 直接用真实用户反馈作奖励并改用 lazy decoder-only 架构,GPR 结合多 token 与 value-aware 训练加层次化策略优化,OxygenREC 结合近线推理指令与统一排序模型奖励服务。共同模式是给生成策略显式加一个后训练阶段,差异只在监督来源。
- 统一架构路线:把候选生成与排序目标塞进同一模型,让 item 级打分而非检索分数决定最终顺序,共享 encoder 提供高效服务。UniPinRec 用共享输入格式与共享骨干统一检索与排序,但检索仍走 ANN;GRank 把 MIPS 生成器与轻量 cross-attention ranker 配对,仍依赖 MIPS 且给生成与排序各留一个历史 encoder;RecoChain 在单个因果 decoder 内合并 SID 生成与重排,但两者用不同的阶段特定输入格式;UniSGR 引入 value-aware SID 生成加统一多目标排序模块。
Gryphon-v2 的定位是把这两条线接起来:从统一 generate-and-rank 这一侧继承 Gryphon 的共享 encoder 架构(轻量 item 级 Ranking Module 在不重新编码历史的前提下重排生成候选),从奖励式后训练那一侧继承"把细粒度服务级偏好从高容量离线模型迁移到线上模型"这一原则。实现方式是把一个 Teacher Ranker(此前已在线上 A/B 中验证优于生产 ranker,但算力代价太大无法全量服务)蒸馏进 Ranking Module。teacher 扮演的角色类似奖励模型,而优化本身仍是监督蒸馏而非强化学习。
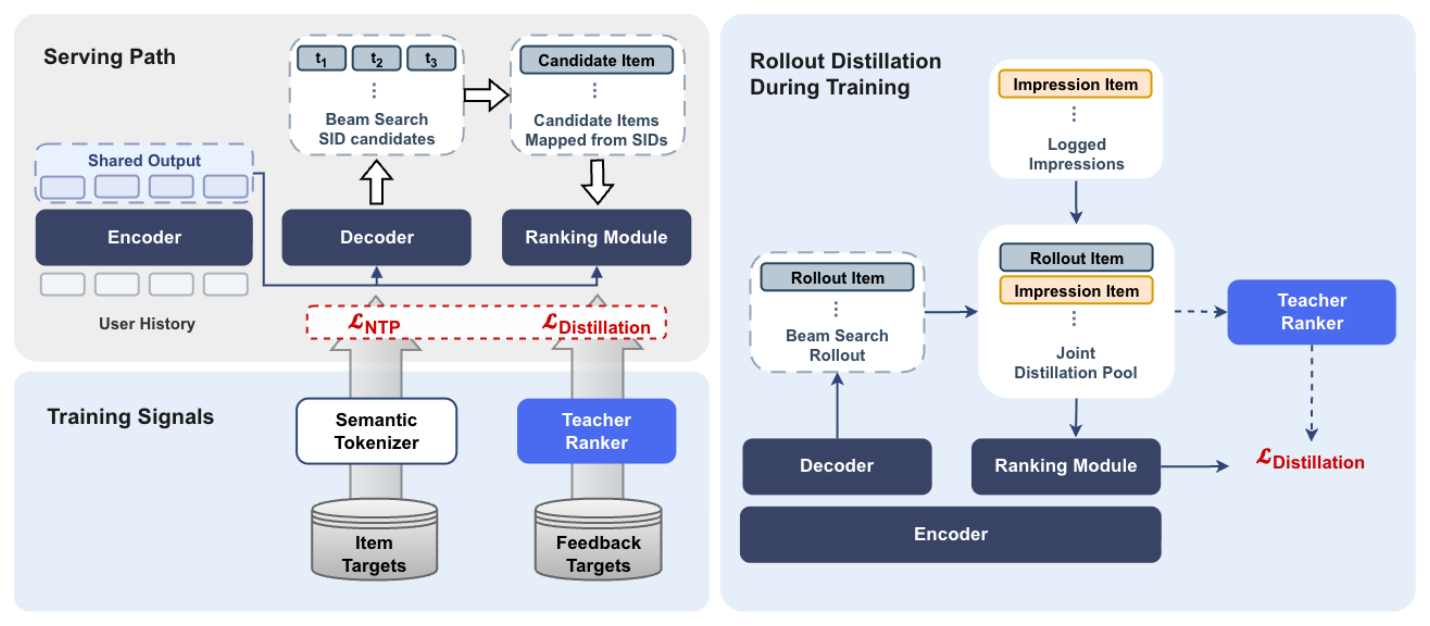
训练方法叫 Rollout Distillation,灵感来自 LLM 后训练的 on-policy distillation:teacher 为两个互补来源的候选提供偏好目标——(a) 由当前 SID decoder 用与服务时完全相同的约束解码机制生成的 rollout;(b) logged impressions,把覆盖面扩展到生产流量中真实曝光过的物品。
核心方法 / 模型架构¶
用一个模型替掉级联,意味着它必须同时满足级联靠多个组件才满足的两个要求:产出足够宽的候选集并有效地给它们排序,同时在延迟预算内只处理一次用户历史。
架构总览¶
Gryphon-v2 沿用 Gryphon 的共享 encoder 架构:history encoder + 自回归 SID decoder + item 级 Ranking Module。
Encoder。 设 $u$ 索引一次请求及其用户上下文,$H_u = (h_{u,1}, \ldots, h_{u,n_u})$ 为请求截断点之前按时序排列的事件序列。一个双向 Transformer 把它映射为上下文状态:
$$E_u = \mathrm{Encode}_{\text{hist}}(H_u). \tag{1}$$
历史只被编码一次:decoder 与 Ranking Module 复用同一份请求特定激活 $E_u$,两条路径都不单独重新编码 $H_u$——这是整套设计能在延迟预算内替掉级联的物理基础。
Decoder。 自回归 decoder 对 $E_u$ 做 cross-attention,逐码发射下一个 item 的 SID;推理时用目录 trie 约束的 beam search 产生合法候选 SID 再解析成具体 item。decoder 被明确定位为提议机制(proposal mechanism):序列似然决定谁进 beam,但不决定解析后 item 的最终顺序。
Ranking Module。 对每个解析出的候选,用一个 item 表征作 query 去查询 $E_u$,预测任务特定的 item 级分数,其固定加权组合决定最终排序。
请求级训练实例¶
每条训练实例对应一次被服务的请求 $u$。设 $\mathcal{M}_u$ 为该请求中被曝光的目录 item 集合及其关联反馈,子集 $\mathcal{P}_u \subseteq \mathcal{M}_u$ 是被用作 NTP 目标的正样本曝光 item,$\mathcal{T}$ 为固定的排序任务集合。联合训练时,当前 SID decoder 生成并解析出 rollout 候选集 $\mathcal{G}_u$;Teacher Ranker 与 Ranking Module 对同一批来自 $\mathcal{M}_u \cup \mathcal{G}_u$ 的候选打分,为每个候选 $i$ 和任务 $t$ 产生 teacher 目标 $r^{T,t}_{u,i}$。按请求分组的意义在于:student 只需编码 $H_u$ 一次,$E_u$ 即可被所有生成目标与蒸馏目标共用。
语义 ID 生成与解析¶
NTP 训练。 每个目录 item $i$ 被赋予语义 ID $\Phi(i) = (s_1, \ldots, s_L)$,即从 $L$ 个层次化码本中抽取、按粗到细排列的离散码元组。条件于 $E_u$,decoder 自回归地分解 SID,每个位置预测一个码。对每个正目标 $i^+ \in \mathcal{P}_u$,其 teacher-forcing 下的 NTP 贡献为:
$$\ell_{\text{NTP}}(u, i^+) = -\sum_{\ell=1}^{L} \log p_\theta\!\left(s^+_\ell \mid s^+_{<\ell},\, E_u\right). \tag{2}$$
对含多个正目标的请求,把各自的 teacher-forcing 贡献求和:
$$\mathcal{L}_{\text{NTP}}(u) = \sum_{i^+ \in \mathcal{P}_u} \ell_{\text{NTP}}(u, i^+). \tag{3}$$
约束生成。 推理时目录 trie 约束的 beam search 保证每个完成的 SID 至少能解析到一个目录 item。用 beam size $K$,decoder 返回一个有序 SID beam $\mathcal{B}^{(K)}_u$。
碰撞解析与候选预算。 多个 item 可能对应同一 SID。设 $\mathcal{C}_\sigma = \{i : \Phi(i) = \sigma\}$ 为 SID $\sigma$ 的碰撞类,把 beam 里每个 SID 展开得到未受预算约束的候选集:
$$\widetilde{\mathcal{I}}_u = \bigcup_{\sigma \in \mathcal{B}^{(K)}_u} \mathcal{C}_\sigma. \tag{4}$$
作者在构造语义索引时刻意让碰撞类保持很小。部署中解析后的候选池被 item 预算 $B_{\text{item}}$ 截断:若 $|\widetilde{\mathcal{I}}_u| > B_{\text{item}}$,按 beam 分数升序把 SID 假设连同碰撞类一起移除直到满足预算。设 $\mathcal{B}^{(K)}_{u,\text{keep}}$ 为保留的 SID beam,最终候选池为:
$$\mathcal{I}_u = \bigcup_{\sigma \in \mathcal{B}^{(K)}_{u,\text{keep}}} \mathcal{C}_\sigma, \qquad |\mathcal{I}_u| \le B_{\text{item}}. \tag{5}$$
$\mathcal{C}_\sigma$ 内所有 item 继承同一个 beam 分数,无法区分碰撞类内部的 item;更一般地,自回归 SID 似然对 item 级相关性估计本身就可能失准。所以 beam 分数只用于候选提议与罕见的容量控制截断,最终排序完全交给 Ranking Module。
Ranking Module¶
Ranking Module 在不重新编码用户历史的前提下,用共享历史状态 $E_u$ 给 $\mathcal{I}_u$ 中的候选打分。它的候选 encoder 可以通过候选表征引入额外的 item 级特征。
对候选 $i$,设 $\mathbf{x}_i$ 为其 item 级特征,候选 encoder 把这些特征映射为候选表征:
$$\mathbf{e}_i = \mathrm{Encode}_{\text{item}}(\mathbf{x}_i). \tag{6}$$
在本文报告的部署里,$\mathbf{x}_i$ 只包含 item 标识符及其 SID。两类特征都用组合式多哈希 embedding表示,从与 history encoder 共享的统一 embedding 表中取出;对 SID 则按 Zheng 等人的做法从码序列构造前缀 $n$-gram 特征。候选表征通过一个或多个 cross-attention 块 attend 共享的编码历史:
$$\tilde{\mathbf{e}}_{u,i} = \mathrm{CrossAttn}(\mathbf{e}_i,\, E_u). \tag{7}$$
任务特定输出头把 $\tilde{\mathbf{e}}_{u,i}$ 映射为每个排序任务 $t \in \mathcal{T}$ 的一个分数,输出结构与 Teacher Ranker 完全对齐:
$$\hat{r}^{\,t}_{u,i} = \mathrm{Head}_t(\tilde{\mathbf{e}}_{u,i}), \qquad t \in \mathcal{T}. \tag{8}$$
最终排序用固定权重组合各任务分数:
$$\hat{R}(u, i) = \sum_{t \in \mathcal{T}} w_t\, \hat{r}^{\,t}_{u,i}, \tag{9}$$
其中 $w_t$ 是任务 $t$ 的权重。$\mathcal{I}_u$ 中的 item 按 $\hat{R}(u,i)$ 降序排列,服务时不再有任何额外的重排步骤。
Teacher Ranker¶
Teacher Ranker 是一个大型序列模型,用长用户交互历史给候选 item 打分,不依赖任何手工表格特征。它是通过此前的内部离线与在线验证从生产 ranker 中胜出而被选中的;这些评估早于本实验、不作为受控结果,只用来说明选择该 teacher 的动机。其计算代价使其无法直接部署,因此只在训练期监督 Ranking Module。
架构上它把序列历史 encoder 与 cross-attention ranker 配对(每个候选直接 attend 编码后的历史),用任务特定 head 做多目标学习。训练沿用 ARGUS 的做法:在时序交互序列上自回归训练,从每条序列的多个位置获取监督,因而能在实际预算内学到远多于 student 的数据。teacher 还能条件于长达 8,000 个事件的历史——这个上下文长度对上线模型代价过高。免特征(featureless)设计是关键:它使 teacher 仅凭历史即可给任意 user–item 对打分,从而能为 rollout 候选提供蒸馏目标(这些候选从未曝光,没有任何日志特征可用)。
Rollout Distillation¶
Rollout Distillation 用 Teacher Ranker 分数训练 Ranking Module,候选来自当前 decoder 的 rollout 与 logged impressions 两个来源。rollout 这一候选选择原则来自 LLM 后训练的 on-policy distillation,但优化本身仍是监督式的,没有任何梯度穿过 beam search。记 $r^{T,t}_{u,i}$ 与 $\hat r^{\,t}_{u,i}$ 分别为 Teacher Ranker 与 Ranking Module 对候选 $i$、任务 $t$ 的分数。
Rollout 候选。 对每条用户历史 $H_u$,约束 beam search 在每一个训练步都用当前 decoder 参数同步生成 SID beam $\mathcal{B}_u$,没有 checkpoint 滞后;生成的 SID 被解析为合法目录 item,得到 rollout 候选集 $\mathcal{G}_u$。Ranking Module 条件于 $E_u$ 打分,teacher 用自己的架构给同一批 item 打分。蒸馏对每个排序任务独立施加、所有任务等权,rollout 候选的蒸馏损失为逐元素 MAE:
$$\mathcal{L}_{\text{roll-distill}} = \frac{1}{|\mathcal{T}|} \sum_{t \in \mathcal{T}} \frac{1}{|\mathcal{G}_u|} \sum_{i \in \mathcal{G}_u} \left| \hat r^{\,t}_{u,i} - r^{T,t}_{u,i} \right|. \tag{10}$$
在本文训练数据中,rollout 候选占去重蒸馏候选的 90% 以上。作者澄清:这个比例描述的是候选覆盖而非损失权重——每个来源的损失都按自己的候选数归一化,两个蒸馏损失以相同系数进入联合目标。
Impression 候选。 rollout 集 $\mathcal{G}_u$ 被对应 logged 请求中真实展示的 item 集 $\mathcal{M}_u$ 补充,把 teacher 打分范围拓宽到 rollout 之外,并锚定在生产流量中被观测到的 item 上。同样用任务级 MAE:
$$\mathcal{L}_{\text{impr-distill}} = \frac{1}{|\mathcal{T}|} \sum_{t \in \mathcal{T}} \frac{1}{|\mathcal{M}_u|} \sum_{i \in \mathcal{M}_u} \left| \hat r^{\,t}_{u,i} - r^{T,t}_{u,i} \right|. \tag{11}$$
Rollout Distillation 即两项之和,各自按自身候选数归一化、系数均为 1:
$$\mathcal{L}_{\text{distill}} = \mathcal{L}_{\text{roll-distill}} + \mathcal{L}_{\text{impr-distill}}. \tag{12}$$
两个来源为什么互补是本文的设计要害:rollout 让 Ranking Module 直接暴露在"服务时同一套生成机制产出的候选分布"上,消除训练-服务分布偏移;logged impressions 则把 student 锚在生产曝光策略上,防止 rollout 分布在训练早期漂移时把监督带偏。
联合训练¶
整个统一架构用 NTP 与 Rollout Distillation 的联合目标训练:
$$\mathcal{L} = \mathcal{L}_{\text{NTP}} + \mathcal{L}_{\text{distill}}. \tag{13}$$
NTP 损失更新 decoder 与共享 encoder,蒸馏更新 Ranking Module 与共享 encoder。Teacher Ranker 只在训练期提供目标,不进入服务计算图。联合训练把 item 级排序信息注入到与 SID 生成同一份编码用户表征 $E_u$ 中。
部署¶
Gryphon-v2 作为实验流量上唯一的学习型推荐模型服务 treatment 分支。服务从离线 checkpoint 启动,此后基于近期交互数据在线更新;Teacher Ranker 提供训练目标并每日刷新,但从不进入服务路径。在线训练实例按请求用 logged impressions 与反馈分组,对应历史 $H_u$ 在请求时间截断点上重建、使用与服务完全相同的画像表示与特征构造,以降低训练-服务偏移(training–serving skew)。
上线模型以 10 分钟为周期更新,每次更新本身耗时数十分钟,因此服务实验的模型通常训练于不到一小时前的用户事件。请求到来时,一个 CPU 服务构造请求特征并发给部署在 NVIDIA Triton Inference Server 上的 GPU 侧模型,后者直接返回最终 item 序,下游没有任何学习型粗排或精排阶段。
实验设置¶
围绕三个研究问题组织:RQ1 与匹配的生成式基线相比,Gryphon-v2 在候选生成质量、对 Teacher Ranker 的保真度、logged impressions 上的排序精度如何?RQ2 能否用单个 generate-and-rank 模型替换生产级联(候选生成 + 粗排 + 精排)并提升线上互动指标?RQ3 蒸馏损失、rollout beam size、候选来源组成如何影响表现?
数据集。 从大规模音乐推荐服务两周的交互日志构造时序训练/测试集,采用 §3.2 的请求级实例。这个两周窗口只用于离线对比;线上实验从四周 checkpoint 起步并在线更新。采用时序切分:测试请求严格晚于训练窗口,覆盖日志最后一天。日志来自一个纯推荐驱动的界面——无搜索、无编辑运营上下文的无限个性化音乐流。只保留至少有一条正曝光的请求,"正"定义为该曲目获得 like 或长播放且未被 dislike,以此保证每条训练请求至少携带一个 NTP 正目标。
基线。 Generative retrieval——只有 SID decoder 的 encoder–decoder 骨干,解析候选按 SID beam 似然排序,用与 Gryphon-v2 完全相同的 NTP 目标训练但没有 item 级 Ranking Module;Gryphon——共享 encoder、SID decoder 与 item 级 Ranking Module 都与 Gryphon-v2 相同,但 Ranking Module 用 next-item 监督而非 Teacher Ranker 蒸馏训练。三者共用相同 tokenizer、骨干、历史特征、候选预算与约束解码流程;Gryphon 与 Gryphon-v2 更共用同一套 Ranking Module 架构,因此二者对比干净地隔离了"teacher 蒸馏 vs. next-item 监督"这一个变量。
评估协议与指标(三个互补诊断)。
-
Recall@1000(R@1000):候选生成召回率,即每次请求的留出目标中被 top-1,000 解析 item 覆盖的比例。该指标在严格按 beam search 分数排序的候选集上测量,在 item 级 Ranking Module 生效之前。
-
TeacherRecall@$k$(T-R@$k$):对 Teacher Ranker top-$k$ 选择的保真度。对每次请求,模型与 Teacher Ranker 给同一个由 decoder 在生产 beam size 下产出的候选池打分:
$$\mathrm{TeacherRecall@}k(u) = \frac{1}{k}\left| \mathrm{Top}_k\!\left(s^{\text{model}}_u\right) \cap \mathrm{Top}_k\!\left(s^{\text{teacher}}_u\right) \right|, \tag{14}$$
在所有被评估请求上取平均:
$$\mathrm{TeacherRecall@}k = \frac{1}{|\mathcal{U}|} \sum_{u \in \mathcal{U}} \mathrm{TeacherRecall@}k(u). \tag{15}$$
值为 1.0 表示模型选出与 teacher 完全相同的 top-$k$,0.0 表示两者不相交。作者强调:该指标本身不独立衡量推荐质量,它衡量的是 student 在自己的服务时候选分布上复现 teacher 的程度。
- Weighted Pair Accuracy(WPA):生产排序模型使用的基于标签的排序质量指标。测试集包含互动等级不同的时序相邻曝光对(可在同一请求内,也可跨越两次相邻请求的边界)。互动序为 $\text{like} > \text{play} > \text{skip} > \text{dislike}$,每个等级有预定义目标权重 $t$。把每个合格对 $(i, j) \in \mathcal{P}$ 定向为 $t_i > t_j$,则:
$$\mathrm{WPA} = \frac{\sum_{(i,j) \in \mathcal{P}} (t_i - t_j)\,\mathbb{1}\{s(i) > s(j)\}}{\sum_{(i,j) \in \mathcal{P}} (t_i - t_j)}, \tag{16}$$
其中 $s(\cdot)$ 是标量排序分数:beam 序评估用 SID beam 似然,带 ranker 的评估用 ranker 分数。正确排序的对按互动权重差成比例贡献,等级差距越大贡献越强。Ranking Module、Teacher Ranker 与生产 ranker 在同一批测试集曝光对上评估。
实现细节。 离线训练在两周窗口上做一次时序单遍。训练 rollout 用 beam size 32;排序任务与联合目标的三个损失等权。多模态 item 表征按 QARM 的做法把文本与音频特征与协同信号对齐——内容特征由 Qwen2.5-Omni 抽取,再由一个用 in-batch 对比目标训练的小 Transformer 投影;残差 $K$-means 量化产出层次化 SID,索引的 Independent Code Rate 为 0.98。推理时 decoder 生成 1,024 个合法 SID,碰撞展开后按 $B_{\text{item}} = 1{,}200$ 截断。线上实验配置相同,只是初始训练于四周数据并随后在线更新。
Table 5:Gryphon-v2 架构超参数
| Parameter | Value |
|---|---|
| Encoder layers | 7(双向) |
| Decoder layers | 2 |
| Ranking Module layers | 1 |
| Hidden dimension | 1,024 |
| Attention heads | 16 |
| Head dimension | 64 |
| Max user-history length | 2,048 events |
| Number of SID codebooks | 3 |
| SID codebook size | 32,000 |
| Total parameters | 0.5B |
优化。 用 AdamW + FSDP2 分片联合优化:每 GPU 每 micro-batch 处理 32 条请求,跨 128 张 GPU 与 4 步梯度累积得到 16,384 条请求的有效 batch size。学习率在前 3,000 步内从 $10^{-5}$ 线性升到 $3\times10^{-4}$,随后线性降到 $7\times10^{-5}$。在线更新沿用相同优化器与 batch size,学习率恒定在 $7\times10^{-5}$(离线调度的终值)。
主要实验结果¶
离线结果(RQ1)¶
Table 1:生成式模型的离线对比——候选生成召回(R@1000)、与 Teacher Ranker 的一致性(T-R@$k$)、基于标签的排序精度(WPA)。
| Model | R@1000 | T-R@10 | T-R@100 | WPA |
|---|---|---|---|---|
| Generative models | ||||
| Generative retrieval | 0.8643 | 0.0382 | 0.1944 | 0.5429 |
| Gryphon | 0.8593 | 0.0392 | 0.1701 | 0.5528 |
| Gryphon-v2 (beam order) | 0.8615 | 0.0381 | 0.1936 | 0.5478 |
| Gryphon-v2 (ours) | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| Reference rankers | ||||
| Production ranker | — | — | — | 0.6141 |
| Teacher Ranker | — | — | — | 0.6199 |
Gryphon-v2 (beam order) 指用 Gryphon-v2 的 checkpoint 但旁路 Ranking Module。加粗标记生成式模型中的最优点估计。参考 ranker 不产生候选,只报 WPA;它们训练于整整一年的日志反馈,而生成式模型只用两周窗口,因此不是匹配对比,仅作上界参照。
结论分析。
- 候选生成质量不受损:R@1000 上 Gryphon-v2 为 0.8615,落在两基线之间,差距都在该指标运行间标准差(约 0.003)之内;旁路 Ranking Module 的版本按构造共享同一数值。作者据此判断:蒸馏出的 Ranking Module 没有以候选生成质量为代价——把蒸馏梯度加到共享 encoder 上并没有"挤掉"生成路径需要的表征容量。
- top-$k$ 选择保真度出现数量级跃升:没有蒸馏时,所有排序方式都完全无法复现 Teacher Ranker 的选择——beam 分数排序(Generative retrieval 与旁路版)和 Gryphon 那个用 next-item 监督训练的 Ranking Module,T-R@10 全部低于 0.04、T-R@100 全部低于 0.20。加上蒸馏后 Gryphon-v2 达到 0.5654 / 0.7344,在 $k=10$ 上高出一个数量级以上。关键在于:Gryphon 的 Ranking Module 与 Gryphon-v2 架构完全相同,差距只能归因于监督信号,而非"item 级打分"这件事本身。这正面回答了 v1 的遗留问题——v1 证明 item 级重打分能越过 beam 天花板,v2 证明这个模块的天花板由监督决定。
- 曝光排序质量大幅逼近参考 ranker:生成式模型中 Gryphon-v2 的 WPA 最高(0.5892),其余至多 0.5528。相对参考上界,teacher 蒸馏弥合了 next-item 监督与 Teacher Ranker 之间 54% 的 WPA gap($(0.5892-0.5528)/(0.6199-0.5528)=54.2\%$)以及到生产 ranker 59% 的 gap($(0.5892-0.5528)/(0.6141-0.5528)=59.4\%$)。仅凭两周训练窗口就收回了两个 gap 的大部分。
- 端到端解读的自我克制:三个指标各自覆盖不同组件与候选分布,没有任何一个单独衡量端到端的 generate-and-rank 系统,因此在线 A/B 才是用户侧质量的主要判据。
线上 A/B 实验(RQ2)¶
合格用户按用户级分配到互不相交的 control 与 treatment 两臂,各占合格人群的 8%。
- Control 臂:完整生产级联——15 个以上异构候选生成器每次请求产出约 10,000 个候选,粗排器压到 3,000,再由独立的生产精排器排出最终 slate。
- Treatment 臂:整条级联被单个 Gryphon-v2 替换——生成 1,024 个合法 SID、展开碰撞类、候选池上限 1,200 个解析 item,由单层 item 级 Ranking Module 用与 Teacher Ranker 相同的组合方式合并各 head 输出产生最终顺序,下游没有任何独立 ranker。作者特别对比 v1:Gryphon 是把候选喂给未改动的生产 ranker,而 v2 是服务路径上唯一的模型。
Table 2:线上 A/B 结果——Gryphon-v2 对比生产级联
| Metric | Relative change |
|---|---|
| Total listening time | +1.62% |
| Active users† | +1.41% |
| Likes | +7.12% |
| "Repeat" commands | +15.25% |
| Unfinished-track ratio | −9.65% |
† 主互动指标;活跃用户指日收听时长 ≥ 7 分钟的用户。所有报告的 delta 均相对完整生产级联,且在 $p < 0.001$ 下统计显著。
结论分析。 主互动指标"活跃用户数" +1.41%,总收听时长(TLT)+1.62%,次要质量指标全面向好。与 Gryphon v1 的 A/B(TLT +0.25%、不显著)相比是一次质变——v1 的结论是"作为唯一召回源非劣、并简化流水线",v2 则是"作为唯一模型、在显著提升互动的同时替掉整条级联"。"Repeat" +15.25% 与 unfinished −9.65% 尤其说明问题:蒸馏进来的 teacher 偏好确实带来了曲目级的听感契合度提升,而不只是多推了几首。
消融(RQ3)¶
Table 3:候选来源、rollout beam size 与蒸馏损失的消融
| Configuration | R@1000 | T-R@10 | T-R@100 | WPA |
|---|---|---|---|---|
| Candidate source | ||||
| Rollout + impressions† | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| Rollout only | 0.8610 | 0.5618 | 0.7288 | 0.5730 |
| Impressions only | 0.8663 | 0.2983 | 0.5281 | 0.5872 |
| Training rollout beam size | ||||
| 32† | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| 64 | 0.8565 | 0.5661 | 0.7359 | 0.5901 |
| 128 | 0.8616 | 0.5762 | 0.7427 | 0.5905 |
| Distillation loss | ||||
| MAE† | 0.8615 | 0.5654 | 0.7344 | 0.5892 |
| MSE | 0.8671 | 0.5748 | 0.7329 | 0.5915 |
| Huber | 0.8679 | 0.5568 | 0.7220 | 0.5894 |
| KL | 0.8662 | 0.5452 | 0.7151 | 0.5860 |
每个 block 相对 †-标记的线上生产配置只变动一个因素。加粗标记 block 内最优点估计,不代表统计显著。
- 候选来源:最有信息量的一组。只用 impressions 在 WPA 上接近部署配置(0.5872 vs. 0.5892),却只能复现 teacher top-10 选择的约一半(T-R@10 0.2983 vs. 0.5654)——因为 logged impressions 从不包含 decoder 会生成但生产从未曝光的那部分候选,student 在自己的服务分布上"没见过世面"。只用 rollout 保住了 teacher 保真度(0.5618)但 WPA 全表最低(0.5730)——纯 on-policy 候选缺少真实曝光锚定,学到的偏好在真实曝光对上泛化更差。部署的混合方案在每个单来源变体各自擅长的指标上都不劣于它,这是"两来源互补"主张的直接证据。
- Rollout beam size:训练 beam 是服务候选池的算力受限 on-policy 采样;匹配服务 beam 1,024 代价过高,因为每个候选都要被生成、解析并由 Teacher Ranker 打分。线上用的 beam 32 在事后分析前就固定了。beam 64 与 128 只带来温和提升(T-R@10 0.5654→0.5762)且算力更高,作者谨慎称之为"描述性点估计",无显著性检验。
- 蒸馏损失:没有任何目标在所有指标上占优——MSE 在 T-R@10 与 WPA 最好,MAE 在 T-R@100 最好,Huber 在 R@1000 最好。线上部署用 MAE 且在事后扫描之前就固定,所以 MSE 的优势仅是离线发现。
服务效率与技术栈简化¶
Table 4:匹配流量下的服务栈复杂度与时延对比
| Measure | Production cascade | Gryphon-v2 |
|---|---|---|
| Candidate generators | > 15 | One model |
| Pre-ranking stage | Separate | Integrated |
| Ranking stage | Separate | Integrated |
| Candidates / request | ∼10,000 → 3,000 | ≤ 1,200 |
| End-to-end latency | Comparable |
分析。 作者先排除了一个显而易见的替代方案:"生成式骨干 + 生产 ranker"不构成可比的统一方案——生产 ranker 的特征流水线依赖其他深度模型的表征,会把级联的大部分服务成本原样保留。
- 候选量:级联每次请求生成约 10,000 个候选、粗排 3,000;Gryphon-v2 生成 1,024 个合法 SID,碰撞展开后最多排序 1,200 个 item——比级联初始扇出少约一个数量级。
- 服务成本:直接的请求级测量(含 CPU 侧特征构造、网络传输、推理服务开销、候选生成与排序)表明端到端时延与生产级联相当;统一路径在匹配时延的同时消除了跨服务跳转与逐级候选打分。
- 吞吐:匹配条件下 Gryphon-v2 的吞吐约为"同一生成式骨干 + 线上串联 Teacher Ranker"的 4 倍。原因是它把 2,048 事件的历史编码复用给轻量 Ranking Module,避免了 Teacher Ranker 对多达 8,000 个事件的独立推理 pass——蒸馏把 teacher 那次昂贵得多的推理从服务路径上彻底移除了,这是"训练期 teacher"设计的直接经济收益。
核心贡献总结¶
- 把"统一架构"与"奖励式后训练"两条工业路线合流:用训练期专用的高容量 Teacher Ranker 充当奖励模型的角色,但优化保持为监督蒸馏,避开 RL 后训练的不稳定与工程复杂度。
- 提出 Rollout Distillation:teacher 目标同时覆盖"当前 decoder 每步同步生成、无 checkpoint 滞后的 on-policy rollout"与"logged impressions",前者消除训练-服务分布偏移、后者提供真实曝光锚定,消融证明二者互补。teacher 的 featureless 设计是前提——它使从未曝光的 rollout 候选也能被打分。
- 一次罕见的整链路替换 A/B:单个 0.5B 模型作为服务路径上唯一的学习型模型替掉 15+ 召回器 + 粗排 + 精排,活跃用户 +1.41%($p<0.001$),时延持平、吞吐 4×、候选量降低一个数量级。
与已归档相关工作的对比¶
OneBar OneBar:端到端内容接地生成式查询推荐(浙大 × 快手,2026-06-13)¶
关系:独立并发(本文未引用 OneBar,两者殊途同归)· 已加载对方精读
- 共同关注的问题:root cause 完全一致——多阶段级联把优化目标碎片化;而用单个生成模型收敛级联之后,生成器的 next-token 目标又承载不了平台真正在乎的后验偏好。两者都明确把"再训一个在线奖励模型"列为想要避开的方案。
- 相近的技术骨架:最后一跳惊人地同构——在 student 自己采样的轨迹(on-policy rollout)上,用一个只在训练期存在的特权 teacher 做稠密蒸馏,把偏好内化进可部署模型,服务接口保持不变。OneBar 的 PIOPD 让 teacher 额外看到"该视频关联的被点击查询"这一后验证据,student 从不观测该查询,只匹配 teacher 在 student 采样前缀上的软分布;Gryphon-v2 让 teacher 额外拥有 8,000 事件上下文与免特征打分能力,student 只匹配 teacher 在 student beam 生成候选上的分数。两者都把"off-policy gap"点为要害,也都强调蒸馏产物不给线上引入任何额外模块。
- 本文的差异与推进:(a) 粒度不同——OneBar 是 token 级软分布蒸馏(KL 风格 + 熵正则 + R-Drop + FGM),Gryphon-v2 是 item 级标量回归蒸馏(逐任务 MAE),更简单但丢掉分布形状信息;耐人寻味的是其消融中 KL 反而是四种损失里最差的(T-R@10 0.5452)。(b) teacher 特权来源不同——OneBar 是"未来的后验点击",Gryphon-v2 是"更长历史 + 更大容量 + 更多数据"。(c) 候选来源——OneBar 是纯 on-policy rollout,Gryphon-v2 显式混合 rollout 与 logged impressions 并用消融量化了纯 rollout 的代价(WPA 0.5730,全表最低),证据更完整。
- 可比的方法/实验差异:OneBar 输出自然语言查询(BART 骨架、beam 8、20–30ms 预算、
[REJECT]弃权内置安全谓词),线上 Query Exposure +16.91%、引导 GMV +21.67%;Gryphon-v2 输出 item 排序(0.5B encoder-decoder、beam 1,024、Triton GPU),线上活跃用户 +1.41%。OneBar 用三阶段渐进训练(SFT → 列表式对齐 → PIOPD),Gryphon-v2 是单一联合目标一次训完——工程上更省,但也失去了分阶段诊断能力,恰好对应它自陈的"A/B 无法隔离各组件边际贡献"。
UniSGR UniSGR:语义 ID 生成与排序的统一框架(阿里 AIDC / Lazada,2026-07-05)¶
关系:显式引用([22],仅在 §2.2 related work 一句带过,无方法/指标层对比)· 已加载对方精读
- 共同关注的问题:两文的问题陈述几乎可以互换——生成式检索能选出语义相关候选,却缺少工业排序所需的细粒度多目标判别力;而在生成器后简单外挂一个判别式 ranker 会重新引入"生成器优化候选可信度、ranker 在被截断的候选集上优化最终收益"的目标错位。
- 相近的技术骨架:都是在同一个 SID encoder-decoder 内挂一个多目标排序模块,复用生成侧的表示,服务时不再调用独立的 item-ID 排序模型。UniSGR 的排序模块直接长在 decoder 上,共享 semantic ID 表示、encoder 表示与 Decoder Representation Sharing;Gryphon-v2 的 Ranking Module 用 item 表征作 query 去 cross-attend 共享 encoder 状态 $E_u$。两者的 head 都是任务特定多目标输出,最终用固定/业务权重合成排序分。
- 本文的差异与推进:监督来源是分水岭。UniSGR 的排序模块用真实标签(click / atc / pay 的 BCE)训练,并用 VA-PMTP 把业务价值权重回灌到生成目标;Gryphon-v2 的 Ranking Module 完全不看真实标签,唯一监督是 Teacher Ranker 的连续分数。天花板因此截然不同:UniSGR 的上限是"日志标签能表达的偏好",Gryphon-v2 的上限是"Teacher Ranker 的质量"——好处是两周窗口就吸收了一个训练于全年数据、8,000 事件上下文的模型的知识(收回 54% WPA gap),坏处是 student 永远不可能超过 teacher,且 T-R@$k$ 存在循环性。另一处差异是候选分布:UniSGR 只在生成候选上打分,没有 on-policy/logged 双源设计。
- 可比的方法/实验差异:UniSGR 额外攻了推理效率(STARK 序列维树注意力,batchsize=1 下 QPS 119→219、时延 30.9ms→14.1ms,batchsize=8 时 QPS 596,约 +200% 吞吐),线上 Lazada 首页 IPV +3.36% / 成交笔数 +2.17% / GMV +5.68%;Gryphon-v2 走的是另一条效率路线——不优化解码本身,而是靠蒸馏把 teacher 的推理 pass 整个从服务路径删掉,换来 4× 吞吐。两者是"统一 generate-and-rank"路线上标签驱动派与教师蒸馏派的对照。
Rec-Distill Rec-Distill:面向大规模推荐模型的工业级蒸馏流水线(字节 AML,2026-05-28)¶
关系:显式引用([3],§2.3 中作为"工业配方把离线模型规模与在线服务成本解耦"的先例提及,无对比实验)· 已加载对方精读
- 共同关注的问题:共享同一条经济学 root cause——模型规模带来的收益与在线推理成本必须解耦:高容量模型离线明显更好但直接上线不可行,只能把知识搬进轻量的上线模型。Gryphon-v2 的 Teacher Ranker(8,000 事件上下文、ARGUS 式多位置自回归训练、算力不允许全量服务)与 Rec-Distill 的 24B 稠密参数 / 20K 序列教师,动机上是同一件事。
- 相近的技术骨架:都是教师-学生解耦——教师独立训练与刷新(Rec-Distill 靠流式训练跟随数据分布并把蒸馏信号缓存到中间存储;Gryphon-v2 的 Teacher Ranker 每日刷新且从不进服务图),学生消费教师的连续分数作监督。两者都用"黑盒"分数匹配而非中间表征对齐(前者教师 logits 的交叉熵,后者逐任务 MAE),都强调这种做法通用、简单、便宜。
- 本文的差异与推进:候选分布是 Gryphon-v2 相对 Rec-Distill 谱系的关键推进。Rec-Distill(以及 §2.3 提到的 ExFM)都从 logged impressions 抽取蒸馏候选。Gryphon-v2 指出这在 generate-and-rank 场景里不够:student 服务时面对的是自己 decoder 生成的候选,而它们大部分从未被生产曝光过——消融把这个论点量化了(impressions-only 的 T-R@10 仅 0.2983,不到混合方案 0.5654 的一半)。反过来,Rec-Distill 更系统地刻画了蒸馏规律:把收益分解为 $\Delta\mathrm{Gain}_{distill} = \Delta\mathrm{Gain}_{scale} \times \eta$,并给出师生容量鸿沟对 $\eta$ 的定量曲线(教师固定 7B 时学生从 1B 减到 376M、184M,$\eta$ 从 73% 降到 65%、48%)。Gryphon-v2 没有这一层分析——未报告师生规模比,也没有 $\eta$ 式迁移率度量("54% WPA gap 收回率"精神最接近但只有单点)。
- 可比的方法/实验差异:Rec-Distill 服务判别式 CTR/CVR 场景(AUC 增益,峰值 $\eta > 60\%$,抖音/TikTok 多场景线上显著),学生仍是级联中的一环;Gryphon-v2 服务生成式检索场景,学生本身就是整条级联的替代品。两者可视作同一套蒸馏经济学在判别式与生成式两种服务形态下的实例化。
讨论与局限性¶
核心贡献与值得借鉴的设计。
(1) "训练期专用高容量模型"这一角色定位极具复用价值。它不是奖励模型(无需 RL),不是线上 ranker(无需服务),而是纯粹的偏好函数供给方。Teacher Ranker 的 featureless 设计是隐藏枢纽——正因为它只依赖历史即可给任意 user–item 对打分,rollout 里那些从未曝光、没有日志特征的候选才可能被监督;想复刻这套方案的团队都得先付出"把 teacher 做成免特征"这笔代价。
(2) 候选分布对齐比损失函数选择重要得多。换损失(MAE/MSE/Huber/KL)的 T-R@10 波动区间是 0.5452–0.5748,换候选来源(impressions-only vs. 混合)的波动是 0.2983–0.5654——后者影响大了一个数量级。这是全文最有迁移价值的经验结论。
(3) 蒸馏作为服务成本的削减手段而非仅仅质量手段。4× 吞吐的来源不是模型压缩,而是"把 teacher 那次 8,000 事件的独立推理 pass 删掉、改为复用 student 自己 2,048 事件的历史编码",提示了把"上下文长度"纳入蒸馏收益核算的思路。
(4) 对 v1 遗留问题的正面回答。v1 证明了"item 级重打分能越过 SID beam 天花板",但只用 next-item + sampled softmax 实例化 ILSM,作者当时也承认它不能消除对生产 ranker 的需求。v2 靠换监督信号(而非架构)走通了这条路——Table 1 中两者共用同一套 Ranking Module 架构、T-R@10 从 0.0392 跳到 0.5654。
局限与争议。
- A/B 是整体性 treatment,无法隔离边际贡献。作者自陈:观测 delta 估计的是"替掉生产级联"的总效应。treatment 臂同时改变了候选生成、粗排、精排和更新频率四件事,+1.41% 有多少来自蒸馏、多少来自 10 分钟级在线更新,无从判断。
- 实验规模与时长受限。单一音乐界面、两臂各 8% 合格用户,只建立了采样流量上的短期可行性。作者还明确列出未评估的维度:长尾目录覆盖、艺人多样性、新颖性、曝光集中度——对一个"把 15+ 异构召回器压成单一 beam"的系统而言,这些恰是最该担心的(异构召回器的隐含功能之一就是保证多样性与探索)。
- 离线指标的循环性与分布错配。T-R@$k$ 用的是提供蒸馏目标的同一个 Teacher Ranker,衡量的只是蒸馏保真度——把它从 0.04 提到 0.5654 在定义上就是蒸馏成功的同义反复。WPA 则在现有级联曝光策略下记录的曝光上评估,不衡量 Gryphon-v2 自己会浮现的那批 item。作者对此毫不含糊:三者都不衡量端到端独立推荐质量。
- 与 RL 后训练无受控对比。论文未与 OneRec / OneRec-V2 / GPR 一族做受控对比,因此在相对质量、稳定性、算力效率上都不下结论,只称两条路线可能互补。
- student 上限被 teacher 锁死。Ranking Module 的唯一监督是 teacher 分数,WPA 天花板即 Teacher Ranker 的 0.6199——相对 UniSGR 那种直接用真实标签的路线,这是明确的方法论代价。
- 方法论可扩展性隐忧。SID 码本(3 × 32,000,residual $K$-means)在联合训练前固化,扩参时"如何表征历史"与"如何建模序列"两条路径仍受离散接口约束;beam 依然是召回上界——Ranking Module 只能在 ≤1,200 个解析 item 内重排。此外训练 rollout beam(32)与服务 beam(1,024)有 32 倍分布缺口,作者虽用 beam 64/128 说明提升温和,但该缺口在更大候选预算下是否仍无害并无证据。
定位。 在 2026 年"用一个模型替掉推荐级联"的密集竞赛中,Gryphon-v2 走的是最保守也最工程可控的一条路:不碰 tokenizer、不上 RL、不改服务接口,只把一个已验证优于生产 ranker 的离线大模型的偏好,通过 on-policy 候选分布蒸馏进 0.5B 的服务模型。它的贡献与其说是新方法,不如说是新配方——把"统一 generate-and-rank 架构"(自家 v1)与"外部大教师蒸馏"(Rec-Distill / ExFM 一族)两块成熟积木拼起来,并补上两者交界处缺失的一环:蒸馏候选必须来自 student 自己的生成分布。对同类工业团队而言,这个配方的可复现性远高于 RL 后训练路线,代价是排序质量上限被外部 teacher 锁死。