Multi-Decoder OneRec:面向多目标工业推荐的可控生成式召回¶
Kuaishou Technology(快手),2026-07-29,投稿 KDD '27。作者 14 人(You Wang、Zhao Liu、Guoping Tang、Yiqing Yang 为共同一作,Xiao Lv、Ruiming Tang 为通讯作者)。
研究动机与背景¶
工业多目标召回的两难¶
大规模推荐系统必须在固定的候选预算下同时服务多个业务目标。工业界的标准做法是多路召回(multi-route retrieval):为 watch-time、explicit interaction、Cold-Start 等目标各自建一条专门的召回路,并给每条路分配一个可配置的配额(quota)。这套设计的好处是覆盖面广、且能直接控制候选池的组成——运营想让冷启多占 10% 的位置,改配额即可。
代价是:随着召回路数量增长,建模、训练、服务三件事同时碎片化,计算与维护开销线性上涨。论文因此把动机定位为:需要一个共享建模容量、但不牺牲对候选组成的显式控制的统一召回器。
生成式召回(generative retrieval)看起来正是答案:把每个 item 表示成一条离散的 Semantic ID(SID)序列,召回变成自回归的 next-token 预测。但论文指出,多数统一生成器用单个 decoder 服务所有目标——因为所有目标共享同一套注意力与前馈层,联合训练把各目标的策略耦合在一起:对某一个目标的更新会改变其他目标所使用的变换,当监督信号与偏好候选分布发散时就会产生负迁移(negative transfer)。推理时,各个"目标条件化"的运行还可能都偏向同一批高概率 SID 区域,在固定预算下产出互相重叠的候选列表。
现有方法通过 prompt、task token、behavior token 注入目标区分度(P5、MBGen、GenSAR),或用 register token / 上下文相关的 BOS query(EARN 一类)。论文的批评很锋利:这些机制只引入了少量目标特定状态,主要落在输入或初始解码状态上;决定 token 概率的核心变换仍然是共享的。它们改变的是"一个共同策略如何被条件化",而不是"给每个目标专属的可训练变换",因此目标策略依旧耦合。
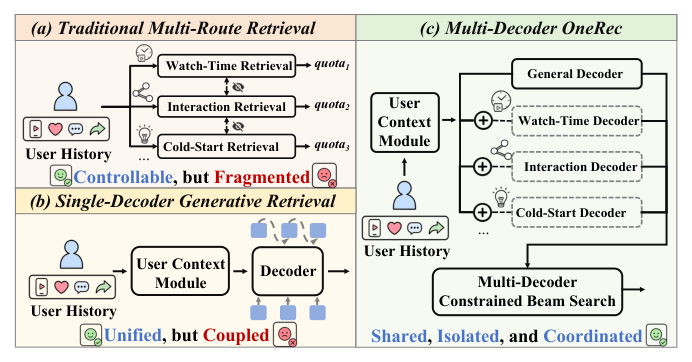
Figure 1 的 (a)(b) 两栏正是这个核心 trade-off 的总结:传统多路召回可控但碎片化,单 decoder 生成式召回统一但耦合。
三条耦合的需求¶
论文把解决这个 trade-off 拆成三条互相耦合的需求:
- 共享建模必须支持独立的目标更新。复用用户表征与共同的 SID 生成先验可以避免整个 decoder 被复制,但每个目标仍需要足够的可训练容量去适配,同时不扰动 General Decoder 或其他目标。给每个目标复制一个完整 decoder 虽然能恢复独立性,却把模型、训练、服务的碎片化又搬了回来。
- 优化必须容纳异质反馈,同时保持生成有效性。不同目标需要不同的样本构造与学习信号,但专门化不能破坏从广谱曝光中学到的合法 SID 分布(valid SID distribution)。
- 独立策略必须产出互补候选。各自独立的策略仍可能产出重叠的高概率候选,因此需要显式配额 + 协同搜索,防止重叠白白浪费固定预算。
因此一个可用的框架必须做到:表征上共享、目标更新上隔离、解码上协同(shared in representation, isolated in objective-specific updates, coordinated in decoding)。
三点核心贡献¶
- 共享但隔离的架构(Shared yet isolated architecture):共享 user-context module 提供可复用的用户表征,全参数化的 General Decoder 提供基座权重与共同的 SID 生成先验;每个目标挂一个隔离专家,含 LoRA 更新、一个目标特定的 BOS embedding、以及对共享 SID embedding table 的加性偏移。专家 + General Decoder 共同构成一个目标特定 decoder。
- 反馈自适应优化 + 梯度隔离(Feedback-adaptive optimization with gradient isolation):General Decoder 与各目标专家并发训练,来自不相交的监督流、走不相交的梯度路径。曝光样本 NTP 更新共享基座;每个目标损失只更新其对应专家参数,在共享基座参数处截断梯度。事件型专家在目标过滤样本上做 NTP;Watch-time 专家用以用户历史归一化的相对奖励做策略优化。KL 正则以 General Decoder 的 stop-gradient 分布为参考,把 Watch-time 专家锚定在共同 SID 先验上,同时 General Decoder 继续从曝光样本学习。
- 配额协同解码(Quota-aware coordinated decoding):MD-CBS 给每个目标 decoder 一个显式配额,并屏蔽已被更早路线占用的 SID 前缀。约束层级决定屏蔽的是完整 SID 还是更粗的语义区域。General Decoder 最后运行,用尚未被选中的合法候选回填剩余预算。
- 公开 Kwai26:十亿级的多目标生成式召回基准,含预定义划分与评估协议。
问题形式化¶
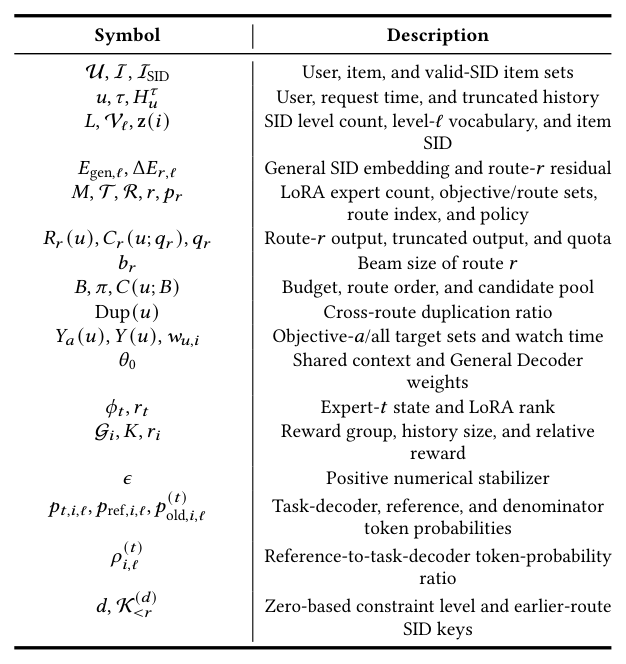
设 $\mathcal{U}$、$\mathcal{I}$ 为用户与 item 集合,$\mathcal{I}_{\text{SID}} \subseteq \mathcal{I}$ 为拥有合法 SID 的可召回 item。用户 $u$ 在请求时刻 $\tau$ 的 session 是已排序的服务 item 列表加上严格时间截断的可用历史 $H_u^\tau = (x_1, \ldots, x_n)$。每条 $\tau$ 之前的交互记录 Item-ID、内容与作者特征、反馈、时间戳。沿用生成式召回的设定,$i \in \mathcal{I}_{\text{SID}}$ 有编码
$$\mathbf{z}(i) = (z_0(i), \ldots, z_{L-1}(i)), \qquad z_\ell(i) \in \mathcal{V}_\ell, \quad 0 \le \ell < L \tag{1}$$
其中 $\mathcal{V}_\ell$ 是第 $\ell$ 层词表。所有路线共享同一份 code-to-item 映射。令 $\mathcal{R} = \{\text{gen}\} \cup \mathcal{T}$,$\mathcal{T} = \{1, \ldots, M\}$ 为目标路线集合。路线 $r$ 在 General Decoder 的基座 embedding $E_{\text{gen},\ell}$ 上加一个残差:
$$\mathbf{e}_{r,\ell}(z) = \big(E_{\text{gen},\ell} + \Delta E_{r,\ell}\big)[z], \qquad r \in \mathcal{R} \tag{2}$$
其中 $\Delta E_{\text{gen},\ell} = 0$。item 身份是共享的,但它的解码表征是路线自适应的——这是"共享 SID 词表却允许各路线有不同 SID 语义视角"的关键机制。
路线 gen 负责曝光召回(exposure retrieval)。专门化目标在离线是 Long-View、Like、Watch-time,在生产是 Watch-time、Share、Cold-Start;只有标签与监督信号不同。每条路线自回归产出有序列表 $R_r(u)$:
$$p_r(\mathbf{z} \mid H_u^\tau) = \prod_{\ell=0}^{L-1} p_r\big(z_\ell \mid z_{<\ell}, H_u^\tau\big) \tag{3}$$
配额满足 $q_{\text{gen}} + \sum_{t \in \mathcal{T}} q_t = B$,产出候选池
$$C(u;B) = \text{Merge}_\pi\Big(\big\{(R_r(u), q_r)\big\}_{r \in \mathcal{R}}\Big), \qquad |C(u;B)| \le B \tag{4}$$
$\text{Merge}_\pi$ 按路线顺序 $\pi$ 执行,剔除已被更早接受的 item,并保留当前路线最高概率的合法 item。合并之前,受限解码已阻止后续路线重新生成已占用前缀;General Decoder 最后运行,在自己的配额内检索未被见过的合法 item。未协同的重叠会按下式损失容量:
$$\text{Dup}(u) = 1 - \frac{\big|\bigcup_{r \in \mathcal{R}} C_r(u; q_r)\big|}{\sum_{r \in \mathcal{R}} \big|C_r(u; q_r)\big|} \tag{5}$$
其中 $C_r(u;q_r)$ 是路线 $r$ 配额截断后、合并前的输出。
对离散目标 $a$(held-out 目标集 $Y_a(u)$),item 级 recall 为
$$\text{Recall}^{(a)}@B = \frac{\sum_u \big|C(u;B) \cap Y_a(u)\big|}{\sum_u \big|Y_a(u)\big|} \tag{6}$$
对 Watch-time,用加权 recall:
$$\text{WTRecall}@B = \frac{\sum_u \sum_{i \in Y(u)} w_{u,i}\,\mathbb{I}\big[i \in C(u;B)\big]}{\sum_u \sum_{i \in Y(u)} w_{u,i}} \tag{7}$$
$Y(u)$ 是所有 held-out 目标,$w_{u,i}$ 是观测到的观看时长。优化目标是在预算 $B$ 下同时提高 general 与目标特定 recall,且保持低任务参数量、低解码成本、低重复率。硬约束:LoRA 专家 $t$ 的梯度不得进入共享基座或其他专家,而基座 NTP 持续更新共享参数。
核心方法:Multi-Decoder OneRec¶
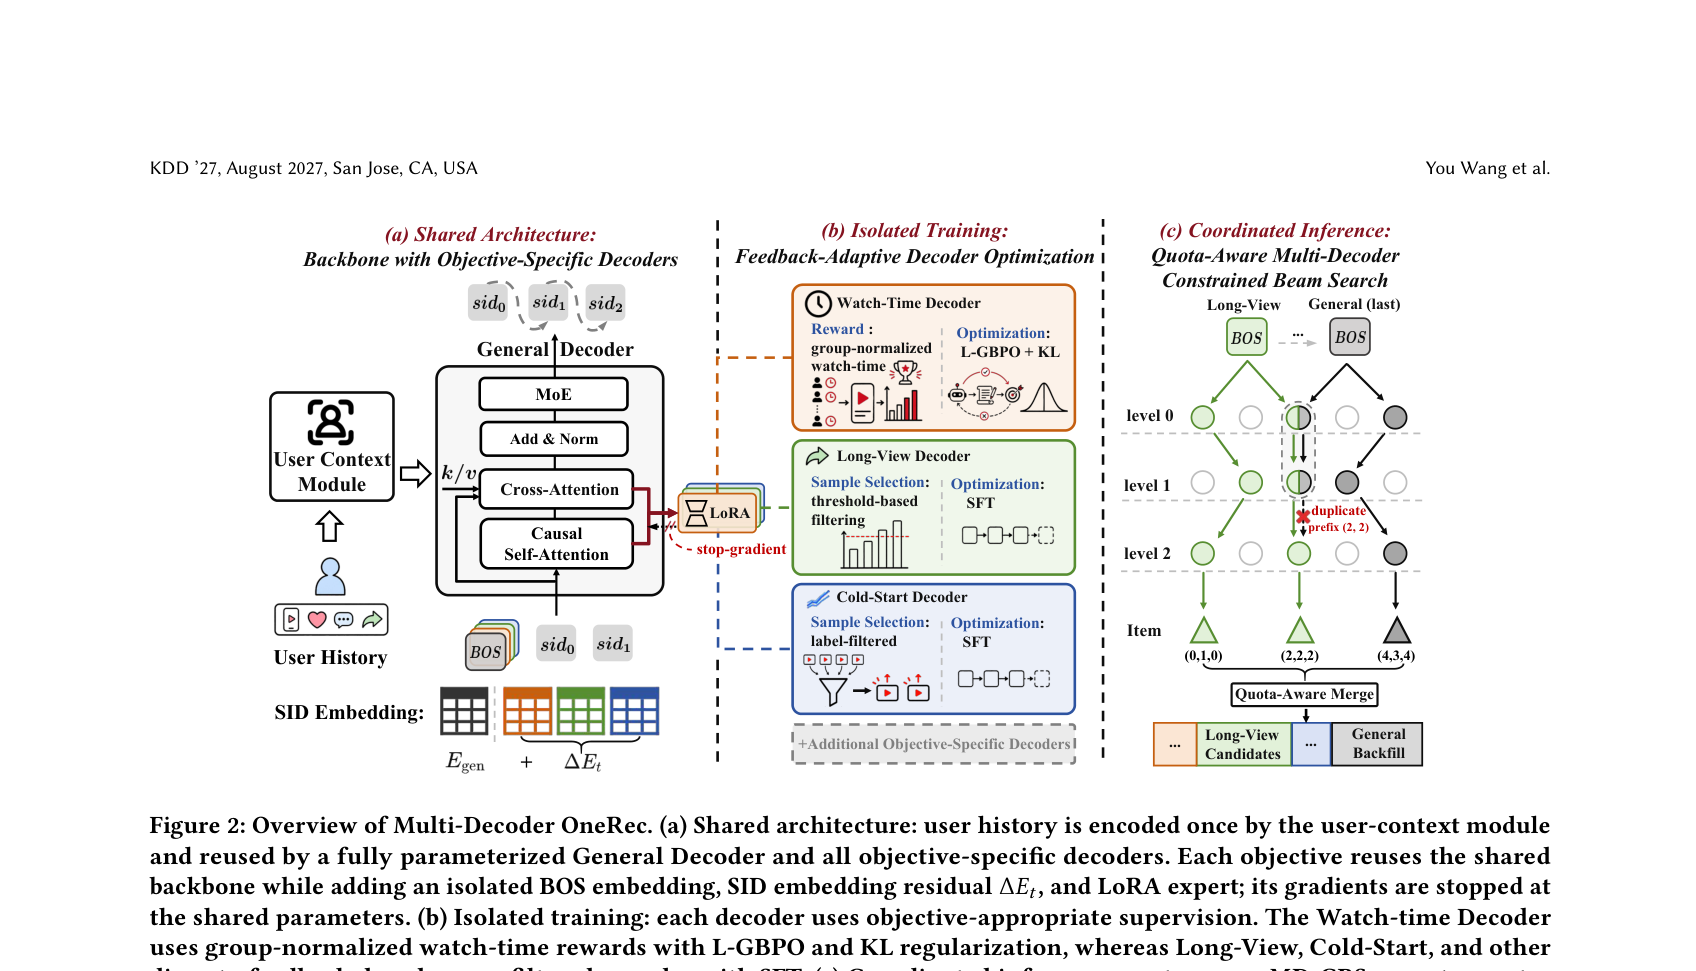
Multi-Decoder OneRec 建在 OneRec 式的 encoder–decoder 骨干上,包含一个 user-context module、一个全参数化 General Decoder、$M$ 个目标特定 decoder。General Decoder 学习通用曝光召回并提供共同 SID 生成先验;目标 LoRA 专家 $t$ 复用基座权重,只加独立 BOS embedding、SID embedding 残差、LoRA 参数。共享参数捕获可迁移的用户兴趣与 SID 句法(SID syntax),隔离的任务参数支持梯度隔离的目标更新,协同解码则把策略差异在固定预算下转化成互补候选。
用户上下文预填充(User-Context Prefilling)¶
encoder 侧,每个请求由两条时间截断的行为视图表示:用户历史序列中最近 20 个交互视频 + 256 个 Long-View 视频。这个设计让模型能在任何目标特定解码之前,就联合捕获短期意图与长期偏好。
每个事件构造成五字段特征 tuple:Item-ID、author ID、tag、time difference、watch time。字段先映射为 embedding,再送进四块 encoder。每个 encoder block 含 feature-level cross-attention 与 sequence-level self-attention:cross-attention 子层融合异质 item 特征,self-attention 子层建模用户行为序列内部的依赖。堆叠编码后得到用户上下文状态
$$\mathbf{H}_u = \text{Enc}(H_u^\tau)$$
它每个请求只算一次,然后被所有 decoder 路线的 cross-attention 模块复用为 key 与 value。这是全文"计算不碎片化"的第一个支点。
Multi-Decoder¶
decoder 侧,每个 target video 由一串离散 SID token 表示,每个 SID token 经 embedding lookup 映射为向量。训练时 General Decoder($\text{Decoder}_0$)的输入由一个可学习的 BOS embedding 与右移后的 target SID 序列拼接而成,送入堆叠的 Transformer decoder block(masked self-attention + cross-attention + FFN)。masked self-attention 保持 SID 生成的自回归分解,cross-attention 注入编码后的用户兴趣上下文 $\mathbf{H}_u$,FFN 做非线性变换。
为了在不复制完整 decoder 的前提下适配不同下游目标,论文在 $\text{Decoder}_0$ 之上为每个任务引入一组独立的 LoRA 参数。论文给出的两条理由很实际:(a) 工业系统里为每个任务维护完整 decoder 会带来随任务数增长的计算、内存、部署成本;(b) 许多下游目标监督极度稀疏,难以充分训练一个大的任务专属 decoder,容易参数估计不准、泛化差。LoRA 则在保留骨干共享知识的同时实现参数高效的任务专门化。
具体地,LoRA 更新 masked self-attention 与 cross-attention 中的 query、key、value 投影矩阵。对任务 $t$,每个被适配的投影写作:
$$\mathbf{W}^{(t)} = \mathbf{W}_0 + \Delta\mathbf{W}^{(t)} = \mathbf{W}_0 + \mathbf{B}^{(t)}\mathbf{A}^{(t)} \tag{8}$$
其中 $\mathbf{W}_0$ 是从 $\text{Decoder}_0$ 继承的共享投影矩阵,$\mathbf{A}^{(t)} \in \mathbb{R}^{r_t \times d_{\text{in}}}$、$\mathbf{B}^{(t)} \in \mathbb{R}^{d_{\text{out}} \times r_t}$ 是独立学习的低秩矩阵,$r_t \ll \min(d_{\text{in}}, d_{\text{out}})$。这些低秩增量让每个任务学到自己的表征与生成模式,同时复用共享骨干的通用 SID 生成能力。
此外,每个下游任务有一个独立可学习的 BOS embedding $\mathbf{b}_t$,在生成起点显式注入任务信息;它的 SID lookup table 也由共享的 $\text{Decoder}_0$ embedding 加任务特定残差组成(式 2)。任务 $t$ 的完整可训练状态为
$$\phi_t = \big\{\mathbf{A}^{(t)}, \mathbf{B}^{(t)}, \mathbf{b}_t, \Delta E_t\big\} \tag{9}$$
其中 $\mathbf{A}^{(t)}$、$\mathbf{B}^{(t)}$ 表示挂在注意力投影上的所有低秩矩阵,$\Delta E_t = \{\Delta E_{t,\ell}\}_{\ell=0}^{L-1}$ 收集各层 SID embedding 残差。$\phi_t$ 与所有其他专家隔离,因此更新一个目标不会改动 General Decoder 或另一个 LoRA 专家。
目标特定训练(Objective-Specific Training)¶
分配给某个 decoder 的监督样本与其损失共同塑造该 decoder 的行为:样本选择定义目标行为,目标函数决定 decoder 把生成策略推向该行为的方式。为防止新引入的目标干扰 $\text{Decoder}_0$ 或彼此,目标损失的梯度被阻止传播进共享 user-context module 与 General Decoder;而曝光损失继续更新这两个共享组件。
Next-Token Prediction¶
General Decoder 在曝光 item 上做 NTP 训练。给定用户上下文 $c$ 与 target SID $\mathbf{y} = \mathbf{z}(i) = (y_0, \ldots, y_{L-1})$:
$$\mathcal{L}_{\text{base}} = -\sum_{\ell=0}^{L-1} \log p_{\text{gen}}\big(y_\ell \mid c, y_{<\ell}\big) \tag{10}$$
离散任务的 LoRA 专家只在满足对应行为条件的样本上训练:Like decoder 用被点赞的 item,Long-View decoder 用 Long-View item。任务 SFT 损失为
$$\mathcal{L}_{\text{SFT}}^{(t)} = -\sum_i \sum_{\ell=0}^{L-1} m_i^{(t)} \log p_t\big(y_{i,\ell} \mid c_i, y_{i,<\ell}\big) \tag{11}$$
$m_i^{(t)}$ 指示样本 $i$ 对目标 $t$ 是否有效。这条监督流只有 $\phi_t$ 收到梯度,因此它的更新既不改变共享基座也不改变其他专家。
基于奖励的策略优化¶
对连续的 Watch-time 目标,二值化的 NTP 只能提供粗糙监督——阈值化会把正样本之间的偏好幅度差异压平。论文因此构造一个个性化的相对奖励,保留连续反馈的强度。对样本 $i$,令 $\mathcal{G}_i$ 包含它自身的观看时长以及该用户最近 $K$ 个合法历史 item 的观看时长,标准化奖励为
$$r_i = \frac{w_i - \mu(\mathcal{G}_i)}{\sigma(\mathcal{G}_i) + \epsilon} \tag{12}$$
$w_i$ 是当前观看时长($w_{u,i}$ 的样本索引形式),$\mu$、$\sigma$ 是组统计量,$\epsilon > 0$ 是数值稳定项。这把 group-relative reward normalization(GRPO / DeepSeekMath 一路)适配到了单个用户自己的日志历史上——奖励衡量的是"这次观看相对该用户平常表现如何",而不是相对全体用户。
任务 decoder 是策略 $p_t$,而 stop-gradient 的前向传播(走 General Decoder)提供参考概率 $p_{\text{ref}}$。记 ground-truth token 概率 $p_{t,i,\ell} = p_t(y_{i,\ell} \mid c_i, y_{i,<\ell})$、$p_{\text{ref},i,\ell} = p_{\text{ref}}(y_{i,\ell} \mid c_i, y_{i,<\ell})$,stop-gradient 分母写作
$$p_{\text{old},i,\ell}^{(t)} = \begin{cases} \max\big(p_{\text{ref},i,\ell},\; \text{sg}(p_{t,i,\ell})\big), & r_i \ge 0, \\[4pt] \max\big(p_{\text{ref},i,\ell},\; 1 - \text{sg}(p_{t,i,\ell})\big), & r_i < 0 \end{cases} \tag{13}$$
其中 $\text{sg}(\cdot)$ 截断梯度。life-long gradient-bounded policy optimization(L-GBPO)目标为
$$\mathcal{L}_{\text{L-GBPO}}^{(t)} = -\mathbb{E}_i\left[r_i \frac{p_{t,i,\ell}}{p_{\text{old},i,\ell}^{(t)} + \epsilon}\right] \tag{14}$$
样本级奖励 $r_i$ 被 item $i$ 的所有 SID 位置共享。
与 OneRec-V2 的 GBPO 的血缘关系:OneRec-V2 的 GBPO 用同构的 dynamic bound $\pi'_{\theta_{\text{old}}} = \max(\pi_{\theta_{\text{old}}}, \text{sg}(\pi_\theta))$(正样本)/ $\max(\pi_{\theta_{\text{old}}}, 1 - \text{sg}(\pi_\theta))$(负样本),把 RL 梯度约束在 BCE loss 的梯度范围内,解决 ratio-clipping 在 $\pi_\theta \to 0$ 时的梯度爆炸。本文的 L-GBPO 做了两处改造:(a) 把参考分布从"旧策略 $\pi_{\theta_{\text{old}}}$"换成"持续在线学习的 General Decoder $p_{\text{ref}}$"——这正是 "life-long" 的含义,因为共享基座一直在被曝光 NTP 更新,参考分布并非冻结快照;(b) 把 GBPO 的三值 advantage $A_i \in \{+1, -1, 0\}$ 换成连续的用户内标准化奖励 $r_i$,保留观看时长的幅度信息。
参考策略正则化阻止偏好优化漂离通用 SID 先验。token 概率比定义为
$$\rho_{i,\ell}^{(t)} = \frac{p_{\text{ref},i,\ell}}{p_{t,i,\ell}} \tag{15}$$
它比较参考策略与任务策略在观测 token 上的概率。非负的 token 级 KL surrogate 为
$$\mathcal{L}_{\text{KL}}^{(t)} = \mathbb{E}_i\left[\rho_{i,\ell}^{(t)} - \log \rho_{i,\ell}^{(t)} - 1\right] \tag{16}$$
期望在所有合法的日志训练位置上取平均。(这是 $k_3$ 型无偏 KL 估计量,恒非负且在 $\rho = 1$ 处取 0。)Watch-time 专家 $t$ 的目标为
$$\mathcal{L}_{\text{RL}}^{(t)} = \lambda_{\text{L-GBPO}}^{(t)}\mathcal{L}_{\text{L-GBPO}}^{(t)} + \lambda_{\text{KL}}^{(t)}\mathcal{L}_{\text{KL}}^{(t)} \tag{17}$$
$\lambda_{\text{L-GBPO}}^{(t)}$ 与 $\lambda_{\text{KL}}^{(t)}$ 分别控制偏好学习与参考正则化。
并发优化与梯度路由¶
曝光监督与目标监督在一个训练过程中并发优化,各自的 batch 可以交错或混合。是梯度路由(gradient routing)而不是时间冻结(temporal freezing)隔离了它们的更新。令 $\theta_0$ 表示 user-context module 与 General Decoder 共享的参数,梯度路由后的目标为
$$\mathcal{L} = \mathcal{L}_{\text{base}} + \lambda_{\text{SFT}}\sum_{t \in \mathcal{T}_{\text{SFT}}} \mathcal{L}_{\text{SFT}}^{(t)}\big(\text{sg}(\theta_0), \phi_t\big) + \sum_{t \in \mathcal{T}_{\text{RL}}} \mathcal{L}_{\text{RL}}^{(t)}\big(\text{sg}(\theta_0), \phi_t\big) \tag{18}$$
$\text{sg}(\theta_0)$ 允许当前共享基座参与每个目标 decoder 的前向传播,但不接收它的梯度;$\mathcal{T}_{\text{SFT}}$ 与 $\mathcal{T}_{\text{RL}}$ 按训练类型划分专门化目标,$\lambda_{\text{SFT}}$ 加权 SFT 损失。因此,基座 NTP 是 $\theta_0$ 的唯一更新来源,而每个目标损失只更新它对应的 $\phi_t$。
Multi-Decoder Constrained Beam Search(MD-CBS)¶
Figure 2(c) 展示了协同推理过程。独立解码 + 事后去重会浪费 beam 容量:不同 decoder 可能把配额花在同一个 item 上,让合并后的候选池低于名义召回预算。MD-CBS 是受限解码的多 decoder 变体:它按预定义的优先级顺序执行各 decoder 路线,同时禁止已被更早路线占用的候选。每条路线由三元组 $(r, b_r, q_r)$ 指定,$b_r$ 是 beam size、$q_r$ 是输出配额。配额之和等于最终召回预算 $B$,General Decoder 被放在最后,负责回填剩余的通用曝光槽位。
由于 Item SID 是层次化的,约束可以施加在任意零基 SID 层级 $0 \le d < L$。令 $\mathbf{z}_{0:d} = (z_0, \ldots, z_d)$ 为对应的部分假设,MD-CBS 把它作为去重 key。对路线 $r$,令 $\mathcal{K}_{<r}^{(d)}$ 表示在顺序 $\pi$ 下被更早路线接受的所有 level-$d$ key,$s_r(\mathbf{z}_{0:d})$ 为其路线得分,则屏蔽后的得分为
$$s'_r(\mathbf{z}_{0:d}) = \begin{cases} -\infty, & \mathbf{z}_{0:d} \in \mathcal{K}_{<r}^{(d)}, \\[3pt] s_r(\mathbf{z}_{0:d}), & \text{otherwise} \end{cases} \tag{19}$$
路线 $r$ 跳过被屏蔽的候选,沿自己的 beam 列表往下走,直到接受 $q_r$ 个唯一候选或 beam 耗尽。被接受的 key 随后插入 $\mathcal{K}_{\le r}^{(d)}$,下一条路线才开始。
约束层级 $d$ 控制质量–效率 trade-off:$d$ 更小会移除更多"被占用前缀"、从而降低解码成本,但也收窄搜索广度——一旦某个粗前缀被占,后续路线就不能在同一个粗语义区域下探索其他有用 item;$d$ 更大延迟去重、保留更丰富的语义探索,但需要更多解码。默认设置中每个 item SID 有三层 $(z_0, z_1, z_2)$,取 $d = 2$,即用完整 SID tuple 作为 key。这既防止重复完整 SID,又不会过早剪掉语义相关但不同的 item;由 SID-to-item 碰撞引起的 item 级重复在合并时移除。更早层的约束在 §5.3 作为粒度变体做了消融。最后 General Decoder 在自己的配额内检索未见过的完整 SID,把独立训练的目标特定 decoder 转成受配额控制、无重复的候选池。
服务流程(Serving Workflow)¶
所有 decoder 在服务时共享一份物化的 encoder 表征。每个 active decoder 应用自己的 BOS、SID 残差、LoRA 状态、beam size、配额,然后做受限合并。因此目标集合与配额分配可以改变而无需修改 General Decoder 或任何 LoRA 专家——这是这套设计对运营最有价值的性质。每增加一个 decoder 仍会带来 decoder 计算开销,§5.5 单独报告(与参数量分开)。
Kwai26 数据集构建¶
论文从一个工业短视频平台 60 个连续日(2026-05-02 至 2026-06-30)的交互构建 Kwai26。
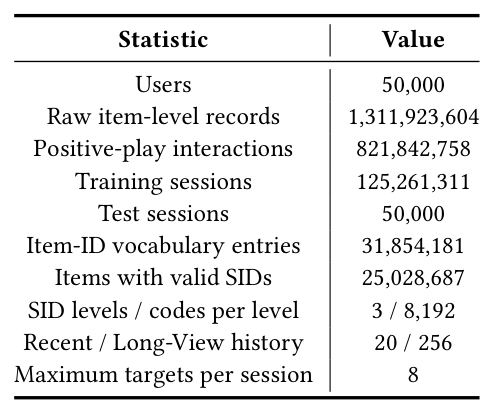
13.1 亿原始记录产出 8.2184 亿正播交互与 1.2526 亿训练 session,5 万用户各留出一个 held-out session。每条事件记录用户与请求标识、事件时间与展示位置、Item-ID 与 author ID、内容 tag、视频时长与观看时长、行为 flag、两个 SID 串。
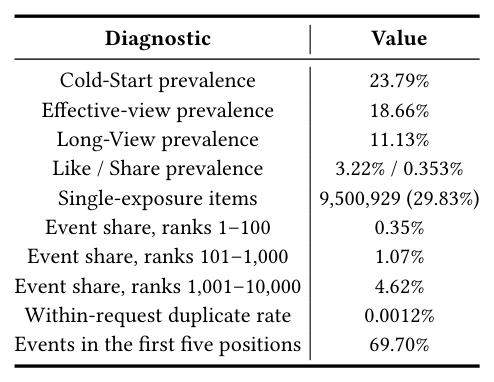
Table 9 报告正播过滤前的源分布诊断:Cold-Start prevalence 23.79%、Effective-view 18.66%、Long-View 11.13%、Like/Share 3.22%/0.353%;单次曝光 item 950.09 万(29.83%);事件在 rank 1–100 上只占 0.35%、rank 101–1000 占 1.07%、rank 1001–10000 占 4.62%(说明长尾极重);请求内重复率仅 0.0012%;69.70% 的事件落在前五个展示位置。
标签与任务视图:Watch-time 是连续效用信号;Effective View 与 Long-View 是平台定义的消费标签;Like 与 Forward 是显式反馈;Cold-Start flag 标记新内容。评估用 General、Long-View、Like、Watch-time 四个视图,最后一个按原始观看时长给 target 加权。
session 定义与规范顺序:一个 session 聚合同一 user + request 标识的事件;事件按时间、展示位置、Item-ID 稳定排序且不去重,同一顺序同时定义 target 与用户历史。
Stage 1(事件过滤与物化,Algorithm 1):把缺失的整型/布尔/字符串字段映射为 $-1$、$0$、空串;移除 4.9008 亿非正观看时长事件(保留总数见 Table 8)。一条剩余事件若主 SID 缺失、或 item / duration / timestamp / request 字段非法,则不能作为 target,但仍可作为历史保留——这个"可作历史不可作 target"的区分是 Kwai26 的一个细节设计。缺失主 SID 占 5832.4674 万此类事件中的 5832.4134 万。Stage 1 物化 1.2625 亿 session 与每用户的按时间历史。
Stage 2(防泄漏历史、target 与划分,Algorithm 2):左界 LowerBound 确保每条历史事件都严格早于 $\tau$;$H_{\text{recent}}$、$H_{\text{LV}}$、$H_{\text{WT}}$ 分别为 recent、Long-View、raw watch-time 历史。历史位置包含 item、author、tag、分桶后的观看时长与时间差、mask、三层 SID 特征,并做左侧 padding。FirstEligible 保留未被拒绝且有合法三层 SID 的 item;target 存 Item-ID 与其 SID,右侧 padding。Stage 2 移除 49,749 个无历史 session 与 884,987 个无合法 target 的 session。
划分与严格训练布局:两道检查之后,每个用户的最后一个合法 session 作为测试数据,更早的所有 session 作为训练数据;不设验证划分,也不用日期/百分比替代方案。Stage 2.5 按 request time、user ID、request 标识、sample key 稳定归并训练行,不做过滤或重采样。32 lane 下每个 2048 行物理 block 产生两个 1024 行 optimizer step(共 122,324 步),最后 1,535 行尾部不参与优化。
特征词表与 SID 目录:OneRec 在这些位置用 item、author、tag、watch-time、time-gap、mask 特征;TIGER 只用 SID。三层 SID 由 residual-quantization K-Means(RQ-KMeans)生成。author/tag 词表含 1,829,583 / 36 项;目录保留 27,139,853 个合法 Item-ID–SID 对与 23,909,817 个 code;其中 1,983,033 个 item 拥有多个 SID(每个至多 8 个)。
数据流水线开源于 https://github.com/liuzhao09/Kwai26-Data-Pipeline。
实验设置¶
Baselines¶
- DSSM:双塔编码用户历史与 item,做全目录 ANN 召回。
- SASRec:因果 Transformer 编码时序行为序列,接 ANN 召回。
- HSTU:pointwise aggregated attention + gated residual updates 的工业序列 encoder,接全目录 ANN 召回。
- TIGER:用 SID 编码 item 历史,自回归生成 target SID 序列。
- OneRec:与本方法相同的多字段 encoder + 单个 decoder(匹配本文的 General Decoder)。
所有 baseline 与本方法接收相同的 session、时序划分、时间截断的 recent-20 与 Long-View-256 行为位置,只在特征表示与召回机制上不同。DSSM / SASRec / HSTU 在曝光 target 上训练,在完整 item 目录上返回 ANN Top-512。TIGER、OneRec 与本方法共享 SID 词表,用 beam search 返回 512 个 item。专门化反馈在本方法中只训练对应的 decoder;General Decoder 使用与 baseline 相同的曝光监督。
实现细节¶
| 超参 | 值 |
|---|---|
| hidden size | 256 |
| encoder / decoder block 数 | 各 4 层,8 heads |
| SID | 3 层 × 8,192 codes/层 |
| 训练 | 一遍时序 pass(one chronological pass) |
| global batch size | 1,024 |
| 默认 LoRA rank | 32 |
| 评估目录 | 相同的 25.03M item Kwai26 目录 |
Beam size:Long-View 86、Like 171、Watch-time 256、General Decoder 512。配额:86、85、85、256,总预算 512。MD-CBS 施加在 SID 最后一层以获得最优性能。
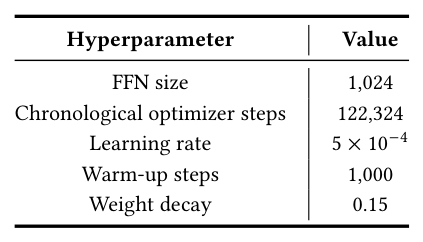
| 超参 | 值 |
|---|---|
| FFN size | 1,024 |
| chronological optimizer steps | 122,324 |
| learning rate | $5 \times 10^{-4}$ |
| warm-up steps | 1,000 |
| weight decay | 0.15 |
指标¶
报告 item 级 Recall@512,覆盖 Exposure(Exp.)、Long-View、Like,以及 Watch-time(WT)Recall@512。Long-View 表示平台定义的 Long-View 标签。前三个指标按式 (6),最后一个按式 (7) 用观测观看时长加权。所有 recall 在 50,000 个测试 session 的 target item 上做微平均(micro-average)。诊断实验额外使用 SID legal rate(映射到合法 Item-ID–SID 对的生成 SID 候选比例)、合法候选总数、参数量、FLOPs。
主要实验结果¶
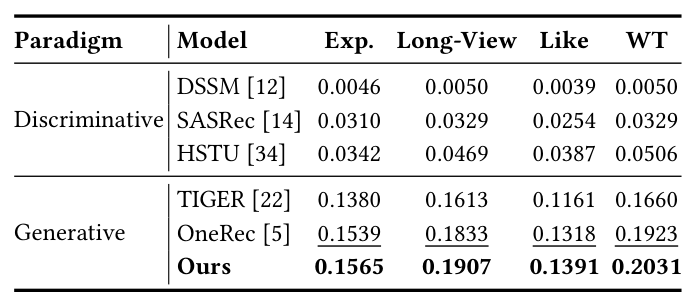
| Paradigm | Model | Exp. | Long-View | Like | WT |
|---|---|---|---|---|---|
| Discriminative | DSSM | 0.0046 | 0.0050 | 0.0039 | 0.0050 |
| Discriminative | SASRec | 0.0310 | 0.0329 | 0.0254 | 0.0329 |
| Discriminative | HSTU | 0.0342 | 0.0469 | 0.0387 | 0.0506 |
| Generative | TIGER | 0.1380 | 0.1613 | 0.1161 | 0.1660 |
| Generative | OneRec | 0.1539 | 0.1833 | 0.1318 | 0.1923 |
| Generative | Ours | 0.1565 | 0.1907 | 0.1391 | 0.2031 |
结论分析(两条清晰趋势):
- SID 生成式召回在大规模稀疏工业目录上大幅超过三个 embedding 召回 baseline。差距是数量级级别的:最强判别式 baseline HSTU 的 Exposure Recall@512 只有 0.0342,而 TIGER 已达 0.1380(4 倍),OneRec 0.1539。这印证了在 2500 万 item 的目录上,生成结构化 item 标识符比在 embedding 空间里做 ANN 检索更有效——ANN 在极长尾(29.83% 的 item 只被曝光一次)上召回能力极弱,而层次 SID 的粗到细搜索天然把概率质量分配到语义区域上。
- Multi-Decoder OneRec 在每个 target 集合上都优于单 decoder OneRec,相对提升分别为 Exposure +1.69%、Long-View +4.04%、Like +5.54%、Watch-time +5.62%。
值得注意的是提升幅度的梯度:Exposure 只涨 1.69%,而三个专门化目标涨 4–5.6%。这符合方法设计的意图——General Decoder 的曝光监督并未改变,涨的 1.69% 来自"配额控制的目标 decoder 联合把额外的高价值候选塞进了同一个 512 预算";而专门化目标涨得多,是因为它们第一次有了自己的可训练变换。论文的总结是:配额控制的目标特定 decoder 之并集在增强目标特定召回的同时保住了通用曝光覆盖。
消融与分析¶
单 decoder vs 多 decoder 训练¶
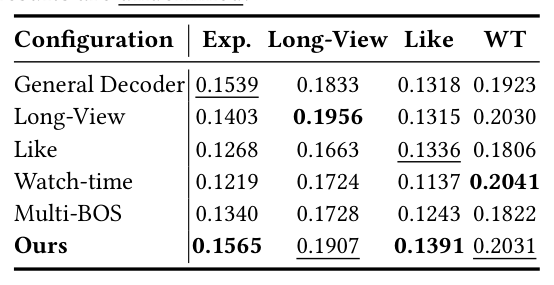
| Configuration | Exp. | Long-View | Like | WT |
|---|---|---|---|---|
| General Decoder | 0.1539 | 0.1833 | 0.1318 | 0.1923 |
| Long-View | 0.1403 | 0.1956 | 0.1315 | 0.2030 |
| Like | 0.1268 | 0.1663 | 0.1336 | 0.1806 |
| Watch-time | 0.1219 | 0.1724 | 0.1137 | 0.2041 |
| Multi-BOS | 0.1340 | 0.1728 | 0.1243 | 0.1822 |
| Ours | 0.1565 | 0.1907 | 0.1391 | 0.2031 |
结论分析:这张表把"任务特定解码"与"配额控制的多目标聚合"两件事解耦了,是全文最有说服力的消融。
- 专门化 decoder 确实能优化自己的目标:Long-View decoder 取得最高 Long-View Recall(0.1956 > Ours 0.1907),Watch-time decoder 取得最高 WT Recall(0.2041 > Ours 0.2031)。
- 但每个专门化 decoder 在别处都大幅失分:Watch-time decoder 的 Exposure Recall 从 0.1539 崩到 0.1219(-20.8%)、Like 从 0.1318 崩到 0.1137;Like decoder 的 Long-View 从 0.1833 掉到 0.1663。任何单一目标策略都无法充当一个均衡的召回池。
- Ours 是唯一在四个指标上全部排进前二的配置。因此论文的判断是:专门化本身不是一个召回器;只有当不同候选流被保留下来、并在共享预算下合并时,它的价值才浮现。这给出了一个比共享 General Decoder 或任何单一专门化策略都更强的多目标操作点。
- Multi-BOS baseline 全面落败:这个 baseline 在相同训练协议与配额分配下,把每个 BOS token 分配给一个特定任务变体(即前文批评的 "task token / 上下文 BOS query" 家族)。结果它在四个指标上全部低于本方法,甚至 Exposure(0.1340)低于单纯的 General Decoder(0.1539)。论文据此断言:仅靠 task-specific BOS 信号不足以实现有效的目标专门化,而 LoRA-expert 适配提供了一个更有表达力的机制来学习任务对齐的生成模式。这条实证是对 P5 / MBGen / GenSAR / EARN 一路方法的正面反驳。
MD-CBS 的粒度¶
Table 3: Effect of MD-CBS granularity. L2 CBS 与 L3 CBS 分别在第二、第三层 SID 施加跨路线约束;No CBS 表示无跨路线约束的独立解码。#Cand. 为候选数量。
| Method | Exp. | Long-View | Like | WT | #Cand. |
|---|---|---|---|---|---|
| L3 CBS | 0.1565 | 0.1907 | 0.1391 | 0.2031 | 512 |
| L2 CBS | 0.1522 | 0.1827 | 0.1350 | 0.1942 | 512 |
| No CBS | 0.1258 | 0.1544 | 0.1122 | 0.1647 | 207.67 |
结论分析:这是"协同解码"必要性的直接证据。
- 不用 MD-CBS,独立路线会反复生成同一批 item:去重后平均只剩 207.67 个唯一候选(相对 512 预算浪费了 59.4% 的容量),四个目标的 recall 全部最低。这定量确认了式 (5) 的 $\text{Dup}(u)$ 不是理论顾虑而是真实损失。
- L2 与 L3 CBS 都恢复了完整的 512 预算,确认协同约束把原本浪费在重叠上的容量拿回来了。
- L3 优于 L2,而两者候选数相同——因此差距不能用候选池大小解释,只能归因于池的质量。机制解释:L2 屏蔽任何"已被占用的第二层前缀"的延续,后续路线因此无法在同一个粗语义区域内探索不同 item;L3 只屏蔽完整 SID,保留了更大的搜索广度同时仍移除真重复。论文的结论是:把去重延迟到完整 SID,避免了过早剪掉语义相关但不同的 item。这也解释了为什么默认取 $d = 2$(零基,即第三层)。
KL 权重的影响¶
结论分析:中等强度的约束最好——权重 1.0 同时取得最高 Watch-time Recall 与最好的曝光 recall / SID legal rate(图中 legal rate 收敛到 90.48%)。降低权重会削弱参考先验,legal rate 与召回质量双双渐降;完全移除 KL 则导致严重崩溃。
论文由此得出一个有普适意义的判断:General Decoder 应当在 RL 适配期间持续提供参考分布,而不仅仅充当初始参数化。这正是 L-GBPO 的 "life-long" 语义在实验上的落地——如果只把共享基座当作初始化,Watch-time 专家会漂出合法 SID 空间,生成大量映射不到任何 Item-ID 的 SID 串。
奖励历史长度¶
用最近 500 个历史 item 做奖励归一化,把 Watch-time Recall 从 $K = 8$ 的 0.2003 提升到 0.2031(+1.40%)。
Table 13: Effect of reward-history size on Watch-time Recall@512.
| Reward-history size | WT Recall |
|---|---|
| $K = 8$ | 0.2003 |
| $K = 500$ | 0.2031 |
原因是更稳定的"用户相对"观看时长偏好估计:$K = 8$ 时组统计量 $\mu(\mathcal{G}_i)$、$\sigma(\mathcal{G}_i)$ 方差过大,标准化奖励噪声大。
连续目标的损失函数选择¶
Table 5: Effect of learning objective on Watch-time Recall@512.
| Objective | WT Recall |
|---|---|
| SFT with 12s threshold | 0.1999 |
| Continuous-reward RL | 0.2031 |
结论分析:对 watch time 这类连续信号,阈值化 SFT 把分级反馈压成二值标签,丢弃了正样本之间的幅度差异;连续奖励 RL 保留用户偏好的相对强度,把 WT Recall 从 0.1999 提到 0.2031。这直接支撑了 §4.3 "为什么 Watch-time 专家要用 RL 而不是 SFT" 的设计论证。
配额分配与 beam scaling¶
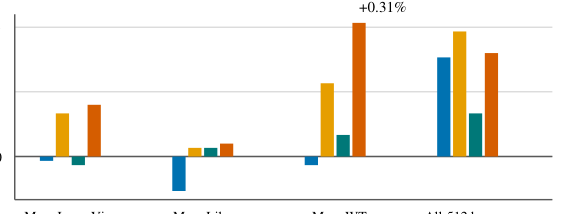
前三组把配额倾向某一个目标:
| Intervention | 效果 |
|---|---|
| More Long-View | Long-View Recall +0.10%,但 Exposure 与 Like 轻微下降 |
| More Like | Like 小幅提升(+0.02%) |
| More WT | 最大的定向变化,WT Recall +0.31% |
| All-512 beams | 每个 bar 都为正,Long-View 与 WT 尤其明显 |
结论分析:三组定向干预都把指标推向预期方向,但没有一组能同时提升所有指标——因为输出预算固定,给一条路线更多配额必然从别的路线拿走候选。这是一个诚实且重要的结论:配额是零和的组成控制旋钮,不是免费的性能提升手段。
相反,最右边的 All-512 beams 组不改配额、只增大 beam width,因此所有 bar 全正。论文的总结非常清晰:配额控制候选池的组成方向(direction),beam scaling 才在有额外算力时提升候选质量。这两个旋钮的语义正交,对工业调参很有指导价值。
LoRA rank¶
Table 12: Recall@512 for different LoRA ranks.
| Rank | Exp. | Long-View | Like | WT |
|---|---|---|---|---|
| 4 | 0.1562 | 0.1865 | 0.1365 | 0.2016 |
| 16 | 0.1543 | 0.1864 | 0.1355 | 0.1978 |
| 32 | 0.1565 | 0.1907 | 0.1391 | 0.2031 |
| 64 | 0.1559 | 0.1892 | 0.1363 | 0.2010 |
结论分析:结果对 rank 非单调——rank 4 与 rank 64 在不同指标上分别取得次优,rank 16 在四项上都落后于两者,rank 32 在每个指标上都最好。把 rank 提到 64 只增加参数而不改善 recall。因此默认取 rank 32 作为适配容量/参数效率的折中。(非单调这一点值得留意:它暗示 LoRA rank 与稀疏监督量之间存在一个非平凡的匹配关系,而不是"越大越好"。)
效率¶
Table 6: Parameter and computation overhead. FLOPs 按 per session 计。
| Configuration | Params (rel.) | FLOPs (rel.) |
|---|---|---|
| Train: General Decoder | 7.93M (1.00×) | 14.93G (1.00×) |
| Train: +3 LoRAs | 9.50M (1.20×) | 22.97G (1.54×) |
| Infer: General Decoder | 7.93M (1.00×) | 325.02G (1.00×) |
| Infer: 4 routes | 9.50M (1.20×) | 725.38G (2.23×) |
结论分析:三个 LoRA 专家只增加 20% 参数,但训练需要 1.54× FLOPs、四路线推理需要 2.23× FLOPs。这是这套方案最实在的成本:参数开销可忽略,计算开销接近线性于路线数。论文指出路线特定的 beam 与配额正是控制这个质量–成本 trade-off 的手段(例如把某条低价值路线的 beam 从 256 降到 86)。相比"给每个目标复制一个完整 decoder",参数侧从 $4\times$ 降到 $1.2\times$ 是核心收益;但推理 FLOPs 侧并没有省下来,因为每条路线仍要跑一遍自己的 beam search——encoder 表征复用只省掉了编码部分(推理 FLOPs 主要由 beam search 主导,可见 325.02G 对比训练的 14.93G)。
源级线上后验分析¶
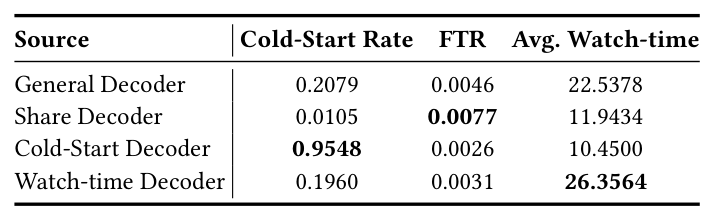
| Source | Cold-Start Rate | FTR | Avg. Watch-time |
|---|---|---|---|
| General Decoder | 0.2079 | 0.0046 | 22.5378 |
| Share Decoder | 0.0105 | 0.0077 | 11.9434 |
| Cold-Start Decoder | 0.9548 | 0.0026 | 10.4500 |
| Watch-time Decoder | 0.1960 | 0.0031 | 26.3564 |
结论分析:这是目标专门化在下游服务后依然成立的最强证据。Share、Cold-Start、Watch-time decoder 分别在 FTR(0.0077)、Cold-Start rate(0.9548)、平均观看时长(26.3564 秒)上领先。尤其 Cold-Start decoder 的 95.48% 冷启率 vs General Decoder 的 20.79%,说明配额化的冷启路线确实在结构上保证了新内容的曝光份额——这在纯 score-based 融合的系统里是难以稳定保证的。同时可以看到专门化的代价:Cold-Start decoder 的平均观看时长只有 10.45 秒(最低),Share decoder 11.94 秒,都远低于 General Decoder 的 22.54 秒。这恰好解释了为什么必须保留配额而不是让某条路线赢下全部预算。
线上 A/B 实验¶
在 Kwai Brazil 的生成式推荐流水线上做 7 天 A/B。该生产流水线以生成式召回为中心,其召回候选贡献总曝光的 57%,之后是排序与重排阶段。实验流量按 device identifier(DID) 随机化。对照组含 14.64% 的 DID,保留单 decoder OneRec;实验组含 7.32% 的 DID,保留相同的共享 encoder 与 General Decoder,并新增 Watch-time、Share、Cold-Start decoder 及显式路线配额。除生成式召回模块外,两组使用相同的下游排序阶段。
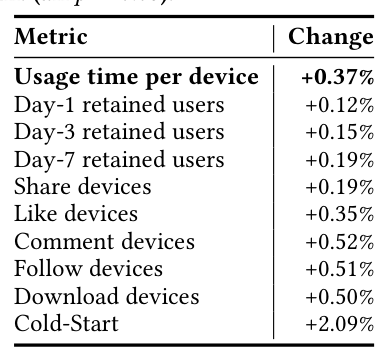
Table 4: Online A/B test performance in short-videos services of Kwai Brazil(all $p < 0.05$)
| Metric | Change |
|---|---|
| Usage time per device | +0.37% |
| Day-1 retained users | +0.12% |
| Day-3 retained users | +0.15% |
| Day-7 retained users | +0.19% |
| Share devices | +0.19% |
| Like devices | +0.35% |
| Comment devices | +0.52% |
| Follow devices | +0.51% |
| Download devices | +0.50% |
| Cold-Start | +2.09% |
结论分析:核心产品指标 usage time per device +0.37%,同时 Day-1/3/7 留存全正(+0.12%/+0.15%/+0.19%,且留存增益随天数递增,暗示不是短期新鲜度效应),互动指标 +0.19%~+0.52%,冷启 +2.09%。
十项结果横跨留存、消费、互动、生态覆盖四个维度。附录 D 记录了共享报告范围以及第 11 项结果:profile-visit devices +0.49%($p < 0.05$);Share、Like、comment、follow、download 与 profile-page 结果都是设备计数,每项变化都显著。每一项结果都改善,说明互补的召回候选在下游排序中存活下来,并转化为消费、互动与生态收益。
需要注意的一个实验设计细节:对照组 14.64% vs 实验组 7.32% 的流量分配不对称(2:1),论文未解释原因;这是新召回路上线时常见的保守做法(限制新模块的暴露面),但会让实验组的统计功效低于对照组。
核心贡献总结¶
- 首个把"共享生成式召回器 + 目标特定 decoder + 梯度隔离适配 + 显式逐路线配额 + 跨 decoder 受限搜索"在固定候选预算下统一起来的框架(作者自称据其所知为首个)。它没有回到"给每个目标一个完整 decoder"的碎片化老路,而是用 LoRA + BOS + SID embedding 残差这三件小东西(参数 +20%)撑起了目标独立性。
- 专家优化 + MD-CBS:事件型反馈用目标过滤样本上的 NTP,连续反馈用相对奖励的策略优化(L-GBPO),参考正则化(KL)保住通用 SID 先验;MD-CBS 把显式配额与跨路线前缀约束结合,减少重叠、提升候选互补性。
- 公开 Kwai26:十亿级多目标生成式召回基准(13.1 亿原始记录、3185 万 Item-ID、2503 万含合法 SID 的 item),含预定义划分、防泄漏的历史构造算法与评估协议,并开源数据流水线。
- 离线 + 生产双重验证:同一 512 预算下四个 Recall@512 相对单 decoder OneRec 提升 1.69%–5.62%;Kwai Brazil 7 天 A/B 十一项指标全正。
与已归档相关工作的对比¶
UniR2 UniR²: Unifying Generative Recall and Multi-Objective Ranking in a Single Sequence(Kuaishou Technology + CAS,2026-07-27)¶
关系:独立并发(本文参考文献 [1]–[38] 未包含 UniR²,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在处理同一个 root cause——共享 Transformer 骨干在异质目标之间产生"表征耦合是好事、梯度耦合是坏事"的分裂。UniR² 把它命名为"seesaw effect / gradient entanglement":简单把 $\mathcal{L}_{\text{gen}} + \mathcal{L}_{\text{rank}}$ 相加会让两种梯度同时冲进共享参数、引发优化干扰。本文则把它称为"single decoder entangles objective policies":联合训练让一个目标的更新改变其他目标使用的变换,产生负迁移。两篇都明确否决了"复制完整模型"这个朴素解(UniR² 说会带来冗余编码与两套参数,本文说会恢复模型/训练/服务的碎片化)。
- 相近的技术骨架:两篇的隔离机制几乎逐条对应——(a) 都在注意力的 Q/K/V 投影上挂 LoRA 低秩残差(本文式 (8) $\mathbf{W}_0 + \mathbf{B}^{(t)}\mathbf{A}^{(t)}$;UniR² 式 (17) $\text{sg}(WX) + \Delta W_X^{\text{rank}}X$);(b) 都用 stop-gradient 把共享基座保护起来,让基座只被"主任务"(本文的曝光 NTP / UniR² 的生成 NTP)更新;(c) 都强调用户上下文只编码一次并被所有分支复用(本文的 $\mathbf{H}_u$ 一次前向 + cross-attention 复用;UniR² 的 prefix 用户段作为共享 KV cache);(d) 都做了参数集的显式不交分解(本文式 (9) 的 $\phi_t$;UniR² 式 (18) 的 $\Theta_{\text{gen}} \cap \Theta_{\text{rank}} = \varnothing$)。UniR² 甚至和本文一样,明确指出"只加 stop-gradient 不够、必须补一条可学习低秩通路,否则弱目标学不动"——这与本文用 Multi-BOS baseline 证明"只换 BOS 不够、必须给可训练变换"是同一条论证。
- 本文的差异与推进:分歧在于隔离的维度。UniR² 沿流水线阶段切(生成式召回 vs 多目标排序,$M = 2$ 个分支,用 DQ-PCA 给两个 query 不同的可见性),目标是消除召回–排序的阶段鸿沟与冗余编码。本文沿业务目标切($M$ 个可任意增减的目标路线,全在召回阶段内),目标是替换传统多路召回的配额体系。因此本文多出两件 UniR² 没有的东西:(a) 推理侧的协同机制 MD-CBS + 配额合并——UniR² 的两个分支输出类型不同(SID 分布 vs 多目标分数)本就不会重叠,而本文的 $M$ 条路线输出同构的 item 列表,必须显式去重,否则式 (5) 的 Dup 会吃掉 59.4% 的预算(Table 3 的 No CBS 只剩 207.67 个候选);(b) 连续反馈的 RL 专家(L-GBPO + KL 参考正则),UniR² 的排序分支只用多目标 BCE。反过来,UniR² 有本文没有的跨阶段 KV cache 复用(端到端推理时间 -54.29%),而本文的四路线推理 FLOPs 反而是 2.23×——这是两者优化重点的直接反映。
- 可比的方法/实验差异:两篇都没有公开学术数据集实验,都只在快手内部数据 + 线上 A/B 上验证,且都用 LoRA rank 与隔离开关做消融。量级上:UniR² 报告"不做隔离会让生成侧 HR@1 崩 44.39%、去掉 ranking LoRA 会让 AUC@GTR 掉 31.29%";本文报告"专门化 decoder 单独用会让 Exposure Recall 掉 20.8%(0.1539→0.1219)、Multi-BOS 替代 LoRA 会让四项指标全面落后"。两组数字从不同角度指向同一结论:共享骨干上的异质目标必须同时具备"表征共享"和"参数隔离",缺一不可。线上侧 UniR² 打在快手直播(播放量 +1.177%、送礼 +2.569%),本文打在 Kwai Brazil 短视频(usage time +0.37%、Cold-Start +2.09%)——同公司、相隔两天、场景互补而互不引用,是一组很典型的大厂内部并行探索。
RGD RGD: Reward Guided Decoding for Generative Recommendation(CAS + Kuaishou + PKU,2026-07-28)¶
关系:独立并发(本文未引用 RGD,RGD 亦未引用本文,两者相隔一天)· 已加载对方精读
- 共同关注的问题:两篇都在解决生成式召回的"似然 ≠ 业务价值"错位,且都要求这种控制在工业上是可切换的。RGD 的表述是:生成器是 likelihood-driven 的,beam search 按局部生成概率扩展,但"最可能出现在用户历史模式下的 item 未必是业务价值最高的",而且工业目标是动态多样的,为每次偏好变化重训生成器不切实际。本文的表述是:单 decoder 纠缠目标策略,且 quota control 必须在固定预算下显式可配。两篇都点名批评了同一类前置方案——把偏好"烘焙进生成器参数"的训练时 RL(OneRec / OneRec-V2 的 GBPO 一路)导致目标切换缓慢——并都主张控制应当在更可配置的层面发生。
- 相近的技术骨架:核心的数学形式惊人一致。RGD 从 KL 正则化 reward 最大化 $\max_Q \mathbb{E}_{j\sim Q}[R(j)] - \beta D_{\text{KL}}(Q\|P)$ 出发,导出闭式 Boltzmann 解 $Q^* \propto P\exp(R/\beta)$,并把基座生成器当作 reference policy $P$;本文的 Watch-time 专家目标(式 17)$\lambda_{\text{L-GBPO}}\mathcal{L}_{\text{L-GBPO}} + \lambda_{\text{KL}}\mathcal{L}_{\text{KL}}$ 同样是"reward 项 + 对 reference 的 KL 惩罚",而 reference 恰好也是基座 General Decoder 的 stop-gradient 分布(式 13、15、16)。两篇都用 $\text{sg}(\cdot)$ 严格保证 reward/偏好学习不污染基座生成器(RGD 冻结 decoder 隐状态做 reward head 输入,本文在 $\theta_0$ 处截断梯度),也都把"约束强度"做成一个可调旋钮并做了敏感性消融(RGD 的 $\beta$,本文 Figure 3 的 KL weight,且两者都发现去掉约束会崩、中等强度最好)。
- 本文的差异与推进:分歧在于控制注入的位置——RGD 把多目标控制放在解码时的分数重加权($\log P + R/\beta$,reward head 是 test-time controller,换目标 = 换 head 或换 $\alpha_m$,基座完全不动);本文把控制放在参数隔离的专家 + 配额化的候选池组成(换目标 = 挂/摘一个 LoRA 专家并改配额,基座同样不动)。两条路径的能力边界不同:RGD 能在同一条候选列表内部按融合价值重排/重剪,但所有候选仍来自一个策略,无法保证"冷启内容拿到 16.6% 的槽位"这类组成级硬约束;本文能给出 Table 11 那种"Cold-Start decoder 冷启率 95.48%"的结构化保证,但代价是推理 FLOPs 2.23×(RGD 只增加一个轻量 reward head)。另一处推进是候选互补性:RGD 完全没有处理"多个目标产出重叠候选"的问题(因为它只有一个生成器),而本文的 MD-CBS 定量证明了不协同会浪费 59.4% 预算。
- 可比的方法/实验差异:两篇都在快手线上验证,但验证的完整度不同。RGD 在三个公开 Amazon 数据集上有完整 baseline 对比(R@10 最高 +11.49%,超过 TIGER/HSTU/RPG/PROMISE),线上却只验证了单目标 CTR 引导——它宣称最大卖点的"多目标 LTR 切换"未获线上验证。本文相反:没有任何公开学术数据集实验(只有自建的 Kwai26),但线上直接验证了三条并行的专门化路线(Watch-time / Share / Cold-Start),且给出源级后验诊断证明每条路线各自领先自己的指标。因此两篇在证据结构上正好互补:RGD 强在"形式化 + 公开可复现性",本文强在"多目标同时上线的工程闭环"。一个有意思的组合可能性是:本文的 $M$ 条 LoRA 路线各自内部再用 RGD 的 $\log P + R/\beta$ 做路线内价值重排——两者的 reference policy 都是同一个 General Decoder,形式上是可叠加的。
Step 2.5 被剔除的近似候选(记录门槛,防止放水): (1) [2607.04068] UniSGR(Alibaba Lazada)——问题落在"召回↔排序阶段统一"这条轴上,与 UniR² 重复且解法骨架是 Task-Aware Tokens + Value-Aware Parallel MTP,恰属本文 Multi-BOS baseline 所证伪的 task-token 家族,非参数隔离 + 配额协同; (2) [2607.17092] UAME(Kuaishou)——同为多目标,但问题是 ensemble ranking 阶段的分数融合与满意度标签偏差,不是召回候选池组成;解法为概率化 pairwise loss + 不确定性重加权,无 decoder 隔离与配额; (3) [2606.16838] OneRank(RUC/Shopee)——含"任务 token 互不可见 + 策略性梯度 detach"的隔离机制,形式接近,但完全运行在排序阶段,无生成式 SID 召回、无路线配额、无候选去重; (4) [2605.05803] UniVA(Tencent)——有 value-guided personalized beam search(解码级控制),但只对单一商业目标 eCPM,杠杆是 tokenizer + PPO/MCTS,非跨 decoder 的多目标配额分配; (5) [2605.14434] CQ-SID(Alibaba TmallAPP)——明确把生成式召回定位为与其他召回通道并存的补充通道(含配额语义),但杠杆是 category-constrained tokenizer + EG-GRPO,无多 decoder / 协同解码。
讨论与局限性¶
值得借鉴的设计¶
- "共享表征 / 隔离更新 / 协同解码"三段式是一个可迁移的框架模板。它把"多目标"这件事拆成了三个互相独立可实现的机制层:前向共享(省算力与知识迁移)、反向路由(防负迁移)、解码协同(防候选浪费)。此前的工作往往只做前两层(如 UniR²),或只做第一层(task token 一族)。
- 梯度路由优于时间冻结。论文明确写道隔离靠 gradient routing 而非 temporal freezing,各目标 batch 可以交错或混合。这允许基座与专家同时持续学习,避免了"先训基座再冻结、再训专家"这种分阶段流程在工业连续训练(one chronological pass)里的不可行性。
- L-GBPO 的 "life-long" 参考是个很实用的改造。经典 PPO/GRPO 用冻结的 $\pi_{\theta_{\text{old}}}$ 快照做参考,而工业系统的基座一直在被曝光数据更新;把参考换成"当前 General Decoder 的 stop-gradient 前向"让 KL 锚点随基座漂移,Figure 3 的消融证明这个持续锚定是必需的(去掉 KL 后 SID legal rate 崩塌)。
- 配额与 beam 是两个语义正交的旋钮(Figure 4)。这条经验对任何多路召回系统的调参都成立:配额调组成方向且零和,beam 调质量且需要额外算力。
- Kwai26 的"可作历史不可作 target"区分与左界
LowerBound防泄漏构造,是工业级序列推荐数据集的良好实践——很多公开数据集在时间截断上并不严格。
局限与争议¶
- 无任何公开学术数据集实验。所有离线结果都在自建的 Kwai26 上。虽然 Kwai26 已开源(含流水线),但目前只有本文使用,方法的可比性与可复现性仍需时间检验。TIGER / HSTU / SASRec 这些 baseline 在 Kwai26 上的实现细节与调参是否充分,读者无法独立核验;尤其 DSSM 的 Exposure Recall@512 只有 0.0046(比 SASRec 低 6.7 倍)低得可疑。
- 推理成本增长几乎线性于路线数(4 路线 2.23× FLOPs)。论文把这个成本诚实地单列在 Table 6,但也意味着"共享建模省算力"这个动机只在训练与参数侧成立,在推理侧并不成立——encoder 复用节省的编码部分相对 beam search 的开销可以忽略(325.02G vs 14.93G)。当目标路线增长到十几条时(这正是论文批评传统多路召回的场景),推理成本会重新变成瓶颈。这是一个尚未解决的结构性张力。
- 配额仍需人工配置。本文取代了"多套独立模型",但没有取代"人来定配额"。Figure 4 已经显示配额调整是零和的,那么最优配额分配本身就是一个多目标优化问题,论文未讨论如何自动化(如按流量/用户分群动态分配)。
- A/B 流量分配不对称且未解释:对照 14.64% vs 实验 7.32%(2:1)。此外 A/B 只跑了 7 天,而 Day-7 留存 +0.19% 的读数在 7 天实验窗口内本身就比较紧;配合"留存增益随天数递增"的趋势,更长窗口的验证会更有说服力。
- 专门化目标集合在离线与线上不一致。离线 Kwai26 用 Long-View / Like / Watch-time,生产用 Watch-time / Share / Cold-Start。因此 Table 1 的 +1.69%~+5.62% 与 Table 4 的线上收益不是同一组 decoder 的结果,两者之间的映射关系需要读者自行推断。尤其 Cold-Start decoder(线上贡献 +2.09%)在离线完全没有对应指标。
- LoRA rank 的非单调性未获解释。Table 12 显示 rank 16 在四项上都差于 rank 4 与 rank 64,这不符合"容量单调"的直觉,论文只描述现象("results are not monotonic in rank")而未给机制解释。可能与不同目标的监督稀疏度/优化器步数(只有一遍 chronological pass,122,324 步)交互有关,但缺少证据。
- MD-CBS 的路线优先级顺序 $\pi$ 是外生给定的。式 (4)(19) 都依赖顺序 $\pi$,且 General Decoder 被固定放在最后。但顺序显然影响结果(越早的路线拿到未被屏蔽的完整搜索空间),论文没有做顺序的消融,也没有讨论如何选择 $\pi$。这是一个被形式化定义了、却没有被实验覆盖的自由度。
工业落地价值¶
这篇论文的落地价值主要在替换路径的平滑性:它保留了工业系统运营最依赖的"显式配额"接口(因此不需要改变运营的心智模型与操作方式),同时把底层从"$N$ 套独立召回模型"换成"1 套共享骨干 + $N$ 个 20% 参数量的 LoRA 专家"。服务侧只需一份物化 encoder 表征,目标集合与配额可以在不修改 General Decoder 或任何专家的前提下改变——这意味着上新目标路线的边际成本从"训练并部署一个新模型"降到"训练一个 LoRA 专家并配一个配额"。配合 Kwai Brazil 上 57% 曝光由生成式召回贡献的现实(生成式召回已是主干而非补充通道),以及十一项指标全正的 A/B 结果,这套方案对已经完成 OneRec 式生成式召回迁移的平台是一条自然的下一步。