Reward Guided Decoding for Generative Recommendation (RGD)¶
Ruochen Yang, Yusheng Huang, Youfeng Zheng, Shuang Wen, Liangliang Chen, Pengbo Xu, Xiaoyu Zhang, Shijun Wang, Shuang Yang, Zhaojie Liu, Lantao Hu, Wenwu Ou, Jiawei Sheng, Tingwen Liu 中科院信工所 / 国科大网安学院 / 快手科技 / 北京大学 · arXiv:2607.25344 · 2026-07-28
1. 研究动机与背景¶
1.1 生成式推荐的范式与它继承的病灶¶
生成式推荐(Generative Recommendation, GR)近年成为序列推荐中极具前景的新范式。与传统判别式方法(从一个大而固定的候选集里检索再打分排序)不同,生成式推荐大量借鉴了 LLM 的 tokenization 与 generation 范式:先把物品表示成离散的 semantic ID(SID),再自回归地逐层生成下一个物品的 SID。这种建模方式实现了从用户历史交互到推荐结果的端到端学习与直接生成,从而给用户提供了快速、个性化的体验,也在工业场景中展现出广阔潜力。
但论文指出一个被范式继承下来、却很少被正面处理的病灶:尽管架构换了,绝大多数生成式推荐方法在内核上仍然是 likelihood-driven(似然驱动)的。
- 生成器是用「在历史交互序列上做最大似然估计」训练出来的;
- beam search 在推理时按照局部生成概率扩展候选。
而在真实推荐系统里,最可能出现在用户历史行为模式下的物品,未必是业务价值最高的那一个。工业平台通常关心多种反馈信号——点击(click)、送礼(gift)、转化(conversion)等。建模历史行为捕捉的是用户在相关性(correlation)下的自然倾向,而业务系统真正想要的是干预(intervention)所诱导出的增量价值。
这个错位导致了一个内生的 mismatch:生成概率 (generation probability) 与下游业务效用 (downstream business utility) 之间的不匹配。生成概率高的物品可能只是反映了历史惯性或流行度偏置(popularity bias),但这并不意味着低概率的替代品就不能带来更高的用户参与或商业回报。
1.2 mismatch 在 beam search 中被进一步放大¶
论文强调,这个 mismatch 在 beam search 中会被进一步放大:高奖励但低概率的分支会在搜索的早期阶段就被剪掉,从而从根本上限制了可检索空间(inherently limiting the retrieval space)。一旦某个高价值前缀在第一层就没进 top-K,后面无论怎么排序都救不回来——这是 post-hoc reranking 无法弥补的结构性损失。
1.3 为什么「往解码里塞 reward」并不平凡¶
一个自然的想法是把 reward guidance 引入生成式推荐的解码过程。但论文列出了三条使其非平凡(non-trivial)的原因:
- 生成概率与 reward 信号活在不同的空间。生成器输出的是归一化的 log 概率,而 reward model 可能预测点击率、送礼概率,或某个融合的多目标分数。直接把这些异质分数加到生成 logits 上是启发式的(heuristic),缺乏有原则的解释。
- reward guidance 必须足够早地生效。post-hoc reranking 只能重排已经生成完的候选,因此无法找回那些在搜索过程中已经被淘汰掉的有价值候选。
- 工业目标是动态且多样的。不同场景可能偏好点击、观看时长、送礼等指标之间的不同权衡。为每一次偏好变化都重训一遍生成器,代价高昂且不切实际。
1.4 现有方案只解决了一部分¶
- 常规生成式推荐方法(TIGER、Letter、MMQ、ETEGRec、COBRA、RPG、EAGER、GEMS、OneLive、Nezha 等)聚焦于改进 semantic tokenization、序列建模与受限生成,但解码时主要仍按似然行事。
- Reranking-enhanced 方法(Onepiece、RankGD、PROMISE、OneRanker 等)引入额外的 ranker 或 process reward model 去过滤/重排生成的候选,但它们的 reward 信号往往被用作事后验证器(post-hoc validator)或剪枝启发式(pruning heuristic),而不是贯穿整个解码过程的、有原则的 business-value controller。
- 训练时偏好优化方法(DPO / GRPO 一类 RL 方案,如 OneRec、OneRec-V2)通过更新模型参数把 reward 对齐进模型,但这类方法把偏好烘焙(bake)进了生成器,导致目标切换缓慢、灵活性差。
- LLM 侧的 reward guided generation(FUDGE、GeDi、Controlled Decoding、PRM)已经证明外部引导信号可以在推理时操控预训练生成器,但如何在生成式推荐中形式化并实例化这一原则,仍然探索不足。
1.5 本文的三项贡献¶
- 理论基础(Theoretical Foundation):把生成式推荐中的价值引导形式化为一个 reward maximization 问题。该形式化自然导出一个闭式的 reward guided decoding 分布,为「业务信号与生成概率如何组合」提供了有原则的判据,避免启发式的分数插值。
- 方法论提案(Methodological Proposal):提出 RGD——一个可控的 reward-guided decoding 框架。RGD 把基座生成器当作 reference policy,引入一个额外的 reward model 作为 test-time controller,在每个 SID 解码步注入 reward。它支持在 serving 期间动态调整多目标引导与权重,允许在不同业务偏好之间灵活对齐与切换。
- 实证验证(Empirical Validation):在公开数据集与工业数据上做了大量实验,显著优于生成式推荐 baseline;并把 RGD 部署到快手平台,验证了线上真实流量下的业务收益。
2. 相关工作定位¶
2.1 生成式推荐¶
TIGER 定义了这一范式:物品 tokenization 成 semantic ID + T5 风格的 encoder-decoder 架构。后续工作沿两条主线展开:
- 物品 tokenization:Letter、MMQ 对齐内容语义与行为信号;ETEGRec、BLOGER 探索端到端的推荐目标引导型 tokenizer;RPG 尝试并行生成无序长 semantic ID。
- 模型架构:COBRA 统一稀疏与稠密目标的生成;EAGER、GEMS 为不同任务适配多个 decoder;OneLive、Nezha 通过顺序多 token 预测或 nimble drafting 降低推理时延。
但绝大多数生成式推荐方法都是通过基于历史交互的最大似然式 next-token 预测优化的,这仅仅拟合了现有线上系统的曝光物品分布。为了实现真正的现实世界部署、克服对过去决策的克隆(cloning of past decisions),OneRec 系列引入了 reward model + policy optimization 去感知用户偏好,能从根本上把模型的生成分布推向高 reward 物品;但这种黑盒策略优化带来的是长周期训练、价值调节与业务对齐的迟缓切换。近期工作尝试用 process reward 在解码策略层面解锁控制:V-Star 把搜索空间聚焦在高潜力前缀上,PROMISE 动态剪枝以防语义漂移。然而它们主要处理的是 beam search 中「探索不足」的问题,没有有效提供一个有原则的 reward-shaped decoding 分布。
2.2 Reward Guided Generation(LLM 侧)¶
- 训练时:RLHF 学一个 reward model 并约束策略不要大幅偏离 reference model;DPO、GRPO 进一步简化偏好对齐。这些方法有效,但需要额外训练,把偏好嵌进了模型参数。
- 推理时受控生成:保持基座生成器不变,在解码时引入外部引导。FUDGE 和 GeDi 用判别器把 token 生成引导向目标属性;Controlled Decoding 学一个 prefix value function 估计部分生成的期望最终 reward,并用它重加权解码概率;PRM 则评估中间推理步骤的 process reward,在推理时把低质量推理轨迹剪掉。
这类方法灵活性更高:引导目标或强度可以在 test time 调整而不更新基座生成器。因此,把真实世界的在线 reward 纳入推荐系统的推理决策过程,对面向价值优化的工业应用极具吸引力——这正是 RGD 的定位。
3. 奖励引导解码的形式化(Reward Guided Decoding Formulation)¶
3.1 预备知识¶
每个物品被事先 tokenize 成一个由 $d$ 层离散码构成的 semantic ID $[s_1, s_2, \ldots, s_d]$,每层的码本大小为 $V$。给定用户上下文 $x$ 和已部分生成的 SID 前缀 $s_{<l}$,生成器自回归地预测下一层的 semantic code。令 $\ell_j$ 表示生成器对候选码 $j$ 的 logit,则对应的 next-token 分布为:
$$p_\theta(j \mid s_{<l}, x) = \frac{\exp(\ell_j)}{\sum_{j'=1}^{V} \exp(\ell_{j'})} \tag{1}$$
为简洁起见,把该分布写作 $P(j)$。推理时使用 beam search,逐步做贪心式地选取 top-$K$ 组合。常规 beam search 按 $\log P(j)$ 扩展候选,因此主要遵循的是从历史交互序列学到的似然。
3.2 最优奖励引导分布¶
3.2.1 问题形式化¶
在真实的在线推荐中,生成概率最高的候选并不总是价值最高的。模型似然主要捕捉「复现历史交互模式」的概率,而业务价值取决于曝光之后的用户反馈——点击、长播(long-view)、送礼(gift)等。因此,解码可能会过度选择那些通向高频或易预测物品的路径,而错过下游价值更高的候选。
为缓解这一点,论文引入一个 value function $R(j)$ 来显式评估业务反馈,并把解码过程与价值导向的目标对齐。
目标是构造一个新的解码分布 $Q(j)$,在提高期望 reward 的同时保持与基座生成器的接近。这个「接近性约束」很重要,因为生成器已经从大规模行为数据中捕获了用户偏好与物品语义。于是把 reward-guided decoding 形式化为如下 KL 正则化的 reward 最大化问题:
$$Q^* = \arg\max_Q \left\{ \mathbb{E}_{j \sim Q}[R(j)] - \beta D_{\mathrm{KL}}(Q \| P) \right\} \tag{2}$$
第一项鼓励选择 reward 更高的码,第二项惩罚新分布对既有模型的偏离。$\beta > 0$ 控制 KL 正则化的强度,其形式为:
$$D_{\mathrm{KL}}(Q \| P) = \sum_j Q(j) \log \frac{Q(j)}{P(j)} \tag{3}$$
该目标把基座生成器当作 reference policy,搜索一个 reward-improved 的解码策略。$\beta$ 越大,惩罚越严厉,迫使 $Q$ 更贴近 $P$;$\beta$ 越小,reward 的作用越强。
式 (2) 也可以视作一个 KL 约束下 reward 最大化问题的 Lagrangian relaxation。具体地,可以先定义等价的约束形式:
$$Q^* = \max_Q \mathbb{E}_{j \sim Q}[R(j)] \quad \text{s.t.} \quad D_{\mathrm{KL}}(Q \| P) \le \epsilon \tag{4}$$
即:在限制对基座生成器偏离程度的前提下,寻求期望 reward 更高的分布。等价性证明见附录 A.1。
3.2.2 闭式解¶
用 Lagrange 乘子 $\lambda$ 处理归一化约束 $\sum_j Q(j) = 1$,Lagrangian 为:
$$\mathcal{L}(Q, \lambda) = \sum_j Q(j)R(j) - \beta \sum_j Q(j)\log\frac{Q(j)}{P(j)} - \lambda\left(\sum_j Q(j) - 1\right) \tag{5}$$
对 $Q(j)$ 求导并令其为零,得到一阶最优性条件:
$$\frac{\partial \mathcal{L}}{\partial Q(j)} = R(j) - \beta\left(\log\frac{Q(j)}{P(j)} + 1\right) - \lambda = 0 \tag{6}$$
对上式右侧做整理,得到:
$$\log Q(j) = \log P(j) + \frac{R(j)}{\beta} - \frac{\lambda + \beta}{\beta} = \log P(j) + \frac{R(j)}{\beta} - \log Z \tag{7}$$
其中 $\log Z = (\lambda+\beta)/\beta$,由于最后一项与 $j$ 无关,因此充当归一化常数。两侧取指数,得到闭式的 reward-guided decoding 分布:
$$Q^*(j) = \frac{P(j)\exp(R(j)/\beta)}{Z}, \qquad Z = \sum_{j'} P(j')\exp(R(j')/\beta) \tag{8}$$
式 (8) 的解具有 Boltzmann 形式:
$$Q^*(j) \propto P(j)\exp(R(j)/\beta) \tag{9}$$
也就是说,reward-guided 的最优分布,是用一个指数缩放的 reward 项去重加权基座生成器分布得到的。温度参数 $\beta$ 控制这种重加权的锐度。
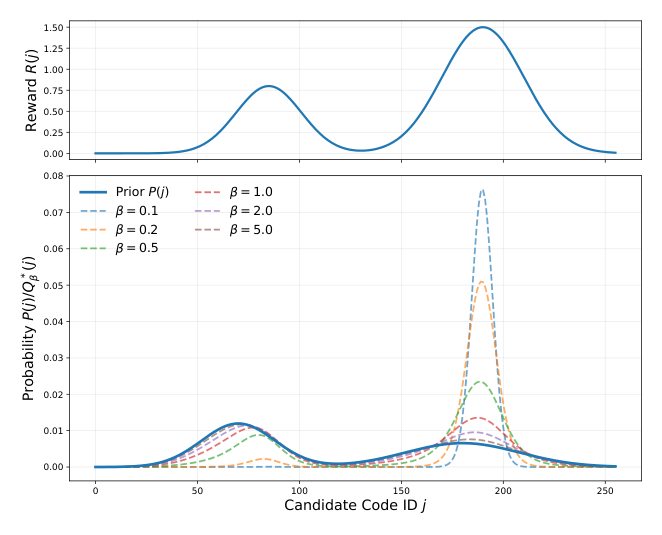
图 1 直观展示了这一点:上半部分是一个多峰的 reward 函数 $R(j)$,下半部分是不同 $\beta$ 下的重加权分布。$\beta$ 越小(如 0.1),分布越向高 reward 候选处收紧成尖峰;$\beta$ 越大(如 5.0),分布越回退到先验 $P$。
3.2.3 从分布到排序规则¶
对于 top-$K$ 解码或 beam 扩展,我们只需要比较候选 token 的相对次序,而无需计算它们的归一化概率。考虑到常规 beam search 用 $\log P(j)$ 排序,reward-guided 分布下的相对排序因此基于 $\log Q^*(j)$,即式 (7) 的形式。由于归一化常数 $Z$ 被所有候选共享,它不影响排序。因此,在 $Q^*$ 下选取 top 候选等价于按下式排序:
$$p^*(j) = \log P(j) + \frac{R(j)}{\beta} \tag{10}$$
这就得到了一个 reward-guided generation 的实用解码判据:用一个从最优 KL 正则化 reward-shaped 分布导出的有原则的排序目标,替换启发式的分数插值。最优性保证见附录 A.2。
这一步是全文最关键的形式化收敛点:论文没有发明新的融合公式,而是证明了「$\log P + R/\beta$ 这条简单的加法规则」正是 KL 约束下价值最大化问题的唯一最优解,从而把此前工业界普遍使用的「生成分 + 价值分加权求和」这类启发式做法升格为有理论依据的决策规则,并明确了 $\beta$ 的语义(KL 预算的对偶变量)。
3.3 与 Policy Shaping 的联系¶
论文特别指出:上述最优 reward-guided 分布,在结构上与 RLHF 中的 KL 正则化策略优化(尤其是 PPO 式的对齐框架)是对齐的。这类方法在惩罚对 reference policy 偏离的同时最大化期望 reward:
$$\max_\pi \mathbb{E}_{y \sim \pi(\cdot \mid x)}[R(y, x)] - \beta D_{\mathrm{KL}}\big(\pi(\cdot \mid x) \,\|\, \pi_{\mathrm{ref}}(\cdot \mid x)\big) \tag{11}$$
在本文的形式化中,基座推荐器 $P$ 对应 reference policy,reward-guided 分布 $Q$ 对应 improved policy。因此,reward guided decoding 可以被看作是在基座推荐器之上的一次 policy improvement step。
与 PPO 式训练不同的是,RGD 不学一个新的参数化策略,而是在解码过程中直接求解这个局部策略改进问题。在每个 SID 步上,候选空间是一个有限码本,因此最优 improved 分布具有式 (8) 的闭式 Boltzmann 形式。这把 policy improvement 变成了一条简单的解码时打分规则,避免了在线 rollout、reward 反向传播和生成器重训。
这一视角为 reward-guided decoding 的实用设计提供了正当性:基座生成器保留了从历史序列学到的协同与语义知识,reward 项则把解码分布推向业务价值更高的候选,在似然保持与价值最大化之间提供了一个有原则的旋钮。
4. 方法论:RGD 框架¶
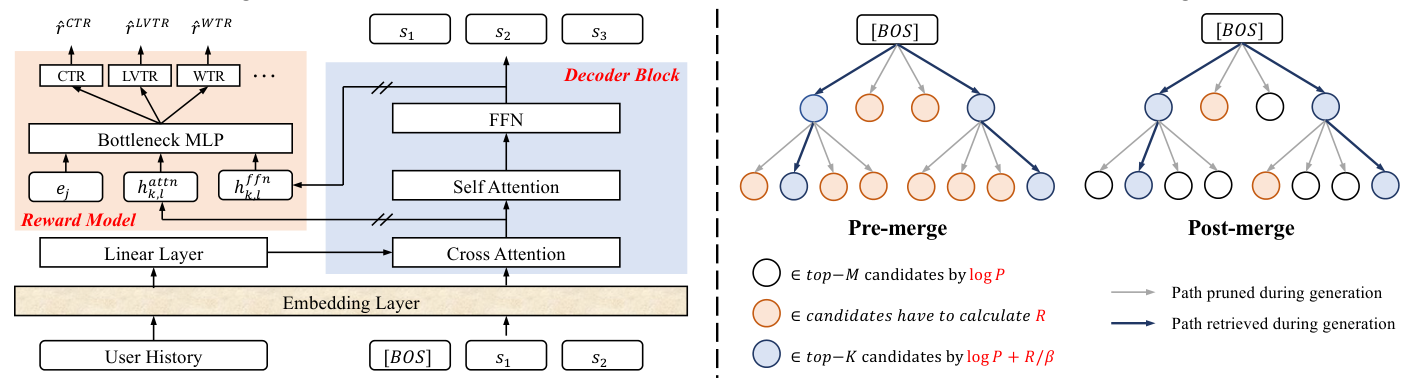
基于式 (8) 导出的闭式 reward guided 分布,论文把它实现为一个实用框架 RGD。有三个具体的设计选择需要作出:
- 如何参数化 reward $R(j)$,使其在每个解码步、对每个候选码都可计算;
- 如何在不干扰基座生成器的前提下训练 reward model;
- 如何把 reward 注入 beam search,使引导在正确的粒度上生效。
4.1 Reward Model 设计¶
reward model $R_\phi$ 是一个挂在预训练生成器上的轻量打分头(lightweight scoring head)。它的作用是:在生成器已经编码好的同一个用户上下文的条件下,估计「把候选码 $j$ 追加到当前 SID 前缀」这一动作的业务价值。
两条设计原则:
- 表示对齐(representation-aligned):$R_\phi$ 应该复用生成器的语义空间做 reward 评估,而不是重新构造一个;
- 链式结构(chain-structured):$R_\phi$ 应该镜像 SID 解码的自回归性质,使得第 $l$ 层的 reward 不仅反映当前候选,也反映整个已提交的前缀 $s_{<l}$。
4.1.1 生成器特征抽取¶
RGD 不构建带独立 encoder 的独立塔,而是直接接入基座生成器的 decoder。由于每个 decoder block 包含三个残差子层(cross-attention、self-attention、feed-forward network),论文抽取第 $l$ 个解码步上第一个和最后一个隐状态:
$$\mathbf{h}_{k,l}^{\mathrm{attn}}, \; \mathbf{h}_{k,l}^{\mathrm{ffn}} \in \mathbb{R}^{d_{model}}$$
其中 $k$ 表示选取第 $k$ 个 decoder block。基于经验观察,并为了适配基座架构中的单层 MTP decoder block,论文设 $k = 0$。这两个隐状态被视作「在生成器给出的当前前缀下,对上下文的一个全面摘要」。
论文冻结(freeze)这两个隐状态,以确保 reward 训练不会干扰生成轨迹——这正是「base generator 作为 reference policy 保持不变」在实现层面的落地。
4.1.2 链式打分头(Chain-Structured Scoring Head)¶
对第 $l$ 层的每个候选码 $j$,从一个专用的码嵌入表 $\mathbf{E}^c \in \mathbb{R}^{V \times d_{model}}$ 里查出候选码嵌入 $\mathbf{e}_j$。三个特征被拼接并投影到共享的上下文维度 $d_r$:
$$\mathbf{u}_l^{(j)} = \mathrm{ReLU}\left(\mathbf{W}_{in}\left[\mathbf{e}_j;\, \mathrm{sg}(\mathbf{h}_{k,l}^{\mathrm{attn}});\, \mathrm{sg}(\mathbf{h}_{k,l}^{\mathrm{ffn}})\right]\right) \tag{12}$$
其中 $\mathrm{sg}(\cdot)$ 表示 stop-gradient 算子(这是「不干扰生成器」的显式保证)。为了让第 $l$ 层的 reward 依赖于已提交的前缀,论文缓存前面各码的投影 $\mathbf{u}_1, \ldots, \mathbf{u}_{l-1}$,并通过一个逐层因果瓶颈 MLP(per-layer causal bottleneck MLP,Houlsby 风格 adapter)把它们与当前候选组合:
$$\mathbf{c}_l^{(j)} = f_l^{up}\left(\mathrm{ReLU}\left(f_l^{down}\left(\mathrm{MLP}\left([\mathbf{u}_1; \ldots; \mathbf{u}_{l-1}; \mathbf{u}_l^{(j)}]\right)\right)\right)\right) \tag{13}$$
其中 $f_l^{down}$ 与 $f_l^{up}$ 是基于一个较小瓶颈宽度的升降维变换,因此维度上是自洽的。一个三层 MLP 头随后产生一个标量 logit,并被 sigmoid 压成概率:
$$\tilde{r}_\phi(j \mid s_{<l}, x) = \sigma\!\left(\mathrm{MLP}(\mathbf{c}_l^{(j)})\right) \in (0,1) \tag{14}$$
4.1.3 从概率到 log-odds:为何要做逆 sigmoid¶
式 (10) 导出的最优解码判据要求 reward 与 $\log P(j)$ 处于同一个 log 空间,而打分头原生输出的是有界概率 $\tilde{r}_\phi \in (0,1)$。因此论文施加了一个逆 sigmoid 的 log-odds 变换,把最终的 sigmoid 反转回一个无界的实值信号,使得融合在量纲上一致:
$$R(j \mid s_{<l}, x) = \log \frac{\tilde{r}_\phi(j \mid s_{<l}, x)}{1 - \tilde{r}_\phi(j \mid s_{<l}, x)} \tag{15}$$
等价地,$R(j)$ 可以被读作 reward head 所区分的正反馈与负反馈之间的 log-likelihood ratio,从而赋予融合分数 $p^*(j)$ 一个贝叶斯后验更新(Bayesian posterior-update)的解释:先验是生成器的 $\log P(j)$,似然比是 reward 提供的证据,$1/\beta$ 是证据的权重。这是全文一个很漂亮的细节——它同时解决了「异质分数不可直接相加」和「$R$ 的物理含义是什么」两个问题。
4.2 Reward Model 训练¶
4.2.1 训练目标¶
reward model 与生成器在相同的 batch 上联合训练,但梯度流严格分离。总损失为:
$$\mathcal{L}_{total} = \mathcal{L}_{gen} + \lambda_r \cdot \mathcal{L}_r \tag{16}$$
其中 $\mathcal{L}_{gen}$ 是标准的 next-token 交叉熵,$\mathcal{L}_r$ 是 reward model 的损失(只对打分头相关组件贡献梯度),$\lambda_r$ 平衡两项。
4.2.2 单目标 reward 损失¶
论文先考虑单目标引导,覆盖四个业务反馈目标:click、long view、follow、gift,记作 CTR、LVTR、WTR、GTR。对每个目标 $m \in \mathcal{M} = \{\text{ctr}, \text{lvtr}, \text{wtr}, \text{gtr}\}$,reward head 通过打分模块 $g_m$ 预测一个 per-level 的 reward 概率:
$$\hat{r}_l^m = \sigma\!\left(g_m(\mathbf{c}_l)\right), \qquad l = 1, \ldots, d \tag{17}$$
目标 $m$ 的 reward 损失是跨所有 SID 层的加权二元交叉熵:
$$\mathcal{L}_r^m = \frac{1}{d}\sum_{l=1}^{d} \mathrm{BCE}\!\left(y^m, \hat{r}_l^m; w^m\right) \tag{18}$$
其中 $y^m$ 是行为标签,$w^m$ 是对应的样本权重。正样本是观察到目标行为的曝光;负样本是发生了有效曝光/观看但目标行为未发生的样本。 这一定义把 reward 与实际的曝光后反馈严格挂钩,从而给 guided decoding 提供了可分离的 reward head。
注意式 (18) 的一个重要设计:监督被施加在每一层 SID 上($l = 1, \ldots, d$),而不是只在完整 SID 生成完毕后。这正是使 reward 能在解码早期(第 1 层)就提供有意义信号的前提——process supervision 的味道。
4.2.3 多目标 reward 损失¶
对多目标引导,论文使用 LTR reward,它代表一个融合后的业务偏好。沿用多目标 ensemble 建模(Pantheon)的实践,LTR head 在 SID level 预测一个标量 reward 概率 $\hat{r}_l^{\mathrm{ltr}}$,并用各行为损失的加权聚合优化:
$$\mathcal{L}_r^{\mathrm{ltr}} = \sum_{m \in \mathcal{M}} \alpha_m \frac{1}{d}\sum_{l=1}^{d} \mathrm{BCE}\!\left(y^m, \hat{r}_l^{\mathrm{ltr}}; w^m\right) \tag{19}$$
其中 $\alpha_m$ 表示目标 $m$ 的业务权重。相比单行为 head,LTR reward 提供了一个统一的引导信号去平衡多个目标,并且可以直接用作多目标 reward guided decoding 的 test-time controller。这一步是 RGD「工业可用性」的核心:换目标 = 换 head / 换 $\alpha_m$,而不必动生成器。
4.3 Reward Guided Inference:三种注入模式¶
推理时,RGD 建立在标准 beam search 之上。在每个 SID 层,beam search 维护 top-$K$ 个部分 SID 序列作为活跃 beam。每个 beam 用当前码本里的候选码扩展,其 top-$M$ 个候选先按生成概率选出。因此所有 beam 的扩展形成一个至多 $K \times M$ 个部分序列的候选池,从中保留 top-$K$ 个序列给下一层。
RGD 把 reward guidance 引入这个扩展与剪枝过程:候选按式 (10) 的修改后分数选取,从而同时依据生成合理性(generation plausibility)与估计业务价值(estimated business value)。由于对所有扩展候选评估 reward 会引入额外计算,论文设计了三种有效性-效率权衡不同的推理策略。
4.3.1 Pre-merge Guidance(合并前引导)¶
在 pre-merge 模式下,每个 beam 在合并进全局候选池之前,先在自己的 top-$M$ 候选上评估 reward。因此 reward 不仅影响哪个候选存活,还影响哪个 beam 被允许扩展,给出了最早可能的介入点(earliest possible entry point)。
这是表达力最强、但也最昂贵的模式:reward model 每层要被查询 $|\mathcal{B}_{l-1}| \cdot M$ 次。
4.3.2 Post-merge Guidance(合并后引导)¶
post-merge 模式先用 $\log P$ 做全局合并,保留一个扩展后的全局池 $M_{\mathrm{expand}} \cdot K$ 个候选,然后只对这个池内的候选施加 reward。reward model 每层被调用至多 $M_{\mathrm{expand}} \cdot K$ 次,比 pre-merge 少一个数量级。
代价是:任何 $\log P$ 不够高、进不了扩展池的候选,即使业务价值高也无法被 reward 挽回。
4.3.3 Hybrid Guidance(混合引导)¶
hybrid 模式在前 $l'$ 层用 pre-merge 融合,在其余层用 post-merge 融合。在生产部署中论文设 $l' = 1$,因为第一层只有一个活跃 beam。这有效地在做关键决策的第一层扩大了搜索空间,同时在更深层剪掉冗余分支,从而匹配生产环境中能容忍的 reward 打分预算。
4.3.4 缓存一致性¶
三种模式都涉及一个工程细节:reward 侧 bottleneck MLP 使用的因果历史缓存 $[\mathbf{u}_1, \ldots, \mathbf{u}_{l-1}]$,必须与生成器的 KV cache 一起、在 beam 重组时同步重排,使得每个存活的 beam 看到的是它真实祖先的 reward 上下文。两套缓存被同一个置换索引,使生成与 reward 评估严格耦合。
4.3.5 算法伪代码(Algorithm 1: RGD Beam Search)¶
输入:用户上下文 x;beam 宽 K;扩展宽 M;mode ∈ {pre, post, hybrid}
输出:K 条生成的 SID 序列

 1  初始化 beams B_0 = {(∅, 0)};cache H = ∅
 2  for l = 1, ..., d do
 3      foreach beam b ∈ B_{l-1} do
 4          计算 log P(· | b, x) 和 cache u_l
 5          按 log P 选出 top-M 候选 T_b
 6          if mode = pre 或 (mode = hybrid 且 l = 1) then
 7              用 Eq.10 给每个 j ∈ T_b 打分
 8          end
 9      end
10      把 ∪_b T_b 合并进候选池 P
11      if mode = post 或 (mode = hybrid 且 l > 1) then
12          按 log P 保留一个扩展池 P' ⊆ P
13          用 Eq.10 给每个 j ∈ P' 打分
14          P ← P'
15      end
16      保留 top-K 候选作为 B_l,并重排 caches
17  end
18  return B_d
5. 实验设置¶
论文围绕四个研究问题组织实验:
- RQ1:RGD 在离线公开数据集上相对现有 baseline 表现如何?
- RQ2:在工业场景中引入 reward 后 RGD 表现如何?不同 reward 有什么影响?
- RQ3:RGD 在业务场景中的参考设置是什么?它们如何影响性能?
- RQ4:RGD 在真实线上服务中表现如何?
5.1 离线公开数据集设置(Appendix C.1)¶
数据集:Amazon Reviews 的三个类目——Sports and Outdoors (Sports)、Beauty、Toys and Games (Toys)。遵循标准实践,把用户历史评论视为交互并按时间排序构成输入序列,采用 leave-last-out 划分训练/验证/测试集。
表 4:预处理后数据集统计(AvgLen 为输入序列平均长度)
| Dataset | User | Item | Interaction | Sparsity | AvgLen |
|---|---|---|---|---|---|
| Sports | 35,598 | 18,357 | 296,337 | 99.95% | 8.32 |
| Beauty | 22,363 | 12,101 | 198,502 | 99.93% | 8.88 |
| Toys | 19,412 | 11,924 | 167,597 | 99.93% | 8.63 |
Baselines:两条线——
- 传统序列推荐:GRU4Rec、BERT4Rec、SASRec、S³-Rec、VQ-Rec
- 生成式推荐:TIGER、HSTU、RPG、PROMISE
评估指标:Recall@$K$ 与 NDCG@$K$($K = 5, 10$)。测试集评估使用验证集最优 checkpoint。
实现细节:
- 语义编码器:sentence-t5-base(统一用于本文实验与复现,保证公平比较)
- 量化:RQ-VAE 或 Res-KMeans
- SID 层数 $L = 3$,码本大小 $K = 256$
- 骨干:T5 encoder-decoder,4 层,维度 64
- 学习率 5e-4,cosine decay;最多 200 epochs,early stopping patience 20
- beam size 一致设为 20,推理策略选 pre-merge
- 全部 PyTorch 实现
一个必须注意的实验设计妥协:由于离线公开数据集只暴露不含多行为日志的用户-物品交互序列,论文把用户序列中的每个 ground-truth next item 当作带隐式点击的正样本,负样本则从同一 batch 内出现的其他物品中抽取。这一设计保证了「reward-guided 机制在单目标下仍可维持」,但也意味着公开数据上的 reward 是一个人造代理信号,其信息量远低于工业场景中真实的多行为反馈。
论文对 baseline 的处理有两个诚实的脚注:RPG 使用 OpenAI 的
text-embedding-3-large作为语义编码器,与其他使用sentence-t5-base的 baseline 相比是不公平的(因此复现时统一了编码器);PROMISE 未提供可用代码,因此按论文进行了复现。
5.2 工业场景设置(Appendix C.2)¶
数据:基于快手直播平台的日志做持续在线学习(continuous online learning)。具体规模:
- 每天约 4 亿用户、300 万创作者、数十亿条交互记录
- 行为类型:click、long view、follow、gift
- 数据流按实时 30 秒滑动窗口组织
Baseline:构建在 OneLive 之上——工业环境中一个已完全部署的生成式推荐服务。在此基础上,接入多种 reward-based 偏好优化方法做对比:DPO、GRPO(RL 路线),以及由多种目标 reward 组合引导的 RGD。引导信号涵盖单行为对应分数(CTR、LVTR、WTR、GTR)和多目标混合 reward LTR。
评估指标:HitRate 与 MRR 衡量生成能力;此外借助 Reward 指标(沿用 OneLive 的做法),用已部署的 ranking model 给生成的候选打分并取平均,从而衡量下游流水线对生成结果的认可程度。
6. 主要实验结果¶
6.1 RQ1:离线公开数据集上的整体表现¶
表 1:三个数据集上不同模型的整体性能对比(最优加粗,次优下划线;* 为本文复现结果;RGD 所有结果相对 baseline 在配对 t 检验下 $p < 0.05$ 显著)
| Models | Sports R@5 | Sports N@5 | Sports R@10 | Sports N@10 | Beauty R@5 | Beauty N@5 | Beauty R@10 | Beauty N@10 | Toys R@5 | Toys N@5 | Toys R@10 | Toys N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Traditional | ||||||||||||
| GRU4Rec | 0.0129 | 0.0086 | 0.0204 | 0.0110 | 0.0164 | 0.0099 | 0.0283 | 0.0137 | 0.0097 | 0.0059 | 0.0176 | 0.0084 |
| BERT4Rec | 0.0115 | 0.0075 | 0.0191 | 0.0099 | 0.0203 | 0.0124 | 0.0347 | 0.0170 | 0.0116 | 0.0071 | 0.0203 | 0.0099 |
| SASRec | 0.0233 | 0.0154 | 0.0350 | 0.0192 | 0.0387 | 0.0249 | 0.0605 | 0.0318 | 0.0463 | 0.0306 | 0.0675 | 0.0374 |
| S³-Rec | 0.0251 | 0.0161 | 0.0385 | 0.0204 | 0.0387 | 0.0244 | 0.0647 | 0.0327 | 0.0443 | 0.0294 | 0.0700 | 0.0376 |
| VQ-Rec | 0.0208 | 0.0144 | 0.0300 | 0.0173 | 0.0457 | 0.0317 | 0.0664 | 0.0383 | 0.0497 | 0.0346 | 0.0737 | 0.0423 |
| Generative | ||||||||||||
| TIGER | 0.0264 | 0.0181 | 0.0400 | 0.0225 | 0.0454 | 0.0321 | 0.0648 | 0.0384 | 0.0521 | 0.0371 | 0.0712 | 0.0432 |
| HSTU | 0.0258 | 0.0165 | 0.0414 | 0.0215 | 0.0469 | 0.0314 | 0.0704 | 0.0389 | 0.0433 | 0.0281 | 0.0669 | 0.0357 |
| RPG* | 0.0281 | 0.0194 | 0.0428 | 0.0241 | 0.0503 | 0.0354 | 0.0714 | 0.0422 | 0.0518 | 0.0356 | 0.0740 | 0.0427 |
| PROMISE* | 0.0271 | 0.0170 | 0.0444 | 0.0226 | 0.0491 | 0.0317 | 0.0775 | 0.0406 | 0.0502 | 0.0340 | 0.0739 | 0.0411 |
| RGD | 0.0318 | 0.0204 | 0.0495 | 0.0261 | 0.0550 | 0.0356 | 0.0827 | 0.0445 | 0.0531 | 0.0373 | 0.0766 | 0.0439 |
结论分析:
-
RGD 在三个数据集、所有评估指标上都取得最好性能,Recall@10 最高提升 11.49%,NDCG@10 最高提升 8.30%。这支持了论文的核心论断:仅靠似然驱动的 SID 生成不足以满足推荐需求,因为 beam search 主要被局部生成概率主导。相比 PROMISE 的直接重排(post-hoc reranking),RGD 通过在每个解码步注入 reward 引导来重塑搜索空间分布,从而促进那些与目标偏好更对齐的候选被检索出来。
-
RGD 在只有隐式交互反馈的公开数据集上也一致最优,说明 reward-guided 解码即使在公开数据上也有效。换言之,reward 模型从正负物品信号中仍能提供超出基座生成器所学似然概率的、有用的偏好对齐与价值引导。
-
Recall 与 NDCG 的一致提升表明 RGD 不仅检索出更相关的物品,同时也提升了 top-ranked 物品的排序质量。这可以归因于 KL 正则化的 policy shaping:基座生成器提供 reference policy,reward model 在 test time 充当 controller,确保有效的分布 fine-tuning 而不产生显著漂移。
-
一个值得注意的细节:PROMISE 在 Beauty R@10 上(0.0775)是第二好,说明 process reward + test-time scaling 这条路线本身就有效;RGD 的增量主要来自「把 reward 融合规则从启发式换成闭式最优解」以及「pre-merge 的早期介入」。
6.2 超参数分析:温度 $\beta$¶
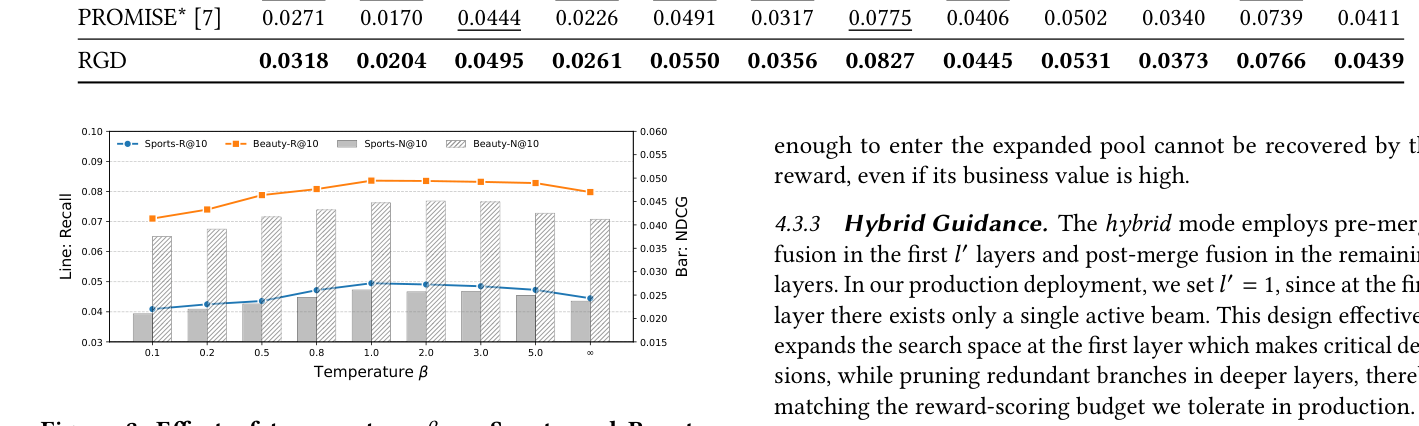
图 3 展示 $\beta$(控制基座生成器与 reward guidance 之间平衡的温度参数)在 Sports 和 Beauty 上的效果,横轴取 0.1 / 0.2 / 0.5 / 0.8 / 1.0 / 2.0 / 3.0 / 5.0。
- $\beta = \infty$ 时 reward 项被移除,退化为纯 likelihood-based 解码,性能变差 —— 这直接证实 reward 模型提供了超出生成器概率之外的有用偏好信号。
- 性能在适中的 $\beta$(图中约 1.0 附近)下最好。
- $\beta$ 过小导致 reward 项主导生成概率,解码偏离可靠的语义结构。
- $\beta$ 过大削弱 reward 项,使解码退化到 RGD 无法充分纠正「生成概率与推荐偏好之间 mismatch」的程度。
尽管如此,$\beta$ 在不同数据集上呈现相似的趋势,表现为一个稳定且易解释的控制参数——这支持了 RGD 作为可控解码框架的价值。
6.3 RQ2:工业场景表现¶
表 2:工业场景数据集上,由不同 reward 方法驱动的变体在同一 baseline 上的整体性能对比(最优加粗;g. 表示由某目标引导)
| Model | HitRate@604 | MRR@604 | Reward@604 CTR | Reward@604 LVTR | Reward@604 WTR | Reward@604 GTR |
|---|---|---|---|---|---|---|
| OneLive | 0.82662 | 0.22963 | 0.05442 | 0.05089 | 0.00530 | 0.00155 |
| DPO | 0.82092 (−0.69%) | 0.22798 (−0.72%) | 0.05495 (+0.97%) | 0.05162 (+1.43%) | 0.00533 (+0.57%) | 0.00156 (+0.65%) |
| GRPO | 0.82331 (−0.40%) | 0.22887 (−0.33%) | 0.05548 (+1.95%) | 0.05221 (+2.59%) | 0.00532 (+0.38%) | 0.00157 (+1.29%) |
| RGD g. CTR | 0.82291 (−0.37%) | 0.22955 (−0.03%) | 0.05618 (+3.23%) | 0.05238 (+2.93%) | 0.00536 (+1.13%) | 0.00157 (+1.29%) |
| RGD g. LVTR | 0.82334 (−0.33%) | 0.22894 (−0.30%) | 0.05587 (+2.58%) | 0.05325 (+4.51%) | 0.00537 (+1.31%) | 0.00156 (+0.64%) |
| RGD g. WTR | 0.82336 (−0.33%) | 0.22931 (−0.14%) | 0.05466 (+0.43%) | 0.05180 (+1.71%) | 0.00545 (+2.79%) | 0.00159 (+2.56%) |
| RGD g. GTR | 0.82374 (−0.29%) | 0.22846 (−0.51%) | 0.05408 (−0.62%) | 0.05084 (−0.10%) | 0.00539 (+1.65%) | 0.00164 (+5.66%) |
| RGD g. LTR | 0.83562 (+1.09%) | 0.22970 (+0.03%) | 0.05489 (+0.86%) | 0.05101 (+0.24%) | 0.00534 (+0.75%) | 0.00162 (+4.52%) |
结论分析:
-
RL(DPO/GRPO)与 RGD 都能有效把生成候选的分布推向业务目标,从而提升下游模型的认可与接受度。这说明把真实业务反馈注入生成过程确实能优化基于似然的局部最优。
-
通过训练优化偏好的 RL 方法会在一定程度上损害生成能力:DPO 的 HitRate 掉 0.69%、MRR 掉 0.72%,GRPO 分别掉 0.40% / 0.33%——这是参数更新对基座生成器引起的分布漂移(distributional drift)。考虑到它们是训练时优化,成本效益并不划算。相比之下,RGD 取得了更有利的生成质量-reward 提升权衡,因为它在解码阶段做 reward shaping,对基座生成器性能的影响最小(HitRate 掉幅普遍在 0.3% 左右,LTR 引导下甚至 +1.09%)。
-
不同的引导 reward 在 RGD 下导致明确不同的优化行为,充分展示了它在工业场景中的可控性:单目标引导显著提升各自的目标 reward(CTR +3.23%、LVTR +4.51%、WTR +2.79%、GTR +5.66%,均在各自列取得最优),而多目标 LTR 引导在多个指标上取得平衡改善。合理的 reward 组合更好地平衡了生成质量与商业价值,RGD 为业务对齐与参数调优提供了便利。
一个需要正视的 trade-off:除 LTR 外,所有单目标 RGD 变体的 HitRate 与 MRR 都是负向的。这说明「用 reward 重塑分布」确实是在以少量生成保真度换取业务价值——只是 RGD 的换汇率优于 DPO/GRPO。而 LTR 引导之所以能同时正向,很可能是因为融合后的 LTR reward 与曝光后综合满意度高度相关,与生成似然的冲突最小。
6.4 RQ3:深入分析¶
6.4.1 概率-奖励失配的可视化¶
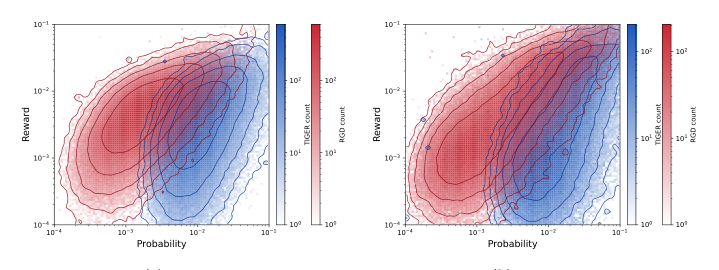
为理解 RGD 如何改变解码行为,论文把生成候选可视化在概率-奖励空间中(横轴概率由生成器给出,纵轴 reward 由 reward model 预测)。
- TIGER 选出的候选(蓝色等高线)主要集中在高概率区域,反映其似然主导的 beam search 策略。
- RGD 产生了更宽的分布(红色等高线),在「生成概率相对更低但 reward 更高」的候选上放置了更多密度。
这表明 RGD 通过提升那些本会被剪掉的有潜力候选,缓解了概率-奖励失配,从而在更宽的搜索轨迹上重塑分布,并对齐更有价值的偏好。这张图是全文对「问题存在性」和「方法有效性」最直接的经验证据。
6.4.2 推理模式的比较¶
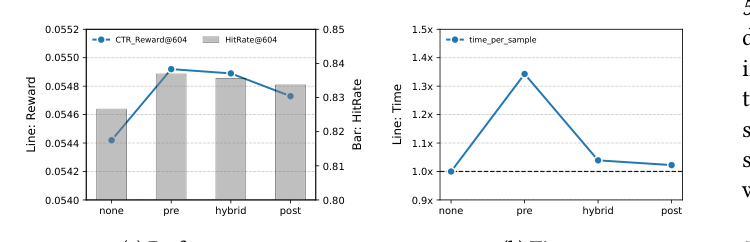
论文在工业场景下、LTR-guided RGD 框架中比较了不同 reward 注入策略(脚注指出:工业场景的搜索空间显著大于公开数据集,使不同策略间的区分更明显)。
- pre-merge 取得最佳整体性能:更大的搜索空间与更早的 reward 施加,让高 reward 候选能在更早的阶段影响搜索轨迹。但代价是更高的推理开销,因为要为更多候选计算 reward(图 5(b) 中 pre 的单样本时间成本约 1.3x)。
- hybrid 策略取得与 pre-merge 相当的性能,同时时延接近 post-merge,相对无 reward baseline 的额外时间开销保持可接受。
结论:hybrid 策略为生产部署提供了更有利的权衡——在关键的早期 SID 上做细粒度搜索,在后续层用 beam 优化。
6.4.3 Reward Model 架构¶
表 3:不同 reward model 架构的结果对比
| Model | CTR_Reward@604 | QPS |
|---|---|---|
| Lite Decoder | – | 1.00x |
| Bottleneck MLP | −0.27% | 1.28x |
Lite Decoder 指与生成器中相同的 decoder block。可以看出:即使 CTR reward 只有轻微、可接受的下降(−0.27%),Bottleneck MLP 也显著降低了推理服务的成本(QPS 提升 1.28x)。因此论文选择该架构作为默认 reward model。
6.4.4 Beam Size 扩展(Appendix C.3)¶
表 5:不同生成模型与 beam size 的结果对比
| Model | Beam Size | HitRate@302 | HitRate@604 | CTR_Reward@302 | CTR_Reward@604 |
|---|---|---|---|---|---|
| Base | 302 | 0.8021 | – | 0.0564 | – |
| Base | 604 | 0.8087 | 0.8188 | 0.0557 | 0.0550 |
| RGD | 604 | 0.8146 | 0.8229 | 0.0570 | 0.0559 |
结论分析:对 base 模型而言,增大 beam size 只带来 HitRate 的有限提升(0.8021 → 0.8087 @302),而 CTR reward 反而下降(0.0564 → 0.0557)——即单纯扩大搜索空间会引入更多「可能但不值钱」的候选,稀释了平均业务价值。相比之下,RGD 在同样 beam size 下取得更好 HitRate,并且在 @604 上还提升了 CTR reward。这说明 reward guided decoding 让被放大的 beam 变得更有效:RGD 不是单纯地探索更多「更可能」的候选,而是用额外的搜索空间去保留并选出业务价值更高的物品。
6.4.5 附录 B:$\beta$ 对分布熵的影响¶
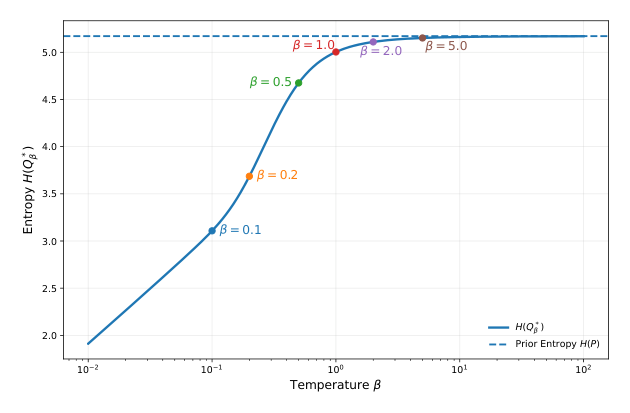
除了图 1 的重加权分布,论文还可视化了 reward-shaped 分布的熵如何随温度 $\beta$ 变化。具体地,计算重塑后的分布:
$$Q_\beta^*(j) = \mathrm{softmax}\!\left(\ell_j + \frac{R(j)}{\beta}\right) \tag{30}$$
并在不同 $\beta$ 下绘制熵 $H(Q_\beta^*)$。
如图 6 所示,$Q_\beta^*$ 的熵随 $\beta$ 单调增加,并逐渐逼近先验分布 $P$ 的熵(图中虚线)。这与 $\beta$ 在 KL 正则化 reward shaping 中的角色一致。因此,$\beta$ 可以被解释为一个调节 reward guidance 锐度的可控旋钮:小 $\beta$ 导致更强、更具选择性的 reward-driven 解码;大 $\beta$ 恢复似然驱动的生成。这也解释了主实验中 RGD 对 $\beta$ 的经验敏感性——适中的 $\beta$ 在「保留基座生成器分布」与「强调高 reward 候选」之间提供了更好的平衡。
6.5 RQ4:线上 A/B 实验¶
论文把 CTR-guided 版本的 RGD 部署到快手直播推荐服务做线上 A/B 测试。选 CTR 作为引导目标的理由:点击反馈比 follow、gift 等稀疏业务信号更稠密、更稳定,使得 reward model 在实时服务流量下更容易可靠估计。此外,点击是直播漏斗中的上游行为,更好的点击引导能进一步改善下游参与度与变现。
两周 A/B 期间,相比已部署的 baseline,RGD 取得:
| 指标 | 提升 |
|---|---|
| 页面级 CTR (page-level CTR) | +0.392% |
| 直播观看时长 (live-streaming watch time) | +0.689% |
| 直播观看次数 (live-streaming watch counts) | +0.349% |
这些结果验证了 reward guided decoding 在真实生产流量下做目标对齐的有效性,以及 RGD 把稠密用户反馈转化为线上业务收益的能力。
7. 理论附录¶
7.1 附录 A.1:等价性证明¶
正文中的 KL 正则化目标,可以看作式 (4) 中约束问题的 Lagrangian relaxation。其 Lagrangian 为:
$$\mathcal{L}(Q,\beta) = \mathbb{E}_{j\sim Q}[R(j)] - \beta\big(D_{\mathrm{KL}}(Q\|P) - \epsilon\big) = \mathbb{E}_{j\sim Q}[R(j)] - \beta D_{\mathrm{KL}}(Q\|P) + \beta\epsilon, \quad \beta \ge 0 \tag{20}$$
对固定的 $\beta$,最后一项 $\beta\epsilon$ 与 $Q$ 无关,因此在 $Q$ 上最大化 $\mathcal{L}(Q,\beta)$ 等价于求解:
$$\max_Q \left\{ \mathbb{E}_{j\sim Q}[R(j)] - \beta D_{\mathrm{KL}}(Q\|P) \right\} \tag{21}$$
因此,带惩罚的目标就是 KL 约束问题的 Lagrangian relaxation。对每个 $\beta$,其解对应于一个满足下式的约束问题:
$$\epsilon = D_{\mathrm{KL}}(Q_\beta^*\|P) \tag{22}$$
7.2 附录 A.2:最优性保证¶
进一步证明:正文导出的闭式分布在 KL 约束视角下是最优的。假设对所有候选 $P(j) > 0$,且 $R(j)$ 有界。对固定的 $\beta > 0$,目标为:
$$\mathcal{F}_\beta(Q) = \mathbb{E}_{j\sim Q}[R(j)] - \beta D_{\mathrm{KL}}(Q\|P) \tag{23}$$
它在概率单纯形上是严格凹的,因为期望 reward 项在 $Q$ 上线性,而 $-D_{\mathrm{KL}}(Q\|P)$ 严格凹。因此其最大化点唯一,即正文推导出的:
$$Q_\beta^*(j) = \frac{P(j)\exp(R(j)/\beta)}{Z_\beta} \tag{24}$$
令 $\epsilon_\beta = D_{\mathrm{KL}}(Q_\beta^*\|P)$。下证 $Q_\beta^*$ 也是如下约束 reward 最大化问题的唯一解:
$$\max_Q \mathbb{E}_{j\sim Q}[R(j)] \quad \text{s.t.} \quad D_{\mathrm{KL}}(Q\|P) \le \epsilon_\beta \tag{25}$$
由于 $Q_\beta^*$ 最大化 $\mathcal{F}_\beta$,对任意可行 $Q$ 有:
$$\mathbb{E}_{Q_\beta^*}[R] - \beta\epsilon_\beta \ge \mathbb{E}_Q[R] - \beta D_{\mathrm{KL}}(Q\|P) \tag{26}$$
整理得:
$$\mathbb{E}_{Q_\beta^*}[R] \ge \mathbb{E}_Q[R] + \beta\big(\epsilon_\beta - D_{\mathrm{KL}}(Q\|P)\big) \ge \mathbb{E}_Q[R] \tag{27}$$
因此,在同一 KL 预算内没有任何分布能取得更高的期望 reward;唯一性由 $\mathcal{F}_\beta$ 的严格凹性得到。
等价地,定义 $r_\beta = \mathbb{E}_{Q_\beta^*}[R]$,则 $Q_\beta^*$ 也是下式的唯一解:
$$\min_Q D_{\mathrm{KL}}(Q\|P) \quad \text{s.t.} \quad \mathbb{E}_{j\sim Q}[R(j)] \ge r_\beta \tag{28}$$
对任意满足 $\mathbb{E}_Q[R] \ge r_\beta$ 的 $Q$,$Q_\beta^*$ 对 $\mathcal{F}_\beta$ 的最优性意味着:
$$r_\beta - \beta\epsilon_\beta \ge \mathbb{E}_Q[R] - \beta D_{\mathrm{KL}}(Q\|P) \ge r_\beta - \beta D_{\mathrm{KL}}(Q\|P) \tag{29}$$
从而 $D_{\mathrm{KL}}(Q\|P) \ge \epsilon_\beta$。因此在所有达到至少同等期望 reward 的分布中,$Q_\beta^*$ 是在 KL 散度意义下离基座生成器分布最近的那一个。这为 RGD 提供了双向的最优性保证:在给定偏离预算下尽可能提升 reward,或等价地,在给定 reward 目标下尽可能贴近生成器。
8. 核心贡献总结¶
-
把「价值导向解码」从工程直觉提升为可证明的最优决策规则。RGD 证明了 $\log P(j) + R(j)/\beta$ 这条排序规则是 KL 约束下 reward 最大化的唯一最优解,并给出双向最优性保证(式 27 / 式 29)。这把工业界常见的「生成分与价值分线性加权」从启发式升格为有理论依据,同时赋予 $\beta$ 明确语义(KL 预算的对偶变量 / 熵旋钮)。
-
reward 作为 test-time controller,而非训练时的模型参数。基座生成器保持为 reference policy 不变,reward head 通过 stop-gradient 复用冻结的 decoder 隐状态。这使得业务目标切换(CTR / LVTR / WTR / GTR / LTR)不需要重训生成器,直接回应了「工业目标动态多样」这一痛点。
-
链式打分头 + 逐层监督,让 reward 能在解码最早期生效。式 (13) 的因果 bottleneck MLP 缓存前缀投影,式 (18) 在每层 SID 上都施加 BCE 监督,使得第 1 层扩展时 reward 就已经可用——这是相对 post-hoc reranking 的结构性优势。
-
三种注入模式的显式成本-收益工程化。pre / post / hybrid 给出了「reward 调用次数」与「介入时机」的完整权衡谱系,并明确了生产部署的推荐配置($l' = 1$ 的 hybrid)。Bottleneck MLP vs Lite Decoder 的 QPS 对比(1.28x / −0.27% reward)也是可直接复用的工程结论。
-
离线公开 + 工业离线 + 线上 A/B 的三段验证,且工业表格诚实地暴露了 HitRate 的负向代价,而非只报正向数字。
9. 与已归档相关工作的对比¶
Step 2.5 语义指纹: 核心问题 —— 生成式推荐的解码被似然主导,业务价值高但生成概率低的候选在 beam search 早期被剪枝;训练时对齐(DPO/GRPO)把偏好烘焙进参数,目标切换成本高。 核心解法路径 —— 把 value-guided decoding 形式化为 KL 正则 reward 最大化,得闭式 Boltzmann 重加权分布,并用复用主干的轻量打分头在解码过程中注入价值信号。
GEM-Rec GEM-Rec: Generative Recommendation with Monetization (Google Research, 2026-03-23)¶
关系:独立并发(本文未引用 GEM-Rec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文认定的 root cause 高度一致——SID 生成式推荐的 decoder 在结构上只表达「语义相关性 / 历史似然」,经济价值或业务效用没有进入自回归过程的通道。GEM-Rec 描述的是「推荐模型与广告排序模型分开训练、展示时靠 blending 层拼接,decoder 永远看不到实时 bid」;RGD 描述的是「likelihood 与 downstream business utility 的内生 mismatch,且被 beam search 早期剪枝放大」。两者都明确否定了 post-hoc 补丁路线。
- 相近的技术骨架:两者都是解码每一步注入价值 + 完全 training-free 的单旋钮控制器,且注入形式都是在 logit 空间做加法。GEM-Rec 的物品级规则是 $\tilde{z}_c = z_c + \lambda\log(1+B(c))$($B(c)$ 是该 SID 前缀语义簇下所有合法赞助广告的最大出价,Prefix-Aware Bid Aggregation);RGD 的规则是 $p^*(j) = \log P(j) + R(j)/\beta$。二者的 $\lambda$ 与 $1/\beta$ 扮演完全同构的角色:调到 0(或 $\beta\to\infty$)就安全退化为基座模型。两者也都强调价值信号必须能在前缀层面聚合,使早期解码步就能感知深层候选的价值。
- 本文的差异与推进:RGD 给出了这条加法规则的最优性来源——它不是设计出来的融合公式,而是 KL 约束 reward 最大化的唯一闭式解,并配了双向最优性证明(附录 A.2)。GEM-Rec 的 $\lambda\log(1+b)$ 则是为竞价场景手工设计的调制项,其正当性来自机制设计侧的性质保证(Safe Fallback、Organic Integrity、Allocative Monotonicity),而非分布层面的最优性。反过来,GEM-Rec 在「价值从哪里来」上更彻底:它的价值信号是外生的实时出价 $b$,无需训练任何 reward model;RGD 的 $R(j)$ 需要一个与生成器联合训练的打分头,因此严格说 RGD 是「生成器免重训」而非「完全免训练」。
- 可比的方法 / 实验差异:GEM-Rec 额外做了词表扩展(
<ORG>/<AD>控制 token)与分层解码(先调制 flag 再在 flag 条件下 beam search),并证明了任意两个有机 item 的相对序关于 $\lambda$ 不变;RGD 没有这类结构性隔离,价值调制作用于全部候选,因此需要靠 $\beta$ 的经验调优避免语义漂移(图 3 显示 $\beta$ 过小确实会偏离可靠语义结构)。验证层面差距明显:GEM-Rec 只在合成竞价市场上验证架构能力,无真实线上实验;RGD 有快手 4 亿用户直播场景的两周 A/B(CTR +0.392%、观看时长 +0.689%)。
Gryphon Gryphon: A Unified Architecture for Semantic ID Generation and Item-Level Scoring (Yandex, 2026-06-07)¶
关系:独立并发(本文未引用 Gryphon)· 已加载对方精读
- 共同关注的问题:两篇都把矛头指向 beam likelihood 本身不可信。Gryphon 的表述是「beam search 打分的对象是 SID token 序列 $\ell_\theta(\sigma|u) = \sum_b \log p_\theta(s_b|u,s_{<b})$,而推荐质量在具体 item 粒度被评估」,并具体化为两个失败模式:序列似然失准(teacher forcing 与自回归推理不一致,早期 token 出错会把 beam 推进错误子树,误差沿层累积)与 SID 碰撞。RGD 的表述则是似然与业务价值的错配,同样强调误差/损失沿解码层累积、早期剪枝不可逆。
- 相近的技术骨架:两者的模块设计惊人地相似——都在基座生成模型上挂一个轻量打分头,且该头复用主干的隐状态而非另建一座塔。Gryphon 的 ILSM 复用共享 encoder 的用户状态 $E_u$,打分器 $r_\phi(u,i) = f_\phi(E_u, e_i)$ 实现为轻量 item→user cross-attention + MLP head 出标量;RGD 的 reward head 复用冻结的 decoder 隐状态 $\mathbf{h}_{k,l}^{\mathrm{attn}}, \mathbf{h}_{k,l}^{\mathrm{ffn}}$,经 bottleneck MLP 出标量。两者都把「打分头与监督信号解耦」当作卖点:Gryphon 说 ILSM 可换成多目标 / ranker 蒸馏 / LTV,RGD 则实际实例化了 CTR/LVTR/WTR/GTR/LTR 五种引导。
- 本文的差异与推进:关键分歧在于价值信号的注入时机与似然的去留。Gryphon 是最激进的 post-hoc 路线——beam likelihood 只决定候选集的成员资格,在最终排序中被彻底丢弃($\mathrm{TopN}(u) = \mathrm{TopN}_{i\in I_u} r_\phi(u,i)$);RGD 的论证恰恰是「post-hoc 无法找回已被剪掉的候选」,因此坚持在每个解码步融合,且保留似然作为先验(式 10 是 $\log P$ 与 $R/\beta$ 的加法,而非替换)。此外 Gryphon 的 ILSM 通过联合损失 $\mathcal{L} = \mathcal{L}_{gen} + \lambda\mathcal{L}_{NIP}$ 需要重训整个模型,不是可外挂模块,也没有 test-time 旋钮;RGD 的 $\beta$ 可在 serving 期任意调整。若把两者放在同一坐标系里,Gryphon 解决的是「SID 粒度 → item 粒度」的分辨率问题(含碰撞消歧),RGD 解决的是「似然 → 业务价值」的目标问题,二者其实正交且可叠加——RGD 的框架里完全可以把 Gryphon 的 item-level score 作为 $R(j)$ 的一个来源。
- 可比的方法 / 实验差异:Gryphon 在 Yandex 音乐 7 天 4% 流量 A/B 中作为唯一候选源替换 15+ 生成器与整个 preranking 阶段,活跃用户 +0.43%、未播完曲目 −1.3%,传给 ranker 的候选从 3000 降到 1000——它的收益主要体现在架构简化与候选集瘦身;RGD 的收益体现在同一架构下的价值提升(CTR +0.392%),两者的价值主张并不冲突。
UniVA UniVA: Unified Value Alignment for Generative Recommendation in Industrial Advertising (Tencent WeChat Channels, 2026-05-07)¶
关系:独立并发(本文未引用 UniVA)· 已加载对方精读
- 共同关注的问题:UniVA 提出的「价值不一致(Value Inconsistency)」三层分解中,第二层与 RGD 的问题陈述几乎逐字对应——「解码被 likelihood 主导,商业目标只在训练目标级注入,商业前景好的前缀一旦在早期 beam 步被语义分数剪掉就不可挽回」。两篇都明确地把「价值不能是生成之后的补丁」当作核心论断。
- 相近的技术骨架:两者都在 beam 扩展的每一步用「生成信号 + 价值信号」的融合分数做候选选择。UniVA 的线上 Value-Guided Personalized Beam Search 累积分数为 $\mathrm{Score}(s_{\le l}) = \sum_{t=1}^{l}\mathrm{Fuse}(o_{gen}^{(t)}, o_{value}^{(t)})[s_t]$,其中 Fuse 是逐元素求和——这与 RGD 的 $\log P(j) + R(j)/\beta$ 在形式上是同一族的加法融合,只是 UniVA 没有温度旋钮,权重被固化在训练好的 dual-head 里。两者的价值 head 也都与生成 backbone 共享表示(UniVA 是 dual-head 共享 decoder 输出,RGD 是 reward head 复用冻结的 decoder 隐状态)。
- 本文的差异与推进:分歧在于「价值注入的深度」与「是否可在 test time 切换」。UniVA 是全链路注入:tokenization 时(Commercial SID,最后一层码本换成按优化目标/ROI/行业/出价分箱的商业码)+ 训练时(eCPM-aware PPO / MCTS-PPO,value head 当 critic)+ 解码每步(fused logits);代价是必须重训整个 backbone,且没有 test-time 旋钮,换一个业务目标就要重跑 tokenizer + RL 全流程。RGD 走的是相反的极简路线:只在解码这一层注入,基座生成器完全不动,目标切换 = 换 reward head 或调 $\alpha_m$。RGD 因此正好回应了 UniVA 这类方案在论文引言中被批评的「retraining the generator for each preference change is costly and impractical」。另一方面,UniVA 的 Commercial SID 提供了 RGD 没有的能力——让 token 空间本身具有商业可分性,避免语义相近但变现潜力迥异的物品被压进相邻 SID 路径;RGD 的 reward 只能在给定 tokenizer 的前提下重加权,无法修复 tokenizer 本身的价值盲区。这是 RGD 一个未被讨论的上游依赖。
- 可比的方法 / 实验差异:UniVA 在微信视频号广告 5% 流量 A/B 中取得 GMV +1.50%,离线 HR@100 +37.04%(其个性化 trie 使 beam width 300 下有效路径从 48 条提升到 300 条);RGD 在快手直播 A/B 中取得 CTR +0.392% / 观看时长 +0.689%。两者的绝对数字不可直接比较(广告 GMV vs 内容 CTR,且基线不同),但可以看出 UniVA 的全链路重构换来更大的离线跃升,RGD 的轻量介入换来更低的迭代成本——这恰是同一问题下两条路线的典型分野。
被剔除的近似候选与理由(防止门槛放水): - [2607.11392] CRID(Alibaba)/ [2607.18796] TSGR(Taobao Search):同样是「业务价值 vs 生成概率」的问题陈述,但价值注入发生在 SID 构造层(intra-cluster business-value ordinal rank / Query-aware Parallel SID),属于 identifier 设计而非解码分布重塑,方法流程图无法与 RGD 抽象重合。 - [2607.24255] OxygenREC-v2(JD.com):问题同构(生成概率 ≠ 业务价值),但解法明确对立——它的论点正是「不要把判别信号外包给 post-hoc external reward model」,改为在预训练时把 behavior instruction 注入 decoder prefix + 后训练用可验证 reward,价值完全落在训练时。属于「同问题、反解法」,不满足「解法路径相近」。 - [2603.02999] OneRanker(Tencent):被本文显式引用(ref [28],仅在 intro 里作为 reranking-enhanced 方法一笔带过),且与 RGD 共享「打分头复用生成 backbone」的骨架;但其价值信号全部在训练时注入(value task token + eCPM BPR + DC 蒸馏),排序是同一模型解码的自然延伸而非解码步 logit 调制,无 test-time 控制器,故不入选叙事对比(结构化关系交由 DAG 处理)。 - [2605.24989] UTTSI(Alibaba):同样是 training-free / test-time 的控制器骨架,但任务是 CTR 预估的按难度分配特征探索路径,问题不是「似然与价值错配」,问题层不同构。 - [2604.22504] TAWin / [2606.08480] AdaGRPO / [2604.22169] ReCast:都在生成式推荐的 RL 对齐上做文章(AUC/OPAUC 等价性、样本级 GRPO 门控、组级可学习性修复),属训练时对齐路线,正是 RGD 要绕开的方向。 - [2605.25749] DeGRe(Zhejiang University):生成式重排,用离线 beam search 的 Lookahead Evaluator 挖掘高价值序列后蒸馏成 dense supervision,价值信号最终落到训练损失,线上只做单次贪心解码,不是 test-time controller。 - [2604.27747] PAD-Rec:同样修改 beam/解码过程,但目标是投机解码加速,与价值对齐无关。
10. 讨论与局限性¶
10.1 值得借鉴的设计¶
-
把启发式融合升格为闭式最优解。工业界「生成分 + 价值分加权」的做法非常普遍,但权重的语义往往说不清。RGD 提供了一条可复用的论证链:KL 约束 → Lagrangian → Boltzmann 闭式解 → 加法排序规则 → $\beta$ 即 KL 预算对偶变量。任何做「双信号融合」的系统都可以套用这个模板去解释自己的权重。
-
log-odds 变换解决量纲不一致。式 (15) 把有界概率 $\tilde{r}\in(0,1)$ 反 sigmoid 回无界 log-odds,从而与 $\log P$ 同空间——这是一个成本极低但常被忽略的细节,并且顺带给出了「reward = 正负反馈似然比、融合 = 贝叶斯后验更新」的解释。
-
stop-gradient + 冻结隐状态 = reference policy 的工程实现。理论上说「基座生成器是 reference policy」,实现上就是式 (12) 的 $\mathrm{sg}(\cdot)$ 与 $k=0$ 的隐状态冻结。这条对应关系很干净。
-
缓存置换一致性。reward 的因果历史缓存必须与生成器 KV cache 用同一置换索引重排——这是所有「在 beam search 里挂状态化辅助模块」的系统都会踩的坑,论文明确点出了。
-
pre/post/hybrid 的成本谱系,以及「第一层只有一个活跃 beam,所以 $l'=1$ 的 pre-merge 几乎免费但收益最大」这条洞察,是可以直接搬到其他生成式检索系统的工程经验。
10.2 局限与争议¶
-
理论新颖性有限。式 (8)/(9) 的 Boltzmann 形式是 KL 正则化 RL 的标准结论,在 RLHF、Controlled Decoding、FUDGE、GeDi 中早已使用(论文自己在 §2.2 与 §3.3 也承认了这一点)。RGD 的贡献更准确地说是把这一已知结论正确地移植进生成式推荐的 SID 解码,并配上工业级的 reward head 与注入策略,而非提出新的理论。
-
「无需重训生成器」是有条件的。reward model 与生成器是在同一批数据上联合训练的(式 16),共享 decoder 隐状态。这意味着 RGD 并不能直接外挂到一个已经冻结上线、不再训练的任意生成器上——你至少需要一次能读到生成器隐状态的联合训练。论文的「test-time controller」说法更准确的含义是「目标切换时不重训生成器」,而非「接入时不训练」。
-
对 tokenizer 的上游依赖未被讨论。RGD 只能在给定 SID 空间上重加权。如果 tokenizer 本身把高价值与低价值物品映射到了相邻甚至碰撞的 SID 路径(正是 UniVA 的 Commercial SID 要解决的问题),reward 在码级别就缺乏可分性,$R(j)$ 的表达力会被结构性地限制。论文没有分析这一失效模式。
-
公开数据上的 reward 是人造代理。Appendix C.1 明确说明:公开数据集无多行为日志,因此把 ground-truth next item 当作隐式点击正样本、batch 内其他物品当负样本。这基本上等价于用「一个从相同数据学出来的判别式打分器」去重排生成结果——表 1 的提升在多大程度上来自「真正的价值对齐」而非「一次隐式的模型集成/两阶段重排」,论文没有做区分性实验(例如:把 $R$ 换成一个随机初始化或纯流行度的打分头做对照)。
-
生成保真度的代价被部分掩盖。表 2 中除 LTR 外的所有单目标 RGD 变体,HitRate 与 MRR 都是负的。论文对此的解释(比 DPO/GRPO 掉得少)是成立的,但「reward 引导必然以牺牲生成保真度为代价」这一 trade-off 的边界在哪里、如何在生产中监控,论文没有给出方法。
-
线上收益偏小且只验证了单一目标。两周 A/B 的 CTR +0.392% 在快手体量下是有意义的,但相对表 2 里 CTR reward +3.23% 的离线提升有明显衰减。且线上只上了 CTR-guided 版本,多目标 LTR 引导(表 2 中唯一同时正向的配置)并未做线上验证——而多目标动态切换恰恰是论文宣称的最大卖点。这是实证链条上最明显的缺口。
-
可扩展性上的结构隐患。reward head 是一个挂在冻结的、第 $k=0$ 个 decoder block 隐状态上的 bottleneck MLP,其容量与生成器主干强耦合。当基座生成器 scaling 时,reward head 的表征能力能否同步增长、$k=0$ 这个经验选择是否仍然最优,论文未做 scaling 分析。表 3 显示用完整 Lite Decoder 做 reward model 反而更好(+0.27% CTR reward),选 Bottleneck MLP 纯粹是 QPS 妥协——这暗示 reward head 的容量目前已经是瓶颈,而非富余。
-
超参数 $\beta$ 的在线自适应缺失。图 3 显示性能对 $\beta$ 敏感(最优在 1.0 附近),但工业场景里不同流量、不同时段的最优 $\beta$ 未必一致。论文把 $\beta$ 当作固定超参,没有讨论按用户/场景/时段自适应的可能,而这恰恰是「可控解码框架」最自然的延伸。
10.3 工业落地价值¶
RGD 的落地价值主要不在单次 A/B 的绝对数字,而在迭代成本结构的改变:在一个已部署的生成式推荐服务(快手 OneLive)上,业务方想把优化目标从点击切到送礼、或调整多目标权重时,传统 RL 路线要重跑一遍 DPO/GRPO 训练并承担分布漂移风险(表 2 显示 DPO/GRPO 的 HitRate 分别掉 0.69%/0.40%),而 RGD 只需要换一个 reward head 或调整 $\alpha_m$。配合 hybrid 注入模式与 Bottleneck MLP 架构(QPS 1.28x、reward 仅降 0.27%),额外推理开销被压到可接受范围。对于目标频繁变化的工业推荐/广告系统,这条「把价值对齐从训练时移到解码时」的路线值得认真评估。