DaV-Gen:以"起草-验证"重构端到端生成式检索¶
Meng Zhao*、Chunmei Liu*、Qinyong Wang(通讯作者),HUJING Digital Media & Entertainment Group(阿里巴巴
@alibaba-inc.com),Arxiv 2607.08365,2026-07-09。*为共同一作。
研究动机与背景¶
大规模工业信息检索系统(搜索与推荐)长期以来建立在多级级联架构(Multi-Stage Cascade Architecture, MCA)之上:通过一条由粗到细的"检索-排序"(retrieve-and-rank)流水线,在效果与效率之间取得平衡(如 YoutubeDNN、DIN 时代的经典漏斗)。然而这条"先召回再排序"的流水线存在一个被本文称为目标不一致(objective inconsistency)的结构性缺陷:各阶段各自的优化目标(召回阶段追求高 recall 的最大内积搜索 MIP,排序阶段追求精细的 CTR/CVR 打分)之间彼此错配,早期阶段的漏检(early misses)是不可逆的——一个 item 一旦在召回阶段被丢弃,排序阶段再强也无法把它捞回来。这种误差传播(error propagation)从根本上限制了最终结果的质量上限(本文援引 Hron et al., 2021 关于两级推荐系统组件交互的分析)。
为统一这条流水线,近来的端到端模型(如 OneRec,Deng et al., 2025)把 item 表示为离散的语义 ID(Semantic ID, SID)(Rajput et al., 2023 的 TIGER),把检索建模成一个 sequence-to-sequence 的生成任务。这类生成式信息检索(Generative Information Retrieval, GenIR)虽有前景,却受制于其自回归(auto-regressive, AR)本性:AR 逐 token 解码带来了难以承受的推理延迟,且缺乏对推荐列表长度的确定性控制(beam search 生成的列表长度不可控)。
DaV-Gen 的立意,是要在"级联架构的高效率"与"生成式模型的统一表达力"之间架桥。作者从投机解码(speculative decoding)的过程中获得灵感,提出 Draft-and-Verify(起草-验证)机制:不再依赖缓慢的逐 token 生成,而是把任务重构成单一端到端可微架构内的两个协同操作——先高效"起草"候选、再用更强的融合打分函数"验证"候选。论文围绕三个核心设计问题展开(对应 Figure 1 的三个子图):
- 如何平衡表征效率与表达力?(Fig 1a)稀疏 token 便于生成但常丢失细粒度语义,稠密向量擅长检索却缺乏结构层次。DaV-Gen 用一个 Hybrid Sparse-Dense Representation(混合稀疏-稠密表示)融合 RQ-VAE 编码器的原始连续信号与上下文化的离散 SID,在不牺牲细粒度精度的前提下支持高召回向量起草。
- 如何在单一模型里对齐互相冲突的目标?(Fig 1b)解决 MCA 的目标不一致不止是共享参数,而是需要一个统一的优化 landscape。DaV-Gen 用一个 Collaborative Training Strategy(协同训练策略),让模型同时被对比判别与生成似然共同优化;关键是一个基于融合的 pairwise 目标充当桥梁,强制起草模块的语义空间与验证模块的排序偏好完全对齐,迫使两阶段互相强化而非互相矛盾。
- 如何打破生成式模型的延迟瓶颈?(Fig 1c)部署 GenIR 的首要障碍是 AR 解码的串行依赖。DaV-Gen 引入 Parallel Inference Pipeline(并行推理流水线),把候选获取与打分解耦:先用 ANN 搜索起草候选,再在一次前向中并行验证整批候选,把 AR 解码的 $O(L)$ 复杂度替换为 $O(1)$ 的并行打分,实现实时响应。
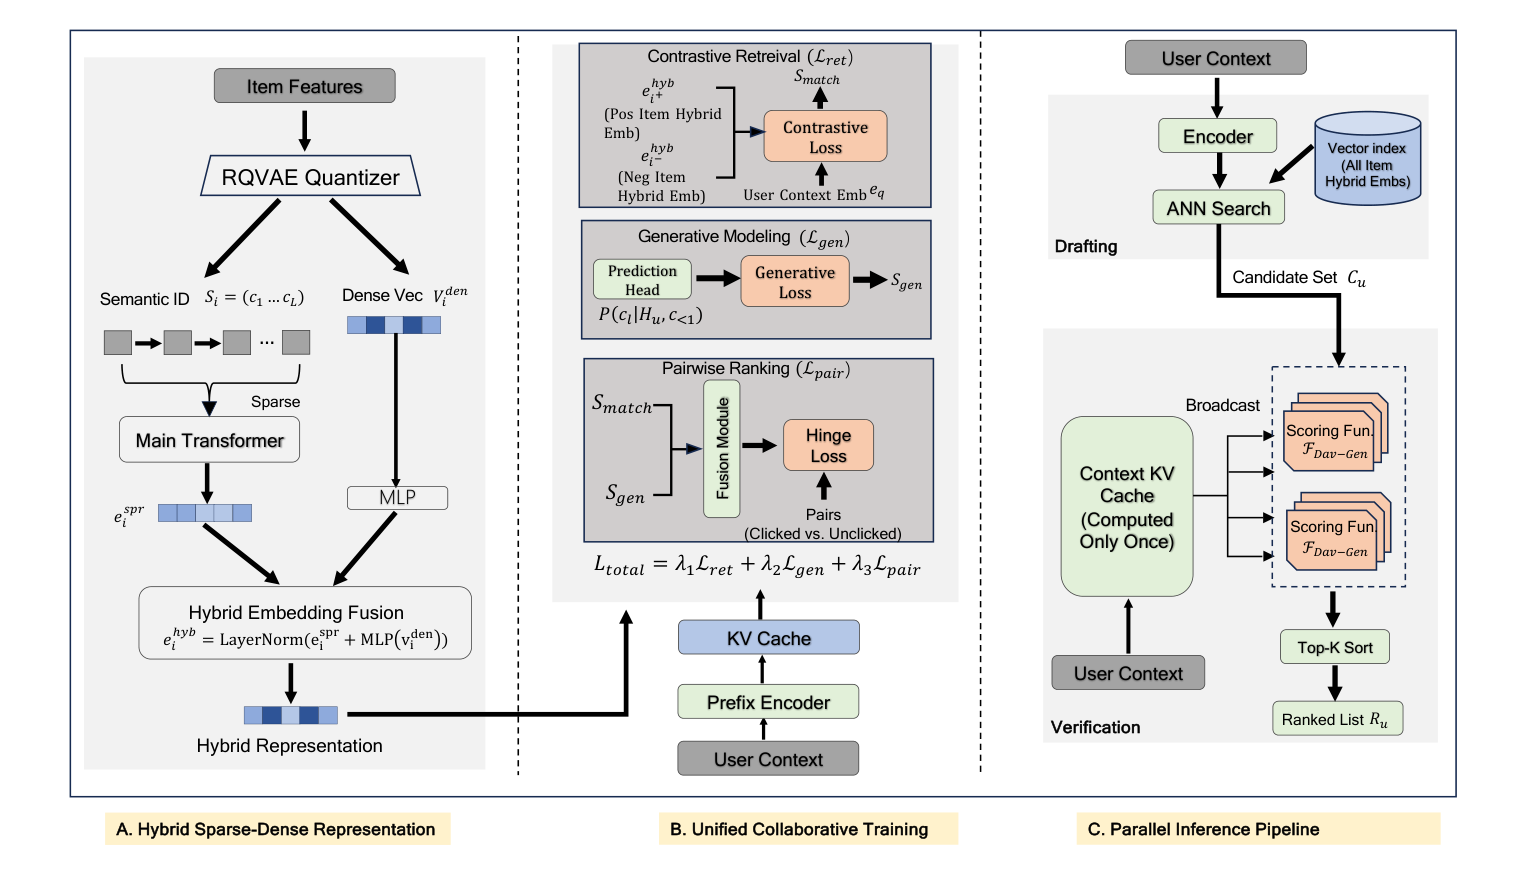
主要贡献(原文 §1 末):
- Draft-and-Verify 范式:把生成式检索从序列生成重构为并行验证,从根本上化解了 AR 模型的延迟瓶颈,达到工业级推理效率并显著超越传统级联系统,同时支持精确的列表长度控制。
- Hybrid Sparse-Dense Representation:融合 RQ-VAE 编码器的细粒度稠密向量与上下文化稀疏 SID 的新型 item 表示,弥合高效检索与精确语义理解之间的鸿沟,同时增强起草阶段的召回与验证阶段的精度。
- Unified Optimization Framework:由复合损失驱动的统一训练流水线,在同一向量空间内同时掌握粗粒度起草与细粒度验证,消除传统级联的目标不一致。
核心方法 / 模型架构¶
问题形式化(§2.1)¶
设 $\mathcal{U}$ 为用户集合、$\mathcal{I}$ 为语料中所有 item 的集合。搜索与推荐共享同一目标:基于用户上下文检索相关 item。定义综合用户上下文为 $\mathcal{C}_{ctx}$:
- 推荐中上下文是隐式的:$\mathcal{C}_{ctx}=H_u=(\mathcal{S}_u,\mathcal{P}_u)$,其中 $\mathcal{S}_u=(i_1,\dots,i_t)$ 是交互历史、$\mathcal{P}_u$ 是用户画像;
- 搜索中上下文是显式的:$\mathcal{C}_{ctx}=\{q,H_u\}$,主要由查询 $q$ 驱动并以历史 $H_u$ 增广。
为记号统一,全文用 $H_u$ 表示这个广义上下文。现代生成式推荐的基石是 Semantic ID:不再用单个原子标识符表示 item,而是先用其丰富内容特征刻画每个 item $i\in\mathcal{I}$;一个量化器 $\mathcal{Q}$(如预训练的 RQ-VAE)把这些特征映射为结构化的 SID $S_i=(c_1,c_2,\dots,c_L)$,其中每个 token $c_j$ 属于有限码本 $\mathcal{C}$。任务因此变成建模条件概率 $P(S_{i_{t+1}}|H_u)$,即给定上下文预测下一个相关 item $i_{t+1}$ 的 SID。
自回归推荐的瓶颈(§2.2)¶
以 TIGER 为代表的主流方法是纯自回归的:把用户交互序列 $\mathcal{S}_u=(i_1,\dots,i_T)$ 建模成一条严格的因果链,训练目标是最小化整条序列上累积的负对数似然:
$$\mathcal{L}_{\text{AR}}=-\sum_{t=1}^{T}\sum_{l=1}^{L}\log P\big(c_l^{(t)}\mid i_1,\dots,i_{t-1},c_{<l}^{(t)}\big) \tag{1}$$
其中 $c_l^{(t)}$ 是第 $t$ 步 item $i_t$ 的第 $l$ 个 token,条件 $i_1,\dots,i_{t-1}$ 显式地把依赖强加到整个前序序列上。这一形式强制逐 item 顺序解码:第 $t$ 步的预测严格等待第 $t-1$ 步完成——这正是高推理延迟的根源。
DaV-Gen 训练流程(§2.3)¶
整个训练是一条为"打造端到端模型"设计的综合流水线,包含渐进式知识注入、混合表示构造与复合损失监督微调。
渐进式知识注入(Progressive Knowledge Injection)¶
用预训练语言模型(PLM)做生成式检索的首要挑战是语义 gap:PLM 的开放世界知识 vs 领域特定的 item 表示(SID)。由于组成 SID 的离散 token 是随机初始化的,直接优化整个模型会导致 PLM 语言能力的灾难性遗忘。作者用一个渐进式策略把 item 知识稳步注入 backbone,任务是一个自监督重构任务——双向地互预测 item 的文本属性与其 SID:
- Embedding Alignment(嵌入对齐)。初始阶段只对齐新引入的 SID token 与 PLM 已有的语义空间。冻结 transformer backbone 的全部参数,只让新 token 的 embedding 矩阵可训练。把 item 的文本描述投影进模型潜空间、优化对应 SID 的 embedding 以匹配这些表示,从而建立一个粗粒度对齐。这个热身过程确保 SID token 在不破坏 base 模型精心预训练权重的前提下获得有意义的向量表示。
- Deep Semantic Integration(深度语义融合)。一旦 token embedding 初步对齐并稳定,进入第二阶段:解冻全部模型参数做全参数微调。这一阶段让模型学到 item 层次结构(由 SID 序列捕获)与其语义内容之间复杂的非线性交互,把特定 item 知识与通用世界知识深度融合,有效地把 PLM 从通用文本生成器转变为领域专家推荐器。
混合稀疏-稠密 item 表示(Hybrid Sparse-Dense Item Representation)¶
灵感来自 COBRA 框架(Yang et al., 2025,"Sparse meets dense"),后者用稀疏与稠密信号的互相强化;但与 COBRA 把二者建模成逐步自回归生成的交替序列不同,DaV-Gen 把二者融合成单一统一向量。这个设计选择对"Draft-and-Verify"范式至关重要:它把 item 的多模语义压缩进一个定长 embedding,与最大内积搜索(MIPS)兼容,从而支持 COBRA 那种序列化架构无法直接支持的高速起草。
具体地,混合 embedding $e_i^{\text{hyb}}$ 由两部分构成:
- Dense Content Vector($v_i^{\text{den}}$):直接取自 RQ-VAE 编码器量化之前的输出,保留常在 tokenization 中丢失的细粒度、非离散的语义特征(如具体文本描述)。
- Sparse Structural Vector($e_i^{\text{spr}}$):为捕获 SID $S_i$ 的层次类目信息,把 token 序列喂进 backbone,对最终隐状态做 mean-pooling 得到 $e_i^{\text{spr}}$。
两者经一个投影层融合,形成最终 item anchor:
$$e_i^{\text{hyb}}=\text{LayerNorm}\big(e_i^{\text{spr}}+\text{MLP}(v_i^{\text{den}})\big) \tag{2}$$
其中 MLP 对齐维度。这个表示既作为起草阶段的可索引向量,又作为验证阶段的语义 anchor——一份表示服务两个阶段,这是统一架构的物理基础。
监督微调(SFT)优化策略:复合损失¶
SFT 阶段用一个复合损失优化模型,是三个关键分量的加权和:
$$\mathcal{L}_{\text{total}}=\lambda_1\mathcal{L}_{\text{ret}}+\lambda_2\mathcal{L}_{\text{gen}}+\lambda_3\mathcal{L}_{\text{pair}} \tag{3}$$
其中 $\lambda_1,\lambda_2,\lambda_3$ 为超参。这个复合目标赋予模型三项本质能力:$\mathcal{L}_{\text{ret}}$ 教模型产出有效的起草 embedding;$\mathcal{L}_{\text{gen}}$ 赋予对 item 序列的深度上下文理解;$\mathcal{L}_{\text{pair}}$ 直接优化最终的验证能力。下面逐一展开。
三个损失分量(§2.3)¶
(1) Contrastive Drafting Loss($\mathcal{L}_{\text{ret}}$)——起草的基石¶
该损失用于构造 embedding 空间,以实现高效起草与准确候选生成。在训练 batch $\mathcal{B}$ 上计算。对每个用户上下文 $H_u$,定义候选集 $\mathcal{C}_u=\{i^+\}\cup\{i_k^-\}$ 为正样本 item $i^+$ 与 batch 内负样本的并集。对比损失是 batch 上的平均:
$$\mathcal{L}_{\text{ret}}=-\frac{1}{|\mathcal{B}|}\sum_{u\in\mathcal{B}}\log\frac{\exp\big(\text{sim}(e_q,e_{i^+}^{\text{hyb}})/\tau\big)}{\sum_{k\in\mathcal{C}_u}\exp\big(\text{sim}(e_q,e_k^{\text{hyb}})/\tau\big)} \tag{4}$$
其中 $e_q$ 是从 $H_u$ 导出的用户 embedding,$e_k^{\text{hyb}}$ 是 item $k$ 的混合 embedding,$\text{sim}(\cdot,\cdot)$ 是余弦相似度,$\tau$ 是控制分布锐度的温度超参。
该损失显式地教模型"语义相关性"的概念:奖励用户表示靠近其正样本 item、惩罚它靠近大量负样本,把高维 embedding 空间组织成有意义的语义簇。其优越性有二:其一,它产出的 embedding 直接为 MIPS 优化,这是让 ANN 检索库(如 FAISS)能被用于初始起草阶段的关键属性,直接规避纯生成式方法的高延迟;其二,从多样负样本中学习让模型获得对 item 间关系的鲁棒理解,提升泛化与推荐新颖但相关 item 的能力,从而提升传给后续验证阶段的候选质量。
(2) Generative Loss($\mathcal{L}_{\text{gen}}$)——细粒度验证信号¶
该损失用一个生成任务捕获对 item 的深度上下文理解。与标准 AR 推荐器建模 item 间依赖不同,本方法独立地处理每个候选 item,但显式保留每个 item 的 SID $(c_1,\dots,c_L)$ 内部的 AR 依赖,以捕获其内部层次结构。目标定义为整个 batch 上的平均负对数似然:
$$\mathcal{L}_{\text{gen}}=-\frac{1}{|\mathcal{B}|}\sum_{(H_u,i)\in\mathcal{B}}\sum_{l=1}^{L}\log P\big(c_l\mid H_u,c_{<l}\big) \tag{5}$$
其中 $P(c_l\mid H_u,c_{<l})$ 是 item $i$ 第 $l$ 个 token 的预测概率,条件于用户历史 $H_u$ 与同一 item 的前序 token $c_{<l}$。
这个设计提取的验证信号正交于简单向量相似度。对比损失回答"哪些 item 语义相似?",生成损失回答"这个具体 item 在这个用户上下文里有多合理?"——它迫使模型超越几何邻近,学习一个 item(由其 RQ-VAE token 编码)的细粒度组合语义以及它如何契合用户动态偏好。由此得到的负对数似然是一个强大而精确的生成式分数,当与匹配分数融合时能支撑更成熟准确的最终验证决策。
Broadcasted Prefix Caching(广播式前缀缓存)。为在大批候选上高效计算该损失,作者引入广播式前缀缓存机制。朴素实现需要把长上下文 $H_u$ 与每个候选 item 拼接,导致上下文被重复编码 $N$ 次的冗余计算。取而代之,只对 $H_u$ 计算一次 Key-Value(KV)状态,并把它广播成所有候选共享的内存前缀;模型再通过 attend 这个预计算缓存来计算 item token 的似然,把上下文编码复杂度从 $O(N\cdot|H_u|)$ 降到 $O(|H_u|)$。这是并行验证得以低延迟的关键工程。
(3) Pairwise Ranking Loss($\mathcal{L}_{\text{pair}}$)——对齐两阶段的桥梁¶
该损失用一个融合分数与显式用户反馈直接优化最终验证能力。首先,对候选 item $i$ 定义最终分数 $\sigma(i)$ 为一个融合网络 $f_{\text{fusion}}$ 的输出,它接收两个输入:匹配分数 $s_{\text{match}}$ 与生成分数 $s_{\text{gen}}$:
$$\sigma(i)=f_{\text{fusion}}\big(s_{\text{match}}(i),s_{\text{gen}}(i)\big) \tag{6}$$
其中 $s_{\text{match}}(i)=\text{sim}(e_q,e_i^{\text{hyb}})$,$s_{\text{gen}}(i)$ 由 item 的生成损失导出。融合网络让模型学到这两个信号最优的非线性组合。随后用一个 pairwise hinge loss 在从 batch 构造的成对样本上训练该分数。构造两组样本:
- Hard 样本 $\mathcal{S}_{\text{hard}}$:来自同一 session 的"被点击 item $i$"与"未点击 item $j$"配对;
- Calibration 样本 $\mathcal{S}_{\text{rand}}$:曝光 item $i$ 与随机采样的负 item $k$ 配对。
目标是让偏好 item 的分数比非偏好 item 的分数至少高一个 margin $m$:
$$\mathcal{L}_{\text{pair}}=\frac{1}{|\mathcal{S}_{\text{hard}}|}\sum_{(i,j)\in\mathcal{S}_{\text{hard}}}\big[\max(0,\sigma(j)-\sigma(i)+m)\big]+\frac{1}{|\mathcal{S}_{\text{rand}}|}\sum_{(i,k)\in\mathcal{S}_{\text{rand}}}\big[\max(0,\sigma(k)-\sigma(i)+m)\big] \tag{7}$$
用两类样本的动机:第一类(clicked vs unclicked)提供 hard 负样本,教模型在"都相关到足以展示给用户"的 item 之间做细粒度区分,直接为 engagement 优化;第二类(exposed vs random)提供关键的全局校准,教模型"任何相关到值得曝光的 item 都应比语料中随机 item 得分更高",确保一个合理的打分基线、提升验证函数整体鲁棒性。这个 pairwise 融合目标正是把起草模块的语义空间与验证模块的排序偏好对齐的"桥梁"——它让 $s_{\text{match}}$(起草信号)和 $s_{\text{gen}}$(验证信号)在同一个可比分数尺度上被联合优化。
并行化生成式推理(§2.4)¶
综合训练带来一个高效的两阶段推理架构,非常适合在线服务。
Stage 1:候选起草(Candidate Drafting)¶
推理从一个快速起草步骤开始。给定用户上下文 $H_u$,框架先计算对应的 query/context embedding $e_q$。设 $\mathcal{E}_{\mathcal{I}}=\{e_i^{\text{hyb}}\mid i\in\mathcal{I}\}$ 为语料中所有 item 的预计算混合 embedding 集合,存于高效向量索引中。起草阶段用一次 ANN 搜索产出大小为 $N$ 的候选集 $\mathcal{C}_u$:
$$\mathcal{C}_u=\text{ANN}(e_q,\mathcal{E}_{\mathcal{I}},N) \tag{8}$$
其中 $\text{ANN}(\cdot)$ 是快速向量搜索。这一步非生成式,几乎瞬时返回定长候选列表。
Stage 2:并行验证(Parallel Verification)¶
从 $\mathcal{C}_u$ 检索到的 $N$ 个候选被传入训练好的 DaV-Gen 模型打分。为保证低延迟,利用训练阶段引入的 Broadcasted Prefix Caching:只计算一次上下文 KV 缓存并广播它来初始化所有 $N$ 个候选的注意力状态;模型在一次并行前向中处理全部 $N$ 个候选的 token。设 $\mathcal{F}_{\text{DaV-Gen}}$ 为学到的打分函数,对每个候选 $i\in\mathcal{C}_u$ 计算:
$$\text{score}(i)=\mathcal{F}_{\text{DaV-Gen}}\big(i\mid\text{Cache}(H_u)\big)\quad\forall i\in\mathcal{C}_u \tag{9}$$
候选按此分数降序排列成 $\mathcal{L}_u$。该设计把上下文长度与候选集大小解耦,使推理延迟只随被验证 item 数缓慢增长。最终推荐列表 $\mathcal{R}_u$ 取 $\mathcal{L}_u$ 的 top-K:
$$\mathcal{R}_u=\text{Top-K}(\mathcal{L}_u) \tag{10}$$
这个架构直接化解了此前方法的困难:用"快速起草 + 并行验证"替换串行生成,规避了 AR 高延迟瓶颈;由于 $N$(起草)和 $K$(展示)都是固定参数,它提供了对结果列表长度精确、确定性的控制;又因为同一个统一模型同时训练起草与验证,经典级联系统的目标不一致被消除。
实验设置(§3.1)¶
评估围绕四个研究问题:RQ1(模型精度)是否在通用 benchmark 上超越 SOTA?RQ2(工业可扩展性)能否有效处理大规模工业场景?RQ3(在线业务价值)在生产环境是否带来真实业务提升?RQ4(消融)各创新组件各自贡献如何?
数据集:三个公开推荐 benchmark——Amazon Beauty、Amazon Sports、Yelp;外加一个大规模工业数据集 Ind-Search(Industrial Search),来自一个领先视频搜索引擎,含 100M+ item 与 500M 搜索日志。全部采用 leave-one-out 评估。
Baselines:
- 判别式模型:SASRec(Kang & McAuley, 2018)、BERT4Rec(Sun et al., 2019)、HGN(Ma et al., 2019),以及工业强 baseline MoE(一个在线服务的、基于 Mixture-of-Experts 的 CTR 预测 DNN)。
- 生成式与检索模型:TIGER(Rajput et al., 2023)、LC-Rec(Wang et al., 2024)、OneRec(Deng et al., 2025),以及 SOTA 稠密检索器 gte-qwen-7b(微调)。
实现细节:为公平比较,所有模型 embedding 维度设为 64;生成式模型(TIGER、OneRec、DaV-Gen)用 5 层层次量化码本;DaV-Gen 用 Adam 优化器、学习率 $1e{-}5$、batch size 256 训练。
主要实验结果¶
RQ1:公开数据集性能对比¶
Table 1 报告三个公开数据集上的表现。指标为 Recall@10 与 NDCG@10(生成式序列推荐的标准指标,值越大越好)。
| Method | Beauty R@10 | Beauty N@10 | Sports R@10 | Sports N@10 | Yelp R@10 | Yelp N@10 |
|---|---|---|---|---|---|---|
| SASRec | 0.0624 | 0.0385 | 0.0482 | 0.0295 | 0.0681 | 0.0412 |
| BERT4Rec | 0.0638 | 0.0392 | 0.0495 | 0.0301 | 0.0695 | 0.0425 |
| HGN | 0.0705 | 0.0441 | 0.0571 | 0.0358 | 0.0738 | 0.0462 |
| TIGER | 0.0698 | 0.0435 | 0.0552 | 0.0348 | 0.0725 | 0.0455 |
| LC-Rec | 0.0715 | 0.0452 | 0.0568 | 0.0355 | 0.0742 | 0.0468 |
| OneRec | 0.0732 | 0.0465 | 0.0588 | 0.0370 | 0.0765 | 0.0481 |
| DaV-Gen (Ours) | 0.0752 | 0.0481 | 0.0605 | 0.0382 | 0.0784 | 0.0495 |
| Improv. | +2.73% | +3.44% | +2.89% | +3.24% | +2.48% | +2.91% |
(加粗为最优,Improv. 相对最强 baseline OneRec 计算。)
分析:(1) 生成式 > 判别式:TIGER/LC-Rec/OneRec 总体优于 SASRec/BERT4Rec,说明直接建模 SID 的生成概率能更有效地捕获协同信号。(2) 对比统一框架:OneRec 显著优于 TIGER,验证了端到端训练模型的有效性;但 DaV-Gen 进一步超越 OneRec——OneRec 依赖 AR 解码,DaV-Gen 用"Draft-and-Verify"机制全局地给候选打分(而非逐 token 局部贪心),带来更鲁棒的验证性能,从而在三个数据集上 R@10 提升 +2.48%~+2.89%、N@10 提升 +2.91%~+3.44%。
RQ2:工业搜索评估(Ind-Search)¶
在 Ind-Search 上对两个强生产 baseline 评估:微调稠密检索器 gte-qwen-7b 与在线排序模型 MoE。报告 Recall@50、NDCG@10、MRR@10(Figure 2;排序指标 ×100 便于可视化)。
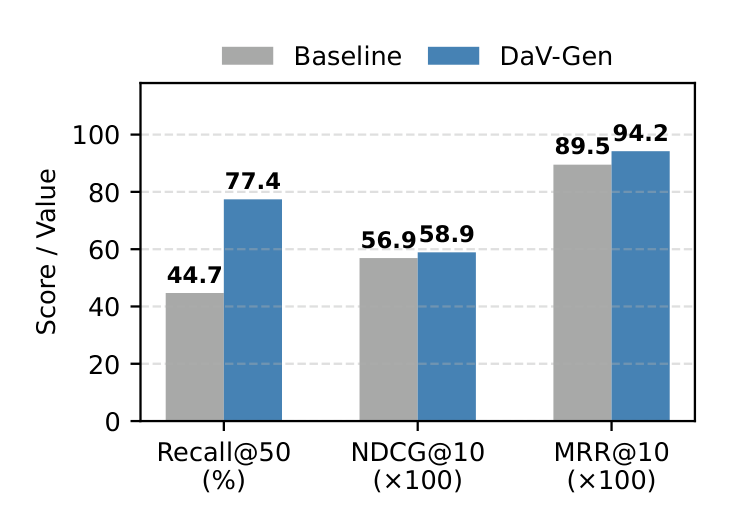
| 指标 | Baseline | DaV-Gen |
|---|---|---|
| Recall@50 (%) | 44.7 | 77.4 |
| NDCG@10 (×100) | 56.9 | 58.9 |
| MRR@10 (×100) | 89.5 | 94.2 |
分析:召回(Recall@50)方面 DaV-Gen 达到压倒性的 77.4%,比稠密检索 baseline(44.7%)高出 30+ 绝对百分点,证实混合稀疏-稠密表示有效捕获了纯稠密向量会漏掉的视频搜索查询复杂语义。排序(NDCG & MRR)方面 DaV-Gen 一致超越判别式 MoE baseline:NDCG@10 从 0.569 提升到 0.589,MRR@10 从 0.895 提升到 0.942——高 MRR 说明 DaV-Gen 特别擅长把最佳结果排到最前,这对优化用户搜索体验至关重要。
RQ3:在线 A/B 测试¶
在一个领先视频提供商的生产环境部署 DaV-Gen 服务真实搜索流量,实验涉及数百万用户、持续一周。关注三个核心业务指标:
- Avg. Time Spent per User (ATS):曝光用户上的人均总停留时长($\text{ATS}=\frac{\sum\text{Time Spent}}{\text{Exposed UV}}$),衡量用户粘性的主指标。
- User Conversion Rate (UCVR):至少发生一次视频播放的用户占曝光用户之比($\text{UCVR}=\frac{\text{Play UV}}{\text{Exposed UV}}$),反映信息流把曝光转化为消费的能力。
- Avg. Successful Searches (ASS):至少一次点击的搜索 query 数除以曝光用户($\text{ASS}=\frac{\text{Hit Search Volume}}{\text{Exposed UV}}$),衡量 session 内满足用户意图的效率。
| Metric | Improvement | Significance |
|---|---|---|
| Avg. Time Spent per User | +2.09% | $p<0.05$ |
| User Conversion Rate | +0.47% | $p<0.05$ |
| Avg. Successful Searches | +0.31% | $p<0.05$ |
分析:相对高度优化的生产 baseline,DaV-Gen 在 ATS 上取得 +2.09% 的提升,说明其细粒度验证机制通过确保最吸引人的内容被优先,显著增强用户粘性;UCVR(+0.47%)与 ASS(+0.31%)的一致增益表明模型在捕获用户意图、促进内容发现方面能力更强。全部指标 $p<0.05$ 显著。
Latency Analysis(延迟分析)¶
在线服务效率至关重要,作者显式对比三种范式的推理延迟:
- 纯生成式模型(如 TIGER):因逐 item token-by-token 解码,延迟高达 ≈3s,对实时服务不切实际;
- 传统级联结构:当前生产 baseline 采用复杂漏斗(Query Processing → Recall → Pre-Ranking → Ranking),累积延迟 ≈130ms;
- DaV-Gen(本文):通过统一"Draft-and-Verify"策略与并行打分,把延迟降到 ≈70ms——相比传统级联 2.5× 加速,相比纯生成式方法快数个数量级,充分证明其对高并发工业环境的优越适配性。
RQ4:消融研究(Ablation Study)¶
为验证设计鲁棒性,在 Amazon Beauty 与 Amazon Sports 上做消融(Table 3),评估四个变体:
- w/o Hybrid Rep.:移除稠密语义向量,只靠稀疏 SID 匹配;
- w/o Prog. Inject.:跳过渐进式知识注入的 Embedding Alignment,直接进入全参数 Deep Semantic Integration;
- w/o Gen. Loss($\mathcal{L}_{\text{gen}}$):移除 token 级生成目标,只用对比损失与 pairwise 损失训练;
- w/o Fusion Loss($\mathcal{L}_{\text{pair}}$):移除基于融合的 pairwise 排序目标,推理时只靠对比分数与生成分数之和。
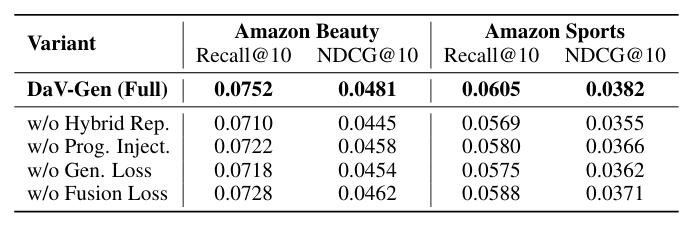
| Variant | Beauty R@10 | Beauty N@10 | Sports R@10 | Sports N@10 |
|---|---|---|---|---|
| DaV-Gen (Full) | 0.0752 | 0.0481 | 0.0605 | 0.0382 |
| w/o Hybrid Rep. | 0.0710 | 0.0445 | 0.0569 | 0.0355 |
| w/o Prog. Inject. | 0.0722 | 0.0458 | 0.0580 | 0.0366 |
| w/o Gen. Loss | 0.0718 | 0.0454 | 0.0575 | 0.0362 |
| w/o Fusion Loss | 0.0728 | 0.0462 | 0.0588 | 0.0371 |
逐项分析:
- 移除稠密向量(w/o Hybrid Rep.)导致最大跌幅(如 Beauty R@10 −5.6%)。验证了单靠稀疏语义 token 不足,与稠密 embedding 结合才能显著丰富模型表达力与起草覆盖。这是四个组件中贡献最大的。
- 跳过对齐阶段(w/o Prog. Inject.)显著下降。说明 PLM 与 SID 之间的"语义 gap"需要一个渐进桥梁;缺了初始 embedding 对齐把 ID token 映射进 PLM 潜空间,后续全参数微调难以收敛到最优。
- 移除 $\mathcal{L}_{\text{gen}}$ 明显退化。证明 token 级生成目标不只是辅助——它迫使模型学习对比学习无法捕获的细粒度顺序依赖与 item 内语义。
- 移除 Fusion Loss($\mathcal{L}_{\text{pair}}$)在 NDCG 上一致下降。协同匹配-生成的融合确保生成目标与验证指标对齐;缺了它,最终验证排序被削弱,确认其精化最终验证顺序的作用。
与已归档相关工作的对比¶
DaV-Gen 与文档库中三篇工作在"生成式检索里如何摆脱 SID 序列级评分/AR 解码"这一 root cause 上高度同构,但解法路径各异。以下逐一对比。
PAD-Rec PAD-Rec: Position-Aware Drafting for Generative Recommendation(中国科学技术大学,2026-04-30)¶
关系:独立并发(本文未引用 PAD-Rec,两者殊途同归;且 DaV-Gen 与 PAD-Rec 都自称受 speculative decoding 启发)· 已加载对方精读
- 共同关注的问题:两篇都把矛头对准同一个 root cause——SID 生成式推荐/检索中自回归逐 token 解码的推理延迟。PAD-Rec 明确指出 1B 模型生成 top-10 列表约需 59 个解码步、耗时 ~700ms,无法满足实时;DaV-Gen 报告纯生成式(TIGER)延迟 ≈3s。两者都从 speculative decoding 的"起草-验证"过程中取经。
- 相近的技术骨架:都区分"快速起草"与"验证/校验"两个阶段,都想用一个便宜的提议器压缩延迟。
- 本文的差异与推进:这是最关键的分岔——PAD-Rec 保留 AR 生成,只是用一个 slot-/step-position-aware 的 draft 模型把 speculative decoding 加速(最高 3.1× wall-clock),target 模型仍逐块 AR 校验、接受最长前缀;DaV-Gen 则彻底抛弃 AR 生成,把起草改为非生成式的 ANN 向量检索、把验证改为一次并行前向的融合打分($O(L)\to O(1)$)。换言之,PAD-Rec 是"让 AR 更快",DaV-Gen 是"用检索+并行打分替代 AR"。
- 可比的方法/实验差异:PAD-Rec 是无损加速(几乎不改推荐质量),其 draft 模块仅 ~0.01% 参数、对框架零侵入;DaV-Gen 是重构范式(端到端重训 + 混合稀疏-稠密表示 + 复合损失),既提速又声称提精度(对 OneRec +2.7%~+3.4%)。PAD-Rec 报 wall-clock speedup,DaV-Gen 报绝对延迟(≈70ms)与在线 A/B(ATS +2.09%)。
Gryphon Gryphon: 统一 SID 生成与 item 级打分(Yandex,2026-06-07)¶
关系:独立并发(本文未引用 Gryphon,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都直指"beam/SID 序列级似然评分"与"推荐质量在具体 item 粒度上被评估"之间的结构性错配。Gryphon 称之为 sequence likelihood miscalibration + SID collisions;DaV-Gen 称之为 objective inconsistency + AR 的确定性控制缺失。root cause 同构:AR/beam 的 token 乘积不是对具体 item 的良定义排序信号。
- 相近的技术骨架:近乎同构——都在一个统一的 encoder-decoder/统一模型内,先让生成组件产出候选 SID 集合(仅决定成员资格),再用一个共享用户表示的专用打分模块对解析出的具体 item 重新打分,有意把最终 item 选择与失准的 beam likelihood 解耦。Gryphon 的 ILSM(item-to-user cross-attention + MLP,复用共享 encoder 状态 $E_u$)与 DaV-Gen 的 Verification(融合 $s_{\text{match}}+s_{\text{gen}}$ 的打分函数,复用广播 KV cache)在角色上一一对应。
- 本文的差异与推进:(1) 起草来源不同:Gryphon 仍用 decoder beam search 生成 SID 候选(AR 未被消除,只是不用其分数),DaV-Gen 把起草换成非生成式 ANN 向量检索,从而真正砍掉 AR 延迟;(2) 表示不同:DaV-Gen 引入混合稀疏-稠密 anchor 让候选可直接 MIPS 检索,Gryphon 走标准 SID + item tower 特征;(3) 打分信号:Gryphon 用 next-item prediction(sampled softmax + LogQ 校正)实例化 ILSM,DaV-Gen 用"对比匹配分 + 生成似然分"经融合网络 + pairwise hinge。
- 可比的方法/实验差异:Gryphon 在工业音乐服务上把 item-level Recall@1000 提升 +3.7%(over vanilla GR),并以单一候选源替换 15+ 生成器 + 预排序阶段;DaV-Gen 在视频搜索上 Recall@50 达 77.4%(vs 稠密 44.7%)、在线 ATS +2.09%。两者都强调"解耦 beam likelihood"是收益来源,属于同一 insight 的两种独立实现。
OneRec OneRec(Kuaishou,2025-06-16)¶
关系:显式引用,本文 Table 1 已作为最强 baseline 直接对比(+DAG edge)· 未加载对方精读
本文报告:在 Amazon Beauty/Sports/Yelp 上 DaV-Gen 全面超越 OneRec(R@10 +2.48%~+2.89%,N@10 +2.91%~+3.44%)。核心机制差异:OneRec 是 encoder-decoder AR 生成、逐 token 局部贪心解码统一 retrieve-and-rank;DaV-Gen 用非生成式 ANN 起草 + 并行融合验证做全局候选打分,既提精度又把延迟从 AR 的秒级降到 ≈70ms。详细精读见 OneRec。
讨论与局限性¶
核心贡献与值得借鉴的设计:
- "用检索替代生成、用并行打分替代 AR 校验"的范式转换是本文最有价值的 insight。它把 speculative decoding 的"起草-验证"直觉从"加速 AR"(PAD-Rec 路线)推进到"消灭 AR",在工业延迟约束下(130ms→70ms)给出了一条比纯 GenIR(3s)现实得多的落地路径,同时保留了生成式模型的语义表达力。
- 混合稀疏-稠密 anchor(式 2)一份表示服务两阶段是架构简洁性的关键:同一个 $e_i^{\text{hyb}}$ 既作为 ANN 可索引向量(起草),又作为验证语义 anchor。它区别于 COBRA 把稀疏/稠密建成交替 AR 序列——正因融合成定长向量才 MIPS-兼容。
- Broadcasted Prefix Caching($O(N|H_u|)\to O(|H_u|)$)是让"一次前向并行验证 N 个候选"真正低延迟的工程支点,值得在任何"共享长上下文 + 大批候选打分"的系统里复用。
- pairwise 融合桥梁(式 6-7)用 hard(clicked vs unclicked)+ calibration(exposed vs random)两类样本对齐起草与验证的分数尺度,是解决级联"目标不一致"的具体抓手,比单纯共享参数更进一步。
局限与争议:
- 实验完整性偏弱。三个公开数据集只报了 R@10/N@10 两个 @10 指标,未给 @5/@20 或 HR,也未提供 baseline 的延迟数值对照表(延迟分析只给了三个范式的粗略量级 ≈3s/≈130ms/≈70ms,无逐 baseline 明细);消融只在两个数据集上做。
- 超参 $\lambda_1,\lambda_2,\lambda_3$、margin $m$、温度 $\tau$、码本层数 vs 论文正文 5 层的取值均未给出敏感性分析,复现性打折。
- 起草-验证的召回天花板问题未讨论:DaV-Gen 用 ANN 起草 top-N,若正样本 item 的混合 embedding 未落入 top-N,验证阶段再强也无法挽回——这本质上是它自己批评的级联"early miss error propagation"的一种温和再现(只是从多级压缩到两级)。论文未量化 N 对召回上界的影响。
- 与最直接对手 COBRA 无实验对比:正文明确说灵感来自 COBRA 且方法上与之对照(融合 vs 交替序列),但 Table 1 的 baseline 里没有 COBRA,缺一个关键的头对头。
- 篇幅短(8 页)、无代码链接、机构信息有限(HUJING 数字媒体娱乐集团,阿里系),工业细节(索引规模、QPS、GPU 成本)披露不足。
工业落地价值:论文的工业信号是扎实的——真实视频搜索场景、100M+ item / 500M 日志的 Ind-Search、数百万用户一周的在线 A/B(ATS +2.09%、UCVR +0.47%、ASS +0.31%,均 $p<0.05$)、以及 2.5× 于生产级联的端到端提速(≈70ms)。对任何面临"生成式检索想上线但 AR 延迟扛不住"的团队,Draft-and-Verify + 广播前缀缓存是一套可直接借鉴的低延迟工程范式。
与已有工作的差异小结:相比 OneRec(AR 统一 retrieve-and-rank)、PAD-Rec(加速 AR 的 speculative decoding)、Gryphon(beam 起草 + item 级重打分),DaV-Gen 的独到之处在于把起草彻底非生成化(ANN 检索)并把验证彻底并行化(一次前向 + 广播 KV),是这条"解耦 SID 序列似然"主线里最激进地追求工业延迟的一支。