SA-RSQ: A Versatile Sparse Representation Framework for Multi-modal Recommender Systems¶
Xiang Wang(天津大学), Shigang Quan, Tingzhen Chang, Kang Yang, Sitong Chen*, Yabo Fan, Xingxing Wang(美团), Zhaodian He(中科院软件所)· arXiv:2608.22979v1(2026-08-24)· 代码:https://github.com/WishArdently/SA-RSQ
一、研究动机与背景¶
1.1 多模态表征的"存储—保真"死结¶
现代推荐系统正在大规模引入 MLLM 抽取的高维语义特征(论文中是 Qwen3-VL 给出的 2048 维向量),用于增强语义表达能力、特别是缓解冷启动。但在服务数亿量级 item 的工业系统里直接落盘稠密向量是不可行的:2048 维 Float16 就是 4096 字节/item,论文 Table 1 里这一行的下游实验结果直接标为 OOM——不是效果差,是根本跑不起来。
主流的缓解手段是 RQ-VAE 系的级联硬量化:把特征压成超短的离散 Semantic ID(典型 8 字节)。论文指出这条路的代价是不可逆的语义失真,并把病灶拆成四条:
- 边界失真(boundary distortion):$\arg\min$ 是 winner-take-all 的,语义相近的两个 item(论文原文的例子是 "iPhone 15" 与 "iPhone 15 Pro")要么被迫共享同一个离散 ID(item collision),要么因为恰好落在码字边界两侧而拿到完全不同的 ID。连续距离结构被抹平,而细粒度相似度判别恰恰是推荐最依赖的东西。
- 加深残差层收益递减:想靠堆 stage 补偿失真,后续 stage 引入的量化噪声会超过它带来的有效信号,最终走向语义坍塌。
- STE 的有偏梯度:硬赋值不可导,必须靠直通估计器(Straight-Through Estimator)近似。STE 的固有偏差既破坏训练稳定性,也堵死了表征学习与下游目标的真端到端对齐。后果是 SID 一旦生成就被冻结:量化模型优化重建目标,下游推荐器优化 CTR/CVR 目标,两个目标从结构上就是错配的。
- 离散 ID 之间的距离不可度量:符号空间里无法计算有意义的语义相似度。
另一条路是软量化(如 SoftVQ-VAE):用软赋值分布乘码本得到低维稠密 embedding,绕开 STE。但论文指出它在推荐的存储约束下会翻车——32 字节在 Float16 下最多只能存 16 维,把 2048 维 MLLM 向量压进这么窄的瓶颈,编码器承受的拟合压力极大,同样导致语义坍塌;而单纯加维度就是等比例涨存储。
作者把这个结构性缺口概括为一句话:在"极端压缩(信息严重损失)"与"高维稠密(存储不可承受)"之间缺失中间地带,且没有一个有原则的机制在两端之间平滑权衡。
1.2 核心洞察:打断"存储占用 ↔ 表征维度"的强耦合¶
SA-RSQ(Sparse Activation-based Residual Soft Quantization)的核心 insight 是:存的东西不必是重建结果本身,而可以是"如何重建"的路由指令。
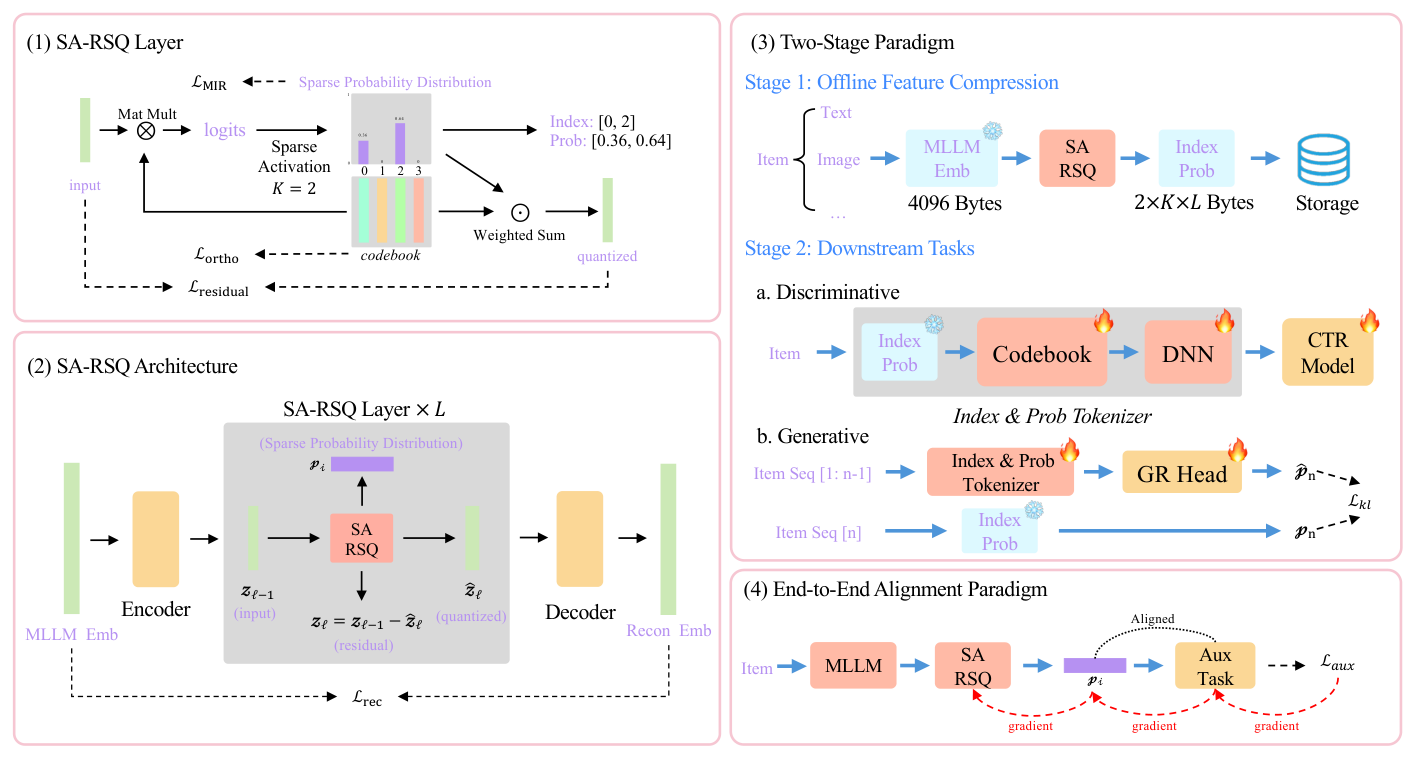
具体地,用 Top-$K$ 支撑集选择 + 掩码 softmax,得到一组紧凑的 (Index, Prob) 元组。支撑集的选择是离散的,但在支撑集固定的前提下,概率、码本取值、加权重建三者全部可导——因此不需要 STE。由于线上只存稀疏路由元组,每 item 的存储与码本维度 $d$ 完全解耦:码本可以做到 64 维、128 维,存储成本一点不涨。推理时只需一次查表 + 概率加权求和即可还原表征。
三点贡献:
- 可微稀疏软量化:用可微 Top-$K$ 稀疏路由替换启发式的 STE 路由,支持 8–48 字节的灵活存储—性能权衡;
- 更优的压缩—性能权衡:离线实验在评测配置上给出有利的前沿;其概率化表征还支撑了一个初步的 "Next-Distribution Prediction"(NDP)生成式推荐范式;
- 工业部署验证:在美团外卖广告平台部署,线上 A/B 相对生产基线取得 CTR +2.51%、CPM +3.66%。
二、核心方法:SA-RSQ 框架¶
2.1 迭代残差形式¶
与标准 RQ-VAE 一致,SA-RSQ 采用 Encoder-Decoder 架构。输入 item embedding $\mathbf{x} \in \mathbb{R}^{D}$ 先被映射到低维隐空间 $\mathbf{h} = \mathrm{Encoder}(\mathbf{x}) \in \mathbb{R}^{d}$,初始残差 $\mathbf{r}_0 = \mathbf{h}$。量化级联 $L$ 个 stage,第 $l$ 个 stage 维护可学习码本 $\mathbf{C}^{(l)} \in \mathbb{R}^{V \times d}$($V$ 个码字)。
与传统 RQ-VAE 的关键分歧在于:把不可导的 $\arg\min$ 硬赋值替换为连续软近似 $\hat{\mathbf{r}}_{l-1}$。残差迭代精化,最终重建表征 $\hat{\mathbf{x}}$ 由聚合的近似量解码得到:
$$\mathbf{r}_l = \mathbf{r}_{l-1} - \hat{\mathbf{r}}_{l-1} \tag{1}$$
$$\hat{\mathbf{x}} = \mathrm{Decoder}\!\left(\sum_{l=1}^{L} \hat{\mathbf{r}}_{l-1}\right) \tag{2}$$
这一形式保留了级联压缩结构。残差更新与加权求和是可导的;Top-$k$ 选择引起的离散支撑集变化在每次前向内被视为固定——这是全篇可微性论证的前提,也是论文反复强调 "for a fixed support" 的原因。
2.2 稀疏激活:截断 Softmax¶
对第 $l$ 层,给定输入残差 $\mathbf{r}_{l-1} \in \mathbb{R}^{d}$ 与码本 $\mathbf{C}^{(l)} \in \mathbb{R}^{V \times d}$,先用缩放点积算出相似度 logits $\mathbf{z}^{(l)} \in \mathbb{R}^{V}$:
$$z^{(l)}_{i} = \frac{\mathbf{r}_{l-1} \cdot \mathbf{c}^{(l)}_{i}}{\sqrt{d}}, \quad \forall i \in \{1, 2, \dots, V\} \tag{3}$$
标准软量化会对全部码字做稠密 Softmax,存储代价不可接受。受 MoE 的稀疏门控路由与稀疏注意力启发,SA-RSQ 强制结构性稀疏:只保留 Top-$k$ 个最相关码字。定义索引集 $\mathcal{I}_k$ 为 $\mathbf{z}$ 中最大的 $k$ 个值的下标,对 logits 做掩码:
$$\tilde{z}^{(l)}_{i} = \begin{cases} z^{(l)}_{i}, & \text{if } i \in \mathcal{I}_k \\ -\infty, & \text{otherwise} \end{cases} \tag{4}$$
掩码后的 logits 过 Softmax 得到稀疏概率分布 $\mathbf{p}^{(l)} \in \mathbb{R}^{V}$:
$$p^{(l)}_{i} = \frac{\exp(\tilde{z}^{(l)}_{i})}{\sum_{j=1}^{V} \exp(\tilde{z}^{(l)}_{j})} \tag{5}$$
由于 $-\infty$ 掩码,所有非 Top-$k$ 码字的概率精确为零。这一步把稠密 logits 投影到稀疏概率单纯形上,保证恰好 $k$ 个位置被激活。支撑集的选择本身是离散的,而掩码 softmax 权重对被选中的 logits 可导。
第 $l$ 层的量化表征是激活码字按稀疏概率的凸组合:
$$\hat{\mathbf{r}}_{l-1} = \sum_{i \in \mathcal{I}_k} p^{(l)}_{i} \mathbf{c}^{(l)}_{i} \tag{6}$$
为什么凸组合能治边界失真:硬量化中 "iPhone 15" 与 "iPhone 15 Pro" 落在同一个码字上就完全不可分;而在式 (6) 下,两者可以激活同一组码字但概率权重不同,重建向量因此仍然可分——连续距离结构在量化后被保留下来。这正是论文用 Semantic Cohesion 指标去度量的东西。
2.3 存储核算:为什么存储与维度解耦¶
离线阶段只需存 $k$ 个激活索引及其非零概率(Index & Prob 格式)。论文给出的显式核算是:每个索引用 16 位无符号整数,每个概率用 Float16;共享码本与模型参数不计入 per-item 预算。于是:
- 仅存索引(index-only):$2LK$ 字节;
- Index + Prob:$4LK$ 字节。
三个配置:$L{=}4, K{=}1 \Rightarrow 8$ 字节;$L{=}2, K{=}4 \Rightarrow 32$ 字节;$L{=}4, K{=}3 \Rightarrow 48$ 字节。该核算假定 $V \le 2^{16}$ 且无额外 per-item padding。
这里是全文最有价值的工程洞察:per-item 成本只由 $L$ 和 $K$ 决定,与码本维度 $d$、码本大小 $V$(只要 $V \le 65536$)全都无关。相比之下,稠密软量化把 32 字节直接换算成"最多 16 维",表征能力被存储预算死死锁住。
2.4 课程式稀疏退火(Curriculum Sparsity Annealing)¶
一上来就做 Top-$k$ 掩码会限制梯度流动、妨碍全局语义探索。论文引入余弦稀疏退火:训练初期用全稠密激活($k(0) = V$)让更新不受阻,随后 active budget $k(t)$ 按余弦因子 $\eta(t)$ 衰减到目标稀疏度 $k_{tgt}$:
$$\eta(t) = \frac{1}{2}\left(1 + \cos\left(\frac{\pi t}{T_{ann}}\right)\right) \tag{7}$$
$$k(t) = \max\left(k_{tgt},\ \left\lfloor k_{tgt} + (V - k_{tgt})\eta(t) \right\rfloor\right) \tag{8}$$
其中 $T_{ann}$ 为总退火步数。该调度平衡探索与利用,并保证推理前已到达 $k_{tgt}$,使落盘的支撑集满足目标预算。
2.5 优化目标:四项损失¶
全局与逐层重建¶
全局重建用 MSE。与依赖 stop-gradient 启发式 commitment loss 的硬量化不同,可微架构天然对齐编码器与码本。为显式稳定级联训练、防止表征坍塌,另加逐层残差重建损失:
$$\mathcal{L}_{recon} = \|\mathbf{x} - \hat{\mathbf{x}}\|_2^2 \tag{9}$$
$$\mathcal{L}_{residual} = \sum_{l=1}^{L} \|\mathbf{r}_{l-1} - \hat{\mathbf{r}}_{l-1}\|_2^2 \tag{10}$$
$\mathcal{L}_{residual}$ 的物理含义是:显式鼓励稀疏路由去找到能紧致包住当前残差的最优码字凸组合,而不是只让最终输出对得上。
几何正交正则¶
硬量化把码字当作刚性质心;SA-RSQ 把码字当作软线性组合的基向量。为最大化组合的张成能力、消除空间冗余,对每个码本内不同码字的余弦相似度做惩罚:
$$\mathcal{L}_{ortho} = \sum_{l=1}^{L} \frac{1}{V(V-1)} \sum_{i \neq j} \frac{\mathbf{c}^{(l)}_{i} \cdot \mathbf{c}^{(l)}_{j}}{\|\mathbf{c}^{(l)}_{i}\|_2 \times \|\mathbf{c}^{(l)}_{j}\|_2} \tag{11}$$
设计动机很直接:既然重建是 $k$ 个码字的凸组合,那么码字越接近正交,$k$ 个基张成的子空间体积越大,同样的 $k$ 能表达的表征越丰富。
互信息正则(MIR)——治码本坍塌¶
不用 "codebook restart" 这类启发式、不可微的 trick,而是最大化输入 $X$ 与软赋值 $Z$ 的互信息 $I(X;Z)$:等价于最大化 batch 边缘熵 $H(Z)$、最小化条件样本熵 $H(Z|X)$。设 $p_{i,j}$ 为 batch(大小 $B$)中第 $i$ 个样本激活第 $j$ 个码字的概率:
$$\mathcal{L}_{sample} = -\frac{1}{B}\sum_{i=1}^{B}\sum_{j=1}^{V} p_{i,j}\log p_{i,j} \tag{12}$$
$$\mathcal{L}_{batch} = -\sum_{j=1}^{V} \bar{p}_j \log \bar{p}_j, \quad \bar{p}_j = \frac{1}{B}\sum_{i=1}^{B} p_{i,j} \tag{13}$$
$$\mathcal{L}_{MIR} = \mathcal{L}_{sample} - \alpha \mathcal{L}_{batch} \tag{14}$$
最小化 $\mathcal{L}_{sample}$ 施加微观稀疏性(单个 item 的分布要尖锐、有判别力);最大化 $\mathcal{L}_{batch}$ 施加宏观均匀性(所有码字都被均匀探索)。$\alpha > 0$ 为超参。
论文特别回应了一个自洽性质疑:Top-$k$ 掩码会阻断未选中 logits 的梯度,$\mathcal{L}_{batch}$ 怎么还能推动全局均匀?答案是课程退火本身就是解药——训练早期 $k(t)$ 很大,$\mathcal{L}_{batch}$ 得以把码字均匀铺到隐空间;等 $k(t)$ 衰减到 $k_{tgt}$ 时,不同 item 在 batch 层面天然会激活不同码字,梯度覆盖因此在全程保持有效。
总目标¶
$$\mathcal{L}_{total} = \mathcal{L}_{recon} + \lambda_1 \mathcal{L}_{residual} + \lambda_2 \mathcal{L}_{ortho} + \lambda_3 \mathcal{L}_{MIR} \tag{15}$$
2.6 与推荐系统的集成¶
两阶段范式(Two-Stage Paradigm)¶
为满足工业系统的时延与内存约束:离线阶段为所有 item 抽取并冻结稀疏路由元组 $(\mathit{Index}, \mathit{Prob})$,保证严格的 $\mathcal{O}(k \times L)$ 字节/item 存储上界;在线阶段下游模型只做轻量查表 + 加权求和,码本可训练。于是 CTR 模型能享用 2048 维语义、内存开销却可以忽略。
注意这里的分工:元组冻结、码本可训——冻结的是"选了哪些基、权重多少",可训的是"基本身指向哪里"。这是把存储与表征能力解耦之后才可能成立的部署形态。
端到端对齐范式(End-to-End Alignment)¶
传统离散 ID 的根本缺陷是优化错配:量化模型只优化重建,对下游推荐目标一无所知。SA-RSQ 让稀疏概率 $p_{d,i}$ 充当可微路由介质:在 Top-$k$ 支撑集固定的前提下,下游梯度可以穿过加权求和回传到上游编码器与码本,不需要 STE;梯度不穿过离散支撑集的变化。
实践中作者只给了一个轻量实例化——离线 Proxy Co-training 模块:在 item pair 上加一个辅助对比损失。由于路由权重在固定支撑集下可导,这个代理信号可以在下游部署前微调稀疏概率、注入任务相关的协同信号。
三、实验设置¶
- 数据集:单一大规模工业数据集,来自外卖广告平台,包含数亿 item。原始 item 语义为预训练 MLLM(Qwen3-VL)抽取的 2048 维向量。论文明确声明:数据集、用户/item 标识、精确交互数、密度、分区基数均为专有、不可公开,因此只报规模与维度,不报这些统计量;并明确不宣称结果可迁移到公开 benchmark。
- 下游模型:SA-RSQ 提供 model-agnostic 的 item 表征,选 DIN 作为代表性骨干。为隔离"信息保留能力"与"下游容量",所有压缩格式的最终 item 表征维度统一为 $D_{model} = 16$。
- 32/48 字节预算下的 baseline 处理:对硬量化 baseline,报的是它们重建出的连续 embedding(Dense Emb)而非超长 SID。论文承认这是一种放宽存储约束的"上界式"对比,而稀疏元组行用的是 §3.1 的显式核算。
- 评估指标:下游 CTR 用 AUC / gAUC;表征质量用 Reconstruction Loss(RL,原始与重建 embedding 的 MSE) 与 Semantic Cohesion(SC)。SC 借自 R3-VAE,定义为正样本对相似度(PosSC)减负样本对相似度(NegSC)。论文声明:表中是同一评估流水线下的点估计,生产评估体系拿不到多种子标准差与置信区间。
四、主要实验结果:判别式任务¶
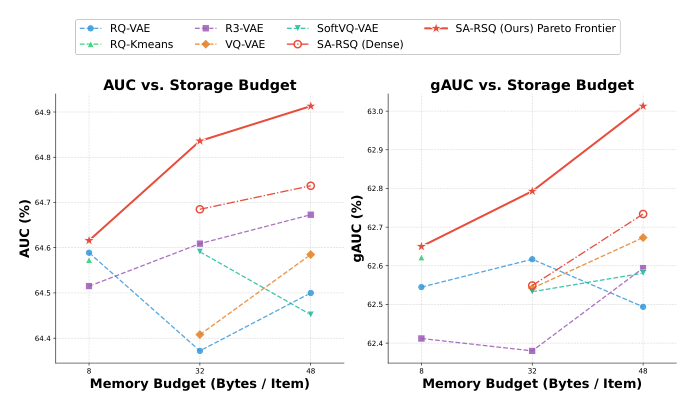
Table 1:不同表征压缩方法在下游 CTR 预测上的整体对比(严格对齐 Bytes/Item)
| Bytes/Item | Method | Format Details | AUC(%)↑ | gAUC(%)↑ | RL↓ | PosSC↑ | NegSC↓ | SC↑ |
|---|---|---|---|---|---|---|---|---|
| 4096 | Qwen3-VL (Original) | 2048D Dense | OOM | OOM | - | - | - | - |
| 8 | RQ-VAE | 4-layer SID | 64.589 | 62.545 | 0.4010 | 0.5276 | 0.0046 | 0.5230 |
| 8 | R-Kmeans | 4-layer SID | 64.573 | 62.622 | 0.5336 | 0.6907 | 0.1831 | 0.5076 |
| 8 | R3-VAE | 4-layer SID | 64.515 | 62.412 | 0.3279 | 0.7805 | 0.0605 | 0.7200 |
| 8 | SA-RSQ (Ours) | L=4, K=1 (Index) | 64.616 | 62.650 | 0.2394 | 0.8535 | 0.1541 | 0.6994 |
| 32 | RQ-VAE | 16D Dense Emb | 64.372 | 62.617 | 0.3934 | 0.8751 | 0.0100 | 0.8651 |
| 32 | R3-VAE | 16D Dense Emb | 64.609 | 62.380 | 0.3461 | 0.9961 | 0.8692 | 0.1269 |
| 32 | VQ-VAE | 16D Dense Emb | 64.408 | 62.542 | 0.6215 | 0.8343 | 0.0146 | 0.8197 |
| 32 | SoftVQ-VAE | 16D Dense Emb | 64.452 | 62.533 | 0.4430 | 0.9673 | 0.1592 | 0.8081 |
| 32 | SA-RSQ (Ours) | 16D Dense Emb | 64.685 | 62.549 | 0.3119 | 0.8944 | 0.0046 | 0.8898 |
| 32 | SA-RSQ (Ours) | L=2, K=4 (Index+Prob) | 64.836 | 62.793 | 0.1660 | 0.9055 | 0.0012 | 0.9043 |
| 48 | RQ-VAE | 24D Dense Emb | 64.500 | 62.494 | 0.3962 | 0.8318 | 0.0094 | 0.8224 |
| 48 | R3-VAE | 24D Dense Emb | 64.673 | 62.594 | 0.3343 | 0.9902 | 0.8635 | 0.1267 |
| 48 | VQ-VAE | 24D Dense Emb | 64.585 | 62.673 | 0.6301 | 0.8147 | 0.0119 | 0.8028 |
| 48 | SoftVQ-VAE | 24D Dense Emb | 64.591 | 62.581 | 0.4334 | 0.9571 | 0.1130 | 0.8441 |
| 48 | SA-RSQ (Ours) | 24D Dense Emb | 64.737 | 62.734 | 0.2653 | 0.9190 | 0.0061 | 0.9129 |
| 48 | SA-RSQ (Ours) | L=4, K=3 (Index+Prob) | 64.913 | 63.013 | 0.1553 | 0.9205 | 0.0026 | 0.9179 |
三条结论:
(1) 极端压缩下(8 字节)的优势。 即便只存离散索引、推理时丢弃概率,SA-RSQ 仍在 8 字节组取得最高 AUC(64.616)与 gAUC(62.650),RL 也从 RQ-VAE 的 0.4010 降到 0.2394。作者的解释是:稀疏软路由培育出的码本本身就比硬赋值更有表达力——即使最后按硬索引使用,训练过程中形成的码字几何结构已经更优。这个结论其实比论文写得更重要:它意味着 SA-RSQ 可以零成本替换现有 8 字节 SID 生产链路,不需要改任何存储格式。
(2) 稀疏概率的威力(32 & 48 字节)。 预算允许存完整 (Index, Prob) 元组时,32 字节配置 AUC 达 64.836,高于所有 16D 稠密 embedding baseline(≈64.6);48 字节配置取得全表最高 AUC(64.913)与 gAUC(63.013)。
(3) 高保真重建驱动精度。 RL 与 CTR 表现呈明显负相关:传统方法 RL > 0.3,SA-RSQ 在 48 字节把 RL 压到 0.1553。配合更优的结构指标(PosSC/NegSC),SA-RSQ 忠实保留了连续细粒度语义,从而缓解 item collision。
几个论文没有展开、但值得注意的观察:
- R3-VAE 在 32/48 字节的稠密 embedding 上出现表征坍塌:PosSC 高达 0.9961/0.9902,但 NegSC 同样高到 0.8692/0.8635,SC 只剩 0.1269/0.1267。也就是说它把所有 item 都拉到了彼此相似的位置——正负样本无差别地相似,这是稠密软量化在窄瓶颈下的典型失效模式,恰好是 §1.1 预言的"投影到窄瓶颈导致语义坍塌"。
- SA-RSQ 在 8 字节并非全面最优:SC 0.6994 低于 R3-VAE 的 0.7200,NegSC 0.1541 显著差于 RQ-VAE 的 0.0046。正文只说"SA-RSQ 取得最高 AUC",回避了 SC 这一格。合理解释是:$K{=}1$ 时掩码 softmax 退化成硬 argmax,稀疏软路由的优势只剩训练期的码本塑形,推理期完全丧失。
- SA-RSQ (Dense) 在 32 字节的 gAUC(62.549)反而低于 RQ-VAE 的 62.617,即 Figure 1 右图那条 Pareto 前沿线只在 Index+Prob 变体上成立,稠密变体并不一致占优。
论文自己也做了明确的措辞收敛:"图表描述的是所评测配置上的一条前沿,并不确立对所有可能方法与超参的全局 Pareto 最优性。" 这是很诚实的表述。
五、探索性研究:生成式推荐(NDP)¶
作者在一个从同一外卖广告平台采样的百万级工业用户交互数据集上,用标准 Transformer 序列架构做了初步验证,对比两种生成范式:
- NTP(Next Token Prediction):自回归预测离散 SID,标准交叉熵。为公平对比,所有 baseline 与 SA-RSQ 都用 4 层硬离散配置($L{=}4, K{=}1$);
- NDP(Next Distribution Prediction):模型预测连续分布,用 KL 散度对齐 SA-RSQ 的稀疏路由元组($L{=}2, K{=}4$)。计算该损失时目标 Top-$k$ 支撑集是固定的。
Table 2:生成式推荐初步结果
| Paradigm | Method | R@10 | N@10 | R@20 | N@20 |
|---|---|---|---|---|---|
| NTP | RQ-VAE | 0.0068 | 0.0045 | 0.0105 | 0.0045 |
| NTP | R-Kmeans | 0.0057 | 0.0031 | 0.0086 | 0.0038 |
| NTP | R3-VAE | 0.0075 | 0.0043 | 0.0105 | 0.0051 |
| NTP | SA-RSQ | 0.0088 | 0.0050 | 0.0126 | 0.0060 |
| NDP | SA-RSQ | 0.0096 | 0.0059 | 0.0131 | 0.0072 |
分析:在传统 NTP 范式下,SA-RSQ 的离散索引已经优于其他硬量化 baseline(R@10 0.0088 vs RQ-VAE 0.0068,+29.4%),再次印证"底层码本质量更高"这一说法。切到 NDP 范式后所有指标进一步提升(R@10 0.0088 → 0.0096,+9.1%;N@20 0.0060 → 0.0072,+20%)。
NDP 的范式意义:NTP 有两个继承自硬量化的结构缺陷——离散 ID 制造了不可微边界,阻碍真端到端优化;自回归解码存在误差累积。NDP 让生成器直接预测码本上的连续稀疏概率分布,训练可微,且对误差具备优雅的容忍度(预测偏一点只是权重偏移,而不是跳到完全不同的 item 簇)。
但论文自己给了非常克制的定性:"这些初步结果表明概率化目标在该设置下是可行的,但不构成 NDP 是一个完整或普遍更优的生成式推荐范式的证据。" 需要注意 Table 2 的绝对量级极低(R@10 ~0.009),且 RQ-VAE 的 N@10 与 N@20 都是 0.0045(N@20 通常应大于 N@10),疑似笔误。
六、消融实验¶
Table 3:SA-RSQ 全面消融(Usage 为码本利用率)
| Variant | AUC(%)↑ | RL↓ | Usage(%)↑ | SC↑ |
|---|---|---|---|---|
| w/o $\mathcal{L}_{residual}$ | 64.622 | 0.3212 | 73.2 | 0.7997 |
| w/o $\mathcal{L}_{ortho}$ | 64.565 | 0.2720 | 68.4 | 0.8005 |
| w/o $\mathcal{L}_{MIR}$ | 64.587 | 0.2413 | 24.5 | 0.2446 |
| w/o Proxy Co-training | 64.746 | 0.1419 | 99.3 | 0.1014 |
| w/o Curriculum Learning | 64.741 | 0.4942 | 15.9 | 0.1587 |
| w/o Top-$k$ Mask | 64.604 | 0.2515 | 49.7 | 0.1035 |
| Full Model (SA-RSQ) | 64.913 | 0.1553 | 100% | 0.9179 |
逐项分析:
- $\mathcal{L}_{residual}$:去掉后 AUC 掉到 64.622、RL 升到 0.3212,说明深监督对稳定级联量化是必需的——没有逐层约束,中间 stage 会摆烂,全部压力堆到最后一层。
- $\mathcal{L}_{ortho}$:AUC 64.565(六个消融里最低),Usage 降到 68.4%。码字失去互斥表达力后,凸组合的张成能力下降。
- $\mathcal{L}_{MIR}$:触发灾难性码本坍塌——Usage 暴跌到 24.5%,SC 从 0.9179 崩到 0.2446。这一格最能说明 MIR 不可替代:宏观均匀性一旦失去,四分之三的码字变成死码。有意思的是 RL 反而降到 0.2413(比 full model 的 0.1553 差但比多数消融好),说明重建误差与码本利用率是两个可以背离的指标——少数几个码字也能把 MSE 做得不难看,但语义结构已经废了。
- Proxy Co-training:SC 从 0.9179 断崖式掉到 0.1014,AUC 降到 64.746,但 RL 反而是全表最低的 0.1419。这是全表最值得玩味的一格:代理对比信号是在牺牲一点点重建保真度的前提下,换来了巨大的语义可分性。它印证了 §1.1 的核心论断——纯重建目标与推荐目标本就错配,RL 最优不等于下游最优。
- Curriculum Learning:去掉后 RL 最差(0.4942)、Usage 只有 15.9%。一开始就上 Top-$k$ 掩码,模型没有机会探索语义空间,绝大多数码字从未被激活过就被永久边缘化。
- Top-$k$ Mask:退化为稠密软量化后 AUC 降到 64.604,Usage 49.7%,SC 0.1035。这一格是对"稀疏化本身有价值"的直接验证——稠密 softmax 让每个 item 都轻微激活所有码字,码字之间失去分工。
七、线上 A/B 实验¶
在外卖广告平台用 10% 生产流量做了为期一周的 A/B。每种方法在线上都试了若干配置,Table 4 报的是各方法的峰值配置,对照组是不含多模态特征的生产基线。
Table 4:线上 A/B 结果(各方法跨配置的峰值相对提升)
| Method | Optimal Online Config | CTR Imp.(%) | CPM Imp.(%) |
|---|---|---|---|
| RQ-VAE | 4-layer SID | 0.96 | 1.27 |
| R3-VAE | 24D Dense Emb | 0.85 | 0.97 |
| VQ-VAE | 24D Dense Emb | 1.26 | 1.68 |
| R-Kmeans | 4-layer SID | 0.91 | 1.21 |
| SA-RSQ | $L=4, K=3$ | 2.51 | 3.66 |
SA-RSQ 的 CTR 提升接近次优方法(VQ-VAE 1.26%)的 2 倍,CPM 提升超过 2 倍。
论文对这组数字给了极为克制的免责声明:流量计数、置信区间、p 值、护栏指标、线上试验次数均被生产系统扣留;报告的峰值应当被解读为部署证据而非显著性分析。 并主动承认:只报了存储,没有 p99 时延与吞吐测量,这是重要的部署局限。
这是相当罕见的诚实,但也确实削弱了这组数字的证据力——"跨多个配置取峰值"在统计上是典型的多重比较问题,尤其在没有 CI 与 p 值的情况下。
八、核心贡献总结¶
- 诊断:把"极端压缩 vs 高维稠密"之间的缺口明确为一个可以被工程解决的问题,并归因到"存储占用与表征维度的强耦合"+ "硬赋值不可微"两条 root cause。
- 机制:Top-$k$ 掩码 softmax + (Index, Prob) 元组存储。存储成本 $4LK$ 字节与码本维度 $d$、码本大小 $V$ 解耦;固定支撑集下全链路可导,彻底摆脱 STE。
- 配套正则三件套:课程稀疏退火(探索)+ 正交码本正则(几何)+ 互信息正则(利用率)。消融显示三者各自不可替代,且失效模式各不相同。
- 部署形态:两阶段(冻结元组、微调码本)+ 端到端对齐(Proxy Co-training 实例化)。
- NDP 范式雏形:把生成式推荐的预测目标从离散 token 换成稀疏概率分布,规避不可微边界与误差累积。
- 工业验证:美团外卖广告平台部署,一周 10% 流量 A/B,CTR +2.51% / CPM +3.66%。
九、与已归档相关工作的对比¶
R3-VAE R3-VAE: Reference Vector-Guided Rating Residual Quantization VAE(ByteDance Toutiao, 2026-04-13)¶
关系:显式引用且作为核心 baseline,但原文只给表格数字、未展开机制对比 · 已加载对方精读
- 共同关注的问题:两篇论文对 RQ-VAE 的病灶诊断几乎逐字重合——STE 的有偏梯度导致训练不稳与码本坍塌,硬 $\arg\min$ 抹掉连续语义结构。SA-RSQ 甚至直接借用了 R3-VAE 提出的 Semantic Cohesion (SC) 指标作为自己的核心评估维度(本文 §4.1 明确标注 SC 引自 [34])。
- 相近的技术骨架:两者的核心算子完全同构——用"打分 → softmax → 码字加权求和"替换 argmin 硬查表。R3-VAE 的式 $\hat{e}^{(l)} = \sum_k w_k^l c_k^l$ 与 SA-RSQ 的式 (6) 是同一个东西,都让梯度流向码本中的多个码字而非单一胜者。
- 本文的差异与推进:分歧点在稀疏化与落盘形态。R3-VAE 训练时用全码本稠密 softmax 加权,推理时再取 $\arg\max_k w_k^l$ 硬截断成 SID——软加权只服务于梯度传播,最终落盘的仍是硬索引,边界失真在推理侧原样复现。SA-RSQ 的关键一步是把 softmax 限制在 Top-$k$ 支撑集上,使得概率本身变得可存储($4LK$ 字节),推理时也用软加权重建。换句话说:R3-VAE 用软量化修复了训练,SA-RSQ 用稀疏软量化同时修复了训练与推理。另一处差异是 R3-VAE 额外引入了可学习参考向量剥离语义中心,SA-RSQ 没有对应组件。
- 可比的方法 / 实验差异:本文 Table 1 显示 R3-VAE 在 8 字节 SID 下 SC 最高(0.7200)但 AUC 最低(64.515);在 32/48 字节稠密 embedding 下则出现严重的正负样本无差别相似(NegSC 0.8692/0.8635,SC 塌到 0.127)。这一现象恰好从实证上支持了 SA-RSQ 的论点:稠密软量化在窄存储瓶颈下会坍塌。线上 A/B 中 R3-VAE 也是五种方法里最差的(CTR +0.85%)。反过来看,R3-VAE 在六个公开 benchmark 上做了完整验证(Beauty/Sports/Toys +14.5% Recall@10)并在今日头条全量部署,实验广度远优于只有单一专有数据集的 SA-RSQ。
CapsID CapsID: Soft-Routed Variable-Length Semantic IDs(2026-05-06)¶
关系:独立并发(本文未引用 CapsID,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把矛头精确对准同一个算子——残差量化里的 winner-take-all 分配。CapsID 的表述是"不确定性必须在离散化之前被建模,不能在 argmax 之后再补救";SA-RSQ 的表述是"边界失真让语义相近的 item 要么共享 ID 要么完全分开"。同一个 root cause 的两种措辞。两者也都明确反对"加深 SID / 放大码本"这条廉价路线(CapsID 引 GRID 的实证,SA-RSQ 引残差 stage 收益递减)。
- 相近的技术骨架:核心分水岭公式是同一条。CapsID 的式 (7) $\mathbf{r}_{i,\ell} = \mathbf{r}_{i,\ell-1} - \sum_k c_{i,\ell k}\mathbf{o}_{i,\ell k}$ 与 SA-RSQ 的式 (1)+(6) 在结构上完全一致:残差更新扣除的是所有激活单元的加权贡献,而非单一胜者码字,只把真正未解释的部分传给下一层。CapsID 用 "travel cooking kit" 同时激活 travel 与 cooking 两个 capsule 来说明这一点,SA-RSQ 用 "iPhone 15 / iPhone 15 Pro" 说明同一件事。
- 本文的差异与推进:CapsID 的软路由靠 capsule 动态路由(3 轮迭代 + squash 非线性),SA-RSQ 靠一次性 Top-$k$ 掩码 softmax——后者显著更轻、更易在亿级 item 上离线批处理,但没有 CapsID 的迭代自纠机制。更重要的是两者的落盘目标不同:CapsID 仍然 emit 离散 token($s_{i,\ell} = \arg\max_k c^{(T)}_{i,\ell k}$),软路由只用于改善 token 质量与残差纯净度,它的存储创新在"变长"(置信度驱动提前停止,$\bar{L} \approx 3.6$);SA-RSQ 则直接把概率本身落盘,走的是"定长但带权重"的路线。可以说两者在同一个洞察上分叉成了变长离散与定长软权重两条压缩路径。
- 可比的方法 / 实验差异:CapsID 有三个公开 Amazon benchmark + 35M item 工业目录 + 11 个 baseline + 三条理论命题(软硬重构界、期望长度上界、路由 ≡ EM E-step),实验与理论严谨度都明显强于 SA-RSQ;SA-RSQ 的独有优势是真实线上 A/B(CapsID 无 A/B)以及显式的字节级存储核算——CapsID 讨论的是 token 数与推理延迟(1.05–1.08× TIGER),没有像 SA-RSQ 这样把每 item 字节预算作为一等实验轴来扫。两篇没有共同数据集,指标无法直接对比。
DIG DIG: Discrimination Is Generation(Meituan, 2026-05-14)¶
关系:独立并发(本文未引用 DIG,且同为美团团队产出)· 已加载对方精读
- 共同关注的问题:两篇都把 "tokenizer 的重建目标与下游推荐目标结构性错配" 当作核心病灶。DIG 的表述是"判别梯度从未流回 codebook,codebook 边界反映的是内容相似度等高线而非推荐决策边界";SA-RSQ 的表述是"量化模型优化重建目标而下游推荐器追 CTR/CVR,这种目标错配让硬编码 SID 永远与任务需求不对齐"。同一个 root cause 的两种表述,且出自同一家公司的不同团队。两者的下游骨干也高度重合(DIG 是 DIN+DCNv2+MoE,SA-RSQ 是 DIN),场景都是美团本地生活/外卖。
- 相近的技术骨架:两者的解法都可以画成同一张流程图:让下游判别信号穿过量化器回传,从而塑造码本,且都刻意绕开了 STE。SA-RSQ 的路线是让量化算子本身可微(固定支撑集下的加权求和),DIG 的路线是把"寻址"与"语义表达"解耦成两套参数——codebook 向量只做 argmin 寻址且用 EMA 更新、不参与打分,另设一套 SID embedding 承担语义表达并由判别 loss 直接驱动,因为它不参与 argmin,梯度可以直接穿过。
- 本文的差异与推进:DIG 走的是真端到端——排序 BCE loss 在训练中就直接驱动 codebook 构造,一次训练同时得到排序器与检索器;SA-RSQ 虽然在 §3.3 提出了 End-to-End Alignment Paradigm,但实际只实例化为一个离线 Proxy Co-training 模块(item pair 上的辅助对比损失),CTR 模型的梯度并没有真的回传到量化器。从"目标对齐"这条主线看,DIG 比 SA-RSQ 走得更远;SA-RSQ 的独有推进在另一条轴上——存储—保真的连续可调(8→48 字节的显式预算扫描),这是 DIG 完全没有触碰的维度(DIG 的 SID 仍是定长 $L{=}4, K{=}256$ 硬 token)。
- 可比的方法 / 实验差异:DIG 在 3 个公开 + 2 个美团工业数据集上对 5 个 SOTA SID baseline 取得 +52%~+220% R@10 并同时提升排序 AUC;SA-RSQ 只有单一专有数据集。两者的消融也印证了互补的结论:SA-RSQ 的 "w/o Proxy Co-training" 一格显示 SC 从 0.9179 塌到 0.1014(RL 反而变好),正是 DIG "纯重建目标不等于推荐目标"论断的一个独立实证。值得注意的是,SA-RSQ 未引用同公司三个月前的 DIG,这在同一业务线内部是个信息传递上的遗憾。
十、讨论与局限性¶
10.1 值得借鉴的设计¶
(1) "存的是路由指令而非重建结果" 是本文最可复用的一条工程原则。一旦意识到 per-item 落盘的可以是 $(\mathit{Index}, \mathit{Prob})$,存储成本 $4LK$ 就与码本维度 $d$、码本大小 $V$($V \le 2^{16}$ 内)彻底无关——码本可以自由做大做宽而不涨一字节线上存储。这个解耦对任何"离线压缩 + 在线查表"的工业链路都直接适用,且不需要改动下游模型结构。
(2) 8 字节 index-only 配置的零成本可替换性。Table 1 显示即使丢弃概率、只存索引,SA-RSQ 仍在 8 字节组全面领先。这意味着现有 RQ-VAE 生产链路可以只换训练侧的量化器、完全不改存储格式与线上代码就吃到收益——落地风险极低。
(3) 三项正则的失效模式各不相同且互补:$\mathcal{L}_{MIR}$ 管码本利用率(去掉 → Usage 24.5%),Curriculum 管探索(去掉 → Usage 15.9% 且 RL 最差),$\mathcal{L}_{ortho}$ 管几何张成(去掉 → AUC 最低)。这套"稀疏路由 + 熵正则 + 退火"的组合拳本身可以迁移到任何带可学习码本的模块。
(4) RL 与下游指标可以背离。"w/o Proxy Co-training" 一格 RL 最优(0.1419)但 SC 只有 0.1014、AUC 下降——这个反例应当被写进任何做 tokenizer 的团队的笔记:别拿重建损失当唯一的离线选型指标。
10.2 局限与争议¶
(1) 实验证据基础是全文最弱的一环。 零个公开数据集——不是"公开数据集上略逊",是完全没有。所有离线结论都建立在单一专有外卖广告数据集上,论文自己也声明"不宣称结果可迁移到公开 benchmark"。这使得方法的普适性完全无法被外部验证,尤其是 SA-RSQ 的很多设计(如 $\mathcal{L}_{MIR}$ 的 $\alpha$、正交正则强度)都有较强的数据分布依赖。相比之下同赛道的 R3-VAE(6 个公开 benchmark)、CapsID(3 个公开 + 工业目录)、CARD(3 个公开)都做了公开验证。
(2) 统计严谨性缺失。 无多种子标准差、无置信区间、无 p 值、无护栏指标。Table 1 中不少差距在 AUC 第三位小数上(如 8 字节组 64.616 vs 64.589,差 0.027),在没有方差信息的情况下难以判断是否显著。线上 A/B 更是"跨多种配置取各方法峰值"——这是标准的多重比较陷阱,论文虽然主动披露了但没有做任何校正。
(3) 时延与吞吐完全缺席。 论文主打的卖点之一是缓解"存储开销与推理时延瓶颈",但全文没有任何 p99 时延或吞吐数据。Top-$k$ 稀疏路由在推理侧需要 $K \times L$ 次查表 + 加权求和(48 字节配置是 12 次),相比硬 SID 的 4 次直接 lookup 是有额外开销的,这部分成本被完全略过。论文在 §4.5 承认了这一局限。
(4) 文本与表格自相矛盾。 §4.2 正文写 "SA-RSQ ($L=1, K=4$) achieves the highest AUC (64.616) among 8-byte baselines",而 Table 1 对应行标的是 "$L=4, K=1$ (Index)"。两者在 index-only 核算下都是 8 字节,但物理含义完全不同(4 层各取 1 个 vs 1 层取 4 个),这直接影响对"为什么 index-only 也能赢"的解释。属于明显的编辑疏漏。
(5) NDP 只是雏形。 Table 2 的绝对量级极低(R@10 ~0.009),只有一个数据集、一个骨干、四个 baseline,且 RQ-VAE 的 N@10/N@20 同为 0.0045 疑似笔误。论文自己把结论限定为"概率化目标在该设置下可行",并在未来工作里承认需要在公开 benchmark 上验证 NDP。这一节更像是占位而非验证。
(6) 端到端对齐名不副实。 §3.3 用了很大篇幅论证"稀疏概率作为可微路由介质可以让下游梯度回传",但实际实现只是一个离线的 item-pair 对比代理任务——真正的 CTR 模型梯度从未回传到量化器。这在方法论可扩展性上是个实打实的瓶颈:整套方案仍然是"先离线压缩、再在线建模"的两阶段解耦范式,码本一旦固化就限制下游表征空间,参数量 scaling 时"如何表征 item"与"如何建模序列"两条路径无法同步增长。同期的 DIG(同为美团)在这条轴上走得更彻底。
(7) 32/48 字节的对比口径存在争议。 硬量化 baseline 在这两档报的是"重建出的连续 embedding",论文自己称之为"放宽存储约束的上界式对比"。但这意味着 baseline 实际上被允许存 16D/24D Float16 稠密向量,而 SA-RSQ 存的是稀疏元组——两者的信息组织形式不同,"严格对齐存储预算"这一说法只在字节数上成立,在建模自由度上未必公平(尽管这次是对 baseline 有利的方向)。
(8) 支撑集不可微被轻描淡写。 全文可微性论证都建立在 "for a fixed support" 这个前提上。但 Top-$k$ 的选择本身是离散的、随训练变化的,梯度不穿过支撑集切换。这与 STE 的性质差异其实是程度而非本质上的——只不过 SA-RSQ 把不可微性从"每个码字的选择"缩小到了"哪 $k$ 个进入支撑集"。论文没有分析支撑集抖动对训练稳定性的影响,也没给出支撑集在训练后期的切换频率统计。
10.3 与已有工作的定位¶
SA-RSQ 属于 2026 年这一批集中攻击"RQ-VAE 硬赋值"的工作之一(R3-VAE、CapsID、CARD、AdaSID、QuaSID、DRQ、VarLenRec 等)。在这个谱系里,它的独特坐标是:唯一把"每 item 字节预算"当作一等实验轴、并给出显式字节核算的工作——其他工作讨论的是碰撞率、码本利用率、SID 长度,而 SA-RSQ 直接问"给我 8/32/48 字节,各能买到多少 AUC"。这个提问方式本身对工业选型很有价值。代价是它在方法新颖性上偏弱(Top-$k$ 掩码 softmax 基本是 MoE 稀疏门控的直接移植),在实验严谨度上明显弱于同赛道多数工作。