R3-VAE: Reference Vector-Guided Rating Residual Quantization VAE for Generative Recommendation¶
ByteDance Toutiao Recommendation Team · Qiang Wan, Ze Yang, Dawei Yang, Ying Fan, Xin Yan 等 · arXiv:2604.11440(v1 2026-04-13,v3 2026-05-06)· 代码:https://github.com/wwqq/R3-VAE
一、研究动机与背景¶
生成式推荐(Generative Recommendation, GR)正在取代传统的"召回—排序"级联流水线:模型直接输出物品标识符,从而省掉中间的 embedding table、ANN 索引与重排模块,实现端到端的可扩展推荐。而支撑这一范式的关键组件是 Semantic Identifier(SID)——一串刻画物品语义属性的离散 token,它让物品 ID 与人类可理解的类目建立可解释映射,也让物品能无缝接入预训练语言模型。
当前 SID 的主流生成方式是向量量化(Vector Quantization, VQ):用一个可学习码本把连续 embedding 压成离散码字。其中残差量化(Residual Quantization, RQ)是基石,代表实现有 TIGER 中的 RQ-VAE 和 OneRec 中的残差 K-Means(residual K-Means / R-KMeans),二者都利用"由粗到细"的层次残差结构。再叠加 VQ-Rec 的 OPQ 码本优化,VQ 已经成为 GR 中 SID 学习的事实标准。
但本文指出,SOTA 的 SID 生成技术存在两个结构性瓶颈:
瓶颈一:量化过程的梯度传播不充分导致训练不稳定。 RQ-VAE 依赖直通估计器(Straight-Through Estimator, STE)来近似穿过"不可导的码本查表"这一步的梯度。STE 提供的是有偏梯度估计,往往无法把重构损失中的细粒度信息有效传回,最终导致码本坍塌(codebook collapse)——绝大多数向量被映射到极少数码字上。residual K-Means 虽然部分缓解了这个问题,但它高度依赖初始聚类中心,容易收敛缓慢或陷入局部最优。
瓶颈二:缺少与下游表现强相关的 SID 质量量化指标。 现有做法只能靠端到端的下游 GR 指标(NDCG、Recall)来间接验证 SID 好坏。这虽然反映真实效用,但计算代价极高:量化模块每改一次,都必须跑一遍完整的下游训练甚至线上 A/B 才能评估,严重拖慢工业迭代。已有的 SID 评估指标——如 Semantic Convergence 提出的 Collision Rate 和 FORGE 使用的 Gini 系数——与下游任务相关性有限,且不便于端到端优化。
针对这两点,本文提出 R3-VAE(Reference Vector-Guided Rating Residual Quantization VAE),三项核心贡献:
- Reference Vector(参考向量):引入一个可学习的参考向量作为初始物品特征的语义锚点。把输入 embedding 投影到该向量上再取残差,让量化过程从第一步就与推荐数据的语义结构对齐,从而缓解初始化敏感性,并保证早期残差携带偏好相关信息。
- Rating 机制替代 STE:用点积"打分"衡量残差与码字的角度相似度(而非欧氏距离),softmax 归一化后做加权求和。与 STE 的硬查表不同,该设计在整个量化链路上保留细粒度梯度信息,稳定训练、加速收敛,同时保住 RQ 的层次优势并消除码本坍塌。
- SC / PD 两个可量化且可优化的 SID 指标:Semantic Cohesion(语义内聚,簇内平均余弦相似度,越高越好)与 Preference Discrimination(偏好区分度,簇间质心平均余弦距离的对数形式,越低越好)。二者与下游表现的相关性显著强于 Collision Rate 与 Gini 系数,且能直接当作训练正则项。
二、相关工作定位¶
生成式推荐:OneRec 与 TIGER 用向量量化把物品映射成 SID 序列,让生成模型捕捉超出协同过滤范围的细粒度用户偏好与物品关联;后续工作进一步引入显式推理(OneRec-Think)与自适应域对齐(LGSID)。
Semantic Identifier:VQ-Rec 用 OPQ 离散化物品编码;CCFRec 用 PQ + RQ 得到多级离散码;UniSearch 用 VQ-VAE 做 tokenizer;TIGER、LETTER、SETRec、GNPR-SID、EGA-V2、DAS、UIST、CoST、MM-RQ-VAE 都采用 RQ-VAE 层次量化器;SEATER 用层次约束 K-Means 生成等长标识符;OneRec 引入基于残差 K-Means 的多级均衡量化机制;RPG、TokenRec、ETEGRec 等提出各种改进方案。本文的判断是:这些方法普遍存在训练不稳定、依赖初始化、收敛慢、表达能力不足的问题。
三、核心方法:R3-VAE 架构¶
R3-VAE 在 VAE 骨干上集成参考向量与 rating 机制,通过层次残差量化把物品连续 embedding 变成高质量 SID,包含三个核心组件:Reference Vector Projection Layer(语义锚定)、Dot Product-Based Rating Quantization Module(保梯度的残差更新)、SC/PD 指标对(直接评估)。
整体流水线分三步:(i) 参考向量投影——输入 embedding 投影到可学习参考向量上,生成语义对齐的初始残差;(ii) 层次 rating 量化——残差通过基于点积 rating 的机制逐层量化,保持梯度流通以避免码本坍塌;(iii) SID 生成与评估——量化码字拼接成 SID,在下游 GR 部署前直接用 SC 与 PD 评估质量。
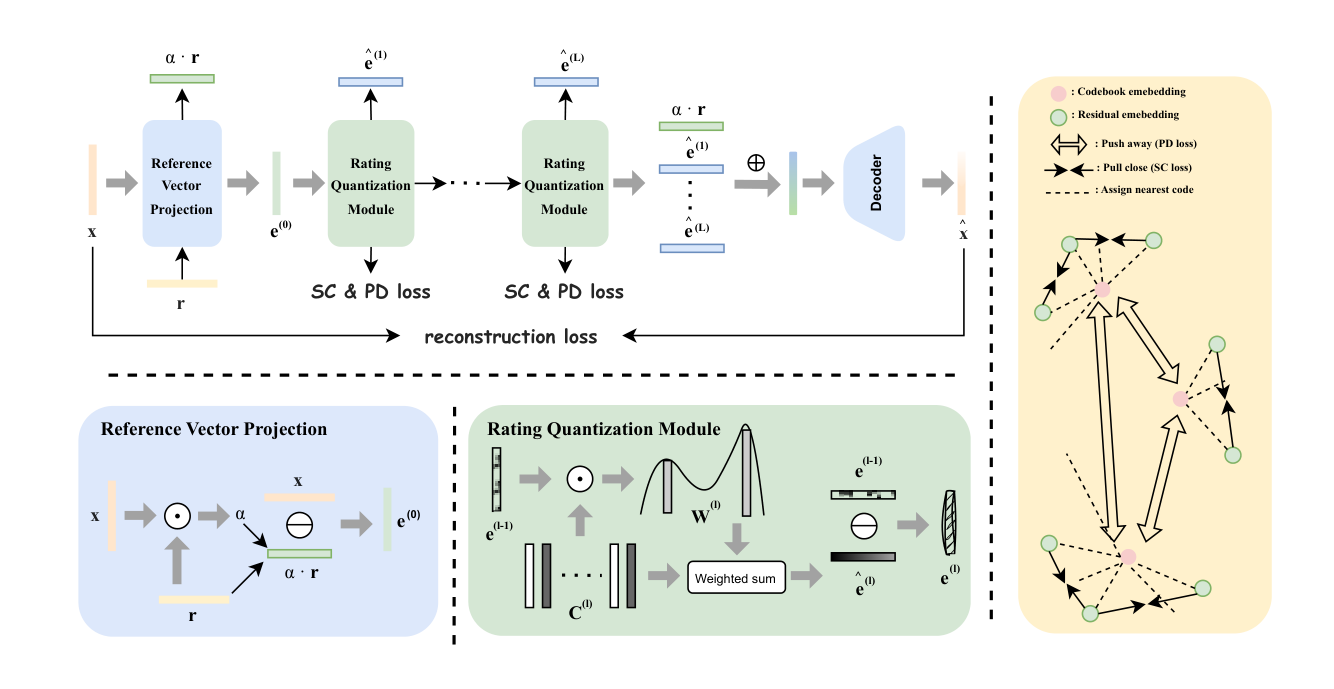
3.1 Reference Vector Projection Layer¶
该层的目标是让初始残差的计算就与推荐数据的语义结构对齐,从而缓解 RQ-VAE 与残差 K-Means 的初始化敏感性。
参考向量定义:引入一个可学习的参考向量 $r \in \mathbb{R}^d$,$d$ 为输入物品 embedding $x \in \mathbb{R}^d$ 的维度。$r$ 端到端优化,用于捕捉推荐数据集的语义中心——例如聚合核心物品主导语义属性的偏好模式。
投影与初始残差计算:对输入 embedding $x$,先用点积计算它在 $r$ 上的语义投影(点积衡量角度相似度,与推荐相关性对齐)。投影标量 $\alpha$ 与初始残差 $e^{(0)}$ 定义为:
$$\alpha = \frac{x \cdot r}{\|r\|^2} \tag{1}$$
$$e^{(0)} = x - \alpha \cdot r \tag{2}$$
其中 $\alpha$ 量化 $x$ 与 $r$ 之间的语义亲和度,$e^{(0)}$ 表示 $x$ 中偏离语义中心的分量。这保证了 $e^{(0)}$ 保留偏好相关信息,而不像 RQ-VAE 中那样是任意残差。
物理含义上,这一步相当于先把"所有物品共有的语义均值方向"剥离出去,只把个体差异部分交给码本去量化。共性由一个可学习标量 $\alpha$ 承载(重构时再加回 $\alpha \cdot r$),码本因此不必浪费容量去表达全局共性,直接从第一层就开始区分个体,这也是它能降低初始化敏感性的机制。
3.2 Rating Quantization Module¶
该模块用点积 rating 机制替换 RQ-VAE 中基于 STE 的梯度近似,实现跨量化步骤的连续梯度传播。采用与 RQ "coarse-to-fine" 范式一致的 $L$ 层层次设计,每层 $l$($1 \le l \le L$)处理上一层的残差并输出一个码字。
码本初始化:每个量化层 $l$ 维护一个码本 $C^l = \{c_1^l, c_2^l, \dots, c_M^l\} \in \mathbb{R}^{d \times M}$,$M$ 为每层码字数(各层固定相同以简化)。R3-VAE 通过语义聚类初始化 $C^l$:先对训练集的初始残差 $e^{(0)}$ 做 K-Means,把 $C^1$ 设为聚类质心;后续码本 $C^l$($l > 1$)用第 $l-1$ 层残差的质心初始化,以保证与层次语义结构对齐。初始化的影响在 §4.8 有消融。
点积 rating 计算:对来自第 $l-1$ 层的残差 $e^{(l-1)}$,用归一化点积计算它与每个码字 $c_k^l \in C^l$ 的 rating 分数 $s_k^l$。选点积而非欧氏距离,是因为点积衡量的是角度相似度(语义对齐)而非几何邻近度,更贴合推荐相关性:
$$s_k^l = \frac{e^{(l-1)} \cdot c_k^l}{\|e^{(l-1)}\|_2 \times \|c_k^l\|_2} \tag{3}$$
再用 softmax 把分数归一化为概率分布,得到每个码字的 rating 权重 $w_k^l$:
$$w_k^l = \frac{\exp(s_k^l)}{\sum_{k'=1}^{M} \exp(s_{k'}^l)} \tag{4}$$
这里 $w_k^l$ 表示"$c_k^l$ 是 $e^{(l-1)}$ 最优码字"的置信度。与 RQ-VAE 的硬码本查表(不可导)不同,软权重 $w_k^l$ 让梯度得以连续流动——每一步反传都会更新码本中的全部码字,而非只更新被 argmax 选中的那一个,这正是消除码本坍塌的机制所在。
残差更新与码字选择:第 $l$ 层的量化表示 $\hat{e}^{(l)}$ 是码字按 $w_k^l$ 的加权和,下一层残差 $e^{(l)}$ 相应更新:
$$\hat{e}^{(l)} = \sum_{k=1}^{K} w_k^l \cdot c_k^l \tag{5}$$
$$e^{(l)} = e^{(l-1)} - \hat{e}^{(l)} \tag{6}$$
其中 $K$ 是取 top-K 的权重数量。走完全部 $L$ 层后,把每层权重最高的码字索引拼接起来即得到 $x$ 的 SID:
$$\mathrm{SID}(x) = \left[\arg\max_k w_k^1, \arg\max_k w_k^2, \dots, \arg\max_k w_k^L\right] \tag{7}$$
值得注意的是:训练时用的是软加权重构(式 5),推理时导出的 SID 用的是硬 argmax(式 7)。软重构承担梯度传播职责,硬 argmax 承担离散化职责,两者解耦——这也意味着从每层"扣掉"的是所有码字的加权贡献,而不只是胜出码字,下一层看到的是更干净的未解释残差。
3.3 SID 质量指标:Semantic Cohesion 与 Preference Discrimination¶
为绕开代价高昂的下游 GR 验证,本文提出两个可直接量化的 SID 质量指标。二者借鉴了已有工作中的簇有效性评估思路,并适配 GR 场景下 SID 的语义与偏好导向特性。
Semantic Cohesion(SC,语义内聚) 衡量语义一致性:计算同一簇内物品的量化 embedding 与其对应码 embedding 之间的平均余弦相似度。对簇 $G$,令 $q_i$ 为物品 $i \in G$ 的量化 embedding:
$$\mathrm{SC}(G) = \frac{2}{|G|^2 - |G|} \sum_{i,j \in G,\ i \ne j} \frac{q_i \cdot q_j}{\|q_i\| \cdot \|q_j\|} \tag{8}$$
其中 $|G|$ 为簇 $G$ 内物品数。模型整体 SC 是所有簇 $C$ 上 $\mathrm{SC}(G)$ 的平均:
$$\mathrm{SC} = \frac{1}{|C|} \sum_{G \in C} \mathrm{SC}(G) \tag{9}$$
SC 越高,说明同簇内物品的量化 embedding 与码 embedding 越一致,即偏好对齐越强。
Preference Discrimination(PD,偏好区分度) 衡量不同 SID 簇之间偏好模式的差异程度。对两个不相交的簇 $G_a$、$G_b$,其偏好散度由质心向量 $\bar{p}_{G_a}$、$\bar{p}_{G_b}$ 之间的距离刻画,整体 PD 是所有簇对上的平均:
$$\mathrm{PD} = \log\left(\frac{2}{M(M-1)} \sum_{a=1}^{M} \sum_{b=a+1}^{M} e^{-t \cdot \left(1 - \frac{\vec{p}_{g_a} \cdot \vec{p}_{g_b}}{\|\vec{p}_{g_a}\| \cdot \|\vec{p}_{g_b}\|}\right)}\right) \tag{10}$$
其中 $M$ 为 SID 簇总数,文中取 $t = 2$。PD 越低(越负)表示簇间偏好模式越有区分度,下游 GR 的冗余越少。注意 PD 定义中带了 $\log$ 与指数核,是为了让"簇对距离"的聚合可微且数值稳定——这是它能直接作为训练正则项、而 Collision Rate 需要额外后处理策略(如码本均衡)的关键差别。
3.4 模型优化¶
R3-VAE 用"VAE 重构损失(保证 embedding 保真度)+ 指标感知正则(保证 SID 质量)"的混合损失优化。
重构损失:VAE 解码器从最终残差 $e^{(L)}$ 与所有量化表示之和 $\sum_{l=1}^{L}\hat{e}^{(l)}$ 重构输入 embedding $x$,损失为 MSE:
$$\mathcal{L}_{rec} = \|x - \hat{x}\|^2 = \left\|x - \left(\alpha \cdot r + \sum_{l=1}^{L} \hat{e}^{(l)}\right)\right\|^2 \tag{11}$$
注意重构式里显式加回了 $\alpha \cdot r$——参考向量剥离的语义中心分量在解码端被还原,因此参考向量是一条无损的预处理,不牺牲重构保真度。
指标感知正则:为让模型向 SC/PD 对齐,加入一个最大化 SC、最小化 PD 的正则项。令 $\mathrm{SC}_{avg}$、$\mathrm{PD}_{avg}$ 分别为跨簇平均:
$$\mathcal{L}_{metric} = -\mathrm{SC}_{avg} + \mathrm{PD}_{avg} \tag{12}$$
总损失:
$$\mathcal{L}_{total} = \mathcal{L}_{rec} + \lambda \cdot \mathcal{L}_{metric} \tag{13}$$
$\lambda > 0$ 平衡两项,实验中经交叉验证设为 0.01。优化器采用 AdamW,学习率 $5 \times 10^{-4}$,weight decay $1 \times 10^{-5}$。
如 Figure 1 所示,SC loss 把同簇的残差 embedding 拉近,PD loss 把码字 embedding 推开——这是一对"拉近簇内、推远簇间"的对偶约束,直接把评估指标做成了训练目标。
四、实验设置¶
数据集:六个公开推荐数据集——Beauty、Sports、Toys、Clothing(Amazon 系列)、LastFM、ML1M,规模与场景各异以保证泛化性;另加一个来自今日头条(Toutiao)交互日志的大规模工业数据集。
Baselines:
- VQ-VAE:标准向量量化 VAE,用 STE 做梯度近似,无残差分解;
- RQ-VAE 及其变体:层次残差量化 VAE;
- MQ(TokenRec):基于掩码向量的 RQ-VAE;
- OPQ-KMeans:优化乘积量化 + KMeans,通过优化码本正交性降低量化误差;
- KMeans:普通 K-Means 聚类量化;
- R-KMeans(Residual K-Means):以 K-Means 学习码本的 RQ 方法(OneRec / QARM 路线)。
评估指标:分两个视角。下游 GR 性能用统一的 Transformer GR 模型(所有方法一致),以 SID 为输入生成推荐序列,指标为 Recall@K 与 NDCG@K(K = 10, 20, 30);SID 质量用本文提出的 SC(式 9,越高越好)与 PD(式 10,越低越好)。
公平性控制:所有方法配置相同超参数。
五、主要实验结果¶
5.1 公开数据集:Beauty / Sports / Toys¶
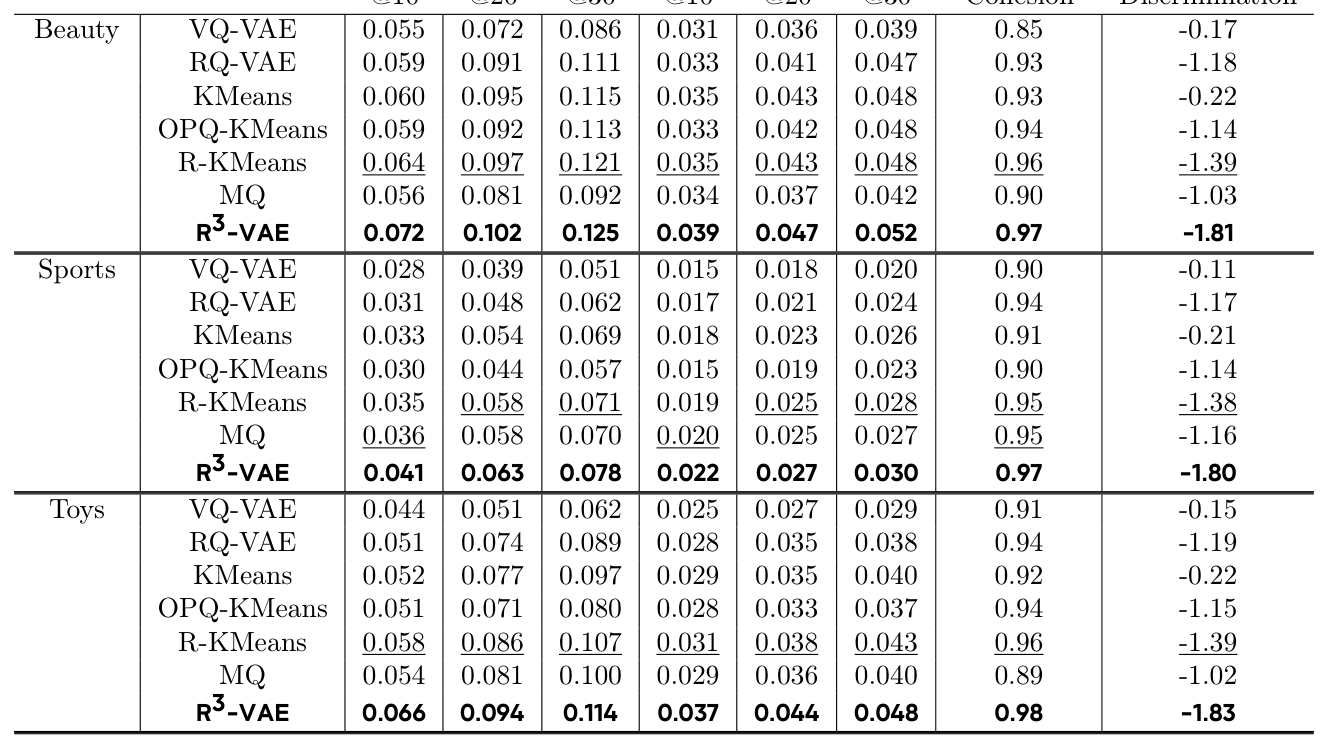
| Dataset | Method | R@10 | R@20 | R@30 | N@10 | N@20 | N@30 | SC ↑ | PD ↓ |
|---|---|---|---|---|---|---|---|---|---|
| Beauty | VQ-VAE | 0.055 | 0.072 | 0.086 | 0.031 | 0.036 | 0.039 | 0.85 | -0.17 |
| Beauty | RQ-VAE | 0.059 | 0.091 | 0.111 | 0.033 | 0.041 | 0.047 | 0.93 | -1.18 |
| Beauty | KMeans | 0.060 | 0.095 | 0.115 | 0.035 | 0.043 | 0.048 | 0.93 | -0.22 |
| Beauty | OPQ-KMeans | 0.059 | 0.092 | 0.113 | 0.033 | 0.042 | 0.048 | 0.94 | -1.14 |
| Beauty | R-KMeans | 0.064 | 0.097 | 0.121 | 0.035 | 0.043 | 0.048 | 0.96 | -1.39 |
| Beauty | MQ | 0.056 | 0.081 | 0.092 | 0.034 | 0.037 | 0.042 | 0.90 | -1.03 |
| Beauty | R3-VAE | 0.072 | 0.102 | 0.125 | 0.039 | 0.047 | 0.052 | 0.97 | -1.81 |
| Sports | VQ-VAE | 0.028 | 0.039 | 0.051 | 0.015 | 0.018 | 0.020 | 0.90 | -0.11 |
| Sports | RQ-VAE | 0.031 | 0.048 | 0.062 | 0.017 | 0.021 | 0.024 | 0.94 | -1.17 |
| Sports | KMeans | 0.033 | 0.054 | 0.069 | 0.018 | 0.023 | 0.026 | 0.91 | -0.21 |
| Sports | OPQ-KMeans | 0.030 | 0.044 | 0.057 | 0.015 | 0.019 | 0.023 | 0.90 | -1.14 |
| Sports | R-KMeans | 0.035 | 0.058 | 0.071 | 0.019 | 0.025 | 0.028 | 0.95 | -1.38 |
| Sports | MQ | 0.036 | 0.058 | 0.070 | 0.020 | 0.025 | 0.027 | 0.95 | -1.16 |
| Sports | R3-VAE | 0.041 | 0.063 | 0.078 | 0.022 | 0.027 | 0.030 | 0.97 | -1.80 |
| Toys | VQ-VAE | 0.044 | 0.051 | 0.062 | 0.025 | 0.027 | 0.029 | 0.91 | -0.15 |
| Toys | RQ-VAE | 0.051 | 0.074 | 0.089 | 0.028 | 0.035 | 0.038 | 0.94 | -1.19 |
| Toys | KMeans | 0.052 | 0.077 | 0.097 | 0.029 | 0.035 | 0.040 | 0.92 | -0.22 |
| Toys | OPQ-KMeans | 0.051 | 0.071 | 0.080 | 0.028 | 0.033 | 0.037 | 0.94 | -1.15 |
| Toys | R-KMeans | 0.058 | 0.086 | 0.107 | 0.031 | 0.038 | 0.043 | 0.96 | -1.39 |
| Toys | MQ | 0.054 | 0.081 | 0.100 | 0.029 | 0.036 | 0.040 | 0.89 | -1.02 |
| Toys | R3-VAE | 0.066 | 0.094 | 0.114 | 0.037 | 0.044 | 0.048 | 0.98 | -1.83 |
结论分析:R3-VAE 在三个数据集的全部指标上一致优于所有 baseline。Beauty 上 Recall@10 = 0.072、NDCG@10 = 0.039,相比该组最强 baseline R-KMeans 分别提升 12.5% 与 11.4%;Sports 上 Recall@10 提升 17.1%、NDCG@10 提升 15.8%;Toys 上 Recall@10 提升 13.8%、NDCG@10 提升 19.4%。
更值得注意的是 SC/PD 与下游指标的同步性:R3-VAE 在三个数据集上同时拿到最高 SC(0.97 / 0.97 / 0.98)与最低 PD(-1.81 / -1.80 / -1.83)。反过来看,SC 与 PD 单独都不足以预测下游表现——KMeans 的 SC 与 RQ-VAE 持平(Beauty 上都是 0.93)但 PD 差得多(-0.22 vs -1.18),而其 Recall@10 反而略高;这说明两个指标是互补的、需要联合看,也解释了为什么 §5.4 要专门做相关性分析。
5.2 公开数据集:LastFM / ML1M / Clothing¶
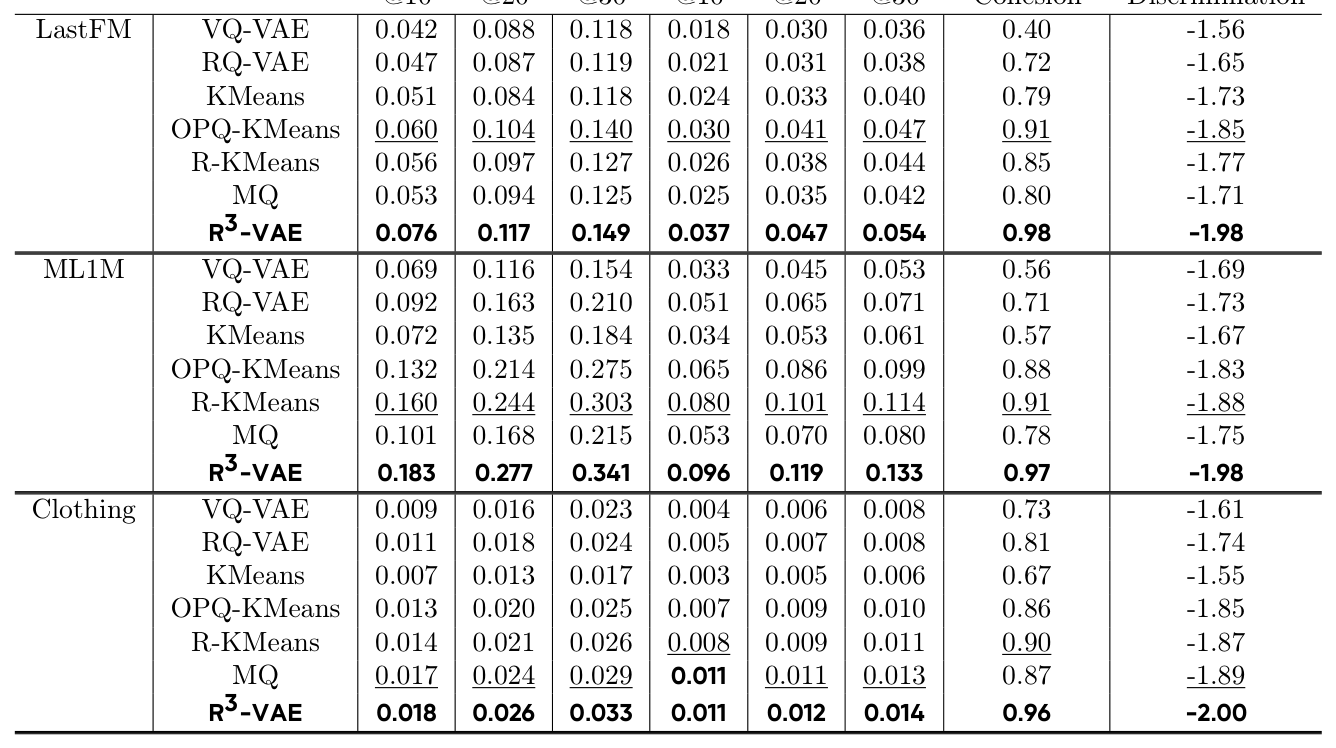
| Dataset | Method | R@10 | R@20 | R@30 | N@10 | N@20 | N@30 | SC ↑ | PD ↓ |
|---|---|---|---|---|---|---|---|---|---|
| LastFM | VQ-VAE | 0.042 | 0.088 | 0.118 | 0.018 | 0.030 | 0.036 | 0.40 | -1.56 |
| LastFM | RQ-VAE | 0.047 | 0.087 | 0.119 | 0.021 | 0.031 | 0.038 | 0.72 | -1.65 |
| LastFM | KMeans | 0.051 | 0.084 | 0.118 | 0.024 | 0.033 | 0.040 | 0.79 | -1.73 |
| LastFM | OPQ-KMeans | 0.060 | 0.104 | 0.140 | 0.030 | 0.041 | 0.047 | 0.91 | -1.85 |
| LastFM | R-KMeans | 0.056 | 0.097 | 0.127 | 0.026 | 0.038 | 0.044 | 0.85 | -1.77 |
| LastFM | MQ | 0.053 | 0.094 | 0.125 | 0.025 | 0.035 | 0.042 | 0.80 | -1.71 |
| LastFM | R3-VAE | 0.076 | 0.117 | 0.149 | 0.037 | 0.047 | 0.054 | 0.98 | -1.98 |
| ML1M | VQ-VAE | 0.069 | 0.116 | 0.154 | 0.033 | 0.045 | 0.053 | 0.56 | -1.69 |
| ML1M | RQ-VAE | 0.092 | 0.163 | 0.210 | 0.051 | 0.065 | 0.071 | 0.71 | -1.73 |
| ML1M | KMeans | 0.072 | 0.135 | 0.184 | 0.034 | 0.053 | 0.061 | 0.57 | -1.67 |
| ML1M | OPQ-KMeans | 0.132 | 0.214 | 0.275 | 0.065 | 0.086 | 0.099 | 0.88 | -1.83 |
| ML1M | R-KMeans | 0.160 | 0.244 | 0.303 | 0.080 | 0.101 | 0.114 | 0.91 | -1.88 |
| ML1M | MQ | 0.101 | 0.168 | 0.215 | 0.053 | 0.070 | 0.080 | 0.78 | -1.75 |
| ML1M | R3-VAE | 0.183 | 0.277 | 0.341 | 0.096 | 0.119 | 0.133 | 0.97 | -1.98 |
| Clothing | VQ-VAE | 0.009 | 0.016 | 0.023 | 0.004 | 0.006 | 0.008 | 0.73 | -1.61 |
| Clothing | RQ-VAE | 0.011 | 0.018 | 0.024 | 0.005 | 0.007 | 0.008 | 0.81 | -1.74 |
| Clothing | KMeans | 0.007 | 0.013 | 0.017 | 0.003 | 0.005 | 0.006 | 0.67 | -1.55 |
| Clothing | OPQ-KMeans | 0.013 | 0.020 | 0.025 | 0.007 | 0.009 | 0.010 | 0.86 | -1.85 |
| Clothing | R-KMeans | 0.014 | 0.021 | 0.026 | 0.008 | 0.009 | 0.011 | 0.90 | -1.87 |
| Clothing | MQ | 0.017 | 0.024 | 0.029 | 0.011 | 0.011 | 0.013 | 0.87 | -1.89 |
| Clothing | R3-VAE | 0.018 | 0.026 | 0.033 | 0.011 | 0.012 | 0.014 | 0.96 | -2.00 |
结论分析:LastFM 上 R3-VAE 的 Recall@10 = 0.076、NDCG@10 = 0.037,相比该数据集最强 baseline OPQ-KMeans 分别领先 26.7% 与 23.3%;ML1M 上相比 R-KMeans 领先 14.4%(Recall@10)与 20.0%(NDCG@10);Clothing 上超过 MQ。
一个有意思的现象是最强 baseline 会随数据集切换:Beauty/Sports/Toys/ML1M 上是 R-KMeans,LastFM 上是 OPQ-KMeans,Clothing 上是 MQ。这恰恰印证了论文的动机——现有方法对数据分布与初始化敏感、缺乏稳定性,而 R3-VAE 是唯一在六个数据集上都占据第一的方法。另外可以观察到 baseline 之间 SC 的方差在 LastFM/ML1M 上极大(0.40~0.91),而 R3-VAE 稳定在 0.96~0.98,说明参考向量 + rating 机制在稀疏/小规模数据上对初始化的鲁棒性收益更大。
5.3 工业数据集上的生成式推荐¶
实现细节:整体框架遵循 OneRec。码本规模 8192 × 8192 × 8192(三层)。优化器 AdamW,初始学习率 $2 \times 10^{-4}$,全部实验在 64 张 NVIDIA A100 上完成。生成配置上 rDPO 设为 5%,beam search 生成的候选数为 512。用户历史行为特征包括用户画像、实时点击序列、实时曝光序列与近期点击序列。受资源限制,只与两个主流工业 baseline(RQ-VAE 与 R-KMeans)对比。
离线评估用 MRR(Mean Reciprocal Rank):
| Method | MRR ↑ | StayTime/U ↑ | LongStay/U ↑ |
|---|---|---|---|
| RQ-VAE | 0.605 | 2630 | 25.20 |
| R-KMeans | 0.618 | 2650 | 25.28 |
| R3-VAE | 0.628 (+1.62%) | 2672 (+0.83%) | 25.35 (+0.28%) |
结论分析:R3-VAE 离线 MRR 达 0.628,相比 RQ-VAE(0.605)提升 3.80%,相比 R-KMeans(0.618)提升 1.62%。线上 A/B 评估两个用户参与度指标:StayTime/U(用户日均总停留时长)与 LongStay/U(用户日均停留超过 10 秒的文档数)。R3-VAE 的 StayTime/U 为 2672 秒,比 RQ-VAE(2630 秒)高 1.60%、比 R-KMeans(2650 秒)高 0.83%;LongStay/U 达 25.35,分别领先 0.60% 与 0.28%。这说明离线的 SID 质量提升确实转化成了可测量的业务价值。
需要指出的是,线上相对提升的量级(0.28%~1.62%)远小于公开数据集上的 12%~27%。这符合工业系统的常识——线上系统本身已经高度优化,且 SID 只是 GR 全链路中的一个模块,但在头条这样体量的系统上,0.83% 的停留时长已经是显著收益。
5.4 工业数据集上的判别式推荐(CTR)¶
为验证 R3-VAE 在判别式场景的泛化能力,作者在同一工业数据集上用 SID 替换 CTR 模型的物品 ID embedding。
实现细节:码本规模同样 8192 × 8192 × 8192。框架遵循 DIN + SIM + RankMixer。优化器 RMSPropV2,batch size 2048,初始学习率 $1 \times 10^{-3}$,使用最近 60 条用户点击序列作为历史行为特征。
离线评估用 UAUC(User AUC):
| Method | UAUC ↑ | SC ↑ | PD ↓ | Collision Rate ↓ | Gini ↓ |
|---|---|---|---|---|---|
| RQ-VAE | 0.6538 | 0.76 | -1.950 | 1.271 | 0.0815 |
| OPQ-KMeans | 0.6571 | 0.85 | -1.975 | 1.070 | 0.0692 |
| R-KMeans | 0.6577 | 0.92 | -1.985 | 1.039 | 0.0366 |
| MQ | 0.6553 | 0.91 | -1.960 | 1.037 | 0.0348 |
| R3-VAE | 0.6669 | 0.94 | -1.980 | 1.033 | 0.0314 |
R3-VAE 取得最高 UAUC(0.6669),且同时具备最优的 SID 质量组合(最高 SC = 0.94、最低 CR = 1.033、最小 Gini = 0.0314)。唯一的例外是 PD:R-KMeans 的 -1.985 略优于 R3-VAE 的 -1.980,但其 UAUC 低了 0.92pp。这个反例说明 PD 单独并非充分条件,SC 与 PD 需要联合优化——也侧面支持了式 (12) 把两者同时放进正则项的设计。
线上 A/B:以 StayDuration/U(人均停留时长,SD/U)与冷启内容点击量(Cold-Start Click Volume,即曝光量低于 512 的内容的点击量,CS Click)为关键指标,分老用户(Existing)与新用户(New)看:
| Method | Existing SD/U ↑ | Existing CS Click ↑ | New SD/U ↑ | New CS Click ↑ |
|---|---|---|---|---|
| RQ-VAE | 37680 | 8224 | 5039 | 1441 |
| R-KMeans | 37696 | 8335 | 5057 | 1510 |
| R3-VAE | 37737 (+0.11%) | 8690 (+4.26%) | 5090 (+0.65%) | 1742 (+15.36%) |
结论分析:相比 R-KMeans,R3-VAE 让老/新用户 StayDuration/U 分别提升 0.11% 与 0.65%,冷启内容点击量分别提升 4.26% 与 15.36%。冷启收益远大于整体停留时长收益,这完全符合 SID 的机制预期——SID 的核心价值就在于让新物品可以借助语义近邻共享统计强度,因此对没有历史交互的冷启内容增益最大;新用户组增益又大于老用户组,因为老用户已有充足的协同信号可依赖。论文表示 R3-VAE 目前已全量部署到生产服务。
5.5 SID 指标与下游表现的相关性分析¶
这是论文验证第二项贡献(SC/PD 作为廉价代理指标)的关键实验。作者对 SID 指标(本文的 SC、PD,以及 Collision Rate、Gini 系数)与 UAUC(判别式核心指标)或 Recall@10(GR 核心指标)做 Spearman 秩相关分析。
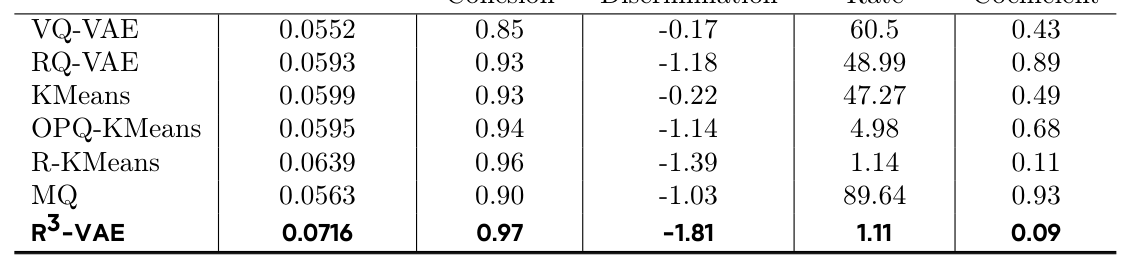
Beauty 上的完整对照(Table 6,四位小数):
| Method | Recall@10 ↑ | SC ↑ | PD ↓ | Collision Rate ↓ | Gini ↓ |
|---|---|---|---|---|---|
| VQ-VAE | 0.0552 | 0.85 | -0.17 | 60.5 | 0.43 |
| RQ-VAE | 0.0593 | 0.93 | -1.18 | 48.99 | 0.89 |
| KMeans | 0.0599 | 0.93 | -0.22 | 47.27 | 0.49 |
| OPQ-KMeans | 0.0595 | 0.94 | -1.14 | 4.98 | 0.68 |
| R-KMeans | 0.0639 | 0.96 | -1.39 | 1.14 | 0.11 |
| MQ | 0.0563 | 0.90 | -1.03 | 89.64 | 0.93 |
| R3-VAE | 0.0716 | 0.97 | -1.81 | 1.11 | 0.09 |
Spearman 相关系数(Table 7):
| Metric | 与 UAUC 的相关性 | 与 Recall@10 的相关性 |
|---|---|---|
| Semantic Cohesion | 0.90 | 0.94 |
| Preference Discrimination | -0.90 | -0.75 |
| Collision Rate | -0.70 | -0.93 |
| Gini Coefficient | -0.70 | -0.64 |
结论分析:
- SC 与 UAUC($\rho = 0.90$)和 Recall@10($\rho = 0.94$)都强正相关,说明簇内语义一致性对推荐准确率的提升是跨场景普适的;
- PD 与两者都强负相关(UAUC $\rho = -0.90$;Recall@10 $\rho = -0.75$)。PD 越负表示簇间偏好散度越大,越有助于区分用户偏好;
- Collision Rate 与 Recall@10 强负相关($\rho = -0.93$)但与 UAUC 仅中等相关($\rho = -0.70$)。碰撞率低意味着 SID 碰撞少、检索歧义小,这一效应在公开数据集的生成式检索任务上更显著;
- Gini 系数(码本不均衡度)与两者都只有中等负相关(-0.70 / -0.64),说明相较 SC、PD、CR 它对下游表现的影响相对有限。
因此结论是分场景的:SC 与 PD 是工业判别式推荐更有效的 SID 质量代理,SC 与 CR 则与公开数据集上的生成式检索表现关联更强。但论文最终从工程可行性角度选择 SC 与 PD 作为核心优化目标——因为 PD 可以直接端到端优化,而 CR 通常需要额外的后处理策略(如码本均衡策略)才能改善。而 R3-VAE 在工业与公开数据集上都取得了这几个关键指标的最优组合,这解释了它对 baseline 的一致优势。
六、消融与分析¶
6.1 关键组件消融¶
在 Beauty 上评估四个消融变体:w/o Reference Vector(去掉参考向量投影层,初始残差 $e^{(0)} = x$);w/o Rating Quantization(用 STE 替换点积 rating 机制,等同 RQ-VAE 的梯度近似);w/o SC Regularization 与 w/o PD Regularization(分别去掉对应正则项)。
| Method | R@10 | R@20 | R@30 | N@10 | N@20 | N@30 | SC ↑ | PD ↓ |
|---|---|---|---|---|---|---|---|---|
| R3-VAE (Full) | 0.0716 | 0.1025 | 0.1250 | 0.0393 | 0.0470 | 0.0518 | 0.97 | -1.81 |
| w/o Reference Vector | 0.0642 | 0.0975 | 0.1211 | 0.0357 | 0.0437 | 0.0486 | 0.94 | -1.73 |
| w/o Rating Quantization | 0.0640 | 0.0968 | 0.1201 | 0.0351 | 0.0434 | 0.0478 | 0.90 | -1.78 |
| w/o SC Regularization | 0.0652 | 0.0988 | 0.1217 | 0.0369 | 0.0451 | 0.0490 | 0.90 | -1.85 |
| w/o PD Regularization | 0.0647 | 0.0981 | 0.1214 | 0.0367 | 0.0440 | 0.0487 | 0.96 | -1.56 |
结论分析:
- 去掉参考向量投影层:Recall@10 下降 10.3%、NDCG@10 下降 9.2%,验证了它在缓解初始化敏感性、把残差与语义结构对齐上的作用;
- 用 STE 替换 rating 量化模块:NDCG@10 下降 10.6%,且 SC 从 0.97 掉到 0.90(四个变体中降幅最大),验证了 rating 机制对梯度保留的价值——梯度只回传给胜出码字直接损害了簇内语义一致性;
- 去掉 SC/PD 正则:都会削弱下游 GR 表现。有意思的是这两项呈现清晰的定向效应:去掉 SC 正则时 SC 掉到 0.90 而 PD 反而更优(-1.85);去掉 PD 正则时 PD 退化到 -1.56 而 SC 保持 0.96。这说明两个正则项各自精确地控制了对应指标,且两者之间存在轻微的此消彼长关系——把簇间推得更开会牺牲一点簇内内聚,反之亦然。而全量模型在两者上取得的是联合最优的折中(0.97 / -1.81),下游表现也最好,从机制上支持了必须联合优化的结论。
6.2 正则权重 $\lambda$¶
固定 $L = 3$、$K = 256$,扫描 $\lambda$ 从 0.001 到 0.1:
| $\lambda$ | Recall@10 ↑ | NDCG@10 ↑ | SC ↑ | PD ↓ |
|---|---|---|---|---|
| 0.001 | 0.0656 | 0.0371 | 0.96 | -1.79 |
| 0.01 | 0.0716 | 0.0393 | 0.97 | -1.81 |
| 0.1 | 0.0669 | 0.0373 | 0.95 | -1.87 |
$\lambda = 0.01$ 是该场景下的最优选择。曲线呈明显的倒 U 形:$\lambda$ 太小则正则约束不足,SID 质量未被充分引导;$\lambda$ 太大则指标正则开始压过重构损失——注意 $\lambda = 0.1$ 时 PD 达到全场最优的 -1.87,但 SC 反而降到 0.95、Recall@10 掉回 0.0669。这是一个重要的警示:过度优化代理指标会脱离重构保真度这一根本目标,代理指标终究只是代理。
七、定性分析与训练稳定性¶
7.1 可视化分析¶
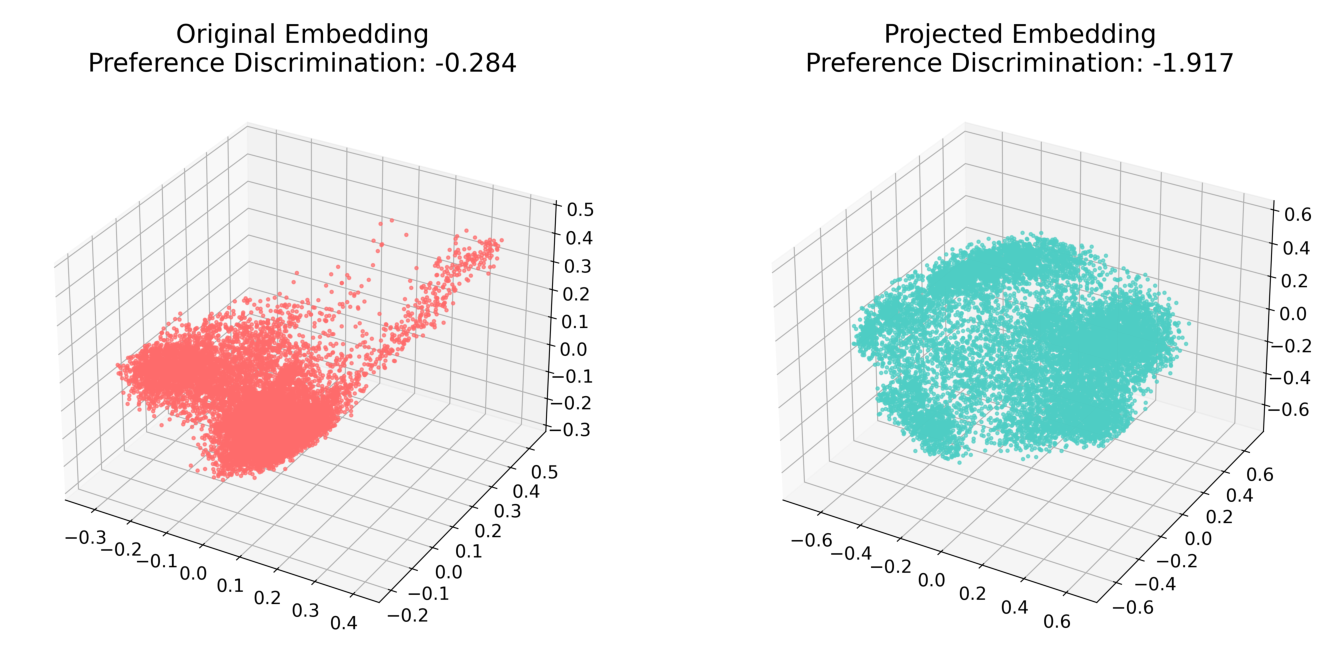
球面分布(Spherical Distribution):Figure 2 对比投影前后 embedding 的 3D PCA。原始 embedding 呈紧凑聚集分布(集中在 PCA 空间的一小块子区域),限制了簇的可区分性——相似点过度聚集,使聚类算法难以区分不同组。投影后的 embedding 在空间上更分散(覆盖更宽的 PCA 范围)同时保持结构一致性。这一分散正符合参考向量投影层的设计目标:扩张 embedding 空间以增强簇间可分性,这是有效聚类的关键前提。
偏好区分角度分布:用 2D 环形投影(Figure 3),点按角度位置(弧度)着色以反映分布展开程度。原始 embedding(左)的 preference discrimination 分数为 -0.284,点高度集中在狭窄的角度区间(红/黄区域主导),重叠严重。投影后(右)该分数降至 -1.917,点均匀分布在所有角度区域(覆盖红、黄、绿、蓝、紫各区)。这一分散确保不同簇的 embedding 占据互不重叠的子空间,直接促成准确的簇分配。
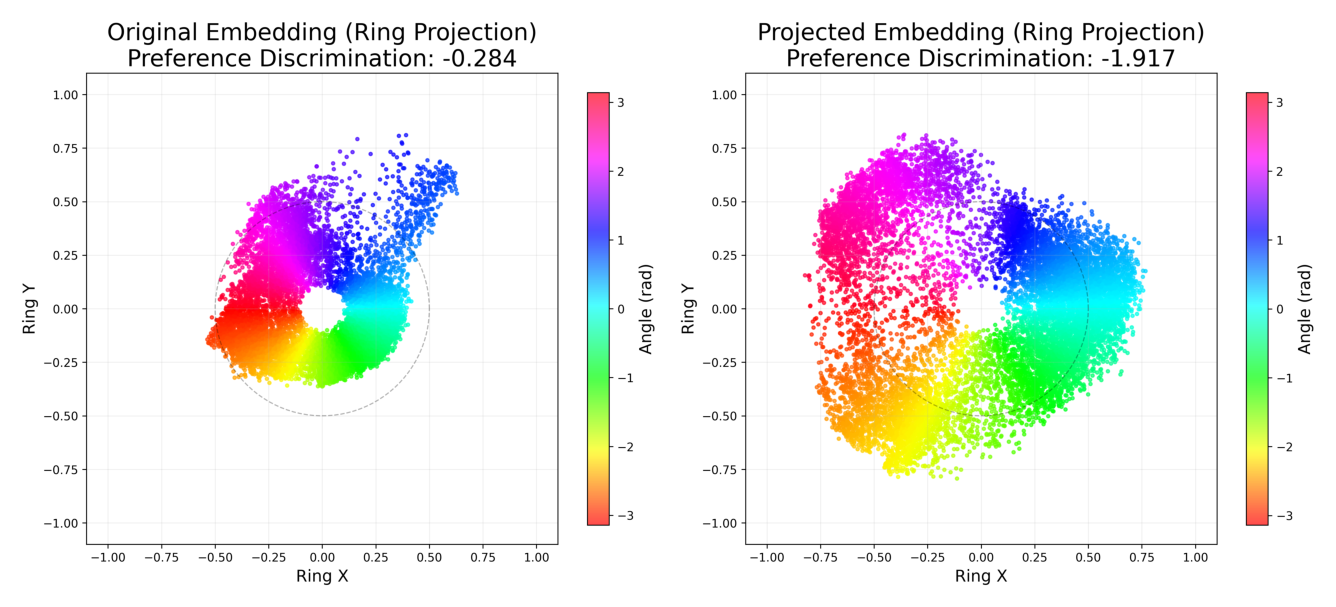
两张图共同说明:参考向量投影层把 embedding 从"紧凑重叠"变成"分散且利于聚类"的分布,通过扩张空间与增强簇间可分性,为下游聚类奠定稳健基础。
7.2 训练稳定性分析¶
对比 R3-VAE 与 RQ-VAE(分别带/不带 K-Means 初始化)在训练过程中的重构损失与码本使用率曲线。
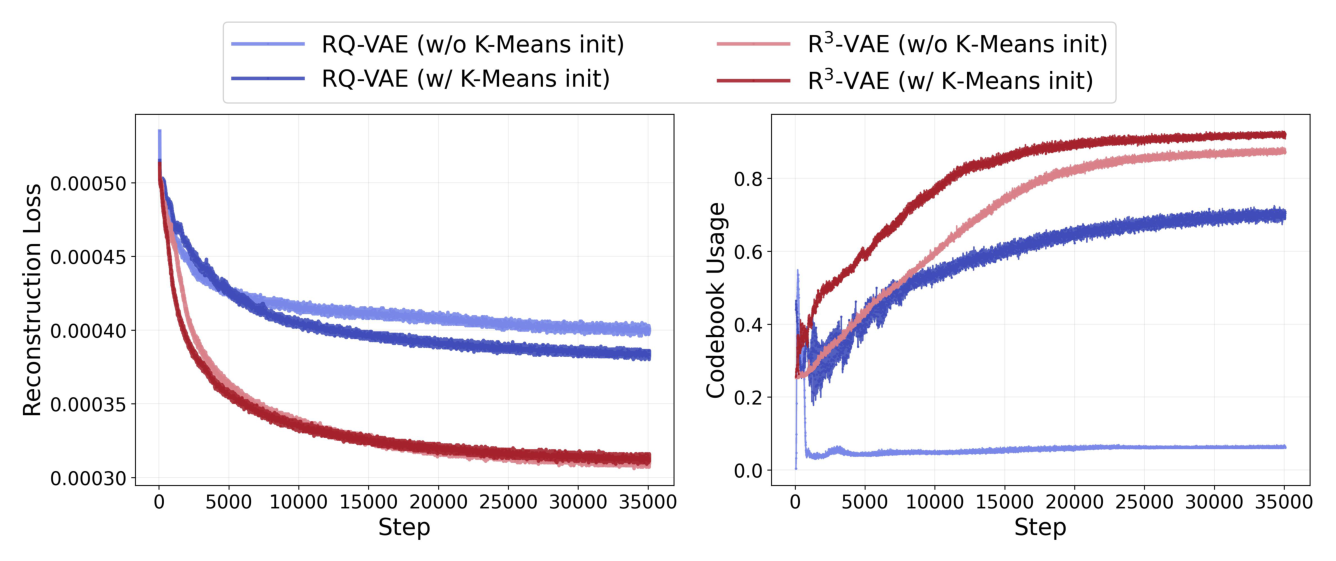
重构损失行为(左图):R3-VAE 无论有无 K-Means 初始化都表现出一致的快速收敛,且两种初始化策略之间的 loss 差距很小。相比之下,RQ-VAE 在不同初始化设置间呈现明显的性能差异。这说明 R3-VAE 的训练过程对初始化选择鲁棒,避免了困扰传统 RQ 方法的敏感性。RQ-VAE 即便带 K-Means 初始化,loss 波动也更大,最终 loss(0.00038)比 R3-VAE 高 19%。
码本使用率行为(右图):R3-VAE 在约 20,000 步后达到接近满额的码本使用率并在训练全程保持稳定;RQ-VAE 带 K-Means 初始化只能到 0.7;RQ-VAE 不带 K-Means 初始化则遭遇严重码本坍塌,使用率跌到 0.05 并长期停滞。
这张图是全文最有说服力的证据:同一个 RQ-VAE,仅仅换一个初始化就在 0.7 与 0.05 之间摆动,而 R3-VAE 的两条曲线几乎重合——初始化敏感性被真正消除了。需要如实指出,正文称 R3-VAE 达到"接近 1.0"的码本使用率,但从图上读数看两条红色曲线最终稳定在约 0.87~0.92,"approaching 1.0"是略微乐观的表述;不过 0.9 vs 0.7 vs 0.05 的量级差异结论不受影响。
八、核心贡献总结¶
- 诊断精准:把 SID 生成的问题拆成两个可分别攻击的 root cause——STE 的有偏梯度导致码本坍塌、K-Means 路线的初始化敏感;以及 SID 质量评估必须依赖昂贵下游验证。这两点都是工业 GR 迭代中的真实痛点。
- 参考向量作为语义锚点:用一个可学习标量投影把"全局语义中心"从量化任务中剥离,重构时无损加回,让码本只负责表达个体差异。这是一个成本极低(一个 $d$ 维向量)但收益明确(Recall@10 +10.3%)的设计。
- 点积 rating 取代 STE:用 softmax 软权重的加权码字和做残差扣除,让梯度流向整个码本而非单一胜出码字,同时保留 RQ 的层次结构与硬 argmax 的离散化能力。码本使用率从 0.05~0.7 提升到约 0.9。
- 把评估指标变成训练目标:SC/PD 既是可微正则项也是廉价代理指标,Spearman $\rho$ 分别达 0.94(GR)与 0.90(CTR),显著优于 Collision Rate 与 Gini。这解决了"改一次量化器就要跑一遍全链路"的迭代效率问题。
- 完整的工业验证闭环:六个公开数据集 + 今日头条 GR 与 CTR 双场景 + 线上 A/B + 全量部署 + 开源代码。冷启内容点击量新用户 +15.36% 是最亮眼的业务数字。
九、与已归档相关工作的对比¶
本文投稿于 2026-04-13(v1)。归档中 SID / RQ-VAE 谱系论文数量很多,但绝大多数发表于本文之后——它们不可能被本文引用,这属于时序使然而非"本文遗漏"。下面三篇按发表时间与本文的先后关系分别说明。
Semantic IDs for Recommender Systems at Snapchat: Use Cases, Technical Challenges, and Design Choices Semantic IDs for Recommender Systems at Snapchat: Use Cases, Technical Challenges, and Design Choices (Snap Inc., 2026-04-05)¶
关系:独立并发(早于本文 8 天,本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文对 root cause 的诊断几乎逐字重合。Snap 把 Challenge 1 直接命名为 "Codebook Collapse",归因为"量化使用 arg max,梯度仅回传到被选中的 centroid;稀疏更新导致对初始化状态高度依赖,频繁导致大量 centroid 从未被选中"——这与本文摘要中的"insufficient gradient propagation through the straight-through estimator and sensitivity to initialization"是同一件事的两种表述。
- 相近的技术骨架:Snap 的解法是改写重构公式,通过 STE 加入 $\mathrm{sim}(\mathbf{h}_i^l, C_l) \cdot C_l - \mathrm{sg}[\mathrm{sim}(\mathbf{h}_i^l, C_l) \cdot C_l]$ 这一项,其中 $\mathrm{sim}$ 是残差与该层全部 centroid 的余弦相似度——即"用相似度加权的全码本项开一条梯度旁路,让 loss 反传到所有 code"。本文式 (3)(4)(5) 的 rating 机制在做同一件事:归一化点积(即余弦)打分 → softmax → 全码本加权和。两者都选了余弦/角度相似度而非欧氏距离,也都保留硬 argmax 用于导出离散 SID。
- 本文的差异与推进:(i) Snap 仍把软相似度项挂在 STE 框架内作为梯度旁路,量化主路径依然是 argmax 查表;本文则把加权和 $\hat{e}^{(l)}$ 直接当作该层的量化表示并用它更新残差(式 6),彻底移除了 STE,因此下一层看到的是扣掉全部部分一致性后的残差。(ii) Snap 的第二条解法是多模态 embedding 融合——靠提高输入方差"逼"码本铺开流形,是数据侧手段;本文的参考向量投影是表示侧手段,靠剥离语义中心扩张分布,Figure 2/3 的 PCA 与环形投影可视化正是在证明这一点。(iii) 本文额外提出 SC/PD 指标并做成训练正则,Snap 只在 §4.3 讨论了"Uniqueness 是否为 SID 质量金标准",停留在评估层面未做端到端优化。
- 可比的方法 / 实验差异:Snap 的第二个挑战是 SID-to-Item Resolution(碰撞后如何落到具体物品),用启发式簇内消歧 + "depth over breadth" 的检索策略解决;本文完全没有处理这个问题,只是把 Collision Rate 作为对照指标报告(工业集上 R3-VAE 的 CR = 1.033,已接近 1,说明碰撞并不严重)。实验上两者不可直接比较:Snap 是纯工业实践报告(Snapchat 排序辅助特征 + 生成式检索),无公开数据集数字;本文有六个公开 benchmark 加今日头条工业验证。
CapsID CapsID: Soft-Routed Variable-Length Semantic IDs for Generative Recommendation (2026-05-06)¶
关系:后续独立工作(晚于本文 23 天,双方均未互相引用,解法骨架高度重合)· 已加载对方精读
时序说明:CapsID 发表于本文 v1 之后 23 天,本文不可能引用它;本文 v3 修订于 2026-05-06,与 CapsID 同日,也不存在引用窗口。两者应视为同一时间窗内独立形成的同构方案。
- 共同关注的问题:CapsID 把矛头精确对准"分配算子"——它明确指出 TIGER / LETTER / ReSID 等 tokenizer-centric 方法"都保留了残差量化的硬最近邻分配这一步,而这正是本文要替换掉的关键算子"。这与本文替换 STE 硬查表的出发点完全一致。CapsID 还提出"量化前先表达不确定性"的不变式:不确定性必须在离散化之前被建模,一旦塌陷为错误 token 就无法挽回——这正是本文用 softmax 置信度 $w_k^l$ 而非 argmax 参与残差更新的理由。
- 相近的技术骨架:CapsID 的残差更新式 $\mathbf{r}_{i,\ell} = \mathbf{r}_{i,\ell-1} - \sum_k c^{(T)}_{i,\ell k}\mathbf{o}^{(T)}_{i,\ell k}$ 与本文的式 (5)(6) 是同一个算子:都用路由/rating 权重对全部码字(capsule)加权求和,再从残差中整体扣除,而非只扣掉胜出者。CapsID 自己的原话是"不再扔掉非胜出 capsule 与残差的部分一致性,而是把所有部分一致性扣除掉,只把真正未解释的部分流向下一层"——这句话同样精确描述了本文的机制。两者也都保留 argmax 用于 emit 离散 token(CapsID 式 6 vs 本文式 7)。
- 本文的差异与推进:(i) 权重来源不同——本文的 $w_k^l$ 由一次归一化点积 + softmax 得到(式 3、4),CapsID 用 capsule 的 $T=3$ 轮迭代动态路由(带 squash 非线性与 agreement logits 累加),计算更重但能自纠。(ii) 本文的码字是纯 embedding 向量,CapsID 的 capsule 带 pose 变换 $\mathbf{W}_{\ell k}$ 与偏置,参数量更大。(iii) CapsID 走向变长 SID(置信度驱动早停 + SemanticBPE 子词合并),本文保持定长三层(工业上是 8192³)。(iv) 反过来,本文有 CapsID 没有的两样东西:参考向量的初始残差语义锚定,以及 SC/PD 这套可优化的质量指标。CapsID 的 $\mathcal{L}_{\text{spread}}$ 在功能上与本文的 PD 正则接近(都在推开码字),但它没有把指标本身立为可对外报告的评估工具。
- 可比的方法 / 实验差异:两者的公开数据集重叠在 Amazon 系列上,CapsID 报告 R@10 相对最强 baseline 提升 8.9%~11.0%,本文在 Beauty/Sports/Toys 上相对 R-KMeans 提升 12.5%/17.1%/13.8%——数量级相近,但两者 baseline 集合与 GR 骨干不同(CapsID 用 SASRec / T5-base,本文用统一 Transformer GR 模型),不可直接横比。工业侧 CapsID 是 35M 目录的离线评估,本文有真实线上 A/B 与全量部署,工业验证更完整。
DRQ Decoupled Residual Quantization for Robust Semantic IDs in Recommendation (Shopee, 2026-06-01)¶
关系:后续独立工作(晚于本文 7 周,双方均未互相引用)· 已加载对方精读
时序说明:DRQ 发表于本文 v1 之后约 7 周,时序上本文不可能引用它。
- 共同关注的问题:DRQ 与本文是归档中唯二明确把"SID 质量需要一套廉价可量化的诊断指标"当作独立贡献来做的论文。DRQ 对码本坍塌的归因与本文一致:"梯度只通过被激活的码字经 STE 流动;对长尾数据,热门物品主导这些更新,把质心拉向稠密码、让很多码欠训练",并指出现有系统"通常把 tokenizer 当作黑盒,因而不直接测量 tokenizer 的几何与码使用如何影响下游检索质量"——这正是本文所说的"必须跑完整下游训练才能评估 SID"的另一种说法。
- 相近的技术骨架:两篇都提出一对互补指标去分解 SID 退化。DRQ 定义 Expected Overlap Rate $O_\pi$ 并拆成 Distribution Penalty($\sum_i \pi_i^2$,码字使用分布是否集中)与 Geometry Penalty(码字间距离核,几何是否分离),再定义 Effective Codebook Size $K_{\text{eff}} = 1/O_\pi$。本文的 SC(簇内一致性)与 PD(簇间分离度)在结构上是同一分解的另一种取角:PD 与 DRQ 的 Geometry Penalty 都在度量"码字/簇是否推得够开",且都用了指数核(DRQ 用 $\exp(-\|c_i-c_j\|^2/4\sigma^2)$,本文式 10 用 $e^{-t(1-\cos)}$)。
- 本文的差异与推进:(i) 最根本的分歧在指标的用途——本文把 SC/PD 做成可微正则项塞进式 (13) 端到端优化,DRQ 的 $O_\pi$/$K_{\text{eff}}$ 只是诊断工具,不参与训练。(ii) 解法方向相反:面对 STE 的梯度病,本文选择保住端到端、只把 STE 换成软 rating;DRQ 选择彻底解耦,先用无量化的 VAE 做连续重塑(式 3,无 STE 无 commitment loss),冻结后再用 RQ-KMeans 做离散匹配。DRQ 认为"强迫连续表示贴到刚性网格上限制了 embedding 能散开多远";本文则用参考向量投影在保持端到端的前提下扩张分布(Figure 2/3)。(iii) 相关性验证方式不同:本文用 Spearman $\rho$ 直接量化 SC/PD 与 UAUC/Recall@10 的秩相关(0.90/0.94),DRQ 只做理论推导 + 工业案例的诊断展示,没有给出指标与下游表现的相关系数。
- 可比的方法 / 实验差异:DRQ 的实验全部在 Shopee 专有短视频数据集(1500 万物品,$K=4096$、$L=3$)上,作者自己声明应视为工业案例研究而非通用 benchmark;本文有六个公开数据集加今日头条工业验证。两者码本配置也不同(本文工业侧 8192³)。指标口径完全不同,无法直接比较数值。
Step 2.5 剔除的近似候选:CRAB(CRAB,Walmart,2026-04-06,早于本文 7 天且未被引用)表层看也在处理"码本不均衡",但 root cause 是流行度偏差放大与曝光公平性,解法是训练后 post-hoc 拆分过热 token + LLM embedding 层次语义对齐,完全不触碰量化器的梯度路径与初始化,方法流程图与本文不重合;QuaSID(QuaSID,2026-02-28,早于本文且未被引用)解决的是 SID 碰撞的有害/良性判定,HaMR + CVPM 是碰撞层面的正则,不针对 STE 梯度与码本坍塌;CARD(CARD,2026-04-29)虽然也在残差量化前插入可学习变换(Kumaraswamy CDF),与参考向量投影形似,但其问题陈述是多模态卡片渲染与视觉语义单元,主线在模态融合;GTI(GTI,2026-04-02)的 root cause 确实是"初始化坍塌到退化子空间",但场景是 LLM 扩词表新 token 的 mean 初始化,解法是语言学接地,与残差量化码本无关;FORGE(FORGE)被本文引用(Gini 系数出处),但它是工业 SID benchmark 与工程实践报告,属引文/对照关系,交由 DAG 结构化处理。
十、讨论与局限性¶
值得借鉴的设计:
- "剥离共性、只量化差异"是一个可迁移的模式。参考向量的本质是让码本不必浪费容量去编码全局均值。这个思路对任何"表示先验高度集中"的量化任务都成立——DRQ 描述的 cone effect(原始多模态 embedding 挤在狭窄锥形区域)正是同一现象,本文用一个 $d$ 维可学习向量就把它缓解了,成本几乎为零。
- 软权重训练 + 硬 argmax 推理的解耦在工业上非常实用:训练期享受连续梯度,推理期仍产出标准的定长离散 SID,下游 GR 系统、trie 约束 beam search、SID 存储格式全部无需改动,是一个真正 drop-in 的替换。
- 把评估指标做成可微正则项是本文最有方法论价值的一点。它同时回答了两个问题:怎么快速判断 SID 好坏(代理指标),以及怎么让 SID 变好(正则项)。Spearman 相关性实验为"代理"这一主张提供了可核验的证据,而不是空口宣称。
局限与争议:
- 计算复杂度未讨论。式 (4) 的 softmax 要遍历整层全部 $M$ 个码字,工业配置下 $M = 8192$,相比 argmax(可用 ANN 加速)是显著更重的操作,而论文对 tokenizer 的训练/推理开销一字未提。式 (5) 中 $K$ 被说明为 "top-K 权重",但全文没有给出 $K$ 的取值,也没有 $K$ 的消融,与式 (4) 的全码本 softmax 之间关系交代不清——这是方法描述上一个实质性的缺口。
- 参考向量只有一个。用单个全局向量表示"整个数据集的语义中心",在多类目、多场景的工业目录上是否够用值得怀疑;论文没有做多参考向量或分层参考向量的探索。
- 指标的自证循环风险。SC/PD 既是训练目标又是评估指标,那么"R3-VAE 的 SC/PD 最优"就近乎同义反复——真正有信息量的是 Spearman 相关性实验,但该实验只用了 Table 4 / Table 6 中约 5-7 个数据点来估计秩相关系数。在 $n \approx 6$ 的样本上得到的 $\rho = 0.94$ 置信区间极宽,论文没有报告 p 值或置信区间,这个证据的强度被高估了。
- 消融不完整。工业数据集上完全没有做组件消融(只有 Beauty 一个数据集有 Table 8),因此无法判断参考向量与 rating 机制在 8192³ 大码本、真实长尾分布下的相对贡献是否与 Beauty 上一致。$L$(层数)与 $M$(码本大小)也没有消融。
- 表述与图不完全一致。§4.8 称 R3-VAE 达到"接近 1.0"的码本使用率,Figure 4 实际读数约 0.9;正文一处写 StayTime/U 比 RQ-VAE 高 1.60%,另一处摘要写 1.59%。这些是小瑕疵,但反映了论文的打磨程度——正文 §3.4 结尾还残留了一处未清理的
"'latex "'排版垃圾。 - 工业对比范围窄。工业实验只对比了 RQ-VAE 与 R-KMeans 两个 baseline(作者归因于资源限制),OPQ-KMeans 与 MQ 只在 CTR 表(Table 4)出现、未进入 GR 表(Table 3)。
工业落地价值:R3-VAE 已在今日头条全量部署,覆盖生成式推荐(OneRec 框架,64×A100,8192³ 码本)与判别式 CTR(DIN + SIM + RankMixer 框架)两条链路。业务收益上,GR 侧 StayTime/U +0.83%、LongStay/U +0.28%;CTR 侧新用户冷启内容点击 +15.36%、老用户 +4.26%,人均停留时长新/老用户 +0.65%/+0.11%。冷启收益远高于大盘收益这一模式,为"SID 替代 item ID"这一改造给出了清晰的收益归因:它主要不是让老内容排得更准,而是让新内容能被找到。同时开源了代码,工程可复现性较好。