PRQ-KMeans: Projection Residual Quantization for Semantic ID Tokenization¶
Yunxiao Luo*, Siyuan Wang*, Ben Chen†, Chenyi Lei(快手 Kuaishou Technology,*共同一作,†通讯作者) arXiv:2608.24207v1 · cs.LG · 2026-08-25
一、研究动机与背景¶
1.1 分层 Semantic ID 与残差量化¶
生成式检索与生成式推荐把「物品 / 文档」从一个原子 ID 换成一小串离散 token,即 Semantic ID(SID)。分层 SID 要求这串 token 从粗到细排列:语义相近的实体共享靠前的 token,靠后的 token 负责区分那些仍然落在同一前缀下的实体。构造一个这样的标识符,在每一层都要同时做两个耦合的决定:
- 当前位置用哪个 token 代表这个实体;
- 往下一层传递什么表示。
残差量化(Residual Quantization, RQ) 是做这两个决定的通用框架:每一层选一个码字作为当前 token,把该码字从当前表示里减掉,把差(残差)交给下一层。两大 tokenizer 范式都用这套递归:
- VAE 派:RQ-VAE(Lee et al. 2022;Rajput et al. 2023 的 TIGER)、R3-VAE(Wan et al. 2026),通过残差量化自编码器学分层 SID;
- Post-hoc 派:RQ-KMeans(QARM,Luo et al. 2025;OneRec,Deng et al. 2025)、RQ-GMM(Tong et al. 2026),直接在已有 embedding 上拟合分层码本。
两派共同点是:残差就是下一层要处理的表示。
1.2 本文的核心视角:渐进共性剥离(progressive commonality removal)¶
本文提出一个统一视角来重新审视残差量化:它本质上是在渐进地剥离共性——被选中的码字代表当前分组内共享的分量,而残差应当只保留留给后续 token 的差异。作者把「相减之后仍然残留在所选码字方向上的那一部分」命名为 residual carryover(残差携带 / 残差夹带)。
这个视角一下子暴露出三个被忽视的问题:
挑战一:共性在任何 cluster 级 token 形成之前就已经存在。 整个 embedding 集合可能被一个语料级共有分量主导。由于它被所有实体共享,它对区分实体几乎没有贡献,但第一层码本却要花一部分容量去建模这个全局背景,而不是去刻画实体之间的粗粒度差异。
挑战二:硬分配限制了码字概括其分组的精度。 每个表示只更新它选中的那个码字,即使它对邻近的候选码字也很相似——分配边界附近的渐进相似度(graded similarity)被完全丢弃。
挑战三:全码字相减并不能对每个表示都准确地移除所选码字分量。 如 Figure 1,被分到同一个码字的表示们,各自含有的该方向分量量不一样,但被减掉的是同一个码字。这会在选中方向上留下一个正的或负的残余,导致下一层码本重新处理已经被当前 token 表示过的变化。
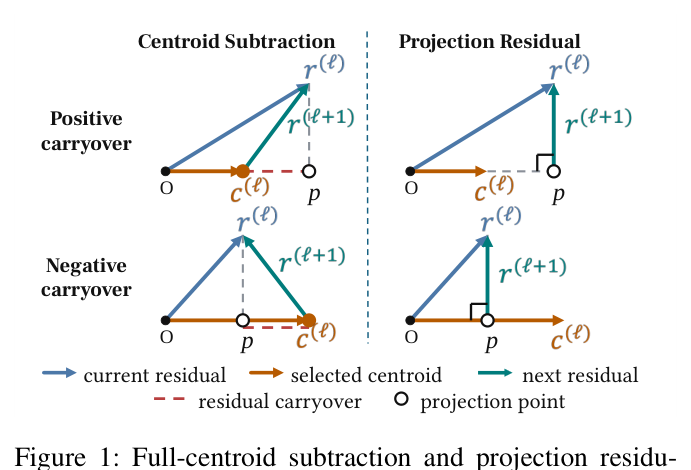
1.3 为什么必须在 post-hoc 设定里做¶
这是本文最关键的一句方法论论证,也是它与 VAE 派工作的根本分界:
- VAE 派的残差被加性重构约束死了。RQ-VAE 一族的重构是「所有层码字之和」,因此减掉当前码字之后剩下的一切都必须传给后续码字——哪怕其中有一部分与当前码字同向。若独立地把那一部分丢掉,就会破坏用于重构的码字和。
- Post-hoc 派不要求码字重构输入,因此残差可以只保留后续 SID 层真正需要的差异。
于是作者在 RQ-KMeans 上开展工作,提出 PRQ-KMeans:去掉全局均值分量、用 Top-k 相似度加权更新精炼质心、用投影残差替代全码字相减。
三项贡献:(1) 提出「渐进共性剥离」视角并识别层间传递的三个挑战;(2) 提出 PRQ-KMeans;(3) 在工业搜索数据集与四个公开推荐 benchmark 上验证。
二、预备知识与实证动机¶
2.1 RQ-KMeans 的形式化¶
RQ-KMeans 中每个码字就是一个 K-Means 质心。设 $X = \{x_i\}_{i=1}^{N} \subset \mathbb{R}^d$ 为用于拟合 tokenizer 的 embedding 集合。深度为 $L$ 的 RQ-KMeans 在每一层学一个码本 $C^{(\ell)} = \{c_j^{(\ell)}\}_{j=1}^{K_\ell}$,把实体 $i$ 映射为 SID $(z_i^{(1)}, \dots, z_i^{(L)})$。从 $r_i^{(1)} = x_i$ 开始,欧氏 K-Means 在「最近质心分配」与「质心更新」之间交替:
$$z_i^{(\ell)} = \arg\min_j \left\lVert r_i^{(\ell)} - c_j^{(\ell)} \right\rVert_2^2,\qquad c_j^{(\ell)} \leftarrow \frac{1}{|I_j^{(\ell)}|}\sum_{i \in I_j^{(\ell)}} r_i^{(\ell)} \tag{1}$$
其中 $I_j^{(\ell)} = \{i : z_i^{(\ell)} = j\}$。拟合完成后 $z_i^{(\ell)}$ 成为第 $\ell$ 层的 token,下一层表示由减去所选质心得到:
$$r_i^{(\ell+1)} = r_i^{(\ell)} - c_{z_i^{(\ell)}}^{(\ell)} \tag{2}$$
一些实现还会额外做就地归一化 $r_i^{(\ell+1)} \leftarrow \mathrm{norm}(r_i^{(\ell+1)})$,其中 $\mathrm{norm}(v) = v/\lVert v\rVert_2$。本文的工业分析全程使用这个归一化变体(遵循 OneSearch / OneSearch-V2 的实现)。
在面向重构的量化里,残差是「选了一个质心之后剩下的近似误差」;但在分层 SID tokenization 里,它同时决定了下一层能拿到什么表示。
2.2 残差 carryover 的代数恒等式¶
考虑一对「表示–质心」,简记为 $r$ 与 $c \neq 0$。写 $c = \rho\hat{c}$,其中 $\hat{c} = c/\lVert c\rVert_2$、$\rho = \lVert c\rVert_2$。令 $\alpha = r^\top \hat{c}$、$u = r - \alpha\hat{c}$(故 $u \perp \hat{c}$),则
$$r = \alpha\hat{c} + u,\qquad r - c = (\alpha - \rho)\hat{c} + u \tag{3}$$
全码字相减用的是共享系数 $\rho$,而表示 $r$ 自己带的是实例特定系数 $\alpha$。 当 $\alpha \neq \rho$ 时,残差在选中质心方向上保留了 $(\alpha - \rho)\hat{c}$——这就是 residual carryover。算术平均质心只匹配它所辖 cluster 内的平均系数,而不是每一个表示的系数,所以 carryover 在一般情况下不可能为零。
2.3 实证测量:carryover 确实存在,且确实伤害下一层¶
作者在工业数据集上拟合一个三层 RQ-KMeans(码本 1024-512-128),定义第 $\ell$ 层的相对 carryover 幅度为
$$m_i^{(\ell)} = \frac{\left| \alpha_i^{(\ell)} - \rho_i^{(\ell)} \right|}{\left\lVert r_i^{(\ell)} - c_{z_i^{(\ell)}}^{(\ell)} \right\rVert_2} \tag{4}$$
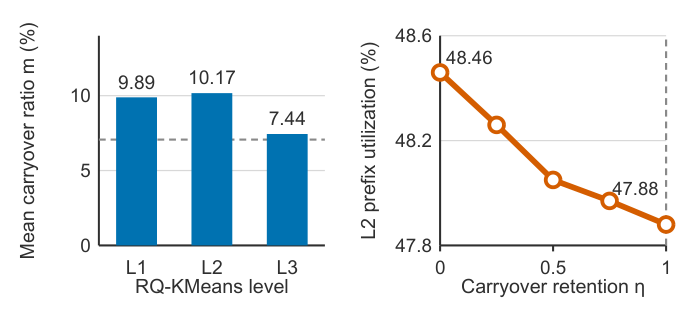
Figure 2(a):L1、L2、L3 的平均 carryover 比例分别为 9.89%、10.17%、7.44%。作为标尺,$d = 128$ 维空间中两个独立各向同性方向的期望绝对余弦为
$$\mathbb{E}\left[|u^\top v|\right] = \frac{\Gamma(d/2)}{\sqrt{\pi}\,\Gamma((d+1)/2)},\qquad u, v \overset{\text{i.i.d.}}{\sim} \mathrm{Unif}(\mathbb{S}^{d-1}) \tag{5}$$
$d = 128$ 时该期望为 7.07%。要传给后续码本的 L1、L2 分别超出这个基线 2.82 和 3.10 个百分点,而终端层 L3 则贴近基线——这个对比很关键:它说明超出部分不是随机噪声,而是系统性地与"该残差还要被下游继续用"这件事相关。
进一步,作者做了一个受控实验:固定 L1 的分配,只保留 L1 carryover 的一个比例 $\eta \in [0,1]$:
$$r_i^{(2)}(\eta) = \mathrm{norm}\left(\eta\left(\alpha_i^{(1)} - \rho_i^{(1)}\right)\hat{c}_i^{(1)} + u_i^{(1)}\right) \tag{6}$$
$\eta = 1$ 对应完整保留 RQ-KMeans 的 carryover,$\eta = 0$ 对应完全移除。Appendix D.1 给出了等价的操作化写法,说明这个更新只是在缩放原始 carryover 项:
$$r_i^{(2)}(\eta) = \mathrm{norm}\left(r_i^{(1)} - \left[\eta c_i + (1-\eta)\frac{r_i^{(1)\top}c_i}{\lVert c_i\rVert_2^2}c_i\right]\right) = \mathrm{norm}\left(\eta(\alpha_i - \rho_i)\hat{c}_i + u_i\right) \tag{7}$$
即:$\eta$ 在「全码字相减」与「投影残差」之间做线性插值。对每个 $\eta$ 用同样的欧氏 K-Means 配置重拟合 L2,测量 $K_1K_2$ 个可能的两 token 前缀中至少被一个物品占用的比例。
Figure 2(b):L2 前缀利用率从 $\eta = 1$ 的 47.88% 单调升到 $\eta = 0$ 的 48.46%。在这个受控协议下,减少 carryover 让紧接着的下一层能用上更宽的前缀集合——这直接构成了「用投影去掉所选质心分量」的动机。
三、核心方法:PRQ-KMeans¶
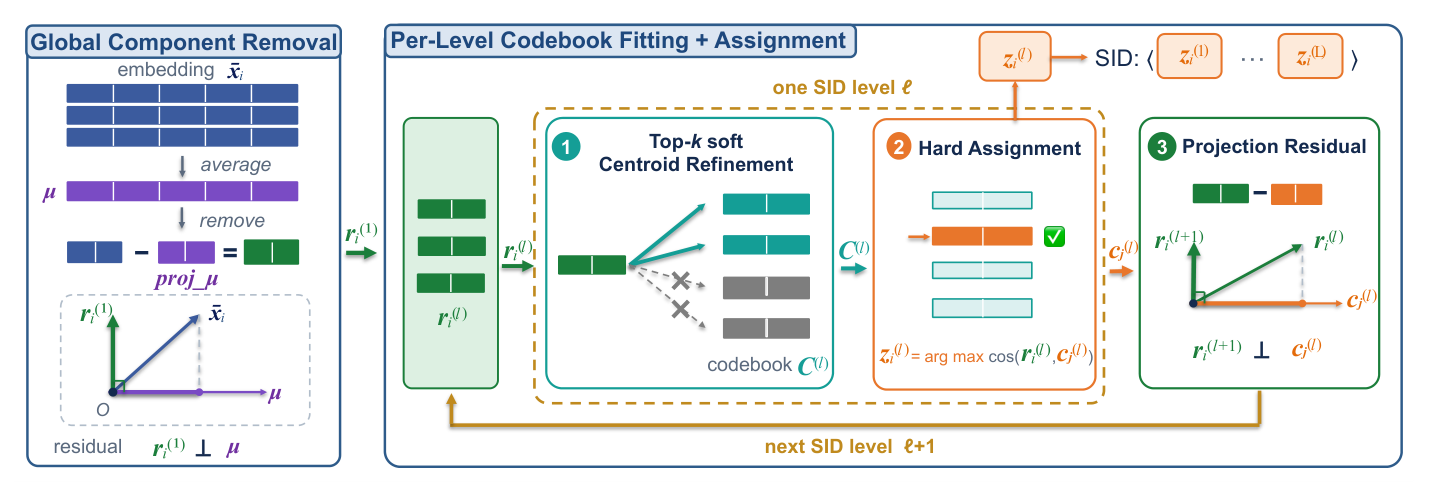
整体流程:先从输入 embedding 里剥掉全局分量;然后逐层学码本——每层用 Top-k 软权重精炼当前质心、用硬余弦分配吐出一个 token、用投影残差作为拟合下一层码本的输入。训练完成后,SID 编码阶段用学好的全局均值和码本重复同样的硬分配与残差更新。投影定义了跨层更新,全局剥离与软精炼则负责准备它的输入表示与质心。
3.1 投影残差构造(核心组件)¶
PRQ-KMeans 要求下一层残差 $v$ 与所选质心 $c$ 正交。但仅有正交性并不能确定一个有用的残差——零向量也满足约束。因此作者选择在所有正交残差中对当前表示 $r$ 改动最小的那一个:
$$v^\star = \arg\min_v \lVert v - r\rVert_2^2 \quad \text{s.t.} \quad v^\top c = 0 \tag{8}$$
解为
$$v^\star = r - \frac{r^\top c}{\lVert c\rVert_2^2}\,c \tag{9}$$
这个解直接消掉了式 (3) 里识别出的 carryover:回忆 $c = \rho\hat{c}$、$\alpha = r^\top\hat{c}$、$r = \alpha\hat{c} + u$,则式 (9) 减掉的分量恰为 $\frac{r^\top c}{\lVert c\rVert_2^2}c = \alpha\hat{c}$,于是 $v^\star = r - \alpha\hat{c} = u$。与 RQ-KMeans 残差 $(\alpha - \rho)\hat{c} + u$ 不同,投影残差在所选质心方向上一点分量都不剩。
Proposition 1(最小改动正交残差):对任意 $r \in \mathbb{R}^d$ 与非零 $c$,式 (9) 的 $v^\star$ 是式 (8) 的唯一解;它满足 $c^\top v^\star = 0$,且在所有与 $c$ 正交的向量中到 $r$ 的欧氏距离最小。
一个重要推论:式 (9) 移除的分量与质心的模长无关(因为 $\frac{r^\top c}{\lVert c\rVert^2}c$ 对 $c$ 的缩放不变)。PRQ-KMeans 因此在比较表示与质心时一律用余弦相似度——余弦同样对质心模长不变。同一套余弦分数被 Top-k 软精炼与硬分配共用,整个方法在「模长无关」这一点上是自洽的。
3.2 全局分量剥离¶
标准 K-Means 用每个 cluster 的均值作为质心,概括的是该 cluster 内表示共享的信息。PRQ-KMeans 把同样的思路提前应用到第一个 SID 层之前:用全体输入表示的均值概括整个集合共享的信息。记 $\bar{x}_i = \mathrm{norm}(x_i)$ 为 L2 归一化后的输入 embedding,其全局均值为
$$\mu = \frac{1}{N}\sum_{i=1}^{N}\bar{x}_i \tag{10}$$
在吐出任何 token 之前,PRQ-KMeans 移除沿该均值方向的分量,得到第一层表示:
$$r_i^{(1)} = \mathrm{norm}\left(\bar{x}_i - \frac{\bar{x}_i^\top \mu}{\lVert\mu\rVert_2^2}\mu\right) \tag{11}$$
全局均值在拟合阶段学一次,编码阶段复用。注意式 (11) 与式 (9) 是同一个算子,只是把「所选质心」换成了「全局均值」——这正是「渐进共性剥离,从全局到局部」这句话的字面实现。
3.3 Top-k 软质心精炼¶
因为残差更新依赖所选质心,质心估计得准不准就变得格外重要。硬 K-Means 让每个表示只更新它被分到的那个质心,忽略了它与 cluster 边界附近其他质心的相似度。PRQ-KMeans 在每轮拟合迭代中计算余弦分数并取 Top-k 候选质心:
$$s_{ij}^{(\ell)} = \cos\left(r_i^{(\ell)}, c_j^{(\ell)}\right),\qquad \mathcal{N}_k\!\left(r_i^{(\ell)}\right) = \mathrm{TopK}_{j \in \{1,\dots,K_\ell\}}\, s_{ij}^{(\ell)} \tag{12}$$
候选集内的软权重为
$$w_{ij}^{(\ell)} = \frac{\exp\left(\beta s_{ij}^{(\ell)}\right)}{\sum_{t \in \mathcal{N}_k(r_i^{(\ell)})}\exp\left(\beta s_{it}^{(\ell)}\right)},\qquad j \in \mathcal{N}_k\!\left(r_i^{(\ell)}\right) \tag{13}$$
候选集之外权重为零。$\beta > 0$ 是 softmax 集中度(逆温度),$\beta$ 越大权重越尖锐。每个质心用「把它当作候选」的所有表示更新:
$$c_j^{(\ell)} \leftarrow \frac{\sum_i w_{ij}^{(\ell)} r_i^{(\ell)}}{\sum_i w_{ij}^{(\ell)}} \tag{14}$$
把权重限制在 $k$ 个最近质心上,既保持了更新的局部性,又允许边界表示对邻近候选做出贡献。这三步(打分—加权—更新质心)重复固定轮数。
一个容易看漏但很重要的设计:软权重只在精炼当前码本时使用。精炼结束后,吐 token 和构造残差用的都是硬分配——软的部分完全被限制在「怎么把质心估得更准」这一件事上,不参与离散化,也不参与跨层传递。
3.4 顺序码本拟合与 SID 编码¶
拟合完 $C^{(\ell)}$ 后,用硬余弦分配把每个拟合表示指派到一个质心:
$$z_i^{(\ell)} = \arg\max_j \cos\left(r_i^{(\ell)}, c_j^{(\ell)}\right) \tag{15}$$
所选下标 $z_i^{(\ell)}$ 就是当前 token。把所选质心记为 $c_i^{(\ell)} = c_{z_i^{(\ell)}}^{(\ell)}$,PRQ-KMeans 在一次更新里完成「移除分量 + 归一化」:
$$r_i^{(\ell+1)} = \mathrm{norm}\!\left(r_i^{(\ell)} - \frac{r_i^{(\ell)\top}c_i^{(\ell)}}{\left\lVert c_i^{(\ell)}\right\rVert_2^2}\,c_i^{(\ell)}\right) \tag{16}$$
对非零投影残差,式 (16) 的归一化良定义;$r_i^{(\ell+1)}$ 被用于拟合 $C^{(\ell+1)}$。逐层重复即学出整个层级。SID 编码阶段冻结全局均值与所有码本,重复同样的硬分配、token 吐出、投影、归一化,不再做任何更新。
Algorithm 1(拟合 + 编码) 步骤化描述:
拟合阶段 1. 全局分量剥离:$\bar{x}_i \leftarrow \mathrm{norm}(x_i)$;$\mu \leftarrow N^{-1}\sum_i \bar{x}_i$;按式 (11) 得 $r_i^{(1)}$。 2. 对 $\ell = 1, \dots, L$: a. 采样 $K_\ell$ 个当前残差初始化质心; b. 对每轮精炼迭代:按式 (12)(13)(14) 更新 $c_j^{(\ell)}$; c. 硬分配:按式 (15) 得 $z_i^{(\ell)}$,$c_i^{(\ell)} \leftarrow c_{z_i^{(\ell)}}^{(\ell)}$; d. 若 $\ell < L$:按式 (16) 得投影残差 $r_i^{(\ell+1)}$。
编码阶段:对每个输入 embedding,$\bar{x}_i \leftarrow \mathrm{norm}(x_i)$,按式 (11) 得 $r_i^{(1)}$;对 $\ell = 1,\dots,L$ 按式 (15) 取 token、按式 (16) 更新残差;存下 $(z_i^{(1)},\dots,z_i^{(L)})$。
3.5 理论证明(Appendix A)¶
A.1 残差 carryover 恒等式。 对非零质心 $c$($\rho = \lVert c\rVert_2$、$\hat{c} = c/\rho$)与非空分配集 $I_j$,对每个 $i \in I_j$ 写 $r_i = \alpha_i\hat{c} + u_i$,令 $\bar{\alpha}_j = |I_j|^{-1}\sum_{i \in I_j}\alpha_i$。由于 carryover 系数是 $\alpha_i - \rho$,其均方幅度满足
$$\frac{1}{|I_j|}\sum_{i \in I_j}(\alpha_i - \rho)^2 = \mathrm{Var}_{I_j}(\alpha) + (\bar{\alpha}_j - \rho)^2 \tag{17}$$
当 $c$ 是所辖表示的算术平均时,$\bar{\alpha}_j = \hat{c}^\top c = \rho$,第二项消失,均方 carryover 恰好等于 cluster 内 $\alpha_i$ 的方差——只有当所有被分配的表示在质心方向上的系数完全相同时才为零。这条恒等式给出了一个很强的结论:用均值做质心的 K-Means,其 carryover 下界就是簇内投影系数的方差,靠调 K-Means 本身是消不掉的;对非均值质心,第二项刻画额外的偏移。
A.2 Proposition 1 的证明。 严格正交性由直接展开给出:
$$c^\top v^\star = c^\top r - \frac{r^\top c}{\lVert c\rVert_2^2}\lVert c\rVert_2^2 = 0 \tag{18}$$
若 $v^\star \neq 0$,归一化只乘一个正标量,因此保持正交。最小欧氏改动:可行集 $S = \{v : v^\top c = 0\}$ 是闭线性子空间,而 $v^\star \in S$ 且 $v^\star - r = -\left(r^\top c/\lVert c\rVert_2^2\right)c \in \mathrm{span}(c) = S^\perp$,故对任意可行 $v \in S$ 有勾股分解
$$\lVert v - r\rVert_2^2 = \lVert v - v^\star\rVert_2^2 + \lVert v^\star - r\rVert_2^2 \tag{19}$$
第二项固定、第一项非负且仅在 $v = v^\star$ 时为零,故 $v^\star$ 唯一。(该最小改动性质是归一化之前的性质。)
四、实验设置¶
4.1 数据集¶
- 工业数据集:来自 KuaiSearch(Li et al. 2026, arXiv:2602.11518)的公开发布的工业电商搜索数据集,约 780 万物品、900 万训练查询记录(tokenizer 拟合共 16,843,945 条表示)。遵循 OneSearch(Chen et al. 2025)构造三个训练阶段:语义内容对齐 35,689,588 条、共现同步 54,459,755 条、用户个性化建模 45,916,427 条;Order 与 Click 两个测试集各 30,000 条 query–item 对,分别来自记录的下单与点击。
- 公开 benchmark:Amazon Sports / Toys / Clothing(He and McAuley 2016)与 LastFM(Cantador et al. 2011),遵循 TIGER 与 R3-VAE 的数据处理。
4.2 Baseline¶
| 类别 | 方法 |
|---|---|
| 学习式残差 tokenizer | RQ-VAE、R3-VAE |
| Post-hoc tokenizer | RQ-KMeans、RQ-GMM |
| 并行量化器 | PQ-KMeans、OPQ-KMeans |
| 五层混合 tokenizer(仅工业) | RQ-OPQ、ResKmeansFSQ、PRQ-OPQ(本文) |
五层混合设定说明:RQ-OPQ(OneSearch)= 两层 RQ-KMeans + 一层 balanced K-Means + 两个 OPQ 后缀 token;ResKmeansFSQ(QARM V2)= 三层 RQ-KMeans + 把 L3 残差用一个联合 12-bit FSQ 码拆成两个 64 路后缀 token;PRQ-OPQ = 把 RQ-OPQ 的前两层 RQ-KMeans 换成 PRQ-KMeans,保留其 balanced 第三层与两个 OPQ 后缀——这个构造专门用来检验 PRQ-KMeans 与既有工业 tokenizer 接口的兼容性。
4.3 实现与评估¶
- 工业:遵循 OneSearch,使用其 128 维蒸馏 BGE 查询/物品表示(编码 query 文本、物品标题、价格、关键词与 OCR 文本,经 query–query / item–item / query–item 三种目标对齐)与 BART-Base 检索器。所有 tokenizer 共享三阶段训练、解码与评估流水线。三层设定码本 1024-512-128;五层设定在同样三层前缀后接两个 64 路后缀 token。PRQ-KMeans 用 $k = 5$、$\beta = 15$。训练 batch size 512、学习率 $5\times10^{-5}$,三阶段分别 4 / 3 / 6 epoch。beam search 返回 128 个 SID,每个 SID 下的物品按可售性与「历史 CTR / CVR / 点击数 / 订单数」复合分排序取前 5,按 beam 顺序展开、稳定去重、截断到 50 个物品。
- 公开:768 维 Sentence-T5-Base 物品表示,码本 256-256-256,TIGER encoder–decoder(4 编码层 / 4 解码层 / 模型维 128 / FFN 1024 / 6 个注意力头),最多 200 epoch、学习率 $10^{-4}$、无 weight decay、训练 batch 256、推理 batch 96、patience 10、beam size 30。PRQ-KMeans 用 $k = 2$、$\beta = 15$。公开评测用 item-level Recall@20 / NDCG@20 而非 SID-level 指标,以处理 SID 碰撞(Zhang et al. 2026):对每个预测 SID,若映射到多个物品则用固定种子 42 随机选一个代表物品,度量前去掉重复物品预测。
- 各 tokenizer 拟合预算:RQ-VAE / R3-VAE 训 20 epoch、batch 4096、学习率 $5\times10^{-4}$;RQ-KMeans / PQ-KMeans 25 轮聚类;OPQ-KMeans 25 轮「旋转 + 聚类」交替;RQ-GMM 最多 30 轮 EM(方差下限 $10^{-6}$);PRQ-KMeans 25 轮软质心精炼。
- 硬件:tokenizer 拟合、SID 编码与码本分析在双路 AMD EPYC 9654(每路 96 核)+ 2.2 TB 内存的 CPU 服务器;下游生成式检索训练与评估在 8×NVIDIA H800(80GB HBM3)+ 双路 Intel Xeon Platinum 8558 上。
4.4 码本质量指标定义¶
设 $S$ 为分配给物品的不同 full SID 集合,$n(s)$ 为分到 $s$ 的物品数。独立码率(ICR):
$$\mathrm{ICR} = \frac{\left|\{s \in S : n(s) = 1\}\right|}{|S|} \tag{20}$$
注意分母是不同 SID 的个数而非物品数。对第 $\ell$ 层,令 $P_\ell$ 为被占用的长度 $\ell$ 前缀集合,累积前缀利用率为
$$\mathrm{Util}_\ell = \frac{|P_\ell|}{\prod_{t=1}^{\ell}K_t} \tag{21}$$
已用前缀 Gini 只在 $P_\ell$ 内的前缀上按物品频次计算:设 $M_\ell = |P_\ell|$,排序后频次 $f_{(1)} \le \dots \le f_{(M_\ell)}$,则
$$\mathrm{Gini}_\ell = \frac{2\sum_{q=1}^{M_\ell} q f_{(q)}}{M_\ell \sum_{q=1}^{M_\ell} f_{(q)}} - \frac{M_\ell + 1}{M_\ell} \tag{22}$$
未使用的前缀被排除,值越低表示占用前缀之间的分布越均匀。三层块的 ICR 用完整三 token SID,五层块的 ICR 用完整五 token SID,而利用率与 Gini 在五层块中报告的是各 tokenizer 的 L1–L3 前缀。
五、主要实验结果¶
5.1 工业 benchmark¶
Table 1:工业数据集上的码本质量与下游生成式检索性能(每个码本块内粗体=最优、下划线=次优;Gini 越低越好)
| Method | Order HitRate | Order MRR | Click HitRate | Click MRR | ICR (%) | Util L1 (%) | Util L2 (%) | Util L3 (%) | Gini L1 | Gini L2 | Gini L3 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 码本 1024–512–128 | |||||||||||
| RQ-VAE | 0.2474 | 0.0501 | 0.2921 | 0.0446 | 54.24 | 100.00 | 47.55 | 3.22 | 0.407 | 0.795 | 0.601 |
| R3-VAE | 0.2289 | 0.0449 | 0.2788 | 0.0402 | 54.96 | 99.41 | 51.04 | 3.34 | 0.427 | 0.783 | 0.592 |
| RQ-KMeans | 0.2913 | 0.0644 | 0.3279 | 0.0540 | 55.52 | 100.00 | 47.88 | 3.61 | 0.413 | 0.774 | 0.569 |
| RQ-GMM | 0.2687 | 0.0594 | 0.3071 | 0.0483 | 50.66 | 99.90 | 38.57 | 3.06 | 0.412 | 0.783 | 0.598 |
| PQ-KMeans | 0.0400 | 0.0061 | 0.0521 | 0.0054 | 50.45 | 100.00 | 22.52 | 0.67 | 0.351 | 0.934 | 0.891 |
| OPQ-KMeans | 0.1242 | 0.0225 | 0.1393 | 0.0164 | 47.35 | 100.00 | 21.85 | 1.15 | 0.276 | 0.916 | 0.804 |
| PRQ-KMeans | 0.3128 | 0.0720 | 0.3488 | 0.0588 | 58.45 | 100.00 | 57.78 | 3.99 | 0.298 | 0.758 | 0.546 |
| 码本 1024–512–128–64–64 | |||||||||||
| ResKmeansFSQ | 0.4038 | 0.1194 | 0.4364 | 0.0969 | 89.19 | 100.00 | 47.88 | 3.61 | 0.413 | 0.774 | 0.569 |
| RQ-OPQ | 0.4276 | 0.1340 | 0.4650 | 0.1083 | 98.99 | 100.00 | 47.88 | 8.00 | 0.413 | 0.774 | 0.266 |
| PRQ-OPQ | 0.4359 | 0.1364 | 0.4713 | 0.1089 | 98.74 | 100.00 | 57.78 | 8.42 | 0.298 | 0.758 | 0.241 |
结论分析:
- 码本质量。三层设定下 PRQ-KMeans 拿到最高 ICR 与最高的 L2–L3 前缀利用率,同时 L2–L3 Gini 最低。相对 RQ-KMeans:ICR 55.52% → 58.45%,L2/L3 利用率 47.88%/3.61% → 57.78%/3.99%,L2/L3 Gini 0.774/0.569 → 0.758/0.546。这与 §2.3 的受控实验完全一致——去掉 carryover 让后续层能铺开到更多前缀,并且铺得更均匀。注意 L1 利用率所有方法都是 100%(1024 个一级码全被占用),差异从 L2 才开始显现,这本身就说明问题出在层间传递而非单层聚类质量。
- 下游检索。RQ-KMeans 是最强的三层 baseline(四个指标全面领先其他基线)。相对它,PRQ-KMeans 的 Order HitRate/MRR 提升 7.4% / 11.8%,Click HitRate/MRR 提升 6.4% / 8.9%。MRR 的提升幅度显著高于 HitRate,说明改善不只是"多召回了一些",而是把正确物品排得更靠前——这与 SID 前缀更有区分度、beam 更早锁定正确子树的机制解释吻合。
- 并行量化器全面崩盘。PQ-KMeans 与 OPQ-KMeans 的 Order HitRate 只有 0.0400 / 0.1242,L2 利用率 22.52% / 21.85%、L3 Gini 高达 0.891 / 0.804。这说明在这个工业设定下,层次结构(共享前缀)对生成式检索是刚需,把向量切成独立子空间会摧毁 beam search 需要的粗到细组织。有意思的是 OPQ-KMeans 的 L1 Gini 最低(0.276),即第一层负载最均衡,但下游依旧很差——均衡本身不等于有用。
- VAE 派不敌 post-hoc。RQ-VAE(0.2474)与 R3-VAE(0.2289)都低于 RQ-KMeans(0.2913)。R3-VAE 在 L2 利用率上(51.04%)优于 RQ-KMeans(47.88%),但下游反而更差,说明利用率与下游指标之间不是简单单调关系;本文自己的方法之所以两者同时改善,是因为改的是残差本身而不是靠约束去逼利用率。
- 五层混合兼容性。PRQ-OPQ 在三个对齐 tokenizer 中拿下全部四个下游指标最优,相对 RQ-OPQ 提升 0.6%–1.9%。其 L2 利用率仍是 57.78%、L3 Gini 更低(0.241 vs 0.266)。唯一略降的是 ICR(98.74% vs 98.99%)——五层设定下 OPQ 后缀已经把碰撞压得极低,这一点微差实际意义有限。这条结果最大的价值在于工程性:PRQ-KMeans 可以只替换 OneSearch 现有 tokenizer 的前两层,其余接口(balanced 第三层 + OPQ 后缀)原封不动。
5.2 公开 benchmark¶
Table 2:四个公开 benchmark 上的 item-level Recall@20 / NDCG@20
| Method | Sports Recall | Sports NDCG | Toys Recall | Toys NDCG | Clothing Recall | Clothing NDCG | LastFM Recall | LastFM NDCG |
|---|---|---|---|---|---|---|---|---|
| RQ-VAE | 0.0522 | 0.0219 | 0.0751 | 0.0321 | 0.0357 | 0.0141 | 0.0082 | 0.0033 |
| R3-VAE | 0.0514 | 0.0211 | 0.0812 | 0.0354 | 0.0361 | 0.0147 | 0.0074 | 0.0029 |
| RQ-KMeans | 0.0528 | 0.0215 | 0.0824 | 0.0346 | 0.0330 | 0.0132 | 0.0115 | 0.0042 |
| RQ-GMM | 0.0506 | 0.0209 | 0.0711 | 0.0287 | 0.0341 | 0.0133 | 0.0082 | 0.0024 |
| PQ-KMeans | 0.0087 | 0.0033 | 0.0177 | 0.0080 | 0.0082 | 0.0034 | 0.0016 | 0.0007 |
| OPQ-KMeans | 0.0379 | 0.0151 | 0.0403 | 0.0171 | 0.0233 | 0.0087 | 0.0033 | 0.0014 |
| PRQ-KMeans | 0.0531 | 0.0219 | 0.0851 | 0.0361 | 0.0382 | 0.0151 | 0.0179 | 0.0076 |
结论分析:PRQ-KMeans 在 8 个指标上全部取得最优或并列最优(Sports NDCG 0.0219 与 RQ-VAE 并列),并且在每一个对比中都超过 RQ-KMeans。增益幅度呈现明显的数据集依赖:Sports、Toys 上比较温和(Recall +0.6% / +3.3% 相对),Clothing 上更大(0.0330 → 0.0382,相对 +15.8%),LastFM 上最为突出(Recall 0.0115 → 0.0179,相对 +55.7%;NDCG 0.0042 → 0.0076,相对 +81.0%)。LastFM 是四者中物品数最少、最稀疏的数据集,也是 SID 容量最容易被浪费的场景——当可用码本容量本来就紧张时,"不要把容量浪费在全局共性和重复表示上"这件事的边际收益最大。
六、消融实验¶
三个消融变体:−Global 去掉全局分量剥离;−Soft 用硬质心更新替换 Top-k 软精炼;−Projection 保留 Global 与 Top-k 精炼,但把余弦拟合/分配换回欧氏版本、把投影残差化换回全码字相减。
Table 3:工业数据集消融
| Variant | Order HitRate | Order MRR | Click HitRate | Click MRR |
|---|---|---|---|---|
| PRQ-KMeans | 0.3128 | 0.0720 | 0.3488 | 0.0588 |
| −Global | 0.3017 | 0.0697 | 0.3379 | 0.0560 |
| −Soft | 0.3067 | 0.0705 | 0.3460 | 0.0584 |
| −Projection | 0.2985 | 0.0687 | 0.3328 | 0.0548 |
Table A1:公开 benchmark 消融
| Variant | Sports R | Sports N | Toys R | Toys N | Clothing R | Clothing N | LastFM R | LastFM N |
|---|---|---|---|---|---|---|---|---|
| PRQ-KMeans | 0.0531 | 0.0219 | 0.0851 | 0.0361 | 0.0382 | 0.0151 | 0.0179 | 0.0076 |
| −Global | 0.0505 | 0.0202 | 0.0830 | 0.0359 | 0.0370 | 0.0151 | 0.0107 | 0.0044 |
| −Soft | 0.0515 | 0.0210 | 0.0815 | 0.0350 | 0.0371 | 0.0146 | 0.0043 | 0.0017 |
| −Projection | 0.0503 | 0.0201 | 0.0810 | 0.0345 | 0.0360 | 0.0141 | 0.0099 | 0.0044 |
逐项分析:
- −Projection 在工业四指标上跌幅最大(Order HitRate 0.3128 → 0.2985,Click MRR 0.0588 → 0.0548),在六个 Amazon 指标上同样跌幅最大。这直接验证了本文的核心主张:三个组件里,投影残差是承重墙。注意 −Projection 同时把余弦换回欧氏——两者被绑成一个消融,因为投影的"模长无关"性质本来就要求配余弦度量,单独拆开在方法上不自洽。
- −Soft 在 LastFM 上跌幅最惨烈(Recall 0.0179 → 0.0043,跌去 76%;NDCG 0.0076 → 0.0017),远超其他任何消融在任何数据集上的影响。LastFM 数据稀疏、每个 cluster 里样本少,硬更新下质心估计的方差极大,此时 Top-k 软权重带来的"借用邻近表示"效应就成了刚需。而工业数据集样本量以亿计,−Soft 的影响最小(Click MRR 只从 0.0588 掉到 0.0584)。
- −Global 在 Clothing NDCG 上与完整模型打平(0.0151),其余七个公开指标与全部四个工业指标均下降;LastFM 上跌幅同样很大(Recall 0.0179 → 0.0107)。这说明全局共有分量的危害程度取决于 embedding 集合本身的各向异性强度,不同语料差异很大。
- 完整 PRQ-KMeans 在每一个工业指标上最优,在 8 个公开指标上最优或并列最优——三个组件是互补而非冗余的。
七、敏感性与鲁棒性¶
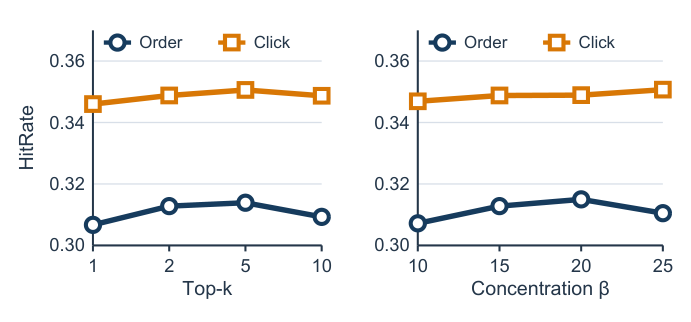
超参敏感性(工业,Figure 4):$k = 2$ 与 $k = 5$ 优于 $k = 1$ 和 $k = 10$。作者给出的解释是一个权衡——邻域太小限制了 cluster 边界处的共享,邻域太大则会因为更新了不够相似的质心而削弱局部性。对 $\beta$:$\beta = 10$ 表现更差,$\beta = 15$–$25$ 之间结果相当。即权重过于弥散会抹平质心之间的相似度差异,更尖锐的权重能更好地优先照顾最近的候选。
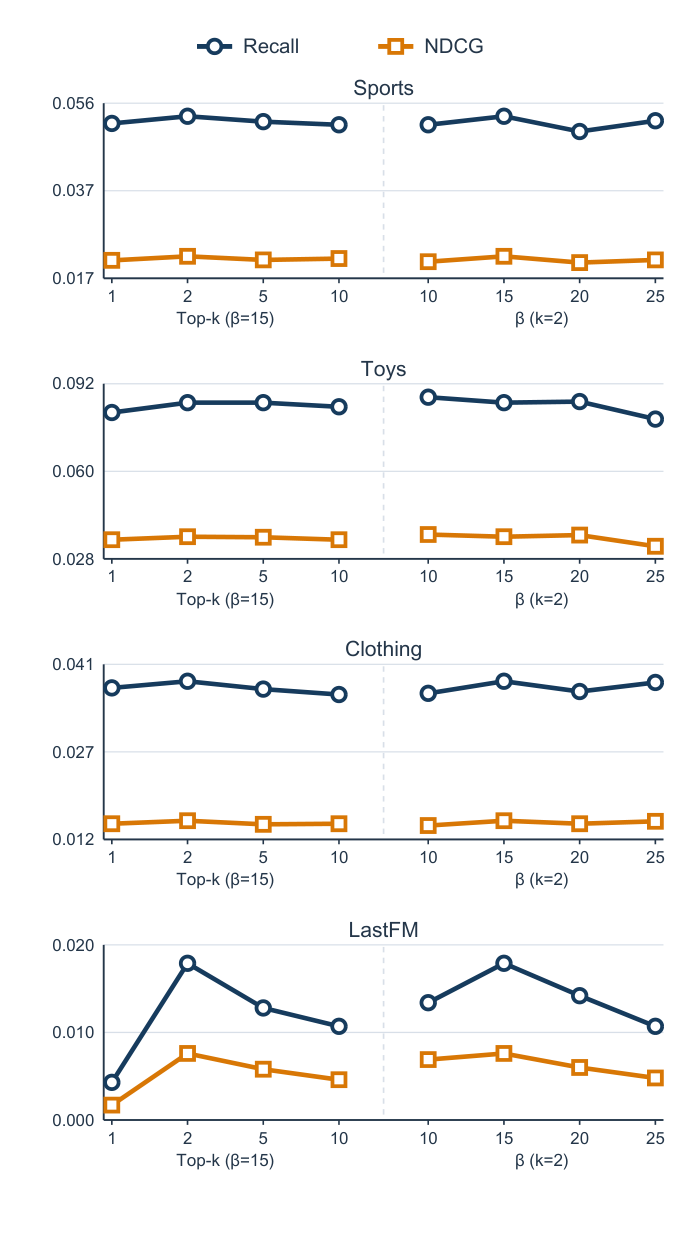
超参敏感性(公开,Figure A1):$k \in \{1,2,5,10\}$(固定 $\beta = 15$)下,$k = 2$ 在四个 benchmark 上都取得最优或并列最优的 Recall 与 NDCG,继续增大 $k$ 没有一致收益。$\beta \in \{10,15,20,25\}$(固定 $k = 2$)下,$\beta = 15$ 在 Sports、Clothing、LastFM 上最好,Toys 上则是 $\beta = 10$ 最好——最优集中度是数据集相关的。注意公开设定用 $k=2$、工业设定用 $k=5$,作者归因于两者码本规模不同(256 vs 1024/512/128)。
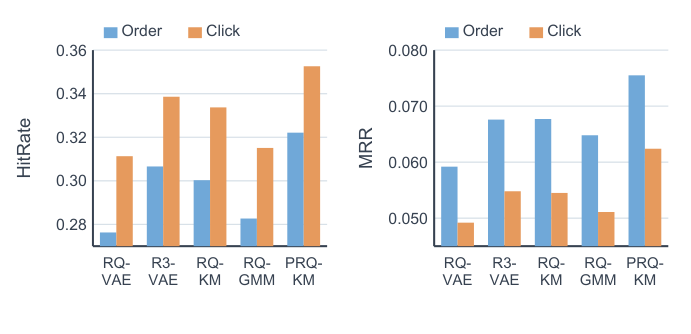
嵌入鲁棒性(Figure 5):把主实验用的对齐 BGE 表示换成对齐后的 Qwen3-Embedding-0.6B 表示(同样 128 维),对齐流程、码本规模与下游协议不变,重跑五个 tokenizer(RQ-VAE、R3-VAE、RQ-KMeans、RQ-GMM、PRQ-KMeans)。PRQ-KMeans 在 Order 与 Click 的 HitRate 与 MRR 上均取得最高值。这一条很重要:因为全局均值剥离这类操作理论上可能是在补某个特定编码器的各向异性缺陷,换编码器仍然领先才说明它抓的是残差量化的通用问题,而不是 BGE 的特有缺陷。
八、定性分析¶
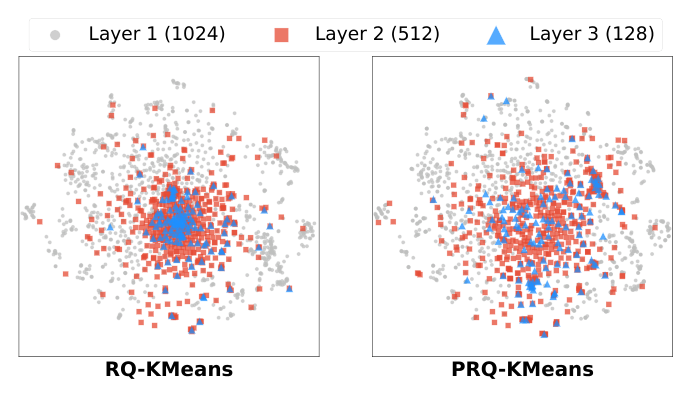
质心可视化:把 RQ-KMeans 与 PRQ-KMeans 的 L1–L3 质心用同一次 t-SNE 联合嵌入(两个面板共享坐标与轴范围)。RQ-KMeans 中,L1 质心铺开一片很宽的区域,而 L2、尤其 L3 质心挤成一个致密核心。这与 residual carryover 的预测完全一致:所选质心分量残留下来,后续码本收到的表示仍沿着更早的质心方向变化,于是它们只能反复去表达已经被表示过的变化,质心因而彼此挤在一起。PRQ-KMeans 在拟合下一层码本前移除了这个分量,其 L2 与 L3 质心覆盖了明显更宽的区域。这一图与 Table 1 中更高的后层利用率、更低的 Gini 互为佐证。
碰撞组案例:作者按固定的 SID 结构准则挑出一组 12 件 Kitty 主题拖鞋——它们在 RQ-KMeans 下共享同一个 full SID(即完全无法区分)。在 PRQ-KMeans 下,这 12 件保留一个共同的 level-1 前缀,在 level-2 分成两个前缀,最终形成三个 full SID、每个各含 4 件。
Table A2:该 12 件碰撞组在 PRQ-KMeans 下的分支关键词(分支标签已匿名化)
| Full-SID 分支 | L2 | 物品数 | 关键词 |
|---|---|---|---|
| A | A | 4 | Outdoor; dormitory; shower.(户外;宿舍;淋浴) |
| B | B | 4 | Indoor; soft-soled.(室内;软底) |
| C | A | 4 | Bathroom; travel; home/outdoor.(浴室;旅行;家用/户外) |
后续 token 区分出了室内软底、户外/宿舍、混合用途三种变体,同时保留了共同的商品主题——这正是"渐进共性剥离"想要的效果:共性留在前缀,差异留给后缀。
弱意图查询案例:对一个预先指定的、翻译为「hotel(酒店)」的查询,考察各 tokenizer 分配的 level-2 前缀下的目录物品。
Table A3:弱意图查询「hotel」的前缀邻域统计
| Method | L2 前缀下物品数 | 不同 L3 分支数 |
|---|---|---|
| RQ-KMeans | 22 | 14 |
| PRQ-KMeans | 100 | 29 |
PRQ-KMeans 的前缀邻域包含了入口、卫生间、走廊、商业装置等与酒店相关的观察到的场景。对弱意图查询而言,更宽的前缀邻域意味着 beam 在第二步就能覆盖更多合理候选,而不是过早收窄到 22 件商品。
九、核心贡献总结¶
- 概念层面:把分层 SID 构造重新表述为「渐进共性剥离」,并把「层间传递什么」提升为一个独立的设计维度。在此视角下识别出三个此前未被系统处理的挑战:语料级共有分量占用一级容量、硬分配丢弃渐进相似度、全码字相减留下 residual carryover。
- 诊断层面:给出 carryover 的闭式恒等式(式 17,说明均值质心下 carryover 的下界就是簇内投影系数方差)、可测量的相对 carryover 比例(式 4)与各向同性基线(式 5),并用受控插值实验(式 6/7)建立「carryover ↑ → 下一层前缀利用率 ↓」的单调因果证据。
- 方法层面:投影残差——把「移除所选质心分量」形式化为一个带正交约束的最小改动问题(式 8),闭式解(式 9)恰好消掉 carryover,并证明唯一性与最小性(Proposition 1)。配套的全局分量剥离(式 11,同一算子提前用在全局均值上)与 Top-k 软质心精炼(式 12–14)分别负责准备该算子的输入与质心。
- 方法论层面:明确论证为什么这条路只能在 post-hoc 设定里走通——VAE 派的加性重构约束禁止独立丢弃与当前码字同向的分量。
- 工程层面:PRQ-OPQ 证明只替换既有工业 tokenizer 的前两层即可获益,其余接口不变。
十、与已归档相关工作的对比¶
R3-VAE R3-VAE: Reference Vector-Guided Rating Residual Quantization VAE (ByteDance 今日头条推荐团队, 2026-04-13)¶
关系:显式引用但原文未展开对比(仅在 related work 一句话提及 + 作为 Table 1/Table 2 的数据行)· 已加载对方精读
- 共同关注的问题:两篇都认为 RQ 一族 tokenizer 的病根在残差是怎么被构造出来的,而不在码本大小或下游模型。两篇都同时点了「初始残差被全局语义中心污染」与「硬 argmax 分配丢信息」这两条。
- 相近的技术骨架:R3-VAE 的 Reference Vector Projection 层写作 $\alpha = \frac{x \cdot r}{\lVert r\rVert^2}$、$e^{(0)} = x - \alpha \cdot r$——这与 PRQ-KMeans 的全局分量剥离式 (11) 是同一个投影算子,差别只在 $r$ 是端到端学出来的语义锚点,而 PRQ 直接取全体归一化 embedding 的算术均值 $\mu$。R3-VAE 的 Rating 机制(点积余弦打分 + softmax 加权)与 PRQ 的 Top-k 余弦软精炼(式 12–13)也共享「用角度相似度而非欧氏距离、用软权重而非独宠胜者」的判断。
- 本文的差异与推进:三点关键分歧。(1) 软权重用在哪里:R3-VAE 用软加权和 $\hat{e}^{(l)} = \sum_k w_k c_k$ 构造残差($e^{(l)} = e^{(l-1)} - \hat{e}^{(l)}$),PRQ 只用软权重精炼质心,吐 token 与构造残差都是硬的。(2) 残差是否正交:R3-VAE 减掉的仍然是一个"加权码字和",不保证与所选码字正交,因此按本文的分析框架它并未消除 carryover——只是把 $\rho$ 换成了另一个共享的加权系数,实例特定的 $\alpha$ 依旧没被匹配。PRQ 的式 (9) 则给出正交性保证。(3) 是否受重构约束:R3-VAE 在重构式里显式加回 $\alpha \cdot r$($\mathcal{L}_{rec} = \lVert x - (\alpha r + \sum_l \hat{e}^{(l)})\rVert^2$),因此它的参考向量剥离是无损预处理;PRQ 因为在 post-hoc 设定,可以真的把那部分丢掉不再管——这正是本文 §1.3 的论证要点。
- 可比的方法 / 实验差异:两者在本文的实验里正面交手。工业三层设定:R3-VAE Order HitRate 0.2289 / MRR 0.0449,PRQ-KMeans 0.3128 / 0.0720。公开 benchmark:Toys 上 R3-VAE Recall 0.0812 vs PRQ 0.0851,LastFM 上 0.0074 vs 0.0179。值得注意的是 R3-VAE 的 L2 前缀利用率(51.04%)反而高于 RQ-KMeans(47.88%)但下游更差,而 PRQ 是两者同时改善——这个不一致本身就说明"提高利用率"不是目标,"不让后层重复表示已表达的变化"才是。原文对 R3-VAE 只有 related-work 的一句话("use autoencoders and recursive residual quantization to learn hierarchical SIDs")与两张表的数字,完全没有机制层对比,因此本节补上。
Tlow Tlow: Flow-based Item Tokenizer for Recommendation (清华大学 / 腾讯, 2026-08-25)¶
关系:独立并发(同一天 arXiv 首发,互不引用,content.txt 中检索 "24176" / "Tlow" / "flow" 均 0 命中)· 已加载对方精读
- 共同关注的问题:两篇对 root cause 的判断惊人地接近——语义 embedding 的几何形状本身就不适合直接量化。Tlow 明确指出语义嵌入高度各向异性、占据一个不均匀的锥形(cone)区域而非均匀铺开,导致标准码本拟合效率低;PRQ-KMeans 说的「一个被整个集合共享、对区分实体没有贡献却占用第一层码本容量的语料级分量」,在几何上就是这个锥的轴向。两篇都不认为问题出在下游生成模型。
- 相近的技术骨架:两者的方法流程图能抽象重合为同一条——先在量化之前变换表示、把几何弄"好",再让量化器保持简单。Tlow:normalizing flow(ActNorm + 可逆线性 + 仿射耦合,多尺度堆叠)把 $x$ 映成标准正态 $z$,然后量化器就是最朴素的 PQ + K-Means(式 13 就是一个 argmin),没有 VAE / STE / commitment loss。PRQ-KMeans:先做一次全局均值投影剥离(式 11),量化器仍是 K-Means。两者都刻意把复杂度前置到量化之前,都不训练带重构约束的 VAE 式 tokenizer。
- 本文的差异与推进:赌注下在完全相反的方向。Tlow 判定残差量化的串行依赖本身(第 $k$ 个 token 必须先解出前 $k-1$ 个)是效率死结,因此离开残差量化,用可逆流换来维度独立、从而做独立 PQ + 并行解码;它的变换是非线性、全局、需要训练的(论文明确对比:OPQ 只是"线性且一次性"的正交变换,子空间内维度仍相关)。PRQ-KMeans 则留在残差量化里,认为层次前缀结构对 beam search 是刚需——它的工业实验恰好给出了这一判断的证据:PQ-KMeans / OPQ-KMeans 这两个并行量化器在工业数据集上崩盘到 Order HitRate 0.0400 / 0.1242,L2 利用率只有 22.52% / 21.85%。PRQ 的变换是一次线性投影、零训练参数,剩下的力气全花在层间残差算子(Tlow 因为放弃了层级,这个问题在它那里根本不存在)。
- 可比的方法 / 实验差异:两者没有共同 baseline 数字可直接对齐(Tlow 走 Amazon Reviews + RPG 式并行解码协议,PRQ 走 KuaiSearch 工业 + TIGER 式自回归协议),但存在一个可交叉验证的定性观察:Tlow 用 Figure 1 展示 OPQ 第一个 token 相同的专辑集合混入大量异类流派(#category 225、entropy 4.11),而 PRQ 用 Table A3 展示 RQ-KMeans 的 level-2 前缀邻域过窄(22 件 / 14 个 L3 分支 vs PRQ 的 100 件 / 29 个分支)。两篇从相反方向指出了同一件事:token 的语义邻域质量是 tokenizer 的真正产出,而不是重构误差。 需要指出的是,两者对 OPQ 的态度也构成有趣对照——Tlow 把 OPQ 当作"不够强的线性变换"来超越,PRQ 则在五层设定里把 OPQ 当作后缀零件复用(PRQ-OPQ)。
Dynamic PV-S2 从静态多级小语义码本到动态单层大语义码本 / Dynamic PV-S2 (快手, 2026-08-21)¶
关系:独立并发(同公司、早 4 天,互不引用,content.txt 中检索 "21012" 0 命中)· 已加载对方精读
- 共同关注的问题:两篇量化的是同一个症状——残差量化的后续语义层容量被严重浪费。Dynamic PV-S2 在快手线上约 15.0 亿条工业样本上统计:全局 SID1 利用率 87.51%、SID2 利用率 93.31% 看起来都"用满了",但条件利用率(每个活跃 SID1 之下实际用到的 SID2 词表占比)均值只有 2.48%、中位数 1.68%。PRQ-KMeans 测的 L2 累积前缀利用率(式 21,$|P_2|/(K_1K_2)$)本质是同一个量的另一种归一化——RQ-KMeans 为 47.88%。两篇都把这个数字当作 tokenizer 的核心诊断量,都认为它直接决定下游生成质量。
- 相近的技术骨架:都是 post-hoc、在 L2 归一化 embedding 上跑 K-Means 变体的路线,都不训练 VAE、不用 STE;都建立了一套码本级离线评测框架,在昂贵的"全量重 tokenize + 重训下游生成器"之前先筛码本——Dynamic PV-S2 用重构余弦 $R_{\text{rec}}$、利用率 $U_\ell$、簇负载 CV、full-SID 碰撞率 $R_{\text{SID}}/R_{\text{item}}$、时间稳定性 $R_{\text{chg}}$;PRQ 用 ICR(式 20)、前缀利用率(式 21)、已用前缀 Gini(式 22)。两套指标高度对应(碰撞 ↔ ICR,簇负载 CV ↔ Gini,利用率 ↔ 利用率)。
- 本文的差异与推进:同一诊断,相反处方,这是本对比最有价值的地方。 Dynamic PV-S2 的归因是"深度换容量这条路线本身就是结构性浪费",因此砍掉第二个语义层——把语义容量集中到一个大码本上($s_{\text{sem}}$ 单码 + 一个不参与语义重构的确定性哈希消歧码),把自回归预测次数从 3 次降到 2 次,再用曝光加权 k-means + EMA 中心更新 + 曝光加权换码惩罚解决码本漂移。PRQ-KMeans 的归因是"浪费是 residual carryover 造成的",因此保留层级、修好残差构造——并用受控实验(式 6/7,$\eta$ 从 1 到 0)证明 L2 利用率从 47.88% 单调升到 48.46%,完整方法进一步推到 57.78%。换句话说:Dynamic PV-S2 认为条件稀疏是层级结构的原罪,PRQ-KMeans 认为它只是残差算子实现得不好的症状。 两者对"消歧码"的态度也相反——Dynamic PV-S2 把消歧码固定成物品键的稳定哈希(跨码本版本不变,服务于流式训练的目标稳定性),PRQ 则让 OPQ/FSQ 后缀继续承担语义细化职责(PRQ-OPQ 的 ICR 达 98.74%)。
- 可比的方法 / 实验差异:两篇都在快手体系内、都用工业规模数据,但评测终点不同——Dynamic PV-S2 主打推理成本(式 20–24 推导去掉一个自回归层级的 FLOPs 与 KV cache 降幅)与时间稳定性($R_{\text{chg}}^{\text{PV}}$),PRQ 主打检索质量(HitRate/MRR)与静态码本质量,完全不讨论解码步数与漂移。这构成两篇各自的盲点:PRQ 的 L2 利用率即使涨到 57.78%,仍然要付出与 RQ-KMeans 相同的三步自回归代价;而 Dynamic PV-S2 的单层大码本放弃了共享前缀,按 PRQ 工业表里 PQ/OPQ 的表现看,这在 beam search 式生成检索里是有风险的(尽管它保留了一个语义码,与完全并行的 PQ 不同)。两篇合起来给出的信息是:「后层条件稀疏」这个现象在快手体系里是被反复确认的真实问题,但它的最优解在 2026-08 尚未收敛。
被剔除的近似候选(各附理由):
- CapsID CapsID(2026-05-06)——问题同构度很高(明确把 winner-take-all argmax 认定为"分配算子"层面的病根,正对应本文挑战二),解法也用软路由并且"扣掉所有部分一致性而非只扣胜者"(其式 7)。但它的残差更新 $r_\ell = r_{\ell-1} - \sum_k c_k o_k$ 仍是减法、不保证正交,因此并未触及 residual carryover 这个 root cause;且 CapsID 的主要赌注其实落在变长 SID + SemanticBPE 子词合并,是词表结构层面的改造。加之软权重的作用位置正好相反(CapsID 用软权重构造残差,PRQ 只用它精炼质心),判为初筛假阳性,剔除。
- DRQ DRQ(Shopee, 2026-06-01)——诊断层面高度相关:明确点出推荐 embedding 的 anisotropy / cone effect 与 RQ-VAE 的 Minkowski-sum 平坦网格几何失配,拆成 Distribution Penalty 与 Geometry Penalty,且其 Stage 2 就是 RQ-KMeans。但解法路径实质偏离:DRQ 的处方是把"VAE 学连续几何"与"K-Means 做离散匹配"解耦成两阶段,核心动作是训一个 VAE 去重塑连续空间(加可选 InfoNCE);PRQ 完全不训任何网络。更重要的是 DRQ 的 Geometry Penalty 关心的是码字之间的距离(跨码字混淆、$K_{\text{eff}}$),PRQ 关心的是单个表示与其所选质心之间的残余投影(层间信息传递)——同为"量化几何",指的却不是一回事。剔除。
- SA-RSQ SA-RSQ(天津大学 + 美团, 2026-08-24)——同样把 cascaded residual quantization 里的 arg min 换成软/可微分配算子,时间只差一天。但其问题是工业多模态特征的存储–维度耦合与不可微(为排序做稀疏表示压缩),目标函数是重建保真与存储率,不是分层 SID 的前缀结构与生成检索命中;问题层面偏离,剔除。
- AdaSID AdaSID(2026-04-26)与 QuaSID QuaSID(2026-02-28)——与本文共享 ICR / full-SID 碰撞这一评估面(QuaSID 还有快手参与),但解法都在碰撞后处理与排斥力调制(区分有害碰撞与良性重叠、深度感知语义门控、自适应压力分配),既不碰残差构造也不改质心拟合,属"问题相似但解法差异大"的典型反例。剔除。
- CRAB CRAB(Walmart Global Tech, 2026-04-06)——同为 post-hoc、同样用正则化 K-Means 修码本、同样关心码字负载均衡(Gini),但其 root cause 是流行度偏置,拆的是单层内过热的码字,与"层间残差如何传递"无关。剔除。
- BlockQuant BlockQuant(首尔大学, 2026-05-19)——把旋转式向量量化推广到球面块码本、有解析的球面块边缘分布推导,几何取向(余弦 / 球面 / 正交)与本文相近;但它是 embedding 压缩与 ANN 的通用量化理论,不构造分层 SID、不面向生成式检索的前缀结构。剔除。
十一、讨论与局限性¶
11.1 值得借鉴的设计¶
把「层间传递什么」当作一等公民。 残差量化被使用了十几年,绝大多数改进集中在「码本怎么学」(VAE、EMA、死码复活、平衡约束)或「分配怎么做」(软路由、Gumbel、capsule),而残差算子本身几乎没人动过——因为在面向重构的语境里它是被定义死的($r - c$,否则重构就不对了)。本文最漂亮的一步是指出 post-hoc 设定解除了这条约束,从而让残差算子成为一个可设计对象。这个"先论证自由度存在、再利用它"的推理链条,比方法本身更有迁移价值。
用一个受控插值实验建立因果。 式 (6)/(7) 用一个标量 $\eta$ 在「全码字相减」与「投影残差」之间连续插值,固定 L1 分配、只重拟合 L2,观察利用率单调变化。这比"我方法好、baseline 差"的端到端对比强得多,因为它把其他所有变量都锁死了。
同一个算子被复用三次。 全局均值剥离(式 11)、投影残差(式 9/16)用的是完全相同的投影算子,只是作用对象从"全局均值"换成"所选质心";余弦度量的选择又是从"投影对模长不变"推出来的。整套方法的内在一致性很高,几乎没有拼凑感。
11.2 局限与争议¶
- 没有线上 A/B。 这是最大的短板。所有工业结果都是在 KuaiSearch 这个(已公开发布的)数据集上离线跑 OneSearch 流水线,没有任何线上实验、没有 GMV / CTR / 订单量口径的业务收益,也没有报告 tokenizer 重拟合的实际耗时与上线成本。虽然 PRQ-OPQ 的兼容性实验暗示了可落地性,但"能不能上线"和"上线有没有用"是两个问题。
- 只有一个真正的工业场景。 工业结论全部来自快手电商搜索一个场景、一套 BGE 表示、一个 BART-Base 检索器。Qwen3 嵌入替换实验缓解了"依赖特定编码器"的担忧,但没有缓解"依赖特定业务/语料"的担忧。
- 投影残差丢掉的信息真的不重要吗? 本文的论证是"$\alpha\hat{c}$ 这一分量已经被当前 token 表示过了"。但严格说,token 只记录了质心的下标,而 $\alpha$ 是连续值——同一个 token 下的物品,$\alpha$ 各不相同,这个差异被投影永久丢弃了。式 (17) 恰恰说明这个被丢弃量的方差就是簇内投影系数方差,未必可忽略。论文靠"post-hoc 不需要重构"来正当化,但当 SID 被用于重构式下游任务(如把 SID 反解回 embedding 做召回打分、或用于多模态压缩存储)时,这个丢弃就不是无害的。论文没有讨论这个边界。
- −Projection 消融把两件事绑在了一起。 该变体同时把「投影 → 全码字相减」和「余弦 → 欧氏」两处改回去,因此无法分离"正交化"与"余弦度量"各自的贡献。虽然作者的理由(投影的模长无关性要求配余弦)在方法上自洽,但从实证角度看,"−Projection 跌幅最大"这个结论里混入了度量切换的效应。
- 超参需要按码本规模调。 $k = 2$(公开,码本 256)与 $k = 5$(工业,码本 1024/512/128)不同,$\beta$ 的最优值也随数据集变(Toys 上是 10,其余是 15)。论文给了直觉解释但没给选择规则,实践中仍需搜索。
- 五层设定的收益迅速衰减。 PRQ-OPQ 相对 RQ-OPQ 只有 0.6%–1.9%,远小于三层设定下的 6.4%–11.8%,且 ICR 略降。一旦后缀 token(OPQ / FSQ)承担了主要的区分职责,前缀质量的边际价值就大幅下降——而工业系统恰恰普遍在用五层混合方案。论文没有正面讨论这个"方法收益与工业现状之间的错位"。
- 与并发工作的关系未被讨论(客观限制,非作者过失):同日的 Tlow 与 4 天前同公司的 Dynamic PV-S2 对同一批症状给出了完全不同的处方,本文自然无法回应。
11.3 工业落地价值¶
本文的工业属性来自三处:作者全部来自快手;实验建立在快手 OneSearch 生产级生成式电商搜索栈之上(沿用其 128 维蒸馏 BGE 表示、BART-Base 检索器、三阶段训练协议与 Order/Click 评测口径),数据规模为 780 万物品 / 900 万查询记录 / 三阶段 3600–5400 万训练样本;PRQ-OPQ 明确针对 OneSearch 已部署的 RQ-OPQ tokenizer 接口做了最小侵入式替换(只换前两层,保留 balanced 第三层与两个 OPQ 后缀),这是一条清晰的上线路径。tokenizer 拟合在纯 CPU 服务器上完成(双路 AMD EPYC 9654 + 2.2TB 内存),不占用 GPU 资源,25 轮软精炼相对 RQ-KMeans 的 25 轮聚类没有量级上的额外开销,SID 编码阶段与 RQ-KMeans 完全同构(只是把减法换成投影 + 归一化),推理侧零额外成本。但必须强调:全程离线、无线上 A/B、无业务指标,因此它是"生产规模系统上的离线证据"而非"已验证的线上收益"。