LGRID:把 LLM 隐状态先拆成属性对齐槽位,再量化成可解释的本地生活 Semantic ID¶
Kuaishou Technology(快手)· arXiv:2607.27944v1 [cs.IR] · 2026-07-30 Long Zhang*、Hao Jiang*†、Sheng Yu、Fei Pan、Peng Jiang、Kun Gai(* 共同一作,† 通讯作者),全部来自快手科技北京
研究动机与背景¶
本地生活服务推荐的特殊约束¶
本地生活(Local-Life Service)推荐是基于位置的服务(LBS)推荐的代表形态:平台利用用户的位置信息与交互历史,推荐附近的餐厅、外卖、生活服务商户。快手、美团、饿了么这类平台都在用地理相关的内容匹配大规模用户群。
与常规电商 / 视频推荐相比,LBS 推荐有一条根本性的额外约束:相关性首先受空间可达性(spatial reachability)支配。由于线下到店成本与距离限制,用户决策通常遵循 "先地理可达、后兴趣匹配"(geographic reachability first, interest matching second)的模式——交互概率随用户–物品距离增加而急剧衰减。因此空间感知对 LBS 推荐是必需项而非可选项。
传统基于 ID 的推荐器在这里明显不适配:稀疏 item ID 既不编码可迁移的语义,也不携带显式空间结构。已有工作虽然把时空信号并入用户交互序列,但通常把位置信息当作辅助上下文、或编码成离散化特征,而不是去学一个带显式空间结构的物品级表示。结果是它们难以捕获空间相关的用户行为,以及用户–物品距离对交互似然的影响。
现有 SID 范式的两个瓶颈¶
LLM 与 Semantic ID(SID)生成给出了另一条路:LLM 提供可迁移的语义先验,SID 方法把物品内容或协同信号量化成紧凑 token 标识符,用来替换或增广稀疏 item ID。为增强空间感知,近期出现了一批 geo-aware SID 方法——OneLoc [8]、GNPR-SID [21]、LGSID [7]——它们在 tokenization 之前注入或对齐地理信号。
但本文指出:这些方法把地理信号注入的是一个"混合的物品表示",而不是保留显式的属性结构。于是量化器仍然作用在地理、语义、上下文信号混杂的一个潜向量上。作者把这一设计统称为 single-representation-then-quantization(先单一表示、后量化)范式,并指出它在 LBS 场景下有两个瓶颈:
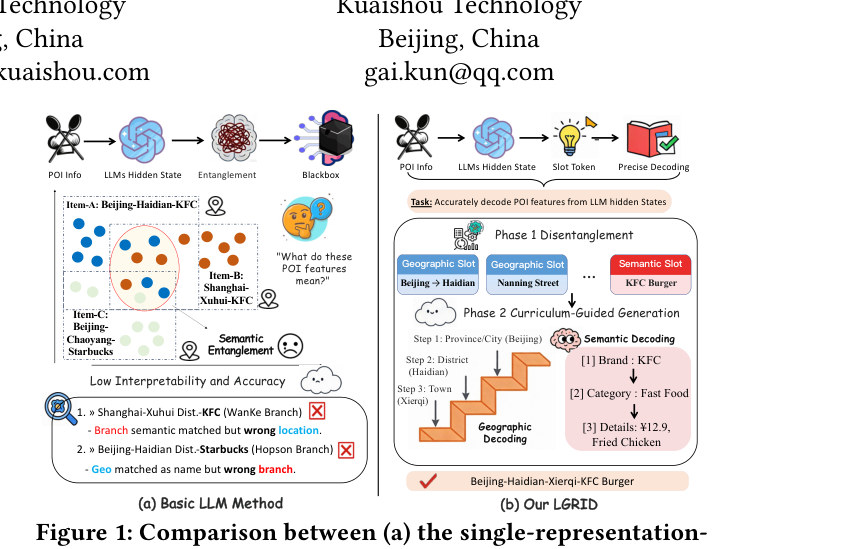
瓶颈一:语义纠缠(Semantic Entanglement)。 表示阶段就把地理、品牌、品类压进一个潜空间,量化时 SID 质量随之退化。品牌这类主导信号会遮蔽细粒度但对决策至关重要的地理区分。这在 LBS 里危害尤其大:语义相似但服务区域完全不同的物品会被映射到过于相似的 SID——例如 "Beijing–Haidian–KFC" 与 "Shanghai–Xuhui–KFC" 不应该拿到高度相似的 SID。Figure 1(a) 给的两个真实失败案例是:
- "Shanghai-Xuhui Dist.-KFC (WanKe Branch)" —— 品牌语义匹配上了,但位置错了;
- "Beijing-Haidian Dist.-Starbucks (Hopson Branch)" —— 地理作为名字匹配上了,但分店错了。
瓶颈二:黑盒表示(Black-box Representation)。 单一表示的学习与量化都限制了可解释性:学到的表示不带显式属性语义,SID 的每个位置无法归因到具体的地理或语义因子。这个问题被 LBS 的地理层级进一步放大——省、市、区、镇定义了逐级精细的服务区域,而现有方法把它们压平进一个混合表示,于是得到的标识符可能保留了品牌语义,却把位置或分店信息编错。
这两点同时削弱了检索可靠性与诊断 / 控制 SID 生成的能力。
一个看似显然的补救为什么不行¶
既然纠缠是问题,那就把地点、品牌、品类等结构化字段独立编码不就行了?这确实避免了跨字段混合,但它同时阻断了 geo-content 交互。作者用 Table 4 直接反驳了这条路:LGRID 相对独立字段级编码取得了 31.4%–88.5% 的相对 MRR 提升。
论文给出的直觉很好:在 LBS 里,地理不只定位一个物品,它还语境化了物品的语义——"Apple" 出现在电子产品街区更可能是零售商而非水果摊。因此融合编码携带了异质属性,而独立字段级编码丢失了 geo-content 交互。
于是 LBS 的 SID 生成需要一个既保留这些依赖、又在量化前施加显式属性结构的框架。由于 LLM 隐状态已被证明编码了可抽取、可解码、可引导(steerable)的概念 [25-29],本文提出核心问题:
能否有一个 SID 生成框架,把纠缠的 LLM 隐状态在量化之前转换成属性对齐的地理槽位与语义槽位?
本文方案与贡献¶
答案是 LGRID(Interpretable Representation via LLM-Driven Generative Disentanglement for Local-Life Service Recommendation),它把 SID 生成重构为 quantization 之前的 generative disentanglement(生成式解耦),实现为一条 Encode → Disentangle → Align → Quantize 流水线。
三条主要贡献:
- 指出主流 single-representation-then-quantization 范式在本地生活 SID 生成中的关键局限:现有方法(含 geo-aware 变体)仍在量化一个共享的物品侧表示,导致语义纠缠、黑盒、严重碰撞;而独立字段级编码又丢失关键的 geo-content 依赖。
- 提出 LGRID,一个 generative-disentanglement-before-quantization 框架:instantiate 一条 encode → disentangle → align → quantize 流水线,保留 geo-content 依赖、构造属性对齐的地理槽与语义槽、再把这些槽分别量化成紧凑 SID。
- 在 Kuaishou 与 Foursquare 上验证:跨多种推荐骨干一致提升,最高 +5.44% 相对 AUC;粗粒度地理属性解码准确率 >99%;全 SID 碰撞率从 LGSID 的 97.0% 降到 39.9%。
相关工作¶
Item Tokenization。 传统推荐用从协同信号学出的稀疏 ID 表示物品,缺语义信息、重度依赖交互数据、易受冷启动与长尾影响。近期的 item tokenization 用 LLM 把物品内容编码成语义嵌入再量化成定长 token 序列,通常遵循「表示 + 量化」两阶段:表示侧 TIGER [18] 与 LC-Rec [19] 从物品侧内容抽语义嵌入,LETTER [33]、EAGER [34]、OneRec [35, 36] 进一步纳入协同或多模态信号;量化侧残差方法占主导(coarse-to-fine 码),RQ-VAE [18] 被 LC-Rec 采用,Recbase [37]、COBRA [38]、GFlowGR [39] 与 QARM [20]、相似度-/n-gram-based 变体 [40, 41] 改进码本利用率并探索替代码构造策略。近期研究把地理信号纳入 SID:OneLoc [8] 与 GNPR-SID [21] 为位置感知推荐整合地理语义表示线索,LGSID [7] 用强化学习把 LLM 表示与空间信号对齐。但地理信号仍是在量化前被注入一个共享的物品表示,而非用来形成显式的属性对齐结构,因此量化器作用于一个不透明的潜向量,其 SID 位置并不显式对应地理或语义因子。
Interpretable LLM Representation。 LLM 导出的物品嵌入仍是黑盒,其内部维度不携带属性级含义,导致产出的码无法被检视或验证。推荐领域内,LMIndexer [42] 与 PLUM [43] 直接从 LLM 表示学 SID,但把 ID 当成扁平序列,编码的是整体表示、模糊了属性层级的边界;更广义地,LLM-based 推荐的可解释性工作 [44, 45] 提供的是事后解释,没有暴露表示所需的属性级结构。NLP 社区的 probing 研究 [46-48] 与 Patchscopes [49] 这类检视框架表明 LLM 隐状态含线性可抽取结构,representation engineering / activation steering [25, 27, 50, 51] 进一步证明该结构可在推理时被操纵。但 probing 与 steering 主要把可解释性当作事后或推理时操作,在「被解释的东西」与「SID 构造所需的东西」之间留下了空隙。LGRID 把可解释性变成一个训练时的表示构造目标:学习属性对齐的地理槽与语义槽,在训练中被解码与对齐,然后分别量化成紧凑 SID。
核心方法 / 模型架构¶
3.1 问题定义¶
LBS 推荐的目标是在严格受空间半径约束(如 5 km)的候选物品中预测用户偏好。形式化地,令 $\mathcal{U}$、$\mathcal{V}$ 分别为用户与物品集合,用户 $u$ 的历史序列 $H_u = (v_1, \ldots, v_T)$。定义空间有效候选集 $\mathcal{V}_u^D \subseteq \mathcal{V}$,只包含距离限 $D$ 之内的物品。任务即学一个打分函数,估计在第 $T+1$ 步对 $v \in \mathcal{V}_u^D$ 的交互概率。LGRID 的目标是产出可解释的层次化物品表示来增强这一打分过程。
3.2 总览¶
LGRID 沿 encode → disentangle → align → quantize 流水线,针对的正是 single-representation-then-quantization 在表示构造阶段的失效模式(Figure 2)。这个顺序是核心:不是去量化一个已融合的物品表示,而是先让属性结构显式化,再离散化由此得到的地理槽与语义槽。
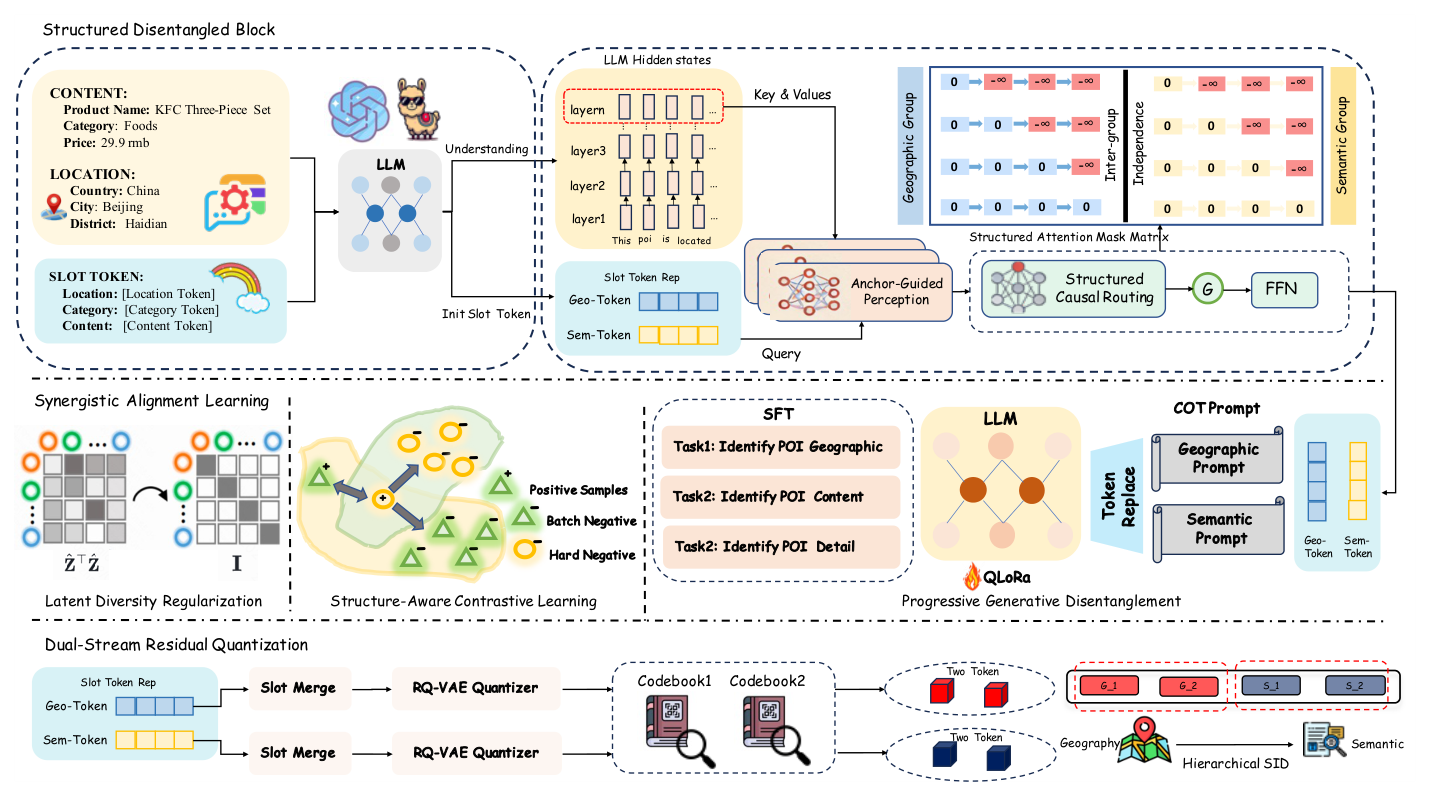
一个 LLM 先联合编码 POI 文本,得到纠缠的隐状态。三个阶段依次:
- Stage 1 — Structured Disentangled Block(SD-Block):把这些状态路由进属性对齐的地理槽与语义槽;
- Stage 2 — Synergistic Alignment Learning(SAL):通过 coarse-to-fine 属性监督与对比正则,使槽位可被 LLM 解码、有判别力、且非冗余;
- Stage 3 — Dual-Stream Residual Quantization(DSRQ):把地理与语义两条槽位流分别量化成紧凑 Semantic ID。
3.3 联合 LLM 编码¶
给定覆盖位置、品牌、品类的物品文本 $\mathcal{S}$,骨干 $\text{LLM}_\phi$ 产出上下文隐状态
$$\mathbf{H} = \text{LLM}_\phi(\mathcal{S}) \in \mathbb{R}^{L \times d},$$
允许 self-attention 在任何解耦发生之前就捕获双向的 geo-content 依赖。虽然语义上很丰富,$\mathbf{H}$ 通常是纠缠的 [52],朴素聚合(如 mean pooling 或取 [CLS] token)容易造成语义平滑与信息损失。正是这一纠缠表示,动机化了后续的结构化解耦;作者在 §4.3 用实验把联合编码与独立字段级编码做了对照验证。
3.4 Structured Disentangled Block(SD-Block)¶
SD-Block 通过三个组件把纠缠隐状态 $\mathbf{H}$ 解耦成 $N$ 个属性对齐的槽 token:Semantic Anchor Injection (SAI)、Anchor-Guided Perception (AGP) 与 Structured Causal Routing (SCR)。
3.4.1 Semantic Anchor Injection(语义锚注入)¶
标准 Q-Former [53] 的 query 是随机初始化的,因 attention 的置换对称性 [54-56] 而没有固有的属性绑定。LGRID 改用对应属性的领域特定 prompt token $\mathcal{T}$(如 "Provincial Unit"、"Brand Name")来初始化这 $N$ 个 query token,产出语义锚 [57]:
$$\mathbf{Z}^{(0)} = \text{LLM}_\phi(\mathcal{T}) + \mathbf{P}_{\text{pos}}, \tag{1}$$
其中 $\mathbf{P}_{\text{pos}}$ 是位置嵌入。把槽 token 接地在 LLM 的语义空间里,建立了槽与物理属性之间的一一对应。实例化 $N = 8$ 个槽:$k = 4$ 个地理槽镜像行政层级(省、市、区、镇),$N - k = 4$ 个语义槽(品牌、品类等)。完整锚词见 Table 11:
| 槽位 | 锚词(Anchor) | 角色 |
|---|---|---|
| 地理流 | ||
| 0 | Province unit | Province / state |
| 1 | City unit | City / prefecture |
| 2 | District location | District / county |
| 3 | Town | Town / township / street |
| 语义流 | ||
| 4 | Brand name | Brand identity |
| 5 | Primary category | Business category |
| 6 | Hot-selling products | Products / services |
| 7 | Business characteristics | Products, services, and style |
注:工业 POI 元数据是中文,实现里用的是同义的中文锚词短语,Table 11 给的是英文翻译。这些锚不是额外监督标签、也不含目标答案,它们只提供语义上有意义的初始方向、降低槽学习的置换歧义。
3.4.2 Anchor-Guided Perception(锚引导感知)¶
AGP 用槽 token 作为 query,从 $\mathbf{H}$ 里探测属性特定的信息。先注入正弦位置编码 $\hat{\mathbf{H}} = \mathbf{H} + \mathbf{P}_{\text{src}}$,然后在第 $l$ 层让槽作为 query 参与多头交叉注意力:
$$\hat{\mathbf{A}}^{(l)} = \mathbf{Z}^{(l-1)} + \text{Dropout}\big(\text{CrossAttn}(\mathbf{Z}^{(l-1)}, \hat{\mathbf{H}}, \hat{\mathbf{H}})\big). \tag{2}$$
AGP 因此充当一个语义过滤器,把稀疏线索(如提到 "Chaoyang District")路由进对应的槽、同时抑制噪声。残差性的"软纠缠"(例如含地名的品牌名)可能残留,由 SCR 解决。
3.4.3 Structured Causal Routing(结构化因果路由)¶
每个解耦层内,AGP 的输出 $\hat{\mathbf{A}}^{(l)}$(简记 $\hat{\mathbf{Z}}$)再由 SCR 精修,其中 "causal" 指的是每个组内部的自回归 attention 顺序。
结构化注意力掩码。 把 $N$ 个槽 token 划分为地理组 $\mathcal{G}_{\text{loc}} = [0, k)$ 与语义内容组 $\mathcal{G}_{\text{sem}} = [k, N)$,划分方式遵循 SAI 定义的语义锚。为强制"组内自回归、组间独立",引入结构化掩码 $\mathbf{M} \in \mathbb{R}^{N \times N}$:
$$\mathbf{M}_{ij} = \begin{cases} 0 & \text{if } \exists g \in \{\mathcal{G}_{\text{loc}}, \mathcal{G}_{\text{sem}}\},\ \{i, j\} \subseteq g \wedge j \le i \\ -\infty & \text{otherwise.} \end{cases} \tag{3}$$
这套设计施加两条硬约束:
- 组内自回归($j \le i$):强迫 token 只关注同组内在它之前的槽,使信息流与行政层级的包含顺序(Province → City)对齐;
- 组间独立($\{i,j\} \not\subseteq g$):阻断跨组 attention 通路,防止混合特征跨组。
自适应门控路由。 用 LayerNorm 并注入位置编码 $\mathbf{P}$ 构造 query / key:$\mathbf{Q} = \mathbf{K} = \text{LayerNorm}(\hat{\mathbf{Z}}) + \mathbf{P}$,value $\mathbf{V} = \text{LayerNorm}(\hat{\mathbf{Z}})$。信息流由结构化掩码 $\mathbf{M}$ 支配:
$$\mathbf{S} = \text{Softmax}\left(\frac{\mathbf{Q}\mathbf{K}^\top}{\sqrt{d}} + \mathbf{M}\right)\mathbf{V}. \tag{4}$$
为避免初始化时硬掩码带来的梯度不稳 [58],用一个可学习门 $\sigma(\alpha)$ [59] 调制更新:
$$\mathbf{Z}_{\text{scr}} = \hat{\mathbf{Z}} + \sigma(\alpha) \cdot \text{Dropout}(\mathbf{S}), \tag{5}$$
再接一个标准 pre-norm FFN 块:$\mathbf{Z}^{(1)} = \text{FFN}(\text{LayerNorm}(\mathbf{Z}_{\text{scr}})) + \mathbf{Z}_{\text{scr}}$,最后一层输出记为 $\mathbf{Z}$。
附录 B.4 给出等价的可见性矩阵写法:8 个槽时形成两个独立的下三角块($i, j \in [0,4)$ 与 $i, j \in [4,8)$),前者遵循 coarse-to-fine 地理层级,后者遵循 brand–category–detail 模式。
3.5 Synergistic Alignment Learning(协同对齐学习)¶
SD-Block 产出属性对齐槽后,Stage 2 优化它们使之可被 LLM 解码且有判别力。这一阶段耦合两个互补目标——Progressive Generative Disentanglement (PGD) 负责层次化语义顺序,Structure-Aware Contrastive Learning (SACL) 负责细粒度判别力——外加一个轻量的多样性正则 (LDR) 防止槽塌缩。
3.5.1 Progressive Generative Disentanglement(渐进式生成解耦)¶
PGD 让每个槽通过 coarse-to-fine 属性监督变得 LLM-decodable。给定槽表示与一个属性特定 prompt,解码器 $P_{\text{dec}}$(由 LLM 骨干实例化)预测与目标槽关联的属性值,促使该槽被语义解码、并与其意图含义对齐。
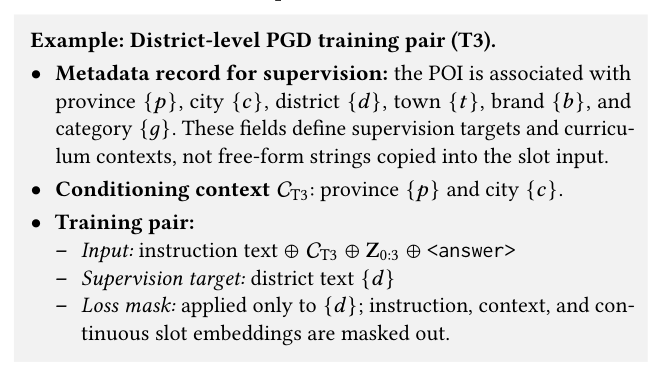
关键设计:每个 PGD 任务只把对应属性标签当作监督目标,解码器输入只含 prompt 与槽表示。因此 PGD 是一个槽级语义解码目标(面向可解释性),而不是重建输入字段。
PGD 遵循一条尊重属性依赖的课程引导解码路径:地理链(槽 1–4)预测 province → city → district → town,每一级都以更粗一级的地理上下文为条件;语义链(槽 5–8)顺序解码 brand → category → 更细语义属性。要预测第 $m$ 个任务的属性值 $y_m$,把槽 token $\mathbf{Z}_{\le m}$ 与属性特定解码 prompt $\mathbf{p}_m$ 拼接,用属性级监督优化解码器:
$$\mathcal{L}_{\text{pgd}}^{(m)} = -\sum_{t=1}^{T_m} \log P_{\text{dec}}(y_{m,t} \mid y_{m,<t},\ \mathbf{p}_m,\ \mathbf{Z}_{\le m}). \tag{6}$$
举例:任务 T3(区级)以 T1–T2 恢复出的省与市为条件,输入拼接指令("…identify the district within the given city…")、槽嵌入 $\mathbf{Z}_{0:3}$ 与一个 <answer> 标记,loss 只施加在目标区名上,指令与槽 token 被 mask 掉。通过把生成从整体约束到局部,这套课程式目标无需人工标注就把属性路由到了它们指定的槽位。
七个 PGD 任务的完整 schema(Table 13):
| 任务 | 家族 | 槽输入 | 监督目标 | 条件化原则 |
|---|---|---|---|---|
| T1 | Geo–Province | $\mathbf{Z}_{0:1}$ | Province / state | 解码最粗的地理属性 |
| T2 | Geo–City | $\mathbf{Z}_{0:2}$ | City / prefecture | 在省级上下文下解码市 |
| T3 | Geo–District | $\mathbf{Z}_{0:3}$ | District / county | 在省 + 市上下文下解码区 |
| T4 | Geo–Town | $\mathbf{Z}_{0:4}$ | Town / township / street | 在全部更粗地理上下文下解码微观位置 |
| T5 | Entity–Brand | $\mathbf{Z}_{4:5}$ | Brand | 解码标准化商户或 POI 品牌 |
| T6 | Entity–Category | $\mathbf{Z}_{5:6}$ | Category | 解码最具体的业务品类 |
| T7 | Entity–Detail | $\mathbf{Z}_{6:8}$ | Detail text | 解码产品、服务与经营特征 |
地理任务遵循累积式 coarse-to-fine 顺序:任务 T$m$ 拿到直到目标层级的槽前缀 + 对应的更高层地理上下文。语义任务用 task-specific 槽切片,因为品牌、品类、细节属性不遵循严格的行政包含层级。评测时更高层的上下文由前序 PGD 预测自回归生成,而非 oracle 标签——即报告的解码准确率不含标签泄漏。
3.5.2 Structure-Aware Contrastive Learning(结构感知对比学习)¶
PGD 建立的是初步的层次结构;纯生成目标常受判别瓶颈之苦,会对结构相似的实体(如不同镇里的同品牌门店)产生过度平滑的表示。SACL 通过正样本对齐强制语义一致性,并从结构化难负例注入细粒度判别信号。
语义一致性:正样本构造。 为保持槽对物品语义忠实,最大化「聚合槽表示」(在槽上 mean-pool,锚视图 $\mathbf{v}_{\text{anc}}$)与「从 ground-truth 元数据导出的参考视图」(目标视图 $\mathbf{v}_{\text{pos}}$)之间的一致性。$\mathbf{v}_{\text{pos}}$ 的获取方式是:把一句元数据导出的描述性句子喂进 LLM 骨干,用加权池化聚合隐状态,从而提供一个无压缩损失的监督信号。
结构化判别:层次化难负例挖掘。 标准随机采样难以区分高度相似的实体。令 $y_{\text{geo}}^{(c)}$、$y_{\text{geo}}^{(f)}$、$y_{\text{sem}}$ 分别表示粗粒度位置、细粒度位置与语义内容。对锚 $x_i$ 构造三个互补的难负例集,每个控制一个属性、变化另一个:
(i) 空间特异性(Spatial Specificity): 选同一粗区域但细粒度位置不同的物品:
$$\mathcal{N}_{\text{loc}} = \{x_j \mid y_{\text{geo}}^{(c)}(x_j) = y_{\text{geo}}^{(c)}(x_i) \wedge y_{\text{geo}}^{(f)}(x_j) \neq y_{\text{geo}}^{(f)}(x_i)\}. \tag{7}$$
这迫使表示在同一粗区域内保留细粒度空间区分。
(ii) 语义独立性(Semantic Independence): 选同一细粒度位置但语义内容不同的物品:
$$\mathcal{N}_{\text{sem}} = \{x_j \mid y_{\text{geo}}^{(f)}(x_j) = y_{\text{geo}}^{(f)}(x_i) \wedge y_{\text{sem}}(x_j) \neq y_{\text{sem}}(x_i)\}. \tag{8}$$
这防止地理上下文变成语义判别的捷径。
(iii) 跨区域判别(Cross-Region Discrimination): 选语义内容相同但粗区域不同的物品:
$$\mathcal{N}_{\text{ent}} = \{x_j \mid y_{\text{sem}}(x_j) = y_{\text{sem}}(x_i) \wedge y_{\text{geo}}^{(c)}(x_j) \neq y_{\text{geo}}^{(c)}(x_i)\}. \tag{9}$$
这防止语义相似的物品塌缩成不可区分的表示。
三者合并为 $\mathcal{N}_{\text{hard}}(x_i) = \mathcal{N}_{\text{loc}} \cup \mathcal{N}_{\text{sem}} \cup \mathcal{N}_{\text{ent}}$。当某个目标集为空时,层次化地放宽对应的地理约束(如从 town 放宽到 district)以提升覆盖率、同时保留负例难度(附录 B.5)。附录还说明:难负例从建在省 / 市 / 区 / 镇 / 品牌字段上的倒排索引中采样,每个 POI 挖 $K = 6$ 个结构化难负例;难负例池太小时用随机负例补齐,这条 fallback 在稀疏长尾 POI 上稳定了训练。
统一对比目标。 整合进一个 InfoNCE:
$$\mathcal{L}_{\text{sacl}} = -\log \frac{E(\mathbf{v}_{\text{pos}})}{E(\mathbf{v}_{\text{pos}}) + \lambda \sum_{\mathbf{v}_n \in \mathcal{N}_{\text{hard}}} E(\mathbf{v}_n) + \sum_{\mathbf{v}_r \in \mathcal{N}_{\text{batch}}} E(\mathbf{v}_r)}, \tag{10}$$
其中 $E(\mathbf{v}) = \exp(\text{sim}(\mathbf{v}_{\text{anc}}, \mathbf{v}) / \tau)$ 是指数化相似度,$\mathcal{N}_{\text{batch}}$ 是 batch 内负例。
3.5.3 Latent Diversity Regularization(潜在多样性正则)¶
为防止槽间冗余,施加 LDR,鼓励子空间正交性使每个槽捕获非重叠特征。做法是最小化 $\ell_2$-归一化槽表示 $\tilde{\mathbf{Z}}$ 的 Gram 矩阵与单位阵之差的 Frobenius 范数:
$$\mathcal{L}_{\text{ldr}} = \|\tilde{\mathbf{Z}}^\top \tilde{\mathbf{Z}} - \mathbf{I}\|_F^2. \tag{11}$$
3.5.4 总优化目标¶
$$\mathcal{L} = \lambda_1 \sum_m \mathcal{L}_{\text{pgd}}^{(m)} + \lambda_2 \mathcal{L}_{\text{sacl}} + \lambda_3 \mathcal{L}_{\text{ldr}}. \tag{12}$$
3.6 Dual-Stream Residual Quantization(DSRQ)¶
给定 Stage 2 产出的可验证、有判别力的槽,DSRQ 把它们离散化成紧凑 Semantic ID,且这些 SID 携带地理–语义的分离性进入离散码。
3.6.1 并行双流架构¶
由于地理特征 $\mathbf{Z}_{\text{geo}}$ 与语义特征 $\mathbf{Z}_{\text{sem}}$ 存在分布分歧,共享量化空间常导致码本竞争 / 语义混淆。因此采用两条并行分支:地理分支把 $\mathbf{Z}_{\text{geo}}$ 映射到码 $\mathbf{C}_{\text{geo}}$,语义分支把 $\mathbf{Z}_{\text{sem}}$ 映射到 $\mathbf{C}_{\text{sem}}$。
3.6.2 结构化残差量化¶
为在有限码本预算内保证高精度映射,采用残差量化(RQ)[18] 做 coarse-to-fine 递归近似。每条流的槽先经拼接 + 投影聚合成单向量 $\mathbf{z}$,再在 $D$ 次迭代中被分解为 $D$ 个码本 $\mathcal{C}$ 中码字的线性组合,得重建 $\hat{\mathbf{z}} = \sum_{d=1}^{D} \mathbf{e}_{i_d}$,$\mathbf{e}_{i_d} \in \mathcal{C}$。这种 coarse-to-fine 递归恰好镜像了 PGD 在离散码上的层次结构。
DSRQ 在 Stage 2 收敛后训练,槽表示冻结,用重建 + commitment 双 loss:
$$\mathcal{L}_{\text{RQ}} = \|\mathbf{z} - \hat{\mathbf{z}}\|^2 + \sum_{d=1}^{D} \|\text{sg}[\mathbf{r}_{d-1}] - \mathbf{e}_{i_d}\|^2, \tag{13}$$
其中 $\text{sg}[\cdot]$ 是 stop-gradient,$\mathbf{r}_d = \mathbf{r}_{d-1} - \mathbf{e}_{i_d}$ 是第 $d$ 步残差($\mathbf{r}_0 = \mathbf{z}$)。每条流用 $D = 2$ 个码层,因此得到 4-token 的 Semantic ID:$\text{SID}(v) = [c_{\text{geo}}^{(1)}, c_{\text{geo}}^{(2)}, c_{\text{sem}}^{(1)}, c_{\text{sem}}^{(2)}]$。
3.6.3 部署与流水线小结¶
对非 SID 的推荐骨干,Semantic ID 不替换原始 item ID。做法是把四个 SID 码嵌入成一个 SID 表示,与原始 item-ID 嵌入拼接:
$$\mathbf{e}_v = \left[\mathbf{e}_{\text{item}}(v);\ \sum_{\ell=1}^{4} \mathbf{e}_{\text{sid}}(c_{o,\ell})\right], \tag{14}$$
其中 $\mathbf{e}_{\text{item}}(v)$ 是标准 item-ID 嵌入、$\mathbf{e}_{\text{sid}}(c_{o,\ell})$ 是第 $\ell$ 个 SID 码的嵌入。这一统一协议不要求骨干做任何架构改动,保证了对所有推荐器的公平比较。所有步骤离线跑,serving 时只用预生成的 SID。
Algorithm 1(LGRID Semantic ID 构造流水线)
输入: POI 文本 S; 骨干 LLM_φ; 锚 T; DSRQ 码本
输出: Semantic ID SID(v)
1: Encode & init:  H = LLM_φ(S);          Z^(0) = LLM_φ(T) + P_pos
2: Disentangle:    Z = SDBlock(H, Z^(0))                  ▷ SAI → AGP → SCR
3: Align:          optimize  λ1 Σ_m L_pgd^(m) + λ2 L_sacl + λ3 L_ldr
4: Quantize:       C_geo = RQ_geo(Z_[0:k)) ;  C_sem = RQ_sem(Z_[k:N))
5: return SID(v) = [c_geo^(1), c_geo^(2), c_sem^(1), c_sem^(2)]
实验设置¶
数据集¶
在一个真实工业 Kuaishou 数据集与一个公开 LBS benchmark Foursquare 上评测。两个数据集都提供地理与文本物品信息;Foursquare 侧的粗粒度位置描述由经纬度导出。
Table 8:数据集统计
| 数据集 | Interactions | Users | Items | Categories |
|---|---|---|---|---|
| Kuaishou | 10,000,000 | 6,673,350 | 2,251,418 | 1,000 |
| Foursquare | 244,896 | 1,084 | 38,334 | 401 |
Kuaishou 是大规模工业数据集,含丰富 POI 元数据(地理属性与文本描述);Foursquare 是公开 LBS 数据集,不提供工业语料那种显式 POI 层级文本,故由经纬度推导粗位置描述。两者让 LGRID 同时在大规模工业与稀疏公开 LBS 场景下受检。
Baseline 与骨干¶
- 推荐骨干(10 个):DIN、DIEN、ETA、SIM、TWIN、HSTU、RankMixer、GRU4Rec、BERT4Rec、SASRec。
- SID 方法(6 个):RQ-VAE、Res-KMeans、RQ-VAE-cos、RQ-VAE-NGram、LGSID、LGSID++(LGSID++ 用 G-GRPO 替代 G-DPO 以提升空间感知)。
实现与超参(Table 9)¶
| 类别 | 超参 | 取值 |
|---|---|---|
| 模型配置 | Backbone | Qwen3-8B |
| LoRA rank / scale | $r = 16$, $\alpha = 32$ | |
| LoRA dropout | 0.05 | |
| LoRA target modules | 所有线性层 | |
| SD-Block | Attention heads | 16 |
| Slot tokens | 8 | |
| 优化 | Optimizer / Scheduler | AdamW / Cosine |
| Warmup ratio | 0.05 | |
| Per-device batch size | 12 | |
| Effective global batch size | 192(4 GPU × 12 × 4 梯度累积) | |
| Stage 1 | 目标 / Epochs | Alignment / 6 |
| LR(compressor / LoRA) | $1.6\times10^{-4}$ / $8.0\times10^{-5}$ | |
| Stage 2 | 目标 / Epochs | Fine-grained tuning / 4 |
| LR (global) | $5.0\times10^{-5}$ | |
| Loss 权重 | 粗粒度属性解码 | 1.6 |
| 细粒度属性解码 | 1.8 | |
| 对比 loss | Warmup → 0.66 | |
| 正交 / 多样性 | 0.05 | |
| InfoNCE 温度 | 初始 0.07,clip 到 $[0.05, 0.20]$ | |
| 硬件 | GPUs | 4 × NVIDIA L20(48GB each) |
SID 构造语料:从工业 Kuaishou 语料中 curate 出 120,000 个训练 POI + 5,000 个 held-out 验证 POI 的 POI-text 子集,跨品类均衡,排除元数据缺失 / 错误 / 语义不完整的 POI。
下游推荐训练:SID 生成后与原始稀疏 ID 嵌入融合。batch size 10,240,用户 / 物品 / SID 嵌入维度均设为 8。每个预测塔用 MLP,维度 [32, 16, 1]。AdamW,学习率 0.1,StepLR 每 500 步衰减 0.9。
评测协议(附录 A.3)¶
- Kuaishou 空间受限排序:沿用 LGSID 评测协议,用固定离线距离阈值 $D = 15$ km 构造候选集。该阈值仅用于离线 benchmark,不是 LGRID 的建模假设。所有方法用同一候选集。
- Foursquare 全量排序:Foursquare 缺生产候选生成器与动态距离策略,故采用序列推荐研究里的标准 full-ranking 协议。
- 所有方法用相同 train/val/test 划分、候选集与评测标签;SID 构造在推荐训练之前离线完成,下游只用生成的 SID token + 标准 item-ID 嵌入。
主要实验结果¶
4.2 整体性能(Table 1)¶
Table 1:跨推荐骨干的 AUC 对比。"vs. SOTA" 是相对每个骨干最强 baseline 的相对提升。
Kuaishou
| Method | GRU4Rec | DIN | SASRec | BERT4Rec | DIEN | SIM | ETA | TWIN | HSTU | RankMixer |
|---|---|---|---|---|---|---|---|---|---|---|
| Base | 0.6324 | 0.5994 | 0.6252 | 0.6408 | 0.6444 | 0.5991 | 0.6036 | 0.6124 | 0.6387 | 0.5995 |
| Res-KMeans | 0.6377 | 0.6361 | 0.6382 | 0.6418 | 0.6436 | 0.6580 | 0.6259 | 0.6671 | 0.6453 | 0.6048 |
| RQ-VAE | 0.6373 | 0.6346 | 0.6529 | 0.6554 | 0.6365 | 0.6468 | 0.8745 | 0.6509 | 0.6448 | 0.6130 |
| RQ-VAE-cos | 0.6424 | 0.6306 | 0.6524 | 0.6536 | 0.6345 | 0.6464 | 0.6612 | 0.6535 | 0.6440 | 0.6131 |
| RQ-VAE-NGram | 0.6301 | 0.6462 | 0.6465 | 0.6429 | 0.6154 | 0.6596 | 0.7629 | 0.6612 | 0.6336 | 0.6037 |
| LGSID | 0.6451 | 0.6519 | 0.6334 | 0.6435 | 0.6460 | 0.6576 | 0.8165 | 0.6610 | 0.6433 | 0.6126 |
| LGSID++ | 0.6436 | 0.6546 | 0.6493 | 0.6538 | 0.6551 | 0.6671 | 0.8327 | 0.6734 | 0.6465 | 0.6019 |
| Ours (LGRID) | 0.6805 | 0.6604 | 0.6647 | 0.6670 | 0.6617 | 0.6732 | 0.8821 | 0.6818 | 0.6492 | 0.6187 |
| vs. SOTA (Δ%) | +5.44% | +0.89% | +1.81% | +1.77% | +1.01% | +0.91% | +0.87% | +1.25% | +0.42% | +0.92% |
Foursquare
| Method | GRU4Rec | DIN | SASRec | BERT4Rec | DIEN | SIM | ETA | TWIN | HSTU | RankMixer |
|---|---|---|---|---|---|---|---|---|---|---|
| Base | 0.7717 | 0.7948 | 0.7712 | 0.7730 | 0.7920 | 0.8198 | 0.8217 | 0.8160 | 0.7746 | 0.7732 |
| Res-KMeans | 0.7988 | 0.8406 | 0.7900 | 0.7714 | 0.8570 | 0.8663 | 0.8584 | 0.8662 | 0.7832 | 0.7772 |
| RQ-VAE | 0.7994 | 0.8773 | 0.7882 | 0.7677 | 0.8744 | 0.8927 | 0.8901 | 0.8910 | 0.7736 | 0.7744 |
| RQ-VAE-cos | 0.7960 | 0.8489 | 0.7883 | 0.7615 | 0.8311 | 0.8707 | 0.8705 | 0.8707 | 0.7739 | 0.7694 |
| RQ-VAE-NGram | 0.7957 | 0.8368 | 0.7914 | 0.7715 | 0.8257 | 0.8683 | 0.8556 | 0.8609 | 0.7773 | 0.7732 |
| LGSID | 0.7979 | 0.8781 | 0.7901 | 0.7696 | 0.8746 | 0.8942 | 0.8872 | 0.8921 | 0.7759 | 0.7704 |
| LGSID++ | 0.8004 | 0.8728 | 0.7918 | 0.7723 | 0.8772 | 0.8889 | 0.8899 | 0.8913 | 0.7759 | 0.7732 |
| Ours (LGRID) | 0.8024 | 0.8785 | 0.7923 | 0.7747 | 0.8910 | 0.9041 | 0.9127 | 0.9107 | 0.7892 | 0.7796 |
| vs. SOTA (Δ%) | +0.25% | +0.05% | +0.06% | +0.22% | +1.57% | +1.11% | +2.54% | +2.08% | +0.76% | +0.31% |
结论分析。 LGRID 在两个数据集、所有十个骨干上都取得最佳,说明生成的 SID 与多样的序列型和工业排序模型都兼容。Kuaishou 上最强 SID baseline 被超出最多 5.44%(GRU4Rec);Foursquare 上 ETA 与 TWIN 提升最明显(+2.54% / +2.08%)。这些结果说明 LGRID 的收益不绑定某个特定推荐架构——它的属性对齐 SID 提供的是可复用的地理与语义信号,用来补充下游排序模型。
值得注意的是 Foursquare 上 GRU4Rec / DIN / SASRec 的提升很小(+0.05%–0.25%),而 DIEN / SIM / ETA / TWIN 这类显式建模用户兴趣演化或长序列检索的骨干提升明显更大。这暗示属性对齐 SID 的价值在能利用结构化物品侧信号的骨干上才被充分释放。
4.3 表示质量与可解释性¶
属性一致的 POI 自检索(Table 2)¶
评估 POI 嵌入质量:用 query 从全语料检索 top-$k$ POI,度量属性一致性。
Table 2:全语料 POI 自检索。报告 MRR、Recall (Rec) 与 Hit at $K = \{1, 10, 50\}$。
| Dim. | Model | MRR | Rec@1 | Hit@1 | Rec@10 | Hit@10 | Rec@50 | Hit@50 |
|---|---|---|---|---|---|---|---|---|
| City | Base | 0.9150 | 0.892 | 0.892 | 0.745 | 0.956 | 0.543 | 0.979 |
| LGRID | 0.9443 | 0.925 | 0.925 | 0.877 | 0.977 | 0.819 | 0.991 | |
| Gain | +3.2% | +3.7% | +3.7% | +17.7% | +2.2% | +50.8% | +1.2% | |
| Dist. | Base | 0.7402 | 0.689 | 0.689 | 0.450 | 0.834 | 0.249 | 0.891 |
| LGRID | 0.8832 | 0.842 | 0.842 | 0.765 | 0.952 | 0.679 | 0.976 | |
| Gain | +19.3% | +22.2% | +22.2% | +70.0% | +14.1% | +172.7% | +9.5% | |
| Brand | Base | 0.9532 | 0.936 | 0.936 | 0.923 | 0.978 | 0.902 | 0.994 |
| LGRID | 0.9713 | 0.958 | 0.958 | 0.939 | 0.993 | 0.921 | 0.997 | |
| Gain | +1.9% | +2.4% | +2.4% | +1.7% | +1.5% | +2.1% | +0.3% |
结论分析。 LGRID 同时改善语义一致性与地理一致性:Brand MRR 从 0.9532 升到 0.9713、Brand Recall@50 从 0.902 升到 0.921。地理属性的增益随粒度变细而显著变大:City MRR +3.2%,而 District MRR +19.3%、District Recall@50 +172.7%。这精确印证了论文的核心主张——纠缠表示牺牲的正是细粒度地理区分,而解耦把它救了回来。作者据此支持"在联合 LLM 编码之后再解耦"的设计选择:模型保留了 geo-content 交互,同时避免它们在量化前塌缩成单一融合表示。
属性可解释性(Table 3)¶
Table 3:跨数据集的属性解码准确率(%)
| 数据集 | Country | Prov. | City | Dist. | Town | Brand | Cat. |
|---|---|---|---|---|---|---|---|
| Kuaishou | — | 99.02 | 99.66 | 99.12 | 92.34 | 86.62 | 97.00 |
| Foursquare | 99.97 | 99.93 | 95.03 | — | — | — | 96.77 |
结论分析。 给定学到的槽嵌入与任务 prompt,解码器预测对应属性标签。LGRID 在两个数据集上都以 >99% 准确率恢复可用的粗粒度空间属性,且在 Kuaishou 的细粒度与语义属性上依然很强——Town 92.34%、Brand 86.62%。这说明 SD-Block 保留了层次语义、SCR 减少了跨域干扰,使学到的槽保留了物理可解释的属性信息、而不是充当不透明的潜在码。
联合编码的必要性(Table 4 / Table 16)¶
Table 4:联合编码 vs 字段级结构化编码(MRR)
| Method | Prov. | City | Dist. | Town | Brand | Cat. |
|---|---|---|---|---|---|---|
| Field-wise | 0.751 | 0.719 | 0.633 | 0.334 | 0.204 | 0.052 |
| LGRID | 0.987 | 0.990 | 0.922 | 0.479 | 0.328 | 0.098 |
| Gain | +31.4% | +37.7% | +45.7% | +43.3% | +60.9% | +88.5% |
附录 C.1 的完整版(Table 16)进一步给出多个 cutoff:
| Dim. | Method | MRR | R@1 | R@5 | R@10 | R@50 | R@100 |
|---|---|---|---|---|---|---|---|
| Prov. | Field-wise | 0.751 | 0.717 | 0.698 | 0.683 | 0.636 | 0.611 |
| Prov. | LGRID | 0.987 | 0.984 | 0.979 | 0.970 | 0.931 | 0.909 |
| City | Field-wise | 0.719 | 0.667 | 0.634 | 0.609 | 0.526 | 0.482 |
| City | LGRID | 0.990 | 0.982 | 0.963 | 0.949 | 0.889 | 0.853 |
| District | Field-wise | 0.633 | 0.551 | 0.489 | 0.442 | 0.300 | 0.240 |
| District | LGRID | 0.922 | 0.864 | 0.809 | 0.765 | 0.579 | 0.479 |
| Town | Field-wise | 0.334 | 0.241 | 0.179 | 0.150 | 0.086 | 0.067 |
| Town | LGRID | 0.479 | 0.344 | 0.284 | 0.250 | 0.164 | 0.131 |
| Brand | Field-wise | 0.204 | 0.119 | 0.125 | 0.124 | 0.128 | 0.130 |
| Brand | LGRID | 0.328 | 0.196 | 0.205 | 0.212 | 0.228 | 0.241 |
| Category | Field-wise | 0.052 | 0.048 | 0.050 | 0.051 | 0.053 | 0.054 |
| Category | LGRID | 0.098 | 0.083 | 0.086 | 0.088 | 0.092 | 0.095 |
结论分析。 Field-wise baseline 分别编码地理描述、商户信息与品类信息,保留了字段边界但阻断了编码期的跨字段交互。LGRID 在全部六个属性上都赢,且增益随地理粒度变细而增大(Province +31.4% → District +45.7%)。语义属性受益更多:Brand +60.9%、Category +88.5%。更细 cutoff 上差距更极端:District R@100 增益 +99.5%、Town R@100 +95.2%。这说明独立编码结构化字段切断了细粒度消歧所需的 geo-content 交互;而联合编码 + 结构解耦既捕获了 geo-content 交互,又把共享表示组织进可解释槽位——这正是论文标题里 "generative disentanglement" 的实质。
SID 碰撞分析(Table 5)¶
Table 5:SID 利用率与全 SID 碰撞率(%)
| Method | $U_1$ ↑ | $U_{1:2}$ ↑ | $U_{1:3}$ ↑ | Collision ↓ |
|---|---|---|---|---|
| RQ-VAE | 54.4 | 1.9 | 0.05 | 98.0 |
| LGSID | 99.0 | 4.0 | 0.05 | 97.0 |
| LGRID | 100.0 | 100.0 | 77.3 | 39.9 |
其中累积前缀利用率定义为(附录 C.2,式 20):
$$U_{1:m} = 100 \times \frac{\left|\{(c_{i,1}, \ldots, c_{i,m})\}_{i=1}^{N}\right|}{\prod_{j=1}^{m} K_j}, \tag{20}$$
$K_j$ 是第 $j$ 层码本大小;全 SID 碰撞率为(式 19):
$$\text{Collision} = 1 - \frac{\left|\{\mathbf{C}_i\}_{i=1}^{N}\right|}{N}, \tag{19}$$
$\mathbf{C}_i = [\mathbf{C}_i^g; \mathbf{C}_i^s]$ 是地理与语义 SID 序列化后的完整 SID。
结论分析。 这是全文最有说服力的一组数字。已有 SID baseline 都受严重全 SID 碰撞之苦(RQ-VAE 98.0%、LGSID 97.0%)。虽然 LGSID 几乎打满了第一层利用率($U_1 = 99.0$),它的深层利用率仍然极低($U_{1:2} = 4.0$、$U_{1:3} = 0.05$),说明后续码层几乎没有提供额外判别力。LGRID 把碰撞率降到 39.9%,同时把 $U_{1:2}$ 与 $U_{1:3}$ 提到 100.0 与 77.3。
这个对比直接支持"量化前先解耦"的论点:仅靠第一层高利用率无法阻止全 SID 碰撞,只要后续码层都是从同一个融合表示上学出来的。另外,因为 LGRID 分离了地理与语义码流,同一套碰撞度量可以分别施加到 $\mathbf{C}_i^g$ 与 $\mathbf{C}_i^s$ 上——这让"重复的全 SID 主要来自地理码还是语义码"成为可分析的问题,而这在单流 SID 方法里是拿不到的。
Scaling law 分析(Figure 3)¶
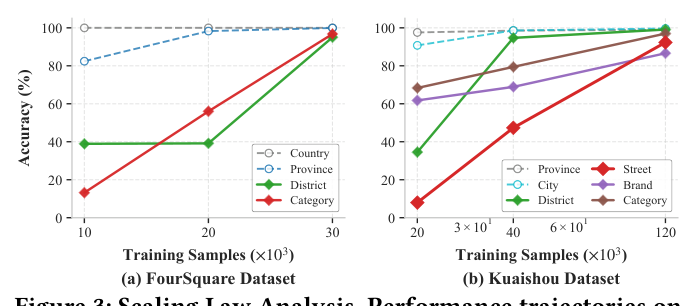
结论分析。 Figure 3 考察属性可解释性如何随训练数据 scale。LGRID 呈现清晰的 coarse-to-fine 模式:Province、City 这类粗粒度地理属性收敛很快,仅用 20k Kuaishou 样本就超过 97% 准确率。相比之下细粒度的 Town 在小规模训练(< 40k 样本,约 7.98%)时仍低,但在数据覆盖足够后急剧上升,在 120k curated POI-text 训练样本时达到 92.34%。这一趋势说明细粒度空间解耦是数据敏感的,而 LGRID 的层次结构支持 coarse-to-fine 的槽学习。
4.4 消融研究¶
学习策略消融(Figure 4)¶
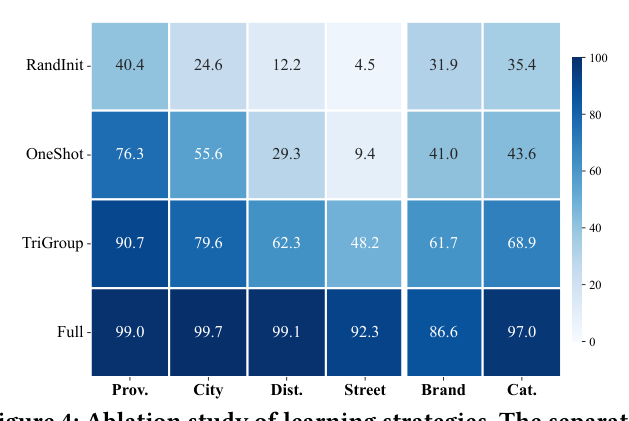
| 变体 | Prov. | City | Dist. | Street/Town | Brand | Cat. |
|---|---|---|---|---|---|---|
| RandInit | 40.4 | 24.6 | 12.2 | 4.5 | 31.9 | 35.4 |
| OneShot | 76.3 | 55.6 | 29.3 | 9.4 | 41.0 | 43.6 |
| TriGroup | 90.7 | 79.6 | 62.3 | 48.2 | 61.7 | 68.9 |
| Full LGRID | 99.0 | 99.7 | 99.1 | 92.3 | 86.6 | 97.0 |
结论分析。 随机槽初始化在细粒度 Town 恢复上彻底塌缩(4.51%),说明 SAI 稳定了 token–属性对齐;一次性(one-shot)解码同样弱(9.36%);粗粒度域分组把 Town 提到 48.17%,但仍远低于 Full LGRID。这表明仅有分组是不够的,还必须有 PGD 建模的 coarse-to-fine 依赖——用较粗的槽作为更细层级的上下文提示,才能把 Town 推到 92.34%。
语义锚的鲁棒性(Table 18)¶
Table 18:语义锚选择对属性解码准确率的鲁棒性(%)
| Method | Prov. | City | Dist. | Town | Brand | Cat. |
|---|---|---|---|---|---|---|
| Random Init | 46.4 | 34.6 | 22.2 | 4.51 | 31.9 | 37.4 |
| Original Anchor | 99.0 | 99.7 | 99.1 | 92.3 | 86.6 | 97.0 |
| Synonym Anchor | 98.2 | 98.8 | 98.2 | 91.4 | 84.8 | 96.2 |
| Natural-language Anchor | 97.6 | 98.3 | 98.0 | 90.7 | 85.1 | 95.8 |
结论分析。 三种语义上有意义的锚变体准确率相近,而随机初始化在细粒度 Town 上急剧退化。这证明语义锚起的是"稳定槽–属性对齐"的作用,而不是充当隐蔽的 prompt 技巧或答案注入——这是对可解释性主张的一个重要防御性实验。
设计级消融(Table 6)¶
Table 6:设计级消融对属性恢复准确率的影响
| Ablation | Variant | Prov. | City | Dist. | Town | Brand | Cat. |
|---|---|---|---|---|---|---|---|
| Full LGRID | 99.02 | 99.66 | 99.12 | 92.34 | 86.62 | 97.00 | |
| SD-Block | Linear | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| Q-Former | 75.14 | 42.37 | 25.47 | 6.85 | 16.65 | 24.42 | |
| Cross-Att | 87.56 | 63.62 | 44.58 | 14.13 | 52.73 | 59.87 | |
| SACL | Simple | 89.36 | 79.42 | 56.53 | 37.17 | 42.66 | 51.87 |
| HierHard | 94.52 | 91.35 | 88.22 | 83.51 | 78.95 | 89.43 |
结论分析。 SD-Block 组里,线性投影在所有属性上全线归零(0.00)——简单投影根本无法把原始 LLM 隐状态组织成结构化槽。Q-Former 与 Cross-Att 改善了这个 baseline,但在细粒度空间与语义属性上仍然弱;Full LGRID 相对 Cross-Att 把 Town 与 Brand 分别提升 78.21 与 33.89 个百分点,说明 SCR 更好地保留了层次空间语义。SACL 组里,vanilla 采样只带来有限的细粒度判别力(Town 37.17%),层次化难负例把它推到 83.51%;Full LGRID 再在 Town / Brand / Category 上分别提升 8.83 / 7.67 / 7.57 点,说明 fallback 采样与难负例挖掘是互补的。
组件级消融(Table 7 / Table 17)¶
Table 7:Kuaishou 上的组件级消融。Acc 单位 %;R@50 表示属性一致检索。
| Variant | Prov. Acc | Brand Acc | Dist. R@50 |
|---|---|---|---|
| Full LGRID | 99.02 | 86.62 | 0.679 |
| w/o SCR | 75.14 | 16.65 | 0.291 |
| w/o $\mathcal{L}_{\text{pgd}}$ | 78.40 | 44.80 | 0.452 |
| w/o $\mathcal{L}_{\text{sacl}}$ | 93.80 | 48.70 | 0.336 |
| w/o $\mathcal{L}_{\text{ldr}}$ | 98.30 | 77.80 | 0.598 |
Table 17:附录 C.3 的扩展版(含更多解码与检索指标)
| Variant | 移除的功能 | Prov. Acc | Town Acc | Brand Acc | Dist. R@50 | Town R@50 | Brand R@50 |
|---|---|---|---|---|---|---|---|
| Full LGRID | – | 99.02 | 92.34 | 86.62 | 0.679 | 0.250 | 0.921 |
| w/o $\mathcal{L}_{\text{PGD}}$ | 移除生成式槽可解码性 | 78.40 | 10.70 | 44.80 | 0.452 | 0.121 | 0.841 |
| w/o SCR | 移除槽间结构化路由 | 75.14 | 6.85 | 16.65 | 0.291 | — | — |
| w/o $\mathcal{L}_{\text{SACL}}$ | 移除结构感知对比判别 | 93.80 | 34.60 | 48.70 | 0.336 | 0.089 | 0.768 |
| w/o $\mathcal{L}_{\text{LDR}}$ | 移除槽多样性正则 | 98.30 | 81.90 | 77.80 | 0.598 | 0.204 | 0.879 |
| SACL-Simple | 只用简单负例 | 89.36 | — | 42.66 | 0.401 | — | — |
| SACL-HierHard | 用层次化难负例但无 fallback | 94.52 | — | 78.95 | 0.561 | — | — |
结论分析(逐组件)。
- 移除 SCR 造成跨解码与检索指标的最大退化(Prov. Acc 99.02 → 75.14,Brand Acc 86.62 → 16.65,Town Acc 92.34 → 6.85)。这说明结构化路由是槽分离的核心:没有它,AGP 探测到的信息在槽之间自由混合,属性对齐直接崩塌。
- 移除 $\mathcal{L}_{\text{PGD}}$ 主要伤害槽可解码性,尤其是细粒度 Town 恢复(92.34 → 10.70)。这符合 PGD 的定位:它是那个"把属性语义显式赋给槽"的目标。
- 移除 $\mathcal{L}_{\text{SACL}}$ 显著削弱判别力与检索(Brand Acc 86.62 → 48.70,Dist. R@50 0.679 → 0.336)——纯生成目标确实存在论文所说的"判别瓶颈"。
- 移除 $\mathcal{L}_{\text{LDR}}$ 造成较小但一致的下降(Brand Acc → 77.80,Dist. R@50 → 0.598),印证其"减少冗余槽使用"的辅助角色。
结论:LGRID 不是一堆冗余模块的堆叠——SCR 造出结构化槽,PGD 赋予可验证的属性语义,SACL 提升细粒度判别,LDR 抑制冗余,四者共同为双流量化准备好槽位。
4.5 效率与案例研究¶
效率(Table 10)¶
| Stage | RQ-VAE | LGRID | Ratio |
|---|---|---|---|
| 离线 SID 构造 | 13.97 ms/item | 21.80 ms/item | 1.56× |
| 在线输入准备 | 0.48 ms/request | 0.50 ms/request | 1.04× |
结论分析。 LGRID 的额外开销局限在离线 SID 构造(1.56×)。由于 SID 是预生成的、serving 时只做查表,在线输入准备几乎不变(1.04×)。这对工业落地是关键论据:可解释性的代价被完全推到离线。
案例研究(Figure 5 / Figure 6 / Figure 7)¶
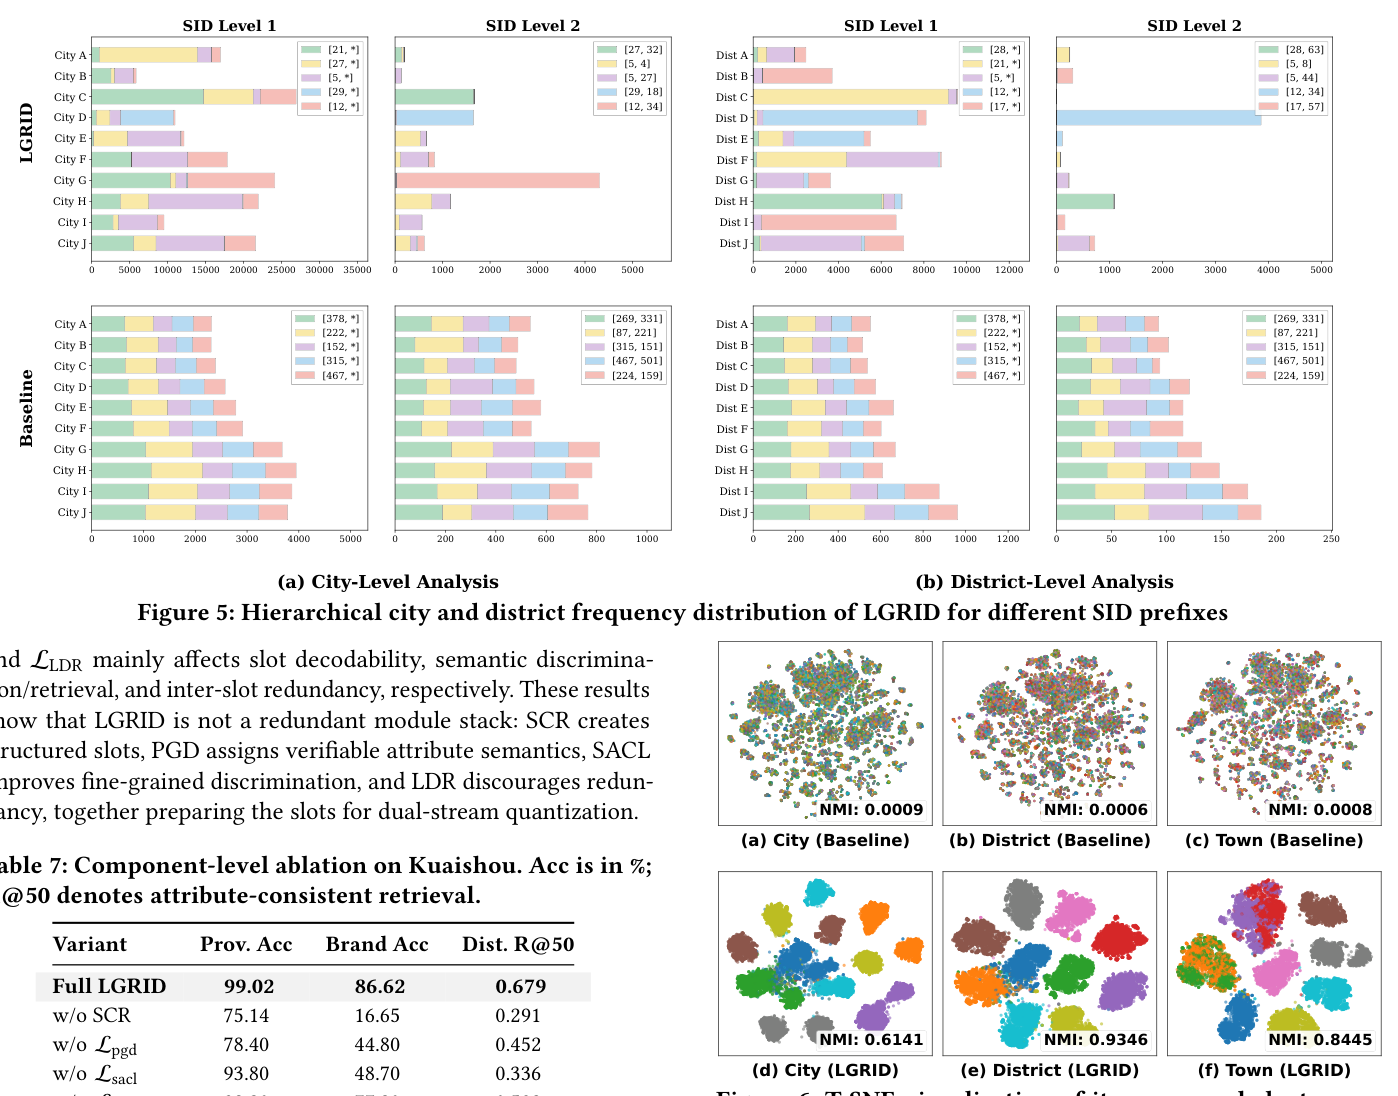
Figure 5 分析。 LGRID 展现出 coarse-to-fine 的空间层次:一级前缀捕获粗粒度的城市级规律,二级前缀进一步聚焦到更细的区级区域。相比之下 baseline 在各空间单元上呈现高且弥散的前缀利用,其前缀只提供很弱的空间判别,因而更易发生码塌缩与碰撞。
Figure 6 分析(t-SNE + NMI)。 Baseline 嵌入把来自不同地理单元的样本混在一起,District NMI 近乎为零(0.0006);LGRID 形成紧凑且良好分离的地理簇,District NMI 达到 0.9346(City 0.6141、Town 0.8445,对应 baseline 的 0.0009 / 0.0008)。这是全文视觉上最直观的证据:解耦确实把地理结构注入了表示空间。
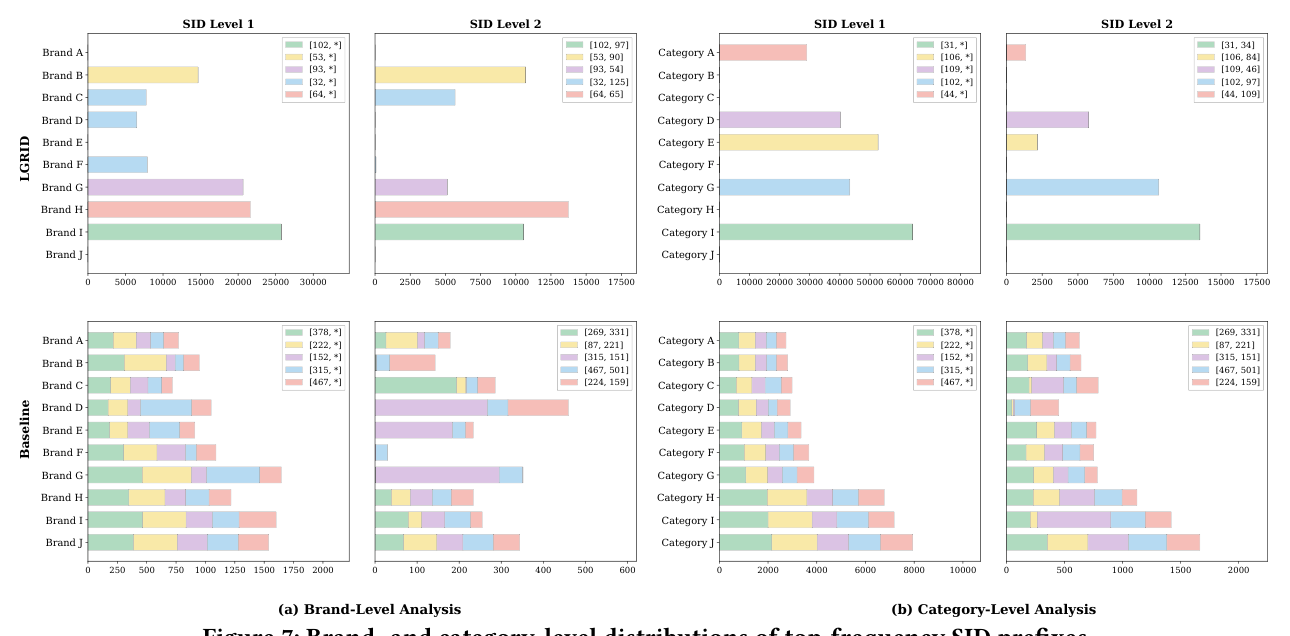
Figure 7 分析(附录 C.6)。 把 SID 前缀分析扩展到语义属性。LGRID 产出更集中的前缀分布,说明语义相关的 POI 被更一致地分配到共享或邻近的前缀模式;baseline 则把相同语义属性摊到很多前缀上,暗示更弱的语义判别与更高的前缀塌缩风险。这说明 LGRID 的结构化 SID 使用不局限于地理属性。
完整属性一致检索结果(Table 19,附录 C.5)¶
评测覆盖全部地理属性(Province、City、District、Town)与语义属性(Brand、Category)。四个指标定义:Recall@K(匹配到的 POI 数除以 $\min(K, |\mathcal{G}(q)|)$)、Coverage@K(top-$K$ 中匹配目标属性的比例)、Hit@K(top-$K$ 中至少一个匹配)、MRR(首个匹配 POI 的倒数排名)。Baseline 为不带 LGRID 结构化槽解耦的纠缠 LLM 表示。
| Dim. | Model | MRR | R@1 | R@5 | Cov@5 | Hit@5 | R@10 | Cov@10 | Hit@10 | R@50 | Cov@50 | Hit@50 | R@100 | Cov@100 | Hit@100 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Prov. | Base | 0.9373 | 0.924 | 0.902 | 0.902 | 0.963 | 0.881 | 0.881 | 0.988 | 0.750 | 0.750 | 0.998 | 0.668 | 0.668 | 0.999 |
| Ours | 0.9592 | 0.943 | 0.918 | 0.918 | 0.980 | 0.903 | 0.903 | 0.990 | 0.854 | 0.854 | 0.998 | 0.825 | 0.825 | 0.999 | |
| Gain | +2.3% | +2.1% | +1.8% | +1.8% | +1.8% | +2.5% | +2.5% | +0.2% | +13.9% | +13.9% | 0.0% | +23.5% | +23.5% | 0.0% | |
| City | Base | 0.9150 | 0.892 | 0.807 | 0.807 | 0.942 | 0.745 | 0.745 | 0.956 | 0.543 | 0.543 | 0.979 | 0.443 | 0.443 | 0.987 |
| Ours | 0.9443 | 0.925 | 0.896 | 0.896 | 0.967 | 0.877 | 0.877 | 0.977 | 0.819 | 0.819 | 0.991 | 0.786 | 0.786 | 0.994 | |
| Gain | +3.2% | +3.7% | +11.0% | +11.0% | +2.7% | +17.7% | +17.7% | +2.2% | +50.8% | +50.8% | +1.2% | +77.4% | +77.4% | +0.7% | |
| Dist. | Base | 0.7402 | 0.689 | 0.537 | 0.539 | 0.801 | 0.450 | 0.452 | 0.834 | 0.249 | 0.252 | 0.891 | 0.181 | 0.184 | 0.911 |
| Ours | 0.8832 | 0.842 | 0.794 | 0.795 | 0.934 | 0.765 | 0.766 | 0.952 | 0.679 | 0.680 | 0.976 | 0.631 | 0.632 | 0.984 | |
| Gain | +19.3% | +22.2% | +47.9% | +47.5% | +16.6% | +70.0% | +69.5% | +14.1% | +172.7% | +169.8% | +9.5% | +248.6% | +243.5% | +8.0% | |
| Town | Base | 0.4284 | 0.356 | 0.229 | 0.240 | 0.511 | 0.176 | 0.186 | 0.569 | 0.087 | 0.090 | 0.679 | 0.064 | 0.066 | 0.720 |
| Ours | 0.5137 | 0.391 | 0.342 | 0.402 | 0.661 | 0.315 | 0.373 | 0.749 | 0.250 | 0.290 | 0.884 | 0.228 | 0.250 | 0.917 | |
| Gain | +19.9% | +9.8% | +49.3% | +67.5% | +29.4% | +79.0% | +100.5% | +31.6% | +187.4% | +222.2% | +30.2% | +256.3% | +303.2% | +27.4% | |
| Brand | Base | 0.9532 | 0.936 | 0.929 | 0.925 | 0.972 | 0.923 | 0.913 | 0.978 | 0.902 | 0.870 | 0.994 | 0.894 | 0.842 | 0.996 |
| Ours | 0.9713 | 0.958 | 0.946 | 0.941 | 0.988 | 0.939 | 0.930 | 0.993 | 0.921 | 0.890 | 0.997 | 0.914 | 0.863 | 0.998 | |
| Gain | +1.9% | +2.4% | +1.8% | +1.7% | +1.6% | +1.7% | +1.9% | +1.5% | +2.1% | +2.3% | +0.3% | +2.2% | +2.5% | +0.2% | |
| Cat. | Base | 0.9179 | 0.893 | 0.879 | 0.879 | 0.968 | 0.854 | 0.854 | 0.976 | 0.838 | 0.838 | 0.994 | 0.817 | 0.817 | 0.997 |
| Ours | 0.9363 | 0.906 | 0.891 | 0.891 | 0.974 | 0.882 | 0.882 | 0.985 | 0.855 | 0.855 | 0.996 | 0.839 | 0.839 | 0.998 | |
| Gain | +2.0% | +1.5% | +1.4% | +1.4% | +0.6% | +3.3% | +3.3% | +0.9% | +2.0% | +2.0% | +0.2% | +2.7% | +2.7% | +0.1% |
结论分析。 增益在粗属性(Province)上温和——因为 baseline 本身就强;但随地理层级变细急剧增大:District MRR 0.7402 → 0.8832(+19.3%),Town MRR 0.4284 → 0.5137(+19.9%)。更大的 cutoff 上差距更极端:District Recall@50 +172.7%、Town Recall@100 +256.3%。这说明 LGRID 在保持 Brand / Category 检索稳定的同时,保留了细粒度地理一致性——正好是 LBS 里"先地理可达"约束最需要的能力。
附录 B.2:与 geo-aware SID 方法的范式级差异(Table 12)¶
论文用一整节强调 LGRID 不应被看作"在 geo-aware SID baseline 上加模块":
| Aspect | Geo-aware SID(如 LGSID) | LGRID |
|---|---|---|
| Representation | 单个 geo-enhanced 物品嵌入 | 多个 LLM-decodable 槽,带显式地理与语义角色 |
| Geo modeling | 在一个潜空间里做坐标 / 距离感知对齐 | Coarse-to-fine 地理层级编码为槽 0–3 |
| Semantic modeling | 地理与内容在量化前仍混合 | 地理与内容在 LLM 编码期交互,随后被结构化解耦 |
| Interpretability | SID 码有效但基本是黑盒 | 槽可被解码为 province、city、district、town、brand、category |
| Quantization | 在一条表示流上做层次化量化 | 在分离的地理流与语义流上做双流残差量化 |
| Limitation addressed | 提升 SID 的地理一致性 | 降低 geo–semantic 纠缠与码碰撞 |
核心区别在于解耦发生在 SID 构造之前,因此最终的码是从结构化、LLM-可解码的槽生成的,而不是从一个不透明的混合向量。
核心贡献总结¶
- 范式层面的重构:把 SID 生成从 "single-representation-then-quantization" 改为 "generative-disentanglement-before-quantization",并给出可操作的 encode → disentangle → align → quantize 四步流水线。
- SD-Block:用领域 prompt 初始化的语义锚(SAI)+ 锚引导交叉注意力(AGP)+ 组内自回归 / 组间独立的结构化掩码(SCR),把纠缠 LLM 隐状态路由成 8 个属性对齐槽。
- Synergistic Alignment Learning:PGD 的七任务 coarse-to-fine 课程式解码使槽可验证,SACL 的三类结构化难负例使槽有判别力,LDR 使槽非冗余。
- DSRQ:地理流与语义流分别残差量化(各 $D=2$ 层),产出 4-token 且带显式属性对应的 SID。
- 强实证:跨 10 个骨干 × 2 数据集全面领先(最高 +5.44% 相对 AUC),粗粒度地理属性解码 >99%,全 SID 碰撞率 97.0% → 39.9%,District t-SNE NMI 0.0006 → 0.9346,且在线开销仅 1.04×。
与已归档相关工作的对比¶
OneRetrieval OneRetrieval:用「可编辑」的关键词对齐 SID 统一电商多路召回(Kuaishou, 2026-06-11)¶
关系:独立并发(本文未引用 OneRetrieval,两者殊途同归;且同属快手不同团队)· 已加载对方精读
- 共同关注的问题:两篇论文攻击的是同一个 root cause——闭码本 SID 的每个位置被绑死到一个量化嵌入,不携带任何显式属性语义,于是 SID 成为不可检视、不可归因的黑盒。OneRetrieval 把这一后果表述为"可编辑性悖论"(运营无法把新词注入码本,只能保留低转化的倒排分支),LGRID 把它表述为"black-box representation 使 SID 位置无法归因到地理或语义因子,削弱诊断与控制能力"。两者都明确拒绝"事后解释",都要求属性语义在 SID 构造期就被写进位置。
- 相近的技术骨架:核心骨架高度重合——把 SID 的每个位置一一绑定到一个具名属性,并用显式的对齐监督把这层绑定训出来。OneRetrieval 的 Keyword-Aligned Encoding 把 18 类关键属性经信息论凝聚聚类合并成 6 个位置专属码本,再用 Stage 0「属性词 ↔ 槽」双向模板监督锚定;LGRID 的 SAI 用领域 prompt 短语("Provincial Unit"、"Brand Name")初始化 8 个槽 token 建立槽–属性一一对应,再用 PGD 的七个属性解码任务把这层对应训成可验证的。两者都用「能否把位置解码回它该代表的属性」作为可解释性的操作化定义(LGRID 的属性解码准确率 vs OneRetrieval 的干预命中率 IHR)。
- 本文的差异与推进:分歧点在于如何获得属性对齐。OneRetrieval 走的是确定性字典路线——用 Aho-Corasick 自动机对照 108 万词的生产属性词表做匹配,编码期不做任何神经推理,因此槽的含义由字典外生固定、可被运营在数小时内改写;代价是完全放弃了量化,且槽含义受限于词表能覆盖的显式词。LGRID 走的是神经解耦路线——保留 LLM 联合编码(从而保留 geo-content 交互,Table 4 证明这值 31.4%–88.5% MRR),再用结构化掩码把隐状态路由进槽,最后仍然做残差量化。因此 LGRID 能表达"品牌 × 地理语境"这类字典写不出来的交互("Apple" 在电子街区是零售商),但它的槽绑定是学出来的、不可被运营直接改写。
- 可比的方法 / 实验差异:OneRetrieval 明确论证了"层次化编码"(让非 ENTITY 属性条件于 entity)在其设定下系统性失败,原因之一是自回归解码器在位置一就承诺了 entity、错误会传播;而 LGRID 的地理流恰恰是强层次化的(province → city → district → town 累积条件),并靠 SCR 的组内自回归掩码 + 课程式 PGD 让它成立(Figure 4:TriGroup 48.2 → Full 92.3 的 Town 恢复)。两篇给出的经验结论表面相反,实质差异在于:LGRID 的层次是行政包含层级(严格偏序、天然 coarse-to-fine),而 OneRetrieval 试图条件化的品牌 / 品类属性不遵循严格包含关系——有意思的是 LGRID 自己也承认了这点,它的语义流(槽 5–8)用的正是 task-specific 切片而非累积条件。两者合起来其实给出了一条一致的规律:只有存在真实包含层级的属性才适合层次化条件解码。
Pro-GEO Pro-GEO:用 Geo-RoPE 把地理邻近性嵌入语义码本(BUPT / Meituan, 2026-04-25)¶
关系:独立并发(本文未引用 Pro-GEO,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇是同一 root cause 的两种诊断——在本地生活 SID 构造中,地理信号被融合进一个共享表示后,会被高维高方差的语义信号淹没,退化成 weak regularizer。Pro-GEO 用一个刺眼的统计量化它:超过 50% 的 POI 与同 SID 下的其他 POI 相距 >40 km,并给出通州搜汉堡被推到廊坊的跨城失败案例;LGRID 用 "Beijing–Haidian–KFC" vs "Shanghai–Xuhui–KFC" 不该拿到相似 SID 来表述同一件事,并用碰撞率(LGSID 97.0%)量化。两者都明确点名 OneLoc / GNPR-SID 这类"把经纬度 concat 进嵌入"的全局注入方式不够。
- 相近的技术骨架:骨架的抽象重合点是——不要让地理与语义共用同一段码,而要在 SID 里为地理划出专属的、结构化的位置。Pro-GEO 保留前两层做语义聚类,把第三层换成专门的 geo-codebook layer:先按语义簇建 geo-centroid 局部极坐标 $(d_p, \sigma_p)$,再用双向 Geo-RoPE 把相对地理位置以正交旋转写进残差向量,最后对变换后的向量做 K-means 得第三层码。LGRID 则把地理彻底提成一条独立的量化流(槽 0–3 + 独立 RQ 分支)。两者的最终产物都是"SID 的某些位置显式承载地理、另一些承载语义"。
- 本文的差异与推进:Pro-GEO 本质上仍在 LGRID 所批判的 single-representation-then-quantization 范式内——它的语义表示是单流的,地理只在最后一层码被调制进去,且调制方式是把地理信号乘性地作用在语义相似度上(其 Eq. 11 显式把余弦距离变化分解为「位置差因子 × 语义相似因子」,刻意让地理只在语义相近时才起作用)。这是个漂亮的设计,但它把地理定位为语义的修正项;LGRID 则把地理提升为与语义对等的一等公民,从表示阶段就分流、并有自己完整的 coarse-to-fine 层级(省→市→区→镇四个槽)。代价与收益都很清楚:Pro-GEO 无需 LLM 微调、改动极小(只换第三层聚类),LGRID 需要 LoRA 微调 Qwen3-8B 与两阶段训练、离线成本 1.56×,但换来了 >99% 的属性可解码性与 39.9% 的碰撞率——Pro-GEO 不提供任何属性解码能力,它的 SID 依然是黑盒(Pro-GEO 报告的是聚类距离与 Hit@50,而非"能否把码解回区名")。
- 可比的方法 / 实验差异:两者的评测轴几乎不重叠,恰好互补。Pro-GEO 报告平均地理聚类距离降低 45.60% 与 Hit@50 +1.87%(Meituan 量级数据集,即 GNPR-SID 同款);LGRID 报告 AUC(最高 +5.44%)、属性解码准确率与碰撞率,并用 t-SNE NMI(District 0.0006 → 0.9346)刻画地理簇的分离度——这个 NMI 指标在精神上与 Pro-GEO 的"平均聚类距离"测的是同一件事,只是一个在嵌入空间、一个在物理空间。两者都没有报告线上 A/B。一个值得注意的方法论差异:Pro-GEO 用余弦相似度 + 正交投影去冗余来做残差聚类,而 LGRID 用标准 RQ-VAE 式的重建 + commitment loss;LGRID 的 baseline 表里恰好有 "RQ-VAE-cos" 这一项(Kuaishou 上 ETA 0.6612,弱于 RQ-VAE 的 0.8745),暗示单纯换相似度度量并不足以解决纠缠——这从侧面为 LGRID "问题不在量化器、而在被量化的表示" 的论点提供了旁证。
Step 2.5 剔除的近似候选(记录以防门槛放水):RaG RaG(Kuaishou)虽有 "Disentangled Semantic ID(content vs creative)"的双流骨架,但其 root cause 是"推荐被固定内容库锁死、需生成新视频",解耦是为了喂给视频生成 agent,而非量化保真与碰撞——问题不同构;DRQ DRQ(Shopee)的 "Decoupled" 指把 STE 从量化中解耦(连续 VAE reshaping + 事后层次 K-Means),诊断的是分布惩罚 / 几何惩罚,不涉及属性对齐槽位;QuaSID QuaSID / AdaSID AdaSID 同样关注 SID 碰撞,但把碰撞当作"良性 vs 有害"的仲裁问题在量化器层面打补丁,而 LGRID 的碰撞下降是表示重构的副产品,解法路径不同;CRID CRID(Alibaba)的结构化 DocID(语义簇前缀 + 业务价值序号)分段确有显式语义,但动机是业务价值对齐与免重训增量更新;CapsID CapsID 用软胶囊路由替代 argmax,仍是单表示流上的量化器改良。
讨论与局限性¶
值得借鉴的设计¶
- 把"可解释性"从事后解释改造成训练时的表示构造目标。这是本文最有方法论价值的一点。probing / Patchscopes / activation steering 都把可解释性当作推理时操作,本文则让"每个槽必须能被 LLM 解码回它的属性"成为一个 loss(PGD),于是可解释性变成可优化、可度量的量(属性解码准确率)。Table 18 的锚鲁棒性实验进一步排除了"锚是隐蔽答案注入"的质疑,做得很扎实。
- "先联合编码、后结构解耦"这个顺序被实验直接证成。Table 4 / Table 16 用独立字段级编码作为对照,证明朴素的"字段隔离"会丢掉 31.4%–88.5% 的 MRR。这个消融回答了读者最自然的反问,比单纯说"我们的方法更好"有力得多。
- 碰撞率诊断的分层化。Table 5 用 $U_1 / U_{1:2} / U_{1:3}$ 的累积前缀利用率揭示了 LGSID "第一层打满 99.0 但第二层只有 4.0" 的病灶,比只报一个碰撞率信息量大得多。这套度量本身可以被其它 SID 工作直接复用。
- 成本推到离线。1.56× 离线 / 1.04× 在线的拆分,是工业论文说服部署方最有效的表述方式。
局限与争议¶
- 没有线上 A/B 实验。这是最明显的短板。论文来自快手且用了快手 2.25M 物品的工业数据集,作者显然有条件跑线上实验,但全文只报离线 AUC。对一篇主张"工业落地"的 LBS SID 论文,缺少线上收益(CTR / 转化 / 距离相关指标)使其说服力打折——尤其考虑到离线 AUC 提升在多数骨干上只有 0.4%–1.8%。
- Table 1 的 ETA 列存在量级异常。ETA 骨干在 Kuaishou 上的 AUC 普遍落在 0.60–0.88 的宽区间(Base 0.6036,但 RQ-VAE 0.8745、LGSID++ 0.8327、LGRID 0.8821),与其余九个骨干集中在 0.60–0.68 的分布明显不同。虽然 "vs. SOTA +0.87%" 与 0.8821/0.8745 严格自洽(因此不是排版错误),但同一数据集上同一骨干因 SID 方法不同而产生 0.60 → 0.87 的 AUC 跨度难以用"SID 更好"解释,论文对此没有任何说明。这一列的可信度需要打问号。
- 碰撞率 39.9% 仍然很高。虽然相对 97.0% 是数量级改进,但接近 40% 的 POI 仍共享完整 SID。论文用的是每流 $D=2$、共 4 token 的极短 SID,码本预算显然是瓶颈;增加码层数对碰撞率与可解释性的影响没有被消融。
- Foursquare 上的收益边缘化。GRU4Rec / DIN / SASRec / BERT4Rec 上提升仅 +0.05%–0.25%,基本在噪声范围内(论文未报方差或显著性检验)。合理解释是 Foursquare 只有 38K 物品、且缺乏真实 POI 层级文本(粗位置由经纬度反推),属性解耦无从施展——Table 3 里 Foursquare 缺 District / Town / Brand 三列正说明了这点。因此"在公开 benchmark 上验证"这一主张实际上偏弱,真正的证据来自 Kuaishou 工业数据。
- 对 LLM 骨干的依赖与成本。方案需要 LoRA 微调 Qwen3-8B、两阶段共 10 个 epoch、4 卡 L20,且 SID 语料需要人工 curate(120K 品类均衡、排除元数据缺失的 POI)。这条 curation 流水线本身可能贡献了不小的收益,但没有被消融(例如"用未 curate 的全量 POI 训练"会退化多少)。
- 槽数与属性划分是人工设定的。$N=8$、$k=4$ 以及 Table 11 的八个锚词都是手工指定,论文没有讨论如何为新领域(非本地生活)自动确定槽的数量与语义。相较之下 OneRetrieval 用信息论凝聚聚类 + 拐点检测自动定出了 $L=6$,在这一点上方法论更完备。
- 对下游的接口偏保守。SID 只是被拼接到 item-ID 嵌入上作为辅助特征(式 14),并未替换 item ID、也没有用于生成式检索。这保证了公平比较与低风险部署,但也意味着论文没有回答"这些可解释 SID 能否直接作为生成式召回的解码目标"——而这恰恰是 TIGER / OneRec 一脉 SID 工作的主战场。
工业落地价值¶
尽管缺线上实验,LGRID 的工程形态对本地生活平台是友好的:全部计算离线完成、serving 只查表、不要求骨干架构改动(式 14 的统一协议已在 10 个骨干上验证)。更有价值的是它带来的可诊断性——当线上出现"品牌对但分店错"这类 badcase 时,运营可以把 SID 解码回 province / city / district / town / brand / category 来定位是哪一段码出了问题,这是黑盒 SID 完全做不到的。结合 OneRetrieval 的预留槽思路,这两条快手内部并行的技术路线合起来指向同一个方向:工业级 SID 正在从"紧凑但不可读的哈希"演化为"紧凑且可被人读、可被人改的结构化标识符"。