TGR 技术报告:腾讯 PCG 把级联推荐「一块一块」换成生成式范式¶
研究动机与背景¶
十年不变的蓝图,同时撞上三堵墙¶
工业推荐系统十年来共享同一张蓝图:召回 → 粗排 → 精排 → 重排的级联架构,每个决策阶段由一个独立优化的 DLRM 驱动。这套蓝图模块化、运维友好,但报告开篇断言它现在同时面临三个结构性挑战——而且这三个挑战「无法在蓝图内部通过调参消解」:
(i) 排序架构不再把算力换成质量。 生产 DLRM 把高基数、异构的特征通过分别设计的模块(特征抽取、特征交叉、表征变换)处理,这种碎片化架构是 memory-bandwidth-bound 的,MFU 很低,且不存在 LLM 式的 scaling law:加参数不再买到质量,特征交叉的上限被「人能手工设计出什么」锁死。生成式范式排序器给出了第一个可信的突破口——把用户、物品、上下文、序列特征统一 tokenize 成一条 token 流,让大 Transformer 去做交叉:HSTU 把序列 transducer 扩到万亿参数量级并在 Meta 线上拿到 +12.4%,OneTrans 在严格延迟预算下把 per-user GMV 抬了 +5.68%。但它们的自注意力代价随行为序列长度二次增长,于是「细粒度跨域交叉」在生产中被例行牺牲掉——靠序列预压缩或截断来控成本。
(ii) 阶段化、逐物品的决策与列表级体验错配。 阶段化优化和逐级候选截断把决策过程碎片化,造成信息损失与目标失配。而且这种碎片化比流水线本身更深:用户真正体验到的是一屏里的一个有序 slate,其质量取决于物品间依赖与位置效应,而 pointwise、孤立打分的方式根本捕捉不到;直接的生成式解法——把 $M$ 个物品、每个 $D$ 个 SID token 的 slate 自回归解出来——在实时约束下又太慢。
(iii) 模式匹配不是推理。 传统推荐模型重度依赖历史交互中的行为共现,编码在 ID 表征里;对多模态物品语义、世界知识和刻意推理的接触有限,限制了对细微或模糊意图的推断,以及稀疏监督下的泛化——而这恰恰是冷启动、长尾、模糊意图这些「推荐质量真正被决定」的场景。LLM 先验是自然解法,但现有做法把推理放在每次请求或每次刷新上执行——无论是 chain-of-thought 文本(OneRec-Think)还是多步 latent rollout(ReaRec)——这个代价工业延迟预算吸收不了,而离线预计算只是把它挪了位置。
TGR 的设定与三条方向¶
腾讯 PCG(Platform and Content Group)的推荐跨一个刻意异构的场景组合:新闻流、短视频、长视频、音乐、网文,合计服务数亿日活,候选库规模从千万到数亿,每阶段 P99 延迟预算在几十毫秒。TGR(Tencent Generative Recommendation)沿三条耦合方向把推荐从级联蓝图推向生成式范式:
- TGR-GenRank —— 生成式范式排序(§3)。保留既有级联,但把生产排序器换成 CCFormer:特征域分离交叉注意力让用户 / 行为序列 / 目标物品 token 沿语义有向流交互,子空间 token 混合 + 分层序列压缩让长序列建模变成亚二次而不放弃全量历史访问。注意:它借用了生成式范式的 tokenized 表征、Transformer 骨干和 scaling 配方,但排序输出仍是逐物品分数——所以叫「生成式范式排序」,还不是「端到端生成」。
- TGR-GenRec —— 统一端到端生成式推荐(§4)。真正跳出级联的方向:用一个生成模型端到端产出结果列表,取代召回、排序、重排。当前每个生成范式各上线一个生产模型:BARGE(NTP 范式,逐物品生成)与 HiGR(NSP 范式,整版生成)。
- TGR-Reason —— 推理增强的生成式推荐(§5)。在「CoT 文本、辅助生成特征、latent 推理状态、推理增强 semantic ID」四种载体中,TGR-Reason 选了最后一种:用 LatentRec 训练的 Think 模型在训练时内化 latent 推理,周期性离线导出 reason token,注入线上生成器(并可进一步查询 Group Memory),请求路径上不增加任何推理 rollout。在 FM4RecSys 的三范式分类(Feature-Based → Generative → Agentic)里,TGR-Reason 是从 Generative 通往 Agentic 的匝道。
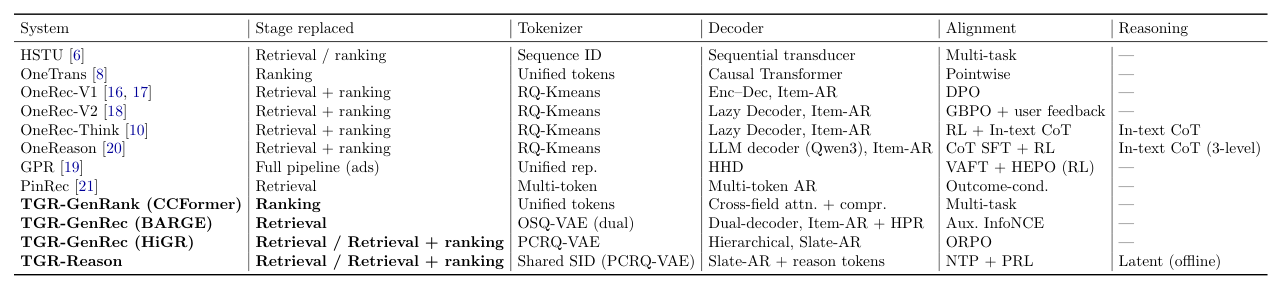
Table 1 把 TGR 与代表性工业生成式推荐器逐列对齐(替换了哪一级 / tokenizer / decoder / 对齐方式 / 推理方式),是理解本报告定位的钥匙:
| 系统 | 替换的阶段 | Tokenizer | Decoder | 对齐 | 推理 |
|---|---|---|---|---|---|
| HSTU | 召回 / 排序 | Sequence ID | Sequential transducer | Multi-task | — |
| OneTrans | 排序 | Unified tokens | Causal Transformer | Pointwise | — |
| OneRec-V1 | 召回 + 排序 | RQ-Kmeans | Enc–Dec, Item-AR | DPO | — |
| OneRec-V2 | 召回 + 排序 | RQ-Kmeans | Lazy Decoder, Item-AR | GBPO + 用户反馈 | — |
| OneRec-Think | 召回 + 排序 | RQ-Kmeans | Lazy Decoder, Item-AR | RL + In-text CoT | In-text CoT |
| OneReason | 召回 + 排序 | RQ-Kmeans | LLM decoder (Qwen3), Item-AR | CoT SFT + RL | In-text CoT(3 级) |
| GPR | 全流水线(广告) | Unified rep. | HHD | VAFT + HEPO (RL) | — |
| PinRec | 召回 | Multi-token | Multi-token AR | Outcome-cond. | — |
| TGR-GenRank (CCFormer) | 排序 | Unified tokens | Cross-field attn. + compr. | Multi-task | — |
| TGR-GenRec (BARGE) | 召回 | OSQ-VAE(双通道) | Dual-decoder, Item-AR + HPR | Aux. InfoNCE | — |
| TGR-GenRec (HiGR) | 召回 / 召回+排序 | PCRQ-VAE | Hierarchical, Slate-AR | ORPO | — |
| TGR-Reason | 召回 / 召回+排序 | 共享 SID (PCRQ-VAE) | Slate-AR + reason tokens | NTP + PRL | Latent(离线) |
这张表本身就说明了 TGR 与 OneRec 谱系的最大差别:OneRec 系列一路都是「召回+排序」整体替换,而 TGR 是分阶段、分范式并行推进——CCFormer 只换排序、BARGE 只换召回、HiGR 才开始碰「召回+排序」。
TGR Stack:设计原则与共享基座¶
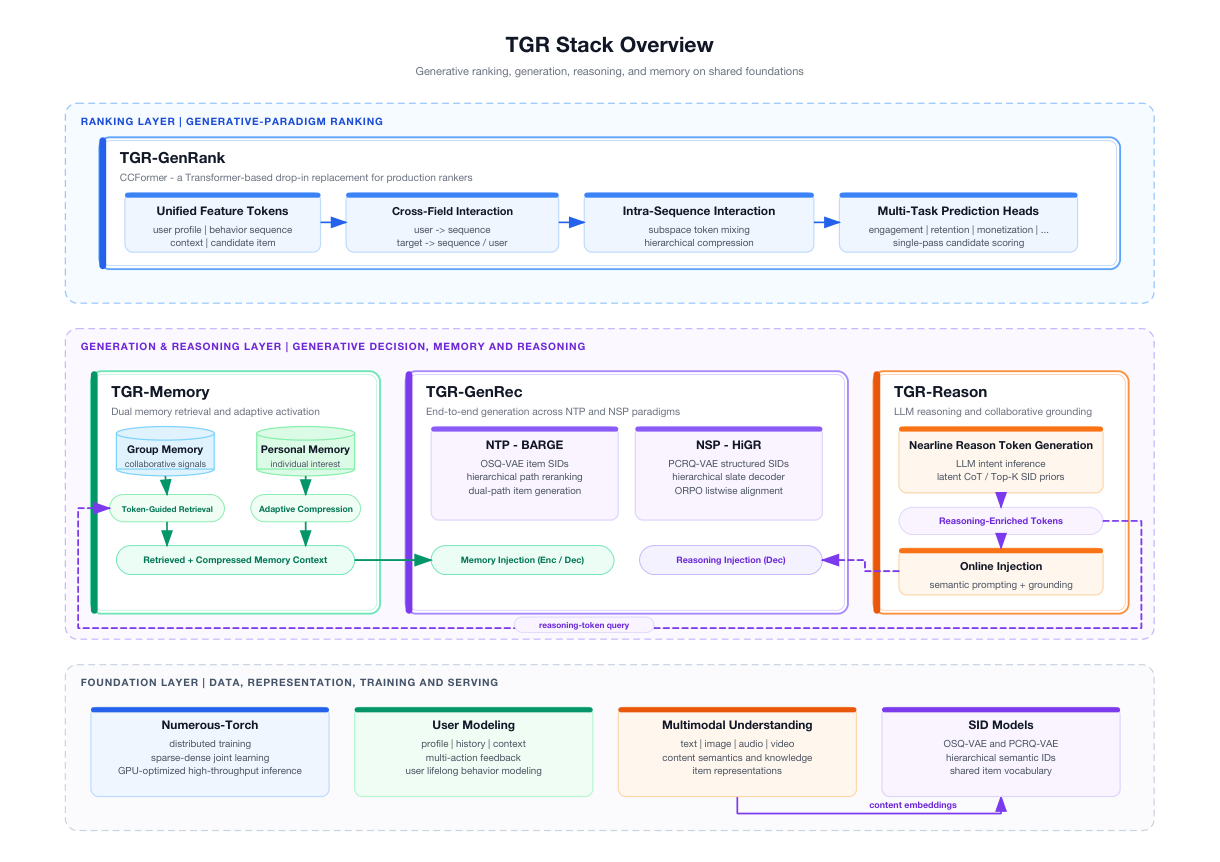
三条设计原则¶
(P1) 一块一块地替换级联,每一块都必须是工业级的。 一个有用的生成式推荐器,必须能从第一天起就以完整生产质量替换掉一个被反复调优过的判别式模块。因此每个 TGR 模型都作为特定阶段的 drop-in 替换部署在既有的安全、去重、业务规则过滤器之后,并被两条硬杠卡住:(i) 离线指标匹配或超过在位模型;(ii) 停留在同样的线上延迟与 GPU 预算内。这条纪律贯穿全篇——CCFormer 在生产特征空间上以 drop-in 排序器上线,BARGE 在「参数量、beam 宽度、服务延迟不得增加」的硬约束下部署,HiGR 在严格的延迟-GPU 信封内做整版生成。
(P2) 跨栈共享结构。 生成式推荐只有在 tokenizer、用户编码器、后训练基础设施能被多个模型摊销时才在规模上成立。TGR 因此强制一个统一的 SID tokenizer 家族(整版生成用 PCRQ-VAE,NTP 生成用正交双通道 OSQ-VAE)、一个共同的用户/上下文编码接口、一套共同的后训练纪律。共享 SID 空间正是 TGR-Reason 的 reason token 能被原生注入 TGR-GenRec 解码器的原因,也是未来给 TGR-GenRank 加生成式 head 时能从 TGR-GenRec 的细粒度物品生成器 bootstrap 的原因。
(P3) 为列表优化,而不是为单品优化。 用户体验的单位是展示出来的列表,所以栈级目标定义在整个 slate 上而非孤立物品。每一级在其范式允许的层次上兑现这个目标:线上所有模型都以列表级和会话级业务结果为闸门;整版生成线直接在列表级训练与对齐,用单一 listwise ORPO 损失把排序保真度、真实兴趣、多样性整合在 slate 级偏好对上,而不是手工融合逐物品奖励;NTP 线与排序阶段则供给列表目标所消费的物品级保真度。
问题形式化¶
设 $\mathcal{U}$ 为用户集合,$\mathcal{V}$ 为物品集合。对用户 $u$,观测到按时间排序的交互历史 $S_u = (v_1^u, \dots, v_n^u)$ 与一组用户、上下文、请求级特征 $x_u$。每次请求返回一个 $M$ 个物品的有序 slate:
$$O_u = (\hat v_1^u, \hat v_2^u, \dots, \hat v_M^u) \tag{1}$$
优化目标是整体列表级用户反馈(观看时长、App 停留、完播、满意度),而非孤立的逐物品分数。TGR 在两种部署形态下追这个目标:级联内,slate 仍由下游阶段组装,CCFormer 消费生产特征空间并在一次前向中为一次请求的全部候选发出多任务分数;端到端,生成式 Transformer $F_\theta$ 直接把 slate 解码成一串 SID token:
$$O_u = F_\theta(u, S_u, x_u) \tag{2}$$
TGR-Reason 则在同一套解码上再叠加推理增强先验作为条件。
共享组件¶
- Semantic ID tokenizer:整版生成模型(HiGR 与 TGR-Reason)共享 PCRQ-VAE;BARGE 在 NTP 范式下用正交双通道 OSQ-VAE。两者都把物品 $v$ 映射为层次化 SID 序列 $(s_1, \dots, s_D)$,高层前缀编码粗粒度语义与协同结构,末层区分具体物品。TGR-GenRank 站在这套机制之外:drop-in 约束要求它消费生产排序器已有的特征空间,所以 CCFormer 直接 tokenize 原始用户、行为、目标特征域,而不是 semantic ID。
- 用户/上下文编码:生成式推荐模型采用共同的 encoder–decoder 接口,Transformer encoder 把 $(u, S_u, x_u)$ 映为上下文化 memory $C$,作为 decoder 交叉注意力的 key/value。TGR-Reason 直接复用 TGR-GenRec 的 encoder–decoder 骨干,因此推理与记忆信号进入生成过程时无需任何表征转换。
- 训练与服务基础设施:TGR 在 Numerous-Torch(腾讯的 Megatron 式 3D 并行训练器,带跨 GPU embedding 缓存)上训练。默认部署跑在 NVIDIA H20 集群上,节点内 NVLink、节点间 400 Gbps RDMA;BFloat16 混合精度、稠密参数 ZeRO-1 分片、最深层做 gradient checkpointing、生成式 decoder 用 TensorRT 式融合 kernel。线上服务跑在 NVIDIA L20 上,默认开 KV cache。
TGR-GenRank:CCFormer 与生成式范式排序¶
动机:三个排序模型家族,三种特有缺陷¶
工业排序器的主要差别在于如何实现特征交叉:在哪些 token 上做、渐进代价多少、保留多少用户历史。按这个视角,规模化部署的排序架构分成三族:
传统 DLRM。 嵌入稀疏类别特征、与稠密特征拼接、施加手工设计的交叉模块(显式低阶交叉 + 深网络 / 目标感知注意力池化 / 长历史的记忆增强压缩)。服务便宜,但把行为当成聚合或短程特征而非序列证据,池化表征丢弃细粒度信号,容量被花在静态特征对而非历史-目标交互上;加容量即饱和,没有可用的 scaling law。
基于注意力的序列排序器。 逐 token 用自注意力建模行为,工业变体在单一可扩展骨干里联合注意行为序列、物品特征、用户画像(HSTU / OneTrans / STCA)。这是唯一在序列长度和模型容量两条轴上都表现出可预测 scaling 的家族。障碍是成本:自注意力在计算和显存上都是序列长度的二次方,在几十毫秒延迟下给海量流量打分时无法承受。生产里有两种有损补救:compress-then-interact(交叉前先压序列,牺牲细粒度信号并削弱历史-目标交互)与 retrieve-or-truncate(SIM / TWIN 谱系,只在目标相关子序列内保留 token 级建模,丢掉长期兴趣却仍在保留窗口内付全额注意力代价)。高效注意力变体则主要优化序列建模项,对排序真正依赖的跨域交叉仍然弱。
Token-mixing 排序器。 把特征空间序列化成统一 token,用源自 MLP-式 ViT 替代品的轻量混合算子交换信息,避开二次自注意力。RankMixer 用多头 token 混合 + per-token FFN 在近线性代价下建模异构特征子空间。其局限在作用域:这些算子面向的是一小组统一特征 token,而不是几百到几千个物品的行为序列;长期兴趣仍须先被压成少数 token 才能参与混合,于是又把第一族的信息损失请了回来。
TGR 的判断:三族共同指向一个未被满足的需求——在全长行为序列上做充分且高效的特征交叉。CCFormer 因此把特征交叉解耦成两个正交组件,并让每一个在构造上就是亚二次的:跨域交叉(有向的域分离交叉注意力,只算排序真正需要的交互方向)与序列内交叉(把 token 混合从短统一 token 集扩展到全序列,配合分层压缩,让更深的块以几何递减的代价获得全历史覆盖)。
CCFormer 架构¶
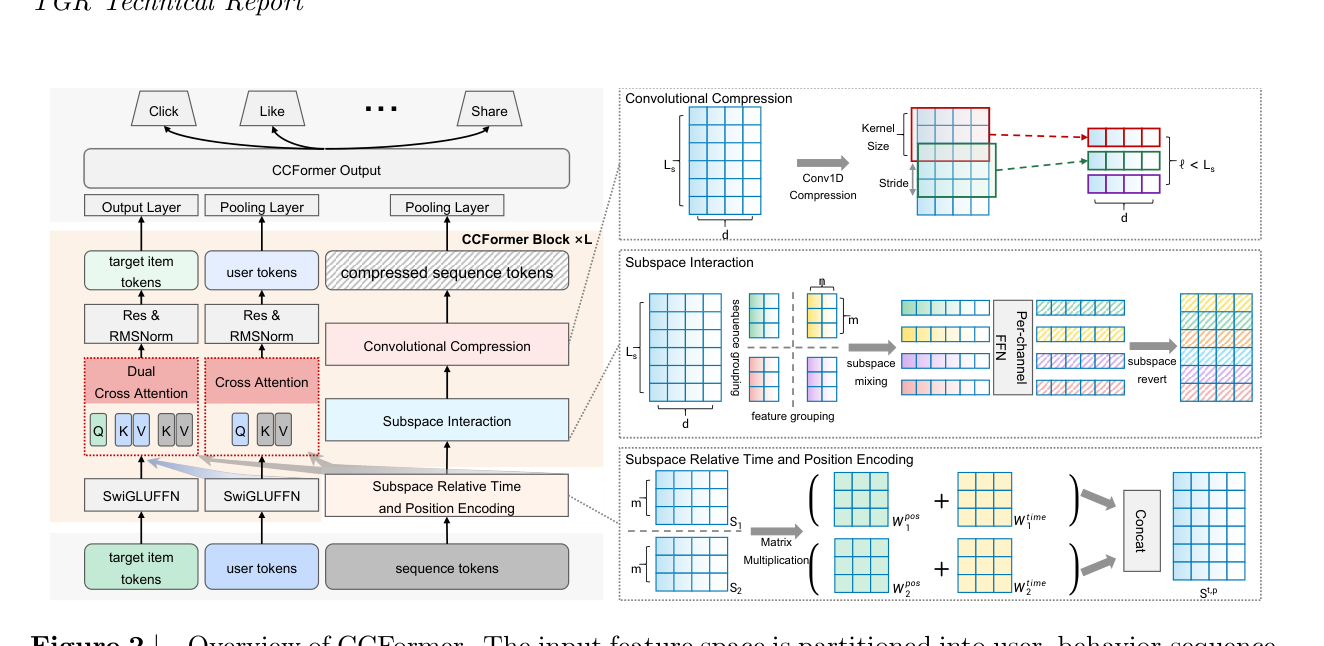
CCFormer 把输入特征空间切成三个语义域——用户画像 token $U \in \mathbb{R}^{L_u \times d}$、行为序列 token $S \in \mathbb{R}^{L_s \times d}$(每个历史物品一个细粒度 token)、目标物品 token $T \in \mathbb{R}^{L_t \times d}$——并堆叠 $L$ 个交互块迭代精炼三者。最后一块之后,归一化的域表征被聚合送入任务特定 head 做多任务预测。四个机制(逐块施加)取代了全局自注意力:
1. 特征域分离交叉注意力。 不做「拼接后所有 token 之间的无向注意力」(那会把语义不同的域一视同仁并浪费计算),而是用三条有向注意力流实现排序真正需要的异构交互:
- $\text{user} \to \text{sequence}$:在全历史上做偏好检索;
- $\text{target} \to \text{sequence}$:目标-历史相关性匹配;
- $\text{target} \to \text{user}$:目标-用户兼容性。
RMSNorm 对齐各域尺度,轻量 SwiGLU FFN 在交叉前精炼用户与目标 token。关键设计:目标 token 只作 query,彼此永不互相注意——这一点后面直接使能了全候选单次前向打分。
2. token 子空间内的相对时序-位置编码。 在 $m$ 个行为构成的局部组内注入 recency 感知的顺序信息:一个可学的时间衰减权重
$$w_{ij} = \alpha\,\beta^{\,|t_i - t_j|^{\gamma}}, \qquad \beta \in (0,1) \tag{3}$$
($\beta < 1$ 使时间上邻近的行为获得更大权重)加上一个可学的相对位置偏置,代价是 $O(L_s m)$ 而非注意力偏置矩阵的 $O(L_s^2)$。
3. 长序列子空间 token 混合。 序列张量被 reshape 成紧凑子空间,每个子空间同时跨 $m$ 个相邻行为 token 与 $n$ 个隐藏通道,每个通道组由一个独立的门控 per-channel FFN 处理。这强迫 token 级与通道级信号在局部子空间内直接交互,代价对 $L_s$ 线性。据作者所知,这是首次把工业排序的 token-mixing 范式从少量统一特征 token 扩展到全长行为序列。
4. 分层序列压缩。 每块之后用一个 stride 卷积(kernel $k$、stride $s$)融合相邻行为 token,把变短的序列交给下一块。每个存活 token 的感受野随深度渐进扩大:浅层在原始序列上捕捉短期细粒度模式,深层在全历史上抽取抽象长期偏好信号。因为后面的块在几何递减的序列上运行,总计算显著下降而全序列访问被保留——层间压缩与层内混合互补。
复杂度上(附录 D):相对时序-位置编码在 $m$ 个行为的局部组内 $O(L_s m)$,子空间 token 混合对 $L_s$ 线性,每块后的 stride 卷积把几何变短的序列交给下一块,因此在匹配容量下 CCFormer 的 per-sample GFLOPs 约为 HSTU 的一半。
工业规模的训练与服务配方¶
作者强调「部署配方与架构同等重要」,四个成分把模型从研究代码带到主流量:
- Numerous-Torch 基础设施:腾讯面向大规模推荐模型的生产级训练与推理基座。建模侧保持 PyTorch 原生开发体验,让 LLM 社区的进展可直接复用;系统侧提供分布式数据摄取、大规模稀疏特征处理、稀疏-稠密联合训练、checkpoint 恢复、模型导出,以及在新鲜用户反馈日志上的持续训练。
- 混合精度训练:主计算跑 BF16/FP16,显存开销降低 >35%,腾出的空间在同样训练预算下换成更大 batch 或更大模型。
- 稀疏参数压缩:ID 特征 embedding 表用 INT8 对称线性量化(相对全精度存储约 70% 压缩),再用 double-hashing 缩小表本身(稀疏参数量再降约 50%)。两者合计大幅削减训练期显存足迹与通信成本,且不损训练有效性。
- 候选单次并行打分:由于目标 token 之间从不互相注意,不存在跨目标信息泄漏,一次请求的全部候选可以打包进目标域一次前向:用户域与序列域的计算在候选间共享,模型一次发出每个候选的多任务分数。相对在位 DLRM 的 pointwise 逐候选推理,这在推理资源不变的前提下把线上峰值 QPS 抬高 30%——尽管 CCFormer 的单样本计算量高出 20 倍。
默认配置:特征 token 维度 $d = 256$、8 个 CCFormer 块、子空间组大小 $m = 8$ / $n = 16$、压缩卷积 $k = 3$ / stride $s = 2$、Adam 学习率 $10^{-4}$、batch size 4096;全部离线对比跑在同一套 16 张 NVIDIA H20 的硬件/软件栈上。
离线实验¶
设定。 两个公开基准——Taobao 与 KuaiRec,行为序列截断到长度 200——以及一个工业数据集:腾讯某推荐系统一个月生产日志,超过 40 亿样本、3000 万用户、1000 万物品,行为序列长度 1000。公开基准 baseline 横跨传统 DLRM 范式(DIN、DeepFM、SASRec、MIMN)与基于注意力的序列排序器(HSTU、OneTrans、STCA);工业对比用生产导向子集(HSTU、OneTrans、STCA),同时报 AUC 与 GAUC。$\Delta$AUC / $\Delta$GAUC 是 RelaImpr 意义下的相对提升,每个方法都各自做 TPE 超参搜索以保证公平。
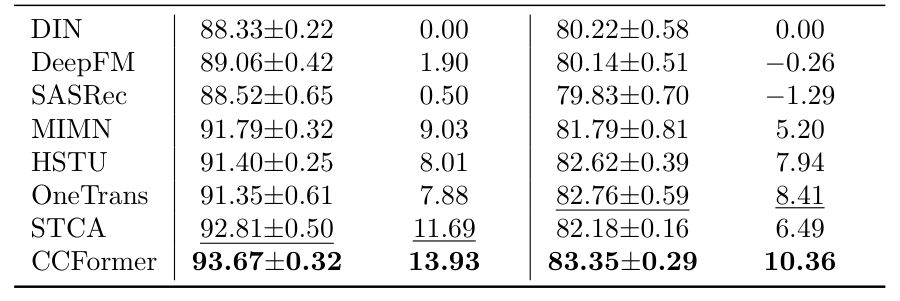
Table 2 | 公开基准离线对比(5 次 run 的 mean ± std),$\Delta$AUC 是相对 DIN 的相对提升
| Method | Taobao AUC (%) | Taobao ΔAUC (%) | KuaiRec AUC (%) | KuaiRec ΔAUC (%) |
|---|---|---|---|---|
| DIN | 88.33±0.22 | 0.00 | 80.22±0.58 | 0.00 |
| DeepFM | 89.06±0.42 | 1.90 | 80.14±0.51 | −0.26 |
| SASRec | 88.52±0.65 | 0.50 | 79.83±0.70 | −1.29 |
| MIMN | 91.79±0.32 | 9.03 | 81.79±0.81 | 5.20 |
| HSTU | 91.40±0.25 | 8.01 | 82.62±0.39 | 7.94 |
| OneTrans | 91.35±0.61 | 7.88 | 82.76±0.59 | 8.41 |
| STCA | 92.81±0.50 | 11.69 | 82.18±0.16 | 6.49 |
| CCFormer | 93.67±0.32 | 13.93 | 83.35±0.29 | 10.36 |
Table 3 | 工业数据集离线对比(40 亿+ 样本,序列长度 1000),$\Delta$ 列相对 HSTU
| Model | AUC (%) | ΔAUC (%) | GAUC (%) | ΔGAUC (%) |
|---|---|---|---|---|
| HSTU | 77.66 | 0.00 | 70.86 | 0.00 |
| OneTrans | 77.69 | 0.11 | 70.90 | 0.19 |
| STCA | 77.73 | 0.25 | 70.95 | 0.43 |
| CCFormer | 77.94 | 1.01 | 71.36 | 2.40 |
结论分析。 CCFormer 在每个数据集、每个指标上都拿到最好成绩。Taobao 与 KuaiRec 上分别到 93.67% 与 83.35% AUC,比各自最强序列 baseline(分别是 STCA 与 OneTrans)高 0.86 与 0.59 个点;把 KuaiRec 序列长度在 {200, 500, 1000} 上变化时对 HSTU / OneTrans / STCA 的领先也保持一致。工业数据集上相对 HSTU 提升 +0.28 AUC / +0.50 GAUC 点(相对 1.01% / 2.40%)——作者强调在生产规模下 0.1% 量级的 AUC 移动就被认为可上线——相对最强 baseline STCA 也还有 +0.21 AUC / +0.41 GAUC 点。
值得注意的是公开基准与工业基准的 baseline 排序不一致:Taobao 上 STCA 是第二,KuaiRec 上 OneTrans 是第二,工业集上 STCA 是第二而 OneTrans 只比 HSTU 高 0.03 点。这提示公开基准(序列 200、样本量小几个数量级)对长序列架构的区分度很有限,工业集上四个模型全部挤在 77.66–77.94 的 0.28 点区间内——这是理解后面消融实验争议的重要背景。
超参鲁棒性。 两族长序列特有的超参在很宽范围内不敏感:压缩 kernel $k$ 从 2 变到 7,AUC 只在 77.92–77.95% 之间移动;所有测试过的 $(m, n)$ 子空间组大小都优于 HSTU 且变化有限。实践上 CCFormer 迁移到新场景不需要精细调参。
Scaling 行为¶
生成式范式排序的前提是「排序质量可以用 FLOPs 买」,问题是汇率是多少。作者在两条对序列排序器最重要的轴上考察,固定硬件/软件栈,并把 GFLOPs 与质量并列汇报。
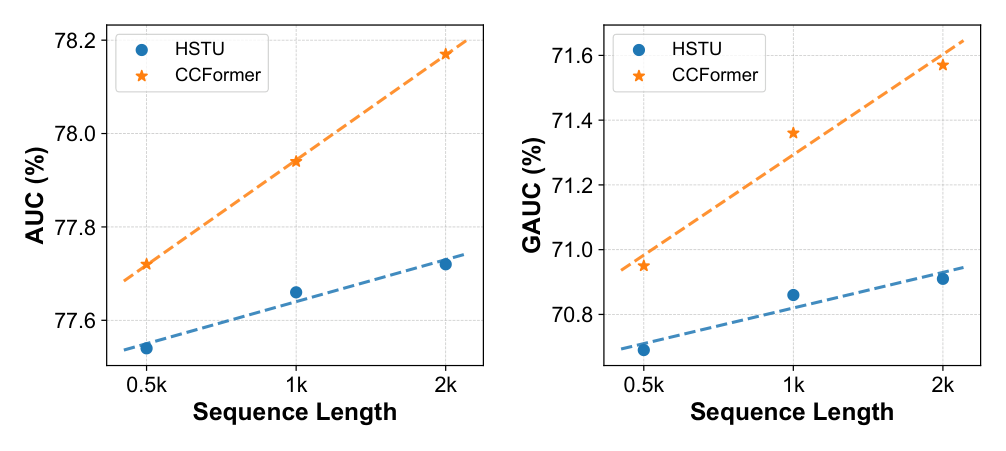
序列长度 scaling。 工业序列长度从 0.5k 涨到 2k,CCFormer 从 77.72% 单调涨到 78.17% AUC、70.95% 涨到 71.57% GAUC,跨长度设置对 HSTU 的平均相对增益为 1.08% AUC / 2.37% GAUC,且序列越长优势越大。最抢眼的是:CCFormer 用 0.5k 行为 token 就已经追平 HSTU 用 2k token 的 AUC 并超过其 GAUC——子空间 token 混合从全历史里榨出了表达性模式,分层压缩以一小部分代价保住了大感受野。
Table 4 | 模型规模 scaling(工业数据集),$\Delta$ 列为同维度下相对 HSTU 的相对提升
| Model | Dim. | AUC (%) | ΔAUC (%) | GAUC (%) | ΔGAUC (%) | GFLOPs/sample |
|---|---|---|---|---|---|---|
| HSTU | 128 | 77.42 | 0.00 | 70.55 | 0.00 | 28.87 |
| CCFormer | 128 | 77.65 | 0.84 | 70.76 | 1.02 | 9.34 |
| HSTU | 256 | 77.66 | 0.00 | 70.86 | 0.00 | 38.37 |
| CCFormer | 256 | 77.94 | 1.01 | 71.36 | 2.40 | 18.28 |
| HSTU | 512 | 77.79 | 0.00 | 71.02 | 0.00 | 63.47 |
| CCFormer | 512 | 78.13 | 1.22 | 71.52 | 2.38 | 36.14 |
结论分析。 特征维度在 {128, 256, 512} 上变化,CCFormer 可预测地 scaling(77.65% → 78.13% AUC,70.76% → 71.52% GAUC,匹配容量下对 HSTU 平均相对增益 1.02% AUC / 1.93% GAUC),同时在每个容量点上只消耗 HSTU 大约一半的 GFLOPs;在 $d = 128$ 时它用 4 倍更少的 per-sample GFLOPs 就逼近到 HSTU 在 $d = 256$ 的 0.01 AUC 点以内。两个分析合起来说明 CCFormer 提供了严格更好的「有效性-效率」汇率,而这正是让 scaling 可部署而不只是可演示的东西。
消融:速度和质量分别来自哪里¶
Table 5 | 工业数据集消融实验。Speedup 是相对 HSTU 的训练吞吐;$\Delta$ 列相对 HSTU。原文标注:加粗=最佳,下划线=次佳
| Variant | Speedup | AUC (%) | ΔAUC (%) | GAUC (%) | ΔGAUC (%) |
|---|---|---|---|---|---|
| HSTU (base) | 1.00× | 77.66 | 0.00 | 70.86 | 0.00 |
| CCFormer (full) | 2.21× | 77.94 | 1.01 | 71.36 | 2.40 |
| w/o relative temporal-pos. encoding | 2.35× | 77.85 | 0.69 | 71.13 | 1.29 |
| token mixing → self-attn | 1.41× | 77.96 | 1.08 | 71.21 | 1.68 |
| w/o long-seq. token mixing | 2.40× | 77.73 | 0.25 | 71.02 | 0.77 |
| w/o sequence compression | 1.29× | 77.96 | 1.08 | 71.25 | 1.87 |
作者给出三条发现:
- 序列压缩是效率杠杆:去掉它 AUC 基本不变(77.96%),但训练加速比从 2.21× 塌到 1.29×。
- 子空间 token 混合是质量主力:去掉它造成最大退化(−0.21 AUC / −0.34 GAUC 点);而把它换成标准自注意力只买到 +0.02 AUC 点、丢掉 0.15 GAUC 点,且加速比掉到 1.41×——「在序列上做昂贵的全局注意力是不必要的」。
- 相对时序-位置编码贡献 +0.09 AUC / +0.23 GAUC 点,靠的是把近期行为与过时行为分开。
我对「纯 AUC 上完整版反而输给两个消融变体」的独立复核¶
这是本篇最值得单独拿出来审的一处。事实层面:token mixing → self-attn 与 w/o sequence compression 两个变体的 AUC 都是 77.96%,都高于完整版的 77.94%;论文的排版把这两个 77.96 加粗(best),把完整版的 77.94 只标下划线(runner-up)。我的独立判断分四条:
(a) 透明度上无可指摘,归因表述与数字一致。 论文没有把完整版的 AUC 粉饰成最佳——加粗给了消融变体,正文也白纸黑字写「removing it leaves AUC essentially unchanged (77.96%)」和「buys only +0.02 AUC points」。「效率杠杆 = 序列压缩、质量主力 = 子空间 token 混合」这个二分法与表内数字逐项对得上:去压缩 → 速度塌(2.21×→1.29×)而 AUC 不动;去 token 混合 → 质量塌(AUC −0.21 / GAUC −0.34)而速度反升(2.40×)。这是一个干净的、可证伪的归因,我认为不构成夸大,同意不因此扣分。
(b) 但「说清楚了」这半句评价过宽——论文只是如实摆出数字,并没有解释背离。 全文从未定义 GAUC 的分组口径:是按 user 分组还是按 request 分组?是按曝光数加权还是等权?只有单类标签的组如何处理?在 AUC 与 GAUC 给出相反排序时,这个口径就不再是无关紧要的实现细节,而恰恰是判断结论是否成立的关键。论文也没有给出任何背离机制的解释(没有分 cohort 的 GAUC、没有按序列长度分桶的结果),只是把两列并排放着。
(c) $\Delta$ 列的 RelaImpr 归一化会系统性放大 GAUC 的相对数,读者若只看 $\Delta$ 列会高估效应量。 RelaImpr 的分母是 $(\text{metric} - 50)$:AUC 侧是 $77.66 - 50 = 27.66$,GAUC 侧是 $70.86 - 50 = 20.86$。同样 0.1 个绝对点,在 GAUC 上换算出的相对数天然比 AUC 高约 33%。完整版对 HSTU 的绝对差是 +0.28 AUC / +0.50 GAUC 点,相对数才成为 1.01% / 2.40%。所以「+2.40% vs +1.68%/+1.87%」这个对比里有一部分来自基线更低导致的分母更小,而不是纯粹的效应更大。以绝对点数复述才是诚实的表述:完整版 GAUC 比 token mixing → self-attn 高 0.15 点、比 w/o sequence compression 高 0.11 点,代价是 AUC 低 0.02 点。
(d) 工业表全部没有误差棒,所以 0.02 的 AUC 差本身不可判定——但这一点反而对论文有利。 Table 2 的公开基准给了 5 次 run 的 ±std(Taobao 上 0.22–0.65 个点量级),而 Table 3/4/5 的工业数字一个方差估计都没有。在这种情况下 0.02 AUC 点的「输」根本没有统计意义,作者自己定的可上线门槛是「0.1% 量级的 AUC 移动」,0.02 点低于该门槛,所以「AUC essentially unchanged」是站得住的。反过来,GAUC 侧 0.11–0.15 点的差同样缺方差估计,只是刚好落在作者自定的可上线量级之上——结论方向可信,但严格来说是「未被证伪」而非「已被证实」。
(e) 一条支持作者的、报告本身没有点破的证据。 我交叉核对了 Table 4:三个容量点上 $\Delta$GAUC(1.02 / 2.40 / 2.38)一致高于 $\Delta$AUC(0.84 / 1.01 / 1.22);Figure 3 的序列长度 scaling 也是同样模式(跨长度平均 1.08% AUC vs 2.37% GAUC),并且「0.5k 的 CCFormer 追平 2k HSTU 的 AUC 但超过其 GAUC」这句话本身就是同一现象的另一种表述。也就是说,「GAUC 增益系统性大于 AUC 增益」不是 Table 5 某一行的偶然,而是横跨容量轴、长度轴、消融轴的稳定架构性质。这大幅提高了作者归因的可信度:一个只在单行出现的背离更像噪声,一个在三张表上重复出现的背离更像机制。
(f) 机制上背离方向也是可解释的,但可能被口径放大的风险确实存在。 全局 AUC 混合了跨用户的分数可比性(重度用户与轻度用户整体倾向是否被摆对),GAUC 剔除跨用户成分只看组内排序。序列压缩与子空间 token 混合影响的正是「长历史里的组内个性化区分度」,落在 GAUC 度量的那一面;一个变体完全可能因为分数分布跨用户更"齐"而在全局 AUC 上小胜、却在组内排序上更差。这个方向是自洽的。但风险也在同一处:如果 GAUC 按曝光数加权,重度用户权重更高,而重度用户序列更长——恰好是 CCFormer 长序列建模优势最大的那批人,口径就会系统性放大差距。论文既没给分组定义也没给分 cohort 结果,读者无法排除这种放大。
(g) 评分 agent 未提到的一处真实缺口:Table 5 只报了训练吞吐,没有报去掉序列压缩后的服务侧成本。 决定能否上线的是 serving 代价与 QPS,而 §3.3 报的 +30% 峰值 QPS 来自「目标 token 互不注意 → 单次前向打分全部候选」,这与序列压缩正交。也就是说,「序列压缩 = 效率杠杆」这个结论在训练侧有证据支撑,在服务侧没有。一个只关心推理成本、训练预算宽裕的团队,看这张表其实得不到「必须保留序列压缩」的结论——而这恰恰是工业读者最想知道的。
总判断:评分 agent 的结论「未夸大归因、不扣分」成立,且比我预期的更站得住((a)(d)(e) 三条支持);但其表述里「作者把这件事讲清楚了」这半句过于宽松——作者是如实摆出而非解释了背离。我把 GAUC 口径未定义、工业表无方差、无服务侧压缩成本这三点写进 limitation,但不因此下调分数。
线上部署与 A/B 结果¶
CCFormer 在腾讯 5 个场景做了 A/B,覆盖视频推荐、内容流、广告排序。在位模型因场景而异,这让对比在两个方向上都有信息量:场景 1 替换的是一个长期迭代优化过的 DLRM 排序器,场景 2–5 替换的是已经部署的 HSTU 模型。每个实验组每天服务超过 100 万曝光用户,窗口两周。所有汇报的提升都统计显著(双样本 t 检验,$p < 0.05$)。
Table 6 | CCFormer 在五个腾讯生产场景的线上 A/B 增益
| 场景 | 指标与相对提升 |
|---|---|
| 场景 1(视频推荐,替换 DLRM) | CTR +3.57%、UCTR +1.93%、3 日活跃度 +1.93%、Video View +3.47%、Unique Viewer +2.61%、Page View +3.86%、Watch Time +1.29%、广告收入 +1.64% |
| 场景 2(广告排序,替换 HSTU) | Ad view +1.43%、广告收入 +1.71% |
| 场景 3 | CTR +2.02%、UCTR +1.67%、新用户 Page View +4.01%、广告收入 +1.29% |
| 场景 4 | Page View +0.55%、完播 +0.98%、Watch Time +0.42%、Follow +2.18% |
| 场景 5 | Page View +0.45%、Watch Time +1.26%、Share +3.49%、CTR +1.01% |
结论分析。 场景 1 的收益覆盖完整参与漏斗——点击、消费、受众、短期留存全线正向,且场景 1 与广告排序场景 2 都抬了广告收入(+1.64% / +1.71%)这个关键变现指标。A/B 之后 CCFormer 在场景 1 与 2 全量上线,现在承载这两个场景的全部生产流量,全量后收益保持稳定。注意场景 2–5 是在已经部署 HSTU 的基础上再拿收益,这比替换传统 DLRM 更难,也更能说明 CCFormer 相对同代注意力排序器的架构优势不是纸面的。
TGR-GenRec:从 next-token 到 next-slate¶
TGR-GenRec 是 TGR Stack 的端到端生成方向,也是发展最充分的部分。它是一个方向而非单一模型:横跨生成式推荐的两种范式,各上线一个生产模型。
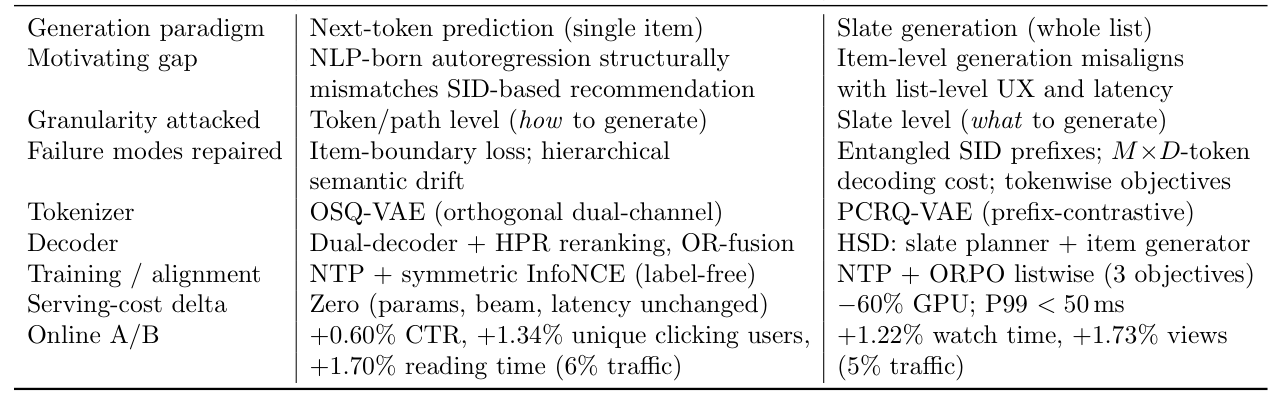
- NTP 范式——忠实地生成一个物品(BARGE)。 主流生成式形式化(TIGER 谱系)把每个物品 tokenize 成层次化 SID 元组,逐 token 预测下一个物品。但这个形式化是从自然语言借来的,那里每个 token 都携带独立语义;而一个层次化 SID 码字只有和它的前缀合在一起才有意义。这个错配在任何 NTP 式 SID 生成器里都造成两个结构性缺口:拉平序列在 encoder 侧溶解了物品边界;层次化解码累积语义漂移——任何一层的错误都把搜索困在错误的子树里。BARGE 的答案是改造 NTP 机制本身:在 encoder 恢复物品结构(ICA)、为全局一致性对解码路径重排(HPR)、通过两个正交量化通道解码(DPD)。
- 整版生成(NSP)范式——生成整个列表(HiGR)。 即便是一个完美忠实的 next-item 生成器也是一次决定一个物品,而我们的界面在一屏里呈现一个有序 slate:质量活在列表层面——排序、兼容性、多样性——而逐物品解出 $M \times D$ 个 token 在实时约束下太慢,token 级似然两者都没优化。HiGR 的答案是把列表变成生成的单位:带可控前缀的层次化 semantic ID(PCRQ-VAE)、粗到细的 slate 规划与物品解码(HSD)、listwise 多目标对齐(ORPO)。
两个模型在构造上正交——BARGE 在 NTP 范式内加固生成机制,HiGR 改变生成的输出结构与目标——它们的修复作用在不相交的失效模式上。两者都在同一条生产纪律(P1)下上线:在既有过滤器栈之后 drop-in 部署,延迟与 GPU 预算持平或更优。
| BARGE | HiGR | |
|---|---|---|
| 生成范式 | next-token prediction(单物品) | slate generation(整列表) |
| 动机缺口 | NLP 出身的自回归与 SID 推荐结构性错配 | 物品级生成与列表级 UX 及延迟错配 |
| 攻击的粒度 | token / 路径级(怎么生成) | slate 级(生成什么) |
| 修复的失效模式 | 物品边界丢失;层次化语义漂移 | SID 前缀纠缠;$M\times D$ token 解码成本;tokenwise 目标 |
| Tokenizer | OSQ-VAE(正交双通道) | PCRQ-VAE(前缀对比) |
| Decoder | 双 decoder + HPR 重排,OR-fusion | HSD:slate 规划器 + 物品生成器 |
| 训练 / 对齐 | NTP + 对称 InfoNCE(无标签) | NTP + ORPO listwise(3 目标) |
| 服务成本变化 | 零(参数、beam、延迟不变) | −60% GPU;P99 < 50 ms |
| 线上 A/B | +0.60% CTR、+1.34% 独立点击用户、+1.70% 阅读时长(6% 流量) | +1.22% 观看时长、+1.73% 播放量(5% 流量) |
BARGE:为工业推荐改造 next-token prediction¶
BARGE(Bridging AutoRegressive Generation for rEcommendation)在不增加参数、beam 预算、服务延迟的硬生产约束下设计,部署在腾讯商业媒体平台上,6% 实时流量的 A/B 交出 +0.60% CTR、+1.34% 独立点击用户、+1.70% 总阅读时长。
动机:工业规模下的两个结构性缺口¶
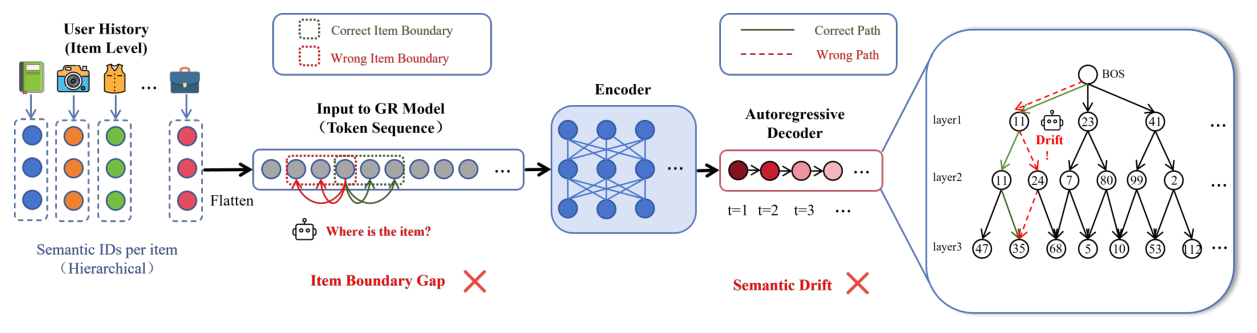
(P1) 物品边界缺口。 现有 RQ-VAE 式生成式推荐器把每个物品 tokenize 成 $L$ 级 SID,并把用户历史里所有 SID 拼成单条 token 序列。这个表示对标准序列模型很方便,但在序列进入 encoder 之前就抹掉了显式的物品边界。自注意力于是对所有 SID token 一视同仁,必须主要从位置和上下文信号里推断哪些 token 属于同一物品。
更微妙的歧义来自 RQ-VAE 码字的层次性:一个码字的语义依赖它的前缀,而它的输入 embedding 通常只由码索引和量化层级决定。考虑两个 SID 为 $\langle 1,3,5\rangle$ 与 $\langle 7,3,8\rangle$ 的物品:第二层都用码字 3,因此拿到相同的初始查表 embedding;但偏路径 $\langle 1,3\rangle$ 与 $\langle 7,3\rangle$ 对应层次码本树上的不同节点,未必代表相同的物品级语义。下游 encoder 只能靠上下文化把这个前缀条件的区分重新恢复出来。
拉平之后,encoder 必须同时重建物品归属并消解单个码字的前缀依赖语义,这把物品级偏好建模的负担压在隐式 token 交互上——尽管推荐本质上是在物品层面进行的。
(P2) 语义漂移。 层次化 SID 定义了一条树状解码路径,每个被预测的码字约束了后续层可达的子树。早期错误因此把解码重定向到错误子树,使目标物品沿所选路径不可达。虽然 beam search 保留多条偏路径,但它主要按累积 token 对数概率排序,没有显式评估路径的全局语义一致性。作者把这种前缀诱导的误差传播称为语义漂移。
Table 8 | Amazon Beauty 上 TIGER baseline 的逐层预测质量(teacher forcing vs 自回归解码,greedy)
| Layer / Mode | Mismatch ↓ | Rank ↓ | Prob ↑ |
|---|---|---|---|
| c1 (TF / AR) | 0.915 | 66.9 | 0.046 |
| c2 (TF) | 0.864 | 25.3 | 0.102 |
| c2 (AR) | 0.981 | 108.2 | 0.015 |
| c3 (TF) | 0.195 | 7.4 | 0.787 |
| c3 (AR) | 0.984 | 119.5 | 0.015 |
| c3 (AR, prefix correct) | 0.230 | 3.7 | 0.738 |
| c3 (AR, prefix error) | 0.994 | 121.1 | 0.006 |
结论分析。 这张表是全篇最有说服力的诊断之一。在最深层 $c_3$,赋给目标码字的概率从 teacher forcing 下的 0.787 掉到自回归解码下的 0.015,约 52 倍的跌幅。自回归解码下,前缀正确时 $c_3$ 准确率 77.0%,前缀错误时只有 0.6%,差距超过 128 倍。这说明深层失败主要源于前序路径错误,而不仅仅是当前层的预测难度——这就把「该修哪里」定死了:不是加深层容量,而是修前缀。
为什么不能简单加宽 beam。 推理延迟大致随 $B$ 线性增长,而 beam 依赖的解码显存随 $B \times L$ 增长;更重要的是,更大的 beam 只是保留更多候选路径,并没有显式纠正底层的语义漂移。这个权衡在平台规模下尤其尖锐——物品库可含数千万到数亿物品且长尾极度倾斜。
方法:三个轻量正交模块¶
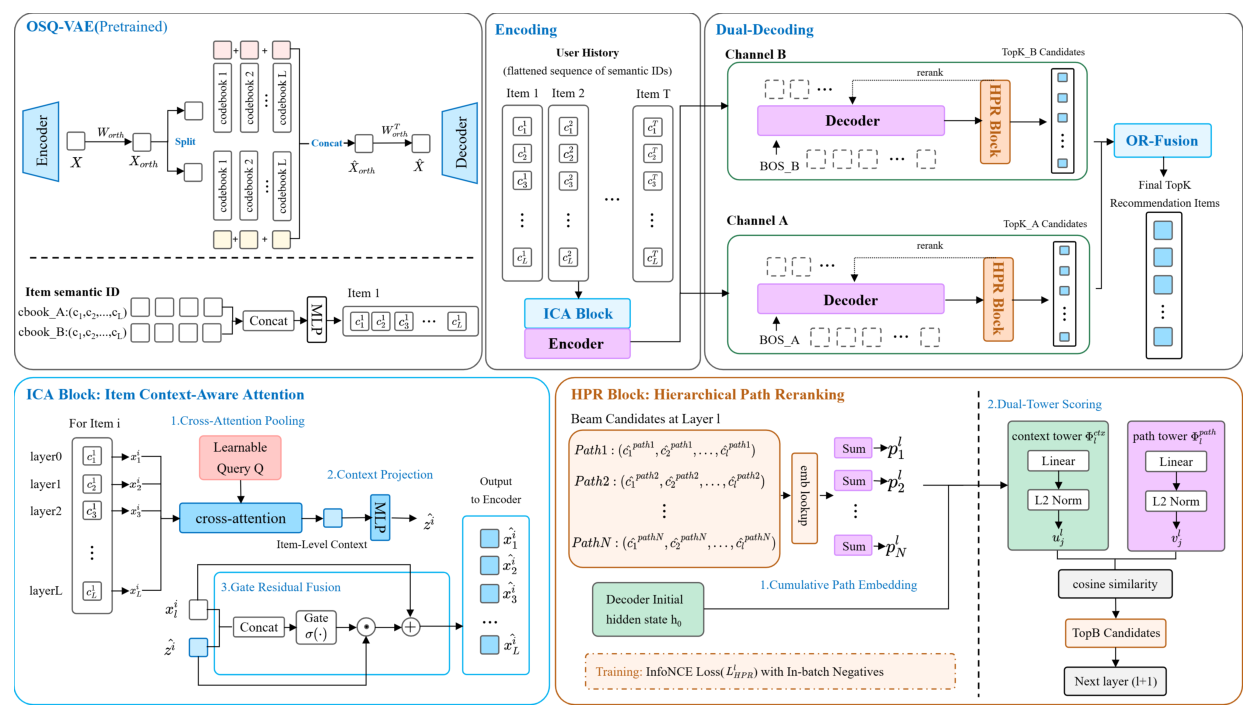
- Item Context-Aware Attention(ICA) 在 encoder 侧解决物品边界缺口。对每个物品,ICA 用一个可学 query 通过交叉注意力聚合它的 $L$ 个 SID token embedding,再通过门控残差连接把得到的物品级上下文注入每个 token。当门趋近 0 时模块退化为恒等路径,保留原始 token 表征。经验上,四个 SID 层的平均门激活在两个公开数据集上都集中在 0.35–0.38,说明 ICA 学到的是适度的上下文注入而非覆盖 token 级信号。
- Hierarchical Path Reranking(HPR) 在每个解码通道内解决语义漂移。在第 $l$ 层,一个双塔打分器评估 decoder 的生成前隐状态 $h_0$ 与累积路径嵌入之间的兼容性:
$$p^{(l)} = \sum_{j=1}^{l} e_{c_j} \tag{4}$$
HPR 与主模型联合训练,用对称 InfoNCE:每个正样本对把 $h_0$ 与其真实累积路径匹配;负样本混合了 in-batch 路径、从 NTP 分布中采样的高概率非真值前缀、以及可选的业务反馈负样本(曝光未点击物品)。这些前缀感知的负样本让 HPR 在训练时就见到了似是而非的漂移模式。推理时 HPR 以权重 $\lambda$ 把路径兼容性分数与生成对数概率融合,对 Top-$N$ 池重排,只保留 Top-$B$ 条路径进入下一层——出射 beam 宽度因此保持不变,上下文侧表征在所有候选路径间共享以限制额外打分成本。
- Dual-Path Decoding(DPD) 从互补的解码方向解决语义漂移。其 Orthogonal Split-and-Quantize VAE(OSQ-VAE) 施加一个可学的 Householder 参数化旋转 $R$,构造上满足
$$R^{\top} R = I \tag{5}$$
并把旋转后的物品表征切成两个正交坐标子空间。两个子空间由独立的残差码本栈量化,为每个物品产出两条 SID 通道。一个共享 encoder 喂两个通道特定的 decoder 塔,每塔配私有输出 head 与 HPR 打分器。它们的物品空间分数通过 LSE 式 soft-OR 融合合并,使任一通道给出高排名的物品都能被救回。DPD 保持每通道 beam 宽度与最终 Top-$K$ 输出长度不变,但两条解码分支相对单通道模型确实引入了额外 decoder 计算。
两个解码通道的经验互补性很强:$K = 10$ 时它们的候选池在 Beauty 上 Jaccard 相似度只有 0.183,Sports 上 0.172;在被 OR 融合成功召回的测试样例中,15.6%(Beauty)与 24.3%(Sports)是由某一个通道独家贡献的。
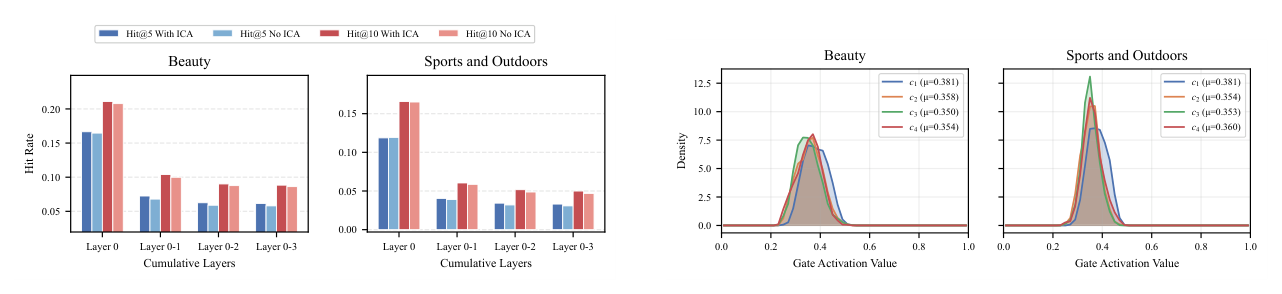
Figure 6 进一步显示 ICA 相对无 ICA 版本的累积命中率优势随 SID 层加深而扩大——这个趋势与「更强地抵抗层次化误差传播」的解释一致。
离线结果¶
Table 9 | BARGE vs 最强已发表 baseline(Amazon Beauty / Sports,R@10 / N@10)。BARGE-base 把 4 层学习码本换成 TIGER 的 3 层码本 + 一个消歧 ID
| Method | Beauty R@10 | Beauty N@10 | Sports R@10 | Sports N@10 |
|---|---|---|---|---|
| TIGER | 0.0648 | 0.0384 | 0.0400 | 0.0225 |
| HSTU | 0.0704 | 0.0389 | 0.0414 | 0.0215 |
| COBRA | 0.0725 | 0.0456 | 0.0434 | 0.0257 |
| ActionPiece | 0.0775 | 0.0424 | 0.0500 | 0.0264 |
| APAO-pointwise | 0.0795 | 0.0453 | 0.0444 | 0.0237 |
| BARGE-base | 0.0896 | 0.0515 | 0.0513 | 0.0285 |
| BARGE | 0.0927 | 0.0547 | 0.0544 | 0.0308 |
结论分析。 Beauty 上把 R@10 从 0.0775(ActionPiece)抬到 0.0927(+19.6%),比 TIGER 高 43.0%。关键在 BARGE-base 这个码本受控变体:它已经超过所有先前 baseline,把三个结构模块的收益与码本设计的收益隔离开——这是很规范的实验设计,避免把「换了更好的码本」误记成「结构修复起作用」。组件消融显示每个模块都独立起作用且增益大体可加,与「三个模块作用于不相交的失效来源」的说法一致。
Table 10 | 腾讯商业媒体平台两个大规模场景的离线表现
| Method | Hit@5 | Hit@10 | Hit@20 | Hit@50 |
|---|---|---|---|---|
| 场景 1(11 天窗口,前 10 天训练 / 末日评估;百万级用户、亿级交互、十万级物品) | ||||
| GraphSAGE-based | 0.2932 | 0.3743 | 0.4650 | 0.5951 |
| NANN | 0.4416 | 0.4946 | 0.5636 | 0.6760 |
| OneRec | 0.5459 | 0.6132 | 0.6729 | 0.7348 |
| BARGE | 0.6015 | 0.6510 | 0.6967 | 0.7520 |
| 场景 2(千万级用户、千万级候选物品、百亿级交互) | ||||
| GraphSAGE-based | 0.0580 | 0.0895 | 0.1330 | 0.2064 |
| BERT-based | 0.0523 | 0.0864 | 0.1347 | 0.2223 |
| OneRec | 0.0835 | 0.1256 | 0.1806 | 0.2658 |
| BARGE | 0.0976 | 0.1441 | 0.2045 | 0.2994 |
结论分析。 场景 1 相对最强 baseline OneRec,Hit@5 提升 10.2%、Hit@10 提升 6.2%;场景 2 增益更明显,Hit@5 +16.9%、Hit@10 +14.7%,且在 Hit@50 上仍有 12.6%——说明收益不止发生在列表最前面几个位置。需要标注一个诚实的口径说明:OneRec 是作者按其公开架构与方法描述内部复现的(原技术报告的源码与 checkpoint 不公开),仅用于离线对比,两个场景都没有部署。作者对被比较系统的机制归因也写得清楚:GraphSAGE、NANN、BERT 类模型主要在原子物品表征上操作,不显式建模相关物品共享的粗粒度语义结构;OneRec 通过 SID 生成缩小了差距,但其单路径 token 级目标仍然易受浅层错误与「不在路径上的物品」影响。
效率与工程¶
Table 11 | 相同配置下 Amazon Beauty 上 TIGER 与 BARGE 的效率对比
| Method | #Params | Train (s/epoch) | Infer (s/epoch) |
|---|---|---|---|
| TIGER | 22.71 M | 22 | 17 |
| BARGE | 19.91 M | 24 | 18 |
结论分析。 BARGE 的准确率增益基本零边际成本:用 2 层 encoder 代替 TIGER 的 4 层,吸收了 ICA、HPR 打分器、DPD 双塔的参数,于是 BARGE 实际上比 TIGER 更小(19.91 M vs 22.71 M);每 epoch 训练/推理成本增长不到 10%,因为两个 DPD 塔共享 encoder 并并行运行。
四条工程不变式与配方是能上线的关键:
- 固定评估预算:beam 宽度全程保持 TIGER 谱系默认 $B = 20$,部署的召回通道每请求跑 50 条 SID 序列;HPR 在 beam 内重排、OR 融合在同一 $K$ 截断,因此下游容量无需重新规划。
- 鲁棒的超参平台:HPR 融合权重呈倒 U 形且有机制解释(救回 vs 破坏的权衡),最优在 $\lambda = 0.25$;重排池在 Top-$N \approx 400$ 之后饱和。两个设置跨数据集迁移无需重调。
- 更便宜的码本设计:逐层递减的 $(512, 256, 128, 64)$ 码本把容量分配给「划分质量最要紧」的粗层,用更少的码字 embedding(960 vs 均匀 4 层配置的 1024)却表现更好。
- 正交性作为硬不变式:Householder 参数化在整个训练中把 $R^\top R = I$ 维持到 $\sim 10^{-6}$,无需任何辅助损失,消除了一整类正则调参失效模式;学到的旋转相对冻结 $R = I$ 把重建损失降低 0.04–0.05。
部署与线上 A/B¶
线上服务。 BARGE 作为生成式召回通道接入腾讯商业媒体平台。每请求用 beam search 生成 50 条 SID 序列。不是把每条 SID 序列映射到单个物品,而是把其构成 SID token 对应的码本 embedding求和得到查询表征,再用它通过 embedding 式近似最近邻检索服务从物品库检索相关物品。当前每请求配额下,每条 SID 序列检索 10 个物品,最多产出 $50 \times 10 = 500$ 个候选。这些候选随后交由既有下游级联处理——粗排、精排、混排、过滤、业务规则。
跨序列去重后,每请求平均保留约 480 个不同候选,重复率仅 ≈4%。50 条生成 SID 序列检索出的候选之间重叠有限,说明生成过程没有塌缩到一小撮主导物品,而是覆盖了物品库的互补区域——这条候选级证据支持「BARGE 在固定 beam 预算下维持了可观的召回多样性」。
线上 A/B。 BARGE 在 2 张 NVIDIA H20 上训练,两周 A/B,实验组分配 6% 实时流量,所有汇报提升均统计显著:相对已部署的多阶段在位系统,CTR +0.60%、独立点击用户数 +1.34%、总阅读时长 +1.70%。
全量后收益变大且更稳定——这是本篇最有洞察力的一处观察。 初次 A/B 后 BARGE 全量上线为生产召回通道,并保留了长期 holdback 组持续测量增量效果。在更长观测窗口里,CTR 与总阅读时长都表现出比初次实验期更大、更稳定的提升。作者给的一个合理解释是训练-服务分布错配的渐进消解:小流量实验期间,BARGE 引入的许多长尾与异质物品在历史曝光日志里代表性不足,因此可能被下游模型低估;全量之后产生的曝光与用户反馈样本被逐步纳入训练流水线,系统能更好地建模 BARGE 引入的物品分布,相应的曝光偏差随之减小。长期 holdback 还捕捉了显著更长周期上的累积系统效应,更大的观测窗口也降低了处理效应估计的方差。
Table 12 | 腾讯商业媒体平台代表性召回通道的线上对比
| Retrieval channel | Exposure adoption rate | CTR |
|---|---|---|
| Content-based (CB) | 0.47% | 5.61% |
| DNN-based | 0.85% | 6.94% |
| Graph-based I2I | 1.03% | 8.70% |
| BARGE | 1.02% | 9.93% |
结论分析。 曝光采纳率定义为「某召回通道最终被下游系统采纳并曝光的物品数」与「该通道提交候选总数」之比,衡量检索候选穿过下游粗排、精排、混排、过滤、业务规则的效率。BARGE 在四个代表性召回通道里取得最高 CTR 9.93%,同时曝光采纳率 1.02% 与 Graph-based I2I 的 1.03% 相当,处于第一梯队。这两个维度合起来说明:BARGE 的检索物品既能有竞争力地穿过下游级联,曝光后又有最高的点击转化率——作为独立召回通道有可度量的自立价值。
HiGR:工业规模的整版生成¶
HiGR(Hierarchical Generative slate Recommendation)不再一次生成一个物品,而是把整个有序 slate 当作单一生成单位。相对匹配容量的 OneRec,在不开 KV cache 的匹配解码设置下 HiGR 取得 >5× 推理加速,开 KV cache 后仍保持最佳质量-效率折衷。HiGR 已部署在多个腾讯商业平台,服务数亿用户。
动机:物品生成与 slate 优化之间的三个断裂¶
判别式两阶段系统孤立地给候选打分,再通过贪心选择、启发式或重排组装 slate;独立优化物品忽略了物品间依赖与位置效应,产出局部合理但全局次优的 slate。SID 式生成式推荐给了更直接的路径——自回归生成一个有序 slate,可以联合建模物品选择、排序、跨物品依赖。但把逐物品 SID 生成扩到工业规模的 slate 优化,暴露三个断裂:
- (D1) 纠缠的 SID 空间。 生成式 slate 质量取决于物品 tokenization,但标准残差量化产出的是纠缠、稀疏的码空间,其中 SID 前缀不反映物品语义或协同关系。不一致的前缀削弱可控性,使得「通过离散码直接调控 slate 级相关性与多样性」变得困难。
- (D2) 低效的细粒度解码。 $M$ 个物品、每物品 $D$ 个 SID 的 slate 需要解 $M \times D$ 个 token。在这个长度上做全序列自回归 beam search 在实时约束下很慢,并且把物品内语义组合与物品间转移纠缠在一起,模糊了全局 slate 结构。
- (D3) 目标失配。 token 级似然不优化用户感知的 slate 质量。平台关心的是多个列表级目标——排序保真度、真实用户兴趣、列表内多样性——而 next-token prediction 一个都没捕捉到。
方法:tokenizer / decoder / 目标三位一体¶
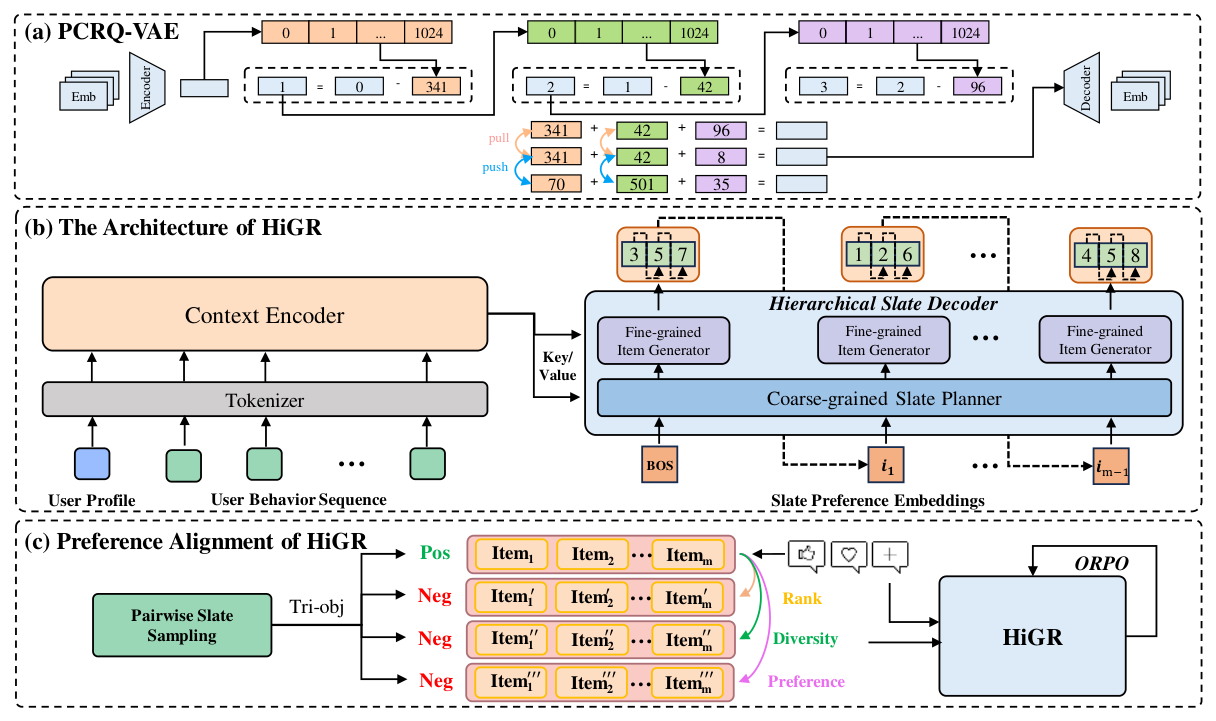
PCRQ-VAE —— 结构化离散空间(对 D1)。 tokenizer 保留标准 RQ-VAE 骨干,但用两个添加项塑形码空间:一个全局量化项把每个物品的聚合码字与其 latent 对齐,防止深层码本中的残差消失;一个前缀对比目标把语义或协同相关物品的前 $D-1$ 层码本拉近,同时排除叶层。高层前缀因此编码共享语义,末层保留物品身份,于是 slate 解码可以直接在离散码上施加相关性与多样性约束,而不是在连续 embedding 上。
HSD —— 粗到细生成(对 D2)。 分层 slate decoder 不在完整 $M \times D$ SID 序列上自回归,而是把生成分解为一个粗粒度 slate 规划器和一个细粒度物品生成器。规划器在紧凑的偏好嵌入空间里自回归——每个 slate 位置一个 embedding——固定全局列表意图;一个共享的物品生成器再把每个偏好落地成一小段局部 SID 序列;规划几何上的列表内多样性(ILD)正则器保持各位置彼此区分。推理时规划器跑 greedy,beam search 被限制在短的逐物品解码内,收缩了有效搜索空间,相对全序列生成大幅削减解码成本。
ORPO listwise 对齐 —— 优化 slate 质量(对 D3)。 为把 token 级生成与用户感知质量连起来,HiGR 通过免参考模型的 Odds Ratio Preference Optimization 对齐整版 slate,它把偏好优化折进有监督学习,不需要 reference model。slate 级正/负样本对从隐式反馈中挖掘,覆盖三个互补目标:排序保真度(对抗错序排列)、真实兴趣(对抗被负面接收的物品)、多样性(对抗过度相似的列表)。有监督项保持生成准确性,对比项拒绝排序糟糕、不相关或重复的 slate。
离线结果¶
Table 13 | 工业数据集与 KuaiRec 上的离线表现
| Method | 工业-曝光 Hit@5 | 工业-曝光 Recall@5 | 工业-有效播放 Hit@5 | 工业-有效播放 Recall@5 | 工业 NDCG@5 | KuaiRec-曝光 Hit@5 | KuaiRec-曝光 Recall@5 | KuaiRec-有效播放 Hit@5 | KuaiRec-有效播放 Recall@5 | KuaiRec NDCG@5 |
|---|---|---|---|---|---|---|---|---|---|---|
| ListCVAE | 0.0857 | 0.0178 | 0.0571 | 0.0117 | 0.0186 | 0.2304 | 0.0523 | 0.0757 | 0.0161 | 0.0630 |
| BERT4Rec | 0.0911 | 0.0187 | 0.0632 | 0.0129 | 0.0201 | 0.2612 | 0.0583 | 0.0829 | 0.0177 | 0.0713 |
| SASRec | 0.1057 | 0.0218 | 0.0700 | 0.0143 | 0.0243 | 0.3017 | 0.0756 | 0.1028 | 0.0231 | 0.0839 |
| TIGER | 0.1812 | 0.0383 | 0.1204 | 0.0249 | 0.0406 | 0.4455 | 0.1299 | 0.1566 | 0.0378 | 0.1363 |
| HSTU | 0.2281 | 0.0506 | 0.1487 | 0.0310 | 0.0492 | 0.5055 | 0.1334 | 0.1728 | 0.0397 | 0.1466 |
| OneRec-25M | 0.2438 | 0.0577 | 0.1603 | 0.0367 | 0.0589 | 0.5150 | 0.1395 | 0.1782 | 0.0422 | 0.1496 |
| HiGR-25M w/o ORPO | 0.2641 | 0.0612 | 0.1810 | 0.0395 | 0.0631 | 0.5218 | 0.1437 | 0.1805 | 0.0462 | 0.1536 |
| HiGR-25M | 0.2825 | 0.0692 | 0.1945 | 0.0433 | 0.0714 | 0.5290 | 0.1485 | 0.1846 | 0.0491 | 0.1574 |
| HiGR-100M | 0.3163 | 0.0760 | 0.2145 | 0.0495 | 0.0831 | 0.5360 | 0.1544 | 0.1905 | 0.0546 | 0.1651 |
评估协议。 公开侧在 KuaiRec 上构造按时间的用户序列,采用 leave-five-out 的 slate 评估协议。工业数据集来自腾讯商业媒体平台,含 10 亿条预训练样本,其中 3% 用于 ORPO 后训练。指标同时评估曝光建模与正反馈质量:Impression Hit@5 / Recall@5 度量模型是否复原展示过的物品,Effective-View Hit@5 / Recall@5 聚焦被正面接收的物品,NDCG@5 度量其排序质量。
结论分析。 同为 25M 参数规模,HiGR 在全部 5 个工业指标上超过最强 baseline OneRec-25M:Impression Hit@5 从 0.2438 到 0.2825(+15.9%),Effective-View Hit@5 从 0.1603 到 0.1945(+21.3%),NDCG@5 从 0.0589 到 0.0714(+21.2%)。关键的隔离实验是 HiGR-25M w/o ORPO 已经在两个数据集全部 10 个指标上超过 OneRec-25M——把 tokenizer 与分层 decoder 的收益从偏好对齐的收益中剥离出来;ORPO 再把每个指标进一步推高。100M 模型整体最好,工业 NDCG@5 达 0.0831,相对 OneRec-25M +41.1%。注意这里同时对比了传统 slate 推荐(ListCVAE)、判别式序列模型(BERT4Rec / SASRec)与生成式基线(TIGER / HSTU / OneRec),跨建模范式的覆盖是充分的。
组件分析。 PCRQ-VAE 方面,把对比对齐施加于前 $D-1$ 层码本得到 2.37% 碰撞、93% 集中度、66.47% 一致性;把约束扩展到叶层会把碰撞抬到 8.73%——确证了「必须为物品身份保留最后一层」。HSD 方面,去掉 ILD 正则器把列表内多样性从 0.62 降到 0.59 而准确率几乎不变;去掉上下文 embedding 则把 NDCG@5 从 0.0753 砸到 0.0664(两者都在 HiGR 原论文的消融配置下测量,其对齐前基线与 25M 主设置不同);为各位置配独立物品生成器相对共享设计没有一致收益。偏好对齐方面,ORPO 在工业数据集与 KuaiRec 上的 ILD 分别为 0.62 / 0.63,而 DPO 只有 0.57 / 0.60;排序保真度与真实兴趣目标主要提升 NDCG@5,多样性目标主要提升 ILD,三者联合优化产出最好的 NDCG@5 0.0831 同时保住 ILD 0.62。
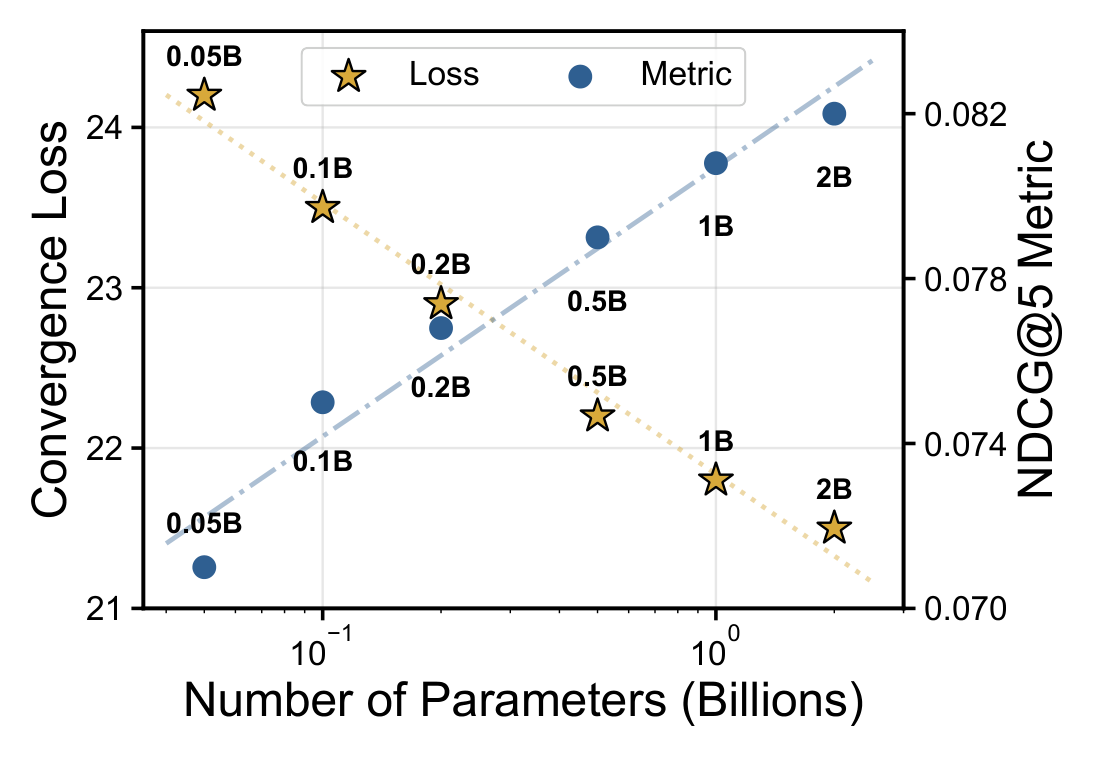
Scaling。 0.05B 到 2B 参数的实验中,损失与 NDCG@5 都遵循清晰的幂律趋势,说明模型容量带来可预测的收益——把 §3.5 在生成式排序上观察到的 LLM 式 scaling 行为延伸到了整版生成。
效率与工程¶
分层 slate 解码带来的效率。 扁平 slate 生成器把 $M$ 个物品的 slate 表示成一条 $MD$ 个 SID token 的序列,这把全局 slate 建模与细粒度物品构造耦合起来,迫使训练与推理都在长目标序列上操作。HSD 把计算分解为一个 $M$ 步的偏好嵌入规划器与一个跑短 $D$ token SID 序列的共享物品生成器。训练时,这把「对一条 $MD$ token 序列的目标侧自注意力」替换成「对 $M$ 个规划位置的注意力 + 一批短的物品级序列」。同一个物品生成器在所有 slate 位置间共享,其参数量不随 slate 长度增长。作者诚实地标注:HSD 改善了训练侧的计算结构与参数效率,但论文没有报告独立的训练速度测量。
推理侧的效率增益更直接。OneRec 式 decoder 把 beam search 贯穿整条 $MD$ token 的 slate,而 HSD 只在 $M$ 个偏好嵌入上做 greedy 自回归规划,并把 beam search 限制在每段短 $D$ token 物品序列内。解码复杂度从
$$O\bigl(B \cdot M^3 D^3 \cdot l_{\text{slate}} \cdot d\bigr) \;\longrightarrow\; O\bigl(M^3 \cdot l_{\text{slate}} \cdot d \;+\; B \cdot M D^3 \cdot l_{\text{item}} \cdot d\bigr) \tag{6}$$
其中 $B$ 是 beam 宽度、$d$ 是隐藏维度、$l_{\text{slate}}$ 与 $l_{\text{item}}$ 分别是规划器与物品生成器的深度。在固定总深度下,把 14 层给规划器、2 层给物品生成器提供了最佳生产折衷:相比 12:4 的切分,它把延迟降低 26%,而 NDCG@5 只相对下降 0.6%。
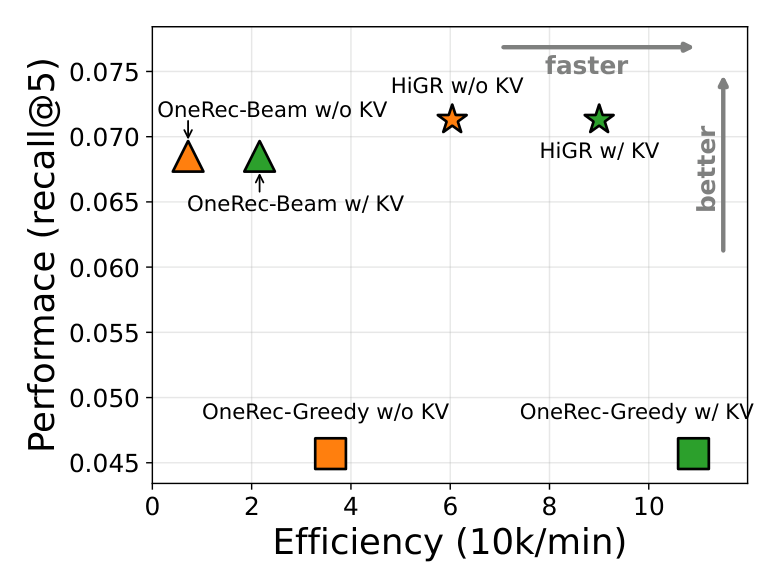
不开 KV cache 时,HiGR 相对 OneRec-Beam(OneRec 式全序列 beam 解码)取得 >5× 推理加速,同时 Recall@5 提升超过 5%;开 KV cache 后仍保持最佳质量-效率折衷。生产服务中,这套解码结构把端到端 P99 延迟压在 50 ms 以下,同时在等吞吐下相对 OneRec 式全序列自回归基线降低约 60% GPU 需求。
Beam search 优化。 作者进一步通过 FlashAttention 感知的张量布局优化局部 SID beam search。第一个 SID 层上所有 beam 共享同一个偏好嵌入,因此物品生成器只跑一次,其 top-$B$ 码字初始化各 beam,避免 $B$ 次相同的 decoder 调用。后续层上所有 beam 前缀在一次批量前向中解码,$B \times V$ 个 beam-码字候选的累积分数被拉平,每请求用一次 top-$B$ 操作剪枝。
主要的显存优化来自对同一批拉平的 decoder 状态使用两套序列布局:对因果自注意力,它们被解释为 $NB$ 条独立 beam 序列,保持 beam 之间的隔离($N$ 为请求批大小);对交叉注意力,每个请求的 $B$ 条 beam 被打包成一条 query 序列,注意一份ragged 用户历史表征。这既去掉了变长历史的 padding,更重要的是避免为每条 beam 复制一份 encoder memory。该实现保持精确的 beam search 打分,同时削减了冗余的首步计算、Python 侧 beam 迭代、以及 beam 依赖的 encoder memory 物化。
部署与线上 A/B¶
Table 14 | HiGR 在三个腾讯商业推荐场景的线上 A/B 相对提升
| 场景 | 指标与相对提升 |
|---|---|
| 场景 1(5% 实时流量) | 平均停留时长 +1.03%、平均观看时长 +1.22%、平均播放量 +1.73%、平均请求数 +1.57% |
| 场景 2 | CTR +0.68%、广告收入 +0.56% |
| 场景 3 | 平均观看时长 +1.14%、平均播放量 +0.88% |
结论分析。 场景 1 显示一致的参与度增益;场景 2 同时改善用户响应与变现;场景 3 进一步提升观看时长与播放量。三个场景的一致增益说明 HiGR 可以迁移出单一部署设定,在参与度、流量消费、商业价值三个维度上稳定改善。
TGR-Reason:推理增强的生成式推荐¶
TGR-Reason 把 LLM 导出的意图推断转成推理增强的 semantic ID(reason token),连接离线推理、记忆检索与线上生成式决策。一个用 LatentRec 训练的 Think 模型在请求路径之外生成用户的 top-$K_r$ 候选物品完整 SID。服务时这些 token 走两条互补路径:直接为 TGR-GenRec 提供语义 prompt;作为 Reasoning-Guided Group Memory Retrieval(GMR) 的查询,从 Group Memory 检索相关行为证据。检索到的群体上下文与用户的 Personal Memory(观测行为序列)结合后被生成器消费。这个设计引入零在线推理 rollout、零额外自回归决策,且瞄准的是共现证据最少的请求:冷启动、长尾、模糊意图。
动机¶
TGR-GenRec 的生成器被训练去复现反馈加权的共现。当用户历史稠密地约束了下一个物品时,它工作得很好。但它在最要紧的请求上不足:几乎没有历史的新用户、协同信号稀疏的长尾物品、意图模糊的会话。这些请求单靠共现是欠定的。
这个局限还暴露出一个记忆不平衡:用户的观测序列形成精确但不完整的 Personal Memory——它反映个体兴趣,但当历史短或模糊时就没有信息量。全人群交互序列形成远为丰富的 Group Memory,但没有意图信号就去检索它会引入热门却不相关的行为。Reason token 桥接两者:它们推断出超出可得 Personal Memory 的合理兴趣,并作为语义查询从 Group Memory 中挑选意图一致的证据,让群体行为补充而不是覆盖个体自己的历史。
两条让 LLM 推荐器推理的路线都把推理放在请求路径上。 显式推理把推理写成语言(OneRec-Think 在解码每个 SID 之前产出一段文本 CoT),可解释但每请求多吐数百个 token。Latent 推理在隐状态空间推理(ReaRec 在预测前把序列表征前滚若干步;STREAM-Rec 同样把序列推荐推向推理时的多步慢思考),去掉了 token 成本但仍在推理时跑 rollout。两种范式都把推理能力绑定在每请求计算上,工业延迟预算吸收不了。TGR-Reason 把推理彻底移出请求路径:Think 模型建立在 LatentRec 之上,通过训练时监督安装推理,并在离线流水线里周期性产出 reason token。服务时不执行任何 LLM 推理 rollout,推理成本被摊销而不是在每次曝光上支付。
方法总览¶
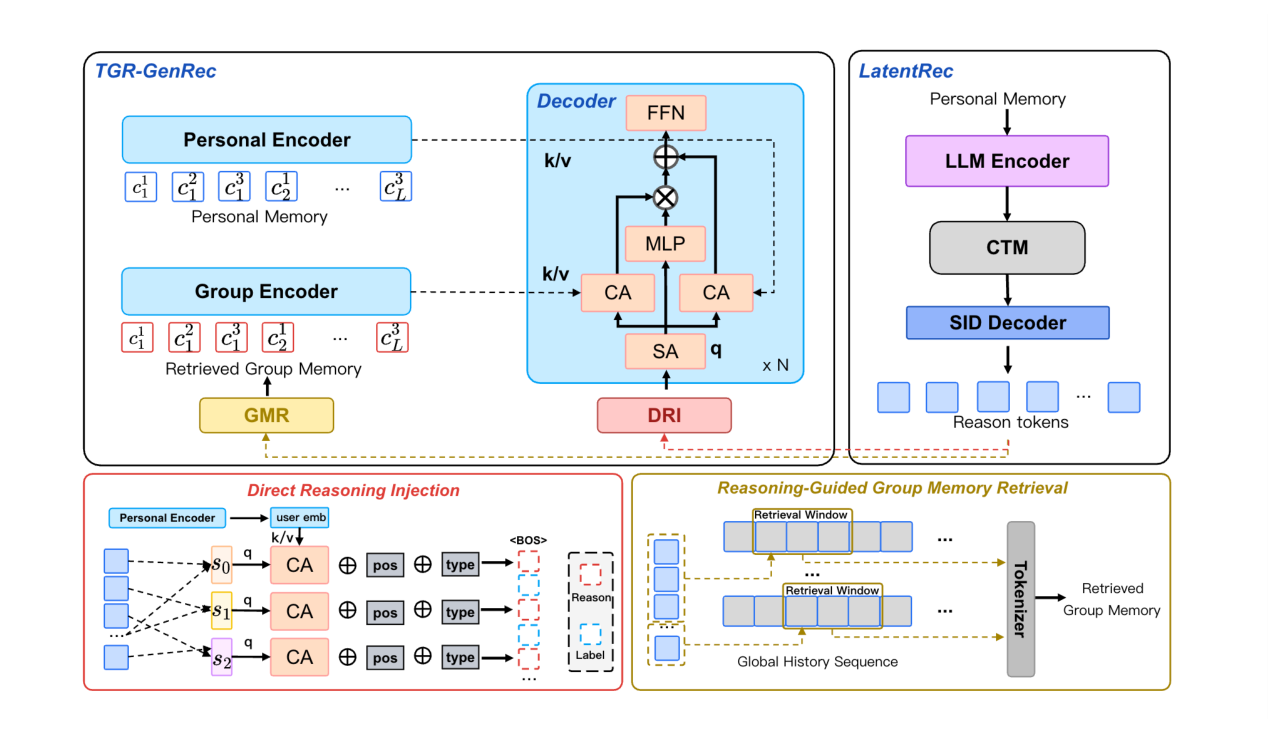
三个协作模块:TGR-Reason 在离线流水线里生成 reason token(Think 模型基于 LatentRec,逐步监督把推理装进模型参数,使部署模型能通过标准解码 pass 发出 top-$K_r$ 完整 SID,无需推理时 rollout);TGR-Memory 维护两个互补来源(Personal Memory 源自当前用户观测行为,Group Memory 索引全人群交互序列,GMR 用 reason token 查询从中挑选意图一致的协同证据);TGR-GenRec 通过两个接口消费这些信号(DRI 把 reason token 转成层级对齐的 decoder 表征,GMR 供给检索到的 Group Memory,经编码后与 Personal Memory 自适应融合)。两条路径都保持生成 SID token 的原有数量,不引入额外自回归推理步;Group Memory 的检索与编码都是有界的非自回归操作。
Reason token 作为推理-记忆的共享接口¶
Table 15 | 连接推理与生成式推荐的四种候选载体
| 载体 | 产生时机 | 请求路径成本 | 在 TGR-Reason 中的角色 |
|---|---|---|---|
| Chain-of-thought 文本 | 推理时 | 高自回归成本 | 未采用 |
| 辅助生成特征 | 离线 / 在线 | 额外特征栈 | 未使用 |
| Latent 推理状态 | 训练时 | $K=0$ 时无 | 内部监督 |
| Reason token(SID) | 离线 | 无推理 rollout | 共享接口 |
结论分析。 CoT 文本暴露推理过程但需要长自回归生成;辅助生成特征引入独立的表征与服务接口;latent 推理状态避免了文本生成,但留在模型内部,无法直接连接独立维护的推理、记忆、推荐三个模块。Reason token 则把 Think 模型的输出表达成整个 TGR Stack 通用词表里的完整 SID——这个共享表征给了每个 reason token 两个互补角色:作为推理载体,其逐层 SID 证据直接 prompt TGR-GenRec 解码;作为记忆查询,完整 SID 驱动 GMR 从 Group Memory 检索意图一致的行为。没有自然语言 rationale 跨越模块边界,线上服务也不添加 LLM 推理 rollout。
LatentRec:离线 reason token 生成¶
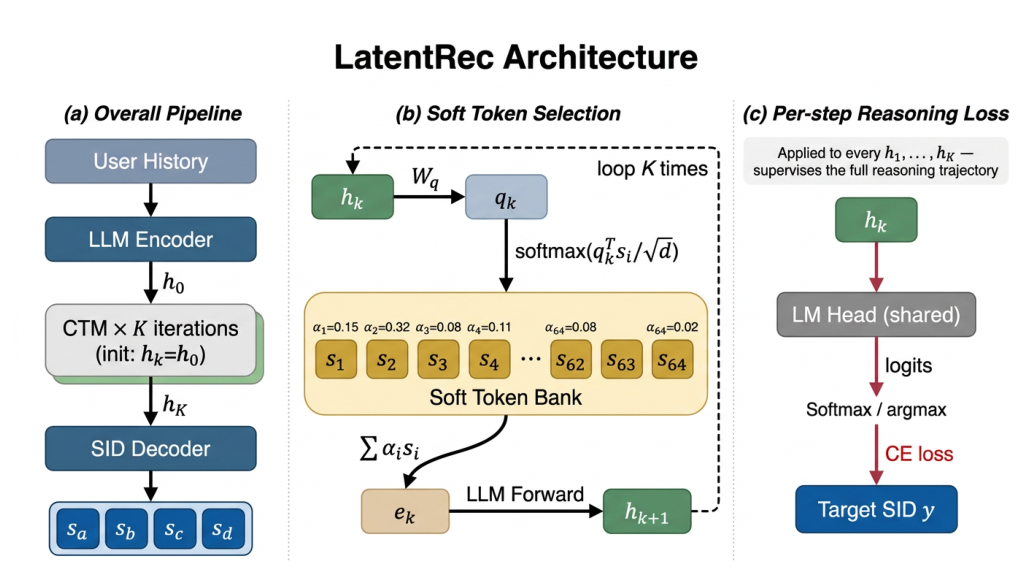
Continuous Thought Module。 从用户历史隐状态 $h_0$(历史最后一个 token 的最后一层表征)出发,展开 $K$ 步 latent 推理:
$$e_k = \phi(h_k), \qquad h_{k+1} = \mathrm{LLM}\bigl(e_k,\ \mathrm{KV}^{(k)}\bigr) \tag{7}$$
其中 $\phi$ 是下面定义的 Soft Token Selection 投影,$\mathrm{KV}^{(k)}$ 是在历史 token 与前 $k$ 个 latent 步上累积的 KV cache。每个 latent 步是一次单 token 前向,注意这个不断增长的 cache,因此复用历史计算而不重算,rollout 在训练时增加 $K$ 次这样的前向。这个递归被刻意设计得极简:它不引入任何推理专用的 Transformer 权重,唯一的可训练添加是 STS 参数,约 2.5 M、不到骨干的 0.2%。因为 rollout 在同一 KV cache 下穿过同一个骨干反馈,关掉它是精确的而非近似的:离线 reason token 生成时设 $K=0$ 完全跳过该模块,直接从 $h_0$ 解码,这就是这里的生产配置。
Soft Token Selection。 表征空间的尺度错配让朴素 latent rollout 在 SID 解码 regime 下不稳定。在 Qwen3-1.7B 骨干里,最后一层隐状态的 L2 范数约为输入 embedding 的 14 倍。把原始隐状态直接喂回作为下一个输入,会随 $K$ 增大把逐步预测推离 SID 词表;而且这里的问题比数学或逻辑的 latent 推理更尖锐,因为每个中间状态还要经预测 head 打分,必须保持可解码。STS 的解法是从不直接反馈隐状态:它维护 $N = 64$ 个从词表 embedding 初始化的可学 soft token $S$,把每个隐状态重表达成它们的凸组合:
$$\alpha_i^{(k)} = \frac{\exp\bigl(q_k^\top s_i / \sqrt{d}\bigr)}{\sum_j \exp\bigl(q_k^\top s_j / \sqrt{d}\bigr)}, \qquad e_k = \sum_i \alpha_i^{(k)} s_i \tag{8}$$
其中 $q_k = W_q h_k$。因为 $e_k$ 是词表尺度向量的凸组合,它在范数与方向两方面都留在输入 embedding 流形内——而单纯的标量缩放虽能修正范数,却会留下方向上的离流形。这保证每个投影输入都能被共享预测 head 解码,这正是同一个 head 能监督全部 $K$ 步的原因。作者强调这不是修辞:在匹配设置下,原始隐状态反馈 + 逐步 head 监督在第一个训练 epoch 内就发散,中间 logits 离开 SID 词表——因此在这个 regime 下 STS 是必要的而非锦上添花。
Per-step Reasoning Loss。 第三个组件通过共享预测 head 监督每一个中间状态 $h_k$,也是承载大部分收益的组件。它把 ReaRec 的渐进监督(原本为序列推荐 encoder 提出)适配到 LLM SID decoder regime,在一个向最后一步锐化的温度下,在每个 latent 步施加共享预测 head:
$$\mathcal{L}_{\mathrm{PRL}} = \frac{1}{K}\sum_{k=1}^{K} \mathrm{CE}\Bigl(\mathrm{LM\ head}(h_k)\,/\,T_k,\ y\Bigr), \qquad T_k = T_b + T_s\Bigl(1 - \frac{k}{K}\Bigr) \tag{9}$$
其中 $y$ 是目标 semantic ID 的第一层,$T_k$ 从第一步的松弛温度线性衰减到第 $K$ 步的 $T_b$。总目标为
$$\mathcal{L} = \mathcal{L}_{\mathrm{CE}} + \lambda\,\mathcal{L}_{\mathrm{PRL}}, \qquad \lambda = 0.1 \tag{10}$$
为什么只监督第一层 SID? 该层承载 RQ 码本里最粗的路由决策,能给中间步一个稳定的目标。监督更深层则需要在每一步 teacher-forcing 目标 SID 前缀,这会把 latent rollout 耦合到一条固定解码路径上,与推理时使用的自回归 SID 解码相冲突,所以更深层留给 $\mathcal{L}_{\mathrm{CE}}$。作者给出一个很精确的解读:PRL 本质是通过预测 head 的多步深度监督(deep supervision),这与「它的收益在 $K=0$ 时仍然存活」是一致的。
让推理可摊销的性质正是:这种监督即使在生成时用 $K=0$、模块根本不参与前向的情况下也提升准确率。收益活在被逐步监督塑形过的 LoRA adapter 里,而不是生成时的多步计算里,所以推理模块在训练后被丢弃,离线流水线退化为标准 SID 解码。CoT 蒸馏初始化是可选的:$K=0$ 时不需要,但它能稳定更深的 rollout——这把多步 latent 计算的价值放在训练时而非生产生成路径上。生产 Think 模型因此以 $K=0$ 生成 reason token。
Reason token。 每次用户刷新,Think 模型输出其 top-$K_r$ 预测物品,每个预测是一个完整的 $L$ 级 semantic ID。Think 模型还可额外导出一个概括每条预测背后推理的紧凑 embedding(Figure 12 中的 cot emb),生成器可作为辅助 soft prompt 消费;该 embedding 在离线刷新时预计算,因此请求路径仍不产生任何自然语言推理,而支撑本文结果的部署配置只依赖 semantic-ID reason token。
推理与记忆注入 TGR-GenRec¶
设 $S_u$ 为构成 Personal Memory 的历史 SID 序列,Think 模型提供 $K_r$ 个 reason token $R_u = \{r_{u,1}, \dots, r_{u,K_r}\}$,其中 $r_{u,k} = (r^1_{u,k}, \dots, r^L_{u,k})$ 是一个完整的 $L$ 级 SID。
Direct Reasoning Injection(DRI)。 DRI 把 $K_r$ 个 reason token 转成Personal-Memory 条件化的、逐层的表征供层次化 SID 解码。一个 reason token 描述一个连贯的候选物品,但其码字沿粗到细的 SID 层次扮演不同角色。DRI 因此按码本层级重组 reason token 集合,同时保留全部 $K_r$ 个候选。对第 $l$ 层,查表得到共享 SID embedding:
$$E^l_u = \bigl[e^l(r^l_{u,1}),\ \dots,\ e^l(r^l_{u,K_r})\bigr] \in \mathbb{R}^{K_r \times d} \tag{11}$$
其中 $e^l$ 是第 $l$ 个码本的 embedding 表。不加任何 rank 或候选位置 embedding:reason token 构成一个无序的证据集合而非一条推理序列。
这些推理证据的相关性取决于 Personal Memory。设 $X_u = [x_{u,1}, \dots, x_{u,N_u}]$ 为源自用户画像与历史 SID 序列的 encoder 侧上下文 embedding,$m_{u,i}$ 指示非 padding 位置,用 masked mean pooling 概括 Personal Memory:
$$q_u = \frac{\sum_{i=1}^{N_u} m_{u,i}\,x_{u,i}}{\max\bigl(1,\ \sum_{i=1}^{N_u} m_{u,i}\bigr)} \tag{12}$$
同一个 Personal-Memory query 在每个注入层级上独立地与 $K_r$ 个 reason-token 码字匹配;第 $l$ 层有自己的多头交叉注意力参数($H$ 个头,头维 $d_h$):
$$o^l_{u,h} = \mathrm{softmax}\!\left(\frac{(q_u W^l_{Q,h})(E^l_u W^l_{K,h})^\top}{\sqrt{d_h}} + A_u\right)\bigl(E^l_u W^l_{V,h}\bigr) \tag{13}$$
$$\bar z^l_u = \mathrm{Concat}_{h=1}^{H}\bigl(o^l_{u,h}\bigr) W^l_O, \qquad z^l_u = \bar z^l_u + p_0 + \tau_l \tag{14}$$
其中 $A_u$ 是 $K_r$ 个 reason token 上的加性注意力掩码(可用 SID 为 0,缺失为 $-\infty$),$p_0$ 是物品位置 embedding,$\tau_l$ 是码本层级类型 embedding。因为不使用候选顺序编码,置换 reason token 不改变 $z^l_u$。更重要的是,注意力权重以 $q_u$ 为条件:这个块学的是哪些推理候选与 Personal Memory 兼容,而不是照抄排名第一的 LLM 预测。各层独立的注意力参数进一步允许粗粒度意图码与细粒度残差码从同一个 reason-token 集合里选出不同的证据。若全部 reason token 缺失,相应的 prompt 位置会被从 decoder 中掩掉。
融合向量 $Z_u = [z^1_u, \dots, z^{L_t}_u]$ 作为连续的、层次对齐的 prompt($L_t \le L$ 为注入层数)。设 $y^l$ 为目标物品在 SID 第 $l$ 层的码字,prompt 被交错插入到对应目标码字之前:
$$\bigl[\mathrm{BOS}\ \big|\ z^1_u,\, y^1\ \big|\ \cdots\ \big|\ z^{L_t}_u,\, y^{L_t}\ \big|\ y^{L_t+1},\ \dots,\ y^{L}\bigr] \tag{15}$$
因果掩码保证 $z^l_u$ 处的 decoder 状态在不观测该目标码字的前提下预测 $y^l$;超过 $L_t$ 的层遵循标准自回归 SID 解码。同时每个 decoder 状态仍然交叉注意 Personal Memory,所以 prompt 是增广而非替换用户观测行为。beam search 期间 $Z_u$ 在解码前计算一次并被所有展开 beam 共享。因此 DRI 利用了全部 $K_r$ 个 reason token 却不在线生成它们,既不改变 SID 决策数量也不改变 beam 搜索空间。
Reasoning-Guided Group Memory Retrieval(GMR)。 Group Memory 是全人群行为序列的索引语料,每个完整 reason token 充当其上的语义检索查询。这与 DRI 互补:DRI 把 Think 模型推断的意图转进解码,GMR 则把该意图接地到「用户群体随后实际消费了什么」。设 $\mathcal{G} = \{G^{(v)}\}_v$,$G^{(v)} = [g^{(v)}_1, \dots, g^{(v)}_{T_v}]$ 是用户 $v$ 的交互序列,每个 $g^{(v)}_t$ 是完整 $L$ 级 SID。对 reason token $r_{u,k}$,token 引导的检索定位其在 Group Memory 中的出现,并汇集每次出现后紧随的 $W$ 个物品:
$$B_{u,k} = \biguplus_{(v,t):\ g^{(v)}_t = r_{u,k}} \Bigl\{\, g^{(v)}_{t+j} \ \Big|\ 1 \le j \le W,\ t + j \le T_v \Bigr\} \tag{16}$$
其中 $\biguplus$ 是多重集并,保留跨用户与序列位置的重复后继出现以便频次统计。对每个不同的后继 SID,GMR 统计其在汇集多重集里的出现次数,按频次排序,并为查询 $r_{u,k}$ 独立地保留最频繁的 $M$ 个,记为 $C_{u,k} = [c_{k,1}, \dots, c_{k,M}]$。对全部 $K_r$ 个 reason token 施加同一操作,产出 $K_r$ 条查询特定的后继列表,它们被拼接而非全局重排:
$$C_u = C_{u,1} \,\|\, \cdots \,\|\, C_{u,K_r}, \qquad |C_u| = K_r M \tag{17}$$
独立处理每个 reason token 保留了与每个推断意图关联的下游行为:前向窗口捕捉「用户在该 SID 之后倾向于消费什么」,而 per-query top-$M$ 选择保证每个 reason token 都贡献 $M$ 个频繁观测到的后继物品。
双记忆编码与自适应融合。 每个检索物品 $c_{k,m}$ 用与 Personal Memory 相同的 $L$ 级 SID tokenizer 表示。分离的 encoder 从拼接后的 $K_r M$ 个检索物品构造 Group Memory 表征,从用户观测历史构造 Personal Memory 表征:
$$H^g_u = \mathrm{Enc}_{\mathrm{group}}\bigl(\mathrm{Tok}_{\mathrm{SID}}(C_u)\bigr), \qquad H^p_u = \mathrm{Enc}_{\mathrm{personal}}\bigl(\mathrm{Tok}_{\mathrm{SID}}(S_u)\bigr) \tag{18}$$
共享 SID 空间让两种记忆语义兼容,而分离 encoder 保留了它们不同的来源:$H^p_u$ 记录当前用户的个体兴趣,$H^g_u$ 概括由 reason token 选出的人群级后继行为。在 SID 解码第 $l$ 层,自注意力状态 $d_l$ 通过分离的交叉注意力算子分别查询两种记忆:
$$a^p_l = \mathrm{CA}^p(d_l, H^p_u, H^p_u), \qquad a^g_l = \mathrm{CA}^g(d_l, H^g_u, H^g_u) \tag{19}$$
保持算子分离,防止群体证据在 decoder 有机会评估其有用性之前就被混进 Personal Memory。 一个向量值的门在每个解码层级自适应激活 Group Memory:
$$g_l = \sigma\bigl(W_g[d_l;\, a^p_l;\, a^g_l] + b_g\bigr), \qquad \tilde a_l = a^p_l + g_l \odot a^g_l \tag{20}$$
这种非对称残差形式把 Personal Memory 保持为主信号,只在群体证据与当前 decoder 状态兼容的地方激活它;噪声大或支撑弱的检索因此可以被抑制而不丢弃个体上下文。Group Memory 每请求编码一次,跨解码步与展开 beam 复用。
训练配方¶
Think 模型训练。 分三阶段共享一个骨干:词表扩展阶段先把 semantic-ID token 加进骨干,使物品成为它能发出的一等符号;内容对齐阶段把骨干适配到目标场景,调一小组可训练 token 让模型的语言接地在平台的物品与描述上;推理阶段施加 LatentRec,只训练 LoRA adapter 与 Continuous Thought Module,在 §5.2.2 的逐步推理损失下,$K_{\mathrm{train}} = 2$、损失权重 $\lambda = 0.1$、温度 $T_b = 1$、$T_s = 5$,骨干保持冻结。保持骨干冻结把推理信号约束在一个轻量 adapter 里,这正是「模块能在 $K=0$ 服务时被丢弃而不扰动已对齐骨干」的原因。CoT 蒸馏初始化位于对齐与推理之间,仅在需要更深 rollout 时使用。
Gen 模型训练。 下游 TGR-GenRec 用生产 SID 生成器同样的 NTP 目标训练。对每条训练请求,Think 模型的 top-$K_r$ reason token 被预计算并当作固定的条件化特征。teacher forcing 下生成器逐层预测目标 SID $y = (y^1, \dots, y^L)$:
$$\mathcal{L}_{\mathrm{gen}} = -\sum_{l=1}^{L} w_l \log p_\theta\bigl(y^l \mid y^{<l},\ H^p_u,\ R_u\bigr) \tag{21}$$
其中 $w_l$ 给更粗的 SID 层更大权重。梯度更新生成器与 DRI 参数,但不回传进近线 Think 模型。启用 GMR 时,其检索上下文 $C_u$ 被加进条件变量,Group Encoder 与自适应融合门通过同一 NTP 损失联合优化;GMR 本身是非参数的、不接收梯度。Gen 模型侧不引入任何额外的推理专用目标——reason token 与双记忆上下文是通过条件化标准 SID 预测任务来改善生成的。
规模化离线生成¶
把推理当成离线特征,只有在能按例行日程、在固定算力预算内为全量用户重新生成 reason token 时才实际可行。两个设计选择使其可能:双流水线刷新把 Think 模型的重训频率与其预测产出频率解耦;批量解码方案让 per-user top-$K_r$ 生成便宜地跑在未经改造的推理引擎上。
例行生产。 刷新按两条节奏跑:周级流水线端到端重训 Think 模型,让词表扩展与内容对齐持续跟踪新物品与漂移的用户兴趣,每周产出一个版本化的推理模型;日级流水线把当前模型应用于被陈旧度检测器标记需要刷新的用户,把它们的 top-$K_r$ reason token 写入生成器读取的 Reason Store。分开两条节奏让昂贵的重训保持周级、而更轻的预测 pass 保持日级,新鲜度与成本可独立调节。在固定大小的周级采样上重训(而非全量日志)把每个周期控制在预算内而不牺牲下游收益,且每个周模型都被版本化,使生成器总是消费一个完整且自洽的发布而不是部分更新的状态。
规模化离线解码。 日级 pass 是成本瓶颈——它必须为数千万用户发出 per-user top-$K_r$ semantic ID,本质是在一段短的固定长度码上做受约束的 top-$K_r$ beam search。高吞吐推理引擎(vLLM)的两条原生路径都不适配这个形状:采样路径即便加上 trie logits 过滤,也是用随机抽样替换 beam 枚举,丢失 top-$K_r$ 召回,Hit@5 明显低于参考 decoder;原生 beam search 路径保住有效性,但作为一个未优化的循环运行,解码比 eager 基线还慢,把迁移的动机(提速)本身抹掉了。这个错配是结构性的:semantic ID 是从受约束词表中抽取的短码,恰恰是引擎的吞吐机制不擅长枚举的 regime。
作者选择不改引擎,而是把 beam search 重铸成引擎调度器本来就跑得好的固定轮数的批量单 token 轮次。一个 semantic ID 跨固定数量的码本层级,所以解码在同样轮数内完成。每轮在一次批量前向中把每条存活 beam 按其 top-$B$ 下一 token 展开,再按累积对数概率剪回 $B$ 条最好的偏 SID——这与标准 beam search 是同一套确定性枚举,不是近似。连续批处理把一个周期内所有用户的 beam 打包进每次 pass,prefix caching 把长的共享用户上下文前缀只存一次,因此一轮的边际成本就是一步增量解码。SID trie 被用作最终有效性检查而非逐步回调,因为枚举出的 beam 实践中已经有效,这让快路径免于逐 token 掩码。加速完全来自引擎在这种解码日程下的批处理与 cache 复用,而非对其 kernel 或调度器的任何修改。
因为这些轮次精确复现了参考枚举,在相同 beam 宽度下该日程逐 bucket 匹配参考 decoder 的 Hit@5(cold / warm / hot 三个桶都持平或略超基线),且只发出有效 semantic ID。加速因此不付任何精度代价。 在 8 张 A100 的生产集群上,它把端到端生成周期缩短 2.2×,从 174 分钟降到 80 分钟,把一千万用户的刷新从约 2.9 天压到 1.3 天。这段余量正是日级流水线能在预算内运行、并让推理保持为「离线摊销特征」而非「每请求成本」的原因。
部署¶
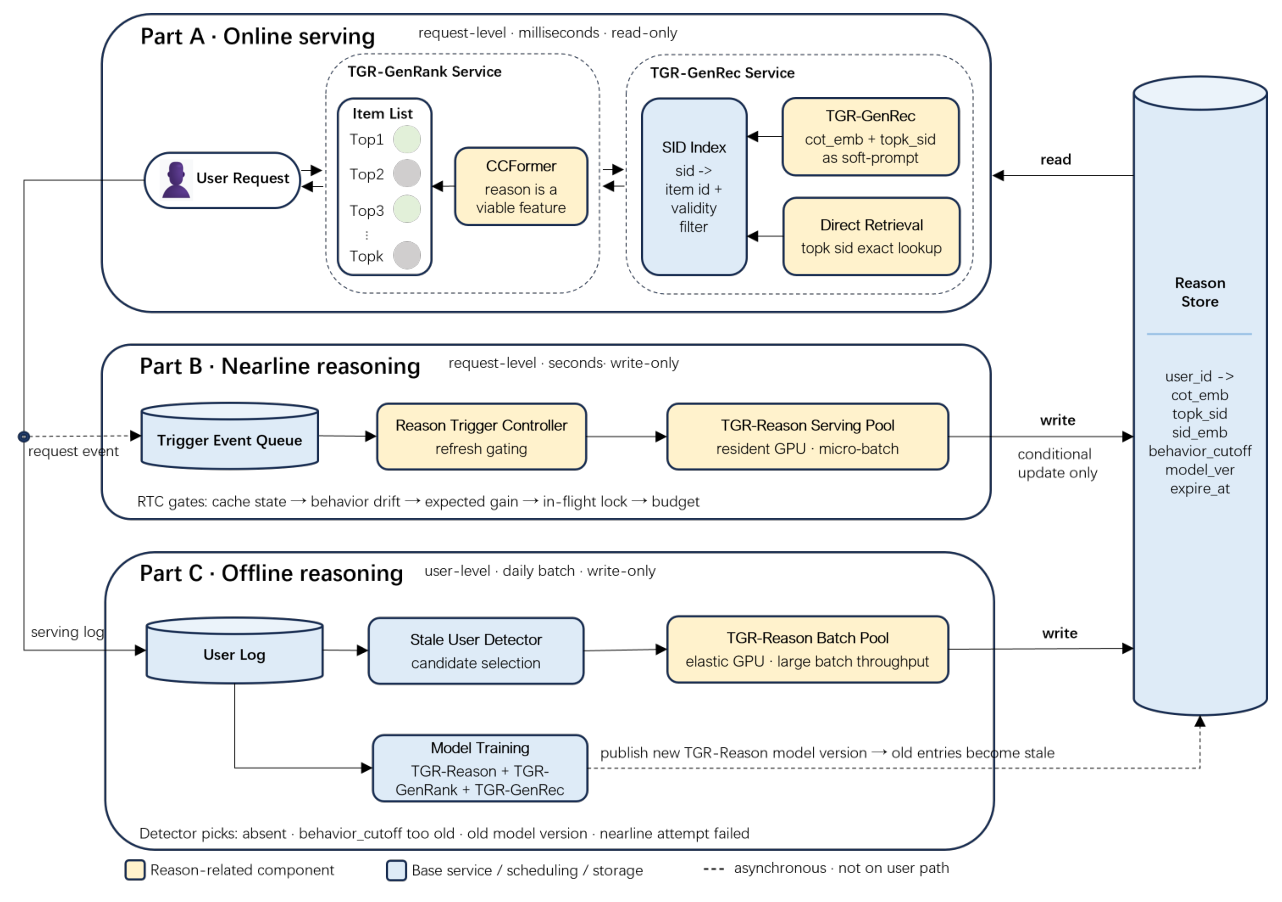
把推理移出关键路径。 Think 模型可能含数十亿参数、需要远超线上生成器的计算量,为每个请求同步运行它会带来无法承受的延迟与 GPU 成本。TGR-Reason 转而把其输出物化成可复用的用户级 Reason 记录,把 Think 模型留在同步请求路径之外。服务时线上生成器通过键值点查读取最新的有效 Reason 记录:预物化的 DRI 表征作为固定大小 soft prompt 注入 TGR-GenRec 的 decoder 侧;并行地,存储的完整 reason SID token 被 GMR 用来检索一组有界的群体级行为记忆,池化后并入 SID 解码前的上下文编码阶段。
存储的 SID 预测还额外支持一条免 decoder 的直接检索路径:topk_sid 通过 SID 索引解析得到精确物品候选,随后过滤无效、不可用、越域的物品。与条件化 TGR-GenRec 的 DRI 和 GMR 不同,直接检索直接产出候选物品、不参与自回归解码。生成的与直接检索的候选在返回下游排序阶段之前被分配独立配额。
DRI 注入、GMR 检索与池化、SID 索引查表全部是有界的非自回归操作:它们既不新增推理 token 生成也不新增 SID 解码步,因此相对原始 TGR-GenRec 服务路径,SID 解码 horizon、beam 宽度、beam 搜索空间都保持不变。额外的请求时成本仅限于 Reason Store 访问、元数据校验、固定大小特征投影、有界的 Group Memory 检索与聚合、以及 SID 解析。
三层架构。
- Part A:线上服务(请求级,毫秒延迟预算,只读)。 收到请求后取用户常规序列、画像、上下文特征,并行用用户标识在 Reason Store 做点查。一条 Reason 记录只有在存在、未过期、被部署模型与特征 schema 支持、且关联当前激活的 SID 码本版本时才算可用。记录可用时其 DRI 表征与 reason SID token 通过互补的条件化路径被 TGR-GenRec 消费,随后自回归生成 SID 列表;并行地直接检索路径对存储的
topk_sid做精确查表。Reason 特征还被排序模型复用——有效的 Reason 记录被投影成 rank 侧特征提供给 TGR-GenRank 的 CCFormer,补充常规用户、物品、上下文特征。因此同一份物化的 Reason 记录同时改善候选生成与下游排序,而无需任何同步的 Think 模型推理。Reason Store 未命中或记录无效永不阻塞请求:TGR-GenRec 回退到原始无 Reason 生成路径,直接检索路径被跳过且其配额由基线候选源填补,TGR-GenRank 使用基础 CCFormer 特征集——线上推荐服务的可用性不依赖 Think 模型的成功执行。 - Part B:请求触发的近线刷新。 每个进来的请求可以异步发出一个轻量触发事件(user_id、请求时间、场景标识)进入触发事件队列,采用 fire-and-forget 模式,与在线候选生成路径并行;当前请求既不等待也不消费新生成的 Reason 记录。Reason Trigger Controller(RTC) 消费这些事件并判断重算该用户 Reason 记录是否值回推理成本,其准入策略联合考虑:(1) 兼容的 Reason 记录是否缺失或接近过期;(2) 自上次行为截止点以来用户行为的变化程度;(3) 对当前用户或用户分群的期望边际推荐收益;(4) 用户级冷却与 single-flight 约束;(5) 当前推理预算、队列积压、GPU 容量。只有被准入的作业才提交给常驻 GPU 的 TGR-Reason 服务池,该池用动态 micro-batching 提升利用率同时维持秒级新鲜度,输出经校验后条件写回 Reason Store,刷新后的记录对后续请求可见而不追溯影响触发它的那次请求。
- Part C:离线回填与模型更新。 离线层在用户粒度上运行、以吞吐而非单作业延迟为先。一个定时的陈旧用户检测器扫描用户日志与 Reason Store 元数据,识别:无物化 Reason 记录的用户;行为已越过存储行为截止点的用户;过期或低质量记录;失败或跳过的近线刷新;由过时 Think 模型、prompt、特征或 SID 码本版本产出的记录。被选中的用户交给弹性大批量推理池处理,通过与近线层相同的条件更新接口写回重新生成的记录。部署中该回填每日执行,而模型重训与 checkpoint 发布走更低频的日程(如每周)。发布新模型版本会把不兼容的 Reason 记录标记为陈旧,并通过近线与离线刷新机制触发其渐进重建。
存储一致性与失效隔离。 Reason Store 是一个分布式键值抽象,后端是腾讯云上的托管 KV 服务,而非绑定某个特定存储引擎。每条记录以用户标识为键(可选地附加推荐场景与实验分桶),内容为:
$$\{\texttt{cot\_emb},\ \texttt{topk\_sid},\ \texttt{sid\_emb},\ \texttt{behavior\_cutoff},\ \texttt{generated\_at},\ \texttt{model\_version},\ \texttt{sid\_codebook\_version},\ \texttt{expire\_at}\} \tag{22}$$
底层托管服务提供低延迟点查、TTL 过期、原子条件更新语义。
条件更新这一段是很有价值的工程细节:近线与离线作业可能乱序完成。例如一个基于「观测到 18:00 行为」的离线作业,可能在一个基于「观测到 20:00 行为」的近线作业之后完成。若只比较 generated_at,就会错误地允许「后完成但语义上更旧」的记录覆盖更新鲜的那条。TGR-Reason 因此只接受与激活模型和特征版本兼容的记录;在同一版本内,进来的记录只有在其 behavior_cutoff 更新时才能替换已存记录。generated_at 被保留用于监控与审计,但不作为主要的新鲜度序。这个版本感知的条件写策略防止了陈旧的离线作业覆盖更新的近线结果。
失效隔离被刻意设计成三层分离:触发队列、RTC 或近线服务池的故障只降低 Reason 新鲜度;离线批处理池的故障只延迟覆盖率恢复;两种故障模式都不中断线上请求路径,后者可以继续使用最近的兼容 Reason 记录或回退到无 Reason 的 TGR-GenRec。这种分离让系统能够在推理新鲜度与推理预算之间做权衡,而不把大模型的可用性与线上推荐的可用性/尾延迟耦合起来。
评估结果¶
Table 16 | reason token 注入 vs 线上 TGR-GenRec 基线的离线对比(腾讯某商业内容平台)。结果在三个测试日上等权平均,使用部署默认配置(Personal Encoder + Direct Reasoning Injection),GMR 分支被排除
| Cohort | Model | Hit@1 | Hit@5 | Hit@10 | Hit@20 | Hit@50 |
|---|---|---|---|---|---|---|
| 全部推荐流量 | TGR-GenRec(线上) | 0.3385 | 0.5152 | 0.5792 | 0.6377 | 0.7063 |
| TGR-Reason | 0.4339 | 0.5686 | 0.6155 | 0.6635 | 0.7233 | |
| 相对增益 | +28.2% | +10.4% | +6.3% | +4.1% | +2.4% | |
| 主推荐流量 | TGR-GenRec(线上) | 0.2247 | 0.4306 | 0.5116 | 0.5859 | 0.6671 |
| TGR-Reason | 0.3563 | 0.4870 | 0.5461 | 0.6085 | 0.6847 | |
| 相对增益 | +58.6% | +13.1% | +6.7% | +3.9% | +2.6% | |
| 主推荐-冷启动 | TGR-GenRec(线上) | 0.0451 | 0.3379 | 0.4551 | 0.5570 | 0.6949 |
| TGR-Reason | 0.2606 | 0.4702 | 0.5684 | 0.6687 | 0.7753 | |
| 相对增益 | +477.8% | +39.2% | +24.9% | +20.1% | +11.6% |
结论分析。 TGR-Reason 在每个 cohort 的每个截断上都有提升,说明推理信号不只对排名第一的预测有用,而是贯穿整个检索候选集。提升在列表头部最强:全部推荐流量上 Hit@1 从 0.3385 涨到 0.4339(+28.2%),而 Hit@5 与 Hit@50 分别只涨 10.4% 与 2.4%。把评估限制在主推荐流量把 Hit@1 增益抬到 58.6%。冷启动用户增益最大:Hit@1 从 0.0451 到 0.2606,绝对增益 0.2155、相对 +477.8%(注意这个惊人的相对数来自极低的基线 0.0451——绝对提升 0.2155 才是更诚实的量级表述)。这个模式支持 TGR-Reason 的核心动机:当行为历史稀疏时,共现驱动的生成器几乎没有证据来解析意图,而推理增强的 token 提供了一个缩小目标空间的语义先验;随着用户历史与候选集宽度增加,协同证据恢复,该先验的边际贡献自然变小。
Table 17 | TGR-Reason 在同一腾讯商业内容平台的线上 A/B 结果(相对在位生产生成器)
| Metric | 相对提升 | 显著性 |
|---|---|---|
| Effective Consumption Rate | +1.75% | 显著 |
| Exposure-to-Conversion Rate(新用户) | +13.09% | 显著 |
结论分析。 第一项结果说明离线增益转化成了「更多曝光产生有意义的内容消费」,而不仅仅是提高了候选召回。显著更大的新用户转化提升也与离线 cohort 分析一致:推理增强 SID 恰恰在个人交互历史最不具信息量的地方提供了有用的语义证据。合起来,线上结果确认 Table 16 的冷启动改善穿过了完整的生产级联并产出可度量的用户价值增益。
默认配置汇总¶
Table 19 | 三个生产模型与 TGR-Reason 的默认配置
| 模块 | 关键配置 |
|---|---|
| CCFormer | $d=256$;8 个交互块;子空间组 $(m,n)=(8,16)$;压缩 kernel/stride $(k,s)=(3,2)$;Adam / $10^{-4}$ / batch 4096;行为序列长度 1000(工业)、200(公开)、500–2000(scaling);16× H20;BF16/FP16 + INT8(~70%)+ double hashing(~50%);TPE 超参搜索应用于每个被比较方法 |
| BARGE | SID 深度 $L=4$,码本 $(512,256,128,64)$ 全部学习;OSQ-VAE(Householder 旋转 $R$、双通道);encoder / decoder 塔各 2 层 4 头(共享 encoder、双 decoder);embedding/attention/FFN 维度 128/512/1024;Adam + warmup / batch 256 / 200 epoch(早停、3 seed);beam $B=20$、HPR 池 $N=400$、融合权重 $\lambda=0.25$;OR-fusion 用 LSE;2× H20 |
| HiGR | $d_{\text{model}}=512$ / $d_{\text{FFN}}=2048$;SID 深度 $D=3$、每层码本 1024;规划器/生成器深度 $l_{\text{slate}}=14$ / $l_{\text{item}}=2$;PCRQ-VAE $\eta=0.1,\lambda_1=0.1,\lambda_2=0.01,(w_1,w_2)=(1,0.1)$;ORPO 系数 $\alpha=0.1$;10 亿预训练样本、3% 用于 ORPO 后训练;部署研究 25M/100M,scaling 0.05B–2B;H20 训练、L20 服务开 KV cache |
| TGR-Reason | Think 骨干 Qwen3-1.7B + LoRA(推理阶段骨干冻结);$K_{\text{train}}=2$、服务 $K=0$;PRL $\lambda=0.1$、$T_b=1$、$T_s=5$;soft token $N=64$(~2.5M 可训练 STS 参数);离线解码在 8× A100 上用 vLLM 批量轮次,周期加速 2.2× |
核心贡献总结¶
- 一个已在生产部署的生成式推荐全栈(TGR),横跨三条耦合方向(TGR-GenRank / TGR-GenRec / TGR-Reason),在共同的生产纪律下运行,semantic-ID tokenizer 家族、用户/上下文编码器、后训练流水线跨生成式推荐模型共享;服务腾讯多个界面上的数亿用户。
- CCFormer 的详细技术描述——特征域分离交叉注意力、长序列子空间 token 混合、分层序列压缩——重点放在工业训练与服务配方(混合精度、INT8 + double hashing 稀疏参数压缩、Numerous-Torch 上的单次并行候选打分),跨 5 个生产场景验证,2 个全量上线。
- TGR-GenRec 的详细技术描述,每个生成范式一个生产模型:BARGE(ICA + HPR + 双路解码,结构性适配 NTP SID 生成)与 HiGR(PCRQ-VAE + HSD + ORPO listwise 对齐,实现整版生成),并给出两者的离线与线上结果。
- TGR-Reason 的设计与部署:一个 LatentRec 训练的离线 Think 模型在训练时摊销推理,导出推理增强的 semantic-ID 先验(reason token),以零请求路径推理成本注入生产生成器。
最值得借鉴的三个设计判断:
- 「目标 token 只作 query、彼此不互相注意」→ 单次前向打分全部候选。这是一个纯粹的架构约束换来的部署红利(+30% 峰值 QPS,尽管单样本算力高 20 倍),是把「学术上更强的模型」变成「工业上能上线的模型」的典型手法。
- 把「beam 宽度、参数量、服务延迟不得增加」当成硬约束写进方法设计(BARGE),而不是事后做工程妥协。ICA/HPR/DPD 三个模块加起来还比 TIGER 小,正是因为设计时就用 2 层 encoder 换掉 4 层来腾预算。
- 推理的成本可以被移到训练时(LatentRec PRL 的收益在 $K=0$ 时仍存活),而不只是移到离线批处理。这是 TGR-Reason 相对「离线预计算 CoT」的真正区别——后者只是把成本换了个地方付,前者是把成本换成了参数。
与已归档相关工作的对比¶
OGR OGR: Once Generated, Ranked(快手,2026-08-18)¶
关系:独立并发(本文未引用 OGR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把「级联式 slate 构造」定为结构性瓶颈,而且给出的 root cause 几乎逐条对应。HiGR 的 D1/D2/D3 是「纠缠的 SID 空间 / $M\times D$ token 解码太慢 / token 级似然不优化列表质量」;OGR 的诊断是「优化范围被候选空间锁死 + 各阶段目标错配("Generated, Then Ranked")」外加对生成式方案本身的两条批评「SID 缺乏推荐感知语义与局部共现结构」「NTP 与 slate 级优化错配」。OGR 还把后一条具象成一个解码困境:自回归逐 item 生成能捕捉跨物品依赖但串行延迟 + 误差累积,而按概率一次取 Top-5 虽高效却没有 listwise 对齐——实测 OneRec 的 Hit Rate / Recall 很强而 NDCG 反输给 PRM / Seq2Slate 这类 listwise 重排器。这与 HiGR「HiGR-25M w/o ORPO 已经全面超过 OneRec-25M、ORPO 再进一步」的隔离实验指向同一件事。
- 相近的技术骨架:两者的方法流程图可以抽象重合成同一张——tokenizer 端把协同结构塞进 SID 前缀 → decoder 端把「整版规划」与「逐物品 SID 解码」拆成粗/细两级 → 训练端加一个 slate 级偏好对齐目标。逐级对照:(a) tokenizer,HiGR 用 PCRQ-VAE 的前缀对比目标把前 $D-1$ 层拉近、显式排除叶层以保住物品身份(扩展到叶层会把碰撞从 2.37% 抬到 8.73%),OGR 用 TUSID 在量化之前注入 Signed CountSketch 压缩的距离加权局部共现,并用 distinct-user 支持度做置信度加权、保范数拼接;(b) decoder,HiGR 的 HSD 是「$M$ 步偏好嵌入规划器 + 共享短 SID 物品生成器」,OGR 的 GL2P 是「list-wise 偏好规划器逐展位产出连续偏好向量 $p_m$ + 位置级 SID 解码器」——连中间变量的语义都一样:一个 slate 位置一个连续偏好嵌入;(c) 对齐,HiGR 用免参考模型的 ORPO 在排序保真度/真实兴趣/多样性三目标上做 listwise 偏好优化,OGR 用 SPA 的主/辅奖励符号一致性门控校准 + clip+KL+监督回放的保守策略优化。
- 本文的差异与推进:HiGR 把规划器与生成器串成「greedy 规划 + 短序列 beam」并按 14:2 的深度分配把延迟再压 26%(NDCG@5 只降 0.6%),OGR 则把规划与解码在时间上流水线重叠($p_m$ 一就绪解码器就开工、规划器同时推进到 $m+1$),把串行深度从 $O(KD)$ 压到 $O(K+D)$。两条路线攻击的是同一个 $M\times D$ 成本,但一个靠结构分解 + 深度分配,一个靠时间重叠。对齐侧的差异更本质:HiGR 选了免 reference model 的 ORPO(把偏好优化折进有监督学习),OGR 选了带 KL 与监督回放的保守策略优化——前者更省一个模型、更好上线,后者对奖励设计的表达力更强。另外 OGR 有一个 HiGR 没有的轻量设计值得记:同一个目标 slate 构造曝光序列与反馈重排序列两条监督($\mathcal{L}_{\text{sup}} = \mathcal{L}^{\text{eps}}_{\text{sid}} + \alpha \mathcal{L}^{\text{fb}}_{\text{sid}}$,$\alpha = 0.3$),用同一批数据把「系统展示了什么」与「用户喜欢什么」拆开供给。
- 可比的方法 / 实验差异:两者都在 KuaiRec 上评估且都用了 Impression / Effective-View 双口径加 NDCG@5,但协议不同不可直接比数(HiGR 用 leave-five-out slate 协议,OneRec-25M 基线 NDCG@5 = 0.1496;OGR 的 OneRec 基线 NDCG@5 = 0.0949)。可比的是相对幅度:HiGR-25M 相对 OneRec-25M 在 KuaiRec NDCG@5 上 +5.2%、工业集上 +21.2%;OGR 相对最强 baseline PRM 在 KuaiRec NDCG@5 上 +27.2%、工业集 +48.2%。效率上 HiGR 报 >5× 于 OneRec-Beam(无 KV cache)、生产 P99 < 50 ms、GPU 需求 −60%;OGR 报 2.43×/2.49× 于 TIGER-Beam/OneRec-Beam。线上,HiGR 在三个腾讯场景拿到最高 +1.22% 观看时长 / +1.73% 播放量(5% 流量),OGR 在快手 3% 流量拿到有效播放 +1.120%、评论 +2.954%。两者的量级高度一致,进一步说明「整版生成」这条路线的工业收益是可复现的,而不是某一家的场景红利。
SONA SONA: Yandex Music 的单模型生成式推荐器(Yandex,2026-08-11)¶
关系:独立并发(本文未引用 SONA / Gryphon 谱系)· 已加载对方精读
- 共同关注的问题:两篇都直指「多阶段级联 + 各自优化的模型」这一根因。SONA 面对的是 Yandex Music 生产级联里的 15 个以上候选生成器加上消费数百个特征的粗排与精排;TGR 面对的是腾讯 PCG 跨新闻/短视频/长视频/音乐/网文的召回-粗排-精排-重排。两者也共享第二个 root cause:长历史在延迟预算下的二次注意力成本——TGR 用 §3.1 的「三族排序器」框住它,SONA 直接写「注意力代价随历史长度二次增长,长历史在服务延迟预算下的可负担性是工业用户模型的老问题」。
- 相近的技术骨架:最锋利的重合在长序列的深度分配上。CCFormer 的分层序列压缩是「每块之后用 stride 卷积把序列几何缩短交给下一块,浅层看细粒度短期模式、深层在全历史上抽长期偏好,全序列访问被保留」;SONA 的 History Compression 是「把 8192 个事件切成最近 2048 的 recent block 与前面的 long-term block,两个单层 cross-attention 让两块互读,一层 self-attention 做唯一一次跨全历史混合,然后把承载绝大部分容量的 7 层深栈只跑在 recent block 上,最后拼接读出」。两者的核心论断一字不差:省下来的成本来自「容量花在哪里」,而不是「丢弃历史」——CCFormer 明写「without retrieving or truncating the sequence in advance」,SONA 明写「节省来自容量花在哪里,而非丢弃历史」。第二处重合在生成之后的重打分:BARGE 的 HPR 用双塔打分器评估 $h_0$ 与累积路径嵌入的兼容性、以权重 $\lambda$ 与生成对数概率融合来对抗 beam 只按累积 token 对数概率排序的缺陷;SONA 的 Ranking Module 则复用 decoder 所 attend 的同一份 encoder memory $K$ 给 SID 展开后的候选打分,解决的是同一个病灶——beam likelihood 不是好的最终排序信号。
- 本文的差异与推进:边界划得完全不同,而且 TGR 自己承认了。 SONA 是一个模型:一次编码的用户表征同时喂 decoder 与 Ranking Module,不用任何手工特征,端到端替掉整条级联(Experiment 4 里蒸馏模型单独替掉整条级联,Experiment 5 的完整 SONA 在 My Vibe 上拿到活跃用户 +4.53%、总收听时长 +6.30%、Likes +11.42%)。TGR 则严格遵守 P1「一块一块地替换级联」:CCFormer 是级联内部的 drop-in 排序器、仍然消费生产特征空间并吐逐物品多任务分数;BARGE 是一条召回通道,其 50 条 SID 各检索 10 个物品得到约 480 个去重候选后,仍然交给既有的粗排、精排、混排、过滤、业务规则;只有 HiGR 才被标为「召回 / 召回+排序」。TGR 的 Limitations 第一条就写着「A stack of coupled models, not yet one model」,还坦承 TGR-GenRec 目前跑着两个 tokenizer(BARGE 的 OSQ-VAE 与 HiGR 的 PCRQ-VAE)。所以这不是「谁做得更彻底」的问题,而是两种明确表述过的、可辩护的策略选择:SONA 赌的是单一模型 + 单一表征的端到端收益,TGR 赌的是「每一块都必须从第一天起就以生产质量替换在位模块」的风险可控性。SONA 的场景条件也支持它的激进——音乐域候选库与消费模式远比腾讯 PCG 的跨模态组合同质。
- 可比的方法 / 实验差异:两者的重打分设计在成本归属上分道扬镳。SONA 的 Ranking Module 不引入第二次 encoder 前向(复用同一份 $K$),把排序成本压到近似为零;BARGE 的 HPR 则把上下文侧表征在所有候选路径间共享、只付一个轻量的逐层双塔打分,同样几乎免费——两者独立收敛到了「重打分必须复用已有编码」这条工业约束。差异在于 SONA 把最终物品选择留在模型内(SID 元组展开成整个碰撞类交由 Ranking Module 排序),而 BARGE 把它交还给下游级联(SID token embedding 求和 → ANN 检索 → 下游粗精排)。另一处对照:SONA 依赖一个训练期存在的 Teacher Ranker(8000 事件上下文、无手工特征、ARGUS 式自回归训练)做 Rollout Distillation,把一整年历史压进权重再蒸馏进只用数周窗口训练的服务模型;TGR 完全没有这条「用大 teacher 摊销长历史」的路径,它的长历史能力全部来自 CCFormer 的架构设计。
AIR AIR: Atomic Intent Reasoning(香港理工大学 / 快手,2026-06-09)¶
关系:独立并发(本文未引用 AIR)· 已加载对方精读
- 共同关注的问题:两篇的第一句诊断可以互换。AIR 写「在线 LLM 推理在毫秒级延迟约束下代价高得不可接受;而周期性的离线用户画像更新又跟不上快速演化的用户兴趣,损害推荐时效性」;TGR-Reason 写「现有做法把推理执行在每次请求或每次刷新上——无论是 CoT 文本还是多步 latent rollout——这个代价工业延迟预算吸收不了,而离线预计算只是把它挪了位置」。两者还共享第二条:原始行为序列又长又脏,对某个目标真正有证据价值的只是一小部分——AIR 明写这一条,TGR-Reason 则表达为「没有意图信号就去检索 Group Memory 会引入热门却不相关的行为」。
- 相近的技术骨架:抽象成一张流程图完全重合——离线让 LLM 把用户行为蒸馏成可复用的结构化语义制品 → 写进高吞吐知识库 / 存储 → 在线只做轻量检索 + 注意力融合,请求路径上零 LLM 调用。逐级对照:(a) 离线制品,AIR 是「原子行为-意图对」$\mathcal{P}(e) = \{p_1,\dots,p_m\}$,每条是一条粗到细的层级意图路径;TGR-Reason 是 top-$K_r$ 条完整 $L$ 级 semantic ID(reason token);(b) 在线检索,AIR 把缓存的原子意图聚合成实时统一意图树、按目标 item 做 target-aware 语义检索得到一条紧凑意图链;TGR-Reason 用 reason token 作查询在 Group Memory 上做 token 引导的后继检索(前向窗口 $W$、per-query top-$M$、拼接而非全局重排);(c) 融合,AIR 用 MHA 以目标 item embedding 为 query 融合检索到的意图链 token 送入下游 CTR/排序塔;TGR-Reason 用逐层多头交叉注意力(以 Personal Memory 的 masked mean pooling $q_u$ 为 query)产出层次对齐的 soft prompt,再用向量门 $g_l$ 做非对称残差融合 $\tilde a_l = a^p_l + g_l \odot a^g_l$。连「不能让检索到的群体/外部证据盖过个体信号」这条设计戒律都一样——AIR 靠时间衰减与置信度加权,TGR-Reason 靠「保持 CA 算子分离 + 非对称残差门」。
- 本文的差异与推进:三点实质推进。第一,制品的表示空间:AIR 的意图路径是自然语言类目,必须通过一套独立的 embedding 与检索接口才能接进推荐模型;TGR-Reason 的 reason token 是整个栈通用词表里的 SID,所以「没有自然语言 rationale 跨越模块边界」,注入时零表征转换——这正是 P2「跨栈共享结构」的兑现,也是 TGR-Reason 能同时喂给 TGR-GenRec 的 decoder 与 TGR-GenRank 的 CCFormer 的原因(同一份 Reason 记录被投影成 rank 侧特征)。第二,推理被摊销的位置更深一层:AIR 把 LLM 调用移到离线,但推理本身仍然是一次完整的 LLM 前向;TGR-Reason 的 LatentRec 把多步 latent 推理的收益压进 LoRA adapter,使得离线生成时也只跑 $K=0$ 的普通 SID 解码 pass——推理成本从「移到离线」进一步变成「换成了参数」。第三,新鲜度工程:AIR 靠「实时用组装意图树」保证时效;TGR-Reason 给出了一套更完整的三层机制(RTC 按预期收益/冷却/预算准入的近线秒级刷新 + 每日离线回填 + 版本感知的条件写,用
behavior_cutoff而非generated_at作为主要新鲜度序来防止乱序覆盖),并显式做了失效隔离——三层任一挂掉都不阻塞线上请求。 - 可比的方法 / 实验差异:两者的效率与效果口径不同但可对照。AIR 报相对实时 LLM 调用约 400× 吞吐增益、快手电商线上 GMV +3.446%;TGR-Reason 报离线生成周期 2.2×(8× A100 上 174→80 分钟,一千万用户刷新 2.9 天→1.3 天)、线上 Effective Consumption Rate +1.75%、新用户 Exposure-to-Conversion +13.09%。注意 400× 与 2.2× 不是同一个量的比较:AIR 的 400× 是「离线缓存 vs 在线 LLM 调用」的架构级差,TGR-Reason 的 2.2× 是已经在离线之后、把 vLLM 的原生 beam search 换成固定轮数批量单 token 轮次带来的工程增益(且精确复现参考枚举,逐 bucket 匹配 Hit@5,零精度代价)。效果侧,两者都在「协同证据最稀薄」的地方拿到最大收益:AIR 主打跨域冷启(内容侧行为 → 电商侧转化),TGR-Reason 主打新用户冷启(Hit@1 从 0.0451 到 0.2606)。
被剔除的近似候选(记录理由,防止门槛放水):
- TransRetrieval TransRetrieval(阿里,2026-08-26):问题上确实与 TGR 的挑战 (i) 部分重叠(召回/排序阶段的 scaling 被结构性因素卡住),且路线立场对立(坚持判别式召回、反对生成式也反对双塔)。但解法骨架完全不同——它的核心是「用加权平均替代加权求和的字段聚合,消除基数驱动的 token 范数发散」,与 TGR 的「统一 tokenize + 有向跨域注意力 + SID 生成 + 离线推理」没有任何可抽象重合的流程。而且 TGR 本身并不是「反判别式」的:CCFormer 就是一个判别式排序器,两者的诊断并不互斥,只是作用在不同阶段的不同机制上。不构成问题+解法双同构,剔除。
- TM20K TM20K(字节,2026-08-07):与 CCFormer 共享「超长行为序列的效果-效率冲突」这一问题,但解法方向相反——TM20K 先用注意力分布证据论证「必须用 full attention 而非 target attention」,然后用教师缓存 20K 全量 token logits + 学生零参数 merge 压到 1.8K;CCFormer 则在构造上就避免全局自注意力(子空间 token 混合 + 分层卷积压缩),并在消融里明确得出「昂贵的全局注意力是不必要的」(换成 self-attn 只买到 +0.02 AUC 却丢 0.15 GAUC、速度掉到 1.41×)。一方是蒸馏 + 离线压缩,一方是端到端架构分解。属于 skill 明示的典型反例(「都在长序列建模方向但路径不同」),剔除。
- UniGD UniGD(快手,2026-08-04):问题上确实是「把生成与判别放进一个模型」,与 TGR 的统一叙事沾边。但其方法核心是 CAGE 的梯度冲突协调(余弦冲突检测 + 判别梯度的正交投影 + 生成优先的自适应加权),解决的是同一骨干内两个目标打架;TGR 从不让两者共享一个训练目标——CCFormer 与 BARGE/HiGR 是分别部署的模型,只共享 tokenizer 与编码接口,栈内根本不存在 UniGD 要解的那个梯度冲突。解法骨架不重合,剔除。
- GenPage GenPage(Netflix,2026-06-30):与 HiGR 在「整页/整版作为生成单位」上高度同构,是本次最接近入选的落选者。剔除理由是同轴冗余——OGR 在解法骨架上与 HiGR 的重合度严格更高(都有「per-position 连续偏好嵌入 + 细粒度 SID 解码」这一中间层,GenPage 是单个 decoder-only 直接自回归整页结构),保留 OGR 已覆盖该轴,且 ≤3 篇的名额有限。
- UniPinRec UniPinRec(Pinterest,2026-05-29)/ UniR2 UniR2(快手)/ UniSGR UniSGR(阿里 Lazada):三者与 SONA 同属「统一召回+排序进单一骨干」家族,问题同构。剔除理由同样是同轴冗余,且 SONA 是这条轴上时间最近、替换范围最彻底(15+ 召回器 + 粗排 + 精排)、且与 CCFormer 在长历史深度分配上另有一层机制级重合的极点,保留 SONA 一篇即可。
- DIRECTOR DIRECTOR(快手 / 中科大,2026-07-29):同样攻击 slate 自回归解码成本,但它彻底放弃自回归规划——一次性并行生成 $n$ 个连续动态检索索引再用熵正则的容量约束最优传输做全局硬分配;HiGR/OGR 的规划器都是自回归的,且 DIRECTOR 没有 tokenizer 与列表级对齐目标的协同设计。解法骨架分叉,剔除。
另需说明的同源关系(非独立并发,故不进本章节):本报告的 CCFormer(CCFormer)与 BARGE(BARGE)本身就是归档里已精读的两篇论文,作者同为腾讯 PCG,本报告是把它们与尚未单独归档的 HiGR(arXiv:2512.24787)以及 TGR-Reason 串成一个栈的总技术报告。因此三者之间是「同源上位/下位」关系而非殊途同归,对比价值由 Step 4 的 DAG 结构化系统迭代边承载。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
这是一篇证据密度极高的工业技术报告:四个子系统全部有生产流量的线上 A/B,其中两个有全量上线记录,服务数亿用户。相比很多「一个模型 + 一次 A/B」的工业论文,TGR 的价值在于它把四种不同的替换策略并排放在同一份纪律(P1/P2/P3)下做对照:drop-in 排序器(CCFormer,5 场景 A/B、2 场景全量)、独立召回通道(BARGE,6% 流量 + 全量 + 长期 holdback)、整版生成(HiGR,3 场景 A/B)、离线摊销推理(TGR-Reason,离线 + 线上 A/B)。这种「同一家公司、同一套基础设施、四种边界」的横向证据在文献里很少见。
几处特别值得记的设计判断已在「核心贡献总结」列出,此外还有三处:
- BARGE 全量后收益反而变大的观察与解释(训练-服务分布错配的渐进消解 + 长期 holdback 捕捉累积系统效应 + 更大窗口降低方差)。这是一个很多团队会遇到但很少写进论文的现象——小流量实验会系统性低估引入长尾物品的召回通道的价值,因为下游模型没见过这些物品的曝光反馈。
behavior_cutoff而非generated_at作为新鲜度主序。近线与离线作业乱序完成时,只比生成时间会让「后完成但语义更旧」的记录覆盖更新的结果。这是一个很小但很容易在生产中踩的坑,作者把它写进了论文。- 把 vLLM 的 beam search 重铸成固定轮数的批量单 token 轮次,而不是改引擎。作者明确诊断了错配的结构性原因(semantic ID 是从受约束词表抽取的短码,恰恰是引擎吞吐机制不擅长枚举的 regime),并证明重铸后的枚举与标准 beam search 逐 bucket 等价、零精度代价。这套「不改基础设施、改用法」的做法可直接复用到任何 SID 解码的离线批处理。
局限与争议¶
作者自己列出的四条局限都很诚实:(1) 还是一个耦合模型栈而非一个模型——TGR-GenRank 仍吐逐物品多任务分数供下游级联消费,TGR-GenRec 目前跑两个 tokenizer(OSQ-VAE / PCRQ-VAE);(2) 冷启动物品——层次化 SID 空间继承了向量量化 tokenizer 的冷启限制,全新物品只能靠语义证据进入码空间,而塑造 SID 前缀的协同关系还无法为它估计,TGR-Reason 展示的冷启收益是新用户而非新物品;(3) 全局对齐权衡——ORPO 把三个目标压在单一全局权重下,跨用户跨上下文一致,个性化或上下文条件化的三目标加权仍未解决;(4) 推理是摊销的、不是审慎的——Think 模型周训、reason token 日更(触发命中的用户可在近线秒级刷新)、服务读 $K=0$ 预计算的 token,因此会话内的意图漂移只能通过生成器自身的输入上下文抵达,显式的在文推理对请求路径仍然太贵。
在此之上我要补充四条报告没有明说的:
(a) 工业实验全部没有误差棒。 Table 2 的公开基准给了 5 次 run 的 ±std,而承载全部核心论证的 Table 3/4/5(以及 Table 10、13)一个方差估计都没有。这直接影响了消融章节里 0.02 AUC 差异的可判定性(见上文独立复核)。作者已经有跑多 seed 的能力(BARGE 部分明写「3 seed、早停」),工业表不给方差更像是篇幅取舍而非能力限制。
(b) GAUC 的分组口径全文未定义。 在 AUC 与 GAUC 给出相反排序的场合(Table 5 两个消融变体),分组键(user / request)、加权方式(等权 / 按曝光加权)、退化组的处理方式都会实质影响结论。若按曝光加权,重度用户权重更高,而重度用户序列更长——恰是 CCFormer 优势最大的那批人——口径本身就可能放大差距。补一个分 cohort 或按序列长度分桶的 GAUC 就能消解这个疑问,成本很低。
(c) 消融只报训练吞吐,没报服务侧成本。 「序列压缩 = 效率杠杆」的证据全部来自 training speedup(2.21× → 1.29×)。但决定能否上线的是 serving 成本与 QPS,而 §3.3 报的 +30% 峰值 QPS 来自「目标 token 互不注意 → 单次前向打分全候选」,与序列压缩正交。对一个训练预算宽裕、只关心推理成本的团队,Table 5 其实推不出「必须保留序列压缩」的结论。
(d) 三条方向的「耦合」在证据层面还很薄。 报告反复强调三条方向是 coupled(共享 tokenizer 家族、编码接口、Numerous-Torch),但真正被实验验证的跨方向耦合只有一处:TGR-Reason 的 Reason 记录被投影成 rank 侧特征喂给 CCFormer。这一处没有单独的消融或 A/B,我们无法知道它贡献了 +1.75% ECR 里的多少。P2 承诺的另一个方向——「未来给 TGR-GenRank 加生成式 head 时从 TGR-GenRec 的物品生成器 bootstrap」——目前完全是路线图。换句话说,TGR 目前更像四个共享基础设施的强工作被组织在一份纪律下,而不是一个已被证明存在协同增益的栈。
(e) 关于 +477.8% 这个数字的读法。 冷启动 Hit@1 从 0.0451 到 0.2606 的相对增益 477.8% 极其醒目,但它来自一个极低的基线——绝对提升 0.2155 才是诚实的量级。作者在正文里同时给了绝对值与相对值,摘要里只给了相对值。对照同表的 Hit@50(+11.6%)可以看出,随着候选集变宽协同证据恢复、先验的边际贡献自然缩小,这个衰减模式本身是可信的。
与已有工作的定位¶
在 Table 1 的坐标系里,TGR 与 OneRec 谱系的分歧点非常清楚:OneRec-V1/V2/Think/OneReason 一路都是「召回+排序」的整体替换并把重心放在对齐与推理(DPO → GBPO → in-text CoT → CoT SFT+RL),而 TGR 是分阶段、分范式并行推进,并且把推理彻底移出请求路径。跟本次 Step 2.5 的三篇对照放在一起看,TGR 在三条轴上的位置是:整版生成上与 OGR 殊途同归、量级相当;单模型替级联上明确比 SONA 保守,且自己写进了 Limitations;离线摊销推理上比 AIR 更进一步(推理从「移到离线」变成「换成参数」)且表示空间更统一。TGR 报告在 Future Directions 里点名的三条(ULTRA-HSTU 式的 scaling 曲线弯折、reasoning-native 与 test-time compute、agentic self-evolution)也都对应着归档里已有的工作(ULTRA-HSTU ULTRA-HSTU、RecGPT-V3 RecGPT-V3、AgentX AgentX),说明这条路线的下一步在整个行业里已经相当收敛。