CCFormer:面向工业推荐的高效跨域特征交互与分层序列压缩¶
腾讯 Platform and Content Group(PCG)· KDD '27 · arXiv:2607.28070 · 2026-07-30
Yunlong Wang*, Huizhe Zhang*, Haonan Hu*, Yudong Li†, Bing Wen, Jianchao Tu, Chengxiang Zhuo, Zang Li (* 共同一作,† 通讯作者)
研究动机与背景¶
工业推荐系统近年出现了一条清晰的主线:把排序模型从传统 DLRM 换成基于自注意力的序列 Transformer 骨干,从而享受可预测的 scaling law —— 加长序列、加大模型容量、加算力预算,收益稳定增长(HSTU、OneTrans、STCA 都是这条线上的代表)。但作者指出,这条路在真实工业系统里被两道墙同时卡住:
第一道墙:二次复杂度。 自注意力对序列长度 $L_s$ 的计算与显存开销都是 $O(L_s^2)$。工业排序场景要在严格延迟与资源约束下处理海量流量,直接把序列拉长或把模型加大,训练与推理成本都不可接受。
第二道墙:异构特征域被"一视同仁"地处理。 现有统一 Transformer 的做法是把所有 token(用户画像、历史行为、目标物品)拼成一条长序列做全局自注意力。作者认为这既做了不必要的计算,也削弱了各特征域的语义角色("standard self-attention over all tokens treats different feature fields uniformly, which not only incurs unnecessary computation but may also weaken their semantic roles")。
面对第一道墙,已有工作沿两条路走,作者都认为不够(见 Figure 1 的架构对比):
- 压缩序列表征(compressed sequence representation):先把长行为序列压成紧凑表示,再进特征交互。计算是省了,但丢失细粒度行为信号,并弱化了历史行为与目标物品之间的后续交互。
- 序列截断 / 稀疏注意力(sequence truncation):检索或截断出一段与目标相关的子序列,在有限窗口内保留 token 级建模(TWIN、SIM 一类),或用稀疏注意力降低开销。但截断不可避免地丢弃潜在有用的长期兴趣,而且在保留下来的序列上做完全自注意力仍有不可忽略的开销。
作者把核心问题凝练成一句话:如何在长用户行为序列中实现充分且高效的特征交互(how to achieve sufficient and efficient feature interactions within long user behavior sequences for industrial recommendation)。序列特征交叉不足会削弱模型发现细粒度偏好模式的能力,而穷尽式自注意力对长序列又太贵。
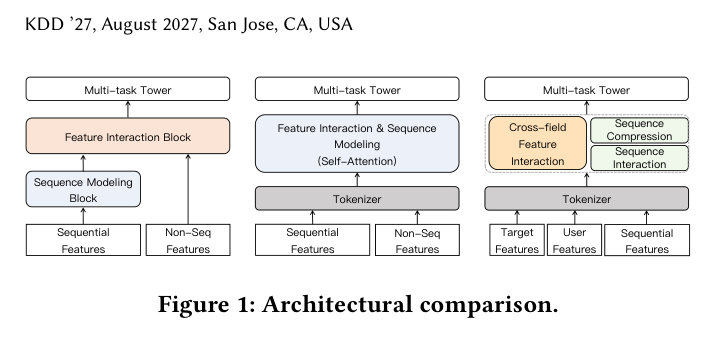
CCFormer 的解法是把特征交互过程解耦成两个正交分量:跨域交互(cross-field interaction) 与 序列内 token 交互(intra-sequence token interaction)。这样模型既能从庞大的历史行为中蒸馏出目标感知的用户兴趣,又避免了在全 token 集上做穷尽自注意力的二次代价。
论文列出三点贡献:
- 提出面向长序列推荐的新交互范式:特征域分离的 cross attention,实现异构域 token 之间高效的早期融合(early fusion);同时子空间级相对时序-位置编码把 recency-aware 的顺序信息注入行为序列。
- 据作者所知,这是首次把 token mixing 从统一特征 token 扩展到工业排序模型的全长用户行为序列,并配套一套定制的分层序列压缩。该范式在大幅降低计算开销的同时保留了丰富的长序列信息,训练最高加速 2.21×。
- 在两个公开 benchmark 与工业数据集上对比先进工业基线做了完整实验;scaling law 分析与腾讯两个真实场景的线上 A/B 验证了有效性、可扩展性与实用性。
相关工作定位¶
传统深度推荐模型(DLRM):Wide & Deep 联合记忆低阶特征共现与泛化,DeepFM 把因子分解机与深度网络结合以同时捕捉低阶与高阶交互。这类模型通常把用户历史当作聚合的或短程的表示处理,而非显式建模长期序列依赖;仅靠静态特征交叉或池化后的行为表示会忽略重要的序列信号。
基于 Token Mixing 的推荐模型:这条线不再依赖异构手工特征交叉模块,而是把统一特征 token 序列化以利用工业级 scaling law。它源自 Vision Transformer 的 MLP 替代方案(MLP-Mixer),用轻量 token mixing 算子替代二次自注意力,通过在 token 间混合子空间向量实现全局特征交互。RankMixer 把多头 token mixing 模块与 per-token FFN 结合,高效建模异构特征子空间;TokenMixer-Large 通过重新设计残差路径(mixing-and-reverting 操作)进一步改进该范式。作者明确指出:已有 token-mixing 推荐模型主要针对统一特征 token,而非全长用户行为序列 —— 这正是 CCFormer 的切入点。
基于注意力的推荐模型:早期序列模型用 RNN / CNN / 注意力编码历史行为。近期工作把注意力架构扩展到工业规模,在可扩展框架内联合建模行为序列、物品特征与用户画像。这些工作表明沿序列长度、模型容量、特征交互模块 scaling 都能持续提升效果,尤其当用户兴趣跨越多样历史与特征域时。但 vanilla 自注意力带来二次计算与显存代价,而许多注意力变体只盯着序列建模开销,反而不擅长捕捉跨域特征交互。因此,"如何实现高效且充分的跨域特征交互"仍是注意力模型的关键挑战。
核心方法 / 模型架构¶
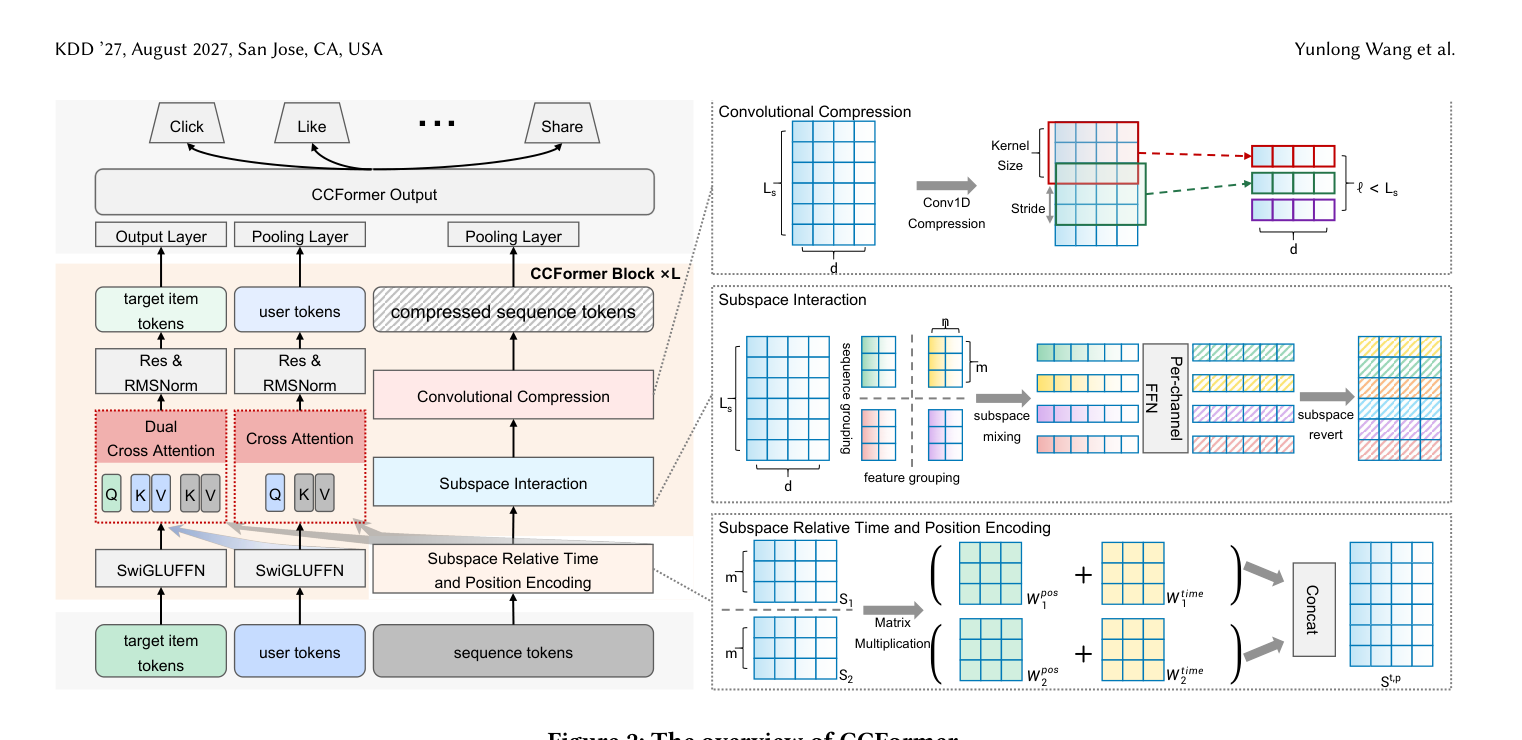
CCFormer 采用解耦架构范式,把输入特征空间显式划分为三个不同的语义域:用户画像(user profiles)、历史行为序列(historical behavior sequences)、目标物品(target items)。
形式化地,令
$$\mathbf{U}^{(0)} \in \mathbb{R}^{B \times L_u \times d}, \quad \mathbf{S}^{(0)} \in \mathbb{R}^{B \times L_s \times d}, \quad \mathbf{T}^{(0)} \in \mathbb{R}^{B \times L_t \times d}$$
分别表示用户域、行为序列域、目标物品域的初始 tokenized 表示。$B$ 是 batch size,$d$ 是隐藏维度,$L_u, L_s, L_t$ 是各域 token 数。具体来说,异构的用户侧特征被投影为一组紧凑的 user token,而每条历史行为与目标物品各自 embed 成细粒度的 item-level token。
CCFormer 的核心是 $L$ 个堆叠的交互块,每块通过前述解耦交互迭代精炼三个域的表示:
$$(\mathbf{U}^{(\ell+1)}, \mathbf{S}^{(\ell+1)}, \mathbf{T}^{(\ell+1)}) = \text{CCFormerBlock}_\ell(\mathbf{U}^{(\ell)}, \mathbf{S}^{(\ell)}, \mathbf{T}^{(\ell)}) \tag{1}$$
经过 $L$ 层深度特征抽取后,三个域的最终归一化表示被聚合,送入任务专属的预测头做多任务学习。
3.1 特征域分离的交叉注意力(Feature-Field Separated Cross Attention)¶
CTR 预估涉及异构特征交互,作者归纳为三类:用户对历史的偏好检索、目标对历史的相关性匹配、目标对用户的兼容性建模。在所有 token 上做标准自注意力对不同特征域一视同仁,既产生不必要的计算,也可能弱化其语义角色。CCFormer 因此用特征域分离的交叉注意力,通过三条有向注意力流来建模这些交互。
在跨域交互之前,先对用户域与目标域施加轻量的 token-wise 前馈网络:
$$\tilde{\mathbf{U}}^{(\ell)} = \text{SwiGLUFFN}^{\ell}_u(\mathbf{U}^{(\ell)}), \quad \tilde{\mathbf{T}}^{(\ell)} = \text{SwiGLUFFN}^{\ell}_t(\mathbf{T}^{(\ell)}) \tag{2}$$
用户域生成 query、key、value,而行为序列只提供 key 与 value —— 因为序列在这里只作为"被检索的上下文":
$$(\mathbf{Q}_u, \mathbf{K}_u, \mathbf{V}_u) = \text{RMSNorm}(\tilde{\mathbf{U}}^{(\ell)})\mathbf{W}_u^{QKV} \tag{3}$$
$$(\mathbf{K}_s, \mathbf{V}_s) = \text{RMSNorm}(\mathbf{S}^{(\ell)})\mathbf{W}_s^{KV} \tag{4}$$
其中 $\mathbf{W}_u^{QKV} \in \mathbb{R}^{d\times 3d}$,$\mathbf{W}_s^{KV} \in \mathbb{R}^{d\times 2d}$。这里用 RMSNorm 是为了对齐不同特征域的尺度。
目标域用两个独立的 query 投影,分别去 attend 行为序列与用户域:
$$\mathbf{Q}_{t\to s} = \tilde{\mathbf{T}}^{(\ell)}\mathbf{W}^{Q}_{t\to s}, \quad \mathbf{Q}_{t\to u} = \tilde{\mathbf{T}}^{(\ell)}\mathbf{W}^{Q}_{t\to u} \tag{5}$$
三条有向交叉注意力流随之计算:
$$ \begin{aligned} \mathbf{O}_{u\to s} &= \text{Attn}(\mathbf{Q}_u, \mathbf{K}_s, \mathbf{V}_s; \mathbf{M}) \\ \mathbf{O}_{t\to s} &= \text{Attn}(\mathbf{Q}_{t\to s}, \mathbf{K}_s, \mathbf{V}_s; \mathbf{M}) \\ \mathbf{O}_{t\to u} &= \text{Attn}(\mathbf{Q}_{t\to u}, \mathbf{K}_u, \mathbf{V}_u) \end{aligned} \tag{6} $$
其中注意力算子为
$$\text{Attn}(\mathbf{Q},\mathbf{K},\mathbf{V};\mathbf{M}) = \text{softmax}\left(\frac{\mathbf{Q}\mathbf{K}^\top}{\sqrt{d_k}} + \mathbf{M}\right)\mathbf{V} \tag{7}$$
对每个注意力头,$d_k = d/h$ 为头维度($h$ 为头数)。mask $\mathbf{M}$ 在无需 mask 时省略,只在序列相关的注意力中用于屏蔽 padding 的行为位置。
最后更新用户域与目标域:
$$\Delta\mathbf{U}^{(\ell)} = \mathbf{O}_{u\to s}\mathbf{W}_u^{O}, \quad \Delta\mathbf{T}^{(\ell)} = [\mathbf{O}_{t\to s}; \mathbf{O}_{t\to u}]\mathbf{W}_t^{O} \tag{8}$$
这样设计的物理含义是:用户域选择性地从历史行为中检索兴趣信号,而目标域同时捕捉"目标-历史相关性"与"目标-用户兼容性"。注意这里的复杂度:注意力的代价是 $O(L_u L_s)$ 与 $O(L_t L_s)$ 而非 $O(L_s^2)$,由于 $L_u, L_t \ll L_s$,跨域交互本身就是线性于序列长度的。
3.2 Token 子空间内的相对时序-位置编码¶
时间与位置线索对捕捉演化偏好至关重要,已有研究表明联合时序-位置建模能显著提升推荐精度。但传统自注意力做这件事是 $O(L_s^2)$ 的,对实时长程推荐是禁止性延迟。CCFormer 因此把相对时序-位置编码限制在局部行为子空间内,把复杂度降到 $O(L_s m)$。
给定序列表示 $\mathbf{S} \in \mathbb{R}^{B\times L_s\times d}$,沿序列维 $L_s$ 划分为大小为 $m$ 的组,每组含 $m$ 条行为。对第 $p$ 组内第 $i$、$j$ 条行为,相对时序编码定义为:
$$\mathbf{W}^{\text{time}}_{p,i,j} = \alpha\cdot\beta^{|t_{p,i}-t_{p,j}|^{\gamma}} \tag{9}$$
其中 $\alpha$ 与 $\gamma$ 是正的可学习参数,$\beta \in (0,1)$ 是时间衰减参数,$t_{p,i}$ 是第 $p$ 组内第 $i$ 条行为的时间戳。由此构造第 $p$ 组的相对时序矩阵 $\mathbf{W}^{\text{time}}_p \in \mathbb{R}^{m\times m}$。由于 $\beta \in (0,1)$,权重 $\mathbf{W}^{\text{time}}_{p,i,j}$ 随时间间隔 $|t_{p,i}-t_{p,j}|$ 增大而单调递减,因此给时间上邻近的行为分配更大权重。
除时序信息外,引入可学习的相对位置偏置 $\mathbf{W}^{\text{pos\_origin}} \in \mathbb{R}^{2m-1}$ 来捕捉同一序列组内不同行为之间的位置关系。第 $p$ 组内第 $i$、$j$ 条行为的相对位置编码为:
$$\mathbf{W}^{\text{pos}}_{p} = \mathbf{W}^{\text{pos\_origin}}\left[i-j+m-1\right] \tag{10}$$
构造第 $p$ 组的相对位置矩阵 $\mathbf{W}^{\text{pos}}_p \in \mathbb{R}^{m\times m}$。最终把时序-位置信息融合进序列 $\mathbf{S}$:
$$ \begin{aligned} \mathbf{S}^{\text{t.p.}} &= \text{Concat}\left(\mathbf{S}^{\text{tp}}_1, \mathbf{S}^{\text{tp}}_2, \ldots, \mathbf{S}^{\text{tp}}_{L_s/m}\right), \\ \mathbf{S}^{\text{tp}}_p &= \left(\mathbf{W}^{\text{time}}_p + \mathbf{W}^{\text{pos}}_p\right)\mathbf{S}\left[(p-1)\cdot m : p\cdot m\right] \end{aligned} \tag{11} $$
即:在每个大小为 $m$ 的局部窗口内,用一个 $m\times m$ 的(时序衰减 + 位置偏置)矩阵对该窗口的行为表示做一次矩阵乘法式的重加权聚合。
3.3 长序列子空间 Token Mixing¶
跨域交互解决了"域间"的问题,但序列内部(intra-sequence)的依赖仍需捕捉。标准自注意力在这里再次撞上 $O(L_s^2)$ 瓶颈。CCFormer 引入 Subspace Token Mixing 模块:不计算稠密的两两注意力,而是把行为序列切成紧凑的 token 子空间,用 Per-channel Feed-Forward Network(PFFN) 处理。
形式化地,输入序列表示 $\mathbf{S} \in \mathbb{R}^{B\times L_s\times d}$ 先被 reshape 成子空间张量:
$$\mathbf{X} = \text{Reshape}(\mathbf{S}) \in \mathbb{R}^{B\times\frac{L_s}{m}\times\frac{d}{n}\times mn} \tag{12}$$
在这个表述中,每个子空间向量 $\mathbf{X}_{b,p,c} \in \mathbb{R}^{mn}$ 同时封装了 $m$ 条相邻行为 token 与 $n$ 个隐藏维度。这一结构重组是关键:它迫使细粒度的 token 级与 channel 级信号在一个局部化、紧凑的表示内直接交互。
随后对每个 channel group 独立施加 PFFN 以抽取子空间专属模式。PFFN 实例化为门控前馈架构以增强非线性表达力:
$$\text{PFFN}_c(\mathbf{x}) = \mathbf{W}^o_c\left(\phi(\mathbf{x}\mathbf{W}^g_c)\odot(\mathbf{x}\mathbf{W}^v_c)\right) \tag{13}$$
其中 $\phi(\cdot)$ 是平滑非线性激活,$\odot$ 是逐元素乘,$\mathbf{W}^g_c, \mathbf{W}^v_c, \mathbf{W}^o_c$ 是第 $c$ 个 channel group 专属的可学习权重矩阵。对每个子空间:
$$\mathbf{Z}_{b,p,c} = \text{PFFN}_c(\mathbf{X}_{b,p,c}) \tag{14}$$
跨 channel group 使用独立参数,使模型能并行捕捉多样、异构的行为模式。输出张量 $\mathbf{Z}$ 保持 $\mathbf{X}$ 的子空间拓扑,随后被还原回原始序列布局:
$$\hat{\mathbf{S}} = \text{Restore}(\mathbf{Z}) \in \mathbb{R}^{B\times L_s\times d} \tag{15}$$
总体上,这个基于子空间的混合机制在表达力与计算效率之间给出了有利折衷:通过在局部子空间内显式混合多个行为 token 与隐藏维度,它有效捕捉了序列内依赖,而复杂度对 $L_s$ 是线性的。
3.4 分层长序列 Token 压缩¶
子空间 token mixing 缓解了序列内交互的成本,但处理全长行为序列本身在 $L_s$ 极大时仍然计算上禁止性昂贵。此外,长用户历史天然存在冗余与局部相关性。为此作者引入 Hierarchical Token Compression 模块,逐层渐进地凝练序列表示。
形式化地,在第 $\ell$ 个块的序列更新之后,沿序列维施加一维卷积下采样算子:
$$\mathbf{S}^{(\ell+1)} = \text{Conv1D}_{k,s}\,\hat{\mathbf{S}}^{(\ell)} \tag{16}$$
其中 $\hat{\mathbf{S}}^{(\ell)}$ 是第 $\ell$ 个 CCFormer 块经子空间 token mixing 后的输出,$\mathbf{S}^{(\ell+1)}$ 作为下一块的输入序列表示;$k$ 与 $s$ 分别是卷积核大小与步长。该操作融合相邻行为 token 以聚合局部上下文,为后续层产出更短的序列。
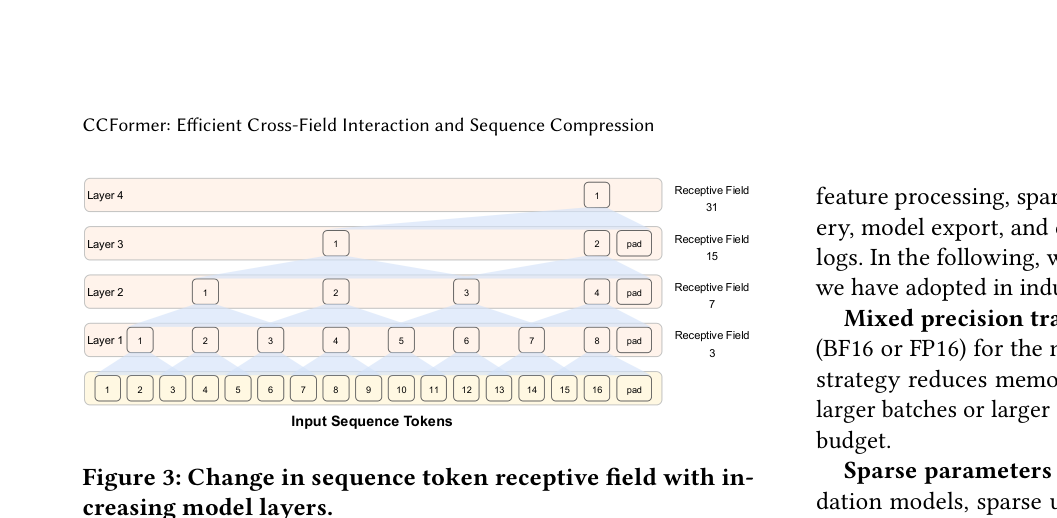
压缩机制与子空间 token mixing 机制天然互补:子空间 token mixing 在每层内捕捉局部交互,而卷积压缩跨层合并局部信息。如 Figure 3 所示,随着网络加深,每个压缩 token 的感受野在原始行为序列上渐进扩张(3 → 7 → 15 → 31)。这使得多粒度用户兴趣建模成为可能:浅层捕捉短期、细粒度的行为模式,深层抽取抽象的长期偏好信号。关键在于,序列长度的渐进缩减显著降低了计算复杂度,保证了 CCFormer 对超长用户序列建模的可扩展性 —— 同时通过扩张的感受野保留了对全序列的访问,而不是像截断那样直接丢弃。
3.5 训练与部署优化¶
CCFormer 建在腾讯自研的生产级训练与推理基础设施 Numerous-Torch 之上。该基础设施的作用是弥合灵活模型创新与工业级推荐部署之间的鸿沟:建模侧保持 PyTorch 原生开发体验,让研究者高效复用 LLM 社区的新进展;系统侧提供生产推荐负载所需的分布式数据摄取、大规模稀疏特征处理、稀疏-稠密联合训练、checkpoint 恢复、模型导出、以及在新鲜用户反馈日志上的持续训练。论文列出三项关键优化:
混合精度训练。 主模型计算采用混合精度(BF16 或 FP16)。实践中该策略降低显存开销超过 35%,在同一训练预算下支持更大 batch 或更大模型参数量。
稀疏参数压缩。 大规模商业推荐模型中,稀疏的 user / item ID 特征占据了绝大部分稀疏模型参数。作者用 INT8 对称线性量化存储这些 ID 特征的 embedding table,相比全精度存储实现约 70% 压缩;此外采用 double-hashing 策略减小 ID 特征 embedding table 尺寸,进一步降低稀疏参数量约 50%。两者结合大幅降低了训练期的显存占用与通信成本,且不降低训练效果。
候选物品并行预测。 在 CCFormer 块中,target token 只作为 query,从不互相 attend。这一设计避免了跨目标的信息泄露,并允许同一请求内的多个候选物品被并行打分。在线服务时,一次请求中的所有候选 target 被打包进 target 域一次性前向;由于 user 域与 sequence 域的建模在候选之间是共享的,CCFormer 单趟前向即可产出所有 target 的多任务分数,避免重复的用户序列计算,提升服务吞吐。相比 DLRM 基线的逐候选 pointwise 推理,这套并行预测方案让 CCFormer 在相同推理资源下把线上峰值 QPS 提升 30%,尽管其计算复杂度高出 20×。
实验设置¶
数据集¶
在两个公开 benchmark(Taobao、KuaiRec)与一个内部工业数据集上做对比实验。
Table 1: Dataset Statistics.
| Datasets | #Users | #Items | #Samples |
|---|---|---|---|
| Taobao | 987,994 | 4,162,024 | 100,150,807 |
| KuaiRec | 7,176 | 10,728 | 12,530,806 |
| Industry | >30M | >10M | >4B |
- Taobao:用用户点击过的物品作为行为序列,预测用户是否会点击目标物品。
- KuaiRec:短视频推荐数据集,提供丰富的用户-物品交互记录。使用提供的 big matrix 数据,当 watch ratio ≥ 2 时视为正样本。
- Industry:采集自腾讯某推荐系统的线上日志与真实用户反馈,含一个月的生产数据,超过 40 亿样本、3000 万以上用户、1000 万推荐内容。
两个公开数据集的行为序列截断到长度 200;工业数据集的用户行为序列长度设为 1000。
Baselines¶
- 公开数据集:两个传统 DLRM 范式的代表(DIN、DeepFM)+ 两个序列推荐模型(SASRec、MIMN),以及三个基于注意力的序列推荐模型(HSTU、OneTrans、STCA)。每个实验重复 5 次,报告 AUC 及对应的相对提升。
- 工业数据集:进一步与面向生产的强基线(HSTU、OneTrans、STCA)对比,同时用 AUC 与 Group AUC(GAUC) 作为评估指标。
评估指标¶
$\Delta$AUC 与 $\Delta$GAUC 表示 AUC 与 GAUC 上的相对提升,按如下 RelaImpr 公式计算:
$$\text{RelaImpr} = \left(\frac{\text{Metric(measured model)} - 0.5}{\text{Metric(base model)} - 0.5} - 1\right)\times 100\% \tag{17}$$
公开数据集上 DIN 作为计算 $\Delta$AUC 的 base model;工业数据集上 HSTU 作为 base model。采用 Tree-structured Parzen Estimator(TPE) 超参搜索为每种方法选择最优配置。
实现细节¶
除非另有说明,所有工业实验中:特征 token 维度 $d = 256$,堆叠 8 个 CCFormer 块;子空间组大小 $m = 8$,channel 组大小 $n = 16$;卷积压缩模块的核大小 $k = 3$、步长 $s = 2$。所有模型用 Adam 优化,学习率 $1\times10^{-4}$,batch size 4096。为保证公平对比,所有实验在同一套硬件与软件配置上进行:16 张 NVIDIA H20 GPU 的集群。
主要实验结果¶
整体性能(Table 2 / Table 3)¶
Table 2: Performance comparison on public datasets.(DIN 作为计算 $\Delta$AUC 的 base model)
| Datasets | Metric | DIN | DeepFM | SASRec | MIMN | HSTU | OneTrans | STCA | CCFormer |
|---|---|---|---|---|---|---|---|---|---|
| Taobao | AUC (%) | 88.33±0.22 | 89.06±0.42 | 88.52±0.65 | 91.79±0.32 | 91.40±0.25 | 91.35±0.61 | 92.81±0.50 | 93.67±0.32 |
| Taobao | $\Delta$AUC (%) | 0.00 | 1.90 | 0.50 | 9.03 | 8.01 | 7.88 | 11.69 | 13.93 |
| KuaiRec | AUC (%) | 80.22±0.58 | 80.14±0.51 | 79.83±0.70 | 81.79±0.81 | 82.62±0.39 | 82.76±0.59 | 82.18±0.16 | 83.35±0.29 |
| KuaiRec | $\Delta$AUC (%) | 0.00 | -0.26 | -1.29 | 5.20 | 7.94 | 8.41 | 6.49 | 10.36 |
Table 3: Performance comparison on the industrial dataset.(HSTU 作为 base model)
| Models | AUC (%) | $\Delta$AUC (%) | GAUC (%) | $\Delta$GAUC (%) |
|---|---|---|---|---|
| HSTU | 77.66 | 0.00 | 70.86 | 0.00 |
| OneTrans | 77.69 | 0.11 | 70.90 | 0.19 |
| STCA | 77.73 | 0.25 | 70.95 | 0.43 |
| CCFormer | 77.94 | 1.01 | 71.36 | 2.40 |
结论分析:CCFormer 在公开与工业数据集上都取得最好性能。Taobao 与 KuaiRec 上 AUC 分别为 93.67% 与 83.35%,分别超过各自数据集上最强的序列基线(Taobao 的 STCA、KuaiRec 的 OneTrans)0.86 与 0.59 个百分点。值得注意的是各数据集上"最强基线"并不相同 —— STCA 在 Taobao 上强而在 KuaiRec 上反而弱于 HSTU/OneTrans,说明这些强基线的优势有数据集依赖性,而 CCFormer 在两者上都稳定领先。
工业数据集上 CCFormer 相对 HSTU AUC +0.28 点、GAUC +0.50 点,对应 1.01% 与 2.40% 的相对提升;相对最强基线 STCA 也有 AUC +0.21 点、GAUC +0.41 点。注意 GAUC 的相对提升(2.40%)明显大于 AUC(1.01%),说明 CCFormer 的收益更多来自用户内部的排序质量而非跨用户的整体区分度 —— 这与"更好地建模个体用户的长期兴趣"的设计意图一致。
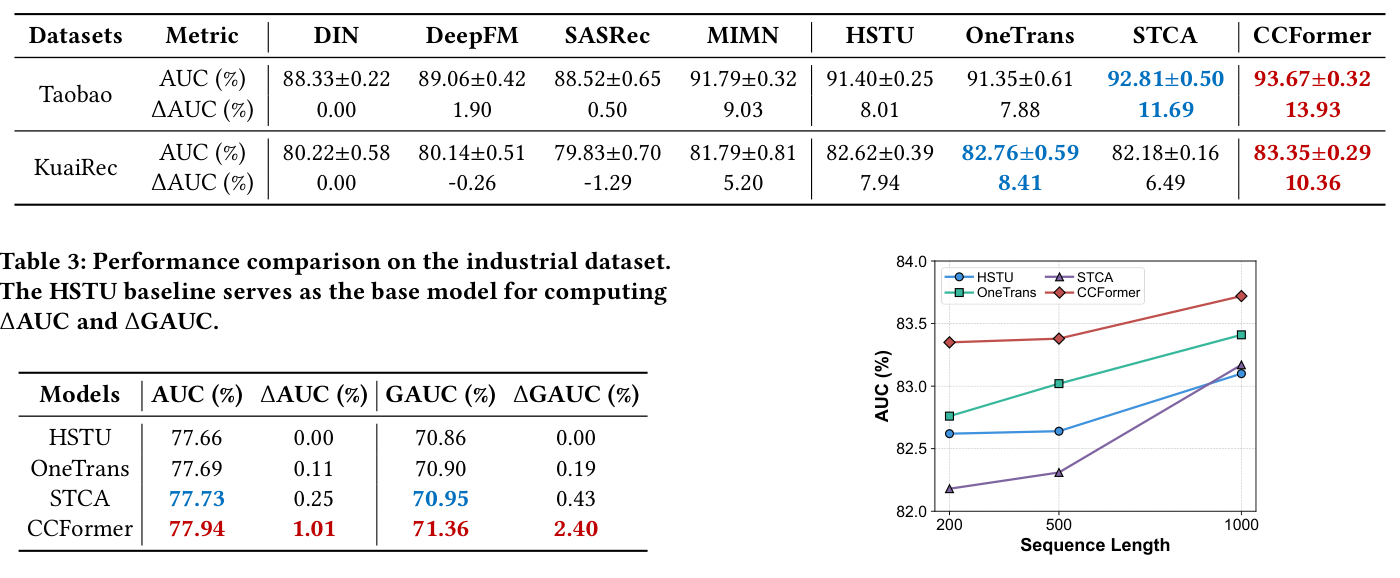
作者进一步在不同序列长度(200、500、1000)下对比四个先进序列推荐模型(Figure 4)。CCFormer 在所有序列长度设置下都一致优于 HSTU、OneTrans、STCA,展示了其在建模用户行为序列上的稳定优势。
4.2 CCFormer 的 Scaling 分析¶
作者聚焦两个对序列推荐模型至关重要的因子:序列长度与模型容量。所有实验在同一套硬件与软件栈上进行;除性能指标外还报告各模型的 GFLOPs。
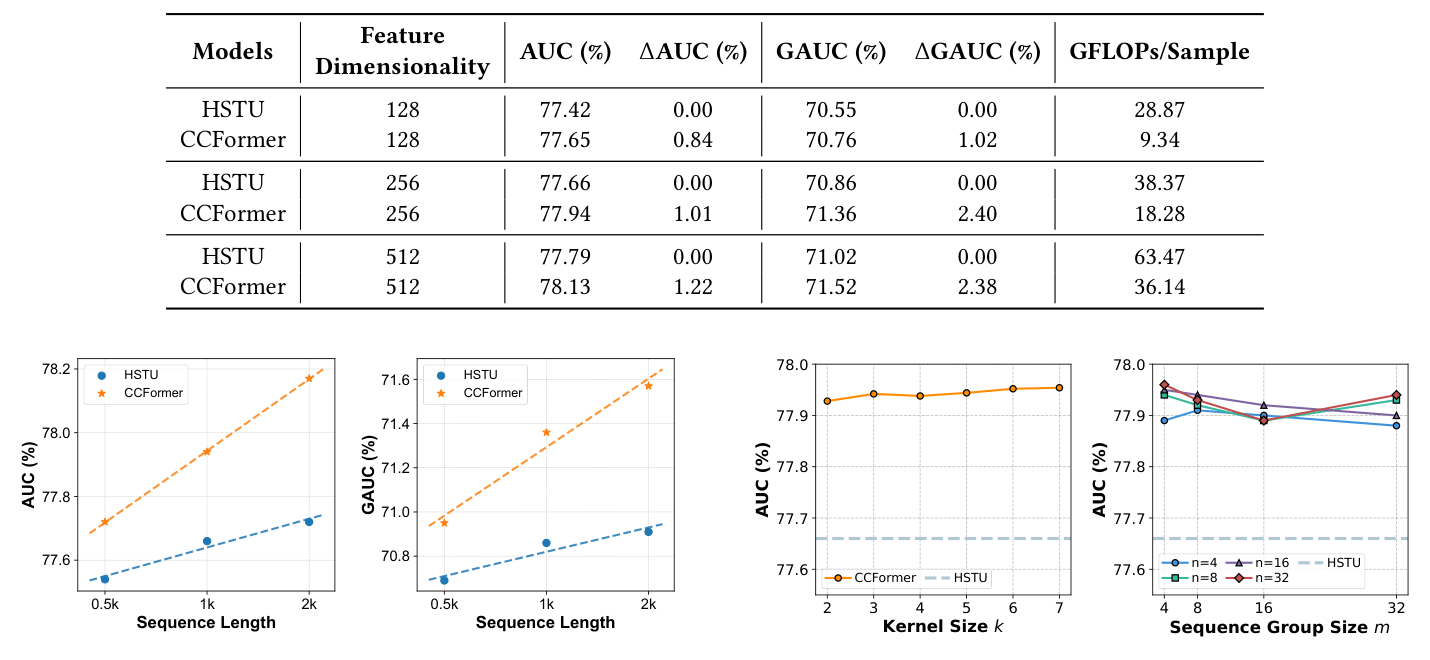
序列长度 scaling。 在工业数据集上把序列长度取 500 / 1000 / 2000(Figure 5)。随着序列变长,CCFormer 表现出可预测的 scaling 行为:AUC 从 77.72% 稳步提升到 78.17%,GAUC 从 70.95% 提升到 71.57%。相比 HSTU,CCFormer 在各序列长度设置下平均相对提升 AUC 1.08%、GAUC 2.37%。
最值得注意的一点是:CCFormer 仅用 0.5k 行为 token 就已经匹配 HSTU 用 2k 行为 token 的 AUC,并超过其 GAUC。而且相对增益随序列变长而变大。作者的解释是:长序列子空间 token mixing 从完整行为历史中捕捉了富有表达力的模式,而序列压缩以显著更低的成本保留了大的感受野。
模型规模 scaling。 Table 4 通过改变特征维度控制模型容量:
Table 4: Effect of the model size.(HSTU 作为 base model)
| Models | Feature Dimensionality | AUC (%) | $\Delta$AUC (%) | GAUC (%) | $\Delta$GAUC (%) | GFLOPs/Sample |
|---|---|---|---|---|---|---|
| HSTU | 128 | 77.42 | 0.00 | 70.55 | 0.00 | 28.87 |
| CCFormer | 128 | 77.65 | 0.84 | 70.76 | 1.02 | 9.34 |
| HSTU | 256 | 77.66 | 0.00 | 70.86 | 0.00 | 38.37 |
| CCFormer | 256 | 77.94 | 1.01 | 71.36 | 2.40 | 18.28 |
| HSTU | 512 | 77.79 | 0.00 | 71.02 | 0.00 | 63.47 |
| CCFormer | 512 | 78.13 | 1.22 | 71.52 | 2.38 | 36.14 |
结论分析:随着特征维度增大,CCFormer 遵循可预测的 scaling law,AUC 从 77.65% 提升到 78.13%,GAUC 从 70.76% 提升到 71.52%。在相同特征维度下,CCFormer 相对 HSTU 平均相对提升 AUC 1.02%、GAUC 1.93%。
这张表最有说服力的一列是 GFLOPs/Sample:CCFormer 在每个规模档位上都只用 HSTU 约 1/3 到 3/5 的算力(128 维:9.34 vs 28.87,约 3.1× 更省;256 维:18.28 vs 38.37,约 2.1×;512 维:36.14 vs 63.47,约 1.76×),却取得更好的 AUC/GAUC。更进一步,CCFormer@128(9.34 GFLOPs,AUC 77.65)已经接近 HSTU@256(38.37 GFLOPs,AUC 77.66)的效果,算力仅为其 1/4。这说明 CCFormer 提供的是更有利的效果-效率权衡曲线,而非单纯靠堆算力换点数。
4.3 长序列建模超参数的影响¶
作者考察两类与长序列建模相关的超参数:序列压缩模块中的卷积核大小 $k$(控制相邻行为 token 上的感受野),以及长序列子空间 token mixing 中的序列组大小 $m$(沿序列维分组)与 channel 组大小 $n$(沿特征维分组)。
Kernel Size。 如 Figure 6 所示,增大核大小略微提升 AUC,整体性能保持稳定:$k$ 从 2 增大到 7,AUC 从 77.92% 变到 77.95%。而且在不同核大小下 CCFormer 都以明显幅度优于 HSTU 基线。这表明分层压缩模块能有效移除长行为序列中的冗余信息,同时保留关键偏好信号。工业实验中作者把步长设为 $s = 2$,以在保持竞争力性能的同时减少长序列建模的序列长度。
Group Size。 考察 $m$ 与 $n$ 的组合。如 Figure 6 所示,CCFormer 在不同 $m$、$n$ 组合下保持稳定,且所有配置都一致优于 HSTU 基线。虽然较小的组大小在某些情况下能略微提升 AUC,但整体波动有限。这说明子空间 token mixing 无需精细调参即可稳健捕捉潜在依赖。
4.4 消融实验¶
在工业数据集上分析 CCFormer 各关键组件的贡献。为公平对比,所有消融变体在同一套硬件与软件栈下用相同的训练与评估协议评测。构造四个消融变体,覆盖相对时序-位置编码、长序列子空间 token mixing、分层序列压缩三项核心设计。训练速度用训练吞吐(单位时间处理的样本数)衡量;为更直观地对比训练效率,定义 training speedup 为相对 HSTU 的相对训练吞吐。
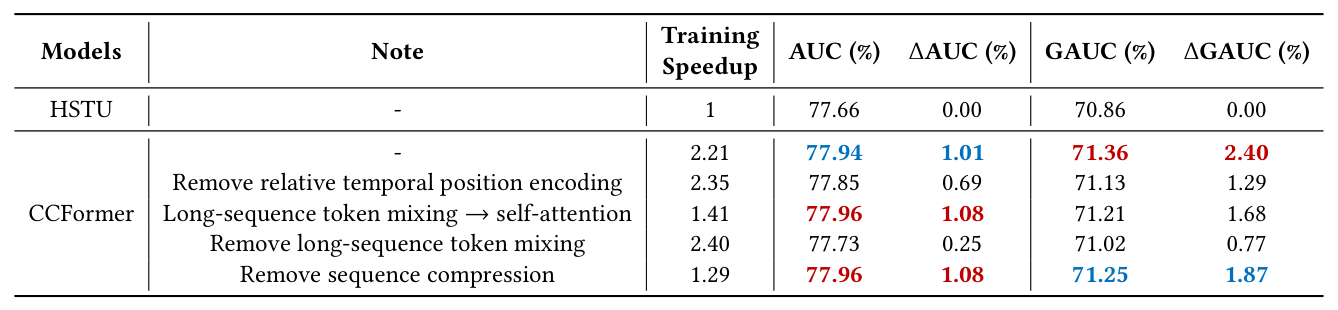
Table 5: Results of ablation study.(HSTU 作为 base model)
| Models | Note | Training Speedup | AUC (%) | $\Delta$AUC (%) | GAUC (%) | $\Delta$GAUC (%) |
|---|---|---|---|---|---|---|
| HSTU | - | 1 | 77.66 | 0.00 | 70.86 | 0.00 |
| CCFormer | - | 2.21 | 77.94 | 1.01 | 71.36 | 2.40 |
| CCFormer | Remove relative temporal position encoding | 2.35 | 77.85 | 0.69 | 71.13 | 1.29 |
| CCFormer | Long-sequence token mixing → self-attention | 1.41 | 77.96 | 1.08 | 71.21 | 1.68 |
| CCFormer | Remove long-sequence token mixing | 2.40 | 77.73 | 0.25 | 71.02 | 0.77 |
| CCFormer | Remove sequence compression | 1.29 | 77.96 | 1.08 | 71.25 | 1.87 |
逐项分析:
- 移除相对时序-位置编码:AUC 从 77.94% 降到 77.85%,GAUC 从 71.36% 降到 71.13%。由于用户兴趣高度时间敏感,相对时序-位置编码帮助 CCFormer 把近期行为与过时行为区分开,更好地捕捉 recency-aware 的偏好模式。
- 移除长序列 token mixing:导致最大退化,AUC 与 GAUC 分别掉到 77.73% 与 71.02%($\Delta$AUC 仅剩 0.25%,$\Delta$GAUC 仅剩 0.77%,几乎回到 HSTU 水平)。这确认了序列内交互建模是效果的主要来源。
- 把长序列 token mixing 换成标准自注意力:AUC 略微改善到 77.96%,但 GAUC 降到 71.21%,且训练加速比从 2.21× 掉到 1.41×。作者据此认为:子空间 token mixing 是一个轻量替代方案,只带来轻微精度损失,却大幅提升训练效率。(值得注意的是,这里 AUC 反而略升而 GAUC 下降,说明 token mixing 相对自注意力的优势主要体现在用户内排序上。)
- 移除序列压缩:AUC 77.96%、GAUC 71.25%。更重要的是,训练加速比从 2.21× 掉到 1.29× —— 这表明序列压缩是训练效率的关键组件。
综合来看,Table 5 呈现出一个清晰的分工:token mixing 主要贡献效果(移除后效果大跌),序列压缩主要贡献效率(移除后加速比大跌但效果几乎不变,甚至 AUC 略高)。两者在"效果-效率"两个维度上互补,共同构成 CCFormer 相对 HSTU 的 2.21× 训练加速 + 效果提升。
4.5 线上 A/B 结果¶
在腾讯两个真实商业推荐场景上做线上 A/B:视频推荐(Scenario 1) 与 广告排序(Scenario 2)。两个场景的线上基线是长期迭代优化过的 DLRM 与一个已部署的 HSTU 模型。每个线上实验组每天覆盖约 100 万曝光用户,实验持续两周。
Table 6: Online A/B gains of CCFormer.
| Scenario | Metric | CTR | UCTR | 3-day Activeness | Video View | Unique Viewer | Page View | Watch Time | Ad revenue |
|---|---|---|---|---|---|---|---|---|---|
| Scenario 1(视频推荐) | Lift (%) | 3.57 | 1.93 | 1.93 | 3.47 | 2.61 | 3.86 | 1.29 | 1.64 |
| Scenario | Metric | Ad view | Ad revenue |
|---|---|---|---|
| Scenario 2(广告排序) | Lift (%) | 1.43 | 1.71 |
结论分析:两个场景的多项业务指标都取得一致提升。
- Scenario 1 中最大增益出现在 Page View,相对提升 3.86%;CTR、Video View、Unique Viewer 分别相对提升 3.57%、3.47%、2.61%。
- UCTR(User Click-Through Rate)与 3-day Activeness 都提升 1.93% —— 作者强调这说明 CCFormer 不仅提升了即时用户响应,也惠及用户参与度与短期留存。
- 广告收入维度:Scenario 1 提升 1.64%、Scenario 2 提升 1.71%。作为广告侧的关键商业指标,这体现了 CCFormer 对工业变现的实际价值。
- 线上增益经两样本 t 检验统计显著($p < 0.05$),确认了生产环境中改进的可靠性。
A/B 之后,CCFormer 已在两个场景全量部署,现服务整个生产流量,全量后线上收益保持稳定。
核心贡献总结¶
- 把"特征交互"拆成两个正交分量:跨域交互(cross-field)与序列内 token 交互(intra-sequence),从架构层面回避了在全 token 集上做穷尽自注意力的二次代价。
- 特征域分离的有向交叉注意力:user / target / sequence 三域各自独立投影,三条有向注意力流($u\to s$、$t\to s$、$t\to u$)显式对应"偏好检索 / 相关性匹配 / 兼容性建模"三类语义关系;由于 $L_u, L_t \ll L_s$,跨域交互对序列长度是线性的。
- 首次把 token mixing 用到全长行为序列:子空间重组($m$ 条相邻行为 × $n$ 个隐藏维)+ per-channel 门控 FFN,以线性复杂度替代序列内自注意力。
- 分层卷积序列压缩:逐层 Conv1D 下采样,感受野渐进扩张(3→7→15→31),实现多粒度兴趣建模,同时保留对全序列的访问(不同于截断),是训练加速 2.21× 的关键来源。
- 子空间内相对时序-位置编码:把 $O(L_s^2)$ 的时序-位置建模降到 $O(L_s m)$,用可学习的时间衰减 $\beta^{|\Delta t|^\gamma}$ 注入 recency 感知。
- 完整的工业落地证据:混合精度(显存 -35%)、INT8 量化 + double hashing(稀疏参数 -70% / -50%)、候选并行预测(峰值 QPS +30%),双场景 A/B 显著正收益并已全量部署。
与已归档相关工作的对比¶
本文的核心问题是"统一 Transformer 排序骨干里,长序列的二次注意力代价 + 异构特征域被无差别处理",解法骨架是"紧凑的非序列 token 作 query 去 cross-attend 全长序列 + 用 token mixing 替代序列内自注意力 + 分层压缩序列长度"。文档库中有三篇论文与之问题 + 解法双同构,且本文均未引用,属独立并发工作。
HyFormer HyFormer: Revisiting the Roles of Sequence Modeling and Feature Interaction in CTR Prediction(ByteDance AML, 2026-01-23)¶
关系:独立并发(本文未引用 HyFormer,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在攻击"先压缩序列、再做特征交互"这一分离式两阶段流水线的结构性缺陷。HyFormer 把它拆成三条:query 建模过度简化、信息交互单向且延迟(压缩后才融合,浅层且隐式)、scaling 效率低。CCFormer 的表述是"压缩丢失细粒度行为信号并弱化后续与目标的交互"。两者指向同一 root cause:序列信息在与异构特征相遇之前就被压扁了。
- 相近的技术骨架:骨架高度重合到近乎逐模块对应。HyFormer 生成 $N$ 个 Global Token 作为 query,用 cross-attention 去解码序列的逐层重算的 key-value($\tilde{Q}_{(l)} = \text{CrossAttn}(Q_{(l)}, K_{(l)}, V_{(l)})$);CCFormer 用紧凑的 user token + target token 作 query,去 cross-attend 序列的 $\mathbf{K}_s, \mathbf{V}_s$(式 3–6),同样每层重算。两者的第二个模块也对应:HyFormer 的 Query Boosting 是 MLP-Mixer 式子空间切分 + 跨 token 混合 + Per-Token FFN;CCFormer 的 Subspace Token Mixing 是子空间重组 + Per-channel FFN(式 12–15)。连"用 MLP-Mixer 谱系的 token mixing 替代注意力"这个选择都一致。
- 本文的差异与推进:三点实质差异。(a) token mixing 的作用对象不同:HyFormer 的 Query Boosting 混合的是 $T = N + M$ 个 query token 与非序列 token(少量),序列本身仍由 Full Transformer / LONGER 式 cross-attn / SwiGLU 三选一编码;CCFormer 把 token mixing 直接下放到全长行为序列本身($L_s$ 量级),这正是本文声称的"首次把 token mixing 从统一特征 token 扩展到全长用户行为序列"。(b) CCFormer 多一层分层压缩:Conv1D 逐层下采样让序列长度在层间递减、感受野递增,HyFormer 没有对应机制(其序列长度在层间恒定)。(c) 域划分粒度不同:HyFormer 是"global token vs 序列"二分,CCFormer 是"user / target / sequence"三分并给出三条语义化的有向注意力流,其中 $t\to u$(目标-用户兼容性)在 HyFormer 中没有独立对应物。
- 可比的方法 / 实验差异:HyFormer 的 LONGER 式编码 $H_l = \text{CrossAttn}(S_{\text{short}}, S, S)$ 把复杂度从 $O(L_S^2)$ 降到 $O(L_H L_S)$,与 CCFormer 的 $O(L_u L_s)$ / $O(L_t L_s)$ 是同一个数量级技巧;差别在 CCFormer 的"short query"不是另一段序列,而是语义上就存在的 user/target 域,省掉了额外构造 $S_{\text{short}}$ 的环节。部署场景上 HyFormer 落在抖音搜索,CCFormer 落在腾讯视频推荐 + 广告排序,两者都报告了线上正收益,但基线不同(HyFormer 对比自家分离式流水线,CCFormer 对比 DLRM 与已部署 HSTU),绝对数值不可直接横比。
TMallGS TMallGS: Scaling Unified Feature and Sequence Modeling for Generative E-commerce Search(Alibaba 天猫, 2026-07-15)¶
关系:独立并发(本文未引用 TMallGS,两篇相隔 15 天)· 已加载对方精读
- 共同关注的问题:两篇都明确反对"LLM 式 All-in-One tokenization + 统一自注意力"直接搬进工业排序。TMallGS 把它命名为异构性鸿沟(The Heterogeneity Gap):强行用统一注意力处理差异极大的模态会触发梯度冲突。CCFormer 的表述是"标准自注意力对不同特征域一视同仁,不仅带来不必要计算,还可能弱化其语义角色"。这是同一 root cause 的两种措辞。两篇的顶层哲学也几乎同义:TMallGS 叫 "Semantic Divide-and-Conquer, Interaction Decoupling"(语义分而治之、交互解耦),CCFormer 叫 "disentangles the feature interaction process into two orthogonal components"。
- 相近的技术骨架:核心机制对应得非常直接。TMallGS 的 Per-Field 异构 QKV 投影把统一输入按域切段,每个域 $\phi$ 用独立投影矩阵 $\mathbf{W}_Q^{\phi(i)}, \mathbf{W}_K^{\phi(i)}, \mathbf{W}_V^{\phi(i)}$,作者称其为"流形对齐机制,允许异构模态各自独立的语义旋转,缓解梯度冲突";CCFormer 的特征域分离交叉注意力给 user 域 $\mathbf{W}_u^{QKV}$、序列域 $\mathbf{W}_s^{KV}$、target 域 $\mathbf{W}^Q_{t\to s}$ / $\mathbf{W}^Q_{t\to u}$ 各自独立的投影(式 3–5)。两者都额外用了归一化来对齐域间尺度(CCFormer 用 RMSNorm,TMallGS 用 LayerNorm 驱动的 Calibrated-Swish)。另一个巧合是候选独立性:TMallGS 用 Context-Dominant Visibility Mask 让候选之间严格不可见以防信息泄露;CCFormer 让 target token 只作 query、从不互相 attend,动机(避免跨目标信息泄露)与效果(同请求多候选并行打分)完全一致。
- 本文的差异与推进:(a) 投影分离 vs 注意力方向分离:TMallGS 仍在一条统一序列上跑(带 mask 的)自注意力,只是 QKV 投影按域分开;CCFormer 更激进,直接取消了全序列自注意力,把注意力重构为三条有向 cross-attention,序列侧只出 K/V 不出 Q。因此 CCFormer 在复杂度上是 $O(L_uL_s + L_tL_s)$,TMallGS 仍是统一序列上的二次注意力。(b) CCFormer 有序列长度压缩,TMallGS 没有:TMallGS 的效率手段是 DCP 减少约 33% 投影 FLOPs,属常数因子优化;CCFormer 的 Conv1D 分层压缩改变的是序列长度本身。(c) 场景约束不同:TMallGS 是搜索(受 query 强约束,因此额外做 Decoupled FiLM 后融合来保护 query-item 匹配分这类高频显式信号,并有 Context-Aware Bias Net 解耦位置偏置);CCFormer 是推荐 + 广告,无 query 约束,因此没有对应的显式交叉特征保护机制 —— 这是 CCFormer 的一处潜在盲点。
SlimPer SlimPer: Make Personalization Model Slim and Smart(Meta Platforms, 2026-07-14)¶
关系:独立并发(本文未引用 SlimPer,两篇相隔 16 天)· 已加载对方精读
- 共同关注的问题:SlimPer 对问题的诊断与 CCFormer 的开篇几乎逐句对应。SlimPer 指出类 Transformer 设计在推荐里面临一个本不必要的两难:要么在层间大力压缩中间表示(信息损失),要么保留大型中间张量(显存与算力随 token 数增长)。CCFormer 的开篇正是同一组二选一:压缩序列表示会丢细粒度信号、截断会丢长期兴趣、保留全序列自注意力算不起。两者都认为这个两难源于借用了不适用于判别式排序的架构前提。
- 相近的技术骨架:SlimPer 维护一个定长知识库 $\mathcal{X}^k\in\mathbb{R}^{K\times d}$(实验中 $K=64$),每层用 all-modality-aware 的 QKV attention 以 KB 为 query 去查询完整的原始用户侧 token 集,从而把模型深度与输入序列长度解耦,达到 $O(N)$ 每层复杂度。CCFormer 的 user token + target token 扮演的正是这个"定长 query 集"角色,同样每层去 attend 全序列,同样得到对 $L_s$ 线性的复杂度。两者也都强调 request-only optimization:SlimPer 把 ROO 扩展到所有用户侧模态(用户侧 token 每请求只算一次、跨候选共享);CCFormer 的候选并行预测同样让 user 域与 sequence 域计算跨候选共享,报告峰值 QPS +30%。
- 本文的差异与推进:最有意思的是两篇对同一个两难给出了相反的解。SlimPer 选择永不压缩序列 —— 保持对完整原始用户侧 token 的直接访问("Complete Access"),只把 KB 做小;CCFormer 选择压缩但保留可达性 —— 用 Conv1D 逐层下采样缩短序列,靠感受野渐进扩张(3→7→15→31)来保证"仍能触达全序列"。前者用空间换信息完整性,后者用层级结构换信息完整性。次要差异:(a) SlimPer 的 KB 初始化自非用户侧(item/cross)token 并做 Select-Match-Refine 三步迭代精炼,含显式点积匹配分;CCFormer 的 query 集来自天然的 user/target 域语义划分,无显式匹配分模块。(b) CCFormer 额外用 token mixing 替代了序列内自注意力,SlimPer 的序列侧只有事件级上下文编码(CNN / sliding-window attention),不建模序列内全局依赖 —— 这意味着 SlimPer 更彻底地放弃了序列内交互,而 CCFormer 用线性成本把它保留了下来。
- 可比的实验差异:两篇都报告了 scaling 与效率优势,但指标体系不同(SlimPer 报 per-item Big-O 与 A/B,CCFormer 报 GFLOPs/Sample 与 training speedup),且分别部署在 Instagram Reels/Feed 与腾讯视频/广告,绝对数值不可横比。
被剔除的近似候选(记录以防门槛放水):WHALE(2607.17017, Meta)虽然也做"非序列特征交互分支 query 序列分支"的跨分支注意力且未被引用,但其 root cause 是"两种可扩展范式各自覆盖不全、需联合 scaling",且序列侧完整保留 HSTU 注意力,并不攻击二次复杂度,与本文的效率动机实质偏离;IAT(2604.08933, ByteDance)压缩的是历史训练样本、root cause 是手工特征的信息瓶颈,压缩轴与本文的序列长度轴不同;SIF(2604.15650, Meituan)用离线分层量化把 token 从 item 级抬到 sample 级,解决的是序列 token 的语义粒度而非注意力开销;HPGR(2603.00980)走的是 Preference-Guided 稀疏注意力路线,正是本文在 related work 中明确区分开的那一支;UxSID(2605.09040, Kuaishou)靠 (UID, SID) 哈希查表做 $O(1)$ 在线推理,属缓存/检索路径而非骨干架构重构。
讨论与局限性¶
核心贡献与值得借鉴的设计。 CCFormer 最值得借鉴的是它把"效果"与"效率"两个目标分派给两个不同的模块,并用消融把这个分工验证得很干净:Table 5 显示移除 token mixing 时效果几乎回落到 HSTU($\Delta$AUC 1.01% → 0.25%)但加速比反而升到 2.40×,而移除序列压缩时效果基本不变(AUC 甚至 77.96% 略高于完整版 77.94%)但加速比从 2.21× 崩到 1.29×。这种"一个组件管效果、一个组件管效率"的清晰正交性,在工业架构论文里并不常见,也让读者可以按自己的资源约束选择性移植:算力紧张就上压缩,效果优先就上 token mixing。
第二个值得借鉴的点是用语义域划分天然地获得"短 query 集"。很多长序列高效架构需要人工构造一段压缩序列或一组可学习的 latent token 来当 query(HyFormer 的 Global Token、SlimPer 的 KB、LONGER 的 $S_{\text{short}}$),CCFormer 直接指出 user profile 与 target item 本来就是数量远小于 $L_s$ 的紧凑 token 集,用它们当 query 既省掉额外构造,又让每条注意力流有明确的语义解释(偏好检索 / 相关性匹配 / 兼容性建模)。
第三,"压缩但保留可达性"这个折衷值得注意。传统压缩与截断的问题都是不可逆地丢信息,而 Conv1D 分层下采样通过感受野扩张保证深层 token 仍"看得到"全序列的每个位置,只是分辨率下降。这与视觉领域 CNN 的多尺度金字塔是同一套直觉,但用在推荐长序列上给出了"$0.5$k token 打平 HSTU 的 $2$k token"这样很强的实证。
局限与争议。
- 消融数据自相矛盾之处未被讨论。Table 5 里"移除序列压缩"与"token mixing 换成自注意力"两个变体的 AUC 都是 77.96%,高于完整 CCFormer 的 77.94%。也就是说在 AUC 这个指标上,完整版并不是最优的,两个核心组件其实各自带来了轻微的 AUC 损失,只是 GAUC 更好。论文只强调"轻微精度损失换大幅效率提升",但没有解释为什么 AUC 与 GAUC 在这里出现方向不一致,也没有给出显著性检验(离线消融未报方差,而 Table 2 的公开数据集实验是报了 ±std 的)。
- 效果增量在工业数据集上其实很小。Table 3 中 CCFormer 相对最强基线 STCA 的绝对增益是 AUC +0.21 点、GAUC +0.41 点。工业 CTR 场景下这确实可能对应可观收入,但论文没有说明离线指标的 run-to-run 波动,因而难以判断这个增量的稳健性。真正硬的证据是线上 A/B(两周、每组约 100 万用户、$p<0.05$),这部分做得扎实。
- A/B 的对照组表述含糊。论文说线上基线是"长期迭代优化过的 DLRM 与一个已部署的 HSTU 模型",但没有明确 Table 6 的各项 lift 究竟是相对 DLRM 还是相对 HSTU,也没有分别给出。考虑到 3.57% CTR 这样的量级在成熟场景中相当大,更可能是相对 DLRM 而非相对 HSTU,但论文未澄清。
- 公开数据集实验与工业实验的结论强度不匹配。Taobao/KuaiRec 上序列只截断到 200,而 CCFormer 的核心卖点(分层压缩 + 长序列 token mixing)在短序列下本就难以体现优势;真正支撑"长序列"论断的只有工业数据集($L_s = 1000$,scaling 实验到 2000)。因此公开 benchmark 上 13.93% / 10.36% 的 $\Delta$AUC 更多反映的是架构整体的表达力,而非长序列效率设计的价值。
- 缺少推理侧延迟数据。论文报告了 training speedup(2.21×)、GFLOPs/Sample、以及峰值 QPS +30%,但没有给出端到端推理延迟(P99)的对比。对工业排序而言延迟是硬约束,而"计算复杂度高出 20× 却 QPS +30%"这句话本身也需要更多上下文才能解读(20× 是相对 DLRM 基线而非 HSTU)。
- 超参敏感性实验的信息量偏低。Figure 6 中卷积核 $k$ 从 2 到 7 只让 AUC 从 77.92% 变到 77.95%,$m$/$n$ 各组合波动也很小。作者把这解读为"鲁棒、无需精调",但也可以反过来解读为这些超参在当前设置下基本不起作用,模型收益主要来自架构本身而非这些旋钮。
- 搜索场景的显式交叉特征保护缺失。如与 TMallGS 的对比一节所述,深层 Transformer 作为低通滤波器会平滑掉高频显式匹配信号。CCFormer 部署在推荐与广告场景,暂时没有暴露这个问题,但若要迁移到搜索类场景,可能需要补上类似 FiLM 后融合的机制。
工业落地价值。 这篇论文的部署证据是完整的:混合精度(显存 -35%)、INT8 对称量化 + double hashing(稀疏参数分别 -70% / -50%)、候选并行预测(峰值 QPS +30%),配合两周双场景 A/B(视频推荐 CTR +3.57%、Page View +3.86%;广告排序 Ad revenue +1.71%)与全量部署后收益保持稳定的说明。对于正在从 DLRM 向 Transformer 骨干迁移、且被长序列成本卡住的团队,CCFormer 的分层压缩模块(Conv1D,$k=3$、$s=2$)是一个改动面小、加速比明确(2.21× → 移除后 1.29×)、且几乎不损失离线指标的可移植组件。
未来工作。 作者计划把 CCFormer 扩展到终身尺度(lifelong-scale)序列,并探索面向召回阶段的压缩感知建模。