SlimPer:把个性化排序重构为对定长知识库的迭代精炼¶
SlimPer 是 Meta Platforms(Instagram / MRS)2026 年 7 月放出的工业推荐排序工作(arXiv:2607.12281v1 [cs.IR],2026-07-14,通讯作者 Xianjie Chen,[email protected])。它对近两年"把 Transformer 搬进推荐系统"的主流做了一次范式层面的反叛:作者论证生成式 Transformer 的"逐 token 自回归预测"前提与判别式排序任务根本错配——排序对每个 <user, item> 对只产出一组相关性分数,没有 token 级监督,因此没有理由维护随序列长度膨胀的大型中间张量。SlimPer 把排序重构为对一个紧凑、统一的 <user, item> 知识库(Knowledge Base,KB)做迭代精炼:每一层选择性地查询原始多模态用户侧 token、计算显式相关性匹配分、再精炼 KB,全程 $O(N)$ 每层开销、定长中间表示。由此模型深度与用户历史长度解耦——加深网络不再带来成比例的算力/显存增长;配合 request-only optimization(ROO)在一次请求内所有候选间共享同一份用户侧 token,进一步压缩显存。SlimPer 在 Instagram Reels 与 Feed 两大排序场景全量部署,在提升用户互动的同时精简了系统、并能有效建模 10k+ 细粒度用户历史事件。
一、研究动机与背景¶
1.1 推荐系统里的 "Transformer 错配"¶
判别式个性化模型(即排序模型,ranking model)塑造着用户每天接触的内容流、视频推荐与商品推荐。这类模型要在生产成本约束下、实时地按用户偏好对候选物品排序。工业推荐模型通常消费多模态输入特征,每种模态在算力成本与细粒度信息捕捉之间提供不同权衡(见 Table 1):
| Modality | Input Type | Representative Signals |
|---|---|---|
| Sparse | 高基数类别 ID | 汇总的用户兴趣(如 top engaged creators / categories),提供显著但粗粒度的偏好信号 |
| Sequence | 结构化的用户互动记录 | 细粒度行为信号,捕捉单次用户动作(消费内容、停留时长、互动类型、时间戳),提供高分辨率时序信息 |
| Dense | 连续数值 | 上下文与实时信号,如用户级统计(CTR)、物品质量指标(reshare rate)、上下文属性(time / device) |
传统做法是不同模态各自被专门组件处理、再浅层拼接(late fusion)。近年受 LLM 中 Transformer 成功的启发,把类 Transformer 架构搬进推荐成了热门方向:或用于建模变长序列特征(如 HSTU、Interformer),或用于统一各模态建模(如 OneTrans、HHFT、RankMixer)。
但作者指出这一趋势忽略了推荐系统与 LLM 的一个结构性差异:在 LLM 里,逐位置的自回归监督要求全程维护完整的 token 级表示,算力被摊薄到每个 token 位置的预测上;而推荐系统没有这种需求——它们为判别式预测训练,对每个 <user, item> 对只产出一组相关性分数,没有 token 级自回归损失。结果类 Transformer 设计面临一个本不必要的两难:要么在层间大力压缩中间表示(信息损失),要么保留大型中间张量(随 token 数增长带来可观的显存与算力开销)。这个两难不是推荐本身固有的,而是借用了不适用的架构前提所致。
1.2 新范式:对知识库的迭代精炼¶
作者主张,判别式推荐的正确抽象不是序列建模,而是对一个紧凑用户-物品知识库的迭代精炼(iterative refinement):模型维护一份定长的 <user, item> 相关性表示,通过选择性地查询原始多模态证据来逐步精炼它,不物化随输入序列长度增长的大型中间张量。
基于此提出 SlimPer(见 Figure 1)。它把个性化排序表述为对统一定长 <user, item> 知识库的迭代精炼过程,每层执行三步:
1. Selection(选择):all-modality-aware 的 QKV attention,以当前 KB 为条件查询完整的原始用户侧 token 集;
2. Matching(匹配):在检索到的证据与多面模板(multifaceted templates)之间计算显式点积相关性分数;
3. Refinement(精炼):用匹配到的证据更新知识库。
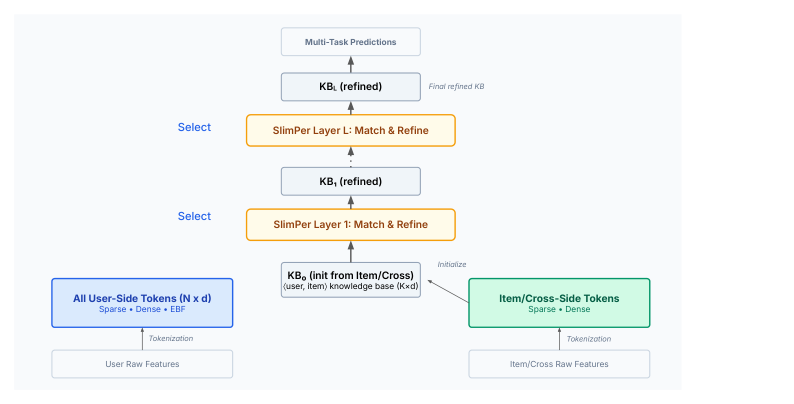
这个设计从根源上化解了 Transformer 两难:加深模型以更好理解 <user, item> 对,不再需要维护随用户侧 token 数膨胀的中间张量(即 Slim);同时模型质量得以保留,因为每一层都保有对完整原始用户侧信息的直接访问;而且知识库把全部学习容量聚焦到 <user, item> 相关性上,相比必须维护全 token 级表示的架构更"聚焦"(即 Smart)。此外,受 HSTU 中 request-only optimization(ROO)的启发,SlimPer 显式区分用户侧与非用户侧特征,并把 ROO 扩展到所有用户侧特征模态——用户侧 token 每请求批只计算一次、在同请求所有候选间共享。
1.3 主要贡献¶
- 迭代精炼作为个性化排序的新范式:把判别式推荐表述为对紧凑
<user, item>知识库的迭代精炼,脱离主流的 transformer-mimicking 范式。每一步精炼都直接查询全部原始多模态 token,从而把模型深度与输入序列长度解耦,实现 $O(N)$ 每层复杂度 + 定长中间表示,有效化解类 Transformer 架构在长历史上的效率-质量权衡。 - 统一的多模态架构 + 推荐中心的效率:SlimPer 仅用标准神经网络积木(MLP、QKV attention、线性投影、RMSNorm)就为 sparse / dense / sequence 特征提供统一骨干。并把 ROO awareness 扩展到全部用户侧模态,减少冗余算力与显存。
- 面向真实推荐系统的内在可解释性:每层的 QKV attention 直接把推荐结果关联到具体的用户互动历史事件,让模型行为更易于解释与调试。
二、核心方法 / 模型架构¶
2.1 问题形式化¶
考虑一次推荐请求,含一个用户 $u$ 和一组待排序候选物品 $\mathcal{I}=\{i_1,i_2,\dots,i_C\}$。输入由多种特征模态构成:Sparse 特征集 $\mathbf{S}$、Dense 特征 $\mathbf{D}$、以及用户互动历史事件序列 $\mathbf{E}$。目标是学习一个打分函数
$$f(u, i; \mathbf{S}, \mathbf{D}, \mathbf{E}) \to \mathbb{R}^{\tau}$$
它通过把候选 $i$ 与用户潜在兴趣表示做匹配来估计相关性。在多任务设定下,该函数同时预测 $\tau$ 个代表不同互动信号的目标。
2.2 记号与预备¶
作者把模型限制到一组最小积木:
- MLP:带 SiLU 激活的多层感知机;
- Segment-wise Linear Projection $\mathcal{L}$:段级线性投影,$\beta=\mathcal{L}(\alpha)=\rho\alpha$,$\rho\in\mathbb{R}^{L_{out}\times L_{in}}$(附录 B eq.13);
- All-modality
<user, item>知识库 $\mathcal{X}$:初始化为 $\mathcal{X}^0=\mathcal{L}(\mathbf{S}_{in})$(来自非用户侧输入 token,通常是 item 侧 / cross 侧 sparse 特征)。KB 形状 $\mathcal{X}^k\in\mathbb{R}^{K\times d}$,$K$ 为 KB 槽位数、$d$ 为嵌入维度。各层 KB 尺寸原则上可不同,实验中固定 $K=64$。
2.3 整体架构¶
一个 SlimPer 模型 = 多模态 tokenization + 堆叠的 SlimPer 层。模型吃原始 sparse / dense 特征 + 用户历史事件序列,先各自 tokenize 成一组多头 $d$ 维嵌入,然后每层跑 Select-Match-Refine 循环,用标准 QKV attention 做 all-modality-aware 的 token 选择与显式相关性匹配。
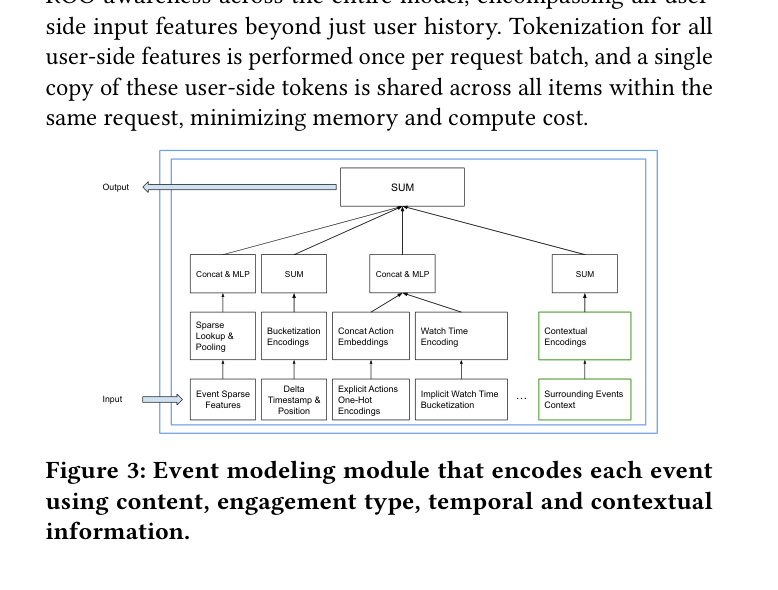
模型通过显式解耦用户侧与物品侧特征,天然内建 ROO awareness。历史上 ROO 与质量-效率权衡挂钩(如早期排序的双塔),或被局限于用户历史建模;SlimPer 把 ROO awareness 扩展到整个模型的所有用户侧输入特征:用户侧特征的 tokenization 每请求批只做一次,一份用户侧 token 副本在同请求所有候选间共享,最小化显存与算力成本。
2.4 Tokenization 模块与事件建模¶
所有原始输入特征被转换为模态特定的 token:sparse 特征经 embedding pooling 变成定长向量;每个用户历史事件被编码成 $1\times d$ 的 token(融合内容、互动类型、时序与上下文信息);dense 特征拼接后经 MLP 投影。
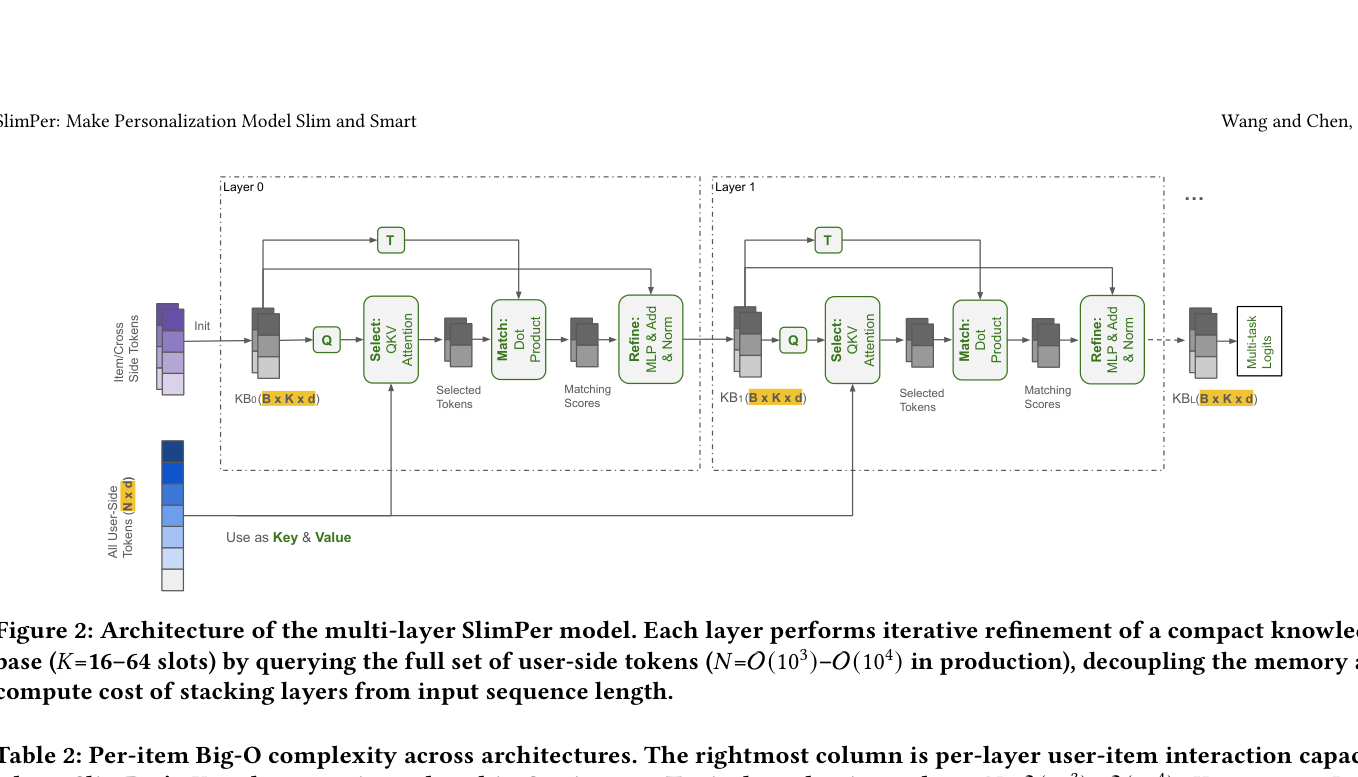
事件 token 的上下文编码(Contextual Encoding):直觉是用户行为常呈局部连续性——一个事件与其邻近事件一起解读时信息量最大。为捕捉这种局部上下文关系,引入额外的上下文编码 $\mathbf{e}^{(t)}_{context}$,显式汇总每个事件 token 周围的邻域信息(Figure 3 绿框):
$$\mathbf{e}^{(t)}_{context} = \Psi_{context}(x_{t-w+1},\dots,x_t) \tag{1}$$
其中 $\Psi_{context}$ 是编码函数,$w$ 是窗口大小,$x_t$ 是位置 $t$ 的用户历史事件信息。作者探索了 CNN、sliding-window attention 及二者组合作为 $\Psi_{context}$,各变体性能相近(消融见 §4.5.1)。
2.5 SlimPer 层:Select、Match、Refine¶
每层遵循三步迭代精炼。Step 1、2 联合处理所有模态的 token,用 QKV attention 检索相关的用户侧 token 并计算显式相关性匹配分;Step 3 用匹配证据精炼 KB。这一设计把算力与显存从"用户侧 token 之间的两两交互"重新分配到"学习判别式用户-物品交互"。Table 2 对比了 SlimPer 与代表性类 Transformer 架构的算力/显存分配。
Table 2. Per-item Big-O 复杂度对比(最右列是每层用户-物品交互容量;典型生产值 $N=O(10^3)$–$O(10^4)$,$K=64$,$q=16$,$B\approx5$ 训练 / $O(10^2)$ 推理):
| Model | Tokenization Cost (per item) | Stacked Layers Cost (per item) | User-Item Interaction Capacity |
|---|---|---|---|
| Conventional DLRM (无 ROO、无序列) | Mem $O(N)$ / Comp $O(N)$ | Mem $O(L\cdot 64)$ / Comp $O(L\cdot N\cdot 16)$ | $O(L\cdot N\cdot 64)$ |
| ROO-aware Transformer (如 HSTU) | Mem $O(N/B)$ / Comp $O(N/B)$ | Mem $O(L\cdot N/B)$ / Comp $O(L\cdot(N+1)^2/B)$ | $O(L\cdot N)$ |
| Non-ROO-aware Transformer (如 OneTrans) | Mem $O(N)$ / Comp $O(N)$ | Mem $O(L\cdot N)$ / Comp $O(L\cdot N^2)$ | $O(L\cdot N)$ |
| Sub-quadratic Transformer (线性/滑窗 attention) | Mem $O(N)$ / Comp $O(N)$ | Mem $O(L\cdot N)$ / Comp $O(L\cdot N)$ | $O(L\cdot N)$ |
| SlimPer (ROO-aware 全模态) | Mem $O(N/B)$ / Comp $O(N/B)$ | Mem $O(L\cdot K)$ / Comp $O(L\cdot N\cdot q)$ | $O(L\cdot N\cdot K)$ |
关键读法:SlimPer 是唯一把 stacked-layers 显存压到 $O(L\cdot K)$(与序列长度 $N$ 无关)、同时把用户-物品交互容量做到 $O(L\cdot N\cdot K)$(比类 Transformer 的 $O(L\cdot N)$ 高 $K$ 倍,与 DLRM 齐平)的架构。
Step 1: 经 All-Modality-Aware Attention 做 Token 选择¶
以当前 KB $\mathcal{X}^k$ 为条件,查询向量 $\mathbf{Q}$ 由 $\mathcal{X}^k$ 经段级线性投影得到:
$$\mathbf{Q} = \mathcal{L}(\mathcal{X}^k)\in\mathbb{R}^{q\times d} \tag{2}$$
$\mathbf{Q}$ 捕捉模型想从用户侧 token 检索的信息。所有用户侧输入 token 作为 keys $\mathbf{K}$ 与 values $\mathbf{V}$(可选线性投影),组织成两个 key-value 集:定长 sparse 特征、变长 sequence 特征。QKV attention 应用到两个集合,聚合对应 value 产出 attention 输出 $\mathbf{R}$:
$$\mathbf{R} = \Phi(\mathbf{Q},\mathbf{K})\mathbf{V} \tag{3}$$
attention kernel $\Phi$ 是模态相关的——对定长 sparse token 用轻量参数化 kernel(MLP 实现,因 token 数恒定);对变长用户历史 sequence 用非参标准 scaled dot-product kernel;dense 特征(维度小,约 ~1000 floats)不过 attention kernel,直接在每层传播并融合:
$$\Phi(\mathbf{Q},\mathbf{K}) = \begin{cases} \mathrm{MLP}(\mathrm{Concat}(\mathcal{L}(\mathbf{Q}),\mathcal{L}(\mathbf{K}))), & \text{sparse features} \\ \mathrm{Softmax}(\gamma\, QK^\top), & \text{sequence features} \end{cases} \tag{4}$$
其中 $\gamma$ 是 softmax 温度。分别应用到两条用户侧 token 流得到两个表示:
$$\mathbf{R}_s = \Phi_s(\mathbf{Q},\mathbf{S})\,\mathbf{S},\qquad \mathbf{R}_s\in\mathbb{R}^{q\times d} \tag{5}$$ $$\mathbf{R}_e = \Phi_e(\mathbf{Q},\mathbf{E})\,\mathbf{E},\qquad \mathbf{R}_e\in\mathbb{R}^{q\times d} \tag{6}$$
实现中原始 sparse token $\mathbf{S}$ 与 sequence token $\mathbf{E}$ 直接用作 K/V(额外线性投影实测无收益,为效率省去)。由于 $\mathbf{Q}$ 源自统一 KB $\mathcal{X}^k$,它融合了所有模态信息,因此 sparse 信息能影响对 sequence 特征的 token 选择,反之亦然——这就是 all-modality-aware attention。
Step 2: 显式多面点积相关性匹配¶
从统一 KB 经线性变换派生一组多面模板 $\mathbf{T}\in\mathbb{R}^{t\times d}$:
$$\mathbf{T} = \mathcal{L}(\mathcal{X}^k),\qquad \mathbf{T}\in\mathbb{R}^{t\times d} \tag{7}$$
相关性匹配分数通过模板与各流 attention 输出之间的显式点积计算:
$$\lambda_s = \mathrm{DotProduct}(\mathbf{R}_s,\mathbf{T}),\qquad \lambda_s\in\mathbb{R}^{q\times t} \tag{8}$$ $$\lambda_e = \mathrm{DotProduct}(\mathbf{R}_e,\mathbf{T}),\qquad \lambda_e\in\mathbb{R}^{q\times t} \tag{9}$$
Step 3: 精炼知识库¶
相关性分数被归一化并经 $\mathrm{MLP}_\mu$ 变换以精炼 KB,产出下一层表示 $\mathcal{X}^{k+1}$;dense token $\mathbf{D}$ 被拼接进来,把 dense 特征信息注入 KB 更新:
$$\mathcal{X}^{k+1} = \mathcal{X}^k + \mathrm{MLP}_\mu\Big(\mathrm{Concat}\big(\mathrm{RMSNorm}(\lambda_s),\mathrm{RMSNorm}(\lambda_e),\mathcal{L}(\mathcal{X}^k),\mathbf{D}\big)\Big) \tag{10}$$
每层可选地为每个预测任务输出一个 task embedding;跨层的 task embedding 求和后经最终线性投影产出 task logits:
$$\mathbf{P}_p^k = \mathrm{MLP}_p(\mathcal{L}(\mathcal{X}^k)) \tag{11}$$
其中 $p\in[1,\tau]$ 索引预测任务。
2.6 通过堆叠 SlimPer 层实现迭代个性化¶
SlimPer 天然可堆叠:多个 SlimPer 层顺序组合,各自对共享 KB $\mathcal{X}$ 执行一次 Select-Match-Refine。生产环境典型堆叠 5 到 10 层。 直觉是更深的层受益于更早层累积的证据——例如早期层收集与目标物品相关的广泛证据(用户历史上是否互动过狗视频),这些累积证据条件化后续层,后者聚焦更细的信号(近期是否频繁划走狗视频,表明兴趣漂移),从而判断早期偏好该强化还是折扣。
这种迭代精炼能力由两条架构性质使能:第一,每层直接 attend 到全部原始输入 token(跨所有模态),保留细粒度信号而不承担维护大型中间张量的显存开销——不同于类 Transformer 架构逐层把信息压进中间隐状态,SlimPer 在每个深度做无损的跨模态、跨侧(user↔item)融合;第二,KB 尺寸在精炼过程中恒定,加深不需要中间显存随输入长度膨胀,因此即便用户历史很长也能实际堆叠很多精炼层。
2.7 信息论视角的合理性¶
定长 KB 看似牺牲信息,但分析显示恰相反:SlimPer 的瓶颈把容量重定向到任务相关信号,而非丢弃它们。
- 瓶颈是容量充裕的:推荐任务对每个
<user, item>对只需 $\tau$ 个标量预测,故目标 $Y$ 与输入 $X$ 之间的互信息被 $H(Y)\le\tau$ bits 界定——远低于 $K\times d$ 知识库的表征容量。而 SlimPer 达到 $O(L\cdot N\cdot K)$ 的用户-物品交互容量,与 DLRM 齐平、比类 Transformer 的 $O(L\cdot N)$ 高 $K$ 倍。差异源于:Transformer 把大多数 $O(N^2)$ 算力花在不直接服务相关性估计的用户侧 token 两两交互上,而 SlimPer 把每层 $K\times N$ 交互全导向 KB-to-token 的相关性匹配。这个容量论证独立于 attention 是否二次——线性/滑窗 attention 虽把每层算力降到 $O(N)$,但仍 (i) 逐层传播 $N$ 尺寸 token 级中间张量、显存停在 $O(L\cdot N)$ 而非 $O(L\cdot K)$,(ii) 把交互容量花在用户侧 token 混合上、用户-物品交互容量仍是 $O(L\cdot N)$、比 SlimPer 低 $K$ 倍。因此作者预期 SlimPer 相对高效-attention baseline 保有质量优势,而不仅是效率优势。 - 迭代访问阻止不可逆损失:标准瓶颈架构受数据处理不等式约束——对 Markov 链 $X\to T\to Y$,压缩时丢的信息不可恢复。SlimPer 打破该链:每层直接 cross-attend 进原始输入 token $X$,而不仅是上一层的压缩表示。用信息瓶颈框架的话说,SlimPer 做的是迭代压缩:每层提取额外的任务相关互信息 $I(\mathcal{X}^k;Y)$,同时原始证据始终可用以纠正早期遗漏——附录 E 的 attention 热图佐证:后续层逐步把注意力从广泛历史上下文收窄到最相关的近期信号。
三、实验¶
3.1 实验设置¶
- 数据集:Instagram 最终阶段排序模型,使用与现有生产模型相同的训练/评估数据(工业内部数据,不含公开学术 benchmark)。
- 评估指标:Normalized Entropy(NE)——标准离线指标,与 A/B 结果方向一致。NE 把模型的二元交叉熵损失(BCEloss)除以一个"预测全局标签均值 $p_k$"的朴素基线的 BCEloss 来归一化。NE 改善约 0.03% 即视为经验显著。
$$\mathrm{NE}_k = \frac{\mathrm{BCEloss}(\hat{y}^{(k)}, y^{(k)})}{-\big[p_k\ln(p_k) + (1-p_k)\ln(1-p_k)\big]} \tag{12}$$
- Baseline:Instagram 现有模型——一个 late-fusion 架构,用 HSTU 建模变长用户互动历史 + Wukong 建模定长 sparse/dense 特征,两者拼接。这是 Instagram 主要场景的最终阶段排序、代表成熟基线。为公平对比,用相同训练/评估日期区间报告相对 NE 改善,其余实验设置(优化器配置、特征集等)跨模型保持一致。
3.2 离线性能¶
在 Reels 与 Feed 两个场景对比 SlimPer 与 baseline,主结果见 Table 3。三个跨场景一致的观察:(1) SlimPer 在所有任务上取得一致 NE 改善;(2) 同序列长度下,SlimPer 同时拿到 NE 赢面与 QPS 赢面,说明既提质又提效;(3) 有明显 scaling 趋势:NE 赢面随序列长度增长而放大——例如 Feed reshare 预测,NE 改善从 1k 序列的 −0.49% 增到 4k 的 −0.94%(接近 2× 的相对质量增益),代价是 16% QPS 回退。
Table 3. SlimPer vs. baseline(NE 与 QPS 是相对变化 %,Memory 是平均使用量的绝对变化 %,均相对各场景 baseline;NE/Memory 越低越好、QPS 越高越好):
| Surface | Model Config | NE reshare | NE skip | NE like | NE comment | NE follow | NE save | QPS (%) | Memory Diff (%) |
|---|---|---|---|---|---|---|---|---|---|
| Reels | Baseline w/ 2k events | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| Reels | SlimPer w/ 2k events | −0.51 | −0.31 | −0.23 | −0.41 | −0.35 | −0.35 | +11.0 | −9.32 |
| Reels | SlimPer w/ 5k events | −0.80 | −0.57 | −0.49 | −0.64 | −0.53 | −0.62 | −10.0 | +4.59 |
| Feed | Baseline w/ 1k events | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| Feed | SlimPer w/ 1k events | −0.49 | −0.28 | −0.54 | −0.52 | −0.71 | −0.62 | +12.5 | −18.12 |
| Feed | SlimPer w/ 4k events | −0.94 | −0.52 | −0.91 | −0.94 | −1.00 | −1.05 | −16.07 | +2.04 |
分析:在匹配序列长度(Reels 2k / Feed 1k)下,SlimPer 同时给出 NE 赢面 + QPS 提升(+11%~+12.5%)+ 显存下降(−9%~−18%),三赢;而把序列拉长(Reels 5k / Feed 4k)会用一定 QPS/显存回退换取更大的 NE 赢面。这些经验发现与 Table 2 的 Big-O 分析一致:SlimPer 的 linear-in-$N$ 算力复杂度与 $O(L\cdot K\cdot d)$ 显存足迹,直接解释了相对二次成本 baseline 观察到的 11%+ QPS 提升与 9–18% 显存下降;因为成本下降源于"用定长 KB 精炼替代全序列自注意力",它可推广到任何用二次自注意力处理全 token 序列的类 Transformer 方法。
3.3 A/B 测试性能¶
作者上线了 Reels 的 SlimPer w/ 5k events 与 Feed 的 SlimPer w/ 4k events。经预测/回测后全量上线两个场景,取得跨多个主要互动指标的统计显著增益,聚合 topline 影响约为一次典型统计显著上线的 10×(相比 2025 年建模改动是显著提升)。此外 SlimPer 对生态护栏指标(integrity、diversity、recency)无回退,训练与推理 GPU 容量维持大致中性——确认离线观察到的效率增益能落到真实 serving。作者提到 2026 年还上线了扩展到 10k+ events 的 SlimPer 变体,在 Meta 多个产品场景取得重大互动增益。
3.4 Scaling 与效率分析¶
Table 2 的 Big-O 预测 SlimPer 的 $O(K\cdot N)$ 每层复杂度应随序列增长对二次 baseline 拉开优势。用 Reels 模型作代表跨不同序列长度对比 baseline(late-fusion HSTU + Wukong),结果见 Figure 4。
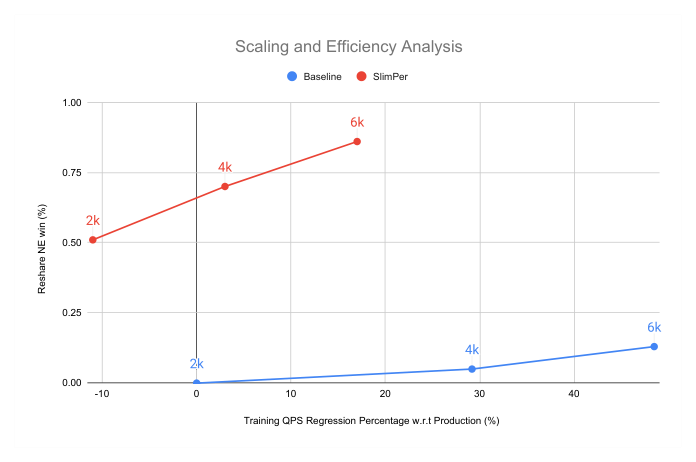
主要发现:匹配 2k 长度时,SlimPer 以 −0.51% NE(reshare)超过 baseline,同时更高吞吐(+11% QPS)+ 更低显存。增益随序列长度复合:6k 时 SlimPer 达 −0.86% NE 且 QPS 回退 <20%,而 baseline 仅得 −0.13% NE 却损失 48% QPS。SlimPer 的 NE 随紧凑 KB 吸收更丰富长时信号而单调改善,而二次成本 baseline 在更长序列上收益递减。作者强调这些结果确认 SlimPer 的质量增益不是靠花更多算力,而是靠把算力更有效地分配到用户-物品相关性匹配上——$O(K\cdot N)$ 每层成本实测转化为 8–25× 更少 FLOPs(附录 E),且优势随输入长度超线性增长。显存效率上,观察到的 9–18% 显存下降源于两个互补机制:定长 KB 替代 $O(N)$ 尺寸中间张量、ROO-aware 设计在一次请求内所有候选间共享一份用户侧 token。
3.5 消融实验¶
§4.5.1 上下文编码的效果:对比三种策略——(1) 无上下文(独立编码)、(2) event-type context(编码周边动作,如 like/reshare/long watch)、(3) full context(event-type + event content 联合)。引入上下文编码带来约 −0.15% NE 改善;且增益主要来自单独编码 event type,加上 event content 只有边际额外收益(<0.02% NE)。这说明用户行为模式(做了什么动作)比其互动的具体物品更有信息量——凸显与语言建模的重要区别(后者是内容依赖决定意义)。
§4.5.2 知识库尺寸与模型深度的效果:
Table 6(KB 尺寸消融,相对 $K=64$ baseline):
| $(K, q, t)$ | NE (%) | QPS (%) | Mem Diff (%) |
|---|---|---|---|
| (64, 16, 32) | 0.0 | 0.0 | 0.0 |
| (4, 1, 2) | +1.2 | +23.2 | −9.53 |
| (8, 2, 4) | +0.53 | +21.2 | −8.19 |
| (16, 4, 8) | +0.36 | +17.8 | −7.43 |
| (32, 8, 16) | +0.18 | +4.25 | −1.31 |
Table 7(SlimPer 层数消融,相对 7 层 baseline):
| Layer | NE (%) | QPS (%) | Mem Diff (%) |
|---|---|---|---|
| 7 | 0.0 | 0.0 | 0.0 |
| 3 | +0.32 | +21 | −8.60 |
| 5 | +0.14 | +8.8 | −5.50 |
| 9 | −0.12 | −7.16 | +4.92 |
分析:$K=64$ 提供质量-效率的良好平衡;把 $K$ 降到 4 可换 +23.2% QPS 但 NE 恶化 +1.2%,确认 KB 作为有效信息瓶颈的角色(更小的瓶颈=更快但更差)。深度上,7 层给出强性能,增益一直延续到 9 层(−0.12% NE)但成本适度上升——是典型的 depth-vs-cost 权衡。
3.6 模型预测的可解释性¶
SlimPer 的 attention 机制能把推荐直接归因到具体用户历史事件。对给定请求,模型产出候选物品与 sequence token 间的 attention 分数,允许从业者识别对每个预测影响最大的 top-$k$ 历史互动。抽检分析确认 attention 权重与排序输出对齐(高匹配保真度)。附录 E 的跨层 attention 热图显示:最低层广泛 attend 到前 4k 序列索引(捕捉粗粒度历史上下文),中间层则聚焦到前几百个索引(更窄、更近期的互动子集)——直观印证了"迭代精炼逐步收窄注意力"的机制。
关键超参数(附录 A,Table 4):所有模型训练 1 个 epoch、用 Shampoo 优化器、学习率 0.05,SlimPer 与 baseline 优化器设置完全一致。
| Hyperparameter | Feed | Reels |
|---|---|---|
| SlimPer 层数 $L$ | 5 | 7 |
| 知识库尺寸 $K$ | 64 | 64 |
| 隐藏维度 $d$ | 256 | 256 |
| Query 槽位 $q$ | 16 | 16 |
| Template 槽位 $t$ | 32 | 32 |
四、核心贡献总结¶
SlimPer 的核心洞见是:判别式排序不需要生成式 Transformer 的逐 token 表示,硬套只会浪费算力/显存。它把排序重构为"对定长知识库的迭代精炼",通过让每层 cross-attend 进完整原始用户侧 token(而非上一层的压缩隐状态),在 $O(N)$ 每层成本 + 定长中间表示下,把模型深度与用户历史长度解耦,同时把交互容量导向 <user, item> 相关性匹配($O(L\cdot N\cdot K)$,比类 Transformer 高 $K$ 倍)。配合把 ROO 扩展到全部用户侧模态,在 Instagram Reels/Feed 全量部署,聚合 topline 约为典型上线的 10×,且效率-质量随序列长度复合改善。
五、与已归档相关工作的对比¶
SlimPer 的语义指纹——问题:类 Transformer 的工业排序把大量算力/显存花在"随用户历史长度膨胀的中间张量 + 用户侧 token 两两自注意力"上,这既不服务判别式相关性又限制了长历史下的深度扩展;解法:用一组定长 latent(KB / interest anchors)反复 cross-attend 进原始用户侧 token、把深度与序列长度解耦,并在请求内跨候选共享用户侧计算(ROO)。文档库里存在多篇问题+解法双同构的独立/并发工作。
UxSID UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence (Kuaishou, 2026-05-09)¶
关系:独立并发(SlimPer 未引用 UxSID,两者殊途同归)· 已加载对方精读
- 共同关注的问题:都盯着"超长用户历史(10k 事件)建模的在线成本随序列长度膨胀"这一 root cause,都要在轻量在线计算下把序列长度扩到 10k+ 而不炸显存/延迟,都强调 target-aware(用户-物品相关性)不能被牺牲。
- 相近的技术骨架:两者骨干都是一组定长 latent 通过 cross-attention 从原始行为序列里聚合信号。UxSID 的 IAIC 模块用 $K$ 个可学习 interest anchors 作 query、对原始序列 $\mathbf{E}$ 做 cross-attention(其 eq.3 与 SlimPer 的 Select 步 eq.5/6 结构几乎一致,都是"learnable/KB-derived query × 原始 token 的 K,V"),再用 Per-token FFN + 正交损失让 anchors 互补——SlimPer 的 KB 也是定长($K=64$)、也靠 MLP kernel + 多面模板做区分。
- 本文的差异与推进:UxSID 是 offline 压缩 + online $O(1)$ 哈希点查(用 target SID 作语义键从 Embedding Server 拉 memory),latent 的 cross-attention 只做一次、且要靠 RQ-VAE/SID 语义键驱动;SlimPer 是完全 online 端到端的统一骨干,把同样的"anchor/KB cross-attend 原始 token"做成每层迭代的 Select-Match-Refine、堆叠 5-10 层逐步精炼,且统一 sparse/dense/sequence 三模态(UxSID 主要处理 sequence 侧、作为一路 feature 拼进下游 ranking MLP)。可以说 UxSID 把定长 latent 用作"离线预算内的一次性长序列压缩器",SlimPer 把它用作"在线全模型的迭代精炼中枢"。
- 可比的方法/实验差异:两者都报告序列 1k→10k 的稳定 scaling 行为与工业 A/B 显著收益(UxSID:快手广告 Revenue +0.337%、延迟仅 +0.16ms;SlimPer:Instagram 聚合 ~10× 典型上线、QPS/显存改善)。UxSID 有公开 benchmark(XLong/KuaiRec-Big),SlimPer 全用内部数据。
CMSL CMSL: Constructive Multi-Sequence Learning for Recommendation (Meta MRS, 2026-06-26)¶
关系:独立并发(同为 Meta,但 SlimPer 未引用 CMSL)· 已加载对方精读
- 共同关注的问题:都从"把用户历史当成 LLM 式单调 token 序列喂自注意力是错误类比"这一 root cause 出发——SlimPer 说错在"逐 token 自回归前提不适用判别式排序",CMSL 说错在"用户历史是嘈杂马赛克、硬塞一条序列导致 context pollution"。都是 Meta 工业排序、都用 NE 指标、都强调线性/次二次成本以让长历史在工业规模可行。
- 相近的技术骨架:两者每层都先用 cross-attention 把原始序列重组成一个更紧凑/更有条理的表示,再做后续计算,且都把这个重组做成逐层堆叠 block。SlimPer 每层 Select 步用 KB-derived query cross-attend 原始 token;CMSL 每 block 用 Multi-Sequence Construction 模块(cross-attention)把原始历史拆成 $K$ 条 intent-aware 隐序列。
- 本文的差异与推进:分道之处在"重组产物是什么"——CMSL 把历史拆成 $K$ 条连贯子序列、每条仍各自跑(线性时间近似 HSTU 的)自注意力、再 summarize/compress 回单序列;SlimPer 则彻底放弃对用户侧 token 跑自注意力,只让定长 KB 去 attend 它们、把交互容量全导向 KB-to-token 的相关性匹配。即 CMSL 是"净化并保留序列结构后继续序列建模",SlimPer 是"根本不做序列内自注意力、改成对 latent 的迭代精炼"。SlimPer 因此把显存压到 $O(L\cdot K)$(与 $N$ 无关),CMSL 的显存仍随序列 token 走。
- 可比的方法/实验差异:都在 Meta 数十亿日活数据上部署、跨多场景(CMSL 跨 5 surface 含 ranking+U2U retrieval;SlimPer 跨 Reels/Feed ranking),都报告 NE 改善。二者其实互补:CMSL 的"多序列去污染" + SlimPer 的"定长 KB 迭代精炼"攻击的是同一长历史痛点的两个侧面(前者去干扰、后者去冗余算力)。
HSTU HSTU (Meta, 2024-02)¶
关系:显式引用,且是 SlimPer 的直接 baseline 组件与 ROO 思想来源 · 未加载对方精读
SlimPer 的 baseline 正是 late-fusion 的 HSTU(建模用户历史)+ Wukong(建模定长特征) 混合体,SlimPer 的 request-only optimization(ROO)awareness 也直接借自 HSTU(HSTU 把 ROO 用于用户历史建模,SlimPer 把它扩展到全部用户侧模态)。原文 §4 报告 SlimPer 在匹配序列长度下相对该混合 baseline 取得 NE 赢面 + QPS/显存改善,并在 §5 论证:单独的 unified HSTU 表现还不如这个混合体,故混合体是更强的对比点。HSTU 属 $O(N^2)$ 二次自注意力(ROO-aware),在 Table 2 中交互容量 $O(L\cdot N)$、比 SlimPer 低 $K$ 倍。详细精读见 HSTU。
六、讨论与局限性¶
核心贡献与借鉴价值:SlimPer 最值得借鉴的是"任务前提决定架构前提"的方法论——它没有盲目跟随"Transformer 化推荐",而是回到判别式排序"只要一组相关性分数、无 token 级监督"的本质,据此推导出"定长 latent 迭代精炼 + 每层直连原始 token"的架构。这条 $O(K\cdot N)$ 每层 + $O(L\cdot K)$ 显存的路线,把"加深模型"与"序列变长"两件事在成本上解耦,是长历史工业排序一个干净且可复现(仅用 MLP/QKV/线性投影/RMSNorm 标准积木)的答案。信息论视角(瓶颈重定向容量而非丢信息、迭代访问打破数据处理不等式)也为"为什么定长瓶颈反而更好"给了有说服力的解释。
工业落地价值:全量部署 Instagram Reels/Feed,聚合 topline 约 10× 典型上线、生态护栏无回退、GPU 容量中性、并扩到 10k+ events。ROO 把用户侧 token 在候选间共享,是把离线效率增益真正落到 serving 的关键。
局限/争议(作者自陈): 1. 对比对象有限:只对比成熟的 HSTU+Wukong 混合 baseline,未直接对比近期 unified 架构(OneTrans / HHFT / RankMixer)。作者论证混合体已比单独 unified HSTU 更强、且跨组织的训练数据/特征/serving 约束使他社数字不可比,但缺横向 SOTA 对比仍是硬伤。不过 Table 2 的复杂度分析是通用的:任何对全序列做二次自注意力、或每候选维护 $N$ 尺寸中间张量/复制用户侧表示的架构,都面临 SlimPer 定长 ROO-aware KB 所化解的同一瓶颈。 2. 仅内部数据、难独立复现:全部实验在 Instagram 内部数据上,模型训到收敛所需的数据量在公开 benchmark 上不可得。作者以"提供详细超参(附录 A)+ 只用标准积木描述模型 + 相对明确 baseline 报告相对改善"来缓解,并认为足够让从业者在自有数据集上复现验证。
未来方向:迭代精炼范式可扩展到无固有顺序的证据源(跨场景互动信号、上游选择系统产出的候选);whole-model ROO-aware 设计利于部署到候选集更大的早期排序阶段(摊销收益更大);当前 matching/refinement 模块刻意轻量(点积匹配 + MLP 更新),探索更表达力的算子可能在保持 $O(N)$ 每层 + 定长显存的前提下带来额外质量增益。