CMSL:把用户历史从「被读取的序列」重构为「被构造的上下文」¶
CMSL(Constructive Multi-Sequence Learning)是 Meta(Meta MRS / Meta PyTorch / Meta FB Monetization 三个团队合著,13 位作者共同一作)2026 年 6 月放出的工业推荐序列建模工作。它提出一个范式判断:当前主流的序列推荐把用户历史当成一条像 LLM 句子那样的「单调时序序列」来喂给自注意力,是一种错误的类比——用户历史本质上是多面的、碎片化的,条目之间的连贯性远弱于自然语言,硬塞进一条序列会导致 context pollution(上下文污染):无关行为争抢同一份注意力预算,稀释模型对当前真实意图的判别力。CMSL 的解法是把「建模一条序列」转变为「主动构造多条上下文」——用一个可学习的 Sequence Construction Module 把一份原始历史在隐空间里拆成 $K$ 条主题一致的「纯净」子序列,各自独立做(线性时间的)自注意力,再汇总压缩回单序列逐层堆叠。CMSL 已在 Meta 的排序(CTR/CVR)与召回(U2U retrieval)任务、跨 5 个大规模线上 surface 部署。
论文信息:Zikun Cui*, Renzhi Wu*, Junjie Yang*, Li Sheng*, Jijie Wei*, Linfeng Liu*, Tai Guo*, Tao Jia*, Xiaodong Wang*, Hong Li*, Li Yu*, Sri Reddy*, Hong Yan(* 全体作者对本研究贡献均等)。单位:¹Meta MRS,²Meta PyTorch,³Meta FB Monetization。arXiv:2606.28533v1 [cs.IR],2026-06-26。
一、研究动机与背景¶
1.1 从 DLRM 到「history-as-prompt」¶
推荐系统的建模范式经历了从 DLRM(Deep Learning Recommendation Models,依赖聚合的类别特征、常丢失时序信息)到序列学习的迁移:序列学习保留了用户 journey 的时序细节,取得了显著成功。近年一个明显趋势是——序列推荐越来越受 LLM 研究启发,很多 RecSys 模型采用了几乎相同的接口:把用户交互历史表示成一串 token(item ID)序列,喂进一个自注意力骨干,把 next-item prediction 当成自回归续写问题。这种 history-as-prompt(历史即提示词) 的视角很有吸引力,因为它提供了统一的建模范式,也给出了随模型规模与上下文长度扩展的清晰路径。
1.2 Context Pollution:本文攻击的核心痛点¶
作者指出这个类比有一个根本性的裂痕。一个句子受严格的句法规则与线性语义依赖支配;而用户的数字足迹是一片 "noisy mosaic"(嘈杂的马赛克)——重叠兴趣、探索性点击、误触交互的混杂物。由于推荐数据缺乏文本那种内在的叙事统一性,直接套用 LLM 式的序列建模常常难以有效捕捉用户的真实意图。无关或弱相关事件会争抢注意力、扭曲当前预测所需的表征。
作者把这个失效模式明确类比为 LLM 里已被充分研究的 Context Pollution / Context Rot(无关 token 拖累推理、诱发幻觉,见 Shojaee et al. 2025、Mei et al. 2025、Hong et al. 2025)。而在推荐里,问题更为尖锐——污染不只是随机噪声,更是语义干扰:强迫模型去计算用户「专业学习(如编程教程)」与「休闲娱乐(如做饭视频)」之间的依赖关系,会鼓励虚假相关、制造表征瓶颈。注意力被无关事件牵走,稀释了用户真实当前意图的信号,导致次优预测。
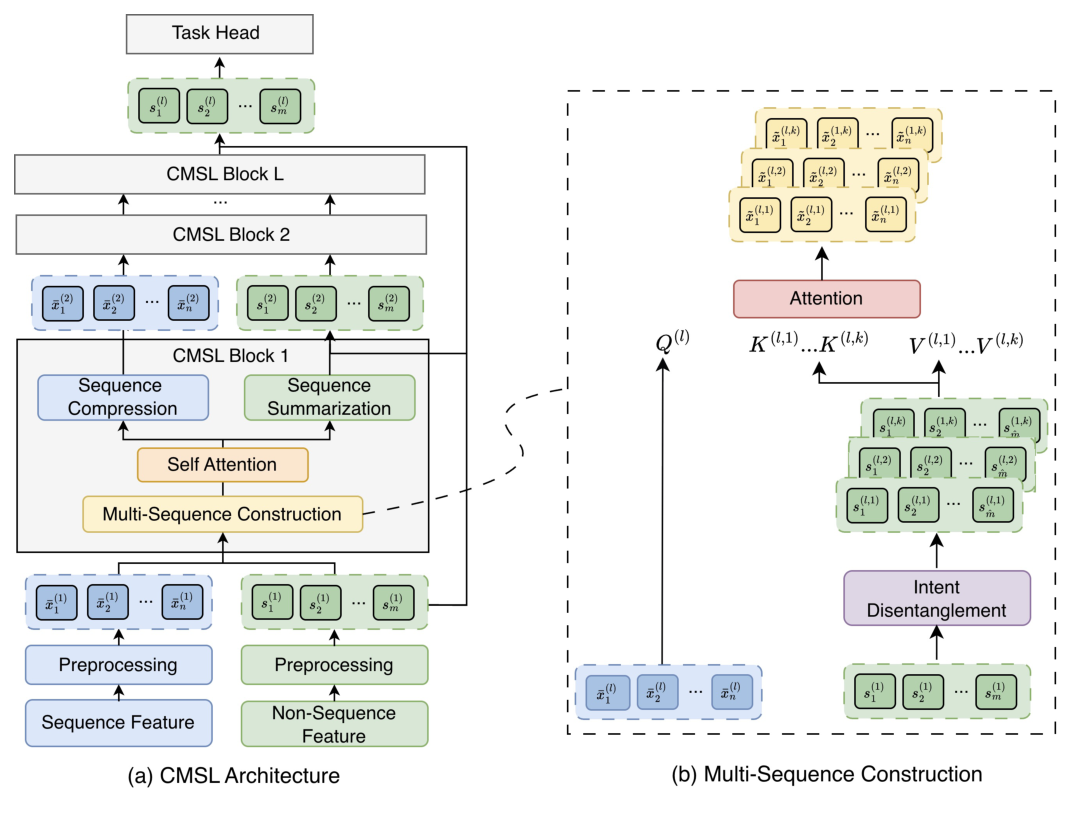
Figure 1(a) 用经验证据佐证了这一现象:向用户历史注入低信号事件会降低性能,而专家驱动的去噪则提升性能。尽管 context pollution 在 LLM 讨论中很显眼,它在序列推荐里仍严重欠探索。
1.3 从「建模序列」到「构造上下文」¶
作者据此抛出一个关键问题:是否存在一种更好的序列学习范式——不把用户历史当成「待读取的 raw prompt」,而是当成「待构造的 context」?
答案就是 CMSL。不同于被动接受一条任意的、单调的序列,CMSL 主动地从用户交互集合中构造多条连贯的隐序列,每条隐序列各自独立做自注意力,从而减少跨意图干扰、缓解上下文污染。如 Figure 1(b) 所示——即便只是由专家手工拆成两条连贯序列,也能超过单序列基线。
这个思路呼应了 LLM 里的 "context engineering"(上下文工程) 哲学:性能取决于喂给模型的上下文如何被组织与筛选。但推荐场景需要领域特化的适配——不同于单词,item ID 是没有显式语义的抽象 token,人工整理不可行。因此 CMSL 通过一个在隐空间里运行的可学习模块来执行 Implicit Context Engineering(隐式上下文工程):自动把嘈杂的原始历史解耦成多条隐序列,这些序列像用户历史的多个 "views"(视图),各自强调不同的相关性侧面,降低语义干扰。
1.4 核心贡献¶
- 一个新视角:把 "Context Pollution" 问题引入序列推荐,并提出「多序列构造与学习」范式来应对。
- 多序列构造模块(Multi-sequence Construction Module):一个把原始历史变换成多条隐流的可学习模块,用 cross-attention 做 intent-aware 构造,让模型在 query 时刻自适应地整理上下文。
- 可扩展线性注意力:一个近似 HSTU 注意力的线性时间机制,把 Transformer 式注意力的算力成本降下来,使多序列建模在工业规模上可行。
- 工业级验证:在拥有数十亿日活的工业数据上实现并部署 CMSL。
1.5 与相关工作的定位¶
作者把近期的工业序列骨干归纳为「共享同一个 formulation」的一类:HSTU(Zhai et al. 2024,通过 target-aware self-attention 提升相关性建模)、OneTrans(Zhang et al. 2025)与 Longer(Chai et al. 2025,架构/效率优化把长历史建模做实)、InterFormer(Zeng et al. 2025,把序列信号与非序列特征更好地融合)、OneRec(Deng et al. 2025;Zhou et al. 2025,用生成式序列建模统一级联系统)。这些方法大多仍把用户过去表示成一条单调时序序列,靠更强的注意力/融合或更长上下文来「提取重要的部分」。CMSL 的立场是互补的——它瞄准一个不同的瓶颈:长、异构历史中的上下文污染,做法是在施加序列注意力之前先从同一份原始历史构造多条上下文条件化的隐序列,把互相竞争的意图分离进不同的流。
二、核心方法 / 模型架构¶
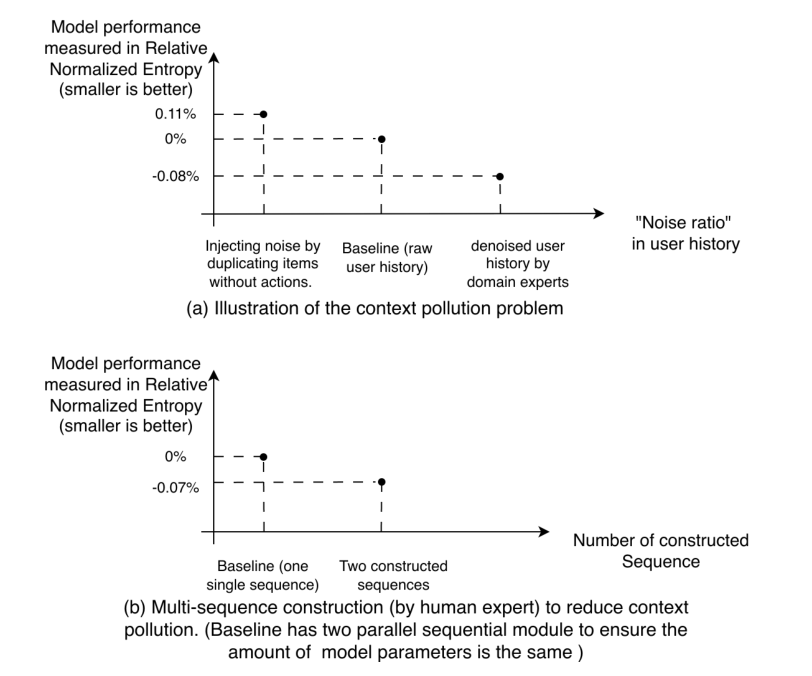
整体架构见 Figure 2。先做特征预处理(§2.1),再进入 CMSL 模型主体(§2.2)。
2.1 特征预处理¶
2.1.1 非序列特征(Non-Sequence Features)¶
分为 dense 与 sparse 两类,分别预处理为 $d$ 维 embedding:
- Dense 特征:连续值(用户年龄、商品价格、视频观看时长等),拼成原始向量 $\mathbf{v}_{dense}\in\mathbf{R}^m$。为保证跨不同特征分布的数值稳定与一致缩放,先归一化,再投影到 $d$ 维 embedding 空间:
$$\mathbf{S}_{dense} = \mathbf{W}_d\cdot\mathrm{Norm}(\mathbf{v}_{dense}),\qquad \mathbf{W}_d\in\mathbf{R}^{d\times m} \tag{1}$$
- Sparse 特征:高基数离散值(国家码、用户语言、商品类目等),每个 sparse 特征 $j$ 关联一张 embedding 表 $\mathcal{T}_j\in\mathbf{R}^{V_j\times d}$;对多值特征(如兴趣标签列表),用各 embedding 的求和作为最终 embedding。每个 sparse 特征同样变换成 $d$ 维 embedding。
2.1.2 序列特征(Sequence Features)与门控压缩¶
用户 $u$ 的交互历史定义为一组序列 $\mathcal{X}=\{X^{(1)},X^{(2)},\dots,X^{(B)}\}$,每条 $X^{(b)}=\{x_1^{(b)},\dots,x_n^{(b)}\}$ 对应一种特定交互模态(点击、点赞、评论等),每个 token $x_i^{(b)}$ 对应一个 item 或 action。每条序列在 token 级过一个共享 embedding 层,把 token 序列变成 embedding 序列。
在大规模社媒平台,单个用户往往拥有海量交互序列,若把它们全部独立处理,算力开销高到不可承受。为在保持性能的同时压低成本,CMSL 把共享属性的序列分组并压缩成单条序列(例如把同一商品 surface 上的 click / like / comment 序列合并)。对一组相关序列 $\mathcal{X}_g=\{X^{(1)},\dots,X^{(M)}\}$,每条先过一个序列专属 MLP,为每个 token 算一个门控分数:
$$s_i^{(m)}=\sigma\big(\mathrm{MLP}^{(m)}(x_i^{(m)})\big) \tag{2}$$
其中 $\sigma$ 是 sigmoid。原始 embedding 按分数加权后沿序列维求和,得到单条压缩序列:
$$\bar X=\sum_{m=1}^{M}\big(s^{(m)}\cdot X^{(m)}\big)\in\mathbf{R}^{n\times d} \tag{3}$$
这种门控求和(gated summation)在不丢弃底层交互信息的前提下,显著降低了后续层的计算成本。
2.2 CMSL Block¶
CMSL 主体由 $N$ 层堆叠的 CMSL Block 构成。每个 Block 在精炼序列表征的同时显式控制上下文干扰,含四个组件:
- Multi-sequence construction:从同一份输入历史构造 $K$ 条上下文条件化的序列;
- Self-attention:在每条构造出的序列内部分别建模 within-sequence 依赖;
- Sequence summarization:抽出总结每条序列的紧凑向量,用于跨层/跨上下文传播;
- Sequence compression:把 $K$ 条序列合并回一条,避免序列数逐层 $K$ 倍爆炸。
这一设计既保留了序列建模的收益,又阻止了无关意图在单一注意力上下文里互相竞争。
2.2.1 Multi-Sequence Construction(多序列构造)¶
这是 CMSL 区别于单调序列建模的关键分岔点(Figure 2(b))。直觉上,同一份原始历史可以通过不同的上下文透镜(contextual lenses)被「读」出不同侧面。CMSL 学出这些透镜,用它们构造 $K$ 条上下文连贯的隐序列,分两步:
- Step 1:在非序列特征上做意图解耦(intent disentanglement)。在第 $l$ 层,先用 $K$ 个投影头把非序列表征投成 $K$ 组上下文专属集合 $S^{(l,k)}$,把用户意图解耦成 $K$ 个不同上下文;每个 $S^{(l,k)}$ 再投成一个 key $K^{l,k}$ 和一个 value $V^{l,k}$。
- Step 2:用 Attention 构造序列。对每对 $(K^{l,k},V^{l,k})$,把当前序列表征 $\bar X$ 投成 query $Q^l$,随后做多头注意力,生成一条新序列 $\tilde X^{(l,k)}$。
由这两步,CMSL 构造出 $K$ 条各自聚焦于不同上下文侧面的序列。注意这里的「多序列」不是预先按行为类型划分的,而是由非序列上下文(用户当前状态)驱动、在隐空间里学出来的——这正是「隐式上下文工程」的落点。
2.2.2 CMSL Attention(线性时间注意力)¶
多序列构造后,每条 $\tilde X^{(l,k)}$ 各自做一次自注意力,捕捉该特定上下文内部的时序相关性——而不是逼一个单一注意力模块去调和相互冲突的意图。但序列自注意力是重操作,复杂度随序列长度平方增长,多序列构造又把计算量再乘上 $K$ 倍。为压低成本,CMSL 用一个近似 HSTU(Zhai et al. 2024)注意力的线性时间机制——HSTU 注意力是 Meta 推荐系统里广泛使用的。
不同于 vanilla transformer,HSTU 注意力没有 row-wise normalization,输出为:
$$\mathrm{SiLU}\big(M\circ QK^\top\big)V \tag{4}$$
其中 $\mathrm{SiLU}(\cdot)$ 是 sigmoid linear unit,$M\in\{0,1\}^{n\times n}$ 是注意力掩码(可为 causal mask)。线性化的动机来自如下观察:
$$\mathrm{SiLU}(x^\top y)\approx \tfrac12(x^\top y)+\tfrac14(x^\top y)^2-\tfrac1{48}(x^\top y)^4+\dots \tag{5}$$
$$\phi(x)=[x_1,x_2,\dots,x_d,\,x_1x_2,\dots,x_ix_j,\dots,x_dx_d]\in\mathbf{R}^{d^2+d} \tag{6}$$
式 (5) 是 SiLU 激活的 Taylor 级数;$\phi(x)$ 是 $x$ 的二次多项式核(degree-2 polynomial kernel)。可以证明:
$$\phi(x)^\top\phi(y)\;\le\;\mathrm{SiLU}(x^\top y)\;\le\;\phi(x)^\top\phi(y)+O\big((x^\top y)^3\big) \tag{7}$$
式 (7) 表明:HSTU 注意力 $\mathrm{SiLU}(QK^\top)V$ 可以用一个线性注意力 $\phi(Q)\phi(K)^\top V$ 再加一项 $AV$ 来近似——其中 $A$ 是只包含 $\mathrm{SiLU}(QK^\top)$ 中大值项的稀疏矩阵。即:
$$\mathrm{SiLU}(QK^\top)V\;\approx\;\phi(Q)\phi(K)^\top V+AV \tag{8}$$
因此对 $\phi(Q)\phi(K)^\top V$ 部分用线性注意力(先算 $\phi(K)^\top V$ 避免 $n\times n$ 矩阵);对大值项 $AV$,受 native sparse attention(Yuan et al. 2025)启发,专门开发了一个 kernel 去捕捉 $QK^\top$ 矩阵里的大值项。这是一个「线性主体 + 稀疏补丁」的混合近似:线性项摊掉主体计算,稀疏项补回被 Taylor 低阶截断丢失的高相关(大 logit)交互。
2.2.3 Sequence Summarization(序列摘要)¶
自注意力之后,用 PMA(Pooling by Multi-head Attention,Lee et al. 2019) 把每条序列摘要成一个定长向量。作者强调摘要是 CMSL 架构里一个至关重要的阶段:它从细粒度的时序表征里蒸馏出高信息量的全局信号;没有显式摘要模块,层间的信息传递会被原始交互序列固有的噪声污染。做法是以当前上下文的非序列特征 $S^{(l,k)}$ 作为 query,让 PMA 有选择地抽取与用户当前状态最相关的行为模式,有效压制冗余或无关的历史数据:
$$h^{(l,k)}=\mathrm{PMA}\big(Q=S^{(l,k)},\,K=\tilde X^{(l,k)},\,V=\tilde X^{(l,k)}\big) \tag{9}$$
各序列的摘要表征 $h^{(l,k)}$ 会成为下一层非序列特征的一部分——这形成了「非序列上下文 → 构造序列 → 摘要回非序列上下文」的跨层闭环。
2.2.4 Sequence Compression(序列压缩)¶
为防止序列数在每层被乘以 $K$,把 $K$ 条序列拼接后投影回单条隐序列:
$$\bar X^{(l)}=\mathrm{MLP}\big([\tilde X^{(l-1,1)}\,\|\,\tilde X^{(l-1,2)}\,\|\cdots\|\,\tilde X^{(l-1,K)}]\big)\in\mathbf{R}^{n\times d} \tag{10}$$
这让模型能跨 $L$ 层学到深层、分层的交互,同时保持每层序列数恒定。
2.2.5 Final Fusion(最终融合)¶
最终表征 $H$ 是最后一层各序列摘要的拼接:
$$H^b=[h^{(l,1)}\,\|\cdots\|\,h^{(l,K)}] \tag{11}$$
它被送入多个任务专属头,做 CTR/CVR 预测。
三、实验设置¶
CMSL 在排序(Ranking)与召回(Retrieval)两类任务上评估。
- 排序用 Normalized Entropy (NE)(He et al. 2014)作为指标,NE 越小预测越好。作者强调 NE 是 Meta 广泛采用的指标,且对排序模型而言 NE 与 A/B 测试指标高度一致(因此可用离线 NE 代理在线收益)。判断标准:NE 改善 >0.03% 即视为统计显著。
- 召回由于线下-线上不一致性强,直接用在线 A/B 测试评估。
训练基础设施:在内部工业训练平台上用混合精度、128 张 NVIDIA H100 GPU 训练,配套定制 kernel 做显存与吞吐优化。每个实验在从生产流量采样的 300–500 亿(30–50 billion) 条样本上训练。
四、主要实验结果¶
4.1 排序评估¶
作者用两种方式验证 CMSL 对 CTR 预估的效果,覆盖四个大规模 surface:
- Surface 1:直接训练一个 CMSL 模型做互动预测,与生产 baseline 对比;
- Surface 2/3/4:引入一个两阶段架构,把重计算从主排序路径解耦——把长上下文的 CMSL 模型下沉到一个异步的上游用户模型(asynchronous upstream user model),从而在保持高保真信号抽取的同时显著降低延迟。
Table 1 报告 Surface 1 上两个最重要互动预估任务、CMSL 相对生产 baseline 的 NE 变化(%):
| Comment | Like | |
|---|---|---|
| Train NE | −0.54 | −0.31 |
| Eval NE | −0.62 | −0.33 |
结论:CMSL 在训练与评估上都取得 0.3%–0.6% 的强 NE 增益;考虑到 >0.03% 已算统计显著,这里的量级远超显著阈值。
Table 2 报告两阶段 CMSL 架构(把 CMSL 用户 embedding 加进生产模型)在 Surface 2/3/4 各自两个最重要任务上的 Eval NE 变化(%):
| Surface 2 · CTR | Surface 2 · CVR | Surface 3 · CTR | Surface 3 · CVR | Surface 4 · CTR | Surface 4 · CVR | |
|---|---|---|---|---|---|---|
| Eval NE | −0.12 | −0.10 | −0.09 | −0.06 | −0.10 | −0.13 |
结论:即使以「异步上游 embedding 注入」这种更保守、更省延迟的解耦方式部署,CMSL 依然在三个 surface 的 CTR 与 CVR 上都取得 0.06%–0.13% 的 NE 下降,全部越过显著阈值——说明多序列构造抽取出的用户表征对下游排序有稳定的边际增量。
4.2 召回评估¶
在 Surface 5 上对 U2U(user-to-user)召回做在线 A/B 测试,用 CMSL 用户 embedding。Table 3 报告 4 个重要互动指标(原文匿名为 Metric 1–4):
| Metric 1 | Metric 2 | Metric 3 | Metric 4 |
|---|---|---|---|
| +0.116% | +0.158% | +0.171% | +0.092% |
结论:CMSL 在全部四个指标上都取得统计显著的正向提升,验证了多序列构造产出的用户表征在召回场景同样有效。
五、与已归档相关工作的对比¶
DUET DUET:为站外转化设计的双用户嵌入 Transformer(Meta,2026-06-08)¶
关系:独立并发(CMSL 未引用 DUET,同为 Meta 但两条不同团队线,殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都指认「用一个无差别的统一编码器去处理统计/语义异构的用户行为」是根本瓶颈。CMSL 称之为 context pollution(无关意图争抢注意力预算);DUET 称之为 signal dominance under regime mismatch——稠密的点击信号会主导稀疏的转化信号,让统一模型欠拟合下游最关心的模式。二者指向的 root cause 是同一个:单一流上的异构行为互相干扰。
- 相近的技术骨架:两篇的处方都是「先把一份历史拆成若干条同质/连贯的流,各用匹配的注意力单独建模,再在下游组合」。DUET 产出 ClickAUE / ConvAUE 两条互补嵌入,CMSL 构造 $K$ 条上下文连贯隐序列。更巧的是部署形态几乎重合:CMSL 的 Surface 2/3/4 用「异步上游用户模型 → 下游 ranker 消费 embedding」的两阶段解耦,DUET 用「事件触发推理(ETI)异步生成用户嵌入 → 下游 OCVR ranker 消费」——同为 Meta 的 async upstream user embedding 范式,连 NE 指标口径都一致。
- 本文的差异与推进:拆分的「主语」不同。DUET 的拆分是数据层的、预定义/监督的——按标签语义与归因时长把训练数据 route 成点击流与转化流(两条流是人为界定的域)。CMSL 的拆分是模型层的、隐式学习的——在每层由非序列上下文驱动、用 cross-attention 现场构造 $K$ 条隐序列,且 $K$ 条并非对应某个可命名的行为域。可以说 DUET 是「按已知域切数据、每域配一套架构」,CMSL 是「在隐空间学出未命名的上下文透镜」。CMSL 更贴近端到端、更少人工先验;DUET 的域先验更强、可解释性更好,且专门针对 OCVR 稀疏长延迟信号做了合成数据补齐。
- 可比的方法/实验差异:DUET 在 6 个下游 OCVR 模型上给出至多 0.38% 训练 NE 下降 + 线上 CVR 正向;CMSL 在 5 个 surface 的 ranking+retrieval 上给出 0.06%–0.62% NE / 0.09%–0.17% 互动指标提升。两者都只报匿名工业指标、无公开 benchmark。
UniFormer UniFormer:面向工业推荐的统一 model-centric scaling(Kuaishou,2026-06-25)¶
关系:独立并发(CMSL 未引用 UniFormer,部分同构)· 已加载对方精读
- 共同关注的问题:UniFormer 把「异构行为下的偏好坍塌(preference collapse)」列为三大核心挑战之一——统一模型要能捕捉短期/长期/跨域等异构兴趣,避免对某一类序列的偏好坍塌。这与 CMSL 的 context pollution 是近亲:都在担心「多种意图/行为混在一起时,强势的一类会压过其余、损害个性化的全面性」。
- 相近的技术骨架:UniFormer 的应对之一正是 多序列 cross-attention——用多条序列 + 跨注意力来防坍塌;CMSL 的 Multi-Sequence Construction 也是「非序列上下文投出 K/V、与序列 query 做 cross-attention 构造多条序列」。两者都用「多序列 + cross-attention」这一骨架来对抗单序列的意图干扰。
- 本文的差异与推进:(1)多序列的来源不同:UniFormer 的多序列是预定义的行为类型(短期序列、长期压缩兴趣、SIM candidate-aware 序列等),CMSL 的 $K$ 条是当层学出来的隐式上下文透镜,无预设语义。(2)对序列内部注意力的取舍相反:UniFormer 为提效省掉了 intra-sequence 交互(lazy 设计,仿 OneRec-v2),只保留跨注意力;CMSL 恰恰把每条构造序列内部的自注意力当作核心(用线性近似来负担 $K$ 倍成本)。(3)问题范围不同:UniFormer 的主线是 feature-space × task-space 的统一 co-scaling,多序列 cross-attention 只是其防坍塌的子组件;CMSL 则把「多序列构造」本身作为唯一主线与全部叙事。二者可视为对同一「异构行为干扰」问题、从不同抽象层级给出的解。
六、核心贡献总结¶
- 问题重述:首次把 LLM 语境里的 "context pollution / context rot" 系统性地移植到序列推荐,并论证推荐里的污染比 LLM 更严重(不止随机噪声,还有语义干扰)。这是一个干净、可传播的问题视角。
- 范式转变:把「建模一条序列」变成「构造多条上下文」——用可学习模块在隐空间做 Implicit Context Engineering,把一份原始历史拆成 $K$ 条主题一致的隐序列。
- 工程可行性:用「线性注意力主体 + 稀疏大值补丁」近似 HSTU 注意力,把多序列构造带来的 $K$ 倍算力成本压回可部署量级;配合门控序列压缩、PMA 摘要与逐层压缩,控制序列数不随层数爆炸。
- 工业落地:跨 ranking / retrieval、5 个 surface 部署,包含「异步上游用户模型」的两阶段低延迟形态。
七、讨论与局限性¶
值得借鉴的设计:
- 「构造上下文 > 读取序列」的视角切换本身极具启发性——它把推荐序列建模从「如何更强地 attend 一条脏序列」的军备竞赛,转到「先把脏序列拆干净」的正交方向,与 DUET、UniFormer 的独立并发出现共同印证了这条路线的时代性。
- 非序列上下文 ↔ 构造序列的跨层闭环(Step 1 用非序列特征投 K/V,PMA 摘要又回流成下一层非序列特征)是一个优雅的设计,让「当前用户状态」持续调制「历史怎么被读」。
- 线性 + 稀疏混合注意力是对 HSTU 的实用工程化,思路(Taylor 低阶给线性主体、native-sparse-attention 式 kernel 补大值)清晰。
局限与争议: 1. 实验严谨度是最大短板。全篇实验完全匿名——surface 1–5、Metric 1–4、baseline 一律隐去,既无任何公开学术 benchmark(Amazon / MovieLens 等),也无任何具名 baseline 的头对头对比(只对「production baseline」)。尽管声称近似 HSTU、且立场是「与 HSTU/OneTrans/Longer 互补」,却没有给出 CMSL vs HSTU / vs OneTrans 的直接数字。 2. 缺关键消融。$K$ 取值的影响、多序列构造 vs 单序列的净收益、线性近似相对精确 HSTU 注意力的精度损失、门控压缩/PMA 摘要各自贡献——这些都没有系统的 ablation,读者无法定位收益究竟来自哪一环。Figure 1 的「两条专家序列优于单序列」只是 motivating 证据,不是对 CMSL 学习式构造的验证。 3. 线性注意力推导偏 sketchy。式 (5)–(8) 的 Taylor 截断(保留到四次项却写成近似)、二次多项式核 $\phi$ 的维度 $d^2+d$ 在大 $d$ 下自身也不便宜、以及式 (7) 上下界的严格性都点到为止,原文公式编号亦有错位,工程细节(稀疏 kernel 如何选大值项、$A$ 的稀疏度)未展开。 4. 两阶段解耦的可扩展性隐患。Surface 2/3/4 采用「离线异步上游用户模型 → 下游 ranker」的解耦部署,上游与下游无法端到端联合优化(与 DUET 同型的权衡),长期看可能限制表征-任务的协同 scaling;只有 Surface 1 是直训。收益量级(0.06%–0.13% NE)在解耦形态下也明显小于直训形态(0.3%–0.6%)。
总评:一个问题视角新颖、工业已落地、但实验呈现单薄的短篇工作。它的价值主要在于把「多序列构造 / 上下文工程」这条路线用 Meta 的规模验证了可行性,并与 DUET、UniFormer 共同标记出「拆分异构历史」正在成为 2026 年工业序列推荐的一个共识方向;但受限于全匿名指标与缺失的消融,它更像一份范式宣言 + 部署报告,而非可复现、可对标的完整研究。