UniFormer:面向工业推荐的高效统一 model-centric scaling¶
UniFormer 是快手(Kuaishou Technology)提出的工业推荐排序模型,核心主张是把推荐模型的扩参范式从 component-centric scaling(组件级扩参) 推进到 model-centric scaling(模型级扩参)。它把整个建模空间显式拆解为 特征空间(feature space) 与 任务空间(task space),分别由堆叠的 Feature-space Interaction Module(FIM) 与 Task-space Interaction Module(TIM) 建模,并配套语义化 tokenization、多序列 cross-attention、多视角 FFN 与一整套训练/推理系统优化,在快手与快手极速版双场景线上 A/B 取得一致的互动与时长收益。
论文信息:Bo Chen*, Jinlong Jiao*, Tijian Hu*, Ruihao Zhang, Yanzhi Liu, Chenghou Jin, Qinglin Jia, Baixuan He, Hechang Pan, Yiwu Liu, Jian Liang, Chaoyi Ma, Ruiming Tang†, Han Li, Kun Gai(Kuaishou Technology,北京)。发表于 KDD '25。(* 共同一作,† 通讯作者)
一、研究动机与背景¶
1.1 工业推荐的模块化现状¶
工业推荐系统需要在 终身行为序列(life-long behavior history) 与 海量异构特征(用户画像、物品 metadata)的基础上,估计用户对候选物品的多种交互效用。以快手、TikTok 这类短视频平台为例,需要同时预测 Click、Like、Share、Comment、Completion 等多种反馈,最终决定视频曝光。
为管理这种复杂度,工业推荐模型在 embedding 层之上通常由三个相互独立设计的模块拼装而成:
- 行为建模模块(behavior modeling module):对用户历史交互序列做时序模式提取(如 DIN、DIEN、SIM、TWIN);
- 特征交互模块(feature interaction module):对跨特征的高阶依赖建模(如 DeepFM、DCN、Wukong);
- 任务建模模块(task modeling module):多目标优化(如 MMoE、PLE、HoME)。
这种分模块的拼装方式催生了大量碎片化、手工设计的算子,虽然在各自子任务上有效,却复杂化了模型优化、限制了对算力资源的高效利用。
1.2 从 component-centric 到 model-centric scaling¶
LLM 的 scaling 成功激励推荐系统也走向"靠堆模型容量提升性能"的路线。论文用一张矩阵图把这条演化路线讲得很清楚:把建模空间看成 (sequence features × non-sequence features × tasks) 的 3×3 交互矩阵,不同方法在扩参时只点亮其中不同的块。
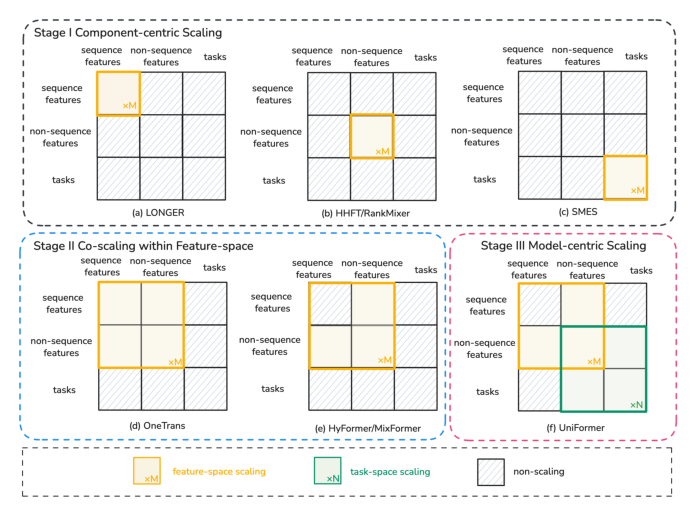
- Stage I — Component-centric scaling(组件级):只扩单个块。LONGER 扩"序列特征×序列特征"块(长序列建模),HHFT/RankMixer 扩"非序列×非序列"块(特征交互),SMES 扩"任务×任务"块(MoE 多任务)。受限于单块扩参,无法享受整体 scaling 的收益。
- Stage II — Co-scaling within feature space(特征空间内协同):OneTrans、HyFormer/MixFormer 把序列建模与特征交互合进一个统一参数空间联合扩参(点亮特征空间的 2×2 块)。这是当前 SOTA 范式,但仍局限在特征空间,任务建模(task modeling)作为一等公民被忽略。
- Stage III — Model-centric scaling(模型级,本文 UniFormer):在特征空间协同(橙色 ×M 块)之外,进一步把任务空间纳入统一建模与扩参(绿色 ×N 块),实现跨"序列行为 + 非序列特征 + 任务"三者的统一 co-scaling。
形式化地,传统碎片化建模可写为($\mathcal{F}_{\text{behavior}}$、$\mathcal{F}_{\text{interaction}}$、$\mathcal{F}_{\text{task}}$ 各自独立设计):
$$\mathbf{y} = \mathcal{F}_{\text{task}}\Big(\mathcal{F}_{\text{interaction}}\big(\mathcal{F}_{\text{behavior}}(\mathbf{e}_{\text{seq}}),\ \mathbf{e}_{\text{non-seq}}\big),\ \mathbf{e}_{\text{task}}\Big) \tag{1}$$
UniFormer 则把任务建模提升为一等组件,统一为:
$$\mathbf{y} = \mathcal{F}_{\text{co-scaling}}\big(\mathbf{e}_{\text{seq}},\ \mathbf{e}_{\text{non-seq}},\ \mathbf{e}_{\text{task}}\big) \tag{2}$$
1.3 三个核心挑战¶
要在工业系统里做高效统一的 model-centric scaling,论文指出必须解决三个问题:
- 效率:工业系统特征量巨大、高并发、低延迟。统一扩参模型必须维持高训练/推理效率,抵消扩参带来的资源开销;
- 异构行为与防偏好坍塌(preventing preference collapse):统一模型要能有效捕捉异构的用户行为(短期 / 长期 / 跨域兴趣),保证个性化的全面性,避免对某一类序列的偏好坍塌;
- 灵活可扩展的参数分配:能在不同组件间均衡分配容量,避免参数过度集中在单一模块。
UniFormer 用三组设计分别对应:语义化 tokenization + lazy 设计 + 用户-物品解耦(效率)、多序列 cross-attention(防坍塌)、多视角 FFN(灵活分配)。
二、核心方法 / 模型架构¶
2.1 总体架构¶
UniFormer 由两大核心组件构成:Tokenization 块(语义分组 + embedding)与 统一交互块(Unified Interaction Block)。统一交互块进一步由 $M$ 层堆叠的 FIM 和 $N$ 层堆叠的 TIM 组成:FIM 建模特征空间内(序列 + 非序列特征)的交互,TIM 建模高阶特征与任务之间、以及任务两两之间的交互。每个模块都采用标准 Transformer 风格的"attention 层 + FFN"结构,从而支持可扩展的参数分配。
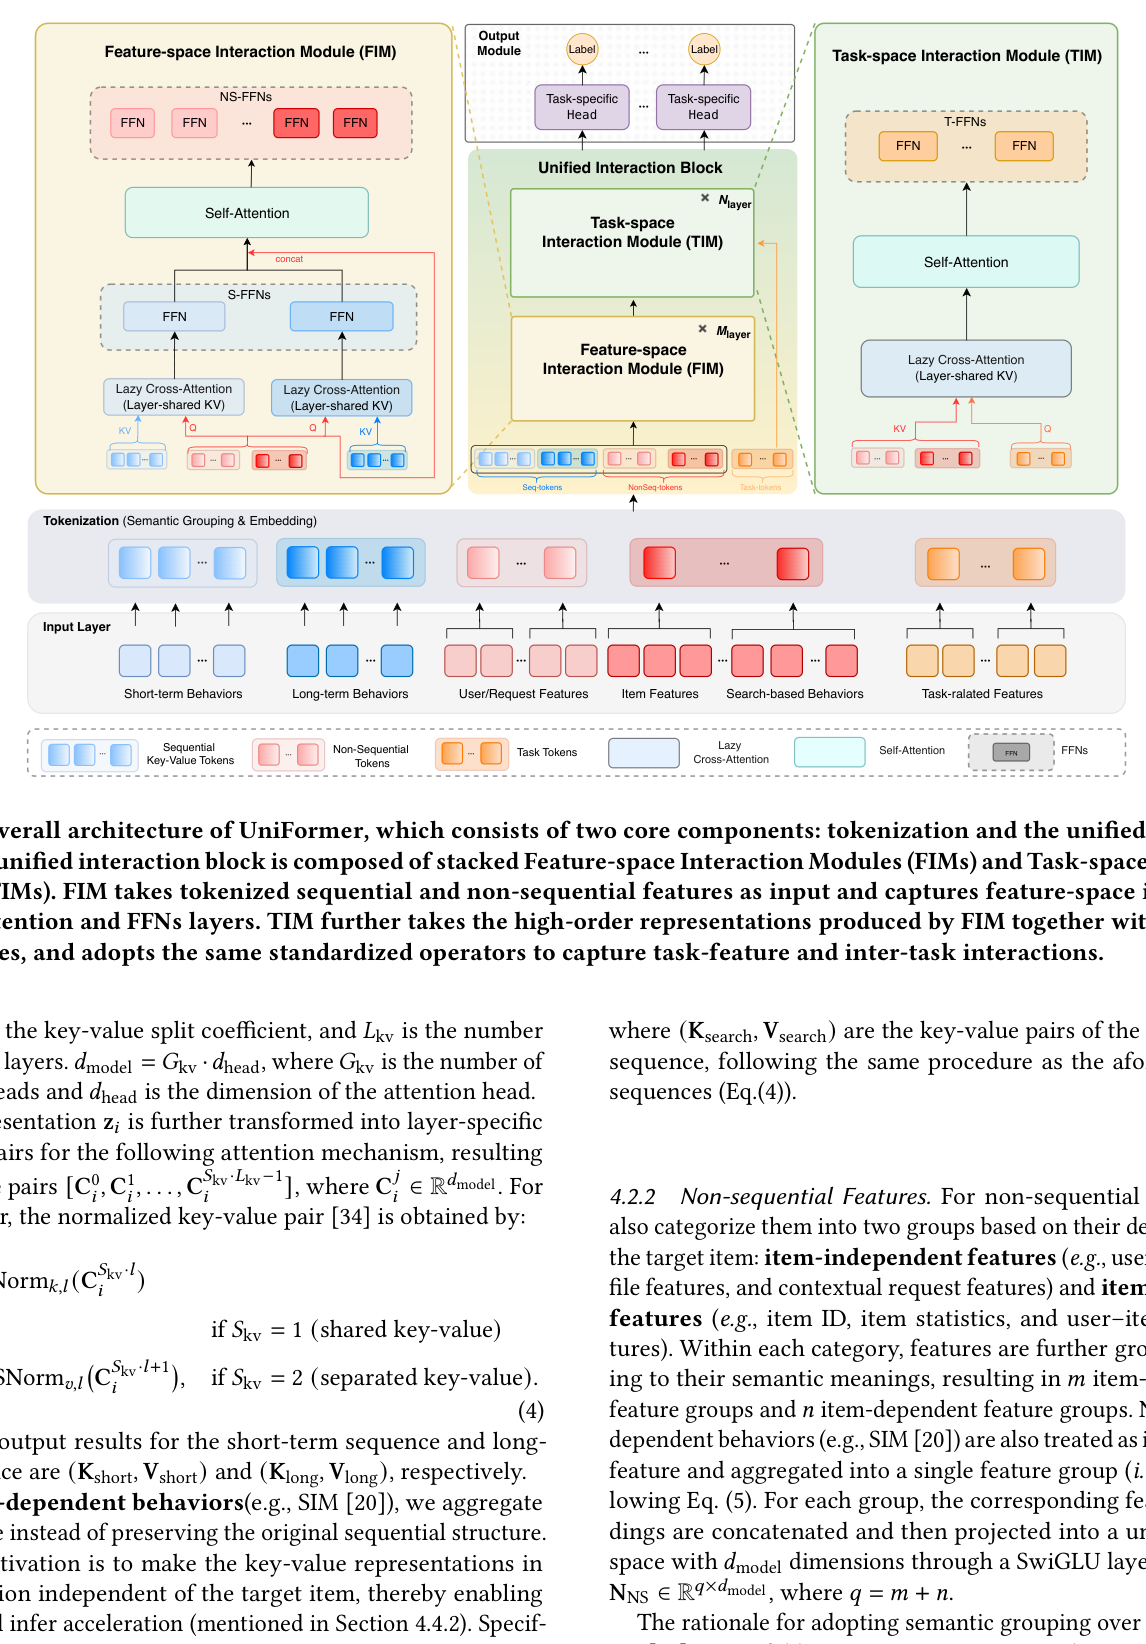
关键设计动机:为避免像 OneTrans 那样在整个特征空间上做 full attention 的高昂代价,UniFormer 省略了序列内部的 intra-sequence 交互(类似 OneRec-v2 的 lazy 设计原则),只保留序列与非序列、序列与任务之间的跨注意力,从而大幅提效。
2.2 Tokenization(语义分组与 embedding)¶
Tokenization 的目标是把序列特征、非序列特征、任务特征都转成紧凑的 token 表示,并为后续的 user-item 解耦(请求级推理加速)打基础。
2.2.1 序列特征(Sequential Features)¶
按对 target item 的依赖性分两类:
- item-independent behaviors(与候选物品无关):保留原始序列结构、逐元素 tokenize。包括短期交互序列与长期压缩兴趣表示(如 C-Former)。
- 短期序列第 $i$ 个元素:拼接物品侧信息(video ID、content type、creator、watch duration 等)得到 token $\mathbf{e}_i^{\text{short}} = [\mathbf{e}_i^{\text{pid}} \,\|\, \mathbf{e}_i^{\text{tag}} \,\|\, \mathbf{e}_i^{\text{pid}} \,\|\, \mathbf{e}_i^{\text{duration}} \,\|\, \cdots]$;
- 长期压缩兴趣表示:直接复用预训练 embedding,$\mathbf{e}_i^{\text{long}} = \mathbf{e}_i^{\text{pretrained}}$。
- 随后(沿用 OneRec-v2)每个表示经 SwiGLU 投影到统一隐空间 $\mathbf{z}_i \in \mathbb{R}^{d_{\text{seq}}}$,维度为:
$$d_{\text{seq}} = S_{\text{kv}} \cdot L_{\text{kv}} \cdot d_{\text{model}} \tag{3}$$
其中 $S_{\text{kv}}$ 是 key-value 切分系数,$L_{\text{kv}}$ 是 key-value 层数,$d_{\text{model}} = G_{\text{kv}} \cdot d_{\text{head}}$($G_{\text{kv}}$ 为 KV 头数,$d_{\text{head}}$ 为头维度)。$\mathbf{z}_i$ 进一步拆为各层的 key-value 对 $[\mathbf{C}_i^0, \mathbf{C}_i^1, \dots, \mathbf{C}_i^{S_{\text{kv}} L_{\text{kv}}-1}]$,第 $l$ 层归一化后的 KV 为:
$$\mathbf{k}_i^{(l)} = \text{RMSNorm}_{k,l}\big(\mathbf{C}_i^{S_{\text{kv}}\cdot l}\big);\qquad \mathbf{v}_i^{(l)} = \begin{cases} \mathbf{k}_i^{(l)}, & S_{\text{kv}} = 1\ (\text{共享 key-value})\\[4pt] \text{RMSNorm}_{v,l}\big(\mathbf{C}_i^{S_{\text{kv}}\cdot l + 1}\big), & S_{\text{kv}} = 2\ (\text{分离 key-value}) \end{cases} \tag{4}$$
- item-dependent behaviors(与候选物品相关):如 SIM 检索出的 candidate-aware 序列。为了让 cross-attention 中的 KV 表示与 target item 无关从而支持请求级加速,UniFormer 对这类序列用 target attention tokenizer 聚合成单个紧凑 token:
$$\mathbf{e}_{\text{search}} = \text{TA}(\mathbf{e}_{\text{target}},\ \mathbf{K}_{\text{search}},\ \mathbf{V}_{\text{search}}) \tag{5}$$
2.2.2 非序列特征(Non-sequential Features)¶
同样按对 target 的依赖性分两组:item-independent(user ID、user profile、上下文请求特征)与 item-dependent(item ID、item statistics、user-item cross features)。组内再按语义细分,得到 $m$ 个 item-independent 组与 $n$ 个 item-dependent 组。值得注意的是,item-dependent 行为(如 SIM)会被当作 item-independent 特征处理,按 Eq.(5) 聚合为单一组 $\mathbf{e}_{\text{search}}$。每组 embedding 拼接后经 SwiGLU 投影到 $d_{\text{model}}$,得到:
$$\mathbf{N}_{\text{NS}} \in \mathbb{R}^{q \times d_{\text{model}}},\quad q = m + n$$
采用 语义分组(semantic grouping) 而非全局分组的关键好处:把计算解耦为"用户请求相关"与"候选物品相关"两部分,前者每次请求只算一次、跨所有候选复用,显著提升推理效率。
2.2.3 任务特征(Task Features)¶
每个任务的任务特征(task ID、task-related bias features)分到一组、拼接投影到 $d_{\text{model}}$,得到任务 token:
$$\mathbf{N}_T \in \mathbb{R}^{t \times d_{\text{model}}}$$
其中 $t$ 为任务数。
2.3 统一交互块之一:Feature-space Interaction Module (FIM)¶
FIM 包含两个互补组件:序列导向交互(sequential-oriented) 与 非序列导向交互(non-sequential-oriented)。
2.3.1 序列导向交互:多序列 Cross-Attention(防偏好坍塌)¶
为了同时利用短期与长期兴趣、又不向某一条序列坍塌,UniFormer 不对拼接后的异构序列做共享 cross-attention,而是对每条行为序列分别做 multi-sequence cross-attention。以短期序列为例,第 $l$ 层用上一层输出 token 作为 query、短期序列的 KV 作为 key/value,并带残差连接:
$$\mathbf{H}_{\text{short}}^{\text{feat},(l)} = \text{CA}\Big(\text{RMSNorm}\big(\mathbf{Q}_{\text{cross}}^{\text{feat},(l-1)}\big),\ \mathbf{K}_{\text{short}}^{(l)},\ \mathbf{V}_{\text{short}}^{(l)}\Big) + \mathbf{Q}_{\text{cross}}^{\text{feat},(l-1)} \tag{6}$$
其中 $\mathbf{Q}_{\text{cross}}^{\text{feat},(l-1)} \in \mathbb{R}^{q \times d_{\text{model}}}$,第一层 query 由 tokenization 的语义分组 token 初始化,即 $\mathbf{Q}_{\text{cross}}^{\text{feat},(0)} = \mathbf{N}_{\text{NS}}$。
Lazy 设计(KV 跨层共享):受 OneRec-v2 的 lazy decoder 启发,默认设 $S_{\text{kv}}=1,\ L_{\text{kv}}=1$,使所有层共享同一份 KV 映射,显著降低显存占用、提升计算效率。这正是"省略 intra-sequence 交互"的体现。论文强调,用语义分组得到的 $q$ 个 token 作为多条行为序列的 query,能从异构来源抽取多视角的互补信息(防坍塌的关键)。同时为稳定训练采用 Pre-Norm RMSNorm。
随后经 序列导向 SwiGLU FFN(S-FFNs) 增强序列感知模式:
$$\bar{\mathbf{H}}_{\text{short}}^{\text{feat},(l)} = \text{FFN}_{\text{short}}^{\text{feat},(l)}\big(\mathbf{H}_{\text{short}}^{\text{feat},(l)}\big) + \mathbf{H}_{\text{short}}^{\text{feat},(l)} \tag{7}$$
长期序列以完全相同的流程独立处理,得到 $\bar{\mathbf{H}}_{\text{long}}^{\text{feat},(l)}$。对短/长/跨域序列分别用独立的 S-FFNs,是 UniFormer 能在专属隐空间里捕捉异构行为、做更细粒度兴趣建模的核心。
两种自适应融合(adaptive fusion) 把异构序列输出整合:
- Global adaptive fusion:学一个全局系数 $\alpha \in [0,1]$ 平衡短/长期序列贡献:
$$\mathbf{H}_{\text{cross}}^{\text{feat},(l)} = \alpha\,\bar{\mathbf{H}}_{\text{short}}^{\text{feat},(l)} + (1-\alpha)\,\bar{\mathbf{H}}_{\text{long}}^{\text{feat},(l)}$$
- Personalized adaptive fusion:考虑到高活/冷启用户的短长期模式差异巨大,进一步用用户相关特征(活跃度、交互行为)动态预测用户级融合系数 $\alpha_i$:
$$\mathbf{H}_{\text{cross}}^{\text{feat},(l)} = \alpha_i\,\bar{\mathbf{H}}_{\text{short}}^{\text{feat},(l)} + (1-\alpha_i)\,\bar{\mathbf{H}}_{\text{long}}^{\text{feat},(l)}$$
2.3.2 非序列导向交互:Interaction Enhancement + 自注意力¶
由于 $\mathbf{H}_{\text{cross}}^{\text{feat},(l)}$ 主要由序列信息主导,UniFormer 在做充分高阶特征交互前,先用 Interaction Enhancement(IE) 把非序列信息补回来:把上一层 self 分支的 query $\mathbf{Q}_{\text{self}}^{\text{feat},(l-1)}$ 与 $\mathbf{H}_{\text{cross}}^{\text{feat},(l)}$ 拼接:
$$\mathbf{X}^{\text{feat},(l)} = \big[\mathbf{H}_{\text{cross}}^{\text{feat},(l)} \,\|\, \mathbf{Q}_{\text{self}}^{\text{feat},(l-1)}\big],\qquad \mathbf{Q}_{\text{self}}^{\text{feat},(0)} = \mathbf{N}_{\text{NS}}$$
再对拼接张量做带残差的自注意力:
$$\mathbf{H}_{\text{self}}^{\text{feat},(l)} = \text{SA}\big(\text{RMSNorm}(\mathbf{X}^{\text{feat},(l)})\big) + \mathbf{X}^{\text{feat},(l)} \tag{8}$$
其中 $\mathbf{H}_{\text{self}}^{\text{feat},(l)} \in \mathbb{R}^{2q \times d_{\text{model}}}$。随后用一组 非序列导向 SwiGLU FFN(NS-FFNs) 对每个 slice 做特征异构性建模:
$$\mathbf{f}_i^{\text{feat},(l)} = \text{FFN}_i^{\text{feat},(l)}\big(\mathbf{h}_i^{\text{feat},(l)}\big) + \mathbf{h}_i^{\text{feat},(l)},\qquad i \in \{0,\dots,2q-1\} \tag{9}$$
得到第 $l$ 层 FIM 输出 $\mathbf{F}^{\text{feat},(l)} \in \mathbb{R}^{2q \times d_{\text{model}}}$。随后按 层级切分比 $\beta^{(l)}$ 沿特征维拆成两部分,分别喂给下一层的 cross 与 self 分支:
$$\mathbf{F}^{\text{feat},(l)} = \big[\mathbf{Q}_{\text{cross}}^{\text{feat},(l+1)} : \mathbf{Q}_{\text{self}}^{\text{feat},(l+1)}\big]$$
其中 $\mathbf{Q}_{\text{cross}}^{\text{feat},(l+1)} \in \mathbb{R}^{2q\beta^{(l)} \times d_{\text{model}}}$,$\mathbf{Q}_{\text{self}}^{\text{feat},(l+1)} \in \mathbb{R}^{2q(1-\beta^{(l)}) \times d_{\text{model}}}$。$\beta^{(l)}$ 默认 0.5;也可采用 金字塔式(pyramid-style) 设计,让 $\beta^{(l)}$ 逐层递减,使 cross-attention 计算逐层轻量化、进一步提效。
2.4 统一交互块之二:Task-space Interaction Module (TIM)¶
FIM 完成特征空间内的充分交互后,TIM 建模"特征-任务关系"。它同样含两个组件:特征导向交互(feature-oriented) 与 任务导向交互(task-oriented)。
2.4.1 特征导向交互(feature-oriented)¶
以任务 token 为 query,对 FIM 最终输出的特征 token 做 cross-attention,让每个任务从全部高阶特征里抽取任务特定信息:
$$\mathbf{H}_{\text{cross}}^{\text{task},(l)} = \text{CA}\Big(\text{RMSNorm}\big(\mathbf{Q}_{\text{cross}}^{\text{task},(l-1)}\big),\ \mathbf{K}_{\text{feat}}^{(l)},\ \mathbf{V}_{\text{feat}}^{(l)}\Big) + \mathbf{Q}_{\text{cross}}^{\text{task},(l-1)} \tag{10}$$
其中第一层 query 为任务 token $\mathbf{Q}_{\text{cross}}^{\text{task},(0)} = \mathbf{N}_T \in \mathbb{R}^{t \times d_{\text{model}}}$,第一层 KV 取自 FIM 输出 $\mathbf{K}_{\text{feat}}^{(1)} = \mathbf{V}_{\text{feat}}^{(1)} = \mathbf{F}^{\text{feat},(M)}$。与 FIM 一样,TIM 的 cross-attention 也用 lazy 设计跨层共享 KV。这一步等价于 MMoE 框架的多任务加权聚合(task-aware weighted aggregation)。
2.4.2 任务导向交互(task-oriented)¶
为捕捉任务间(inter-task)关系,TIM 再用带残差的自注意力 + 一组 任务导向 SwiGLU FFN(T-FFNs):
$$\mathbf{H}_{\text{self}}^{\text{task},(l)} = \text{SA}\big(\text{RMSNorm}(\mathbf{H}_{\text{cross}}^{\text{task},(l)})\big) + \mathbf{H}_{\text{cross}}^{\text{task},(l)};\qquad \mathbf{f}_i^{\text{task},(l)} = \text{FFN}_i^{\text{task},(l)}\big(\mathbf{h}_i^{\text{task},(l)}\big) + \mathbf{h}_i^{\text{task},(l)} \tag{11}$$
得到 $\mathbf{F}^{\text{task},(l)} \in \mathbb{R}^{t \times d_{\text{model}}}$,作为下一层 TIM 的 query,即 $\mathbf{Q}_{\text{cross}}^{\text{task},(l+1)} = \mathbf{F}^{\text{task},(l)}$。
2.5 输出与多任务损失¶
第 $N$ 层 TIM 的输出 $\mathbf{F}^{\text{task},(N)}$ 即任务特定表示,喂入任务专属 FFN head + Sigmoid 给出预测:
$$\hat{y}_i = \sigma\Big(\text{FFN}_i\big(\mathbf{f}_i^{\text{task},(N)}\big)\Big) \tag{12}$$
采用加权多任务损失(BCE)优化:
$$\mathcal{L} = \sum_{i=1}^{t} \lambda_i\,\mathcal{L}_i(y_i, \hat{y}_i) \tag{13}$$
其中 $y_i$ 是第 $i$ 个任务的真值,$\mathcal{L}_i$ 为该任务损失(如二元交叉熵 BCE),$\lambda_i$ 为任务权重。
三、关键技术细节:训练与部署优化¶
3.1 训练优化(Optimization for Train)¶
- User-level Common Compression(用户级公共压缩):同一请求/会话内的多个候选物品共享相同的用户侧行为序列。考虑到行为特征 multi-valued 且长度大,重复处理代价高。UniFormer 对用户侧公共特征只处理一次、存起来,再用索引映射关联到对应样本,减少冗余的序列 embedding 查表、内存拷贝与聚合。设一个 batch 有 $B$ 个样本来自 $U$ 个唯一用户、平均每用户 $\bar{k} = B/U$ 个样本,$C_{\text{com}}$ 为处理用户侧公共特征的代价、$C_{\text{sample}}$ 为其余特征代价,则总代价从 $B(C_{\text{com}}+C_{\text{sample}})$ 降至 $U C_{\text{com}} + B C_{\text{sample}}$,理论加速比:
$$\text{speedup} = \frac{B(C_{\text{com}}+C_{\text{sample}})}{U C_{\text{com}} + B C_{\text{sample}}} = \frac{C_{\text{com}}+C_{\text{sample}}}{C_{\text{com}}/\bar{k} + C_{\text{sample}}}$$
- 变长 FlashAttention(Variable-length FlashAttention):异构用户序列长度不一,padding 浪费严重。语义分组 token(长度 $q$)需 attend 到不同长度的行为序列 $\{L_i\}_{i=1}^{B}$。padded cross-attention 复杂度 $O(BqL_{\max}d)$,变长形式降为 $O(q\sum_i L_i d)$;配合 FlashAttention 的 IO-aware tiling 避免显式物化注意力矩阵,进一步省计算与显存带宽。
- BF16 混合精度训练:相比 FP32 减半张量存储、启用低精度 tensor core,在保持足够数值精度的同时提升吞吐。
3.2 推理优化(Optimization for Infer)¶
- User-Item Decoupling(用户-物品解耦):线上一次用户请求通常配 $I$ 个候选物品(典型 512 或 1024)做排序。得益于 tokenization 把非序列特征拆成 $m$ 个 item-independent token 与 $n$ 个 item-dependent token,并把 item-dependent 行为序列(如 SIM)聚合成 KV 与 target 无关的紧凑 token,item-independent token 每次请求只算一次、跨全部候选复用,避免冗余的用户侧计算。
- Attention Mask 去除跨侧依赖:FIM 里的 cross-attention 与 FFN 天然支持上述解耦,但 full self-attention 层会让所有 token 互相依赖,使用户侧表示又依赖候选物品。为此 UniFormer 在自注意力里加 mask,去掉用户侧 query 对物品侧 key 的注意力,从而让用户侧注意力计算每请求只做一次并复用。
- 实测收益:在每请求 512 候选的生产场景,用户-物品解耦把推理 QPS 相比原始版本提升 48%,且 GAUC 退化可忽略(negligible)。
四、实验¶
4.1 实验设置¶
- 数据集:快手(Kuaishou)单页短视频推荐场景——快手最大的推荐场景,服务 4 亿+ 日活,每天产生 500 亿+ 交互日志。每条样本是 ⟨user, video⟩ 对,附带用户侧行为特征(短期浏览序列、item-dependent 长期检索序列、压缩终身兴趣表示)。聚焦四个预测任务:Effective-view(有效播放)、Long-view(长播放)、Like(点赞)、Follow(关注)。
- 评估指标 GAUC:短视频服务中最关键的离线指标,按用户分别算 AUC 再按样本量加权聚合:
$$\text{GAUC} = \sum_u w_u \cdot \text{AUC}_u,\qquad w_u = \frac{\#\text{samples}_u}{\sum_i \#\text{samples}_i} \tag{14}$$
鉴于训练样本规模极大带来的稳定性,0.05% 的相对 GAUC 提升即被视为高度显著、能带来可观业务收益。
- Baselines(覆盖 pre-scaling 与 scaling 两类,均含序列建模 + 特征交互):
- SIM+DCN:经典 pre-scaling 架构,SIM(超长行为序列建模)+ DCN(特征交互);
- SIM+HoME:把 DCN 换成 HoME(层级化 mask MoE 多任务模块);
- SIM+RankMixer:SIM + RankMixer(token-mixing、可扩参的组件级 scaling 模块);
-
HyFormer、MixFormer:在特征空间内联合扩参行为建模与特征交互的 cross-module co-scaling 方法。
-
实现细节:所有模型从零训练、同一 GPU 集群、相同优化设置。稀疏与稠密部分均用 AdamW,学习率 1e-3、weight decay 1e-3,per-GPU batch 2048。UniFormer 默认 3 层,hidden 维度 $d_{\text{head}} = 1280$。
4.2 主实验结果(Table 1)¶
提升相对第一行 baseline SIM+DCN 计算。粗体为最高分,下划线为 baseline 中最佳。最后一列为稠密网络参数量。
| Model | Effective-view GAUC | Impr. | Long-view GAUC | Impr. | Like GAUC | Impr. | Follow GAUC | Impr. | #Params |
|---|---|---|---|---|---|---|---|---|---|
| SIM+DCN | 0.7418 | – | 0.7734 | – | 0.8486 | – | 0.8361 | – | 115.8M |
| SIM+HoME | 0.7424 | +0.08% | 0.7740 | +0.08% | 0.8494 | +0.09% | 0.8374 | +0.16% | 114.8M |
| SIM+RankMixer | 0.7443 | +0.34% | 0.7757 | +0.30% | 0.8507 | +0.25% | 0.8374 | +0.16% | 492.0M |
| HyFormer | 0.7447 | +0.39% | 0.7762 | +0.36% | 0.8512 | +0.31% | 0.8381 | +0.24% | 496.5M |
| MixFormer | 0.7450 | +0.43% | 0.7764 | +0.39% | 0.8514 | +0.33% | 0.8388 | +0.32% | 489.4M |
| UniFormer | 0.7457 | +0.53% | 0.7771 | +0.48% | 0.8531 | +0.53% | 0.8435 | +0.89% | 516.0M |
| UniFormer-Large | 0.7465 | +0.63% | 0.7779 | +0.58% | 0.8538 | +0.61% | 0.8448 | +1.04% | 995.3M |
结论分析:
- 组件级 scaling 有效:RankMixer 显著优于 DCN、HoME(Effective-view +0.34% vs +0.08%/+0.08% 等),验证了推荐模型里参数 scaling 的价值。
- 特征空间协同 scaling 更优:HyFormer、MixFormer 通过把行为建模与特征交互在一个框架内联合扩参,进一步超过 SIM+RankMixer;说明"联合扩多个组件"比"组件级单独扩"收益更大。
- 模型级协同 scaling 最优:UniFormer 在所有目标上一致超过最强 baseline MixFormer,且参数量相当(516.0M vs 489.4M)。Follow 任务提升尤为突出(+0.89% vs MixFormer +0.32%)——这正是把任务空间纳入统一建模的直接体现;HyFormer/MixFormer 只做到特征空间扩参,UniFormer 额外把 task space 纳入统一流程,并实现更均衡的全模型参数分配。
- 继续扩参仍有收益:UniFormer-Large(995.3M)在 UniFormer 基础上各任务再提升约 +0.1%(如 Effective-view +0.63% vs +0.53%),取得全场最佳。论文把这归功于针对不同组件定制的多视角 FFN——它带来灵活可扩展、随容量增长更稳的性能增长。
说明:UniFormer 仅在快手工业数据集上评测,未使用公开学术 benchmark(无 Recall@K/NDCG@K 类指标),故本篇不录入公开 benchmark 榜单。
4.3 消融实验(Figure 3)¶
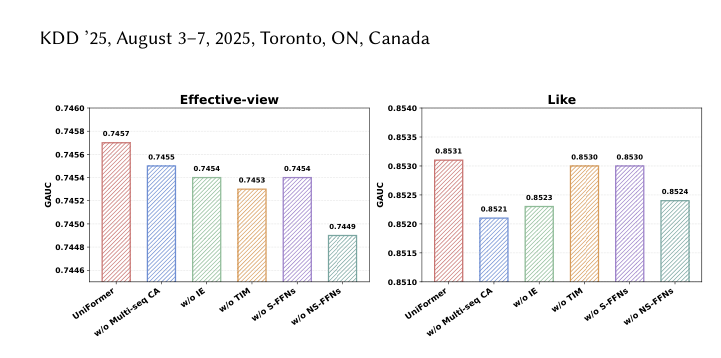
在 Effective-view 与 Like 两任务上考察六个变体:替换多序列 cross-attention 为共享 cross-attention(w/o Multi-seq CA)、去掉 Interaction Enhancement(w/o IE,即 $\mathbf{X}^{\text{feat},(l)} = \mathbf{H}_{\text{cross}}^{\text{feat},(l)}$)、去掉 TIM(w/o TIM)、把 S-FFNs 换成共享 FFN(w/o S-FFNs)、把 NS-FFNs 换成共享 FFN(w/o NS-FFNs)。
| 变体 | Effective-view GAUC | Like GAUC |
|---|---|---|
| UniFormer(完整) | 0.7457 | 0.8531 |
| w/o Multi-seq CA | 0.7455 | 0.8521 |
| w/o IE | 0.7454 | 0.8523 |
| w/o TIM | 0.7453 | 0.8530 |
| w/o S-FFNs | 0.7454 | 0.8530 |
| w/o NS-FFNs | 0.7449 | 0.8524 |
逐项分析:
- 完整 UniFormer 在所有任务上优于全部消融变体,验证统一交互块设计的有效性。
- 去掉多序列 cross-attention(w/o Multi-seq CA)在交互类指标 Like 上掉得最明显(0.8531→0.8521),直接印证多序列 cross-attention 对防偏好坍塌的作用——共享 cross-attention 会让模型坍塌向某条序列、丢失多视角兴趣。
- 把 S-FFNs 或 NS-FFNs 换成共享 FFN 导致最严重退化(w/o NS-FFNs:Effective-view 0.7457→0.7449,Like →0.8524),说明针对不同组件的灵活、可扩展参数分配(多视角 FFN)对均衡而有效的容量 scaling 至关重要。
- w/o TIM、w/o IE 也都有可见退化,验证任务空间交互与非序列信息增强各自的贡献。
4.4 Scaling 分析(Figure 4)¶
通过增大多视角 FFN(S/NS/T-FFNs)的隐藏维度从 0.1B 扩到 1B,UniFormer 展现明显的 scaling law:GAUC 增益随参数量(对数横轴)近似线性增长。
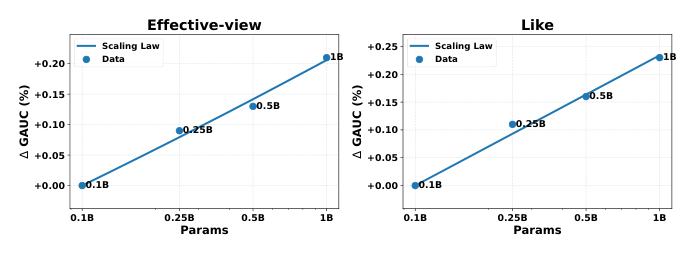
- Effective-view:0.1B→+0.00%,0.25B→+0.09%,0.5B→+0.13%,1B→+0.20%;
- Like:0.1B→+0.00%,0.25B→+0.11%,0.5B→+0.16%,1B→+0.23%。
得益于针对不同组件定制的多视角 FFN,UniFormer 实现更均衡可扩展的参数分配,维持更强的性能增长曲线,有效缓解了传统组件级 scaling 常见的 边际收益递减(Law of Diminishing Returns)。
4.5 可视化分析(Figure 5 & 6)¶
语义 tokenization(Figure 5):把 UniFormer 的语义 tokenization 与不显式保留语义分组的 全局 tokenization 对比(FIM 内 cross-attention 的注意力模式)。
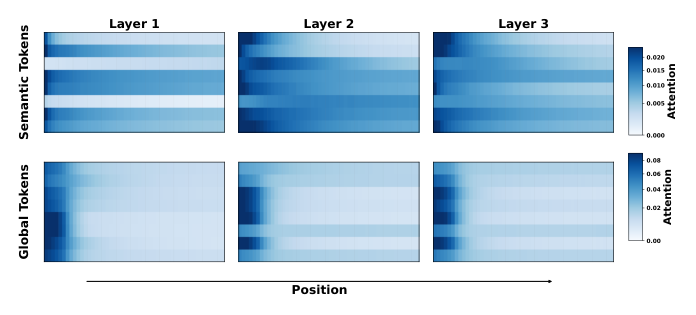
语义 token 在跨层、跨注意力中呈现更多样、更结构化的注意力,能 attend 到不同的行为来源,从而捕捉多视角用户偏好;全局 token 则注意力多样性差、反复集中在相似位置(即 Attention Homogenization 注意力同质化)。这印证了语义分组对多视角兴趣建模的价值。
特征-任务关系(Figure 6):可视化 TIM 中不同任务对特征 token 的注意力分布。
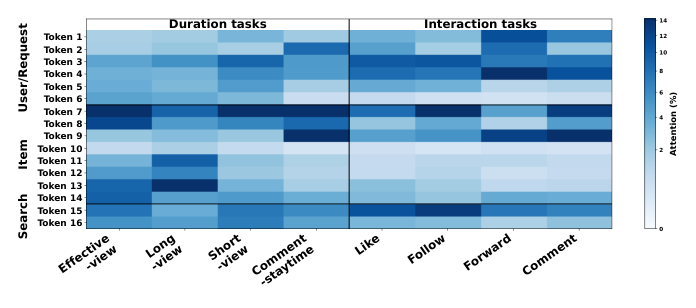
- 部分特征(item 基础特征、search-based 行为特征)在所有任务上都获得高注意力,说明其在多任务预测中的普遍重要性;
- item 统计特征(Tokens 11-14)对 duration 类任务(Effective-view/Long-view)注意力更高,而某些用户特征(Tokens 1-4)更被 interaction 类任务 强调——任务会自适应地聚焦到与其优化目标相关的特征源;
- 高度相关的任务呈现高度对齐的注意力分布(如 Comment Staytime 与 Comment Rate),表明 UniFormer 能通过特征-任务交互捕捉任务间关联。
4.6 线上 A/B 测试(Table 2)¶
在快手与快手极速版 APP 的最大短视频频道上部署,5% 生产流量 引到实验桶,做 7 天 在线 A/B。评估指标含 App Stay Time、Watch Time 及多种互动指标。
| 类别 | 指标 | 快手极速版(Kuaishou Lite) | 快手(Kuaishou) |
|---|---|---|---|
| Engagement | App Stay Time | +0.260% | +0.101% |
| Engagement | Watch Time | +1.113% | +0.729% |
| Engagement | Video View | +0.252% | +0.249% |
| Interaction | Like | +1.089% | +0.155% |
| Interaction | Comment | +1.818% | +1.488% |
| Interaction | Collect | +0.930% | +0.647% |
| Interaction | Forward | +1.274% | +0.157% |
结论:UniFormer 在用户参与(时长)与互动指标上都取得统计显著的一致提升,且有效缓解了多目标间的 seesaw(跷跷板)效应。结合 §3.2 的效率收益——用户-物品解耦使每请求 512 候选的推理 QPS 提升 48%、GAUC 退化可忽略——证明 model-centric co-scaling 既能提质又适合工业部署,是 scaling 工业推荐的有前景方向。
五、核心贡献总结¶
- 范式倡导:系统性论证应从 component-centric scaling 转向 model-centric scaling,并提炼出效率、防偏好坍塌、灵活参数分配三大关键挑战。
- UniFormer 架构:把建模空间显式拆为特征空间(FIM)与任务空间(TIM),用标准化 attention 算子 + 多视角 FFN(S/NS/T-FFNs)实现跨"序列行为 + 非序列特征 + 任务"的统一可扩展建模——把任务建模提升为 scaling 的一等公民 是其相对 OneTrans/HyFormer/MixFormer 的关键差异。
- 效率与防坍塌设计:语义化 tokenization + lazy KV + 用户-物品解耦(请求级推理加速,QPS +48%);多序列 cross-attention 防偏好坍塌;变长 FlashAttention + 用户级公共压缩 + BF16 训练优化。
- 充分的工业验证:快手 4 亿日活双场景线上 A/B 一致正收益,并展示了清晰的 scaling law。
六、与已归档相关工作的对比¶
UniFormer 把自己明确定位在"Stage II 特征空间协同 scaling"(OneTrans / MixFormer / HyFormer)之上,因此这三者既是其概念对照、也大多是其实验 baseline。三者均出自字节跳动,且都试图用统一 Transformer 把"行为序列建模 + 特征交互"塞进单一参数空间联合扩参——与 UniFormer 的 root cause 同构;UniFormer 的关键推进是再加一个任务空间维度,并在效率/防坍塌的算子选择上各有取舍。
MixFormer MixFormer:统一 Transformer 在单一参数空间协同扩参(ByteDance, 2026-02-15)¶
关系:本文显式引用 [10] 且为 Table 1 baseline(特征空间协同 scaling 的最强 baseline,被下划线标注)· 已加载对方精读
- 共同关注的问题:序列建模与特征交互被实现为参数独立的两个模块,带来 co-scaling 困境(序列模块随长度增长、特征模块随宽度增长,固定预算下互相争夺资源、全局次优)。两文都主张把二者统一进单一参数空间联合优化。
- 相近的技术骨架:都是 decoder/Transformer 风格堆叠块 + 序列 cross-attention 聚合 + per-head/per-slice FFN 处理特征异构性;都为工业部署设计了 user-item decoupling(MixFormer 用 mask 隔离 user-side/item-side head 支持 Request Level Batching,省 ~36% FLOPs;UniFormer 用 attention mask 去掉用户侧→物品侧注意力 + item-independent token 复用,推理 QPS +48%)。
- 本文的差异与推进:① MixFormer 的"自注意力替代物"是零参数 HeadMixing + per-head FFN(token-mixing,借鉴 RankMixer),UniFormer 保留标准 attention 并显式区分 cross/self 两条分支 + Interaction Enhancement;② MixFormer 仍局限在特征空间(Figure 1 的 Stage II),UniFormer 额外引入 TIM 把任务空间纳入统一扩参——这正是 UniFormer 在 Follow 任务上拉开 MixFormer 的来源(+0.89% vs +0.32%)。
- 可比的方法 / 实验差异:评测域不同(MixFormer 在抖音 Finish/Skip CTR,用 AUC/UAUC;UniFormer 在快手四任务,用 GAUC)。在 UniFormer 自己的 Table 1 里,UniFormer(516.0M)相对 MixFormer(489.4M)在四任务 GAUC 全面更优(如 Like 0.8514→0.8531、Follow 0.8388→0.8435)。
OneTrans OneTrans:单一因果 Transformer 统一序列建模与特征交互(ByteDance, 2025-10-30)¶
关系:本文显式引用 [33]、作为"Stage II 特征空间协同"的代表性对照,并被点名为"在整个特征空间做 full attention 计算代价高昂"的反例;非 Table 1 数值 baseline · 已加载对方精读
- 共同关注的问题:传统 encode-then-interaction 流水线信息流单向、两模块独立阻碍统一优化与扩展;两文都要打通行为序列与非序列特征的双向交互、复用 LLM 工程优化(KV cache / FlashAttention / 混合精度)。
- 相近的技术骨架:都把序列与非序列特征统一 tokenize 进单一 Transformer 堆叠,并为线上 serving 设计 跨请求 KV 复用(OneTrans 的 cross-request KV caching ↔ UniFormer 的 user-item decoupling + item-independent token 复用),都用金字塔式逐层裁剪/递减切分降本(OneTrans pyramid stack ↔ UniFormer 的金字塔式 $\beta^{(l)}$ 递减)。
- 本文的差异与推进:① OneTrans 用单一因果 self-attention 跨全部 token(S-tokens 共享、NS-tokens 独立的 mixed parameterization),UniFormer 明确指出这种 full attention 在整个特征空间上"计算代价高昂",转而用 cross-attention + lazy 共享 KV 省略 intra-sequence 交互;② OneTrans 仍在特征空间内联合建模,UniFormer 把任务空间也纳入(TIM);③ 防坍塌策略不同:OneTrans 靠 RMSNorm 防 S/NS token 数值差导致的 attention collapse,UniFormer 靠多序列 cross-attention 防对单条序列的偏好坍塌。
- 可比的方法 / 实验差异:两文均无公开数据集交集(OneTrans 在电商场景报告 +5.68% GMV/u,UniFormer 在快手短视频四任务 GAUC + 双场景 A/B),无法直接对数;机制层面 UniFormer 可视作"把 OneTrans 的 full-attention 特征空间换成更省的 cross-attention,并外接一个任务空间"。
HyFormer HyFormer:用 Global Tokens 统一长序列建模与特征交互(ByteDance AML, 2026-01-23)¶
关系:本文显式引用 [11] 且为 Table 1 baseline;Figure 5 的"语义 tokenization vs 全局 tokenization"对照,其中"全局 tokenization"对应 HyFormer 的 Global Tokens 思路 · 已加载对方精读
- 共同关注的问题:分离式"先长序列建模、再特征交互"流水线导致 query 过度简化、信息交互单向延迟、scaling 效率低。两文都要把长序列与异构特征紧密集成进单一骨干。
- 相近的技术骨架:都沿用 RankMixer 式语义分组 tokenization;都用一组语义 token(HyFormer 的 Global Tokens / UniFormer 的语义分组 query)作为非序列特征与长序列之间的共享接口,通过逐层重算 KV 的 cross-attention 让序列表示随深度共同演化(HyFormer Query Decoding ↔ UniFormer 多序列 cross-attention),并用 token-mixing/self-attention 增强异构交互(HyFormer Query Boosting ↔ UniFormer 的 IE + 自注意力 + NS-FFNs)。
- 本文的差异与推进:① HyFormer 用单组 Global Tokens 共享地解码各序列,UniFormer 坚持对每条序列分别做 cross-attention(multi-seq CA)以显式防偏好坍塌——其消融正是把 multi-seq CA 换回共享 CA 后 Like 掉点;② Figure 5 直接论证语义 tokenization 比全局 tokenization 注意力更多样、避免"注意力同质化",这是对 Global-Token 路线的针对性批评;③ HyFormer 仍在特征空间,UniFormer 外接任务空间(TIM)。
- 可比的方法 / 实验差异:在 UniFormer 的 Table 1 里,UniFormer(516.0M)四任务 GAUC 全面优于 HyFormer(496.5M,如 Effective-view 0.7447→0.7457、Follow 0.8381→0.8435);HyFormer 部署于抖音搜索、UniFormer 部署于快手推荐主场景。
被剔除的近似候选(门槛防放水): - RankMixer RankMixer:是 UniFormer 的组件级 scaling baseline(SIM+RankMixer),解法骨架是 per-token FFN + multi-head token-mixing 替代 self-attention,属"Stage I 单块扩参",与 UniFormer 的特征/任务空间分解不同构 → 交给 DAG 结构化边处理,不入孪生叙事。 - TokenFormer TokenFormer:在"统一多域+序列、缓解 collapse"上与 UniFormer 的防坍塌动机有重叠,但其解法是 Bottom-Full-Top-Sliding 注意力模式 + 非线性交互表示,无任务空间分解 → 解法骨架实质偏离,剔除。 - UniMixer UniMixer(同为快手):标题也含"unified",但它统一的是不同扩参原语(attention / TokenMixer / FM 模块)的桥接(参数化 TokenMixer),而非 UniFormer 的建模子空间(feature/task)分解,问题轴不同构 → 剔除。 - TokenMixer-Large TokenMixer-Large:聚焦把 token-mixer 深度扩到 15B 的稳定性工程(Mixing-Reverting / inter-layer residual / Sparse-Pertoken MoE),机制与"特征+任务空间统一扩参"正交 → 剔除。
七、讨论与局限性¶
核心贡献与可借鉴设计:UniFormer 最有价值的洞见是把"任务建模"从 scaling 的盲区提升为一等公民——OneTrans/HyFormer/MixFormer 已把行为与特征统一进特征空间,UniFormer 顺势补上 task space,构成"序列行为 + 非序列特征 + 任务"的完整 co-scaling 矩阵。工程上几处设计很实用且可迁移:① 语义化 tokenization + item-independent/dependent 拆分,使用户侧计算每请求只算一次、跨候选复用(线上 QPS +48%),是工业排序模型扩参时控成本的关键模板;② 多序列 cross-attention + lazy 共享 KV,在"防偏好坍塌"与"省算力"之间取得平衡;③ 多视角 FFN(S/NS/T-FFNs)实现按组件定制的容量分配,撑起更平滑的 scaling law。
局限与争议:① 所有离线评测只在快手单一工业数据集上,无公开 benchmark,外部可复现性与跨域泛化性难以核验;② 单任务 GAUC 提升幅度本身不大(多为 +0.1%~+0.5% 区间,仅 Follow +0.89% 较突出),论文以"0.05% 即高度显著"的工业口径来论证,离线绝对增益对学术读者偏弱;③ 与最直接对手 MixFormer/HyFormer 的对比是在 UniFormer 自家 setting 下复现的 self-reported 结果,跨场景(抖音 vs 快手)不完全可比;④ 引入 FIM/TIM 两段堆叠 + 多套 FFN + 多种自适应融合,超参与结构复杂度较高($M$、$N$、$\beta^{(l)}$、$S_{\text{kv}}$、global/personalized fusion 选择等),调参与维护成本不容忽视;⑤ 论文未给出 TIM 在任务数很多时的扩展性边界与失败案例分析。
工业落地价值:作为已在快手 4 亿日活双场景上线、5% 流量 7 天 A/B 验证、并明确给出推理加速数字的工作,UniFormer 的部署成熟度高,对正在从组件级 scaling 转向统一大模型范式的工业推荐团队有直接参考意义。