UniDot:把「token 之间的点积」当作统一特征交互与序列建模的唯一原语¶
Meta(Menlo Park)· arXiv:2608.16797v1 [cs.IR] · 2026-08-17 · KDD Cup 2026 Tencent UniRec Challenge Workshop
Rongcheng Lin, Yan Sun, Jamey Zhang, Guanglei Xiong, Ivan Ji, Xianjie Chen, Shujian Bu(全部为 Meta 员工,邮箱均为 @meta.com)
论文脚注明确声明:所有实验、数据采集与处理均在比赛主办方的基础设施上完成,未在 Meta 基础设施上进行任何实验、数据采集或处理。
研究动机与背景¶
两条平行演化的技术传统¶
大规模推荐系统要在实时约束下对海量候选打分,其预测模型沿两条基本独立的传统成熟起来:
- 特征交互模型:Wide&Deep、DeepFM、xDeepFM、DCN / DCN-v2、FiBiNet、AutoInt、Wukong、DHEN。它们在一个宽而基本静态的特征集(用户画像 × 物品属性)上学习显式与隐式交叉。
- 序列化用户兴趣模型:DIN、DIEN、DSIN、SIM、ETA、TWIN、LONGER、TIN。它们建模用户行为的动态演化,典型做法是在单一行为历史上做 target-aware attention。
生产系统里这两族只被松耦合地拼在一起(先把序列压成摘要 embedding,再喂进特征交互塔)。TAAC × KDD Cup 2026(Tencent Uni-Rec Challenge)的命题——"Towards Unifying Sequence Modeling and Feature Interaction for Large-scale Recommendation"——正对准这道缝:要求一套统一 tokenization 方案与一个同质、可堆叠的骨干,在一个架构里同时建模序列与非序列特征,按推理时延预算下的 AUC 排名。
UniDot 的切入视角:把内积当作第一性原语¶
作者刻意选择了一个因子分解机(FM)视角作为起点。FM 的内积 $\langle v_u, v_i \rangle$ 是协同过滤的引擎:用户与物品通过从所有观测共现中估计出的隐因子相遇,因此打分可以泛化到训练中从未共同出现过的 user–item 对。而在广告转化数据里,正样本稀疏、广告库存庞大且快速变动,服务时的大多数候选对实际上都是新对——泛化性正是这个场景最需要的性质。
论文的核心观察是:嵌入内积与注意力的 query·key 打分是同一个运算。既然如此,一个"token 之间的点积"就足以同时支撑特征交互与序列建模。模型名 UniDot 即 Unified modeling via Dot-products Of Tokens。
与已有统一工作的关键区别在于:先前工作让这个内积变成隐式的——它只是深层交互堆栈或 Transformer 的一个涌现性质。UniDot 则在信号跨越 user–item 边界或 candidate–history 边界的每一处都把内积保持为显式运算,并用更深的机器(token mixing、门控 MLP、attention)去精炼这些点积的操作数,而不是替换掉点积这个运算本身。
论文同时声明其设计遵循了 Meta 自家新提出的 SlimPer 框架,并称 UniDot 是"SlimPer 框架在公开数据集上的一次初步检验"。
四点贡献¶
- 双路径、逐层并行的宏块:不把序列模块串接进交互骨干,而是每块内并行跑两条路径——非序列 token-mixing 路径(一个可替换的 mixer 槽位,默认 Wukong 的并行 LCB + FMB,TokenMixer 式块可直接插拔)与序列检索路径(物品 token 交叉注意行为序列)——两者每层通过一次标准 MLP-Mixer 融合交换状态。该交错设计受 InterFormer 与 Kunlun 启发,UniDot 的差异在于把跨边界信号保持为显式点积。
- 共享的、候选感知的多域序列流水线:所有行为域只嵌入一次并被位置局部的 fid 轴压缩重整为统一的每位置宽度;DIN 式条件门控 SwiGLU 把候选上下文只注入门(不污染值路径);一条按时间戳交错的合并流建模跨域时序模式。
- FM Highway:逐域 query–key 点积、聚合 Gram 矩阵、跨总线 user–item 点积,跨层拼接后直接送进分类器,绕过残差融合路径,以极小代价保住深残差栈倾向于冲刷掉的 FM 式二阶信号。
- 共享 embedding 上的多路互学习:两条 UniDot 路径在同一份(且占参数主导的)稀疏 embedding 表上联合训练,各自被拉向对方的预测,从而把单条路径也拉到更好的极小值——单路径 1× 推理成本的模型本身就足以拿到亚军(Table 1),两路平均只是补回剩下的小尾巴。
结果:UniDot 在 TAAC × KDD Cup 2026 工业赛道以官方 AUC 指标取得亚军,最终榜 AUC 0.83217。作者强调该成绩来自架构与规模而非重特征工程——除已发布 schema 外未添加任何手工交叉特征。
问题形式化¶
任务是点击后转化预测(post-click conversion prediction)。一个样本 $x = (u, i, \mathcal{S})$ 带二值标签 $y \in \{0,1\}$($y=1$ 表示转化),其中 $u$ 是用户画像(user_int ID、按位置对齐的权重、预训练用户 embedding),$i$ 是候选物品(item_int ID、物品 embedding),$\mathcal{S} = \{S_s\}_{s=1}^{4}$ 是四个行为域。模型预测转化概率,用二元交叉熵训练。以下记 $d$ 为 $d_{\text{model}}$。
(1) Tokenization:把原始输入映射为 $d$ 维 token:
$$\mathbf{U} = \mathrm{Tok}_u(u) \in \mathbb{R}^{T_u \times d},\quad \mathbf{I} = \mathrm{Tok}_i(i) \in \mathbb{R}^{T_i \times d},\quad \mathbf{I}_h = \mathrm{Tok}^h_i(i) \in \mathbb{R}^{T_{ih} \times d},\quad \mathbf{H}^{(s)} = \mathrm{Seq}(S_s) \in \mathbb{R}^{L_s \times d} \tag{1}$$
(2) 可堆叠块:两个 token 状态由 tokenizer 初始化,$Z^0_{\text{mix}} = [\mathbf{U}; \mathbf{I}]$(token-mixing 总线)与 $Z^0_{\text{seq}} = \mathbf{I}_h$(序列检索总线)。对 $\ell = 1,\dots,L$ 个完全相同的块:
$$\big(Z^{\ell}_{\text{mix}},\, Z^{\ell}_{\text{seq}},\, \phi^{\ell}\big) = \mathrm{Block}^{\ell}\big(Z^{\ell-1}_{\text{mix}},\, Z^{\ell-1}_{\text{seq}},\, \{\mathbf{H}^{(s)}\}_{s=1}^{S}\big) \tag{2}$$
其中 $\phi^{\ell}$ 是该层的 FM Highway 信号(token 点积与 Gram)。
(3) 读出:分类器消费最终状态的压缩读出 $\rho$、每一层的 highway 信号、以及 skip-embedding 信号 $e_{\text{skip}}$:
$$\hat{y} = \sigma\Big(\mathrm{MLP}\big(\rho(Z^L_{\text{mix}}, Z^L_{\text{seq}});\, \phi^1;\, \dots;\, \phi^L;\, e_{\text{skip}}\big)\Big) \tag{3}$$
逐层 highway 信号是拼接而非求和,因此每一层的显式交互都能不被稀释地抵达分类器。这是一个刻意的设计选择:求和会让不同层的二阶信号互相抵消,拼接则把"第几层产生的交互"这一信息也保留给分类器。
(4) 目标函数:BCE 加一个辅助延迟损失:
$$\mathcal{L} = -y\log\hat{y} - (1-y)\log(1-\hat{y}) + \lambda\,\mathcal{L}_{\text{delay}} \tag{4}$$
其中 $\mathcal{L}_{\text{delay}}$ 是对 $\log\big(1 + (t_{\text{label}} - t_{\text{event}})\big)$(到下一次动作的时间)的 MSE 回归,在所有存在下一次动作的行上生效(点击与转化,而不只是正样本)。
核心方法 / 模型架构¶
4.1 总体设计¶
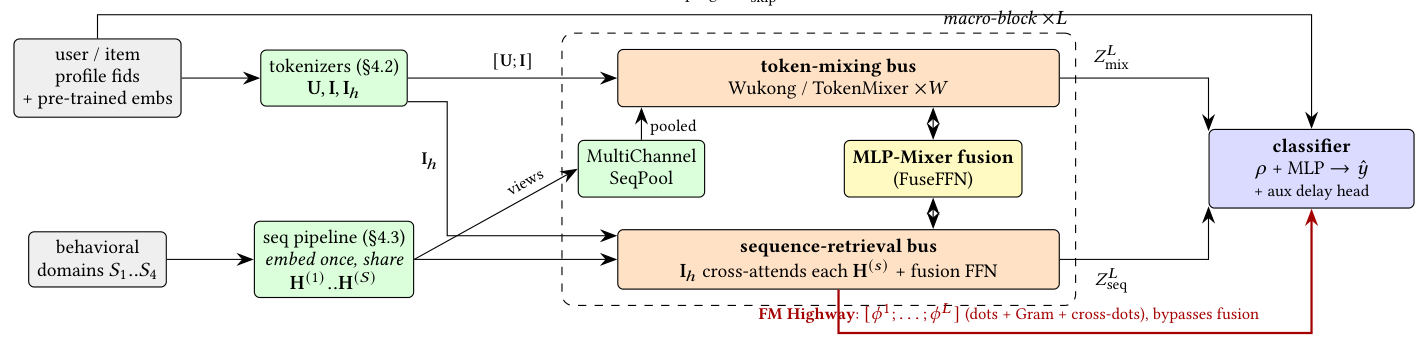
统一 tokenization:每一种输入——非序列的用户/物品多字段特征、以及行为序列的每个位置事件——都被嵌入到同一个 $d_{\text{model}}$ 空间并表示为 token。随后一个单一的可堆叠宏块处理它们;堆叠 $L$ 个相同的块是唯一的深度旋钮,使得在深度与宽度两个方向扩展都很简单。
两条总线穿过 $L$ 个宏层(每层内含 $W$ 个 token-mixing 子层)协同演化;MLP-Mixer 融合每层在两者间交换信息,FM Highway 与之并行运行。一条共享的序列流水线同时喂给交叉注意力和一个逐层的多通道池化(后者把池化后的序列 token 注入非序列总线)。
4.2 Tokenizer:把异构输入压进同一 token 空间¶
Tokenization 把模型的异构输入(类别 fid、多值 ID 列表、预训练 embedding、行为序列)映射进一个共享的 $d$ 维 token 空间,让宏块能统一处理。每个多字段输入通过沿 token 轴压缩变成少数几个 $d$ 维 token。全模型反复出现两个原语,都把 $\mathbb{R}^{T \times d} \to \mathbb{R}^{T' \times d}$ 并带一个 LayerNorm 尾巴:
- LCB:单层 token 轴 MLP-mixer(一个线性层);
- NCB:其两层版本(两个线性层,中间夹 GELU)。
类别(fid)特征:每个 fid 按位置嵌入,位置束由一个可学习的 NCB 沿 token 轴压缩到 token 预算。作者强调:因为 NCB 是学出来的,所以由数据决定哪些特征组合构成哪个 token,而不是由一条固定池化规则把位置级的显著性平均掉。由此得到用户 token $\mathbf{U}$($T_u$ 个),以及从两张独立的物品表得到一个紧凑视图 $\mathbf{I}$($T_i$,供 token-mixing 总线)和一个更丰富的 $\mathbf{I}_h$($T_{ih}$,供序列检索总线,其 token 充当交叉注意力的 query)。行为序列以同样方式 token 化(逐 fid 嵌入后用位置局部的 fid 轴 NCB 压到统一的每位置宽度),每次前向只做一次,被所有消费者共享。
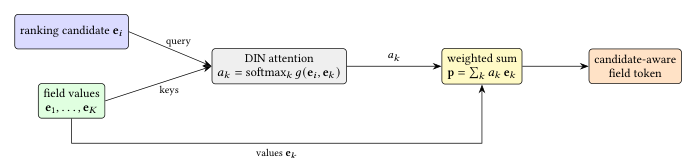
多值 fid:FAFE。少数高价值 fid 是行为 ID 的列表,其顺序不携带含义(位置不变)。对这些字段,静态 NCB 被替换为候选感知的 DIN 式注意力池化:对排序候选打分每个值,使该字段的 token 对每个候选都是其取值的不同组合。这是"压缩到 token"这一步的一个特例,只是池化权重变成候选相关的。
预训练 embedding 特征:稠密预训练向量(用户侧 SUM、LMF4Ads…;物品侧 embedding)先归一化,再由一个小 MLP 投影成额外 token,追加到对应的 token 集合。另有若干成对的 user_dense 数组不是特征,而是 fid embedding 的逐位置乘子(见后文 §C.2)。
4.3 序列编码器:一次编码、全局共享¶
序列编码器(式 (1) 中的 $\mathrm{Seq}(\cdot)$)把 §4.2 的每位置序列 token 转成下游消费的视图 $\mathbf{H}^{(s)}$,每次前向只跑一次、被所有消费者共享——这正是"约束推理时延"的关键。它是一条四阶段流水线,每阶段针对行为流中的一种不同结构:
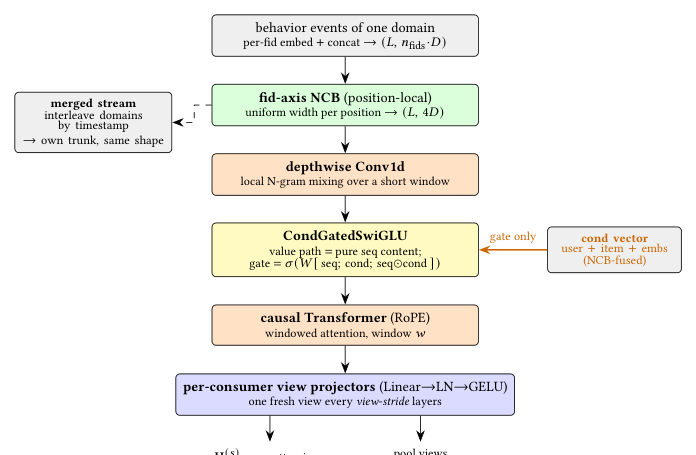
- 跨域合并流:一部分域按时间戳交错合成一条额外的跨域流,让下游模块更容易学到跨域交互。真实域加上合并流给出下游序列数 $S$。
- 局部混合:depthwise Conv1d。一个轻量的 depthwise Conv1d 在局部窗口内逐通道混合,廉价地捕捉 N-gram 模式(突发、相邻事件母题)——否则自注意力要花容量重新学一遍。
- 信息过滤:DIN 式条件 SwiGLU。一个复合的每样本 cond 向量(用户 + 物品 LCB token + emb-cond,经 NCB 融合)只进入 SwiGLU 的门,值路径保持为序列内容的纯函数。门按候选相关性选择位置(DIN 式),但不改变这些位置的内容。这一"候选只进门"的设计与位置局部压缩组合得很干净。
- token 依赖:因果 Transformer。全局编码器是一个浅层 Transformer,带 RoPE 和因果、窗口化注意力(窗口 $w$),通过融合注意力 kernel(SDPA / FlashAttention)按时间序建模 token 依赖。随后逐消费者的视图投影器(Linear → LN → GELU)产出 $D$ 维视图 $\mathbf{H}^{(s)}$,每 view-stride 层刷新一次。
4.4 每层计算:两条总线并行 + FM Highway¶
每个宏层并行跑两条总线然后融合。
token-mixing 总线¶
总线状态(用户 token、物品 token 与池化 token 拼接)穿过 $W$ 个跨 token 块。这个块是一个可替换槽位,默认用 Wukong(并行 LCB + FMB 带残差,其中 FMB 贡献显式的两两点积)。作者也评估了 TokenMixer 式块与 UniMixer,但在其数据规模下都没有打赢 Wukong——作者推测两者都需要更多数据才能收敛。
作者对此结论作了明确的自我限缩:这是 UniDot 内部的受控槽位替换,不是等配的端到端重训(在比赛预算下超出范围),因此只应读作"在我们这个规模下的指示性结论,而非确定性排名"。池化 token 在层间被切掉,使持久状态维持在 $(T_u + T_i, D)$。
MultiChannelSeqPool¶
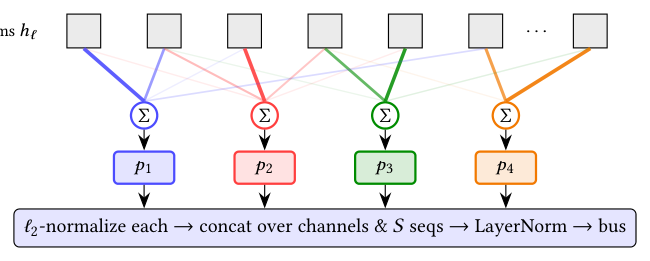
对 $S$ 条序列视图中的每一条,一个多通道池化(精神上类似 NetVLAD / NeXtVLAD 的多簇软分配聚合)产出 $C$ 个池化 token。每个通道用一个独立的 sigmoid(不是 softmax)门控每个位置,条件是当前 mixing 总线状态的一个摘要——这样各通道独立发火,而不必为一份固定的注意力质量互相竞争。每个池化 token 是位置的门控加权和。
因为 sigmoid 门控让幅度无界,每个池化 token 沿 $D$ 做 $\ell_2$ 归一化以恢复单位范数;$S \cdot C$ 个 token 随后过一个 LayerNorm 尾巴才进入总线——与 NCB 尾巴的画像 token 对齐,使 token-mix 不会系统性地压低它们的权重。(同样的"尾部对齐"考虑在 §C.4 的预训练 embedding token 上再次出现,是本文一以贯之的一个细节洁癖。)
序列检索总线¶
作者指出:这条总线的单历史、单层实例就退化成一个标准的单历史 target-attention CTR 模块(HyFormer 那一类);本文把它推广到 $S$ 个域(真实 + 合并)、逐层 query、以及一个 FM-Highway 读出。物品状态有 $T_{ih}$ 个 token,每层:
- 逐序列交叉注意力:物品状态 query $S$ 条序列视图中的每一条(内部无残差),给出原始输出 $A_0,\dots,A_{S-1} \in \mathbb{R}^{B \times T_{ih} \times D}$;
- LCB 聚合:$\text{attn\_agg} = \mathrm{LCB}(\mathrm{stack}(A_0,\dots))$,取线性是因为下面的融合 FFN 已经提供了非线性;
- 逐 token 融合 FFN:一个小 FFN 把每个物品 token 与该 token 从所有 $S$ 条序列检索到的向量混合成一个 $D$ 维残差增量,加到物品状态上;
- FM Highway 信号(绕过融合、跨层拼接):每层贡献
- 逐序列点积 $d_i[t] = \langle \text{item}[t], A_i[t]\rangle$,即候选与每个行为域之间的逐 token 亲和度;
- 学习式融合域点积(跨 $S$ 个输出做一个 NCB,再与物品状态点乘);
- 聚合 Gram $G = \text{item} \cdot \text{attn\_agg}^{\top}$,即完整的两两点积矩阵;
- user–item 跨总线点积(在融合之后计算,是 mixing 总线的用户 token 与检索总线的物品 token 之间的内积)。
这四组合起来构成式 (2) 中的 $\phi^{\ell}$。
总线级融合(FuseFFN,标准 MLP-Mixer)¶
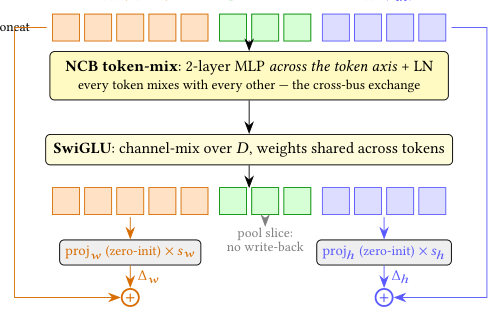
三组 token——$w_{\text{out}}$($T_u + T_i$ 个)、pooled($S \cdot C$ 个)、$h_{\text{out}}$($T_{ih}$ 个)——沿 token 轴拼接,然后依次通过:
- NCB token-mix:跨 token 的非线性混合,每个 token 与其他每个 token 混合,这就是跨总线交换本身;
- 逐 token SwiGLU channel-mix:在 $D$ 上做通道混合,权重跨 token 共享;
- 逐侧的零初始化投影,乘以逐侧可学习门(sigmoid,初值 0.5),产出两条总线各自的残差增量 $\Delta w$、$\Delta h$。
池化 token 走"pool slice:no write-back",即不回写。因为侧投影是零初始化的,融合在训练开始时是恒等映射,是被逐步学进来的。
4.5 分类器读出¶
最终总线状态不被整体展平。压缩读出 $\rho$ 有两部分:
- 一个 NCB 把 $(T_u + T_i + T_{ih})$ 个拼接后的总线 token 压成少数几个读出 token,再展平;
- 一个跨总线 Gram——mixing 总线与检索总线 token 之间的全部两两内积,在未压缩的状态上计算——被追加进来,使压缩无法抹掉显式的二阶信号。
分类器输入拼接 $\rho$、层间拼接的 FM Highway $[\phi^1;\dots;\phi^L]$(经 LayerNorm)以及经 LayerNorm 的 skip-embedding 信号 $e_{\text{skip}}$,送入一个 2 层 MLP 和一个线性头;logits 被截断到 $[-20, 20]$。另有一个辅助转化延迟头贡献第二个损失项。
4.6 多路互学习(DML)¶
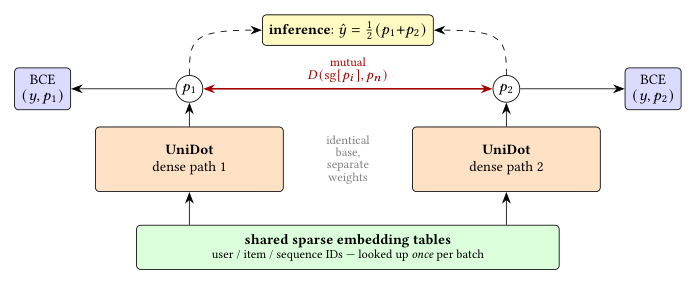
把单个模型训练成两条 UniDot 路径,在同一批数据上联合训练,共享一套(且占主导的)稀疏 embedding,推理时对两条路径的 logit 求平均。动机来自 Deep Mutual Learning 原文识别的正则化效应:两条路径互相模仿对方的预测,收敛到一个更宽、更平坦的极小值——一个它们互相认同的鲁棒解。平坦极小值对未见数据泛化更好,而这恰是本设定所奖励的性质:测试期比训练期领先一步,且大多数候选 user–item 对都是新的。
互学习目标:设 $z_n$ 为路径 $n$ 的 logit,$p_n = \sigma(z_n)$。每条路径既被自身预测上的任务损失监督,也被拉向其他路径的detach 后的预测:
$$\mathcal{L} = \sum_{n=1}^{N}\Big[\mathcal{L}_{\text{task}}(y, p_n) + \frac{\lambda}{N-1}\sum_{i \neq n} D\big(\mathrm{sg}[p_i],\, p_n\big)\Big] \tag{5}$$
其中 $\mathcal{L}_{\text{task}}$ 是 BCE(加辅助延迟头),$\mathrm{sg}[\cdot]$ 是 stop-gradient,$D$ 是概率上的平方误差 $D(a,b) = (a-b)^2$。提交方案用 $N=2$ 条路径、互学习权重 $\lambda = 20$,互学习项在第一个 epoch 之后才打开。
服务:推理时对两条路径的 logit 求平均。只服务单条路径成本是 $1\times$,已经得到 0.83184 的测试 AUC——只比两路平均(0.83217)低 0.033%,是一个可行的廉价部署方案。
关键实现细节(附录 C)¶
这些组件与核心架构(§4)大体正交——是数据相关的特征处理与训练机制——但对复现报告数字很关键。
C.2 逐位置权重(user_dense 配对)¶
十个 user_dense 数组不是特征,而是逐位置乘子。每个都与同编号的多值 user_int fid 逐位置对齐(长度相同),在池化前缩放该 ID 的 embedding,使每个取值的贡献都被其配对统计量加权(如停留时长或交互次数)。两类分别处理:
- 计数型 fid(62–66、118、121):过一个固定的 $\log(1+x)/10$ 变换——log 驯服重尾,除以 10 把它落到接近单位的范围——然后乘上匹配的 embedding;
- 相似度型 fid(89–91,带符号的 cosine / score 值):截断到 $[-1, 1]$ 后直接作为带符号乘子,因此负的亲和度可以把某个取值的 embedding 减掉。
两种变换都用固定(非学习)常数,因此这个加权在 §C.7 的冷重启重新初始化之间是稳定的。
C.3 FAFE(字段感知特征嵌入)¶
少数高价值多值 user_int 字段——fid 15、63–66、115–118、121、122(行为 ID 列表)——采用候选感知池化而非静态池化。其余字段保持 §4.2 的静态 NCB 池化。这样把候选感知集中在真正能获益的大型行为 ID 列表上,避免了把整个 tokenizer 都做成 target-aware 所带来的回退。
C.4 预训练 embedding 的投影与归一化¶
- 归一化:其重尾的计数维度先用在训练集上一次性估计出的固定统计量标准化到零均值/单位方差(不是 per-batch),这样推理看到的缩放与训练一致,投影器也不会被长尾破坏稳定性。
- 投影:每个归一化向量由一个 2 层(Linear–GELU–Linear)MLP 映射成几个 $d$ 维 token,再由一个共享的逐 token LayerNorm 拉到单位尺度——与 §4.2 的 NCB LayerNorm 尾巴匹配,使总线 token-mix 不会系统性压低 embedding token。
- 结构化子向量嵌入:一个预训练 fid(LMF4Ads,320 维)不是单个向量,而是 10 个各自独立 L2 归一化的 32 维子向量的拼接,每个要么是单位向量要么全零(padding)。把它压平成一个 320 维输入再过上述 MLP 会模糊这个块结构、并把各自独立归一化的子空间混在一起,因此这个 fid 走一个结构化 tokenizer:reshape 成 $10 \times 32$,用一个共享线性映射把每个 32 维槽位提升为一个 token,按槽位范数是否非零 mask 掉零填充槽位(这样空槽位的 bias 就无法泄漏进来),再用一个 LCB 把 10 个槽位 token 压到与扁平路径相同的 per-fid token 数(其 LayerNorm 尾巴给出单位方差 token)。其余 emb fid(如 SUM,一个整体归一化的 256 维 embedding)保持扁平 MLP 投影。
C.5 高基数 skip embedding¶
基数超过阈值(2M)的 fid 被移出逐 fid 路径,交给一个共享的哈希(hashing trick)表。它们的池化信号也直接喂进分类器(式 (3) 的 $e_{\text{skip}}$),并在冷重启时重新初始化。item-id fid 另外享有一张专属的 2M 槽位乘法哈希表,其 embedding 喂给物品 tokenizer。这一处理直接针对数据集里 fid 116 约 9.4M 取值的极端基数。
C.6 辅助转化延迟头¶
一个专属 trunk + head 在 MSE 损失下回归 $\log\big(1 + (t_{\text{label}} - t_{\text{event}})\big)$,即到用户下一次动作的延迟。mask 是 $t_{\text{label}} > t_{\text{event}}$(存在下一次动作),因此它同时覆盖"点击但未转化"与"转化"两类行——大致是全部行,而不只是约 12% 的正样本,辅助信号量约为 8×。它贡献式 (4) 的 $\lambda\mathcal{L}_{\text{delay}}$ 项($\lambda = 0.01$)。
C.7 优化与训练¶
双优化器:embedding 参数用 Adagrad(稀疏梯度)。稠密参数被拆开:$\geq 2\mathrm{D}$ 的矩阵权重用 Muon(Moonshot 变体,它加入解耦权重衰减、并把正交化后的更新重缩放到与 AdamW 的更新 RMS 匹配,因此 AdamW 调好的学习率可以直接迁移、不需要单独搜 Muon 的 LR;权重衰减 1e-3),而 1D 参数(LayerNorm scale、bias)走一个 AdamW 辅助组(权重衰减 0)。两者共享一个线性 LR warmup,可选在每个冷重启边界衰减。
冷重启:在第一个 epoch 之后的每个 epoch 边界,基数高于阈值的 embedding 表——在当前配置下阈值为 0,即所有表——连同它们的 Adagrad 状态一起重新初始化,而稠密参数保留:骨干跨 epoch 持续训练,embedding 则每个 epoch 重新学一遍,作为一个与"训练/测试之间领先一步的时间差"相匹配的正则化器。每次重新初始化之后稠密学习率会重新 warmup(第二段 warmup 调度),让重学的 embedding 先稳下来再恢复满速更新。
时间分桶:连续差值 $t_{\text{now}} - t_{\text{event}}$ 映射到 64 个 embedding 槽位(0 为 padding),边界跨越约 1 秒到约 1.5 年,容量集中在 1 小时–18 个月区间(recency 加权的网格)。
Logit 截断:前向 logits 截断到 $[-20, 20]$。
EMA 权重:追踪稠密参数的指数滑动平均(decay 0.999);当有 held-out 划分可用时,每个 epoch 发布 live 与 EMA 中在其上得分更高的那一份,最终全量数据提交则服务 EMA 权重。EMA 在每个重新初始化后的 warmup 窗口内被重置为 live 权重,使高方差的重新预热步不污染平均。
实验设置¶
数据集(附录 A)¶
比赛发布了一个基于真实腾讯广告日志构建的、完全匿名化的大规模广告数据集,分两轮;本文参加工业赛道。所有稀疏特征是匿名整数 ID,所有稠密特征是定长浮点向量;不发布原始内容或 PII。
Table 6:工业赛道数据集与 schema(第二轮;括号内为第一轮)
| Quantity | Industrial track |
|---|---|
| 训练 / 测试样本 | 35M / 12M(第一轮 2M) |
| 列数(类目) | 142(7) |
| User Int / Dense fid | 54 / 17 |
| Item Int / Dense fid | 17 / 4 |
| 预训练 emb fid(u/i) | 7 / 4 |
| 按位置对齐的 fid | 10 |
| 行为域 | 4(9/14/12/10 个字段) |
| 高基数 ID(fid 116) | ≈9.4M |
| 标签 / 指标 | 转化 / AUC |
每个样本是一次 user–item 交互,含两类输入:非序列多字段特征(user_int / item_int 类别 ID,单值与多值;user_dense / item_dense 连续向量,其中包含预训练 embedding,如用户侧 SUM 与 LMF4Ads、物品侧 embedding);四个域的行为序列特征(seq_a 到 seq_d,每域 9–14 个字段,是带时间戳与动作类型的时序事件列表)。
有两条 schema 性质直接塑造了模型:其一,若干 user_dense 数组与对应的 user_int 数组逐元素对齐——每个 dense 值是该 ID 的逐元素统计量(如停留时长或分值),不是独立特征,UniDot 因此按其本意把它们当作 ID embedding 的逐位置权重消费;其二,少数 ID 基数极端(fid 116 约 9.4M),促成了 §C.5 的 skip-embedding 处理。
训练与评估设置(附录 B)¶
- 数据:TAAC × KDD Cup 2026 工业赛道(35M 训练 / 12M 测试;第一轮 2M),转化标签。
- 指标:ROC 的 AUC(官方);另报告 LogLoss。
- 训练:有效 batch ≈3k(本地 A/B)/ ≈12k(online,4 GPU),双 Adagrad/Muon(稠密 LR 4e-4、Muon 权重衰减 1e-3、稀疏 LR 0.1),100 步 warmup,BCE + 辅助延迟($\lambda = 0.01$),torch.compile 与 bf16 autocast。
- 模型:提交配置见 Table 8(约 2.1B 参数,$d_{\text{model}} = 128$,$N=2$ 多路)。
- 推理:服务模型用 torch.compile 与 bf16 autocast。在 12M 测试集上的端到端推理加评估(含一次性编译)约 14,500 秒(两路模型)与约 7,200 秒(单路,大约一半),均在比赛的推理预算内。bf16 autocast 只带来极小的 AUC 退化(< 0.0001)。
Table 7:训练/评估模式
| Mode | 数据(训练 / 评估) | GPU | 角色 |
|---|---|---|---|
| tiny | 4M / 1M,随机 hold-out | 1 | 快速设计 A/B |
| remote | 35M / 10% 随机 hold-out | 4 | 全规模验证 |
| final | 35M / 无 hold-out | 4 | 提交(EMA 权重) |
tiny 模式把数据限制到随机的 4M 训练 / 1M 评估子集、单 GPU,用于设计选择的快速 A/B;remote 把存活下来的配置提升到全量数据、4 GPU 带 held-out 划分,确认收益在全规模仍成立;final 在全部数据上重训并服务 EMA 权重。
Table 8:支撑报告数字的提交配置
| Group | Setting |
|---|---|
| 宏层 $L$ / 每层 mix 块 $W$ | 6 / 2 |
| $d_{\text{model}}$ | 128 |
| Token-mix 块 | Wukong(并行 LCB + FMB,rank 32) |
| 用户 NS / 用户 emb token | 8 / 2(×7 fid)⇒ $T_u = 22$ |
| 物品 NS token(mix / retrieval 总线) | 4 / 16(+ 4 个 emb fid ×2)⇒ $T_i = 12$,$T_{ih} = 24$ |
| Fuse / 分类器 hidden 倍数 | 4 / 8 |
| 序列近期窗口 | a:256 b:256 c:512 d:512 |
| 合并流 | abcd:512(⇒ $S = 5$) |
| 序列 fid 压缩 token | 4(→ 512 维/位置) |
| DIN cond token(u/i/emb/fused) | 2 / 4 / 1 / 4 |
| Trunk 编码器 | Transformer,1 层,4 头,因果,窗口 $w=128$,RoPE |
| Pre-trunk 编码器(逐域 + 合并) | depthwise Conv1d,kernel 21 |
| 视图投影 | Linear→LN→GELU,view stride 1 |
| FuseFFN delta 门 | sigmoid(·),初值 0.5 |
| 分类器读出 | NCB 压到 4 个 token + 跨总线 Gram |
| Skip-emb 阈值 / 类型 / 槽位 | 2M / hash / 2M |
| item-id 哈希表 | 2M 槽位 |
| 稠密优化器 | Muon(wd 1e-3);稀疏:Adagrad |
| 损失 | BCE;辅助延迟($\lambda = 0.01$) |
| 多路(DML) | $N=2$ 路,共享稀疏 emb |
| 互学习损失 / 权重 | MSE / $\lambda = 20$(从 epoch 1 起) |
| 参数量 | ≈2.1B(embedding 主导) |
Token 预算算下来:$T_u = 8 + 7 \times 2 = 22$ 个用户侧 token,$T_i = 4 + 4 \times 2 = 12$ 与 $T_{ih} = 16 + 4 \times 2 = 24$ 个物品侧 token,$S = 4 + 1 = 5$ 条序列(四个行为域加合并流);fid 轴压缩给出统一的 $4 \times 128 = 512$ 维每位置宽度。参数总量约 2.1B 但由 embedding 主导(稀疏查表),稠密计算路径只有数千万参数。因为逐 fid embedding 表宽度就是 $d_{\text{model}}$,把 $d_{\text{model}}$ 从 64 提到 128 大致把占主导的 embedding 参数量翻倍。
主要实验结果¶
Table 1:最终工业赛道排行榜(第二轮,前 10)
| Rank | AUC ↑ | Gap to #1 |
|---|---|---|
| 1 | 0.83254 | — |
| 2(UniDot,本文) | 0.83217 | 0.037% |
| (UniDot,单路径)★ | 0.83184 | 0.070% |
| 3 | 0.83145 | 0.109% |
| 4 | 0.83080 | 0.174% |
| 5 | 0.83073 | 0.181% |
| 6 | 0.83036 | 0.218% |
| 7 | 0.82915 | 0.339% |
| 8 | 0.82888 | 0.366% |
| 9 | 0.82881 | 0.373% |
| 10 | 0.82854 | 0.400% |
★ 服务全量数据 DML 模型的单条路径($1\times$ 推理成本)仍然能排第二——多路训练把单模型也拉到了更好的极小值。
结论分析:这张表最值得注意的不是名次,而是榜单前十的总跨度只有 0.400% AUC,而 UniDot 与第一名的差距是 0.037%。也就是说,在这个数据集上不同参赛架构之间的可分辨性非常低,任何架构层面的因果归因都必须谨慎——这是后文讨论局限性的基础事实。真正有信息量的是单路径 vs 两路平均的对照:$2\times$ 稠密成本只换来 0.033%,说明大部分收益在训练阶段(互相正则化)已经落进单模型,推理端的集成只是补尾。
Table 2:$d=128$、$N=2$ 多路运行的逐 epoch 训练动态(Eval/Test (sel.) 为模型选择运行,remote,10% held-out;Test (final) 为最终提交,全量数据重训 + EMA;LL = LogLoss,train 跨两条路径、eval 在其均值上;"—" 表示未提交)
| Ep. | Train AUC | Eval AUC | Test (sel.) | Test (final) | Train LL | Eval LL |
|---|---|---|---|---|---|---|
| 1 | 0.83193 | 0.84181 | 0.82772 | — | 0.43395 | 0.21259 |
| 2 | 0.84232 | 0.84441 | 0.83031 | 0.83036 | 0.42422 | 0.21113 |
| 3 | 0.84606 | 0.84558 | 0.83136 | 0.83143 | 0.42072 | 0.21058 |
| 4 | 0.84962 | 0.84607 | 0.83193 | 0.83195 | 0.41750 | 0.21029 |
| 5 | 0.85485 | 0.84629 | 0.83196 | 0.83217 | 0.41288 | 0.21048 |
| 6 | 0.86199 | 0.84568 | — | 0.83212 | 0.40679 | 0.21116 |
结论分析:Train AUC 单调上升到 0.86199 而 Eval AUC 在 epoch 5 见顶后回落,Eval LogLoss 也在 epoch 4 触底——这是教科书式的过拟合转折点,最终提交因此取 epoch 5 的 EMA 权重。值得注意的是,尽管每个 epoch 都把 embedding 表冷重启一遍(§C.7),骨干仍然在第 6 个 epoch 开始过拟合,说明冷重启是减缓而非消除了记忆效应。另外 Eval AUC(0.846)系统性高于 Test AUC(0.832)约 1.4 个点,反映 held-out 随机划分与"时间上领先一步"的真实测试期之间存在明显分布差——这也解释了作者为何把"平坦极小值有利于泛化"当作 DML 的主要动机。
Table 3:第二轮增量改进(每行加一项改动)
| # | Change | Test AUC | Δ |
|---|---|---|---|
| 0 | competition baseline | 0.81398 | — |
| 1 | + UniDot | 0.82500 | +1.102 |
| 2 | + item-id 哈希 embedding | 0.82565 | +0.064 |
| 3 | 调 token 数 | 0.82609 | +0.044 |
| 4 | 调 batch size | 0.82704 | +0.095 |
| 5 | + 更多 FM-Highway 点积 | 0.82722 | +0.018 |
| 6 | + depthwise-conv pre-trunk | 0.82736 | +0.014 |
| 7 | + 辅助延迟损失 | 0.82812 | +0.075 |
| 8 | + FAFE | 0.82837 | +0.026 |
| 9 | 调学习率 | 0.82894 | +0.056 |
| 10 | + EMA 权重 | 0.82993 | +0.099 |
| 11 | scale $d_{\text{model}}$ 64→96 | 0.83024 | +0.031 |
| 12 | scale $d_{\text{model}}$ 96→128 | 0.83043 | +0.019 |
| 13 | + 多路 DML($d=64$) | 0.83128 | +0.085 |
| 14 | 多路 DML($d=128$) | 0.83196 | +0.068 |
| 15 | + 全量数据重训 | 0.83217 | +0.021 |
| 相对 baseline 总计 | +1.818 |
结论分析:最大的单跳是 UniDot 本身(+1.102%),占总提升 +1.818% 的 61%。但这一行把整个架构替换打包成了一个数据点——它相对的"competition baseline"是什么架构、参数量是否匹配,论文没有说明,因此这 +1.102% 无法被拆解为"统一 token 空间"、"双总线"、"FM Highway"各自的贡献。剩下 +0.716% 由十四项工程改动累加而成,其中没有任何单项超过 +0.1%;调 batch size(+0.095)、EMA(+0.099)、辅助延迟损失(+0.075)这三项纯训练技巧加起来(+0.269)已经超过 $d_{\text{model}}$ 从 64 翻到 128 的架构扩容(+0.050)五倍以上。这张表诚实地暴露了一件事:在这个数据规模上,训练配方的边际收益压过了架构扩容的边际收益。
消融与分析¶
Table 4:组件消融(tiny 模式,单路径,$d=64$;同分布 held-out 评估,因此只有相对差距有意义)
| Variant | AUC ↑ | LogLoss ↓ | ΔAUC |
|---|---|---|---|
| Full UniDot(6 层) | 0.83657 | 0.2151 | — |
| 2 macro-layers | 0.83600 | 0.2157 | −0.057% |
| 4 macro-layers | 0.83603 | 0.2154 | −0.054% |
| 8 macro-layers | 0.83624 | 0.2152 | −0.033% |
| 10 macro-layers | 0.83615 | 0.2152 | −0.042% |
| −FM Highway(全部) | 0.83530 | 0.2159 | −0.127% |
| −cross-bus dots only | 0.83570 | 0.2156 | −0.087% |
| −multi-channel seq pool | 0.83624 | 0.2155 | −0.033% |
| −token-mixing bus(identity) | 0.83590 | 0.2161 | −0.067% |
| −FuseFFN(无总线融合) | 0.83679 | 0.2154 | +0.022% |
| −sequence cross-attention | 0.83604 | 0.2153 | −0.053% |
| −merged cross-domain stream | 0.83619 | 0.2152 | −0.038% |
逐项分析:
- 深度:收益到默认的 6 个宏层为止;8–10 层在 4M 数据集上过拟合。但注意 2 层与 6 层的差距只有 0.057%,而 8 层比 6 层只差 0.033%——深度这个"唯一的深度旋钮"在本数据规模上的可分辨收益极小,"one stackable block, 深度可扩展"这一卖点在实验上并未被证成。
- FM Highway 是最重要的组件(−0.127%),且仅移除跨总线点积就已经损失 −0.087%(占 highway 全部贡献的 69%)。这直接支撑了论文的中心论点:把跨 user–item 边界的内积保持为显式运算是有价值的,深残差栈确实会冲刷掉这部分二阶信号。 这是全文最扎实的一条证据链——中心主张与最大消融损失对得上。
- token-mixing 总线(−0.067%) 比 序列交叉注意力(−0.053%) 更重要。作者对后者的解释是:多通道池化捕获了其中大部分同类信号——也就是说,把序列池化成 token 注入 mixing 总线,已经替代了大部分"物品 token 逐层去 query 序列"的作用。这个解释是自洽的(−multi-channel seq pool 也只有 −0.033%,两者互为冗余),但也意味着序列检索总线这条被写进标题与摘要的支柱,其独立边际贡献很小。
-
FuseFFN(+0.022%):移除总线融合反而略微提高 AUC,只是 LogLoss 变差(0.2154 vs 0.2151)。作者没有回避,明确写道该模块的贡献"并非完全确定"(not fully conclusive),并给出解释:他们不把这读作反对跨总线交换的证据,而是读作融合器设计得不够好——其静态路由是薄弱环节,一个输入条件化(二阶)的融合器是最清晰的开放方向。 这一点必须严肃对待:"两条总线每层通过 MLP-Mixer 融合交换状态"是摘要与 Figure 1 的头号卖点,而它在自家消融里 AUC 为负贡献。 结合上一条,实际扛事的是 FM Highway(显式点积)+ 多通道池化(把序列摊进 mixing 总线),而不是叙事所围绕的"双总线逐层协同演化"。
-
合并跨域流(−0.038%):正贡献但很小,与 Table 3 中同类的小改动量级一致。
Scaling 研究¶
Table 5:Scaling 研究
| Configuration | Dense par. | GFLOP | Test AUC ↑ | Δ |
|---|---|---|---|---|
| $d=64$,sparse fold×2 | 18.8M | 5.9 | — | no win |
| $d=64$(baseline) | 18.8M | 5.9 | 0.82993 | — |
| $d=96$ | 36.7M | 12.4 | 0.83024 | +0.031% |
| $d=128$ | 60.3M | 21.2 | 0.83043 | +0.050% |
| $d=64$,2-path | 37.6M | 11.7 | 0.83128 | +0.135% |
| $d=128$,2-path | 120.6M | 42.5 | 0.83196 | +0.203% |
结论分析:在这个任务上有产出的 scaling 轴是稠密容量而非稀疏容量。单独把 embedding 宽度翻倍没有拿到任何 A/B 胜利——高基数表不是瓶颈。把稠密路径从 64 加宽到 96 再到 128,AUC 单调提升但收益递减(累计 +0.050%)。
一条更有意思的对照:在互蒸馏下加第二条相同路径,是对稠密容量更有效的用法——$d=64$ 时 +0.135%,超过整个宽度扫描(+0.050%)的两倍以上,代价是稠密参数与 FLOPs 翻倍但 embedding 表不变。两条轴可以叠加:$d=128$ 加两条路径达到 0.83196(相对 $d=64$ 单路基线 +0.203%),即提交方案;全量数据重训再给到 0.83217。
需要指出这个对照的含义:"扩容架构"输给了"训练两个模型互相正则化"。$d=64$ 双路(37.6M 稠密参数,11.7 GFLOP)比 $d=128$ 单路(60.3M,21.2 GFLOP)参数更少、FLOPs 更少、AUC 更高(0.83128 vs 0.83043)。这对一篇以"可堆叠、易扩展的统一块"为卖点的论文来说是一个反向信号:在该数据规模上,架构容量并不是紧约束。
附录 D:数据 scaling 研究
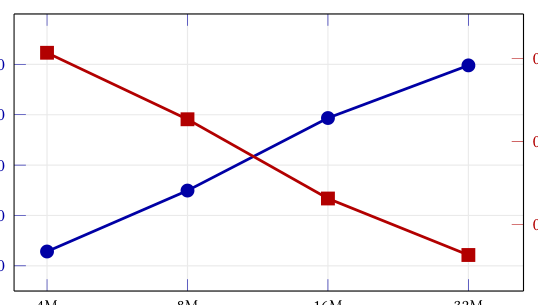
保持模型为 tiny 配置(单路径 $d=64$)、只改训练样本上限:
| 训练样本 | Held-out AUC | LogLoss |
|---|---|---|
| 4M | 0.83657 | 0.2151 |
| 8M | 0.83899 | 0.2139 |
| 16M | 0.84187 | 0.2125 |
| 32M | 0.84396 | 0.2115 |
结论分析:held-out AUC 随数据对数线性上升,约每翻倍 +0.0025 AUC,LogLoss 同步下降。跨完整 32M 区间趋势干净、没有折点,说明这个统一块是"数据饥渴"的、尚未饱和——作者以此论证生产环境 / scaling-law 后续工作的必要性。把这条与 Table 5 并读,结论其实很清楚:在 35M 样本这个规模上,瓶颈是数据而不是模型容量,这也解释了为什么宽度扩容与深度扩容的收益都这么小。
核心贡献总结¶
- 一个视角:把 FM 内积与 attention 的 query·key 打分识别为同一原语,因此单一的 token 点积可以同时承载特征交互与序列建模;并主张在信号跨越 user–item / candidate–history 边界处保持这个点积为显式运算,用深层机器去精炼其操作数而非替换它。
- 一个架构:单一可堆叠宏块,内含并行的 token-mixing 总线与序列检索总线,逐层经标准 MLP-Mixer(FuseFFN,零初始化侧投影 + 可学习门)交换残差增量。
- FM Highway:逐层的逐序列点积、融合域点积、聚合 Gram、跨总线 user–item 点积,跨层拼接后绕过融合路径直送分类器——本文自家消融中贡献最大的单一组件。
- 一条共享序列流水线:多域 + 时间戳交错合并流,每次前向只编码一次(跨域合并 → depthwise Conv1d → DIN 式条件门控 SwiGLU(候选只进门)→ 因果窗口化 RoPE Transformer → 逐消费者视图投影),从而约束推理时延。
- 一套训练配方:稀疏/稠密双优化器(Adagrad + Muon/AdamW 三分组)、辅助转化延迟头(覆盖约 8× 于正样本的行)、每 epoch embedding 冷重启 + 二次 warmup、EMA、logit 截断、共享 embedding 上的多路互学习。
- 成绩与诚实度:TAAC × KDD Cup 2026 工业赛道亚军(0.83217 AUC),且明确标注了两处自家不利/不充分的证据(FuseFFN 消融为正、槽位替换实验只是指示性)。
与已归档相关工作的对比¶
WHALE WHALE: A Scalable Unified Model for Recommendation with Wukong-HSTU (Meta Platforms, 2026-07-19)¶
关系:独立并发(本文未引用 WHALE,且两者同属 Meta)· 已加载对方精读
- 共同关注的问题:两篇诊断的 root cause 字面重合——特征交互模型与序列模型是两条独立演化、各自无法覆盖对方核心目标的传统,而生产系统里流行的"浅层混合"(先把历史压成少量摘要 embedding 再喂进交互塔)在两个信号源之间制造了一个浅接口:历史一旦被压成固定摘要,高阶特征交互就无法再在细粒度事件层面选择性抽取证据。两篇都把"逐层反复交换"作为破局点。
- 相近的技术骨架:抽象后几乎是同一张流程图——每层内并行保持两个骨干活跃(WHALE:Wukong 模块 + HSTU 模块;UniDot:Wukong token-mixing 总线 + 序列检索总线),用非序列侧的高阶交互表示去 query 序列侧的细粒度表示(WHALE:$Q$ 来自 Wukong 输出、$K/V$ 来自 HSTU 输出;UniDot:物品 token 作 query 交叉注意各域视图),两条路径各自保有独立的传播通道并只通过融合模块交换(WHALE 的 Fusion MLP + SwiGLU FFN 残差;UniDot 的 FuseFFN 零初始化门控残差)。连默认的非序列骨干都同为 Wukong 的 LCB + FMB。
- 本文的差异与推进:其一,序列侧的算力分配相反。WHALE 每层都跑一次 HSTU 模块($X_s^{(\ell+1)} = H_s^{(\ell)}$),序列表示逐层被重新编码;UniDot 把序列每次前向只编码一次并共享给所有消费者,层间只用廉价的逐消费者视图投影器(Linear→LN→GELU,view stride 1)刷新——这是 UniDot 用来"约束推理时延"的核心手段,代价是序列侧的表征容量被钉死在一个 1 层、窗口 128 的 trunk 上。其二,跨边界信号的形态不同:WHALE 把跨分支交换完全交给 softmax 注意力 + Fusion MLP,内积只是注意力内部的一步;UniDot 把这些内积抽出来做成一条独立的 FM Highway,跨层拼接后绕过融合器直送分类器。其三,UniDot 多出一条并行的池化通路(MultiChannelSeqPool 把序列摊成 token 注入 mixing 总线),而 WHALE 没有对应物。
- 可比的方法 / 实验差异:WHALE 在 Meta 生产环境有离线评估 + 线上 A/B,并报告了对序列长度、模型深度、模型宽度三个维度的良好 scaling;UniDot 只有比赛数据集,且其深度扩展在 4M 子集上 8–10 层就过拟合、宽度扩展 64→128 只值 +0.050% AUC。两者的消融也给出了相反倾向的信号:WHALE 把"逐层跨分支交换"确立为可用的设计原则;UniDot 自家消融里移除跨总线融合(FuseFFN)反而让 AUC 上升 0.022%。考虑到两组作者同属一家公司、时间相差一个月,这更像是同一设计直觉在"有生产反馈"与"只有单一比赛数据集"两种验证条件下的分化——WHALE 的证据强度明显更高。
SlimPer SlimPer: Make Personalization Model Slim and Smart (Meta Platforms, 2026-07-14)¶
关系:显式引用但原文未展开对比(正文仅两句:「Following the recently introduced SlimPer framework, we designed UniDot」与「UniDot is a preliminary public-dataset test of this framework」)· 已加载对方精读
- 共同关注的问题:SlimPer 论证判别式排序没有 token 级自回归监督,因此没有理由维护随序列长度膨胀的大型中间张量;正确抽象是对一个紧凑定长
<user, item>知识库做迭代精炼。UniDot 继承了这个前提:它的持久状态被刻意钉在 $(T_u + T_i, D) = (34, 128)$ 与 $T_{ih} = 24$ 这样的小 token 预算上,而序列以 $S=5$ 条视图的形式留在外面被反复 query,而不是被逐层压进隐状态。 - 相近的技术骨架:SlimPer 每层三步 Select–Match–Refine 与 UniDot 每层的结构可以逐项对上——Select ↔ 物品/用户 token 作 query 去交叉注意各序列视图;Match(模板与检索结果之间的显式点积相关性分数 $\lambda_s, \lambda_e$)↔ FM Highway 的逐序列点积 / 融合域点积 / 聚合 Gram / 跨总线 user–item 点积;Refine ↔ 逐 token 融合 FFN 产生的残差增量。两者都强调"每层都直接访问原始 token 而非上一层的压缩表示",SlimPer 用信息瓶颈框架把它论证为"迭代压缩打破了数据处理不等式的马尔可夫链",UniDot 则以 "embed once, share" 的工程形式实现同一件事。SlimPer 的 ROO(用户侧 token 每请求批只算一次、在候选间共享)与 UniDot 的"序列每次前向只编码一次、被所有消费者共享"也是同一思想在不同粒度上的表达。
- 本文的差异与推进:其一,UniDot 把 SlimPer 的单一 KB 拆成了两条总线——SlimPer 的 $\mathcal{X}^k$ 是一份统一知识库,UniDot 分成 token-mixing 总线(负责非序列高阶交叉)与序列检索总线(负责候选–历史匹配),并另加 FuseFFN 交换。其二,UniDot 把"显式点积匹配"从 KB 更新的一个中间量升格为一条独立的、跨层拼接、绕过融合直达分类器的 highway——SlimPer 的 $\lambda$ 经 RMSNorm 后进入 $\mathcal{X}^{k+1}$ 的更新(即仍在残差栈内),UniDot 则明确让它绕开残差栈,理由正是"深残差栈会冲刷掉 FM 式二阶信号"。其三,UniDot 用 Wukong 的 LCB + FMB 作为非序列侧的显式交叉骨干,SlimPer 则刻意只用最小积木(MLP、QKV attention、线性投影、RMSNorm)。
- 可比的方法 / 实验差异:SlimPer 在 Instagram Reels 与 Feed 两大排序场景全量部署,并能有效建模 10k+ 细粒度历史事件,其复杂度分析给出 stacked-layers 显存 $O(L\cdot K)$、用户–物品交互容量 $O(L\cdot N\cdot K)$;UniDot 只在一个 35M 样本、窗口 256–512 的比赛数据集上验证,序列长度比 SlimPer 的生产设定小一到两个数量级。因此 UniDot 对该框架的检验只覆盖了 SlimPer 主张中"质量"的一半,完全没有触及"把深度与序列长度解耦"这个 SlimPer 最核心的效率论断——在 $L_s \leq 512$ 的规模上,二次注意力本来也不是瓶颈。作者自称"preliminary public-dataset test"是准确的。
CCFormer CCFormer: Efficient Cross-field Interaction and Hierarchical Sequence Compression (Tencent PCG, 2026-07-30)¶
关系:独立并发(本文未引用 CCFormer,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都反对"把所有 token(用户画像、历史行为、目标物品)拼成一条长序列做全局自注意力"这一统一范式。CCFormer 的措辞是这样做既产生不必要的计算,也削弱各特征域的语义角色;UniDot 的措辞是 OneTrans / TokenFormer 那类把一切嵌成同一条序列的做法必须去对抗 sequential collapse,而 UniDot 的双总线分离从构造上就避免了它。两者指向同一个 root cause:异构特征域被一视同仁地处理。
- 相近的技术骨架:都把输入显式划分为语义域并逐层各自传播 + 有向交叉。CCFormer 分成用户画像 / 行为序列 / 目标物品三域,用特征域分离的有向交叉注意力($\mathbf{O}_{u\to s}$、$\mathbf{O}_{t\to s}$、$\mathbf{O}_{t\to u}$)让紧凑的用户/目标 token 去 query 全长行为序列,复杂度是 $O(L_u L_s)$、$O(L_t L_s)$ 而非 $O(L_s^2)$;UniDot 的序列检索总线让 $T_{ih}=24$ 个物品 token 去 query $S$ 条序列视图,是同一个"少数紧凑 token 检索长序列"的形状。两者也都在序列进入交互前做局部压缩(CCFormer 的 Conv1D 卷积压缩 + 子空间交互;UniDot 的位置局部 fid 轴 NCB + kernel 21 的 depthwise Conv1d)。
- 本文的差异与推进:其一,UniDot 多了一条真正的非序列高阶交叉骨干(Wukong LCB+FMB 的 token-mixing 总线),CCFormer 的用户域与目标域之间只有一条 $\mathbf{O}_{t\to u}$ 交叉流、没有独立的高阶交叉堆栈。其二,UniDot 把跨边界内积显式抽出成 FM Highway 送分类器,CCFormer 的所有交互都留在 softmax 注意力与残差栈内部——这正是 UniDot 自称与所有统一工作的分野,而 CCFormer 恰好是这个分野的一个新样本。其三,时序建模的位置相反:CCFormer 把相对时序-位置编码限制在大小为 $m$ 的局部行为子空间内($O(L_s m)$,含可学习的时间衰减 $\alpha\beta^{|t_i-t_j|^\gamma}$),UniDot 则把时间做成 64 槽位的分桶 embedding(跨度约 1 秒到 1.5 年、容量集中在 1 小时–18 个月)加 RoPE + 因果窗口注意力。其四,多域:UniDot 处理 4 个行为域并额外合成一条按时间戳交错的跨域流,CCFormer 是单一行为序列。
- 可比的方法 / 实验差异:CCFormer 在两个公开 benchmark + 工业数据集上对比了先进工业基线,做了 scaling law 分析,并在腾讯两个真实场景做了线上 A/B,还量化了训练最高 2.21× 加速;UniDot 只有单一比赛数据集、无公开 benchmark、无线上验证、且没有把任何一个统一架构(OneTrans / HyFormer / TokenFormer / HSTU)拿来端到端等配对比。有意思的是,两篇论文的数据都出自腾讯广告/内容场景,但 CCFormer 是主办方一侧的生产团队、UniDot 是参赛方——同一批数据下,验证条件的差距直接决定了两者结论强度的差距。
(Step 2.5 被剔除的近似候选与理由)
- HyFormer HyFormer(ByteDance AML):问题同构(统一序列建模与特征交互),但已被本文显式引用并定位——§2 明确"HyFormer 把特征交互模块与一个交叉注意行为历史的 transformer 配对;我们的序列总线把它扩展到多域加合并跨域流",§4.4 又指出"本总线的单历史单层实例即退化为 HyFormer 那类标准单历史 target-attention CTR 模块"。原文已给出机制级定位,交由 DAG 边结构化记录,叙事对比的增量有限。
- MixFormer MixFormer(ByteDance)与 OneTrans OneTrans(ByteDance):问题同构,但解法路径实质相反——两者都把序列与特征塞进单一参数空间/单一同质流,正是 UniDot 明确站在对立面的那一派(本文称这类做法让 CF 内积变成隐式的,且需对抗 sequential collapse)。属于"问题相似但解法骨架不重合",不入选。
- TokenFormer TokenFormer(Tencent):同上,且已被本文引用并点名差异("必须对抗 sequential collapse,而 UniDot 的双总线分离从构造上避免了它")。
- UniMixer UniMixer(Kuaishou)与 TokenMixer-Large TokenMixer-Large(ByteDance AML):仅是本文 token-mixing 槽位内的候选实现(作者做了槽位替换但未报告数值、且自我限缩为指示性),属于组件级 baseline 关系而非问题+解法双同构,交给 DAG。
- TMallGS TMallGS(Alibaba):同样做统一特征与序列 Transformer 排序,但其 root cause 定位在"LLM 式 all-in-one 架构的异构性鸿沟与信号稀释",解法重心是分布校准的分层 tokenization 与 Per-Field 处理,与 UniDot 的"显式点积 + 双总线"骨架抽象后不重合。
- FAT FAT(Alibaba):同为特征交互 scaling 的结构性诊断,但解法是把 field-pair 变换因子化(per-field QKV + 标量 field-pair 调制)以降参数复杂度,与"保留显式点积并旁路到分类器"不是同一条路径。
讨论与局限性¶
值得借鉴的设计¶
- "保持运算显式、用深层机器精炼操作数"是一个可迁移的设计原则。这是全文最有价值的一句方法论,且被消融支持(移除 FM Highway 是最大损失 −0.127%,其中跨总线点积独占 −0.087%)。它给出的可操作推论是:当一个深残差栈倾向于稀释某类低阶信号时,比起指望它涌现,不如为它开一条绕过残差栈、跨层拼接、直达分类器的旁路。
- "每次前向只编码一次序列、被所有消费者共享"是一个直接可抄的时延控制手段,配合逐消费者的廉价视图投影器(Linear→LN→GELU)在层间刷新,代价可控。
- "候选上下文只进门、不进值路径"(DIN 式条件门控 SwiGLU)是一个干净的抽象:让候选决定哪些位置重要,但不改变这些位置是什么,从而与位置局部压缩组合时不会互相污染。
- 一系列"尾部对齐"细节:池化 token 的 $\ell_2$ 归一化 + LayerNorm 尾巴、预训练 embedding 的共享逐 token LayerNorm——都是为了让 token-mix 不会系统性压低某一类 token 的权重。这类细节在大多数论文里被略过,本文写清楚了。
- 结构化子向量 tokenizer(LMF4Ads 的 $10\times32$ 分块、按槽位范数 mask 掉零填充以防 bias 泄漏)与逐位置权重的语义化消费(区分计数型 $\log(1+x)/10$ 与相似度型带符号截断),都体现了"按 schema 的真实语义而不是按数据类型处理特征"的态度。
- 辅助任务的样本效率视角:转化延迟头的 mask 取 $t_{\text{label}} > t_{\text{event}}$ 而非只取正样本,使辅助信号覆盖约 8× 于正样本的行——在正样本稀疏的转化预测里,这是一个廉价且合理的密集化手段。
局限与争议¶
- 无线上部署、无 A/B。论文脚注明确所有实验都在主办方基础设施上完成、未在 Meta 基础设施上进行;结论章把"在真实生产系统中部署 UniDot"列为 future work。因此本文的工业价值是潜在的而非已验证的。
- 单一数据集,且无架构级 baseline。全部数值来自一个比赛数据集,没有任何公开学术 benchmark,也没有把 HSTU / OneTrans / HyFormer / TokenFormer / InterFormer / Kunlun 中的任何一个拿来做等配的端到端对比。唯一的"vs 其他架构"是 UniDot 内部的 token-mixing 槽位替换,且未报告数值、作者自己限缩为"指示性"。这意味着"我们的统一方式优于别人的统一方式"这一隐含主张在本文中没有任何直接证据。
- 效应量极小且无方差报告。Table 4 的消融在 tiny 模式(4M 训练 / 1M 评估)下进行,差距在 0.022%–0.127% AUC 区间;Table 3 的十四项工程改动没有一项超过 +0.1%。全文没有任何种子重复、置信区间或显著性检验。在 1M 规模的 held-out 上,0.0005 量级的 AUC 差异是否可分辨,读者无从判断。榜单前十总跨度仅 0.400% 更强化了这个担忧。
- 头号叙事机制在自家消融中为负贡献。摘要与 Figure 1 把"两条总线每层通过 MLP-Mixer 融合交换状态"作为核心卖点,但 Table 4 显示移除 FuseFFN 让 AUC 上升 0.022%(仅 LogLoss 略差)。叠加"移除序列交叉注意力只损失 0.053%、且作者承认多通道池化已捕获大部分同类信号",真实的贡献结构是:FM Highway(显式点积)+ 把序列摊成 token 注入 mixing 总线扛起了主要收益,而"双总线逐层协同演化"这个叙事骨架的独立贡献并不成立。作者对此的处理是诚实的(明说"not fully conclusive"、归因于"under-designed fuser"、并把输入条件化的二阶融合器列为最清晰的开放方向),但诚实不等于该主张被证成。
- 深度与宽度的可扩展性未被证成。"堆叠 $L$ 个相同块是唯一的深度旋钮"是核心卖点,但 2 层与 6 层只差 0.057%、8–10 层过拟合;$d_{\text{model}}$ 从 64 到 128(稠密参数 3.2×、FLOPs 3.6×)只值 +0.050%;稀疏扩容"no win"。相比之下,$d=64$ 双路(37.6M / 11.7 GFLOP)以更少的参数和算力打败了 $d=128$ 单路(60.3M / 21.2 GFLOP)——最有效的"scaling"其实是集成/正则化,不是架构容量。作者把这归因于数据规模(附录 D 的数据 scaling 仍呈干净的对数线性、未饱和,约每翻倍 +0.0025 AUC),这个解释是合理的,但也等于承认架构的 scaling 性质在本文中无法被检验。
- 方法论可扩展性上的一个结构性隐患:序列侧被刻意做薄——1 层、4 头、窗口 128 的因果 Transformer,每次前向只跑一次,层间只用线性视图投影器刷新。这正是它约束时延的手段,但也意味着当参数量 scaling 时,"如何表征历史"这条路径基本不增长,扩容主要落在 token-mixing 与融合侧。与 WHALE(每层重新跑 HSTU 模块,报告了序列长度维度的 scaling)相比,UniDot 在"表征能力与序列建模能力能否一起增长"这个问题上处于更被动的位置。当然,本文序列窗口只有 256–512,这个隐患在当前规模下尚未暴露。
- 多路 DML 的定位需要小心。它本质是一个共享 embedding 的双模型协同训练 + 推理集成。作者的处理是妥当的(明确报告单路径 0.83184 并称之为"可行的廉价部署"),但把 +0.135% 记在"scaling 稠密容量"的账上,与"扩宽 $d_{\text{model}}$"并列为两条 scaling 轴,在概念上是有歧义的——前者是正则化/集成,后者才是容量扩展。
- 与已有工作的关系存在一处未披露的空白:同为 Meta、仅早一个月的 WHALE(Wukong + HSTU 双分支逐层交叉注意力融合)在骨架上与 UniDot 高度同构,本文未引用也未讨论。这不影响 UniDot 的正确性,但确实让"据我们所知这是首个……"式的定位缺了一个最近的参照点。
总体判断¶
这是一篇工程密度很高、自我审查也很诚实的参赛方案论文。它有一个真正可脱离比赛复用的方法论内核(把 CF 内积保持为显式运算,并为它开一条绕过残差栈的 highway),且这个内核被自家消融中最大的一项损失所支撑。同时它的验证条件是全文最大的短板:单一比赛数据集、无线上部署、无架构级 baseline、效应量在 0.1% AUC 以下且无方差报告,加上头号叙事机制(逐层双总线融合)在自家消融中并不成立。因此它的价值主要在于设计原则与工程配方的可借鉴性,而不在于"这个架构比别的统一架构更好"这一未被检验的主张。