From Scaling to Structured Expressivity: Rethinking Transformers for CTR Prediction¶
Alibaba Group(Beijing),KDD 2026 收录。arXiv 2511.12081v2(v1 2025-11-15,v2 2026-05-31)。四位共同一作 Bencheng Yan / Yuejie Lei / Zhiyuan Zeng / Zheye Deng,通讯作者 Bo Zheng。
研究动机与背景¶
LLM 揭示了一条规律:当架构与数据对齐时,scaling 是可预测的。模型规模、数据量、算力一起涨,性能平滑改善。这条经验催生了大量把 Transformer 搬进工业推荐(尤其 CTR 预估)的尝试。但本文指出,多数工作停留在架构模仿(architectural mimicry)——把 CTR 特征 tokenize 后直接套标准 Transformer,无论是放进传统 pointwise 框架还是改写成生成式。这些方法确实拿到了容量收益,但实证研究普遍观察到规模增长时收益迅速衰减。
本文把根因归结为结构性错配(structural misalignment):标准 Transformer 的归纳偏置与 CTR 数据的本质不符。两者虽然都是离散 token 序列,但语义结构截然不同:
- 自然语言中,语义是序列的、组合的:意义来自同质 token 的层次化构造,顺序严格,注意力由句法依赖和上下文驱动。
- CTR 预估中,预测力是组合的、域相关的(combinatorial and field-dependent):用户行为由跨域合取驱动,如"年轻用户 × 奢侈品牌"、"移动设备 × 晚间会话"。输入是异构特征集合,每个特征属于某个语义域(
user_age、ad_category、device_type),顺序是任意的;真正重要的是不同语义域之间的交互拓扑。
标准 self-attention 是为稠密有序序列上的组合语义设计的,它用全局共享的投影矩阵一视同仁地处理所有 embedding。在极端稀疏(绝大多数 field-value 组合罕见)的条件下,这种无结构注意力会放大噪声、扭曲梯度,阻碍可扩展的学习。
更麻烦的是推荐领域缺乏 scaling 的理论基础。LLM 有成熟的泛化界与建立在统计学习理论上的 scaling law,而 CTR 模型这方面基本空白。没有理论,scaling 就退化成试错,与架构设计原则脱节。于是本文提出核心问题:
能否重新设计面向推荐的 Transformer,使其表达能力与数据底层的交互复杂度协同增长——不是靠原始参数量,而是靠结构化表达力(structured expressivity)?
本文从一条经典洞见出发:域感知交互建模。FFM 为每个有序域对分配专属隐向量,实现上下文敏感建模。顺着这条思路,最自然的推广就是让 Transformer 的投影矩阵按域对特化。但直接实现的参数量代价高到离谱:$F$ 个语义域下,交互专属参数按 $O(F^2d^2)$ 二次增长。真实系统里 $F \sim 10^3$、$d \sim 128$,一个中等规模的基座模型会从 1 亿参数暴涨到超过 10 万亿,深度 scaling 根本无从谈起。
FAT(Field-Aware Transformer)就是为化解这个"表达力 vs 可扩展性"张力而生的。
核心方法 / 模型架构¶
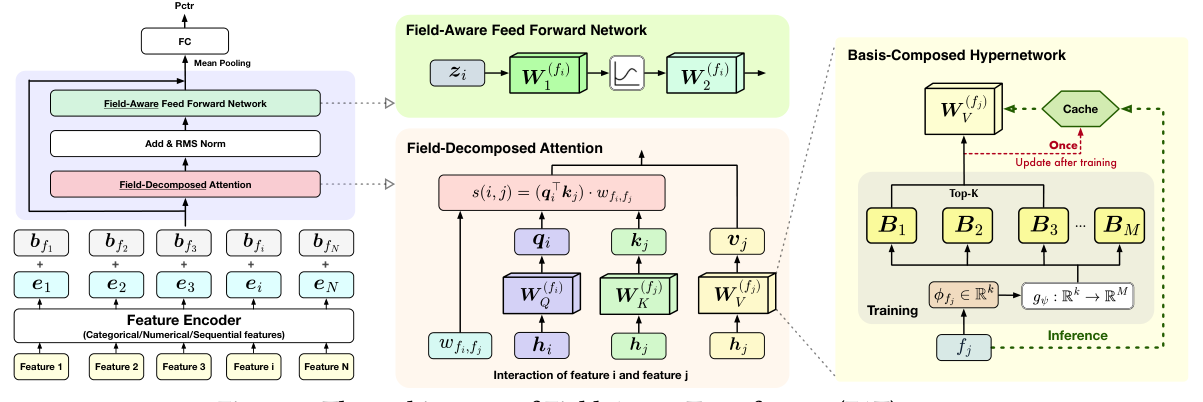
FAT 从输入到输出贯彻语义一致性,在 Field-Aware Tokenization 基础上,用两个域中心组件重构 Transformer block,并用超网络把参数量压回可承受范围。整体参数复杂度从 $O(F^2d^2)$ 降到 $O(Fd^2 + F^2)$。
Field-Aware Tokenization¶
CTR 输入是来自不同语义域的无序异构特征集合。每个原始特征 $x_i$ 经类型专属编码器映射为稠密 token $\bm{e}_i \in \mathbb{R}^d$:类别特征与离散化数值特征走 embedding 查表,用户行为列表走序列池化(如 DIN)。
鉴于特征集合的非序列性,本文用域感知偏置替换标准位置编码——注入的是基于语义角色而非任意位置的结构先验。对属于域 $f_i$ 的 token $i$:
$$\bm{h}_i = \bm{e}_i + \bm{b}_{f_i}, \tag{1}$$
其中 $\bm{b}_{f_i} \in \mathbb{R}^d$ 是域 $f_i$ 专属的可学习偏置向量。这个形式同时保证了置换不变性并把每个 token 锚定在其语义上下文中。
Field-Decomposed Attention¶
标准 self-attention 在全局基上运算,忽略 CTR 各域的异构性。给每个域对 $(f_i, f_j)$ 分配独立投影矩阵能捕捉这些交互,但会带来 $O(F^2d^2)$ 的参数复杂度。
本文把注意力因子分解为两个可承受的分量:
- 域感知内容对齐(field-aware content alignment):两个 token 依各自语义角色的交互程度;
- 域对交互调制(field-pair interaction modulation):信息从一个域流向另一个域的强度。
为实现深层语义对齐,为每个域 $f$ 分配独立投影矩阵 $\{\bm{W}^{(f)}_Q, \bm{W}^{(f)}_K, \bm{W}^{(f)}_V\}$。原始注意力分数定义为:
$$s(i,j) = \left(\bm{q}_i^\top \bm{k}_j\right)\cdot w_{f_i,f_j}, \quad \bm{q}_i = \bm{h}_i\bm{W}^{(f_i)}_Q,\ \bm{k}_j = \bm{h}_j\bm{W}^{(f_j)}_K. \tag{2}$$
第一项是域感知内容对齐。与通用相似度不同,域专属投影让模型能按域的角色定制变换——例如区分一个 age token 作为用户画像特征与作为上下文特征时应被如何编码。
标量参数 $w_{f_i,f_j} \in \mathbb{R}$ 执行域对交互调制,充当门控,支配域间信息流强度。这带来细粒度控制:较大的 $w_{\text{ad\_category},\text{user\_behavior}}$ 放大相关用户兴趣,较小的 $w_{\text{ad\_category},\text{device\_type}}$ 抑制无关耦合带来的噪声。
最终按域投影的 value $\bm{v}_j = \bm{h}_j\bm{W}^{(f_j)}_V$ 聚合得到层输出:
$$\text{FAT-Attn}(\bm{H})_i = \sum_{j=1}^{N}\left(\frac{\exp\!\left(s(i,j)/\sqrt{d}\right)}{\sum_{k=1}^{N}\exp\!\left(s(i,k)/\sqrt{d}\right)}\right)\bm{v}_j. \tag{3}$$
这一机制的三个关键优势:
- 层次化域感知:内容对齐在粗粒度的每域层面编码语义角色,交互调制在细粒度的域对层面支配路由强度。
- 可解释性与非对称性:学到的标量 $w_{f_i,f_j}$ 天然建模方向性效应($w_{f_i,f_j} \neq w_{f_j,f_i}$),暴露可解释的域间交互模式。
- 效率与可扩展性:无需全秩域对矩阵,参数复杂度从 $O(F^2d^2)$ 坍缩到 $O(Fd^2 + F^2)$,典型设置下削减超过 99%(如从 150B 降到 0.5B)。
一句话概括:Field-Decomposed Attention 通过把表示与路由解耦奠定了结构化表达力——它不是靠堆无结构容量来扩展交互建模,而是在受控的前提下加深语义分辨率。
Field-Aware Feed Forward Network¶
同理,标准 FFN 对所有 token 施加统一变换,忽略异构域各自的特征分布。FAT 的 FFN 显式以 token 所属的域 $f_i$ 为条件:
$$\text{FAT-FFN}(\bm{z}_i) = \text{SiLU}\!\left(\bm{z}_i\bm{W}^{(f_i)}_1\right)\bm{W}^{(f_i)}_2, \tag{4}$$
其中 $\bm{W}^{(f_i)}_1 \in \mathbb{R}^{d\times d_{ff}}$、$\bm{W}^{(f_i)}_2 \in \mathbb{R}^{d_{ff}\times d}$ 是域专属投影矩阵,$d_{ff}$ 为中间扩张维度。
Basis-Composed Hypernetwork¶
即便如此,为所有域存储全秩矩阵 $\{\bm{W}^{(f)}_Q, \bm{W}^{(f)}_K, \bm{W}^{(f)}_V, \bm{W}^{(f)}_1, \bm{W}^{(f)}_2\}$ 在大规模系统里仍是难以承受的显存开销。为把参数增长与域基数(field cardinality) 解耦,本文引入超网络来生成域专属投影。
按参数类型构造独立基组。令 $\Phi \in \{Q, K, V, 1, 2\}$ 表示参数类型,对每个类型 $\Phi$ 维护一组 $M$ 个基矩阵 $\mathcal{B}_\Phi = \{\bm{B}_{1,\Phi}, \dots, \bm{B}_{M,\Phi}\}$,每个 $\bm{B}_{m,\Phi}$ 与目标投影 $\bm{W}^{(f)}_\Phi$ 同维。对给定域 $f$,一个轻量单层 MLP 路由器 $g_\psi(\cdot)$ 把域嵌入 $\phi_f \in \mathbb{R}^k$ 映射为域专属的选择签名 $s^{(f)} \in \mathbb{R}^M$:
$$s^{(f)} = g_\psi(\phi_f), \qquad \pi_f = \text{top-}K\!\left(s^{(f)}\right). \tag{5}$$
在选中的下标上做 softmax 得到稀疏混合系数:
$$\alpha^{(f)}_m = \frac{\exp\!\left(s^{(f)}_m\right)}{\sum_{m'\in\pi_f}\exp\!\left(s^{(f)}_{m'}\right)}, \quad \forall m \in \pi_f. \tag{6}$$
最终按类型合成域专属投影矩阵:
$$\bm{W}^{(f)}_\Phi = \sum_{m\in\pi_f}\alpha^{(f)}_m\bm{B}_{m,\Phi}. \tag{7}$$
超网络带来三个关键优势:
- 复杂度与域基数解耦:域专属投影由共享基合成,打破了 $O(Fd^2)$ 的参数依赖。存储复杂度线性增长为 $O(Md^2 + Fk)$,即使 $F$ 扩到数千也不会参数爆炸。
- 可持续的特征演进:引入新特征域只需初始化一个轻量 meta-embedding $\phi_f$,而不必分配全秩矩阵,支撑敏捷的工业迭代。
- 零动态生成开销:参数虽在训练时动态定义,但推理前离线物化——训练后所有域专属矩阵预计算并缓存,因此推理零额外开销,满足严苛的生产约束。
CTR 预测¶
FAT 堆叠 $L$ 层,每层由 field-decomposed attention 子层与 field-aware FFN 子层构成,配 layer normalization 与残差连接。第 $\ell$ 层的更新规则为:
$$\bm{Z}^{(\ell+1)} = \text{FAT-FFN}\!\left(\text{LayerNorm}\!\left(\text{FAT-Attn}\!\left(\bm{Z}^{(\ell)}\right)\right)\right) + \bm{Z}^{(\ell)}. \tag{8}$$
最后用 sum-pooling 把各域表示聚合成全局实例向量,经 sigmoid 投影输出:
$$\hat{y} = \sigma\!\left(\sum_{i=1}^{N}\bm{z}^{(L)}_i\bm{w}\right). \tag{9}$$
理论分析:泛化界与 scaling law¶
推荐系统最想要的目标之一,是随模型规模增大获得可预测、平滑的性能提升——LLM 已通过经验 scaling law 充分记录了这一现象。但在 CTR 里,朴素 scaling 往往因无结构的容量增长放大噪声而非信号而导致饱和甚至退化。
本文论证 FAT 通过让架构设计与特征交互的组合语义对齐来实现有原则的 scaling。关键在于:FAT 注意力层的有效模型复杂度由语义域数量 $F$ 与域对交互结构支配,而非原始词表规模 $n = \sum_{i=1}^{F}|\mathcal{V}_i|$(工业场景下可超 $10^9$)。
定理 4.1(FAT 的泛化界)。设 $\mathcal{D}$ 为输入序列 $\bm{H} = [\bm{h}_1,\dots,\bm{h}_N]$ 上的分布,$\|\bm{h}_i\|_2 \le R$。假设所有参数矩阵 $(\bm{W}^{(f)}_Q, \bm{W}^{(f)}_K, \bm{W}^{(f)}_V)$ 的 Frobenius 范数有界于 $B$,所有交互标量 $w_{f_i,f_j}$ 有界于 $B_w$。设 $m$ 为训练样本数,$L_{\text{train}}$ 与 $L_{\text{gen}}$ 分别为有界 1-Lipschitz 损失下的经验风险与总体风险。则以至少 $1-\delta$ 的概率,单个 FAT 层的泛化误差满足:
$$L_{\text{gen}} \le L_{\text{train}} + O\!\left(\frac{\sqrt{Fd^2 + F^2}}{\sqrt{m}}\cdot C(R,B,B_w,d) + \sqrt{\frac{\log(1/\delta)}{m}}\right), \tag{10}$$
其中 $C(R,B,B_w,d) = O\!\left(R^2B^2B_w\sqrt{d} + RBB_w\right)$ 是依赖于范数界与嵌入维度的常数。
这个界点出了相对标准 Transformer 的关键优势。标准 self-attention 在所有 token 上均匀作用,缺乏区分语义域的结构约束;这种无约束的灵活性迫使模型从零学习交互模式,在极端数据稀疏下极易过拟合伪相关。相比之下,FAT 的域条件变换只依赖语义域数量 $F$(及域对调制 $F^2$),把有效假设空间限制在 $\text{poly}(F)$ 内,显式地把学习复杂度与庞大的词表规模 $n$ 解耦。于是每个参数都在其所属域内被海量数据共享,统计效率与泛化能力大幅改善。
紧的泛化界进一步支撑了可预测 scaling:固定数据分布与域 schema $F$ 时,增大嵌入维度 $d$(从而总参数量 $N_{\text{params}} \propto Fd^2$)会同时加深内容对齐与交互调制的表征保真度,让模型学到更高秩、更细腻的域间交互函数,从而系统性降低训练误差 $L_{\text{train}}$。因为架构与数据的组合结构对齐,这些额外参数精炼有意义的模式而非拟合噪声。
两个效应(表达力增强带来的偏差下降 + 紧界带来的方差下降)合起来,为经验观测到的幂律给出理论依据:
$$\Delta\text{AUC} \propto N^{\beta}_{\text{params}}, \quad \beta > 0. \tag{11}$$
实验设置¶
围绕五个研究问题:RQ1 跨规模跨数据集是否稳定超越 SOTA;RQ2 各域感知组件与超网络各自贡献多少;RQ3 学到的交互模式是否语义自洽;RQ4 是否呈现可预测的幂律 scaling;RQ5 线上服务是否高效且有业务收益。
数据集:(1) Taobao——来自淘宝赞助搜索的大规模 CTR 数据集,两周内超过 140 亿次用户曝光;(2) MovieLens-20M——13.8 万用户对 2.7 万部电影的 2000 万条评分,评分 $\ge 3$ 二值化为点击,提供稠密可复现的拓扑。
Baselines 分两类:
- 传统交互模型:FFM、DeepFM、AutoInt、DCNv2,外加一个常规 Embedding-MLP 框架(记为 DeepCTR)作为无约束隐式交互学习的强基线;
- 面向 scaling 的架构:HiFormer、Wukong、HSTU、RankMixer。
双尺度评测协议(这是本文实验设计里最讲究的一点):
- 传统交互模型在其典型容量 $\sim$50M 参数下评测,并在验证集上做贝叶斯搜索调优(embedding 维度、hidden size、dropout 0.1–0.5、L2 正则 1e-6 到 1e-3),对位 FAT-Small($\sim$50M);
- 面向 scaling 的架构统一放大到约 0.5B 参数(调宽或调深,保留各自核心架构约束,如 RankMixer 的专家数、HSTU 的层级数),在该固定容量下重新调超参,对位 FAT-Large($\sim$0.5B),另设 FAT-XL($\sim$1.5B)做 scaling 趋势分析。
训练基础设施:128 张 NVIDIA GPU,同步数据并行 SGD,单卡 batch 2048,Adam($\beta_1=0.9,\beta_2=0.999$),学习率在 $\{1e{-}4, 3e{-}4, 5e{-}4, 1e{-}3\}$ 中调,weight decay 1e-6。所有模型共享同一套特征预处理:类别特征哈希、数值特征离散化、序列行为经共享 DIN 式抽取器,embedding 维度固定在 $d \in \{8,16,32,64\}$。
FAT 专属配置:8 个注意力头;域 meta-embedding $\phi_f \in \mathbb{R}^{64}$ 随机初始化并跨层共享;超网络用 $M=64$ 个共享基矩阵、Top-$K=3$ 稀疏激活;域对交互标量 $w_{f_i,f_j}$ 从 $\mathcal{N}(0, 0.01)$ 初始化。
主要实验结果(RQ1)¶
Table 1(双尺度评测协议下与 SOTA 方法的整体 CTR 性能对比):
| Type | Method | #Params† | Taobao AUC (%) | Δ (%) | MovieLens-20M AUC (%) | Δ (%) |
|---|---|---|---|---|---|---|
| Baseline | DeepCTR | 40M | 77.62 | – | 80.12 | – |
| Traditional | DeepCTR-Large | 0.48B | 77.64 | +0.02 | 80.16 | +0.04 |
| FFM | 25M | 77.32 | −0.30 | 79.85 | −0.27 | |
| DeepFM | 45M | 77.47 | −0.15 | 80.22 | +0.10 | |
| AutoInt | 57M | 77.67 | +0.05 | 80.48 | +0.36 | |
| DCNv2 | 47M | 77.68 | +0.06 | 80.53 | +0.41 | |
| Scaling-Oriented | Wukong | 0.54B | 77.73 | +0.11 | 81.02 | +0.90 |
| HSTU | 0.54B | 77.72 | +0.10 | 81.22 | +1.10 | |
| HiFormer | 0.58B | 77.79 | +0.17 | 80.82 | +0.70 | |
| RankMixer | 0.51B | 77.85 | +0.23 | 81.62 | +1.50 | |
| Ours | FAT-Small | 52M | 77.78 | +0.16 | 80.94 | +0.82 |
| FAT-Large | 0.54B | 78.09 | +0.47 | 83.84 | +3.72 | |
| FAT-XL | 1.5B | 78.20 | +0.58 | 84.50 | +4.38 |
† #Params 指稠密(非 embedding)参数量。
小规模区间($\sim$50M)的有效性。在工业常见的 50M 参数约束下,FAT-Small 稳定超过传统交互模型。一个关键观察是这些基线的性能饱和:DeepCTR 从 40M 放大到 0.48B(DeepCTR-Large)只带来 +0.02% 的可忽略提升——传统架构无法有效利用额外容量。相同参数约束下 FAT 的 +0.16% 说明其域感知注意力分解比隐式 MLP 结构更有效地捕捉了交互。
大规模区间($\sim$0.5B)的优越性。放大到 0.5B 时 FAT-Large 超过所有面向 scaling 的现代架构。由于对比模型都做了统一放大与超参重调,FAT 的持续领先说明优势来自更好的归纳偏置而非单纯容量。这种结构优势在稠密拓扑上更明显:MovieLens-20M 上 FAT-Large 拿到 +3.72% 的巨大提升,作者归因于 FAT 能显式建模稠密高价值语义连接(如 User-Item),而标准全局注意力倾向于把这些特定信号淹没在噪声里。
scaling 潜力。进一步扩到 1.5B(FAT-XL)仍持续增益、无饱和迹象,与基线的停滞形成鲜明对比。
消融与分析(RQ2)¶
Table 2(FAT 各组件消融,数值为相对基线 DeepCTR 的相对 AUC 提升):
| Variant | ΔAUC (%) |
|---|---|
| FAT-Large | +0.47 |
| w/o Field-Aware Biases($\bm{b}_{f_i}=0$) | +0.41 |
| w/o Interaction Modulation($w_{f_i,f_j}=1$) | +0.35 |
| w/o Field-Aware Content Alignment(全局 $\bm{W}_{Q,K,V}$) | +0.32 |
| w/o Field-Aware FFN(全局 $\bm{W}_{1,2}$) | +0.35 |
| w/o Hypernetwork(独立矩阵) | +0.46 †(5× 参数量) |
| w/o Field-Decomposed Attention(全域对矩阵) | N/A ‡(OOM,>150B 参数) |
逐项分析:
- 结构先验(域感知偏置):移除后降到 +0.41%。说明为域赋予静态语义角色有益,但主要充当基础先验而非表达力的主要驱动。
- 交互路由(交互调制):禁用域对标量($w_{f_i,f_j}=1$)后显著降到 +0.35%。这证实让所有域自由交互是不够的——模型需要显式上调有意义的通路(如 User → Item)并通过非对称路由抑制噪声。
- 内容对齐(域感知内容对齐):把域专属内容投影换成全局共享矩阵造成最剧烈的退化,降到 +0.32%(掉 0.15 个百分点)。这确立了 Field-Aware Content Alignment 是最关键组件——按域角色的早期特化是建模深层交互的前提。
- 特征适配(域感知 FFN):还原为标准共享 FFN 降到 +0.35%。说明建模域内统计分布与建模域间交互同等重要。
超网络分析:把 Basis-Composed Hypernetwork 换成完全物化的参数矩阵,收益为可比的 +0.46%,但参数量多 5 倍——证明超网络在不牺牲表征能力的前提下有效压缩了参数空间。反过来,不做分解直接实现域对注意力会 OOM(>150B 参数),凸显结构分解对工业系统可行性的必要性。
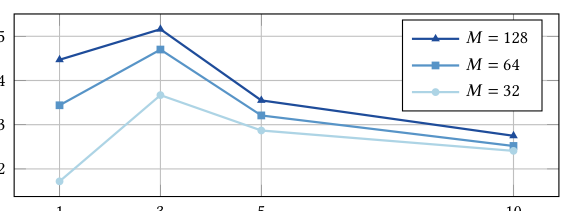
参数合成机制($M$ vs $K$):
- 基容量 $M$ 的影响:增大 $M$ 持续带来增益($M=128$ 优于 $M=32$),说明更丰富的基池扩展了表征流形。但实践中会为控制显存而给 $M$ 设上限。
- 激活基数 $K$ 的权衡:$K$ 不遵循"越大越好",它是表达力与稀疏性之间的调节杆。$K$ 过小限制多样性,$K$ 过大导致过平滑(over-smoothing)。
- 动态平衡:$K$ 的最优值与 $M$ 呈反比。基池受限时($M=32$)需要更大的 $K$ 通过组合混合弥补容量;随 $M$ 增大,最优 $K$ 向 1 偏移。这说明 FAT 通过用少量计算代价换取指数级更大的表征能力,来平衡显存与表达力。
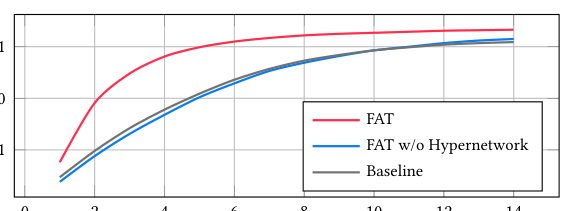
特征演进效率:先把 Baseline、FAT(w/o Hypernetwork)、FAT 在同一特征集上预训练至收敛,然后注入一个新域 $f_{new}$ 并继续训练 14 天。$\Delta\text{AUC}(t) = \text{AUC}_{\text{old}+f_{new}}(t) - \text{AUC}_{\text{old}}(0)$ 度量各框架相对自身注入前收敛性能的增益。结果:FAT 借助预训练共享基实现快速收敛(warm start),只需为新域学一个轻量路由签名;而 FAT(w/o Hypernetwork)与 Baseline 都受冷启动困扰,必须从零学全秩参数,轨迹同样迟缓。虽然 FAT(w/o Hypernetwork)最终预期能追平 FAT(与 Table 2 一致),但 FAT 显著缩短了新特征的 time-to-value。
可解释性分析(RQ3)¶
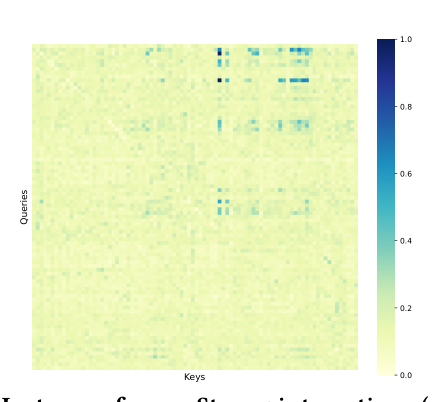
分析调制权重 $w_{f_i,f_j}$(支配信息从域 $f_j$ 流向 $f_i$ 的强度,在同一域对内跨 token 共享,反映全局交互模式),呈现两个性质:
结构化自洽性。权重矩阵稀疏且呈清晰的块状结构,高值集中在语义有意义的域对上:
- 候选物品特征(
item_cate、shop_level等类目与店铺属性)与实时用户信号(recent_clicks)强关联; - 用户画像域(
age、gender等人口属性)与长期偏好指标(fav_brands、longterm_clicks)交互最强。
而无关模态之间的跨域交互(如 device_type → income)接近零。这与领域直觉吻合:短期意图驱动物品相关性,静态画像塑造稳定偏好。FAT 无需显式监督就学到了这种分离。
非对称影响。交互模式有强方向性,反映域之间的功能层级:
| Query Field ($f_i$) \ Key Field ($f_j$) | item | recent_clicks | user_profile |
|---|---|---|---|
| item | – | 0.97 | 0.16 |
| recent_clicks | 0.23 | – | 0.24 |
| user_profile | 0.24 | 0.32 | – |
候选物品作为 query 时,对 recent_clicks 的注意力高达 0.97——物品扮演主动检索者,激进地从行为历史中综合用户意图以判定自身相关性。反过来 recent_clicks 作为 query 时对 item 的注意力弱且弥散(0.23),说明历史行为是被动的支撑证据:被查询时提供上下文,但不需要候选物品来定义自身语义。作者的措辞是这一非对称性确认 FAT 学到了推荐的因果结构:物品寻找用户,而非相反。
Scaling 行为(RQ4)¶
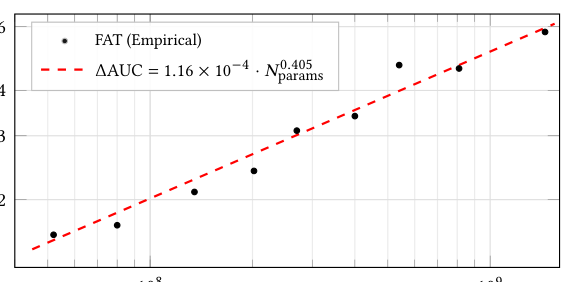
在同一数据集、一致超参与基础设施下,评测从 50M 到 1.5B 稠密(非 embedding)参数的一系列 FAT 变体。ΔAUC 随参数量在三个数量级上单调增长,遵循幂律:
$$\Delta\text{AUC} = 1.16\times 10^{-4}\cdot N^{0.405}_{\text{params}}. \tag{12}$$
测试范围内未观察到饱和,这在 CTR 模型中是罕见性质——无结构架构通常在规模下走平甚至退化。
这一平滑 scaling 与定理 4.1 一致:FAT 的复杂度按 $O(Fd^2 + F^2)$ 增长,与 token 词表规模 $n$ 无关。作者特别澄清了一个容易被误读的点:$F$ 定义的是交互拓扑,不是一个 scaling 维度。与标准 scaling 不同,增大 $F$ 是从根本上改变输入 schema。因此 Figure 5 的趋势反映的是 schema 内可扩展性(intra-schema scalability)——在固定结构基础上,表征保真度加深带来性能可预测提升。
线上 A/B 结果(RQ5)¶
在淘宝赞助搜索系统做了大规模线上 A/B:流量均分,对照组是现有生产模型(一个高度优化、含人工特征交叉的传统 CTR 模型),实验组只替换预测模块为 FAT-Large($\sim$0.5B)。
| Model Setting | P99 Latency | GFLOPs | MFU | CTR | RPM |
|---|---|---|---|---|---|
| Online Baseline | 45 ms | 20 | 5% | – | – |
| FAT-Large | 48 ms | 100 | 34% | +2.33% | +0.66% |
| FAT-Large(未缓存 $\bm{W}^{(f)}_\Phi$) | 133 ms | 150 | N/A † | N/A † | N/A † |
† 服务不可用:严重超时导致模型无法承接线上请求,MFU 与 CTR/RPM 等指标因无法维持流量而失效。
系统效率:尽管模型 FLOPs 增加 5×,P99 延迟仅从 45ms 微增到 48ms。作者归因于硬件对齐的模型设计与优化策略——MFU 从 5% 飙升到 34%。而不做缓存时 P99 涨到 133ms,模型直接不可部署。这条对照非常有说服力:它证明超网络的离线物化不是锦上添花,而是这套设计能否上线的分水岭。
业务收益:CTR +2.33%,RPM +0.66%。
核心贡献总结¶
- 诊断:把 CTR 模型 scaling 失效的根因明确为结构性错配——Transformer 假设序列组合性,CTR 数据要求跨异构域的组合推理;并给出了"为什么直接域对特化不可行"的量化论证($O(F^2d^2)$,10 万亿参数)。
- 方法:Field-Decomposed Attention 把域对变换因子分解为 $O(Fd^2)$ 的内容对齐 + $O(F^2)$ 的标量调制,配 Field-Aware FFN 与 Basis-Composed Hypernetwork,把复杂度压到 $O(Fd^2+F^2)$ 且推理零开销。
- 理论:基于 Rademacher 复杂度给出 CTR Transformer 的泛化界,说明泛化取决于域交互的组合结构而非词表规模 $n$,为推荐领域的 scaling 提供了少见的理论支点。
- 验证:三个数量级上的幂律 $\Delta\text{AUC} \propto N^{0.405}$ 无饱和;淘宝赞助搜索线上 +2.33% CTR / +0.66% RPM,MFU 5%→34%。
与已归档相关工作的对比¶
本篇在本库中的位置比较特殊:它是两篇已归档论文的上游被引方,而它自己此前不在库里。
DeRes DeRes: Decoupling Residual Stability and Adaptivity for Scalable CTR Transformers(2026-06-06)¶
关系:后续工作显式引用并在其之上构建理论(DeRes 的 ref [36] 即本文)· 已加载对方精读
- 共同关注的问题:两篇都认定 CTR Transformer 加深时收益衰减,且都拒绝"再堆容量"这个答案,转而问"是哪个结构件挡住了 scaling"。本文的答案是注意力的全局共享投影;DeRes 的答案是层间残差连接。
- 相近的技术骨架:都是"在标准 Transformer block 里换掉一个默认组件,使其与 CTR 数据结构对齐,然后用 scaling law 曲线证明斜率变陡"。DeRes 甚至直接沿用了本文与 Wukong 的 scaling law 拟合方法论。
- 本文的差异与推进:DeRes 把本文的泛化界当作已确立的前提来用——它在 Proposition 3 中以"FAT generalization bound [36]"为出发点,推出 $\tilde{O}(\sqrt{F K \log d / N})$ 的形式并论证有效跨层交互阶 $K$ 才是容量主杠杆,最后把自己的实测幂律斜率($\gamma=0.118$ vs OneTrans 的 0.071)解释为"与 FAT 的预测一致:与 CTR 数据交互结构对齐的架构 scaling 更高效"。换句话说,本文提供的是理论地基,DeRes 提供的是在该地基上的一层新楼。两者正交、可叠加:FAT 改注意力内部,DeRes 改层与层之间。
- 一处需要留意的引用瑕疵:DeRes 正文两处把本文写作 "Zhang et al. [36]",而其参考文献 [36] 条目本身是 "Bencheng Yan, Yuejie Lei, Zhiyuan Zeng, Di Wang, Kaiyi Lin, Pengjie Wang, Jian Xu, and Bo Zheng"。本库中 DeRes 的精读忠实转录了正文的 "Zhang et al.",因此该处作者归属沿袭了原文的错误,正确应为 Yan et al.。
HiFormer HiFormer: Heterogeneous Feature Interactions Learning with Transformers(Google DeepMind, 2023-11-10)¶
关系:显式引用且作为 Table 1 的 baseline 直接对比 · 已加载对方精读
- 共同关注的问题:两篇的问题陈述几乎重合——vanilla Transformer 的 self-attention 让所有特征共享同一组 Q/K/V 投影,无法捕捉特征间的异构语义。HiFormer 的原话是
app_id的嵌入含应用性质/流行度/语言,user_country的嵌入含地理偏好,二者交互时需要选择性提取不同维度——与本文"age token 作为用户画像 vs 作为上下文应被不同编码"是同一个论证。 - 相近的技术骨架:解法起点也相同——给每个特征/域独立的 Q/K/V 投影,并配套异构 FFN。HiFormer 的 Heterogeneous Attention Layer 与本文的 Field-Aware Content Alignment 在形式上高度对应。
- 本文的差异与推进:分歧出现在"如何为这份特化买单"。HiFormer 走的是每个特征独立投影 + Composite 投影(把所有特征嵌入拼接后整体投影,让 key/value 自身就编码交互信息),代价是 $O(L^2d^2)$,只能靠低秩近似($\hat{\bm{K}}^h = \bm{L}^h_k(\bm{R}^h_k)^\top$)与末层剪枝把常数压下来,复杂度仍随特征数二次增长。本文走的是按域(而非按特征)特化 + 把域对交互降维成标量 $w_{f_i,f_j}$ + 超网络合成,把复杂度做到 $O(Fd^2+F^2)$ 且推理端完全物化为静态矩阵。粒度选择上,HiFormer 更细(per-feature)但更贵,本文更粗(per-field)但可扩展——本文的 Table 1 显示 FAT-Large 在同为 0.5B 量级时 Taobao 78.09 对 HiFormer 77.79、MovieLens-20M 83.84 对 80.82,差距在稠密数据集上尤其大。
- 一个本文没有正面讨论的问题:HiFormer 的 per-feature 粒度理论上比 per-field 更有表达力,本文没有给出"为什么域粒度足够"的直接论证,只以泛化界间接说明更粗的粒度带来更紧的假设空间。这条 trade-off 值得后续工作单独验证。
SSR SSR: Beyond Dense Connectivity — Explicit Sparsity for Scalable Recommendation(Alibaba AIDC, 2026-04-09)¶
关系:独立并发(互不引用,同为阿里体系但不同 BU)· 已加载对方精读
- 共同关注的问题:两篇对 CTR scaling 失效给出的诊断在同一层——都不是"容量不够",而是"无结构的稠密混合让额外容量去拟合噪声"。SSR 的表述是稠密 FC 层把所有输入不加筛选地混合,稀释有用维度、放大噪声,迫使后续非线性层花力气抑噪而非建模;本文的表述是无结构注意力在极端稀疏下放大噪声、扭曲梯度。两者都把根因指向推荐数据与语言数据在信息密度上的本质差异。
- 相近的技术骨架:解法路径也抽象重合——把"该跟谁交互"这件事从隐式学习变成显式的架构约束,再在被约束过的小空间里做稠密计算。SSR 是"先按维度过滤、再在净化后的子空间稠密融合"(first filter, then fuse);本文是"先按域对用标量 $w_{f_i,f_j}$ 门控路由、再在域内做全秩变换"。两者都能画成"稀疏路由 → 稠密计算"的两段式流程图。
- 本文的差异与推进:约束的依据不同。SSR 的稀疏是维度级、由数据统计驱动的(其 Figure 1 的经验证据是线上模型 92% 权重 <10⁻³、80% 权重能量集中在前 4% 维度),静态版本甚至是随机采样的选择矩阵,属于"不管语义、按能量裁";本文的稀疏是域级、由语义 schema 驱动的,$w_{f_i,f_j}$ 学出来的块状结构可以直接读作领域知识(Figure 4)。因此本文额外拿到了 SSR 拿不到的可解释性与非对称性(item→recent_clicks 0.97 vs 反向 0.23),代价是必须依赖一个人工定义的域 schema——而 SSR 不需要任何 schema。
- 可比的实验差异:SSR 报告 AliExpress 线上 +2.1% CTR / +3.5% GMV,本文报告淘宝赞助搜索 +2.33% CTR / +0.66% RPM,量级相当。两者原理上互补(一个裁维度、一个裁域对),叠加是双方都没做的实验。
初筛后被剔除的近似候选:CCFormer CCFormer(同样做"特征域分离的注意力分解",问题+解法确有同构,但它只在 related work 的一处群引 [18, 26, 33] 中提到本文,且归类为"用 RNN/CNN/注意力编码历史行为"的方法——这是对本文的误分类,不构成实质对比关系,其真正的问题焦点是长序列的二次复杂度而非域异构性);SpecFormer SpecFormer(同样研究 CTR Transformer 的深度 scaling 失效,但 root cause 定位在谱坍缩、解法是谱软化;它在自己的 DAG 边里已把本文归为"空间域补丁",属对立观点而非同构解法);LoopCTR LoopCTR(同样是 CTR + 新 scaling 轴,但轴是递归复用而非结构化表达力,解法骨架不重合);RankMixer / Wukong / HSTU(本文 Table 1 的 baseline,属对比关系而非孪生,交由 DAG 结构化处理)。
讨论与局限性¶
这篇的真正贡献是"给推荐的 scaling 补了一块理论地基",而不只是又一个 CTR 架构。定理 4.1 把泛化界从词表规模 $n$($>10^9$)换成域数量 $F$($\sim 10^3$)这件事,是整篇文章里最有迁移价值的部分——它给了一个可证伪的判据来回答"什么样的推荐架构值得 scaling"。DeRes 随后直接在这个界上盖楼,本身就是这块地基有效性的旁证。
但理论与实验之间的连接比论文声称的要松。 定理 4.1 是单层 FAT 注意力的界,而实验里的 FAT 是 $L$ 层堆叠;论文没有给出多层情形下界如何复合(层数增加时 Rademacher 复杂度通常按乘积或指数增长)。更关键的是,从"泛化界更紧"到"$\Delta\text{AUC} \propto N^{0.405}$"这一步,论文的论证是定性的——它说"偏差下降 + 方差下降 ⟹ 幂律",但指数 0.405 无法从理论中导出,理论也不预测幂律形式本身。所以准确的说法是:理论解释了为什么 FAT 不饱和,但没有预测它以什么速率增长。论文用词是 "offers a potential explanation",比正文其他地方的措辞谨慎,这是恰当的。
scaling 实验的口径需要注意。 Figure 5 的三个数量级是通过增大嵌入维度 $d$($N_{\text{params}} \propto Fd^2$)实现的,即纯宽度 scaling;论文没有报告深度 scaling(增大 $L$)的曲线。而 CTR Transformer 的深度问题恰恰是 DeRes DeRes 与 SpecFormer SpecFormer 各自攻击的靶子。因此"FAT 无饱和"这个结论应被读作"在固定 schema 下沿宽度轴无饱和",深度轴上是否同样成立本文没有回答。另外 $F$ 被明确排除在 scaling 维度之外("$F$ 定义交互拓扑,不是 scaling 维度")是诚实的,但也意味着这条 scaling law 的适用范围被限定在一个固定的特征 schema 内——而工业系统的 schema 恰恰是持续演进的,这与 §5.3 主打的"可持续特征演进"之间存在一点张力:加新域会改变 $F$,也就跳出了 Figure 5 所刻画的那条曲线。
消融里有一处结论被低估了。 "w/o Hypernetwork" 只掉 0.01 个百分点(+0.46 vs +0.47)却省下 5× 参数——这说明超网络的价值几乎完全在工程侧(显存、新特征冷启动),而非表达力侧。论文在正文里把它包装成"不牺牲表征能力地压缩参数空间",读起来像是双赢,但反过来也可以说:域专属全秩矩阵这条更简单的路线在效果上并不吃亏,超网络是为部署约束买的单。这一点在线上 A/B 里得到了印证——未缓存版本 P99 133ms 直接不可服务,说明缓存(而非超网络本身)才是上线的必要条件。
MovieLens-20M 上 +3.72% 的巨大提升需要谨慎解读。 该数据集只有 user/item/rating 三类基本域,$F$ 极小且拓扑稠密,恰好是 FAT 的域对调制最容易学准的场景;而工业 Taobao 上($F$ 大得多、极端稀疏)提升是 +0.47%。论文把 MovieLens 的大幅领先归因于"能显式建模稠密高价值语义连接",这个解释成立,但也提示FAT 的收益幅度对域 schema 的形状高度敏感,两个数据集的数字不宜合并叙述。此外把评分 $\ge 3$ 二值化为点击是常见但粗糙的处理,MovieLens 的绝对 AUC(80-84%)与 CTR 场景差异很大。
其他未覆盖处:$w_{f_i,f_j}$ 是全局标量(同一域对内跨所有 token 共享),这带来了可解释性,但也意味着它无法表达样本级的路由差异——"这个用户此刻的 device_type 确实重要"这类条件依赖被结构性地排除了。论文没有讨论这条限制,而 SSR 的动态 ICS 算子正是冲着"样本自适应"去的。另外线上 A/B 只报告了 CTR 与 RPM 两个指标、未说明实验时长与流量规模,也没有长期效果或分人群/分位数的拆解。
可借鉴的设计:(a) 双尺度评测协议——把传统模型和 scaling 导向模型分别在各自典型容量上对齐后再比,并对每一档重新调超参,比"一刀切同参数量"公平得多,值得作为本库后续 CTR 论文的评测质量基准;(b) 把"贵但对"的结构先做出来,再用超网络/缓存把部署代价消掉这一两段式思路,比一开始就为部署妥协表达力更可取,"未缓存 133ms 不可服务"这条对照是很有说服力的写法;(c) 用 $w_{f_i,f_j}$ 的非对称性反读推荐的因果结构(item 主动检索、行为被动支撑),是一个廉价且有洞察力的可解释性分析范式。