SpecFormer: Mitigating Embedding and Attention Collapse via Spectral-Aware Transformer for Recommendation¶
浙江大学联合阿里巴巴(Alibaba Group)提出 SpecFormer,回答一个长期困扰工业界的问题:为什么 Transformer 直接搬到推荐特征交互上,效果反而不如精心设计的简单模型(如 RankMixer),且一堆层就崩? 作者给出的答案是「推荐数据的异质性(heterogeneity)+ 长尾(long-tail)导致嵌入矩阵严重谱坍缩(spectral collapse),而谱坍缩会在 Transformer 的前向与反向传播中形成一个闭环恶性循环」:坍缩的嵌入 → 低秩注意力 → 低通滤波 → 梯度只喂主谱方向 → 次要谱方向饥饿 → 嵌入更坍缩。对症下药,SpecFormer 在每个注意力层内塞进三件套:(1) Learnable Spectral Softening(对输入做 SVD,用可学习幂指数 $\tau$ 压平奇异值谱);(2) Spectrum-softened Attention(用软化后的谱空间算 Q/K,Value 保持原始);(3) Spectral Residual Position Encoding(用奇异值的二阶 Taylor 展开构造注意力偏置,把被压平的主谱能量补回来)。在 1 个工业数据集 + Criteo/Avazu 上全面 SOTA;更关键的是它逆转了推荐 Transformer 的深度诅咒——堆层时注意力有效秩单调上升而非坍缩。已在阿里巴巴电商广告平台全量 A/B:CTR +1.34%、CVR +15.97%、Order +16.72%,仅 +5ms 延迟。
- arXiv: 2607.24025 (2026-07-27, cs.IR)
- 作者: Yu Cui*(浙江大学)、Yi Xu*、Jiahao Wang、Hao Zhang、Yu Zhang、Xiaoyi Zeng(Alibaba Group)、Can Wang(浙江大学)、Jinxin Hu†(Alibaba Group)、Jiawei Chen†(浙江大学) (* 共同一作,† 通讯作者)
- 代码: https://github.com/istarryn/SpecFormer
一、研究动机与背景¶
1.1 推荐里的 Transformer 为什么「不灵」¶
Transformer 在 NLP、CV 上的成功推动了它向推荐系统(RS)的迁移。除了最早的序列推荐应用外,Transformer 已经越来越多地成为特征交互(feature interaction)建模的核心骨干:把多种异构特征数据视作一个个 token,用注意力机制抽取高阶交叉特征依赖,已被广泛用于大规模工业推荐(HiFormer、RankMixer、OneTrans 等)。
但作者的实证观察揭示了尴尬的现实(见后文 Table III):基于标准自注意力的 SOTA 特征交互模型(如 OneTrans),有时甚至打不过精心设计的简单特征交互架构(如 RankMixer)。更严重的是,与 LLM 从深度中显著受益不同,推荐里的 Transformer 在很浅的层就出现严重的注意力坍缩,堆层往往带来性能退化与注意力矩阵有效秩的骤降。
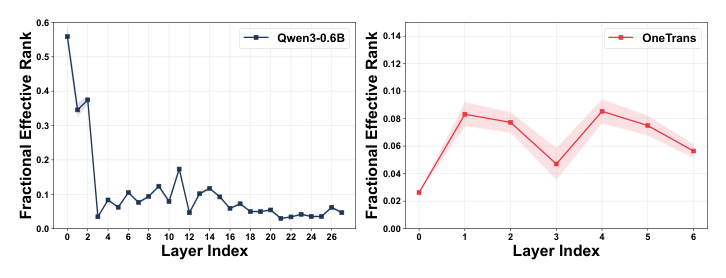
图 1 是全文的「第一张证据」:Qwen3-0.6B 的注意力 ferank 在首层短暂下降后长期维持在一个非零平台上(约 0.2–0.3 区间波动),而 OneTrans 的 ferank 全程在 0.06 以下震荡,且随层数继续走低。同样是 Transformer,推荐场景的注意力矩阵有效秩比 LLM 低了整整一个数量级。
由此引出本文的核心问题:
Why does the attention mechanism yield sub-optimal performance and collapse so quickly in recommender systems?
1.2 根因一:数据异质性与长尾分布诱发谱坍缩¶
作者认为,与 LLM 中「文本 token 共享一个相对连续、平滑的语义空间」不同,推荐特征(用户画像、item ID、上下文)是高度异质的。
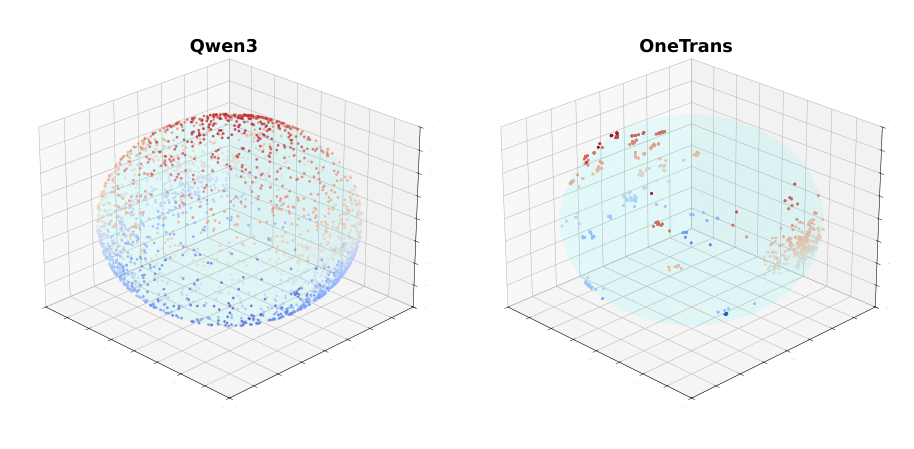
图 2(a) 的可视化显示:Qwen3 的 token 嵌入在球面上分布相对连续弥散,而 OneTrans 的推荐 token 嵌入不是均匀分布的,而是形成了高度隔离、离散的语义子空间(highly segregated, discrete semantic sub-spaces)。
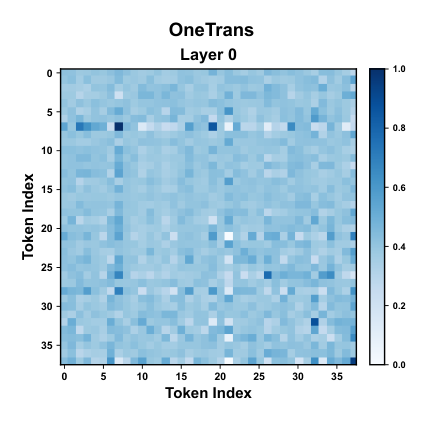
后果是:当注意力机制试图对这些异质 token 建模时,无法在异质字段之间建立平滑的语义对齐,注意力图因此失去区分度(原文表述为 "overly sparse attention maps",而图 2(b) 的直观呈现是一张几乎处处等值的均匀热力图——两种说法指向同一件事:注意力矩阵丧失了 token routing 的判别能力)。
第二个数据侧根因是长尾:
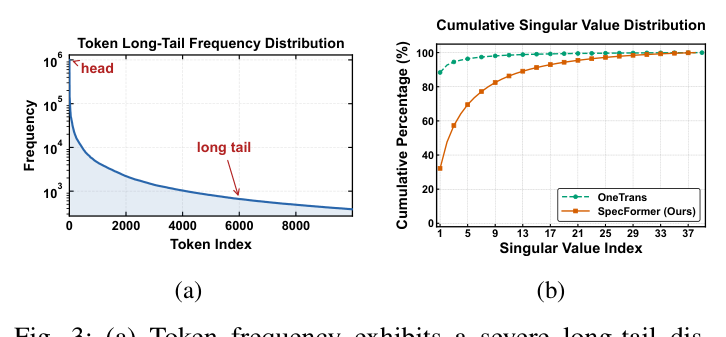
图 3(a) 显示特征频率跨越数个数量级的长尾;图 3(b) 显示 OneTrans 的累积奇异值曲线在极小的 $k$ 处就逼近 100%——即嵌入矩阵被少数几个主奇异值完全主导,次要谱成分被实质性抹除(essentially obliterated)。这一点承接了作者团队自己的前序工作 [13]("How do recommendation models amplify popularity bias? An analysis from the spectral perspective", WSDM'26)。
1.3 根因二:前向 + 反向传播中的恶性循环¶
这是本文与「已有坍缩研究」最关键的差异:作者主张谱坍缩不是一个静态缺陷,而是在 Transformer 架构内部触发了一个闭环恶性循环:
- 前向传播:坍缩的输入嵌入 → 计算出的注意力矩阵退化为稀疏低秩形式,几乎完全由主谱成分支配。随着层数堆叠,这种低秩注意力充当低通滤波器(low-pass filter),激进地抹平 token 表征。
- 反向传播:梯度流经这个低秩注意力矩阵时,被强行投影到主谱子空间上。次要谱方向遭遇梯度饥饿(gradient starvation),几乎收不到有效更新。这种带偏的更新规则在下一轮迭代中进一步加剧谱坍缩。
这个循环解释了为什么推荐 Transformer 相比 LLM 在浅得多的层就坍缩。
1.4 已有方法为何不够¶
作者梳理了三条既有路线及其局限:
| 路线 | 代表工作 | 局限 |
|---|---|---|
| 多嵌入范式(multi-embedding) | [14] On the embedding collapse when scaling up recommendation models、[15] RankUp | 引入高昂的参数开销,对大规模系统不实用 |
| 堆 FFN 参数 / 外部知识注入 | [11] RankMixer、[16] FAT | 仍然在原始空间域(spatial domain)操作,无法从根本上解决谱坍缩的 root cause |
| 谱正则 / Fourier 变换 | [17] WhitenRec、[18] FEDIN | 要么不适合特征交互建模,要么无法改善注意力坍缩 |
因此需要一个从谱视角内在地解决坍缩瓶颈的新 Transformer 架构。
1.5 主要贡献¶
- 系统揭示推荐中 Transformer 注意力机制失效的 root cause,理论 + 实证证明由数据异质性与长尾引起的注意力与嵌入坍缩的恶性循环;
- 提出 SpecFormer,用 Learnable Spectral Softening、Spectrum-softened Attention、Spectral Residual Position Encoding 三个模块,从注意力机制内部内在化地解决坍缩瓶颈;
- 大量离线实验 + 线上 A/B 验证 SOTA;关键是它主动提升注意力有效秩,解锁了推荐 Transformer 的深度 scaling 潜力;
- 在真实电商广告平台部署:CTR +1.34%、Order +16.72%,仅 5ms 延迟代价。
二、预备知识与符号¶
2.1 任务形式化¶
本文聚焦 CTR(Click-Through Rate)预测。设 $\mathcal{F} = \{f_1, f_2, \ldots, f_F\}$ 为 $F$ 个原始输入字段(如 user ID、age、item ID、时序序列)。CTR 预测建模为学习预测模型 $f_\theta$:
$$\hat{y} = \sigma(f_\theta(\mathcal{F})), \tag{1}$$
其中 $\hat{y}$ 为预测点击概率,$\sigma(\cdot)$ 为 sigmoid 函数。$f_\theta$ 的核心在于捕获有效的特征交互。
符号表(Table I):
| 符号 | 含义 |
|---|---|
| $\mathcal{F}$ | 推荐数据的字段集合 |
| $L$ | 特征 token 数量 |
| $D$ | token 嵌入维度 |
| $\mathbf{X}$ | 初始输入特征 token 矩阵 |
| $\mathbf{H}^{(l)}$ | 第 $l$ 层的隐 token 表征 |
| $\mathbf{Q}, \mathbf{K}, \mathbf{V}_{\text{val}}$ | 注意力中的 Query / Key / Value 矩阵 |
| $\mathbf{W}_q, \mathbf{W}_k, \mathbf{W}_v$ | 自注意力的投影矩阵 |
| $\mathbf{O}$ | 自注意力的输出矩阵 |
| $\mathbf{S}$ | pre-softmax 注意力分数矩阵 |
| $r$ | 矩阵的秩 |
| $\mathbf{U}, \mathbf{V}, \boldsymbol{\Sigma}$ | SVD 后的左奇异矩阵 / 右奇异矩阵 / 奇异值矩阵 |
| $\sigma_i$ | 第 $i$ 个奇异值 |
| $\boldsymbol{\Sigma}^*, \mathbf{H}^*$ | 软化后的奇异值矩阵 / 软化后的 token 特征矩阵 |
| $\tau, a$ | 软化因子及其可学习参数 |
| $\mathbf{P}_{\text{bias}}, \mathbf{S}_{\text{bias}}$ | 可学习谱残差位置编码偏置 / 原始空间注意力偏置 |
| $\beta_p$ | 第 $p$ 项的 Taylor 展开系数 |
| $\alpha, \gamma$ | 控制残差强度的(可学习)参数 |
2.2 基于 Transformer 的特征交互模型¶
一个标准的 Transformer 特征交互模型由三段串联组成:
1) 输入特征 Tokenization。传统做法把每个原始特征字段映射为一个独立嵌入直接送入模型 [10](AutoInt),但把数百个原始特征当作独立 token 会带来参数碎片化(parameter fragmentation)、重要特征建模不足、GPU 利用率低。现代模型(OneTrans [6]、RankMixer [11])采用统一 tokenization:先把特征分组成语义连贯的簇,组内嵌入顺序拼接成一个统一向量 $\mathbf{e}_{\text{input}} = [\mathbf{e}_1; \mathbf{e}_2; \ldots; \mathbf{e}_L]$,再切分并投影到固定维度:
$$\mathbf{x}_i = \text{Proj}\left(\mathbf{e}_{\text{input}}[d \cdot (i-1) : d \cdot i]\right), \quad i = 1, \ldots, L, \tag{2}$$
其中 $d$ 为每个切片的维度,$L$ 为得到的 token 数,$\text{Proj}(\cdot)$ 是把切片嵌入映射到统一维度 $D$ 的 MLP。tokenized 特征矩阵记为 $\mathbf{X} = [\mathbf{x}_1; \mathbf{x}_2; \ldots; \mathbf{x}_L] \in \mathbb{R}^{L \times D}$。
2) 特征交互网络。以 $\mathbf{H}^{(0)} = \mathbf{X}$ 为输入,通过残差连接 + LayerNorm 更新表征:
$$\mathbf{Z}^{(l)} = \text{LN}\left(\text{FeatureInteraction}\left(\mathbf{H}^{(l)}\right) + \mathbf{H}^{(l)}\right). \tag{3}$$
$\text{FeatureInteraction}(\cdot)$ 有多种设计:常见的是标准自注意力(OneTrans),也有精心设计的简化机制(RankMixer 的 token mixing),后者无需重投影矩阵即可实现高效特征交互。
3) 前馈网络。传统 Transformer 在所有 token 间共享 FFN 参数,而现代主流推荐 Transformer 采用 Per-token FFN(PFFN) [11]:对每个 token 施加专属变换,保留异质语义子空间的多样性,防止高频特征淹没长尾信号:
$$\mathbf{H}^{(l+1)} = \text{LN}\left(\mathbf{Z}^{(l)} + \text{PFFN}\left(\mathbf{Z}^{(l)}\right)\right). \tag{4}$$
经过若干层传播后,最终表征通过 mean pooling 聚合,送入预测头得到 $\hat{y}$。
2.3 Embedding Collapse 与 Attention Collapse 的量化¶
对矩阵 $\mathbf{H} \in \mathbb{R}^{L \times D}$(秩 $r = \min(L, D)$)做 SVD:
$$\mathbf{H} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T, \tag{5}$$
其中 $\mathbf{U} \in \mathbb{R}^{L \times r}$、$\mathbf{V} \in \mathbb{R}^{D \times r}$ 为列正交矩阵,$\boldsymbol{\Sigma} = \text{diag}(\sigma_1, \ldots, \sigma_r)$,$\sigma_1 \ge \sigma_2 \ge \cdots \ge \sigma_r \ge 0$。
1) Embedding Collapse(嵌入坍缩):指输入 token 表征退化到一个狭窄的低维子空间。在典型 CTR 设定下 $L < D$,故最大可能秩为 $r = L$。沿用前序工作 [32](Spectran),用累积奇异值比(cumulative singular value ratio)量化:
$$\rho(k) = \frac{\sum_{i=1}^{k}\sigma_i^2}{\sum_{i=1}^{r}\sigma_i^2}, \quad k = 1, \ldots, r. \tag{6}$$
$\rho(k)$ 在很小的 $k$ 上就迅速饱和到接近 $100\%$ → 严重嵌入坍缩,特征空间被极少数主成分支配。
2) Attention Collapse(注意力坍缩):指注意力图丧失判别能力,退化为平滑或过度稀疏的模式。对注意力分数矩阵 $\mathbf{S} \in \mathbb{R}^{L \times L}$(此时 $r = L$)做 SVD,用 Effective Rank [33] 度量退化程度——即奇异值分布 Shannon 熵 [34] 的指数。先计算 $L_1$ 归一化奇异值:
$$p_i = \frac{\sigma_i}{\sum_{j=1}^{r}\sigma_j}, \quad i = 1, \ldots, r, \tag{7}$$
再定义:
$$\text{erank}(\mathbf{S}) = \exp\left(-\sum_{i=1}^{r} p_i \ln p_i\right). \tag{8}$$
$\text{erank}(\mathbf{S})$ 取值连续地落在 $1$(完全坍缩的秩 1 矩阵)到 $r$(完美各向同性满秩矩阵)之间。为了在不同序列长度 / 模型维度间做尺度不变的公平比较,进一步用 Fractional Effective Rank [15][37](其中 [15] 即 RankUp):
$$\text{ferank}(\mathbf{S}) = \frac{\text{erank}(\mathbf{S})}{r}. \tag{9}$$
$\text{ferank}(\mathbf{S}) \in [0, 1]$,趋近 0 表示严重注意力坍缩,等于 1 表示最优的满秩注意力图。
三、理论分析:恶性循环的数学刻画¶
与 LLM 中 token 嵌入通常具备丰富语义方差不同,推荐数据严重依赖稀疏、幂律分布的数据(cf. 图 2、图 3),这一特性使得谱坍缩在输入嵌入层就已经发生(cf. 图 1)。本节形式化证明这种固有的嵌入坍缩会通过标准注意力的前向与反向传播触发退化的恶性循环。为数学简洁,作者省略标准缩放因子 $1/\sqrt{D}$。
3.1 命题 III.1(前向:严重嵌入坍缩诱发快速注意力坍缩)¶
Proposition III.1. 设输入特征矩阵 $\mathbf{H} \in \mathbb{R}^{L \times D}$,其 SVD 为 $\mathbf{H} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T$,$\mathbf{U}$、$\mathbf{V}$ 正交,$\boldsymbol{\Sigma} = \text{diag}(\sigma_1, \ldots, \sigma_r)$。在推荐场景严重谱坍缩的前提下,假设 $\sigma_k \le \epsilon\sigma_1$ 对所有 $k \ge 2$ 成立($0 < \epsilon \ll 1$)。则注意力图退化,几乎完全被主谱成分支配,丧失特征判别能力。
证明思路:pre-softmax 分数矩阵为 $\mathbf{S} = \mathbf{H}\mathbf{W}_q\mathbf{W}_k^\top\mathbf{H}^\top$。代入 SVD 并定义投影核矩阵 $\mathbf{M} = \mathbf{V}^\top\mathbf{W}_q\mathbf{W}_k^\top\mathbf{V} \in \mathbb{R}^{r \times r}$,可写作:
$$\mathbf{S} = \mathbf{U}\boldsymbol{\Sigma}(\mathbf{V}^\top\mathbf{W}_q\mathbf{W}_k^\top\mathbf{V})\boldsymbol{\Sigma}\mathbf{U}^\top = \mathbf{U}\boldsymbol{\Sigma}\mathbf{M}\boldsymbol{\Sigma}\mathbf{U}^\top. \tag{10}$$
其 $(i,j)$ 元素可显式展开分解为:
$$S_{ij} = \sum_{a=1}^{r}\sum_{b=1}^{r} u_{ia}\sigma_a M_{ab}\sigma_b u_{jb} = \underbrace{\sigma_1^2 M_{11} u_{i1} u_{j1}}_{\text{Dominant Component}} + \underbrace{\sum_{(a,b) \ne (1,1)} \sigma_a\sigma_b M_{ab} u_{ia}u_{jb}}_{\text{Minor Component } R_{ij}}. \tag{11}$$
由于 $\mathbf{U}, \mathbf{V}$ 正交($|u_{ij}| \le 1$),且学到的权重矩阵 $\mathbf{W}_q, \mathbf{W}_k$ 因标准正则化而范数有界,其乘积 $\mathbf{M} = \mathbf{V}^\top\mathbf{W}_q\mathbf{W}_k^\top\mathbf{V}$ 被限制在相对小的尺度上。因此每一项的量级严格由奇异值支配。在嵌入坍缩条件($\sigma_k \le \epsilon\sigma_1$,$k \ge 2$)下,残差项有界:$|R_{ij}| \le \mathcal{O}(\epsilon\sigma_1^2)$。
于是 pre-softmax 分数被 rank-1 主成分严重支配。更糟的是,经过 softmax 的指数函数放大后,这种支配被指数级强化。注意力矩阵 $\mathbf{A} = \text{softmax}(\mathbf{S})$ 丧失对次要特征交互的敏感性,迅速坍缩为主要由 $\mathbf{u}_1$ 支配的低秩矩阵。$\square$
物理含义:这解释了图 2(b) 中的均匀热力图——当分数矩阵近似 $\sigma_1^2 M_{11}\mathbf{u}_1\mathbf{u}_1^\top$ 这样的秩 1 外积时,行与行之间只差一个标量因子,softmax 归一化后每行几乎相同,注意力彻底失去 routing 能力。
3.2 命题 III.2(反向:梯度集中于主成分放大坍缩)¶
Proposition III.2. 给定由命题 III.1 导出的平滑退化注意力矩阵 $\mathbf{A}$,反向传播中的梯度高度集中在主谱成分上,次要成分只收到可忽略的更新,使模型无法恢复已丢失的特征多样性。
证明思路:考察通过 value 聚合阶段 $\mathbf{O} = \mathbf{A}\mathbf{X}$(其中 $\mathbf{X} = \mathbf{H}\mathbf{W}_v$)的反向传播。(梯度同样会经 query 和 key 投影回传,但那些更新本身涉及与高度秩亏的输入 $\mathbf{H}$ 的右乘,因此其梯度也被严格限制在主谱子空间内 [38]。)聚焦 value 聚合路径,由链式法则,对输入表征 $\mathbf{X}$ 的梯度为:
$$\nabla_{\mathbf{X}}\mathcal{L} = \mathbf{A}^\top\nabla_{\mathbf{O}}\mathcal{L}. \tag{12}$$
由命题 III.1,pre-softmax 分数矩阵可表示为 $\mathbf{S} = \mathbf{S}^1 + \mathbf{R}$,其中 $\mathbf{S}^1 = \sigma_1^2 M_{11}\mathbf{u}_1\mathbf{u}_1^\top$ 是 rank-1 主成分,残差满足 $\|\mathbf{R}\|_\infty = \mathcal{O}(\epsilon\sigma_1^2)$。令 $\mathbf{A}^1 = \text{softmax}(\mathbf{S}^1)$。由 softmax 的 Lipschitz 连续性 [39],实际注意力矩阵满足 $\mathbf{A} = \mathbf{A}^1 + \mathbf{A}^E$,误差矩阵有界 $\|\mathbf{A}^E\| \le \mathcal{O}(\epsilon\sigma_1^2)$。
把上游梯度 $\nabla_{\mathbf{O}}\mathcal{L}$ 投影到正交基 $\mathbf{U}$ 上:
$$\nabla_{\mathbf{O}}\mathcal{L} = \mathbf{u}_1\mathbf{g}_1^\top + \sum_{k=2}^{r}\mathbf{u}_k\mathbf{g}_k^\top, \tag{13}$$
其中 $\mathbf{g}_k$ 表示对应第 $k$ 个谱成分的梯度向量。反向更新展开为:
$$\nabla_{\mathbf{X}}\mathcal{L} = (\mathbf{A}^1 + \mathbf{A}^E)^\top\left(\mathbf{u}_1\mathbf{g}_1^\top + \sum_{k=2}^{r}\mathbf{u}_k\mathbf{g}_k^\top\right). \tag{14}$$
如前序工作 [38] 所证,自注意力矩阵本质上是一个低通滤波器。因为 $\mathbf{A}^1$ 由 $\mathbf{u}_1$ 的隐结构生成,其各行方差极小、缺乏高频复杂度。因此变换 $\mathbf{A}^{1\top}$ 强烈保留主结构成分 $\mathbf{u}_1$,却严重衰减高频次要成分 $\mathbf{u}_k$($k \ge 2$)。
令 $\xi_k = \|\mathbf{A}^{1\top}\mathbf{u}_k\| / \|\mathbf{u}_k\|$ 为衰减因子,刻画第 $k$ 个谱成分的幅度在反向传播中被保留的比例。低通滤波性质决定了对次要谱成分有 $\xi_k \ll \xi_1$。于是投影到第 $k$ 个次要成分($k \ge 2$)上的梯度更新有界:
$$\|\nabla_{\mathbf{X}}\mathcal{L} \cdot \mathbf{u}_k\| \le \xi_k\|\mathbf{g}_k\| + \mathcal{O}(\epsilon\sigma_1^2). \tag{15}$$
由于衰减因子 $\xi_k$ 极小、残差扰动被 $\mathcal{O}(\epsilon\sigma_1^2)$ 界住,梯度压倒性地集中在主成分 $\mathbf{u}_1$ 上。次要成分只收到高度衰减的更新,这加剧了嵌入坍缩并阻止模型逃离这一退化状态。$\square$
3.3 推荐中坍缩的恶性循环¶
命题 III.1 与 III.2 共同揭示了一个闭环恶性循环:
- 初始已坍缩的嵌入 → 生成平滑、低秩的注意力图(前向传播);
- 这些退化的注意力图充当低通滤波器 → 把梯度更新严格限制在主谱方向(反向传播);
- 这推动嵌入在下一次迭代中变得更加坍缩。
这一机制从数学上解释了为什么标准自注意力在推荐场景下比在 LLM 中更快、更严重地遭受注意力坍缩。
四、核心方法:SpecFormer¶
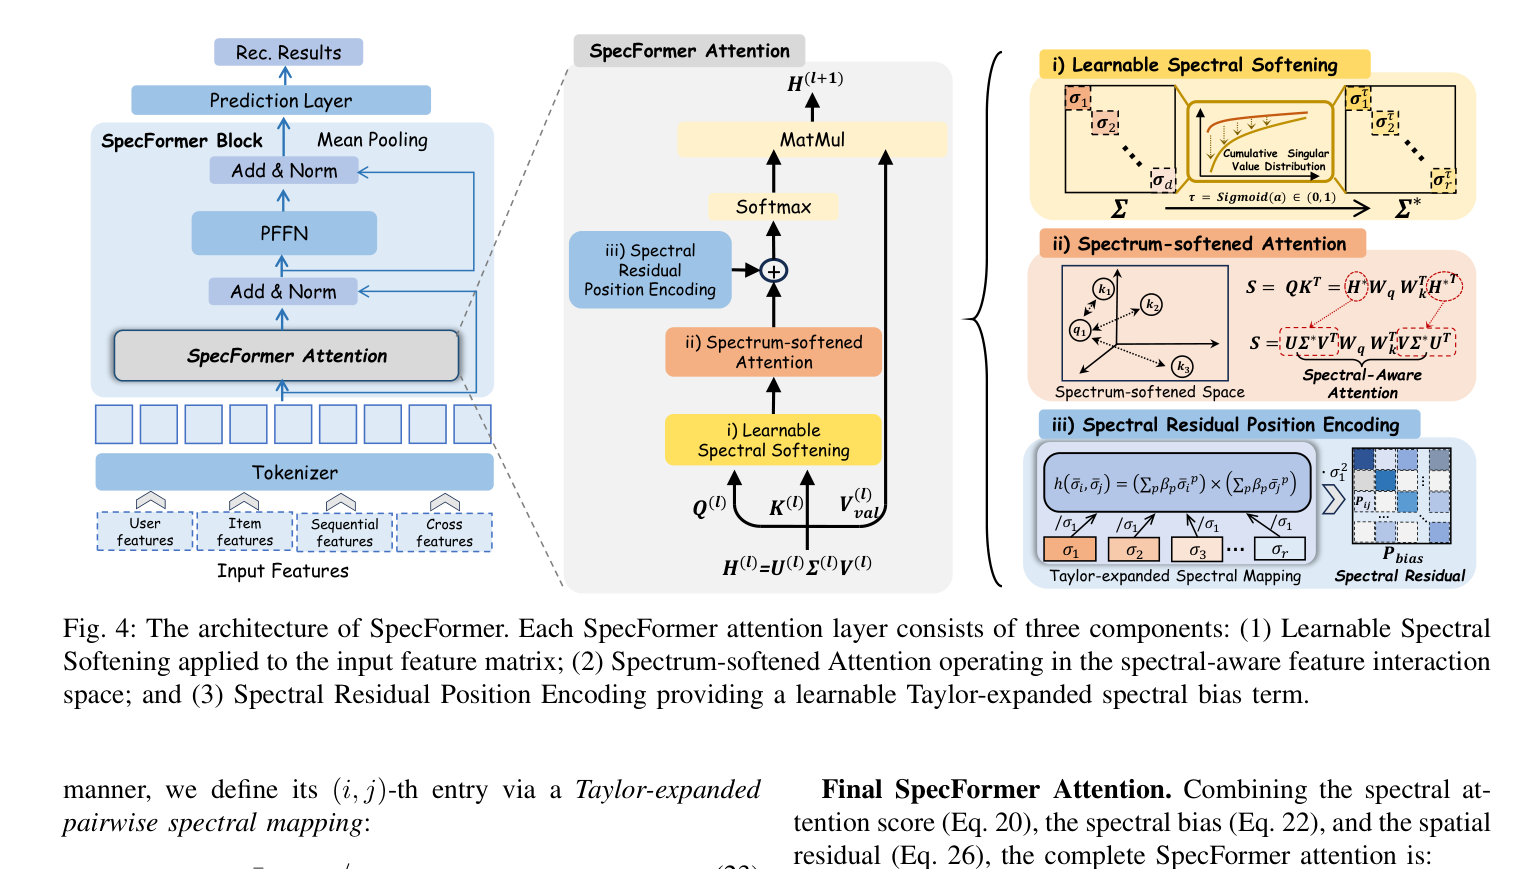
每个 SpecFormer 层用三个紧耦合的谱组件替换标准自注意力模块,其余 Transformer 组件(PFFN、LayerNorm、残差)保持不变。
4.1 Learnable Spectral Softening(可学习谱软化)¶
嵌入坍缩的 root cause 是特征嵌入矩阵奇异值分布过度倾斜——少数主奇异值捕获了几乎全部表征信息。作者直接对症:在每层注意力计算之前,对输入施加一次可学习的谱软化。
设 $\mathbf{H}^{(l)} \in \mathbb{R}^{L \times D}$ 为第 $l$ 层输入,$\mathbf{H}^{(0)} = \mathbf{X}$。先做 SVD:
$$\mathbf{H}^{(l)} = \mathbf{U}^{(l)}\boldsymbol{\Sigma}^{(l)}\mathbf{V}^{(l)\top}, \tag{16}$$
其中 $\mathbf{U}^{(l)} \in \mathbb{R}^{L \times r}$,$\mathbf{V}^{(l)} \in \mathbb{R}^{D \times r}$,$r = \min(L, D)$,$\boldsymbol{\Sigma}^{(l)} = \text{diag}(\sigma_1^{(l)}, \ldots, \sigma_r^{(l)})$,$\sigma_1^{(l)} \ge \cdots \ge \sigma_r^{(l)} \ge 0$。
随后对奇异值谱施加幂律软化(power-law softening):
$$\boldsymbol{\Sigma}^{(l)*} = \text{diag}\left(\sigma_1^{(l)\tau},\ \sigma_2^{(l)\tau},\ \ldots,\ \sigma_r^{(l)\tau}\right), \tag{17}$$
其中 $\tau = \text{Sigmoid}(a) \in (0, 1)$,$a$ 是初始化为 0 的可学习标量(即 $\tau$ 从 0.5 起步)。由于 $\tau < 1$,幂律变换对大奇异值的压缩比对小奇异值更激进,从而有效压平谱、把表征能量重新分配到所有维度上。软化后的特征矩阵重建为:
$$\mathbf{H}^{(l)*} = \mathbf{U}^{(l)}\boldsymbol{\Sigma}^{(l)*}\mathbf{V}^{(l)\top}. \tag{18}$$
设计动机:幂律软化提供了一种连续的、数据自适应的谱压平强度控制,且只引入 1 个标量参数(相比多嵌入范式的巨大参数开销,成本几乎为零)。
4.2 Spectrum-softened Attention(谱软化注意力)¶
标准自注意力直接在原始特征空间计算交互,导致注意力被坍缩的主成分支配。作者转而在谱软化域(spectrum-softened domain)中用软化后的嵌入计算注意力权重,使所有谱成分都能对特征交互做出有意义的贡献。
具体地,Query 与 Key 用软化嵌入 $\mathbf{H}^{(l)*}$ 定义,而 Value 矩阵保持原始特征空间:
$$\mathbf{Q}^{(l)} = \mathbf{H}^{(l)*}\mathbf{W}_q^{(l)}, \quad \mathbf{K}^{(l)} = \mathbf{H}^{(l)*}\mathbf{W}_k^{(l)}, \quad \mathbf{V}_{\text{val}}^{(l)} = \mathbf{H}^{(l)}, \tag{19}$$
其中 $\mathbf{W}_q^{(l)}, \mathbf{W}_k^{(l)} \in \mathbb{R}^{D \times D}$。
为什么 Value 用原始 $\mathbf{H}^{(l)}$(既不软化也不投影)? 这是经验性的选择:Value 矩阵聚合的是特征内容,保留原始表征可以避免输出侧的信息损失。作者在 §V-C 的消融中与其他 Value 设计做了对比,验证该设计最优。
pre-softmax 注意力分数矩阵为:
$$\mathbf{S}^{(l)} = \mathbf{Q}^{(l)}\mathbf{K}^{(l)\top} = \mathbf{H}^{(l)*}\mathbf{W}_q^{(l)}\mathbf{W}_k^{(l)\top}\mathbf{H}^{(l)*\top}. \tag{20}$$
把式 (18) 代入式 (20)(略去层上标)可揭示其谱本质:
$$\mathbf{S} = \mathbf{U}\underbrace{\left(\boldsymbol{\Sigma}^*\mathbf{V}^\top\mathbf{W}_q\mathbf{W}_k^\top\mathbf{V}\boldsymbol{\Sigma}^*\right)}_{\text{spectrum-softened attention}}\mathbf{U}^\top. \tag{21}$$
对照式 (10)(标准注意力的 $\mathbf{U}\boldsymbol{\Sigma}\mathbf{M}\boldsymbol{\Sigma}\mathbf{U}^\top$),差别正是把两侧的 $\boldsymbol{\Sigma}$ 换成了 $\boldsymbol{\Sigma}^*$。由于软化谱 $\boldsymbol{\Sigma}^*$ 使各成分贡献更加均衡,这一设计天然阻止了单个谱成分支配注意力计算——即直接切断了命题 III.1 中「$\sigma_1^2$ 项压倒残差项」的机制。
4.3 Spectral Residual Position Encoding(谱残差位置编码)¶
在谱软化注意力之外,作者进一步引入可学习的谱残差位置编码,为特征交互提供显式的谱归纳偏置,并防止坍缩跨层复合。
谱残差项(Spectral Residual Term)。定义谱位置编码偏置 $\mathbf{P}_{\text{bias}}^{(l)} \in \mathbb{R}^{L \times L}$:
$$\mathbf{P}_{\text{bias}}^{(l)} = \mathbf{U}^{(l)}\mathbf{P}^{(l)}\mathbf{U}^{(l)\top}, \tag{22}$$
其中 $\mathbf{P}^{(l)} \in \mathbb{R}^{r \times r}$ 是可学习的谱交互权重矩阵。为了以结构化、数据自适应的方式参数化 $\mathbf{P}^{(l)}$,通过 Taylor 展开的成对谱映射(Taylor-expanded pairwise spectral mapping)定义其 $(i,j)$ 元素:
$$\bar{\sigma}_i = \sigma_i / \sigma_1, \tag{23}$$
$$h(\bar{\sigma}_i, \bar{\sigma}_j) = \left(\sum_{p=0}^{2}\beta_p\bar{\sigma}_i^{\,p}\right) \times \left(\sum_{p=0}^{2}\beta_p\bar{\sigma}_j^{\,p}\right), \tag{24}$$
$$P_{ij}^{(l)} = \sigma_1^2\, h(\bar{\sigma}_i, \bar{\sigma}_j), \tag{25}$$
其中 $\bar{\sigma}_i$ 是归一化奇异值,$h(\bar{\sigma}_i, \bar{\sigma}_j)$ 是刻画第 $i$、$j$ 个谱成分成对谱交互的二阶多项式,$\boldsymbol{\beta} = [\beta_0, \beta_1, \beta_2]^\top$ 是共享的可学习参数。
设计动机(关键洞察):谱软化(§4.1)虽然有效压平了表征空间以复活长尾特征,但它可能无意中惩罚了高度信息量的主成分。通过显式地把交互锚定在最大奇异值 $\sigma_1^2$ 与归一化谱上,这个偏置项充当一个有针对性的结构残差——在被均匀化的空间中保留重权重的主推荐谱模式,避免主信号丢失。换言之,§4.1 负责「压平」,§4.3 负责「有选择地补回来」,两者是一对张力平衡。
空间残差项(Spatial Residual Term)。为了进一步稳定训练并保留来自原始空间的特征交互信号,再加一个由未软化嵌入计算的第二残差项:
$$\mathbf{S}_{\text{bias}}^{(l)} = \left(\mathbf{H}^{(l)}\bar{\mathbf{W}}_q^{(l)}\right)\left(\mathbf{H}^{(l)}\bar{\mathbf{W}}_k^{(l)}\right)^\top, \tag{26}$$
其中 $\bar{\mathbf{W}}_q^{(l)}$、$\bar{\mathbf{W}}_k^{(l)}$ 是专用于该残差连接的独立线性投影,以确保原始空间与软化空间的梯度流互相独立(这一点很重要:如果共享投影,谱软化路径的梯度会污染原始路径)。
4.4 最终的 SpecFormer 注意力¶
组合谱注意力分数(式 20)、谱偏置(式 22)与空间残差(式 26),完整的 SpecFormer 注意力为:
$$\text{SpecAtt}\left(\mathbf{H}^{(l)}\right) = \phi\left(\mathbf{S}^{(l)} + \alpha\mathbf{P}_{\text{bias}}^{(l)} + \gamma\mathbf{S}_{\text{bias}}^{(l)}\right)\mathbf{V}_{\text{val}}^{(l)}, \tag{27}$$
其中 $\phi(\cdot) = \text{softmax}(\cdot)$ 为激活函数,$\alpha, \gamma \in \mathbb{R}$ 是控制各残差项强度的超参数。
其余组件沿用标准 Transformer 设计。第 $l$ 层的完整更新规则为:
$$\mathbf{Z}^{(l)} = \text{LN}\left(\text{SpecAtt}\left(\mathbf{H}^{(l)}\right) + \mathbf{H}^{(l)}\right), \tag{28}$$
$$\mathbf{H}^{(l+1)} = \text{LN}\left(\mathbf{Z}^{(l)} + \text{PFFN}\left(\mathbf{Z}^{(l)}\right)\right), \tag{29}$$
其中 $\text{LN}(\cdot)$ 为 LayerNorm [29],$\text{PFFN}(\cdot)$ 为 §2.2 引入的 per-token FFN。最终表征在特征维度上 mean-pool 后送入预测 MLP。
算法流程小结(单层):
- 对 $\mathbf{H}^{(l)}$ 做 SVD 得 $\mathbf{U}, \boldsymbol{\Sigma}, \mathbf{V}$;
- $\tau \leftarrow \text{Sigmoid}(a)$,$\boldsymbol{\Sigma}^* \leftarrow \boldsymbol{\Sigma}^\tau$,重建 $\mathbf{H}^* = \mathbf{U}\boldsymbol{\Sigma}^*\mathbf{V}^\top$;
- $\mathbf{Q} = \mathbf{H}^*\mathbf{W}_q$,$\mathbf{K} = \mathbf{H}^*\mathbf{W}_k$,$\mathbf{V}_{\text{val}} = \mathbf{H}$,算 $\mathbf{S}$;
- 由 $\bar{\sigma}$ 与共享 $\boldsymbol{\beta}$ 构造 $\mathbf{P}$,得 $\mathbf{P}_{\text{bias}} = \mathbf{U}\mathbf{P}\mathbf{U}^\top$;
- 由未软化的 $\mathbf{H}$ 与独立投影 $\bar{\mathbf{W}}_q, \bar{\mathbf{W}}_k$ 得 $\mathbf{S}_{\text{bias}}$;
- $\text{softmax}(\mathbf{S} + \alpha\mathbf{P}_{\text{bias}} + \gamma\mathbf{S}_{\text{bias}})\mathbf{V}_{\text{val}}$,再走残差 + LN + PFFN + LN。
五、实验设置¶
作者围绕 5 个研究问题设计实验:
- RQ1:SpecFormer 相比现有 SOTA 传统 / Transformer-based / spectral-based 推荐模型表现如何?
- RQ2:各关键组件对整体性能的贡献如何?
- RQ3:SpecFormer 是否缓解了坍缩瓶颈,并在堆叠 Transformer 层时获得 scaling 能力?
- RQ4:不同超参数的影响是什么?
- RQ5:在真实大规模线上工业系统中,系统效率与业务指标如何?
5.1 数据集¶
Table II: 实验所用数据集统计
| Dataset | #Samples | #Fields | #Features | #Positive |
|---|---|---|---|---|
| Industrial | 1.2B | 391 | >1B | 2.7% |
| Criteo | 45M | 39 | 1.33M | 26.0% |
| Avazu | 40M | 23 | 1.54M | 17.0% |
- Industrial:采集自某国际领先电商平台(阿里巴巴)的线上展示广告系统。约 12 亿曝光样本,用户行为序列长度最长 256。(注:正文表述为 "containing 38 feature fields",与 Table II 的 391 字段存在数字不一致,疑为笔误。)
- Criteo:CTR 预测的知名公开 benchmark,一周真实广告点击数据,13 个连续特征 + 26 个类别特征。
- Avazu:10 天按时间顺序排列的广告点击数据,23 个特征字段,用于测试时序有序的类别数据。
5.2 Baseline¶
分三类:
- 传统特征交互模型:DeepFM (arXiv'17)、AutoInt (CIKM'19)、MaskNet (arXiv'21)、FiBiNet++ (CIKM'23)、GDCN (CIKM'23),以及 Table III 中的 Wide&Deep。
- Transformer-based 特征交互模型:HiFormer (arXiv'23)、FAT (arXiv'25)、RankMixer (CIKM'25)、OneTrans (WWW'26)。
- Spectral-based 推荐模型:WhitenRec (ICDE'24,用基于谱的白化变换缓解维度坍缩)、FEDIN (arXiv'26,利用 Fourier 变换在频域优化特征表征并建模全局交互模式)。
5.3 评估指标¶
沿用前序工作 [6][11],采用 AUC(ROC 曲线下面积)与 Logloss(交叉熵损失)。工业数据集额外报告 GAUC(Group AUC),衡量用户级排序质量,与线上表现高度相关。注意:AUC/GAUC 提升 0.001 在工业应用中即视为显著,可带来巨大营收增长 [10][42]。
5.4 实现细节¶
- PyTorch 实现,NVIDIA L20 GPU。
- Industrial:token 嵌入维度 304,优化器 Adagrad [43],batch size 1024。
- 公开数据集:嵌入维度 Criteo 312、Avazu 176,batch size 512。
- 学习率网格搜索:Industrial 在 $\{0.005, 0.01, 0.05, 0.1\}$;公开数据集在更宽的 $\{0.001, 0.002, 0.005, 0.01, 0.05, 0.1\}$。
5.5 训练策略与 Warm-up 协议¶
为保证数值稳定与模型收敛,SpecFormer 采用两阶段训练,而 baseline 遵循标准单阶段流程:
- (a) Baseline 配置:按 CTR 预测的通行做法,所有 baseline 用标准高斯分布初始化,在 100% 训练集上训练以优化目标 CTR 损失。
- (b) SpecFormer 配置:
- 第一阶段(Embedding Warm-up):用 5% 的训练数据,通过优化 Spatial Residual Term 来初始化嵌入;
- 第二阶段(Main CTR Training):用剩余 95% 的数据,以完整架构(包含 Spectral Softening 模块)训练。
warm-up 为何必要:随机初始化的嵌入常呈现被噪声支配的病态奇异值分布(ill-conditioned singular value distributions),直接施加谱变换容易数值不稳定。先用 Spatial Residual Term 预训练,可把嵌入投影到一个结构化的特征流形上,为后续 CTR 训练阶段的鲁棒频域精化建立稳定的谱基础。
六、主要实验结果¶
6.1 整体性能对比(RQ1)¶
Table III: SpecFormer 与代表性 baseline 在三个真实数据集上的性能对比(AUC↑ / GAUC↑ 越高越好,Logloss↓ 越低越好)
| Category | Model | Ind. AUC↑ | Ind. GAUC↑ | Ind. Logloss↓ | Criteo AUC↑ | Criteo Logloss↓ | Avazu AUC↑ | Avazu Logloss↓ |
|---|---|---|---|---|---|---|---|---|
| Traditional | Wide&Deep | 0.7373 | 0.6287 | 0.1144 | 0.6589 | 0.5372 | 0.6364 | 0.4335 |
| Traditional | DeepFM | 0.7378 | 0.6282 | 0.1143 | 0.5988 | 0.5421 | 0.7404 | 0.3965 |
| Traditional | GDCN | 0.7491 | 0.6426 | 0.1133 | 0.6727 | 0.5268 | 0.7370 | 0.3989 |
| Traditional | AutoInt | 0.7483 | 0.6405 | 0.1136 | 0.7022 | 0.5153 | 0.7439 | 0.3952 |
| Traditional | FiBiNet++ | 0.7508 | 0.6437 | 0.1133 | 0.7485 | 0.4868 | 0.7410 | 0.3965 |
| Transformer | HiFormer | 0.7497 | 0.6417 | 0.1134 | 0.7570 | 0.4811 | 0.7248 | 0.4842 |
| Transformer | FAT | 0.7559 | 0.6490 | 0.1126 | 0.7551 | 0.4828 | 0.7440 | 0.3955 |
| Transformer | RankMixer | 0.7587 | 0.6526 | 0.1127 | 0.7484 | 0.4859 | 0.7450 | 0.3951 |
| Transformer | OneTrans | 0.7555 | 0.6497 | 0.1127 | 0.7558 | 0.4823 | 0.7461 | 0.3943 |
| Spectral | WhitenRec | 0.7481 | 0.6425 | 0.1139 | 0.7472 | 0.4888 | 0.7484 | 0.3932 |
| Spectral | FEDIN | 0.6945 | 0.5675 | 0.1189 | 0.6172 | 0.9568 | 0.6737 | 0.4256 |
| Ours | SpecFormer | 0.7611 | 0.6537 | 0.1119 | 0.7587 | 0.4791 | 0.7574 | 0.3902 |
(粗体为最优,_斜体_为原文标注的次优。)
结论分析:
1) 整体性能。 SpecFormer 在三个数据集的 AUC / GAUC / Logloss 上一致且显著地优于所有 baseline。Industrial AUC 从最强 baseline RankMixer 的 0.7587 提升到 0.7611(+0.0024,是工业「显著」阈值 0.001 的 2 倍以上);Avazu AUC 从 0.7484(WhitenRec)提升到 0.7574(+0.009,涨幅相当大)。这验证了谱感知架构的有效性与泛化性——通过从根本上解决谱坍缩瓶颈,SpecFormer 成为一个高效且鲁棒的特征交互骨干。
2) 对比传统模型。 传统模型虽能通过精心设计的结构捕获低阶与高阶特征交互,但天然缺乏上下文感知的建模能力。此外,像 AutoInt 这类早期尝试自注意力的模型直接作用在原始特征嵌入上,因而极易受参数碎片化之害 [11]。SpecFormer 使用现代化 tokenization 范式并在谱注意力中运作,解锁了更大的表达容量。
3) 对比 Transformer baseline。 这里是本文最有信息量的观察:采用标准自注意力的模型(如 OneTrans,Industrial AUC 0.7555)有时反而不如设计良好的更简单 token-mixing 方法(RankMixer 0.7587)。这一经验证据强有力地佐证了 §III 的理论分析——面对异质推荐数据时,标准注意力图会被少数主谱成分支配。SpecFormer 通过在动态软化的谱空间中建模特征交互超越了这些强 baseline:谱感知设计有效复活了长尾特征,迫使模型捕获一组更均衡、更多样的谱信号,从而打破了标准注意力机制造成的瓶颈。
4) 对比 spectral-based baseline。 SpecFormer 大幅超越谱类方法。WhitenRec 用静态 SVD 与谱约束调整谱,但单纯的谱变换不足以应对复杂特征交互;FEDIN 在各数据集上表现很差(Criteo AUC 仅 0.6172、Logloss 高达 0.9568),确认了简单频域变换难以捕获基于注意力的非线性特征交互。相反,SpecFormer 把谱感知特征交互内在地集成进注意力机制本身,并缓解了注意力中的核心谱坍缩。
一处需要留意的数据细节:Avazu 列中,WhitenRec 的 AUC 0.7484 实际高于被原文标注为次优的 OneTrans 0.7461,原文的次优标注在该列疑有笔误;此外 Criteo 上 DeepFM 的 AUC 0.5988 明显低于同类的 Wide&Deep 0.6589,FEDIN 的 Criteo Logloss 0.9568 也远离正常量级,提示这些 baseline 可能存在调参不充分的问题。
6.2 消融实验(RQ2)¶
作者设计了四组共 7 个消融变体:
- 1) Learnable Spectral Softening 模块:(a) w/o Spectral Softening($\boldsymbol{\Sigma}^* = \boldsymbol{\Sigma}$)——移除可学习幂律软化,直接用原始奇异值重建空间。
- 2) Value 矩阵设计:(b) Value Matrix w/ Projection($\mathbf{V}_{\text{val}} = \mathbf{H}\mathbf{W}_v$)——对 Value 施加标准线性投影;(c) Value Matrix w/ Softening($\mathbf{V}_{\text{val}} = \mathbf{H}^*$)——用谱软化嵌入作为 Value。
- 3) 谱残差与空间残差:(d) w/o Spectral Position Encoding($\alpha = 0$);(e) Spectral Position Encoding → Identity Matrix($\mathbf{P} = \mathbf{I}$)——用单位阵替换 Taylor 展开的可学习谱映射矩阵;(f) w/o Spatial Residual($\gamma = 0$)。
- 4) Spectrum-softened Attention 机制:(g) w/o Spectrum-softened Attention $\mathbf{S}$(Only Residuals)——移除核心动态谱软化注意力矩阵 $\mathbf{S}$,只留结构化残差偏置。
Table IV: SpecFormer 的消融实验
| Method | Ind. AUC↑ | Ind. GAUC↑ | Ind. Logloss↓ | Criteo AUC↑ | Criteo Logloss↓ | Avazu AUC↑ | Avazu Logloss↓ |
|---|---|---|---|---|---|---|---|
| SpecFormer | 0.7611 | 0.6537 | 0.1119 | 0.7587 | 0.4791 | 0.7574 | 0.3902 |
| (a) w/o Spectral Softening ($\boldsymbol{\Sigma}^*=\boldsymbol{\Sigma}$) | 0.7576 | 0.6541 | 0.1100 | 0.6555 | 0.5332 | 0.7525 | 0.3914 |
| (b) Value Matrix w/ Projection ($\mathbf{V}_{\text{val}}=\mathbf{H}\mathbf{W}_v$) | 0.7555 | 0.6526 | 0.1103 | 0.6593 | 0.5351 | 0.5645 | 0.4476 |
| (c) Value Matrix w/ Softening ($\mathbf{V}_{\text{val}}=\mathbf{H}^*$) | 0.7547 | 0.6518 | 0.1100 | 0.6472 | 0.5346 | 0.5643 | 0.4479 |
| (d) w/o Spectral Position Encoding ($\alpha=0$) | 0.7588 | 0.6555 | 0.1099 | 0.6598 | 0.5299 | 0.6700 | 0.4169 |
| (e) Spectral Position Encoding → Identity ($\mathbf{P}=\mathbf{I}$) | 0.7573 | 0.6548 | 0.1101 | 0.7536 | 0.4832 | 0.5667 | 0.4469 |
| (f) w/o Spatial Residual ($\gamma=0$) | 0.7551 | 0.6527 | 0.1106 | 0.7555 | 0.4812 | 0.6733 | 0.4203 |
| (g) w/o Spectrum-softened Attention $\mathbf{S}$ (Only Residuals) | 0.7582 | 0.6551 | 0.1100 | 0.7569 | 0.4812 | 0.7382 | 0.3980 |
逐项分析:
1) 移除 Learnable Spectral Softening(a) 导致灾难性的性能下降,在最重要的 AUC 指标上尤为明显——Criteo AUC 从 0.7587 崩到 0.6555(-0.103)。这直接验证了 §III 的核心动机:不动态压平奇异值分布,注意力机制会立刻坍缩到主成分上,丧失捕获长尾特征交互的能力。
2) Value 矩阵设计(b)(c) 都给出明显次优的结果,说明:对已坍缩的输入 $\mathbf{H}$ 施加标准投影 $\mathbf{W}_v$ 是不必要的并导致性能变差;同样,用软化表征 $\mathbf{H}^*$ 作 Value 会人为扭曲嵌入的语义、造成信息损失。Avazu 上这两个变体 AUC 直接掉到 0.5645/0.5643(接近随机),影响最为剧烈。这从经验上论证了 §IV-B 的设计:用原始 $\mathbf{H}$ 作 Value 保留了原始信息,而软化后的 Q/K 矩阵负责建模谱感知的特征交互——一种漂亮的职责分离。
3) 残差位置编码(d)(e)(f) 的消融证明保留原始谱信号与空间信号的必要性。移除 Spectral Position Encoding(d)带来显著下降(Criteo AUC -0.099,Avazu AUC -0.087),证明谱软化虽然复活了长尾特征,却不可避免地惩罚了主谱模式——Spectral Position Encoding 是补偿这些本质信号的关键结构残差。更进一步,用单位阵替换它(e)造成最严重的性能下降之一(Avazu AUC 0.5667):完全均匀的分布无法把交互锚定在最大谱($\sigma_1^2$)上,模型难以区分不同谱成分的重要性差异。最后移除 Spatial Residual(f)也略微降低性能,凸显其从原始空间视角稳定训练的作用。
4) 移除 Spectrum-softened Attention $\mathbf{S}$(g) 在所有数据集上都带来显著下降(Avazu AUC 0.7382 vs 0.7574)。这表明:虽然残差偏置提供了优秀的结构先验,但它们无法替代注意力机制的动态、数据依赖的特征交互能力。SpecFormer 的 SOTA 性能,正是核心谱软化注意力与结构化残差协同组合的产物。
值得注意的一处张力:在 Industrial 数据集上,多个消融变体的 GAUC 与 Logloss 反而优于完整 SpecFormer(例如 (d) GAUC 0.6555 > 0.6537,多个变体 Logloss ≈ 0.110 < 0.1119)。原文未对此作出解释。这意味着完整模型在 Industrial 上主要是把 AUC(全局排序)优化到最好,而在用户内排序(GAUC)与概率校准(Logloss)上并非全面占优——这是一个应当被正视的取舍。
6.3 Scaling 研究(RQ3)¶
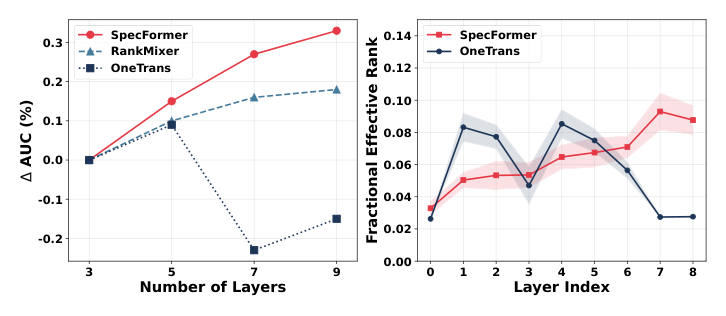
为评估 SpecFormer 相对其他 Transformer 模型在深度方向的可扩展性,作者在 Industrial 数据集上把 RankMixer、OneTrans、SpecFormer 的模型深度从 3 层扩到 5、7、9 层,从两个维度分析:增量 AUC 增益(ΔAUC)与注意力矩阵的逐层 fractional effective rank。
结论分析:
1) 深度 vs 性能。 随层数增加,SpecFormer 与 RankMixer 的 AUC 持续增长,而 OneTrans 呈现严重的先升后降(rise-then-fall)性能退化。这印证了 §III 的理论分析:依赖标准自注意力的 OneTrans 不可避免地落入注意力坍缩的恶性循环;相反,SpecFormer 从根本上打破了这个瓶颈,展现出持续 scale up 模型深度以换取显著性能增益的能力(从 3 层到 9 层,ΔAUC 从约 -0.05% 单调爬升到约 +0.3%)。
2) 与 RankMixer 的差异。 虽然 SpecFormer 与 RankMixer 都有 scaling 能力,但 SpecFormer 的 AUC 增长曲线更陡,且在 3/5/7/9 层上一致优于 RankMixer。这证明:精心手工设计的 token-mixing 策略(RankMixer)能通过简化交互来规避注意力坍缩,但它们天然缺乏对复杂特征交互建模的表达力。装备了谱感知注意力机制的 SpecFormer 不仅缓解了坍缩,还释放了 Transformer 在推荐中的潜力,能远为有效地建模细粒度、高阶特征交互。
3) 逐层有效秩。 随模型深度增加,SpecFormer 注意力矩阵的 fractional effective rank 呈现稳定的上升趋势(从约 0.02 爬到 0.10 以上)。形成鲜明对比的是,OneTrans 的注意力有效秩在浅层剧烈震荡、深层则不可逆地坍缩。这为本文方法提供了经验证明:通过谱感知注意力设计,SpecFormer 有效打破了原始注意力坍缩的闭环,确保即便在深层,注意力图仍保持高有效秩,成功跨多样谱成分捕获特征交互。
6.4 超参数敏感性(RQ4)¶
观察:
-
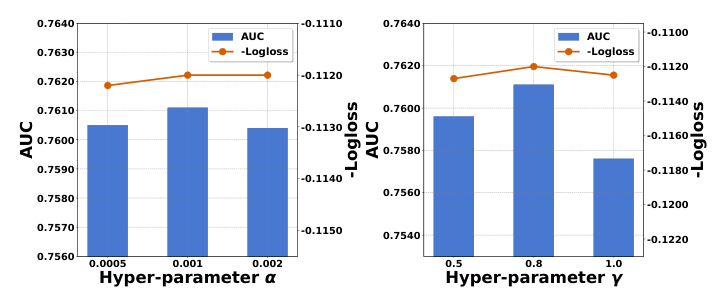
当 $\alpha$ 从 $0.0001$ 增大到 $0.001$ 再到 $0.01$,推荐性能先升后降,大致在 $\alpha \approx 0.001$ 处达到峰值。类似地,$\gamma$ 在 $\{0.5, 0.8, 1.0\}$ 上也呈现明显的先升后降,最优约在 $\gamma \approx 0.8$。这说明为原始谱与空间偏置信号赋予适当权重是必要的,用以补偿谱软化对主信号的惩罚;但过大的 $\alpha$ 或 $\gamma$ 会压倒动态学习的谱软化注意力,反而损害推荐性能。
-
更值得注意的是,$\alpha$ 的最优值(0.001)比 $\gamma$ 的最优值(0.8)小了几个数量级。原因有二:
- (a) 空间残差 $\mathbf{S}_{\text{bias}}^{(l)}$ 是通过标准点积注意力计算的,其数值尺度与主谱软化注意力矩阵 $\mathbf{S}^{(l)}$ 接近,因此 $\gamma$ 天然工作在 0.8 附近的量级;
- (b) 谱残差项 $\mathbf{P}_{\text{bias}}^{(l)}$ 由奇异值的多项式展开显式参数化并被 $\sigma_1^2$ 锚定,其数值本质上远大于标准 pre-softmax 注意力分数。因此需要一个严格很小的 $\alpha$ 来正则化其幅度,防止梯度爆炸并确保训练稳定。
6.5 线上实验(RQ5)¶
6.5.1 模型 scaling 与多轮训练策略¶
SpecFormer 通过其深层架构展现出优越的可扩展性,非常适合大规模参数扩张。为充分利用增大的模型容量,作者实施了带渐进式参数继承(progressive parameter inheritance)的多轮(multi-epoch)训练策略。
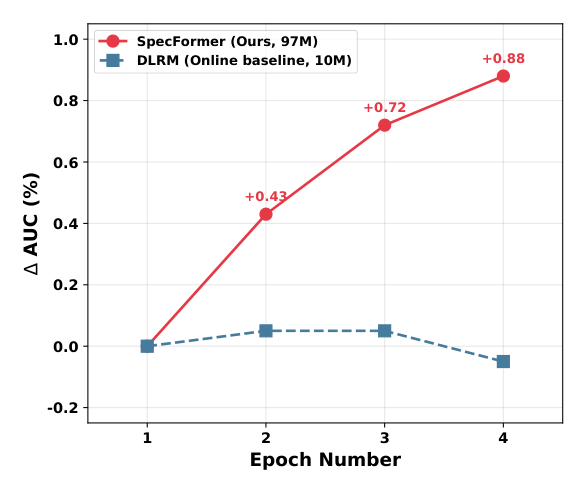
与 DLRM 这类传统模型往往快速性能饱和不同,SpecFormer 随训练轮数增加持续产生显著 AUC 增益:
| Epoch | SpecFormer ΔAUC | DLRM (Online baseline) ΔAUC |
|---|---|---|
| 1 | 0.00% | 0.00% |
| 2 | +0.43% | ≈ +0.05% |
| 3 | +0.72% | ≈ +0.05% |
| 4 | +0.88% | ≈ -0.05%(下降) |
其机制是:在每个 epoch 开始时利用 warm-up 过的嵌入,并继承上一个 epoch 优化好的参数,从而有效放大模型 scaling 的收益。为平衡训练成本与效率,作者最终部署了 3-epoch 模型,相比生产环境 DLRM baseline 取得 +0.92% AUC 增益。
6.5.2 效率优化¶
为应对 SVD 的计算复杂度与大规模部署压力,作者做了一整套工程优化:
- In-batch SVD 算子:在 batch 内做谱分解,平衡谱精化与训练吞吐;
- Distributed Dynamic Embedding (DDE) 框架:嵌入表跨 rank 分片,支持特征空间的动态扩展同时显著降低显存占用;
- Coalesced lookup(合并查表):缓解高维特征引起的通信瓶颈,把嵌入查询频率降至 baseline 的 8%;
- FlashAttention:把每层注意力开销降低 40%;
- FP16 混合精度:与上述优化叠加,整体带来 35% 的训练效率提升。
6.5.3 线上 A/B 结果¶
作者在阿里巴巴的电商广告平台上做了大规模 A/B 测试:实验期为 2026 年 6 月 1 日至 6 月 10 日,共 10 天,覆盖平台 10% 的生产流量。用户通过正交哈希协议(orthogonal hashing protocol)随机分配到对照组(高度优化的 DLRM baseline)或实验组(SpecFormer)。
Table V: 大规模电商广告平台上的线上 A/B 实验结果(所有增益在 $p < 0.05$ 下统计显著)
| Method | CTR | CVR | Order | Δ Latency |
|---|---|---|---|---|
| DLRM Baseline | - | - | - | - |
| SpecFormer | +1.34% | +15.97% | +16.72% | +5ms |
结论:SpecFormer 在所有关键业务指标上都取得显著提升,包括 CTR(+1.34%)与 Order(+16.72%),代价仅为推理延迟增加 5ms,完全在严格的线上服务要求之内。
一处值得存疑的地方:CVR +15.97% / Order +16.72% 相对于 CTR +1.34% 高出一个数量级。CTR 模型的改进通常不会带来如此不成比例的转化收益,论文未解释这一 gap(是否涉及广告出价链路的联动、流量结构变化,或转化统计口径差异均未说明)。这是解读该线上收益时需要谨慎的地方。
七、相关工作¶
7.1 基于 Transformer 的推荐系统¶
Transformer 已在多个领域取得成功。在推荐中,早期采用主要聚焦捕获序列用户行为(BERT4Rec、SASRec 等)。随后 Transformer 被引入 CTR 预测以自动建模复杂高阶特征交互:AutoInt 直接对原始特征嵌入用多头自注意力显式映射到交互空间;在此基础上,近期工作探索了各种结构增强,例如 HiFormer 用层次化 Transformer 同时处理细粒度特征内与粗粒度特征间关系。为优化交互效率并缓解参数碎片化,现代架构改进了 tokenization 与聚合过程:RankMixer 集成专为排序任务定制的特化 token-mixing 注意力,OneTrans 提出统一的特征交互框架无缝整合多种范式。此外 LLM 也在推荐中展现强能力(作为直接推荐器或语义增强器),但因高昂的推理延迟,在大规模工业系统中部署 LLM 仍极具挑战,不是本文关注点。
尽管这些工作取得成功,注意力机制仍因推荐数据的异质性与长尾分布而性能次优。现有尝试要么严重依赖多参数(multi-parameters)[14][15],要么依赖外部谱增强 [17][18],但它们要么严重依赖空间域补丁,要么无法把核心注意力机制整合进来,改进有限。相比之下,SpecFormer 从根本上揭示了注意力机制的局限,并从谱视角解决了性能瓶颈。
7.2 推荐系统中的谱坍缩¶
Embedding collapse 指表征退化到低维子空间的现象,在自然语言生成 [54] 与对比学习 [55][56] 中已被广泛研究。近期研究指出,推荐数据的极端异质性与长尾分布会大幅加剧这种坍缩,导致嵌入空间被极少数主奇异值支配 [13][31][32]。同时,attention collapse 发生在注意力图丧失 token routing 判别能力时,严重限制自注意力的表达力 [38][58]。
本文的理论分析(§III)推进了这条研究路线:从数学上刻画了嵌入坍缩与注意力坍缩在前向与反向传播中的恶性循环——一个在推荐场景下尤其严重的现象。近期推荐工作引入显式谱正则 [17] 防止维度坍缩,或探索 Fourier 变换 [18] 捕获频域信号用于 Transformer 特征交互。然而这些方法通常把谱分解当作事后正则项或一个孤立于核心注意力模块之外的静态变换。 SpecFormer 用新颖的谱感知注意力内在地缓解嵌入与注意力坍缩,有效打破推荐系统中的坍缩恶性循环。
八、核心贡献总结¶
- 诊断的深度:不是简单地报告「推荐 Transformer 效果不好」,而是把它归因到「数据异质性 + 长尾 → 谱坍缩」,并进一步用两个命题证明这不是静态缺陷而是前向/反向传播的闭环恶性循环。这条因果链(数据特性 → 嵌入谱 → 注意力秩 → 梯度分布 → 嵌入谱)是本文最有价值的部分。
- 解法与诊断的对应关系干净:谱软化直接切断命题 III.1 中「$\sigma_1^2$ 主导」的机制;空间残差用独立投影保证梯度流分离,直接针对命题 III.2 的梯度饥饿;谱残差位置编码则处理「压平会误伤主信号」这一副作用。三个模块各自对应一个明确的失效环节。
- 深度可扩展性的经验证明:Fig 5 同时给出「层数 ↑ → AUC ↑」与「层数 ↑ → 注意力 ferank ↑」两条曲线,把「性能提升」与「机制假设」绑在同一张图上,比单纯的性能对比更有说服力。
- 工业落地扎实:97M vs 10M 的参数规模跃迁、多轮训练 + 渐进参数继承、in-batch SVD + DDE + coalesced lookup + FlashAttention + FP16 的完整工程栈、10 天 10% 流量的正交哈希 A/B,以及 +5ms 的延迟预算,都给出了可复现的落地路径。
九、与已归档相关工作的对比¶
RankElastor RankElastor: Expand More, Shrink Less — Shaping Effective-Rank Dynamics for Dense Scaling in Recommendation (Tencent + HKUST-GZ, 2026-05-22)¶
关系:独立并发(本文未引用 RankElastor,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把「工业 CTR 排序模型堆参数/堆深度收益递减」的 root cause 定位到表征谱坍缩(有效秩退化),而不是容量不足或数据不够。两者都用逐层有效秩轨迹作为核心诊断工具,都把「加参数 ≠ 加表达能力」当作论文的出发点,也都为此配了理论定理(SpecFormer 的两个 Proposition,RankElastor 的四个 Theorem)。SpecFormer 的靶子是 OneTrans(标准自注意力),RankElastor 的靶子是 RankMixer(无参数块转置 token mixing + P-FFN)——恰好是同一张 Table III 里互为对手的两个 SOTA 骨干。
- 相近的技术骨架:两者都不改 tokenization、不改训练目标,而是在 block 内部替换那个「压秩」的算子,然后论证替换后的算子谱鲁棒。都把「秩扩张 vs 秩收缩」当作可以逐模块归因的量,并据此设计对症模块。
- 本文的差异与推进:路线是正交的。RankElastor 走的是参数化路线——把无参数块转置混合泛化成可学习的 $\mathbb{R}^{TD \times TD}$ 全混合矩阵(expand more),把 GELU FFN 换成 GLU 门控(shrink less),本质是在原始空间域里换更强的算子。SpecFormer 走的是谱域路线——显式做 SVD,用一个可学习标量 $\tau$ 直接对奇异值做幂律压平,本质是换一个计算注意力的空间。参数代价上 SpecFormer 极轻(谱软化只有 1 个标量 $a$、谱残差只有 3 个共享 $\beta_p$),代价转移到了每层 SVD 的计算开销上(作者用 in-batch SVD 算子缓解);RankElastor 则相反,$\mathbb{R}^{TD\times TD}$ 全混合矩阵参数量巨大但计算是稠密 GEMM,对 GPU 友好。有意思的是,RankElastor 的诊断(token mixing 扩张、P-FFN 收缩,形成阻尼振荡)恰好可以解释 SpecFormer Table III 中「RankMixer 在 Industrial 上强于 OneTrans」的现象——RankMixer 至少有一个扩秩模块,而标准自注意力连扩秩模块都没有。
- 可比的方法/实验差异:两者采用的有效秩定义不同,这是对比时必须注意的:RankElastor 用 stable rank $\|X\|_F^2/\|X\|_2^2$,SpecFormer 用谱熵指数 $\exp(-\sum p_i \ln p_i)$ 再除以 $r$ 归一化为 ferank。两者度量的对象也不同:RankElastor 测的是 token 表征矩阵的有效秩,SpecFormer 测的是注意力分数矩阵的有效秩。数据集上两者都跑 Criteo/Avazu,但 SpecFormer 额外有 1.2B 样本的工业数据集和真实 A/B(RankElastor 无线上实验);提升幅度上 RankElastor 报「AUC 最高提升 0.001」,SpecFormer 在 Criteo/Avazu 上的绝对提升更大(Avazu +0.009),但这部分要打折看待——SpecFormer 对自己用了两阶段 warm-up 而 baseline 用单阶段。
RankUp RankUp: Towards High-rank Representations for Large Scale Advertising Recommender Systems (Tencent WeChat Ads, 2026-04-20)¶
关系:显式引用但原文未展开对比(仅在 related work 与指标定义处提及)· 已加载对方精读
- 共同关注的问题:两篇都把 Effective Rank 退化当作工业排序模型 scaling 的结构性瓶颈,且都主张「scaling 参数规模 ≠ scaling 表达能力」。事实上 SpecFormer 的 Fractional Effective Rank 定义(式 9)正是引用 RankUp(文中 [15])而来——两篇用的 erank 公式 $\exp(-\sum_i p_i \ln p_i)$ 完全一致。两者都在广告 CTR/CVR 场景、都有大规模线上部署。
- 相近的技术骨架:都是「先用有效秩做诊断 → 再设计模块把有效秩提上去 → 用有效秩曲线证明机制生效」的三段式论证结构,而非纯粹的性能刷榜。
- 本文的差异与推进:SpecFormer 对 RankUp 的立场是批评式引用——在 Introduction 中把 RankUp 归入「多嵌入范式(multi-embedding paradigms)[14][15]」,指出其「引入了 prohibitive parameter overhead,对大规模系统不实用」。这抓住了要害:RankUp 的五个机制(随机置换分片、多嵌入表、全局 token、跨域预训练嵌入融合、任务专属 token)本质上是通过扩大潜空间本身的容量来提升有效秩,属于「加维度换秩」;SpecFormer 则是在不加维度的前提下,把已有维度里被挤压的能量重新摊开,属于「重分配换秩」。前者参数开销随嵌入表数量线性增长,后者只加 1 个标量 + 3 个 Taylor 系数。另一个关键差异:RankUp 提升的是 token 表征矩阵的有效秩,而 SpecFormer 明确指出光提表征秩不够,必须提注意力矩阵的秩——因为命题 III.2 的梯度饥饿是通过注意力矩阵这个低通滤波器发生的。
- 可比的方法/实验差异:SpecFormer 未把 RankUp 纳入 Table III 的 baseline(Transformer-based 一栏是 HiFormer/FAT/RankMixer/OneTrans),因此两者没有直接可比的数值。线上收益的口径也不同:RankUp 报 GMV 相对提升 3.41%/4.81%/2.21%(微信视频号/公众号/朋友圈,CVR 任务),SpecFormer 报 CTR +1.34%/Order +16.72%(阿里电商广告)。有价值的后续问题是:RankUp 的多嵌入扩容与 SpecFormer 的谱软化是否可叠加——前者扩大可用谱空间,后者保证这个空间被均匀使用,机制上并不冲突。
FEDIN FEDIN: Frequency-Enhanced Deep Interest Network for CTR Prediction (Tsinghua University, 2026-05-03)¶
关系:显式引用且原文已在 Table III + §V-B-4 做了对比 · 未加载对方精读
原文把 FEDIN 归入 Spectral-based Recommendation Models 一类(与 WhitenRec 并列),描述为「leverages Fourier Transform to optimize feature representations in the frequency domain and model global interaction patterns」,并在 Table III 中报告了完整数值:Industrial AUC 0.6945 / GAUC 0.5675 / Logloss 0.1189;Criteo AUC 0.6172 / Logloss 0.9568;Avazu AUC 0.6737 / Logloss 0.4256——在三个数据集上均为全表最差。SpecFormer 对此的解释是:「FEDIN performs poorly across the datasets, confirming that simple frequency-domain transformations struggle to capture non-linear attention-based feature interactions.」
需要客观指出的是,这个对比对 FEDIN 可能不公平:FEDIN 原本的设计目标是目标物品条件下的用户兴趣序列频谱建模(其核心发现是「用户兴趣谱只有在以 target item 为条件时才呈现低熵集中模式」),属于序列兴趣建模赛道,而非多字段特征交互赛道;被搬到 Criteo/Avazu 这类无长序列的纯特征交互 benchmark 上,其核心机制(复值 MLP 谱滤波 + 时域 patching + Top-k target attention)本就无用武之地,Criteo Logloss 高达 0.9568 也强烈提示未充分调参。两篇论文真正的共识在于「推荐表征的谱是病态的、值得被显式操作」这一判断;分歧在于操作对象——FEDIN 操作的是行为序列的时频谱,SpecFormer 操作的是特征嵌入矩阵的奇异值谱。详细精读见 FEDIN。
十、讨论与局限性¶
10.1 值得借鉴的设计¶
- 把「诊断指标」直接当作「优化对象」:ferank 既是本文的问题度量(图 1),也是方法有效性的证明(图 5 右)。这种「用同一把尺子提问题和验答案」的写法,让论文的因果论证闭环,值得在方法论层面借鉴。
- 压平与补偿的成对设计:谱软化压平谱以救长尾,谱残差位置编码锚定 $\sigma_1^2$ 以护主信号。承认自己的核心操作有副作用并给出配套补偿,比单向鼓吹一个 trick 更可信——消融 (d)(e) 也确实证明了补偿项不可或缺。
- 梯度流分离:空间残差用独立的 $\bar{\mathbf{W}}_q, \bar{\mathbf{W}}_k$ 而非复用主路径投影,明确写出动机是「确保原始空间与软化空间的梯度流独立」。这是一个容易被忽略但对训练稳定性影响很大的细节。
- 超参尺度的机制性解释:§6.4 中对「为什么 $\alpha$ 要比 $\gamma$ 小三个数量级」给出了基于数值量级($\mathbf{P}_{\text{bias}}$ 被 $\sigma_1^2$ 锚定,量级远大于 pre-softmax 分数)的解释,而不是「网格搜索出来就是这样」。
10.2 局限与争议¶
-
实验协议的公平性存疑(最重要的一条)。SpecFormer 使用两阶段训练(5% 数据做 Embedding Warm-up + 95% 主训练),而所有 baseline 使用标准单阶段训练。论文把 warm-up 解释为「谱变换的数值稳定性所必需」,这个理由成立,但它同时也是一个额外的训练技巧。在没有「baseline + 同样 warm-up」这一组对照的情况下,Table III 中的部分增益无法排除来自 warm-up 本身。这是全文最大的方法论漏洞。
-
SVD 的实际计算代价缺乏量化。每层每个 batch 都要做一次 SVD,这是本方法与所有 baseline 最本质的成本差异。论文只提到用 "in-batch SVD operator" 缓解,以及一揽子工程优化带来「整体 35% 训练效率提升」(但这是相对于优化前的 SpecFormer 自身,不是相对于 baseline)。缺少「SpecFormer vs OneTrans 在同等参数下的训练 FLOPs / wall-clock 对比」,读者无法判断这套方案的性价比。线上 +5ms 延迟是唯一的硬成本数据点。
-
Table IV 中完整模型并非全指标最优。Industrial 上多个消融变体的 GAUC 与 Logloss 优于完整 SpecFormer((d) 的 GAUC 0.6555 > 0.6537;多个变体 Logloss ≈ 0.110 < 0.1119),原文完全未讨论。考虑到论文自己强调「GAUC 与线上表现高度相关」,这一点尤其需要解释。
-
部分 baseline 疑似调参不足。Criteo 上 DeepFM AUC 0.5988(低于更老的 Wide&Deep 0.6589)、FEDIN Criteo Logloss 0.9568(远超正常量级)、Avazu 上多个消融变体 AUC 掉到 0.564(接近随机)——这些数值都偏离常识,削弱了对比的可信度。
-
线上收益的归因不清。CVR +15.97% / Order +16.72% 相对 CTR +1.34% 高出一个数量级,论文未做任何解释。CTR 模型改进带来的转化提升通常与 CTR 提升同量级,如此悬殊的 gap 需要说明是否涉及广告链路联动、流量结构变化或统计口径差异。
-
理论假设较强。命题 III.1 依赖「$\sigma_k \le \epsilon\sigma_1$ 对所有 $k \ge 2$」这一均匀坍缩假设,而真实谱通常是幂律衰减而非「一个大的 + 一堆同样小的」;命题 III.2 中「注意力是低通滤波器」直接援引 [38] 的结论,$\xi_k \ll \xi_1$ 也是定性断言而非定量刻画。理论提供的是机制性直觉而非严格的定量界,这一点论文未明确说明。
-
谱软化的层间一致性未讨论。每层各自独立做 SVD 并学一个 $\tau^{(l)}$,但论文没有报告不同层学到的 $\tau$ 值分布。如果浅层与深层需要的软化强度差异很大(直觉上应当如此,因为深层的谱状况已被前面各层改造过),这本身就是一个有价值的分析;论文没做。
-
只验证了 CTR 单任务、判别式排序场景。方法是否能迁移到生成式推荐(序列自回归、SID 解码)尚属未知——那里的 token 空间性质(离散码本、因果掩码)与本文的多字段特征 token 差异很大,谱软化的假设未必成立。
10.3 工业落地价值¶
从落地角度看,这是一篇诚意较足的工业论文:给出了参数规模跃迁路径(10M DLRM → 97M SpecFormer)、多轮训练 + 渐进参数继承的训练配方、完整的效率工程栈(in-batch SVD、DDE 分片嵌入、coalesced lookup 把查询频率降到 8%、FlashAttention 降 40% 注意力开销、FP16),以及明确的部署配置(3-epoch 模型,+0.92% AUC over DLRM)与延迟预算(+5ms)。对于正在做「推荐 Transformer 深度 scaling 但发现堆层不涨点」的团队,本文的诊断工具(逐层 ferank 曲线)比方法本身可能更有即时价值——先用 ferank 确认自己是不是撞上了注意力坍缩,再决定要不要上谱软化。