WHALE:用 Wukong-HSTU 架构统一非序列特征交互与序列建模的可扩展推荐模型
研究动机与背景
大规模推荐系统是现代社交媒体平台的核心组件。它们在海量规模上对候选「用户-物品」交互打分,需要融合异构信号——长期与历史行为序列、用户与物品属性、上下文特征,以及显式的「用户×物品」交叉——同时满足严格的延迟与部署约束。随着推荐工作负载持续在规模和质量上增长,增大模型容量已成为提升质量的重要路径:更大的模型能够捕捉更丰富的用户意图、物品语义与多阶特征交叉模式。
近期工作沿着两条高度可扩展但相互独立的方向推进大规模推荐模型(见 Figure 1):
-
非序列特征交互方向(Wukong 式):聚焦于对静态与上下文特征之间的高阶交互建模——用户属性、物品属性、上下文信号,以及显式的「用户×物品」交叉。以 Wukong 为代表的架构证明:通过分解式参数化(factorized parameterization)或显式交叉网络,推荐质量可以随「用户×物品」交互与「用户-物品交叉」的高阶建模能力扩大而提升。该范式在排序系统中不可或缺,因为许多重要的相关性信号来自稀疏与稠密字段的组合。
-
序列行为建模方向(HSTU 式):聚焦于用户行为历史中的动态时序模式。以 HSTU 为代表的生成式推荐器表明:序列转导(sequential transduction)能够有效建模长的、异构的交互序列,并持续受益于容量增大。该范式吸引人之处在于用户意图随时间演化——近期与历史行为揭示了不断变化的兴趣、重复偏好与长程依赖。
核心矛盾:这两个范式各自都无法单独完全覆盖对方的核心建模目标。以序列为中心的模型能捕捉用户行为的时序演化,但自身不显式地对用户、物品与请求特征之间的静态与上下文交叉进行 scaling;反之,特征交互模型能对非序列交叉建模,却缺乏对长行为历史中时序演化建模的显式机制。
这一鸿沟在社交媒体排序中尤为明显:一个候选物品的相关性往往取决于把当前候选或上下文连接到用户行为历史中的具体事件。不同候选或上下文可能需要强调同一段历史的不同部分——一个「物品×上下文」交叉可能由某个近期动作支撑,也可能由某个长期重复偏好、或某种特定行为模式支撑。
已有混合方案的缺陷(shallow-hybrid):Figure 1c 展示了一种「浅层混合」思路来结合两个范式——先用序列模型把行为历史压缩为少量摘要 embedding(summary embeddings),再把这些摘要连同非序列特征一起送入特征交互模型。这种做法在两个信号源之间制造了一个浅接口:一旦历史被压缩成固定摘要,高阶特征交互就无法再在细粒度行为事件形成之时选择性地从中抽取证据。这限制了静态特征交互与动态序列模式之间的渐进式交换。
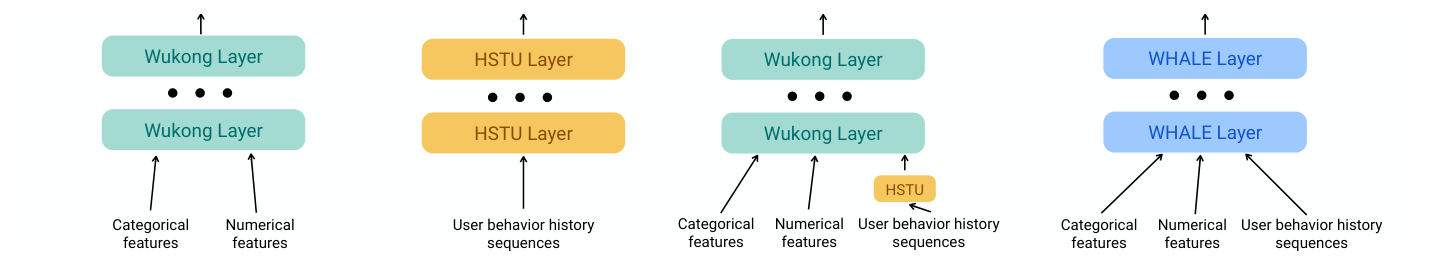
本文方案 WHALE(Wukong-HSTU-based scALable unified modEl):一个可扩展的统一推荐架构(Figure 1d),它让 Wukong 式特征交互与 HSTU 式序列建模作为同时活跃、容量可扩展的组件存在于同一架构中,并进行渐进式交换。WHALE 由一叠递归层(recursive layers)构成,每层包含一个 Wukong 模块、一个 HSTU 模块和一个基于注意力的融合模块。Wukong 模块在非序列特征上建模高阶交互,HSTU 模块建模行为历史依赖,融合模块则让 Wukong 分支产生的高阶交互表示去 query HSTU 分支产生的序列感知表示,从而为候选- 与上下文-相关的特征交叉检索出最相关的行为证据。通过在多层间重复这种交换,WHALE 实现了静态特征交互与动态序列模式之间逐层加深的交换。
三点贡献: 1. 提出 WHALE——一个递归架构,跨层保持 HSTU 与 Wukong 两个分支同时活跃,并通过基于注意力的跨分支交换(cross-branch exchange)融合它们。据作者所知,这是首个在单一模型内统一 Wukong 与 HSTU(两种分别代表非序列特征交互与序列行为建模的架构)的可扩展推荐架构。 2. 开发了一整套训练与推理优化技术,使 WHALE 能在线部署。 3. 通过实验证明:WHALE 随序列长度、模型深度、模型宽度都表现出良好的 scaling,并在离线评估与在线 A/B 测试上均优于强 HSTU-only 与 Wukong-only 基线。这些贡献将渐进式 Wukong-HSTU 跨分支交换确立为一条实用的设计原则——在严格训练与服务约束下,联合 scaling 工业推荐器的序列建模与特征交互。
相关工作定位
特征交互模型:从非序列特征(用户属性、物品属性、上下文信号、显式「用户×物品」交叉)建模交互的一条主线。许多深度排序模型遵循 embedding-based 流水线:非序列特征先映射为稠密表示,再由交互模块组合。FM 为稀疏场景下的两两特征交叉建立了高效机制;后续的 DeepFM、xDeepFM、AutoInt、DCN-V2 提升了显式/隐式交互学习的表达力。Wukong 是其中最具代表性的工作之一,它 scale 了交互模块本身:核心是由 factorization machine block(FMB)与 linear compression block(LCB)堆叠而成的架构。
序列感知推荐:把用户行为历史当作有序事件序列,保留时序、推断当前意图。DIN、DIEN 表明「物品条件化注意力 + 显式兴趣演化」能显著提升排序质量;LONGER 研究了工业推荐器中超长序列建模的 scaling。HSTU 是这条线中最具代表性的工作之一,为长的、非平稳的行为序列而设计,在捕捉长程用户动态的同时持续受益于更大模型与训练算力。
混合推荐架构:UniMixer 与 RankMixer 更接近于提升稠密排序骨干可扩展性的努力——UniMixer 在单一框架内统一 attention-based / TokenMixer-based / FM-based 的 scaling block,RankMixer 提出面向可扩展工业排序的硬件感知 token-mixing 架构。但这些模型通过紧凑摘要(而非维护细粒度历史分支反复与非序列特征交互)来纳入序列信息,这种「浅耦合」随模型深度增长会限制渐进式跨分支细化。Kunlun 更相关——它提出一种多层架构,每层含一个序列建模块与一个用于序列/非序列双向交换的交互块,是迈向统一建模的重要一步;但它与 WHALE 的设定不同:Kunlun 不采用 HSTU 式序列骨干,因此不针对「按请求复用用户历史计算」这一点(在大流量有机排序如短视频推荐中,同一请求内许多候选共享同一段用户历史,把历史表示计算一次并跨候选复用,能让长序列建模对大规模工业排序在计算上可行)。OneTrans 提供了另一种统一途径,但它并非围绕一个可分离可扩展的非序列特征交互骨干(如 Wukong)构建。WHALE 则显式建立在 Wukong 与 HSTU 两个已在大规模工业推荐中被验证的可扩展设计之上,通过在每个递归层内保持两个骨干同时活跃,让高阶非序列交互能反复 query 细粒度行为历史信号,而非仅依赖压缩摘要或单独的非序列交互。
推荐的 scaling law:近期开始追问推荐模型是否服从与语言模型类似的 scaling law。已有 DLRM 式研究刻画质量随参数、数据、算力的变化;HSTU 与 Wukong 从两个互补维度推进——HSTU 强调大规模序列转导,Wukong 证明稠密特征交互模块也能表现出良好 scaling。本文在此基础上研究一个统一架构如何在实用工业有机内容推荐场景下同时受益于序列分支与特征交互分支。
核心方法 / 模型架构
WHALE 由一个输入层后接若干堆叠的 WHALE 层构成(Figure 2)。输入层把异构原始特征映射为 embedding;每个 WHALE 层包含:(i)用于高阶非序列特征交互的 Wukong 模块,(ii)用于序列建模的 HSTU 模块,(iii)用于 Wukong 与 HSTU 之间渐进式跨分支交换的基于注意力的融合模块。
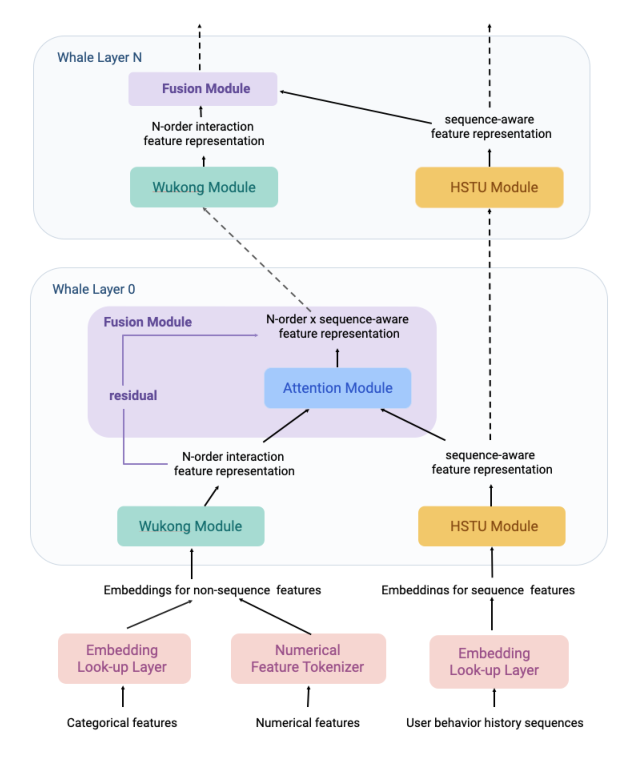
输入层
WHALE 接收多样输入信号:用户与物品 categorical 特征、用户与物品 numerical 特征、以及用户行为序列。输入层把这些异构特征映射为稠密 embedding,作为堆叠 WHALE 层的初始表示。
- 非序列特征:categorical 字段(如 user ID、item ID)通过 embedding 表映射为可学习 embedding;numerical 字段(如 intensity、count)通过 MLP 映射为 embedding——这个 MLP 组件在 Figure 2 中标为 Numerical Feature Tokenizer。随后把 categorical 与 numerical embedding 融合为非序列特征表示 $E_{ns} \in \mathbb{R}^{N \times D}$,其中 $N$ 是输入层之后的非序列特征数。
- 序列特征:用户行为历史记录了用户在当前请求之前交互过的物品。每个历史行为由一个 item ID 连同侧信息(如 action type、author ID)表示。先用 embedding 层把这些离散属性映射为 embedding,再用 MLP 把物品与侧信息 embedding 融合为序列特征表示 $E_s \in \mathbb{R}^{L \times D}$,其中 $L$ 是序列长度。虽然序列表示与非序列表示不必共享维度,但为记号简洁假设共享 embedding 维度 $D$。
WHALE 层
每个 WHALE 层的设计目标是:让候选- 与上下文-相关的非序列特征交叉从用户行为历史中检索相关证据。在第 $\ell$ 层,对输入的非序列表示与序列表示:Wukong 模块在 user / item / contextual 特征上构造高阶交互表示,HSTU 模块从行为历史编码细粒度时序证据,融合模块随后用 Wukong 输出去 query HSTU 输出,把最相关的序列信号注入非序列交互表示。通过堆叠多层,WHALE 实现逐层加深的跨分支交换,让特征交互与序列模式反复相互条件化。
层间非序列/序列表示初始化为 $X_{ns}^{(0)} = E_{ns}$、$X_s^{(0)} = E_s$。在第 $\ell$ 层,$X_{ns}^{(\ell)} \in \mathbb{R}^{N \times D}$ 与 $X_s^{(\ell)} \in \mathbb{R}^{L \times D}$ 表示当前非序列/序列表示。
Wukong 模块回顾(非序列特征交互)
Wukong 的核心是由 factorization machine block(FMB)与 linear compression block(LCB)堆叠而成的架构。设 $X_i$ 为进入第 $i$ 个 Wukong 交互层的特征-embedding 表示,$X_{i+1}$ 为传给下一层的变换表示。单个 Wukong 交互层可总结为:
$$ \begin{aligned} \mathrm{FMB}_i(X_i) &= \mathrm{reshape}\big(\mathrm{MLP}(\mathrm{LN}(\mathrm{flatten}(\mathrm{FM}(X_i))))\big),\\ \mathrm{LCB}_i(X_i) &= W_L X_i,\\ X_{i+1} &= \mathrm{LN}\big(\mathrm{concat}(\mathrm{FMB}_i(X_i), \mathrm{LCB}_i(X_i))\big) + X_i. \end{aligned} \tag{1} $$
其中 $\mathrm{FM}(\cdot)$ 是 factorization machine 算子,$\mathrm{MLP}(\cdot)$ 是多层感知机,$\mathrm{LN}(\cdot)$ 是 layer normalization(稳定跨递归交互层的特征表示),$W_L$ 是 LCB 中的可学习线性投影。FMB 显式建模两两交互并将其映射回 embedding 空间,LCB 则线性地重组合输入特征。 通过递归重复该过程,更深的堆叠能表示逐渐更高阶的特征交叉——这使得深度与宽度成为大规模排序系统的天然 scaling 旋钮。在 WHALE 中,Wukong 为非序列的 user / item / contextual / cross 特征提供了强而可扩展的骨干,但其本身不建模用户行为序列中编码的时序演化与长程依赖。
在 WHALE 层内,Wukong 模块对 $X_{ns}^{(\ell)}$ 施加堆叠的特征交互变换,产生 $n$-阶交互表示:
$$ H_w^{(\ell)} = \mathrm{Wukong\_module}(X_{ns}^{(\ell)}) \in \mathbb{R}^{N \times D}. $$
HSTU 模块回顾(序列建模)
HSTU 为长的、非平稳的行为序列而设计,捕捉长程用户动态,同时持续受益于更大模型与训练算力。借用原文记号,设 $X_i$ 为进入第 $i$ 个 HSTU 层的输入,一个紧凑的 HSTU block 可总结为:
$$ \begin{aligned} [U_i, V_i, Q_i, K_i] &= \mathrm{Split}\big(\phi(\mathrm{Norm}(X_i) W_1 + b_1)\big),\\ A_i &= \mathrm{Norm}\Big(\phi\big(Q_i K_i^{\top} + \mathrm{rab}^{(p,t)}\big) V_i\Big),\\ X_{i+1} &= X_i + W_2 (A_i \odot U_i) + b_2, \end{aligned} \tag{2} $$
其中 $W_1, b_1$ 是产生 $U_i, V_i, Q_i, K_i$ 的可学习投影矩阵与偏置;$W_2, b_2$ 是可学习输出投影矩阵与偏置;$\phi$ 是逐点非线性(如 SwiGLU);$\mathrm{rab}^{(p,t)}$ 是对位置与时序信息的相对注意力偏置(relative attention bias)。作为序列骨干,HSTU 捕捉动态用户意图,但其本身不显式捕捉非序列 user / item / cross 特征之间的丰富高阶交互——这正是把它与 Wukong 结合的动机。
在 WHALE 层内,HSTU 模块对 $X_s^{(\ell)}$ 施加堆叠的序列变换,产生序列感知的行为表示:
$$ H_s^{(\ell)} = \mathrm{HSTU\_module}(X_s^{(\ell)}) \in \mathbb{R}^{L \times D}. \tag{3} $$
输出 $H_s^{(\ell)}$ 仍是行为历史的一个 $L$-step 表示。这一粒度对 WHALE 至关重要:不同的 Wukong 交互表示可能需要不同的行为证据——某个近期动作、某个涉及 action type / author information 的特定模式、以及诸如「距上次动作到当前请求的时间间隔」之类的时序信号。
融合模块:基于注意力的跨分支融合
融合模块是 WHALE 的主跨分支交换机制:它把高阶非序列交互表示与细粒度行为历史表示连接起来。与「简单拼接 Wukong 与 HSTU 分支输出」不同,它采用跨分支注意力(cross-branch attention)——Wukong 交互表示充当 query,HSTU 行为表示提供 key 与 value。这让每个候选- 与上下文-相关的交互表示能从用户历史中选择性地检索相关行为证据。
设 $H_w^{(\ell)} \in \mathbb{R}^{N \times D}$ 与 $H_s^{(\ell)} \in \mathbb{R}^{L \times D}$ 分别为第 $\ell$ 层 Wukong 与 HSTU 模块的输出。采用 pre-layer normalization,注意力投影为:
$$ \begin{aligned} \widetilde{H}_w^{(\ell)} &= \mathrm{LN}_w^{(\ell)}(H_w^{(\ell)}), \qquad \widetilde{H}_s^{(\ell)} = \mathrm{LN}_s^{(\ell)}(H_s^{(\ell)}),\\ Q^{(\ell)} &= \widetilde{H}_w^{(\ell)} W_Q^{(\ell)}, \quad K^{(\ell)} = \widetilde{H}_s^{(\ell)} W_K^{(\ell)}, \quad V^{(\ell)} = \widetilde{H}_s^{(\ell)} W_V^{(\ell)}, \end{aligned} $$
其中 $\mathrm{LN}_w^{(\ell)}, \mathrm{LN}_s^{(\ell)}$ 是 layer normalization,$W_Q^{(\ell)}, W_K^{(\ell)}, W_V^{(\ell)} \in \mathbb{R}^{D \times D}$ 是可学习投影矩阵。注意力输出为:
$$ A^{(\ell)} = \mathrm{softmax}\left(\frac{Q^{(\ell)} K^{(\ell)\top}}{\sqrt{D}}\right) V^{(\ell)} \in \mathbb{R}^{N \times D}. \tag{4} $$
$A^{(\ell)}$ 把被注意到的行为信息组织为 $N$ 个交互特化的表示——每个非序列 Wukong 交互对应一个。由于注意力权重在 Wukong-派生的 query 与 HSTU-派生的 key 之间计算,$A^{(\ell)}$ 的每一行都为一个特定的候选- 与上下文-相关的非序列交互聚合了相关的行为历史证据。
为进一步融合两分支,引入 Fusion MLP:把注意力输出 $A^{(\ell)}$ 与对应的 Wukong 表示 $H_w^{(\ell)}$ 拼接,投影回维度 $D$,并施加残差连接:
$$ \overline{A}^{(\ell)} = H_w^{(\ell)} + [H_w^{(\ell)} | A^{(\ell)}] W_F^{(\ell)} \in \mathbb{R}^{N \times D}, \tag{5} $$
其中 $W_F^{(\ell)} \in \mathbb{R}^{2D \times D}$ 是 Fusion MLP 的可学习投影矩阵,$[\cdot|\cdot]$ 表示沿特征维拼接。直观上,$\overline{A}^{(\ell)}$ 把候选- 与上下文-条件化的行为证据与高阶交互特征结合起来。
遵循标准注意力块设计,随后对该融合表示施加一个 pre-norm feed-forward network(FFN)。FFN 实现为 SwiGLU FFN(用门控机制调制一个被另一个投影表示,通常有更好的建模质量)。对 $\overline{A}^{(\ell)}$:
$$ \begin{aligned} \widehat{A}^{(\ell)} &= \mathrm{LN}_{\mathrm{ffn}}^{(\ell)}(\overline{A}^{(\ell)}),\\ \overline{A}^{(\ell)} &= \overline{A}^{(\ell)} + \mathrm{SwiGLU\_FFN}^{(\ell)}(\widehat{A}^{(\ell)})\\ &= \overline{A}^{(\ell)} + \Big(\mathrm{SiLU}(\widehat{A}^{(\ell)} W_{\mathrm{gate}}^{(\ell)}) \odot \widehat{A}^{(\ell)} W_{\mathrm{up}}^{(\ell)}\Big) W_{\mathrm{down}}^{(\ell)} \in \mathbb{R}^{N \times D}, \end{aligned} \tag{6} $$
其中 $\mathrm{SiLU}$ 是激活,$\odot$ 是逐元素乘,$W_{\mathrm{gate}}^{(\ell)}, W_{\mathrm{up}}^{(\ell)}, W_{\mathrm{down}}^{(\ell)}$ 是可学习投影矩阵。所得 $\overline{A}^{(\ell)}$ 因此是对融合后跨分支表示的一个残差门控细化。
pre-norm SwiGLU FFN 的输出被用作融合表示,并传给下一 WHALE 层:
$$ X_{ns}^{(\ell+1)} = H_f^{(\ell)} = \overline{A}^{(\ell)}. \tag{7} $$
于是所得融合表示 $H_f^{(\ell)}$ 同时是序列感知与交互感知的。与此并行,Eq. (3) 中的 HSTU 输出沿序列分支传播,作为下一层 HSTU 模块的序列输入:
$$ X_s^{(\ell+1)} = H_s^{(\ell)}. $$
这样,WHALE 为非序列表示与序列表示保留了各自独立的传播路径,同时允许它们在每一层通过融合模块交换信息。 这是与 shallow-hybrid 的关键区别:序列分支从不被一次性压缩成固定摘要,而是逐层保持 $L$-step 的细粒度表示,供每一层的高阶交互反复 query。
关键技术细节:效率优化(面向工业部署)
推荐系统的训练与推理是最苛刻的 GPU 工作负载之一,涉及高吞吐数据处理、延迟敏感服务、以及依赖输入特征的不规则张量形状。WHALE 用 QPS(queries per second)作为吞吐指标:Training QPS 是分布式训练系统每秒处理的样本数,Inference QPS 是在目标延迟预算下每秒服务的请求数。
Training QPS 优化
Training QPS 优化建立在 Wukong 与 HSTU 模块已有的优化实现之上,并针对 WHALE 引入的额外效率瓶颈。组合了定制 kernel、轻量架构改动、混合精度执行与编译级图优化,在保持模型质量的同时提升吞吐。
定制注意力 kernel(fused Triton kernel):融合模块的跨分支注意力用一个融合 Triton kernel 实现。针对 WHALE 做了两点定制:
- (1) 共享 key-value:profiling 显示跨分支注意力 kernel 是 memory-bound。为减少这一开销,WHALE 在注意力中共享 key 与 value 张量,即令 $K = V$。融合 kernel 可复用已加载的 key 张量作为对应 value 张量,避免单独读取 value 张量,把 KV 侧的 GPU 显存流量减半。反向传播中,共享的 KV 梯度在 kernel 内累加,进一步降低显存流量、提升 kernel 吞吐。实测该改动不降低模型质量。
- (2) 非对称反向变体(asymmetric backward):WHALE 中跨分支注意力有非对称形状——少量 query token(如 64)注意一条长用户历史序列(如 15,000)。这种非对称形状使反向对「计算如何划分」很敏感,因为 query-并行与 key-value-并行的划分会带来不同的梯度归约代价。采用 FlashAttention 的反向调度作为 KV-parallel 变体(沿 key-value 维划分反向、本地累积 key-value 侧梯度、跨 worker 归约 query 侧梯度),并为短-query 场景补充一个 Q-parallel 变体(沿 query 维划分反向,允许 query 侧梯度本地累积,同时扫描长历史序列)。在运行时根据 query 与 sequence 长度在两个变体间选择——这种形状感知的选择减少了不必要的显存流量,相对仅用 KV-parallel 基线带来约 1.2× 的 kernel 级加速。
Shared-gate SwiGLU FFN:标准 SwiGLU FFN 使用独立的 gate / up / down 投影矩阵,需三次矩阵乘。为提升 QPS,采用 shared-gate 变体——把 gate 与 up 投影矩阵绑定($W_{\mathrm{gate}}^{(\ell)} = W_{\mathrm{up}}^{(\ell)} \triangleq W_s^{(\ell)}$):
$$ \mathrm{SharedGateSwiGLU\_FFN}^{(\ell)}(\overline{A}^{(\ell)}) = \Big(\mathrm{SiLU}\big(\overline{A}^{(\ell)} W_s^{(\ell)}\big) \odot \overline{A}^{(\ell)} W_s^{(\ell)}\Big) W_{\mathrm{down}}^{(\ell)}. \tag{8} $$
这只需计算一次共享投影,把 FFN 的矩阵乘从三次减到两次(即 33% 的减少)。实测该权重绑定不降低模型质量。
混合精度训练与编译优化:采用两种广泛使用的效率技术——混合精度执行与编译级图优化——并按 WHALE 各组件的计算特性选择性应用。混合精度方面,稠密骨干(Wukong 模块、HSTU 模块、融合模块与所有 FFN)跑在 BF16 以降低显存带宽、提升吞吐,而数值敏感组件(如 loss 计算、task arch)保留 FP32 以保训练稳定。编译级图优化方面,对稠密骨干子图施加 torch.compile,使 TorchInductor 融合子算子、规划显存用量、更高效地分发编译 kernel。
Inference QPS 优化
训练侧的若干优化(shared-gate SwiGLU FFN、定制注意力 kernel、编译级图优化)同样提升推理 QPS。但在线服务引入训练时不太可见的额外瓶颈——不规则张量形状、kernel launch 开销、以及运行时形状计算引起的 CPU-GPU 同步。因此进一步通过形状感知 kernel 调优、编译图执行、无同步形状处理优化推理路径。
Kernel 级优化与算子融合:在 Triton kernel 之上,针对服务流量调优 kernel 中张量形状。进一步启用 AOTInductor(扩展 PyTorch 编译栈的 ahead-of-time 编译),把各组算子分组、把每组融合为单个 fused operation,减少显存访问频率、把多个操作最小化到单次高效 pass。该优化相对不规则形状替代方案带来 18% 更高吞吐。
动态形状的整图优化(whole-graph optimization for dynamic shapes):涉及动态张量形状的模型中,频繁的 GPU-CPU 同步在运行时形状计算时造成显著瓶颈。用形状提示张量(shape hint tensors)解决——让系统无需触发昂贵同步即可推断维度,确保更流畅、GPU-centric 的执行流。消除单个同步点可把服务延迟降低 1-5 ms,这对在紧张延迟约束下服务 WHALE 这样的大排序模型至关重要。该优化把推理 QPS 提升 15%。
实验设置
离线设置:使用来自最大规模短视频社交媒体平台之一的训练日志——80B(800 亿)样本训练、4B(40 亿)样本评估。除非另有说明,所有实验在 NVIDIA B200 GPU 上进行,全局 batch size 与优化器设置在各 run 间保持不变。每个模型训练单个 epoch。
评估指标:报告平台主要参与度预测任务的 normalized entropy(NE)。给定二元标签 $y_i \in \{0,1\}$、预测概率 $p_i$、经验点击率 $\bar{p}$,NE 定义为:
$$ \mathrm{NE} = \frac{-\frac{1}{N}\sum_{i=1}^{N}\big[y_i \log p_i + (1-y_i)\log(1-p_i)\big]}{-\big(\bar{p}\log\bar{p} + (1-\bar{p})\log(1-\bar{p})\big)}. \tag{9} $$
NE 越低表示模型质量越好。在该平台,0.05% 的 NE gain 被视为可观察的提升。除非另有说明,FLOPs 用作跨架构与跨 scaling 配置的相对模型复杂度度量(denote per-example forward-pass computation)。
在线设置:在一个大规模社交媒体推荐面(surface)上做在线 A/B 测试,与线上基线对比,使用相同的候选生成与服务约束(如延迟)。A/B 测试运行 14 天。在该平台,主评估指标 0.03% 的 win 被视为显著。
回答的三个问题:
- Q1:WHALE scale 得如何?(架构对比 + 序列长度/深度/宽度三方向 scaling)
- Q2:融合模块有多重要?(消融关键组件)
- Q3:WHALE 在线表现如何?(在线 A/B)
主要实验结果
架构对比(Q1)
将 WHALE 与两个经大规模工业验证的强单范式基线对比:
- Wukong-only ranker:强调非序列特征间的高阶交互。
- HSTU-only ranker:聚焦用户行为历史的序列建模。
为隔离统一设计的收益,通过调整 hidden dimension、层数与序列长度,把三个模型的模型复杂度尽量对齐,并用 FLOPs 度量模型复杂度。如 Figure 3,在 8 / 14 / 32 GFLOPs 三个复杂度点上,WHALE 一致优于两个单范式基线,且随复杂度增大差距扩大。以 8-GFLOP Wukong-only 模型为参考基线(NE gain 定义为 0),各配置的相对 NE gain 为:
| 复杂度 (GFLOPs) | Wukong-only | HSTU-only | WHALE |
|---|---|---|---|
| 8 | 0.00% (ref) | 0.40% | 0.60% |
| 14 | 0.04% | 0.54% | 0.83% |
| 32 | 0.06% | 0.73% | 1.39% |
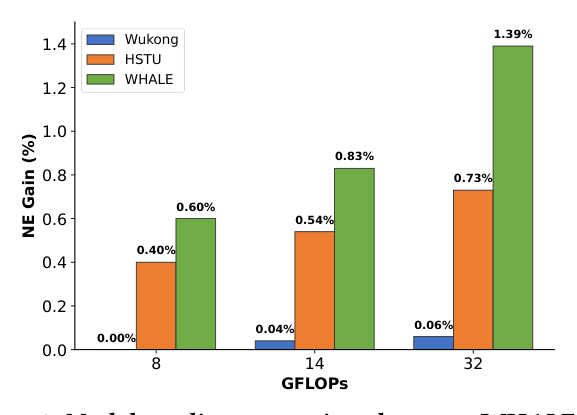
结论分析:在可比复杂度下,统一两个范式改善了 scaling——与其单独增大任一范式的容量,WHALE 从互补的特征交互信号与行为序列信号中同时获益,从而在相同算力下取得更好模型质量。注意到 Wukong-only 从 8→32 GFLOPs 几乎不涨(0.00%→0.06%),说明单靠非序列特征交互的容量已接近饱和;HSTU-only 涨到 0.73%;而 WHALE 涨到 1.39%——接近 HSTU-only 的两倍,且随算力持续拉开,印证了「渐进式跨分支交换」比堆单一分支容量更有效。
Scaling 分析(Q1)
从序列长度、模型深度、模型宽度三个方向分析 WHALE 的 scaling 行为(Figure 4)。
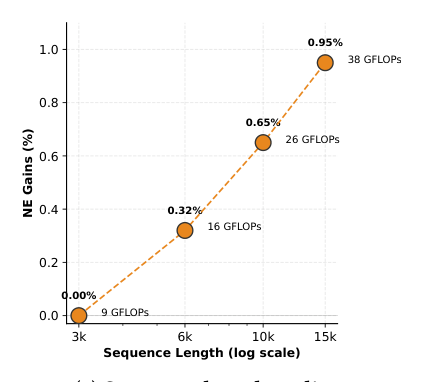
序列长度 scaling:固定其余配置(8 层 WHALE、非序列与序列 embedding 均设 256),把用户交互历史序列长度在 3k / 6k / 10k / 15k 间变化。以 3k 为基线:
| 序列长度 | NE gain | FLOPs |
|---|---|---|
| 3k | 0.00% (ref) | 9 GFLOPs |
| 6k | 0.32% | 16 GFLOPs |
| 10k | 0.65% | 26 GFLOPs |
| 15k | 0.95% | 38 GFLOPs |
结论:增大序列长度到 15k(数据集中可得的最长历史)持续带来 NE gain,说明 WHALE 能有效利用更长行为历史,对序列长度呈现良好 scaling。
模型深度 scaling:固定序列长度 15k、非序列与序列特征均 256 维,把 WHALE 层数在 2 / 4 / 6 / 8 间变化。以 2 层为基线:
| 层数 | NE gain | FLOPs |
|---|---|---|
| 2 | 0.00% (ref) | 10 GFLOPs |
| 4 | 0.12% | 19 GFLOPs |
| 6 | 0.21% | 29 GFLOPs |
| 8 | 0.28% | 38 GFLOPs |
结论:更深的模型持续带来 NE gain(到 8 层)。这表明堆叠更多 WHALE 层强化了特征交互与序列分支间的渐进式交换,从而随模型深度取得更好 scaling——这正是「逐层加深的跨分支交换」这一设计原则的直接证据。
模型宽度 scaling:固定序列长度 15k、深度 8 层,把非序列与序列分支共享的 embedding 维度在 64 / 128 / 256 / 512 间变化。以 64 维为基线:
| embedding 维度 | NE gain | FLOPs |
|---|---|---|
| 64 | 0.00% (ref) | 3 GFLOPs |
| 128 | 0.18% | 11 GFLOPs |
| 256 | 0.31% | 38 GFLOPs |
| 512 | 0.40% | 141 GFLOPs |
结论:增大宽度持续带来 NE gain,说明 WHALE 能有效利用更宽的分支表示,对模型容量呈现良好 scaling。综合三方向:WHALE 在多个模型容量来源(更多行为上下文、更深跨分支计算、更宽表示)上都表现出一致的 scaling 行为——这对一个旨在「随参数量同步扩充表征与序列建模能力」的统一架构是关键验证。
不同融合策略的消融(Q2)
融合策略决定 WHALE 如何在非序列特征交互与用户行为序列之间交换信息。从两个层级研究(Table 1):架构层级(把 WHALE 的渐进式融合与 Figure 1 的 shallow-hybrid 浅融合对比)与模块层级(聚焦 WHALE 融合模块内部设计——把 Eq. (4) 的注意力替换为对 $V^{(\ell)}$ 序列长度维的 average pooling;移除 Eq. (5) 的 fusion MLP;移除 Eq. (6) 的 SwiGLU FFN)。更大的 NE regression 表示相对 WHALE 更大的质量下降,因而是更重要的设计选择。
| 层级 | 融合策略 | NE reg. (%) |
|---|---|---|
| Reference | WHALE | 0.00 |
| Architecture level | Shallow-hybrid fusion | 0.25 |
| Module level | Avg.-pooling fusion | 0.23 |
| Module level | Fusion w/o MLP projection | 0.11 |
| Module level | Fusion w/o SwiGLU FFN | 0.08 |
结论分析:两个层级的融合策略都很重要。架构层级上,shallow-hybrid 融合表现明显更差(+0.25% NE reg)——证明「渐进式跨分支融合」对联合利用非序列与序列特征很重要,也直接支撑了本文动机(浅接口限制了细粒度证据检索)。模块层级上,用 average pooling 替换注意力导致明显退化(+0.23%)——说明注意力对「让高阶非序列交互去 query 长历史表示、检索相关行为证据」很关键;移除 MLP projection(+0.11%)或 SwiGLU FFN(+0.08%)也损害性能——说明学到的跨分支整合与融合后的非线性变换都对推荐质量有贡献。
在线实验(Q3)
在一个大规模社交媒体推荐面上做在线 A/B(14 天),与线上基线用相同候选生成与服务约束对比。为让 WHALE 可在线部署,Section 4 的 training QPS 优化把训练吞吐提升 30%,inference QPS 优化把服务吞吐进一步提升 22%(均相对未优化替代方案)。在线结果(Table 2,正值表示提升;负的 inference QPS 表示服务吞吐 regression):
| 指标 | 相对变化 |
|---|---|
| Primary evaluation metric | +0.113% |
| Metric 1 | +0.824% |
| Metric 2 | +1.820% |
| Inference QPS | -5% |
结论分析:相对线上基线,WHALE 把主评估指标提升 0.113%(该平台 0.03% 即视为显著,故此为显著正收益),同时把 Metric 1 与 Metric 2 分别提升 0.824% 与 1.820%。系统侧,这些收益伴随 5% 的 inference QPS regression(在在线服务预算内可接受)。该结果表明:把 Wukong 式特征交互建模与 HSTU 式长程序列建模统一,能改善在线推荐效果,且工程上可在紧张服务约束下落地。
与已归档相关工作的对比
WHALE 处在「工业推荐中统一非序列特征交互与序列建模」这一密集赛道上。文档库中有两篇与其问题(序列建模与特征交互被实现为独立参数模块,浅耦合限制联合 scaling)+ 解法(把两者放进一个可逐层交换/联合优化的架构)双同构的论文,值得逐一对照。
MixFormer MixFormer: 统一序列动态与稠密特征交互的 Transformer(ByteDance, 2026-02-15)
关系:独立并发(WHALE 未引用 MixFormer,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇指向同一 root cause——工业 Transformer 推荐器把序列建模与特征交互实现为参数各自独立的两个模块,在固定算力预算下二者争夺资源(MixFormer 称之为「co-scaling 困境」),限制了跨模块交互深度与联合 scaling。WHALE 用「shallow-hybrid 浅接口」、MixFormer 用「Stacked/Parallel 严格参数分离」描述同一缺陷。
- 相近的技术骨架:两者都主张「有效 co-scaling 需要把序列与非序列建模放进一个逐层、深度交换的单一架构」,且都用 cross-attention 让非序列表示去 query 序列表示(MixFormer 的 Cross Attention 模块用 $N$ 个 Query-Mixer head 作 sub-query 关注行为序列;WHALE 的融合模块用 Wukong 交互表示作 query、HSTU 表示作 K/V),并都以 SwiGLU FFN 作融合后非线性、都做了 KV/计算共享类的部署优化。
- 本文(WHALE)的差异与推进:WHALE 保留两个已被验证的可扩展骨干(Wukong + HSTU)作为分立分支,各自独立传播、仅在融合模块交换——是「双骨干 + 逐层跨分支注意力」;MixFormer 则更激进,把序列与非序列统一进单一参数空间(用零参数 HeadMixing + per-head SwiGLUFFN 替换 self-attention,Query-Mixer/Output-Fusion 的 per-head FFN 同时服务两类特征),不再有两个命名模块。WHALE 的路线让它能直接复用 Wukong/HSTU 各自成熟的 kernel 与优化;MixFormer 的路线让 user-side 计算可解耦复用(UI-MixFormer 的 RLB,约 36% FLOPs 减少)。
- 可比的方法/实验差异:两者都在抖音/短视频量级工业数据 + CTR/参与度任务上验证,指标口径不同(MixFormer 报 AUC/UAUC,WHALE 报 NE gain/在线 A/B),无公开数据集交集,故无法直接比对绝对数值;共同结论一致——统一后能随序列长度与模型宽度协同 scaling,优于单范式与浅耦合基线。
OneTrans OneTrans: 用单个 Transformer 统一特征交互与序列建模(ByteDance, 2025-10-30)
关系:独立并发(WHALE 引用了一个 2026 版 OneTrans[ref 34, arXiv:2603.24104],但与本库归档的 2025-10 版 arXiv:2510.26104 非同一版本,且原文未做方法/指标层展开对比)· 已加载对方精读
- 共同关注的问题:同样针对「encode-then-interaction 流水线在序列建模与特征交互之间制造架构壁垒」——OneTrans 强调两模块间缺乏双向信息交换、且无法复用 LLM 领域成熟工程优化(KV cache / FlashAttention / 混合精度)。这与 WHALE 的动机 root cause 一致。
- 相近的技术骨架:两者都用「把非序列特征当作 token、让其从行为序列检索证据」的注意力机制;OneTrans 的 NS-token 通过因果掩码可注意完整 S 历史(等效 target-attention 聚合),与 WHALE「Wukong query → HSTU K/V」的融合注意力异曲同工;两者也都做了系统级共享/裁剪优化(OneTrans 的金字塔裁剪 vs WHALE 的 shared-KV + 非对称反向)。
- 本文(WHALE)的差异与推进:OneTrans 把所有输入拼成单一 token 序列送进一个因果 Transformer,靠混合参数化(S-token 共享权重、NS-token 各自独立)在一个 stack 内统一两类建模;WHALE 则保留 Wukong 与 HSTU 两个分立可扩展骨干、每层用跨分支注意力桥接。WHALE 论文明确把「不围绕一个可分离可扩展的非序列交互骨干(如 Wukong)构建」列为与 OneTrans 式统一途径的关键区别——即 WHALE 显式复用 Wukong 已验证的高阶交互 scaling 能力,而非从零训练一个统一 backbone。
- 可比的方法/实验差异:OneTrans 报公开电商日志 + 内部数据(金字塔在固定 FLOPs 下支持 1.75× 更长序列,在线 GMV/u +5.68%),WHALE 报短视频参与度 NE gain + 在线 A/B +0.113%,无公开数据集交集,无法直接比对绝对数值。
(另注:WHALE 在 related work 还把 Kunlun[ref 15] 列为「最相关」的多层双向交换工作、把 UniMixerUniMixer 与 RankMixer 归为「浅耦合摘要式」混合骨干;Kunlun 尚未归档、UniMixer 的解法路径是「统一 attention/TokenMixer/FM 三类 scaling module」而非「序列×非序列跨分支交换」,故不作为核心孪生展开。)
讨论与局限性
核心贡献:WHALE 首次在单一可扩展架构内统一 Wukong(非序列高阶特征交互)与 HSTU(长行为序列建模)两条已被工业验证的 scaling 路线。其核心 insight——让两个骨干在每一层都保持活跃,并通过「Wukong 交互表示 query HSTU 序列表示」的跨分支注意力进行逐层加深的渐进式交换——把「浅耦合摘要」升级为「细粒度、可反复检索」的深耦合。这一设计在离线(序列长度/深度/宽度三方向 scaling,架构对比一致领先,32 GFLOPs 时 NE gain 达单范式 HSTU 的近两倍)与在线(主指标 +0.113% 显著,已部署)都得到验证。
值得借鉴的设计: 1. 双骨干 + 分立传播路径 + 逐层融合:相比「压成单一 token 序列」(OneTrans)或「统一进单一参数空间」(MixFormer),WHALE 的双分支设计让它能直接继承 Wukong/HSTU 各自成熟的 kernel、优化与已验证的 scaling 曲线,工程迁移成本低。 2. 形状感知的系统协同设计:shared-KV($K=V$,显存减半且不掉点)、query/sequence 长度非对称场景下的 KV-parallel vs Q-parallel 运行时反向选择(1.2× kernel 加速)、shared-gate SwiGLU(矩阵乘 3→2,减 33%)、AOTInductor 算子融合(+18% 吞吐)、shape-hint 张量消同步(延迟 -1~5ms,推理 QPS +15%)——一整套「不掉点换吞吐」的实用工程范式,对任何长序列 × 稠密交互的大排序模型都有借鉴价值。 3. 方法论可扩展性强:WHALE 无显式多阶段解耦、无固化码本或离散 token 空间;参数量 scaling 时「如何表征历史(HSTU 分支宽度/深度)」与「如何建模高阶交互(Wukong 分支)」两条路径能同步增长——正对上精读评分标准里「参数 scaling 时表征与序列建模能力能否一起增长」的关键判据,属无明显架构瓶颈的路线。
局限/争议: 1. 实验全为相对/内部指标,缺乏公开可复现性:所有离线结果都是相对某基线的 NE gain(无绝对 NE 值、无公开学术数据集、无开源),架构对比也只有 Wukong-only / HSTU-only 两个自建基线,未与 OneTrans / MixFormer / Kunlun / UniMixer 等同期统一架构直接对比——难以定位 WHALE 在这一密集赛道中的相对位置。 2. 消融偏薄:Table 1 只有 4 个消融点,且都是「移除/替换某组件」的负向 regression,缺少对「共享 KV=V 是否损害注意力表达」「双分支 vs 单参数空间」等更深层设计选择的对照。 3. 在线收益量级中等且伴随服务代价:主指标 +0.113%(虽超过 0.03% 显著阈值)叠加 5% inference QPS regression,说明在生产延迟预算内 WHALE 的算力开销不可忽视;论文也承认这一 regression「在预算内可接受」,但未给出不同复杂度点的收益-成本权衡曲线。 4. 匿名化平台细节:数据集、在线 metric、平台均匿名(Metric 1/2 未具名),限制了外部读者对收益来源的独立判断。
工业落地价值:WHALE 在 Meta 的短视频短形式内容推荐面上以 80B 样本训练、B200 GPU、15k 序列长度规模落地,并通过 14 天在线 A/B 验证后已部署到生产系统。它给出了一个「如何在严格训练与服务约束下,把两条主流 scaling 路线(特征交互 + 序列建模)可扩展地统一」的实用范例,并暗示工业推荐器 scaling 的下一阶段不仅是「把某个骨干做大」,而是「在每一层渐进式统一互补的非序列特征交互与序列行为建模架构」。