TMallGS:为生成式电商搜索扩展统一特征与序列建模
阿里巴巴天猫(Taobao & Tmall Group of Alibaba)· KDD '26 · arXiv:2607.13398 · 2026-07-15
研究动机与背景
工业级搜索与排序系统中的 CTR(Click-Through Rate)预估正在经历一次范式迁移:从传统的 DLRM(Deep Learning Recommendation Model) 走向统一的、计算密集型的 Transformer 架构。这次迁移的根本动机是希望借助 Model FLOPs Utilization (MFU) 来实现可预测的性能增长——即遵循类似 LLM 的 Scaling Law,通过堆算力换取稳定收益。
作者指出,传统 DLRM 范式(如 DeepFM、DCN-V2)依赖"双轨设计":巨大的 embedding 表负责记忆(memorization) + 浅层 MLP 负责特征交互(feature interaction)。这种架构本质上是 内存受限(Memory-Bound) 的:它依赖稀疏、不规则的内存访问模式,严重低效地利用现代 GPU 的 Tensor Core,导致 MFU 极低——作者称之为"工业算力墙(Industrial Compute Wall)"。单纯加宽 MLP 或加深交互层只会带来边际递减(diminishing marginal returns),且受内存带宽约束无法高效建模超长序列(如终身行为历史)。
于是工业界转向 统一 Transformer 骨干(Unified Transformer Backbone) 以最大化算力利用(代表工作 OneRec、OneTrans)。但作者强调:搜索(Search)不同于推荐(Recommendation)。推荐可以容忍模糊发现,而搜索受 Query 约束严格支配。直接把 LLM 式的 "All-in-One tokenization"(一体化 tokenization) 架构迁移到高精度搜索排序,会引入三个严重缺陷:
- 异构性鸿沟(The Heterogeneity Gap):搜索输入跨度极大——从短查询到长尾用户行为。强行用统一注意力机制处理这些差异巨大的模态,会触发 梯度冲突(Gradient Conflicts)。
- 信号稀释(Signal Dilution):显式交叉特征(如 query-item 匹配分)对搜索是决定性的。但深层 Self-Attention 本质上是 低通滤波器(low-pass filter),会过度平滑(over-smoothing)这些高频硬信号。
- 优化不稳定(Optimization Instability):不同于 LLM 的稠密监督,CTR 依赖稀疏二值反馈,导致深层网络严重的梯度消失。
针对这三个瓶颈,作者提出 TMallGS(Tmall Generative Search),一个为天猫精排(precision ranking)领域量身定制的、高性能、可扩展的通用排序架构。核心哲学是 "Semantic Divide-and-Conquer, Interaction Decoupling"(语义分而治之,交互解耦)。五大核心创新:
- 层次化分布校准 Tokenization(Hierarchical Distribution-Calibrated Tokenization):用 FSR + DCP 把异构特征投影到校准后的最优子空间,从输入层解决异构性鸿沟。
- 场景自适应门控 Transformer 骨干(Field-Adaptive Gated Transformer Backbone):用 Per-Field QKV 投影 + 噪声自适应门控,动态过滤行为序列噪声。
- 解耦 FiLM 后融合(Decoupled FiLM Late Fusion):用 FiLM 调制显式交叉特征,恢复被深层稀释的高频匹配信号。
- 上下文感知偏置解耦(Context-Aware Bias Decoupling):用 Context-Aware Bias Net 从真实用户意图中正交解耦系统性偏置。
- 误差感知渐进训练(Error-Aware Progressive Training):基于层次化预测误差动态加权损失,实现自适应难样本挖掘。
核心方法 / 模型架构
问题定义
将工业搜索排序的 CTR 预估形式化为学习一个概率估计器 $f_\theta : \mathcal{X} \to [0,1]$。训练语料 $\mathcal{S} = \{(u_i, q_i, C_i, \mathbf{y}_i)\}_{i=1}^N$,其中 $u_i$ 是用户上下文,$q_i$ 是搜索查询,$C_i = \{c_1, \ldots, c_M\}$ 是该 session 的候选物品集,标签 $\mathbf{y}_i \in \{0,1\}^M$ 表示各候选的点击状态。
异构特征空间 $\mathcal{X}$ 被划分为三个逻辑子空间以支撑解耦架构:
- 上下文特征 $\mathbf{x}_{ctx}$:请求级全局先验,所有候选共享(如 query 文本、用户画像、翻页偏置)。
- 序列特征 $\mathbf{x}_{seq}$:变长历史行为,含 User Interaction History (UIH, $\mathcal{H}_u$) 和 Query History (UQH/QH, $\mathcal{H}_q$,捕捉长期意图漂移)。
- 候选特征 $\mathbf{x}_{cand}$:物品级属性。关键地,候选特征被二分为 Light Attributes $\mathbf{x}_c^{light}$(如 ItemID,用于语义表征学习)和 Heavy Cross-Attributes $\mathbf{x}_c^{heavy}$(如 Q2I 匹配分,用于精确校准)。
架构总览
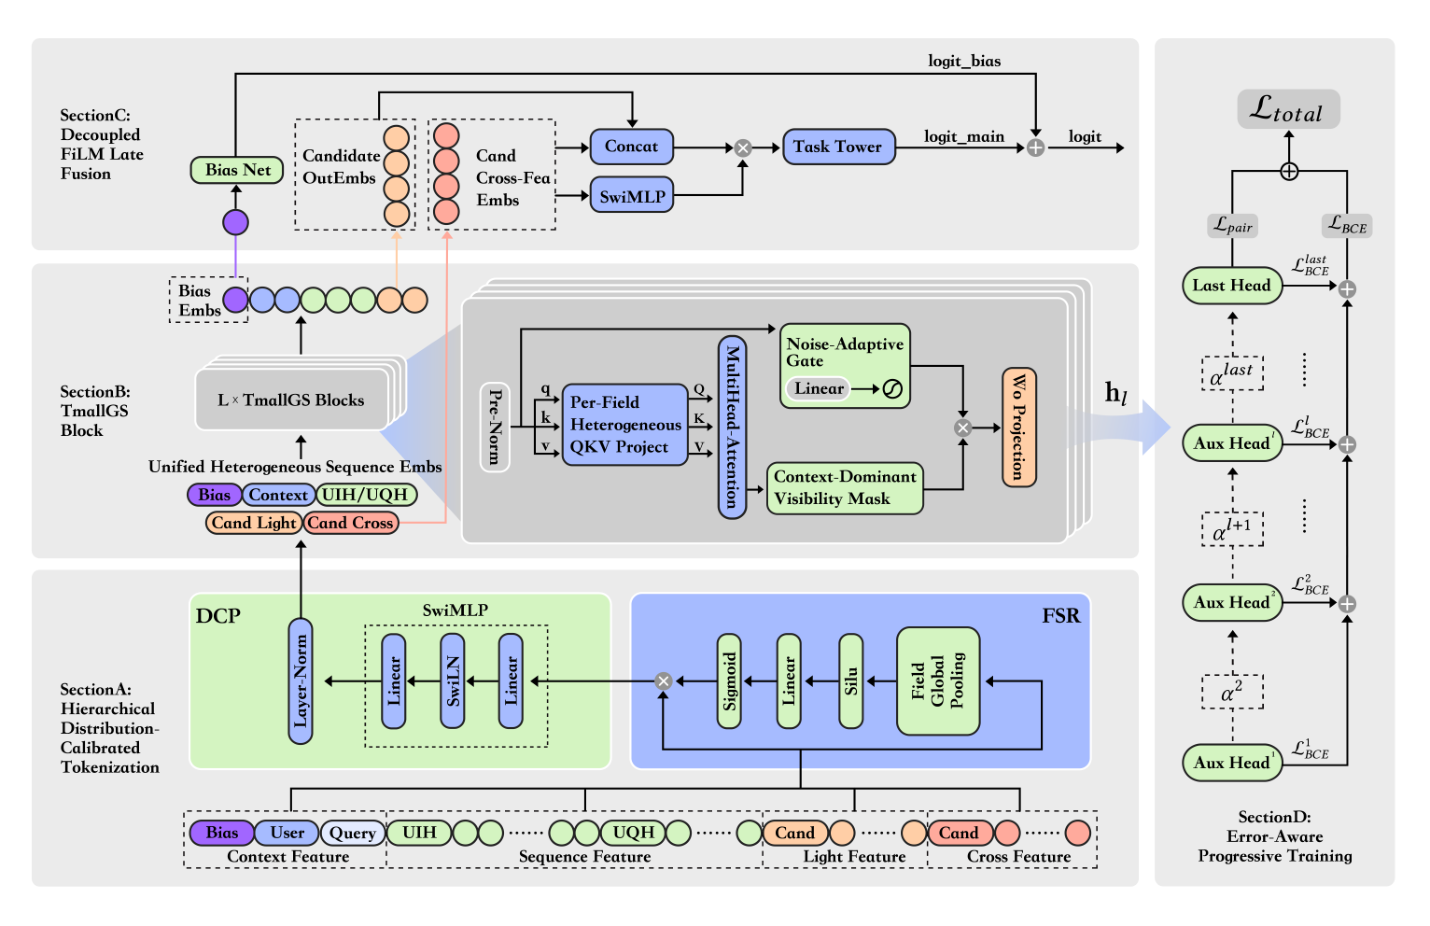
TMallGS 摒弃 LLM 式单体 tokenization,采用语义交互解耦范式,由五个协同模块组成。整体架构分为四个 Section(见 Figure 1):Section A 层次化 tokenization,Section B TmallGS Block,Section C 解耦 FiLM 后融合,Section D 误差感知渐进训练。
4.2 层次化分布校准 Tokenization
Tokenization 是从稀疏原始特征通往稠密语义交互的基础桥梁。鉴于工业特征词表的巨大规模与噪声,简单线性投影不足,而标准 heavy gating(如 SwiGLU-FFN)成本过高。作者提出 Coarse-to-Fine Tokenization Pipeline(粗到细的 tokenization 流水线),扮演渐进去噪滤波器的角色,由两个耦合阶段构成。
Stage 1:场景显著性重加权(Field-wise Saliency Reweighting, FSR)
在把原始特征映射到潜空间之前,先基于全局上下文校准不同特征域的重要性。
令 $\mathcal{X} = \{\mathbf{X}_1, \ldots, \mathbf{X}_F\}$ 为输入特征域,$\mathbf{X}_i \in \mathbb{R}^{L \times d_i}$ 表示第 $i$ 个域(序列长度 $L$、原始维度 $d_i$)。
全局上下文聚合:不同于只在通道维度聚合的标准 SE-block,FSR 同时在时间维 $L$ 和特征维 $d_i$ 上聚合,得到鲁棒的全局描述子 $z_i$:
$$z_i = \frac{1}{L \cdot d_i} \sum_{t=1}^{L}\sum_{k=1}^{d_i} \mathbf{X}_{i,t,k}, \quad \mathbf{z} = [z_1, \ldots, z_F] \in \mathbb{R}^F \tag{1}$$
门控网络生成显著性权重 $\mathbf{w} \in \mathbb{R}^F$,建模域间依赖:
$$\mathbf{w} = \sigma(\mathbf{W}_{ex} \cdot \delta(\mathbf{W}_{sq}\mathbf{z})) \tag{2}$$
其中 $\delta$ 是 SiLU 激活,$\mathbf{W}_{sq}, \mathbf{W}_{ex}$ 构成瓶颈结构以捕捉域相关性。原始特征随后被动态调制 $\tilde{\mathbf{X}}_i = w_i \cdot \mathbf{X}_i$。这一步是软性的域选择器:放大全局有信息量的域,抑制无关域。
Stage 2:分布校准投影(Distribution-Calibrated Projection, DCP)
对重加权后的特征,用轻量自门控机制投影到语义空间。引入 Calibrated-Swish 激活 $\phi_{cal}$(由层统计驱动的自门控):
$$\phi_{cal}(\mathbf{H}) = \mathbf{H} \odot \sigma(\text{LayerNorm}(\mathbf{H})) \tag{3}$$
对重加权域 $\tilde{\mathbf{X}}_i$,token embedding $\mathbf{E}_i$ 计算为:
$$\mathbf{E}_i = \text{MLP}_{cal}(\tilde{\mathbf{X}}_i) = \left(\phi_{cal}(\tilde{\mathbf{X}}_i \mathbf{W}_1 + \mathbf{b}_1)\right)\mathbf{W}_2 \tag{4}$$
LayerNorm 标准化潜分布,确保自门控信号严格居中于梯度敏感区。效率分析:FSR 在池化后的标量上做门控,开销可忽略;DCP 相比 SwiGLU-FFN[7] 减少约 33% 的投影 FLOPs,实现高吞吐下的鲁棒非线性建模。
4.3 统一异构序列构造(Unified Heterogeneous Sequence Construction)
为充分利用 Transformer 的全局感受野,采用 Request-Level Sequence Construction(请求级序列构造) 策略。不同于冗余地按候选编码上下文的 item-centric 范式,TMallGS 把序列严格对齐到 User-Query Request(用户-查询请求),构造一个所有候选共享的统一输入 $\mathbf{E}_{in}$。
五个核心语义组件:(1) Context Bias Anchor $\mathbf{e}_{bias}$(tokenize 翻页索引以聚合全局上下文);(2) Context & Query $\mathbf{e}_{ctx}, \mathbf{e}_{qry}$(用户画像 + 当前意图);(3) User History $\mathbf{H}_{uih}, \mathbf{H}_{uqh}$(捕捉交互与显式意图漂移);(4) Candidate $\mathbf{e}_{cand}$(仅限 Light Attributes,与历史对齐,绕过 heavy cross-attributes)。最终序列把 Anchor 放在开头以确保全局注意力覆盖:
$$\mathbf{E}_{in} = [\mathbf{e}_{bias}; \mathbf{e}_{ctx}; \mathbf{e}_{qry}; \mathbf{H}_{uih}; \mathbf{H}_{uqh}; \mathbf{e}_{cand}^{light}] \tag{5}$$
4.4 TmallGS Block
核心推理引擎由 $L$ 个堆叠的 TmallGS Block 组成。为处理行为数据独特的 intra-session 排序结构和噪声,作者用三项设计重新设计标准 Transformer block:场景专属投影、置换不变可见性 mask、噪声自适应门控。
4.4.1 Per-Field 异构 QKV 投影
标准 Transformer 把所有 token 投影到共享潜空间,忽略了搜索各域间的 流形差异(manifold discrepancies)。TMallGS 把统一输入 $\mathbf{E}_{in}$ 划分为场景专属段,每个域 $\phi$(如 Query、UIH、Candidate)用独立投影矩阵。第 $i$ 个 token $\mathbf{h}_i$(属于域 $\phi(i)$)的 QKV:
$$\mathbf{q}_i = \mathbf{h}_i \mathbf{W}_Q^{\phi(i)}, \quad \mathbf{k}_i = \mathbf{h}_i \mathbf{W}_K^{\phi(i)}, \quad \mathbf{v}_i = \mathbf{h}_i \mathbf{W}_V^{\phi(i)} \tag{6}$$
这是一种流形对齐机制:允许异构模态各自独立的语义旋转,缓解梯度冲突。
4.4.2 上下文主导可见性 Mask(Context-Dominant Visibility Mask)
搜索排序中,多个候选在同一 batch 内被同时打分。为保证效率与理论正确性,施加严格注意力 mask $\mathbf{M} \in \mathbb{R}^{T \times T}$。序列分为 Context Prefix 集 $\Omega_{ctx} = \{\text{Anchor}, \text{User}, \text{Query}, \text{UQH}, \text{UIH}\}$ 和 Candidate 集 $\Omega_{cand}$。规则:
- Context Full-Attention:$\Omega_{ctx}$ 内 token 互相全可见,建模深层全局上下文交互。
- Candidate Independence:每个候选 token $c_i \in \Omega_{cand}$ 可关注 $\Omega_{ctx}$ 全部及自身,但对其他候选 $c_j (j \neq i)$ 严格不可见。
$$\mathbf{M}_{ij} = \begin{cases} 0 & \text{if } j \in \Omega_{ctx} \text{ or } i=j \\ -\infty & \text{if } i, j \in \Omega_{cand} \text{ and } i \neq j \end{cases} \tag{7}$$
该策略防止候选间信息泄露(shortcut learning),确保候选打分仅取决于其与上下文的交互,而非同页其他候选。
4.4.3 噪声自适应门控注意力(Noise-Adaptive Gated Attention)
用户行为序列常含与当前查询无关的噪声(如误点击)。标准 Softmax 归一化强制注意力权重和为 1,导致噪声传播——无关历史 token 被分配了非平凡权重。TMallGS 在注意力操作之后、输出投影 $\mathbf{W}_O$ 之前插入门控。关键地,门控由 Pre-Norm 输出 $\mathbf{X}_{norm}$(而非不稳定的注意力输出)生成,因为 $\mathbf{X}_{norm}$ 保留稳定的残差恒等映射,为判定特征显著性提供鲁棒参考:
$$\mathbf{A} = \text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) \tag{8}$$ $$\mathbf{G} = \sigma(\mathbf{X}_{norm}\mathbf{W}_{gate} + \mathbf{b}_{gate}) \tag{9}$$ $$\mathbf{H} = (\mathbf{A} \odot \mathbf{G})\mathbf{W}_O \tag{10}$$
其中 $\odot$ 是逐元素乘。通过 $\mathbf{G} \in (0,1)$ 赋予注意力机制未归一化能力:当上下文无关时,$\mathbf{G}$ 可饱和到 0,动态抑制噪声传播。这有效打破了标准 Value-Output 投影路径 $\mathbf{W}_V \cdot \mathbf{W}_O$ 的线性瓶颈,增强模型捕捉复杂 query 匹配模式的非线性能力。
4.5 解耦 FiLM 后融合(Decoupled FiLM Late Fusion)
深层 Transformer 层作为低通滤波器,会过度平滑 $\mathbf{x}_c^{heavy}$ 中的高频显式信号(如精确字符串匹配、统计交互率)。为保护这些信号,在最终阶段用 FiLM(Feature-wise Linear Modulation) 机制。
令 $\mathbf{h}_c^L$ 为候选 $c$ 经最终 Transformer block 的语义输出,$\mathbf{e}_c^{all}$ 为候选的综合 embedding(融合 light 和 heavy 特征)。先拼接得统一表征基:
$$\mathbf{u}_c = [\mathbf{h}_c^L \oplus \mathbf{e}_c^{all}] \tag{11}$$
用一个专门的 Task Tower(MLP)以综合特征 $\mathbf{e}_c^{all}$ 为输入生成仿射变换系数 $\boldsymbol{\gamma}_c, \boldsymbol{\beta}_c \in \mathbb{R}^{d_u}$:
$$\boldsymbol{\gamma}_c, \boldsymbol{\beta}_c = \text{MLP}_{FiLM}(\mathbf{e}_c^{all}) \tag{12}$$
最终表征通过动态缩放与平移统一向量获得:
$$\mathbf{v}_{final} = (1 + \boldsymbol{\gamma}_c) \odot \mathbf{u}_c + \boldsymbol{\beta}_c \tag{13}$$
该机制让显式交叉特征能锐利地调制语义表征,恢复深层传播中损失的信号分辨率。主语义 logit:
$$\text{logit}_{main} = \text{MLP}_{head}(\mathbf{v}_{final}) \tag{14}$$
4.6 上下文感知偏置网络(Context-Aware Bias Net)
天猫搜索中,一个请求对应展示的一页候选。用户翻页时系统创建新请求和新训练实例,因此同一请求内所有候选共享请求级因子(翻页、query 上下文、用户状态、流量条件)。作者引入 Context Anchor token 汇总这些共享因子。为把系统性偏置从语义相关性中解耦,提出 Context-Aware Bias Net,利用 Context Anchor 的深层上下文编码。从 Context Anchor 提取最终隐状态 $\mathbf{h}_{bias}^L$(已注意整个请求上下文),投影为标量偏置项并与主 logit sigmoid 前加性融合:
$$\text{logit}_{bias} = \text{SwiMLP}(\mathbf{h}_{bias}^L), \quad \hat{y} = \sigma(\text{logit}_{main} + \text{logit}_{bias}) \tag{15}$$
关键:加性形式实现正交优化。 当在同一请求内的点击项 $c^+$ 与未点击项 $c^-$ 之间计算 Pairwise Loss 时,请求级偏置项自然抵消:
$$\Delta\text{logit} = (\text{logit}_{main}^+ + \text{logit}_{bias}) - (\text{logit}_{main}^- + \text{logit}_{bias}) \equiv \text{logit}_{main}^+ - \text{logit}_{main}^- \tag{16}$$
这实现了干净的关注分离:Bias Net 吸收全局点击先验以稳定 AUC,而 Pairwise Loss 从建模系统偏置中解放出来,纯粹聚焦相对相关性($\text{logit}_{main}$),直接提升 GAUC。避免了激进 pairwise 优化常伴随的校准退化。
4.7 误差感知渐进训练(Error-Aware Progressive Training)
为缓解深层网络的梯度消失并促进 Curriculum Learning,提出动态 Error-Aware Progressive Training。核心思想:用第 $l$ 层的预测误差监督第 $(l+1)$ 层,强制更深层聚焦浅层误判的难样本。
在每层 $l$ 给候选 token 输出 $\mathbf{h}_c^l$ 挂一个轻量辅助头,生成中间预测 $\hat{y}^l$。计算无裁剪的绝对预测误差作为难度度量:
$$\delta^l = |y - \hat{y}^l| \tag{17}$$
该误差决定下一层的损失权重 $\alpha^{l+1}$:
$$\alpha^{l+1} = 1 + \lambda \cdot \text{StopGradient}(\delta^l) \tag{18}$$
StopGradient 确保权重 $\alpha$ 纯作为标量调制器,防止不稳定梯度通过加权机制自身回传。
总目标:为显式优化 intra-session 排序(GAUC),在最终输出上加 pairwise 约束:
$$\mathcal{L}_{pair} = -\frac{1}{|\mathcal{P}|}\sum_{(c^+, c^-)\in\mathcal{P}} \log \sigma(\hat{y}(c^+) - \hat{y}(c^-)) \tag{19}$$
其中 $\mathcal{P}$ 是每个 query session 内构造的有效训练对($c^+$ 点击、$c^-$ 未点击)。总目标为加权和:
$$\mathcal{L}_{total} = \sum_{l=1}^{L} \alpha^l \mathcal{L}_{BCE}(\hat{y}^l, y) + \gamma \cdot \mathcal{L}_{pair}(\hat{y}^L) \tag{20}$$
前项是逐层渐进 pointwise(progressive pointwise),后项是 pairwise ranking。$\gamma$ 平衡 BCE 与 pairwise。这一混合设计通过深度监督保证鲁棒收敛,同时直接提升面向搜索的排序能力。
训练算法(Algorithm 1,附录)
端到端流程可概括为: 1. 采样 batch $\mathcal{B} = \{(u,q,C,\mathbf{y})\}$; 2. 层次化 tokenization(Sec 4.2):逐域全局聚合 → 生成显著性权重 $\mathbf{w} = \sigma(\mathbf{W}_{ex}\delta(\mathbf{W}_{sq}\mathbf{z}))$ → 场景重加权 $\tilde{\mathbf{X}}_i = w_i \mathbf{X}_i$ → 分布校准投影 $\mathbf{E}_i = \text{MLP}_{cal}(\tilde{\mathbf{X}}_i)$; 3. 统一序列构造(Sec 4.3):拼接 Context Anchor + 各域 token 得 $\mathbf{E}_{in}$; 4. 骨干 + 渐进训练:初始化 $\mathcal{L}_{prog}=0$、$\alpha^1=1$;逐层前向 Per-Field QKV + Noise-Adaptive Gating 得 $\mathbf{H}^l$,取候选表征 $\mathbf{h}_c^l$,辅助预测 $\hat{y}^l$,累加 $\mathcal{L}_{prog} \mathrel{+}= \alpha^l \mathcal{L}_{BCE}$,误差 $\delta^l = |y-\hat{y}^l|$,更新 $\alpha^{l+1} = 1 + \lambda\text{SG}(\delta^l)$; 5. 解耦 FiLM 融合 & Bias Net(Sec 4.5、4.6):提取候选终态 $\mathbf{h}_c^L$ 和 Anchor 终态 $\mathbf{h}_{bias}^L$;Bias 路径 $\text{logit}_{bias} = \text{BiasNet}(\mathbf{h}_{bias}^L)$;主路径 FiLM 计算 $\boldsymbol{\gamma}_c, \boldsymbol{\beta}_c$,$\mathbf{v}_{final} = (1+\boldsymbol{\gamma}_c)\odot[\mathbf{h}_c^L \oplus \mathbf{e}_c^{all}] + \boldsymbol{\beta}_c$,$\text{logit}_{main} = \text{TaskTower}(\mathbf{v}_{final})$,$\hat{y}^L = \sigma(\text{logit}_{main} + \text{logit}_{bias})$; 6. 正交优化:计算 $\mathcal{L}_{pair}$,总目标 $\mathcal{L}_{total} = \mathcal{L}_{prog} + \gamma\mathcal{L}_{pair}$; 7. 用 Split-Optimizer(稀疏 Adam / 稠密 AdamW)更新 $\Theta$。
实验设置
数据集
因缺乏同时包含超长用户行为序列和显式 query-item 匹配信号的公开大规模搜索数据集,实验仅在天猫 App 搜索日志采集的工业数据集上进行。
| Item | Statistics |
|---|---|
| 时间跨度 | 31 天 |
| 总样本 | ~5 亿(>500 Million) |
| 平均序列长度 | 1,500 |
| 用户数 | 1300 万 |
| 物品数 | 7400 万 |
| 训练集(Day 1-30) | 4.84 亿 |
| 测试集(Day 31) | 1600 万 |
平均序列长度 1500 远超典型工业设置(通常 <200),构成对高效建模的重大挑战。严格按时间序划分:前 30 天训练、最后一天测试。
Baselines
Group 1 传统模型(DLRM):
- DNN:标准 Embedding-MLP,捕捉隐式特征交互。
- DIN:局部激活单元捕捉用户兴趣;与 RankMixer 组合作为生产基线(production baseline)。
- DCNv2:低秩 cross 层高效学习有界度显式特征交互。
- APG:超网络动态生成实例专属参数以处理多样数据分布。
Group 2 可扩展架构(Transformer):
- HiFormer:两阶段层次聚合高效建模长行为。
- RankMixer:多头 token mixing 替代 self-attention 最大化 MFU(生产基线)。
- HHFT:异构特征分块 + 独立投影防止干扰。
- HSTU:point-wise 聚合替代 softmax-attention 实现高效大规模扩展。
- MTGR:把 CTR 预测重构为序列生成任务(排序精度常受限)。
- OneTrans:把所有上下文和序列特征序列化为单一 token 流做统一因果建模。
评估指标
- AUC:全局排序能力,衡量随机正样本排在随机负样本之前的概率。
- GAUC(主指标):在每个 user-query group 内计算 AUC 的加权平均。$\text{GAUC} = \frac{\sum_{(u,q)} w_{(u,q)}\times\text{AUC}_{(u,q)}}{\sum_{(u,q)} w_{(u,q)}}$,其中 $w_{(u,q)}$ 是该 session 的曝光数。因为同一 query session 内物品的相对顺序比全局绝对分更关键。在大规模工业推荐中,GAUC 绝对提升 0.001 即视为统计显著。
实现细节
- 分布式训练框架,16 张高性能 Nvidia GPU 集群。
- 全局 batch size = 4096,学习率 = $2\times10^{-4}$。
- Split-Optimizer 策略:稀疏部分用 Adam(处理长尾 ID 的非平稳分布,自适应学习率);稠密骨干和 MLP 塔用 AdamW(decoupled weight decay 有效防止深层计算密集层过拟合)。
- 公平对比:所有 DNN 类模型用相同 MLP 隐藏维;所有 Transformer 类模型用相同隐藏维。
主要实验结果
RQ1:整体性能(Table 2)
相对生产基线 DIN 的相对提升(%)。粗体为最佳、下划线为次佳。
| Model | ΔAUC (%) | ΔGAUC (%) |
|---|---|---|
| Group 1 传统模型 | ||
| DNN-based | -0.25 | -0.21 |
| DIN (Base) | 0.00 | 0.00 |
| DCNv2 | +0.11 | +0.19 |
| APG | +0.21 | +0.27 |
| Group 2 可扩展架构 | ||
| HiFormer | +0.33 | +0.59 |
| HSTU | +0.58 | +0.61 |
| MTGR | +0.64 | +0.69 |
| HHFT | +0.36 | +0.67 |
| OneTrans | +0.82 | +0.75 |
| RankMixer (Prod. Base) | +0.39 | +0.77 |
| TMallGS (Ours) | +1.12 | +1.26 |
两个核心洞见: 1. 计算中心迁移(Compute-Centric Shift):可扩展架构(Group 2)普遍超越内存受限的 DLRM(Group 1),确认扩展骨干容量和序列长度($L=1500$)对捕捉复杂依赖至关重要。 2. 解耦优越性(Decoupling Superiority):OneTrans 虽提升 AUC,但其 GAUC 落后于 RankMixer,暴露了通用 Transformer 的信号稀释。TMallGS 通过 Decoupled FiLM Fusion 保护高频匹配信号,取得最高增益(+1.12% AUC、+1.26% GAUC),证明领域专属解耦对将 LLM 架构适配到搜索是关键。
RQ2:消融研究(Table 3)
各变体相对完整模型的性能下降幅度(%)。"w/o" = 移除,"→" = 替换。
| Model Variants | ΔAUC (%) | ΔGAUC (%) |
|---|---|---|
| TMallGS (Full Model) | - | - |
| A. 交互解耦 | ||
| — w/ Cross-Fea in Block: w/o FiLM Fusion | -0.21 | -0.32 |
| — w/ Cross-Fea in Block: FiLM → Concat | -0.15 | -0.24 |
| — w/o Cross-Fea in Block: w/o FiLM Fusion | -0.17 | -0.19 |
| — w/o Cross-Fea in Block: FiLM → Concat | -0.10 | -0.11 |
| B. 噪声过滤 | ||
| Gating → Std. Attn | -0.13 | -0.16 |
| C. Tokenization | ||
| Only DCP | -0.08 | -0.06 |
| Only FSR | -0.13 | -0.09 |
| FSR+DCP → MLP | -0.17 | -0.11 |
| FSR+DCP → SwiGLUFFN | -0.05 | -0.03 |
| D. 优化与训练 | ||
| w/o Bias Net | -0.07 | -0.13 |
| w/o Prog. Train | -0.11 | -0.08 |
| w/o Pairwise Loss | +0.05 | -0.87 |
| w/o UQH Seq | -0.65 | -0.29 |
结构设计影响:
- Block A 证明交互解耦的必要性——移除 FiLM Fusion 导致最陡 GAUC 下降(-0.32%),验证深层 Transformer 会稀释显式匹配信号;FiLM 的乘性调制优于加性拼接(-0.24%)。
- Block B:Noise-Adaptive Gating 优于标准注意力(-0.16% GAUC),有效缓解噪声行为序列中的 attention sink。
- Block C:FSR+DCP 流水线与 heavy SwiGLU-FFN 性能相当(gap <0.03%)同时减少约 33% 投影 FLOPs,达到最优效率-精度权衡。
优化策略影响:
- 移除 Pairwise Loss 导致 GAUC 灾难性下降 -0.87%(AUC 反而 +0.05% 稳定),确认其在优化 intra-session 排序中不可替代——这是 pointwise/pairwise 正交分离设计价值的直接体现。
- 移除 UQH(Query History)严重损害全局 AUC(-0.65%),凸显其对长期意图建模的价值。
- Context-Aware Bias Net 和 Progressive Training 均贡献稳定性,移除导致一致退化。
RQ3:可扩展性分析(Figure 2)
沿三个维度探测扩展性质,对比冷启动 DIN 基线:Width ($D \in \{512, 768, 1024\}$)、Depth ($L \in \{4, 8, 10\}$)、Length ($T \in \{500, 1000, 1500\}$)。
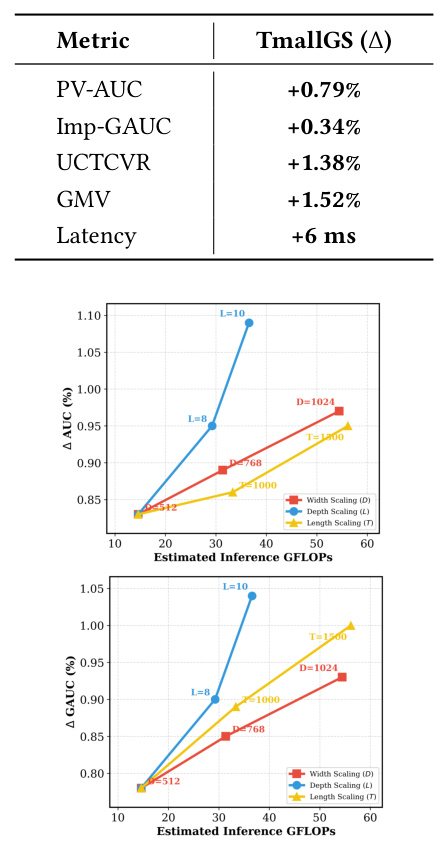
TMallGS 遵循 scaling law,所有维度随算力预算单调增长。Depth 缩放斜率最陡(最高 ROI,对排序精度最有利)。Length 缩放到 $T=1500$ 仍保持鲁棒线性增长而不饱和——证明 Noise-Adaptive Gating 有效防止超长序列中的噪声累积。这直接回应了传统 DLRM 参数饱和(简单加宽 MLP 边际递减)的痛点。
RQ4:部署策略与效率
两阶段表征对齐(Two-Stage Representation Alignment)
为继承海量遗留 embedding,解决直接加载导致的 流形错配(manifold misalignment)。提出两阶段 warm-up:先冻结稀疏 embedding 对齐稠密骨干,再端到端联合微调。
| Warm-up Strategy | ΔAUC (%) | ΔGAUC (%) |
|---|---|---|
| Cold Start | - | - |
| Direct Loading | +0.46 | +0.34 |
| Two-Stage (Ours) | +1.42 | +1.09 |
两阶段策略显著超越直接加载,+1.42% AUC、+1.09% GAUC。
在线配置
考虑天猫搜索严格的延迟约束和高 QPS,直接部署十亿级 LLM 不可行。基于 RQ3 的 scaling law 分析,优先序列长度而非模型深度,配置:Layers=4, Dimension=1024, Head=8, 序列长度=1500。稠密骨干约 0.05 billion(5000 万)参数。这一配置达到最优平衡:扩展序列长度捕捉长期兴趣,浅而宽(shallow-but-wide)结构确保 GPU 上大规模并行、把推理延迟控制在 SLA 内。
在线 A/B 测试(Table 4,30 天,全部 $p<0.05$ 统计显著)
| Metric | TMallGS (Δ) |
|---|---|
| PV-AUC | +0.79% |
| Imp-GAUC | +0.34% |
| UCTCVR | +1.38% |
| GMV | +1.52% |
| Latency | +6 ms |
+1.52% GMV lift 和 +1.38% UCTCVR lift 表明更高的用户满意度与转化效率。虽然稠密骨干使平均延迟略增(+6ms),但仍严格控制在生产 SLA 内,证明 TMallGS 成功在高容量建模与系统效率间取得有利平衡。
核心贡献总结
- 诊断了 LLM 架构直接迁移到高精度搜索排序的三大结构性缺陷:异构性鸿沟、信号稀释、优化不稳定,并给出精确的机制解释(self-attention 作为低通滤波器稀释高频匹配信号)。
- 提出 "语义分而治之 + 交互解耦" 范式:核心是 Decoupled FiLM Late Fusion——把 heavy cross-features 从被深层稀释的语义主干中解耦出来,用 FiLM 乘性调制在末端重新注入。这是相对 OneTrans 式"一体化"的关键差异,也是 GAUC 领先的主因。
- Per-Field QKV + Noise-Adaptive Gating:从投影层(流形对齐)和注意力层(未归一化门控破除 Softmax 和为 1 约束)双管齐下应对异构性与序列噪声。
- 正交优化设计:Context-Aware Bias Net 的加性偏置在 pairwise loss 中自然抵消,实现"Bias 吸收全局先验稳 AUC、Pairwise 纯做相对排序提 GAUC"的干净分离。
- 完整工业落地:天猫 App 搜索精排线上部署,浅宽(L=4, D=1024)+ 长序列(T=1500)配置,5000 万稠密参数,+1.52% GMV、+1.38% UCTCVR,延迟 +6ms 内。
与已归档相关工作的对比
OneTrans OneTrans: Unified Feature Interaction and Sequence Modeling (ByteDance, 2025-10-30)
关系:显式引用,原文 RQ1 已作为强 baseline 充分对比 · 未加载对方精读
OneTrans 是本文最直接的对照对象,也是"一体化 Transformer"路线的代表:把所有上下文和序列特征序列化为单一 token 流做统一因果建模。原文 Table 2 报告:OneTrans 取得次佳 AUC(ΔAUC +0.82%,仅次于 TMallGS 的 +1.12%),但其 GAUC(+0.75%)反而落后于生产基线 RankMixer(+0.77%)。作者据此论证 OneTrans 式一体化 tokenization 在搜索场景暴露信号稀释问题——深层 self-attention 过度平滑了对搜索决定性的高频 query-item 匹配信号。TMallGS 的核心机制差异正是用 Decoupled FiLM Late Fusion 把 heavy cross-features 从主干解耦、末端再注入,从而在 GAUC 上反超 0.51 个百分点。详细精读见 OneTrans。
MixFormer MixFormer: Unified Sequence & Feature Interaction in a Single Parameter Space (ByteDance, 2026-02-15)
关系:独立并发(本文未引用 MixFormer,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两者都攻击"统一 Transformer 骨干中序列建模与特征交互如何共存"这一 root cause,且都识别到 异构特征域下标准共享 QKV 内积注意力不可靠(MixFormer 明言"传统基于内积的 self-attention 在异构性下不可靠",TMallGS 称之为"异构性鸿沟触发梯度冲突")。
- 相近的技术骨架:两者都用 per-field / per-head 独立参数化 处理异构性——MixFormer 用 per-head SwiGLUFFN + 零参 HeadMixing 替代 self-attention,TMallGS 用 Per-Field QKV 投影 + Noise-Adaptive Gating。两者都设计了 User-Item 解耦的可见性 mask 以在同一 request 内跨候选共享 user-side 计算(MixFormer 的 Query Mixer Mask ≈ TMallGS 的 Context-Dominant Visibility Mask)。
- 本文的差异与推进:MixFormer 走的是"统一到单一参数空间"的极致融合路线(其核心论点恰恰是不该分离);TMallGS 走的是相反哲学——"交互解耦",认为 heavy cross-features 必须从统一主干中剥离并在末端 FiLM 重注入,否则会被深层稀释。此外 TMallGS 是搜索场景(受 query 严格约束、强调 GAUC),MixFormer 是推荐/信息流场景(Finish/Skip 双任务)。
- 可比的方法/实验差异:MixFormer 在抖音数据上以 UI-MixFormer 实现 -36% FLOPs;TMallGS 在天猫搜索用浅宽+长序列(L=4,D=1024,T=1500)实现 +1.52% GMV。两者都强调 co-scaling / 长序列扩展且都验证了 scaling law。
HHSFT HHSFT / UniScale: Data-Architecture Co-Design for Tmall Search Scaling (Taobao & Tmall Group of Alibaba, 2026-03-25)
关系:独立并发(本文未引用;系同一天猫搜索团队的前序/并行工作,殊途同归)· 已加载对方精读
- 共同关注的问题:同一团队、同一天猫搜索排序任务、同一"DIN 生产基线"框架、同一"纯参数缩放收益递减 + 异构数据分布退化"的 root cause。这是极高价值的孪生对——两篇论文攻击完全一致的工业瓶颈。(注意:本文参考文献 [31] 引的 "HHFT (2511.21035)" 是另一支 HiFormer 血缘的异构特征 Transformer,与此处 Tmall 团队的 HHSFT/UniScale 并非同一工作。)
- 相近的技术骨架:几乎相同的异构注意力设计——UniScale 的 HHSFT 用 Token-specific QKV Projection(token 专属 $\mathbf{W}_i^Q/\mathbf{W}_i^K/\mathbf{W}_i^V$)+ Token 专属 FFN 处理异构特征域;TMallGS 的 Per-Field QKV Projection 是同一思路的直系延续。两者都用"跨域前向可见、域内反向隔离 + stop-gradient"风格的注意力/门控做上下文-候选或跨域解耦。
- 本文的差异与推进:UniScale 的重心在数据缩放(ES3 全空间采样 + 层次化标签归因 + 跨域样本搜索化)与跨域用户兴趣融合(DREF MoE + DAPGA);TMallGS 的重心在架构侧的信号保护与优化稳定性(Decoupled FiLM、Noise-Adaptive Gating、Error-Aware Progressive Training、正交 Bias Net)。可视为同一团队在"co-scaling"大命题下从数据轴(UniScale)到架构-优化轴(TMallGS)的两次推进。
- 可比的方法/实验差异:UniScale 报告 Taobao 搜索 +2.04% GMV;TMallGS 报告天猫搜索 +1.52% GMV、+1.38% UCTCVR。两者不能直接横比(数据系统与线上口径不同),但都用 GAUC 作主指标、都在阿里搜索精排线部署。
讨论与局限性
核心贡献与借鉴价值:TMallGS 最值得借鉴的是它对"LLM 架构不能无脑迁移到搜索"这一命题给出了机制级的诊断与对症下药。特别是 Decoupled FiLM Late Fusion——它精准指出深层 Transformer 的低通滤波会稀释 query-item 匹配这类高频硬信号,并用 FiLM 乘性调制在末端恢复;这一"语义主干 + 显式信号旁路"的解耦思想,对任何"统一 Transformer 排序"工作都有直接参考价值。此外,加性 Bias Net 在 pairwise loss 中自然抵消 的正交优化设计非常巧妙,用一行公式(式 16)把"稳 AUC"和"提 GAUC"两个常冲突的目标干净分离。
工业落地价值:明确的浅宽(L=4, D=1024)+ 长序列(T=1500)+ 5000 万稠密参数配置,是"优先序列长度而非深度"这一 scaling law 洞见的直接产物,把延迟控制在 +6ms/SLA 内。这对严格延迟约束下想上 Transformer 骨干的工业搜索团队是可直接抄的配方。
局限与争议: 1. 仅工业私有数据集验证:因缺少同时含超长序列 + 显式匹配分的公开搜索数据集,全部实验在天猫私有数据上进行,无公开可复现 benchmark,外部难以核验。 2. 与自家并发工作缺乏对比:本文与同团队的 UniScale/HHSFT(2603.24226)机制高度重叠(Per-Field QKV ≈ Token-specific QKV),却未在正文引用或对比,两者的贡献边界与叠加收益不清晰。 3. 多模块协同的可解释性:五大创新(FSR/DCP、Per-Field QKV、Noise Gating、FiLM、Bias Net、Progressive Train)耦合较深,虽有消融,但各模块交互效应、以及在非搜索场景的可迁移性未充分讨论。 4. scaling 上限未探明:受延迟约束仅上线 L=4 的浅模型,RQ3 虽显示 Depth 斜率最陡却因成本优先了 Length,模型真实容量天花板未被探到;作者在结论中把"扩展到十亿参数级 + 多模态生成"列为未来工作。