AgentX:面向工业推荐系统自迭代的 Agent 驱动框架¶
Kuaishou(快手)· AgentX Team · arXiv 2606.26859 · 2026-06-25 · 48 页技术报告
研究动机与背景¶
工业推荐系统的算法迭代长期高度依赖算法工程师的持续投入。一次完整的算法迭代通常要穿越多个阶段——数据分析、特征工程、模型开发、在线部署、A/B 测试、归因复盘——并进一步依赖异构的数据平台、训练框架与监控工具,发布周期往往以"周"为单位度量。由于工业推荐面对复杂的业务目标与严苛的工程约束,有效的系统改进高度依赖那种"难以显式编码"的专家经验。因此整个系统的迭代吞吐量在很大程度上被工程师的人数与认知负载所约束。
论文指出一个更尖锐的问题:工程师的相当一部分精力并未花在高价值判断上,而是散落在重复性杂务里——拉数据、改配置、维护流水线。这稀释了真正稀缺的能力:提出高质量假设、理解实验失败的根因、识别系统优化方向。常规的应对手段(扩招工程师、或建设更强的底层平台)本质上都只是对"人工开发过程"的线性放大,无法改变"推荐系统迭代严重依赖人力与个体经验"这一结构性瓶颈。
论文把核心命题凝练为一句话——推荐系统迭代的瓶颈正在发生迁移:
From the labor of algorithm engineers to the capability of agent systems.(从算法工程师的人力,转向 Agent 系统的能力。)
前者高度依赖个体经验,后者则是可复现、可复利(compoundable)的。一旦每一次线上迭代的执行轨迹(trajectory)都能被记录、分析并回灌进底层 agent 框架,系统本身就不再是一个线性的自动化工具,而成为一个会随时间越来越强的"开发机制"。
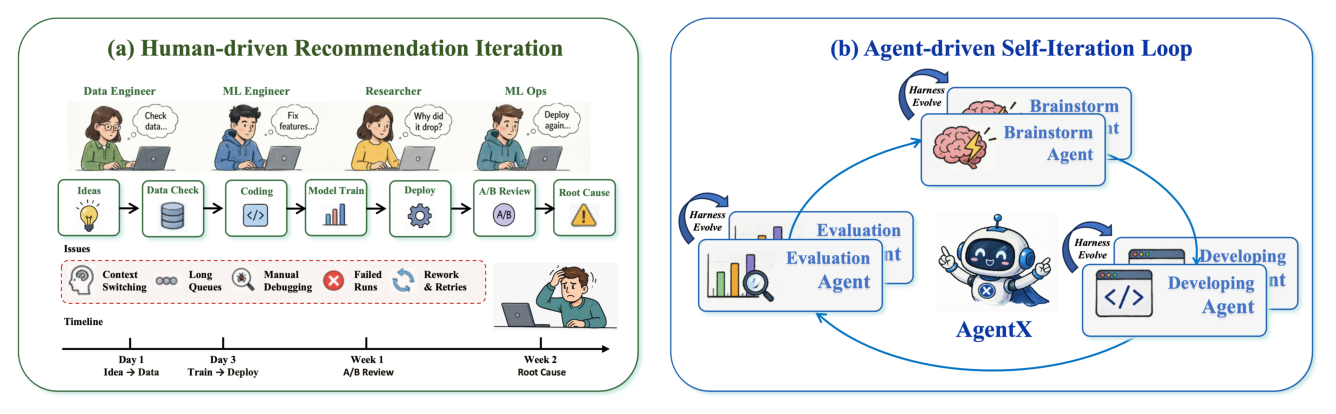
论文将 LLM 驱动的 ML 开发自动化按自治程度分为三层递进:
- Pipeline automation(流水线自动化):把 LLM 嵌入预定义的 AutoML / 数据科学流水线,任务定义与解空间仍由人指定(CAAFE、DS-Agent、Data Interpreter、AutoML-Agent)。
- Experimental automation(实验自动化):把"可执行实现 + 实验轨迹"当作自治搜索的对象,agent 反复改代码、跑实验、读指标日志并据经验反馈选择后续动作(IMPROVE、MLE-STAR、AIDE、R&D-Agent、AutoMind、MLEvolve)。
- Research automation(研究自动化):进一步把决策空间从"解决预定义任务"扩展到"formulate 并 validate 研究本身"(The AI Scientist、Agent Laboratory、AI Scientist-v2、Ai-researcher)。
但从工业推荐的视角审视这些工作,论文识别出三个结构性缺口:
- 缺乏真实在线反馈(Lack of real online feedback):既有系统多用离线指标或人类专家评分作为成功信号,这对学术评测合理,却不等价于真实业务价值的正贡献。线上 A/B 结果才是与真实价值最对齐、最不易被噪声污染的奖励信号,而它在既有研究里基本缺席。
- 工业规模验证不足(Limited validation at industrial scale):当前公开工作验证的数据 / 模型 / 流水线规模仍落后于真实推荐系统(十亿级样本、耦合多目标、多业务线并行)。规模差异不仅影响绝对性能,更会重塑系统的瓶颈结构——那些在小规模下可忽略的工程约束,在工业规模下成为决定闭环能否成立的关键变量。
- 缺乏持续进化机制(Absence of continuous evolution mechanism):多数 ML 工程 agent 在单个任务完成后不沉淀参数、prompt、workflow,缺乏长期复利效应,导致系统难以适应新任务、反复掉进同一个坑。
换言之,既有工作回答了"agent 能否在受控环境完成 ML 任务",却尚未回答更具业务本质的问题:agent 能否在真实工业推荐系统中持续交付线上收益并随时间自我进化。在"想法生成与验证不再稀缺"的前提下,关键已从"产生想法"转向"如何构建贴合真实业务的闭环、全生命周期开发流水线"。
AgentX 即为此而生:它不是让 LLM 在 sandbox 里完成一次性 ML 任务,而是在真实推荐业务中持续驱动算法迭代。它构成完整的在线反馈闭环——想法生成 → 代码与流水线开发 → A/B 分析反馈 → 下一轮推演,每一次执行过程都以轨迹形式持久蒸馏,作为后续优化 agent workflow、训练基础模型、改进系统策略的数据源。
三点主要贡献:
- 完整闭环(Complete closed loop):在真实工业推荐场景中跑通了从调研到生产部署的端到端算法开发与进化流水线,系统不依赖人来逐步缝合,agent 在统一编排下持续驱动整个过程。
- 真实工业奖励(Real industrial reward):最终成功判据落在真实线上 A/B 反馈上,利用最干净的用户训练信号,把整个系统的优化目标与真实业务收益直接对齐。
- 可扩展收益与自迭代飞轮(Scalable gains and a self-iterative flywheel):并发生成多个想法并经统一质量漏斗验证,提升实验吞吐与线上收益规模;同时每次实验产生的轨迹回灌进 agent 编排框架与基础模型,使系统在长期运行中持续变强。
整体设计哲学:什么是好的工业推荐迭代闭环¶
在描述各 agent 之前,论文先抛出设计原则的核心问题:工业推荐里一个好的迭代闭环应该长什么样? 经典 LLM agent 任务(数学、代码、sandbox ML benchmark)通常假设:环境暴露一个可验证的奖励、单条执行轨迹足以判定成功、优化目标在 agent 启动前就已固定。而工业推荐同时违背这三个假设:
- 奖励信号活在延迟的线上 A/B 反馈里,而非离线指标;
- 单次部署在任何分数可得之前,要先经过 guardrail 与人工评审的把关;
- 优化目标本身会随业务目标、流量结构、平台约束的演变而漂移。
因此一个生产级推荐 agent 闭环必须是 closed-loop 而非 one-shot:要把模糊的业务意图转成有证据支撑的提案,把每个提案转成与代码仓库一致的代码,经安全灰度 + guardrail veto 验证变更,并把正负轨迹都回灌使闭环本身随时间改进。
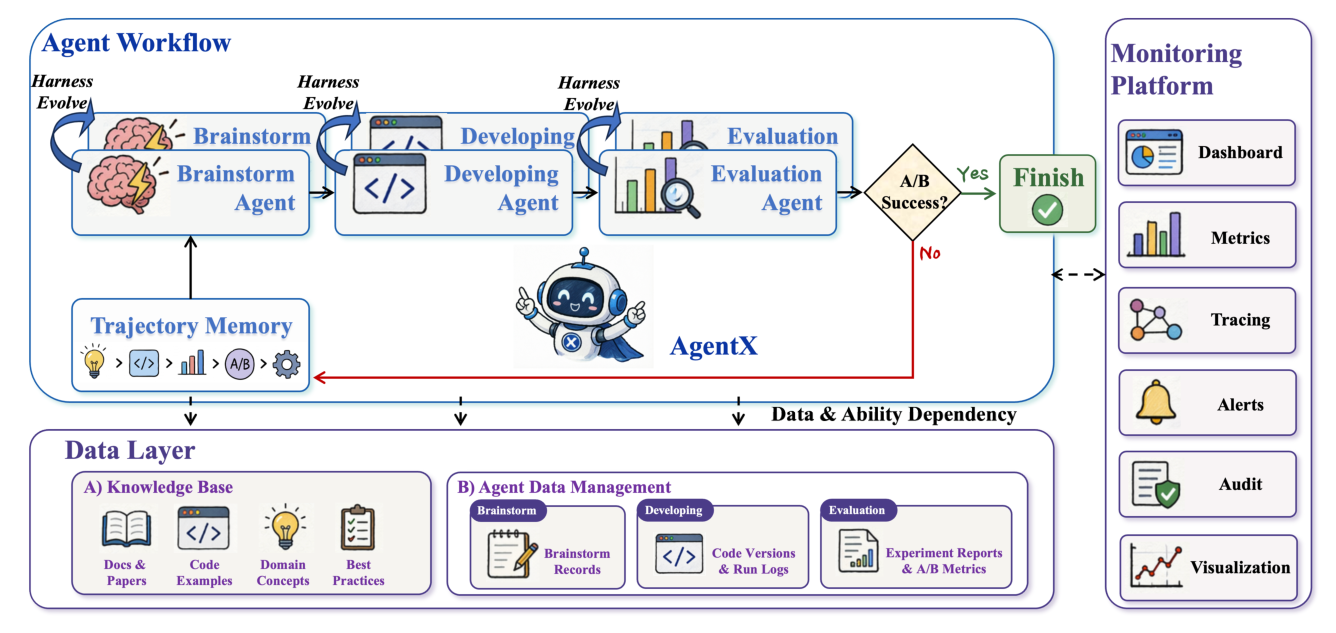
AgentX 沿单一闭环分解为四个阶段,其中前三个共同把一个想法从 intent 带到验证过的线上结果,第四个把产生的轨迹回灌以精炼闭环本身:
- Brainstorm Agent:通过有界探索(bounded exploration)与证据加权生成(evidence-weighted generation),把欠规约的用户意图转成一个小而有序的可执行实验提案集。
- Developing Agent:通过仓库 grounded 的生成与面向验证的实现循环,把每个选中提案翻译为生产就绪代码。
- Evaluation Agent:管理灰度与流量分配,用 guardrail veto 判定 A/B 结果,并把线上结果(含失败)资产化为可复用的奖励信号与失败记忆。
- Harness Evolution(SGPO):对累积的执行轨迹做推理,用语义梯度(Semantic-Gradient-based Prompt Optimization)更新各 subagent 规约,且仅通过 paired replay 准入。
围绕这一闭环,一个共享的 Data Layer(包含当前实践经验的知识库 + 实验报告等 Agent 数据管理记录)持久化每一件 artifact,Monitoring Platform 通过 dashboard / metrics / tracing / alerts / audit / visualization 持续观测系统健康。
一、Brainstorm Agent:从模糊意图到有序提案¶
Brainstorm Agent 是 AgentX 闭环的入口,它决定下游 agent 被允许实现、评估、上线什么。它的角色不是生成一长串貌似合理的想法,而是把一个模糊的优化意图,转成一个小而有序的可执行实验提案集。每个提案必须:grounded 在生产证据上、scoped 到允许的变更面、precise 到足以被编码、上线、事后诊断。
1.1 The Ambiguity Problem(歧义问题)¶
头脑风暴的核心困难在于:输入有意地欠规约(under-specified),而输出必须在操作上精确(operationally precise)。若 agent 探索太自由,会发明信号、假设不存在的特征、提出超出允许代码路径的变更;若太保守,则只返回熟悉策略的局部变体,无法扩展机会空间。因此 Brainstorm Agent 被设计为一个边界设定 + 证据聚合模块:在一个被记录的生产包络内保留创造性搜索。
对每个任务,agent 先把用户请求归一化为一个 intake boundary(接收边界),记录:primary objective、allowed business scope、forbidden changes、known guardrails、candidate output requirements、unresolved questions。目的不是逼用户预先指定一切,而是让不确定性显式化:已知字段约束搜索,未知字段则变成保守默认或具名的后续探针(follow-up probe),防止歧义被静默传给 Developing Agent。
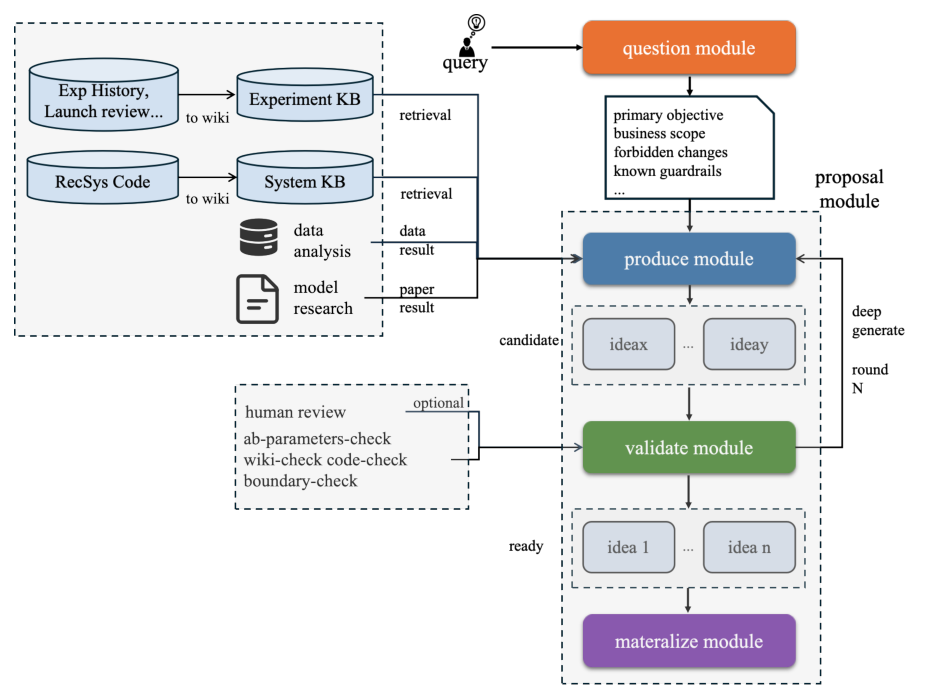
整条流水线分离三项职责(对应 Figure 3 的模块):
- Question(问题模块):把欠规约的用户意图转成显式的任务边界(primary objective / business scope / forbidden changes / known guardrails)。
- Idea Production(想法产出模块):在两个耦合控制下生成候选——
- Bounded proposal exploration(有界提案探索):想法按批(batch)产出而非单条自由响应,每个想法绑定目标、可能实现面、预期下游 artifact、成熟度状态。
- Evidence context(证据上下文):从四个来源检索证据。
- Validation and Materialization(验证与物化):validate 模块经人工评审 + 生产检查(A/B 参数检查、知识库一致性、code-scope、boundary check)过滤;materialize 模块把已接受候选转成结构化提案 artifact,交付下游做验证、编码、上线与事后诊断。
1.2 Bounded Proposal Exploration(有界提案探索)¶
边界固定后,agent 按批探索提案。批结构之所以重要,是因为生产想法不仅在机制上不同,也在成熟度上不同。AgentX 给每个候选赋予三种状态之一:
- Ready-to-implement:有具体目标、流水线中的具名位置、合理的目标路径、足够进入评审的证据。
- Probe-first:有前景但需先做一个具体的数据 / 源 / dry-run 检查才能实现。
- Moonshot-backlog:保留那些在未来基础设施 / 数据 / 模型改进后才可能有用的长程方向。
这种成熟度切分让系统能广泛探索而不混淆"探索"与"承诺"。批循环还是残差式(residual)的:每轮之后,被拒方向、历史重复、违反约束、已覆盖机制都被写入一个 avoid set;有前景但不完整的方向转成显式探针。下一轮于是搜索剩余空间,而非复述同样的想法。在这个意义上,Brainstorm Agent 不只是从 LLM 采样建议,而是在生产约束下收缩可行机会空间。
1.3 Evidence-Weighted Proposal Generation(证据加权提案生成)¶
如果把所有检索到的上下文当作同等权威,头脑风暴就不可靠。不同候选需要不同种类的证据:novelty-oriented 想法要对照历史 launch review 以避免重复已知失败;code-path-sensitive 想法要对照架构与源码 scope 知识以避免不可能的交接;metric-diagnosis 想法要 grounded 在数据分析而非直觉。因此 agent 把知识表示为候选特定的证据混合,而非固定检索结果。
设 $c$ 为候选想法,$q$ 为结构化接收边界,证据源集合为:
$$\mathcal{K} = \{\text{Experiment KB}, \text{System KB}, \text{Data Analysis}, \text{Model Research}\}. \tag{1}$$
一个加权机制让同一候选格式支持不同推理 regime,而无需硬编码单一检索策略:
$$\alpha_k(q,c) \geq 0, \qquad \sum_{k \in \mathcal{K}} \alpha_k(q,c) = 1, \tag{2}$$
其中 $\alpha_k(q,c)$ 反映来源 $k$ 对当前问题与候选的相关性与可靠性。每个来源产出证据分 $e_k(c) \in [0,1]$,加权证据项为:
$$E(c \mid q) = \sum_{k \in \mathcal{K}} \alpha_k(q,c)\, e_k(c). \tag{3}$$
最终候选分把证据项与目标对齐、业务有效性、实现可行性、交接完整性、风险结合:
$$S(c \mid q) = \lambda_o O(c,q) + \lambda_b B(c) + \lambda_f F(c) + \lambda_h H(c) + \lambda_e E(c \mid q) - \lambda_r R(c). \tag{4}$$
其中 $O$ 度量与用户主目标的对齐,$B$ 度量业务语义有效性,$F$ 度量实现可行性,$H$ 度量交接是否完整到足以下游执行,风险项 $R$ 惩罚重复方向、未解决的核心信号、过宽 scope、不安全权衡等提案缺陷。
四个证据源各司其职(论文 §4.3.1–4.3.4 详述):
- Experiment KB:存历史 launch review、业务定义、过往实验结论与教训;不仅记"想法成败"还记"结果背后的上下文"(目标场景、受影响用户群、指标变动、上线决策、事后诊断)。当候选依赖 novelty / 历史经验 / 业务语义时权重更高,用于惩罚重复方向、避开被证伪的假设、复用成功教训——把头脑风暴从无状态变成累积式。
- System KB:存推荐系统内部的结构化知识(模型架构、DSL 行为、流水线边界、配置语义、源码 scope),目的是降低 code-path-sensitive 想法的幻觉。它构建为结构化领域 wiki(三层:schema 层定义字段与关系、wiki 层存结构化 Markdown 条目、raw-source 层把每条目链回原始代码/配置/文档),经 ingest–query–lint 生命周期维护。对 feasibility-sensitive 候选权重更高,把架构与实现约束转成显式证据。
- Data Analysis:为依赖观测数据模式(而非直觉)的候选提供经验证据,可访问历史分析报告、指标定义、SQL 计划、离线统计与即时 SQL 查询。在 metric diagnosis、segment 行为、分布漂移等场景权重更高,把头脑风暴从直觉驱动转成 data-aware 假设形成。
- Model Research:为依赖近期论文 / 学术发现的候选提供外部研究证据。它把论文转成可执行的提案知识:每篇论文被分解为 typed claims(按 problem / assumption / method / finding / limitation 角色与证据强度标注)、architecture components、inter-paper relations(extend / contradict / parallel / apply)。生产 baseline 用同一 schema 表示,连同特征契约与训练约束(流式增量训练、无 epoch、禁止 backbone freezing/early stopping 等硬约束),使 paper-derived 想法是被对照真实系统而非抽象评测——这正是与学术 auto-research 系统的核心工业区别:搜索空间在源头就被真实生产架构与训练 regime 约束,而非事后才用生产指标评估。这些 grounded 提案不止于单论文复现,还驱动一个系统性探索循环——复现、模块消融、跨论文组合(详见 §7.2 与下文 Model Developing)。
1.4 Validation and Implementation Handoff(验证与实现交接)¶
候选生成后有一个准入步骤。validator 检查主目标对齐、业务语义、用户约束、模型分数语义、实现可行性、历史重叠、A/B 参数可行性、成熟度一致性。评审产生轮级(round-level)与候选级(candidate-level)决策:只有 ready 候选且通过 validation 才能进入人工审批门;probe-first 想法留作显式取证任务;backlog 想法留在执行队列之外。
人工评审被当作一个聚焦的准入门而非"对每个弱候选都修一遍"的修复机制。被批准想法的实现交接会创建恰好一个正式实验记录、一份 source manifest、一份给 Developing 的 handoff plan(含目标行为、所需信号、预期指标路径、guardrails、已知实现边界),但刻意不在头脑风暴阶段写生产代码。这种职责分离正是 AgentX 内部可组合性的来源:Brainstorm Agent 拥有歧义削减、证据加权、提案准入;Developing Agent 拥有代码实现与仓库级验证。强制这一边界,AgentX 既防止模糊想法泄漏进实现,又允许系统搜索超越显而易见的局部变更。
二、Developing Agent:双轨的"可验证代码 artifact"¶
Developing Agent 把已批准提案变成一个可验证的代码 artifact(verifiable code artifact),沿两条镜像了推荐系统实际迭代方式的并行轨道:
- 在线策略轨(online strategy track):artifact 是面向特征 / 策略级变更的生产代码改动,目标是安全地服务线上流量而无静默可靠性失败。
- 离线模型轨(offline model track):artifact 是针对模型架构提案的训练实验,目标是产出可信到能沉淀进长期探索知识库的结论。
一个结论只有当四个条件同时成立才被视为可信:(1) 实现被验证匹配策略声明的因果机制与预期可观测量;(2) 一个隔离的专家 agent 面板对策略达成超多数一致;(3) 指标由原始训练日志确定性提取而非 LLM 解读;(4) 任何 AUC 增益都有验证过的因果链归因支撑——未归因的增益作为刹车信号而非按数值改善被记录。
尽管交付物不同,两轨面临同一根本风险:有前景的想法在实现阶段退化为静默失败。在线侧:错误特征名能编译却读到无意义数据、缺失工厂注册让策略静默失效、无 guard 的默认改动可能在评审前影响线上流量。离线侧:幻觉指标与未验证因果机制同样能悄无声息地污染知识库,没有显式失败信号。因此 Developing Agent 不是通用代码生成器,而是一个面向验证的实现系统(verification-oriented implementation system),其纪律在两轨上一致应用。
2.1 在线策略轨(§5.1)¶
2.1.1 The Production-Code Reliability Problem¶
AgentX 里的编码契约比"生成语法有效的 patch"严格得多:agent 必须保留提案意图、留在允许变更边界内、只用仓库原语、通过本地与集成检查、留下一个能安全上线的可评审改动。核心困难是这些要求会交互:一个 patch 可能逻辑上对齐提案却用了幻觉属性;可能编译却漏了必需的流水线注册;可能正确实现策略却在没有 default-off guard 的情况下激活它。
主要失败模式因此不是通用编程错误,而是仓库特定的可靠性失败:属性幻觉(在 user/context/item 特征 schema 里发明字段)、DSL 误用(猜测 ranking DSL 算子名或参数契约)、harness-pattern 违规(改动放错队列、注册不完整、绕过必需安全模式)。此外,每一次额外的纠错循环与每一次人工介入都降低自动化可靠性,因为 AgentX 的目标是用最少人工救援闭合 idea-to-launch 闭环。
2.1.2 Repository-Grounded Code Generation¶
Developing Agent 用两类仓库知识 grounding 实现:(1) 一个项目特定知识库,记录变更模式、注册约定、feature-switch 规则、被接受 patch 的样例;(2) 一个 case toolbox:一组确定性工具与 checker,强制 agent 在使用事实前先验证。最重要的 grounding 规则是特征属性必须在使用前被查询——schema query 工具为 user/context/item 各域返回可用字段,agent 被要求在读属性前调用相应工具,让字段名成为被验证的事实而非语言模型的猜测。ranking DSL 调用由编译器 backed 的 checker 验证算子名、参数类型、调用契约;C++ 惯用法与项目特定语法糖由轻量静态 linter 在 patch 进入更重的 build 前捕获。
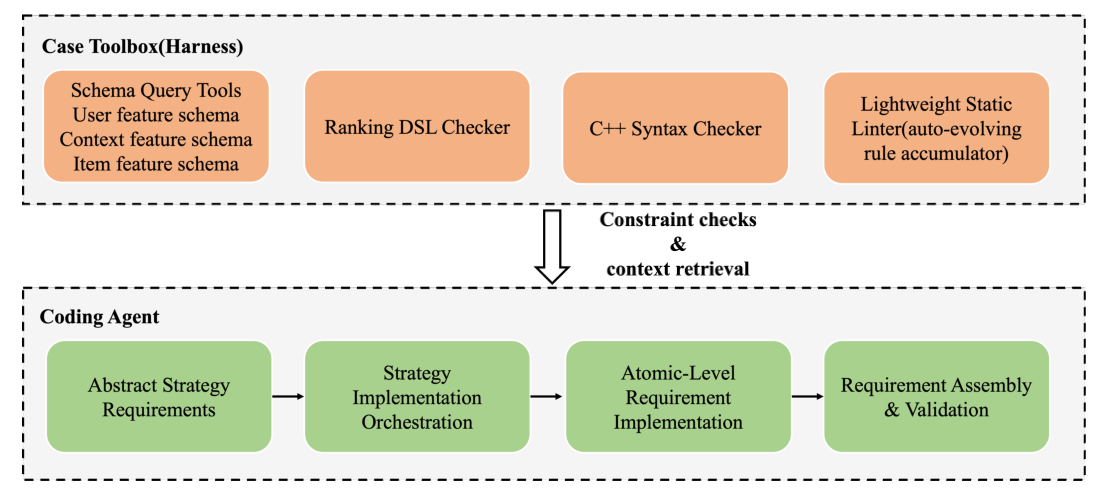
2.1.3 Verification-Oriented Implementation Loop¶
每个编码任务遵循分阶段循环:agent 先把已批准提案抽象成实现计划(哪些文件会变、需要哪些信号、哪个流水线阶段拥有逻辑、哪个 feature switch 守护行为、提交前要过哪些检查),再实现原子子需求、装配 patch、跑确定性验证。失败以有针对性的修复指令反馈,而非宽泛的重新生成 prompt。
两个验证层尤为重要:accuracy loop 把实现与计划比对并把额外修复迭代计为质量成本(理想轨迹是首次实现已匹配规约);dryrun pipeline 编译并集成检查分支(干净轨迹只过一次 Dryrun,反复 Dryrun 失败说明 agent 在把远程基础设施当 debug 工具用而非产出本地自律 patch)。两层都进入下面的质量分。
2.1.4 Quality Scoring(质量打分)¶
编码质量被度量为一个加权可靠性分而非单一通过/失败。设 $\mathcal{N} = \{1,\dots,8\}$ 为八个观测失败维度,$s_i \in [0,1]$ 为维度 $i$ 的归一化成功分:
$$Q_{\text{code}} = \sum_{i \in \mathcal{N}} \lambda_i s_i, \qquad \sum_{i \in \mathcal{N}} \lambda_i = 1. \tag{5}$$
当前实现的权重实例化为:
$$Q_{\text{code}} = 0.06 s_1 + 0.12 s_2 + 0.22 s_3 + 0.08 s_4 + 0.06 s_5 + 0.18 s_6 + 0.18 s_7 + 0.10 s_8. \tag{6}$$
Table 1 | 八维编码质量分因子
| 因子 | 含义 | 严重度 | 权重 |
|---|---|---|---|
| $N_1$ | C++ 语法糖违规 | B | 6% |
| $N_2$ | Harness 模式违规 | A | 12% |
| $N_3$ | 属性幻觉 | S | 22% |
| $N_4$ | Ranking DSL 检查纠正 | A | 8% |
| $N_5$ | C++ 语法检查纠正 | B | 6% |
| $N_6$ | 正确性循环迭代次数 | S | 18% |
| $N_7$ | 人工算子介入 | S | 18% |
| $N_8$ | Dryrun pipeline 通过 | A | 10% |
各维度被归一化为"越高越好"。对基于计数的失败,$s_i$ 随纠正/违规次数增加而下降。人工介入被当作硬二值门:无人工介入则 $s_7 = 1$,否则 $s_7 = 0$。Dryrun 相对"单次通过"的理想打分:$s_8 = \max(0, 1 - (N_8 - 1)/2)$。三个严重度为 S 的维度(属性幻觉、正确性循环开销、人工介入)合计占总权重 58%,因为它们最直接威胁自治生产可靠性。
2.1.5 Failure Modes¶
打分维度对应具体实现失败。无 schema grounding,agent 可能读到貌似合理但不存在的 item 属性(例:在 schema 工具被强制前,agent 曾发明 author_live_cpm_boost 字段),代码看似合理却读到无效/非预期属性。无 DSL 检查,可能发明算子或以不支持形式传参(典型:创造貌似合理但未注册的 ranking 算子,而注册算子契约要求不同的 scorer 接口)。无 harness-pattern 知识,可能实现 scorer 却没接进 serving pipeline,核心打分文件正确但工厂/队列注册缺失,策略线上静默无效。无 feature-switch 纪律,可能默认启用策略而非藏在 disabled flag 后——无条件分数乘法被当作 safety-by-default 违规。Developing Agent 的目的就是让这些失败在 patch 抵达生产评审前可观测,它为来自 Brainstorm Agent 与 Model Agent 的提案提供仓库级可靠性层,使其成为安全、可检视的代码改动。
2.2 离线模型轨:Model Developing(§5.2)¶
模型架构提案的开发方式不同于在线生产改动。目标不是安全可部署的 patch,而是一个可信的离线训练实验:agent 要实现提出的架构、在生产平台跑真实训练-评估作业、返回一个能被相信的结论。步骤链很长——解读提案、改模型代码、验证改动、向共享集群提训练作业、等结果、解析训练日志、综合结论——每一步都引入潜在失败模式:LLM 误解方向、写下微妙错误代码、幻觉指标、把相关当机制;训练平台贡献 GPU OOM、瞬时基础设施故障、日志 stall。论文给出的一句核心原则:
an LLM is permitted to be wrong only on judgment; every objective fact is produced by deterministic code.(LLM 只允许在判断上出错;每一个客观事实都由确定性代码产出。)
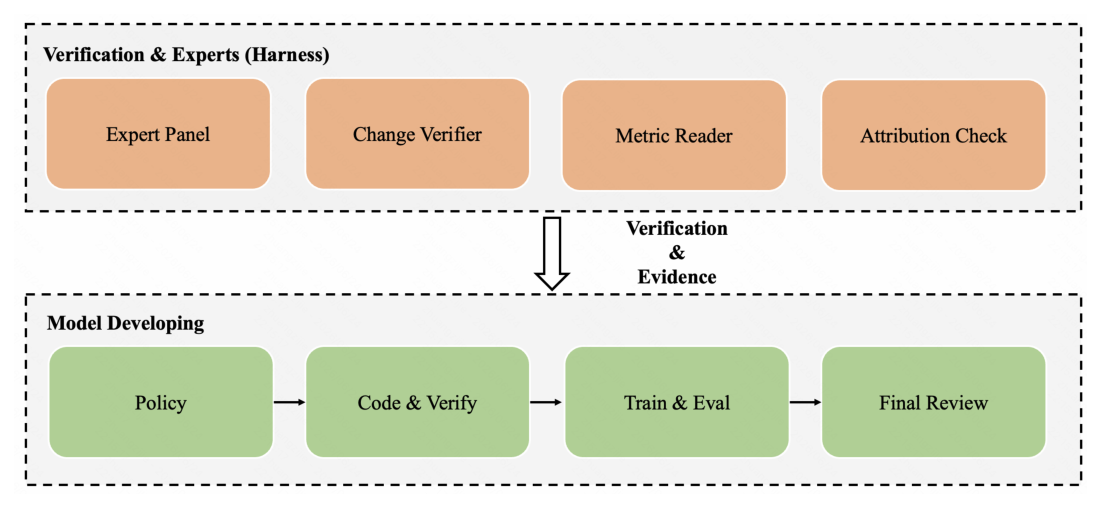
2.2.1 Single-round pipeline¶
研究循环的每一轮遵循结构:
$$\texttt{policy} \rightarrow \underbrace{(\texttt{code} \leftrightarrow \texttt{verify})}_{\leq 3\ \text{rewrites}} \parallel \underbrace{\texttt{experts} \times N}_{\text{concurrent}} \rightarrow \texttt{exec} \rightarrow \texttt{final\_review}. $$
- policy:不止声明改什么,还声明所主张的因果机制与一组预期可观测量(expected observables)——每个被精确命名,使 code agent 能把它接进
tf.print或tf.summary,并描述健康 vs 病态行为长什么样(例:"gate activation > 0.5 after step 1000 表示 live gate;≈ 0 表示 collapse")。这迫使本轮预先承诺如何被证伪,而非事后解读结果。 - code:在指定文件边界内实现 policy。verify 检查两件事:结果
git diff在语义上匹配 policy 方向;每个声明的 observable 名出现在 diff 中。任一检查失败则 code agent 重写(最多三次),耗尽预算则干净地让本轮失败,而非带着未验证代码继续。 - expert agents:并发独立评估 policy,只读 policy 文本与各自私有知识库,与历史及彼此意见物理隔离。专家共识由 Python 计票(超多数 $\geq \lceil 2N/3 \rceil$),从不由 LLM 计。
- exec:纯 Python 状态机,无 LLM 参与,通过提交、轮询、评估、指标提取(正则从原始训练日志拉 AUC)流转。此处排除 LLM 是刻意的:指标提取是有正确答案的模式匹配问题,幻觉 AUC 数字传进知识库的代价很高。
2.2.2 Falsifiable attribution(可证伪归因)¶
final review 综合指标、专家意见、训练日志为一个裁决,并逐链裁决声明因果链的每一环——verified / broken / unclear——通过把训练日志观测对照 policy 里声明的 observable 来判定。Python 再确定性折叠:所有链 verified → 归因状态 CLEAR;任一 broken 或 unclear → UNCLEAR。裁决与归因状态分离很关键:一轮 AUC 提升但归因不明者是刹车信号——系统不传播未归因增益。
论文用 RankMixer backbone 上的实验说明这一约束为何必要:第 1 轮复现某论文的乘法门 $\mathbf{x} \cdot \tanh(\mathbf{V}_o \mathbf{x})$,代码正确、AUC 小增 +0.0003;但声明的 gate-activation observable 全程近零——分析确认 Glorot 初始化的 $\mathbf{V}_o$ 产生 $\mathbf{V}_o \mathbf{x} \approx \mathbf{0}$,导致 $\tanh(\cdot) \approx 0$,门输出归零、梯度被完全阻断。归因状态 UNCLEAR,该增益未被记录。第 2 轮用一行残差修复 $\mathbf{x} \cdot (1 + \tanh(\mathbf{V}_o \mathbf{x}))$——当 $\mathbf{V}_o \approx \mathbf{0}$ 时退化为 identity、恢复梯度流——返回 $\Delta\text{AUC} = +0.0022$ 且所有因果链 verified。
2.2.3 Robust execution under platform failures(平台故障下的鲁棒执行)¶
生产训练环境里许多失败与提案本身无关:GPU OOM、集群作业 stall、基础设施连接超时。若一律对待(总重试或不重试),系统要么在根本损坏的配置上浪费算力,要么被瞬时噪声杀死。执行 agent 因此对每个失败先分类再决定如何响应:纯函数分类器读日志头(8 MB)、日志尾(256 KB)、从中段采样的至多 64 行 FATAL,把失败映射到具体 reason code。确定性错误(NaN 梯度、特征表冲突、缺失评估 checkpoint)立即放弃——重试无助;瞬时故障(指尾字节数与 hash 指纹识别的日志 stall、基础设施 abort)重试一次;LLM gateway 故障轮换到下一个可用 gateway。分类器按固定优先级评估 reason code:像 ps_aborted 这种可能掩盖底层确定性错误的基础设施症状总是最后评估,防止 schema bug 被误判为可恢复瞬时故障。一个 detached watchdog 守护进程对一批内所有活跃 run 应用同一策略,无人工介入地自愈卡住/失败的 run。每个被放弃的 run 显式记录 reason code(如 given_up:nan_train),使根因立即可读。
三、Evaluation Agent:把噪声流量变成可信奖励¶
Evaluation Agent 闭合 AgentX 的生产闭环:它决定 Developing Agent 物化的代码改动应被保留、回滚、还是作为负面教训回灌下一轮。其角色不只是报 A/B 数字,而是把噪声、延迟、部分可观测的线上流量转成系统其余部分可据以行动的可信奖励信号,并转成塑造未来迭代的可复用约束。
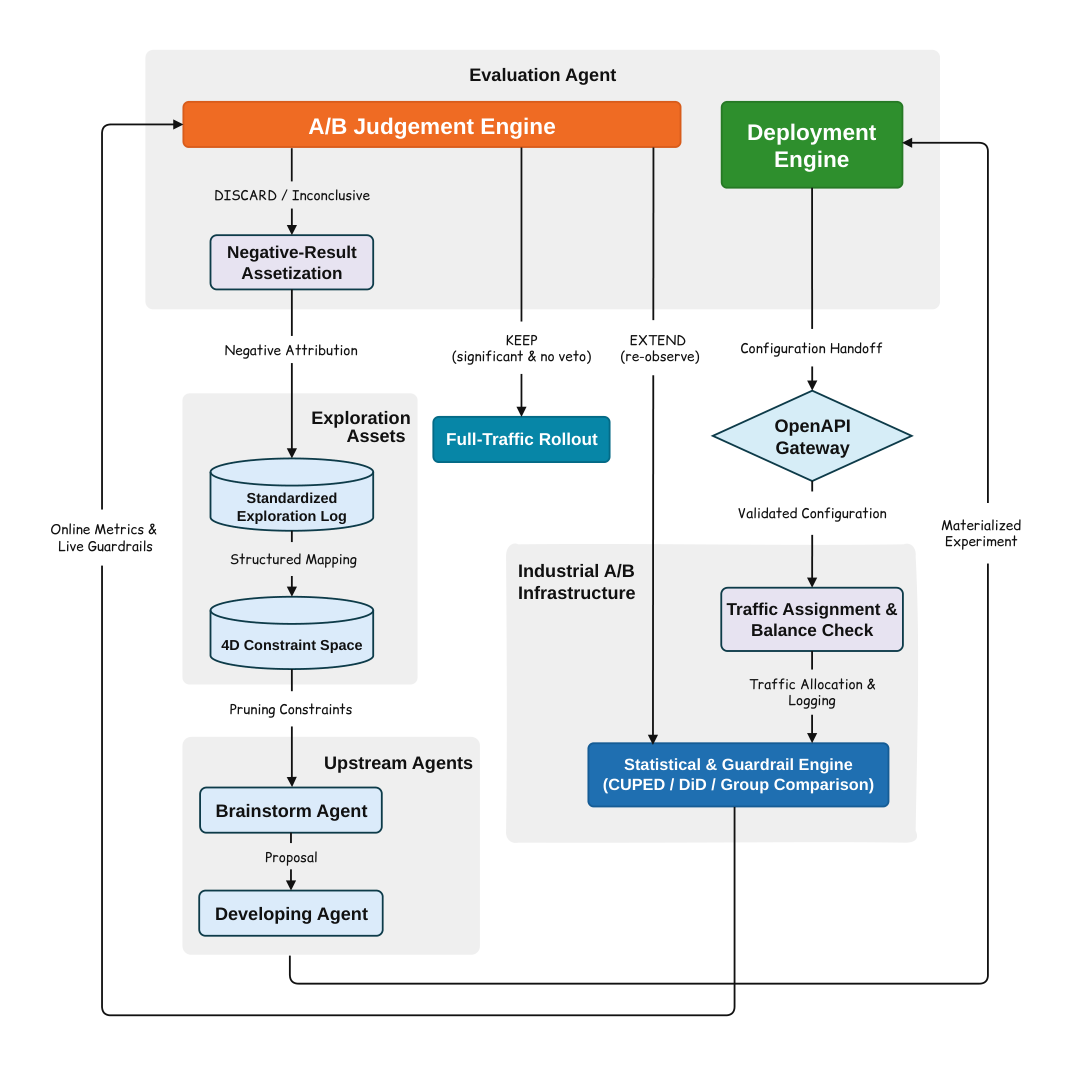
3.1 The Real-World Reward Problem¶
在 Brainstorm 提案、Developing 物化之后,系统仍不知道该变更是否值得保留。离线代理与自我反思在推荐系统中不充分:一个策略可能改善内部分数却损害长期用户体验,或在小切片上看似有前景却破坏 guardrail 指标。AgentX 因此把线上 A/B 反馈作为系统迭代的权威奖励信号。这造成第二个可靠性问题:agent 必须安全地上线实验、不污染其他实验、读噪声线上指标、施加严格上线标准、把负结果转成可复用记忆。
3.2 Safe Deployment and Traffic Assignment¶
实验产生奖励前必须安全进入流量。工业推荐通常把请求路由经多个业务域、layer、world、bucket range、split factor。不尊重此拓扑而上线自动生成策略,会引发参数冲突、跨实验污染、不一致的用户分配。Deployment 层把每个实验映射到正确业务域与 world,选合适 split factor,分配互斥流量桶。对 account-bound 实验按 user ID 路由;对 device-side 体验改动用 device ID;对混合人群用 UID-first 策略(登录用户保持一致性,匿名流量回退 device 身份)。当桶分配欠定时,agent 做实验前 balance check,选基线失配最小的流量组。安全控制在上线前施加:参数改动必须过工程白名单(agent 不能改未授权的调度或 serving 控制);配置上线走 canary 路径——API 提交改动后系统先观测一个最小灰度窗口再升全量;监控检测到不稳定则在实验变成大规模线上风险前halt。
3.3 A/B Judgement with Guardrail Veto¶
流量上线后,agent 必须判定观测效应是否可信。线上数据噪声、延迟、有时部分缺失。Evaluation Agent 把指标提取与决策逻辑分离:有实验前历史时用方差缩减方法如 CUPED;当数据环境不满足其假设时回退到更鲁棒的 difference-in-differences(DiD) 或直接组对比;上游数据缺失时收缩或平移观测窗口,而非把不完整查询当结论。
决策策略刻意保守,guardrail 设计遵循三原则以控制 false negative:
- Guardrails 是业务 scoped 而非普适:每个业务域(消费、直播、电商、广告)有自己的核心指标与 veto 阈值;一个域的实验不受全系统所有 guardrail 的并集约束,主要对其所在域的 guardrail 指标 + 一小组跨域稳定性指标负责。
- Guardrails 用复合经济交换(economic-exchange)指标而非单指标 veto:不在任何单指标越线时阻断,而是计算一个聚合的 lifetime-value(LT)交换分(把若干业务目标加权为统一摘要);单个 guardrail 指标负向移动不自动触发 veto,agent 看的是复合全局图,大幅降低噪声驱动的 false negative,同时仍能捕获真正损害生态的策略。
- 阈值是注意力信号而非绝对阻断:guardrail 阈值的主要作用是给人工评审标记风险,而非机械丢弃实验;触发时策略被升级(escalate)而非自动丢弃。一个高收益策略即便触发中度 guardrail 恶化,仍可经例外评审路径推进——只要增益大到足以正当化外部性。这种分层(严重恶化硬阻断、中度信号升级、观测指标仅监控)防止系统过度保守同时维持安全。
分析阶段的输出因此不是单一数字,而是一个结构化裁决:KEEP / EXTEND / DISCARD,连同 primary effect、guardrail status、统计方法、观测窗口、caveats。这个结构化裁决就是后续阶段消费的奖励记录。候选只有当主目标同时清过最小效应阈值与统计显著、且 guardrail 评估确认无不可接受的跨域损害时,才有资格 KEEP。
3.4 Negative-Result Assetization(负结果资产化)¶
大多数生产实验不会成为成功上线。对 AgentX 这不是浪费——一个负结果若能记录策略为何失败并阻止未来 agent 重走同一条路,就是有用的。Evaluation Agent 把 DISCARD 与 inconclusive 结果转成探索资产。每个失败实验都带根因写入(missing significance、guardrail deterioration、traffic mismatch、business-context mismatch),并按 pipeline stage、business objective、affected user/content segment、strategy lever 索引(即 4D Constraint Space)。下一轮 brainstorm 或 analysis 前,AgentX 可检索这些资产以避免重新发现失败方向(例:若某 boost 策略曾损害低频用户的留存 guardrail,同一坐标组合就成为未来提案生成的高风险区域)。这一资产化步骤闭合了闭环:线上 A/B 决定哪些变更存活,负结果决定哪些未来分支该被更谨慎地剪枝或探针。Evaluation Agent 因此同时供给奖励信号与失败记忆,使 AgentX 的自迭代 grounded 在真实生产反馈而非模型自评。
四、AgentX Harness Evolution:SGPO 自进化层¶
生产实验分析只捕获 AgentX 反馈闭环的一面。尽管 Experiment Analysis Agent 成功诊断线上结果、记录失败方向、把 A/B 反馈翻译成可复用记忆,它留下一个关键缺口:它不解释为何一个上游 agent 没能捕获正确约束、漏了 business-causal chain、产出不完整交接、或生成违反仓库约定的代码。为弥合此缺口,AgentX 引入第二个优化层,作用在执行轨迹上。优化目标不是推荐策略本身,而是控制每个 subagent 如何推理、提问、验证、交接、从失败恢复的 harness。
论文在严格受限意义上使用 harness 一词。完整运行 harness 含顶层编排、记忆、工具接口、跨 agent 协议、subagent 指令;但当前生产安全版本一次只更新一个 subagent 级的 harness 规约。进化运行期间,基础模型、工具接口、顶层编排、其他 subagent 保持固定,只编辑目标 subagent 的指令、验证规则、输出契约、工具使用纪律。这一设计确保更新完全可检视,并让 old-vs-new replay 有意义:任何分数变化都能被隔离到一处局部 harness 编辑,而非席卷式系统重写。为此论文引入 Semantic-Gradient-based Prompt Optimization(SGPO)——一个离线 harness 进化方法,把累积执行轨迹转成局部 subagent prompt 更新,仅经 paired replay 准入。简言之,SGPO 把对轨迹失败的自然语言诊断当作语义梯度,在 AgentX 其余部分固定的前提下修订单个 subagent 规约。
4.1 SGPO-I:基于会话轨迹的 harness 进化(§7.1.1)¶
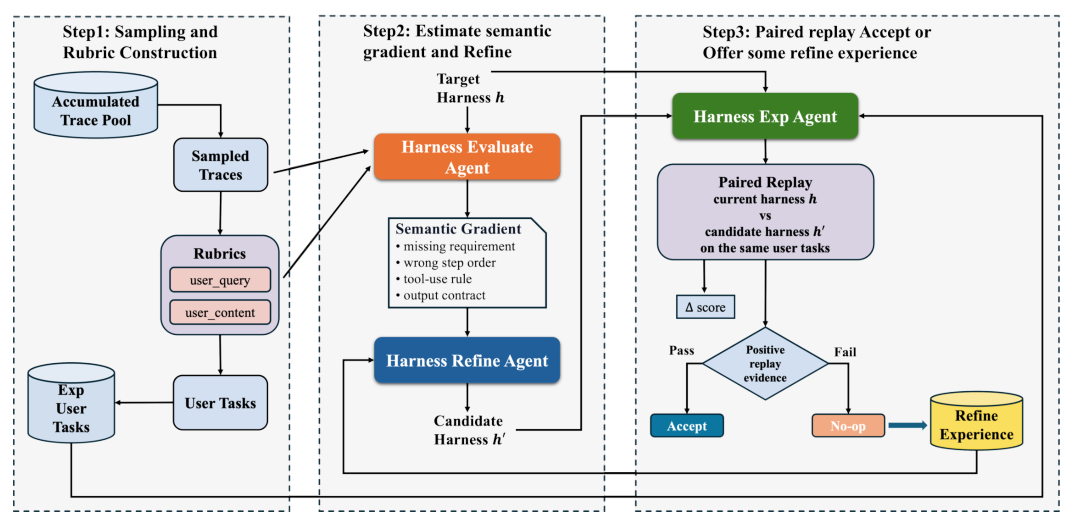
SGPO-I 用会话轨迹作为证据源。设 $h_{t,i}$ 为目标 subagent $i$ 在进化轮 $t$ 的当前 harness 规约。每轮从累积的线上轨迹池采一小批与 subagent $i$ 相关的轨迹。评估器不逐字读完整会话,而是从初始用户 query 与后续用户输入抽取紧凑 rubric(这些字段通常含显式任务约束与交互中揭示的隐式约束)。
第一步 loss 计算:给定当前 harness、采样轨迹证据 $\mathcal{T}$、抽取的 rubric $\mathcal{R}$,评估 agent $E_{\text{agent}}$ 先写一份自然语言 loss 报告,再凝练为语义梯度 $g_{t,i}$:
$$\ell_{t,i},\ g_{t,i} = E_{\text{agent}}(h_{t,i};\ \mathcal{T},\ \mathcal{R}). \tag{7}$$
语义梯度 $g_{t,i}$ 不是数值导数,而是对缺失约束、弱步骤排序、欠规约证据要求、不完整下游契约的结构化诊断。
第二步语义梯度更新:精炼 agent $R_{\text{agent}}$ 把梯度转成局部 harness 编辑,产出候选修订 harness:
$$h'_{t,i} = R_{\text{agent}}(h_{t,i}, g_{t,i}). \tag{8}$$
精炼限于目标 subagent 的指令、验证规则、输出契约、工具使用纪律,不重写完整 AgentX harness。
第三步 paired replay 准入:$h'_{t,i}$ 生成后,SGPO 立即在同一组 replay task 上评估新旧 harness。replay task 集由同一轨迹池生成(LLM 把用户 query 与后续输入重写为独立用户任务,保留业务域、目标、guardrails、允许变更类型、预期 artifact、已知约束,去掉对早先对话上下文的依赖)。AgentX 用旧 harness $h_{t,i}$ 与候选 $h'_{t,i}$ 在相同任务下重跑,评估器用同一 rubric family 给两者输出打分:
$$\Delta J_i = \text{ReplayScore}(h'_{t,i}) - \text{ReplayScore}(h_{t,i}), \qquad h_{t+1,i} := h'_{t,i}\ \text{ if } \Delta J_i > \epsilon \wedge \text{Safe}(\Delta h_i). \tag{9}$$
$\Delta J_i$ 是 paired-replay 改进、$\epsilon$ 是准入阈值。若 $\Delta J_i > \epsilon$ 且安全检查保留 schema 兼容性、工具边界、human-review 约束,候选更新被接受、$h'_{t,i}$ 在下轮作为 $h_{t,i}$;否则不更新目标 subagent,被拒 patch、评估分、失败解释作为 refine experience 留待后续轮次。
生产案例(Table 2):SGPO-I 应用于想法生成阶段,此处失败常表现为模糊目标、缺证据 grounding、重复方向、下游 validation/coding agent 无法直接消费的 artifact。归一化 replay 分从 75.15% 提升到 98.00%。最重要的被接受编辑不是通用 prompt 润色,而是具体契约改动——如在想法生成前显式化任务契约、要求每个候选暴露 business-causal chain。
Table 2 | brainstorm subagent 的 SGPO-I 进化轨迹
| 轮 | 编辑焦点 | harness 含义 | 平均分 | 归一化 |
|---|---|---|---|---|
| 1 | Task contract normalization | 在生成候选前重述业务域、目标指标、scope、human-review 要求、硬约束、缺失信息 | 3.76 | 75.15% |
| 2 | Evidence grounding | 要求显式证据索引、标记不可用证据而非静默靠直觉 | 3.89 | 77.82% |
| 3 | Candidate-quality schema | 把每个想法标准化为 problem source / business-causal chain / strategy formula / implementation point / dry-run checks / risk | 4.53 | 90.67% |
| 4 | Novelty and rejection | 把 same-theme-but-new-point 想法与重复优化点分离,记录被拒方向及理由 | 4.87 | 97.33% |
| 5 | Evaluable handoff | 产出候选总览、优先级、validation/coding 字段、不支持项、每个想法的评估标准 | 4.90 | 98.00% |
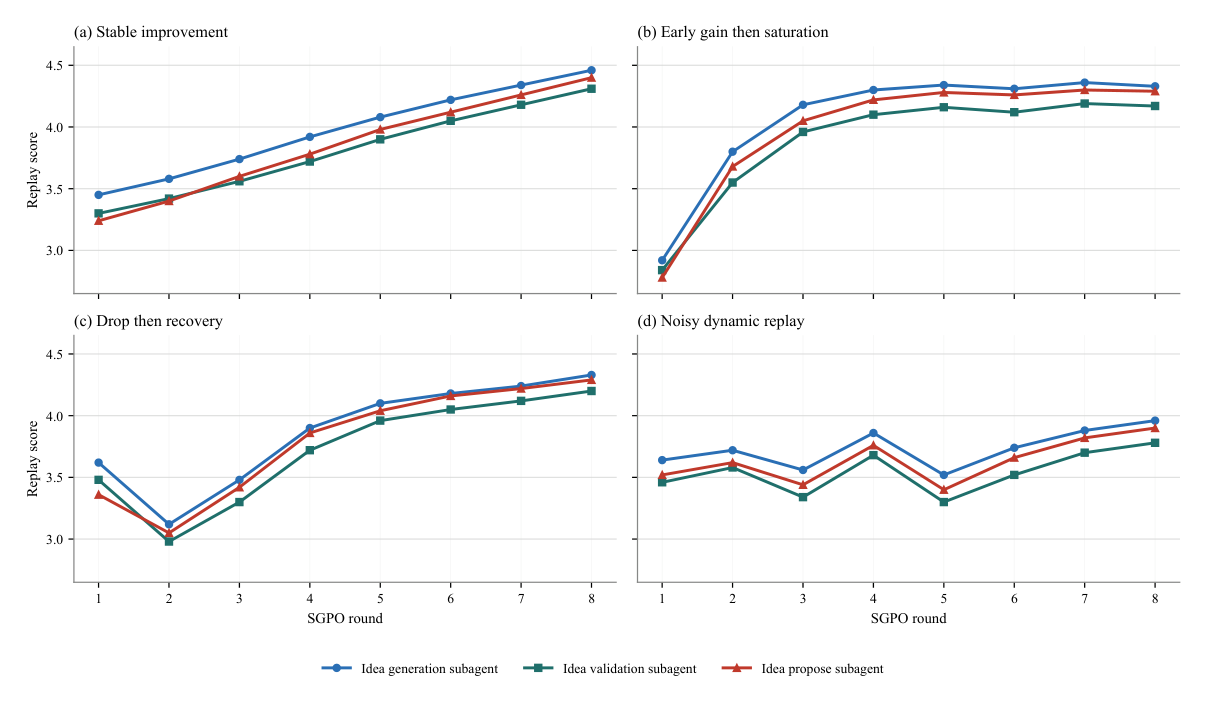
论文强调:SGPO-I 不必然单调——一轮可能稳定增益、早期饱和、暂时回退、噪声恢复(Figure 8 四种模式)。这意味着 SGPO-I 应被理解为一个 gated search 过程而非单调优化器。暂时掉分是预期的,因为每轮采新轨迹、重生成 rubric 与 replay task。关键性质不是每次更新都改善每个 replay set,而是 paired replay 在准入前暴露回退。
4.2 SGPO-II:基于编码 replay 的 harness 进化(§7.1.2)¶
作为 SGPO-I 的扩展,SGPO-II 把证据源从对话轨迹换成源自历史已合并请求(merged requests, MR)的编码 replay case。这是必要的,因为 developing-agent 失败是长程且仓库特定的:生成 patch 可能满足表面需求却违反 ownership 边界、feature-flag 纪律、local helper 约定、rollback 预期、确定性验证规则。MR 历史因此充当编码轨迹池。replay 前 SGPO-II 过滤该池以去除噪声 / 陈旧 / trivial / 大块改动:包括 bulk reformat、revert、依赖 bump、<10 行改动的 patch、>5000 行重写、生成文件为主的改动、以及原始 diff 上下文在当前代码库已不存在的 MR。保留的是 human-approved、仓库上下文仍存活的代码改动。
Table 3 | 编码 patch replay 的五个评估维度
| 维度 | 权重 | 标准 |
|---|---|---|
| Semantic Correctness | 40% | 核心逻辑语义等价于 ground truth;边界条件正确(硬门:score ≥ 4 required) |
| Requirement Coverage | 25% | 需求规约中所有验收标准被满足 |
| File Coverage | 20% | 改动文件集与落地 patch 一致;无显著遗漏 |
| Safety by Default | 10% | 新行为藏在默认禁用的 feature flag 后;对已有逻辑无无保护改动 |
| Code Style Consistency | 5% | 命名、结构、注释遵循仓库约定 |
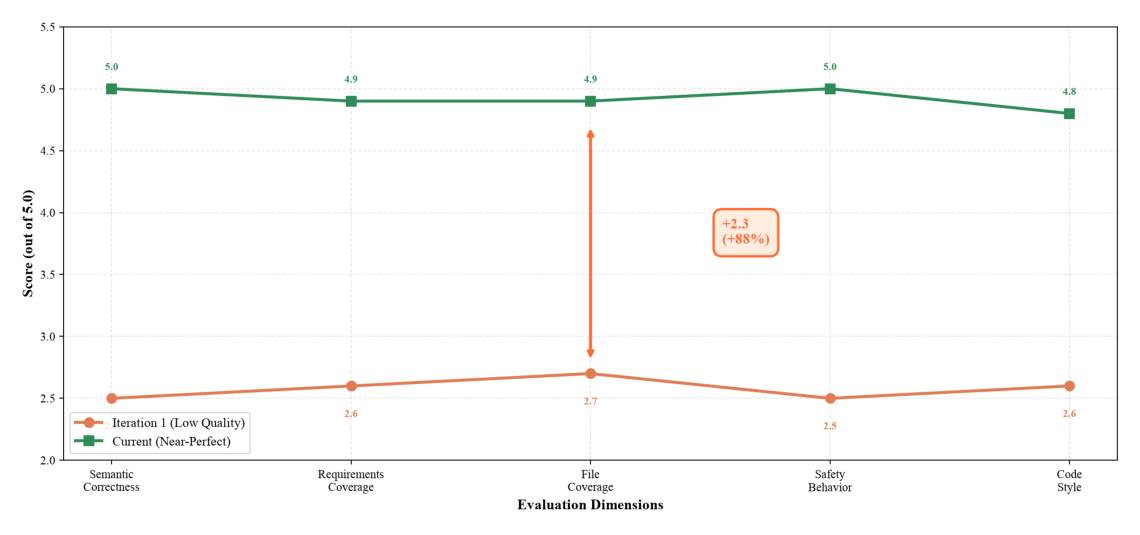
从清洗后的池,SGPO-II 采 replay case,把每个保留 MR 转成 requirement-only task(类比 SGPO-I 的用户任务)。落地 patch 对 Developing Agent 隐藏,只在 agent 产出实现后供评估器作参考。case 以 batch size 5 合成,每个 case 在从 MR base commit 初始化的干净分支上尝试。评估器只在加权聚合分 $\geq 4.0$ 且 Semantic Correctness $\geq 4$ 时通过 case。replay 失败时评估器把失败概括为语义梯度并传给 Harness Refine Agent(类比 SGPO-I),后者把梯度转成 Developing Agent harness 规约的局部更新——具体地精炼其执行规则、evaluator lessons、pattern memory、确定性 precheck。SGPO-II 因此保留同样的梯度优化范式,只把会话轨迹换成仓库 grounded 的编码证据。
SGPO-II 案例研究(Table 4):应用于一个需多文件协调、异步回调流管理、全面错误处理的复杂异步模块。harness 从早期失败累积项目特定约束后,整体分从 2.60 提升到 4.90(+88%)。
Table 4 | SGPO-II 复杂异步模块自进化前后
| 维度 | 失败描述(Iteration 1) | Before | After | Δ |
|---|---|---|---|---|
| Semantic Correctness | 异步回调协调不完整;方法偏离参考 | 2.5 | 5.0 | +2.5 |
| Requirement Coverage | 关键异步路径缺失;实现碎片化 | 2.6 | 4.9 | +2.3 |
| File Coverage | 多文件修改不完整;co-change 缺失 | 2.7 | 4.9 | +2.2 |
| Safety by Default | 多路径错误处理不完整 | 2.5 | 5.0 | +2.5 |
| Code Style Consistency | 格式与命名约定不一致 | 2.6 | 4.8 | +2.2 |
| Overall (weighted) | 2.60 | 4.90 | +2.30 |
论文也诚实地记录:迭代管线并非所有输入都单调。评估集中观察到少数回退(一个匿名例子分数从 3.67 掉到 1.80,$\Delta = -1.87$,最终 FAIL 判定)。这类回退出现在困难或边界条件 case——LLM-as-judge 误诊失败模式、提出与已有约束冲突的 harness 编辑。论文显式保留而非过滤这些回退:它们留在评估记录里以刻画方法局限、指导后续改进。关键地,paired-replay 准入门($\Delta J > \epsilon$)防止回退性 artifact 进入被接受 harness 状态——一个在候选 harness 下打分更差的 case 被拒,judge 的误诊只产生 no-op 而非永久退化。这使 SGPO 的可靠性取决于准入门而非评估器的绝对可靠。
4.3 演化模型研究探索管线(§7.2)¶
SGPO 演化 agent 如何推理(编辑单个 subagent 的 harness)。第二条进化轴关注系统探索什么——模型架构方向的空间本身。这里 harness 固定,改进的是搜索空间:每个实验裁决重塑下一轮生成哪些方向。答案是一个三阶段穷举循环,每阶段基于上一阶段的结论。
三阶段探索:
- Phase 1:对每篇论文生成一个复现提案(针对其证据最干净的发现),分派到 §5.2 执行管线,结果按对生产 baseline 的平均 $\Delta$AUC 聚合排名。top-$K=16$ 论文进 Phase 2,同时记录每个 top-$K$ 论文哪些模块被标
ablatable。 - Phase 2:隔离每个模块的贡献。对每个 top-$K$ 论文的每个可消融模块,系统枚举两种实现(原始
orig_choice与 LLM 推断的替代),构造只激活目标模块、把其余所有 top-$K$ 增项回退为 baseline 等价的 bundle。隔离是刻意严格的:原论文里的 bundled 评估常掩盖到底哪个组件真正驱动增益。一个模块只有产出正 $\Delta$AUC 才被确认有效。 - Phase 3:跨论文组合。常规轮把每个 top-$K$ 论文的 lineage 用尚未在其 lineage 里的最高-delta 已确认模块扩展,组合源自不同论文的技术。为防搜索过早收敛到一小簇结果,challenger 轮(每四个常规轮触发一次)把 top effective 模块应用到排名 17–32 的论文,维持探索空间多样性。
Memory-guided pruning(记忆引导剪枝):对 1312 篇论文及其模块做朴素穷举搜索计算上不可行,且会重访已被证无效的方向。系统通过持续更新两层剪枝决策避免:在 paper level,若某结果在生产设置中证伪了一篇论文的核心前提,该论文的所有模块被排除出 Phase 2/3(RankUp 论文是具体例子:完整复现得 $\Delta\text{AUC} = -0.0203$,训练日志观测直接矛盾其"effective-rank 正则化改善在线训练表征"的前提,于是被记为 paper-level prune,并加一条 anti-pattern:在投入模块级消融前先验证结构前提在生产成立)。在 module level,Phase 2 里被确认无独立贡献的消融把该模块排除出 Phase 3 组合。Saturation detection 提供全局停止判据:当 novelty-signature 重复率(对离散化架构字段的 SHA-1 hash)连续两轮超过 80%,循环终止而非生成结构冗余的实验。
Experience flywheel(经验飞轮):驱动剪枝的结论本身被 curated 而非盲信,这是 §6.4 负结果资产化的离线实验对应物——探索循环把每个完成训练轮(成功或失败)转成结构化事件追加到 append-only event log,知识库是该 log 上的视图。教训组织为 anti_patterns(失败模式,各带 log 与 diff 正则以识别未来类似失败)与 playbook(成功配方,$\Delta\text{AUC} > 0.001$ 时记录)。并非每个实验结果都可靠到能据以行动:单次成功可能是幸运超参交互、单次失败可能是瞬时环境问题。为从噪声中过滤信号,每个候选经验条目在被注入未来轮前要过两个门:threshold gate(要求至少两个独立 run 的证据)与 adversarial review gate(一个专门 agent 唯一任务是证伪声明的因果机制——存活的成为 confirmed,争议的成为 contested(带警告注入),被证伪的永久排除)。这与 AgenticRecTune 的 Skillhub 形成对比:后者直接从 A/B 结果蒸馏经验,但单凭结果不解释为何有效,一个无法解释自身机制的经验条目是负债——可能泛化差、或编码虚假相关污染未来决策。在知识库层面要求验证过的因果解释才能晋升,正是把可证伪归因应用到的同一标准。
4.4 Discussion(§7.3)¶
SGPO 把 agent 改进当作一个离线、可 replay 的系统优化问题,与在线实验分析互补:实验分析解释一个推荐策略是否有效,SGPO 解释当轨迹本身揭示反复弱点时 agent harness 该如何变。当前实现刻意保守:一次更新一个 subagent 规约、冻结其余运行 harness、仅经 paired replay 准入。这使更新路径比无约束自我编辑更慢,但对生产推荐 workflow 更安全——一处过宽的 harness 改动可能污染下游实验 artifact。
五、实验¶
5.1 生产度量与闭环性能(§8.1)¶
论文围绕三个研究问题,用一次三周部署收集的单一证据体回答:三个 AgentX worker 在 Kuaishou App 的两个生产场景(主 feed 推荐 + 生活服务商业化)并发跑 idea-to-rollout 闭环。
- RQ1:AgentX 是否缩短 idea-to-rollout 周期?
- RQ2:AgentX 是否交付更多 per-worker rollout-level 结果?
- RQ3:AgentX 上线的实验是否交付可度量的线上指标增益?
监控平台把每个闭环节点(idea pass、code-and-launch、positive evaluation)记录为显式状态转移,其中 positive evaluation 指有资格全量上线的实验(即 launchable result, LR)。
Table 5 | AgentX idea-to-rollout 闭环的节点级转化率与计数
| 场景 | Ideas | Idea Pass | Code-&-Launch | Positive Eval. | LR |
|---|---|---|---|---|---|
| Main Feed | 361 | 27.7% | 95.0% | 8.4% | 8 |
| Life Service | 13 | 46.1% | 83.3% | 40.0% | 2 |
| Overall | 374 | 28.34% | 94.3% | 9.9% | 10 |
闭环形成链式转化漏斗,每阶段以上一阶段成功为条件:
$$374 \xrightarrow{\text{idea pass } 28.34\%} 106 \xrightarrow{\text{code\&launch } 94.3\%} 100 \xrightarrow{\text{positive eval } 9.9\%} 10. \tag{10}$$
两条业务线在此公式下内部一致:$361 \times 27.7\% \times 95.0\% \times 8.4\% = 8$(Main Feed),$13 \times 46.1\% \times 83.3\% \times 40.0\% = 2$(Life Service)。
什么阻塞了想法进入编码与上线? Table 6 把 268 个被拒想法划入互斥分类,揭示一个惊人的不对称:看似是 agent 责任的失败其实集中在 agent 之外。
Table 6 | 268 个未过 VALIDATE 门想法的分类拒绝理由(按优先级 A→B→C→E→D→F→Z 每个想法归一类)
| ID | 拒绝类别 | 占比 |
|---|---|---|
| A | Parameter-resource conflict(目标参数已被 holdout combo / in-flight 实验 / 不同 traffic world 占用) | 64.7% |
| B | Pre-condition enable flag off |
6.4% |
| C | 违反硬约束 / 白名单 / 能力边界 | 7.5% |
| E | 不可行实现 / 参数不在 live DSL world / 缺前置代码 | 0.6% |
| D | 与历史实验重叠 | 5.2% |
| F | 弱假设 / guardrail 风险 / null-result 风险 | 1.2% |
| Z | 缺失 user/item 属性(信号未在生产 feature store 暴露) | 14.5% |
仅 AB 平台的 parameter-resource conflict 就占全部拒绝的 64.7%——想法技术上合理却无法在生产流量上物化。三个相邻操作摩擦(B 软开关疏忽 6.4%、D 历史 launchable/in-flight 重复 5.2%、E 不可行 0.6%)再贡献 12.2%。再加 14.5% 落在数据基础设施侧(信号未暴露)。综合起来,平台与基础设施约束吸收了 91.4% 的拒绝,而真正的 agent 错误(C 硬约束/白名单违规 7.5% + F 弱假设 1.2%)只占 8.7%。两点含义:闭环瓶颈是操作性而非算法性——单是闭上 A 类 gap 就能恢复约 2/3 当前损失的想法;最高杠杆的下一步不是更聪明的 agent,而是一个上游 conflict checker,在头脑风暴前查询 AB 平台状态,使资源锁定参数从一开始就不进入候选池。
残差编码循环失败集中在哪? Table 7 暴露同样的不对称:超 95% 的编码失败是基础设施侧而非 agent 侧。框架语法违规——debug 分支上的 DSL wiring(CA, 35%)、MaTX/C++ 约束(CB, 20%)、if/else 结构(CC, 15%)——吸收 70% 的编码失败;toolchain 与环境摩擦(CD+CE)再加 20%。真正的算法错误占不到 5%。结论与 Table 6 一致:残差损失追溯到本可前置为模板的框架约定,而非 agent 的推理质量。
Table 7 | CODING 阶段观测到的分类失败模式
| ID | 编码失败类别 | 占比 |
|---|---|---|
| CA | DSL / force-enable wiring error on debug branch | 35% |
| CB | C++ / MaTX compiler constraint violation | 20% |
| CC | Mis-structured if/else branches across parallel ideas | 15% |
| CD | Dryrun state-machine misjudgment | 10% |
| CE | Local validation environment unavailable | 10% |
| CF | dryrun-mr launch-contract or dirty-worktree violation | 5% |
| CG | Log-parsing artefact masquerading as a code bug | 5% |
RQ1:AgentX 通过把串行 workflow 变成并行 pipeline 缩短 idea-to-rollout 周期。 人工 workflow 把生命周期当单条串行链执行:每个想法阻塞下一个,吞吐被最慢交接 cap。AgentX 通过解耦提案、编码、上线、监控为独立 worker,把链重构为并行 pipeline,不同想法在同一时刻占据不同阶段,每想法有效周期时间因此塌缩为最忙阶段而非所有阶段之和。三个 worker 三周内把 374 个想法带过闭环,per-worker 并发吞吐每周约翻倍(经 skill 巩固、pitfall 累积、dryrun-template 成熟自进化)。三周窗口内每个 AgentX worker 平均维持约 12 个并发实验,对比传统人工 workflow 的工程师 1.5——即 8× 单 worker 增益。
RQ2:AgentX 通过在人工评审下自动化闭环两端,交付更多 rollout-level 结果。 前端 brainstorm agent 并行产候选并经评审门,工程师 curate 高量想法流而非手写每个;只有 28.34% 想法过评审存活,人力被提升到"想法选择"。后端 developing agent 是决定性杠杆:把想法变成清过 dry-run 验证的可部署代码,是人工 workflow 最劳力密集、最易失败的步骤;把 code-and-launch 率提到 94.3%,让工程师聚焦评审而非执行。三周内三个 worker 把 374 想法转成 10 个 launchable 结果(端到端转化 $10/374 \approx 2.67\%$,约 3.3 LR/worker)。论文不声称 per-idea 质量持平——senior 工程师在 per-idea 命中率上仍约 1.9× 领先(人工想法手挑预筛)——AgentX 刻意用 precision under scarcity 换 volume under automation:在 worker-week 粒度产出 0.0623% 累积 app-time 增益 对工程师的 0.0167%,即 3.7× 单位人力实现业务价值。
Table 8 | Per-worker 生产力与并发:AgentX worker vs 算法工程师(传统人工迭代)
| 指标(per worker · week) | AgentX | Engineer | Ratio |
|---|---|---|---|
| Concurrent experiments | 12 | 1.5 | 8× |
| LR Count | 1.1 | 0.08 | 13.8× |
| Cumulative app-time gain produced | 0.0623% | 0.0167% | 3.7× |
| Per-idea rollout conversion rate | 2.7% | 5.1% | 0.53× |
RQ3:AgentX 上线的实验交付可度量线上增益,且其量随算力 scale。 系统端到端产出 10 个 launchable 结果(主 feed 361 想法出 8 个、生活服务 13 想法出 2 个),转化为可观业务收益:
- Main Feed:Kuaishou App 用户消费时长累积增益 +0.561%。
- Life Service:Kuaishou 平台年化收入 超 RMB 100 million(1 亿元)。
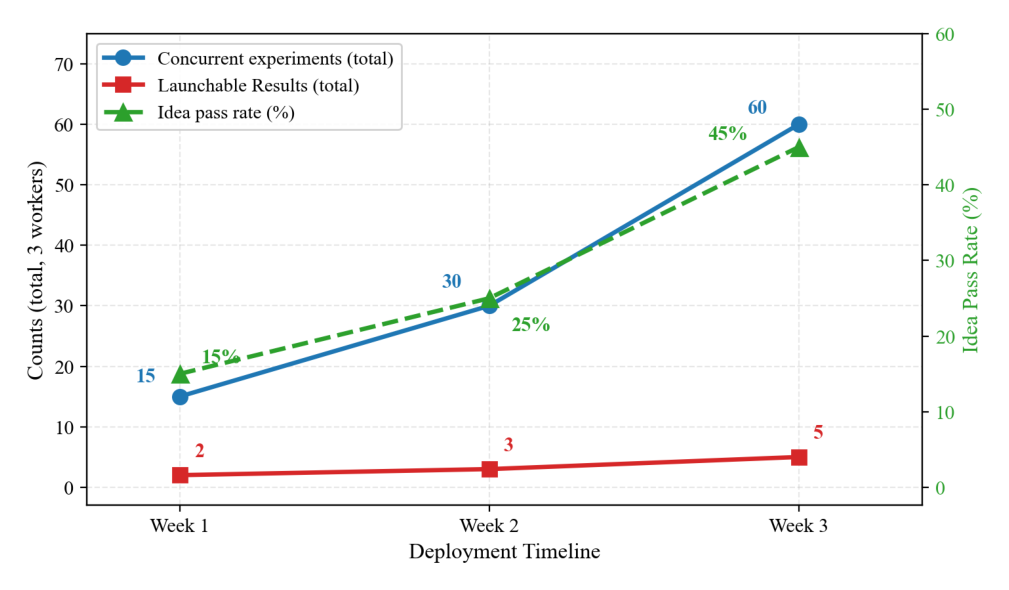
如 Figure 10,自进化同时扩张吞吐并收紧选择性。因人力被限于评审与决策、每个执行重的阶段被自动化,rollout-level 结果的量不再被 headcount 约束,而主要由分配给闭环的算力决定。吞吐大致随 worker 数线性 scale(每增一个 worker 按此处观测的 ~1.1 LR/worker/week 贡献),ramp 阶段系统自进化又复合一个额外的每周翻倍。本研究展示的业务价值因此沿两条互补轴扩张:更多 worker(算力线性)与更成熟系统(早期 super-linear)。
5.2 Showcase I:端到端 AgentX 实验(§8.2)¶
最强 showcase 不是单一隔离指标,而是多份 launch-review 文档能被追溯到一条自治研究路径:提案生成、可行性检查、实现、在线实验、事后分析。
PCV-enhanced constrained fine-ranking score(PCV 增强的约束精排分):此 launch-review case 展示 AgentX 如何经闭环多 agent 改进一个机制级排序想法。主目标是提升 Kuaishou 主 feed 用户观看时长,同时保持 user real-show 稳定。为此引入 PCV(post-consumption value,消费后价值) 作为附加排序信号,捕获视频消费后的行为(分享、收藏、复看),可指示超越即时观看/点击信号的持久内容价值。但 PCV 也有风险:高 PCV 不总意味高内容质量,低质病毒/标题党内容也可能触发消费后行为。
Loop 1:直接 PCV boosting(Table 9)。Brainstorm Agent 生成五个候选方向,选了 post-consumption-value boosting 作为上线候选。Developing Agent 实现为简单乘法打分公式:
$$S_1 = B_r \cdot (1 + \beta P), \tag{11}$$
$B_r$ 为相关性导向 base score,$P$ 为混合 PCV 分,$\beta$ 为固定 PCV 权重。Evaluation Agent 分析线上 A/B:首版在主时长指标上正但弱——per-capita 观看时长 +0.034%、user 观看时长 +0.021%;但若干诊断指标暗示不稳定——active devices 略负(−0.023%)、18–30 年龄段 device-average 使用 −0.032%、多样性相关指标(兴趣簇、novelty 簇、surprise 簇)小幅负移。诊断结论:直接 PCV boosting 方向有前景但太噪——likely 因为首版无差别 boost 所有高 PCV 内容、未区分高质量消费后价值与噪声/标题党行为,且用了相关性导向 base score + 固定 PCV 权重(对观看时长目标无显式保护、不随用户活跃度自适应)。
Table 9 | Loop 1:Direct PCV boosting – agent 输入输出
| Agent | Input | Output |
|---|---|---|
| Brainstorm | 排序目标:提升观看时长同时保持 real-show 与体验 guardrail 稳定 | 生成五候选(session-budget-aware scoring / duration-preference matching / exploration-exploitation balancing / negative-feedback-sensitive user protection / post-consumption-value boosting),选 PCV boosting,假设现有精排分对反映长尾内容价值的消费后行为利用不足 |
| Developing | 选中的 PCV boosting 想法 | 实现生产可行乘法公式 $S_1 = B_r(1+\beta P)$,由实验开关守护,就绪上线 |
| Evaluation | $S_1$ 的线上 A/B 结果 | 首轮诊断:弱正但统计不可靠的时长增益(+0.034% per-capita / +0.021% user watch time),诊断风险(active devices −0.023%、18–30 段 −0.032%)。结论:直接 PCV boosting 太噪,需质量与时长约束 |
Loop 2:约束 PCV 排序(Table 10)。第二个闭环用首轮评估作输入。Brainstorm Agent 把想法从直接 boosting 精炼为约束 PCV 排序。Developing Agent 实现约束公式:
$$S_2 = B_d \cdot (1 + \beta(u) G(P)), \tag{12}$$
$B_d$ 为时长导向 base score,$G(P) = \max(P - \tau, 0)$ 是阈值为 $\tau$ 的质量门控 PCV 信号,$\beta(u)$ 是由用户活跃度决定的活跃度感知动态权重。Evaluation Agent 经线上 A/B 验证:约束 PCV 机制取得更清晰的正向 lift——user 观看时长 +0.071%、real-show +0.118%,同时用户体验 guardrail 保持稳定。除指标验证外,Evaluation Agent 还把两 loop 学习巩固为可复用知识 artifact:直接 PCV boosting 噪声大,而 PCV 经质量过滤、按用户活跃度缩放、锚定到时长导向 base score 后,约束 PCV 排序更可靠。
Table 10 | Loop 2:Constrained PCV ranking – agent 输入输出
| Agent | Input | Output |
|---|---|---|
| Brainstorm | Loop-1 评估反馈:方向正但不够鲁棒 | 精炼为约束 PCV 排序,三设计原则:质量门控、活跃度感知动态权重、时长导向 base score |
| Developing | 约束 PCV 排序想法 | 实现 $S_2 = B_d(1+\beta(u)G(P))$,准备第二轮线上 A/B |
| Evaluation | $S_2$ 的线上 A/B 结果 | 产出 launch-review-ready 结论并巩固两 loop 学习;最终线上结果 user watch time +0.071%、real-show +0.118%,体验 guardrail 稳定 |
此 case 展示 AgentX 不是 one-shot 想法生成器:它闭合了从想法生成、实现、在线评估、反馈驱动重设计、知识巩固、到可度量线上影响的完整闭环。
5.3 Showcase II:与专家 agent 共进化(§8.3)¶
超越独立端到端模式,论文进一步部署一个多 agent 协作模式:一个专家 agent 与 AgentX 在生活服务场景协同。具体地,训练一个专用推荐决策 agent 作为该场景的专家 agent,它通过观察用户行为与画像做用户级诊断、评估当前曝光是否对齐用户更深层服务兴趣、产出用自然语言表达的控制决策。AgentX 随后推理每个诊断如何被解决、在生产是否可行,精炼为更稳健的方案并写出完整可部署执行计划。
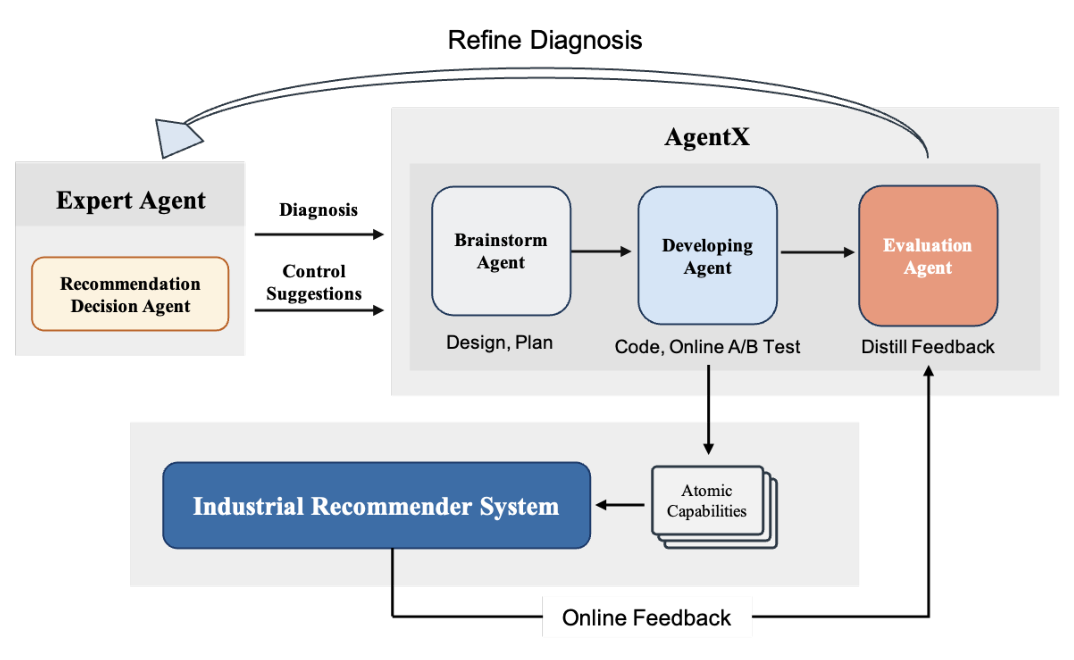
Table 11 | 专家 agent 与 AgentX 共进化闭环 – agent 输入输出(Revenue 指 Kuaishou 平台在线广告系统产生的商业收入)
| Agent | Input | Output |
|---|---|---|
| Recommendation Decision Agent (Expert) | 历史序列、用户画像、聚合统计 | 经 chain-of-thought 诊断用户广告兴趣(如结合驾驶职业 + 车辆定价搜索,推断对汽车广告明确但欠服务的兴趣),产出跨多因子控制建议(industry filter、CPM threshold、CPM boost ratios 等)为结构化 JSON |
| Brainstorm Agent | 决策 agent 的控制建议 | 评估控制建议可行性,选 CPM boost 作控制动作,产出完整可执行方案 |
| Developing Agent | CPM-boost 方案 | 实现数据拉取逻辑与 UV-level 控制,把方案带过代码开发到线上 A/B |
| Evaluation Agent | CPM-boost 方案的线上 A/B 结果 | 产出 launch-review-ready 结论:UV-level CPM boost 取得正 lift,收入 +4.7% |
这一共进化已在生产展现价值:一份生活服务记录中,推荐决策 agent 在大用户群上取得 +4.7% 相对收入 lift。这表明 AgentX 的价值不止于自治完成端到端研究,还在于作为整个推荐流水线的放大器:对任意形式的请求,它快速推理出可执行方案、带到全量部署并持续监控。决策 agent 与 AgentX 沿两条互补维度共进化——决策 agent(在生活服务领域知识上微调)作为领域专家供给高质量诊断、加深研究循环,AgentX 持续提出/实现/验证新策略方向、把诊断实现为细粒度原子动作、拓宽循环。高质量执行轨迹进一步经 SGPO 精炼 AgentX,跨迭代产生累积能力增益。
5.4 附录实验:模型研究能力验证(Appendix B)¶
附录验证 §7.2 模型研究探索管线的三种能力。
B.1 复现实验(Table 12):自治模型探索的前提是忠实复现近期已发表推荐方法。用 RankMixer 作 base,在四个公开数据集(KuaiRand、Taobao、Amazon、ML-1M)复现 CASE、HiSAC、SORT、LASER、Zenith、RankUp、Wukong、QARM 等,主指标 AUC。AgentX 为每个 (method, dataset) 对完成完整复现循环,在同一 RankMixer backbone 上产出 32 个可训练变体,表明它能在统一协议下把多样的论文级设计忠实翻译为可运行 artifact。且无单一方法在全部四数据集占优——AgentX 浮现这些跨数据集差异而非报告一律正向数字,说明其复现反映真实方法行为、为后续模块探索循环提供可信构件。
Table 12 | 复现模型跨方法性能对比(baseline 加粗、各列最优下划线,AUC)
| Model | KuaiRand | Taobao | Amazon | ML-1M |
|---|---|---|---|---|
| RankMixer | 0.6860 | 0.5647 | 0.6671 | 0.7935 |
| CASE | 0.6643 | 0.6090 | 0.6913 | 0.7947 |
| HiSAC | 0.6860 | 0.6099 | 0.6671 | 0.7935 |
| SORT | 0.6523 | 0.6189 | 0.6770 | 0.8020 |
| LASER | 0.6860 | 0.5881 | 0.6671 | 0.7935 |
| Zenith | 0.6895 | 0.5821 | 0.6732 | 0.7864 |
| RankUp | 0.6742 | 0.5780 | 0.6808 | 0.7948 |
| Wukong | 0.6897 | 0.5685 | 0.6588 | 0.7881 |
| QARM | 0.6879 | 0.5712 | 0.6690 | 0.7936 |
B.2 模块探索实验(Table 13):评估 AgentX 能否基于既有研究自治发现并实现有效改进。在 RankMixer 上,AgentX 被指示自动检索理解近期相关工作、提出兼容模块、实现代码改动、跑训练评估、选有前景候选。探索模块含 MHFT(Multi-Head Fourier Transformer)、HSTU、MVSF(Multi-View Sparse Filtering)、VQ_Code、SMES、SORT、MixFormer。单模块设置多个候选超越 baseline(MVSF/SORT 在 KuaiRand 各 +0.0064/+0.0063、MHFT 在 Taobao +0.0504);多模块设置若干组合正增益,其中 MHFT + VQ_Code + MVSF 在 KuaiRand/Taobao 取 0.6900/0.6134,平均 +0.0264 最优。这表明 AgentX 不只识别有效单模块,还能经组合探索发现更强变体。
Table 13 | 基于 RankMixer 的多模块组合性能(baseline 加粗、各数最优下划线,蓝色高亮总体最优;AUC)
| Variants | KuaiRand | Taobao | Avg. Imprv. |
|---|---|---|---|
| RankMixer (Baseline) | 0.6860 | 0.5647 | – |
| Single module | |||
| + MHFT | 0.6871 | 0.6151 | +0.0258 |
| + HSTU | 0.6908 | 0.5765 | +0.0083 |
| + MVSF | 0.6924 | 0.5748 | +0.0083 |
| + VQ_Code | 0.6876 | 0.5720 | +0.0045 |
| + SMES | 0.6886 | 0.5666 | +0.0023 |
| + SORT | 0.6923 | 0.5771 | +0.0094 |
| + MixFormer | 0.6838 | 0.5722 | +0.0027 |
| Two modules | |||
| + MHFT + HSTU | 0.6895 | 0.6017 | +0.0203 |
| + MHFT + SMES | 0.6886 | 0.6006 | +0.0193 |
| + MHFT + VQ_Code | 0.6860 | 0.5989 | +0.0171 |
| + MHFT + MixFormer | 0.6826 | 0.5963 | +0.0141 |
| + SORT + MixFormer | 0.6823 | 0.5783 | +0.0050 |
| + SORT + MVSF | 0.6856 | 0.5670 | +0.0010 |
| Three modules | |||
| + MHFT + HSTU + SMES | 0.6899 | 0.6090 | +0.0241 |
| + MHFT + HSTU + MVSF | 0.6895 | 0.6017 | +0.0203 |
| + MHFT + VQ_Code + MVSF | 0.6900 | 0.6134 | +0.0264 |
B.3 工业场景实验(Table 14):把公开数据集上表现较好的变体子集迁到一个广告投放与用户增长场景的生产规模数据集(百万级用户、十亿级交互),每个选中变体插进同一 RankMixer backbone 在生产协议下训练评估,报告对 RankMixer baseline 的相对 AUC 提升。工业结果与公开观测大体一致:单模块 MHFT 与三模块 MHFT+HSTU+MVSF(已在公开数据集名列前茅)也领跑工业榜,分别 +0.0151 与 +0.0098。这表明 AgentX 浮现的模块与组合带有真正可迁移成分,而非过拟合任一公开 benchmark 的统计。同时排名不严格保留——某些离线看似有前景的组合在工业数据下相对序变化,说明公开数据集证据与工业行为相关但不等价,组合探索仍需在生产数据重验证。
Table 14 | 工业场景数据集多模块组合性能(蓝色高亮最优;对 RankMixer 的 AUC 提升)
| Variants | AUC Imprv. |
|---|---|
| Rankmixer (Baseline) | – |
| + MHFT | +0.0151 |
| + MVSF | +0.0057 |
| + VQ_Code | +0.0028 |
| + MHFT + SMES | +0.0092 |
| + MHFT + HSTU | +0.0091 |
| + MHFT + VQ_Code | +0.0086 |
| + MHFT + HSTU + MVSF | +0.0098 |
附录 C 还给出三类 subagent 的完整 prompt 格式(Candidate Idea Generation / Candidate Validation / Code Implementation / Experiment Launch / AB-Test Monitoring Agent),其中明确了各 subagent 的 Role / Task / Inputs / Workflow / Constraints / Output Format,例如 Candidate Validation Agent 的硬约束"只有 PASS_READY 可进物化 shortlist,每轮 cap 两个"、Code Implementation Agent 的"每个新特征默认关闭、合并时不改生产行为""clean code 只在 feature 分支、force-enable 开关与日志只在 debug 分支"等,可作为复现该 harness 的工程模板。
核心贡献总结¶
- 完整生产闭环:在真实工业推荐场景跑通从调研到生产部署、再到进化的端到端算法开发闭环(Brainstorm→Developing→Evaluation→Harness Evolution),系统在统一编排下持续驱动而不依赖人逐步缝合。
- 以真实线上 A/B 为权威奖励:把整个系统优化目标与真实业务收益对齐,配 guardrail veto(业务 scoped + 复合经济交换指标 + 分层阈值)控制 false negative,并把负结果资产化为 4D 约束空间的失败记忆。
- 面向验证的实现纪律:在线轨用 repository-grounded 生成 + case toolbox + 八维质量分把"静默可靠性失败"前置可观测;离线轨用"LLM 只在判断上出错、客观事实由确定性代码产出"原则 + 专家面板超多数共识 + 可证伪因果归因(未归因增益当刹车信号)。
- SGPO 自进化飞轮:把执行轨迹的自然语言诊断当语义梯度,离线、可 replay、一次一个 subagent 地更新 harness,仅经 paired replay 准入;配合三阶段模型研究探索管线 + 记忆引导剪枝 + 经验飞轮(anti_patterns / playbook + 对抗证伪门),使系统随迭代越来越强。
- 量化工业收益:三周三 worker 把 374 想法转 10 个 launchable 结果,8× 并发、3.7× 单位人力业务价值;主 feed +0.561% app 消费时长、生活服务年化收入超 RMB 1 亿、广告共进化 case 收入 +4.7%。
与已归档相关工作的对比¶
NOVA NOVA: A Verification-Aware Agent Harness for Architecture Evolution (Tencent, 2026-06-25)¶
关系:独立并发(本文未引用 NOVA,两者殊途同归)· 已直读对方 PDF intro+method(NOVA 尚无归档精读)
这是一对极强的"独立并发 / 殊途同归"孪生:两文同日(2026-06-25)挂出、arXiv ID 相邻(AgentX 2606.26859 / NOVA 2606.27243)、分别来自快手与腾讯,均在十亿级用户的工业广告/推荐生产系统部署,主题都是"verification-aware agent harness 驱动工业推荐的自迭代",且互不引用。
- 共同关注的问题:两文都认定通用 coding agent 的成功判据(编译通过、单测通过、可运行)对工业推荐不充分——NOVA 称之为 silent failures(runnable-but-negative:代码能跑能训却悄悄劣化 AUC/calibration/业务指标),AgentX 称之为 silent reliability failures(错误特征名能编译却读无意义数据、缺工厂注册让策略静默失效、未归因增益)。两者都把验证从事后过滤提升为搜索过程的一等公民,并把真实线上 A/B(GMV/Bias vs app-time/revenue)当权威奖励。
- 相近的技术骨架:最惊人的同构是都用"梯度"隐喻一个不可微的改进信号。NOVA 的 architecture gradient $g_t = \text{Grad}(e_{t-1}, V_t, \Delta J_t, H_t)$ 把"上一次修改 + 验证诊断 + 指标反馈 + 轨迹记忆"聚合为下一步修改方向(含 weak components / modification directions / forbidden directions 三类信息,明确自陈 SGD-inspired);AgentX 的 SGPO / semantic gradient $g_{t,i} = E_{\text{agent}}(h_{t,i}; \mathcal{T}, \mathcal{R})$ 把"对轨迹失败的自然语言诊断"当语义梯度去修订 subagent harness。两者都把失败回灌为 forbidden directions / anti_patterns 以给搜索去噪,都用一个准入门(NOVA 的 offline-AUC 门 + Copilot 人审;AgentX 的 paired-replay $\Delta J > \epsilon$ 门)把误诊降为 no-op 而非永久退化。两者都用"隔离专家面板 + 确定性指标提取"对抗 LLM 幻觉(NOVA 的 expert panel 投票 + Python 计票;AgentX 的 expert agents 超多数 + Python 提 AUC)。
- 本文(AgentX)的差异与推进:(1) 闭环范围更宽——AgentX 自动化整条 idea-to-launch 生命周期(想法生成 + 在线策略代码 + 离线模型 + A/B + 负结果资产化),覆盖在线策略轨与离线模型轨两条线;NOVA 更窄更深,专注架构演化(模型结构/特征/交互模块的修改),大致对应 AgentX 的"Model Developing + 模型研究探索管线"这一条支线。(2) 两种'梯度'更新的对象不同——NOVA 的架构梯度更新"下一步试哪个架构修改"(探索什么的轴),AgentX 的 SGPO 更新"agent 自己怎么推理"(harness 如何的轴),其 §7.2 模型研究探索管线才是 NOVA 架构梯度的最直接对应物;换言之 AgentX 把 NOVA 合在一起的"探索什么 + 怎么探索"显式拆成两条进化轴。(3) NOVA 形式化了 L1–L4 任务级 + AutoRun/Copilot 模式门(按 skill-coverage 而非 level 决定是否人审),AgentX 则用人工评审作聚焦准入门、未提出 level 分类。两者是同一时刻、同一问题、同一"验证即搜索 + 梯度隐喻"哲学下的两套独立实现,互为最佳印证。
注:因 NOVA 自身的 Table 12/13/14 是对 其它模型(RankMixer 等)的复现/架构修改实验、AgentX 同理,二者都不向推荐模型 DAG 注册结构化对比边;本对比为叙事性孪生对照。
(Step 2.5 被剔除的近似候选与理由:AgenticRec AgenticRec —— LLM-as-recommender,优化推荐 agent 自身的 reasoning/tool/ranking 决策轨迹,问题是"让推荐 agent 推理更好"而非"自动化推荐系统的开发迭代",root cause 不同;TwiSTAR TwiSTAR —— agentic 生成式推荐,planner 在 serving 时分派工具,仍是 LLM-as-recommender 而非开发闭环 agent;RaG RaG —— 多 agent 但用于视频内容生成而非推荐系统自迭代。三者均问题不同构,剔除。AgentX related-work 引用的真正同族工作 Self-EvolveRec / Self-Evolving Rec System / AgenticRecTune / A/B Agent 均未归档,无法做精读级对照。)
讨论与局限性¶
值得借鉴的设计:
- "LLM 只在判断上出错,客观事实由确定性代码产出"是贯穿全篇的工程铁律——指标提取、专家计票、归因折叠、平台故障分类全部由纯 Python 状态机完成,把幻觉的爆炸半径限制在"判断"而非"事实",这是把 LLM agent 安全引入生产推荐的关键纪律。
- 可证伪归因(falsifiable attribution)把"AUC 提升但归因不明"显式当刹车信号而非成功——RankMixer 乘法门的 collapse 案例(+0.0003 增益因 $\tanh(\mathbf{V}_o\mathbf{x})\approx 0$ 被否、一行残差修复后 +0.0022 且因果链 verified)是 agent 自研里极有说服力的"不被数字骗"案例。
- 负结果资产化 + 经验飞轮的双门(threshold gate 两 run + 对抗证伪门)把"无法解释自身机制的经验"明确当负债,要求验证过的因果解释才晋升,比直接从 A/B 结果蒸馏经验(如 AgenticRecTune Skillhub)更稳健。
- 拒绝/失败的分类学(Table 6/7)诚实暴露了"看似 agent 的失败其实 91%+ 在平台/基础设施侧",并据此给出最高杠杆的下一步(上游 conflict checker、把框架约定前置为模板),这种 root-cause 拆解对工业落地极有指导价值。
局限与争议:
- 缺乏 agent-vs-agent 的严格对照:所有主结果(8×、3.7×、13.8×)都是对照"一个人工工程师",而非对照其它 agent 系统(如并发的 NOVA、AgenticRecTune、Self-EvolveRec)。论文坦承 per-idea 命中率上人类仍约 1.9× 领先,AgentX 是用"自动化下的量"换"稀缺下的精",因此"8×"等数字应理解为吞吐而非质量优势。
- showcase 驱动、样本量小:Showcase I/II 各只有 1–2 个端到端 case,Life Service 仅 13 个想法出 2 个 LR;"RMB 1 亿年化收入""收入 +4.7%"等是单 case 报数,难以判断方差与可复现性。
- 技术报告体例、匿名团队:作者署"AgentX Team"(附录列核心贡献者,含 Kun Gai、Han Li 等),多处 prompt/系统细节给到工程模板级,但部分关键超参($\lambda$ 权重、$\epsilon$ 阈值、$\beta(u)$ 形式、base 模型)未完全披露。
- 闭环瓶颈在平台而非 agent:论文自己的数据显示当前最大损失(64.7% parameter-resource conflict)是 AB 平台资源锁,意味着 AgentX 的边际价值高度依赖 Kuaishou 内部平台/数据基础设施的成熟度,迁移到其它公司的收益未必等价。
- SGPO 的保守性:一次只更新一个 subagent、冻结其余、仅 paired-replay 准入——安全但更新慢,且 replay 评分本身用 LLM-as-judge(论文也记录了 judge 误诊导致的 −1.87 回退),其可靠性最终系于准入门而非评估器质量。
工业落地价值:作为一份生产部署的工业自迭代系统报告,AgentX 的核心价值不在某个新推荐模型,而在把"推荐迭代的生产函数"从人力的线性叠加重写为可复利的工程杠杆——一层工程师与 agent 系统协作加速策略/模型迭代,另一层进化 agent 框架与基础模型本身,轨迹数据连接二者使每次改进被后续每个实验自动继承。它与同日的 NOVA 一起,标志着"agent 驱动的工业推荐自迭代"从假设走向了有真实线上收益的生产实践。