NOVA:面向工业推荐系统架构演进的"验证感知"智能体框架
Shaohua Liu, Liang Fang, Yilong Sun, Shudong Huang 等,Tencent Inc.,2026-06-25(arXiv:2606.27243)
研究动机与背景
工业推荐/广告模型的进步,本质上是一部架构演进史:从早期的 LR、FM、FFM 等浅层特征交叉模型,到 Wide & Deep、DeepFM、DCN 这类带显式记忆与交叉网络的深度模型,再到 DIN、DIEN、SIM 等用户行为序列建模,直至最近以 RankMixer、TokenMixer-Large、MixFormer 为代表、引入排序骨干注意力机制与 token 化交互的新一代结构。这条轨迹呈现出清晰的规律:当简单的特征工程红利耗尽后,推荐质量与业务收益越来越依赖更具表达力的骨干网络与更丰富的交互机制。因此,"架构演进"天然成为工业推荐研发中最值得自动化的环节。
然而架构演进在生产环境里极难规模化,原因在于其专家密集(expert-intensive)与高度耦合:
- AutoML 只能调局部变量。传统 AutoML/NAS/HPO(如 Optuna、DARTS、Auto-WEKA)主要在学习率、隐藏维度、embedding 维度、层深等预定义算子空间内搜索超参,而真正有效的模型升级往往需要跨模块的拓扑改动——例如把 target attention 升级为 Seq-Token / Non-Seq-Token 联合建模、重新设计 logit 融合路径、把标准残差替换为 AttentionRes 模块。这些改动必须同时保证输入输出形状兼容、dtype 一致、特征依赖、训练稳定性以及线上推理兼容性。
- 通用 LLM 编程智能体只优化"能跑"。LLM 编程智能体(SWE-agent、OpenHands 等)的成功通常用软件层信号衡量:编译通过、单测通过、任务完成。但在工业推荐中,一份实现能跑通甚至能训练,却可能违反推荐特有的架构语义——例如错误地移除了序列 mask、把 self-attention 退化成简单 MLP、或改坏了 logit 融合路径。这类"runnable-but-negative"候选会悄悄拖垮 AUC、校准(calibration)与业务指标。论文把这种现象命名为静默失败(silent failures)。
针对上述两个缺口,论文提出 NOVA:一个层级感知(level-aware)、面向验证(verification-aware)的智能体框架,用于工业推荐系统的架构生成与演进。NOVA 的两个核心机制:
- 架构梯度(architecture gradient):一个受 SGD 启发、非可微的结构化更新信号,把"上一次修改 + 验证诊断 + 指标反馈 + 轨迹记忆"聚合为下一步的修改方向。它不是单纯的文本建议,而是一个用于选择下一个可行修改的结构化信号。
- 静默失败感知的多阶段验证级联(verification cascade):在昂贵的训练/线上实验之前就做架构语义检查,并把失败模式记录为禁止方向(forbidden directions)反馈回架构梯度。如此,验证不仅否决当前无效候选,还能塑造后续搜索、抑制同类失败的重复出现。
配合 L1–L4 的能力分级与 AutoRun/Copilot 双执行模式,NOVA 把低风险任务自动化,把高风险任务路由给人类(Copilot)做监督判断,从而在保持可审计、风险可控的前提下,渐进地生成更高质量的架构候选。
论文的三项主要贡献:
- 架构梯度引导的演进:提出 NOVA 框架与"架构梯度"这一 SGD 风格的非可微更新信号;结合 L1–L4 分级与 AutoRun/Copilot 管控,渐进生成高质量、可审计、风险可控的架构候选。
- 静默失败感知的验证:提出多阶段验证级联,在昂贵的训练/线上实验前拦截"能跑但结构错误"的候选,并把诊断转化为可复用的禁止方向,使验证成为搜索信号的一部分(而非事后过滤器)。
- 生产部署:在服务超 10 亿用户的大规模工业广告系统中部署 NOVA,并与人类专家闭环、AutoML、通用编程智能体基线对比。在 L3"文献到生产(Literature-to-Production)"任务上,NOVA 取得 86.7% LPR、60.0% EPR,显著超过编程智能体基线,并把人类专家闭环的 EPR 翻倍以上;把一个"文献→生产"周期的人工耗时缩短 13× 以上。线上 A/B 中,离线选出的 L3 候选在三个 pCVR 目标上分别带来 GMV +1.25% / +1.70% / +2.02%,同时把 pCVR bias 分别降低 58.8% / 66.7% / 37.3%。
相关工作
论文把相关工作分为四条线:
- 自演进推荐系统(self-evolving recommender systems):YouTube 的 Self-Evolving Recommendation System [21] 用离线/在线智能体生成、评估、部署模型改进提案;AgenticRecTune [24] 与 Meta 的 Ranking Engineer Agent(REA)[11] 进一步展示了智能体辅助配置生成与广告排序实验的价值。NOVA 在此基础上,聚焦于可审计的架构级修改(模型结构、特征配置、交互模块的改动),并在生产约束下进行。与上述工作最大的区别在于验证的用法:NOVA 在训练之前做架构语义检查,并把诊断结果作为禁止方向喂回架构梯度,从而在后续迭代中避免重复的结构性失败、减少"能跑但负向"的候选。
- LLM 反馈作为梯度(LLM feedback as gradient):ProTeGi [16] 与 TextGrad [27] 用 LLM 写的文本反馈作为优化 prompt、代码等的梯度。NOVA 借用了"反馈驱动更新"的高层思想,但应用到受约束的生产架构演进上——此时更新信号必须指向具体的架构修改,并聚合多源信息(上次修改、验证诊断、指标变化、轨迹记忆)。因此 NOVA 的架构梯度不是独立的文本建议,而是用于选择下一个可行修改的结构化信号。论文在第 5 节专门设了一个"反馈消融"变体来隔离"把诊断与历史结果喂入下一步搜索方向"的作用。
- AutoML / NAS / HPO:传统方法在超参或受限算子空间上搜索,对局部、定义良好的选择很有效;但工业推荐架构演进常需在严格生产约束下做跨模块拓扑改动。NOVA 因此把模型结构、特征配置、交互模块作为搜索单元,而非仅仅超参或预定义算子。
- 编程智能体(coding agents):SWE-agent、OpenHands 等通用编程智能体优化软件层正确性(编译、单测、任务完成),但不验证一份能跑的实现是否保留了推荐特有的架构语义。NOVA 正是补上这个缺口:加入架构语义验证,并把诊断反馈回搜索过程。
问题形式化
NOVA 研究生产推荐系统的自动化架构演进:给定一个已有的生产模型,目标是迭代地提出、验证、评估能在生产约束下提升推荐质量与业务指标的架构修改。这些修改的搜索单元覆盖模型拓扑、特征路由、交互模块、结构超参。
架构状态与可行修改空间。 NOVA 把每个候选架构表示为三元组: $$A_t = (G_t, \phi_t, F_t)$$ 其中 $G_t$ 是模型图(model graph),$\phi_t$ 是结构超参,$F_t$ 是特征配置。初始状态 $A_0$ 来自生产代码库 $C$;论文来源 $P$ 与静态知识库 $KB$ 提供修改先验与"有效/无效方向"的历史证据。之所以把 $F_t$ 显式纳入架构状态,是因为工业推荐改进往往需要特征、结构、特征–结构交互的协调改动。
代表性的修改类型见下表:
Table 1:架构与特征修改示例
| 修改类型 | 典型修改 |
|---|---|
| 结构超参 | 调整 token 维度、token 数量、层数及其组合 |
| 特征增删 | 新增特征;移除冗余/有偏特征;调整特征分组 |
| 序列建模升级 | 升级 target attention 的非序列 token 交互,或引入 MixFormer 式交互 |
| 模块/算子替换 | 用 AttentionRes 替换残差模块;注入 mixer 或 cross-attention 块 |
| 架构迁移 | 把 TokenMixer-Large、MixFormer 或其他论文模块适配到生产模型 |
每次迭代施加一个修改 $e_t \in \mathcal{E}$,把当前架构变换为新候选: $$A_{t+1} = \text{Apply}(A_t, e_t) \tag{1}$$
一个候选可行当且仅当满足硬生产约束: $$\mathcal{A}_\Omega = \{A \mid A \text{ satisfies } \Omega\} \tag{2}$$ 其中 $\Omega$ 包含接口兼容、张量形状一致、dtype 兼容、特征可用性、训练框架兼容、serving 兼容、延迟上限、参数/FLOPs 预算等。
离线与在线评估目标。 NOVA 在离线内层循环里用 AUC 作为部署前评估指标对可行候选排序: $$\max_A \quad J_{\text{offline}}(A) = \text{AUC}(A) \quad \text{s.t.}\ A \in \mathcal{A}_\Omega \tag{3}$$ 离线搜索停止后,选出最佳可行候选,再用在线业务指标验证: $$J_{\text{online}}(A) = \sum_i w_i \cdot m_i(A), \quad m_i \in \{\text{GMV}, \text{Bias}\} \tag{4}$$ 其中 $w_i$ 是业务权重,像 Bias 这种"越低越好"的指标被赋予负权重。
用架构梯度优化架构。 因为架构状态 $A_t = (G_t, \phi_t, F_t)$ 是离散且受约束的,对 $A_t$ 求标准梯度不可用。NOVA 改用架构梯度作为架构修改空间里的结构化更新信号。下表给出与 SGD 的类比(仅为类比,不含真实数学梯度):
Table 2:NOVA 架构修改更新的"SGD 风格"视角
| 标准 SGD | NOVA 架构修改 |
|---|---|
| 优化变量 $\theta$ | 架构状态 $A = (G, \phi, F)$ |
| 可行域 | 生产受约束的架构空间 $\mathcal{A}_\Omega$ |
| 目标反馈 | 来自离线评估与在线验证的指标变化 $\Delta J$ |
| 更新方向 $-\nabla L(\theta)$ | 更新方向 $g_t = \text{Grad}(e_{t-1}, V_t, \Delta J_t, H_t)$ |
| 更新操作 $\theta_{t+1} = \theta_t - \eta\nabla L(\theta_t)$ | $A_{t+1} = \text{Apply}(A_t, e^*)$ |
| 动量 / 历史 | 轨迹记忆 $H$(修改历史) |
| 噪声拒绝 | 语义验证 $V$ 与禁止方向 |
| 停止准则 | 离线提升阈值或预算耗尽 |
在第 $t$ 步,NOVA 计算架构梯度: $$g_t = \text{Grad}(e_{t-1}, V_t, \Delta J_t, H_t) \tag{5}$$ 其中 $e_{t-1}$ 是上一次架构修改,$V_t$ 是验证诊断,$\Delta J_t$ 是离线目标的观测变化,$H_t$ 是修改/失败/诊断/指标反馈的历史轨迹。架构梯度 $g_t$ 指定三类更新信息:
- 弱组件(weak components):$G_t/\phi_t/F_t$ 中哪些部分可能是当前瓶颈;
- 修改方向(modification directions):接下来应探索哪些候选修改方向;
- 禁止方向(forbidden directions):哪些先前失败、语义无效、或反复负向的修改模式应被避免。
给定 $g_t$,NOVA 选择下一个可行架构修改: $$e_t^* \in \arg\max_{e \in \mathcal{E}} \text{Score}(e; g_t, H_t) \quad \text{s.t.}\ \text{Apply}(A_t, e) \in \mathcal{A}_\Omega \tag{6}$$ 然后更新架构: $$A_{t+1} = \text{Apply}(A_t, e_t^*) \tag{7}$$ 验证诊断被纳入 $g_t$:失败候选在昂贵训练前就被拦截并记入 $H_t$ 的禁止方向,而验证通过的候选贡献指标反馈 $\Delta J_t$。
问题小结。 在预算 $B$ 内,NOVA 先由离线内层循环选出最佳可行架构: $$A_{\text{off}}^* = \arg\max_{A \in \mathcal{T}_B \cap \mathcal{A}_\Omega} J_{\text{offline}}(A) \tag{8}$$ 其中 $\mathcal{T}_B$ 是预算 $B$ 内访问过的架构集合。被选中的候选再用 $J_{\text{online}}(A_{\text{off}}^*)$ 做线上验证。
核心方法:NOVA 框架
层级感知的闭环工作流
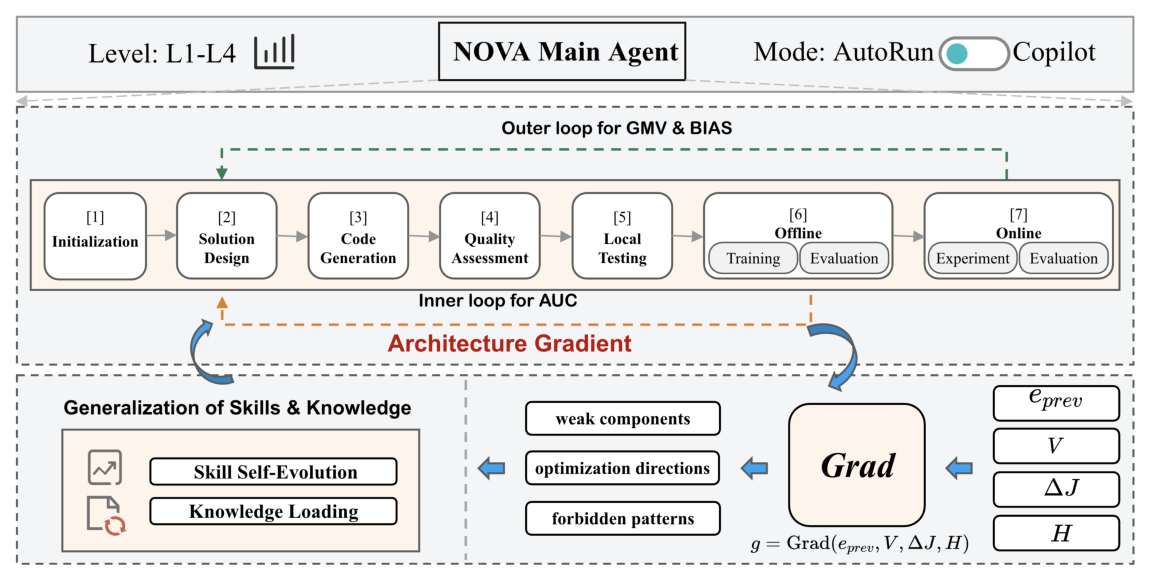
如 Figure 1 所示,NOVA 框架分三层:
- 顶层(任务级管控):固定复杂度层级 L1–L4 与执行模式 AutoRun/Copilot。
- 中层(七阶段工作流):依次执行 [1] Initialization → [2] Solution Design → [3] Code Generation → [4] Quality Assessment → [5] Local Testing → [6] Offline(Training + Evaluation)→ [7] Online(Experiment + Evaluation)。其中 AUC 内层循环驱动离线搜索,GMV & Bias 外层循环驱动线上验证。
- 底层(反馈与泛化):记录验证诊断与指标反馈,转化为下一轮的架构梯度(输出 weak components / optimization directions / forbidden patterns),并支持 Skill Self-Evolution(技能自演进)与 Knowledge Loading(知识加载)。
层级控制修改范围,模式控制是否需要人类确认。 关键设计是:模式由"技能规约覆盖度(skill-specification coverage)"决定,而非直接由层级决定——被技能规约覆盖的修改走 AutoRun(全自动),未覆盖或高风险的决策路由到 Copilot(人类确认)。
Table 3:能力层级与执行模式
| 层级 | 任务类型 | 典型任务 | 模式 |
|---|---|---|---|
| L1 | 原子结构调优 | 调整单个架构变量(如 RankMixer 层数或 token 维度) | AutoRun |
| L2 | 约束感知 ScaleUp | 联合放大耦合的架构变量(token 数、token 维度、RankMixer 层数),受参数/FLOPs 预算约束 | AutoRun |
| L3 | 文献到生产迁移 | 把 TokenMixer-Large、AttentionRes、MixFormer、OneTrans 等论文模块适配到生产模型 | AutoRun 或 Copilot |
| L4 | 开放式创新 | 从趋势、业务需求或历史证据中提出新结构 | Copilot |
初始化与信号来源
在迭代搜索开始前,NOVA 构造初始架构状态 $A_0$ 并汇集计算首个架构梯度所需的初始信号: $$g_0 \leftarrow \text{Grad}(\emptyset, V(A_0), \text{baseline metrics}, H_0) \tag{9}$$ 其中 $\emptyset$ 表示当前 run 还没有上一次修改,$V(A_0)$ 是生产模型的初始诊断,baseline metrics 提供参考性能,$H_0$ 是本次 run 初始化的轨迹记忆。
初始化用三类信号源: 1. 生产代码分析:解析代码库 $C$ 得到 $A_0 = (G_0, \phi_0, F_0)$ 与可行修改边界; 2. 来源文档分析:从论文来源 $P$ 抽取架构先验,转成"生产可适配"的修改方向; 3. 知识加载:从静态知识库 $KB$ 检索"有效/无效方向"的历史证据。
与 $KB$ 不同,轨迹记忆 $H$ 在当前 run 进行中被持续更新(修改、诊断、失败、指标反馈)。
架构梯度搜索算法
算法 1 把第 3 节的更新规则实例化到框架中:沿 $g_t$ 提出候选修改 → 用 $g_t$ 的禁止方向过滤重复失败模式 → 训练前验证幸存候选 → 评估并把反馈写回 $H$。
Algorithm 1:NOVA 架构梯度演进循环
输入:初始架构 A0,修改空间 E,约束集 Ω,离线预算 N,候选数 K,J_offline,J_online
输出:A*(沿搜索轨迹找到的最佳可行架构)

 1: A_t ← A0;  H ← ∅;  t ← 0                      // 任务级初始化,固定 best 入口
 2: level ← ComplexityTier(task)                   // L1–L4
 3: if BeyondSkillCoverage(task) then
 4:    m ← Copilot                                 // 需人类判断
 5: else
 6:    m ← AutoRun                                 // 语义门自动检查
 7: end if
 8: g0 ← Grad(∅, V(A0), baseline metrics, H)
 9: while ¬Converged(A_t) and t < N do
10:   // 1. 沿梯度方向提出候选修改                  |Cand| = K
11:   Cand ← FilterByConstraints(Propose(A_t, g_t, H), Ω, E)
12:   // 2. 验证级联:去噪反馈并拦截静默失败
13:   survivors ← ∅
14:   for e ∈ Cand do
15:     r_sem ← V_sem(Apply(A_t, e))               // 形状/mask/映射/融合
16:     if r_sem.fail then H ← H ∪ {(e, r_sem, ⊥)}; continue; end if
17:     r_loc ← V_local(Apply(A_t, e))             // 本地可执行性
18:     if r_loc.fail then H ← H ∪ {(e, r_loc, ⊥)}; continue; end if
19:     survivors ← survivors ∪ {e}
20:   end for
21:   if survivors = ∅ then
22:     g_{t+1} ← Grad(failed modifications, diagnostics, ΔJ_fail, H); t ← t+1; continue
23:   end if
24:   // 3. 施加更新;Copilot 需人类确认
25:   e* ← Select(survivors, g_t, H)
26:   if m = Copilot mode then e* ← HumanConfirm(e*); end if
27:   A_{t+1} ← Apply(A_t, e*)
28:   // 4. 离线内层循环评估                        AUC
29:   J_offline ← OfflineTrain(A_{t+1});  ΔJ ← J_offline(A_{t+1}) − J_offline(A_t)
30:   // 5. 记录反馈并构造下一架构梯度
31:   H ← H ∪ {(e*, V(A_{t+1}), ΔJ)};  g_{t+1} ← Grad(e*, V(A_{t+1}), ΔJ, H);  t ← t+1
32: end while
33: // 6. 外层循环:把最佳离线候选拿去线上验证
34: A* ← argmax_{A∈trajectory, A feasible} J_offline(A)
35: (GMV, Bias) ← OnlineExp(A*);  return A*
Table 4:算法 1 中的关键操作
| 符号/操作 | 含义 |
|---|---|
| Converged($A_t$) | 早停。触发条件:连续若干轮离线 AUC 不再提升,否则跑满预算 $N$。 |
| Propose($A_t$, g, H) | 候选生成。沿梯度方向、参考历史,产出至多 $K$ 个候选。 |
| Apply($A_t$, e) | 候选构造。把 $e$ 施加到 $A_t$ 用于验证或更新。 |
| Select(·) | 训练前排序。按梯度对齐度、历史、约束余量排序;最终效果用 AUC 衡量。 |
| $\Delta J_{\text{fail}}$ | 失败信号。所有候选都在训练前被拒时使用。 |
| $J_{\text{offline}}$ | 离线目标。内层循环用 AUC 排序候选。 |
| $J_{\text{online}}$ | 在线目标。用 GMV/Bias 验证选中候选。 |
| FilterByConstraints | 静态过滤。检查 $\Omega$ 约束与禁止方向,不实际构造候选。 |
| $V_{\text{sem}}$ | 语义验证。构造候选图并检查张量级语义。 |
静默失败感知的多阶段架构验证
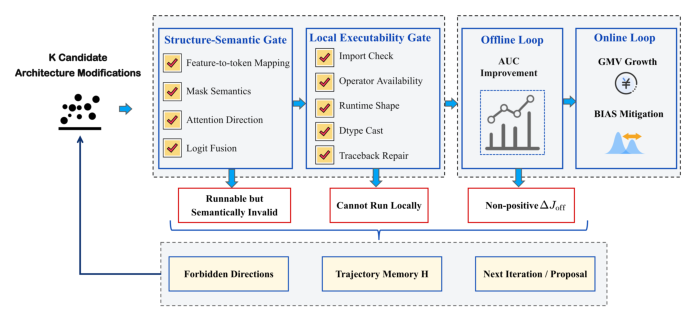
NOVA 用静默失败指代那些"通过显式工程检查、能跑能训,却无法带来预期离线/在线提升"的修改。它来自两类源头:(a) 训练前可检出的架构语义错误;(b) 结构上有效、但对业务目标无效的修改。NOVA 用一个渐进的验证级联同时覆盖两类(Figure 2):早期阶段做轻量语义/可执行检查筛掉无效候选,后期阶段再对更小的已验证候选集合做离线/在线评估。
- 结构-语义门(Structure-semantic gate):检查修改逻辑、形状/dtype、特征到 token 的映射、注意力方向、mask 语义、logit 融合。它在训练前就拦下"能跑但结构错误"的候选。对应 Figure 2 的四项勾选:Feature-to-token Mapping、Mask Semantics、Attention Direction、Logit Fusion。
- 本地可执行门(Local executability gate):检查单机可执行性,在离线训练前拦下工程失败。对应:Import Check、Operator Availability、Runtime Shape、Dtype Cast、Traceback Repair。
- 离线内层循环(Offline inner loop):用 AUC 评估已验证候选(部署前)。
- 在线外层循环(Online outer loop):用 GMV/Bias 做生产验证。
为什么语义门要放在训练前? 一个候选可以在张量形状兼容的前提下执行一个 mask、一条 branch 连接、或一条特征融合路径,但无法判断 mask 方向、特征路由、logit 融合逻辑是否匹配预期架构。换言之,编译与本地测试只能证明"图能跑",不能证明"架构语义正确"。语义门据技能规约(skill specifications)而非独立的 lint 规则来检查这些约束。
验证即梯度去噪(Verification as gradient denoising)。 验证诊断被喂回第 3 节的架构梯度:当候选被拒,其失败模式存入 $H$,并在后续轮次作为禁止方向。这一反馈通过阻断"假阳性"方向、减少重复语义失败,对搜索做了去噪。
技能规约的来源与泛化。 语义门由技能规约驱动(而非独立 lint),这些规约综合了历史种子规则、累积的禁止模式、以及 LLM 对"预期设计与模型上下文"的辅助检查。对未覆盖情形,门会避免过度自信地拒绝,把候选留给离线/在线评估。该机制在任务间保持固定,但改进会沉淀到技能规约,被后续相似架构/失败模式的任务复用。
能力边界。 语义门不判断一个语义上有效的修改对业务目标是否有效——这类性能相关失败交给离线/在线评估处理。
系统实现
NOVA 实现为一个 Main Agent 编排多个专门化子智能体。这一执行层不是独立的算法贡献,而是把"架构梯度搜索 + 验证级联"在生产中落地。
- 阶段依赖:子智能体构成一条有向工作流 Initialization → Solution Design → Code Generation → Quality Assessment → Local Testing → Offline Training & Evaluation → Online Experiment & Evaluation。下游智能体可消费多个上游输出(如 Code Generation 同时用 Solution Design 的结构假设和 Initialization 的生产上下文;Offline 把指标反馈与诊断返回给 Main Agent 更新 $H$ 与 $g$)。
- 异常处理(三类失败):
- 临时执行失败(Temporary execution failures):源于环境而非候选本身,NOVA 在有界重试预算内重试,防止噪声污染架构梯度;
- 候选级失败(Candidate-level failures):含结构-语义违规与"可训练但离线负向",NOVA 把它们记入 $H$ 作为禁止/低价值方向,并退回 Solution Design;
-
规约未覆盖/高风险失败:路由到 Copilot,避免在未覆盖技能规约之外做自主外推。
-
迭代预算与选择规则:离线阶段最多跑 $N$ 轮或直到满足停止准则;每轮报告离线 AUC 并更新 $H$ 与 $g$。离线搜索停止后,Main Agent 从轨迹中选离线 AUC 最佳的可行候选送线上实验——实现"低成本离线探索 + 选择性在线验证"。
实验设置
研究问题
- RQ1 有效性:相同预算下,NOVA 是否比基线找到更多"AUC 正向"的架构修改?
- RQ2 机制消融:各组件(论文复现、方案设计、多候选生成、质量评估、架构梯度反馈)对有效通过率的贡献如何?
- RQ3 生产代码修改:在"文献到生产"迁移任务上,NOVA 如何实际修改真实生产推荐代码?
- RQ4 线上验证:离线选出的候选是否在生产 A/B 中提升 GMV/Bias?
任务与数据
- L2 ScaleUp:在生产 RankMixer 式骨干上,搜索结构超参
token_cnt、token_dim、RankMixer 层数,并把总模型规模控制在生产 baseline 的 ±10% 内。看似简单的参数调优,但目标变量结构耦合(例如token_cnt必须能被token_dim整除,受 tokenization 与交互建模约束)。 - L3 Literature-to-Production:测试能否把 TokenMixer-Large 迁移进同一生产骨干——修改 token 交互模块,同时保留特征 pipeline、张量形状、训练稳定性与推理兼容性。
- 数据集:来自生产流量的大规模工业广告推荐数据集,训练语料跨越一个月、含十亿级用户–物品交互,每条记录关联超过一千个特征字段(含序列与非序列信号)。每个候选模型都在同一数据集上从头训练。
预算与协议
- 所有基于 LLM 的方法均由同一基座模型 Claude Sonnet 4.6 驱动,因此性能差异反映的是框架设计而非原始 LLM 能力。
- 每个方法跑 $N_{\text{task}} = 10$ 个独立任务,每任务至多 $N_{\text{iter}} = 10$ 轮;每轮可生成至多 $K$ 个候选,通过门的候选用离线 AUC 评估。离线选出的 $A_{\text{off}}^*$ 是预算内找到的最佳可行候选。
评估指标(四个视角)
- 推荐质量:离线用 $\Delta\text{AUC}$(相对生产 baseline),$\Delta\text{AUC} > 0.001$ 记为 AUC-positive;在线用 $\Delta\text{GMV}$ 与 $\Delta\text{Bias}$。
-
工程有效性 — Local Pass Rate(本地通过率): $$\text{LPR} = \frac{N_p}{N_g} \tag{10}$$ 其中 $N_g$ 为生成的候选修改数,$N_p$ 为通过本地测试的数量。
-
静默失败率 — Silent Failure Rate:衡量"能跑但无效"的比例: $$\text{SFR} = 1 - \frac{N_+}{N_p} = \frac{N_p - N_+}{N_p} \tag{11}$$ 其中 $N_+$ 为本地通过候选中 AUC-positive 的数量。
-
有效通过率 — Effective Pass Rate:从"生成"到"离线正向"的端到端成功率: $$\text{EPR} = \frac{N_+}{N_g} = \text{LPR} \cdot (1 - \text{SFR}) \tag{12}$$
直觉:LPR 高说明"会写能跑的代码",SFR 低说明"写的代码架构上真有效",EPR = LPR·(1−SFR) 把两者乘起来,才是真正端到端有用的产出率。NOVA 的核心论点正是:通用编程智能体 LPR 可以不低,但 SFR 极高(静默失败多),所以 EPR 很差。
基线
- Human Expert Loop:在同一生产模型上,资深工程师历史迭代日志(人工设计、改码、调试、训练、分析)回放。
- ReActAgent-only:标准 ReAct 范式下的单 LLM 智能体,不含 NOVA 的技能机制、多候选生成、轨迹记忆、语义验证、架构梯度反馈——用于隔离"NOVA 框架相对一个 vanilla 推理-行动智能体"的增量价值。
- OpenHands:SOTA 开源编程智能体,读仓库、改文件、对执行反馈迭代,优化"可运行代码正确性"而非推荐特有架构有效性。
- Optuna-TPE:AutoML 基线,用 TPE(Tree-structured Parzen Estimator)+ 异步早停,在预定义开关空间(学习率、隐藏维度、block 数、dropout、token 数)搜索。仅适用于 L2 ScaleUp。
- NOVA:含架构梯度反馈、语义验证、轨迹记忆、技能规约、层级/模式控制的完整系统。
主要实验结果(RQ1)
Table 5:L2 ScaleUp 与 L3 Literature-to-Production 主对比(LPR↑ 本地通过率,SFR↓ 能跑但负向率,EPR↑ 端到端有效通过率)
| 方法 | L2 LPR↑ | L2 SFR↓ | L2 EPR↑ | L3 LPR↑ | L3 SFR↓ | L3 EPR↑ |
|---|---|---|---|---|---|---|
| Human Expert Loop | 95.5% | 48.4% | 49.3% | 40.0% | 22.2% | 31.1% |
| OpenHands | 33.3% | 80.0% | 6.7% | 27.3% | 62.5% | 10.2% |
| ReActAgent-only | 37.5% | 66.7% | 12.5% | 25.0% | 71.4% | 7.1% |
| Optuna-TPE | 17.2% | 72.7% | 4.7% | – | – | – |
| NOVA | 99.0% | 45.5% | 54.5% | 86.7% | 30.8% | 60.0% |
L2 ScaleUp 分析。 该任务在生产 RankMixer 式骨干上做参数调优,看似简单,但目标变量结构耦合(token_cnt 必须能整除 token_dim)。这些约束直接影响 LPR:人类专家能拿到高 LPR;而 AutoML、通用编程智能体、ReActAgent-only 常忽视这些架构耦合,产出无效配置。NOVA 用"架构感知规则 + 验证反馈"避开这些失败,并进一步用历史优化知识识别有效的缩放方向,从而提升 SFR/EPR。这说明 L2 ScaleUp 需要的是架构感知的约束处理,而非盲目参数搜索。
L3 Literature-to-Production 分析。 L3 要在保留特征路由、张量形状、推理兼容性的前提下,把论文模块适配进生产骨干。人类专家在读懂论文后通常能形成语义有效的设计,但把设计翻译成生产代码、并通过本地调试常需反复试错(拉低 LPR)。ReActAgent-only 与 OpenHands 式编程智能体主要优化"可运行代码",在这类结构改动中无法可靠保留生产推荐语义。NOVA 通过把研究架构翻译成生产兼容修改方案、生成可执行实现、用验证反馈跨轮纠正不兼容方向,取得显著更高的 LPR 与 EPR(86.7% / 60.0%)。这表明"文献到生产"迁移同时需要架构感知适配与可靠的生产代码实现,而不只是可运行代码生成。
值得注意:在 L3 上,Human Expert Loop 的 SFR 最低(22.2%),即人类专家"一旦写出来就更可能真有效";但其 LPR 仅 40.0%(写出能跑实现本身难),导致 EPR 只有 31.1%。NOVA 用更高的 LPR(86.7%)弥补了略高的 SFR(30.8%),最终 EPR(60.0%)几乎是人类的两倍。
消融研究(RQ2)
在最具挑战的 L3 设置上做组件级消融(每次移除一个组件,保持任务预算与评估协议不变)。
Table 6:L3 任务的组件级消融(LPR/EPR 越高越好,SFR 越低越好)
| 变体 | 移除的组件 | LPR↑ | SFR↓ | EPR↑ |
|---|---|---|---|---|
| NOVA(完整) | — | 86.7% | 30.8% | 60.0% |
| w/o Paper Reproduction | 移除对源材料的结构化分析与复现产物;智能体只收到原始文档 + 简短任务描述 | 91.7% | 63.6% | 33.3% |
| w/o Solution Design | 移除"把论文架构映射为生产模型具体改动"的规划步骤 | 81.8% | 77.8% | 18.2% |
| w/o Multi-Candidate Generation | 每轮只生成一个候选修改 | 66.7% | 61.1% | 25.9% |
| w/o Quality Assessment | 移除本地测试/训练前的架构感知候选评审 | 71.9% | 69.6% | 21.9% |
| w/o Architecture-Gradient Feedback | 移除迭代级诊断反馈进入架构梯度 | 87.5% | 57.1% | 37.5% |
逐项分析:
- w/o Paper Reproduction:LPR 反而升到 91.7%,但 SFR 飙到 63.6%、EPR 跌到 33.3%。即"没有论文复现"仍能产出能跑代码,却缺乏对论文架构意图的结构化理解,候选多能通过本地检查却拿不到离线正收益——浅层论文信息不足以支撑可靠的"文献到生产"适配。
- w/o Solution Design:最差结果,SFR 升到 77.8%、EPR 跌到 18.2%。没有显式设计步骤,系统直接从论文信息跳到实现,不分解架构改动、不检查模块依赖、不与生产骨干对齐——Solution Design 是"论文级想法"到"生产兼容修改"的关键桥梁。
- w/o Multi-Candidate Generation:LPR 跌到 66.7%、EPR 跌到 25.9%。每轮只生成一个候选会让搜索对早期错误更敏感:若单一候选走错适配路径,系统没有备选可比较或回退。
- w/o Quality Assessment:保留多候选生成但移除"本地测试/训练前"的架构感知评审,导致 SFR 69.6%、EPR 21.9%。说明多候选生成必须配合质量评估,否则会把高风险候选直接放行。
- w/o Architecture-Gradient Feedback:LPR 仍较高(87.5%),但 SFR 升到 57.1%、EPR 跌到 37.5%。没有诊断反馈引导 $g_t$,系统倾向于提出"更容易跑通但架构上不那么有效"的改动;虽然仍能观察到每轮结果,但失败不被转化为可复用的禁止方向——NOVA 的增益依赖把失败转化为搜索知识,而非仅仅观察最终指标。
消融小结:NOVA 通过同时提升 LPR、降低 SFR 来提升 EPR。论文复现、方案设计、多候选生成帮助产出生产兼容的候选;质量评估与架构梯度反馈则降低"能跑但负向"的失败。
生产代码修改案例(RQ3)
论文分析了两个基于 TokenMixer-Large 的 L3 案例(均有线上实验验证)。
Case 1:参数高效的架构变体。 NOVA 把 TokenMixer-Large 适配进生产 RankMixer 式骨干,受参数、FLOPs、serving 约束。直接对齐论文的变体用四个 TokenMixer block + 层间残差 + 辅助损失;NOVA 反而发现一个更轻的两 block 变体,在仅约 43% 稠密参数下取得可比的离线效果。最终变体减少 TokenMixer block 数、收窄 FFN 扩张比、并在标准 mixing/reverting 结构之外额外加了一条 norm + FFN + residual 路径。该修改既保留论文的 token 交互意图,又更好匹配生产骨干的容量与延迟约束——说明 NOVA 做的是架构适配(在生产约束下找可行修改),而非论文复现。
Case 2:通过辅助损失做架构梯度修正。 第二个案例展示 NOVA 如何用目标级反馈修正一次生产改动。初始迁移整体带来正信号,但 task1 仍低于期望提升。NOVA 因此探索"辅助监督应该全局共享还是为特定目标专门化"。轨迹分三步:
1. 先迁移主 TokenMixer 组件,但观察到 task1 提升不足;
2. 移除辅助损失以减少干扰,却伤到 task2 和 task3,说明辅助监督对部分模型仍有用;
3. 以更小权重重新引入辅助损失,并加一个 task1 专属辅助信号。当这仍只带来有限的 task1 收益、且对 task3 有负面影响时,NOVA 诊断出两个问题:task1 辅助损失可能从错误的目标表征读取;全局辅助目标可能干扰 task3。下一步修改于是改正 task1 辅助损失索引、并把 task1 从全局辅助目标中 mask 掉。
此后 NOVA 进一步测试"能否用更强的 task1 专属分支(加 task-token MLP + 提高辅助损失权重)改进 task1";这种更激进的精修产生负向结果,表明对 task1 过度专门化有害。NOVA 于是回到此前更好的轨迹、降低辅助损失权重,得到预期的正向结果。该案例展示了架构梯度反馈的作用:用历史结果与诊断帮助修正修改方向、避免重复错误、收敛到生产兼容的设计。
线上验证(RQ4)
把 L3 离线 AUC 最佳的 TokenMixer-Large 迁移候选部署到生产 pCVR 模型,用 5% 生产流量、请求级随机化与线上 baseline 对比;报告三个目标级的 GMV 与 pCVR bias(bias 绝对值越低说明校准越好)。所有 GMV 增益在平台标准显著性检验下均显著。
Table 7:线上 A/B 结果(相对生产 baseline)
| 目标 | GMV | pCVR bias |
|---|---|---|
| task1 | +1.25% | −58.8% |
| task2 | +1.70% | −66.7% |
| task3 | +2.02% | −37.3% |
线上分析:离线选出的 L3 候选在三个 pCVR 目标上同时提升 GMV(+1.25% / +1.70% / +2.02%)并降低 pCVR bias(−58.8% / −66.7% / −37.3%)——即架构修改在带来业务增益的同时改善了预测校准,而非以更差校准为代价换取 GMV。这验证了 NOVA"离线 AUC 选优 → 线上业务验证"闭环的有效性。
附录:框架足迹、效率与可复现性
框架足迹与单智能体 LLM 用量
Table 8:NOVA 框架足迹与单智能体 LLM 用量(Size 为 prompt + 技能 bundle 大小;Input/Output 为单次调用平均 token;Tool Calls 为单任务平均调用数;Tokens = (Input + Output) × Tool Calls)
| 智能体 | Size | Input/call | Output/call | Tool Calls | Tokens |
|---|---|---|---|---|---|
| Init | 45 KB | 92.5K | 0.9K | 29.3 | 2.74M |
| Solution-Design | 110 KB | 154.5K | 1.1K | 136.1 | 21.17M |
| Code-Gen | 50 KB | 89.6K | 0.5K | 83.5 | 7.51M |
| Quality-Review | 40 KB | 96.0K | 0.3K | 155.3 | 14.95M |
| Local-Testing | 15 KB | 67.9K | 0.4K | 95.7 | 6.54M |
| Offline | 5 KB | 71.9K | 0.5K | 32.8 | 2.38M |
| Online | 10 KB | 54.3K | 0.4K | 28.3 | 1.55M |
token 用量由 Solution-Design 与 Quality-Review 主导:前者在每个外层迭代都出现且消费最丰富的上下文,后者执行密集的多候选检查(含语义评审 $V_{\text{sem}}$)。Main Agent 只做编排,从不直接调 LLM。
效率:NOVA vs 人类工作流
论文把一个完整"文献到生产"周期分为五个阶段,用抽象的工程师小时单位 $u$(绝对尺度保密,但比率精确,因为两套工作流用同一单位测量)报告 wall-clock 与 human-attended 时间。
Table 9:端到端速度——人类工作流 vs NOVA 框架(单位 $u$;两行 training 在两套工作流下 wall-clock 相同,因 GPU-bound,节省来自更少的人工监控)
| 阶段 | 人类 Wall-clock | 人类 Human-attended | NOVA Wall-clock | NOVA Human-attended |
|---|---|---|---|---|
| 论文阅读 & 复现 | 28u | 28u | 0.7u | 1.0u |
| 训练搭建 & 单机调试 | 6u | 6u | 0.3u | 0.5u |
| 冷启训练 | 28u | 4u | 28u | 1.0u |
| 在线训练 | 8u | 4u | 8u | 1.0u |
| 反思 & 迭代规划 | 12u | 12u | 0.3u | 0.5u |
| 端到端 | 82u | 54u | 37u | 4u |
节省集中在工程师时间而非 GPU 吞吐。 两个 training 阶段因 GPU-bound 而 wall-clock 不变,收益来自把人工监控($4u \to 1u$)压掉。最大的压缩出现在 human-bound 的设计-调试阶段:论文阅读与复现($28u \to 0.7u$,40×)、单机调试($6u \to 0.3u$,20×)、反思+规划($12u \to 0.3u$,40×)。端到端 wall-clock 从 $82u$ 降到 $37u$(2.2×),而 human-attended 时间从 $54u$ 降到 $4u$(13.5×)。残余人力集中在战略性门控(需求提交、计划/代码评审、最终结果评审),从而在固定 headcount 下显著提高实验吞吐。
可复现性产物
因生产 prompt 语料含专有运营规则与标识符,论文不逐字公开 prompt,而是在机制层提供三类产物:(1) 暴露接口契约的 prompt skeleton;(2) 展示"验证如何更新架构梯度"的轨迹片段;(3) 压缩后的结构化技能摘要。论文给出了 Solution-Design Agent 的 prompt 模板骨架(含 ROLE / PATH CONVENTION / AUTONOMY LEVELS & SKILL ROUTING / INPUTS TO Grad / TASKS / OUTPUT PROTOCOL 等段),一个在第 7 轮学到的禁止规则示例(pattern: "sequence self-attention without causal mask",defect_class: "future-information leakage",enforcement: [hard-filter, negative-example-in-Propose]),以及一段轨迹片段展示该规则如何在第 8 轮把搜索方向重定向到"保持因果性的序列建模(上三角 causal mask)"。还给出三个技能库示例(Paper-to-Code Skill / Architecture-Edit Planner Skill / Multi-LLM Code Review Skill),均强调"先读 grounding 文件、拒绝违反约束的改动、把每个实现选择标注为 paper-stated / inferred-from-paper / engineering-assumption"。
核心贡献总结
- 把架构演进形式化为"验证感知的架构梯度搜索":用 SGD 类比把离散、受约束的架构修改空间上的搜索,组织成一个聚合"上次修改 + 验证诊断 + 指标变化 + 轨迹记忆"的结构化更新信号 $g_t$(弱组件 / 修改方向 / 禁止方向)。
- 静默失败感知的多阶段验证级联:结构-语义门 → 本地可执行门 → 离线 AUC → 在线 GMV/Bias,把"能跑但结构/业务无效"的候选在昂贵训练前拦下,并把失败转成可复用的禁止方向("验证即梯度去噪")。
- L1–L4 分级 + AutoRun/Copilot 双模式:模式由"技能规约覆盖度"决定,低风险全自动、高风险人类监督,使自动化既激进又可审计、风险可控。
- 真实工业落地:服务超 10 亿用户的腾讯广告系统;L3 任务 EPR 60.0%(人类 31.1% 的近两倍)、人工耗时缩短 13.5×;线上 A/B GMV +1.25%~+2.02% 且 pCVR bias 同步下降。
讨论与局限性
值得借鉴的设计:
- 把"验证"从事后过滤器升级为搜索信号。多数自动化方案把验证当作 pass/fail 门,NOVA 的关键 insight 是让失败诊断反向塑造下一步搜索(禁止方向 + 弱组件定位),这是它相对 ReActAgent-only / OpenHands 拉开差距的根本原因(消融里去掉架构梯度反馈,EPR 从 60.0% 跌到 37.5%)。
- EPR = LPR·(1−SFR) 这个指标拆解本身很有价值。它精准刻画了"通用编程智能体的失效模式不是写不出能跑的代码(LPR 不低),而是写出的代码静默失效(SFR 极高)",为"工业架构自动化为什么不能只看软件层信号"提供了量化论据。
- 技能规约 + 覆盖度路由:用"是否被技能规约覆盖"而非"任务层级"来决定是否需要人类确认,是一个比"按风险等级硬编码"更细粒度、更可演进的管控方式。
局限与争议:
- "架构梯度"是类比而非真梯度。论文坦承 $g_t$ 只是 SGD 风格的结构化启发式 prompt 信号,没有真实数学梯度的收敛保证;本质上是"带记忆的 LLM 引导搜索 + 约束过滤",理论性偏弱。
- 可复现性有限。所有实验在腾讯专有工业数据与生产骨干上进行,无公开学术数据集;prompt 语料因含专有规则而不公开,只提供机制层骨架,外部难以严格复现具体数字。
- 效率指标用抽象单位 $u$。Table 9 的绝对尺度保密,13.5× 等比率虽精确,但读者无法判断绝对工时与跨团队可迁移性。
- 它不是一个新的推荐架构:NOVA 的产出是"被它发现的架构修改",而非 NOVA 本身。它属于智能体框架 / R&D 自动化工具这一范畴,与 RankMixer、TokenMixer-Large、MixFormer、OneTrans 等"被它操作的骨干"是元层–对象层关系,而非同层竞争。因此它不进入推荐架构的 benchmark/DAG 谱系。
- 依赖强基座 LLM:所有方法用 Claude Sonnet 4.6,差异归因于框架设计;但 NOVA 单任务 token 消耗很高(Solution-Design 21.17M tokens、Quality-Review 14.95M tokens),成本结构在更弱/更贵的基座下是否仍划算未充分讨论。
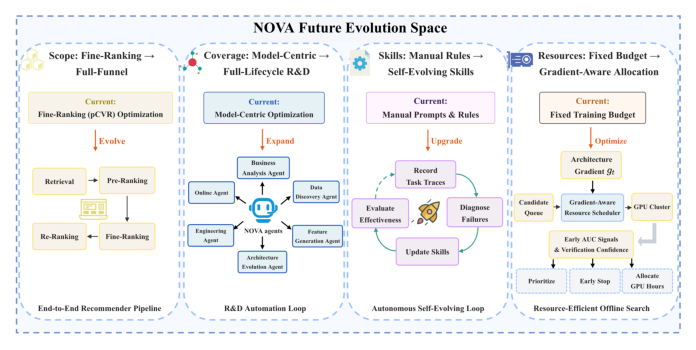
未来工作(Figure 3 路线图): 1. 全漏斗范围扩展:从精排 pCTR/pCVR 优化扩展到检索、粗排、精排、重排的全链路; 2. 全生命周期 R&D 自动化:协调智能体覆盖业务分析、数据发现、特征生成、架构演进、工程优化、在线实验; 3. 技能自演进:从人工维护的 prompt/规则升级为"持续记录任务轨迹、诊断失败、更新技能、评估技能有效性"的自演进技能; 4. 梯度感知的资源调度:按验证置信度、早期训练信号、历史 promise 与集群可用性自适应分配 GPU/训练预算,减少在低价值候选上的训练浪费、提高离线搜索吞吐。