DREAM Technical Report 精读¶
Taobao & Tmall Group of Alibaba · DREAM Team · arXiv 2608.09408 · 2026-08-10 · 40 页技术报告
DREAM = Developing Recommender Engine with Agentic Methods。这不是推荐模型论文,而是工业推荐系统"控制层"的架构报告:一个召回/排序/重排模型都不替换,只在既有级联管线之上叠一层可感知、可编排、可审计的策略层,由 LLM Agent 在线为每个用户即时改写管线参数。
研究动机与背景¶
工业推荐系统长期被组织为"召回 → 排序 → 重排"的级联管线。这种模块化设计稳定高效,但随用户行为复杂化与业务目标增多,论文点名四个反复出现的结构性瓶颈:
- 信息割裂(information fragmentation):上游模块看不到下游结果,反之亦然;
- 目标散落(objective scattering):点击、转化、增长、体验各自独立优化,从不被统一仲裁;
- 策略僵化(strategy rigidity):绝大多数策略仍来自静态规则、人群包与人工调参;
- 实时意图感知薄弱(weak real-time intent awareness):会话级"浏览 → 比较 → 购买"的状态迁移无人处理。
缺的那一块,是一个能感知意图、跨模块协调策略、并从线上反馈自我优化的控制平面(control plane)。
论文把已有 LLM agentic 推荐工作分成四类:直接选 item 的 agent、模拟用户的 agent、与用户对话的 agent、编排系统本身的 agent。每类只解决一个切面,没有一个端到端覆盖"意图感知 + 策略生成 + 执行反馈"且跑在工业规模上。由此提炼出三条贯穿性局限:
- 意图感知与策略生成脱节:item-selector 类 agent 只靠记忆传播偏好,看不到端上微观信号、会话级意图与全局业务状态;orchestrator 类 agent 能自动化架构演进,但规划策略时没有实时用户意图,"看得远却瞄不准"(far-sighted but poorly aimed)。
- 策略僵化、多目标协调弱:规则方法跟不上实时状态迁移;单体 agent 把所有目标压进一次决策,无显式仲裁。论文点名 AgenticRecTune 用 Pareto Memory 调融合权重,但只在全局层面而非按用户动态出策略,迭代慢且指标长期互相拉扯。
- 执行到上游优化的闭环缺失:orchestrator 类工作虽有 harness 演化与 A/B 判决,但环路服务于架构级迭代而非用户级参数的实时校准,执行信号从不回流到感知与决策模块。
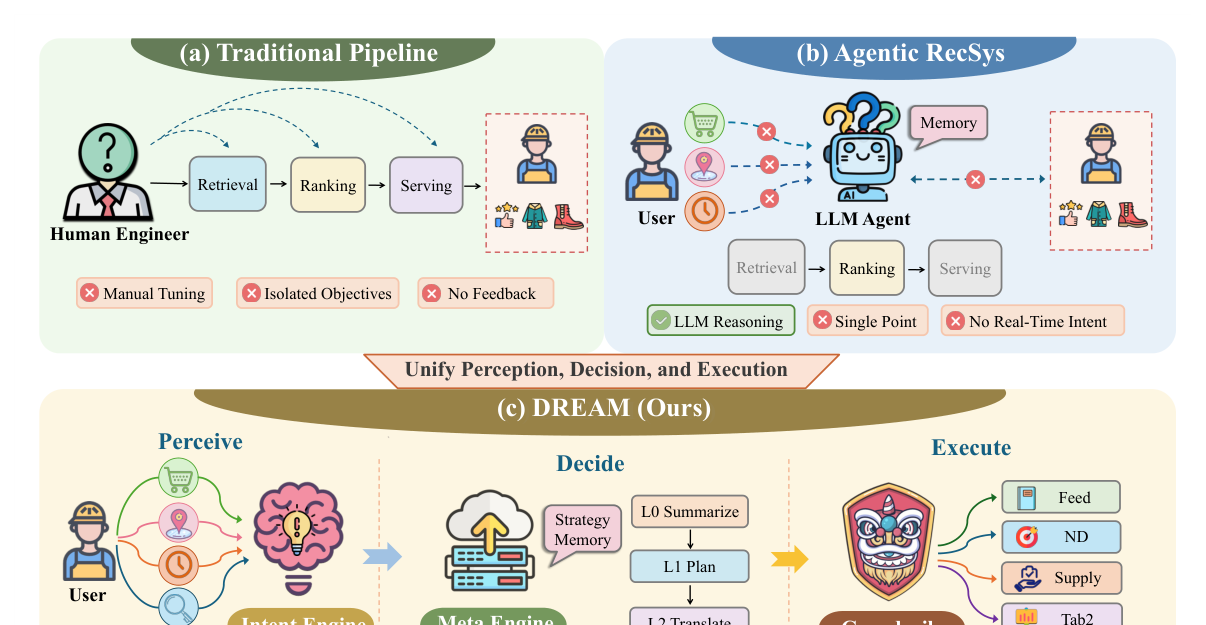
Figure 1 并置三种范式:(a) 传统管线由人工调参,目标孤立、无反馈;(b) Agentic RecSys 让 LLM Agent 带记忆做推理,但单点介入、无实时意图;(c) DREAM 把 Perceive / Decide / Execute 串成一条链并由 Reward Dual Loop 回灌。
核心方法:DREAM 框架¶
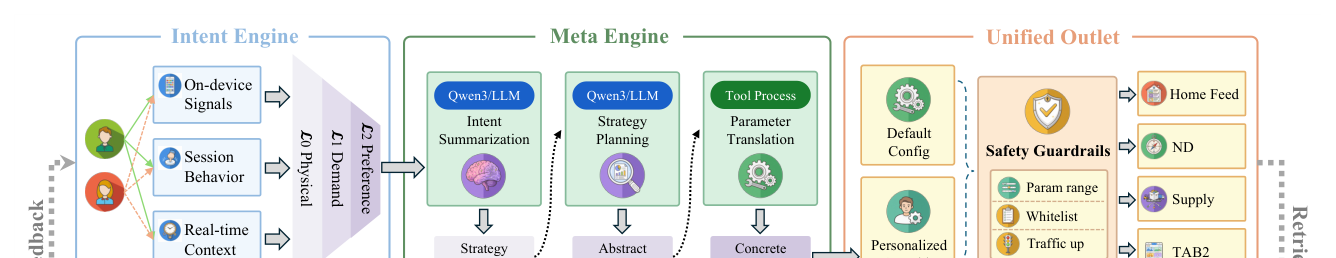
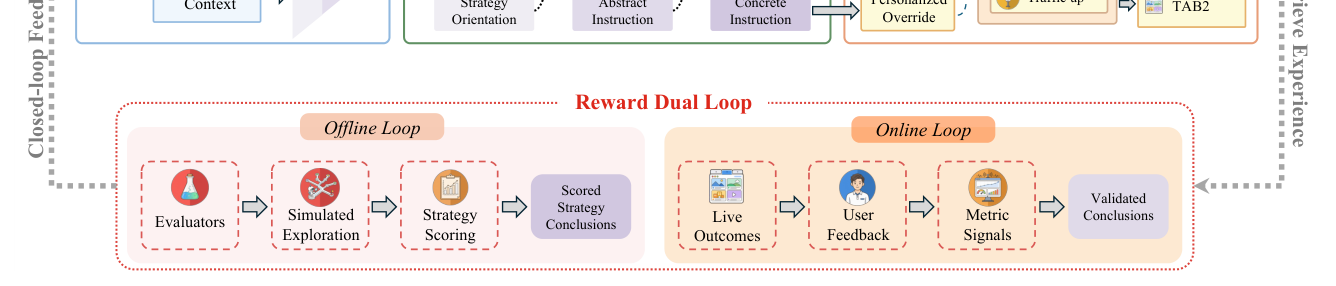
DREAM 是叠加式(overlay)架构,三个模块构成闭环:
- Intent Engine(§3,感知层):把异构行为信号转成三层结构化意图(L0/L1/L2)。它被刻意设计成中间件,只对"意图质量"负责,下游怎么消费由下游自己决定——这让它成为通用意图基础设施而非任务定制组件。
- Meta Engine(§4,决策层):MetaModel(基于 Qwen3 的主 agent)协调专用子 agent,诊断用户状态、生成候选策略,并经 Tools 接口翻译成有界可执行参数。
- Unified Outlet(统一出口):所有具体指令——无论来自 MetaModel 还是既有线上配置——都走同一条路径进入 Homepage Feed / ND / Supply / TAB2,采用"默认兜底 + 个性化 override",由安全护栏强制参数范围、白名单与流量上限。因每次 override 都是增量且有界的,主链路始终是安全网。
信息流双向:行为信号自执行向上流到感知,意图自感知流向决策,策略参数自决策流回执行。
三层意图表示与优先级¶
引擎对每个用户维护一份共享的 L0 画像 $P_{L0}$ 与一个活跃意图列表。单条意图的形式化表示为:
$$\mathrm{Intent}(u, i, t) = \langle \mathrm{id},\ \mathrm{name},\ \mathrm{commodity},\ \mathrm{strength},\ \mathrm{confidence},\ \mathrm{origin},\ \mathrm{metadata} \rangle \tag{1}$$
保留下来的意图按优先级分数排序:
$$R(i) = s(i)\,\kappa(i)\,\gamma(i)\,u(i) \tag{2}$$
$s(i)$ 是行为强度、$\kappa(i)$ 收敛度、$\gamma(i)$ 新近度、$u(i)$ 未满足需求程度,聚合前归一化。乘积形式意味着任何一维塌陷都会把该意图整体压下去,比加权和更保守。
三层分工:L0 Physical 存跨所有意图共享的稳定信息(人口属性、长期兴趣、行为记忆、身份标签),粗粒度更新;L1 Demand 描述用户当下需要什么(需求类目/场景、类目认知、目标人群、时间节点、意图置信度);L2 Preference 描述用户在该需求下如何评估备选(子类目、品牌倾向、价格与属性偏好、决策状态、实时心理),是异步精修的主要目标。每条意图还带稳定 intent ID、1–5 优先级与三种意图类型之一(goal-driven / inspiration exploration / aimless browsing)。证据不足的字段被显式置为 null 或空列表,而不是硬猜。
关键技术细节¶
1. Traffic Funnel:端云四级级联漏斗¶
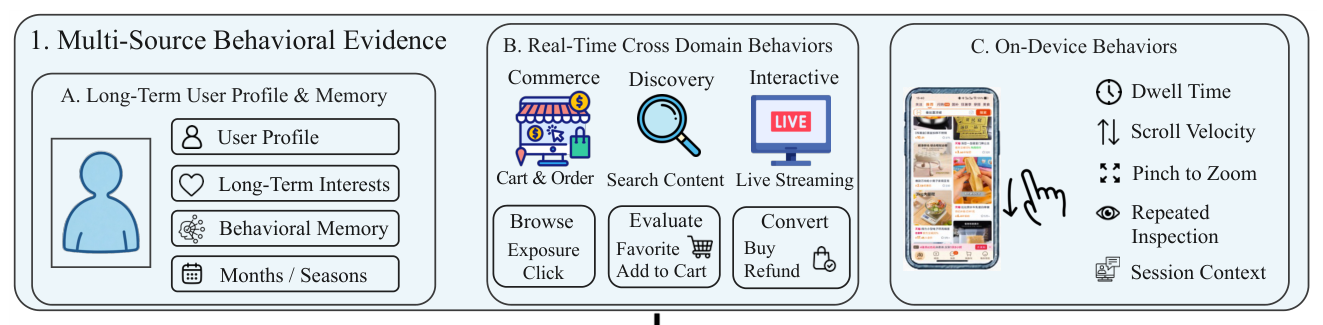
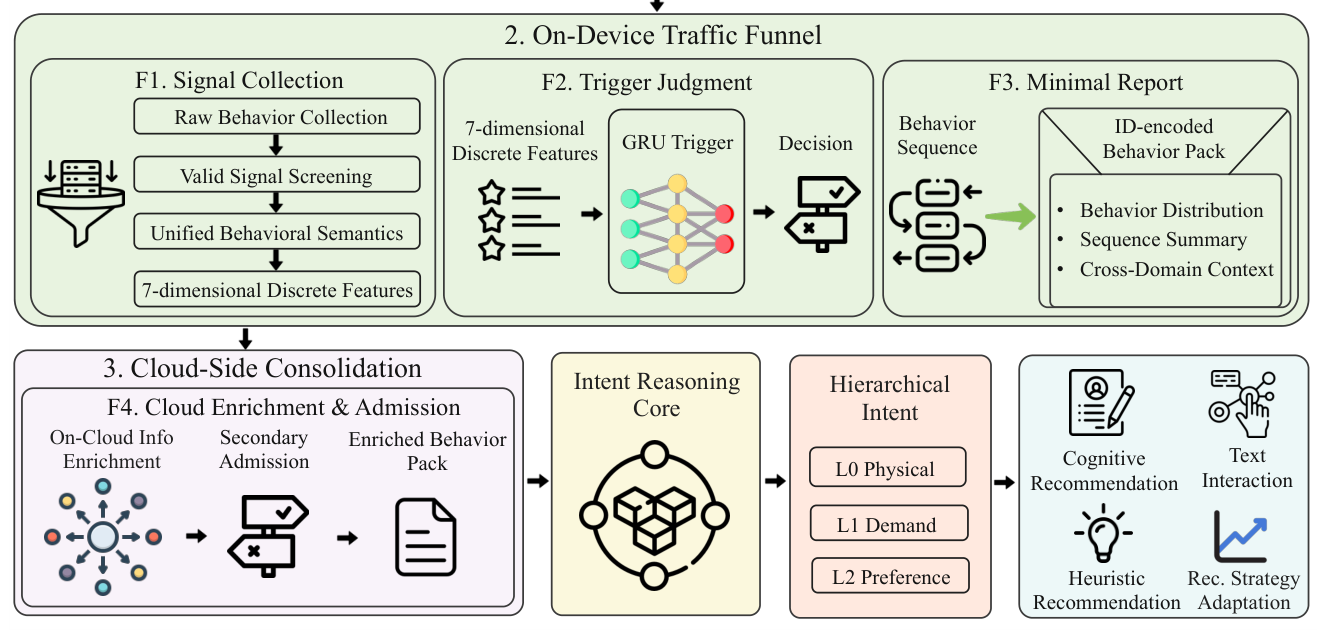
核心矛盾是信号获取瓶颈:顶级推荐位每秒数万次原始行为,全量上云既不满足延迟也不满足预算,过度过滤又会丢掉跨域跨会话上下文。解法是严格级联的四级链路,越往下频率越低、算力越重:
Table 1 | Traffic Funnel 的四级级联链路
| Stage | Locus | Function | Decision output |
|---|---|---|---|
| F1 | Device | Signal encoding | 埋点编码为可学习特征 |
| F2 | Device | Trigger judgment | 是否因意图变点触发上报 |
| F3 | Device | Minimal report | 是否上传 ID 编码 behavior pack |
| F4 | Cloud | Enrichment + admission | 是否唤起 Intent Reasoning Core |
- F1 信号采集:不等 T+1 批日志,客户端实时把埋点编码成结构化行为特征(具名信号 + action ID + 少量离散特征维度),把端上行为词表从 6 类扩到 60+ 类。
- F2 触发判断:单层 GRU 在 7 维离散特征流上做变点检测,隐状态跨事件携带;配短窗误触保护(2 秒内或曝光前退回原场景则抑制)与 RuleTree 兜底。生产中该门只放行约 15% 的行为。
- F3 最小上报:触发后把最近至多 50 条行为(带 item / shop 实体 ID)打包成 ID 编码的最小 behavior pack,端上不做语义扩充。与旧的单事件上报不同,这是会话级聚合负载,才带得动云端推理所需的跨域上下文。
- F4 云端扩充与准入:把 pack 与最近的 L1–L2 意图列表、L0 画像 $P_{L0}$ join,把 item_id / scene_id 还原成标题、店铺、类目,每条行为约 5ms;再做二次准入把琐碎或冗余的 pack 挡在推理核心之外。摘要里"上报量降到约 8.7%"即这条链路端到端的净效果。
2. Intent Reasoning Core:0.8B 主 Agent + 4B 异步专家 + 在线蒸馏¶
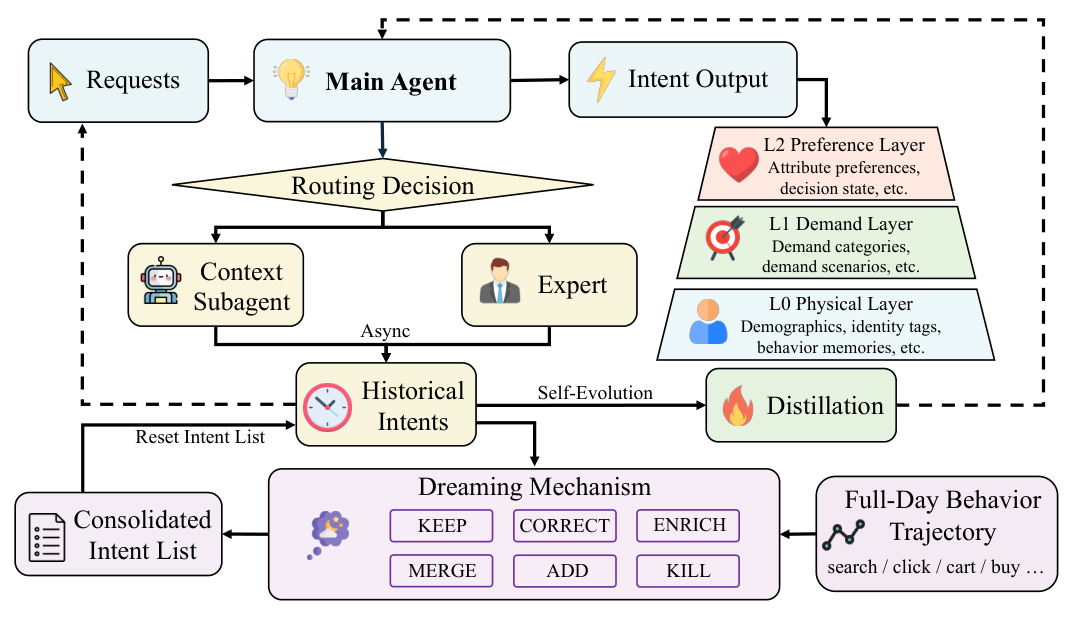
Main Agent 是 0.8B 语言模型,对漏斗放行的每个请求同步运行:
$$\big(\Delta \mathcal{I}_t,\ r_t\big) = f_\theta\big(P_{L0},\ \mathcal{I}_{t-1},\ \mathcal{B}_t\big) \tag{3}$$
$P_{L0}$ 是 L0 画像,$\mathcal{I}_{t-1}$ 是上一轮意图列表,$\mathcal{B}_t$ 是当前 behavior pack,$r_t$ 是路由决策。$\Delta\mathcal{I}_t$ 只含 insert / update 增量操作而非重写整张列表——这是把在线成本钉住的关键。
双层路由决定是否异步精修:规则层检查行为条数与不同 L1 需求类目数是否超阈值;模型层用 Main Agent 在 $r_t$ 中吐出的升级置信度 $c \in [0,1] \cup \{\mathrm{null}\}$,超阈值 $\tau$ 即为额外升级信号,null 则交给规则层独判。任一层正信号即升级,同步路径无需额外模型推理。生产中约 6.3% 请求被送往异步 4B 层:context subagent 处理"L1 需求合理但子类目/意图结构不确定",用更长历史与 L0 画像补齐;expert 处理"类目已定但 item 级偏好不确定",精修价格/属性偏好、决策状态、意图类型。冲突按字段级确定性策略解决:近期可靠行为证据支撑的值优先,其余字段仅当异步估计的置信度超阈值才更新。
自进化分两级。交互级:子 agent 输出异步改写历史意图列表,后续推理立即受益且不需改参数。模型级:这些输出用 on-policy 蒸馏训练 Main Agent——令 $x_t = (P_{L0}, \mathcal{I}_{t-1}, \mathcal{B}_t)$,Main Agent 采样 $\hat{y}_t \sim p_\theta(\cdot \mid x_t)$,被选中的专用 agent 在学生自己生成的前缀上给出下一 token 分布:
$$\mathcal{L}_{\mathrm{OPD}}(\theta) = \mathbb{E}_{x_t,\ \hat{y}_t \sim p_\theta(\cdot|x_t)} \left[ \frac{1}{|\hat{y}_t|} \sum_{j=1}^{|\hat{y}_t|} \mathrm{KL}\Big( p_\theta(\cdot \mid x_t, \hat{y}_{t,<j}) \,\Big\|\, p_\phi(\cdot \mid x_t, \hat{y}_{t,<j}) \Big) \right] \tag{4}$$
$p_\phi$ 是 4B 专用 agent 的分布。反向 KL 沿学生轨迹求值,让训练分布对齐推理时的真实状态(避免 teacher forcing 的曝光偏差);该目标只作用于意图更新序列,不监督路由决策 $r_t$。
3. Dreaming Mechanism:夜间闲时算力做意图整合¶
在线推理只看得到触发时刻的证据,这个窄视野导致三类失效:意图膨胀(碎片证据造出语义等价的多条意图)、意图不准(证据未足即填字段)、意图遗漏(单独很弱但一致的信号从不触发在线更新)。而夜间请求骤降、GPU 闲置,Dreaming 就用这个低峰窗口整合意图状态:
$$\mathcal{I}^{\mathrm{init}}_{D+1} = \mathrm{Dream}\big(P_{L0},\ \mathcal{I}_D,\ \mathcal{B}_D\big) \tag{5}$$
$\mathcal{I}_D$ 是第 $D$ 天最后一次请求后的在线意图列表,$\mathcal{B}_D$ 是当天全量行为轨迹。产出完全替换累积的在线意图状态并初始化第 $D+1$ 天首个请求的 $\mathcal{I}_{t-1}$。与在线增量只有 insert / update 不同,Dreaming 在完整列表上做六种原子操作:
Table 3 | Dreaming 的六种原子操作
| Operation | Definition | Function |
|---|---|---|
| keep | 与扩展证据仍一致时保留活跃意图 | 保持 |
| correct | 修正与扩展证据冲突的字段 | 纠错 |
| enrich | 用额外证据补齐缺失/欠定字段 | 补全 |
| merge | 合并指向同一底层需求的记录 | 去重 |
| add | 新建有证据支撑但在线列表缺失的意图 | 补漏 |
| kill | 移除已满足/已放弃/被取代/无证据的意图 | 退役 |
五条证据纪律:结果优先推理(先看最新行为、交易状态、显式放弃信号再回看更早证据,以支撑可靠的 kill / correct);行为聚类后与意图对齐(按类目、场景、时段分组再对齐,为 merge / add 提供连贯证据);证据优先于画像(L0 仅在证据不足时使用);意图优先级(按式 (2) 降序);属性级负反馈(显式负行为只映射为属性级排除,不上升为类目级排除,否则会把相关候选整体从召回抹掉)。
4. Agent Loop 触发与频控:把 LLM 调用建模成受约束的选择性计算¶
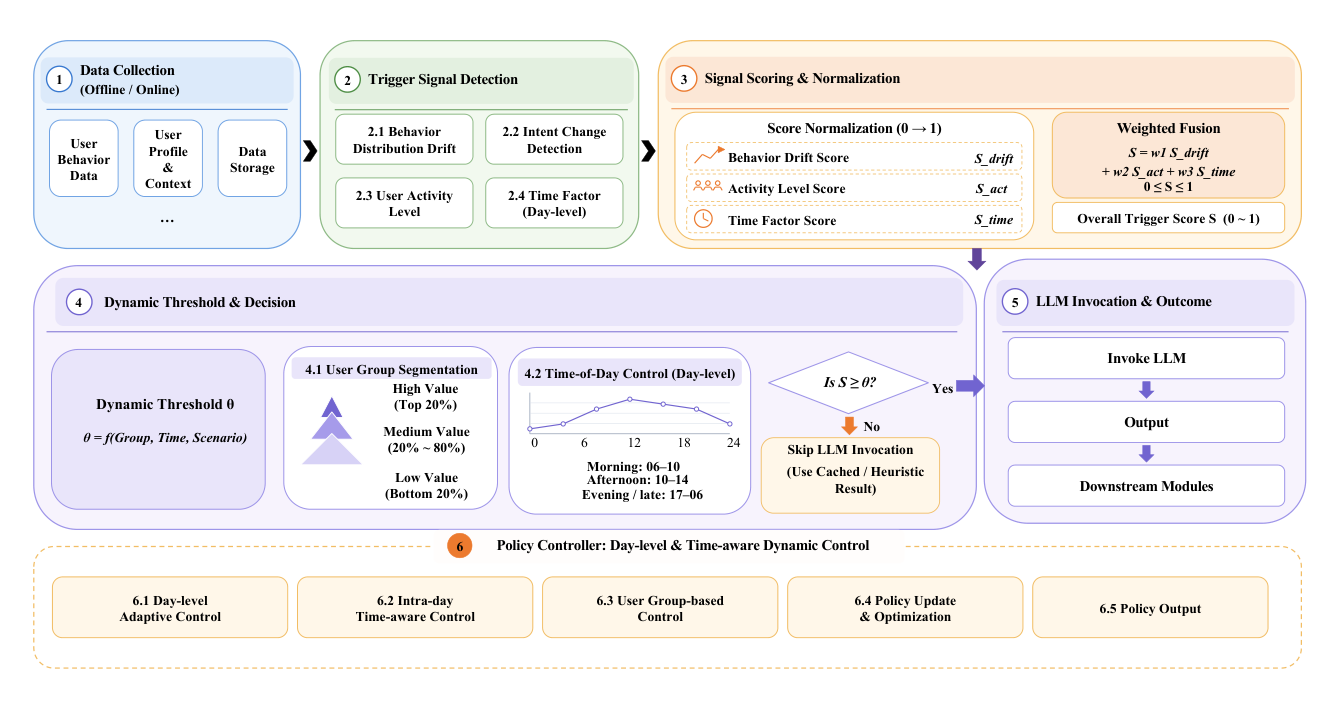
每个事件都调 LLM 是浪费的,因为相邻交互间意图往往稳定,论文把频控形式化为选择性计算问题。令决策上下文为:
$$x_{u,t} = \big(\mathcal{H}^W_{u,t},\ p_u,\ c_{u,t},\ q^{\mathrm{cache}}_{u,t},\ h^{\mathrm{call}}_{u,t}\big) \tag{6}$$
$\mathcal{H}^W_{u,t}$ 是长度 $W$ 的近期历史窗口,$p_u$ 是稳定画像,$c_{u,t}$ 含渠道、设备、场景、时间,$q^{\mathrm{cache}}_{u,t}$ 是缓存意图,$h^{\mathrm{call}}_{u,t}$ 是近期调用历史。二元动作 $a_{u,t} \in \{0,1\}$ 要么调 LLM 刷新意图,要么复用缓存/启发式结果。给定下游效用 $R(q;x)$,一次反事实刷新的价值为:
$$\Delta_{u,t} = \mathbb{E}\big[ R(q^{\mathrm{llm}}_{u,t}; x_{u,t}) - R(q^{\mathrm{cache}}_{u,t}; x_{u,t}) \mid x_{u,t} \big] \tag{7}$$
令 $C^{\mathrm{llm}}_{u,t}$、$L^{\mathrm{llm}}_{u,t}$ 为调用成本与延迟,对每个用户组 $g$ 与时间桶 $b$:
$$\max_{\pi}\ \mathbb{E}_\pi\big[ a_{u,t}\Delta_{u,t} - \lambda_c a_{u,t} C^{\mathrm{llm}}_{u,t} - \lambda_l a_{u,t} L^{\mathrm{llm}}_{u,t} \big] \tag{8}$$
$$\mathrm{s.t.}\quad \mathbb{E}_\pi\Big[ \sum_{(u,t) \in \mathcal{B}_{g,b}} a_{u,t} \Big] \le B_{g,b},\quad \forall (g,b) \tag{9}$$
$B_{g,b}$ 是调用预算,$\lambda_c, \lambda_l \ge 0$ 是资源价格。$\Delta_{u,t}$ 在线不可得,故用触发分估计紧迫度。令 $\widehat{\Delta}_{u,t} = \phi_{g,b,s}(S_{u,t})$ 为从触发分到刷新价值的单调标定、$\mu_{g,b} \ge 0$ 为容量对偶价格:
$$a^\star_{u,t} = \mathbb{1}\big[ \widehat{\Delta}_{u,t} \ge \lambda_c C^{\mathrm{llm}}_{u,t} + \lambda_l L^{\mathrm{llm}}_{u,t} + \mu_{g,b} \big] \tag{10}$$
由单调性,式 (10) 等价于一个上下文相关的分数阈值——这正是把约束优化合法地退化成工程可实现的"打分 + 阈值"的关键一步,阈值同时跟踪调用价值与 LLM 容量的影子价格。
触发信号经组/场景专属参考分位数的鲁棒归一化 $\mathcal{N}_{j,g,s}$ 映射到 $[0,1]$,防止高方差特征仅因量纲而主导。行为分布漂移用 Jensen–Shannon 散度度量类目、品牌、动作类型、渠道的漂移:
$$S^{\mathrm{drift}}_{u,t} = \mathcal{N}_{\mathrm{drift},g,s}\big( D_{\mathrm{JS}}(P^{\mathrm{cur}}_{u,t} \| P^{\mathrm{ref}}_{u,t}) \big) \tag{11}$$
活跃度与时间因子分别为:
$$S^{\mathrm{act}}_{u,t} = \mathcal{N}_{\mathrm{act},g,s}\Big( \log\big(1 + n^{\mathrm{pv}}_{u,t} + \alpha n^{\mathrm{uv}}_{u,t} + \beta n^{\mathrm{act}}_{u,t}\big) \Big) \tag{12}$$
$$S^{\mathrm{time}}_{u,t} = \mathcal{N}_{\mathrm{time},g,s}\big( F_{\mathrm{time}}(b(t), d(t), s) \big) \tag{13}$$
$b(t)$ 标识早高峰 / 午间 / 晚高峰 / 深夜,$d(t)$ 是日级上下文。信号融合为:
$$S_{u,t} = w_1 S^{\mathrm{drift}}_{u,t} + w_2 S^{\mathrm{act}}_{u,t} + w_3 S^{\mathrm{time}}_{u,t},\quad w_i \ge 0,\ \sum_{i=1}^{4} w_i = 1 \tag{14}$$
阈值分解为全局基线 $\theta_0$ 加四项可加修正:$\delta_g(u)$ 用户组偏移(按历史价值分高/中/低)、$\delta_b(t)$ 时间桶偏移(重载时抬高 $\theta$ 抑制低价值调用)、$\delta_s(t)$ 场景偏移(首页刷新 / 搜索 / 详情页)、$\delta_d(t)$ 日级漂移修正:
$$\theta_{u,t} = \mathrm{clip}\big( \theta_0 + \delta_g(u) + \delta_b(t) + \delta_s(t) + \delta_d(t),\ \theta_{\min},\ \theta_{\max} \big) \tag{15}$$
图中高/中/低价值用户阈值分别为 0.45 / 0.60 / 0.75。再叠资格掩码 $m_{u,t}$ 强制冷却期、单用户上限、场景白名单与过载保护,最终线上决策为:
$$a_{u,t} = m_{u,t}\,\mathbb{1}\big( S_{u,t} \ge \theta_{u,t} \big) \tag{16}$$
5. 分层策略契约与参数翻译¶
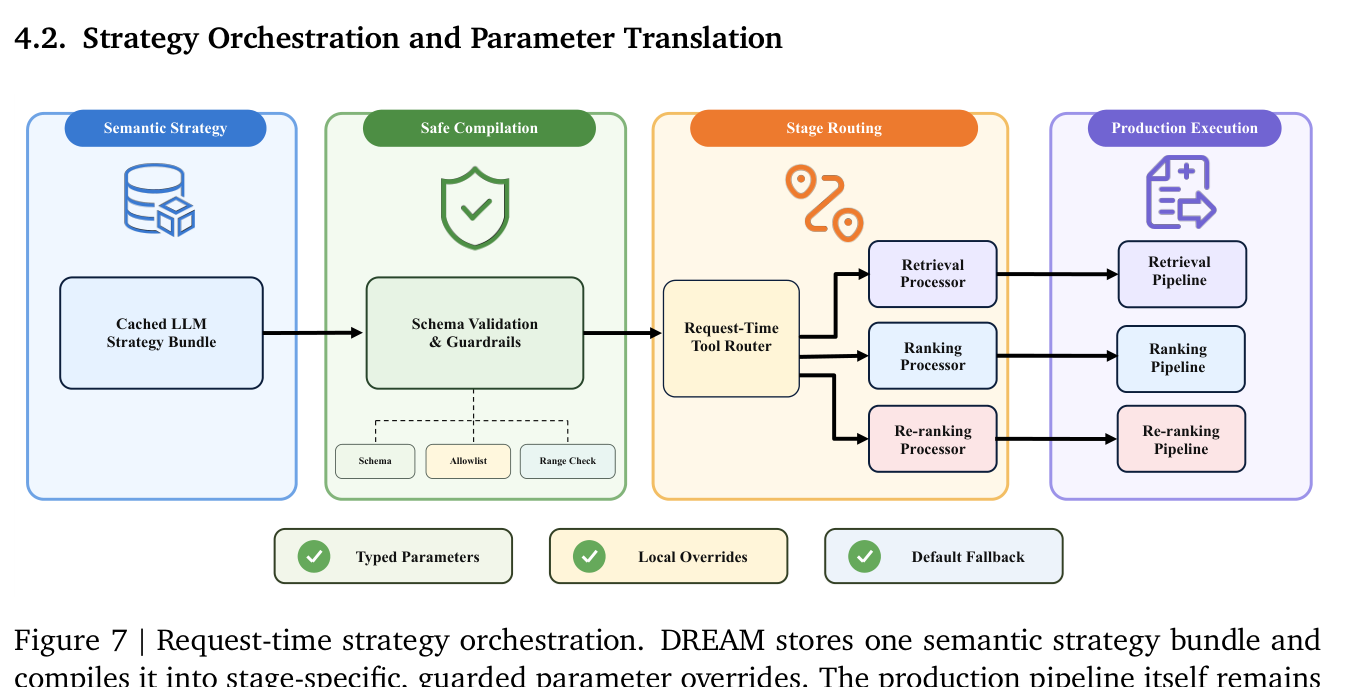
MetaModel 在语义动作空间推理,生产服务消费的却是带类型的数值参数、标识符、过滤器与配额。DREAM 用一份共享策略契约 + 一组分阶段 Tool Processor 桥接:契约全管线共享,参数解释局部于各阶段。决策分三层:M1 确立全局取向(决策依据、目标取向、购买力分层、活跃度分层);M2 是受 schema 约束的 JSON bundle,含目标提升、业务扶持、类目与内容类型偏好、体验约束、位置策略等语义动作;M3 不是自由 LLM 输出,而是把 M2 确定性编译成生产参数的结果。前两阶段跑近线路径,第三阶段跑实时路径做轻量确定性映射。所有字段取值来自严格枚举,压缩输出空间以换稳定性与可审计性。
Table 6 | M2 语义动作与其当前消费方
| M2 field | Semantic decision | Current consumer |
|---|---|---|
| intent_summary | 当前意图与供给摘要 | MetaModel planning context |
| ranking_weight_boost | CTR / IPV / CVR / GMV 相对侧重 | Ranking, re-ranking |
| business_support | 需保护的白名单 PlanID | Ranking 截断与下游混排 |
| category_preference | 对类目或类目标签值的偏好 | Retrieval, ranking, re-ranking |
| cardtype_preference | 对商品/视频/直播/内容供给的偏好 | Retrieval, re-ranking |
| experience_constraints | 曝光、购买、密度约束 | Re-ranking |
| top_ctr_strategy | 页面级 top-CTR 与倒序开关 | Re-ranking |
请求时编排把 LLM 推理与延迟敏感的服务路径解耦:近线 MetaModel 把最新有效 bundle 写进在线缓存,请求到达时 Tool Process 读缓存、校验版本与 schema 后分发给三个 processor。令 $a_u$ 为用户 $u$ 的缓存策略、$p^0_s$ 为阶段 $s$ 的默认参数、$\mathcal{T}_s$ 为其确定性翻译器:
$$p^{\mathrm{exec}}_s = \mathrm{Guard}_s\big( p^0_s \oplus \mathcal{T}_s(a_u) \big),\quad s \in \{\mathrm{ret}, \mathrm{rank}, \mathrm{rerank}\} \tag{17}$$
$\oplus$ 是局部覆盖而非整份配置替换,processor 只读自己白名单里的字段,因此 bundle 缺失、过期或格式错误时对应默认参数保持不变。排序阶段的翻译最具体:对每个目标 $i$ 读取配置的基础权重 $w^0_i$ 与有界语义档位 $b_i \in \{-2,-1,0,1,2\}$:
$$\delta_i = w^0_i b_i \tag{18}$$
排序服务把 ltr_ctr_delta 等四个 delta 作为乘性修正作用到标定后的目标项上:
$$f_{\mathrm{rank}} = f_{\mathrm{ltr}} \prod_i \big(1 + \delta_i \hat{v}_i\big) \tag{19}$$
$\hat{v}_i$ 是该目标的生产标定预估值。注意这是在原 LTR 分数之上做修正而非替换——LLM 从不直接产出排序分。类目多样性则通过打散窗口调整:
$$n^{\mathrm{new}}_c = \max\big(1,\ n^{\mathrm{default}}_c + b_c\big) \tag{20}$$
负值强制打散,正值在意图明确时允许集中。
四道校验门:JSON 解析 → schema 校验 → 阶段级白名单 → 参数范围校验。业务扶持有上限、打散窗口有正下限、枚举域外档位直接拒绝;编译结果被限定在指定请求与 processor 内,override 不能污染无关阶段或全局配置,任一门失败即记录并执行生产默认值。重排阶段配置的是既有生产 Generator 或白名单重排配方,LLM 不产出 item ID 也不产出最终排列。
6. 离线 RL:production-path replay + 二元 Evaluator 奖励¶
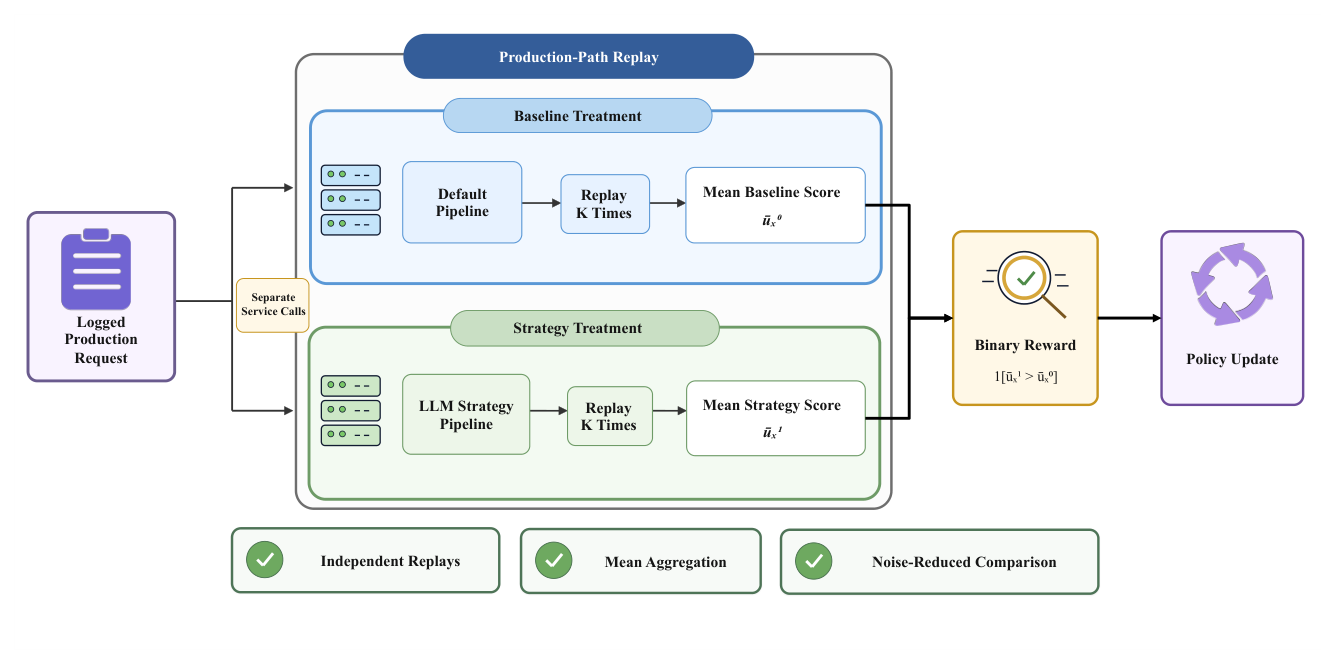
DREAM 把策略离线训练,但rollout 走真实生产管线,避免在用户流量上探索。学习问题是单步上下文决策:给定一条日志请求,MetaModel 产出 strategy bundle,生产管线执行,list 级 Evaluator 给代理结果,不模拟后续点击、成交或状态转移。对每条记录 $x$ 构造两个 treatment:
$$L^0_{x,k} = F(x;\ p^0,\ \xi^0_{x,k}) \tag{21}$$
$$L^1_{x,k} = F\big(x;\ p^0 \oplus \mathcal{T}(a_x),\ \xi^1_{x,k}\big),\quad a_x \sim \pi_\theta(\cdot \mid x) \tag{22}$$
$F$ 是既有"召回–排序–重排"管线,$p^0$ 是默认配置,$\xi$ 表示单次 replay 遇到的实时特征状态、模型状态与服务波动。两个 treatment 作为独立服务调用发出——即便来自同一条日志,因为在线特征与生产模型在 replay 时才解析,输出未必可复现。故每个 treatment 执行 $K$ 次,用生产 list 级 Evaluator $E$ 打分:
$$u^z_{x,k} = E(L^z_{x,k},\ x),\quad z \in \{0,1\},\ k = 1,\dots,K \tag{23}$$
$$\bar{u}^z_x = \frac{1}{K} \sum_{k=1}^{K} u^z_{x,k} \tag{24}$$
奖励刻意做成二元的——只有策略的平均 Evaluator 分超过同一条日志请求上默认管线的平均分时才给正奖励:
$$r(x, a_x) = \mathbb{1}\big( \bar{u}^1_x > \bar{u}^0_x \big) \tag{25}$$
$$\max_\theta\ J(\theta) = \mathbb{E}_{x \sim \mathcal{D},\ a_x \sim \pi_\theta(\cdot|x)}\big[ r(x, a_x) \big] \tag{26}$$
这消化了 Evaluator 分数在不同请求间的尺度差异,直接问"个性化全链路 override 是否优于生产默认"。分差保留作诊断,但训练奖励本身是二元的,不混入 rank、lift、课程竞争或教师蒸馏项。
实验设置¶
主实验是淘宝首页"猜你喜欢"的生产 A/B。基线是现有管线;两个累积式 treatment 都启用同一套 Intent Engine、MetaModel、参数翻译与安全护栏,先加重排控制再加精排控制,以隔离"把控制面扩展到下一阶段"的条件增益。所有结果都是相对提升,绝对值因保密省略。指标定义:PV 有效曝光事件数;IPV 归因的商品详情页访问数;Core IPV 限定核心商品域的 IPV;PCTR 剔除回退重复曝光后的点击率;Click UV 至少一次有效一跳点击(dpv1 > 0)的近似去重访客数;UCTR = Click UV / Exposure UV;GMV 归因已付订单成交额;Ad Cost 广告消耗,被当作平台商业价值的正向度量。
Intent Engine 下游实验是独立在线 A/B:treatment 把对应意图字段接入生产场景,基线是同场景不接意图信号,分别报告全域(Table 8)与 Heuristic Recommendation 场景内(Table 9)效果。额外指标:Inquiry Card Clicks 问询卡有效点击数;CTR 问询卡落地页内商品的有效一跳点击 / 该场景 PV;Transaction Volume 归因该场景的完成订单数。Intent Engine 自身用两套协议评估:LLM-as-a-Judge(裁判模型拿到预测意图与评估窗口内的后续行为,按与后续曝光/搜索/点击的一致性逐字段打分,后续行为不足的样本剔除)与 Search-Behavior Recall(以意图推理后的第一个搜索会话为证据,search term recall 衡量预测意图与后续 query 是否语义一致,filter recall 衡量预测偏好是否命中用户选择的筛选条件)。
主要实验结果¶
Table 7 | Meta Engine 逐阶段累积的线上相对提升(vs 生产基线)
| Configuration | PV ↑ | IPV ↑ | Core IPV ↑ | PCTR ↑ | Click UV ↑ | UCTR ↑ | GMV ↑ | Ad Cost ↑ |
|---|---|---|---|---|---|---|---|---|
| DREAM (@ rerank) | +1.03% | +2.06% | +2.39% | +0.76% | +0.54% | +0.53% | +0.88% | +0.21% |
| DREAM (@ rerank & rank) | +1.04% | +2.71% | +3.06% | +1.25% | +0.68% | +0.81% | +1.31% | +0.02% |
结论分析:仅控重排已在所有指标上转正;扩展到精排后 IPV / Core IPV / GMV 再涨 0.65 / 0.67 / 0.43 个百分点,PCTR 从 +0.76% 升到 +1.25%。关键读法在 PV:两个 treatment 的 PV 几乎不变(+1.03% vs +1.04%),说明深层阶段的增量收益来自既有曝光的互动与转化效率,而不是多发曝光——这排除了"靠灌量刷指标"的解释,是全文最有说服力的对照。Ad Cost 从 +0.21% 掉到 +0.02%:论文未解释,推测是 IPV 导向的权重调整挤压了广告位竞争力。
Table 8 | Intent Engine 下游应用的全域线上 A/B
| Application | IPV ↑ | Core IPV ↑ | PCTR ↑ | Transaction Volume ↑ |
|---|---|---|---|---|
| Recall (Cognitive Recommendation) | +0.80% | +0.91% | +0.84% | +0.36% |
| Recommendation Strategy Adaptation | +0.52% | +0.70% | -0.02% | +0.33% |
Table 9 | Heuristic Recommendation 场景内线上 A/B
| Application | PV ↑ | Inquiry Card Clicks ↑ | CTR ↑ |
|---|---|---|---|
| Recall (Heuristic Recommendation) | +5.06% | +7.17% | +2.00% |
| Explicit Text Interaction | +7.41% | +10.64% | +3.01% |
结论分析:全域层面两个应用都是正收益;策略自适应 PCTR 中性(−0.02%)但 Core IPV +0.70%,说明它改的是转化深度而非点击率——与它调的是召回配额/打散参数而非排序目标一致。论文强调"全域指标远比场景内指标难推动",故 0.5%–0.9% 的全域提升在工业语境下有意义。场景内两项优化互补:召回接入决定哪些需求被做成问询卡,文案优化决定每个需求怎么被说出来。
Table 5 | Intent Engine 输出被各下游场景消费的方式
| Application Scenario | Intent Fields Consumed | Implementation |
|---|---|---|
| Recall / Cognitive Recommendation | L1 Demand Category; L2 Subcategory | Tag-based Recall |
| Recall / Heuristic Recommendation | L1 Demand Category; L2 Subcategory; L2 Attribute Preference–Priority Attribute | Inquiry Card |
| Explicit Text Interaction | L0 User Profile; L1 Demand Category & Demand Scenario; L2 Decision State | Inquiry Card |
| Recommendation Strategy Adaptation | L1 Demand Category & L1 Category Cognition; L2 Subcategory & Priority | Personalized Parameter |
消融与分析¶
Table 2 | Multi-Scale Intent Model 的组件消融
| Variant | LLM-as-a-Judge Overall Score | Search-Behavior Recall: Search term | Search-Behavior Recall: Search Filters |
|---|---|---|---|
| Baseline | 71.32% | 50.57% | 24.25% |
| + Routing | 78.20% | 51.68% | 26.79% |
| + Routing + Self-Evolution | 84.74% | 56.05% | 26.40% |
逐项分析:路由把裁判总分抬高 6.88 个百分点并同时改善两项 recall——说明"把 6.3% 的困难请求丢给 4B 专家"的收益远大于算力成本。再加自进化后裁判分再涨 6.54 个百分点、search term recall 再涨 4.37 个百分点,但 filter recall 回落 0.39 个百分点(仍高出基线 2.15 个百分点)。这处轻微回退很说明问题:on-policy 蒸馏把 4B 的结构化判断压回 0.8B 时收益集中在意图类型/类目这类粗粒度决策上,而 filter 对应的细粒度属性偏好本就是 expert 的强项,蒸馏反而略微磨平了它。
Table 4 | Dreaming 整合前后的逐字段评估(683 个匹配用户的配对设计)
| Layer | Field | Daytime | After Dreaming |
|---|---|---|---|
| Intent | Intent type | 0.583 | 0.680 |
| Intent | Priority | 0.524 | 0.571 |
| L1 | Demand category | 0.570 | 0.580 |
| L1 | Category cognition | 0.819 | 0.838 |
| L1 | Demand scenario | 0.797 | 0.817 |
| L1 | Temporal node | 0.893 | 0.897 |
| L1 | Intent confidence | 0.592 | 0.611 |
| L2 | Subcategory | 0.477 | 0.523 |
| L2 | Decision state | 0.561 | 0.592 |
逐项分析:配对设计(同一批用户的在线终态列表 vs 其整合版,用同一份次日行为证据评估)压掉了用户行为差异带来的方差。所有字段均有提升但增益分布极不均匀:Intent type(+0.097)、Priority(+0.047)、Subcategory(+0.046)涨得最多,temporal node(+0.004)、demand category(+0.010)几乎不动。这正好印证 Dreaming 要治的三种病——意图膨胀与遗漏体现在"有几条意图、谁更重要、细到哪一级",而不是"是不是这个大类目"。换言之 Dreaming 的价值本质是跨会话的组织能力而非单点识别能力。
Table 11 | 4B replay-RL 策略相对其 Base 的离线相对提升
| Policy | pCTR ↑ | pCVR ↑ | pIPV ↑ | pGMV ↑ | Valid ↑ |
|---|---|---|---|---|---|
| RL (4B) | +2.42% | -0.99% | +1.38% | +0.37% | +22.25% |
分析:Base 与 RL 共用同一批留出请求、策略 prompt、动作 schema、validator / compiler / 执行引擎 / 生产 Evaluator,因此这个对比干净地隔离出 replay RL 的贡献。四个诊断里三个转正,pCVR −0.99% 是明确代价——二元奖励只问"整体 Evaluator 分是否胜出",不做多目标仲裁。真正的大头是 Valid +22.25%,即从 80.86% 升到 98.85%(+17.99 个百分点):replay RL 最主要的作用其实是把 LLM 教会生成可编译、可执行的 bundle,而不是教它选更好的策略。
Table 10 | 策略执行层的可控参数(L1 选稀疏策略子集,L2 映射到护栏内的具体值)
| Stage | Module | Control Mechanism |
|---|---|---|
| Retrieval | BE Chain | 开关召回路径 |
| Retrieval | Plan / Category Quota | plan 与类目间重分配配额 |
| Blending | Ranking Formula | 调 CTR / IPV / CVR / GMV 权重 |
| Blending | Natural Blending Alpha | 混排公式各目标权重 |
| Blending | Global-Push Alpha Hat | 缩放非全域推桶 alpha 乘子 |
| Blending | Extreme-CTR Strategy | 坑位公式 CTR 激进/均衡切换 |
| Blending | PVR Control Weighting | 合并广告与 boost 分的系数 |
| Boosting | Boost Weighting | 为指定 item / plan 注入 boost |
| Experience | Category Diversity | 同类目卡片最小打散间隔 |
| Experience | CSR Filtering | 移除低于卡型满意度阈值的卡 |
| Experience | DTR Filtering | 移除高于卡型不喜欢阈值的卡 |
| Experience | Personalized Fatigue | 疲劳衰减系数 |
| Experience | Vector Scatter | embedding 相似度间隔阈值 |
| Experience | Rule-based Scatter | 按卡型/品牌/卖家/类目设间隔 |
| Re-ranking | Generator | 注入额外 generator 模块 |
参数同时覆盖相关性旋钮(召回路径、排序权重、混排 alpha)与体验旋钮(多样性、疲劳、过滤);MetaModel 不会同时操纵全部,M2 按策略取向选稀疏子集、M3 翻译成具体值。
Case Study¶
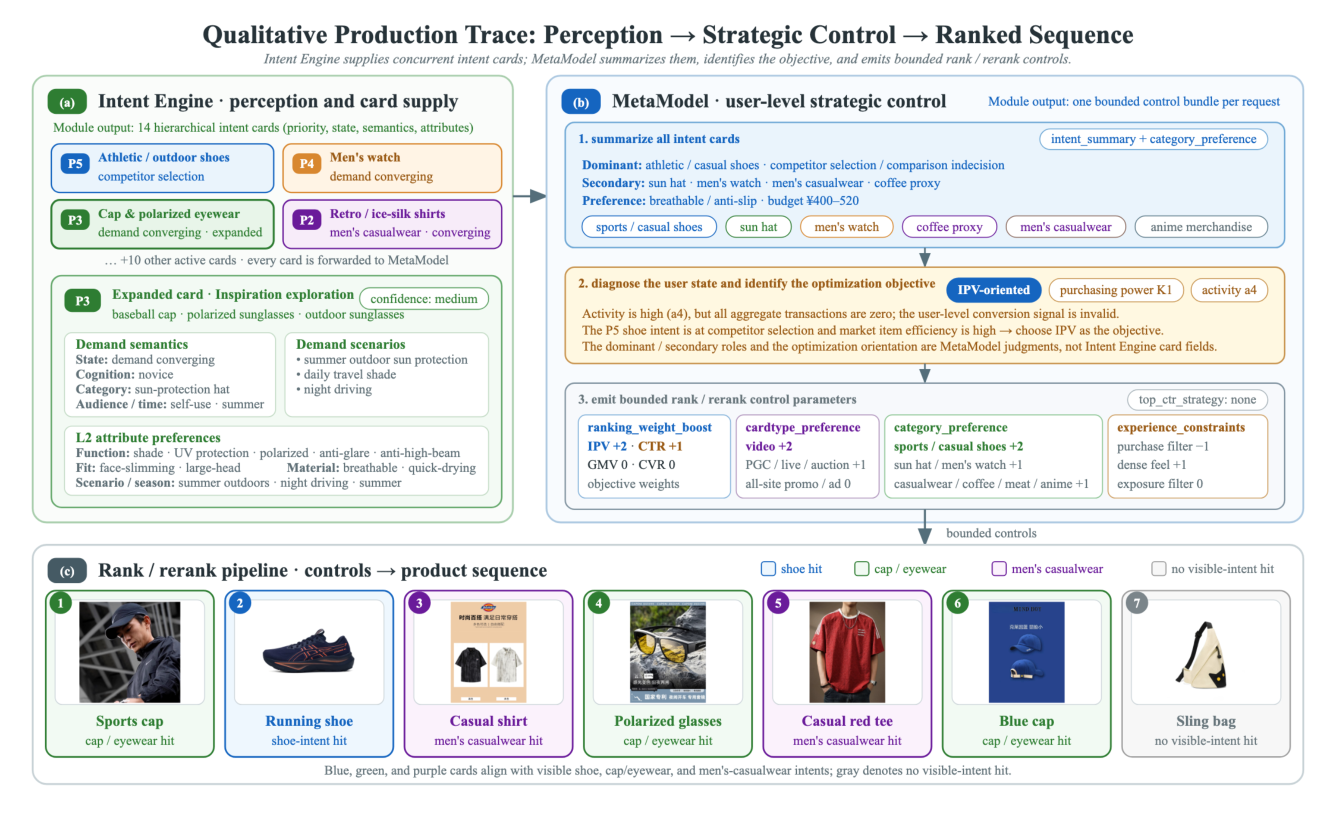
一条脱敏生产请求的全链路追踪:(a) Intent Engine 在 14 条活跃意图中给出多张并发意图卡(P5/P4/P3/P2),展开的 P3 卡是以棒球帽与偏光/户外太阳镜锚定的 inspiration exploration,需求收敛中、置信度中等。(b) MetaModel 拿到完整卡集之后才开始工作:判定运动/休闲鞋为主导意图且处于竞品比选态,防晒帽、男表、男装休闲、咖啡代下单为次要意图——主/次分派是 MetaModel 的判断,不是 Intent Engine 的字段。该请求购买力 $K_1$、活跃度 $a_4$,但汇总交易计数全为零,故用户级转化信号被判无效;因主导意图已到竞品比选且市场级单品效率高,MetaModel 选 IPV 导向并参数化为稀疏 bundle:IPV=+2、CTR=+1、GMV=CVR=0,video +2,选定卡型与类目 +1/+2,购买过滤 −1、密集布局 +1。(c) 管线消费这些有界 override 返回商品序列,卡片着色对应各条可见意图——论文明确说明这只是语义对齐的着色,不构成因果归因。
核心贡献总结¶
- 提出"叠加式 agentic 元控制"范式:不替换任何管线模型,只叠一层感知-决策-执行闭环,用"默认兜底 + 个性化 override + 安全护栏"把 LLM 权限约束在可回滚、可审计的范围内。
- 三层 Intent Engine + 端云 F1–F4 漏斗:行为词表 6 → 60+ 类,端上 GRU 放行约 15%,端到端上报约 8.7%;0.8B 主 Agent 同步出增量意图,6.3% 困难请求升级到 4B 专家再经 on-policy 反向 KL 蒸馏回灌。
- Dreaming 机制:用夜间闲置 GPU 以六种原子操作在全天行为轨迹上重建完整意图列表,专治在线窄视野导致的意图膨胀、不准与遗漏。
- M1→M2→M3 分层策略契约:语义动作与生产参数解耦、枚举化输出空间、四道校验门 + 局部 override,使 LLM 能协调跨阶段耦合决策却不可能产出任意服务配置或最终排列。
- production-path replay 离线 RL:rollout 走真实生产管线但隔离压测流量,二元奖励只问"是否胜过默认管线",把 bundle 可执行率从 80.86% 拉到 98.85%。
- 大规模线上验证:淘宝首页 A/B,重排+精排联控 IPV +2.71%、Core IPV +3.06%、GMV +1.31%,PV 基本持平。
与已归档相关工作的对比¶
RecGPT-Mobile RecGPT-Mobile: On-Device Large Language Models for User Intent Understanding in Taobao Feed Recommendation (Taobao & Tmall Group, 2026-05-06)¶
关系:独立并发(本文未引用 RecGPT-Mobile,同公司平行工作,殊途同归)· 已加载对方精读
- 共同关注的问题:同一个 root cause——"用 LLM 理解会话级实时意图"的价值是真的,但按行为频率逐事件调用 LLM 在工业流量下无论算力、延迟还是功耗都不可承受;两者都拒绝"周期性离线画像"这个廉价替代。
- 相近的技术骨架:流程图几乎重叠——端上把原始行为映射为离散标签/特征流 → 用轻量统计/序列模型量化"意图是否变了" → 融合分数对比阈值决定是否唤起小 LLM → 未触发走缓存/启发式路径 → 触发后写缓存并回流日志。RecGPT-Mobile 的漂移分 $\Delta_{\text{intent}} = \lambda_1 \Delta H + \lambda_2 (1 - JA) + \lambda_3 JS$ 与 DREAM 的式 (14) 是同一个"归一化信号加权融合 + 阈值判决"模板,连 JS 散度都撞上了(DREAM 式 (11))。
- 本文的差异与推进:RecGPT-Mobile 把 0.6B LLM 整个搬到端上,触发与推理都在客户端,产出是单个 next-query;DREAM 把触发拆成端云两级(F2 端上 GRU + F4 云端准入),LLM 留在云端,产出是结构化多意图列表,且意图不是终点而是 Meta Engine 参数控制的输入。DREAM 的阈值还多一层制度化:式 (15) 拆成四项可加修正并有式 (10) 的对偶价格解释——RecGPT-Mobile 的 $\tau$ 只是全局定值超参(0.8)。
- 可比的方法 / 实验差异:RecGPT-Mobile 报 21% 触发率、功耗降到常驻模式的 40%;DREAM 报 F2 放行约 15%、端到端上报约 8.7%、6.3% 升级到 4B——DREAM 的漏斗更陡,代价是需要云侧配合而非纯端上。收益上 RecGPT-Mobile 场景内 +1.8% CLICK / +2.5% GMV,DREAM 首页全场景 +1.31% GMV,口径不可直接比较;但同司两条路线并存本身说明端侧意图与云侧意图控制是淘宝内部并行推进的两个工程赌注。
AIR AIR: Atomic Intent Reasoning — Bringing LLM Semantics to Industrial Cross-Domain Recommendations (HK PolyU + Kuaishou, 2026-06-09)¶
关系:独立并发(本文未引用 AIR,两者对同一成本困境给出互补解)· 已加载对方精读
- 共同关注的问题:AIR 把困境写得更直白——在线 LLM 推理在毫秒级延迟下代价不可接受,而周期性离线画像又跟不上快速演化的兴趣。这与 DREAM §4.1 开篇"每个事件都调 LLM 是浪费的"是同一枚硬币的两面:如何在工业延迟/成本预算内保住 LLM 级别的意图语义。两者也都不满足于扁平标签,都构造了层级化意图表示(AIR 的意图树 vs DREAM 的 L0/L1/L2)。
- 相近的技术骨架:抽象后都是"把 LLM 从每请求同步路径摘下来 → 维持一份可增量维护的结构化意图状态 → 在线用廉价操作组装 → 交给下游消费"。AIR 的节点权重 $w_u = \log(1+N(u))\sum_k \exp(-\lambda \Delta t_k)$ 与 DREAM 的 $R(i)$ 做同一件事:用行为强度 × 时间衰减给并存意图排序,因为下游只能消费 top-K。
- 本文的差异与推进:分歧点在"LLM 什么时候跑"。AIR 走彻底离线化(原子行为-意图对灌进知识库,在线零 LLM,用意图树 + 目标感知检索 + MHA 替代,换约 400× 吞吐);DREAM 走在线门控(LLM 仍在线上跑,只是被压到 8.7% 调用面)。前者上限是"原子意图组合能否逼近整序列语义",后者是"触发器能否不漏掉真正的变点"。另一处结构差异是输出去向:AIR 的意图是喂进 CTR 模型的一路特征,仍在模型内部;DREAM 的意图喂给 MetaModel 生成管线参数,作用在模型外部——这也解释了为何 DREAM 需要 Dreaming 而 AIR 不需要(AIR 的原子对幂等可重放,DREAM 的在线增量会累积漂移)。
- 可比的方法 / 实验差异:AIR 有公开 benchmark SOTA 对比 + 快手电商 A/B(+3.446% GMV),DREAM 完全没有公开数据集实验。实验可核验性 AIR 更强;控制面广度 DREAM 覆盖三阶段十余类参数,远超 AIR 的单点特征注入。
AgentX AgentX: Towards Agent-Driven Self-Iteration of Industrial Recommender Systems (Kuaishou, 2026-06-25)¶
关系:显式引用但原文未展开对比(仅在 introduction 的 orchestrator 一类里以引文号带过,无方法/指标层比较)· 已加载对方精读
- 共同关注的问题:两篇都指向"工业推荐的策略迭代被人力与个体经验锁死",都坚持真实线上 A/B 才是唯一可信的奖励信号,也都要求闭环把经验沉淀复利(AgentX 的 Trajectory Memory / avoid set,DREAM 的 Strategy Memory 正例作候选、负例作约束)。
- 相近的技术骨架:抽象后高度重合——"LLM agent 在有界动作空间生成候选 → 经 validator / guardrail 准入(不合规直接拒绝并记录)→ 生产环境安全执行 → 用线上/评估器结果判定成败 → 双向写回记忆约束下一轮生成",连"负结果资产化"的思路都一致。
- 本文的差异与推进:控制面完全不同。AgentX 控制离线的开发迭代周期,产出是代码 artifact,周期以天/周计;DREAM 控制在线的每请求参数,产出是有界枚举化 bundle,周期以请求计。DREAM 对这类工作的批评正是"其环路服务于架构级迭代而非用户级参数的实时校准",而它自己的代价是动作空间被压缩到十几类预定义旋钮(Table 10),无法像 AgentX 那样发明新机制。两者其实互补:AgentX 决定管线里有什么模块,DREAM 决定这些模块此刻对这个用户怎么配置。
- 可比的方法 / 实验差异:AgentX 报告三周内把 374 个想法变成 10 次上线、主 feed app 时长 +0.561%,"吞吐"叙事有明确计量;DREAM 没有任何策略迭代速度的量化,只有终端业务指标。反过来 AgentX 没有实时意图输入,DREAM 的 Intent Engine 恰好补上这块。
讨论与局限性¶
值得借鉴的设计。第一,把"控制"和"模型"彻底分离:LLM 不产出 item ID、不产出排序分、不产出最终排列,只在 LTR 分数上做式 (19) 的乘性有界修正,主链路永远是安全网,任一校验失败即无声退回默认配置——这让 agentic 能力可以在零替换风险下增量上线。第二,枚举化语义动作空间(档位限定 $\{-2,\dots,2\}$、类目键不超过六个、卡型至少三个非零且至少一个负值)把 LLM 自由度压到可穷举验证的程度,同时让每次决策可审计。第三,式 (10) 从约束优化到"打分+阈值"的等价退化给了频控干净的理论出口:阈值就是容量的影子价格。第四,Dreaming 复用夜间闲置 GPU,边际成本近乎为零。
存在的局限与争议。其一,实验体系明显偏弱:无公开数据集实验,未与任何已发表 agentic 方案做可比实验,所有对比都是"vs 生产基线"且绝对值保密——外部读者无法判断增益里有多少来自 agentic 控制本身、多少只是"给管线加了一层个性化参数"(缺规则版个性化参数表的对照组)。其二,核心机制缺消融:Strategy Memory 与在线奖励环被反复强调却无"去掉会掉多少"的实验;式 (14) 的 $w_i$、式 (15) 的四项偏移、三档阈值都无敏感性分析。其三,Table 11 暴露奖励设计问题:二元奖励最大的增益是可执行率而 pCVR 为负——当前 RL 更像在教模型"输出合法 JSON",多目标仲裁仍主要来自 prompt 里的启发式规则。其四,数字口径不自洽:摘要用"上报量约 8.7%"、正文 F2 门写"约 15%",两者关系从未交代。其五,天花板受限于动作空间:Table 10 全是既有系统已暴露的配置项,DREAM 的上限就是"人能调的东西被调得更个性化更及时"。其六,近线路径的时效性:M1/M2 跑近线写缓存、请求时只读缓存,策略对会话内意图突变的响应存在缓存新鲜度滞后,论文既未给量级也未讨论缓存过期时的降级表现。
工业落地价值与部署细节。DREAM 已在淘宝首页"猜你喜欢"全量 A/B 验证,并经统一出口接入 Homepage Feed / ND / Supply / TAB2。部署细节:F4 云端语义还原每条行为约 5ms,F3 单包最多 50 条行为,异步 4B 层承接 6.3% 请求且不阻塞同步路径;replay 训练走隔离压测流量,不写曝光/归因/业务计数,且训练与服务共用同一套 schema、翻译逻辑、范围检查与兜底行为——这消除了离线训练与线上执行之间最常见的一类偏差;上线前必过五项检查并按用户状态与意图分群复核。Intent Engine 的下游收益(全域 Core IPV +0.70%~+0.91%,问询卡场景内点击 +7.17%~+10.64%)说明结构化意图作为中间件的复用价值可能高于任何单一下游应用——这也是最值得其他团队直接抄的组织方式:把意图生产与消费解耦,让感知层只对意图质量负责。