CORAL:把 LLM Agent 放进生产推荐系统控制面的持续优化闭环¶
Muhammad Rafay Azhar, Yuhang Zhou, Gilbert Jiang, Yuchen Wang, Rahul Sharma, Matthew DeSousa, Jiayi Liu, Xin Guo, Lizhu Zhang, Xiangjun Fan · Meta AI · arXiv 2609.02730 · 2026-09-02(论文标注日期 September 3, 2026)· 正文 8 页 + 附录
CORAL = Constraint-Optimized Recommender via an Agentic Loop。
这不是一篇推荐模型论文,也不是一篇 LLM 建模论文。它是一份工业推荐系统"控制面自动化"的部署报告:召回模型、排序模型、服务栈一个都不动,只把工程师原本手工设定的那批控制参数(各召回源的候选预算份额、各人群的服务算力档位)交给一个通用 LLM,让它每 3 天看一次运行指标、回忆自己上一轮改了什么以及线上量到了什么效果、提出新的调整、经一个数值优化器投影到预算可行集后直接下发到线上,再用 A/B 量出结果写回记忆。
一、研究动机与背景¶
1.1 被人力而非机会空间限定的迭代¶
论文开篇给出的图景是工业推荐从业者都熟悉的:现代工业推荐器不是一个模型,而是一套多阶段系统——候选召回、排序、服务,每一层的行为都由一大批参数与策略支配:召回预算(retrieval budgets)、排序权重(ranking weights)、服务与缓存策略(serving and caching policies)、分人群处置(per-segment treatments)等等。
关键在于,这些选择大多由工程师人工设定,而不是与模型一起端到端学出来的。改进它们的方式是经典的人工迭代:提出假设 → 实现改动 → 线上实验评估 → 依据结果行动 → 重复。论文用一句话点破这个循环的结构性问题:
progress scales with the number of engineers and experiments rather than with the size of the opportunity. (进展随工程师人数与实验次数扩张,而不是随机会空间的大小扩张。)
由此派生出三条具体缺陷:
- 慢且保守:每次实验只能探测巨大设计空间中的一小块区域;
- 被动而非前瞻:改动通常由已观察到的回归(regression)或机会触发,是 reactive 而非 anticipatory 的;
- 长期不复核导致漂移:因为每轮周期耗时且算力昂贵,系统的一部分被长期搁置、在两次干预之间基本冻结——而内容、用户行为、上游模型仍在持续变化,于是系统会在两次干预之间偏离自己的最佳工作点。
论文特别指出,这些效应对低信号用户(low-signal users)与新用户最严重:他们的行为在指导多数决策的聚合指标里被稀释、代表性不足;同时这些决策还被运行约束(服务容量、算力预算)耦合在一起——动一个召回源的预算就要从别处扣。
1.2 已有 LLM 工作停在哪里¶
论文承认 LLM 已被用于排序(Hou et al., 2024;Zhang et al., 2023)、用户建模、给 agent 装记忆与工具(Shen et al., 2026 = 2605.14401;Chen et al., 2026;Peng et al., 2025),以及自动化离线模型开发与系统优化的一部分(Lao et al., 2026 = AgentX 2606.26859;Liu et al., 2026 = NOVA 2606.27243;Hu et al., 2026 = 2603.26100)。但它给出的定位判断是:
Most such systems, however, act on the model, the user representation, or the offline development pipeline; comparatively few place an agent in a continual, closed loop that acts on a live production system and learns from the measured consequences of its own decisions.
即:既有 agent 作用的对象是模型、用户表征或离线开发流水线;很少有 agent 处在一个持续闭环里,直接作用于线上系统,并从自己决策的实测后果中学习。CORAL 要补的正是这一格。
需要注意的是,这一段是 CORAL 对 AgentX / NOVA 一类工作的全部讨论——只有类别层面的定位区分,没有任何方法级或指标级的对比(详见后文「与已归档相关工作的对比」)。
1.3 四点贡献(原文自述)¶
- 把推荐系统的持续、agent 驱动优化形式化为一个部分可观测、非平稳、带约束的优化问题,其中 LLM 策略从自身先前动作的实测效果中在上下文里精炼决策;
- 提出 CORAL harness——把一个通用 LLM 变成线上推荐器持续优化器所需的上下文、工具与闭环,并展示它能跨 surface、跨决策类型泛化,而非绑死在单个 lever 上;
- 报告两个大规模部署,均以 A/B 实验评估,二者合起来"横跨 engagement–efficiency frontier",含低信号与新用户的收益;
- 提炼运营这样一个闭环的实践经验,包括从人工监督走向 guardrail 下自治运行的路径。
二、问题形式化¶
设 $s$ 为这批可调控制参数的一个配置(configuration)。它的效果依赖于周边的运行上下文——推荐器服务的用户与内容、它所用的上游模型——而这个上下文 agent 无法直接观测,且随时间变化。论文用按周期 $t$ 索引系统响应的方式来刻画这种依赖:在周期 $t$ 下采用配置 $s$,推荐器取得业务目标 $J_t(s)$(论文取为 engagement),并产生运行成本 $c_t(s)$,后者不得超过固定预算 $B$。
论文强调目标与约束都由运营方设定而非方法本身规定:这个形式化对二者不作任何特殊假设,任何"在有界资源约束下希望改进的目标"都能套进同一形式。因此它不仅覆盖"在成本预算下最大化目标",也覆盖其对偶——"在把目标维持在某个水平的前提下最小化成本";论文的两个部署恰好各取一种形式。
把可调面切成 $N$ 个控制单元(control unit),索引 $i = 1, \dots, N$;每个单元是一个组件,其设置 $s_{t,i}$ 由 agent 控制,取自一个可行集——要么是一个有界连续值,要么是一个离散集合中的选项。举例:一个控制单元可以是一个召回源,其设置是它在固定候选预算中占的份额;也可以是一个用户分群,其设置是从离散服务菜单中选出的一种处置。每个决策周期 $t$,agent 选出配置 $s_t = (s_{t,1}, \dots, s_{t,N})$。
周期 $t$ 的最优配置为
$$s_t^* = \arg\max_{s} J_t(s) \quad \text{subject to} \quad c_t(s) \le B \tag{1}$$
这里 $s_t^*$ 是周期 $t$ 的最优可行配置(oracle optimum),而 $s_t$ 是 agent 实际选出的配置。由于运行上下文在演化,$s_t^*$ 不是固定的:它逐周期移动,一个保持不变的配置会越来越次优。因此 agent 的目标不是收敛到单个最优解,而是让部署中的配置追住这个移动的靶子。跨周期地,论文把它表述为最小化相对最优可行配置的累计亏空:
$$\min_{\pi} \sum_{t} \bigl( J_t(s_t^*) - J_t(s_t) \bigr) \quad \text{subject to} \quad c_t(s_t) \le B \;\; \forall t \tag{2}$$
其中配置 $s_t$ 由 agent 的策略 $\pi$ 产生。
策略 $\pi$ 就是一个 LLM,把当前观测与记忆映到下一个配置:
$$s_t = \pi(o_t, M_t) \tag{3}$$
agent 只通过聚合信号观测系统。每个周期它收到观测 $o_t$,汇总前一个窗口内的逐单元运行统计量及其相对上一窗口的变化;它同时维护一个覆盖最近 $m$ 个周期的记忆 $M_t$:见过的观测、选过的配置、以及归因给这些配置的结果。
策略并非一步到位,而是经由一小段动作序列抵达配置:分析当前统计量 → 从记忆中检索相关历史 → 估计上一个配置的效果 → 调用数值优化器把候选配置投影到预算可行集,使每个发出的配置按构造(by construction)满足 $c_t(s_t) \le B$。
值得注意:式 (2) 的 regret 形式是纯粹的叙事框架。论文既没有估计 $J_t(s_t^*)$,也没有报告任何 regret 数值或收敛性分析——这个形式化在正文之后再未被使用。
三、CORAL Harness¶
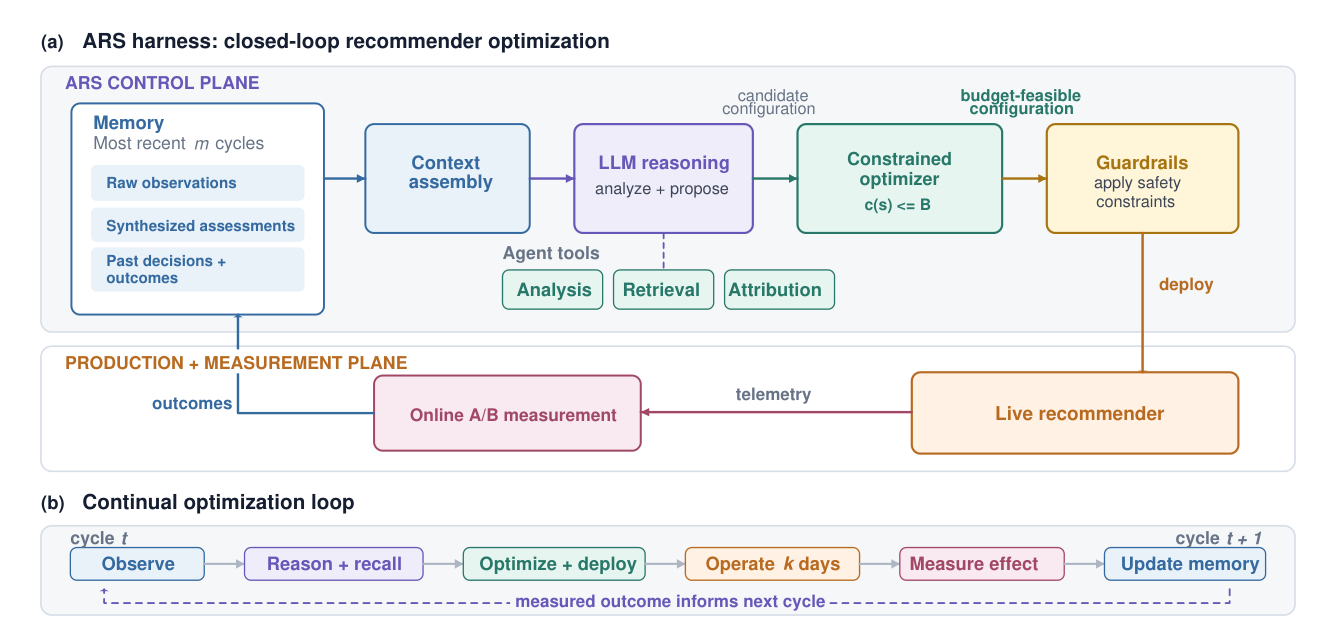
论文把系统称作 harness(挽具):它围绕语言模型补上模型本身不提供的三样东西——理解推荐器当前状态所需的上下文、分析并作用于该状态的一组工具、以及按固定节奏运行、把经验从一个周期带到下一个周期的闭环。一句话概括分工:
The model contributes reasoning; the harness makes that reasoning grounded, budget-feasible, and cumulative. (模型贡献推理;harness 让这份推理有据可依、预算可行、可累积。)
论文用一整段论证为什么这里适合用 LLM:每周期的决策建立在大量异构、部分定性的逐单元信号上——原始指标、漏斗行为、每个单元的趋势——还要与"这些信号意味着什么"的领域知识一起权衡,它抗拒被写成一条固定规则或一个可调公式;同时正确的分配会随运行上下文漂移,所以策略必须每周期重新解释当前信号,而不能固化成一个静态映射。LLM 在两方面都合适:能在异构证据与先验知识上推理决定往哪里重分配,能随新结果到来在上下文中适应而无需重训,还能为每次改动写出一段理由——这正是闭环用于人工监督与自我归因所依赖的性质。而 LLM 自身保证不了的东西(硬预算、一致且格式良好的决策),由 harness 用优化器与 guardrail 补上。
3.1 Memory(记忆)¶
harness 维护一份跨最近 $m$ 个周期的持久记忆,分三个 store:
| Store | 内容 | 作用 |
|---|---|---|
| Observation store | 原始观测 $o_t$:逐单元运行统计量及其近期变化 | 让模型看到系统各部分的当前状态 |
| Assessment store | 模型自己在早前周期给出的综合判断:关于哪些部分表现好/差、趋势如何的简洁自然语言判断 | 保留模型自己的定性理解 |
| Decision store | agent 先前部署过的配置 + 后来归因给它们的结果 | 让模型把决策锚定在"已经试过什么、结果如何"上 |
三者合起来的效果是:模型不仅能基于系统的当前状态做决策,还能基于自己已经试过的东西的后果做决策。
3.2 Tools(工具)¶
语言模型自身无法保证提案在数值上站得住、也无法保证遵守硬预算,因此 harness 给它配了一小组工具,在推理过程中调用:
- Analysis tool(分析工具):从原始观测中计算并汇总统计量及其变化;
- Retrieval tool(检索工具):从记忆里取出相关历史——过去的配置、评估与结果;
- Attribution tool(归因工具):估计 agent 上一个配置的效果;
- Constrained optimizer(约束优化器)——论文明言这是对可靠性最重要的一件:给定模型提出的有界逐单元调整,它返回满足运行预算的最近配置,即该提案在预算可行集 $\{s : c_t(s) \le B\}$ 上的投影。当提案本身已满足预算时,这个投影原样返回;只有当提案会超支时它才起作用,在各单元间重分配,使部署的配置可证明地满足 $c_t(s_t) \le B$;
- Apply tool:把接受的配置下发到推荐器的控制面。
论文对这套分工的表述是:让模型做它最擅长的事——权衡众多异构信号并说清一次改动为什么应当有帮助——而把数值可行性委托给一个能给出保证的组件。每个工具都是确定性的,返回结构化结果供模型继续推理。
论文没有给出约束优化器的具体形式:不知道它是 LP、二次投影、水填充还是别的;也没有给出 $c_t(\cdot)$ 的函数形式。对一篇把"约束优化器是可靠性核心"写进标题(Constraint-Optimized)的论文,这是一处显著的留白。
3.3 优化闭环¶
harness 以 $k$ 天为固定节奏运行这些组件,且每个周期按同一固定顺序调用它们,而不是把控制流交给模型(这一点值得注意:CORAL 的 agent 并不自由规划工具调用序列,控制流是硬编码的)。流程为:
- 把当前观测与相关记忆装配进模型上下文;
- 模型分析状态 → 回忆试过什么 → 估计上一个配置的效果 → 提出新配置;
- 优化器把它渲染成预算可行的配置;
- 下发。配置保持生效直到下一个周期;
- 其效果用一个 A/B 实验测量,结果写回记忆——闭合回路,成为下一周期上下文的一部分。
超参数选择:两个部署都取 $k = 3$ 天——"长到足以让一个配置的效果在指标里浮现,又短到让 agent 能对观察及时行动";记忆跨度 $m = 3$ 个周期——"保留足够多的近期结果供 agent 学习,又不至于携带那些因运行上下文漂移而变得不那么相关的更早结果"。论文明确说这两个值是按常识选的默认值而非调出来的(chosen as sensible defaults rather than tuning them),并承认最佳节奏可能随季节性变化,系统化选取 $k$ 与 $m$ 是正在探索的方向。
为什么这不只是"定时重跑":论文专门用一段区分二者。因为每个配置生效整整一个周期,agent 才能把观察到的变化归因到自己最近的那次决策——比较改动前后的时段,并在有 A/B 实验时拿到一个实测处理效应。记录这些归因结果,让 agent 能强化有效的改动、回退无效的改动,于是决策逐周期改进。而这种改进不需要重训:agent 完全在上下文中适应,通过记忆里累积的观测、评估与结果。
自治程度:闭环自主运行,每周期的配置直接下发到线上推荐器。一个人类在旁监督,跟踪它的改动效果与决策;随着对 agent 的信心增长,这份监督将逐步被 harness 的自动 guardrail 替代——可行性检查、有界改动限制、安全约束。
3.4 每周期决策 prompt¶
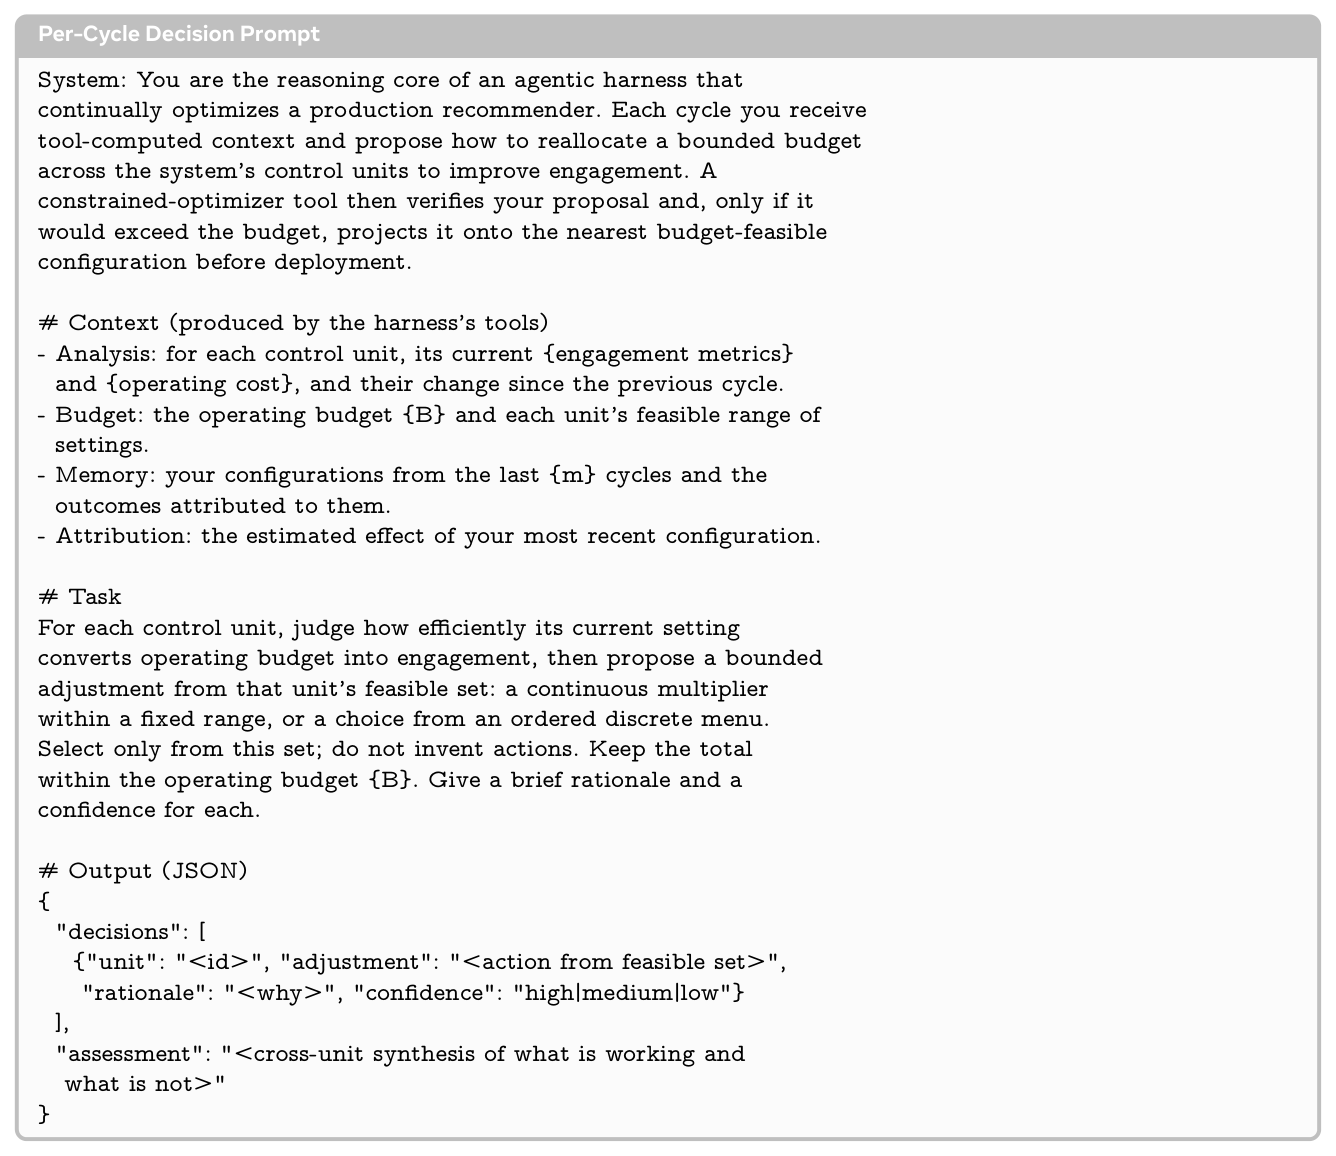
附录 A 给出抽象化后的每周期决策 prompt 模板——即模型把工具算出的上下文转成一个提案配置的那唯一一次调用。内部指标、模型与系统名被替换成花括号里的角色占位符。结构为:
- System:你是一个持续优化生产推荐器的 agentic harness 的推理核心。每周期你会收到工具算出的上下文,并提议如何在系统的控制单元间重分配一个有界预算以改善 engagement。随后一个约束优化器工具会验证你的提案,仅当它会超预算时才把它投影到最近的预算可行配置再部署。
- Context(由 harness 的工具产生):Analysis(每个控制单元的当前 engagement 指标与运行成本,及相对上周期的变化)/Budget(运行预算 $B$ 与每个单元的可行设置范围)/Memory(你最近 $m$ 个周期的配置与归因给它们的结果)/Attribution(你最近一次配置的估计效果)。
- Task:对每个控制单元,判断其当前设置把运行预算转成 engagement 的效率,然后从该单元的可行集里提出一个有界调整:一个固定范围内的连续乘子,或一个有序离散菜单中的一项。只能从这个集合里选,不得发明动作。总量保持在预算 $B$ 内。为每一项给出简短理由(rationale)与置信度(high/medium/low)。
- Output(JSON):
decisions数组,每项含unit/adjustment/rationale/confidence;外加一个assessment字段——跨单元的综合判断,说明什么在起作用、什么没有。
Table 3:两个案例如何实例化模板占位符(两个案例用同一模板,只是填充物不同)
| 占位符 | Retrieval-budget 案例 | Serving-capacity 案例 |
|---|---|---|
| control unit | 召回源(retrieval source) | 用户分群(user segment) |
| feasible set | 有界连续乘子 | 有序离散处置菜单 |
| engagement metric | 视频观看会话数、观看时长 | engaged sessions、time spent |
| operating budget | 召回预算 | 服务算力预算 |
注意 assessment 字段的输出正是 3.1 中 assessment store 的写入源——模型的定性判断由自己生成、自己回读,构成一条无外部校验的自反馈通路。
四、案例研究一:在候选源之间分配召回预算¶
4.1 设置¶
第一个部署是一个视频推荐服务,它从一组互补的召回源为每个用户组装候选。每个源被分配固定召回预算的一个份额,决定它能贡献多少候选。论文点明现状:这些份额通常是手工设定且极少复核的(typically hand-set and seldom revised),然而最佳分配会随内容与行为变化而移动,且一个对某类人群高效的源对另一类人群可能是浪费。
在论文的形式化下:控制单元 = 召回源;配置给每个源一个有界范围内的预算乘子;运行成本 = 消耗的总召回预算。每周期 agent 观测逐源信号——一个源贡献多少条目、这些条目转化为 engaged views 的效果如何、它们在下游漏斗中存活多远——并提出一次重分配:从候选转化差的源里削预算,补给那些高效产出 engaged views 的源,全部在总预算内完成。
4.2 三轮结果¶
Table 1:CORAL 的召回预算策略在一个大规模视频服务上、经三轮连续闭环(R1–R3)的效果,每轮以一次 A/B 实验评估。R1 是零样本提案;R3 聚合了若干决策周期,是已部署的配置。Sessions 指视频观看会话;"neutral" 表示无统计显著变化。
| 指标 | R1 | R2 | R3 |
|---|---|---|---|
| Watch time | +0.13% | neutral | +0.15% |
| Sessions (all users) | neutral | neutral | +0.16% |
| Sessions (largest market) | neutral | neutral | +0.77% |
论文对这条轨迹的叙述:R1 是一个零样本提案,只依据单个统计窗口形成,产生了小幅观看时长收益但会话无显著变化(sessions 定义为包含至少一次视频观看的单次用户 App 访问);R2 agent 在源之间更激进地转移预算但过度校正(overcorrected),实测效果为 neutral;吸收该结果后,agent 在若干后续周期中精炼分配,抵达下面报告的部署配置,观看时长进一步改善并产生显著会话收益。
论文自己给出的解读值得原文引述:
This progression is not monotonic—the second round did not improve on the first—yet it is precisely the behavior the loop is designed to produce: rather than a gain in every round, the agent reacts to the measured effect of its own decisions and, over successive rounds, converges on a better configuration.
即:非单调是设计预期而非缺陷——闭环追求的不是每轮都涨,而是对自身决策的实测效果做出反应并最终收敛。
对收敛后的全局分配,跨越数百万用户的 A/B 显示:视频观看会话 +0.16%(全体用户)、总观看时长 +0.15%,且不增加任何服务成本——因为这次重分配是把召回预算整合(consolidated)而非扩张。
4.3 分人群扩展¶
随后作者把 agent 从单一全局分配扩展为按用户分群给出不同分配,分群按参与度水平与账号年龄定义——例如高活跃用户、低信号用户、新注册用户。论文强调这种逐群控制对低信号与新用户最重要:一个按高活跃用户调出来的分配倾向于亏待他们。
对这个历史参与度稀疏的群体,agent 把预算转向那些依赖内容与当前上下文信号的召回源——这类信号在逐用户数据稀缺时仍然可靠——并从依赖丰富用户历史的源上撤出。结果:新的低信号用户的视频观看会话 +0.23%。
论文的结论是,同一个 harness 能为被单一全局分配落下的人群特化自己的策略,直接回应了低信号用户被系统性亏待的问题。
五、案例研究二:在用户分群之间分配服务容量¶
第二个实验在另一个服务上,agent 在用户分群之间分配服务容量。对每个分群,服务可以从一个从轻量到算力密集的菜单中选一种处置,改变它检索与排序的激进程度、缓存多少、预取多少。更密集的处置能抬高 engagement 但服务成本更高,而总服务成本被一个固定预算封顶——正是论文形式化所描述的受约束分配问题。
控制单元 = 用户分群;配置给每个分群指派菜单中的一个离散处置;运行成本 = 服务它所需的算力,受预算约束。每周期 agent 观测逐群的 engagement 与成本,决定在哪里多花、在哪里少花——把处置抬高到那些"追加算力换来的 engagement 最多"的群,压低那些"追加算力收效甚微"的群,让回收的预算为增量买单。
因为一次处置指派会生效整整一个周期,agent 能比较一个分群在自己上次决策前后的 engagement 与成本,把变化归因到那次决策,并据此决定下周期是继续这个方向还是掉头。
两轮结果(涉及数百万用户的 A/B):
- 第一轮:在用户分群的一个子集内工作,agent 大幅降低服务成本,年化容量支出节省数百万美元(saving millions of USD in annualized capacity expenditure);
- 第二轮:对照先前决策读出结果后,agent 认识到同样的改动可以安全地应用到更多用户分群,于是扩大了分配范围,把第一轮的节省再放大 44%,同时 engagement 在统计上保持不变——从而释放出可以投到别处的容量。
论文把这个部署定位为"目标的效率一侧":在不劣化 engagement 的前提下,把运行预算导向产出最高的地方。
5.1 跨案例讨论(原文 §5.3)¶
论文自评:同一个 harness 处理了显著不同的控制问题——一个是召回预算在源之间的连续重分配,另一个是服务处置在分群间的离散指派——并沿互补的轴改进了系统:第一个是 engagement(含低信号用户),第二个是不劣化 engagement 的服务效率。两者一起"勾勒出生产推荐器必须管理的 engagement–efficiency frontier"。
论文还给出一个未经测量的效率主张:这些收益来自一个不需要逐决策工程投入的过程。手工产出这样的分配是一件沉重的周期性工作——工程师形成假设、跑实验、在数周内修订单个 lever,且投入随 lever 与分群数量增长而增长。harness 则在短而固定的节奏上自主调整每一个控制单元,算力成本可忽略——"把一个调优周期从数个工程师-周压缩到几个自主的日,周转快一个数量级,且回路里没有工程师"。
六、计算成本¶
因为 harness 作用于控制面而非单条请求,它的语言模型成本按决策周期计费,而非按用户计费。在一次跨 $T$ 天、节奏为 $k$ 天的部署中,总推理成本为
$$\text{Cost} = \underbrace{(T/k)}_{\text{cycles}} \cdot C \cdot \bigl( \tau_{\text{in}} p_{\text{in}} + \tau_{\text{out}} p_{\text{out}} \bigr) \tag{4}$$
其中 $C$ 是每周期的 LLM 调用次数,$\tau_{\text{in}}$、$\tau_{\text{out}}$ 是每次调用的平均输入/输出 token 数,$p_{\text{in}}$、$p_{\text{out}}$ 是单 token 价格。论文从中读出三条性质:
- 成本与节奏成反比:$k$ 越短响应越及时,成本按比例上升;
- 每周期成本有界:因为 $\tau_{\text{out}}$ 不会超过模型的输出 token 上限;
- 最关键的一条:$C$ 由控制面被划分成多少个决策组决定(每周期一小把),而不由服务的用户数或请求数决定,所以成本与流量无关,即便在十亿用户量级的 surface 上也可忽略。论文明写这与逐条目 / 逐用户的 LLM 推理形成鲜明对比——后者的成本随流量增长。
Table 2:两个部署的每次调用成本参数(论文注:由 prompt 与 payload 尺寸估算,因为流水线不记录 token 用量)
| 案例 | 每周期调用数 | 每次输入 tokens | 每次输出 tokens |
|---|---|---|---|
| Retrieval-budget | ~10 | ~1,500 | ~2,500 |
| Serving-capacity | ~8 | ~2,000 | ~2,500 |
每周期只发出一小把几千 token 的调用,于是跨越若干周期的整次部署总量在 $10^6$ token 量级。按"具有代表性的前沿 LLM 定价"作参照,这把每次部署的端到端推理成本放在数十美元量级——相对它产生的 engagement 收益与运行成本节省"可忽略不计"。
这个成本表是全文最有说服力的一段论证,也是 CORAL 相对"LLM 做推荐"路线的真正结构性优势所在。但同时要注意:它没有回答"这几十美元买到的东西,是否比一个几十美元的贝叶斯优化器买到的更多"。
七、消融与分析:本文没有消融实验¶
必须明确记录:CORAL 全文没有任何消融实验,也没有任何基线对比。 论文既未与非 LLM 的方案比较,也未拆解 harness 内部各组件的贡献。缺失的对照至少包括:
| 缺失的对照 | 它要回答的问题 |
|---|---|
| 贝叶斯优化 / 多臂老虎机 / PID 控制器 / 随机重启做同一个受约束分配 | 收益是来自 LLM 推理,还是来自"终于有人在动这些参数了"? |
| 去掉 memory($m = 0$)的同一闭环 | "策略随闭环迭代变好"是否真由记忆驱动? |
| 只有约束优化器、提案来自简单启发式 | 投影本身(把预算从低效单元挪走)是否已经贡献了大部分收益? |
| 一个人类工程师在同一时间窗口内做同样的重分配 | 相对人工的增量是多少? |
这直接关系到「引入新信号 ≠ 收益来源」这条判据。CORAL 引入的新信号是"LLM 对异构逐单元信号的推理 + 对自身历史决策的记忆";但实验建立的只是"LLM 闭环 > 长期未复核的手工配置"。而论文自己写明这些份额"typically hand-set and seldom revised"——也就是说 A/B 的对照组是一个已经漂移的陈旧配置。在这样的对照下,任何有效的再调优手段(含最朴素的坐标下降或随机搜索加保留更优者)都可能拿到相近的正收益。收益归因到 LLM 这一步,论文并未建立。
论文内部唯一支持"闭环在学习"的证据是 Table 1 的 R1→R2→R3 轨迹,但这条证据本身很弱:
- 只有 3 个数据点,且中间那个是回退(R2 neutral,不如 R1)。作者把非单调解释为"设计预期",这在叙事上自洽,但在统计上意味着:一个"随机扰动 + 保留更优者"的过程会产生完全相同的形状;
- 三轮的努力量不对等。表注明写 "R3 aggregates several decision cycles"——R1 是单窗口零样本、R2 是一轮、R3 是若干轮。所以 R3 > R1 完全可以只是"多调了几轮",而不是"从反馈里学会了"。要证明后者,需要一个同样跑若干轮但不给它记忆的对照臂;
- R3 的 A/B 是在"依据实测结果挑出这个配置之后"报告的。论文没有说清 R3 的数字是一次针对收敛配置的独立新实验,还是那些调优周期的聚合。若是后者,选择与评估用了同一批数据,估计值会被系统性抬高(winner's curse)。
八、独立核验:三个需要单独确认的问题¶
8.1 收益的真正落点是质量还是成本?——是成本,而且两者从未在同一个系统上同时兑现¶
摘要用 "spanning the engagement–efficiency frontier" 把两个部署缝在一起,容易读成"CORAL 同时改善了质量与成本"。逐条核对原文后,实际情况是:
| 案例一(视频服务) | 案例二(另一服务) | |
|---|---|---|
| 质量 | watch time +0.15%、sessions +0.16% | "statistically unchanged"(无收益) |
| 成本 | "at no additional serving cost"(无节省,只是没变贵) | 年化节省数百万美元,第二轮再 +44% |
| 计量单位 | 相对百分比 | 绝对美元 |
结论:
- 两个收益分别发生在两个不同的 surface / 服务上,从来没有在同一个系统上同时出现。 "横跨 frontier" 是把两次单轴实验并置的修辞,论文没有给出任何一条真实的 engagement–efficiency 权衡曲线,也没有任何一个部署同时改善两个轴;
- 唯一以硬通货计量的收益在成本侧。 案例一的召回预算重分配是"整合"而非扩张,明确写着 at no additional serving cost——即成本持平,不是节省;
- 两个案例的计量口径不对称,且这种不对称对论文有利。 质量收益用相对百分比报告(+0.15% 听起来很小),成本收益用绝对美元报告("数百万美元"听起来很大)。但成本侧没有给任何分母:数百万美元占该服务年服务支出的多少?0.1% 还是 10%?以 Meta 量级的基础设施支出计,"annualized millions of USD" 完全可能是一个比 +0.15% 还小的相对量。论文既没给百分比,也没给基线规模,这个数字因此无法与 +0.15% 放在同一标尺上比较;
- 案例二的 "+44%" 是对第一轮节省额的相对放大,不是任何业务大盘指标的提升;且它靠"把同一改动推广到更多分群"取得,本质是覆盖面扩张而非策略变得更聪明。
综合判断:CORAL 已兑现的、可验证的价值主要在成本侧(且量级未标准化),质量侧的收益量级极小且不带成本节省。 更重要的是,两者不是同一个系统的两个面,而是两次互不相干的部署。
8.2 那个 "+0.77% 最大市场" 是预设分析还是事后切片?¶
证据面:
- 这一行只出现在 Table 1 里,正文从未讨论过它。§5.1 描述收敛配置的效果时只写 "a 0.16% increase in video-viewing sessions across all users, alongside a 0.15% increase in total watch time",完全没有提到最大市场;
- 论文没有说明分市场分析是否预先注册(pre-registered),没有列出一共分析了多少个市场,没有报告其他任何市场的结果,没有任何多重比较校正的说明;
- 全文没有一个 p 值、没有一个置信区间、没有一个样本量(只有"millions of users"),统计语言只有表注里那句 "neutral denotes no statistically significant change";
- 这一行在 R1 和 R2 都是 neutral,只在 R3 变正。
"最大市场"这个切法本身是可预设的(它是一个自然的、事先就能指定的分群,不像"25-34 岁安卓用户"那种典型的事后钓鱼切片),这一点对论文有利。但可预设不等于已预设:论文没有提供任何证据表明它是预先声明的分析计划的一部分,而"只在表里出现、正文只字不提、且是唯一被展示的市场"这三个特征,恰恰与事后择优呈现(selective reporting)的形态一致。
还有一个内部的算术紧张值得单独指出:设最大市场占全体会话的份额为 $w$,则
$$\text{全体提升} = w \times 0.77\% + (1-w) \times \text{其余市场提升} = 0.16\% \tag{5}$$
- 若 $w = 0.20$,其余市场提升 $\approx (0.16 - 0.154)/0.80 \approx \mathbf{0.008\%}$,实质为零;
- 若 $w = 0.10$,其余市场提升 $\approx 0.092\%$;
- 若 $w \ge 0.21$,其余市场提升为负。
也就是说,只要最大市场占到会话的两成以上,全局那 +0.16% 就几乎完全由这一个市场贡献,其余市场合计接近或低于零。这与论文"同一个 harness 能跨 surface、跨决策类型泛化"的主旋律构成张力:即便在同一个 surface 内部,收益的地理泛化性都存疑。论文没有披露 $w$,也没有报告任何其他市场,因此这一点无法证实也无法证伪——但它是审阅这篇论文时最应该追问的数字。
结论:无法认定 +0.77% 是预设的分市场分析;其呈现方式(仅在表中、正文不提、无其他市场对照、无多重比较说明、无 CI)与事后挑选的有利切片一致,应当按未校正的探索性发现对待。
8.3 "LLM-Native Harness" 到底指什么?——LLM 完全不在线上推理路径里¶
答案非常明确,且论文本身写得毫不含糊:LLM 不在服务路径上,甚至不在训练路径上。它是一个每 3 天被调用约 10 次的离线控制面组件。
原文 §6 的措辞是决定性的:
Because the harness acts on the control surface rather than on individual requests, its language-model cost is charged per decision cycle, not per user.
$C$ is fixed by how the control surface is partitioned into decision groups (a handful per cycle), not by the number of users or requests served, so the cost is independent of traffic and remains negligible even on billion-user surfaces. This is in stark contrast to per-item or per-user LLM inference, where cost grows with traffic.
配上 Table 2 的量级(每周期 ~8–10 次调用、每次 ~1.5–2k 输入 / ~2.5k 输出 token,$k = 3$ 天,整次部署共 $10^6$ token 量级、数十美元),可以确认:
- 推荐器本身完全没变,仍是传统的多阶段召回-排序-服务系统,不含任何 LLM 组件;
- LLM 既不做在线推理,也不参与模型训练,它只写配置;
- "LLM-Native" 修饰的是 harness(那个优化闭环),不是 recommender。标题 "An LLM-Native Harness for Production Recommender Systems" 在字面上是准确的,但很容易被读成"用 LLM 重做推荐系统"。
与 AMBER(2608.25546,AI at Meta,2026-08-26)的同司对照。 AMBER 的 §4.1 坦承:为实时排序在线服务端到端 LLM 会带来严重基础设施瓶颈,尤其是长用户历史的 KV cache 维护,明确把这部分留作未来工作;实际上线的是降级路径——把离线算好、缓存起来的 Event Token 作为即插即用序列特征喂给既有的非 LLM 生产排序模型。两篇合起来看,一个月内 Meta 出的两篇"LLM × 工业推荐"论文,其上线形态都是"LLM 不碰用户请求"。
但二者的性质并不相同,这个区别很重要:
- AMBER 是一次退让:它想要的是端到端 LLM 实时排序,因为 KV cache 撞墙而退到降级路径,论文最有野心的部分恰恰是没部署的那部分;
- CORAL 不是退让,而是换靶:它从一开始就不打算把 LLM 放进请求路径,而是重新定义 LLM 该替代的对象——不是"替代排序模型",而是"替代做决策的那个工程师"。并且它把"与流量无关"从一个约束翻转成了卖点(§6 显式地拿它对比逐用户 LLM 推理)。
从这个角度,CORAL 相对 AMBER 是更彻底地离开了服务路径,但在诚实度上反而更高:它没有把未部署的雄心当作贡献来叙述。代价是贡献的天花板也随之下降——一个每 3 天写一次配置文件的 agent,其上限受限于"这批控制参数还剩多少可榨取的空间",而这个空间论文从未估计过(式 (2) 里的 $J_t(s_t^*)$ 始终是个符号)。
九、核心贡献总结¶
- 定位上的贡献大于方法上的贡献:把 agent 的作用对象从"模型 / 用户表征 / 离线开发流水线"移到"线上系统的控制面",并要求它从自身决策的实测 A/B 后果中学习。这是一条此前少有人正面部署的路径;
- 成本结构的论证是真洞见:式 (4) 说清了"agent 作用于控制面"这一选择在经济上的结构性优势——调用数由控制面的划分决定而非由流量决定,因此在十亿用户 surface 上成本仍然可忽略。这条论证对任何考虑"LLM 能不能进推荐系统"的团队都有直接的决策价值;
- 分工设计干净:LLM 出判断与理由,确定性工具出计算与硬保证(预算可行性由投影按构造保证),控制流由 harness 固定而不交给模型。这是一个可复制的工程模板;
- 对低信号 / 新用户的处理有实质内容:把全局分配拆成逐群分配,并观察到对稀疏历史人群应当把预算转向内容与上下文信号型召回源——这条结论本身是有迁移价值的领域知识;
- 诚实报告了一次失败轮次(R2 过度校正、效果 neutral),并把非单调性纳入叙事,而不是只报告最好那一轮。
与已归档相关工作的对比¶
RecHarness RecHarness: A Bandit-Routed Agentic Harness for Self-Evolving Recommender Systems(Georgia Tech + Kuaishou, 2026-07-31)¶
关系:独立并发(CORAL 全文未引用 RecHarness,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把"推荐系统的持续优化被工程师人力而非机会空间限定"当作 root cause,并且都把它形式化成在有限预算下的搜索/分配问题——RecHarness 是 $s^\star = \arg\max_{s \in S} h(T,s)$ s.t. $C(s) \le B$(试验预算),CORAL 是式 (1) 的 $\max_s J_t(s)$ s.t. $c_t(s) \le B$(运行预算)。两者的动作空间都是人类事先划定的一组有界"编辑维度 / 控制单元",都明令 agent 只能从这个集合里选、不得自创动作。
- 相近的技术骨架:都是"LLM + 一个确定性决策组件"的两级 harness,都用"上一轮的实测反馈 → 决定这一轮怎么改"的闭环,都区分标量证据与文本证据并分别路由,都以"只有优于当前 incumbent / 只有 A/B 显著才留下"作为晋升准则,也都在真实工业系统上跑了线上 A/B。
- 本文的差异与推进:分工方向恰好相反,这是两篇最有价值的对照。RecHarness 的关键判断是"不能把方向选择交给 LLM"——可累计的标量验证分归显式 Multi-Armed Bandit(每 arm 一个 Beta 后验、Thompson Sampling 选方向),LLM 只在已选定的方向内读日志、写假设与代码,且论文明确说这样做是为了"文本总结不会暗中覆盖路由器积累的统计证据"。CORAL 的分工正相反:分配决策本身完全由 LLM 做出,确定性组件(约束优化器)只负责事后把提案投影到预算可行集,"仅当提案会超支时才起作用"。也就是说,RecHarness 用确定性模块管探索-利用,CORAL 用确定性模块管可行性;RecHarness 不信任 LLM 的信用分配,CORAL 把信用分配(attribution tool + decision store)也交给了 LLM。另一处差异是作用对象:RecHarness 改的是代码与模型实现(学习率 schedule、dropout、embedding 维度、层数、loss 替换、结构跳跃 arm),每次试验要重新训练;CORAL 改的是线上配置,不训练、不改代码、不重新部署模型。
- 可比的方法 / 实验差异:RecHarness 在 Amazon 序列推荐、KuaiRec watch-time/ranking 两组公开/半公开数据上做了可复现的离线验证,再加快手大规模短视频广告排序的 7 天线上 A/B(广告主价值 / 收入 / 曝光同时提升);CORAL 没有任何离线实验、没有任何公开数据集、没有任何基线,只有两个匿名 surface 的 A/B 表。更关键的是:RecHarness 的 Thompson 路由器本身就是 CORAL 最需要而没有的那个非 LLM 对照臂——如果把 CORAL 的 LLM 换成一个在召回源上做 Thompson 采样的老虎机,收益会不会一样?两篇论文合起来把这个问题摆到了台面上,但谁都没有回答它。
DREAM DREAM Technical Report(Taobao & Tmall Group of Alibaba, 2026-08-10)¶
关系:独立并发(CORAL 全文未引用 DREAM)· 已加载对方精读
- 共同关注的问题:两篇给出的诊断几乎逐条重合。DREAM 点名工业推荐级联的四个结构性瓶颈中有两条与 CORAL 完全同构——"策略僵化:绝大多数策略仍来自静态规则、人群包与人工调参"、"执行到上游优化的闭环缺失:执行信号从不回流到感知与决策模块"。两篇都判定缺的那一块是"一个能跨模块协调策略、并从线上反馈自我优化的控制平面(control plane)"——CORAL 的 Figure 1(a) 就直接把自己那半张图标注为 "ARS CONTROL PLANE"。
- 相近的技术骨架:两者都是叠加式(overlay)架构——召回/排序/重排模型一个都不替换,只在既有级联之上叠一层由 LLM 驱动的策略层;都让 LLM 输出结构化 JSON 的有界参数调整而非直接输出物料;都靠 guardrail 强制参数范围与安全边界(DREAM 是参数范围/白名单/流量上限 + "默认兜底 + 个性化 override",CORAL 是可行性检查 + bounded-change limits + 优化器投影);都用一条把线上结果回灌到决策模块的反馈环闭合(DREAM 的 Reward Dual Loop,CORAL 的 decision store + attribution tool)。
- 本文的差异与推进:决策粒度与节奏完全相反,而 DREAM 恰好预先批评了 CORAL 所处的那一档。DREAM 的策略是逐请求、逐用户生成的,其立论前提是 orchestrator 类 agent"看得远却瞄不准"(far-sighted but poorly aimed),并点名 AgenticRecTune 只在全局层面调融合权重而非按用户动态出策略,导致迭代慢且指标长期互相拉扯。CORAL 正是这条批评所指的形态:全局(或至多按粗粒度人群)配置、3 天一轮。CORAL 对此的回答藏在 §6 的成本论证里——正因为不逐请求决策,它的 LLM 成本才与流量无关、才在十亿用户 surface 上可忽略;DREAM 那种逐请求 agent 必须付出与流量同阶的推理成本(DREAM 因此要靠端云 F1–F4 漏斗与蒸馏把成本压下来)。两篇实际上是在同一条 frontier 的两端:DREAM 买"瞄得准",CORAL 买"成本与流量解耦"。
- 可比的方法 / 实验差异:DREAM 是一份 40 页技术报告,给出了三层 Intent Engine、MetaModel(基于 Qwen3)+ 子 agent 的完整设计、四道校验门与 Reward Dual Loop 的离线/在线双环;CORAL 是 8 页正文,harness 的三个 store 与四个工具全部只有散文描述,约束优化器的具体形式与所用 LLM 的身份都未披露。在证据密度上两者不在同一量级。
AgentX AgentX: Towards Agent-Driven Self-Iteration of Industrial Recommender Systems(Kuaishou, 2026-06-25)¶
关系:显式引用但原文未展开对比(仅在 §1/§2.2 以引文号一笔带过,无任何方法或指标层比较)· 已加载对方精读
- 共同关注的问题:两篇的命题句几乎可以互换。AgentX 把核心命题凝练为 "From the labor of algorithm engineers to the capability of agent systems",CORAL 的结论句是 "a single agentic loop can carry out the continual optimization work that has traditionally fallen to human algorithm engineers"。两篇都判定线上 A/B 是唯一与真实业务价值对齐的奖励信号,都拒绝用离线指标或人类评分代替它,也都强调闭环必须是 closed-loop 而非 one-shot,且优化目标本身会随业务与流量结构漂移。
- 相近的技术骨架:都是"提案 → 执行 → 线上 A/B 判决 → 结果回灌记忆 → 下一轮"的四段式闭环,都配 guardrail 把关,都保留人在环上做监督并规划逐步收回监督的路径,都把历史决策与其结果(含失败)显式资产化为后续决策的上下文(AgentX 的 Experiment KB 记"结果背后的上下文"、avoid set;CORAL 的 decision store + assessment store)。
- 本文的差异与推进:三处结构性差异。(a) 作用对象:AgentX 的 Developing Agent 产出生产就绪代码、走完整的开发-灰度-上线流程,闭环的一轮是"一个想法从 intent 到验证过的线上结果"(周为单位);CORAL 完全不写代码、不训练、不部署新模型,只改配置,因而一轮可以压到 3 天且可以无限重复。(b) 学习机制:AgentX 的 Harness Evolution 用 SGPO(Semantic-Gradient-based Prompt Optimization)更新各 subagent 的规约——即 harness 本身的参数(prompt)会被改写;CORAL 明确宣称 "the policy improves in context, without parameter updates",改进完全靠记忆窗口内的 $m=3$ 个周期。这使 CORAL 的"改进"是有限窗口内的、不可累积到 $m$ 之外的——超出 3 个周期的教训会被直接遗忘,而 AgentX 的轨迹回灌是长期复利的。(c) 硬约束:CORAL 多出一个 AgentX 没有的组件——把提案投影到预算可行集的数值优化器,使"不超预算"成为按构造成立的性质而非需要校验的性质。
- 原文的对比深度:CORAL 对 AgentX 的全部讨论是一句类别判断——"agents to search over models, code, and system configurations, thereby automating parts of system development and optimization... the agent operates on the recommendation model, user representation, or offline development pipeline"。没有任何指标对比、没有把 AgentX 当基线、也没有讨论 SGPO 与"无参数更新"两条改进路线的取舍。 这正是本节要补上的空白。
被剔除的近似候选(记录以防门槛放水) - NOVA NOVA(Tencent, 2026-06-25):问题同构度很高(同样把"专家密集的迭代"当瓶颈,同样用"上次修改 + 验证诊断 + 指标反馈 + 轨迹记忆"聚合出下一步方向,其可行域 $\mathcal{A}_\Omega$ 也与 CORAL 的预算可行集在结构上呼应),且同样被 CORAL 引用而未展开对比。剔除仅因保留上限为 3 篇,且它的内层优化目标是离线 AUC、线上 A/B 只做一次终局验证,缺少 CORAL 最核心的"从自己上一次线上实测效果中学习"这一环。已在 DAG 中登记结构化对比边。 - MetaStrategy MetaStrategy(Alibaba, 2026-08-10):解法层高度相似——LLM 生成 schema 约束的可执行 JSON 排序策略(目标权重、类目偏好、体验约束)。但它是逐请求生成的排序策略,没有"部署一段时间 → 测量 → 归因到自己上次决策 → 修正"的闭环,问题落在排序建模而非持续系统调优 → 剔除。 - Uniboost Uniboost(Alibaba, 2026-05-26):问题几乎完全同构——工业混排阶段的流量/预算分配长期由碎片化的人工加权方案(PID 保量、冷启 Boost、运营活动)叠加而成,耦合严重、难以归因与迭代,且它同样构成"在线执行 → 近线统计 → 离线聚合 → 更新参数"的闭环。剔除因为解法路径的核心器官不同:Uniboost 用的是锚定指标对齐 + 线性 Boosting 范式 + PID 控制器这一套确定性控制律,没有 LLM、没有 agent 记忆、也不从自身历史决策中在上下文里学习。但它恰恰是 CORAL 最该做而没做的那个非 LLM 对照——同一类分配问题,控制论方案已经有可归因、可量化 ROI 的成熟形态。 - STEPS STEPS(ByteDance, 2026-08-03):也是"自触发 agentic loop",且同样让系统决定自己下一次被调用的时机(对照 CORAL 固定的 $k=3$)。但问题是逐用户的推送时机决策,属于面向用户的推荐动作而非系统控制面配置 → 剔除。 - AMBER AMBER(AI at Meta, 2026-08-26):同公司、同样以"LLM 的成本不能随流量增长"为设计的支配约束,对照价值高。但问题陈述实质偏离——AMBER 求的是"如何让 LLM 推荐在工业规模下 scale",CORAL 求的是"如何自动化工程师的调参劳动";解法骨架(事件级 tokenization + 离线缓存 + 喂给非 LLM ranker)与 agentic 控制闭环毫无重合 → 按双同构标准剔除,改在 §8.3 作为同司服务路径取舍的对照来处理。
讨论与局限性¶
值得借鉴的设计¶
- "把 LLM 放在控制面而不是数据面"是一个被低估的定位。式 (4) 那条"调用数由控制面的划分决定、与流量无关"的性质,使这条路线在经济上天然可行——这与所有试图把 LLM 塞进请求路径的工作(含同司的 AMBER)形成结构性区别。任何在做"LLM × 工业推荐"选型的团队都应当先问一遍:我要 LLM 做的这件事,能不能挪到控制面上按周期做?
- "LLM 提判断、确定性组件给硬保证"的分工模板可直接复用。尤其是"投影到可行集"这一手:它把"不超预算"从一个需要事后校验、可能失败的性质,变成一个按构造成立的性质,从而允许 LLM 在提案阶段更自由。
- 把控制流固定在 harness 里、不交给模型。CORAL 的 agent 并不自主规划工具序列,每周期的调用顺序是硬编码的。这是一个在生产环境里换取可预测性与可审计性的务实取舍,值得对照那些强调"让 agent 自由规划"的学术设计。
- 诚实报告失败轮次,并把非单调性纳入方法叙事,而不是只报最好那一轮。
局限与争议¶
- 零消融、零基线,收益归因不成立(详见 §7)。这是全文最严重的问题:论文证明的是"LLM 闭环 > 长期未复核的手工配置",而不是"LLM 闭环 > 任何再调优手段"。归档里的 Uniboost 已经展示了同类分配问题的确定性控制论解法,RecHarness 则展示了用 Thompson 老虎机做方向选择的 agentic 解法——CORAL 与二者都没有比较。
- 统计报告不达标:全文无 p 值、无置信区间、无样本量(只有 "millions of users")、无多重比较说明。在 +0.15% 这个量级上,这些是判断结论可信度的必需信息,而非可选项。
- "+0.77% 最大市场"呈现方式可疑(详见 §8.2),且式 (5) 的算术显示:只要该市场占会话两成以上,全局收益就几乎全部来自它,其余市场合计接近零——这与论文的泛化性主张构成直接张力。
- 方法层几乎没有可复现的内容:约束优化器的形式未给、所用 LLM 未披露(只说 "a general-purpose LLM"、"representative frontier-LLM pricing")、prompt 是"抽象化"后的模板、两个 surface 均匿名、无代码无数据。连成本表都是"从 prompt 与 payload 尺寸估算的,因为流水线不记录 token 用量"——这个细节说明工程侧的可观测性本身也不完整。
- 记忆窗口 $m=3$ 与"无参数更新"共同限定了学习的天花板。超出 3 个周期的教训会被遗忘,而 harness 本身(prompt、工具、单元划分)不会被改进。对照 AgentX 的 SGPO 轨迹回灌,CORAL 的"改进"是局部且不复利的:它能追住漂移的靶子,但不会变得越来越会追。
- 归因工具本身可能有偏。论文说 agent"比较改动前后的时段"来归因,只有"在有 A/B 实验可用时"才拿到实测处理效应。前后对比会被时间趋势、季节性、其他团队的并发实验污染;这意味着写进 decision store 的"结果"可能是有偏估计,而后续决策正是建立在这些估计之上——闭环有把自己的归因误差累积进记忆的风险,论文未讨论。
- 只验证了一类 lever。作者自己承认两个部署都只实例化了同一类决策——推荐器资源在其组件间的受约束分配;把同一闭环扩展到"召回与排序逻辑本身"这类性质不同的 lever 仍是未来工作。因此"harness 跨决策类型泛化"的主张目前只覆盖"连续乘子分配"与"离散菜单指派"这两个相当接近的变体。
- "自主"是有限定的:闭环虽自主下发配置,但仍在人工监督下运行;把监督替换为自动 guardrail 是论文自陈的下一步,尚未完成。
- 评估方法论的缺口是论文自己点名的:"我们的证据来自 A/B 实验,它测量真实效应但昂贵且限于其自身场景;在部署前评估 agent 驱动的系统优化,仍是一个开放问题。" 这条自评是准确的,也解释了为何本文难以被复现或与他人比较。
与已有工作的差异(小结)¶
CORAL 与 AgentX / NOVA / RecHarness 这条"agent 改进推荐系统本身"的线相比,独特之处只有一条但很清晰:它是唯一一篇 agent 的动作直接落在线上控制面、并以自己上一次动作的线上实测效果作为下一次动作输入的。AgentX 与 NOVA 的闭环终点是"一次上线是否成功",RecHarness 的闭环终点是"离线验证分是否超过 incumbent",只有 CORAL 让 agent 在同一个活着的系统上反复出手并读回自己的成绩单。这个定位是真的;问题在于,支撑它的证据(两张各三行、无 CI 的 A/B 表,加上一个非单调且努力量不对等的三点序列)远不足以承载它想要的结论。