STEPS: A Self-Triggered Agentic Push Recommendation System 精读¶
作者:Zhao-Yu Zhang*, Qingying Chen*, Chunyuan Zheng*, Jing Zhou, Jian Sun, Siqi Chen, Leiying Chen, Chuan Zhou, Huiyou Jiang†, Xin Tao, Haoxuan Li, Zhouchen Lin 机构:ByteDance(字节跳动)· Peking University(北京大学) 会议:RecSys '26(2026-09-27 ~ 10-02, Minneapolis)· ArXiv 2608.01949 · 2026-08-03
研究动机与背景¶
Push notification(推送通知)是少数能"主动出圈"的推荐场景。绝大多数推荐链路只在用户打开 App 之后才起作用,而推送让系统可以在用户离开 App 时主动触达,是长周期 re-engagement(重新激活)最直接的抓手。论文用 Figure 1 说明这个场景:用户先授予通知权限(左),随后才能收到推送(右)——这条链路的存续本身依赖用户不主动关闭权限。
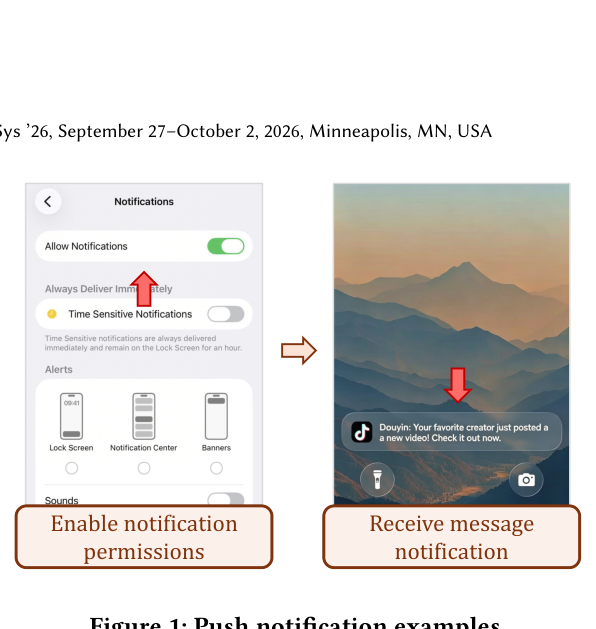
推送的难点被论文概括成一个 "whether and when"(是否发、何时发)问题:好的推送提升活跃,坏的推送引发疲劳,进而导致用户直接关闭推送权限——这是一次性、不可逆的损失(权限一旦关闭,整条触达通道对该用户永久失效)。因此推送不是单点的 CTR 排序问题,而是"连续时间轴上的序列化优化问题"。
理想解法很直观也很不现实:每秒对每个用户评估一次是否该推。在十亿用户量级的工业系统里,这种"逐秒实时排序"因为算力约束根本不可能。已有工业方案因此退化为两种被动范式:
- Pre-planned Frequency(预排频次):离线做 user-level uplift modeling,估计每个可能时刻/频次的正负收益,再用整数规划求解器在全局预算约束下把投放时刻与频次提前一天排好;到点后系统被触发执行发送计划(LinkedIn 的 Email Volume Optimization、Duolingo 的 sleeping-recovering bandit 等属于这一类)。
- Fixed-interval Triggering(定时轮询):绕开时刻分配,按预设的短时间片周期性唤醒推送系统,每次实时判断是否发送。
论文对这两条路线的批评非常具体:
- 预排频次缺实时性:决策基于预先设定的时间点,看不到实时信息(近期用户活跃、当前可推内容)。举例来说,即使实时轨迹显示此刻推送价值极高,系统也不会发——因为计划里没有这个时刻。
- 定时轮询陷入严格两难(strict dilemma):轮询太密,item 排序负载会吃掉大量算力;轮询太疏,最优投放时刻就被漏掉。没有一个时间片长度能同时满足有效性与效率。
- 多阶段框架局部最优:无论哪条路线都是多阶段流水线(先定时刻 → 再定是否发 → 再定发什么),每一阶段各自局部最优,整体次优。
论文的 root cause 判断是:决策系统"何时被唤醒"这件事一直是外生给定的(要么离线排好,要么固定周期),系统自身无权决定。受 agentic AI(强调基于环境反馈的 plan-act 闭环)启发,作者把推送重构为自触发(self-triggered)的 agentic 过程:系统不仅决定"采取什么动作",还决定"自己下一次何时被调用",从而把时刻决策内生化、闭环化。
由此提出 STEPS(Self-Triggered End-to-end agentic Push recommendation System),已在抖音(Douyin,超 10 亿用户)全量部署。
主要贡献:
- 把工业推送重构为自触发闭环决策问题,提出端到端 agentic 系统 STEPS:planning agent 主动生成下一次推送时刻,execution agent 决定是否推送,另加轻量 filtering agent 同时承担算力控制与安全兜底;
- 推送时刻生成上,提出 gated ordinal regression(门控序数回归)来有效注入目标回报;执行决策上,提出 value-guided learning 纠正离线日志中的次优行为;
- 抖音全量线上验证:用户活跃天数(UAD)+0.2843%、推送权限关闭率(NE)-1.9089%,filtering agent 降低 79.42% 算力开销。
相关工作定位¶
推送系统:推送涉及"发什么内容"与"是否发/何时发"两类决策,前者在工业界已相对标准化,本文只聚焦后者。已有工作被归为上文两个范式(Pre-planned Frequency [10,15,19,32,34] 与 Fixed-interval Triggering [5,7,18,23,27]),两者的局限共同呼唤"联合决定是否发送与何时再唤醒、同时保住实时性与资源效率"的自触发过程。
生成式强化学习:RL 在推荐长期目标优化上研究广泛(slate 推荐、feed 排序、通知投放),但在大规模工业系统里部署传统 value-based / policy-gradient 方法有隐患——bootstrapping 不稳定、对离线日志的分布漂移敏感。近期生成式 RL 把序列决策改写为条件序列建模:Decision Transformer(DT)[8] 用监督学习目标、以 return-to-go(RTG)+ 历史状态 + 历史动作为条件预测动作;Trajectory Transformer [13] 把状态/动作/奖励统一成轨迹序列做长程规划;Q-learning Decision Transformer [31] 用动态规划重标注 return,把 Q-learning 的轨迹缝合(trajectory stitching)能力与 DT 的训练稳定性结合。这一范式已在工业多目标系统(通知优化 [18]、自动出价 [9])显示价值。STEPS 沿这条线,但目标是主动式推送——系统必须同时生成"下次何时激活"与"激活后是否发送"。
问题形式化¶
把面向长期活跃的推送优化视为连续时间轴上的序列执行问题。设某时间周期(如一天)内有 $T$ 个候选推送时刻,目标是在控制日级负向价值(通知权限关闭)的前提下最大化正向价值(用户活跃天数),其中 $T$ 因用户与方法而异。
对某用户在时刻 $t \in \{1,2,\dots,T\}$,DT 把问题写成条件序列建模。令 $R_t$ 为时刻 $t$ 的 return-to-go(期望未来回报):
$$R_t = \sum_{j=t}^{T} \left( r_j^{+} - \lambda_n r_j^{-} \right) \tag{1}$$
其中 $r^{+}$、$r^{-}$ 分别是正、负奖励,$\lambda_n$ 是平衡二者的超参数。
已有 DT-based 推荐框架以当前状态 $s_t$(用户特征、环境信息如当前时间与上次推送时间)、目标 RTG $R_t$ 以及可选的 item 特征为输入,条件生成二元动作 $a_t \in \{0,1\}$:
$$a_t = \pi(s_t, R_t) \tag{2}$$
两种既有范式在这个形式化下的缺陷一目了然:预排频次方法用 uplift 建模 + 整数规划在目标日之前离线算好 $T$ 个时刻,因而在固定时刻执行推送、完全不看实时环境;定时轮询方法按预设短间隔周期性激活系统,既消耗大量算力,又要评估很多低价值的推送时机。
STEPS 的做法是把推送写成 sequential generate-and-decide 问题,彻底抛弃对预定义 $T$ 的依赖。系统在任一被激活的时刻 $t$ 观察状态 $s_t$ 与目标 RTG $R_t$,同时执行两件事:execution agent $\pi_A$ 输出二元决策 $a_t \in \{0,1\}$ 决定此刻是否发送,planning agent $\pi_P$ 输出时间间隔 $\Delta t > 0$ 把下次系统激活安排在 $t + \Delta t$:
$$(a_t, \Delta t) = \bigl( \pi_A(s_t, R_t),\ \pi_P(s_t, R_t) \bigr) \tag{3}$$
为实现端到端学习,两个任务共享底层的 user / environment / 可选 item embedding 参数。
核心方法:三智能体闭环¶
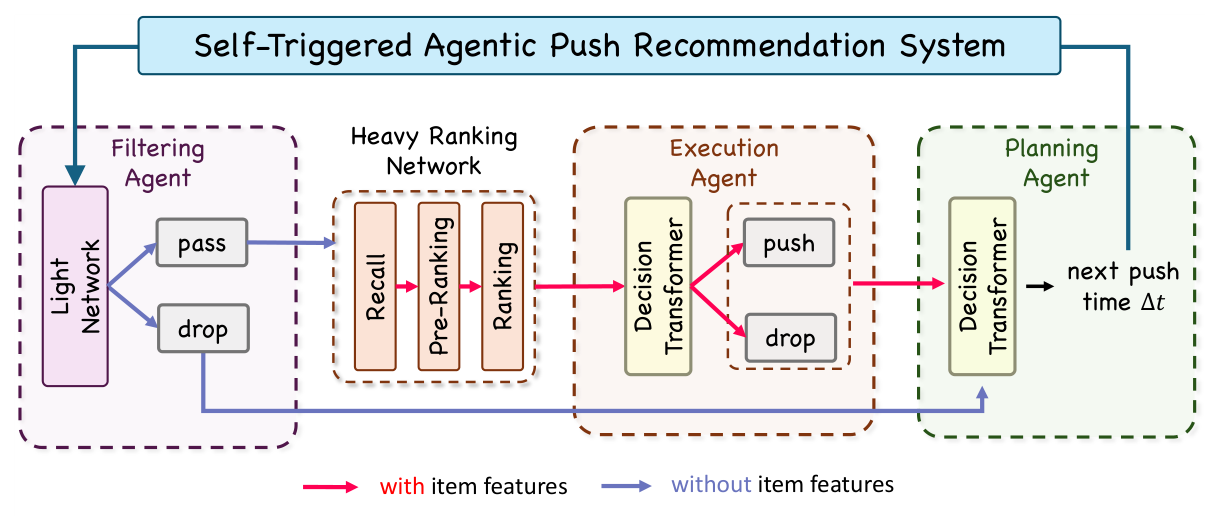
Figure 2 是整个系统的骨架,闭环顺序为:
- Filtering Agent(轻量网络) 先对到来的请求判 pass / drop;
- pass 的请求进入 Heavy Ranking Network(Recall → Pre-Ranking → Ranking 三段式重排序,带 item 特征,图中红色箭头);
- Execution Agent(Decision Transformer)在候选 item 就绪后判 push / drop;
- Planning Agent(Decision Transformer)生成 next push time $\Delta t$,回流到 filtering agent,闭环重启。
一个值得注意的工程细节:被 filtering agent drop 掉的请求并不直接丢弃,而是走蓝色箭头(不带 item 特征)直连 planning agent——也就是说即使这次请求被剪枝,系统仍然会重新规划下一次唤醒时刻,闭环不会断掉。这正是"轻量剪枝不破坏自触发链路"的关键设计。
1. Planning Agent:主动引擎¶
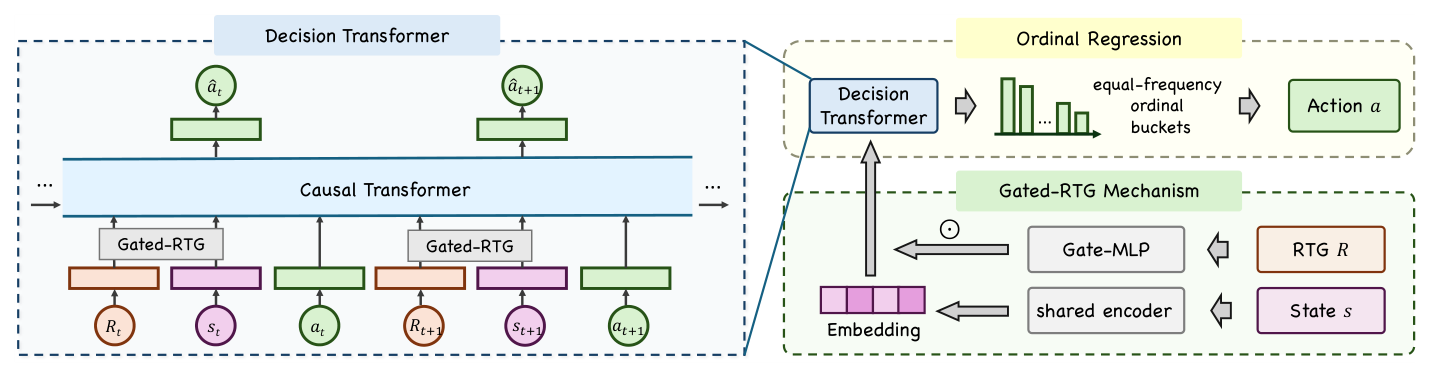
planning agent 是 agentic 框架的"主动引擎"。DT 结构以状态 $s_t$ 与目标 RTG $R_t$ 为输入,条件生成 $\Delta t$(item 侧信息可选,取决于是否执行 item 排序)。为在高度动态的推送场景里真正获得这种生成能力,论文引入两个核心机制。
Gated-RTG 条件注入机制¶
问题:标准架构直接把 RTG 与稠密高维状态表征拼接(concatenate),RTG 很容易被占主导的状态特征淹没,模型学不出稳定的条件-动作关联。直觉上原因很清楚——RTG 是 1 维高方差标量,拼进几百维的 state embedding 后,网络最省力的优化路径就是直接绕过它。
做法:RTG $R_t$ 先经一个 MLP tower 升维,再以逐元素相乘(Hadamard 积)的方式注入状态,充当门控:
$$e_{gated} = e_s \odot \mathrm{MLP}(R_t) \tag{4}$$
其中 $e_s$ 是状态 embedding。门控后的表征 $e_{gated}$ 送入 decoder 生成推送时刻。乘性注入的意义在于:网络无法再"绕过"这个不可靠条件——RTG 一旦为 0,整条状态通路就被压制,从而强制建立条件-动作对齐。
序数回归做时刻生成¶
问题:直接回归连续时间间隔 $\Delta t$(0 到 24 小时)非常不稳定,因为标签分布非高斯、重长尾,且误差容忍度非线性。论文举的例子很直白:10 分钟与 40 分钟的差别,远比 10 小时与 10.5 小时的差别关键。
做法:把时刻生成改写为 ordinal regression(序数回归),利用动作与回报之间的整体单调关系(推送间隔越大,活跃率通常越低)。具体地,把连续动作空间切成 $K = 100$ 个等质量(equal-mass / equal-frequency)桶,边界为 $\{\tau_k\}_{k=1}^{K}$,保证每桶样本数相同。decoder 输出序数 logits $z_k$,每个桶表示"下一次推送时刻 $\Delta t$ 严格大于边界 $\tau_k$"的概率。因此第 $k$ 桶的标签为 $y_k = \mathbb{1}[\Delta t > \tau_k]$,用跨全部桶的二元交叉熵优化:
$$\mathcal{L}_{next} = \sum_{k=1}^{K} BCE(y_k, z_k) \tag{5}$$
在线推理时,把序数 logits 平滑聚合还原成精确的连续时间间隔(取 $\tau_0 = 0$):
$$\Delta t = \sum_{k=1}^{K} (\tau_k - \tau_{k-1}) \cdot \mathrm{Sigmoid}(z_k) \tag{6}$$
这个解码式本质上是对生存函数(survival function)做数值积分:$\mathrm{Sigmoid}(z_k)$ 是"超过 $\tau_k$"的概率,乘以桶宽求和即期望值。相比 argmax 取桶,它输出连续值且对单桶噪声不敏感。
$\lambda_n$ 条件化:不重训也能调业务目标¶
为了让线上能动态调整业务目标,预测的 $\Delta t$ 必须在不同输入 RTG 值下都泛化良好,因此策略 $\Delta t = \pi_P(s_t, R_t)$ 需要捕捉 $R_t$ 中 $\lambda_n$ 的具体作用。做法是训练阶段不固定 $\lambda_n$,而是把策略条件化在 $\lambda_n$ 上,并从均匀分布 $U(0,1)$ 采样 $\lambda_n$(沿用多目标 RL 的 dynamic weights 思路 [2])。结果是线上可以直接调 $\lambda_n$ 来在正负业务效果之间取舍,无需重新训练——这对工业系统的运营灵活性极为重要。
2. Execution Agent:价值引导的决策¶
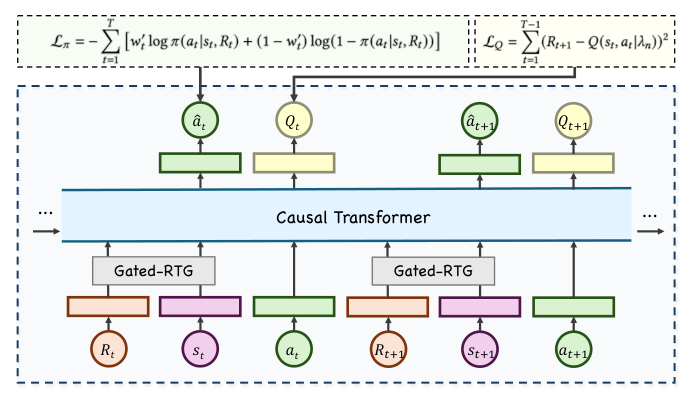
execution agent 负责在 planning agent 生成的时刻上判定是否发送。基于状态 $s_t$,受 GAVE [9] 启发,论文提出 Generative Value-Guided Decision 架构,同样沿用 Gated-RTG 与 $\lambda_n$ 采样机制以支持线上动态调优。
具体需要估计动作价值函数 $Q(s_t, a_t \mid \lambda_n)$ 来学习 $R_{t+1}$,同时学习动作生成策略 $\pi(a_t \mid s_t, R_t)$。与原始 GAVE 的两处差异:
- GAVE 在连续动作空间里做 action sampling,而推送是离散二元动作空间,因此这一步被省略;
- 更关键的差异:GAVE 直接把 $Q(s_t,a_t\mid\lambda_n)$ 回归到观测到的 RTG $R_t$ 上。但离线训练数据里的动作可能本身就是次优的,观测 RTG 无法准确代表状态 $s_t$ 下的真实未来回报 [31],直接回归观测 RTG 会导致次优表现。
因此改用 Bellman 方程学习 $Q$。以正向奖励 $r_t^{+}$ 为例,对应 $Q$ 值代表用户的活跃概率。直觉上:不活跃用户始终 0 奖励;活跃用户在时刻 $M$(若用户在 $M$ 与 $M+1$ 之间变活跃)获得 1 奖励。因此活跃用户的奖励定义为:
$$r_t^{+} = \begin{cases} 0, & t < M \\ 1, & t = M \text{ 且用户在 } M \text{ 与 } M+1 \text{ 间活跃} \\ 0, & t > M \end{cases} \tag{7}$$
正向 RTG 据此迭代定义:
$$R_t^{+} = \begin{cases} 0, & \text{若用户已活跃} \\ r_t^{+} + \gamma \max_a Q^{+}(s_t, a \mid \lambda_n), & \text{经 Bellman 方程} \end{cases} \tag{8}$$
同样的技巧用于定义负向 RTG $R_t^{-}$。随后用 MSE 学习 $Q$:
$$\mathcal{L}_Q = \sum_{t=1}^{T-1} \bigl( R_{t+1} - Q(s_t, a_t \mid \lambda_n) \bigr)^2 \tag{9}$$
其中 $R_t = R_t^{+} - \lambda_n R_t^{-}$,$Q(s_t,a_t\mid\lambda_n) = Q^{+}(s_t,a_t\mid\lambda_n) - \lambda_n Q^{-}(s_t,a_t\mid\lambda_n)$。
目标是引导策略学到 $Q$ 值更高的动作。沿用 GAVE,计算 advantage weight:
$$w_t = \mathrm{Sigmoid}\bigl( \alpha_r \cdot ( Q(s_t, a_t \mid \lambda_n) - Q(s_t, 1 - a_t \mid \lambda_n) ) \bigr) \tag{10}$$
$\alpha_r$ 为缩放超参数。用它重加权动作损失:
$$\mathcal{L}_{\pi} = -\sum_{t=1}^{T} \Bigl[ w'_t \log \pi(a_t \mid s_t, R_t) + (1 - w'_t) \log \bigl(1 - \pi(a_t \mid s_t, R_t)\bigr) \Bigr] \tag{11}$$
其中 $w'_t$ 是梯度冻结版的权重。直觉是:给相对 $Q$ 值更大的动作更高权重,从而显式把 execution agent 推向最优行为。注意这里的写法很巧妙——当 $w_t \to 1$(日志动作确实更优)时退化为对日志动作的模仿;当 $w_t \to 0$(反动作更优)时,损失变成"学习反动作",等价于在二元空间里做了一次动作翻转纠正。这正是"纠正离线日志次优行为"的机制所在。
最终训练损失为:
$$\mathcal{L} = \mathcal{L}_{next} + \lambda_1 \mathcal{L}_Q + \lambda_2 \mathcal{L}_{\pi} \tag{12}$$
为什么两个 agent 结构不同(重要的工程判断)¶
论文专门讨论了 planning 与 execution 结构不对称的原因:
- planning agent 用传统 DT 结构:预测精确投放时刻是高噪声 + 连续动作空间任务。噪声高的原因是 planning agent 位于推送系统上游,单次决策的效果会被下游多个环节稀释;且推送时刻决策并不直接决定最终投放,RTG 与生成时刻之间关联相对薄弱。
- execution agent 用 value-guided 结构:作者实证发现引入 critic 能带来更高的性能上限,但参数更难调、在高噪声条件下容易 reward hacking。因此只在噪声更低的二元执行场景使用价值引导结构。
这段讨论的价值在于给出了"何时该上 critic"的经验法则:动作空间离散、信号与结果链路短、噪声低 → 上 value guidance;反之保守用监督式 DT。
3. 落地挑战与 Filtering Agent¶
论文用一节专门讲系统落地要解决的两个现实问题。
第一,纯 agent 触发会漏掉实时业务事件。平台上有海量实时事件(关注的创作者开播、好友发新视频),只靠 planning agent 会错过这些时效性强的关键时刻。例如用户关注的创作者突然开播,这是高潜力的即时推送机会。因此实际实现里,事件驱动触发与 agent 生成的时刻被无缝融合。
第二,百万级 QPS 下的失控风险。由于系统抛弃了固定预算上限与预定义投放窗口,存在异常时间规划的固有风险(比如生成极短间隔),过度触发会吞掉巨量算力。为此引入轻量 filtering agent 保障整条 agentic 流水线的安全性、稳定性与资源效率。
两条硬边界控制:
- System-side control:一次成功投放之后的固定窗口内,抑制下游激活;
- User-side control:用户自然活跃之后的固定窗口内,抑制下游激活。
实践中这两条边界用高度保守的硬编码阈值(分钟级而非小时级),只用于杜绝极端 case 的通知轰炸。
核心过滤决策由轻量模型完成:把重量级 execution agent 的知识蒸馏进一个 3 层 MLP,且刻意不使用 item 侧特征。这个排除是关键——一旦引入 item 特征,就不可避免要调起下游 item 排序流水线;而 recall / pre-ranking / ranking 这几段复杂阶段主导了算力开销,全流水线消耗大约是只用 user + environment 特征的 10 倍。通过蒸馏决策过程、充当稳健的守门员,用可接受的模型指标微降,换取系统不在低潜力时刻上浪费巨量算力。
实验设置¶
- 离线:超过 6 个月的抖音生产日志,覆盖超 10 亿用户,保证模型在多样化用户分层上的稳健性与泛化性;
- 在线:直接在抖音推送平台做 A/B,完全随机的用户设备分流,连续运行 14 天;
- Baseline 一(Pre-Planned Frequency [15]):抖音当前的生产基线。在目标日开始前,这套多阶段系统用 uplift 建模预排推送频次,并在全局预算约束下用整数规划求解器为每个用户提前分配投放时刻。
- Baseline 二(Fixed-Interval Triggering [18]):一个工业级 Decision Transformer 模型(LinkedIn 的多目标 DT 通知优化),用固定间隔机制周期性判断是否发送,绕开精确时刻生成。为保证线上 A/B 公平,作者仔细调过它的轮询频率,使其资源消耗尽可能对齐基线。
评估指标(均报告相对预排频次基线的相对百分比变化):
| 指标 | 含义 | 方向 |
|---|---|---|
| UAD(User Active Days) | 用户活跃天数 | ↑ |
| NE(Negative Experience) | A/B 期间撤销推送权限的用户数,直接刻画过度/不当打扰造成的用户疲劳 | ↓ |
| Resource Consumption | 系统整体算力成本 | ↓ |
主要实验结果¶
与 SOTA 范式的对比(Table 1)¶
| Method | UAD ↑ | NE ↓ | Resource ↓ |
|---|---|---|---|
| Pre-planned frequency | – | – | – |
| Fixed-interval triggering | -0.0670% | +0.0205% | +6.548% |
| STEPS | +0.2843% | -1.9089% | -79.42% |
结论分析:
- 定时轮询在可比资源预算下打不过预排基线:UAD 轻微掉点(-0.0670%),NE 反而上升(+0.0205%),资源还多用了 6.548%。这个结果本身就是对"固定时间片"范式的有力反驳——当轮询频率被压到与基线同等资源时,它捕捉最优时机的能力就已经被削没了。
- STEPS 三个维度同时改善:UAD +0.2843%、NE -1.9089%、资源 -79.42%。在十亿 DAU 的量级上,0.2843% 的活跃天数与 1.9089% 的权限关闭率降幅都是相当可观的绝对量。
- 论文自己做了一处诚实的归因澄清:虽然自触发机制天然避免冗余轮询,但 79.42% 的资源削减主要来自新引入的轻量 filtering agent,它在请求触达算力密集的下游 item 排序与执行流水线之前就剪掉了低价值请求。
消融:三个 agent 各自的贡献(Table 2)¶
| Agent | UAD ↑ | NE ↓ | Resource ↓ |
|---|---|---|---|
| Planning | +0.1808% | -0.9781% | -4.54% |
| Execution | +0.1035% | -0.6843% | – |
| Filtering | – | -0.2465% | -74.88% |
结论分析:
- planning agent 是正负指标的主要贡献者(+0.1808% UAD、-0.9781% NE)。这说明更好的规划既能保证有价值的时机被抓住,也能主动避开会打扰用户的不合理发送时间——一个模块同时改善两个相反方向的指标,正是"把时刻决策内生化"的直接收益。
- execution agent 进一步放大收益(+0.1035% UAD、-0.6843% NE),靠的是在规划出的时刻上准确评估候选 item。
- filtering agent 提供边界控制进一步压 NE(-0.2465%),而它对低潜力请求的剪枝贡献了-74.88% 的算力削减——这是全系统 -79.42% 里的绝对主项。
三者的分工非常清楚:planning 管"时机质量",execution 管"内容判断",filtering 管"算力与安全"。
深入分析(一):Planning Agent¶
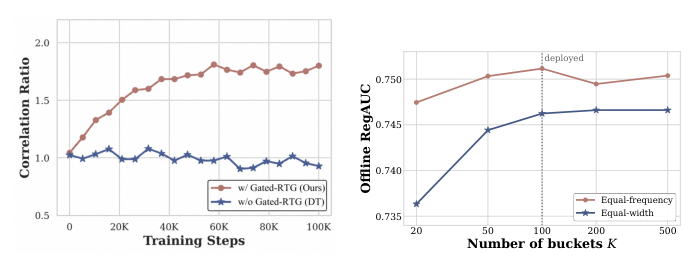
Gated-RTG 是否真的让模型"听懂"了条件? 在高噪声工业环境里观测 RTG 方差极大,标准条件模型常常直接忽略这个信号。作者定义 Correlation Ratio 来量化模型预测 $\Delta t$ 时是否真的跟随 RTG 提示:
$$\text{Correlation Ratio} = \frac{\mathbb{E}_x\bigl[\hat{\Delta}t(\text{RTG} = r_{low})\bigr]}{\mathbb{E}_x\bigl[\hat{\Delta}t(\text{RTG} = r_{high})\bigr]} \tag{13}$$
其中 $r_{low} = 0.0$、$r_{high} = 1.0$。比值接近 1.0 意味着严重的"condition-ignoring"问题——无论目标 RTG 是什么,模型输出都一样;比值明显偏离 1.0 才证明模型建立了稳定的条件-动作对齐。
Figure 5a 的结果:不带 Gated-RTG 的标准 DT 彻底失败,correlation ratio 在 1.0 附近随机波动(整个 100K 训练步都没脱离)。原因是标准拼接把 1 维高方差 RTG 标量当作普通输入特征,神经网络通过"绕过它"来优化,脆弱的条件信号被丰富的高维状态 embedding 完全淹没。而 Gated-RTG 用乘性方式强迫状态 embedding 被 RTG 调制,消除了网络绕过这个不可靠条件的能力,比值稳步收敛到约 1.8——这个值与训练数据的真实经验统计高度吻合。这有力证明了 Gated-RTG 在严重环境噪声下仍能稳健捕捉底层数据分布。
桶配置超参分析:评估两种分桶方式(equal-width 等宽 vs equal-frequency 等频)与不同桶数 $K \in \{20, 50, 100, 200, 500\}$。Figure 5b 显示:
- 等频策略一致优于等宽,因为它把更细的分辨率分配给稠密的短间隔区域;
- 等频设置下 $K \in [50, 500]$ 性能稳定,峰值在 $K = 100$(Regression AUC 0.75116);
- $K$ 太小会损失关键的时间分辨率,$K$ 太大则把监督信号过度稀疏化且无额外收益。
最终线上配置定为 $K = 100$ 等频桶(图中 deployed 竖线位置)。
下游通过率(Table 3):
| Filtering Pass Rate | Execution Pass Rate |
|---|---|
| +12.3% | +2.3% |
一个理想的生成时刻应当顺畅通过所有下游 agent 触发投放,同时最大化业务价值与资源效率。两个通过率都显著提升,根本原因在于 RTG 是端到端采集的——从最初的规划决策,经下游各 agent,直到最终用户响应。因此任何被下游拦截的请求都得到零 RTG,这把过滤结果作为隐式监督信号嵌进了奖励里。通过优化端到端 RTG,planning agent 自然偏向生成"能活着走完下游"的时间间隔。结果是同样的算力预算现在能支撑更多高质量、可投放的请求——作者认为这是 UAD 提升的首要驱动力。
这一点很值得借鉴:用端到端 RTG 把下游拦截转化为上游的隐式监督,避免了为"下游是否通过"单独设计一个辅助损失。
发送密度(Table 4):
| Inter-push Gap | 0~20min | 20min~1h | 1h~3h | 3h~6h |
|---|---|---|---|---|
| Change | -35.93% | +20.37% | +91.93% | +179.84% |
| Quantile | 0.01 | 0.05 | 0.25 | 0.5 |
|---|---|---|---|---|
| Change | +0.1% | +13.1% | +20.1% | +25.6% |
planning agent 大幅抑制了高频突发:极短间隔推送(0–20 分钟)占比骤降 35.93%,而 3–6 小时的良好间隔占比暴涨 179.84%;相应地,间隔分布的第 5 到第 50 百分位一致向更大值移动(+13.1% ~ +25.6%),而第 1 百分位几乎不动(+0.1%)——即最极端的短间隔尾巴被保留(用于承接实时事件),但整体分布被系统性拉开。通过主动削减密集推送簇,planning agent 成为缓解用户疲劳、降低 NE 的关键机制。
深入分析(二):Execution Agent¶
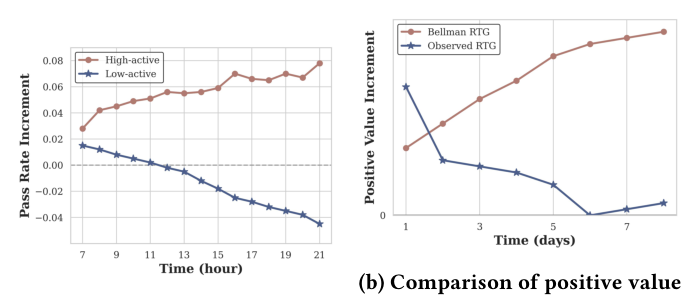
日内通过率动态(Figure 6a):对当前未激活但历史高活跃的用户,通过率增量随时间稳步上升且始终为正,在晚间达到峰值(约 +0.08)。这说明如果一个高活用户到了夜里还没来,推一条的正向价值相当可观。反过来,对当前未激活的低活跃用户,通过率增量在晚间跌破零进入负区间(约 -0.045)。这个鲜明对比反映了模型的轨迹感知能力:低活用户到了夜里还没打开,说明他今天大概率不会来了,推送的正向价值微乎其微。这些时序现象支撑了执行策略的合理性。
Bellman RTG 的长期价值(Figure 6b):在线 A/B 监控长期正向价值增量。传统上直接从观测 RTG 学 $Q(s,a)$ 的方法初期冲高但随后衰减,正向价值增量在几天内收敛到接近零;相比之下 Bellman RTG 建模呈现持续稳定上升,一直稳居基线之上。由于两种方法都用了 Gated-RTG 机制,这种长期改善可以主要归因于 Bellman RTG 形式化本身,证明它在优化累计轨迹价值上的有效性。
这张图是全文最有说服力的证据之一:它把"离线日志次优 → 观测 RTG 有偏"这个理论论断,转化成了线上可观测的"初期虚高、随后回落"曲线形态。
极端发送行为的缓解(Table 5):
| Metric | Relative Change |
|---|---|
| Zero sends (0) | -4.06% |
| Moderate sends (1~20) | +20.31% |
| Frequent sends (21~30) | -6.87% |
| Extreme sends (>30) | -9.30% |
每用户日发送量分布变得显著更均衡:收到 >20 条与 >30 条推送的用户占比分别降低 6.87% 与 9.30%,同时零发送用户降低 4.06%。这表明 Bellman-based RTG 建模同时惩罚过频与过疏的发送,把整体人群平滑地推向更合理适中的日推送量(1~20 条)区间。注意这是一个双向收敛的效果——一般的频控手段只能压上限,而这里"零发送"也在减少,说明模型确实在做价值判断而非简单限流。
Q 值的准确性(Figure 7):
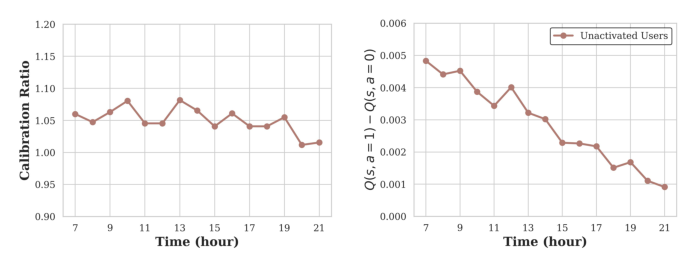
以 $Q^{+}$ 为例:(a)预测 $Q$ 值与真实 RTG 的比值在一天各小时内稳定在 1.0 到 1.1 之间,说明预测校准良好(略微高估但幅度极小);(b)分析触发推送的边际价值 $Q^{+}(s, a=1) - Q^{+}(s, a=0)$,对当前未激活用户,该边际差在一天内单调递减(从早 7 点约 0.0048 降到晚 21 点约 0.001)。这有效捕捉了底层的人群动态:随着时间推移,剩余未激活用户池越来越被本质低活跃的用户主导,导致日内后段推送的边际回报自然衰减。这与 Figure 6a 展示的时序动态一致互证。
深入分析(三):Filtering Agent¶
早期过滤的必要性(Table 6,归一化到 filtering agent):
| Agent | Resource (Overall) | Resource (Per 1k requests) |
|---|---|---|
| Filtering | 1.00 | 1.00 |
| Planning | 1.27 | 1.27 |
| Execution | 9.62 | 57.72 |
filtering 与 planning 的单请求开销相当,而 execution agent 昂贵得多——每 1k 请求消耗超过 filtering 阶段 50 倍的算力(57.72×)。这巨大开销主要来自该 agent 内部复杂的候选 item 排序机制,需要对多个候选 item 做密集的实时价值估计。因此有效减少抵达执行阶段的请求量,直接转化为可观的算力节省,保证端到端 agentic 流水线在海量线上流量下仍然可扩展、可行。
注意 Overall 列(9.62)与 Per 1k 列(57.72)之间的差距本身就是过滤有效性的证据:执行阶段的总开销只有单位开销的 1/6,正是因为绝大部分请求根本没走到那里。
过滤阈值敏感性(Figure 8):
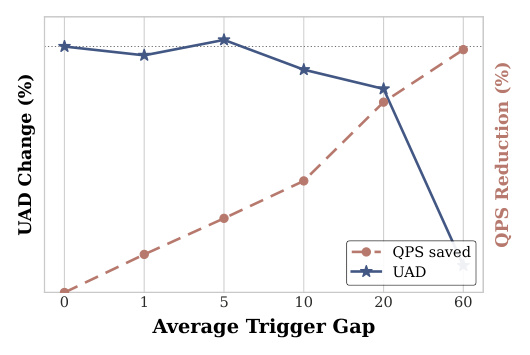
filtering agent 用固定阈值过滤 planning agent 或实时业务(如好友发新视频)产生的低价值事件。调整该阈值会影响 execution agent 的触发频率。作者以两次触发之间的时间间隔(trigger gap)作为生产环境的关键监控指标。Figure 8 揭示了价值-效率权衡的明显拐点:平均 trigger gap 增大到 20 分钟以内时,QPS 节省稳步显著上升,而 UAD 只有边际下滑;但更激进的过滤会带来不成比例的价值损失——当平均 trigger gap 达到 60 分钟时 UAD 断崖式下跌。因此线上采用分钟级而非小时级的保守阈值,在效率与用户价值之间取得最优平衡。
价值感知的资源削减(Table 7,本文 filtering agent 相对两种 baseline 的请求剪枝率):
| Baseline | Inactive | High-Active | Fully-Active |
|---|---|---|---|
| No Filter | 78.86% | 66.63% | 85.65% |
| Random Filter | 5.60% | 5.13% | 63.70% |
相比无过滤设置,filtering agent 的整体请求剪枝率为 74.88%,其中不活跃用户(78.86%)与完全活跃用户(85.65%)的剪枝率尤其高。这与设计动机完全吻合:
- 不活跃用户的边际响应价值本就很低,是早期剪枝以省算力的首选;
- 完全活跃用户天然会触发大量业务事件(关注创作者开播、好友发新视频),产生众多潜在推送机会,但这些冗余推送价值可忽略却显著损害用户体验(通知疲劳)。
因此过滤模块主要针对这些冗余请求。与 random filter 的对比是这张表的精髓:为了达到完全相同的最终发送量,朴素随机过滤必须放行显著更多请求进入下游,在那些 execution agent 最终必然拒绝的低质机会上白白浪费算力;而价值感知的 filtering agent 能提前准确预测并剪掉这些"注定失败"的请求,相比随机基线在完全活跃用户群上额外多剪 63.70% 的请求。这明确证明其剪枝决策由用户价值驱动,而非仅仅是固定流量预算。
由此论文总结过滤阶段的双重角色:(i) 提前丢弃大量候选推送事件,直接砍掉后续流水线的算力成本;(ii) 选择性剪除冗余低价值推送机会,在不牺牲 UAD 的前提下防止过度打扰、显著降低 NE。
核心贡献总结¶
- 问题重构:把工业推送从"被动执行预设计划"改写为"自触发闭环 agentic 过程",系统自己决定下一次何时被唤醒——这是整篇论文最有迁移价值的形式化,它把时间轴决策从系统外生参数变成了模型内生动作。
- Gated-RTG:用乘性门控替代拼接注入条件,解决工业高噪声下 DT 的 condition-ignoring 问题,并用 Correlation Ratio 这个简洁指标把"模型是否真听条件"变得可测量。
- 门控序数回归:把长尾、误差容忍非线性的连续时刻预测转成 100 个等频桶上的序数分类 + 生存函数积分解码,兼顾稳定性与连续输出精度。
- Bellman RTG + advantage 重加权:用 Bellman 方程替代对观测 RTG 的直接回归,纠正离线日志次优行为,线上验证了长期价值不衰减。
- 蒸馏式 filtering agent:以 item 特征的有无划分轻重两条通路(10× 算力差),把重模型知识蒸馏进 3 层 MLP 做守门员,单点贡献 74.88% 算力削减,并兼作规划异常的安全兜底。
- $\lambda_n$ 条件化:训练期从 $U(0,1)$ 采样 $\lambda_n$,线上不重训即可调正负目标权衡。
与已归档相关工作的对比¶
GAVE GAVE: Generative Auto-Bidding with Value-Guided Explorations (Kuaishou, 2025-04-20)¶
关系:显式引用,本文 execution agent 直接改造自 GAVE,但原文仅在 §3.3 做机制层说明、未给出指标层对比表 · 已加载对方精读
- 共同关注的问题:两者都在解同一个 root cause——把 DT 用于工业序列决策时,离线日志中的动作本身是次优的,纯条件模仿会复现次优行为(behavioral collapse),而观测 RTG 又不足以代表状态下的真实未来回报。GAVE 在自动出价场景遇到它,STEPS 在推送执行决策上遇到它。
- 相近的技术骨架:两者的方法流程图可以抽象重合——DT 主干 + 一个额外的价值信号 + 用价值差构造的 Sigmoid 权重去重加权动作损失。STEPS 的 advantage weight $w_t = \mathrm{Sigmoid}(\alpha_r \cdot (Q(s_t,a_t) - Q(s_t,1-a_t)))$ 与 GAVE 的 $w_t = \mathrm{Sigmoid}(\alpha_r \cdot (\hat r_{t+1} - \tilde r_{t+1}))$ 在形式上一一对应,连缩放系数记号 $\alpha_r$ 都沿用。
- 本文的差异与推进:(1) 动作空间——GAVE 的动作是连续出价系数 $\lambda_t$,需要 $\hat\beta_t \in (0.5, 1.5)$ 的探索缩放来保证稳定性保持更新;STEPS 是二元动作,直接用"反动作" $1 - a_t$ 作对照,省掉了整个 action exploration 模块。(2) 价值目标——GAVE 用 expectile regression($\tau = 0.99$)学 $V_{t+1}$ 逼近 $r_{t+1}$ 的上界,本质仍锚在观测 RTG 上;STEPS 明确指出这一点是缺陷,改用 Bellman 迭代(式 8)自举 $Q$,并在 Figure 6b 用线上 A/B 证明:观测 RTG 路线初期冲高后衰减至近零,Bellman 路线持续稳定上升。这可以看作对 GAVE 价值估计环节的一次直接修正。(3) λ 条件化——GAVE 用 score-based RTG(CPA 惩罚因子 $\mathbb{P}(CPA_t;C)$)把约束编码进回报;STEPS 则把权衡系数 $\lambda_n$ 直接作为策略条件并从 $U(0,1)$ 采样,实现线上免重训调参,灵活性更高。
- 可比的方法/实验差异:GAVE 在公开 AuctionNet / AuctionNet-Sparse 上做 round-robin 评测(相对 GAS 提升 1.3%~6.75%),有完整的离线 baseline 矩阵;STEPS 完全没有公开数据集实验,只有抖音线上 A/B。从可复现性看 GAVE 更规范,从系统完整性看 STEPS 更完整——后者把 DT 从"单个决策模块"扩展成了包含自触发与算力守门的整条流水线。
TwiSTAR TwiSTAR: Think Fast, Think Slow, Then Act (Tsinghua SIGS, 2026-05-12)¶
关系:独立并发(本文未引用 TwiSTAR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两者都在攻击"推荐系统对昂贵推理/计算采用固定调用策略"这一结构性瓶颈。TwiSTAR 指出现有生成式推荐要么全量 fast(在 hard 样本上欠拟合)、要么全量 slow(在 easy 样本上浪费算力且掉点);STEPS 指出推送系统要么离线预排(缺实时性)、要么固定间隔轮询(算力与时机两难)。去掉场景差异后,两者的 root cause 完全一致:昂贵下游的调用时机被外生固定,无法按价值自适应分配算力。
- 相近的技术骨架:两者都引入了一个学到的上游 planner/agent,由它决定是否/何时调用昂贵下游,并用端到端的最终结果信号来训练这个 planner。TwiSTAR 的 planner 在 fast retriever / rank tool / slow think-and-rec 三个工具间路由,用 SFT 模仿 + agentic RL(GRPO)训练;STEPS 的 planning + filtering agent 在时间轴与请求维度上决定何时唤醒、是否放行重排序流水线,用端到端 RTG 与蒸馏训练。两者的方法流程图都是"廉价决策器 → 条件性调起昂贵管线 → 结果回流训练决策器"。
- 本文的差异与推进:TwiSTAR 的自适应维度是样本难度(这条用户历史该用多深的推理),决策是离散的工具选择;STEPS 的自适应维度是时间轴(下次何时唤醒自己),决策是连续时刻生成 + 二元放行。STEPS 多出了 TwiSTAR 没有的一环:决策的输出会改变系统自身未来被调用的时刻,形成真正的自触发闭环,而 TwiSTAR 的 planner 仍然是被动响应外部到来的请求。另一方面 TwiSTAR 用 LLM + GRPO,可解释性与语义能力更强;STEPS 用 DT + 蒸馏 MLP,量级上能扛百万 QPS。
- 可比的方法/实验差异:TwiSTAR 在 Amazon Beauty/Toys/Sports 上做学术评测,报告 12 个 metric-dataset 单元全胜 OneRec-Think 且推理墙钟时间降 3.3×;STEPS 只有工业 A/B,报告算力降 79.42%、UAD +0.2843%。两者的"效率增益"数量级差异(3.3× vs 5×)主要来自剪枝对象不同:TwiSTAR 省的是 CoT 解码 token,STEPS 省的是整条 recall/pre-ranking/ranking 级联。
RecGPT-Mobile RecGPT-Mobile: On-Device LLMs for User Intent Understanding (Taobao & Tmall Group of Alibaba, 2026-05-06)¶
关系:独立并发(本文未引用 RecGPT-Mobile)· 已加载对方精读
- 共同关注的问题:两者共享一个具体到近乎相同的子问题——一个昂贵模型不可能对每个事件都调用一次,必须由一个廉价上游信号决定"何时值得唤醒它"。RecGPT-Mobile 面对的是端侧 LLM:每次行为变化都触发一次推理会迅速耗尽电量与内存预算;STEPS 面对的是推送流水线:每个候选时刻都调起带 item 排序的重管线会吃掉百万 QPS 的算力。
- 相近的技术骨架:两者都在昂贵组件前面放了一道轻量触发闸门,并且都把"触发率"作为一等公民指标来报告。RecGPT-Mobile 用 entropy + Jaccard + JS 三类统计信号做意图漂移检测,把 LLM 日均调用压到 21% 触发率、功耗降到 40%;STEPS 用蒸馏出的 3 层 MLP(刻意不含 item 特征)做价值过滤,剪掉 74.88% 请求。"故意不给闸门喂昂贵特征"是两者共同的关键设计——RecGPT-Mobile 的漂移检测只看本地行为统计,STEPS 的 filtering agent 只看 user + environment 特征,因为一旦引入 item 特征就必须调起下游排序(10× 开销)。
- 本文的差异与推进:触发器的学习方式与决策语义不同。RecGPT-Mobile 的触发器是无参数的统计规则(漂移超阈值即触发),只回答"该不该重算意图";STEPS 的闸门是从重模型蒸馏而来的学习式价值预测器,回答的是"这次请求的推送价值够不够进入昂贵管线",并且额外有 planning agent 生成下一次唤醒时刻——RecGPT-Mobile 的触发仍然是被动的(等行为发生才检测漂移),STEPS 是主动的(自己规划未来时刻)。这也是 STEPS 相对更彻底的一步:把"何时"从触发条件升级成了生成目标。
- 可比的方法/实验差异:RecGPT-Mobile 报告 Mobile Taobao 4 个场景一个月 A/B:+1.8% CLICK / +2.7% PAY / +2.5% GMV,效率指标是触发率 21% 与功耗 40%;STEPS 报告抖音 14 天 A/B:+0.2843% UAD / -1.9089% NE / -79.42% 资源。两者都没有公开数据集实验,都属于"只能靠工业 A/B 佐证"的系统论文。
讨论与局限性¶
值得借鉴的设计¶
- 把"何时被调用"变成模型输出:这是最具普适性的 insight。任何"昂贵决策系统 + 外生触发时机"的架构(推送、召回预计算、端侧模型唤醒、离线特征刷新)都可以套用这个重构——与其调参找最优轮询频率,不如让模型自己生成下次唤醒时刻。
- 端到端 RTG 自带下游监督:把下游拦截记为零回报,上游 planner 会自动学会生成"能活着通过下游"的决策。这避免了为对齐上下游单独设计辅助 loss 或引入复杂的多阶段联合训练,是一个很轻的工程技巧。
- 乘性条件注入 + 可测量的条件遵从度:Gated-RTG 本身不复杂,但配套的 Correlation Ratio 指标很有价值——它让"模型是否忽略了条件"从玄学变成一条可以画在训练曲线上的诊断线。任何做 conditional generation(RTG-conditioned、reward-conditioned、约束条件注入)的工业系统都应该抄这个诊断。
- 按特征成本切分轻重通路:filtering agent 与 execution agent 的边界不是按模型大小划的,而是按"是否需要触发下游 item 排序"划的——这才是真正的成本分水岭(10×)。这个"以调用图而非参数量定义模型层级"的思路,比常见的 cascade 剪枝更贴近真实开销结构。
- 训练期采样权衡系数:$\lambda_n \sim U(0,1)$ 的条件化让线上运营可以在不重训的前提下滑动正负目标的权衡点,对推送这种需要频繁调节"激进/保守"的业务尤其实用。
局限与争议¶
- 完全没有公开数据集实验,可复现性为零。全文所有实验都在抖音生产环境,无任何学术 benchmark,外部研究者无法验证 Gated-RTG、序数回归、Bellman RTG 三个组件各自的通用性。作为 RecSys 工业 track 论文这可以理解,但它也意味着这些组件的有效性证据完全绑定在一个特定系统上。
- 绝对收益幅度不大。UAD +0.2843% 在十亿用户量级上是有意义的绝对量,但作为一次涉及三个 agent 的架构级重构,这个幅度并不惊人;NE -1.9089% 反而更亮眼。更关键的是79.42% 的资源削减主要来自 filtering agent 这个相对朴素的蒸馏剪枝器,而非自触发形式化本身——论文自己也诚实承认了这点。换言之,如果只把 filtering agent 加到原有的定时轮询系统上,可能也能拿到大部分算力收益。自触发机制的独立贡献从消融看是 planning agent 那一行(+0.1808% UAD / -0.9781% NE / -4.54% 资源)。
- 消融是"逐个累加"而非"逐个移除",读法有歧义。Table 2 三行的数值加起来(+0.1808 + 0.1035 = 0.2843)恰好等于总 UAD 增益,暗示这是增量累加式的消融;但论文没有明确说明每一行的对照组是什么,也没有报告"去掉某个 agent"的结果。三个 agent 之间是否存在交互效应无从判断。
- 缺少与更强 baseline 的对比。全文只对比了两个范式(各一个代表方法),没有对比诸如上下文 bandit、约束优化 + 实时修正的混合方案,也没有与"定时轮询 + 同样的 filtering agent"这个最关键的消融对照——这恰恰是分离"自触发形式化"与"轻量剪枝"两项贡献的唯一办法。
- planning agent 不用 critic 的理由是经验性的。论文说引入 critic 能提高性能上限但难调参、易 reward hacking,这是有价值的工程经验,但没有给出任何支撑数据(哪怕一条失败曲线)。读者只能选择相信。
- 安全边界依赖硬编码阈值。system-side / user-side 两条抑制窗口是"高度保守的硬编码分钟级阈值",filtering 阈值也是固定值(Figure 8 靠人工扫描确定)。这意味着这个"agentic"系统的最外层安全网仍然是规则——自触发的自由度实际上被一圈手工护栏框住了,论文没有讨论这些阈值在用户分层间是否应当差异化。
- 方法论可扩展性存疑。核心是两个共享底层 embedding 的 DT,参数规模、序列长度、上下文窗口都未披露,也没有任何 scaling 相关实验。从架构看,扩参数时"如何表征用户历史"与"如何建模决策序列"可以一起增长(共享 encoder + causal transformer),不存在硬性的两阶段解耦瓶颈;但 filtering agent 作为蒸馏出的固定 3 层 MLP 是一个明确的容量天花板——主模型越强,蒸馏损失越大,守门员与执行者之间的能力鸿沟会越来越难弥合。
工业落地价值¶
这篇论文的工业价值主要不在指标幅度,而在披露了一套完整可运行的自触发推送架构:三个 agent 的职责切分、按"是否触发 item 排序"划分算力通路的判据(10×、57.72× 两个数字)、事件驱动触发与 agent 生成时刻的融合方式、以及分钟级保守阈值这一实操结论(Figure 8 的 20 分钟拐点与 60 分钟崩塌点)。对任何在做推送/触达/召回预计算的团队,这些数字与判据的参考价值高于 UAD 那 0.28%。