RecHarness:以 Bandit 路由驱动推荐模型自进化的 Agentic Harness
Haoran Ling、Yuecheng Li、Zeyu Song、Jing Yao、Shuwen Kang、Chi Lu、Wenjin Wu、Peng Jiang;Georgia Institute of Technology、Kuaishou Technology;arXiv:2607.29241v1,2026-07-31。
研究动机与背景
现代推荐模型的优化仍高度依赖工程师反复修改架构、训练目标、优化策略与特征交互方式。LLM-based MLE agent 已能读取任务、改代码、执行训练并依据日志继续迭代,但推荐系统里的每次试验都包含代码生成、训练和验证,成本并不低;在有限预算下,如果同时让 LLM 自由决定“下一步探索哪个方向”和“这个方向里具体改什么”,搜索容易发散,成功率与稳定性都不足。
RecHarness 的关键判断是:一次试验产生两类性质不同的反馈,不能都交给 LLM 隐式消化。验证分数是可累计的标量证据,适合交给显式的 Multi-Armed Bandit 路由器决定有限试验预算投向哪里;训练日志、收敛趋势、错误信息和失败原因是文本证据,适合让 LLM 在已经选定的方向内形成具体假设与代码修改。论文据此把“方向选择”与“假设/代码生成”解耦,并在局部编辑停滞时开放结构跳跃 arm,从而兼顾有限预算下的探索—利用与跨局部最优盆地的长期搜索。
这一目标不是为某个固定推荐模板做一次 AutoML,而是构造一个可适配不同任务、数据集、模型骨干和评价指标的自进化 harness。论文覆盖 Amazon 序列推荐、KuaiRec watch-time/ranking,以及快手大规模短视频广告排序;最终候选在 7 天线上 A/B 中同时提升广告主价值、收入和曝光。
核心方法与系统架构
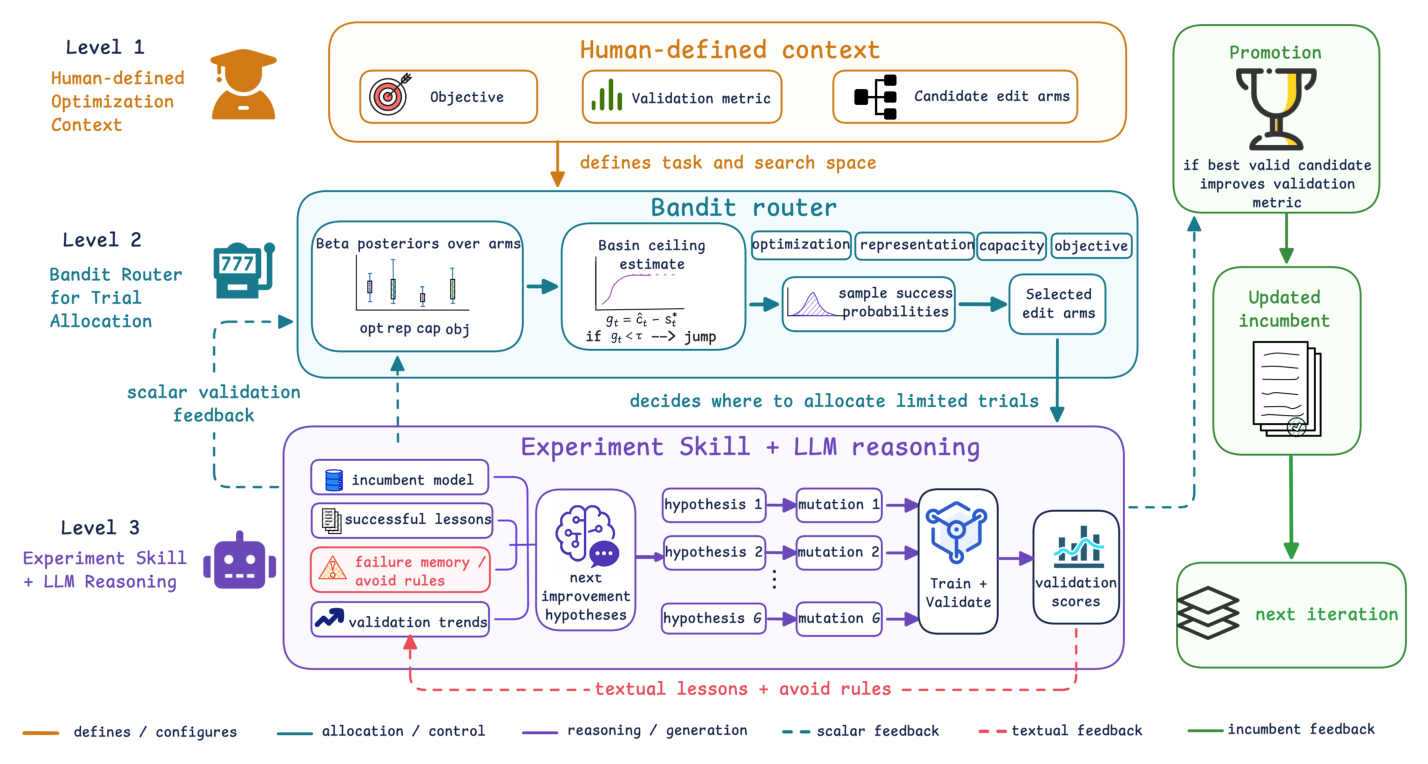
RecHarness 包含三级控制:
- Level 1:Human-defined context。 人类指定优化目标、验证指标和候选 edit arms,约束任务边界与搜索空间。
- Level 2:Bandit Router。 每个 arm 维护 Beta 后验;系统依据历史标量验证反馈,用 Thompson Sampling 选择下一轮应该探索的修改方向。
- Level 3:Experiment Skill + LLM reasoning。 LLM 读取当前 incumbent、成功经验、失败/avoid rules、验证趋势和日志,在选定 arm 内生成具体假设与可执行 mutation。候选经训练验证后,只有优于 incumbent 才晋升。
这三层形成两条反馈回路:标量分数回流到 Bandit posterior,决定“往哪里试”;文本教训回流到 Experiment Skill,决定“在该方向内怎么改”。两者职责分离,文本总结不会暗中覆盖路由器积累的统计证据。
1. 预算约束的推荐模型优化
给定初始实现 $f_0$、训练/验证划分 $D=(D_{\mathrm{train}},D_{\mathrm{val}})$、验证指标 $M$,实现 $f$ 所诱导的训练过程和指标为:
$$ \omega_f=\operatorname{Train}(f,D_{\mathrm{train}}),\qquad M(f)=M(\omega_f;D_{\mathrm{val}}). \tag{1} $$
任务 $T$ 上的目标是在总资源预算 $B$ 内,从有效实现空间 $S$ 找到最优实现:
$$ s^\star=\arg\max_{s\in S}h(T,s) \quad\text{s.t.}\quad C(s)\le B. \tag{2} $$
若第 $t$ 轮并行试验组为 $G_t$,其消耗包括代码生成、执行、训练和验证:
$$ C_t=\sum_{a\in G_t}c(f_{t,a}),\qquad \sum_t C_t\le B. \tag{3} $$
搜索空间不是具体 patch 或标量网格,而是一组可解释编辑维度:
$$ \mathcal A=\{a_1,a_2,\ldots,a_K\}. \tag{4} $$
例如学习率 schedule、dropout/weight decay、embedding 维度、层数/头数、序列 pooling、特征注入、loss 替换等。arm 又分为局部微调与结构跳跃两类:
$$ \mathcal A=\mathcal A_{\mathrm{local}}\cup\mathcal A_{\mathrm{jump}}, \qquad \mathcal A_{\mathrm{local}}\cap\mathcal A_{\mathrm{jump}}=\varnothing. \tag{5} $$
搜索始终围绕当前最优实现 $f_t^\star$,而不是每轮重新修改原始模板。LLM mutation operator 为:
$$ f_{t,a}=\mu_\phi(f_t^\star,a,m_t,\ell_t), \tag{6} $$
其中 $m_t$ 是 Experiment Skill,$\ell_t$ 汇总近期日志与验证轨迹,$\phi$ 是冻结的代码生成 LLM。候选集合 $V_t$ 只有严格提升时才替换 incumbent:
$$ f_{t+1}^\star= \begin{cases} \arg\max_{f\in V_t}M(f),&\max_{f\in V_t}M(f)>s_t^\star,\\ f_t^\star,&\text{otherwise}. \end{cases} \tag{7} $$
2. 组内归一化成功信号
arm $a$ 相对本轮开始时 incumbent 的改进为:
$$ \Delta_t(a)=M(f_{t,a})-s_t^\star. \tag{8} $$
为在同一并行组内公平比较不同候选,系统按组均值和标准差标准化:
$$ \widehat A_t(a)= \frac{\Delta_t(a)-\operatorname{mean}_{b\in G_t}\Delta_t(b)} {\operatorname{std}_{b\in G_t}\Delta_t(b)+\epsilon}. \tag{9} $$
普通局部试验只有同时满足“执行有效、优于组均值、不低于历史 incumbent”才记为成功:
$$ r_t(a)=\mathbb I\!\left[ f_{t,a}\ \text{is valid}\ \land\ \widehat A_t(a)>0\ \land\ M(f_{t,a})\ge s_t^\star \right]. \tag{10} $$
这是 incumbent-conditioned 的局部证据,不假设每个 arm 在所有模型状态下都有固定成功率。
3. Thompson Sampling 路由
每个 arm 维护 Beta posterior:
$$ \theta_a\sim\operatorname{Beta}(\alpha_a,\beta_a). \tag{11} $$
完成一轮后用二元奖励更新:
$$ \alpha_a\leftarrow\alpha_a+r_t(a),\qquad \beta_a\leftarrow\beta_a+1-r_t(a). \tag{12} $$
并行度为 $G$ 时,从当前可用 arm 集合 $\mathcal A_t$ 的采样成功率中取 Top-$G$:
$$ G_t=\operatorname{TopG}_{a\in\mathcal A_t}(\widetilde\theta_a), \qquad \widetilde\theta_a\sim\operatorname{Beta}(\alpha_a,\beta_a). \tag{13} $$
这让高回报方向更常获得预算,同时对证据不足的 arm 保留探索概率。重要的是,Bandit 只选语义方向,不生成具体代码;具体修改仍由 LLM 完成。
4. Experiment Skill 的文本记忆
每轮验证后,系统把成功候选的 arm、patch 摘要、验证分数和改进模式沉淀为 reusable lessons;把无效、失败或有害试验提炼为 failure feedback 与 avoid rules,并更新 incumbent 与趋势摘要:
$$ m_{t+1}=\operatorname{Summarize} \left(m_t,\{a,f_{t,a},M(f_{t,a}),e_{t,a}\}_{a\in G_t}\right), \tag{14} $$
其中 $e_{t,a}$ 包含执行状态、错误与压缩后的训练日志。Experiment Skill 只影响 $\mu_\phi$ 的假设形成,不直接修改 posterior,因此避免自然语言记忆把统计路由“架空”。
5. Basin-aware jump 与局部重调
incumbent 搜索样本效率高,但会在局部盆地饱和。系统用最近 $W$ 轮的平均改进速率判断是否接近盆地上限:
$$ \widehat v_t=\frac{s_t^\star-s_{t-W}^\star}{W}. \tag{15} $$
当 $\widehat v_t\le\tau$ 时开放 jump arms:
$$ J_t=\mathbb I[\widehat v_t\le\tau],\qquad \mathcal A_t= \begin{cases} \mathcal A_{\mathrm{local}}\cup\mathcal A_{\mathrm{jump}},&J_t=1,\\ \mathcal A_{\mathrm{local}},&J_t=0. \end{cases} \tag{16} $$
结构变化可能需要局部重调后才能显示价值,因此 jump candidate 不以即时分数裁决。若从 jump arm $a$ 出发,经过最多 $R$ 轮局部适配后的最佳实现超过跳跃前 incumbent 至少 $\delta_{\mathrm{jump}}$,才接受跳跃:
$$ \operatorname{AcceptJump}(a,t)=\mathbb I\!\left[ \max_{0\le r\le R}M\!\left(f_{t,r}^{(a)}\right)-s_t^\star>\delta_{\mathrm{jump}} \right]. \tag{17} $$
实验设置
数据集
序列推荐使用四个 Amazon Reviews 子集,每个用户和物品至少有 5 次交互,按 leave-last-out 划分:最后一条测试、倒数第二条验证、更早交互训练;每个评估样本包含 1 个正例和 99 个采样负例。
| 数据集 | 用户数 | 物品数 | 交互数 |
|---|---|---|---|
| Movies | 11,947 | 17,490 | 144,071 |
| Scientific | 23,627 | 25,764 | 266,164 |
| Electronics | 27,601 | 31,533 | 292,308 |
| CDs | 18,481 | 30,951 | 284,695 |
KuaiRec 用于 watch-time、watch-ratio 与 ranking 目标:
| 划分 | 交互数 | 用户数 | 物品数 | 平均交互/用户 |
|---|---|---|---|---|
| Train | 12,530,806 | 7,176 | 10,728 | ≈1,746 |
| Test | 4,676,570 | 1,411 | 3,327 | ≈3,314 |
模型、指标与预算
- Amazon 骨干:GRU4Rec、BERT4Rec、NextItNet、SASRec、HSTU;指标为 HR@10/20 与 NDCG@10/20,越高越好。
- KuaiRec 骨干:D2Q、TPM、GR;指标为 WT-XAUC、WR-XAUC(越高越好)及 WT-MAE、WR-MAE(越低越好)。
- 搜索阶段只看 validation;test 在搜索结束后仅评估一次。每个模型从 cold-start template 和一次 baseline trial 开始。
- 每个模型总 GPU-time 预算为 43,200 秒;消融实验固定 SASRec、四个并行试验/轮,所有结果取 3 次运行平均。
- 论文没有披露统一学习率、batch size、优化器、$W/\tau/R/\delta_{\mathrm{jump}}$ 等具体数值;这些由模型模板或补充配置决定,是复现信息的明显缺口。
主要实验结果
Amazon Reviews:五类骨干的完整结果
下列四表重排原文 Table 3;Base 为 cold-start baseline,Ours 为 RecHarness 优化结果,Paper 为 Kim et al. (2025) 的匹配报告结果。HSTU 没有 Paper 列。
Movies
| 骨干 | 版本 | NDCG@10 | NDCG@20 | HR@10 | HR@20 |
|---|---|---|---|---|---|
| GRU4Rec | Base / Ours / Paper | 0.1267 / 0.3349 / 0.3152 | 0.1570 / 0.3709 / 0.3494 | 0.2317 / 0.5179 / 0.4883 | 0.3525 / 0.6606 / 0.6245 |
| BERT4Rec | Base / Ours / Paper | 0.2585 / 0.3393 / 0.2959 | 0.2943 / 0.3734 / 0.3303 | 0.4302 / 0.5269 / 0.4785 | 0.5723 / 0.6620 / 0.6213 |
| NextItNet | Base / Ours / Paper | 0.1347 / 0.3326 / 0.2538 | 0.1661 / 0.3666 / 0.2879 | 0.2617 / 0.5168 / 0.4221 | 0.3868 / 0.6516 / 0.5522 |
| SASRec | Base / Ours / Paper | 0.3688 / 0.4023 / 0.3459 | 0.4039 / 0.4348 / 0.3745 | 0.5335 / 0.5923 / 0.5180 | 0.7034 / 0.7210 / 0.6310 |
| HSTU | Base / Ours | 0.3253 / 0.3794 | 0.3611 / 0.4121 | 0.5038 / 0.5634 | 0.6460 / 0.6932 |
Scientific
| 骨干 | 版本 | NDCG@10 | NDCG@20 | HR@10 | HR@20 |
|---|---|---|---|---|---|
| GRU4Rec | Base / Ours / Paper | 0.1663 / 0.3017 / 0.2642 | 0.1950 / 0.3377 / 0.2974 | 0.2831 / 0.4970 / 0.4313 | 0.3979 / 0.6396 / 0.5524 |
| BERT4Rec | Base / Ours / Paper | 0.2379 / 0.2880 / 0.2576 | 0.2728 / 0.3246 / 0.2913 | 0.4081 / 0.4763 / 0.4437 | 0.5471 / 0.6216 / 0.5822 |
| NextItNet | Base / Ours / Paper | 0.2179 / 0.2870 / 0.2263 | 0.2482 / 0.3243 / 0.2657 | 0.3632 / 0.4749 / 0.3908 | 0.4833 / 0.6227 / 0.5356 |
| SASRec | Base / Ours / Paper | 0.2805 / 0.3311 / 0.2918 | 0.3195 / 0.3645 / 0.3245 | 0.4701 / 0.5381 / 0.4691 | 0.6242 / 0.6700 / 0.5987 |
| HSTU | Base / Ours | 0.2804 / 0.3265 | 0.3184 / 0.3615 | 0.4690 / 0.5220 | 0.6193 / 0.6604 |
Electronics
| 骨干 | 版本 | NDCG@10 | NDCG@20 | HR@10 | HR@20 |
|---|---|---|---|---|---|
| GRU4Rec | Base / Ours / Paper | 0.1789 / 0.2442 / 0.2364 | 0.2077 / 0.2774 / 0.2743 | 0.3005 / 0.3940 / 0.3843 | 0.4148 / 0.5257 / 0.5196 |
| BERT4Rec | Base / Ours / Paper | 0.1870 / 0.2277 / 0.1867 | 0.2170 / 0.2613 / 0.2172 | 0.3186 / 0.3745 / 0.3325 | 0.4377 / 0.5081 / 0.4740 |
| NextItNet | Base / Ours / Paper | 0.2293 / 0.2441 / 0.1712 | 0.2579 / 0.2750 / 0.2069 | 0.3833 / 0.3965 / 0.3017 | 0.4967 / 0.5194 / 0.4324 |
| SASRec | Base / Ours / Paper | 0.2614 / 0.2635 / 0.2267 | 0.2981 / 0.2991 / 0.2606 | 0.4271 / 0.4336 / 0.3749 | 0.5729 / 0.5750 / 0.5096 |
| HSTU | Base / Ours | 0.2424 / 0.2682 | 0.2804 / 0.3038 | 0.4038 / 0.4335 | 0.5547 / 0.5744 |
CDs
| 骨干 | 版本 | NDCG@10 | NDCG@20 | HR@10 | HR@20 |
|---|---|---|---|---|---|
| GRU4Rec | Base / Ours / Paper | 0.1394 / 0.3764 / 0.2155 | 0.1733 / 0.4127 / 0.2530 | 0.2586 / 0.5872 / 0.3712 | 0.3936 / 0.7310 / 0.5092 |
| BERT4Rec | Base / Ours / Paper | 0.2872 / 0.3789 / 0.3019 | 0.3255 / 0.4152 / 0.3386 | 0.4693 / 0.5908 / 0.5018 | 0.6213 / 0.7345 / 0.6605 |
| NextItNet | Base / Ours / Paper | 0.1367 / 0.3768 / 0.2207 | 0.1678 / 0.4118 / 0.2562 | 0.2544 / 0.5853 / 0.3842 | 0.3781 / 0.7233 / 0.5422 |
| SASRec | Base / Ours / Paper | 0.2614 / 0.4465 / 0.3451 | 0.2981 / 0.4770 / 0.3795 | 0.5833 / 0.6593 / 0.5278 | 0.7309 / 0.7793 / 0.6635 |
| HSTU | Base / Ours | 0.3192 / 0.4046 | 0.3553 / 0.4382 | 0.5124 / 0.6080 | 0.6551 / 0.7409 |
四数据集平均 HR@10
| 骨干 | Base | Ours | Paper |
|---|---|---|---|
| GRU4Rec | 0.2685 | 0.4990 | 0.4188 |
| BERT4Rec | 0.4066 | 0.4921 | 0.4391 |
| NextItNet | 0.3156 | 0.4934 | 0.3747 |
| SASRec | 0.5035 | 0.5558 | 0.4725 |
| HSTU | 0.4723 | 0.5317 | — |
RecHarness 对弱 GRU4Rec 的平均 HR@10 提升 85.85%,对更强 HSTU 仍提升 12.58%,且所有骨干、所有数据集和四个 top-$N$ 指标都不低于其 Base。提升在 CDs、Movies 等 baseline 较弱的数据集最大,说明 harness 能充分利用较大的架构/优化余量;SASRec 在 Electronics 上只从 0.4271 到 0.4336,说明接近强 baseline 时可用 headroom 会明显收窄。
KuaiRec:跨 watch-time/ranking 目标
| 模型 | 指标 | Base | Ours(相对变化) | Paper |
|---|---|---|---|---|
| D2Q | WT-XAUC ↑ | 0.5310 | 0.5947 (+12.00%) | 0.5650 |
| D2Q | WT-MAE ↓ | 3.4129 | 3.3107 (-2.99%) | 5.4260 |
| D2Q | WR-XAUC ↑ | 0.7307 | 0.7444 (+1.87%) | 0.7120 |
| D2Q | WR-MAE ↓ | 0.3558 | 0.3451 (-3.01%) | 0.3710 |
| TPM | WT-XAUC ↑ | 0.5342 | 0.5808 (+8.72%) | 0.5710 |
| TPM | WT-MAE ↓ | 4.5372 | 3.3406 (-26.37%) | 3.4560 |
| TPM | WR-XAUC ↑ | 0.7012 | 0.7418 (+5.79%) | 0.7340 |
| TPM | WR-MAE ↓ | 0.4730 | 0.3481 (-26.41%) | 0.3610 |
| GR | WT-XAUC ↑ | 0.6161 | 0.6176 (+0.24%) | 0.6140 |
| GR | WT-MAE ↓ | 3.1901 | 3.1851 (-0.16%) | 3.1960 |
| GR | WR-XAUC ↑ | 0.7528 | 0.7535 (+0.09%) | 0.7530 |
| GR | WR-MAE ↓ | 0.3323 | 0.3319 (-0.12%) | 0.3330 |
TPM 的两个 MAE 均下降超过 26%,而强 GR 的改进仅 0.09%–0.24%(XAUC)和 0.12%–0.16%(MAE)。这与 Amazon 结果共同支持“优化空间越大,harness 收益越高”,也说明论文不是只针对单一序列推荐模板调参。
消融与搜索效率分析
SASRec 消融比较完整 RecHarness、随机选择 arm、由 LLM 直接选择 arm,以及完全移除预定义 edit dimensions 的自由搜索。所有方法使用相同 validation-driven promotion、GPU 预算和每轮四并行试验。
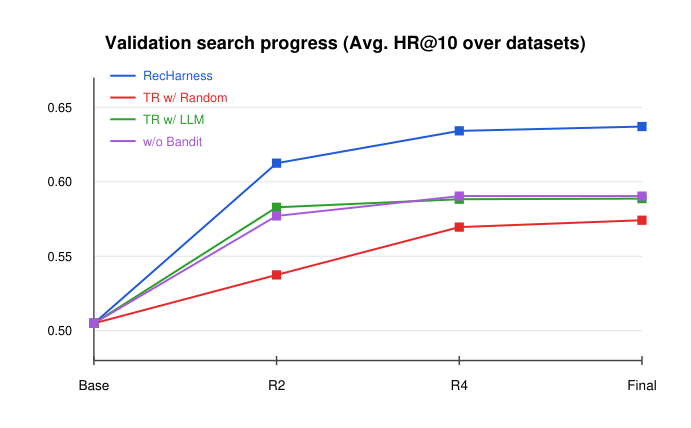
起点为 0.5050;RecHarness 在 Round 2 达到 0.6125,Round 4 达到 0.6342,明显快于其他三种策略。TR w/ LLM 优于随机路由,说明文本记忆有用,但仍不及显式 posterior;w/o Bandit 可以发现局部改进,却更容易把预算分散到低上限方向。
| 方法 | 改进试验 / 全部试验 | 改进率 | 平均增益 | 最大增益 |
|---|---|---|---|---|
| RecHarness | 23 / 48 | 47.92% | 5.06% | 24.00% |
| TR w/ Random | 11 / 49 | 22.45% | 4.94% | 16.63% |
| TR w/ LLM | 10 / 46 | 21.74% | 5.04% | 15.11% |
| w/o Bandit | 20 / 48 | 41.67% | 4.05% | 10.16% |
完整系统相对 Random/LLM arm selection 把改进命中率提高一倍以上;相对自由 LLM 搜索,命中率差距较小,但最大增益从 10.16% 提高到 24.00%。因此 Bandit 的价值不只是“少做失败试验”,还在于更可能把预算投向高上限方向;LLM 则负责在方向内部产生有效代码候选。
工业部署与在线 A/B
线上 baseline 是成熟的 shared-bottom DNN 广告排序模型,融合 user/item/combine-side 特征与 6 组实时商业行为序列。local arms 包括特征注入、融合位置和训练配置;jump arms 包括 sequence encoder 升级。局部 arm 连续无稳定收益后,系统开放 jump arm,选中 sequence_encoder_upgrade。Experiment Skill 指出既有 HSTU 模块主要处理压缩 virtual tokens,缺少原始序列内部 item-item 关系建模;LLM 因而生成“对 6 条实时行为序列分别做 self-attention,再分别用 MLP 压为 32 维,拼接成 192 维表示注入 shared-bottom ranker”的结构候选。
该候选离线生产 AUC 提升 0.09%,随后在 10% 流量上进行 7 天 A/B:
| 场景 | ADVV | Revenue | Exposure |
|---|---|---|---|
| 短视频广告 | +2.084% | +0.534% | +0.559% |
其工业价值在于:harness 没有在开放代码空间无约束搜索,而是在人给定的可审计 arm 空间内先识别局部盆地,再允许结构跳跃;最终改动明确、可部署,且离线小幅 AUC 增益成功转化为三项线上业务收益。
核心贡献总结
- 提出面向推荐模型自进化的通用 Agentic Harness,把昂贵、连续的代码级优化形式化为有限预算下的 incumbent-conditioned bandit search。
- 将方向分配与具体修改解耦:Thompson router 消化跨轮标量证据,Experiment Skill + LLM 消化日志和文本反馈,分别回答“往哪里试”和“怎么改”。
- 设计 basin-aware jump + retuning window,在局部编辑停滞后开放结构方向,并允许结构候选经局部适配后再裁决。
- 在两类任务、六个公开/工业数据集、八种骨干上展示一致收益,并通过快手短视频广告 7 天 A/B 验证可部署价值。
与已归档相关工作的对比
AgentX AgentX: Towards Agent-Driven Self-Iteration of Industrial Recommender Systems(Kuaishou,2026-06-25)
关系:显式引用但原文仅在 related work 简要提及 · 已加载对方精读
- 共同关注的问题:二者都试图把高度依赖工程师经验的推荐系统迭代变成可积累反馈、持续自我改进的 Agent 闭环,而非一次性代码生成。
- 相近的技术骨架:都把候选实现、确定性执行/验证、文本经验记忆和后续迭代连成闭环;失败结果不被丢弃,而是转成下一轮的 avoid rule 或约束。
- 本文的差异与推进:AgentX 覆盖 Brainstorm→Developing→线上 Evaluation→SGPO harness evolution 的完整 idea-to-launch 生命周期,权威奖励来自线上 A/B;RecHarness 聚焦有限离线试验预算如何分配,用 Beta posterior + Thompson Sampling 把“探索方向”从 LLM 手中分离,并加入盆地跳跃。
- 可比的方法/实验差异:AgentX 强调生产代码可靠性、guardrail、轨迹 replay 和长期 harness 自进化;RecHarness 则提供更清晰的 trial-level 搜索消融,证明显式 Bandit 路由相对随机、LLM 选臂与无 Bandit 搜索的命中率和最大增益优势。
NOVA NOVA: A Verification-Aware Agent Harness for Architecture Evolution in Industrial Recommender Systems(Tencent,2026-06-25)
关系:显式引用但原文仅在 related work 简要提及 · 已加载对方精读
- 共同关注的问题:两者都针对生产推荐架构的昂贵、离散、受约束迭代,使用历史修改、诊断和指标反馈决定下一次结构/训练代码修改。
- 相近的技术骨架:NOVA 的 architecture gradient 聚合上次修改、验证诊断、指标变化与轨迹记忆;RecHarness 的 Experiment Skill 也汇总 incumbent、成功经验、失败规则与验证趋势。二者都把候选训练结果闭环反馈到搜索控制层。
- 本文的差异与推进:NOVA 的核心是训练前 verification cascade,把“能跑但架构语义错误”的静默失败提炼为 forbidden directions,并以 L1–L4/AutoRun/Copilot 控制风险;RecHarness 的核心是可解释 edit arms 上的显式 posterior trial allocation,并用 jump-basin 处理局部饱和。前者更擅长保证候选正确,后者更直接优化预算投向。
- 可比的方法/实验差异:NOVA 报告 literature-to-production 的 60% EPR、13.5× 人工时间节省及 GMV +1.25%~+2.02%;RecHarness 报告 47.92% trial 改进率、跨八骨干离线收益及 ADVV +2.084%。两者互补:实际系统可在 RecHarness 路由后接 NOVA 式语义验证,减少昂贵训练前的假阳性。
讨论与局限性
最值得借鉴的设计是明确拆开标量与文本反馈:传统 LLM agent 容易把所有历史塞进 prompt,让同一个模型同时做探索策略、日志诊断、代码生成和结果判断;RecHarness 用一个很轻的统计状态约束搜索方向,保持 LLM 在语言与代码推理上的优势。这种“算法路由器 + Agent 生成器”组合比完全由 LLM 自主选臂更可控,也天然支持并行试验。
方法新颖性与边界。 Thompson Sampling、Beta-Bernoulli posterior、文本记忆和 incumbent search 本身都不是新算法,创新主要来自面向推荐工程试验的系统组合,以及 basin-aware jump 的产品化闭环。二元奖励把幅度信息压成成功/失败,虽然组内标准化减少尺度差异,但也可能让微小胜出与巨大提升得到相同 posterior 更新;非平稳 incumbent 又意味着 Beta 统计只是局部启发式,并非严格满足 stationary bandit 假设。
实验可信度。 论文跨五类序列骨干、三类 watch-time 模型和线上广告验证,消融直接回答“为什么不能让 LLM 自己选方向”,证据较扎实。但公开数据上的 baseline 是作者自建 cold-start template,巨大相对提升部分来自较弱起点;论文没有与 AIDE、Reasoning-as-Gradient、NOVA、AgentX 等完整 agent harness 在同一代码/预算下直接比较,也没有报告置信区间或显著性检验。关键路由/跳跃超参数、LLM 型号与 prompt、每个 arm 的完整定义、失败/无效试验成本也未充分披露。
工业可迁移性。 线上案例证明单个候选能落地,但只来自一个广告排序场景、10% 流量、7 天窗口;尚不能证明长期反复自治搜索不会产生 reward hacking、数据泄漏、guardrail 退化或累计技术债。当前 arm 空间仍由人定义,因而系统把“开放式发现新方向”的难题上移给专家;jump arm 的触发也依赖人为阈值。更稳妥的生产实现应补充 NOVA 式训练前语义验证、AgentX 式 guardrail-vetoed deployment、成本感知 reward,以及 posterior aging/contextual bandit 以应对 incumbent 变化。
综合评分为 8/10:方向选择与代码生成解耦是清晰而有用的系统 insight,消融和线上 A/B 都有说服力;但核心算法组件偏经典、与同类 Agent harness 缺少同预算直接比较,且复现与长期安全信息仍不足,因此属于扎实且工业价值明确的工作,而非已被充分验证的开创性范式。