MetaStrategy:让 LLM 生成「可执行排序策略」而不是物品序列
Taobao & Tmall Group of Alibaba(Chengyu Lai、Jiuning Lin、Zhibo Xiao、Ruiquan Lan、Bin Zhang、Zihong Huang、Wendong Zhang、Chuxin Chen、Yinjiang Cai、Dimin Wang、Jialin Zhu、Han Zhu 等,另有武汉大学、香港大学、剑桥大学合作者),投稿 KDD '27,arXiv:2608.09440,2026-08-10,正文 10 页。
一句话:现有生成式排序直接构造 item 序列,与成熟预测模型、运营规则、字段级护栏之间存在难以逾越的集成边界;MetaStrategy 改为让 LLM 以请求上下文为条件生成一份 schema 受约束的类型化 JSON 可执行策略包(目标权重 / 卡片类型偏好 / 类目偏好 / 体验约束 / 头部 CTR 开关),由确定性 validator + compiler 翻译成生产参数、挂到一个隔离的 Generator 上,在 Generator-Evaluator(GE)架构里与约十个存量 Generator 做原子竞争。训练侧用生产链路 replay 环境(重放线上日志、不曝光用户)产出三重奖励做 RL,用自竞争课程把高频策略模式冻成新竞争者防坍缩,再用 Evaluator 路由的 reward-augmented on-policy distillation 把两个 4B Teacher 压进一个 0.8B Student。淘宝首页「猜你喜欢」上线,nearline diff 触发使 LLM 推理完全离开同步排序链路、RT 无可观测增长;7 天随机 A/B 赢下 27.93% 的实验侧 GE 调用,曝光 PV +1.49%、点击 PV +2.11%、IPV +3.12%、成交额 +2.83%。
一、研究动机与背景
1.1 工业排序列表从来不是一个分数决定的
电商首页一屏里混排着商品、内容帖、短视频、直播、广告位,它们预估目标不同、运营约束不同,却在争抢同一批曝光位置。因此生产系统普遍在预测模型之上再叠一层策略层(strategy layer),协调目标权重、内容构成、类目偏好、曝光过滤、密度约束与位置专属规则。
这一层的特点是:可靠,但难以个性化。症结有两条:全局多目标公式无法表达每个请求特有的权衡;规则独立调优会忽略它们之间的交互——论文给了两个很具体的例子:一个偏点击的权重调整可能被头部位置策略直接覆盖,一个内容类型的加权可能在重排之后违反密度约束。结论是这些决策必须联合做出,并以用户上下文、当前意图、候选供给为条件。
1.2 直接生成 item 序列造成的集成边界
生成式推荐天然适合建模联合决策,已有工作把推荐表述为文本生成(P5、M6-Rec)、语义标识符生成(TIGER、OneRec)或自回归 slate 构造(Seq2Slate)。但在成熟的高流量系统里直接生成 item 序列会制造一条很难跨越的集成边界:
生成出的序列必须复现既有的过滤器、已校准的预测器、配额与安全控制,同时没有任何简单办法去检查或纠正某一条具体的业务决策。
于是本文反过来做:生成排序策略,让生产 ranker 去执行它。LLM 消费上游意图模型的实时多意图表征、用户历史统计量与有序近期行为序列,产出一份 schema 受约束的 JSON 包联合调整若干排序模块,确定性 tool 进程校验并把语义动作翻译成已有生产参数。LLM 不吐 item id,也不吐 item 排列——这个分离既保住自回归模型联合决策的表达力,又保住已部署 ranker 的控制面。
1.3 GE 架构给了非侵入接入点,但 RL 有两个挑战
MetaStrategy 运行在 Generator-Evaluator(GE)架构内:LLM 只控制一个隔离的 Generator,与约十个存量 Generator 竞争——它能改善最终决策却不必绕过既有生产边界。RL 层面有两个挑战:Evaluator 有用但不完美,直接做奖励优化会坍缩到少数极端 bundle(利用代理模型稳定的偏好规律,而非真的按请求自适应);大 LLM 是好的离线探索 Teacher,但服务预算撑不起。对应解法即自竞争课程与 Evaluator 路由的 reward-augmented OPD。
二、问题设定与形式化
2.1 工业策略组合
设 $x$ 为一次推荐请求的上下文,$I=\{i_1,\dots,i_n\}$ 为其共享候选集。用户侧上下文含三个互补视图:上游意图模型给的实时多意图表征、概括长期偏好与参与度的历史统计量、一段有序的实时行为序列(点击、加购、购买等),再与请求状态和候选供给摘要组合。本文部署里 $n$ 是数百量级,曝光列表是数十量级。一个生产排序策略是一组决策的组合而非一个标量分数,简化后的目标融合可写作:
$$q(i \mid x) = \alpha(x)\,\hat{v}_{\text{eng}}(i,x) + \beta(x)\,\hat{v}_{\text{txn}}(i,x) + \gamma(x)\,\hat{v}_{\text{com}}(i,x) \tag{1}$$
但最终列表还依赖过滤、供给混排、多样性与位置规则。论文明确划清边界:ESMM / MMoE 等多任务模型改进的是底层预测,本文聚焦协调这些预测与规则的请求级 policy。文中 CTR / CVR / GMV 分别指点击率、转化率、成交额,前缀 $p$ 表示模型预估值。
2.2 Generator-Evaluator 架构
对策略 $s_j$,Generator $G_j$ 把共享候选映射为一个有序列表:
$$L_j = G_j(I, x; s_j), \qquad |L_j| \ll |I| \tag{2}$$
Generator 可以是既有排序配方、人工策略或 LLM 生成策略。列表级 Evaluator 给出:
$$u_j = E(L_j, x), \qquad j^\star = \arg\max_{j \in \mathcal{C}} u_j, \qquad L^\star = L_{j^\star} \tag{3}$$
其中 $\mathcal{C}$ 是当前激活的 Generator 池。与 pointwise ranker 不同,$E$ 消费完整列表并带上用户、item、位置与业务上下文;其监督头覆盖 point 级点击与成交、下滑行为、列表级点击结果与 eCPM,这些头的校准组合代表比较完整列表的部署效用。论文强调 Evaluator 与 LLM 是刻意分开的:Evaluator 代表平台侧决策边界(用户价值、商业价值、体验约束),LLM policy 只在这个边界内部搜索个性化策略。
2.3 策略生成目标
设 $\mathcal{A}$ 为 schema 受约束的策略空间,$\pi_\theta(a\mid x)$ 为 LLM policy,每次生成产出一个完整 bundle $a \in \mathcal{A}$。确定性 tool 进程 $\mathcal{T}$ 把语义动作转成生产参数,参数控制一个隔离 Generator $G_{\mathcal{T}(a)}$。学习目标是:
$$\max_{\theta}\ \mathbb{E}_{x\sim\mathcal{D},\,a\sim\pi_\theta(\cdot\mid x)}\Big[E\big(G_{\mathcal{T}(a)}(I,x),\,x\big)\Big] \tag{4}$$
约束是 schema 合法性、执行约束与平台护栏。由于 bundle 内含多个互相依赖的模块,policy 自回归分解:
$$\pi_\theta(a \mid x) = \prod_{m=1}^{M} \pi_\theta(a_m \mid x, a_{<m}) \tag{5}$$
论文特意反驳了「字段域很小所以可枚举」这一直觉:联合空间指数增长,且后面的模块可以强化或覆盖前面的决策。
三、核心方法:MetaStrategy
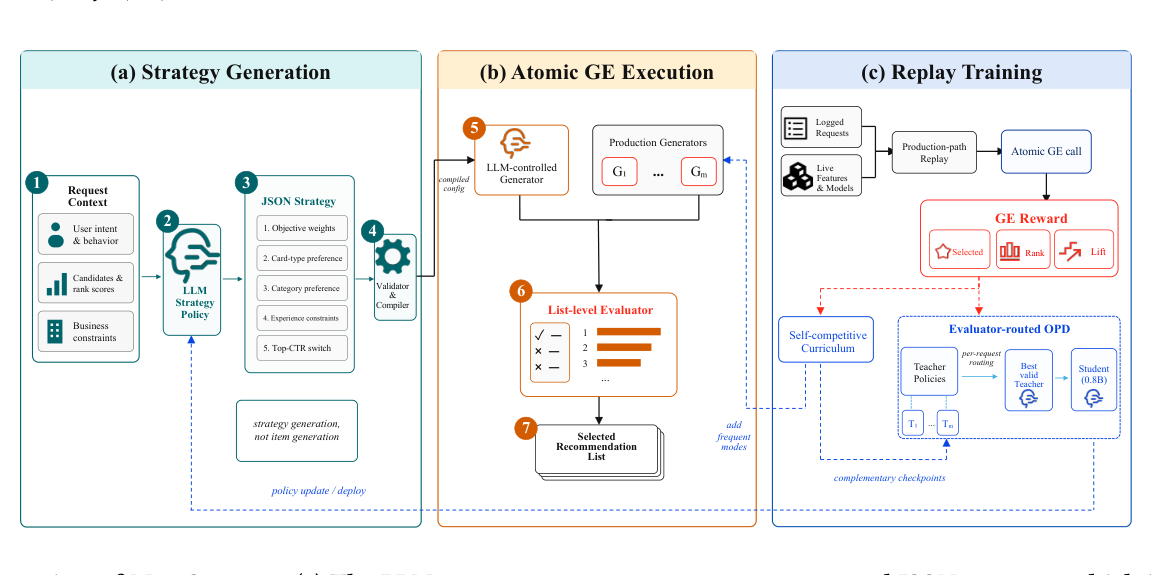
Figure 1 把执行与学习闭环画成三块:(a) 策略生成——请求上下文(用户意图与行为 / 候选与排序分 / 业务约束)经 LLM Strategy Policy 产出 5 模块 JSON、再经 Validator & Compiler 得到 compiled config,图中直接标注了 "strategy generation, not item generation";(b) 原子 GE 执行——LLM 控制的 Generator 与 $G_1 \dots G_m$ 一起被列表级 Evaluator 打分选出曝光列表;(c) replay 训练——日志请求 + 实时特征模型经生产链路 replay 走一次原子 GE 调用,产出 Selected / Rank / Lift 三种 reward,分别喂给自竞争课程与 Evaluator-routed OPD。上游分工上,意图模型给出当前多意图状态,策略 policy 额外观察历史聚合量与原始近期行为,为的是「避免重新学习意图,同时保留压缩状态里缺失的时序证据」。
3.1 可执行策略包(Executable Strategy Bundle)
policy 产出一个被固定 answer 分隔符包裹的 JSON 对象,含五个有序的可执行模块(附录 A Table 3):
Table 3:当前部署中的结构化策略空间
| 模块 | 决策与取值域 |
|---|---|
ranking_weight_boost |
CTR、IPV、CVR、GMV 四项调整;每字段取 $\{-2,-1,0,1,2\}$ |
cardtype_preference |
对竞价、广告、促销、视频、直播、专业内容的偏好;每字段取 $\{-2,-1,0,1,2\}$ |
category_preference |
对合格类目的偏好强度;每 key 取 $\{-2,-1,0,1,2\}$ |
experience_constraints |
曝光、购买、密度约束;每字段取 $\{-2,-1,0,1,2\}$ |
top_ctr_strategy |
页面专属的 top-CTR 与逆序开关;每 page group 取 $\{0,1\}$ |
论文对这套 schema 的定位说得很清楚:这是语言 policy 与生产重排系统之间的契约,刻意排除 item 标识符、自由形式代码与直接排列;序数值表达相对偏好或调整强度,不替换既有精排分、不绕过硬性约束。有界具名字段带来三重收益:决策可审查、跨模块交互被暴露、可施加字段级上限;训练 / replay / nearline / 服务共享同一份 schema 则直接降低了 training-serving skew。
3.2 校验、编译与隔离:四道确定性闸门
输出要过四道闸门:Parser(抽取 answer block 并解析 JSON)→ Schema validation(检查模块完整性、顺序、字段类型、枚举、数值范围)→ Tool process(把语义动作映射为生产参数,含 Generator 配置、多样性规则、头部位置设置)→ 隔离挂载(编译后参数只附着到指定 Generator)。
失败处理是 fail-closed 的:非法的 Student 输出拿到 format penalty 并跳过 tool 执行,格式错误的 Teacher 被移出路由集合,目的是防止「缺字段 / 空配置」变成一条捷径。配置隔离还让 replay 奖励可归因到 LLM 策略本身。
3.3 生产链路 replay 环境
这是全文最有工程分量的一节,它明确取代了一个本地实现的 user simulator。
每个 episode 由一条真实线上请求的输入日志初始化,日志保留候选集、精排分与重排所需上下文。召回与精排推理不被重放——episode 从固定候选与分数开始,通过隔离的压测流量执行生产的混排与重排链路;replay 时请求解析当前线上特征并调用当前生产模型,为每个生成列表拿一个新鲜的列表级 Evaluator 分。一次原子 GE 调用内,LLM 控制的 Generator 与约十个生产 Generator(含扰动型与上下文感知重估型变体)作用于同一请求与候选集,所有有效列表由一次 Evaluator 调用打分;超时、失败或返回非法列表者被移出比较。
隔离性上:replay 选出的列表返回训练进程但从不曝光给用户,请求不写曝光日志、归因记录或业务计数器;一个 episode 是单步上下文决策,环境不合成点击或成交、也不模拟后续状态转移,因此 Evaluator 输出只是列表的代理效用。
论文对 replay 的非确定性处理得很坦率:同一条日志请求重复执行不必产生相同结果(线上特征在 replay 时解析,生产模型会随发布变化)。因此他们避免跨调用比较绝对分数,学习信号一律基于共享一次原子 GE 调用的 Generator 之间的、成对的、请求内比较。这保住了对当前重排栈的保真度,又把优化限制在「已记录候选 + 固定精排分」的支撑集内——它不是对历史服务状态的精确重建,也不是长时程用户模拟器。
3.4 Evaluator 导出的 GE 奖励
环境每次返回所有有效 Generator 列表的分数与 Evaluator 选中的 Generator。设 $u_S$ 为 Student Generator 分数,$u_B$ 为指定基线分数,$N$ 为有效竞争列表数,$\text{rank}_S \in \{0,\dots,N-1\}$ 为 $u_S$ 的降序排名。三个互补奖励:
$$r_{\text{sel}} = \mathbb{I}[\,j^\star = S\,] \tag{6}$$
$$r_{\text{rank}} = \frac{N - 1 - \text{rank}_S}{\max(N-1,\,1)} \tag{7}$$
$$r_{\text{lift}} = \text{clip}\!\left(\frac{u_S - u_B}{\max(|u_B|,\,\epsilon)},\ -c,\ c\right) \tag{8}$$
分工很清楚:selection 与最终 GE 决策对齐但稀疏、rank 给出跨竞争者的稠密相对信号、lift 度量相对同一次调用内生产参照的连续改进量。聚合奖励:
$$r_{\text{GE}} = w_{\text{sel}}\cdot r_{\text{sel}} + w_{\text{rank}}\cdot r_{\text{rank}} + w_{\text{lift}}\cdot r_{\text{lift}} \tag{9}$$
做 group-based policy optimization 时,对同一请求采样多个 bundle 并在组内归一化奖励:
$$A^{\text{RL}}_{q,k} = \frac{r_{q,k} - \mu_q}{\sigma_q + \epsilon} \tag{10}$$
这个 advantage 送进 clipped policy 目标。这里有个关键错位:奖励依赖被执行的列表,而 policy 的动作依然是策略 bundle——两者处在不同空间,中间隔着确定性编译器与整条生产重排链路。
3.5 自竞争策略课程(Self-Competitive Strategy Curriculum)
Evaluator 是学出来的代理,可能含可被利用的规律。训练早期观察到的坍缩是:policy 反复把有界字段推到极值,或对毫不相关的请求吐出近乎一样的 bundle——这类 policy 在 replay 里分数不错,却几乎没有请求级自适应能力。课程的核心思路是把 policy 的主导行为变成它下一轮的竞争对手。在轮次 $t$,policy 针对池 $\mathcal{C}_t$ 训练:
$$\theta_t = \text{RL\_Train}(\mathcal{D},\ \mathcal{C}_t) \tag{11}$$
执行所有有效采样 bundle,并对编译后的配置计算规范签名 $z = \text{Sig}(\mathcal{T}(a))$——用编译后签名的好处是把操作上等价的 JSON 变体合并掉。令 $\mathcal{Z}_t$ 为 $k$ 个最高频签名,下一轮池子为:
$$\mathcal{C}_{t+1} = \mathcal{C}_t \cup \{\,G(z) : z \in \mathcal{Z}_t\,\} \tag{12}$$
每个 $G(z)$ 是执行对应策略的冻结 Generator。于是下一代 policy 必须超越这些已被显式化的模式,而不能靠重新发现它们来赚奖励。
补充三点:课程是跨训练作业的外层循环;它不枚举联合策略空间,也不要求在线执行多份 LLM 输出;不同轮次、种子、规模的 checkpoint 可组成互补的 Teacher 池。作者还跟踪 compiled-signature 多样性与有界动作饱和度,但这些只是诊断量,真正抬高竞争难度的是式 (12)。
3.6 Evaluator 路由的 reward-augmented OPD
蒸馏分支把一池昂贵的 policy 压进紧凑 Student。路由按请求执行,一次有效比较要求所有候选策略看到同一个 replay 状态。对请求 $x$,Student 与 $M$ 个 Teacher 各生成:
$$a_S \sim \pi_\theta(\cdot \mid x), \qquad a_i \sim \pi_i(\cdot \mid x), \quad i = 1,\dots,M \tag{13}$$
每个有效 bundle 被编译成一条隔离的 Generator 规则。Student、Teachers 与生产基线在同一次 replay 调用里提交,列表共享原始请求、候选与 Evaluator 状态。Teacher 路由排除 Student,在通过解析、schema、tool 执行与 Evaluator 打分的 Teacher 中选:
$$i^\star(x) = \arg\max_{i \in \mathcal{V}(x)} E\big(G_{\mathcal{T}(a_i)}(I,x),\ x\big) \tag{14}$$
其中 $\mathcal{V}(x)$ 是有效 Teacher 集合,平手由确定性标识符打破;若为空则请求路由到 __none__:保留 RL 奖励、屏蔽蒸馏项。OPD 在 Student 自己采样出的 token 轨迹上评估,而不是在 Teacher-forced 的目标序列上。在响应 token $\ell$ 处:
$$d_\ell(x) = \log \pi_\theta\big(a^S_\ell \mid x, a^S_{<\ell}\big) - \log \pi_{i^\star(x)}\big(a^S_\ell \mid x, a^S_{<\ell}\big) \tag{15}$$
在 Student 采样下,这个 log-ratio 估计 reverse KL 方向,即 $\mathrm{KL}(\pi_\theta \Vert \pi_{i^\star})$。作者把它直接与奖励 advantage 组合:
$$A^{\text{mix}}_\ell = A^{\text{RL}} - \lambda_{i^\star(x)}\, d_\ell(x) \tag{16}$$
并把 $A^{\text{mix}}_\ell$ 送进标准 clipped policy 目标,只有被路由中的 Teacher 贡献参考 log-prob。论文特意划清界限:这不是额外的 Teacher-forced 交叉熵损失,也不是独立的 KL 损失。
为什么必须保住 $A^{\text{RL}}$:纯模仿无法超越被路由的 Teacher,且在所有 Teacher 都弱时会传播糟糕监督。混合目标同时做到三件事——保留针对生产 GE 奖励的探索、有好 Teacher 时用最好的可比 Teacher、路由不可用时退化为纯 RL 训练。
两阶段训练流程:Teacher 构建迭代式地针对课程池训练 policy、把高频编译模式加为竞争者、保留互补 checkpoint;Student 压缩原子地评估每个 policy 的一个 bundle、路由出最好的有效 Teacher、用式 (16) 更新 Student。Teacher 池仅离线存在。
四、生产部署
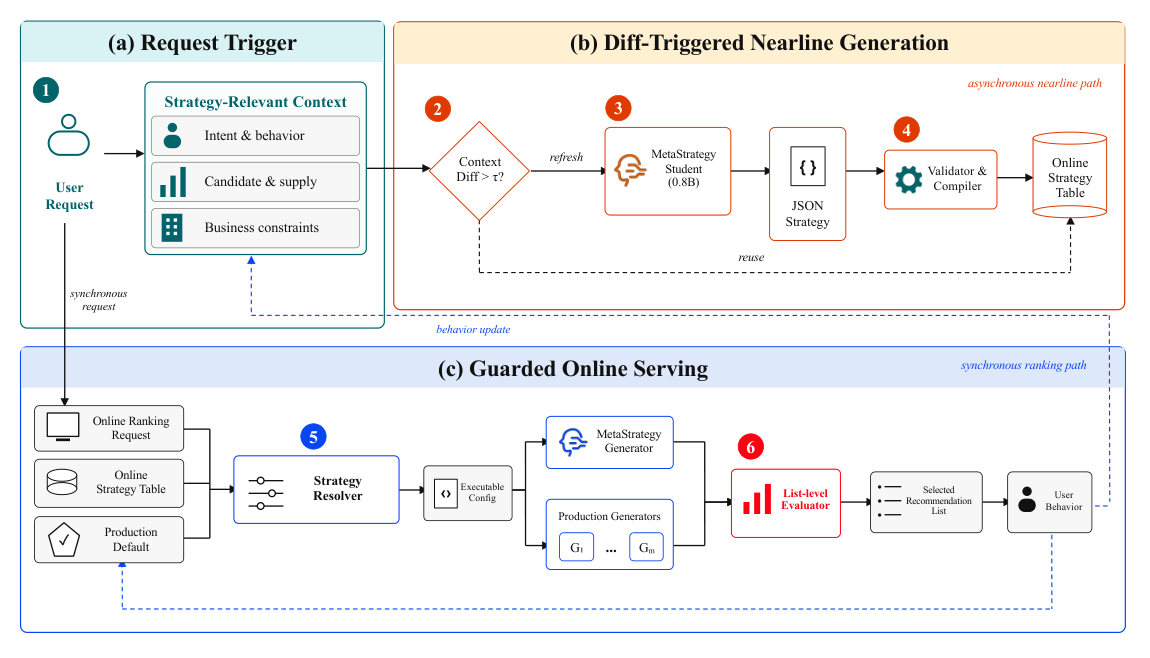
部署场景是淘宝首页「猜你喜欢」信息流。核心设计是:LLM 推理跑在异步 nearline 分支,同步链路只做策略查表与确定性解析——这种解耦带来无可观测的 RT 开销,且存量 Generator、Evaluator 与兜底行为完全不变。
Diff 触发生成。每次请求创建两条逻辑解耦路径:同步分支直奔线上 ranker;并行 nearline 分支从意图与行为、候选与供给摘要、业务约束组装策略上下文 $h_t$。令 $\bar{h}_t$ 为最新有效表项对应的上下文,nearline 服务在无有效表项或满足下式时调用 0.8B Student:
$$\Delta(h_t,\ \bar{h}_t) > \tau \tag{24}$$
其中 $\Delta$ 度量策略输入上的 feature-aware 变化,否则复用当前表项。刷新时 validator 与 compiler 先强制 schema 与字段级边界再翻译成可执行参数,只有合法配置才被发布;一次失败的刷新不会替换最新有效表项,无可用表项时同步服务选生产默认值。
受护栏保护的 GE 服务。同步链路不做任何 LLM 推理:确定性 resolver 读取最新有效表项或生产默认值并检查有效性,返回一份可执行配置(有效的个性化表项优先,无效 / 缺失 / 过期取默认)。配置只被附着到 MetaStrategy Generator,其列表与未改动的生产 Generator 在存量 Evaluator 下竞争,只有赢下原子 GE 比较时才被曝光。时间解耦、发布前校验、确定性兜底与结构隔离共同保住在线 RT,并支持灰度放量、请求级归因与即时回滚。
五、实验设置
评测围绕四问:RQ1 可执行策略生成能否在存量 Generator 之外带来增量价值?RQ2 模型规模与逐级训练阶段如何影响可执行性、策略集中度与 GE 贡献?RQ3 路由 OPD 能否把 4B 压成有竞争力的 0.8B Student?RQ4 线上部署的用户与平台结果如何?
工业 replay 数据集:从淘宝首页猜你喜欢采集连续 8 天线上请求日志,每天随机采样 8,192 条、合计 65,536 条;第 1–6 天训练(49,152)、第 7 天验证(8,192)、第 8 天测试(8,192)。测试期反馈被排除在 RL、课程构建、OPD、prompt 选择与超参调优之外。
Replay 协议:生产行在未改动的存量池 $\mathcal{P}$ 里度量,每个 LLM Generator $G_j$ 单独加进同一池子;所有方法用相同的日志请求与 pin 住的生产模型 / Evaluator 版本,调用在同一 replay 窗口内交错执行以平衡线上特征查询的时序波动。策略当且仅当通过解析与编译并返回可执行列表时才算 valid,没有有效列表的请求对该方法的 selection rate 与 ΔGE 贡献 0。
生产 Generator 基线:Base G 贪心地在每个位置填入剩余卡片里生产 rank 分最高的一张(满足共用的硬过滤、位置、密度与多样性约束),是相对提升的参照方法;GNR G 是序贯上下文感知 Generator,每个位置条件于已放置卡片对剩余候选重估点击倾向;NAR G 并行预测位置专属分数并用非自回归列表构造器;Single-objective perturbation G 从 Base G 打分公式出发扰动某一个业务目标。
LLM Generator 变体:Prompt-only(共用 prompt / schema / 校验 / 编译器但不做参数更新,评估 0.8B 与 4B);RL(针对原始生产池优化式 (9),不回灌高频策略);Curriculum RL(对 4B 施加自竞争课程);Routed reward-augmented OPD(把两个 4B checkpoint 蒸进 0.8B Student)。
5.1 形式化评测指标
设 $L^j_q$ 为 Generator $G_j$ 在请求 $q$ 上产出的长度为 $K_q$ 的列表,$\mathcal{V}_j$ 为它返回有效列表的请求集合。对目标 $m \in \{\text{CTR},\text{CVR},\text{IPV},\text{GMV}\}$,pointwise 列表诊断量先在列表内、再在有效请求上做平均:
$$S_m(G_j) = \frac{1}{|\mathcal{V}_j|}\sum_{q\in\mathcal{V}_j}\frac{1}{K_q}\sum_{i\in L^j_q} s_m(i, x_q) \tag{17}$$
设 $\mathcal{C}_{q,j}$ 为第 $j$ 行原子调用里的有效 Generator 集合、$\mathcal{P}$ 为存量池,按生产 tie-breaking 规则:
$$j^\star_q = \text{TieBreakArgMax}_{g \in \mathcal{C}_{q,j}}\ E(L^g_q, x_q) \tag{18}$$
同一次调用内定义:
$$u_{q,j} = E(L^j_q, x_q), \qquad u^{\mathcal{P}}_q = \max_{g\in\mathcal{P}} E(L^g_q, x_q) \tag{19}$$
以 $u_{q,B}$ 记同一次调用的 Base G 分数,Evaluator lift 为:
$$\Delta\text{Eval}(G_j) = \frac{1}{|\mathcal{V}_j|}\sum_{q\in\mathcal{V}_j}\frac{u_{q,j} - u_{q,B}}{\max(|u_{q,B}|,\ \epsilon)} \tag{20}$$
汇报 validity $|\mathcal{V}_j|/N$ 与 selection rate:
$$\text{SR}(G_j) = \frac{1}{N}\sum_{q=1}^{N}\mathbb{I}[q\in\mathcal{V}_j]\,\mathbb{I}[j^\star_q = j] \tag{21}$$
beat-Base rate 把存量参照换成 $u_{q,B}$。对首要离线端点,令非法输出的 $\tilde{u}_{q,j} = -\infty$、否则 $\tilde{u}_{q,j} = u_{q,j}$,增量 GE lift 为:
$$\Delta\text{GE}(G_j) = \frac{1}{N}\sum_{q=1}^{N}\frac{\max(u^{\mathcal{P}}_q,\ \tilde{u}_{q,j}) - u^{\mathcal{P}}_q}{\max(|u^{\mathcal{P}}_q|,\ \epsilon)} \tag{22}$$
这个定义值得多看一眼:它衡量把一个 Generator 加进存量池的边际效用——分数低于池内最优则贡献为零,只有真正赢过整个存量池时才有正贡献,比「单独看列表质量」严格得多。
最后,对任一策略模块 $h$,令 $z^{(h)}_{q,j}$ 为 $G_j$ 在请求 $q$ 上的编译后决策,其集中度为:
$$F_{\text{top1}}(G_j; h) = \max_{z}\ \frac{1}{|\mathcal{V}_j|}\sum_{q\in\mathcal{V}_j}\mathbb{I}\big[z^{(h)}_{q,j} = z\big] \tag{23}$$
值越低表示对模块 $h$ 的动作空间使用得越广。所有比较按请求配对。
六、主要实验结果
Table 1:淘宝首页猜你喜欢上的生产链路 replay。Pointwise 与 Evaluator 列为相对 Base G 的变化;「–」表示该指标不适用。
| 方法 | ΔpCTR ↑ | ΔpCVR ↑ | ΔpIPV ↑ | ΔpGMV ↑ | ΔEvaluator ↑ | Valid ↑ | Selected ↑ | ΔGE ↑ | Beat Base ↑ |
|---|---|---|---|---|---|---|---|---|---|
| 生产排序 Generator | |||||||||
| Base G | – | – | – | – | – | – | 6.97% | – | – |
| GNR G | -2.43% | +2.08% | -2.75% | +14.04% | +1.68% | – | 6.09% | – | 37.4% |
| NAR (non-autoregressive) G | +1.64% | +15.24% | +6.46% | +17.03% | +2.75% | – | 13.7% | – | 63.4% |
| Single-objective perturbation G | +13.82% | -4.01% | +11.81% | +1.05% | +1.21% | – | 4.94% | – | 50.1% |
| LLM 策略 Generator | |||||||||
| Prompt-only (0.8B) | -2.82% | +8.17% | +0.13% | +12.65% | -0.29% | 4.39% | 0.39% | +0.02% | 1.8% |
| Prompt-only (4B) | -3.41% | +13.67% | -0.41% | +13.81% | +0.42% | 80.86% | 7.87% | +0.34% | 35.69% |
| RL (0.8B) | -0.48% | +10.10% | +2.51% | +13.58% | +1.05% | 97.12% | 8.56% | +0.38% | 46.88% |
| RL (4B) | -1.07% | +12.54% | +0.96% | +14.23% | +1.58% | 98.85% | 7.93% | +0.45% | 45.86% |
| Curriculum RL (4B) | -5.70% | +18.47% | -2.95% | +18.88% | +0.56% | 98.89% | 11.27% | +0.57% | 45.65% |
| Routed reward-augmented OPD (0.8B) | -0.68% | +22.69% | +1.65% | +37.76% | +2.53% | 98.03% | 16.24% | +0.73% | 62.60% |
6.1 生产基线之间的对比揭示了什么
NAR 是最强的存量 Generator(Evaluator lift +2.75%、selection 13.70%、beat-Base 63.40%);GNR 拿到 +1.68% Evaluator lift,却只在 6.09% 的调用上被选中;单目标扰动产出最大的 pCTR 与 pIPV 增益(13.82% 与 11.81%),却只有 +1.21% Evaluator lift 和 4.94% selection。论文由此提炼的结论非常锋利:改进一个孤立的预测器,并不保证在平台目标下得到一个更好的异质列表——这正是本文做策略层联合决策而非单目标调优的实证依据。
6.2 规模与 replay RL 的分工
把 prompt-only 从 0.8B 放大到 4B,validity 从 4.39% → 80.86%、selection 从 0.39% → 7.87%、ΔGE 从 +0.02% → +0.34%——规模主要改进的是「吐出可执行策略」的能力,0.8B 未经训练时几乎写不出合法的五模块 JSON。而 replay RL 让 0.8B 达到 97.12% 有效、selection 与 ΔGE 抬到 8.56% 与 +0.38%,在两个 GE 指标上略微超过 prompt-only 的 4B;4B 上 RL 进一步把 Evaluator lift 抬到 1.58%、ΔGE 抬到 +0.45%,但 selection 停在 7.93%。
结论因此是二分的:规模帮助的是可行性(feasibility),被执行列表的奖励提供的才是 GE 贡献所需的对齐(alignment)——「换更大的模型」和「用生产反馈训练」解决的是两个不同问题,不可互相替代。
6.3 课程与路由 OPD
匹配 4B 规模上相对直接 RL:Curriculum RL 保持 validity 不变(98.85% vs 98.89%),却把 selection 从 7.93% 抬到 11.27%、ΔGE 从 +0.45% 抬到 +0.57%。它的 pCTR 与 pIPV 下降而 pCVR 与 pGMV 上升——论文指出这说明课程优化的是联合列表效用,而非同时在所有 pointwise 指标上占优;只看 pCTR 会误判它变差。
路由 0.8B Student 有效率 98.03%,拿到最高的 selection(16.24%)与增量 lift(+0.73%),Evaluator lift(2.53%)与 beat-Base(62.60%)排第二,两个 GE 贡献指标同时超过两个 4B 变体。作者专门解释了一处看似矛盾之处:NAR 的独立 Evaluator lift 略高(2.75% vs 2.53%),但 Student 领先的 ΔGE 说明它对存量池有更大的边际互补性——Student 赢的不是「单独看列表更好」,而是「它在存量池已经不行的那些请求上行」,这正是式 (22) 的设计用意。
七、消融:策略坍缩缓解
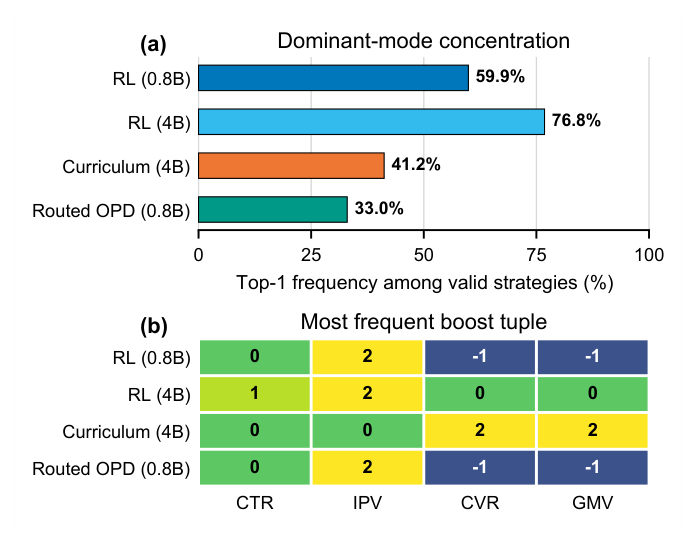
以 ranking_weight_boost 为代表策略做消融:它给 CTR、IPV、CVR、GMV 各赋一个 $\{-2,-1,0,1,2\}$ 的值,共 625 个完整元组。Figure 3 用式 (23) 度量有效输出中的集中度,并结合 Table 1 的 validity 与 GE 效用一起解读,这样低频率就不能被归因为执行失败。
Figure 3 数据整理
| 方法 | Top-1 完整元组频率 | 主导元组 (CTR, IPV, CVR, GMV) |
|---|---|---|
| RL (0.8B) | 59.9% | (0, 2, −1, −1) |
| RL (4B) | 76.8% | (1, 2, 0, 0) |
| Curriculum (4B) | 41.2% | (0, 0, 2, 2) |
| Routed OPD (0.8B) | 33.0% | (0, 2, −1, −1) |
规模对照:直接 RL 把 0.8B 输出的 59.9% 集中在 $(0,2,-1,-1)$、把 4B 输出的 76.8% 集中在 $(1,2,0,0)$——单靠增加容量并不能在同一个 Evaluator 导出的奖励下阻止坍缩,反而 4B 坍缩得更厉害。这是全文最反直觉也最有说服力的观察:更大的模型更善于找到代理奖励的漏洞。
课程消融:4B 上课程把 Top-1 频率从 76.8% 降到 41.2%,validity 基本不变(98.85% vs 98.89%),selection 从 7.93% 升到 11.27%、ΔGE 从 +0.45% 升到 +0.57%——在不牺牲 GE 贡献的前提下拿到了更广的请求条件化选择。路由 OPD 消融:0.8B 上 Top-1 频率从 59.9% 降到 33.0%,validity 从 97.12% 升到 98.03%、selection 从 8.56% 升到 16.24%、ΔGE 从 +0.38% 升到 +0.73%。两组同规模配对消融共同证明课程竞争与路由 OPD 都在缓解坍缩的同时改进了列表级效用;值得一提的是路由 OPD 的主导元组与 RL (0.8B) 相同但频率大跌——说明 Student 学到的不是「换一个偏好」,而是「在更多请求上偏离这个默认偏好」。
八、线上 A/B 实验
Table 2:7 天线上 A/B 测试(加粗值为统计显著)
| 曝光 PV ↑ | 点击 PV ↑ | IPV ↑ | 成交笔数 ↑ | 成交额 ↑ | 广告消耗 ↑ |
|---|---|---|---|---|---|
| +1.49% | +2.11% | +3.12% | −0.24% | +2.83% | +0.87% |
实验于 2026 年 7 月进行。用户按确定性 hash 分到稳定的对照与实验桶,每桶占生产服务 1% 流量、含数百万用户,先行 A/A 测试未发现实质不平衡。广告消耗指广告支出,是正向的平台商业价值指标。对照保留存量 GE 池,实验组只加入最终的路由 OPD 0.8B Generator,其余排序组件与准入规则全部固定。
平台标准流程判定曝光 PV、点击 PV、IPV 与成交额的增益显著;成交笔数(−0.24%)与广告消耗(+0.87%)不显著。论文没有解释成交笔数微降与成交额 +2.83% 的组合,但从数据看这意味着客单价上升——策略把流量导向了更高价值的成交而非更多笔数。部署后 MetaStrategy 每日服务数亿用户。另一个容易被忽略的关键数字是 27.93% 的 GE 胜率,远高于离线 replay 的 16.24% selection rate(两者口径不同),足以说明这个 Generator 在生产环境里承担了接近三成的最终列表决定权。
九、核心贡献总结
- 把生成式排序重述为「请求条件化的可执行联合策略生成」——类型化 action schema 加确定性编译器让 LLM 同时控制多个生产排序模块,同时保住校验、隔离与兜底。立意即:动作空间从 item 排列换成了配置空间。
- 生产链路 replay 环境:一次对当前重排栈的调用里比较存量与 LLM 控制的 Generator,三个信号提供请求级反馈而不把流量曝光给用户,明确取代了本地 user simulator。
- 自竞争课程 + Evaluator 路由的 reward-augmented OPD:前者把高频编译策略变成显式竞争者,后者在压缩互补 Teacher 的同时保留直接的 GE 优化。
- 非侵入式服务架构落地淘宝首页猜你喜欢:nearline LLM 推理不增加在线 RT,隔离 Generator 保住存量排序与兜底路径。
十、与已归档相关工作的对比
Hypothesis-Driven Shelf Generation for Personalised Recommendation Hypothesis-Driven Shelf Generation(Spotify,2026-07-28)
关系:独立并发(本文未引用 Spotify 这篇,两者殊途同归)· 已加载对方精读
- 共同关注的问题:同一个 root cause——生产系统里那层「手工设计的有限模板 / 规则集合」无法覆盖个体口味与请求特异性的长尾。Spotify 指的是 Home 货架模板把「什么需求 / 什么内容算有效实现 / 用哪个系统填充」三个决策耦合死了,MetaStrategy 指的是策略层全局公式与位置 / 密度规则互相覆盖。
- 相近的技术骨架:LLM 不直接产 item,而产一个结构化中间契约交给既有系统执行,执行结果再作为候选回到既有排序里竞争。Spotify 的中间物是「货架假设」(原话即 "a compact contract between planning and fulfilment",形式化为 $h = (q, c, f, r, t_0, d_0)$),MetaStrategy 的是五模块 typed JSON。服务架构几乎同构:离线 / nearline 批量生成 → 校验 → 写表 → 同步链路只查表 → 生成物作为候选竞争而非钉死固定位,都以「不增加在线延迟」为硬约束,也都做了「前沿大模型探索 → 蒸馏进小模型上生产」。
- 本文的差异与推进:中间契约的类型不同,闭环质量也不同。Spotify 的契约是自由文本假设,履行靠 SemID 受约束生成式检索,评测只能靠 LLM-as-a-Judge 加均匀随机曝光,全文无损失函数;MetaStrategy 的契约是枚举域有限的 typed JSON,可做 schema 校验、字段级上限、编译后签名去重,更关键的是能被既有列表级 Evaluator 打分,从而闭合成可优化的 RL 回路。
- 可比的实验差异:Spotify 线上结果有正有负(专辑 +36%、单集 +2%,但歌单 −14%、播客节目 −41%);MetaStrategy 的生成物必须赢下原子 GE 比较才曝光,天然不存在「强行占位导致体验下降」的风险——这是 GE 隔离接入相对「注入候选行」的结构性优势。
FGPD FGPD: From Understanding to Action(Kuaishou,2026-07-30)
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都主张「策略 / 决策规则」应成为被显式建模、被结果验证的一等变量,而非隐含在 item 级监督或全局公式里。FGPD 把这个缺口命名为 Understanding–Action Gap:理解用户想要什么(intent)不等于知道该怎么推(policy),现有 LLM-enhanced 推荐器多半只补前者。MetaStrategy 结构上完全平行:上游意图模型已给出实时多意图状态,缺的正是「据此该如何配置排序」这一层 action。
- 相近的技术骨架:LLM 生成候选策略 → 在受控执行环境里按结果评估其相对基线的增量 → 只保留有正增益的 → 蒸馏进轻量模型做低成本在线服务。FGPD 的 policy agent 生成 $K$ 条假设,由 executor 算出相对 intent-only baseline 的 advantage,feedback agent 群体反思迭代;MetaStrategy 采样多个 bundle,由 replay 算出相对 Base G / 存量池的 lift 与 rank。两者都拒绝「语言上合理即可」,收尾也一致:FGPD 蒸进 Intent/Policy 两个隐 token 做到线上零 LLM 调用,MetaStrategy 路由 OPD 进 0.8B Student、同步链路零 LLM 推理。
- 本文的差异与推进:策略的载体与可执行性是分水岭。FGPD 的 policy 是自然语言决策规则(推荐方向 + 拒绝边界),只能以 latent token 影响 SID 生成,动作空间仍是 item;MetaStrategy 的策略直接编译成生产排序参数,动作空间就是配置本身,天然具备可审查性与即时回滚。防坍缩上 FGPD 靠「必须优于 intent-only baseline」这道门槛过滤,MetaStrategy 则把自己的高频模式冻成竞争对手,是更强的递归机制。
- 可比的实验差异:FGPD 在三个 Amazon 公开数据集上有 +19.8%~+39.6% Recall@10 的可比数字,线上快手本地生活广告 7 天 A/B 拿到 Revenue +4.506% / ADVV +4.621%;MetaStrategy 完全没有公开数据集实验——这是可复现性短板,也是「策略必须由真实生产链路执行」这一设定的必然代价。
GR2 GR2 Technical Report(Meta AI,2026-06-30)
关系:独立并发(本文未引用 GR2,OPD 只引 Agarwal et al. 2024)· 已加载对方精读
- 共同关注的问题:两篇都在攻工业重排引入 LLM 的三重税——推理 / 决策能力被闲置、代理奖励极易被 hack、serving 成本撑不住大模型。GR2 列成 G1/G2/G3;MetaStrategy 的表述是「Evaluator 有用但不完美,直接奖励优化会坍缩」与「大 LLM 是好 Teacher 但太贵」。root cause 判断一致:在工业重排里,奖励设计与服务成本是比模型能力更硬的约束。
- 相近的技术骨架:三处逐条对应。(a) 用 on-policy distillation 而非 SFT 把大 Teacher 压进可服务 Student:GR2 指出 naive SFT 在工业规模会崩溃,其 OPD 让 student 从自身分布采样、teacher 只贡献 token log-prob 作逐 token reverse-KL anchor;MetaStrategy 的式 (15) 同样在 Student 自采样的 token 轨迹上算 log-ratio、同样估计 reverse KL、同样强调「不是 Teacher-forced 交叉熵也不是独立 KL 损失」。(b) 在 OPD 之上保留 RL 奖励:两者的 KL 都只作 anchor,MetaStrategy 的式 (16) 更是把蒸馏项减进 advantage 而非另加损失。(c) 显式的反 reward-hacking 机制:GR2 识别出 identity-permutation cheating 与位置偏置利用并用 conditional verifiable reward 把 $R_{\text{rank}}$ gate 住;MetaStrategy 识别出「有界字段推极值 / 对无关请求吐同一 bundle」,用自竞争课程把高频模式变成竞争者。
- 本文的差异与推进:Teacher 路由是 MetaStrategy 独有的一步。GR2 用单个 frozen teacher 作 anchor;MetaStrategy 有 Teacher 池,在每个请求上用共享 Evaluator 调用原子地比较所有 Teacher(式 (14)),只让当次最好的有效 Teacher 提供参考 log-prob,无有效 Teacher 时路由到
__none__屏蔽蒸馏项、保留 RL 奖励——等于给蒸馏加了一层按请求的质量门控。另一差异是动作空间:GR2 的动作仍是 slate permutation(奖励可以是 per-impression AUC / NDCG),MetaStrategy 的奖励必须绕经真实生产链路后由 Evaluator 给出。 - 可比的实验差异:GR2 的 OPD student 在 5% 参数量下恢复 32B teacher 约 82% 的增益;MetaStrategy 的 0.8B Student 恢复得更彻底——两个 GE 贡献指标上超过了两个 4B 训练变体(ΔGE 0.73% vs 0.57%/0.45%)。这个「学生打败老师」的现象,论文归因于混合 advantage 里保留的 GE 奖励让 Student 能在 Teacher 之外继续探索。
十一、讨论与局限性
核心贡献的价值判断。最值得借鉴的是一个定位判断:在成熟的高流量系统里,生成式模型的收益不必来自「替换掉排序」,也可以来自「配置排序」。这一次性化解了三个工程难题——不必复现过滤器与配额、不必重建校准预测器、不必自建安全控制,因为它们全都还在原地,只是被一份可审查的 JSON 调了参数。配合 GE 原子竞争,接入是纯增量的:赢了才曝光,输了什么也没发生。
三个值得借鉴的具体设计:(1) 式 (22) 的 ΔGE 指标——衡量的不是「我的列表好不好」而是「把我加进现有池子的边际效用」,NAR 独立 lift 更高但 ΔGE 更低正是其价值证明;(2) 用编译后签名而非 JSON 文本做去重;(3) fail-closed 的四道闸门,防止模型把「什么都不做」学成捷径。
局限与争议(附录 C 自陈了大部分,态度相当坦率):
- 优化的是学出来的 Evaluator,而非线上价值本身。自竞争抬高了利用高频模式的成本,却无法消除 Evaluator 的错误设定;Evaluator 与生产模型还会随发布变化,原子 replay 只保证请求内可比。
- replay 固定了候选集与精排分,因此无法评估任何需要不同召回候选或不同上游精排预估的收益,也不模拟点击与后续状态转移;结果只是日志请求支撑集内的列表级代理效用。
- typed action schema 把策略限制在生产 ranker 暴露的机制上,改善了可审计性与回滚能力,但可能排除掉有用的策略——schema 的表达力上限即方法的能力上限。
- 无公开数据集、无开源、无可复现基线。Base G / GNR G / NAR G 都是内部生产 Generator,削弱了方法层面的可比性。
- 方法论可扩展性的隐忧。策略空间是人工定义的五个模块,扩参数量不会自动扩表征能力——Table 1 已显示 4B 相比 0.8B 在 GE 指标上优势有限(RL 4B 的 ΔGE 0.45% vs OPD 0.8B 的 0.73%)。要继续 scaling 必须同步扩充 action schema,而这需要匹配的 compiler 更新与生产侧改造,是一条人工介入、非自动的扩展路径。
- 成交笔数 −0.24% 未被讨论,也没做分人群分析——考虑到策略可调
cardtype_preference与category_preference,商业曝光与内容构成的结构性漂移风险是真实的;附录 C 自己也承认部署需要字段级上限、兜底行为、灰度放量、分群分析与持续的体验监控。
工业落地价值:部署细节交代得相当完整——nearline diff 触发(式 (24))、发布前校验、失败刷新不覆盖最新有效表项、确定性 resolver、隔离 Generator、赢下原子 GE 才曝光、即时回滚,对同类电商首页混排场景可直接照搬。