From Understanding to Action:用结果反馈发现推荐策略,再蒸馏成两个隐 token¶
一句话:SID 生成式推荐里,"理解用户想要什么"(intent)和"决定该怎么推"(policy)被压在同一个 item-level 目标里;LLM 只能补前者,而且它"语言上合理"的推理未必对推荐决策有用。本文把这个错配命名为 Understanding–Action Gap,提出一个双 agent 框架:policy agent 从历史转移里生成 K 条候选决策规则,受控执行器算出每条规则相对 intent-only baseline 的增量优势(advantage),feedback agent 做群体反思迭代进化;最后把 intent / policy 两个 LLM teacher 表征通过一阶 + 高阶双空间关系蒸馏灌进轻量 SID 生成器的两个隐 token,线上不调用任何 LLM。快手本地生活广告 7 天 A/B:Revenue +4.506%、ADVV +4.621%。
作者:Zhi Chen(华中农业大学,快手实习期间完成)*†、Minmao Wang(复旦大学)†、Xingchen Liu(快手)、Haoqiang Liang(快手)、Huihuang Lin(快手)、Likang Wu(天津大学)‡、Hongke Zhao(天津大学)、Yulong Wang(华中农业大学)、Shijie Yi(快手)‡、Fei Pan(快手)、Peng Jiang(快手) (* 快手实习期间完成;† 共同一作;‡ 通讯作者)
ArXiv:2607.27789 · 2026-07-30 · cs.IR
关于命名:论文没有给自己的框架起名字(表格里一律写 TIGER + Ours / LETTER + Ours)。为便于归档检索与 DAG 对齐,本库按论文标题取简称 FGPD(Feedback-Grounded Policy Discovery);这不是论文原文用词。
1. 研究动机与背景¶
1.1 SID 生成式推荐的结构性缺口¶
生成式推荐把 item 预测重述为序列生成,为召回 + 排序提供了统一替代。其中 Semantic-ID(SID) 路线是主流:每个 item 被编码成一小段离散语义 token,推荐被表述为条件序列生成。这提供了一个紧凑、结构化的输出空间,兼顾表达力与推理效率。
但论文指出,现有 SID 推荐器主要仍由 item-level 的行为监督训练,捕捉的是行为共现(behavioral co-occurrence)与局部转移(local transition)。即使把文本、协同、多模态语义注入 item tokenization(如 LETTER、LIGER),训练目标本身并没有把"需求理解"与"推荐决策"显式分开。当交互稀疏、兴趣快速演化、或未来需求根本无法从局部模式推断时,这个局限尤为明显。
1.2 LLM 补上了"理解",但没补上"行动"¶
LLM 的世界知识与语义推理能力,天然能连接异构交互、识别 item 之间的功能关系、推断行为背后的任务(task)。论文用 Figure 1 的例子说明:一个包含网球拍、网球、球场鞋的序列,直观表明用户在组装一整套网球装备,而不是在表达三个孤立偏好。这种任务级理解给出了对交互历史的连贯解释,并识别出与下一次推荐相关的语义区域(semantic region),从而支持一个"看起来合理"的 next-item 预测。
但理解用户当前在找什么,并不必然揭示哪个候选最适合这个用户。
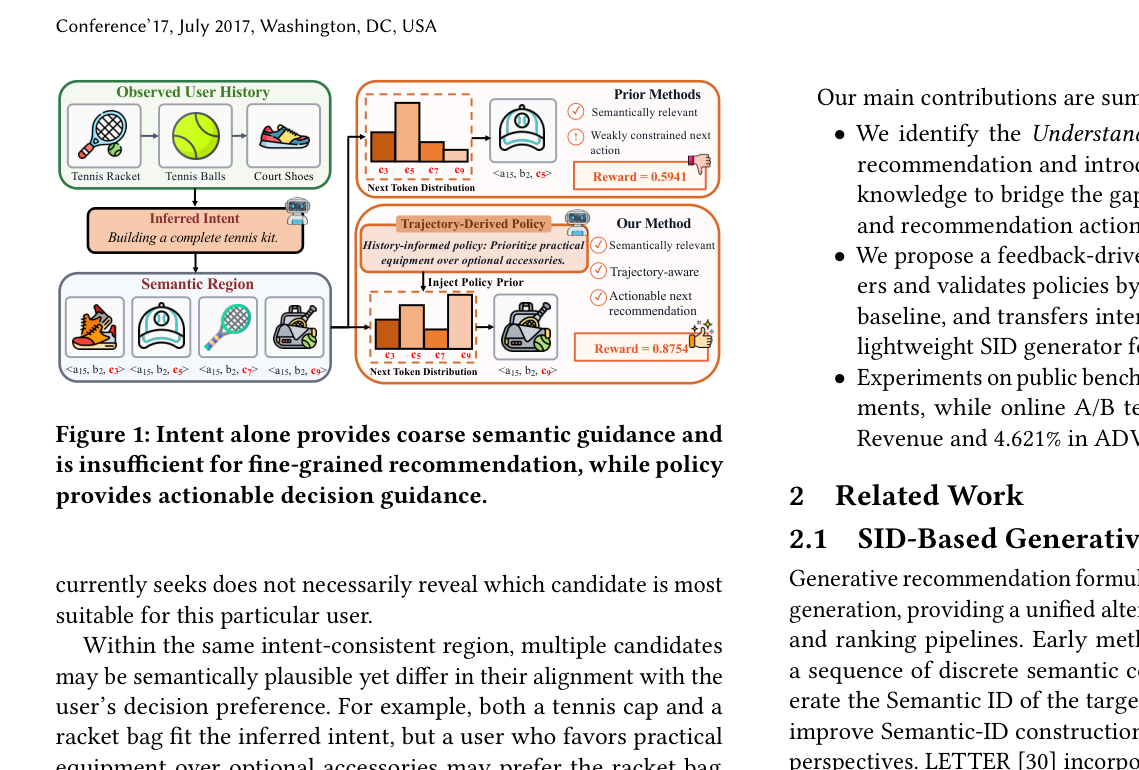
在同一个 intent-consistent 区域内,多个候选可能都语义合理,却在与用户决策偏好的对齐程度上有差别。论文举的例子极其贴切:网球帽和拍包都符合"组装网球装备"这个 intent,但偏好实用装备胜过可选配件的用户会更喜欢拍包。Figure 1 里,只有 intent 的 prior method 推出的是帽子(reward 0.5941),注入 policy prior 之后推出的是拍包(reward 0.8754)。
1.3 两类互补知识:intent knowledge vs policy knowledge¶
这促使作者区分两种知识:
- 意图知识(intent knowledge):识别用户当前在寻求什么,约束相关的语义区域;
- 策略知识(policy knowledge):在 intent-consistent 的候选之间指导选择,由推荐方向(recommendation direction)与拒绝边界(rejection boundary)共同刻画。
关键的方法论主张是:从轨迹里导出的偏好,默认只是一条"候选策略"(candidate policy);只有当它相对一个 intent-only baseline 产生可验证的正增益时,才被保留为 policy knowledge。
现有 LLM-enhanced 推荐器主要导出用户画像、语义偏好或推理信号,很少把任务理解与 outcome-grounded 的行动选择区分开。论文把这个错配命名为生成式推荐中的 Understanding–Action Gap(理解—行动鸿沟)。
1.4 为什么要蒸馏¶
LLM 提供了丰富的 intent 与 policy 知识,但在线部署时的 serving 成本挡住了直接使用。因此本文只把 LLM 当作离线 teacher,在轻量 SID 生成器里引入一个 Intent Token 和一个 Policy Token,其上下文化状态构成一条有序的隐式推荐链(latent recommendation chain)。
由于语言导向的 teacher 与行为导向的 student 处在不同表征空间,作者不做直接 embedding 匹配,而是迁移关系结构(relational structure):双空间关系蒸馏(dual-space relational distillation)同时对齐 intent 空间与 policy 空间中的一阶用户关系与高阶邻域结构。最终模型直接从交互历史推断隐 intent / policy 状态并生成目标 SID,在线不做任何 LLM 推理。
1.5 三条贡献¶
- 识别生成式推荐中的 Understanding–Action Gap,并引入 policy knowledge 来弥合 intent 理解与推荐动作之间的鸿沟;
- 提出反馈驱动的 agent 框架,用"相对 intent-only baseline 的增益"来发现并验证策略,并把 intent + policy 知识迁移进轻量 SID 生成器,实现 LLM-free 在线服务;
- 公开 benchmark 上一致提升,在线 A/B 取得 Revenue +4.506%、ADVV +4.621%。
2. 相关工作¶
2.1 SID-Based Generative Recommendation¶
早期方法(TIGER)用一段离散语义码表示 item,自回归生成目标 item 的 Semantic ID。后续工作从不同角度改进 SID 构造与生成:LETTER 把语义信息、协同信号、code-assignment 正则一并塞进 item tokenization;LIGER 结合生成式检索与稠密检索提升鲁棒性。更近的工作探索端到端生成架构、更长 / 并行的 SID 生成、以及 recommendation-aware 的 item tokenization。
尽管如此,已有方法主要仍由最终 target SID 监督,主要学的是"从用户历史到目标 SID"的映射。于是需求理解与推荐决策仍纠缠在单一的 item 生成目标里,两个阶段都没有显式变量或监督。本文的做法相反:把 intent 与 policy 作为两个互补变量前置到 SID 生成之前。
2.2 LLM-Enhanced User Understanding¶
一条线是从交互历史抽取 / 摘要 / 动态更新用户画像与意图;agent 类方法进一步引入工具使用、记忆与个性化技能,例如 iAgent 用个体化 memory 建模用户指令,SAGER 把个性化从"用户知识"扩展到"用户专属策略技能"。另一条线在推荐前引入显式或隐式推理:STREAM-Rec 和 R2Rec 构造多步推理轨迹;Think Before Recommend、LARES、LatentR³ 在 latent 空间做额外计算以降低文本推理开销;OneRec-Think 把显式推理集成进工业生成式推荐器。
作者的批评很锋利:这些方法主要丰富的是"用户理解"或"直接改进 item 预测";即使引入了 user-specific 的 skills 或 policies,它们通常只从用户信息推断出来,而没有推荐结果反馈,因此仍是 intent modeling 的延伸,而非 outcome-grounded 的 policy knowledge。本文把 intent knowledge 与 policy knowledge 分开,只在后者持续优于 intent-only baseline 时才保留它。
3. 方法¶
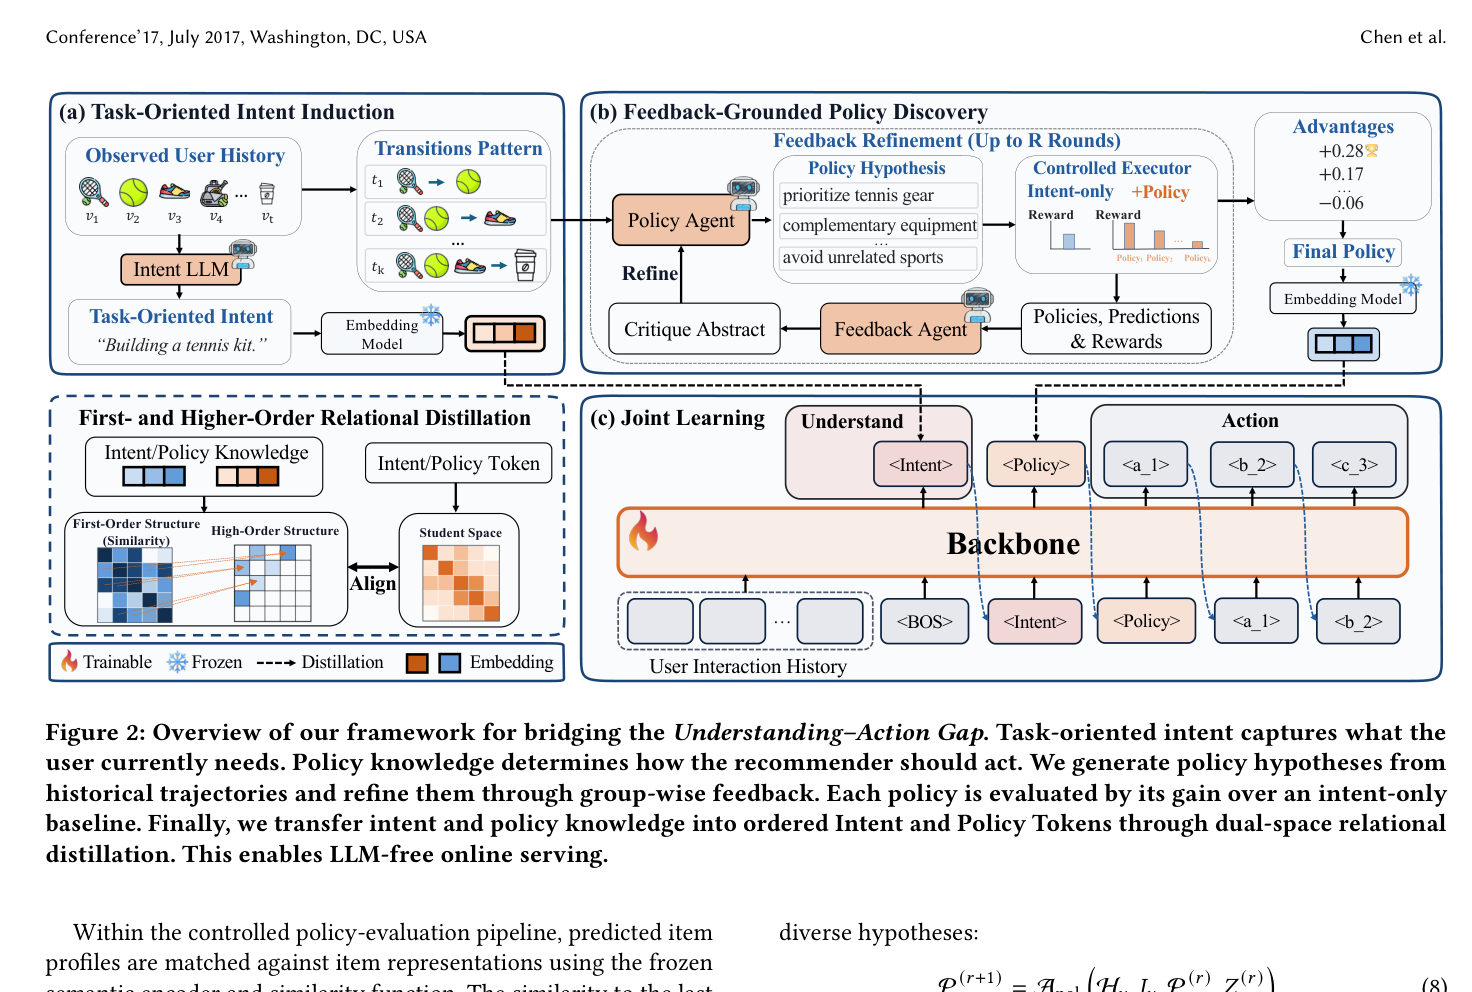
整体框架分三块:(a) Task-Oriented Intent Induction → (b) Feedback-Grounded Policy Discovery → (c) Joint Learning(双空间关系蒸馏 + 自回归推荐)。
3.1 问题形式化¶
设用户集 $\mathcal{U}$、item 集 $\mathcal{V}$。用户 $u \in \mathcal{U}$ 有时序交互序列 $\mathcal{H}_u = (v_{u,1}, \ldots, v_{u,T_u})$,$T_u$ 为序列长度,目标是预测下一个交互 item $y_u \in \mathcal{V}$。SID 生成式推荐把每个 item $v$ 表示成一个 $L$ 级离散语义码序列:
$$\mathrm{SID}(v) = \left(c_v^{(1)}, c_v^{(2)}, \ldots, c_v^{(L)}\right), \tag{1}$$
其中 $c_v^{(\ell)}$ 是 item $v$ 在第 $\ell$ 级量化层被分配的码。给定交互历史,目标 SID 被自回归生成:
$$p_\theta\left(\mathrm{SID}(y_u) \mid \mathcal{H}_u\right) = \prod_{\ell=1}^{L} p_\theta\left(c_{y_u}^{(\ell)} \mid \mathcal{H}_u, \mathbf{c}_{y_u}^{(<\ell)}\right), \tag{2}$$
其中 $\mathbf{c}_{y_u}^{(<\ell)} = (c_{y_u}^{(1)}, \ldots, c_{y_u}^{(\ell-1)})$ 是已生成的 SID 前缀。
关键批评:这个表述虽然给 next-item 生成提供了高效框架,但它的监督仍完全来自 target item。模型必须从同一个 item-level 目标里同时隐式学会"用户当前在找什么"和"推荐器该怎么行动"——这就是 Understanding–Action Gap。
为显式建模这两个互补因素,作者引入 task-oriented intent $I_u$ 与 recommendation policy $P_u$:$I_u$ 捕捉下一次交互背后的主导短期需求;$P_u$ 指定推荐器该如何响应该需求,包含首选推荐方向与拒绝边界。$I_u$ 从 $\mathcal{H}_u$ 推断,$P_u$ 进一步同时条件于 $\mathcal{H}_u$ 和 $I_u$。
3.2 Task-Oriented Intent Induction¶
与刻画整体兴趣的一般偏好画像不同,task-oriented intent 捕捉与当前推荐上下文最相关的需求,同时兼顾长期偏好与近期行为证据。给定交互历史与历史 item 的文本元数据,LLM-based intent agent $\mathcal{A}_{\mathrm{int}}$ 生成文本意图 $I_u$,再编码成连续 teacher 表征:
$$I_u = \mathcal{A}_{\mathrm{int}}\left(\mathcal{H}_u, \mathcal{M}(\mathcal{H}_u)\right), \qquad \mathbf{e}_u^{I} = \mathcal{E}(I_u). \tag{3}$$
其中 $\mathcal{M}(\mathcal{H}_u)$ 是历史 item 的文本元数据,$\mathbf{e}_u^{I} \in \mathbb{R}^d$ 是冻结语义编码器 $\mathcal{E}$ 产出的 teacher 意图表征。
关键 prompt 设计:intent agent 被明确指示推断需求本身(demand),而不是直接预测某个具体 item(附录 D.1 的 system prompt 里写死了 "Do not predict a concrete item, title, category path, item ID, or ASIN")。这样得到的 $I_u$ 是后续策略发现的语义条件,$\mathbf{e}_u^{I}$ 则作为意图知识迁移的 teacher 信号。
3.3 Feedback-Grounded Policy Discovery¶
Intent 描述了用户当前在找什么,但不唯一确定推荐器该怎么行动。同一 intent 下多条 policy hypothesis 都可能看似合理,却只有一部分能提供额外的预测价值。为发现结果有效(outcome-effective)的策略,作者设计了一个双 agent 框架:policy agent 与 feedback agent,通过一个共享的 recommendation executor 连接。policy agent 提出并迭代修订个性化决策原则,feedback agent 从推荐结果里诊断其执行失败。executor 提供了一个受控环境,用来评估每条 policy 相对 intent-only baseline 的表现,使 policy knowledge 能按增量推荐效用而非语言合理性被筛选和精炼。
3.3.1 Policy Agent for Hypothesis Induction(策略假设归纳)¶
交互历史提供了多个可观测的前缀—后继转移。对用户 $u$ 构造
$$\mathcal{T}_u = \left\{ \left(\mathcal{H}_u^{<t}, v_{u,t}\right) \right\}_{t=2}^{T_u}, \qquad \mathcal{H}_u^{<t} = (v_{u,1}, \ldots, v_{u,t-1}).$$
每个前缀—后继对提供了"用户的需求如何转化为下一次交互"的观测证据。条件于这些转移、历史 item 元数据、以及推断出的 intent,policy agent $\mathcal{A}_{\mathrm{pol}}$ 生成 $K$ 条个性化策略假设:
$$\mathcal{P}_u^{(0)} = \left\{ P_{u,1}^{(0)}, \ldots, P_{u,K}^{(0)} \right\} = \mathcal{A}_{\mathrm{pol}}\left(\mathcal{T}_u, \mathcal{M}(\mathcal{H}_u), I_u\right). \tag{4}$$
每条假设指定一个优先的推荐方向和一条拒绝边界(抑制"合理但不合上下文"的替代品)。因此这 $K$ 条候选代表的是在同一推断 intent 下的不同行动方式,而不是对 intent 本身的不同描述。
为什么必须验证:观测转移只提供了假设归纳的证据,并不保证生成的 policy 真能改进推荐。因此所有候选都要通过受控执行 + 推荐监督来评估。
3.3.2 Advantage-Based Policy Evaluation(基于优势的策略评估)¶
令 $\mathcal{F}_{\mathrm{exec}}$ 是一个固定的 recommendation executor,它为预测 item 生成一份文本 profile。给定同一份历史与 intent,executor 先产出 intent-only 预测 $\widehat{M}_{u,0} = \mathcal{F}_{\mathrm{exec}}(\mathcal{H}_u, I_u)$,再为进化轮次 $r$ 的每个候选产出 policy-conditioned 预测 $\widehat{M}_{u,k}^{(r)} = \mathcal{F}_{\mathrm{exec}}(\mathcal{H}_u, I_u, P_{u,k}^{(r)})$。
令 $M_u^{+}$ 表示用户训练序列中最后一个 item 的文本 profile。用冻结语义编码器 $\mathcal{E}$ 定义:
$$ \begin{aligned} R_{u,0} &= \cos\left(\mathcal{E}(\widehat{M}_{u,0}),\ \mathcal{E}(M_u^{+})\right), \\ A_{u,k}^{(r)} &= \cos\left(\mathcal{E}(\widehat{M}_{u,k}^{(r)}),\ \mathcal{E}(M_u^{+})\right) - R_{u,0}. \end{aligned} \tag{5} $$
优势 $A_{u,k}^{(r)}$ 度量的是:这条 policy 在"历史 + intent 已经捕捉到的信息"之上,额外引入了多少增量效用。
为什么用语义相似度而不是 Recall@K / NDCG@K:作者给的理由非常实际——排名类指标对迭代式策略精炼太稀疏。当用户训练序列的最后一个 item 落在 top-$K$ 列表之外时,所有候选 policy 的 reward 都是 0,即使它们实实在在改进了检索得分。这种"不可区分的反馈"无法为候选比较或后续轮次精炼提供任何方向。相反,在受控评估流水线里,预测 item profile 与 item 表征用同一个冻结语义编码器 + 相似度函数匹配,因此哪怕还没进 top-$K$ 列表,与最后一个 item 的相似度也能给出分级反馈;再减去 intent-only 分数,就单独隔离出 policy 带来的增量进展。
作者不是立刻选出单个候选,而是保留整套假设集合作为后续反思的比较证据。
3.3.3 Feedback Agent for Policy Evolution(策略进化)¶
每一轮,feedback agent 联合审视候选策略、执行结果、以及对应的优势:
$$Z_u^{(r)} = \mathcal{A}_{\mathrm{fb}}\left(\left\{ P_{u,k}^{(r)},\ \widehat{M}_{u,k}^{(r)},\ A_{u,k}^{(r)} \right\}_{k=1}^{K}\right). \tag{6}$$
通过比较在同一历史、intent、executor 与 reward 函数下被评估的候选,feedback agent 识别出:与更高 reward 关联的决策模式、较弱候选之间共享的失败模式、以及探索不足的策略方向。这种群体式反思利用的是"跨候选比较证据",是独立精炼每条 policy 拿不到的信息。
当前轮的最佳策略记为:
$$k_u^{(r)} = \arg\max_{1 \le k \le K} A_{u,k}^{(r)}, \qquad P_{u,\mathrm{best}}^{(r)} = P_{u,k_u^{(r)}}^{(r)}. \tag{7}$$
条件于交互历史、intent、当前策略集合、群体级 critique,policy agent 生成新一组 $K$ 条多样化假设:
$$\mathcal{P}_u^{(r+1)} = \mathcal{A}_{\mathrm{pol}}\left(\mathcal{H}_u, I_u, \mathcal{P}_u^{(r)}, Z_u^{(r)}\right). \tag{8}$$
重生成 prompt 鼓励 agent 保留有效的决策模式、纠正反复出现的失败、探索互补的推荐方向与拒绝边界。
新候选用同一套受控执行与评估流程打分。只有当新一轮的最佳优势超过上一轮时,进化才继续;否则流程终止。最多 $R$ 轮。最终选择整个进化过程中遇到的最高优势策略:
$$\left(r_u^{*}, k_u^{*}\right) = \arg\max_{\substack{0 \le r \le R \\ 1 \le k \le K}} A_{u,k}^{(r)}, \qquad P_u^{*} = P_{u,k_u^{*}}^{(r_u^{*})}, \qquad \mathbf{e}_u^{P} = \mathcal{E}(P_u^{*}). \tag{9}$$
因此 policy teacher 表征 $\mathbf{e}_u^{P} \in \mathbb{R}^d$ 来自多假设进化过程中被识别出的最高优势策略,而不是 LLM 一次性生成的初始输出。
数据泄漏防护(重要):策略发现与进化只在训练交互上进行,而且 policy 监督只应用于至少有一个候选优势为正的用户。没有这类候选的用户仍参与推荐学习和 intent 蒸馏,但被排除在 teacher 侧的 policy 蒸馏之外。validation / test target 从不用于 policy 的生成、评估或精炼。
作者总结:最终的 policy knowledge 建立在三层证据之上——历史转移支撑假设生成、正优势验证增量效用、迭代群体反馈渐进精炼决策原则。
3.4 Latent Intent–Policy Knowledge Transfer(隐式知识迁移)¶
Intent / policy teacher 提供了显式的需求与决策知识,但在线推理时调用它们代价巨大。而且它们的表征来自自然语言描述,student 学的却是面向 SID 生成的行为导向表征。直接特征匹配因此过于严格——teacher 与 student 空间根本不共享同一套坐标。
于是作者只把 LLM agent 用作离线监督,把它们的关系知识迁移进轻量 SID 生成器的两个隐状态。
3.4.1 Latent Intent–Policy Recommendation Chain¶
在原始 SID 解码序列前加两个 latent token:Intent Token $q^{I}$ 与 Policy Token $q^{P}$。给定编码后的交互历史 $\mathcal{H}_u$,decoder 先处理 Intent Token,再处理 Policy Token,最后自回归生成目标 SID 码。两个位置的 decoder 隐状态记为 $\mathbf{h}_u^{I}$ 与 $\mathbf{h}_u^{P}$。
顺序有明确语义:Intent Token 从行为历史推断,$\mathbf{h}_u^{I}$ 捕捉用户的底层需求;Policy Token 同时条件于行为历史与前面的 Intent Token,让 $\mathbf{h}_u^{P}$ 表示"在该需求下推荐器应如何行动"。目标 SID 再条件于两个 latent token 生成,把推荐组织成一条 understand–plan–generate(理解—规划—生成)的隐式链条。
3.4.2 First- and Higher-Order Relational Distillation(一阶 + 高阶关系蒸馏)¶
对知识类型 $X \in \{I, P\}$,令 $\mathbf{e}_u^{X}$ 表示 teacher 表征,$\mathbf{z}_u^{X} = g_X(\mathbf{h}_u^{X})$ 表示投影后的 student 表征。intent 与 policy 用同一个关系目标,但 policy 蒸馏只作用于拥有已验证 policy 监督的用户。
一阶关系:先保留用户之间的直接关系。对 $v \in \{\mathrm{T}, \mathrm{S}\}$(teacher / student),令 $\mathbf{r}_u^{X,\mathrm{T}} = \mathbf{e}_u^{X}$,$\mathbf{r}_u^{X,\mathrm{S}} = \mathbf{z}_u^{X}$。batch 内用户 $i$ 的关系分布定义为:
$$\pi_{ij}^{X,v} = \frac{\exp\left(\mathrm{sim}\left(\mathbf{r}_i^{X,v}, \mathbf{r}_j^{X,v}\right)/\tau_v\right)}{\sum_{m \in \mathcal{B}_X \setminus \{i\}} \exp\left(\mathrm{sim}\left(\mathbf{r}_i^{X,v}, \mathbf{r}_m^{X,v}\right)/\tau_v\right)}, \qquad j \in \mathcal{B}_X \setminus \{i\}. \tag{10}$$
teacher 与 student 分布定义在同一批用户集合上,因此它们的直接关系结构可比。
高阶关系:一阶关系只描述用户间的直接邻近性,不刻画用户是否表现出相似的关系模式。因此保留 teacher 每个一阶分布的 top-$K_1$ 项,构造稀疏邻域画像 $\bar{\boldsymbol{\pi}}_i^{X,v}$(teacher 与 student 用同一组索引),高阶亲和度定义为:
$$g_{ij}^{X,v} = \left\langle \bar{\boldsymbol{\pi}}_i^{X,v},\ \bar{\boldsymbol{\pi}}_j^{X,v} \right\rangle. \tag{11}$$
对每个用户,排除其自身与一阶 top-$K_1$ 邻居,在剩余用户中按 $g_{ij}^{X,\mathrm{T}}$ 取 top-$K_2$,再 row-wise softmax 得到高阶分布 $\boldsymbol{\rho}_i^{X,v}$。这捕捉的是"结构上相似但不在直接邻域里"的用户,避免重复迁移同样的直接关系。
两级关系联合迁移:
$$ \mathcal{L}_X^{\mathrm{rel}} = \frac{1}{|\mathcal{B}_X|} \sum_{i \in \mathcal{B}_X} \left[ \mathrm{KL}\left(\mathrm{sg}[\boldsymbol{\pi}_i^{X,\mathrm{T}}] \,\middle\|\, \boldsymbol{\pi}_i^{X,\mathrm{S}}\right) + \gamma\, \mathrm{KL}\left(\mathrm{sg}[\boldsymbol{\rho}_i^{X,\mathrm{T}}] \,\middle\|\, \boldsymbol{\rho}_i^{X,\mathrm{S}}\right) \right], \qquad X \in \{I, P\}. \tag{12} $$
其中 $\mathrm{sg}[\cdot]$ 是 stop-gradient,$\gamma$ 控制高阶项的贡献。一阶项保留直接语义邻域,高阶项迁移邻居之外的互补结构关系。
3.4.3 Joint Learning and Inference¶
关系蒸馏只结构化了 Intent / Policy Token 空间,并不直接监督 next-item 预测。因此与自回归推荐目标结合:
$$\mathcal{L}_{\mathrm{rec}} = -\frac{1}{|\mathcal{B}|} \sum_{u \in \mathcal{B}} \sum_{\ell=1}^{L} \log p_\theta\left(c_{y_u}^{(\ell)} \,\middle|\, \mathcal{H}_u,\ q^{I},\ q^{P},\ \mathbf{c}_{y_u}^{(<\ell)}\right), \tag{13}$$
完整目标为:
$$\mathcal{L} = \mathcal{L}_{\mathrm{rec}} + \lambda_I \mathcal{L}_I^{\mathrm{rel}} + \lambda_P \mathcal{L}_P^{\mathrm{rel}}, \tag{14}$$
其中 $\lambda_I$、$\lambda_P$ 控制 intent 与 policy 迁移的强度。推荐目标直接优化 latent token 服务于 next-item 预测,intent / policy 蒸馏目标则引入互补的需求级与决策级监督。
推理阶段只保留 SID 推荐器 + 两个 latent token 位置。LLM agent、文本 profile、语义编码器、projection head 全部只用于离线监督,不引入任何在线 serving 成本。 student 直接从交互历史推断 Intent / Policy Token 状态,然后生成目标 SID。
4. 实验¶
论文用五个 RQ 组织实验:
- RQ1 有效性:离线 + 在线与强 baseline 对比如何?
- RQ2 Understanding–Action Gap:policy knowledge 是否补充了 intent understanding?
- RQ3 策略发现:反馈驱动的策略发现是否优于直接生成与随机选择?
- RQ4 知识蒸馏:一阶 + 高阶关系蒸馏把 intent / policy 知识迁移进轻量 student 的效果如何?
- RQ5 效率:在线服务上的效果—效率权衡如何?
4.1 实验设置¶
4.1.1 数据集¶
三个广泛使用的 Amazon Review 类目:Beauty、Toys and Games、Sports and Outdoors。leave-one-out 划分:最后一次交互测试,倒数第二次验证,其余全部训练。所有对比方法使用同一套预处理与数据划分。
Table 7: 数据集统计
| Dataset | #Users | #Items | #Interactions | Avg. Length |
|---|---|---|---|---|
| Beauty | 22,363 | 12,101 | 176,139 | 8.87 |
| Toys | 19,412 | 11,924 | 148,185 | 8.63 |
| Sports | 35,598 | 18,357 | 260,739 | 8.32 |
4.1.2 Baselines¶
- 传统推荐器(6 个):Caser(卷积序列嵌入)、GRU4Rec(GRU 会话建模)、SASRec(因果自注意力)、BERT4Rec(Cloze 式双向掩码)、HGN(特征级 + 实例级门控,显式建模长短期兴趣)、P5(统一 text-to-text 推荐范式)。
- SID 生成式推荐器(2 个):TIGER(层级 Semantic ID + seq2seq 自回归生成)、LETTER(联合语义、协同信号与 code-assignment 多样性的 item tokenizer)。
- Direct LLM baseline:用 Qwen3.5-122B-A10B 直接从交互历史生成 next item 的文本 profile,再通过 embedding 相似度匹配候选 item 表征来检索推荐。
4.1.3 评估指标¶
Recall@K 与 NDCG@K,$K \in \{5, 10\}$。leave-one-out 设定下,Recall@K 衡量 held-out target item 是否出现在 top-$K$ 推荐列表中;NDCG@K 进一步考虑排名位置,排得越靠前得分越高。在线 A/B 用 ADVV(Advertiser Value,广告主价值:平台可为投放流量向广告主合理收取的金额) 与 Revenue(平台实现的营收)作为主要业务指标。期望结果是两者都涨,同时 ADVV 的相对涨幅大于 Revenue。
4.1.4 实现细节¶
- item 文本 = title + category 拼接,用 Qwen3-Embedding-8B 编码(即冻结语义编码器 $\mathcal{E}$);
- backbone 用 TIGER 与 LETTER 两个生成式骨干;
- intent agent 与 policy agent 均用 Qwen3.5-122B-A10B;
- (附录 A.2)PyTorch 实现,8× NVIDIA A800 80GB 训练;学习率 $\in \{1\times10^{-3}, 2\times10^{-3}\}$,batch size 2048,训练轮数 $\in \{200, 300\}$;蒸馏权重 $\lambda_I, \lambda_P$ 独立地从 $\{0.5, 1.0\}$ 选取;
- Policy Agent 每轮生成 $K = 5$ 条候选策略;虽然分析里跑了更多轮,实践中用 $R = 2$ 轮精炼以平衡推荐质量与计算成本;
- 关系蒸馏的一阶 / 高阶邻居数 $K_1 = K_2 = 5$,高阶系数固定 $\gamma = 0.1$;
- 所有实验重复 5 次取均值;TIGER 遵循 GRID 报告的实现与训练配置,LETTER 用官方代码与推荐超参复现。
4.2 主要结果(RQ1)¶
Table 1: 三个 Amazon 数据集上的整体性能对比
| Method | Beauty R@5 | R@10 | N@5 | N@10 | Toys R@5 | R@10 | N@5 | N@10 | Sports R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| P5 | 0.0163 | 0.0254 | 0.0107 | 0.0136 | 0.0070 | 0.0121 | 0.0050 | 0.0066 | 0.0061 | 0.0095 | 0.0041 | 0.0052 |
| Caser | 0.0205 | 0.0347 | 0.0131 | 0.0176 | 0.0166 | 0.0270 | 0.0107 | 0.0141 | 0.0116 | 0.0194 | 0.0072 | 0.0097 |
| GRU4Rec | 0.0164 | 0.0283 | 0.0099 | 0.0137 | 0.0097 | 0.0176 | 0.0059 | 0.0084 | 0.0129 | 0.0204 | 0.0086 | 0.0110 |
| SASRec | 0.0387 | 0.0605 | 0.0249 | 0.0318 | 0.0463 | 0.0675 | 0.0306 | 0.0374 | 0.0233 | 0.0350 | 0.0154 | 0.0192 |
| BERT4Rec | 0.0203 | 0.0347 | 0.0124 | 0.0170 | 0.0116 | 0.0203 | 0.0071 | 0.0099 | 0.0115 | 0.0191 | 0.0075 | 0.0099 |
| HGN | 0.0325 | 0.0512 | 0.0206 | 0.0266 | 0.0321 | 0.0497 | 0.0221 | 0.0277 | 0.0189 | 0.0313 | 0.0120 | 0.0159 |
| LLM (Direct) | 0.0293 | 0.0413 | 0.0203 | 0.0241 | 0.0416 | 0.0645 | 0.0278 | 0.0352 | 0.0146 | 0.0233 | 0.0089 | 0.0118 |
| TIGER | 0.0425 | 0.0617 | 0.0279 | 0.0333 | 0.0336 | 0.0510 | 0.0217 | 0.0273 | 0.0216 | 0.0332 | 0.0140 | 0.0177 |
| TIGER + Ours | 0.0491 | 0.0739 | 0.0341 | 0.0417 | 0.0485 | 0.0712 | 0.0322 | 0.0393 | 0.0288 | 0.0441 | 0.0186 | 0.0234 |
| LETTER | 0.0447 | 0.0693 | 0.0296 | 0.0375 | 0.0366 | 0.0542 | 0.0239 | 0.0296 | 0.0232 | 0.0372 | 0.0143 | 0.0188 |
| LETTER + Ours | 0.0513 | 0.0753 | 0.0347 | 0.0423 | 0.0497 | 0.0724 | 0.0345 | 0.0415 | 0.0282 | 0.0446 | 0.0183 | 0.0233 |
结论分析(why,不只是 what):
-
对骨干的相对提升非常可观:Beauty 上 TIGER 的 R@10 从 0.0617 → 0.0739(+19.8%),N@10 从 0.0333 → 0.0417(+25.2%);Toys 上 TIGER R@10 从 0.0510 → 0.0712(+39.6%);Sports 上从 0.0332 → 0.0441(+32.8%)。LETTER 侧提升同样一致(Toys R@10 +33.6%,Sports +19.9%,Beauty +8.7%)。方法不绑定特定架构,可直接插进不同 SID 生成式骨干。
-
Toys 上有一个值得注意的现象:SASRec(R@10 = 0.0675)大幅超过 TIGER(0.0510)与 LETTER(0.0542)——即两个 SID 生成式骨干在这个数据集上原本是落后于纯序列判别式基线的。加上本文框架后,TIGER+Ours(0.0712)与 LETTER+Ours(0.0724)才首次反超 SASRec。这说明 policy knowledge 补的正是 SID 生成路线最缺的那部分决策信息,而不是简单叠加一个可有可无的特征。
-
Direct LLM baseline 并不强:Beauty 上 0.0413 R@10,甚至低于 SASRec(0.0605)和 TIGER(0.0617);Toys 上 0.0645 接近 SASRec 但仍不敌 +Ours。这从反面印证了论文的核心论点——直接让 LLM 做推荐(纯语言层面的"理解")并不能自动转化为好的推荐决策,必须经过结果验证并内化进推荐器。
-
Sports 上 TIGER+Ours 的 NDCG 略高于 LETTER+Ours(N@5 0.0186 vs 0.0183,N@10 0.0234 vs 0.0233),说明骨干本身的 tokenizer 优势在加入 intent/policy 监督后会被部分"抹平"——决策级监督的边际贡献可能大于 tokenizer 层面的改进。
4.3 模型分析¶
4.3.1 Understanding–Action Gap 分析(RQ2)¶
考察 intent understanding 是否足够、policy 是否提供了互补的决策知识。所有变体都保留 Intent Token 与 intent 蒸馏,只在是否使用 Policy Token 与 policy 蒸馏上有差异。实验在 Beauty + TIGER 骨干上进行(其他数据集见附录 B.1)。
一个关键统计量:Beauty 上 87.74% 的训练用户至少有一条候选 policy 相对 intent-only baseline 取得正优势,因而获得 policy 监督。
Table 2: Policy Token 与 policy 蒸馏在 Beauty + TIGER 上的效果(所有变体均保留 Intent Token 与 intent 蒸馏)
| Policy Token | Policy Distillation | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|
| – | – | 0.0448 | 0.0682 | 0.0307 | 0.0383 |
| ✓ | – | 0.0478 | 0.0722 | 0.0325 | 0.0401 |
| ✓ | ✓ | 0.0491 | 0.0739 | 0.0341 | 0.0417 |
分析:只加 Policy Token(不做 policy 蒸馏)已经优于 intent-only(0.0682 → 0.0722),说明 intent 并没有完全决定最终的 item 级决策——多留一个 latent 决策槽位本身就有价值。但增益在没有 policy 蒸馏时是有限的,说明改进不仅仅来自"多了一个 latent token"。完整模型(0.0739)通过迁移已验证的 policy knowledge 取得最好性能,为 Understanding–Action Gap 提供了实证支持。注意 intent-only 变体(0.0682)本身已经明显高于原始 TIGER(0.0617),说明 intent 蒸馏单独就贡献了大约 +10.5%。
Table 3: intent 与 policy 在 Beauty + TIGER 上的分级贡献($\mathrm{R}_{1:\ell}@10$ 表示 SID 前缀在前 $\ell$ 级上匹配目标前缀的 Recall@10,数值为绝对百分点增益)
| Model Comparison | $\Delta \mathrm{R}_{1:1}@10$ | $\Delta \mathrm{R}_{1:2}@10$ | $\Delta \mathrm{R}_{1:3}@10$ |
|---|---|---|---|
| TIGER → TIGER + Intent | +2.23 | +1.63 | +1.19 |
| TIGER + Intent → Full Model | +0.01 | +0.18 | +0.37 |
分析(本文最漂亮的一个实验):这张表揭示了一个由粗到细的分工。intent 在第一级 SID 上增益最大(+2.23 pp),说明它主要改进的是对目标广义语义区域的定位;policy 在第一级几乎无贡献(+0.01 pp),却在更深层次上产出递增的增益(第二级 +0.18,第三级 +0.37),正是需要细粒度 item 区分的地方。这个模式与两者各自的角色高度一致:intent 识别需求区域,policy 在该区域内决定行动。这不是事后叙事,而是被 SID 前缀级指标定量分离出来的。
4.3.2 反馈驱动策略发现分析(RQ3)¶
考察有效策略是否需要 advantage-grounded 的选择与迭代精炼,以及其收益是否超越"任意 LLM 生成的策略"或"直接的目标语义监督"。Beauty + TIGER,三个对照变体:
- w/o Policy Evolution:只从初始候选集里选优势最高的那条,不做进一步精炼;
- Random Policy Selection:从初始策略里随机选一条,不做 advantage 验证;
- Target-as-Policy:把发现的 policy 直接换成目标 item 的描述,其余(Policy Token + 蒸馏流水线)不变。
Table 4: Beauty + TIGER 上的策略选择与进化消融
| Policy Construction | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| Full Model | 0.0491 | 0.0739 | 0.0341 | 0.0417 |
| w/o Policy Evolution | 0.0483 | 0.0728 | 0.0331 | 0.0407 |
| Random Policy Selection | 0.0470 | 0.0718 | 0.0319 | 0.0398 |
| Target-as-Policy | 0.0474 | 0.0703 | 0.0314 | 0.0385 |
Table 8 / Table 11:Toys 与 Sports 上的同一消融
| Policy Construction | Toys R@5 | R@10 | N@5 | N@10 | Sports R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|---|---|---|
| Full Model | 0.0485 | 0.0712 | 0.0322 | 0.0393 | 0.0288 | 0.0441 | 0.0186 | 0.0234 |
| w/o Policy Evolution | 0.0471 | 0.0702 | 0.0319 | 0.0390 | 0.0280 | 0.0433 | 0.0183 | 0.0233 |
| Random Policy Selection | 0.0468 | 0.0666 | 0.0308 | 0.0379 | 0.0272 | 0.0426 | 0.0178 | 0.0227 |
| Target-as-Policy | 0.0466 | 0.0696 | 0.0310 | 0.0381 | 0.0279 | 0.0424 | 0.0181 | 0.0228 |
分析:
- 去掉策略进化一致地降低性能,随机选择降得更多——advantage-grounded 验证与迭代精炼都不可省;
- Target-as-Policy 表现更差(Beauty R@10 0.0703 < Full 0.0739,甚至低于 w/o Evolution 的 0.0728),这是本文最有说服力的一条反驳:增益来自抽象的决策原则,而不是直接注入目标语义。如果只是"把答案偷偷塞进 latent token",那 Target-as-Policy 应该最强,但事实相反。这排除了"policy 只是变相的标签泄漏"的质疑。
Figure 3:策略进化轮数的影响
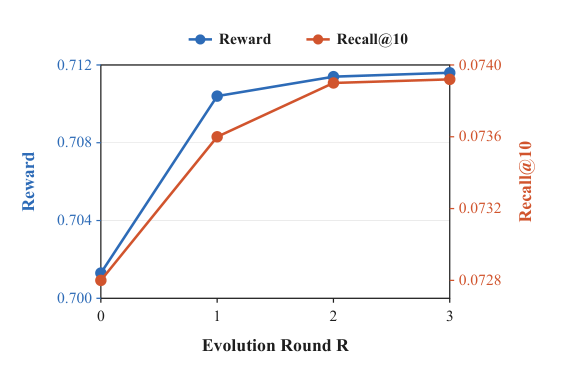
每一轮里,当前最佳策略给"下一组 $K$ 条假设是否带来改进"提供参考。相似度 reward 与 Recall@10 都随轮数一致上升,大部分增益在前两轮内取得(reward 从约 0.700 涨到约 0.711,Recall@10 从约 0.0728 涨到约 0.0740,$R=2$ 之后基本走平)。这也解释了为什么实践中取 $R = 2$。作者再次强调:与稀疏的排名类指标(最后一个 item 掉出 top-$K$ 就给 0 反馈)不同,相似度在同一语义评估函数下提供分级信号,其一致上升的趋势证明该 reward 能够指导策略精炼,同时保持与推荐性能对齐。
4.3.3 知识蒸馏分析(RQ4)¶
Table 5: Beauty 上的知识蒸馏消融
| Method | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| Relational Distillation (Ours) | 0.0491 | 0.0739 | 0.0341 | 0.0417 |
| Direct Distillation | 0.0469 | 0.0698 | 0.0318 | 0.0391 |
| w/o Higher-Order Distillation | 0.0481 | 0.0721 | 0.0330 | 0.0406 |
| w/o Intent Distillation | 0.0466 | 0.0711 | 0.0311 | 0.0389 |
| w/o Policy Distillation | 0.0478 | 0.0722 | 0.0325 | 0.0401 |
| w/o Distillation | 0.0457 | 0.0709 | 0.0308 | 0.0388 |
Table 10 / Table 13:Toys 与 Sports 上的同一消融
| Method | Toys R@5 | R@10 | N@5 | N@10 | Sports R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|---|---|---|
| Relational Distillation (Ours) | 0.0485 | 0.0712 | 0.0322 | 0.0393 | 0.0288 | 0.0441 | 0.0186 | 0.0234 |
| Direct Distillation | 0.0473 | 0.0684 | 0.0308 | 0.0381 | 0.0274 | 0.0434 | 0.0180 | 0.0231 |
| w/o Higher-Order Distillation | 0.0478 | 0.0687 | 0.0319 | 0.0387 | 0.0279 | 0.0424 | 0.0183 | 0.0228 |
| w/o Intent Distillation | 0.0460 | 0.0690 | 0.0313 | 0.0386 | 0.0277 | 0.0421 | 0.0184 | 0.0230 |
| w/o Policy Distillation | 0.0453 | 0.0688 | 0.0309 | 0.0379 | 0.0283 | 0.0430 | 0.0185 | 0.0233 |
| w/o Distillation | 0.0430 | 0.0662 | 0.0289 | 0.0363 | 0.0268 | 0.0416 | 0.0174 | 0.0222 |
分析:
- 去掉 intent 蒸馏或 policy 蒸馏都掉点,同时去掉掉得最多(Beauty w/o Distillation 的 N@10 0.0388 vs 0.0417)——两路监督在标准 next-item 目标之外提供了互补的需求级与决策级知识;
- 去掉 intent 蒸馏的下降幅度更大(Beauty N@5 0.0311 vs w/o policy 的 0.0325),说明 intent 提供了主要的语义基础,policy 在其上做精炼——与 Table 3 的分级结论一致;
- 去掉高阶蒸馏也掉点,说明邻域级结构补充了直接用户关系;
- Direct(MSE)匹配一致劣于关系蒸馏(Beauty R@10 0.0698 vs 0.0739;Toys 0.0684 vs 0.0712),支持"在异构 teacher–student 空间之间做关系级对齐而非坐标级对齐"的设计动机。
Figure 4 / Figure 7:相似度结构可视化
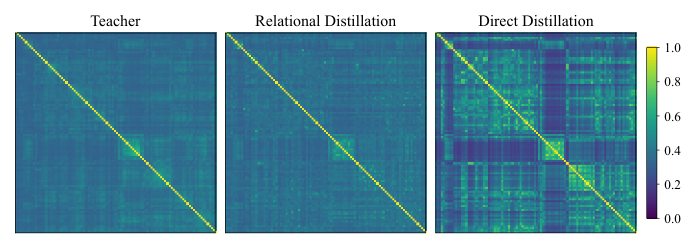
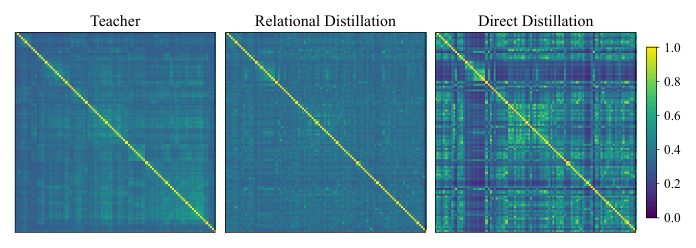
关系蒸馏保留的结构更接近 teacher,而直接 MSE 对齐引入了更明显的块状扭曲(block-wise distortion)。这种结构保真度也体现在更强的推荐性能上。Figure 7 在 intent 空间给出了同样的结论。
4.3.4 超参敏感性¶
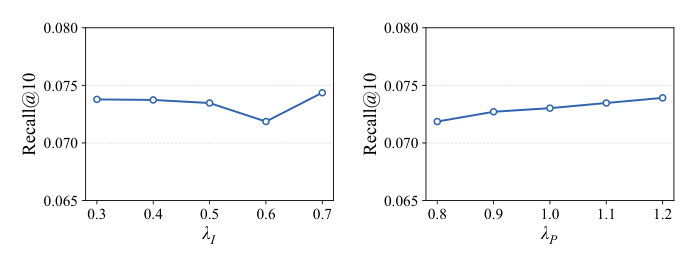
在 Beauty + TIGER 上扫描 $\lambda_I \in [0.3, 0.7]$ 与 $\lambda_P \in [0.8, 1.2]$,Recall@10 基本稳定在 0.070–0.075 区间($\lambda_I = 0.6$ 处有一个小凹陷),方法对这两个权重不敏感。
4.4 在线部署¶
4.4.1 部署流水线¶
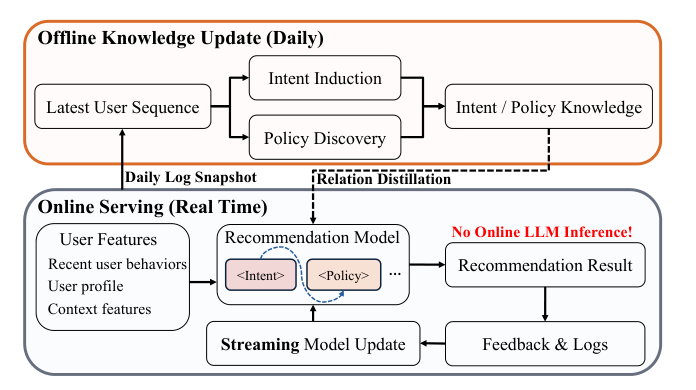
框架部署在快手本地生活广告系统(Kuaishou local-services advertising system),采用多时间尺度(multi-timescale)架构:
- LLM teacher 每天产出一次用户级 intent 与 policy 监督(离线知识更新:Latest User Sequence → Intent Induction / Policy Discovery → Intent / Policy Knowledge);
- 轻量 SID 生成器通过 streaming training 持续刷新(在线服务侧:User Features / Recent Behaviors / User Profile / Context Features → Recommendation Model(含
<Intent><Policy>两个 token 位)→ Recommendation Result → Feedback & Logs → Streaming Model Update); - LLM teacher 用已完成的历史交互归纳 task-oriented intent 并发现已验证的推荐策略。这些 intent / policy 信号当天内固定,作为关系蒸馏的 teacher 监督;与此同时 SID 生成器用新观测到的交互更新;
- 每个在线请求,student 模型接收实时行为与上下文特征,形成隐 Intent / Policy Token 状态,生成目标 SID 用于候选检索与排序。
这个设计把"每日 LLM 知识刷新 + 学生模型持续更新 + 实时 SID 生成"组合起来,在线服务路径上完全不调用 LLM。
4.4.2 在线 A/B 实验¶
- 7 天 A/B,覆盖约 13.25 million 用户 与 1.61 million items;
- 对照组与实验组各占 5% 总流量,实验期间产生约 7000 万(70 million)交互样本;
- 相较生产 baseline:Revenue +4.506%、ADVV +4.621%,两项提升在 95% 置信水平下统计显著;
- ADVV 涨幅大于 Revenue,表明模型不仅提升平台营收,还给广告主交付了更大价值(符合 §4.1.3 中"期望 ADVV 相对涨幅更大"的设定)。
4.4.3 服务效率(RQ5)¶
一个自然的担忧是:latent intent–policy chain 在服务时引入了两个额外的生成步骤。作者测了同一服务配置下的平均单样本推理延迟。
Table 6: 同一服务配置下的平均单样本推理延迟
| Method | Latency (s/sample) |
|---|---|
| Base Model | 0.023 |
| Base + Intent Token | 0.029 |
| Base + Intent and Policy Tokens | 0.032 |
| Direct LLM Inference | 4.437 |
分析:两个 latent token 只把延迟从 0.023 抬到 0.032 s/sample(+39%),而 Direct LLM 推理慢了两个数量级以上(4.437 s,约 139×)。这说明框架在保持底座在线模型效率的同时,有效地把 LLM 导出的 intent 与 policy 知识内化了进来。
4.5 案例研究(附录 C)¶
C.1 intent 与 policy 的互补角色:完成美甲流程¶
用户此前交互过 nail file(指甲锉)、nail-dotting tools(点花笔)、gel nail polish(甲油胶),ground-truth 下一个 item 是 one-hand LED gel-nail dryer(单手 LED 光疗机)。
- intent 正确识别出用户当前需求是美甲护理与创意美甲,从而把候选空间限制到美甲相关商品;
- 但这个语义区域内仍有多个貌似合理的候选:更多甲油、装饰工具、笔刷套装、固化设备;
- 只条件于 intent 时,模型推荐了 nail-art brush set,语义 reward 0.5941——虽与"美甲"大方向一致,却忽略了用户最近交互(甲油胶)引入的即时功能依赖;
- policy 识别出 curing(固化)是美甲流程中的下一步必需环节,并抑制那些"只是重复用户历史里已有功能"的产品。在该 policy 指导下,模型推出了 ground-truth 的 LED 光疗机,语义 reward 升到 0.8754。
Table 14: 该案例中推断出的 intent 与经过结果验证的 policy
| Component | Content |
|---|---|
| Intent | 用户当前正在完成美甲护理与创意美甲的工作流 |
| Recommendation Direction | 优先推荐与最近交互 item 有直接功能互补的产品,特别是美甲流程中下一步立即需要的工具(如甲油胶之后的固化设备) |
| Rejection Boundary | 排除那些只是宽泛地与美甲艺术相关、但不推进当前工作流的产品,以及功能与用户历史交互重复的工具 |
作者的关键论断:intent 与 policy 的区分不是语义粒度上的差别。intent 概括的是用户当前的需求状态并识别一个合理的候选区域;policy 则作为该区域内的历史依赖决策规则,指定哪些功能转移该被优先、哪些语义相关但行动上不合适的替代品该被拒绝。"知道用户在做美甲"并不唯一确定下一个推荐——policy 补上了缺失的行动级指导。
C.2 反馈驱动的策略进化:一个完整轮次¶
用户此前交互过 wrinkle-treatment patches(抗皱贴) 与 bentonite-clay facial cleanser(膨润土洁面),ground-truth 下一个 item 是 rose-water facial hydrator(玫瑰水保湿喷雾)。重要的是:这个 item 只被外部 reward 环境使用,从不出现在 Policy Agent 或 Feedback Agent 的 prompt 里。 intent 正确定位了面部护肤需求,但预测被最近的深层清洁行为主导。
初始策略假设(Table 16,$K = 5$ 条行为上互异的策略,为可读性略作缩短但不改变决策语义):
| Policy Hypothesis |
|---|
| 优先推荐天然成分的深层清洁面膜或全脸黏土类产品;避免合成去角质产品或与"天然、土系"偏好不符的产品 |
| 优先推荐为抗老护理做准备的清洁 / 排毒类产品;避免只提供保湿而无主动清洁或排毒功效的产品 |
| 优先推荐与此前眼周专项护理不同的面部清洁产品或面膜;避免额外的眼贴或功能重复的局部产品 |
| 优先推荐用于物理去角质、毛孔清洁或质地平滑的天然产品;避免只有补水功效、无质地改善的产品 |
| 优先推荐护肤流程中的互补步骤,例如搭配靶向治疗的深层清洁面膜;避免不推进流程序列的产品 |
执行结果:五条策略带来异质的执行结果。强调流程推进与功能互补的策略优于 intent-only 分支;对成分来源、保湿或物理去角质施加刚性约束的策略反而有害。"流程完成"型策略被选为最佳初始策略——但它仍然预测了另一款黏土面膜,说明初始假设集合过度集中在面膜与深层清洁上。
群体反馈(Table 17:从五条初始策略导出的结构化群体 critique)
| Component | Content |
|---|---|
| Preserve Patterns | 保留功能互补性与流程推进(推进到下一步全脸护肤),而不是单纯重复最新的品类 |
| Shared Failure Modes | 避免按成分来源或物理质地做过度约束的推荐——这会窄化决策空间并削弱与当前流程的功能对齐 |
| Underexplored Directions | 探索非面膜形态,包括精华、爽肤水、洁面产品,它们能桥接"此前的靶向治疗"与"后续全脸护理" |
| Regeneration Guidance | 放松"天然 vs 合成"的约束,扩展到面膜与磨砂之外,优先考虑下一件产品的序列功能而非表面属性(质地、形态) |
注意 Feedback Agent 是 target-blind 的:它联合接收五条 policy–prediction–advantage 三元组,不观测用户训练序列的最后一个 item、其元数据或其语义表征。它产出的 critique 不指认也不推荐任何具体 item,只识别"哪些决策原则把有益策略与语义合理但无效的策略区分开"——功能推进应被保留,重复形态与不必要的表层约束应被纠正。
第一轮进化后被选中的策略(Table 18)
| Component | Content |
|---|---|
| Recommendation Direction | 通过非面膜形态(爽肤水、精华、温和洁面)优先推进功能进展,桥接靶向眼部护理与后续全脸护理 |
| Rejection Boundary | 避免重复同一局部功能的额外眼部专项产品,也不要仅因"缺乏天然品牌标签"就排除有效产品 |
进化后的策略预测了 leave-on facial serum(免洗面部精华)而非另一款黏土面膜,reward 从最佳初始策略的 0.5854 升到 0.6765,超过接受阈值、通过了基于结果的门控。预测与观测到的爽肤水并非精确匹配,但进化把推荐从"重复性面膜"移向了更合适的非面膜全脸护理语义区域。
4.6 Prompt 设计要点(附录 D)¶
论文完整给出了五个 prompt 模板,其中几处设计值得单独记录:
- D.1 Intent Agent:明确禁止预测具体 item / 标题 / 类目路径 / item ID / ASIN,也禁止引入无依据的人口、医疗、兼容性或生活方式假设;只输出一条 JSON 格式的 intent。
- D.2 Initial Policy Hypothesis Generation:定义 policy 为"由 recommendation direction + rejection boundary 构成的可执行决策规则";强制每条 policy 描述"推荐器该如何行动"而不是复述 intent;
policy_value字段必须以"Prioritize ..."开头并包含一个"Avoid ..."子句;禁止预测隐藏目标、未见 item、item ID 或不支持的属性。 - D.3 Controlled Policy Execution:executor 每次只做一次模型调用、只预测一条语义 profile(
predicted_title+predicted_category);无 policy 时只用 History 与 Intent;有 policy 时把它当作附加决策规则——"Policy 应指导选择,但不得覆盖显式的行为证据";禁止输出 rationale、置信度或目标猜测。 - D.4 Group-Wise Policy Feedback:显式声明 "You are a target-blind Feedback Agent";对每个候选只能看到 policy 文本、执行的语义预测、以及相对 intent-only baseline 的标量 advantage;永远看不到 user History、inferred Intent、target item、target metadata、target representation;禁止复制具体预测标题、品牌、完整类目路径或可唯一识别的属性组合,禁止推断或重建隐藏 target,禁止指定具体 next item。
- D.5 Feedback-Guided Policy Refinement:critique 只能当作 meta-level guidance,每条新 policy 必须 ground 在给定的 History 与 Intent 里;rejection boundary 必须"局限于当前决策"。
这套 prompt 边界是本文防止标签泄漏的主要工程手段,与 §3.3.3 的"只用训练交互 + 只对正优势用户施加 policy 监督"共同构成了泄漏防护。
5. 核心贡献总结¶
- 概念层面:明确命名并区分了生成式推荐里的 intent knowledge(用户当前在找什么)与 policy knowledge(推荐器该怎么行动),把两者的纠缠诊断为 Understanding–Action Gap。这个区分不是文字游戏——Table 3 的 SID 前缀级分解定量证明了两者的粗—细分工(intent 主管第一级语义区域定位,policy 主管深层细粒度区分)。
- 方法层面:提出以 advantage over intent-only baseline 为核心的策略筛选准则,把"LLM 输出是否可信"从语言合理性转成可测量的增量推荐效用;配合 target-blind 的 group-wise feedback agent 做迭代进化。Target-as-Policy 消融证明了增益来自抽象决策原则而非目标语义注入。
- 工程层面:双空间(intent + policy)一阶 + 高阶关系蒸馏把两类 LLM 知识内化为轻量 SID 生成器的两个隐 token,在线延迟只从 0.023 涨到 0.032 s/sample,比直接 LLM 推理快约 139×;快手本地生活广告 7 天 A/B 取得 Revenue +4.506% / ADVV +4.621%。
- 评估设计:用语义相似度替代稀疏的 Recall/NDCG 作为策略迭代的 reward,解决了"目标掉出 top-K 时所有候选 reward 全为 0、无法比较"的稠密反馈问题——这是一个可迁移到其他 LLM-agent-for-rec 场景的实用技巧。
6. 与已归档相关工作的对比¶
PauseRec PauseRec:Implicit Reasoning for LLM-based Generative Recommendation(University of Virginia + Snap Inc., 2026-06)¶
关系:独立并发(本文未引用 PauseRec,PauseRec 也未引用本文)· 已加载对方精读
- 共同关注的问题:两篇都在攻击同一个 root cause——在 SID 生成式推荐里,"语言层面看起来合理的推理"并不自动转化为更好的 item 决策。PauseRec 从训练流水线侧诊断:CoT SFT 一致地劣于朴素 next-item SFT,收益只有在昂贵的 RL 后训练之后才浮现;三大根因是世界知识言语化受损、文本–SID 嵌入空间错位、对 rationale 质量的脆弱性。本文从知识类型侧诊断:LLM 补的是 intent understanding,而"语言上合理的推理不必然导向有效的推荐决策"。两者都拒绝"把自然语言 rationale 直接喂给 SID 生成器"这条路。
- 相近的技术骨架:两者的落点惊人地一致——在目标 SID 生成之前插入一小段可训练的 latent token,让推理发生在隐空间而不是文本空间。PauseRec 插的是一串
<pause>token,本文插的是有序的<Intent>+<Policy>两个 token。两者都不在线上做任何文本推理,都强调训练/推理开销的下降。 - 本文的差异与推进:PauseRec 的
<pause>token 只由最终 next-item 预测目标优化,是"纯隐式计算",不需要 teacher 也不需要 RL——极其轻量但也没有外部知识注入。本文的两个 latent token 则由离线 LLM teacher 的关系结构监督(公式 12),并且 teacher 侧的 policy 经过了 outcome-grounded 的筛选(公式 5 的 advantage)。换句话说:PauseRec 的答案是"别让 LLM 说话,让模型自己在隐空间算";本文的答案是"让 LLM 说话,但只保留说对了的那部分,再把它压成隐空间的关系结构"。本文额外解决了 PauseRec 未触及的"如何判断 LLM 产出的知识是否有用"这个问题。 - 可比的方法 / 实验差异:两篇的 Beauty 数据集口径接近但不完全可比。PauseRec 报告 Beauty R@5/R@10/N@5/N@10 = 0.0568 / 0.0746 / 0.0401 / 0.0467(Qwen3-1.7B 骨干,SID token 加入 LLM 词表),本文 LETTER+Ours = 0.0513 / 0.0753 / 0.0347 / 0.0423(T5 量级 SID 骨干)。PauseRec 的 NDCG 明显更高,但它的骨干是 1.7B LLM,本文骨干是轻量 SID 生成器——本文的在线延迟 0.032 s/sample 是 PauseRec 这条路线难以达到的。另一个差异是 PauseRec 有完整的诊断性实验(CPT 能恢复多少 SID 语义、rationale 扰动敏感性),本文则有工业 A/B(Revenue +4.506%);两篇在"诊断深度"与"落地强度"上正好互补。
Taiji Taiji:Pareto-Optimal Policy Optimization with Semantics-IDs(Kuaishou, 2026-06)¶
关系:独立并发(同为快手广告场景,本文未引用 Taiji)· 已加载对方精读
- 共同关注的问题:两篇都直指 "推荐场景是 open-ended 生成任务,LLM 产出的推理链没有唯一可验证的答案,因此其质量无法用语言学标准度量"。Taiji 的表述是"以往工作只用最终答案是否正确来评判 CoT 质量,缺乏合理且系统的指标";本文的表述是"LLM 没有针对推荐结果反馈训练过,语言上合理的推理不必然导向有效的推荐决策"。两者都认定:必须引入一个来自推荐结果的、可量化的信号,来给 LLM 的输出打分并做筛选。
- 相近的技术骨架:"生成 K 条候选 → 用结果代理信号打分 → 拒绝低分的 → 把留下来的知识注入线上轻量模型" 这条骨架两篇几乎完全重合。Taiji 用 QwQ-32B 对每个 prompt 生成 $k=3$ 条候选 CoT,用 ground-truth 答案的困惑度 PPL 作为质量代理(PPL 低 = 这条 CoT 让真实答案更可预测),保留 PPL 低于中位数的样本;本文用 Qwen3.5-122B-A10B 生成 $K=5$ 条候选 policy,用 相对 intent-only baseline 的语义相似度 advantage 作为质量代理,只保留 advantage 为正的。两者的代理信号本质相同:都是"这条 LLM 输出是否让真实的下一个 item 变得更容易被命中"。 部署侧也同构:Taiji 把 RL 对齐后的 LLM 做近线推理、输出量化稀疏特征注入在线排序模型;本文把 LLM teacher 每天离线跑一次、蒸馏进 student 的两个隐 token。两者都是快手广告场景,主指标都是 ADVV + Revenue(Taiji +2.83% ADVV / +3.30% Revenue,本文 +4.621% ADVV / +4.506% Revenue)。
- 本文的差异与推进:(1) 筛选粒度不同——Taiji 筛的是"一条推理链的整体质量",本文筛的是"一条决策规则相对 intent-only 基线的增量效用",后者显式做了基线相减,因此排除了"policy 只是复述 intent 已有信息"的情况;(2) 迭代 vs 一次性——Taiji 的拒绝采样是一次性筛选,本文有 target-blind feedback agent 驱动的多轮群体进化(公式 6–8),Figure 3 显示两轮内还能继续涨;(3) 知识注入方式不同——Taiji 把 LLM 输出量化成稀疏特征拼进排序模型(特征级),本文做的是关系结构蒸馏(分布级 KL,公式 12),且区分了 intent 空间与 policy 空间;(4) Taiji 额外解决了本文未涉及的多奖励冲突问题(POPO 的 Pareto 权重自适应),本文只有单一相似度 reward。
- 可比的方法 / 实验差异:Taiji 是纯工业论文(无公开 benchmark 对比),本文有三个 Amazon 数据集 + 两个骨干的完整离线对比;Taiji 的 A/B 覆盖 4 亿 DAU 全量部署,本文是 5%+5% 流量的 7 天实验(约 13.25M 用户)。Taiji 在"部署规模与多目标平衡"上更成熟,本文在"筛选信号的因果隔离"与"公开可复现性"上更清晰。
RecoReward RecoReward:Recommender-Guided Multimodal Description Generation(Nankai University, 2026-07)¶
关系:独立并发(本文未引用 RecoReward,两者同月上传)· 已加载对方精读
- 共同关注的问题:两篇共享一个非常特定的 root cause——LLM/MLLM 的输出"内容保真度高、语言流畅"并不等于"对推荐有用",因此不能用语言学质量做训练目标,必须把推荐器本身当作评判者。RecoReward 的表述是"一段流畅完整的描述可以强调广泛相关的语义,但对最可能与该 item 互动的那批用户只提供了很弱的区分信号";本文的表述是 Understanding–Action Gap。两者都把"评判权"从语言模型移交给了一个冻结的推荐侧打分器。
- 相近的技术骨架:最惊人的结构重合在奖励定义上——两者都做了"减去一个基线以剥离共享/无区分度成分"。RecoReward 的 Recommender Affinity Score 是 RAS = 目标用户中心亲和度 − λ × 非目标用户中心亲和度,用于剥离"广泛共享的背景亲和";本文的 advantage 是 $A = \cos(\text{policy 预测}, \text{目标}) - \cos(\text{intent-only 预测}, \text{目标})$,用于剥离"history + intent 已经捕捉到的信息"。两者都用冻结的编码器 / 双塔做打分器(RecoReward 用行为训练的 DSSM,本文用 Qwen3-Embedding-8B + 余弦相似度),都用群体相对(group-relative)的方式比较候选,并且都把用户 / 目标信息严格限制在训练期的打分器内部,推理时的生成侧完全看不到(RecoReward 保持 content-only 推理;本文的 feedback agent 是 target-blind,且 student 在线只看行为特征)。
- 本文的差异与推进:(1) 优化对象不同——RecoReward 优化的是 item 侧的一段共享描述(一次编码、复用于千万用户),本文优化的是 user 侧的一条决策规则(每个用户一条);(2) 落地方式不同——RecoReward 用 GRPO 直接更新 MLLM 生成器的参数,本文不训练 LLM,只用 prompt 驱动的 agent 循环 + 关系蒸馏,因此离线成本形态完全不同(本文省了 RL 训练但多了 $K \times (R+1)$ 次 LLM 推理);(3) 本文多了一层迭代反思——RecoReward 是单轮 reward 引导的策略梯度,本文有显式的 critique → regeneration 循环;(4) RecoReward 主动引用了 Gao et al. 的 reward model overoptimization scaling law 并明确界定"这是推荐器空间里的代理量,不是描述质量的普适度量",本文缺少这一层自我限定——这恰好是本文最需要补的一个讨论(见 §7.2)。
- 可比的方法 / 实验差异:RecoReward 在直播推荐场景做 matched-tower 召回评测 + 系统级在线 A/B,本文在 Amazon 公开集 + 快手本地生活广告 A/B。两者不共享数据集,无法直接比数值;但"用冻结推荐器当训练期裁判 + 减基线隔离增量信号"这一范式在两篇里独立成立,是当前 LLM4Rec 里一条正在收敛的路线。
7. 讨论与局限性¶
7.1 值得借鉴的设计¶
- "advantage over intent-only baseline" 是一个可直接复用的验证准则。 它把"LLM 说的话有没有用"这个模糊问题,转成了一个可计算、可比较、可迭代的标量。关键在于基线的选择:不是与"随机"比,而是与"已经用上了 intent 的自己"比,因此隔离出的是纯增量。这个思路可以推广到任何"LLM 增强推荐器"的场景(例如:用户画像的增量价值、item 标签的增量价值)。
- 稀疏 reward → 稠密语义 reward 的替换。 排名指标在迭代优化里的稀疏性是一个非常普遍的痛点(目标掉出 top-K 时所有候选都拿 0)。用同一个冻结语义编码器算"预测 profile 与目标 profile 的余弦相似度"作为分级反馈,是一个便宜且有效的解法。
- target-blind feedback agent。 让做反思的 agent 看不到 user history / intent / target,只看 policy 文本 + 预测 + 标量 advantage,是防止"反思变成偷看答案"的关键工程约束。这个设计在附录 D.4 里被 prompt 层面强制。
- 关系蒸馏而非坐标蒸馏。 teacher(语言空间)与 student(行为空间)不共享坐标系时,迁移一阶 + 高阶用户间关系分布比匹配 embedding 更合理,Table 5 与 Figure 4/7 都支持这一点。
- Table 3 的 SID 前缀级归因方法。 用 $\mathrm{R}_{1:\ell}@10$ 拆解不同监督在 SID 层级上的贡献,是一个非常干净的诊断工具,值得在其他 SID 生成式工作里复用。
7.2 局限与争议¶
- 奖励是代理量,且论文没有做代理有效性验证。 advantage 定义在"预测 item 的文本 profile 与 $M_u^{+}$ 的余弦相似度"上,而 $M_u^{+}$ 是训练序列的最后一个 item。论文没有报告这个相似度 reward 与真实 Recall/NDCG 的相关性,也没有讨论 reward overoptimization 的风险(对比之下 RecoReward 明确讨论了这一点)。Figure 3 显示 reward 与 Recall@10 同向上升,但那只是 3 个点的趋势观察,不构成量化证据。
- $M_u^{+}$ 的选择存在结构性张力。 用"训练序列最后一个 item"当 reward 锚点,等于奖励"能预测出用户最近行为"的策略——但案例 C.2 的问题恰恰是"intent-only 预测被最近的深层清洁行为主导"。也就是说,reward 锚点本身带有"近因偏置",而框架又要靠它来纠正近因偏置。论文没有讨论这个张力,也没有做"锚点换成倒数第二个 item / 多个 item 平均"的敏感性实验。
- 12% 的用户没有 policy 监督,处理方式未详述。 Beauty 上 87.74% 的训练用户有正优势候选,剩下约 12% 被排除在 policy 蒸馏之外。这些用户的 Policy Token 仍然存在于解码序列里(结构上必须存在),但没有 teacher 信号。论文没说这个 token 在这些用户上学到了什么、是否引入噪声、是否需要 masking。
- 离线 LLM 成本完全没有报告。 每个用户需要:1 次 intent 归纳 + 1 次 intent-only executor + $K \times (R+1) = 5 \times 3 = 15$ 次 policy-conditioned executor + $R = 2$ 次 feedback 反思 ≈ 19 次 122B MoE 推理。Beauty 22K 用户尚可,工业场景 13.25M 用户 × 每日刷新,这个成本量级是巨大的,但论文只字未提离线算力开销、也没有讨论采样策略(是否只对高价值用户跑)。这是"LLM-free 在线服务"这个卖点背后被隐藏的账。
- 在线实验的指标口径偏窄。 只报 Revenue 与 ADVV,没有 CTR / CVR / 转化率等中间指标,也没有报告 GMV 或用户侧体验指标。广告场景的 Revenue 提升有可能来自出价 / 流量分配的变化而非推荐质量本身,缺少中间指标就难以排除这种解释。另外在线是本地生活广告场景,与公开集的 next-item 任务差异很大,两组实验之间的因果链条并不完整。
- 框架未命名,可复现性描述偏薄。 论文没给自己的方法起名字,也没提供代码链接;policy agent / feedback agent 用的 Qwen3.5-122B-A10B 是一个不常见的型号,复现门槛不低。
- 方法论可扩展性存在两阶段解耦的隐患。 这是一个典型的"离线 LLM 产出监督 → 在线轻量模型消费监督"的两段式架构:teacher 侧的 policy 发现与 student 侧的 SID 生成无法端到端联合优化。当 student 参数量 scaling 上去时,teacher 侧的 intent/policy 表征维度 $d$(由冻结的 Qwen3-Embedding-8B 决定)与 $K=5, R=2$ 的假设预算都是固定的,"如何表征历史"与"如何建模序列"这两条路径没法随规模同步扩充。换言之,framework 的上限被离线 teacher 的表达力与假设搜索预算钉死了。这与 SIF / IAT 那类"先压缩再建模"范式面临的是同一类长期瓶颈。
- 与自引工作的关系不清晰。 参考文献 [29] 是同一批作者的 WWW'26 论文《Hierarchical Semantic RL: Tackling the Problem of Dynamic Action Space for RL-based Recommendations》,但正文没有讨论两者的关系;考虑到本文的"策略发现"与 RL 的"策略"概念高度相关,这个缺失有点可惜。
7.3 综合评价¶
这是一篇问题定义比方法本身更有价值的论文。"Understanding–Action Gap"这个命名以及 intent / policy 的二分,配合 Table 3 的 SID 前缀级归因证据,把一个此前含混的直觉("LLM 补的是理解不是决策")钉成了可测量的对象。Target-as-Policy 消融是全文最有说服力的一笔——它直接堵住了"policy 只是变相标签泄漏"的质疑。工程上,"LLM 只做离线 teacher + 两个隐 token + 关系蒸馏"的组合干净利落,延迟数据(0.023 → 0.032 s/sample vs Direct LLM 4.437)与 A/B 收益(Revenue +4.506% / ADVV +4.621%)都实打实。
主要短板在于代理奖励的有效性没有被验证、离线成本被完全隐藏、两阶段解耦的 scaling 上限存疑。对做工业 LLM4Rec 的团队而言,最值得直接借鉴的是"减基线的 advantage 筛选准则"与"target-blind 群体反思"这两个可移植的构件,而非整套流水线。