RecoReward:用推荐器反馈引导的多模态描述生成¶
作者:Guohong Mu¹、Yueyang Liu²、Jiangxia Cao²*、Changxin Lao²、Zijie Zhuang²、Yuhui Zhang²、Jiaqi Feng²、Ruochen Yang³⁴、Shuang Yang²、Zhaojie Liu²、Qibin Hou¹* 所属:¹南开大学计算机学院 VCIP · ²快手科技(北京) · ³中科院信息工程研究所 · ⁴中国科学院大学网络空间安全学院(*通讯作者) ArXiv:2607.25901v1 · 2026-07-28 · cs.IR 部署:快手直播推荐,一周系统级在线 A/B
1. 研究动机与背景¶
现代推荐系统越来越依赖多模态内容来补充 item ID、元数据和历史交互:图像、视频、语音、文本承载了传统信号无法完全刻画的 item 语义,而这些语义对内容感知匹配、泛化和冷启动至关重要。多模态大模型(MLLM)提供了一条灵活的路径——把 item 的多模态内容转成自然语言的结构化描述,推荐系统再把这些描述当作 item 侧的语义特征,与常规 ID 特征、预抽取内容特征拼在一起使用。得到的 item 接口是可解释的,并且与现有的双塔召回架构天然兼容。
但作者指出,绝大多数面向内容的 MLLM 方法只从观测到的 item 内容生成描述,把推荐当作下游的消费方,而不是用召回阶段的信号去指导"该强调什么"。这个疏漏之所以要紧,是因为一段共享描述只被编码一次、却要被复用于与成千上万个用户做比对。内容保真度本身并不决定推荐效用:两段都遵循同一结构化 schema 的描述,可以分别聚焦于不同的人、事件、场景、属性或用户相关线索。一段流畅完整的描述可以强调"广泛相关"的语义,但对"最可能与该 item 互动的那批用户"只提供了很弱的区分信号。
近期的 recommender-guided 方法证明了用户侧信息确实能把生成引导向下游推荐目标:
- Rec-R1 [17] 以用户 query 或行为历史为条件生成,用推荐器反馈优化输出;
- CURec [19] 用交互序列推断用户兴趣模式,为不同用户生成个性化的推荐理由;
- VRAgent-R1 [3] 从历史交互模拟用户决策。
但作者对这条路线提出了一个工程上非常锋利的批评:一旦把用户信息塞进每一次 MLLM 请求,可复用的 item 表示就退化成了用户相关的计算。服务系统必须去取用户历史或画像、序列化它们、在交互变化时重建 prompt,并且要为不同用户重复生成同一个 item 的描述,而不是缓存一份 item 描述。更糟的是,长而异构的行为序列本身就难以被 LLM 可靠地解读——ReLLa [16] 报告过:在还没触及上下文长度上限之前,性能就会随历史变长而下降。
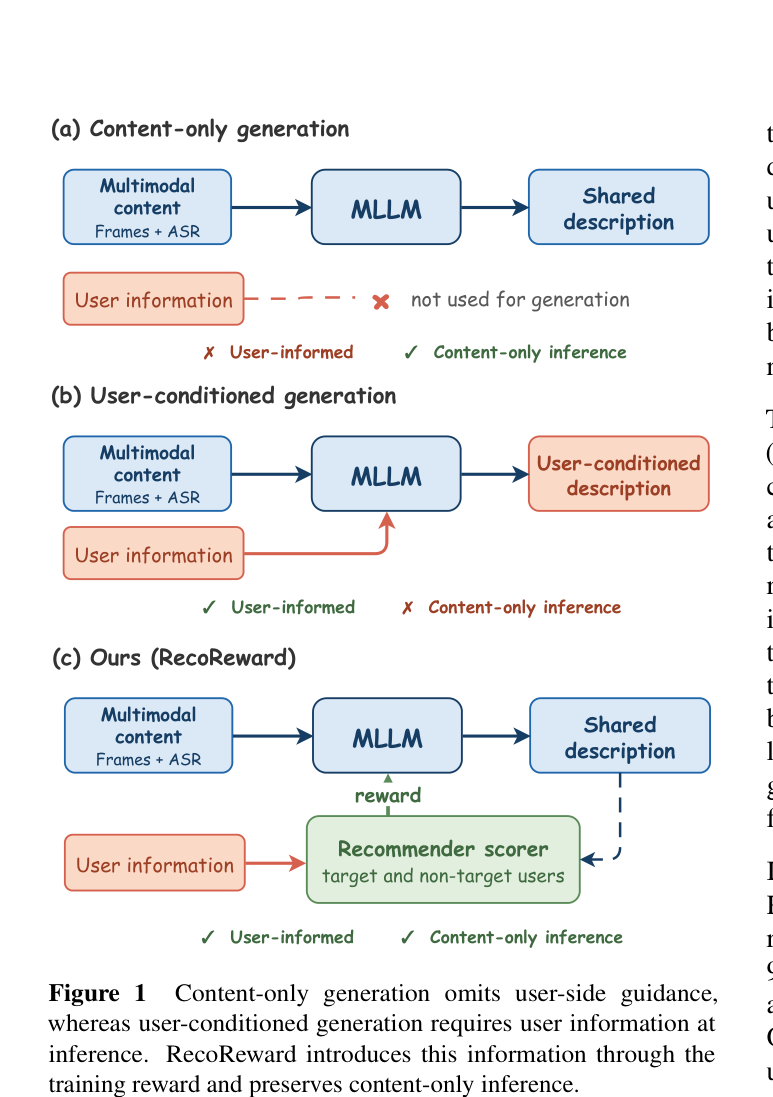
Figure 1 把这个设计权衡总结得很清楚:(a) content-only 生成简单易服务,但不用用户侧引导;(b) 直接的 user-conditioned 生成用了引导,但推理时必须有用户信息。于是本文的中心问题是:
能否让用户监督只在训练期教会 MLLM 去偏好那些更适合下游推荐的描述,而在推理时保持 content-only?
作者的关键洞察是:把行为训练出来的 DSSM 当作一个训练期接口。如 Figure 2 所示,用户和候选描述共享同一个匹配空间,因此观测到的用户行为可以在不把用户信息加进生成器输入的前提下,去给不同的候选描述打分。RecoReward 用这个接口去训练一个 content-only 的生成器。
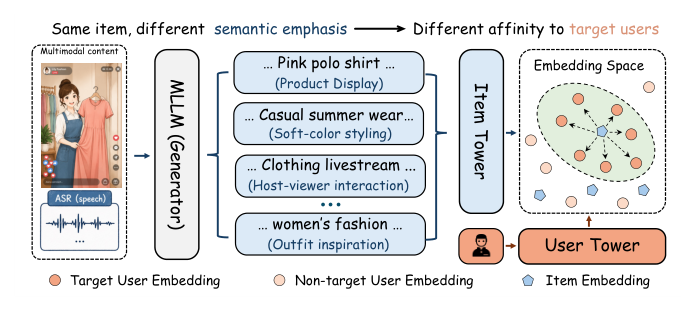
Figure 2 的具体含义是:同一个直播间的多模态内容(画面帧 + ASR 语音),MLLM 可以生成"粉色 polo 衫(商品展示)"、"休闲夏装(柔色系搭配)"、"服装直播(主播-观众互动)"、"女装(穿搭灵感)"等多种都符合内容的描述;它们经 Item Tower 编码后,在嵌入空间里与目标用户群的亲和度是不同的。这就是可优化的空间。
三点贡献:
- user-selective reward 设计的行为学证据:在一个时间上严格分离的直播分析中,证明历史目标用户能预测未来目标用户,但其均值表示同时也包含了"广泛共享"的亲和成分。
- RAS 引导的策略学习:形式化 Recommender Affinity Score 来减掉这部分共享亲和,并把它作为 sequence-level 反馈来训练 content-only 的 MLLM 策略。用户特征始终被限制在冻结的推荐器侧打分器内部。
- 直播推荐中的验证:通过 matched-tower 召回评测与奖励设计消融验证。RecoReward-9B 在全部七个召回指标上取得所有被评测模型中的最高均值,相对其底座提升 31.7–40.4%;独立的系统级在线 A/B 在关键页面与外流指标上均为正。
2. 相关工作定位¶
2.1 面向推荐的多模态内容表示。早期方法把预训练模态特征灌进协同模型;后续工作联合建模多模态内容与 user–item 结构,或把通用内容表示对齐到推荐空间 [8, 9, 29, 31, 32, 35, 39–41]。近期 LLM/MLLM 路线里,RLMRec [24] 把 LLM 生成的画像与协同表示对齐,NoteLLM-2 [38] 通过视觉-语言适配学习多模态推荐表示,另有工作把 MLLM 的视频描述编码为推荐器特征 [4]。直播场景下 SARM [34] 生成语义锚点并接入工业排序模型。这些工作大多是在生成之后再去改进或对齐 item 表示;RecoReward 则是让推荐行为直接决定模型生成哪一段共享 item 侧描述。
2.2 Recommender-Guided 文本生成。Rec-R1 [17]、CURec [19]、VRAgent-R1 [3] 都用推荐目标引导生成,但输出形态与条件边界与 RecoReward 不同:RecoReward 只从直播内容生成单一共享 item 侧描述,监督来自 author 级的用户集合,从观测到的非目标用户测得的广泛共享亲和会被减掉,而且服务时生成器输入里不需要任何用户信息。
2.3 奖励引导生成与偏好优化。序列级优化(MRT [27]、SCST [25])处理 token 似然与下游效用的错配;RLHF/DPO/群体相对策略优化把奖励引导学习扩展到开放式语言生成 [21, 23, 26, 28]。作者主动引用了 Gao et al. 的 reward model overoptimization scaling law [5],承认优化一个学到的或近似的奖励最终会停止改进真实目标。作者明确界定:RecoReward 的奖励来自一个在观测行为上训练的推荐器,度量的是"一段描述作为 item 侧特征、相对于非目标人群、对历史用户代理的价值";它是一个推荐器空间里的代理量,不是描述质量、事实性或因果用户偏好的普适度量。
3. 行为分析:为什么需要 user-selective 奖励¶
本节是全文最有价值的实证部分——它先把"历史目标用户中心是一个不完备的代理"这件事量化出来,再据此推导奖励设计。
3.1 分析设置¶
每个冻结的双塔评测器由一个 user tower(编码用户历史)和一个 item 侧 tower(编码候选描述)组成,两者内积衡量用户与描述的兼容性。对每个 author 采样四个互不相交的用户组:历史目标用户、历史非目标用户、未来目标用户、未来非目标用户。历史目标中心定义了"代理方向",减去历史非目标中心得到"修正方向";未来两组保留用于评测。 比较过程中候选集(5 条固定描述)、用户组、塔参数全部固定,使用 3 个冻结塔的随机种子。
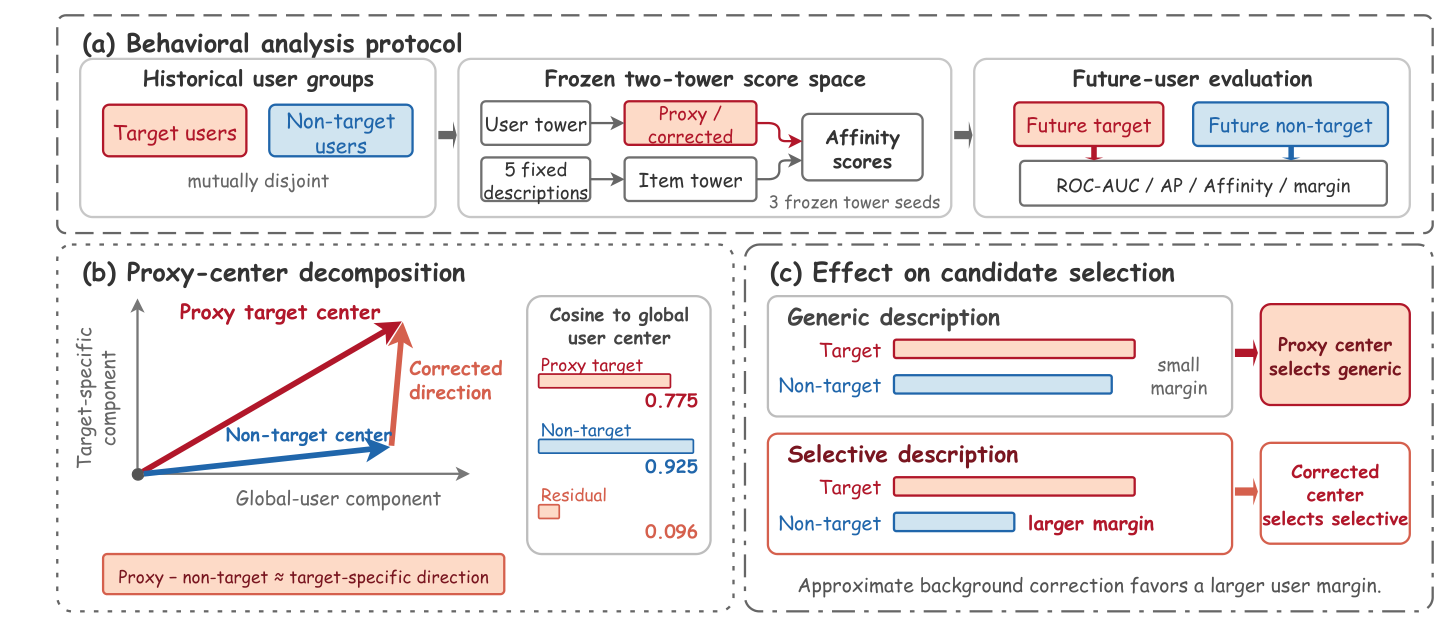
Table 1 行为分析所用指标及其解读:
| 指标 | 测什么 | 解读 |
|---|---|---|
| Disagreement rate | 减法是否改变了被选中的描述 | 越高说明候选切换越频繁 |
| Global-center cosine | 共享用户亲和是否还残留 | 接近 0 说明共享对齐基本被移除 |
| ROC-AUC / AP | 历史信息能否区分未来目标与非目标用户 | 越高越好,ROC-AUC = 0.5 为随机 |
| Future-user margin | 选择是否偏向未来目标用户 | 越大说明目标用户特异性越强 |
3.2 行为发现¶
(a)代理中心确实被"全局用户成分"污染。 到全局用户中心的平均余弦相似度:代理目标中心 0.7752,非目标中心 0.9255——两者都含有很强的全局用户成分。做差之后,残差方向与全局中心的余弦只有 0.0960。这组观测支持"把非目标中心当作背景估计"的做法,与共享成分被平均抵消的假设一致;但作者谨慎地补了一句:这并不构成一个精确分解,也不能得到一个纯粹的目标中心。
(b)修正提升了未来用户判别力,而不是把预测信号一起削掉。 在主评测面上,代理目标方向的未来用户 ROC-AUC 为 0.7603、AP 为 0.7518;修正方向把这两个值提到 0.8052 / 0.7904。
(c)修正显著改变候选排序。 五条候选虽然遵循同一 schema、描述同一场直播,代理方向与修正方向在三个评测器种子下对 44.7%–50.9% 的 author 选出了不同的描述,平均分歧率 47.4%。
(d)修正牺牲一点目标亲和,换来更大的 margin。 相对代理中心打分,修正把未来目标亲和从 0.3108 降到 0.2969,但把未来非目标亲和从 0.1596 更大幅度地降到 0.1354,于是未来用户 margin 从 0.1513 升到 0.1616。也就是说修正改变了候选排序,并偏好更具选择性的描述(Figure 3(c))。
Table 2 未来用户判别力与被选描述的亲和度:
| Direction | 未来用户判别 ROC-AUC | AP | 被选描述 Target 亲和 | Non-target 亲和 | Margin |
|---|---|---|---|---|---|
| Proxy target | 0.7603 | 0.7518 | 0.3108 | 0.1596 | 0.1513 |
| Corrected | 0.8052 | 0.7904 | 0.2969 | 0.1354 | 0.1616 |
3.3 设计启示¶
历史目标中心是一个有用但混合的代理:它同时包含未来目标用户的信息与"被广泛活跃用户共享"的亲和。只对着这个中心打分,会奖励那些同时匹配目标和非目标用户的泛化描述。非目标中心提供了一个背景项,减掉它就得到一个更具目标特异性的候选选择代理。
作者在这里再次自我设限:历史目标用户只是未来目标用户的代理,不是完整或因果的用户偏好定义;在给定的采样流程下,非目标用户是"没有观测到对该 author 的正向交互的活跃用户"。因此修正方向是一个全局对齐被削弱后的经验目标方向,而非真正的、被纯化的目标中心。
4. 方法:RecoReward¶
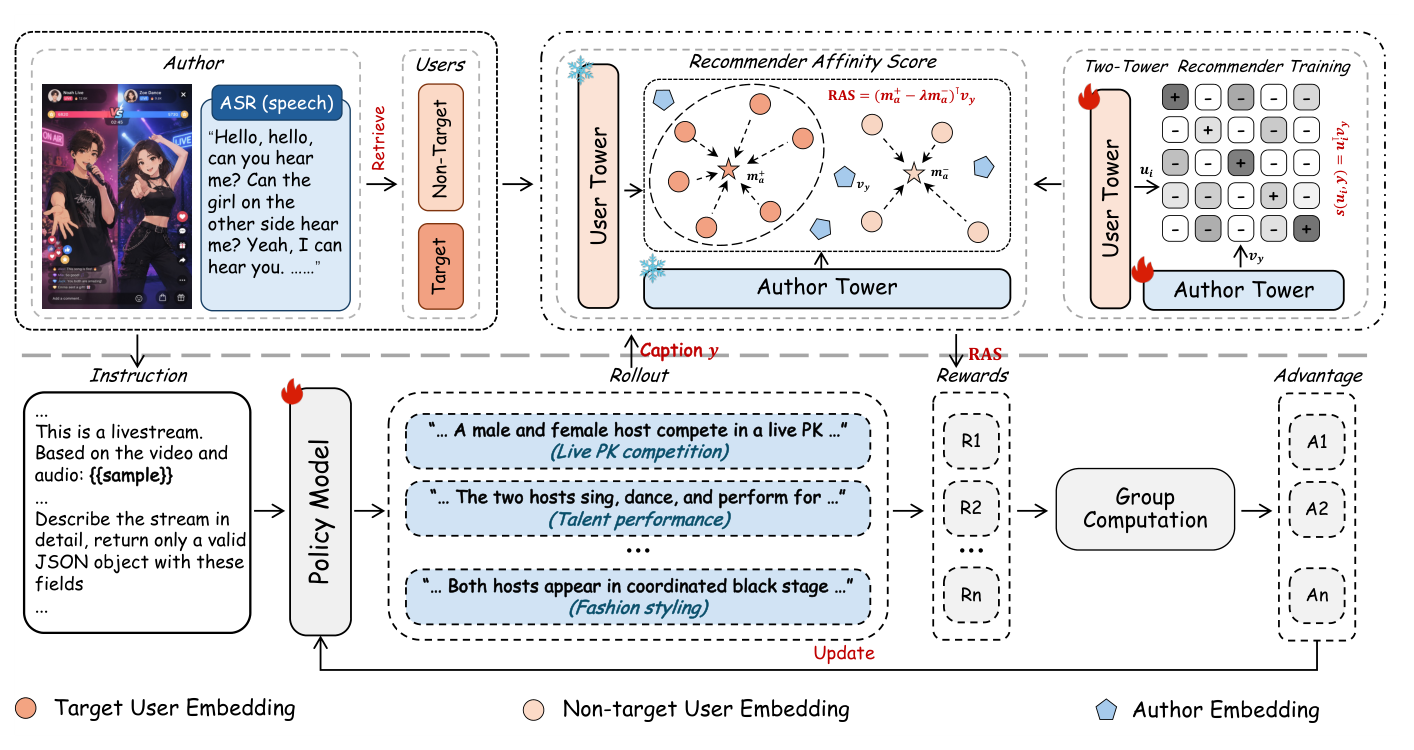
整条流水线是"content-only 生成 → 推荐器打分 → 群体相对策略更新"三段式。行为用户特征始终被限制在冻结的推荐器侧打分器里,从不进入 MLLM 输入。
4.1 问题形式化与预备知识¶
设 $x = (F, T)$ 表示一段直播上下文,$F$ 为视觉帧,$T$ 为转写的语音片段。MLLM 策略据此生成结构化描述:
$$y \sim \pi_\theta(\cdot \mid x) \tag{1}$$
设 $\mathcal{Y}(x)$ 为受观测内容支持、且符合要求输出 schema 的描述集合。对 author $a$,理想描述解的是
$$y^* \in \arg\max_{y \in \mathcal{Y}(x)} U_{\text{rec}}(y; a) \tag{2}$$
其中 $U_{\text{rec}}$ 表示"把 $y$ 用作共享 item 侧语义特征"所获得的推荐效用,优化被限制在 $\mathcal{Y}(x)$ 所表示的内容与格式约束之内。因为真实效用在策略训练时不可得,RAS 是一个行为导出的代理,而不是 $U_{\text{rec}}$ 的等价定义。
强化学习方面:GRPO 对每个输入采样 $G$ 条响应,在组内归一化奖励,从而无需学到的 critic 即可做相对优化;DAPO 追加了非对称 clip 的 token-level 目标,并在有效响应 token 上平均 loss [26, 36]。这两者构成了 RAS 引导训练的优化背景。
4.2 行为对齐的双塔空间¶
冻结的打分器由 user tower 与 description tower 组成,把行为上下文与生成文本映射到共享的推荐空间。对用户 $i$,$h_i$ 表示完整的用户侧特征记录(含 ID、属性、近期行为序列);对生成的描述 $y$,description tower 只接收对应的文本 token。两塔在同一 $d$ 维空间产出归一化表示:
$$u_i = f_u(h_i), \qquad v_y = f_i(y), \qquad s(u_i, y) = u_i^\top v_y \tag{3}$$
内积 $s(u_i,y)$ 衡量从观测行为学到的"用户 $i$ 与描述 $y$"的兼容性。Author 标识符与 author 专属 ID embedding 被显式排除在 $v_y$ 之外——这一点关键:它阻止身份特征直接决定同一场直播不同描述之间的分数差异,从而保证奖励差异真的来自语义内容。
两塔在正向 user–stream 交互上训练。设 mini-batch $\mathcal{B} = \{(h_b, y_b, w_b)\}_{b=1}^{N_{\text{mb}}}$,$N_{\text{mb}} = |\mathcal{B}|$。用户 $b$ 与其交互过的直播描述配对,batch 内其余描述作为对比项。令 $u_b = f_u(h_b)$,$v_j = f_i(y_j)$,匹配概率为
$$p(y_b \mid h_b; \mathcal{B}) = \frac{\exp(u_b^\top v_b / \tau)}{\sum_{j=1}^{N_{\text{mb}}} \exp(u_b^\top v_j / \tau)} \tag{4}$$
训练最小化行为加权目标:
$$\mathcal{L}_{\text{tower}} = -\sum_{b=1}^{N_{\text{mb}}} w_b \log p(y_b \mid h_b; \mathcal{B}) \tag{5}$$
权重 $w_b$ 代表观测到的正向行为强度,包括进房、长时观看、关注、评论、点赞、送礼。这个目标使匹配空间按推荐行为而非通用语言相似度来成形——这是整套奖励可信度的根基。
4.3 Recommender Affinity Score¶
RAS 把冻结的 user–description 匹配函数转换成一个 user-selective 的标量奖励:奖励与历史互动过的目标用户的兼容性,同时减去与非目标用户共享的亲和。
4.3.1 目标与非目标用户集合¶
对 author $a$,目标集合由在构造窗口内近期表现出指定正向行为的用户组成,非目标集合由在同窗口内对该 author 没有观测到正向交互的活跃用户组成:
$$\mathcal{U}_a^+ = \{u_{a,i}^+\}_{i=1}^{M}, \qquad \mathcal{U}_a^- = \{u_{a,j}^-\}_{j=1}^{B} \tag{6}$$
作者再次强调边界:目标集合是对 author $a$ 潜在未来用户的经验历史代理;非目标用户是一个观测性人群,他们不是被标注的曝光负样本、不是表达过厌恶的用户、也不是反事实用户标签。双塔打分器与物化的用户表示在整个策略训练过程中保持冻结。
4.3.2 User-Selective 兼容性¶
经验目标中心与非目标中心:
$$m_a^+ = \frac{1}{M}\sum_{i=1}^{M} u_{a,i}^+, \qquad m_a^- = \frac{1}{B}\sum_{j=1}^{B} u_{a,j}^- \tag{7}$$
对描述 $y$,对应的亲和分量为
$$S^+(y; a) = \frac{1}{M}\sum_{i=1}^{M} s(u_{a,i}^+, y) = (m_a^+)^\top v_y \tag{8}$$
$$S^-(y; a) = \frac{1}{B}\sum_{j=1}^{B} s(u_{a,j}^-, y) = (m_a^-)^\top v_y \tag{9}$$
注意这里利用了内积的线性性:对用户求平均等价于对用户中心求内积,因此 RAS 的计算成本与用户数无关,只需物化两个中心向量。这两个量只是中间分量,不是独立的方法目标。
Recommender Affinity Score 定义为
$$\mathrm{RAS}_\lambda(y; a) = S^+(y; a) - \lambda S^-(y; a) = (m_a^+ - \lambda m_a^-)^\top v_y \tag{10}$$
其中 $\lambda \ge 0$ 控制非目标减法的强度。目标项与非目标项分别实现了 §3.3 得出的"匹配"与"共享亲和减除"两条要求。RAS 度量的是行为训练出的推荐空间里的 user-selective 兼容性;它不度量事实性、不估计因果偏好、也不代表普适的推荐效用。
4.4 强化学习¶
4.4.1 奖励构造¶
因为归一化的塔亲和落在 $[-1, 1]$,$\mathrm{RAS}_\lambda$ 的理论范围是 $[-(1+\lambda), 1+\lambda]$。把它映射到单位区间:
$$r_{\text{sem}}(y; a) = \mathrm{clip}_{[0,1]}\left(\frac{\mathrm{RAS}_\lambda(y;a) + (1+\lambda)}{2(1+\lambda)}\right) \tag{11}$$
令 $r_{\text{fmt}}(y) \in \{0, 1\}$ 指示输出是否为包含全部必需字段的合法 JSON 对象。最终奖励合并两项:
$$r(y; a) = \alpha\, r_{\text{sem}}(y; a) + (1-\alpha)\, r_{\text{fmt}}(y) \tag{12}$$
语义项度量 user-selective 的推荐器兼容性,格式项强制句法可解析性——但作者明确说明:格式项并不建立事实性基础。
4.4.2 训练与服务边界¶
这是全文的落地要点。只有冻结的打分器在训练期访问历史目标与非目标用户。 MLLM 接收的是直播帧、转写语音,以及由其输出诱导出的标量奖励;它从不接收用户标识符、历史或 embedding 作为输入。优化完成后,策略模型直接从直播内容生成单一共享描述,既不使用用户信息,也不调用打分器。作者用一句话总结这个定位:"这是一个用行为导出的用户监督训练出来的 content-only 策略,而不是面向个体用户的个性化生成器。"
5. 实验设置¶
三个研究问题:RQ1 RecoReward 与代表性 MLLM 在下游召回上的比较;RQ2 不同超参下的召回表现;RQ3 对线上直播推荐系统的影响。
5.1 数据集¶
离线数据集来自快手直播平台一周的观测用户行为,前六天训练、最后一天留作离线召回评测,构成严格的时序切分。训练数据含 69,947 个直播 item、7,392,141 条正向交互、1,042,130 个用户、56,443 个 author。对每条 query,正样本是训练期未观测到的一场直播,在共享候选全集上排序;同一用户的其他已知正向交互被 mask 掉,避免评测把它们当负样本。
5.2 策略训练¶
从对应的 Qwen3.5 模型初始化 4B 与 9B 两个策略。视觉编码器冻结,全部语言模型参数用 FSDP 更新。策略训练用 8,000 个具备完整多模态输入与充足异构用户反馈的直播 item;这些 RL 训练 item 都不出现在评测集里。在固定采样流程下,非目标用户是没有观测到正向交互的活跃用户。每个配置跑一个固定顺序的 epoch,共 500 个优化器步。优化使用学习率 $1\times10^{-6}$、非对称 clip 区间 $[1-0.2,\ 1+0.28]$、rollout 温度 1、top-$p$ 为 1、不做 top-$k$ 截断。语义与格式权重分别为 0.9 / 0.1。训练用 8 张 80GB GPU。
5.3 评测协议(matched-tower)¶
评测协议设计得相当严谨:对每个生成器,重新为同样的 69,947 个直播 item 生成描述,并在得到的描述分布上重新训练新的 DSSM。每个生成器训练 3 个不同随机种子的 DSSM,全局 batch size 8,192、学习率 $1\times10^{-3}$、weight decay $1\times10^{-4}$、对比温度 0.07,训练 3 个 epoch。随机种子度量的是评测器初始化引起的离散度,而非独立的 actor 训练。 所有模型共享同样的交互、架构、优化设置与冻结的次日召回 benchmark。
报告 HR@$K$ 与 NDCG@$K$($K \in \{10, 64, 128\}$)以及 MRR。设 $r_q$ 为 query $q$ 的目标直播排名,$\mathcal{Q}$ 为评测 query 集合:
$$\mathrm{HR@K} = \frac{1}{|\mathcal{Q}|}\sum_{q\in\mathcal{Q}} \mathbb{I}[r_q \le K] \tag{13}$$
$$\mathrm{NDCG@K} = \frac{1}{|\mathcal{Q}|}\sum_{q\in\mathcal{Q}} \frac{\mathbb{I}[r_q \le K]}{\log_2(r_q+1)} \tag{14}$$
$$\mathrm{MRR} = \frac{1}{|\mathcal{Q}|}\sum_{q\in\mathcal{Q}} \frac{1}{r_q} \tag{15}$$
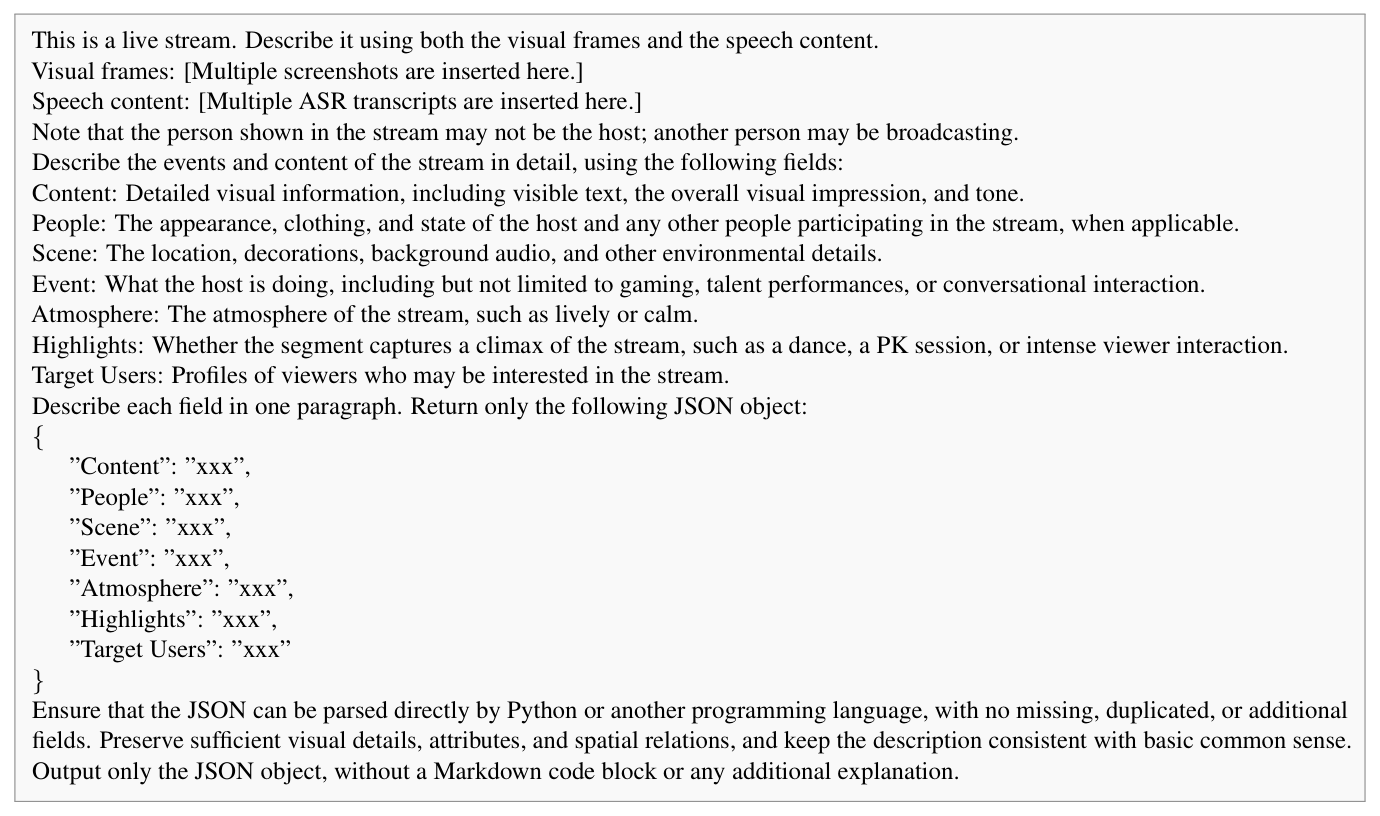
生成 prompt 见附录 Table 8:要求模型基于视觉帧与语音内容,输出含 Content / People / Scene / Event / Atmosphere / Highlights / Target Users 七个字段的 JSON,每字段一段话,且必须能被直接解析、无缺失/重复/多余字段。
6. 主要实验结果(RQ1)¶
Table 3 benchmark 上的整体召回表现(数值为 %,mean ± population std,跨 matched evaluator):
| Model | HR@10 ↑ | HR@64 ↑ | HR@128 ↑ | NDCG@10 ↑ | NDCG@64 ↑ | NDCG@128 ↑ | MRR ↑ |
|---|---|---|---|---|---|---|---|
| Non-MLLM Methods | |||||||
| DSSM [12] | 0.2292 ± 0.0099 | 1.3858 ± 0.0207 | 2.6884 ± 0.0722 | 0.1042 ± 0.0036 | 0.3336 ± 0.0019 | 0.5322 ± 0.0128 | 0.1725 ± 0.0025 |
| LightGCN [10] | 0.3009 ± 0.0188 | 1.5724 ± 0.0389 | 2.9404 ± 0.0451 | 0.1606 ± 0.0140 | 0.4149 ± 0.0053 | 0.6234 ± 0.0035 | 0.2296 ± 0.0102 |
| NextItNet [37] | 0.5865 ± 0.1091 | 3.2467 ± 0.1196 | 6.2128 ± 0.5687 | 0.2888 ± 0.0290 | 0.8191 ± 0.0374 | 1.2717 ± 0.0347 | 0.4149 ± 0.0540 |
| GRU4Rec [11] | 0.5791 ± 0.1254 | 3.0671 ± 0.0893 | 5.9253 ± 0.2929 | 0.2785 ± 0.0823 | 0.7781 ± 0.0787 | 1.2138 ± 0.0692 | 0.3989 ± 0.0660 |
| Commercial Models + DSSM | |||||||
| GPT-5 [20] | 0.7790 ± 0.0367 | 3.7555 ± 0.1743 | 6.4385 ± 0.2625 | 0.3445 ± 0.0180 | 0.9477 ± 0.0462 | 1.3577 ± 0.0597 | 0.4307 ± 0.0189 |
| Gemini-3.1-Pro [7] | 0.8943 ± 0.0247 | 4.0332 ± 0.0777 | 6.9300 ± 0.1660 | 0.4019 ± 0.0132 | 1.0371 ± 0.0201 | 1.4793 ± 0.0310 | 0.4841 ± 0.0117 |
| Open-Source Models + DSSM | |||||||
| Qwen3-VL-4B-Instruct [1] | 0.7996 ± 0.0245 | 4.0215 ± 0.0393 | 7.1210 ± 0.0683 | 0.3561 ± 0.0042 | 1.0081 ± 0.0088 | 1.4814 ± 0.0134 | 0.4596 ± 0.0011 |
| Qwen3-VL-8B-Instruct [1] | 0.8181 ± 0.0415 | 4.1787 ± 0.1350 | 7.1849 ± 0.1888 | 0.3664 ± 0.0245 | 1.0444 ± 0.0435 | 1.5028 ± 0.0470 | 0.4677 ± 0.0219 |
| Qwen3.5-4B [22] | 0.7721 ± 0.0927 | 3.6704 ± 0.3507 | 6.4266 ± 0.5331 | 0.3517 ± 0.0401 | 0.9371 ± 0.0928 | 1.3577 ± 0.1205 | 0.4424 ± 0.0367 |
| Qwen3.5-9B [22] | 0.7577 ± 0.0238 | 3.6026 ± 0.1168 | 6.2489 ± 0.1832 | 0.3392 ± 0.0076 | 0.9129 ± 0.0265 | 1.3166 ± 0.0359 | 0.4259 ± 0.0079 |
| InternVL3-8B [42] | 0.6894 ± 0.0688 | 3.3061 ± 0.2219 | 5.8540 ± 0.2906 | 0.3118 ± 0.0305 | 0.8401 ± 0.0641 | 1.2284 ± 0.0745 | 0.4004 ± 0.0270 |
| InternVL3.5-4B [30] | 0.6414 ± 0.0663 | 3.3502 ± 0.2930 | 5.9787 ± 0.4395 | 0.2780 ± 0.0276 | 0.8244 ± 0.0731 | 1.2254 ± 0.0953 | 0.3750 ± 0.0254 |
| InternVL3.5-8B [30] | 0.6731 ± 0.0701 | 3.5165 ± 0.2133 | 6.2287 ± 0.3731 | 0.2973 ± 0.0332 | 0.8681 ± 0.0619 | 1.2816 ± 0.0842 | 0.3971 ± 0.0303 |
| Ours + DSSM | |||||||
| RecoReward-4B | 0.9211 ± 0.0864 | 4.8315 ± 0.2684 | 8.4187 ± 0.4224 | 0.4177 ± 0.0461 | 1.2095 ± 0.0844 | 1.7572 ± 0.1074 | 0.5391 ± 0.0436 |
| RecoReward-9B | 0.9978 ± 0.0289 | 5.0577 ± 0.1379 | 8.6597 ± 0.1871 | 0.4509 ± 0.0257 | 1.2701 ± 0.0416 | 1.8199 ± 0.0483 | 0.5646 ± 0.0271 |
结论分析:
- RecoReward-9B 在七个指标上全面第一,胜过所有非 MLLM baseline。相对 Qwen3.5-9B 底座,NDCG@128 从 0.013166 提到 0.018199、HR@128 从 0.062489 提到 0.086597,七个指标提升幅度 31.7–40.4%。
- RecoReward-4B 也强于所有未经优化的 8B / 9B 模型——包括 GPT-5、Gemini-3.1-Pro、Qwen3-VL-8B、InternVL3.5-8B。这说明"是否对齐下游行为"比"参数量"更决定描述的推荐价值。
- 最锋利的一条观察:在开源 baseline 里,召回表现并不随模型规模单调上升——Qwen3.5-9B 在全部七个指标上都输给 Qwen3.5-4B。作者据此论证:当生成目标里缺少下游行为信号时,更大的模型规模并不保证更高的推荐效用。这直接支撑了本文把下游推荐行为纳入训练目标的动机。
- 两个商业模型的表现介于开源模型之间(Gemini-3.1-Pro 在 HR@10/NDCG@10 上强,但 HR@128 反而不如 Qwen3-VL 系列),进一步说明通用生成质量与推荐效用是两个不同的坐标轴。
7. 消融与分析(RQ2)¶
RQ2 考察三个影响奖励构造与策略优化的设置:非目标减法系数、rollout 数量、参与奖励计算的用户数量。
7.1 非目标减法系数 $\lambda$¶
在固定数据、模型初始化与评测协议的前提下变动 $\lambda$。$\lambda = 0$ 即 target-only、无减法的 baseline。
Table 4 不同 $\lambda$ 的召回表现(%,三个评测器种子的整体均值):
| $\lambda$ | NDCG@64 ↑ | NDCG@128 ↑ | HR@64 ↑ | HR@128 ↑ | MRR ↑ |
|---|---|---|---|---|---|
| 0 | 0.9663 | 1.4118 | 3.8698 | 6.7874 | 0.4417 |
| 0.5 | 1.0857 | 1.5716 | 4.3333 | 7.5160 | 0.4856 |
| 1 | 1.0755 | 1.5291 | 4.2296 | 7.2027 | 0.4906 |
| 2 | 1.2095 | 1.7572 | 4.8315 | 8.4187 | 0.5391 |
分析:所有正系数配置在五个指标上都优于 target-only 行;$\lambda = 2$ 在所有召回指标上给出最强策略。相对 $\lambda = 0$,该配置把 NDCG@128 从 0.014118 提到 0.017572、HR@128 从 0.067874 提到 0.084187、MRR 从 0.004417 提到 0.005391。作者对 $\lambda = 0.5$ 与 $\lambda = 1$ 的非单调现象给了机制解释:$\lambda = 0.5$ 施加更温和的非目标惩罚、保留更多目标亲和信号,因而在 NDCG@64/128 与 HR@64/128 上更高;而 $\lambda = 1$ 更高的 MRR 说明更强的减法会锐化 top-ranked 排序,尽管在更深的截断处表现更差。到 $\lambda = 2$,对"同时匹配两个用户组"的描述做激进抑制,产生了更 user-selective 的奖励排序与更清晰的相对优势,与 §3.2 的行为发现一致。"增大 $\lambda$ 并不总是更好"——这条非单调性被作者如实写出,没有粉饰。
7.2 Rollout 数量 $G$¶
$G$ 同时决定每个输入采样多少条描述、以及用多少样本估计群体相对优势。固定 batch size、数据顺序、学习率、优化器步预算与评测协议。
Table 5 不同 rollout 数 $G$ 的召回表现(%):
| $G$ | NDCG@64 ↑ | NDCG@128 ↑ | HR@64 ↑ | HR@128 ↑ | MRR ↑ |
|---|---|---|---|---|---|
| 4 | 1.0575 | 1.5099 | 4.1435 | 7.1072 | 0.4872 |
| 8 | 1.0755 | 1.5291 | 4.2296 | 7.2027 | 0.4906 |
| 12 | 1.1770 | 1.6528 | 4.6122 | 7.7258 | 0.5315 |
| 16 | 1.1516 | 1.6606 | 4.5647 | 7.8990 | 0.5182 |
分析:每个 rollout 设置都胜过 Table 3 里的 Qwen3.5-4B baseline。$G$ 从 4 增到 12 时五个指标全部改善——一个合理解释是更大的组覆盖更宽的描述分布、提供更丰富的组内比较,提高了观察到有用高奖励输出的概率并产出更有信息量的相对优势。但 $G=16$ 时趋势不再一致:NDCG@128 与 HR@128 继续改善,而 NDCG@64、HR@64、MRR 下降。作者的解释非常克制且切中要害:样本更多时,组内更可能包含来自高 RAS 尾部的输出;这些样本会得到很强的正优势,把策略推向代理奖励偏好的模式。因为 RAS 是近似而非直接度量推荐效用,对这类尾部行为做更强的优化可能损害泛化。 结论是当前设置下 $G=12$ 在输出探索与代理奖励过优化之间取得更好平衡;作者同时声明这是描述性解读(每个配置只跑一次 actor,更大的 $G$ 也增加了采样轨迹总数)。
7.3 奖励用户数量 $M$¶
用户上限 $M$ 控制 RAS 两侧各自平均的目标用户数(非目标用户数相同)。固定直播 item、用户顺序、模型初始化、rollout 数、优化器设置与 matched-tower 评测协议。
Table 6 不同奖励用户上限 $M$ 的召回表现(%):
| $M$ | NDCG@64 ↑ | NDCG@128 ↑ | HR@64 ↑ | HR@128 ↑ | MRR ↑ |
|---|---|---|---|---|---|
| 25 | 1.1636 | 1.6475 | 4.5281 | 7.6966 | 0.5376 |
| 50 | 1.1230 | 1.6087 | 4.4232 | 7.6085 | 0.5110 |
| 100 | 1.0755 | 1.5291 | 4.2296 | 7.2027 | 0.4906 |
| 200 | 1.0606 | 1.5015 | 4.1670 | 7.0564 | 0.4842 |
分析:$M = 25$ 在五个指标上全面最强,且性能随 $M$ 单调下降(25 > 50 > 100 > 200)。相对 $M = 100$,$M = 25$ 把 NDCG@128 从 0.015291 提到 0.016475、HR@128 从 0.072027 提到 0.076966、MRR 从 0.004906 提到 0.005376。作者指出这里存在 user selectivity 与 estimation stability 的权衡:增大 $M$ 得到更稳定的亲和估计,但会削弱 target–non-target 的对比,使奖励对策略学习的信息量降低。在实测范围内,$M = 25$ 保留了更锐利的 user-selective 信号。这个结论有点反直觉——通常人们会预期更大的用户样本更好——但在"奖励要能区分候选"的目标下,平均得太狠反而把可优化的差异抹平了。
8. 在线 A/B 实验(RQ3)¶
在快手直播服务上做了一周的系统级 A/B 测试。Effective-user penetration 度量在关键页面上满足平台定义的有效观看标准的用户占比;Outflow exposure 与 users 分别度量通过外流流量触达的曝光数与独立用户数。
Table 7 RecoReward 一周在线 A/B 结果:
| System | Key Pages — Effective-User Penetration | Outflow — Exposure | Outflow — Users |
|---|---|---|---|
| Kuaishou | +0.265% | +0.791% | +0.740% |
分析:RecoReward 把关键页面的有效用户渗透率提升 0.265%,同时把外流曝光与外流用户分别提升 0.791% 与 0.740%。作者的解读是:推荐对齐的语义建模既提升了关键页面的用户参与度,也扩大了直播在真实部署中的分发范围。 值得注意的是外流指标的提升幅度(约 0.79%/0.74%)明显大于关键页面渗透率(0.265%),暗示更 user-selective 的 item 描述主要帮助把直播内容匹配到关键页面之外的更多流量场景——这与 RAS 的设计意图(提高目标用户特异性,从而在更宽的候选池里被正确召回)是自洽的。
9. 定性对比(附录 B)¶
作者用同样的多模态输入与结构化 prompt,在四个直播样例上对比五个模型(GPT-5、Gemini-3.1-Pro、Qwen3-VL-8B、InternVL3.5-8B、RecoReward-4B),展示 Event 与 Target Users 两个字段的完整英文翻译。绿色粗体标记 RecoReward 捕捉到的推荐相关细节,红色粗体标记其他模型里不正确、无依据或过度泛化的细节。作者明确声明:这些样例是为了展示语义强调的差异而挑选的,不是随机样本;聚合性能结论仍以 §5.2 的 matched-tower 评测为准。
- 本地美食售卖(Table 9):RecoReward 保留了具体的"引导到店"动作、产品尺寸与肥瘦讨论、以及非正式互动风格。两个商业模型恢复了若干有用的交易细节,但其余开源模型把卤味与烤肉/烧烤混淆,并产出更宽泛的目标用户描述。
- 装饰画售卖(Table 10):RecoReward 同时描述了可见的指点动作、珠光工艺、风水布局,以及画作对不同墙面布局的调整。GPT-5、Gemini-3.1-Pro、Qwen3-VL-8B 也保留了大部分产品叙述,但其目标用户描述外推到了收藏家、投资者或高端消费者却无直接证据;InternVL3.5 的输出保留了主题但漏掉了大量工艺与陈设信息。
- 日常生活闲聊(Table 11):RecoReward 保留了"教新学员"与"雇专业厨师"之间的区分,同时刻画了非正式互动风格。Qwen3-VL-8B 错误地把两件事合并成"教学员做饭",还有几个描述把这场直播映射到宽泛的学习或家务兴趣人群。
- 球鞋售卖(Table 12):RecoReward 跟随销售序列,包括重新摆放鞋子对比黑白配色、查库存、解释包装与验货流程。其他模型要么恢复了主交易但省略这一序列,要么补上了输入不支持的人口属性与产品细节。
这组定性对比的价值在于:它把"user-selective 奖励到底改变了什么"落到了可读的文本层面——RecoReward 倾向于保留具体的、可核验的交易/互动动作,而未优化模型倾向于生成听上去合理但缺乏输入依据的目标人群标签(例如"收藏家""投资者""高端消费者")。后者正是 §3.3 说的"泛化描述",它对目标用户的区分力很弱。
10. 核心贡献总结¶
- 提出了一个干净的"训练期用用户、推理期不用用户"的接口设计。把行为训练出的双塔当作训练期打分器,让用户监督只通过奖励进入生成器,从而同时拿到 user-informed 与 content-only inference 两个此前互斥的性质(Figure 1(c))。
- RAS:一个对比式的 user-selective 奖励。$\mathrm{RAS}_\lambda = S^+ - \lambda S^-$ 通过减去非目标用户中心来剥离"广泛共享的亲和",并且由于内积线性性,计算只需两个物化中心向量,成本与用户数无关。
- 先做行为分析、再设计奖励的方法论。§3 的时序分离协议先量化"代理中心被全局用户成分污染"(余弦 0.7752 / 0.9255 → 残差 0.0960)、再验证"减法提升未来用户判别力"(ROC-AUC 0.7603 → 0.8052),最后才把结论形式化成奖励。这比直接拍一个奖励函数要扎实得多。
- 严谨的 matched-tower 评测协议。为每个生成器重新训练 DSSM,用 3 个评测器种子报告均值与标准差,隔离了"描述分布"这一唯一变量。
- 一个对工业界有价值的负面观察:开源 MLLM 的召回表现不随规模单调上升(Qwen3.5-9B < Qwen3.5-4B),说明通用生成能力的 scaling 不自动转化为推荐效用。
11. 与已归档相关工作的对比¶
Taiji Taiji: Pareto Optimal Policy Optimization(Kuaishou,2026-06-02)¶
关系:独立并发(本文未引用 Taiji,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都属 LLM-as-Enhancer 路线,都在解同一个 root cause——LLM/MLLM 生成的语义内容与下游推荐目标错位:模型按语言似然或内容保真去生成,但推荐系统真正需要的是"能区分目标用户"的语义。两者也都刻意保持 LLM 与在线服务解耦(Taiji 走近线推理产出稀疏特征,RecoReward 走 content-only 离线生成共享描述),避免把 LLM 塞进在线打分链路。
- 相近的技术骨架:都是"冻结/外部的推荐模型给生成文本打分 → 标量 reward → 群体相对策略优化(GRPO 系)训练 LLM 生成器 → 生成结果作为特征喂给下游推荐模型"。Taiji 的推荐协同奖励 $r_{id}$ 来自广告 CTCVR 模型,RecoReward 的 $r_{\text{sem}}$ 来自冻结 DSSM 的双塔亲和;两者都把"语义/格式"与"推荐效用"两类异构信号做加权组合。
- 本文的差异与推进:Taiji 的重心在多奖励之间的动态权衡——POPO 在跨域空间自适应调整语义奖励与推荐奖励的权重,追求 Pareto 前沿并给出理论保证。RecoReward 的重心在单个推荐奖励本身的构造质量——它认为直接拿推荐器打分当 reward 是不够的,因为代理中心被"全局用户成分"污染,必须做对比式减法(减非目标中心)才能得到 user-selective 的信号。换言之,Taiji 在问"两类奖励怎么配比",RecoReward 在问"推荐奖励本身该怎么定义"。另一个关键差异是生成对象:Taiji 生成的是用户侧偏好推理 CoT(用户画像 + 行为序列 → CoT),RecoReward 生成的是物品侧共享描述,且严格禁止用户信息进入生成器输入以保住 item 描述"编码一次、复用多次"的可缓存性——这一点 Taiji 没有约束(它本来就是 per-user 近线推理)。
- 可比的方法/实验差异:Taiji 用 DeepSeek-R1-7B + QwQ-32B teacher 蒸馏 CoT,先 SFT(ORFT)再 RL;RecoReward 直接从 Qwen3.5-4B/9B 出发不做 SFT、纯 RL(500 步),只靠格式奖励约束输出 schema。业务侧 Taiji 报告快手广告 +2.83% ADVV / +3.30% Revenue,RecoReward 报告快手直播关键页面有效用户渗透 +0.265% 与外流曝光/用户 +0.791%/+0.740%,两者场景(广告 vs 直播分发)与指标口径不同,不能直接比较量级。
RPORec RPORec: Reinforced Preference Optimization for Reasoning-Augmented Recommendations(CityU × Kuaishou,2026-05-21)¶
关系:独立并发(本文未引用 RPORec)· 已加载对方精读
- 共同关注的问题:两篇都在处理"把 LLM 接进推荐系统时该用什么接口"。RPORec 明确拒绝 hidden-state 耦合(会侵蚀 backbone 推理能力)而选择文本作为 LLM 与推荐头之间的接口;RecoReward 同样把生成的结构化文本描述当作 MLLM 与 DSSM item tower 之间的唯一接口,并且拒绝把用户信息灌进生成器输入。两者都把"接口选择"当成一等的设计决策,而不是实现细节。
- 相近的技术骨架:冻结一个轻量推荐打分器当 verifier / reward source,用它对 LLM 生成的文本打分,再用 GRPO 反向精炼生成器;奖励都是"格式项 + 推荐效用项"的多路组合。RPORec 的 Rechead 是一个带 soft adapter 的检索头,输出 $s(u,v) = h_u^\top h_v$;RecoReward 的打分器是 DSSM,输出 $s(u_i,y) = u_i^\top v_y$——两者都是共享空间点积检索打分,都在训练策略期间保持冻结以提供稳定 reward。
- 本文的差异与推进:最大的结构差异是生成方向相反。RPORec 生成用户侧内容(
<think>CoT +<answer>预测 item 的标题与属性),推理时仍需要用户历史作为输入,本质上是 per-user 的在线推理;RecoReward 生成物品侧描述,推理时完全不需要用户,产出可被全量用户复用的单一共享特征。这直接决定了两者的服务成本模型截然不同。其次,RPORec 的 reward 是"ground-truth item 是否被 Rechead 排到前面"的 verifiable reward(NDCG 式),本质上是有监督标签驱动;RecoReward 没有可验证的 ground-truth 描述,reward 完全来自用户群中心的对比式亲和,因此它必须额外解决"代理不纯"的问题——这是 RPORec 不需要面对的。 - 可比的方法/实验差异:RPORec 采用两阶段迭代(Stage I 冻 backbone 训 Rechead,Stage II 冻 Rechead 训 backbone),RecoReward 的双塔打分器则是一次性预训练后全程冻结,不做迭代互训——这既是简化也是局限(打分器无法随策略分布漂移而更新)。评测上 RPORec 在三个 Amazon 数据集 + 4000 万用户广告 A/B(Revenue +1.348%),RecoReward 在快手直播自建 benchmark + 一周系统级 A/B。
AdaGRPO AdaGRPO: Adaptive Loss Balancing for Noise-Robust GRPO(JD.com,2026-06-07)¶
关系:独立并发(本文未引用 AdaGRPO)· 已加载对方精读
- 共同关注的问题:两篇指向同一个被低估的 root cause——把一个在观测行为日志上训练出来的推荐模型当作 reward model,这个 reward 本身是被污染的、不可直接信任的。AdaGRPO 的诊断是曝光偏置:production ranker 在长尾/未曝光 item 上不可靠,会把流行干扰项排到 ground truth 之上。RecoReward 的诊断是"共享亲和污染":历史目标用户中心与全局用户中心的余弦高达 0.7752,直接对它打分会奖励那些同时匹配目标和非目标用户的泛化描述。两者都不满足于"设计更强的奖励",而是先去问"这个 reward 在什么条件下才可信/才有区分力"。
- 相近的技术骨架:都是"先做一轮实证诊断量化 reward 的失效模式 → 据此在 GRPO 之上加一个校正机制"。AdaGRPO 用 beam 排序 vs reward 排序的位移 $\Delta = \mathrm{idx}_{\mathrm{LLM}} - \mathrm{idx}_{\mathrm{RM}}$ 做分层分析;RecoReward 用时序分离的四组用户 + 固定候选集做代理/修正方向对比(disagreement rate 47.4%、ROC-AUC 0.7603 → 0.8052)。两篇的实证章节在方法论上高度同构:都先证明"朴素用法的聚合收益接近零或被掩盖",再证明"某个条件化/校正后收益显著"。
- 本文的差异与推进:校正机制的作用域完全不同。AdaGRPO 在样本域动手——用 policy-side difficulty 与 reward discriminability 两个 rollout 诊断做逐样本二值 gating,不可信的样本退化为纯 NLL 监督更新,本质是"把 PPO 的 clip 从 ratio 域抬到 sample 域"。RecoReward 在奖励值域动手——不丢弃任何样本,而是通过 $S^+ - \lambda S^-$ 从每个样本的 reward 里减掉背景成分。前者是"选择性准入",后者是"信号提纯"。两者理论上正交,可以叠加。
- 可比的方法/实验差异:AdaGRPO 的策略生成 SID(离散 item 标识符序列,有唯一 ground truth),因此它能用 hit-rate 类可验证信号做诊断;RecoReward 的策略生成自然语言描述(开放式、无唯一正解),只能依赖推荐器打分本身,这也是它必须靠"对比减法"而非"正确性验证"来净化奖励的根本原因。另一个有意思的呼应:AdaGRPO 担心 easy 样本上 advantage 坍缩导致 RM 噪声主导梯度、诱发 over-optimization;RecoReward 在 $G=16$ 的 rollout 消融里观察到了同一类现象——更大的组更容易采到高 RAS 尾部样本,强正优势把策略推向代理奖励偏好的模式,反而损害泛化。两篇从不同路径撞上了同一个 reward over-optimization 边界。
12. 讨论与局限性¶
12.1 值得借鉴的设计¶
(1)"训练期接口"这个抽象很有迁移价值。 本文最漂亮的一点不是 RAS 公式本身,而是把"用户信息该在哪一层进入系统"当作一个可设计的边界:user-conditioned 方法让用户信息进入生成器输入,代价是 item 表示不再可复用;RecoReward 让用户信息只进入奖励函数,于是 serving 侧完全无感。任何"内容侧模型 + 行为侧模型"的组合都可以套用这个模式。
(2)对比式奖励构造 + 线性性带来的零成本。 因为塔是内积结构,"对 $M$ 个用户的分数求平均"等价于"对用户中心求内积",所以 RAS 无论用多少用户,在线计算都只是两个向量的内积。这让"用大量用户估计 reward"在工程上变得免费——尽管消融告诉我们用户不是越多越好($M=25$ 最优)。
(3)把 author ID 排除出 item tower 输入。 这是一个容易被忽略但很关键的细节:如果 $v_y$ 里含有 author ID embedding,那么同一场直播的不同描述之间的分数差异会被身份特征而非语义内容主导,奖励就失去了区分候选描述的能力。
(4)matched-tower 评测协议。 为每个生成器重训 DSSM、跑 3 个种子报告标准差,是"评测生成内容对下游推荐的价值"这类任务里比较可信的做法,值得作为该方向的评测模板。
12.2 局限与争议¶
作者自己在附录 D 里给了三条相当坦率的局限,我认为都成立且值得放大:
(1)RAS 完全构建在观测性用户行为之上。 历史目标用户只是未来目标用户的近似;非目标用户是"没有观测到正向交互的活跃用户",不是曝光负样本。曝光模式、item 流行度、先前的推荐器策略都会同时影响这两组,因此 RAS 不应被解读为因果用户偏好。这一点在实践中意味着:RAS 会继承线上系统已有的偏置,存在"推荐器教 MLLM 生成推荐器已经偏好的东西"的自我强化回路风险。
(2)RAS 评的是冻结双塔空间里的 user-selective 兼容性,不是事实准确性或描述质量。 高分可以来自那些能区分用户群、但未必被多模态输入完全支持的细节;更强的 RL 优化可能放大这类特定于代理奖励的模式。作者明确说需要独立的事实性与 grounding 评测来判断这个 trade-off 如何随优化强度变化——而本文没有做这项评测,这是最大的实证缺口。格式奖励 $r_{\text{fmt}}$ 只保证 JSON 可解析,完全不约束事实性。附录 B 的定性对比虽然用绿/红标注了正确与无依据的细节,但这是人工挑选的样例、不是系统性度量。
(3)实证范围窄。 只在一个平台的直播推荐上验证,使用固定的结构化 prompt 和 matched 双塔召回评测。三个报告种子变的是评测器初始化而非策略训练,每个 ablation 设置只跑一次 actor run——这意味着 Table 4/5/6 里那些 0.02–0.05 个百分点量级的差异,其策略侧方差是未知的,作者因此明确要求消融解释"应按描述性理解"。结论不能外推到其他推荐域、语言、输出 schema 或推荐器架构。
(4)我额外补充的两点观察:
- 打分器全程冻结带来分布漂移风险。 策略在 500 步 RL 后生成的描述分布已经显著偏离双塔训练时见过的描述分布,而打分器不做任何更新。RPORec 用两阶段迭代互训来缓解同类问题,本文没有;这可能正是 $G=16$ 出现指标倒挂的部分原因。
- 在线 A/B 是系统级而非严格的单变量对照。 论文只给了三个正向指标(+0.265% / +0.791% / +0.740%),没有报告置信区间、流量占比或负向护栏指标。0.265% 这个量级在直播大盘上是否具备统计显著性,读者无法从文中判断。
12.3 与已有工作的核心差异¶
一句话总结本文在文献坐标系里的位置:Rec-R1 / CURec / VRAgent-R1 把推荐信号引入生成,但代价是生成变成 user-dependent;SARM / RLMRec / NoteLLM-2 保持了 item 侧表示的可复用性,但生成过程本身不受推荐目标引导。RecoReward 是第一个明确把这两件事拆开的工作——让推荐信号只走"训练期奖励"这一条通道,从而同时拿到 user-informed 训练与 content-only 服务。 RAS 的对比式构造(减非目标中心)则是这条通道上的关键净化步骤,也是本文相对同期 recommender-as-reward 工作(Taiji、AdaGRPO)最独特的技术贡献。