GR2 Technical Report 精读¶
Meta AI 的 Generative Reasoning Re-Ranker(GR2)。核心命题:工业推荐漏斗里离用户最近、对参与度影响最大的 re-ranking(重排) 环节,至今仍在用 point-wise CTR 打分,完全没吃到 LLM 的世界知识与显式推理红利。GR2 把 LLM 的 chain-of-thought 推理第一次系统地带进工业重排,用「语义 ID mid-training + 更强 teacher 蒸馏推理链 + 可验证奖励 RL」三段式端到端框架,再叠加四项工业落地改造(context 压缩、On-Policy Distillation 替代 SFT、推理内化去 CoT、剪枝/KV cache),在工业级流量上取得 +18.7% R@1 / +7.1% R@3 / +9.6% N@3,并把 serving ROI 提升约 15×。论文的一个关键发现:重排里 奖励设计是成败核心——LLM 极易通过「保持输入顺序」或「利用位置偏置」来 hack 奖励,因此 conditional verifiable reward(条件可验证奖励) 是工业组件里不可或缺的一环。
1. 研究动机与背景¶
1.1 重排是漏斗里被 LLM 忽视的最后一公里¶
工业推荐系统通过一条多阶段漏斗服务数十亿用户:retrieval(召回)→ early-stage ranking(粗排/精排)→ re-ranking(重排)。其中最终的重排步骤对用户实际看到、交互的内容具有不成比例的决定权——尤其在 carousel(轮播)与 grid(网格)展示格式里,顶部位置主导了绝大部分参与度。
尽管 LLM 在推荐上热度高涨,工业落地却存在三个结构性缺口,恰好把重排留在了原地:
- (G1) Reasoning is left on the table(推理被闲置):LLM 通常以 zero-shot 或在朴素 ranking label 上做 supervised fine-tuning 的方式部署,而 CoT 能力最有效的激发方式——基于可验证奖励的 RL——在重排里几乎没人用。
- (G2) Vocabulary mismatch(词表错配):工业目录用非语义 identifier 索引数十亿 item,这些 ID 落在任何 base-LLM 词表之外,直接破坏了模型对候选做语义推理的能力。
- (G3) Industrial-scale tax(工业规模税):朴素做法带来高昂训练成本、长思维链导致的低 serving 吞吐,以及——本文重点揭示的——reward hacking,它会虚高离线指标却不反映真实排序质量。
现有 LLM 重排工作大多聚焦召回与粗排,工业重排器仍依赖 point-wise CTR 打分,不对用户意图或 item 语义做任何显式推理。GR2 的立意就是补齐这最后一公里。
1.2 GR2:三段式流水线 + 四项工业改造¶
GR2(Generative Reasoning Re-Ranker)建立在一条面向大规模重排定制的三段式训练流水线上(Figure 1):
- First — SID mid-training:一个预训练 student LLM(如 Qwen3-8B)在由 tokenizer 产出的 semantic item ID(SID) 上做 mid-training,该 tokenizer 达到 ≥99% uniqueness,让模型无需词表爆炸就能识别、泛化整个目录。
- Second — 推理链蒸馏:用更强的 teacher(如 Qwen3-32B),配合重排专用模板,通过 targeted sampling(定向采样) 与 rejection sampling(拒绝采样) 生成分层推理轨迹,SFT 出一个把 student 推理锚定在用户行为与 item 语义上的高质量语料。
- Third — 可验证奖励 RL:改造 DAPO,配一个重排专用的多组件奖励——format 项 + 基于 AUC/NDCG 的可验证 ranking 项 + 可选的 LLM-as-a-judge 推理项,提供可扩展、奖励驱动的监督。
在此之上,为让 GR2 真正工业可行,论文再补三/四项改造:
- (iv) Context Compressor(上下文压缩器):把输入长度砍 >80%,同时匹配 full-context 质量,摊薄训练成本。
- On-Policy Distillation(OPD)作为 SFT 的可扩展替代——作者发现 naive SFT 在工业规模会崩溃,而一个 1.7B 的 OPD student 在 5% 参数量下能恢复 32B teacher 增益的 ≈82%。
- De-hacking conditional reward(去 hack 的条件奖励):不加约束时模型会学会「保持输入顺序」或「利用位置偏置」来刷奖励。
- Reasoning distillation(推理内化):把 CoT 内化进一个 non-thinking 策略,在 iso-quality 下带来 ~15× serving ROI。
1.3 六大贡献¶
- Re-ranking-first LLM design:区别于把 LLM 适配到召回/粗排的前作,本文确立了 LLM-based 重排的设计原则,并证明 LLM 世界知识与推理可转化为可度量的排序增益。
- Semantic-ID mid-training:一套把非语义 item ID 转成 SID(≥99% uniqueness)的 tokenization 方案,配合「SID + 世界知识」混合 mid-training 语料,让 LLM 直接在目录上推理。
- Reasoning activation pipeline:重排专用 prompt + targeted/rejection sampling 产出分层推理轨迹,SFT(工业规模用 OPD)在这些轨迹上安装一个纯 RL 无法恢复的推理先验。
- Verifiable-reward RL for re-ranking:DAPO 的重排定制版 + 多组件奖励;识别并缓解两种 reward-hacking 模式(保持输入顺序 与 利用位置偏置),靠 conditional verifiable reward 与去偏训练数据。
- Industrial adaptations:context 压缩、OPD 蒸馏、CoT 内化服务——每项都做了消融量化其对部署可行性的贡献。
- Comprehensive evaluation:GR2 在工业流量上 +18.7% R@1 / +9.6% N@3,且在随后 9 天服务中无衰减;消融确认 OPD 提供推理先验、RL 在其上锐化排序目标。
2. 核心方法:GR2 四阶段框架总览¶
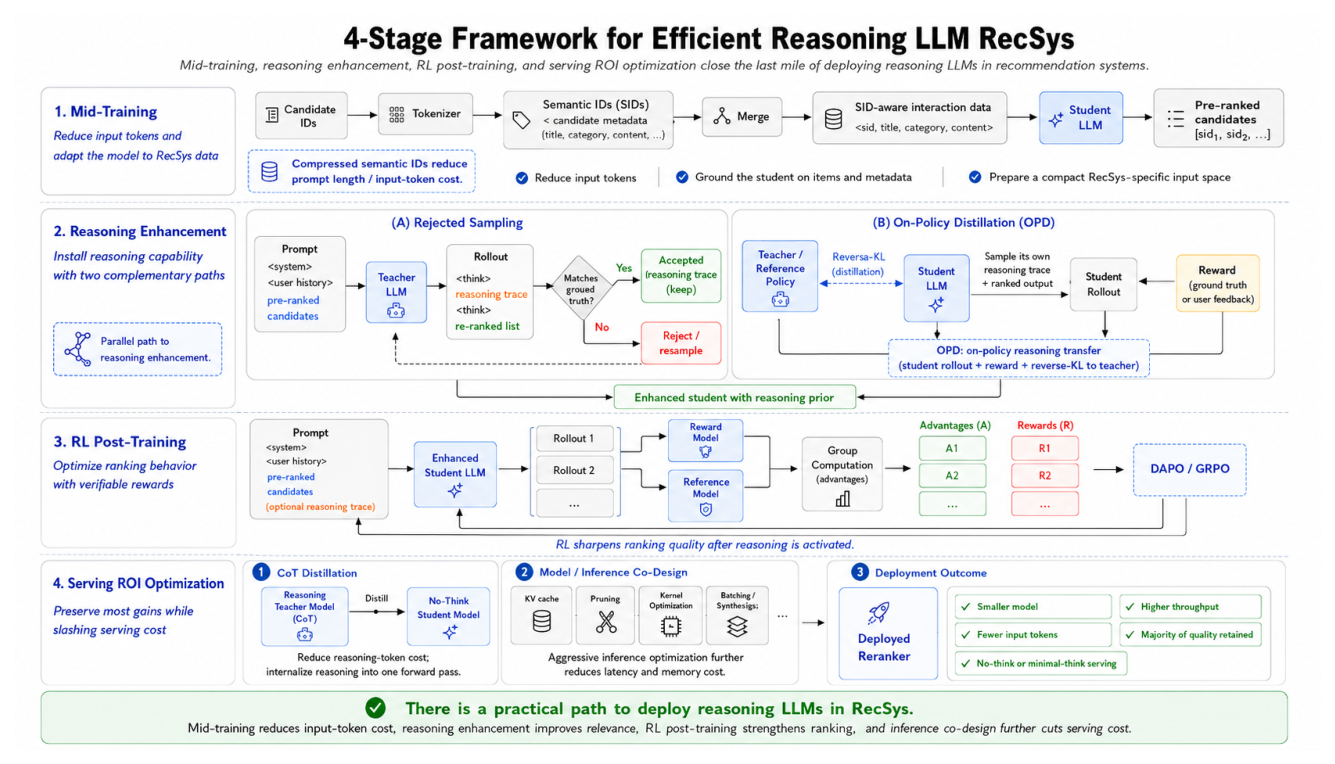
如 Figure 1,四个阶段各司其职、层层递进:
- 阶段 1 Mid-Training:把预训练 LLM 适配到 RecSys 输入,用 SID 压缩 prompt,把 student grounding 到 item 与 metadata(§2)。
- 阶段 2 Reasoning Enhancement:安装推理能力,两条互补路径——(A) Rejected Sampling(拒绝采样)与 (B) On-Policy Distillation(OPD),得到带推理先验的增强 student(§3)。
- 阶段 3 RL Post-Training:在推理先验之上,用可验证奖励通过 DAPO/GRPO 锐化排序质量(§4)。
- 阶段 4 Serving ROI Optimization:CoT 蒸馏成 no-think student、model/inference 协同设计(KV cache、pruning、量化),落地一个「更小模型、更高吞吐、丢弃 CoT、保留多数质量」的 Deployed Reranker(§5)。
论文用一句话给整篇定调:「There is a practical path to deploy reasoning LLMs in RecSys.」 下面逐阶段展开。
3. 阶段 1:Tokenized Mid-Training(§2)¶
要得到 LLM-based 生成式推荐器,两个关键组件是 tokenization 与 mid-training。GR2 沿用其前作(Liang et al., 2026)的生成式检索 mid-training 工作流。
3.1 Tokenizer 与 Semantic ID(SID)¶
学习所谓的 semantic ID(SID) 已被推荐系统广泛采纳,用来缓解大 embedding table 的泛化问题。奠基工作 TIGER(Rajput et al., 2023) 首次把该技术用于序列推荐。给定 item 的文本特征 $x$,tokenizer 把它映射成一串离散整数——一个紧凑的符号表示:
$$\mathrm{Tokenizer}(x) = (z_1, z_2, \ldots, z_K) \tag{1}$$
最终表示是集合 $\{1, \ldots, C_1\} \times \cdots \times \{1, \ldots, C_K\}$ 的一个成员,其中 $C_i$ 是第 $i$ 层 codebook 的基数。tokenizer 核心是一个 RQ-VAE(Residual-Quantized VAE,Lee et al., 2022)。SID token 作为 special token 加入词表。GR2 的 tokenizer 达到 ≥99% uniqueness(即绝大多数 item 拥有独一无二的 SID,几乎无碰撞),这是它能在数十亿目录上做无损语义推理的前提。
3.2 Mid-Training via Multi-Task Learning¶
TIGER 纯在 SID 序列上训练一个自回归模型。到了 LLM 时代,利用预训练 LM 里编码的世界知识成为重要方向。为此 OneRec(Liu et al., 2025)引入了一个 mid-training 阶段,称为 'item alignment':让 LLM 把推荐知识与语言(即 SID 与 LLM 语言空间)对齐。具体思路是 在单个序列里交错(interleave)SID 与自然语言 token,在 next-token prediction 目标下优化 SID embedding table。GR2 的 mid-training 任务沿用前作设计。这一步同时解决了 §1 的 (G2) 词表错配——SID 进了词表、且被 grounding 到语义。
4. 阶段 2:Reasoning Enhancement(§3)¶
本阶段设计重排专用的推理增强。§3.1 给出一个把 item 表示 grounding 到 SID 的 chat-format 训练样本结构,支持结构化 JSON 输出的 CoT;§3.2 给出两种互补的高质量推理轨迹生成策略——targeted sampling(借 ground-truth 引导)与 rejection sampling(迭代验证保证推理真实性),配五条 prompt 设计原则。
4.1 推理数据的 Chat 模板¶
训练样本构造成三种消息角色的 chat 结构,遵循六条原则:
- Role-based System Prompt:system 消息实例化一个「分析师」人设,指定重排目标,激活领域推理,但不引入购买意图或说服框架(避免模型走向营销话术)。
- Rich Item Metadata:每个 item 带 title 与 category 层级,支持语义与品类感知推理。
- Unified Item Format:历史 item 与候选 item 共享同一结构格式(SID + title + categories),保证跨输入上下文的表示学习一致。
- Chain-of-Thought Reasoning Trace:assistant 回复包含逐步推理,显式用 SID 引用具体 item,产出 grounded、可验证的轨迹。
- Structured JSON Output:回复是一个含「推理解释 + 排序列表」的 JSON 对象,支持确定性解析与评估。
4.2 推理轨迹生成:Targeted 与 Rejection Sampling¶
Targeted Sampling(定向采样):提供目标 item $\mathbf{s}_{v_{n+1}}$ 与最近 $k$ 个历史 item,查询一个更大的 LLM 生成解释该目标交互的推理轨迹 $\tau$:
$$\tau \sim P_\theta\bigl(\cdot \mid \mathcal{P}_{\mathrm{targeted}}([\mathbf{s}_{v_1}, \ldots, \mathbf{s}_{v_k}], [\mathbf{s}_{y_1}, \ldots, \mathbf{s}_{y_c}], \mathbf{s}_{v_{n+1}})\bigr) \tag{2}$$
其中 $\mathcal{P}_{\mathrm{targeted}}(x, y, z)$ 构造一个 prompt,问「与序列 $x$ 交互的用户,为何会对候选列表 $y$ 里的 $z$ 最感兴趣」。因为 ground-truth 被塞进了 prompt,定向法总能产出「目标为何被偏好」的理由——但这也要求 prompt 里必须有 ground-truth。
Rejection Sampling(拒绝采样):与定向法形成鲜明对比,不提供 ground-truth。反复查询 LLM,让它从 pre-ranked 候选里预测用户最可能的下一个兴趣 $\hat{\mathbf{s}}_{y_c}$,直到预测命中 ground-truth 目标为止:
$$ \begin{aligned} (\tau, \hat{\mathbf{s}}_{y_c}) &\sim P_\theta\bigl(\cdot \mid \mathcal{P}_{\mathrm{rejection}}([\mathbf{s}_{v_1}, \ldots, \mathbf{s}_{v_k}], [\mathbf{s}_{y_1}, \ldots, \mathbf{s}_{y_c}])\bigr) \\ \text{s.t.} \quad & \hat{\mathbf{s}}_{y_c} = \mathbf{s}_{v_{n+1}} \end{aligned} \tag{3} $$
$\mathcal{P}_{\mathrm{rejection}}(x, y)$ 构造 prompt,问「给定历史 $x$,候选列表 $y$ 里哪个 item 最可能是用户下一个兴趣」。只有命中真实答案的轨迹才被保留——这保证了推理的真实性(不是事后编的理由)。
五条 prompt 设计原则(在上述两法之上进一步约束):
- Concrete System Role and Re-ranking Task definition:明确推荐领域、LLM 的专职角色与重排任务的具体定义。
- Collaborative Context Presentation:同时呈现用户参与历史(带 title/category 结构化 metadata)与完整候选集,让模型做整体比较而非孤立评估。
- Domain Knowledge Priming:显式提示模型考虑领域启发式(如「洗发水 → 护发素 → 造型产品」的序贯购买模式),应用商品互补性与常规复购的常识推理。
- Critical Guidelines as Output Constraint:施加显式约束,如要求用 SID 引用 item,强制推理锚定在具体历史 item 上,杜绝幻觉式辩护,提供推理步骤到上下文的直接可追溯性。
- Structured Multi-Step Reasoning Format:给出带示例的逐步输出格式,引导模型经过 (1) 宽泛模式识别 →(2) 识别互补商品类型 →(3) 匹配到具体候选,镜像人类决策过程。
4.3 在推理轨迹上做 SFT(§3.3)¶
问题设定:给定用户参与历史与上一阶段产出的 pre-ranked 候选列表,目标是重排候选以把 ground-truth next item 提上来。每个训练/推理实例格式化成 system / user / assistant 三角色 chat prompt。SFT 阶段训练模型生成完整的 assistant 消息;RL 阶段策略只 condition 在 system 与 user 消息上,assistant 输出被当作 action。
生成的推理轨迹被用来监督一个 base LLM 习得重排推理能力。微调模型同时生成推理轨迹 $\tau = [r_1, \ldots, r_M]$ 与排序输出 $\mathbf{o} = [o_1, \ldots, o_T]$。为在启用推理的同时保住排序性能,GR2 把推理 token 与排序 token 的 loss 解耦,语言建模 loss 只作用于 assistant 消息,两段用不同权重:
$$\mathcal{L}_{\mathrm{SFT}} = -\lambda_r \sum_{i=1}^{M} \log P(r_i \mid \mathcal{P}, r_{<i}) - \lambda_o \sum_{j=1}^{T} \log P(o_j \mid \mathcal{P}, \tau, o_{<j}) \tag{4}$$
其中 $\lambda_r < \lambda_o$ 平衡推理流畅度与排序准确率(排序段权重更高)。该训练过程教模型生成 grounded、连贯、连接用户历史与候选比较的推理轨迹,同时维持强重排行为。
4.4 OPD 做推理激活(§3.4)¶
GR2 用 on-policy distillation(OPD,Zhao et al., 2026) 把推理从一个 frozen teacher 迁进部署 student。一个 GRPO 式循环把 student 当可训练 actor、teacher 当 reference policy:每一步 student 从自身分布 $\pi_\theta$ 采样推理链与排序列表,每条 rollout 拿到 §4 的奖励,actor 用一个 clipped surrogate 加逐 token reverse-KL anchor to teacher 更新:
$$ \begin{aligned} \mathcal{L}_{\mathrm{OPD}}(\theta) = -\,\mathbb{E}\Bigl[& \min\bigl(\rho_t \hat{A}_t,\ \mathrm{clip}(\rho_t, 1-\epsilon_{\mathrm{lo}}, 1+\epsilon_{\mathrm{hi}})\hat{A}_t\bigr) \\ & + \beta\, \mathbb{KL}\bigl[\pi_\theta(\cdot \mid s_t)\,\|\,\pi_T(\cdot \mid s_t)\bigr]\Bigr] \end{aligned} \tag{5} $$
其中 $\rho_t$ 是逐 token importance ratio,$\hat{A}_t$ 是 group-relative advantage,$\beta$ 是蒸馏强度。teacher 只贡献 token log-probabilities、从不给 label,充当分布式 anchor,而梯度流经 student。
为什么 on-policy 蒸馏能打败 off-policy 的 CoT 监督? §3.3 引入的两个 CoT-SFT baseline 都把推理迁移降级成对静态 teacher 语料的 behavior cloning,继承了 teacher-forced 序列学习的标准病:student 被监督在它部署时永远不会访问的 state 上,产生 train/inference 分布错配,并沿生成链复合。此外各法还叠加自身偏置:
- Targeted sampling 让 teacher condition 在答案上,产出的轨迹倾向编码事后的、label-aware 的捷径,student 记成流畅但非因果的推理。
- Rejection sampling 悄悄丢弃每个「teacher 在采样预算内无法满足 AUC bar」的 prompt,既浪费 teacher 算力,又恰好把最难的样本——监督最需要的地方——从训练集里移除。
OPD 靠构造避开两种失败模式:梯度在 student 自己采样的轨迹上计算;无论对 teacher 而言样本多易多难,每个 prompt 都贡献一个连续奖励信号;teacher 的角色从「生成目标轨迹」降为「正则化 student 自身分布」。这种「on-policy 曝光 + 稠密逐 rollout 奖励 + 逐 token KL anchoring」的组合,让小 student 吸收 teacher 的推理能力,却不继承其 trace-style 错配。
5. 阶段 3:RL Post-Training(§4)¶
SFT 能带来连贯推理,但不直接优化重排目标。在 §3.3/3.4 的蒸馏推理能力之上,GR2 用 RL 精炼推理过程与最终排序质量。给定 prompt $\mathcal{P}(\mathcal{H}, \mathcal{D})$,策略 $\pi_\theta$ 生成输出 $o = (\tau, \mathbf{o})$;RL 时策略只 condition 在 system 与 user 消息上,$o$ 当 action。
关键差异:不像公开 benchmark 每个 impression 只有单个 next item,工业 slate 是 multi-positive 的——一个候选列表可能同时带多个参与 label。因此 GR2 用「对整条 permutation 打分、对齐 multi-label ground-truth」的奖励函数,替换前作的单目标 rank-delta。
5.1 Ranking Reward(排序奖励)¶
候选 slate $\mathcal{D} = \{c_1, \ldots, c_K\}$ 关联一个二值参与 label 向量 $\mathbf{y} \in \{0,1\}^K$(可含多个 1)。GR2 用预测 permutation $\pi$ 对 $\mathbf{y}$ 的 per-impression AUC 作为主排序信号:
$$R_{\mathrm{AUC}}(\pi, \mathbf{y}) = \frac{1}{|\mathcal{M}||\mathcal{N}|} \sum_{i \in \mathcal{M}} \sum_{j \in \mathcal{N}} \mathbf{1}\bigl[\mathrm{rank}_\pi(i) < \mathrm{rank}_\pi(j)\bigr] \tag{6}$$
其中 $\mathcal{M} = \{i \mid y_i = 1\}$、$\mathcal{N} = \{j \mid y_j = 0\}$。AUC 原生支持多正例、有界于 $[0,1]$、在同一 label 类内 permutation-invariant,提供稳定的 RL 信号。
当有更丰富的 post-engagement 信号时,进一步用三级 label $g_i \in \{0,1,2\}$(无参与 / 点击 / 点击+转化)引入 graded-relevance 的 NDCG 项:
$$R_{\mathrm{NDCG}}(\pi, \mathbf{g}) = \frac{1}{Z} \sum_{i=1}^{K} \frac{2^{g_{\pi^{-1}(i)}} - 1}{\log_2(i+1)} \tag{7}$$
$Z$ 是 ideal DCG。内部数据设定下组合排序奖励是 $R_{\mathrm{rank}} = R_{\mathrm{AUC}}$ 或 $R_{\mathrm{NDCG}}$。无正例或无负例的 slate($|\mathcal{P}|=0$ 或 $|\mathcal{N}|=0$)在数据加载时被过滤。
5.2 Conditional Format Reward 与两种 Reward Hacking(§4.2)¶
加一个 format reward $R_{\mathrm{fmt}} = \Omega(o)$,检查 (i) 推理轨迹 $\tau$ 与排序输出 $\mathbf{o}$ 能否被可靠解析,(ii) 解析出的排序是 $\{1, \ldots, K\}$ 的合法 permutation 且匹配 slate 大小。朴素地把 $R_{\mathrm{rank}}$ 与 $R_{\mathrm{fmt}}$ 相加会暴露两条 reward-hacking 通道:
- 非法 permutation 仍可能从部分解析里赚到非平凡 $R_{\mathrm{rank}}$——因此把 $R_{\mathrm{rank}}$ gate 在 $\Omega(o)=1$ 上。
- 当上游 slate 本身非平凡有序(即 identity permutation 已经 $R_{\mathrm{rank}} < 1$)——策略可以不做任何重排、直接吐出 $[1, 2, \ldots, K]$ 骑在上游顺序上收割 format reward。这就是 identity-permutation cheating(恒等排列作弊)。GR2 检测它:当模型输出等于输入顺序且输入顺序次优时,把 $R_{\mathrm{rank}}$ 归零:
$$ R = \begin{cases} R_{\mathrm{rank}} + \alpha R_{\mathrm{fmt}}, & \pi \neq [1, \ldots, K] \ \text{或}\ R_{\mathrm{AUC}}([1, \ldots, K], \mathbf{y}) = 1, \\ \alpha R_{\mathrm{fmt}}, & \pi = [1, \ldots, K] \ \text{且}\ R_{\mathrm{AUC}}([1, \ldots, K], \mathbf{y}) < 1, \end{cases} \tag{8} $$
其中 $\alpha$ 是 format-reward 权重。当上游 slate 已最优时,identity permutation 是真正正确的答案,奖励正常流动。(第二种 hacking——利用位置偏置——则靠去偏训练数据缓解,即用户历史聚合到 impression 前 2 天以防 label 泄漏,见 §6.1.1。)
5.3 用 DAPO 训练(§4.3)¶
策略用 DAPO(Decoupled Clip and Dynamic sAmpling Policy Optimization,Yu et al., 2025) 优化——一个建立在 GRPO(Shao et al., 2024) 上的 SOTA RL 算法,能有效解决 GRPO 训练里的 entropy collapse 与 rollout length bias。对每个 prompt,采样一组 $G$ 个输出 $\{o_i\}_{i=1}^G$ 并优化:
$$ \begin{aligned} \mathcal{J}_{\mathrm{DAPO}}(\theta) = \mathbb{E}_{(q,a)\sim\mathcal{D},\,\{o_i\}_{i=1}^G \sim \pi_{\theta_{\mathrm{old}}}(\cdot\mid q)} \Bigl[ & \frac{1}{\sum_{i=1}^{G}|o_i|} \sum_{i=1}^{G}\sum_{t=1}^{|o_i|} \min\bigl(r_{i,t}(\theta)\hat{A}_{i,t}, \\ & \mathrm{clip}(r_{i,t}(\theta), 1-\varepsilon_{\mathrm{low}}, 1+\varepsilon_{\mathrm{high}})\hat{A}_{i,t}\bigr) \Bigr] \end{aligned} \tag{9} $$
其中
$$r_{i,t}(\theta) = \frac{\pi_\theta(o_{i,t} \mid q, o_{i,<t})}{\pi_{\theta_{\mathrm{old}}}(o_{i,t} \mid q, o_{i,<t})}, \qquad \hat{A}_{i,t} = \frac{R_i - \mathrm{mean}(\{R_i\}_{i=1}^G)}{\mathrm{std}(\{R_i\}_{i=1}^G)} \tag{10}$$
$\pi_\theta$ 与 $\pi_{\theta_{\mathrm{old}}}$ 分别是当前与旧策略。优势 $\hat{A}_{i,t}$ 对每个输出序列 $o_i$ 计算并在组内归一化。遵循 Clip-Higher 策略,DAPO 解耦低/高 clipping 范围($\varepsilon_{\mathrm{low}}$ 与 $\varepsilon_{\mathrm{high}}$);此外为避免零策略梯度、提升样本效率,它过采样并过滤掉 accuracy 恰为 1 和 0 的 prompt(这些 prompt 组内无对比信号)。
6. 阶段 4:Serving ROI Optimization(§5)¶
前三阶段产出一个强但昂贵的推理排序器。最后一阶段在保住 ROI 增益的同时沿两条主导成本轴削减 serving 成本:input cost(prompt over 一个 $O(B)$ item 目录)与 decode cost(每请求生成一条 CoT)。对应两条互补 lever——input 侧 context 压缩 与 decode 侧推理内化。
6.1 Input 侧:Context Compression(§5.1)¶
在 $O(B)$ item 目录上 mid-train 需要生成海量 SID 对齐数据、每次迭代 GPU 成本高,拖慢在线实验。作为削 input 成本的更快替代,GR2 训练一个 context compressor,在输入到达排序器之前就把它缩小。
压缩器用 GRPO 训练,配一个 LLM-as-a-judge,沿三轴给每个压缩输出打分:solvability $s \in \{0,1\}$、information preservation $p \in \{1, \ldots, 10\}$、ranking quality $q \in \{1, \ldots, 10\}$。judge prompt 是 mode-aware 的(item-level vs free-form summary)。奖励组合一个连续压缩项与一个 solvability-conditioned judge 项:
$$ r_{\mathrm{judge}} = \begin{cases} 0.2\,\bar{p} + 0.8\,\bar{q}, & s = 1 \\ 0.8\,\bar{p} + 0.2\,\bar{q}, & \text{otherwise} \end{cases} \tag{11} $$
$$r = \bigl(\alpha\, r_{\mathrm{comp}} + (1-\alpha)\, r_{\mathrm{judge}}\bigr) \cdot \lambda_{\mathrm{ellipsis}} \tag{12}$$
其中 $\bar{p} = p/10$、$\bar{q} = q/10$、$r_{\mathrm{comp}} = \max(0, 1 - |\text{compressed}|/|\text{original}|)$,$\alpha$ 权衡压缩 vs 质量,$\lambda_{\mathrm{ellipsis}} \in [0,1]$ 惩罚截断捷径。当任务可解($s=1$)时,把 ranking 信号 $\bar{q}$ 的权重压过 raw 信息完整度 $\bar{p}$——因为作者发现,可解时 preservation 与下游排序只弱相关,而更高压缩反而能抑制噪声。这直接对应 §6.3 的一个反直觉发现:aggressive、ranking-aware 的压缩像一个 denoiser。
6.2 Decode 侧:Internalizing Reasoning(§5.2)¶
每请求生成完整 CoT 是 GR2 的主导 decode 成本。为在大规模 serving 延迟下保住推理增益,GR2 在 §4 的 RL post-training checkpoint 上再跑一遍 RL,但显式绕过推理:策略被训练成只吐结构化排序输出,直接 condition 在 system 与 user prompt 上。因为推理先验——经 OPD 安装(§4/阶段2)、经 RL 锐化(§5/阶段3)——已经编码进共享 backbone,它能迁移到直接输出策略而不产生 CoT 生成成本。这个 reasoning-free 变体就是部署的 artifact;CoT-enabled 模型保留在离线用于评估与奖励设计。
6.3 系统级优化:Pruning 与 KV Caching(§5.3)¶
上面两条 lever 减 token 数,两项系统级技术进一步降每 token 成本:
- Model Pruning:对服务网络做 depth-wise(layer)剪枝再蒸馏恢复质量,同时降 prefill 与 decode 的算力。
- KV Caching:利用 RecSys prompt 的结构——一个请求的候选集固定且在用户间大量共享,因此预计算其 key-value 表示、跨请求复用;把 prompt 排成 system prompt → candidates → user context 的顺序,使候选 KV 保持可复用。
两者把算力摊到输入的稳定部分与更小的模型上,与压缩、推理内化的节省复合叠加。
7. 实验设置(§6.1)¶
论文聚焦工业设定,回答三个 research question:
- Q1:GR2 是否胜过 point-wise legacy baseline?增益对 test-set 规模、流量新鲜度、student 模型规模是否鲁棒?
- Q2:不同推理激活策略(SFT、OPD)与 RL post-training 如何影响工业规模的重排质量?
- Q3:企业级改造(context 压缩、OPD 蒸馏、隐式 CoT 服务)能否在工业延迟与 GPU 预算下保住排序质量?
公开 benchmark 结果、SID tokenizer 设计、codebook/uniqueness 研究已在前作技术报告(Liang et al., 2026)报告;本文集中在适配挑战主导的工业设定。
数据集(§6.1.1):GR2 在单日(01-25)内部日志上训练,约 70k 用户 session,在 02-01 至 02-09 的 held-out session 上评估。每个训练样本对应一个 impression list 配用户历史反馈(如点击商品)。标准工业过滤:丢重复 logging 事件、丢观察窗内交互 <3 次的用户。为压测泛化,test split 构造成 user identifier 与交互商品几乎不与训练重叠:>99% 候选商品、100% user ID、93% 用户历史 item 在训练中未见。用户历史聚合到 impression 前 −2 天以防 label 泄漏(这也是缓解 position-bias hacking 的去偏手段)。除非注明,报告相对 point-wise legacy baseline 的相对增益,该 baseline 每 60–90 分钟 snapshot 刷新一次在线训练。
指标(§6.1.2):标准序列推荐指标 Recall@K 与 NDCG@K,在 held-out impression list 上计算。
8. 主要实验结果(§6.2)¶
8.1 GR2 大幅超越 legacy baseline¶
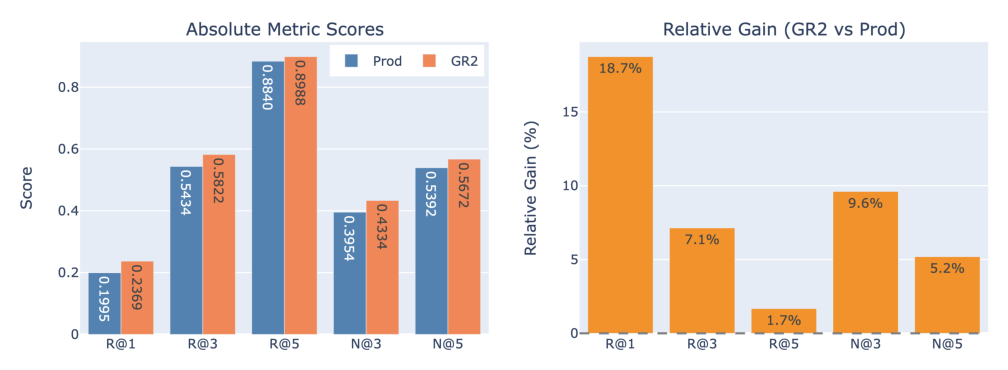
在内部 test set 上,GR2 相对一个重度调优的 legacy baseline 取得:
| 指标 | 相对增益 |
|---|---|
| R@1 | +18.7% |
| R@3 | +7.1% |
| R@5 | +1.7% |
| N@3 | +9.6% |
| N@5 | +5.2% |
尽管 GR2 只在单日日志上训练。关键论证:GR2 checkpoint 相对 test 窗已陈旧约两周,而 baseline 每小时刷新——所以增益不能归因于数据新鲜度,它反映的是由 product 语义推理驱动的真实排序质量提升。R@1 增益(+18.7%)显著大于 R@5(+1.7%),说明 GR2 的推理最擅长把最相关的那一个顶到最前,这正是 carousel/grid 场景最看重的头部位置。
8.2 增益在工业规模上保持¶
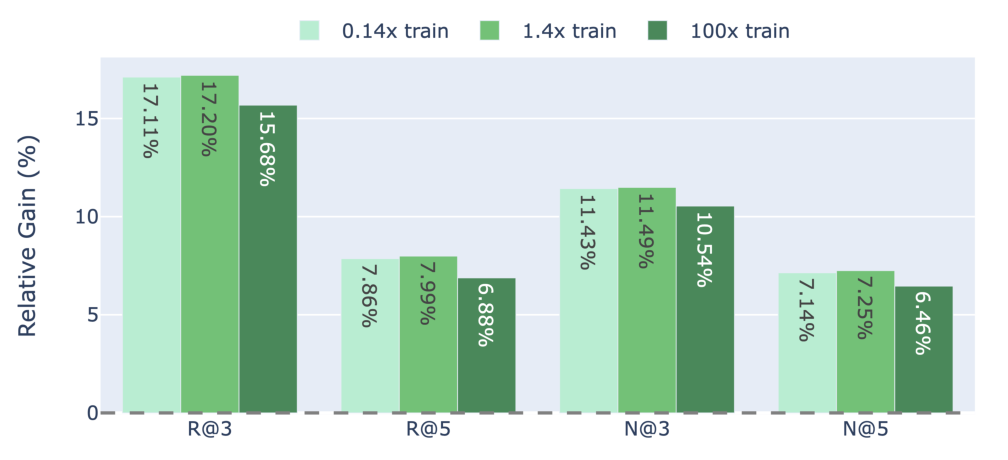
固定训练数据在 70k session,把 test-set 规模从 0.14× 经 1.4× 扫到 100× 训练数据量。相对 R@K 与 N@K 增益在三档基本恒定:
| 指标 | 0.14× | 1.4× | 100× |
|---|---|---|---|
| R@3 | 17.11% | 17.20% | 15.68% |
| R@5 | 7.86% | 7.99% | 6.88% |
| N@3 | 11.43% | 11.49% | 10.54% |
| N@5 | 7.14% | 7.25% | 6.46% |
结论:GR2 的提升不是小样本评估的假象,能迁移到工业服务的流量体量(100× 时仍保 +15.68% R@3)。
8.3 增益不随模型陈旧而衰减¶
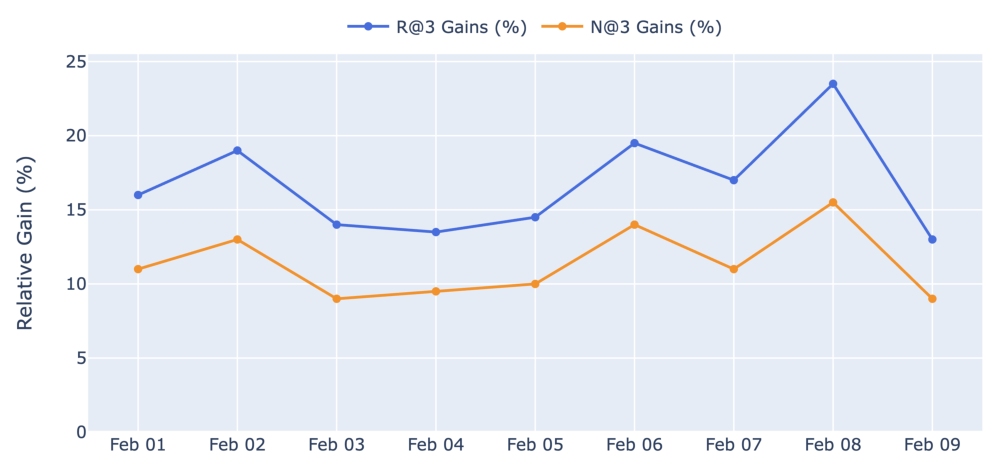
从 02-01 起连续 9 天每日评估,相对 legacy baseline 的提升无可测衰减,即便 GR2 checkpoint 到窗尾已陈旧 2 周多。考虑到 §6.1.1 的冷启设定(test 时几乎每个 user/product 都是 novel),这一点尤为醒目:GR2 靠 LLM 世界知识与推理 而非记忆的 sparse ID 泛化——而后者恰恰是逼 legacy baseline 每 60–90 分钟刷新以避分布漂移的原因。作者预期这个 gap 在下漏斗信号(延迟转化)上会更大,因为 sparse-ID 模型在反馈延迟与 label 稀疏下更吃亏。9 天里 R@3 增益在约 13%–23% 波动、N@3 在约 9%–15.5% 波动,无下行趋势。
8.4 性能随模型规模扩展¶
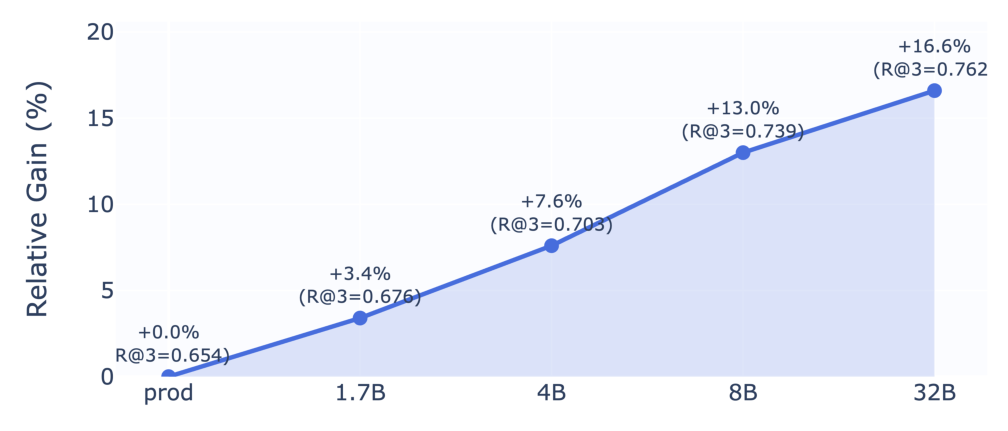
在 Qwen3 从 1.7B 扫到 32B,R@3 增益单调随模型规模增长:
| 模型 | R@3 相对增益 | R@3 绝对 |
|---|---|---|
| prod | +0.0% | 0.654 |
| 1.7B | +3.4% | 0.676 |
| 4B | +7.6% | 0.703 |
| 8B | +13.0% | 0.739 |
| 32B | +16.6% | 0.762 |
这表明 GR2 在广告重排域继承了 LLM 的 scaling law——与 sparse-ID baseline 形成对比,后者的 scaling 受 ID-vocabulary 容量而非参数量约束。当前曲线在 ~10-GPU 预算下尚未 flatten,暗示仍有 headroom;随之而来的 serving 成本 gap 由 OPD(§4)来填。
9. Serving 延迟与蒸馏(§6.3)¶
9.1 OPD 带来 Serving ROI¶
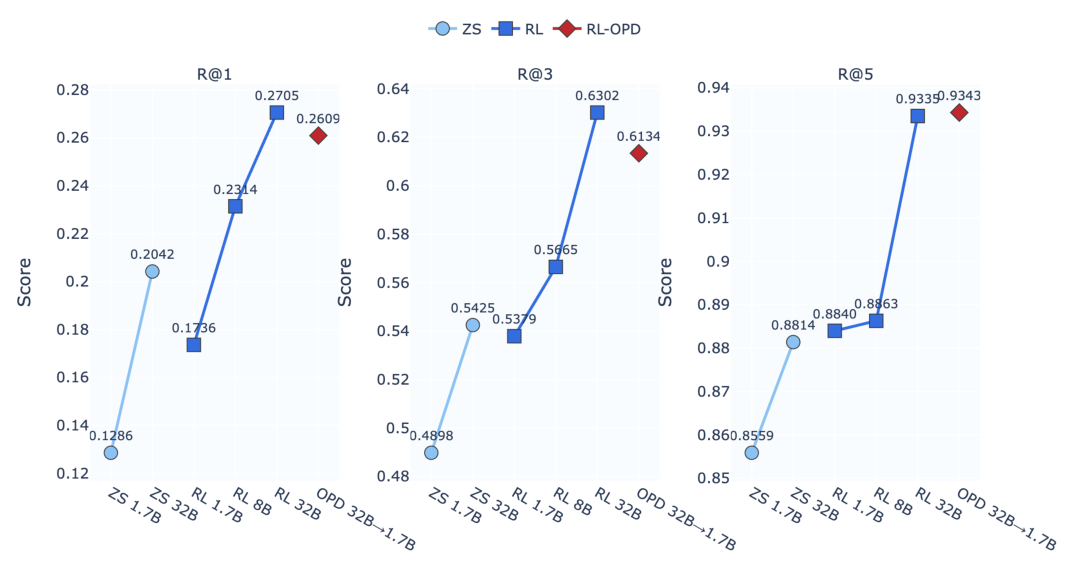
GR2 默认配方记作 RL-OPD:先用 OPD bootstrap 推理(避开 token-level SFT 观察到的灾难性遗忘),再在 OPD checkpoint 上跑 RL post-training 锐化排序、同时保住推理先验。
关键结果:一个从 32B teacher 蒸馏的 1.7B student(teacher 5% 大小)恢复了 32B 相对 baseline 增益的 82%,并交付一个无蒸馏训练的 8B 模型 2.6× 的增益,得到 ~15× serving-ROI 提升($32/1.7 \times 0.82$)at iso-quality。从 Figure 6 的绝对分数看(如 R@3):ZS-1.7B 0.4998 → RL-1.7B 0.5379 → RL-8B 0.5665 → RL-32B 0.6302,而 OPD 32B→1.7B 达到 0.6134——一个 1.7B 模型逼近 32B 的 RL 水平。
9.2 Context Compression¶
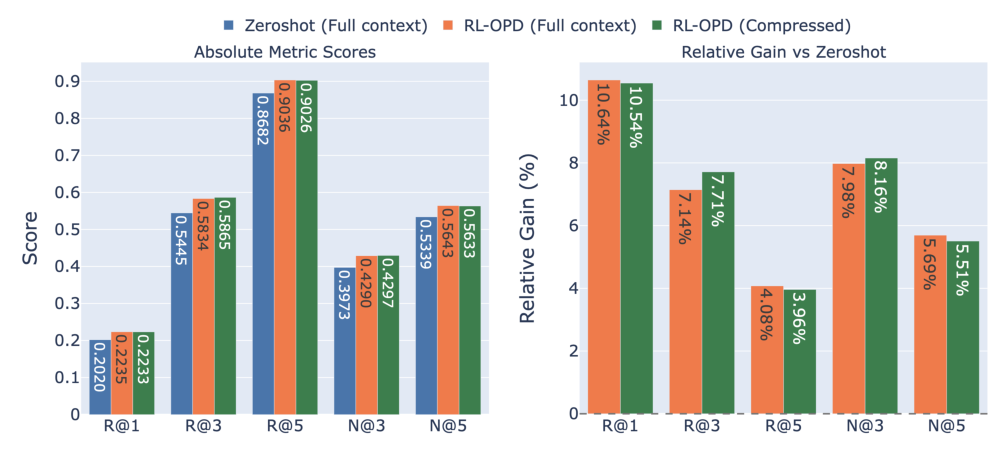
两个 RL-OPD 变体都大幅超过 zero-shot 0.6B baseline(+10–12% R@1、+4–6% R@5/N@5)。compressed-context 变体在 R@3/N@3 上匹配甚至略超 full-context(+7.71% vs +7.14%;+8.16% vs +7.98%),却只消耗 <20% 的 token——即在 iso-quality 下额外 >5× 的 context 缩减。作者归因于 solvability-conditioned 奖励(式 11):当 $s=1$ 时压缩器被推向 ranking quality $\bar{q}$ 而非字面 preservation $\bar{p}$,学会丢弃 ranking-无关信号。这印证了其假设:信息保真度与排序效用只弱相关,aggressive ranking-aware 压缩起到 denoiser 作用。
10. 推理质量与消融(§6.4)¶
10.1 内化推理:隐式能否替代显式 CoT?¶
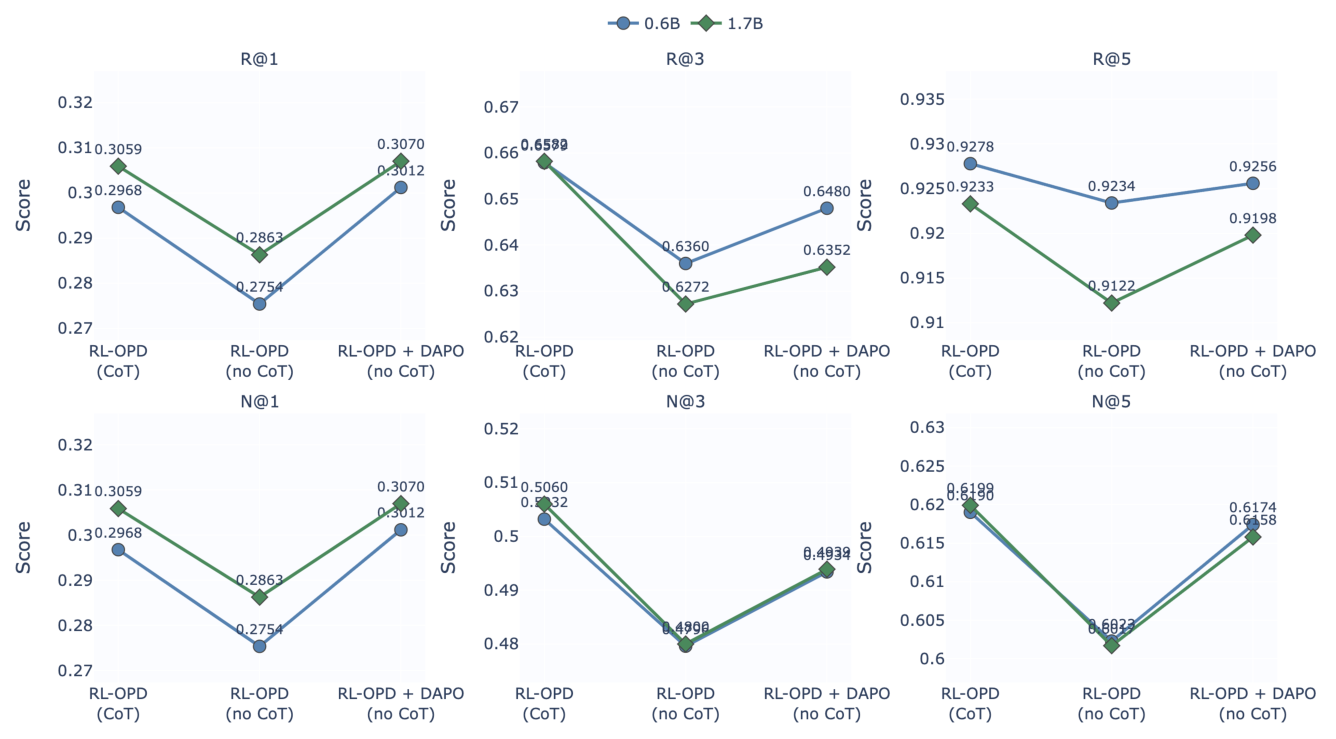
为压测隐式推理能否替代显式 CoT,在一个 hard subset(被大 foundation LLM 标记为「需要 above-average 推理」的 session,绕过 CoT 应最伤)上评估。前两个点追踪同一 RL-OPD checkpoint 的有/无 CoT:推理时移除 trace 会显著掉 Recall 与 NDCG(0.6B 与 1.7B 上均 −6~7% R@1/N@1、−3~5% R@3/N@3),确认 CoT 在这个切片上携带真实排序信号。但第二遍 RL 完全补回 gap、甚至在排序头部略超 CoT reference(R@1/N@1:0.6B 0.3012 vs 0.2968、1.7B 0.3070 vs 0.3059;深处 cutoff 也匹配:0.6B R@5 0.9256 vs 0.9278、N@5 0.6174 vs 0.6190,均在 ~0.3% 内)。OPD 预训练的 backbone 已编码一个 over-reasoning-traces 的鲁棒排序先验,第二遍 RL 只需把这个先验re-route 进直接输出策略,把 CoT 内化进共享 backbone。部署 artifact 因此在 iso- 甚至 super-CoT 质量下 reasoning-free,即便在 reasoning-heavy 流量上。
10.2 推理质量跨训练配方¶
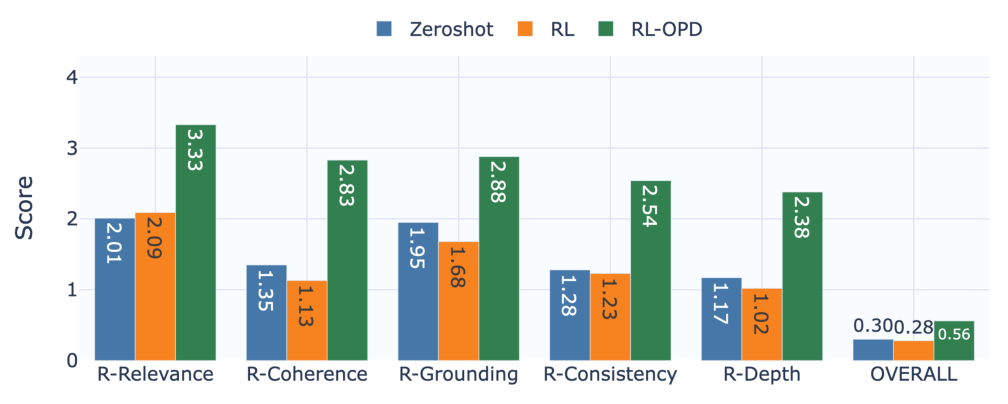
在 zero-shot checkpoint 上直接上 RL,会在全部五个 rubric 上轻微降低推理质量(相对 OPD-initialized 变体);退化在 Depth(深度) 上最重(≈1.02,接近 rubric 下限),确认 RL alone 学会「排得好」却不会「想得好」。RL-OPD 配方恢复推理质量、同时保住排序增益,产出同时更短更聚焦的轨迹:
| Rubric | Zeroshot | RL | RL-OPD |
|---|---|---|---|
| R-Relevance | 2.01 | 2.09 | 3.33 |
| R-Coherence | 1.35 | 1.13 | 2.83 |
| R-Grounding | 1.95 | 1.68 | 2.88 |
| R-Consistency | 1.28 | 1.23 | 2.54 |
| R-Depth | 1.17 | 1.02 | 2.38 |
| OVERALL | 0.30 | 0.28 | 0.56 |
10.3 训练配方权衡消融¶
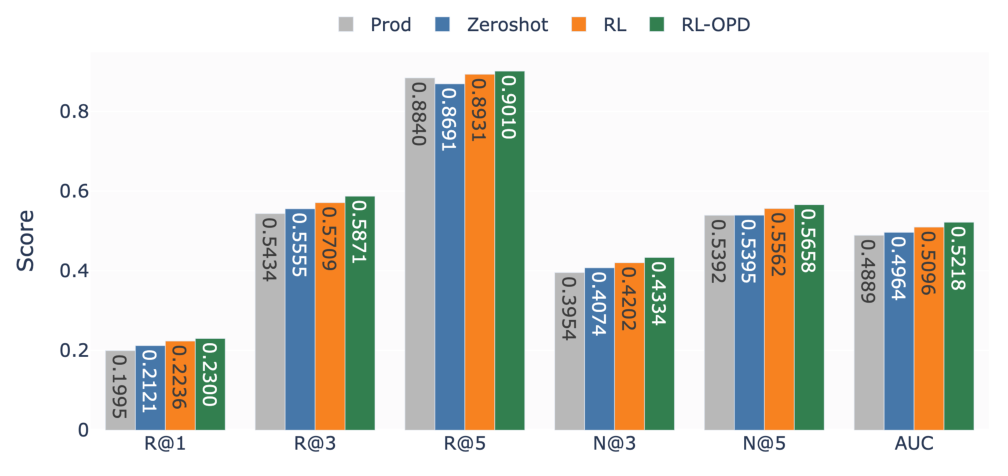
三配方并排比较排序指标与推理质量:(i) RL-only on zero-shot、(ii) RL-OPD。RL-only 在排序指标上匹配 RL-OPD,但在每个推理 rubric 上都落后;RL-OPD 在两者上 Pareto 占优,支撑 headline 论断——OPD 提供推理先验,RL 在其上锐化排序目标,二者缺一不可。从 Figure 10 绝对值看(Prod / ZS / RL / RL-OPD):R@1 0.1995 / 0.2121 / 0.2236 / 0.2300;R@3 0.5434 / 0.5555 / 0.5709 / 0.5871;R@5 0.8840 / 0.8691 / 0.8931 / 0.9010;N@3 0.3954 / 0.4074 / 0.4202 / 0.4354;AUC 0.4889 / 0.4964 / 0.5096 / 0.5218。
10.4 Case Study(Table 1)¶
GR2 把排序 grounding 在 product 属性(category / material / function)与用户揭示的点击模式——这些是 sparse-ID baseline 无法表示的语义。从一段以 皮质枪套、手枪盒、皮外套 主导的历史,GR2 推断出一个连贯的「leather goods + firearms accessories」画像,把一件 vintage 皮质警用大衣顶到最前,找回了 baseline 排在第 4 位的那次点击。非皮质、离题的候选(珠宝锤、安全剃刀、Oakley 墨镜)被正确压到底部,而皮靴、皮裤作为「合理但更弱的匹配」被留在中间。这一案例直观展示了「显式语义推理」相对纯 ID 记忆在可解释性与相关性上的优势。
11. 核心贡献总结¶
- 把 LLM 推理带进工业重排的第一套系统方案:确立 re-ranking-first 的 LLM 设计原则,证明 LLM 世界知识 + CoT 能转化为可度量排序增益(+18.7% R@1)。
- SID mid-training 解决词表错配:≥99% uniqueness 的 tokenizer + SID/世界知识混合语料,让 LLM 直接在数十亿目录上语义推理。
- 推理激活流水线:targeted + rejection sampling 产分层轨迹,SFT/OPD 安装 纯 RL 无法恢复 的推理先验;OPD 在工业规模替代崩溃的 SFT,1.7B 恢复 32B 的 82%。
- 重排专用可验证奖励 RL:DAPO + 多组件奖励(AUC/NDCG + 条件 format),系统识别并封堵两种 reward hacking(恒等排列作弊 与 位置偏置利用)。
- 完整工业落地栈:context 压缩(>80% token、iso-quality 甚至去噪)、推理内化(~15× serving ROI、reasoning-free 部署)、pruning + KV cache,复合削减 serving 成本。
- 一个反直觉的方法论结论:OPD 供推理先验、RL 供排序锐化,二者 Pareto 互补;且推理可被内化——部署 artifact 无需生成 CoT 即达 iso/super-CoT 质量。
12. 与已归档相关工作的对比¶
OneReason OneReason: 让 thinking 模式稳超 non-thinking(Kuaishou, 2026-06-04)¶
关系:独立并发(GR2 未引用 OneReason,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在攻同一个 root cause——如何让 LLM 的显式 CoT 推理在生成式/SID 推荐里真正兑现排序价值,而不只是「加了推理却打不过不推理」。OneReason 甚至把这个反常现象(thinking 打不过 non-thinking)当作全篇立论起点;GR2 则在 §6.4 的 CoT vs no-CoT 消融里正面回应了同一疑问。
- 相近的技术骨架:两者的流水线抽象后几乎重合——itemic/SID mid-training(感知/对齐)→ 高质量 CoT 的 SFT(认知/推理激活)→ RL + on-policy distillation(统一/锐化)。OneReason 的 MOPD(on-policy distillation) 与 GR2 的 OPD 是同一族技术,都用来在 RL 阶段做可扩展的跨域/跨规模统一;两者也都强调 CoT 质量的显式度量(OneReason 用五维质量评估 + Action-Logic Score,GR2 用 LLM-as-a-judge 五 rubric)。
- 本文的差异与推进:GR2 明确定位在工业重排(re-ranking) 这一最终漏斗环节,输入是 pre-ranked slate、输出是 permutation,奖励用 per-impression AUC/NDCG(multi-positive) 与 conditional format reward 防 reward hacking;OneReason 是跨四域(视频/商品/广告/直播)的推荐基础模型,覆盖 R0-R3 四层能力,重点在感知(四粒度预训练 578B token)与「specialize-then-unify」的多域 RL 平衡。可以说 OneReason 更「宽」(做通用推荐推理基座),GR2 更「深」(把一个环节的工业成本护栏做透,如 context 压缩 >5×、推理内化 ~15× ROI)。
- 可比的方法/实验差异:都报告「小模型经蒸馏逼近大模型」——OneReason 开源 0.8B/8B,GR2 报 1.7B 恢复 32B 的 82%;都做线上部署(OneReason 快手本地生活广告 ROI>5,GR2 工业流量 +18.7% R@1)。一个显著方法差异:OneReason 丢弃 itemic 尾部 end token 省 context 给推理,GR2 则靠外挂 context compressor + 推理内化省成本,路径不同但目标一致。
OneRec-Think OneRec-Think: 生成式推荐的 In-Text Reasoning(Kuaishou, 2025-10)¶
关系:显式引用但原文未展开对比(GR2 在 intro 与 related work 提及 OneRec-Think「扩展了显式推理轨迹、CoT 提升准确率」,但无方法/指标级对照表)· 已加载对方精读
- 共同关注的问题:两篇都要把显式、可控的 CoT 推理引入生成式推荐——生成式推荐器本质是「隐式预测器」,缺 LLM 的显式推理优势。GR2 的 §1 (G1)「reasoning is left on the table」与 OneRec-Think 的立论几乎逐句对应。
- 相近的技术骨架:三段式高度同构。OneRec-Think 的 Itemic Alignment(多任务预训练)→ Reasoning Activation(从 pruned context 用 top-k 相似度 bootstrap CoT 再 SFT)→ Reasoning Enhancement(GRPO + Rollout-Beam reward) 对齐 GR2 的 mid-training → reasoning enhancement(targeted/rejection sampling + SFT/OPD)→ RL(DAPO)。尤其 OneRec-Think 的「pruned-context bootstrap」(选与目标最相关 top-k 历史再让模型解释目标交互)与 GR2 的 targeted sampling(给定目标 item + 最近 k 历史生成解释轨迹,式 2)是同一手法。两者也都直面工业 serving 成本:OneRec-Think 的 Think-Ahead(离线用完整模型采样推理 prefix、在线用轻量 OneRec 约束解码)与 GR2 的 推理内化(第二遍 RL 去 CoT)都在「离线做重推理、在线免推理成本」这条思路上。
- 本文的差异与推进:(1) 任务环节不同——OneRec-Think 是端到端检索/生成(自回归解 next itemic token,Think-Ahead 服务),GR2 是重排(对 pre-ranked slate 重排、AUC/NDCG permutation 奖励)。(2) 奖励设计——OneRec-Think 用 Rollout-Beam reward 解决稀疏命中,GR2 用 multi-positive AUC + conditional verifiable reward 防恒等排列/位置偏置 hacking,后者是 GR2 独有的工业 insight。(3) 蒸馏——GR2 明确提出 OPD 替代崩溃的 SFT 并量化 15× serving ROI,OneRec-Think 用标准 SFT + GRPO。GR2 未与 OneRec-Think 做 head-to-head benchmark(实验纯工业内部),二者更多是「同一思想在检索 vs 重排两个环节的平行演化」。
RPORec RPORec: Reasoning-Augmented Recommendation 的强化偏好优化(CityU HK + Kuaishou, 2026-05-21)¶
关系:独立并发(GR2 未引用 RPORec)· 已加载对方精读
- 共同关注的问题:两篇都在解「如何用显式 CoT 推理做推荐,同时让 RL 用可验证奖励把推理与推荐目标对齐」,且都特别在意「别让推理被噪声/reward-hacking 带偏」。RPORec 关注 text→item 语义鸿沟与 hidden-state 扭曲,GR2 关注 SID 词表错配与 reward hacking——不同表述,同指「显式推理落到精确 item 排序」这一硬骨头。
- 相近的技术骨架:RL 奖励设计这条轴上二者最像。RPORec 的总奖励 $r = r_{fmt}\cdot(\alpha_0 r_{fmt} + \alpha_1 r_{clean} + \alpha_2 r_{ndcg} + \alpha_3 r_{sim} + \cdots)$ 用 format reward 做乘性 gate(格式错则全奖励归零)+ NDCG-based verifiable reward + CoT 质量奖励;GR2 的式 (8) 同样把 $R_{rank}$ gate 在 $\Omega(o)=1$ 上、用 AUC/NDCG verifiable reward + format reward + 可选 LLM-judge 推理奖励。两者都用 GRPO 族(RPORec GRPO,GR2 DAPO=GRPO 改进版),都显式惩罚冗长/离题 CoT(RPORec 的 $r_{clean}/r_{comp}$,GR2 的 context compressor + 推理内化)。
- 本文的差异与推进:(1) 架构——RPORec 解耦 LLM backbone(产
<think>/<answer>)与轻量检索头 Rechead,用文本接口避免 hidden-state 扭曲、并规避 text→item 鸿沟;GR2 是统一端到端重排器,LLM 本身就是排序器,靠 SID mid-training 把 item 纳入词表来消鸿沟。(2) 任务——RPORec 做 next-item 检索(Amazon 数据 + 40M 用户广告 A/B +1.348% Revenue),GR2 做工业 slate 重排。(3) 奖励可验证性来源——RPORec 的 verifiable reward 来自一个冻结的 Rechead(learned verifier),GR2 的来自规则化 AUC/NDCG(无需额外模型)+ 反 hacking 条件项。可以看作两条并发路线:RPORec「用一个学出来的头做 verifier」,GR2「用可验证的排序指标本身做 reward,并把工程重心放在防 hack 与 serving 成本」。
被剔除的近似候选(问题或解法未双同构):
- Taiji(2606.03866, Kuaishou)——共享 targeted(RUPR)+ rejection sampling(ORFT, PPL 过滤)+ 小模型蒸馏(7B 超 32B teacher)recipe,与 GR2 §3 极像;但 Taiji 是 LLM-as-Enhancer 范式,LLM 产出量化特征喂给独立的下游排序模型,而非自己做排序,任务层不同构(增强 vs 端到端重排)。
- PauseRec(2606.14142, UVA)——问题同构(SID 生成式推荐里 explicit CoT 为何失效),但解法相反:用可训练
<pause>token 做隐式 latent reasoning、无 teacher CoT、无 RL,正好与 GR2「显式 CoT 蒸馏 + RL」对立。 - TwiSTAR(2605.11553, Tsinghua)——同样关心 serving 成本,但解法是 agentic planner 动态 dispatch 到 fast/rank/slow-CoT 三个工具,而非 GR2 的推理内化;路径不同构。
- MLLMRec-R1(2603.06243)/ OneSearch-V2(2603.24422)——scene 不同(多模态序列推荐 / 电商 search query 理解),非工业 item re-ranking。
13. 讨论与局限性¶
核心贡献与借鉴价值。GR2 最值得借鉴的不是单点技术,而是把「LLM 推理落进工业重排」拆成一条完整的成本-质量协同流水线:用 SID mid-training 消词表错配、用两种采样 + OPD 装推理先验、用可验证奖励 + 反 hacking 做 RL、再用压缩/内化/剪枝把成本压回可部署区间。其中三个洞见对做工业生成式推荐的人尤其有价值:(1) naive SFT 在工业规模会崩、OPD 是更稳的推理先验安装方式,且 on-policy 曝光 + 逐 token KL anchor 从原理上避开了 teacher-forcing 的分布错配;(2) reward hacking 在重排里是一等公民问题——「恒等排列作弊」与「位置偏置利用」都会虚高离线指标,conditional verifiable reward 是必需的工业组件;(3) 推理可以被内化——离线保留 CoT 做评估/奖励设计,在线部署 reasoning-free 策略,鱼与熊掌兼得(~15× ROI)。
局限与争议。(1) 实验完全是工业内部数据,公开 benchmark、SID/tokenizer 细节都甩给了前作(Liang et al., 2026),外部难以复现或与学界 SOTA 直接对照;相对增益都是「vs 一个未完全披露的 legacy baseline」。(2) 单日 70k session 训练规模偏小,虽然作者用「陈旧 2 周仍不衰减」反证泛化,但这也可能与冷启 test split 的构造方式有关,泛化结论需更多场景验证。(3) 公式与超参披露不均衡——RL/OPD 的 $\lambda_r/\lambda_o$、$\alpha$、$\beta$、$\varepsilon$、$G$ 等关键权重多数未给数值,reward 组件的相对权重(AUC vs NDCG vs format vs judge)也语焉不详,工程复现存在空白。(4) Table 1 case study 只有单例定性,缺系统化的推理-质量与排序-质量因果分析。(5) 与并发工作(OneReason、OneRec-Think、RPORec、Taiji)无任何 head-to-head,很难判断 GR2 相对同期同思路方案的净增益。
工业落地价值。论文的部署叙事相当完整:deployed artifact 是剪枝后、reasoning-free、context 压缩的小 student,靠 KV cache 复用共享候选集、按 system→candidates→user 顺序排布 prompt 保持候选 KV 可复用。业务收益(+18.7% R@1 且 9 天不衰减)与成本收益(~15× serving ROI、>5× context 缩减)双双兑现,且明确论证了「reasoning LLM 在 RecSys 里有一条可部署的实用路径」——这对正在纠结「LLM 推理在推荐里到底能不能扛住工业延迟/成本」的团队,是一份有说服力的工程范本。