Hypothesis-Driven Shelf Generation:把"货架模板库"换成 LLM 生成的自然语言假设¶
Spotify(Aleksandr V. Petrov、Tarun Chillara、Matthew D. Moellman、Lucas de Haas、Yabai Song、Alina Susoykina、Melissa Crawford、Gabriel Negash、Erik Franco、Tasnim Rahman、Binal Jhaveri、Shubham Bansal、Hugues Bouchard、Roberto Mirizzi、Mounia Lalmas、Aloïs Gruson),RecSys '26(2026-07-28,arXiv:2607.25823,9 页)。一句话:Spotify Home 的"货架"(shelf,即首页那一行行带标题的横向内容行)长期由有限的人工模板定义,论文把它换成一条四阶段生成式流水线——用 LLM 从用户画像生成自然语言的"货架假设"(shelf hypothesis)作为中间规划表示,再用 Semantic ID 受约束生成式检索把假设落到目录实体,再用 LLM 做候选精选 + 标题重写对齐,最后把离线预算好的货架作为候选注入 Home 排序去和既有货架竞争。离线 LLM-as-a-Judge 显示生成式检索全面超过 BM25/稠密/混合基线(Overall 0.56→0.71),对齐阶段再把整体分从 0.71 抬到 1.27(+78%);线上均匀随机曝光下,专辑池 +36%、单集池 +2%,但歌单 −14%、播客节目 −41%。
⚠️ 阅读提示:这是一篇系统/落地导向的工业论文,全文只有两个形式化定义、无损失函数、无训练细节公开。它的真正价值在三处:(a) "货架假设作为规划与检索之间的契约"这一架构抽象;(b) 一套按流水线阶段切分的 LLM-as-a-Judge 评测方法论(两个判官 + 12 个评分维度 + 明确的失败模式边界);(c) 罕见地把不利的线上数字一并披露。
研究动机与背景¶
货架(shelf)是什么,以及模板范式的三重耦合¶
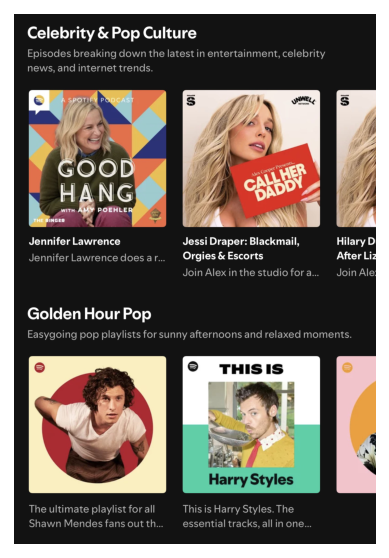
现代推荐界面越来越依赖 shelves(货架):首页上一行行紧凑的、带主题的横向内容行。一个首页可能同时混排"熟悉的最爱""新发行""编辑歌单""播客单集""长尾发现"等多种货架。论文强调,货架这个形态之所以强大,是因为它让推荐意图变得可读(makes recommendation intent legible):
像 "More of What You Like" 或 "New Releases for You" 这样的行标题不只是一个 UI 标签,它是一个承诺——承诺这些 item 为什么属于同一组、为什么出现在这个用户的页面上。
问题在于,生产系统里这个承诺几乎总是通过一组有限的、手工设计的模板来兑现。而论文一针见血地指出:每个模板都隐式地把三个本可分离的决策耦合死了——
- 这个货架应当满足什么用户需求;
- 什么内容算作该需求的有效实现;
- 用哪个检索或排序系统去填充这一行。
对"最近在听""全球热门新发行"这类宽泛且反复出现的意图,模板范式很有效。但它对个体口味的长尾构成瓶颈:要为「流派 × 年代 × 场景 × 情绪 × 熟悉度 × 市场 × 媒体类型」的每一种组合都维护一个专用模板,在生产规模下根本不可行。
把货架生成重构为生成式规划问题¶
论文的做法是:不再从固定的模板集合里挑选,而是让模型生成"内容假设"(content hypotheses)——用自然语言描述个性化货架概念。这些假设既可以是宽泛主题(如"当代 dance-pop 歌单"),也可以是极窄的小众niche(如原文举例的 "glacial ambient post-rock albums with orchestral textures",冰川感氛围后摇 + 管弦织体的专辑)。
每个假设充当用户建模与目录检索之间的中间规划表示(intermediate planning representation)。但论文随即点出真正的难点:
一个有用的货架不只是一段看起来合理的文本描述。它必须被真实目录实体所接地(grounded)、满足产品与用户约束、产出忠实的用户可见文案、扩展到数百万用户,并且在不引入额外服务延迟的前提下集成进生产系统。
这些要求直接推导出论文的核心架构决策:把个性化货架规划(planning)与目录履行(fulfilment)分离。假设生成器消费收听历史、近期偏好、播客行为、市场信息等信号,产出含用户可见文案 + 检索约束 + 元数据的货架假设;一个独立的履行模型再通过受约束生成式检索去取回能实现该假设的目录实体。
论文自陈三条贡献:(1) 把货架生成形式化为假设驱动的推荐问题,分离个性化货架规划与目录检索;(2) 提出一个组合了假设生成 + 受约束生成式检索 + LLM 货架对齐、并同时覆盖音乐与播客内容类型的架构;(3) 通过离线分析与 Spotify Home 上均匀随机曝光下的早期线上评测做验证。
相关工作的四条脉络¶
- 多列表推荐(multi-list recommendation):研究把推荐界面组织成多行标签行(carousel / shelf)的形态——多列表界面的收益 [15]、设计空间综述 [10]、用户如何与 carousel 布局交互 [11];音乐场景里 carousel 个性化被形式化为上下文老虎机 [1],自动生成的合集被证明优于 item 级推荐 [20]。差异:这些工作是对固定的一组货架做排序或个性化,本文是生成个性化货架假设、随后再用目录 item 去履行它。
- 推荐即语言问题:P5 的统一 text-to-text 框架 [7];音乐场景的 Text2Tracks [12]、Text2Playlist [6]、从歌单标题做 LM 生成 [2]。差异:这些方法都从用户主动输入的 prompt 出发并直接检索曲目/歌单;本文从用户行为画像自动生成货架假设,并把它当作中间规划表示。
- 生成式检索:神经语料索引与可微检索 [22,25];Semantic-ID 生成式检索作为传统检索架构的替代 [16],后续工作显示 SemID 改善推荐泛化 [5,21] 并支持搜索-推荐联合 [13]。差异:本文把履行当作在目录标识符上的受约束生成,但生成式检索在这里扮演不同角色——履行只以生成出的货架假设为条件,而不以完整用户画像为条件,刻意把"个性化货架规划"与"目录检索"分开。
- Slate 生成与工业多阶段架构:Prompt-to-Slate [23] 从自然语言 prompt 直接产出连贯的 item 集合;本文则先生成个性化货架概念、再检索实例化它的 item。Netflix [8] 与 YouTube [4] 展示了把推荐分解为多阶段的价值,本文遵循同样原则但分解轴心是"个性化货架规划 / 假设驱动履行 / 事后对齐"。论文强调其目标不只是推荐相关 item,更是生成在 Home 界面上连贯、可解释、有意义的货架概念。
核心方法 / 系统架构¶
设计目标与分解¶
论文列出四条既有工作未充分解决的需求:(a) 生成新的货架概念而非从固定库存中选择;(b) 从行为画像而非用户书写的 prompt 推断货架概念;(c) 通过受约束检索把这些概念接地到大规模目录;(d) 支撑生产规模服务并配备分阶段的评测。这四条共同推出中心架构决策:个性化货架规划(personalised shelf planning)→ 假设驱动的目录履行(hypothesis-driven catalogue fulfilment)。
在这个分解下,规划阶段决定"该给这个用户存在哪些货架",履行阶段负责取回实例化这些概念的目录实体。货架假设构成两阶段之间的接口:一个把自由形式的自然语言意图与检索、过滤、路由、评测所需元数据结合起来的表示。
对用户 $u$,规划器先用近期收听、长期偏好、市场上下文、熟悉内容、播客参与度等信号构造口味画像 $p_u$;再生成货架假设,包含自然语言货架描述 $q$、目标内容类型 $c$、熟悉度等级 $f$、可选路由约束 $r$(如市场或新鲜度)、临时标题与副标题 $t_0, d_0$。形式化为:
$$h = (q,\ c,\ f,\ r,\ t_0,\ d_0) \tag{1}$$
论文对这个定义给了一句关键论述:
因此假设不只是一个检索 query:它是规划与履行之间的一份紧凑契约(a compact contract between planning and fulfilment)。它必须足够有表现力以捕捉长尾用户口味、足够具体以约束检索、足够结构化以支撑评测。
履行阶段把 $h$ 映射为一组候选目录实体;候选精选与货架对齐再把这组候选转成最终的货架记录:
$$s = (t,\ d,\ q,\ \mathcal{I}) \tag{2}$$
其中 $t, d$ 是最终标题与副标题,$\mathcal{I}$ 是解析后的 Spotify 目录实体有序列表。这一分离的意义是:规划器去优化口味对齐、具体度、发现性;履行器去优化目录有效性、相关性、覆盖度——两个目标不再互相牵制。
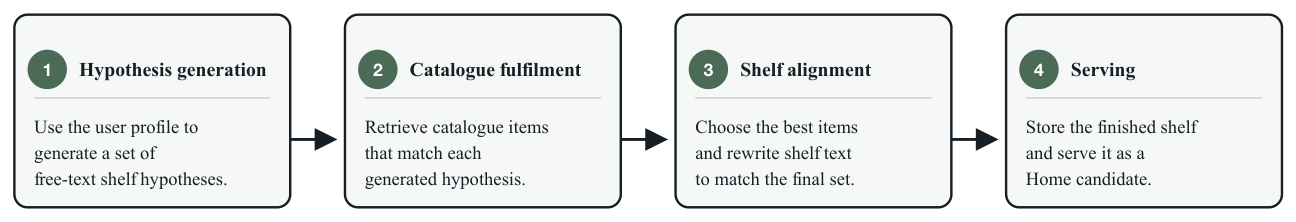
整条流水线以每日批处理方式跑在符合条件的用户上,不在 Home 服务时引入延迟。这样做的收益是可以使用更大的检索候选集、元数据富化、后处理与离线分析。每个阶段产出一份稳定的中间产物(假设、检索候选集、对齐后的货架、服务记录),使下游组件与评测流程可以独立演进。
Table 1: 流水线各阶段的职责与 §4 使用的评测边界
| 阶段 | 输入 | 输出 | 职责 | 主要失败模式 | 评测挂钩 |
|---|---|---|---|---|---|
| 1. 假设生成 | 用户画像 | 货架假设 | 从行为证据推断个性化货架意图 | 概念泛化、无证据支撑、或欠具体 | User-to-Hypothesis Judge |
| 2. 履行 | 生成的假设 | 候选 URI | 检索能实例化该概念的目录实体 | item 未能实现该假设 | Hypothesis-to-Shelf Judge、检索基线 |
| 3. 货架对齐 | 解析后的候选 URI + 草稿文案 | 最终 item + 修订文案 | 挑出连贯货架并让可见承诺与 item 对齐 | 标题夸大(overclaim)、或该行缺乏集合级连贯性 | 对齐前/后对比 |
| 4. 服务 | 最终货架记录 | Home 候选 | 把预计算货架注入 Home 排序 | 离线很强的货架未必转化为有竞争力的参与度 | 均匀随机探索 |
这张表本身就是论文方法论上的一个亮点:每个阶段都被绑定了唯一的失败模式和唯一的评测挂钩,这使得"哪一段是瓶颈"成为一个可实证回答的问题。
Stage 1:假设生成¶
第一阶段从用户画像 $p_u$ 生成一小组货架假设。生成多条假设是为了在同一个 Home 界面内覆盖用户口味画像的不同侧面。每条假设指定目标内容类型、熟悉度等级、可选新鲜度约束、临时标题 $t_0$、临时副标题 $d_0$,以及自然语言货架假设 $q$。
论文给的例子:一个对北欧氛围乐、后摇、现代古典有强偏好的用户,可能收到 "glacial ambient post-rock with orchestral textures" 这样一条假设。论文点明其相对模板的表达力优势:
与固定的货架模板不同,假设可以表达狭窄的流派交集、艺人邻域、年代、语言、情绪与收听情境。
从前沿模型到蒸馏模型:系统的早期版本用前沿 LLM(frontier LLM)以批处理模式做这一步。为支撑生产规模的货架生成,团队把这个行为蒸馏进一个紧凑的开源 LLM,部署在 GPU 批处理集群上。蒸馏后的模型接收用户画像的紧凑序列化,输出结构化的货架假设。schema 把生成器约束在下游阶段所需的字段上,同时仍允许假设文本自由发挥;非法或缺失的类目值被映射到安全默认值;生成的假设按用户打成 bundle 交给下游检索与过滤。
Stage 2:目录履行(受约束生成式检索)¶
履行阶段把货架假设接地到具体目录实体:在尊重内容类型、熟悉度、路由约束的前提下,检索能实例化该货架概念的 item。
论文把履行形式化为一个生成式检索问题:模型不去对所有候选 item 直接打分,而是生成 Semantic ID(SemID)——在目录实体上学到的紧凑离散标识符。检索因此通过在 SemID 上做序列生成完成,生成的标识符随后被解析为 Spotify 目录 item。
履行模型建在一个更小的开源 LLM 上,其词表被扩展了以 Spotify 目录数据为基础学习的 SemID(过程类似 [5,9])。为保证生成的标识符总是对应到有效的目录实体,解码被内容类型特定的索引(实现为 trie 前缀树)所约束;专辑、艺人、编辑歌单、播客节目、播客单集各自维护独立的 trie。
关键设计:履行模型接收假设 + 描述目标货架类型与检索约束的元数据,但不接收完整用户画像。论文明确说这是刻意的——用户特定的推理已经在假设生成阶段发生过了,履行阶段解决的是一个更窄的问题:检索能实现该货架概念的目录实体。
不同货架类型走不同的受约束索引:
- 编辑类货架 → 市场特定的编辑索引;
- 新发行货架 → 按时效过滤的索引;
- 熟悉类货架 → 即时构造(on-the-fly) 的"用户已熟悉目录实体"索引;
- 发现类货架 → 更宽的目录索引。
生成的 SemID 随后被解析为 Spotify URI,并按类型一致性、既往收听、熟悉度约束做过滤。这套约束共同确保履行始终忠于生成出的货架假设,同时产出有效、类型一致、可直接上生产的目录推荐。
Stage 3:候选精选与货架对齐¶
受约束履行产出的是一个排序候选集而非最终展示列表。论文指出这里有一个货架推荐特有的挑战:
许多被检索到的 item 可能单独看都匹配货架假设,但在完整推荐行的层面这个货架仍可能失败。特别是,展示出的货架标题可能夸大(overstate)、缩小(understate)或以其他方式错误刻画(mischaracterise) 被检索到的 item 集合。
于是引入候选精选与货架对齐阶段,联合优化最终货架内容与用户可见文案:给定原始假设、临时标题 $t_0$、临时副标题 $d_0$、以及富化后的候选元数据,一个 LLM 挑选最终的 $k$ 个 item,并重写标题与副标题产出 $t, d$。
论文再次强调其与通用排序检索的区别:
货架标题是对整行的一个承诺:即便被检索到的 item 都合理,只要其展示文案描述的是一个更窄、更宽或不同的概念,这个货架仍然失败。
因此候选精选与货架对齐是把货架当作一个连贯的推荐单元来优化,在 item 相关性、集合连贯性、多样性、标题承诺兑现之间做权衡。对齐阶段还在架构上制造了检索与呈现之间更干净的分离:履行负责取回能实现货架概念的实体,对齐负责让货架文案忠实反映最终检索集——这使得检索质量与呈现质量可以在评测框架里被独立分析。
Stage 4:服务¶
最终阶段把生成的货架集成进 Home 推荐界面。由于规划、履行、对齐都已离线完成,服务时只需取回预计算的货架候选去做排序与呈现。
一个重要的产品决策:这些货架不是钉死的固定位(pinned placements),而是通过平台的排序机制与其他 Home 候选竞争。这让部署变成增量式的——在不引入任何额外 Home 服务延迟的前提下,扩充个性化货架候选的供给。
服务阶段也保留了离线货架生成与在线排序之间的分离。论文坦承一个评测上的麻烦:货架的参与度强烈受到货架位置以及生产排序器如何挑选和排列货架的影响,导致不同货架族之间难以直接比较。为削弱这些效应,§4 的线上评测采用均匀随机探索(uniform random exploration):货架顺序独立于生产排序器被随机化,从而可以在一个已知的曝光策略下比较货架表现。
同一套结构化货架表示在"已履行货架 / 已对齐货架 / 服务记录"之间保持一致。这种模块化使得单个阶段可以被替换或消融(前沿 vs 蒸馏假设生成、受约束 vs 无约束履行、有 vs 无货架对齐),而不改变下游服务行为。
实验设置与评测方法论¶
论文围绕四个问题组织评测:
- 假设生成器是否产出个性化且足够具体的货架概念?
- 生成式检索履行这些假设是否比词法与嵌入式检索基线更有效?
- 候选精选与货架对齐是否改善最终货架的连贯性与呈现质量?
- 最终货架在均匀随机曝光下于 Home 上表现是否有竞争力?
为什么必须用 LLM-as-a-Judge¶
论文用了整整一小节论证方法论选择,理由值得完整摘录:
货架生成任务不存在简单的黄金标准离线目标。与常规推荐设定不同,本系统不是在一个"预先撰写好的货架清单 + 历史相关性标签 + 标准正确答案"上做排序,而是生成新的货架假设并把它们接地到目录实体。在这种开放式设定下,诸如"对留出 item 的召回"或"在固定候选集上的排序质量"这类标准离线指标,并不直接度量一个生成出的货架概念是否恰当、检索到的 item 是否实现了该概念、以及最终货架放到 Home 界面上是否说得通。
进一步的核心论断:
货架质量本质上是集合级(set-level)而非点级(pointwise)的。 一个货架可能在其中若干单个 item 都合理的情况下仍然失败:这一行可能内部不连贯、遗漏了标志性 item、缺乏有用的多样性,或者没有兑现其标题与副标题所隐含的语义承诺。反过来,一个货架也可能因为其 item 协同作用为一个连贯的推荐单元而成功——而这个性质是 item 级相关性分数捕捉不到的。
这一策略有近期工作支撑:LLM 生成的相关性判断可以追踪人类判断并保持推荐器排序的可比性,包括在工业推荐场景 [14];强 LLM 判官在开放式生成任务中能逼近人类偏好判断,但仍存在需要谨慎协议设计的已知偏差 [26]。因此论文的定位是:LLM 判官作为早期流水线阶段的方向性离线信号(用于优化与失败模式分析),而把线上用户行为作为货架质量的最终度量。
两个判官与 0–2 序数量表¶
§3 的架构分解诱导出两条互补的评测边界:生成的货架假设对目标用户是否恰当?检索到的 item 是否成功实现了该假设?于是设两个判官,分别作用在流水线的两个主要中间产物上——货架假设与已履行货架。
两个判官都用 0–2 序数量表(0 = fail,1 = fair,2 = good)。论文明确解释了这个量表选择:
- 更粗的量表降低 rubric 歧义、提升人类与 LLM 打分者之间的一致性,而更细粒度的量表往往放大而非解决中间档位上的分歧 [19];
- 把输出限制在少量良好分离的类别上,还能让判官行为在不同 prompt 表述与重复运行之间更稳定 [24];
- 同时 0–2 仍保留足够分辨率去区分"失败 / 边缘 / 可接受",而不引入更细粒度上观察到的校准漂移。
User-to-Hypothesis Judge:评估生成的货架假设对目标用户是否恰当。它以近期用户参与信号(如 top artists、top shows、近期消费 item)+ 生成的货架假设与标题为条件,但不观察检索到的货架 item,从而把假设生成阶段的评测隔离出来。
Table 2: User-to-Hypothesis Judge 评分维度
| 维度 | 度量什么 |
|---|---|
| Taste Alignment(口味对齐) | 假设是否被用户历史中的直接证据支撑;满分需要多个不同信号 |
| Personalisation Depth(个性化深度) | 假设是否捕捉到一个用户特有的、区分性的属性交集,而非宽泛的编辑式框定 |
| Discovery Potential(发现潜力) | 假设是否把用户延伸到邻近但可信的领地;既惩罚炒冷饭、也惩罚无根据的新奇 |
| Hypothesis Specificity(假设具体度) | 假设是否携带足够的多轴内容信号去约束检索,同时不塌缩成一个 item 级 query |
| Title Quality(标题质量) | 用户可见标题是否吸引人、有代表性、可理解 |
Hypothesis-to-Shelf Judge:评估检索到的目录 item 是否成功实现了生成的货架假设。它以货架标题、副标题、假设、以及用 genre / origin / year / language 等元数据富化后的渲染 item 列表为条件。
Table 4: Hypothesis-to-Shelf Judge 评分维度
| 维度 | 度量什么 |
|---|---|
| Style Match(风格匹配) | item 级风格属性与假设所指定属性的对齐,含流派、年代、主题、格式、调性 |
| Item Relevance(item 相关性) | 每个 item 是否是所述 niche 的可信代表;凑数项、热度错配、边缘相关项被惩罚 |
| Shelf Coherence(货架连贯性) | item 集合是否通过年代、场景、声音或策展逻辑串得起来;独立于假设契合度评估 |
| Hypothesis Coverage(假设覆盖度) | 货架是否处理了假设中点名的具体细微差别;满分要求每一处不同的 nuance 都被反映 |
| Completeness(完备性) | 与该假设关联的标志性(canonical)item 是否在场——即该货架能否满足一个内行用户的基线期待 |
| Diversity(多样性) | 货架是否在保持"不跑题"的同时变化其 item;高度集中的货架被惩罚,除非概念本身明确要求 |
| Title Promise Fulfilment(标题承诺兑现) | item 是否满足标题与副标题做出的显式声明;判官还会记录承诺未兑现时的主要错配轴 |
主要实验结果¶
假设质量(Stage 1)¶
Table 5: Stage 1 假设质量,User-to-Hypothesis Judge(0–2)。均值 ± 10k 次重采样得到的 95% bootstrap 置信区间半宽。此处评的是模型开发期使用的前沿 LLM 生成器。
按评分维度:
| 指标 | 分数 |
|---|---|
| Overall | 1.59 ± 0.01 |
| Taste Alignment | 1.59 ± 0.01 |
| Personalisation Depth | 1.45 ± 0.01 |
| Discovery Potential | 1.31 ± 0.01 |
| Hypothesis Specificity | 1.99 ± 0.00 |
| Title Quality | 1.76 ± 0.01 |
按内容类型:
| 内容类型 | 均分 |
|---|---|
| Album | 1.90 ± 0.01 |
| Artist | 1.98 ± 0.01 |
| Playlist | 1.86 ± 0.01 |
| Show | 0.66 ± 0.03 |
| Episode | 0.51 ± 0.05 |
结论分析:生成的假设整体得分很强,其中假设具体度(1.99,几乎满分)与标题质量(1.76)尤为突出——说明系统产出的是具体的、面向用户的货架概念,而不是含糊的推荐 prompt。定性抽检也显示同样模式:多数生成假设具体、可信、可辨识地扎根于目标用户上下文。但按内容类型拆开后暴露出一个尖锐的裂口:音乐类(专辑 1.90 / 艺人 1.98 / 歌单 1.86)全面优秀,口语类(节目 0.66 / 单集 0.51)几近不及格。这条裂口后面会在线上数字里再次出现(播客节目池 −41%)。另外值得注意的是 Discovery Potential 只有 1.31,是维度里最低的——说明"把用户延伸到邻近但可信的新领地"仍是这套生成器最弱的一环。
蒸馏一致性检查(parity check):由于生产流水线用的是 §3 描述的蒸馏开源生成器,论文另做了一次对齐性验证——在来自 Stage 1 画像快照的固定 800 个用户画像队列上,用同一个 User-to-Hypothesis Judge 评测前沿 LLM 基线与蒸馏学生模型。结果:两者整体分实质上没有变化——78.3% vs 78.2%,维度层面只有微小且方向混杂的差异。这支撑了在生产中使用蒸馏生成器,不会让假设生成成为质量损失的主要来源;也正因如此,论文把注意力更强地转向下游的目录履行。
论文对这一节的总结是:表现在音乐导向的假设上最强,而口语类货架概念仍更具挑战;综合来看,更要命的质量瓶颈在下游的目录履行。
目录履行质量(Stage 2)¶
为隔离出 Stage 2 履行模型的贡献,论文在同一批来自 1,000 用户评测队列的 10,000 条货架假设上,把生成式检索与三个检索基线对比:BM25 [17]、MiniLM [18] 稠密检索、以及 BM25 与 MiniLM 分数的等权线性插值(Hybrid, α=0.5)。所有方法都在假设指定的内容类型内履行,并用同一个 Hypothesis-to-Shelf Judge 评测。
Table 3: Hypothesis-to-Shelf Judge 下的目录履行质量(0–2)。均值 ± 10k 次重采样的 95% bootstrap CI 半宽。加粗为最优、下划线为次优(此处以粗体标注最优)。 表示在双侧配对 $t$ 检验 + Bonferroni 校正下,生成式检索超过该指标上最强的非生成式基线(校正后 $p < 0.001$)。*
| 方法 | Overall | Style | Relev. | Coher. | Coverag. | Compl. | Divers. | Title |
|---|---|---|---|---|---|---|---|---|
| BM25 | 0.56±0.02 | 0.87±0.02 | 0.84±0.02 | 0.93±0.02 | 0.92±0.02 | 0.75±0.02 | 1.06±0.02 | 0.54±0.02 |
| Dense (MiniLM) | 0.39±0.01 | 0.67±0.01 | 0.65±0.01 | 0.73±0.02 | 0.78±0.01 | 0.61±0.02 | 0.94±0.02 | 0.37±0.01 |
| Hybrid (α=0.5) | 0.49±0.01 | 0.78±0.01 | 0.76±0.02 | 0.82±0.02 | 0.92±0.01 | 0.74±0.02 | 1.06±0.02 | 0.46±0.01 |
| Generative Retrieval | 0.71±0.02*** | 0.99±0.01*** | 1.04±0.01*** | 1.05±0.01*** | 1.15±0.01*** | 1.28±0.02*** | 1.39±0.01*** | 0.66±0.02*** |
结论分析:生成式检索在每一个评分维度上都超过所有词法与嵌入式基线,最大增益出现在 Completeness(0.75→1.28,+71%)、Diversity(1.06→1.39,+31%)、Hypothesis Coverage(0.92→1.15,+25%)。这些提升在跨 24 组 method × dimension 比较做 Bonferroni 校正后仍然显著。论文把这一结果读作对全文中心假设的支撑:
许多货架概念所需的目录关联,是无法仅通过直接的词法或嵌入相似性恢复的。
几个更细的观察值得注意:
- 稠密检索(MiniLM)反而全面差于 BM25(Overall 0.39 vs 0.56),混合也没能超过纯 BM25。这说明通用句嵌入在"把一段风格化的货架假设映射到目录实体"这件事上并不比精确词法匹配更强,甚至更弱——很可能是因为目录实体侧的文本描述与假设文本处在不同的语域。
- 相对性能差距在不同内容类型上不均匀。当目录实体带有丰富的人工策展描述符、且这些描述符与货架假设用词高度贴近时,词法基线更有竞争力(BM25 尤其受益),直接文本匹配能恢复相当一部分目标信号。而当货架概念是通过风格化联想、更宽的文化语境、或只在 item 元数据里弱表征的属性组合间接表达时,词法基线的表现就退化了。
- 论文对"那能不能靠人工堆描述符补上"给了明确回应:原则上部分差距可以通过为每个目录域做大量人工描述符工程来缩小;但在生产规模下维护这类描述符昂贵、内容类型特定、且难以与不断演化的生成式货架假设语言对齐。生成式检索提供的是一个可扩展的替代方案——直接学习把富有表现力的货架假设映射到目录实体,无需穷尽式的人工描述符设计。
候选精选与货架对齐的效果(Stage 3)¶
这一分析对比目录履行刚结束时的货架与经过 Stage 3 对齐后的生产货架。对齐前队列含 10,000 个货架,对齐后生产队列含超过 16,000 个货架;两个集合不共享任何货架标识符。因此论文使用双侧 Welch 独立样本 $t$ 检验并在 8 个报告维度上做 Bonferroni 校正(*** 表示校正后 $p<0.001$)。
Table 6: Stage 3 货架对齐的效果,Hypothesis-to-Shelf Judge(0–2)
| 指标 | Pre | Post | Δ (%) |
|---|---|---|---|
| Overall | 0.71±0.02 | 1.27±0.01 | +78%*** |
| Style Match | 0.99±0.01 | 1.51±0.01 | +52%*** |
| Item Relevance | 1.04±0.01 | 1.58±0.01 | +52%*** |
| Shelf Coherence | 1.05±0.01 | 1.64±0.01 | +56%*** |
| Hypothesis Coverage | 1.15±0.01 | 1.37±0.01 | +19%*** |
| Completeness | 1.28±0.02 | 1.46±0.01 | +14%*** |
| Diversity | 1.39±0.01 | 1.74±0.01 | +25%*** |
| Title Promise | 0.66±0.02 | 1.31±0.01 | +99%*** |
结论分析:候选精选与货架对齐显著提升整体货架质量,把整体判官分从 0.71 抬到 1.27(+78%),且每一个评分维度都改善。增益结构非常说明问题:
- 最大增益在 Title Promise(+99%,近乎翻倍)——这正是 Stage 3 被设计出来解决的那个失败模式(标题夸大/错配)。
- 其次是 Shelf Coherence(+56%)、Item Relevance(+52%)、Style Match(+52%)——即"集合级质量"与"呈现级质量"。
- 而更依赖检索本身的维度增益最小:Completeness 仅 +14%、Hypothesis Coverage 仅 +19%。这是符合直觉的:对齐阶段只能从已被检索出的候选池里做精选与改写,补不回检索阶段就没取到的标志性 item。这也反过来印证了 Stage 2 才是内容供给上限的所在。
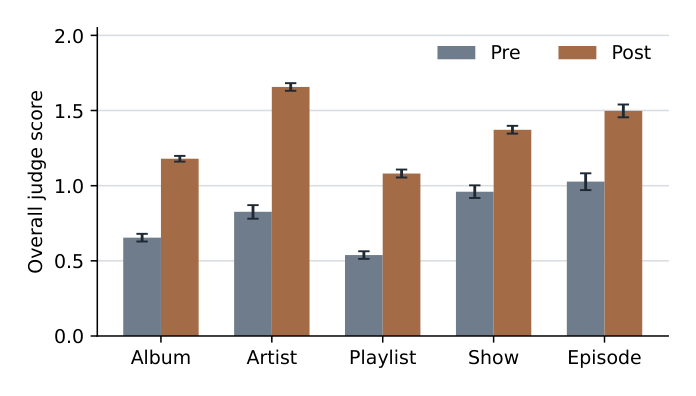
论文对 Figure 3 的解读是:同样的模式跨内容类型成立——所有组在对齐后都改善,其中歌单与艺人的相对增益尤其大。这些发现共同支撑了 Stage 3 的动机:
仅有检索质量是不够的,因为货架文案充当着对整行的语义承诺。
均匀随机曝光下的线上表现(Stage 4)¶
最后评估假设驱动的货架在 Home 上真实用户行为层面是否有竞争力。与前几个阶段评测中间产物和语义质量不同,这一阶段聚焦于生成货架被真正服务时的观测用户行为。
由于 Home 上的货架参与度强烈受排序位置以及生产排序器如何挑选/排列货架的影响,在标准服务策略下直接比较货架族是困难的。为削弱这些效应,论文采用工业推荐评测的标准随机曝光协议 [3]:一小部分 Home 请求被分配到均匀随机探索,货架顺序独立于生产排序器随机化。一个重要细节——分配发生在请求级(request level)而非用户级(user level),这样可以收集探索曝光而不让任何用户持续暴露在随机化的信息流下。
Table 7: 跨内容类型 shuffle pool 的均匀随机探索汇总。对每个 pool,报告该 pool 中观测到的最强假设驱动货架与最强经典对照货架。单元格为 30 秒流播率(30-second stream rate),单位为百分点,均值 ± 95% bootstrap CI 半宽;Δ 为相对百分差。论文明确声明:这些是 pool 内的描述性对比,不是汇总的因果效应估计。
| 内容类型 | 假设驱动 (%) | 最佳经典货架 (%) | 排名 | Δ (%) |
|---|---|---|---|---|
| Album | 1.20 ± 0.13 | 0.88 ± 0.09 | 1 / 10 | +36% |
| Artist | 0.82 ± 0.17 | 0.89 ± 0.06 | 2 / 9 | −8% |
| Playlist | 0.92 ± 0.09 | 1.07 ± 0.07 | 5 / 15 | −14% |
| Show | 0.92 ± 0.31 | 1.57 ± 0.11 | 2 / 6 | −41% |
| Episode | 0.63 ± 0.20 | 0.62 ± 0.08 | 1 / 7 | +2% |
结论分析:假设驱动货架在专辑池(+36%)与单集池(+2%)取得该池内最强的观测均值(分别排名 1/10 与 1/7),在艺人池与节目池排名第二。在歌单池与节目池表现较弱——既有的生产货架仍保持优势。最大差距出现在节目池(−41%),论文直接把它读作"改进播客货架生成的明确空间(clear headroom)"。
论文自己的总结口径相当克制:
尽管跨内容类型表现有差异,假设驱动货架在多数 pool 里与强大的既有货架具有竞争力,同时大幅扩展了个性化推荐供给的灵活性与多样性——超出固定模板库存所能覆盖的范围。
几点需要读者自行留意的方法论保留:(1) 论文明确标注这些是 pool 内的描述性对比而非汇总因果效应估计;(2) 每个池只报告"最强的假设驱动货架 vs 最强的经典货架",这是一种取极值的对比口径,不是货架族的平均效果;(3) 节目池的假设驱动货架置信区间半宽高达 ±0.31,曝光量明显偏薄;(4) 指标是 30 秒流播率这一单一近端指标,没有报告任何长期或用户级留存指标。
核心贡献总结¶
- 把货架生成重构为"假设驱动的规划问题":识别出人工模板把「满足什么需求 / 什么内容算有效实现 / 用什么系统检索」三个决策耦合死了这一 root cause,并用一条自然语言假设把三者解开。这是全文最有价值的架构 insight。
- "货架假设作为规划与履行之间的契约" $h=(q,c,f,r,t_0,d_0)$:同时具备表达力(自由文本 $q$)、可约束性(结构化字段 $c,f,r$)、可评测性(每个字段对应一条评测挂钩)。这个三重要求的显式表述,比具体实现更有可迁移价值。
- 刻意不给履行模型完整用户画像:用户级推理只发生在 Stage 1,Stage 2 只解一个"给定概念取回实体"的窄问题。这既是解耦的落实,也让履行模型可以做得更小、更容易被 trie 约束住。
- 按内容类型分索引的受约束生成式检索:编辑/新发行/熟悉/发现四类货架各自解码到不同的 trie(其中"熟悉类"用即时构造的用户已熟悉实体索引),把产品约束直接写进解码空间而非事后过滤。
- 一套按阶段切分的 LLM-as-a-Judge 方法论:两个判官 + 12 个评分维度 + Table 1 那张"阶段 × 失败模式 × 评测挂钩"矩阵,加上对 0–2 序数量表的显式论证(粗量表降低 rubric 歧义、提升人机一致性、跨 prompt 更稳定)。这是本文对社区最可复用的产出。
- 前沿 LLM → 紧凑开源模型蒸馏的一致性验证:800 用户队列上 78.3% vs 78.2%,以数据支撑"蒸馏不是质量瓶颈"的判断,并据此把优化重心转向履行阶段。
- 诚实披露不利线上数字:5 个内容池里 3 个为负(艺人 −8%、歌单 −14%、节目 −41%),且主动标注"描述性对比而非因果估计"。在工业论文里这种自我设限相当少见。
与已归档相关工作的对比¶
LLM-Based User Personas for Recommendations at Scale LLM-Based User Personas for Recommendations at Scale(Google / Google DeepMind,2026-06-10)¶
关系:独立并发(本文未引用该工作,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在解同一个 root cause——工业推荐系统能表达的"用户意图"被既有的离散工件锁死了。Spotify 这边是固定的货架模板库存(模板数量有限,覆盖不了「流派 × 年代 × 情绪 × 熟悉度」的组合爆炸);Google 那边是固定的预定义 cluster 词表(既有"规模化推理"框架只让 LLM 在一个小而固定的 cluster 标签集合里输出,还受限于离线查找表的组合复杂度,只能用用户最后 2 个观看视频)。两者的解法方向完全一致:把这个离散瓶颈换成自由形式的自然语言。
- 相近的技术骨架:两者本质上是同一张流程图。Google 论文把它明确命名为分层规划范式(hierarchical planning paradigm)——「高层语言策略:LLM 生成一段对用户下一个兴趣的自然语言描述」+「低层 item 策略:经典推荐模型把这些兴趣接地(ground) 到 item 空间」。Spotify 的「Stage 1 假设生成 + Stage 2 履行」就是这套范式的逐字对应,只是它把中间表示从"兴趣画像"换成了"货架假设"。更巧的是接地机制也同构:Google 在最近邻检索上"引入一个语义约束,把检索限制在与 LLM 生成的文本兴趣语义相关的 item 子集上,从而把生成空间收束到用户的文本兴趣之内";Spotify 则用内容类型特定的 trie 把 SemID 解码空间收束到有效且合规的目录实体。两者还都做了前沿模型 → 紧凑模型的知识蒸馏(Gemini 1.5 Pro → Gemini Nano/Flash;前沿 LLM → 紧凑开源 LLM),并且都用离线/异步生成把 LLM 推理挪出在线服务路径。
- 本文的差异与推进:(1) 中间表示的粒度不同——Google 的 persona 是用户级的兴趣画像(Summarized Interests + Exploration Interests),Spotify 的 hypothesis 是界面单元级的货架概念,自带目标内容类型、熟悉度、路由约束、临时标题等结构化字段,可以直接驱动检索与过滤,而不只是一段供下游软性参考的文本;(2) 多了一个呈现层——Spotify 有 Stage 3 的"标题承诺兑现"问题(货架标题是对整行的承诺,可能夸大/缩小),Google 的 persona 并不直接展示为一行内容的标题,因此没有这个失败模式;(3) 接地方式不同——Google 复用生产里已高度优化的 transformer 序列模型 + 受限最近邻检索,Spotify 走的是 SemID 生成式检索,并实测其显著优于词法/嵌入基线。
- 可比的方法 / 实验差异:两者的探索/发现维度都是弱项且都被单独度量——Google 显式设计 Exploration Interests 分支去外推新主题缓解反馈回路,Spotify 的 Discovery Potential 是五个维度里最低的(1.31)。蒸馏一致性验证的方法论几乎一致:Google 通过 Insight 3 发现"模型规模在总结任务上存在饱和点(Pro→Ultra 提升趋于饱和)"从而决定蒸馏,Spotify 则用 800 用户队列直接实测前沿 vs 蒸馏为 78.3% vs 78.2%——两条不同路径得到同一个结论:这类"生成自然语言用户意图"的任务所需推理能力有上限,可以安全地压进小模型。线上口径差异明显:Google 报告的是十亿级用户、30+ 天正式 A/B 的观看时长 +0.04% / 活跃用户 +0.03%(统计显著);Spotify 只报告了均匀随机曝光下的描述性 pool 内对比,且 5 个池里 3 个为负——Google 的线上证据强度明显更高,Spotify 的线上部分仍处于早期。
RecGPT RecGPT Technical Report(Alibaba 淘天集团,2025-07-30)¶
关系:独立并发(本文未引用 RecGPT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:RecGPT 的核心命题是传统推荐都在 "learn clicks from clicks"——用历史共现拟合下一次点击,缺乏对用户意图的显式理解,于是不断强化已暴露偏好、放大信息茧房与马太效应。Spotify 的诊断在形式上不同(模板库存有限)但指向同一个结构性缺陷:系统里没有一个显式的、可被推理和检查的"意图"层——旧范式要么把意图隐式编码在模型权重里(RecGPT 的批评),要么把意图硬编码在人工模板里(Spotify 的批评)。两者的答案都是把意图外化为自然语言,让它成为流水线里一个可独立优化、可独立评测的一等公民。
- 相近的技术骨架:两者都是四阶段的"LLM 生成自然语言意图 → 接地到目录 item → 组装成可展示单元" 管线。RecGPT 是「$\mathcal{LLM}_{\text{UI}}$ 用户兴趣挖掘 → $\mathcal{LLM}_{\text{IT}}$ item tag 预测 → User-Item-Tag 三塔检索 → $\mathcal{LLM}_{\text{RE}}$ 解释生成」;Spotify 是「假设生成 → SemID 受约束履行 → LLM 货架对齐 → Home 服务」。逐段对应关系相当整齐:RecGPT 的"自然语言 tag"≈ Spotify 的"货架假设 $q$";RecGPT 的"三塔把 tag 接地到商品"≈ Spotify 的"trie 约束把 SemID 接地到目录实体";RecGPT 的"解释生成"≈ Spotify 的"标题/副标题重写"——两者都意识到光把 item 取回来还不够,还必须生成一段忠实的用户可见文案。此外两者都做了前沿/教师模型 → 生产小模型的蒸馏(DeepSeek-R1 → Qwen3-SFT / TBStars-SFT;前沿 LLM → 紧凑开源 LLM),都把 LLM 推理离线化预计算(RecGPT 的兴趣双周刷新、解释查找表离线预生成;Spotify 的每日批处理),也都用 LLM-as-a-Judge 做规模化质量把关。
- 本文的差异与推进:(1) 意图的落点不同——RecGPT 的 tag 最终服务于单个商品的召回(改善候选生成的相关性与长尾覆盖),Spotify 的假设最终服务于一整行内容的组装,因此 Spotify 必须处理 RecGPT 完全不面对的集合级质量问题(连贯性、多样性、完备性、标题承诺);(2) 接地技术路线不同——RecGPT 用判别式的三塔向量检索($\hat y_{\text{final}}=\beta\hat y_{\text{col}}+(1-\beta)\hat y_{\text{sem}}$,融合协同分与语义分),Spotify 用 SemID 上的受约束自回归生成;有意思的是 RecGPT 精读里记录的 V1 已知瓶颈之一正是"tag 作为 lossy 文本信道承载不了 item 级细粒度证据"(该问题在 RecGPT-V3 里靠引入 Semantic ID 修复),而 Spotify 的方案从一开始就用 SemID 做接地信道——某种意义上直接跳过了 RecGPT 走了两代才补上的那一步;(3) 是否消费用户画像——RecGPT 的检索塔仍然吃 user embedding(协同分),Spotify 则刻意不把用户画像给履行模型,把用户级推理严格锁在 Stage 1。
- 可比的方法 / 实验差异:LLM 判官的设计哲学明显不同。RecGPT 走的是"多维拒绝采样 + 人机协同评审"(Willingness/Reasonableness、Relevance/Consistency/Specificity/Validity 等四维质控,加 Milestone-Based Human Supervision 做周期性人工校准),重点是训练数据质控;Spotify 走的是"按流水线阶段切分的评测边界"(Table 1 的阶段 × 失败模式 × 评测挂钩矩阵),重点是定位瓶颈在哪一段,并对 0–2 粗量表给出了明确的心理测量学论证。线上证据的强度差距悬殊:RecGPT 全量部署淘宝首页「猜你喜欢」,一个月 A/B 拿到 CTR +6.33% / IPV +9.47% / CICD +6.96% / DT +4.82% 的全线正向;Spotify 只有均匀随机曝光下的早期描述性对比,5 个内容池 3 负 2 正。这个差距很大程度上来自成熟度而非路线优劣——但也提示:「LLM 生成自然语言意图」这条路线在商品域(tag 与商品标题语域接近、意图可被购买行为直接验证)比在内容/口味域(风格化描述与目录元数据语域错位,尤其是播客)更容易兑现收益,这一点恰好被 Spotify 自己 Table 3 里"BM25 在有丰富人工描述符时更具竞争力"的观察和播客全线塌陷所印证。
讨论与局限性¶
值得借鉴的设计¶
- "承诺"作为一等的设计对象。论文反复强调货架标题不是 UI 标签而是对整行的承诺,并据此单独设立 Stage 3 与 Title Promise Fulfilment 维度。任何做"带标题的内容聚合单元"(频道、专题、合集、卡片组)的系统都可以直接借用这个抽象——检索质量与承诺兑现是两个正交的失败模式,必须分开优化、分开度量。
- 把产品约束写进解码空间而非事后过滤。按内容类型维护独立 trie、按货架类型切换索引(编辑索引 / 时效索引 / 用户熟悉实体的即时索引 / 全目录索引),使得"生成非法或不合规实体"在结构上不可能发生,而不是靠后置规则去补。
- 阶段 × 失败模式 × 评测挂钩矩阵(Table 1)。这张表让"瓶颈在哪一段"从争论变成可实证的问题,并直接指导了论文自身的结论走向(Stage 1 蒸馏无损 → 重心转 Stage 2;Stage 3 只提升呈现类维度、补不回 Completeness → Stage 2 才是供给上限)。
- 对评分量表的显式论证。多数工业论文的 LLM 判官量表是拍脑袋定的,本文引用 [19,24] 论证 0–2 粗量表在人机一致性与跨 prompt 稳定性上的优势,值得在自建 LLM 评测体系时照抄这条思路。
局限与争议¶
- Stage 3 的 +78% 建立在非配对队列上。对齐前 10,000 个货架与对齐后 16,000+ 个货架不共享任何货架标识符,论文因此只能用 Welch 独立样本 $t$ 检验。这意味着"对齐带来 +78%"这个数字里混杂了两个队列在假设分布、用户分布、时间窗上的差异,不是一个干净的因果估计。相比之下 Table 3 的履行对比用的是同一批 10,000 条假设 + 配对 $t$ 检验,严谨得多。这是全文最大的实验设计短板,而恰恰发生在增益最大的那个数字上。
- 离线评测完全依赖 LLM 判官,无人工标注校准。论文引用 [14,26] 论证 LLM 判官与人类判断的相关性,但没有在自己的场景上报告任何人机一致性(agreement)数据——没有 Cohen's κ、没有人工抽检通过率。对比 RecGPT 报告了每个任务上 LLM 判官 vs 人工的 ACC(如解释生成 56.77%→89.76%),本文这一环是空的。所有离线结论因此都建立在"判官是可信的"这个未经本地验证的前提上。
- 线上证据薄弱且口径宽松。5 个内容池里 3 个为负;每池只比"最强 vs 最强"这一取极值口径;节目池 CI 半宽 ±0.31 说明曝光量很薄;唯一指标是 30 秒流播率这一近端信号,没有留存或长期指标;而且是均匀随机曝光而非标准生产排序下的效果(论文把后者列为 future work)。论文自己也标注"描述性对比而非汇总因果效应估计"——这份克制值得称道,但也意味着"假设驱动货架比模板货架更好"这个命题目前尚未被线上数据证实,论文实际证明的是"在多数场景下不比现有货架差,同时供给面大幅扩展"。
- 播客/口语内容全线塌陷。Stage 1 假设质量 Show 0.66 / Episode 0.51(vs 音乐类 1.86–1.98),线上 Show 池 −41%。论文只用一句"clear headroom"带过,没有分析原因。合理猜测是:音乐目录实体有丰富的流派/年代/情绪标签可供 SemID 学习与假设匹配,而播客的主题语义主要在音频内容本身而非元数据里,导致"风格化假设 → 目录实体"的映射在口语域失效。这实际上暴露了整套路线的一个前提条件:目标目录必须已经具备足够丰富的语义可及性。
- 两阶段解耦的方法论上限。规划器与履行器无法端到端联合优化——履行器甚至刻意看不到用户画像。这带来了可控性与可评测性,但代价是:当履行阶段发现"这条假设在目录里根本无法被良好实现"时,没有任何信号能反馈回规划器去修正假设。论文自己在 future work 里把"planning 与 fulfilment 更紧的集成"列为首要方向,正是承认了这一点。按本项目的评分标准,这是典型的"显式多阶段解耦"扩展性隐患:参数量 scaling 时,规划能力与接地能力无法同步增长,两者之间的信息瓶颈(一条自然语言假设 + 几个结构化字段)是固定的。
- 技术组件层面的单点新颖性有限。SemID 生成式检索来自 [16] 及 Spotify 自家的 [5,9,13];trie 约束解码是标准做法;LLM 重写文案是常规用法;蒸馏是既有工程实践。论文的贡献几乎完全在架构分解与评测方法论层面,而非任何单个技术组件。
- 训练细节几乎全部缺失。假设生成器的蒸馏数据构造、履行模型的 SemID 训练目标、对齐 LLM 的 prompt 与选择策略、$k$ 的取值、模型规模——一概未公开。论文可复现性很低,只能作为架构参考而非实现指南。
工业落地价值¶
- 部署形态是增量式的,风险低:生成货架作为候选注入 Home 排序与既有货架竞争,而非钉死固定位。这意味着即使生成货架质量参差,劣质货架也会被排序器自然过滤掉,不会直接伤害用户体验。这是一个非常务实的上线路径,值得所有"用 LLM 生成新型推荐单元"的项目参考。
- 全离线批处理 = 零额外服务延迟:所有 LLM 调用(假设生成、货架对齐)与生成式检索都在每日批处理里完成,服务时只做一次预计算结果的取回。代价是无法响应实时意图——论文把"超越完全预计算、走向近实时货架生成"列为 future work。
- 供给侧扩展的价值独立于点击收益:即便线上参与度只是"持平",这套系统把个性化推荐的供给多样性扩展到了固定模板库存覆盖不到的长尾区域。对一个内容平台而言,这本身可能就是值得投入的战略性收益——尽管论文没有给出任何供给多样性的量化指标来支撑这一说法。