RecGPT Technical Report 精读¶
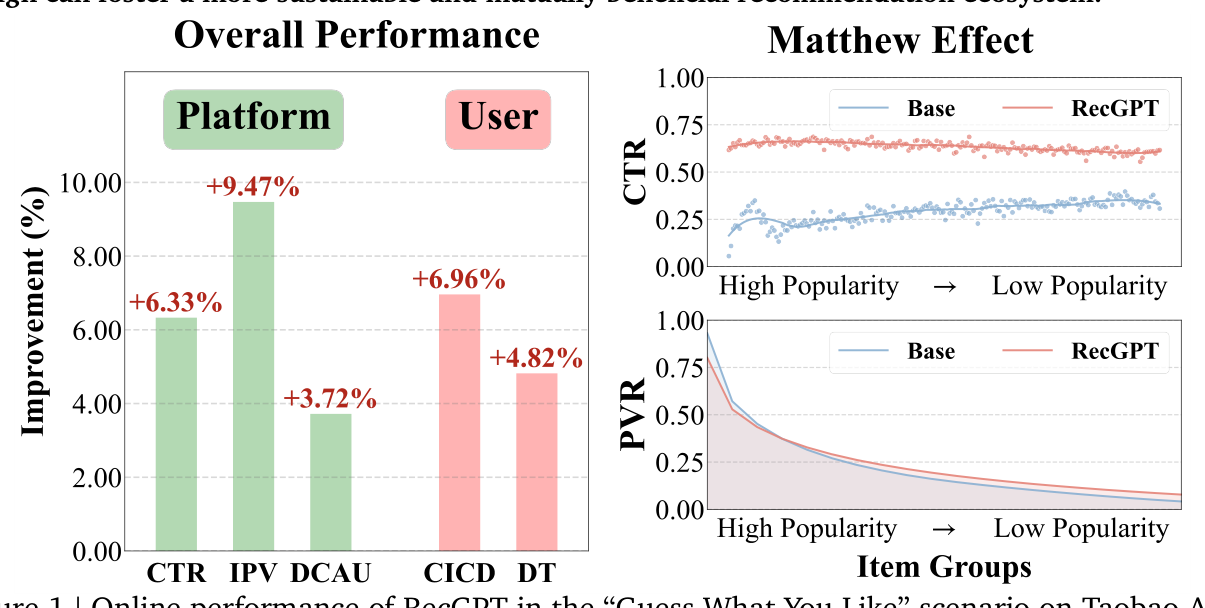
Alibaba 淘天集团「RecGPT Team」,2025-07(arXiv:2507.22879,42 页)。这是阿里 RecGPT 系列(V1→V2→V3→Mobile)的开篇 V1:第一个把「LLM 显式推理用户意图」真正接进十亿级工业推荐主链的系统。核心命题——传统推荐都在「learn clicks from clicks」(用历史共现拟合下一次点击),只放大用户已暴露的偏好、加剧信息茧房与马太效应;RecGPT 把「用户为什么想要」放到流水线中心,用三个推理型 LLM 重构「用户兴趣挖掘 → item tag 预测 → item 检索 → 解释生成」闭环。已全量部署于淘宝首页「猜你喜欢」,一个月线上 A/B:CTR +6.33%、IPV +9.47%、DCAU +3.72%、CICD +6.96%、DT +4.82%。
1. 研究动机与背景¶
过去二十年推荐系统沿「特征工程 + 模型架构」两条线演进——特征从手工统计到超长行为序列,架构从因子分解机(Rendle 2010)到深度匹配网络、图神经网络、再到最新的生成式 Transformer(Deng et al., 2025, OneRec)。但它们共享同一个根本局限:本质是在拟合历史日志里的共现模式——"learn clicks from clicks",缺乏对用户意图的显式理解,于是不断强化相似用户已消费过的东西,放大 filter bubble(信息茧房) 并进一步边缘化长尾(Matthew Effect,马太效应)。
LLM 的出现给出越过这一局限的路径:凭广博世界知识、细粒度语义理解与逐步推理能力,LLM 能在上下文里解读用户行为、显式推断「用户为何想要某 item」。但既有 LLM-for-Rec 研究大多停在小规模离线 benchmark,无法落到真实工业环境。RecGPT 要填的正是这个空白:如何把推理型 LLM 有效整合进十亿级工业推荐系统去真正理解、挖掘用户意图。
论文自陈三大贡献:(1) 全量部署淘宝「猜你喜欢」,各利益方(用户/商家/平台)指标全面正向,声称首个部署于服务超十亿消费者与商品的、推理增强的百亿级推荐基础模型;(2) 用 LLM 世界知识 + 推理显式挖掘潜在兴趣,把范式从「表层相关性」推向「深度画像 + 偏好建模」;(3) 一套系统化多阶段训练框架(推理增强预对齐 → 自训练进化),并配 Human-LLM Cooperative Judge,实现「专家人工评审 → 人机协同评审」的渐进过渡,大幅加速迭代同时守住质量。
2. 整体架构:RecGPT Workflow¶
RecGPT 的核心思路是用三个 LLM 模块分别赋能推荐流水线的不同阶段:$\mathcal{LLM}_{\text{UI}}$(用户兴趣挖掘)、$\mathcal{LLM}_{\text{IT}}$(item tag 预测)、$\mathcal{LLM}_{\text{RE}}$(推荐解释生成)。四段闭环:用户兴趣挖掘(§2.1)→ item tag 预测(§2.2)→ item 检索(§2.3)→ 解释生成(§2.4)。关键设计是把传统 user-item 双塔匹配器扩成 user-item-tag 三塔——把 LLM 推理出的自然语言 tag 注入检索阶段,只让「符合推断意图」的 item 进入下游排序/重排,从而在不改动下游基础设施的前提下,把候选生成从协同过滤重塑为「意图增强」过程,改善召回相关性与长尾覆盖。
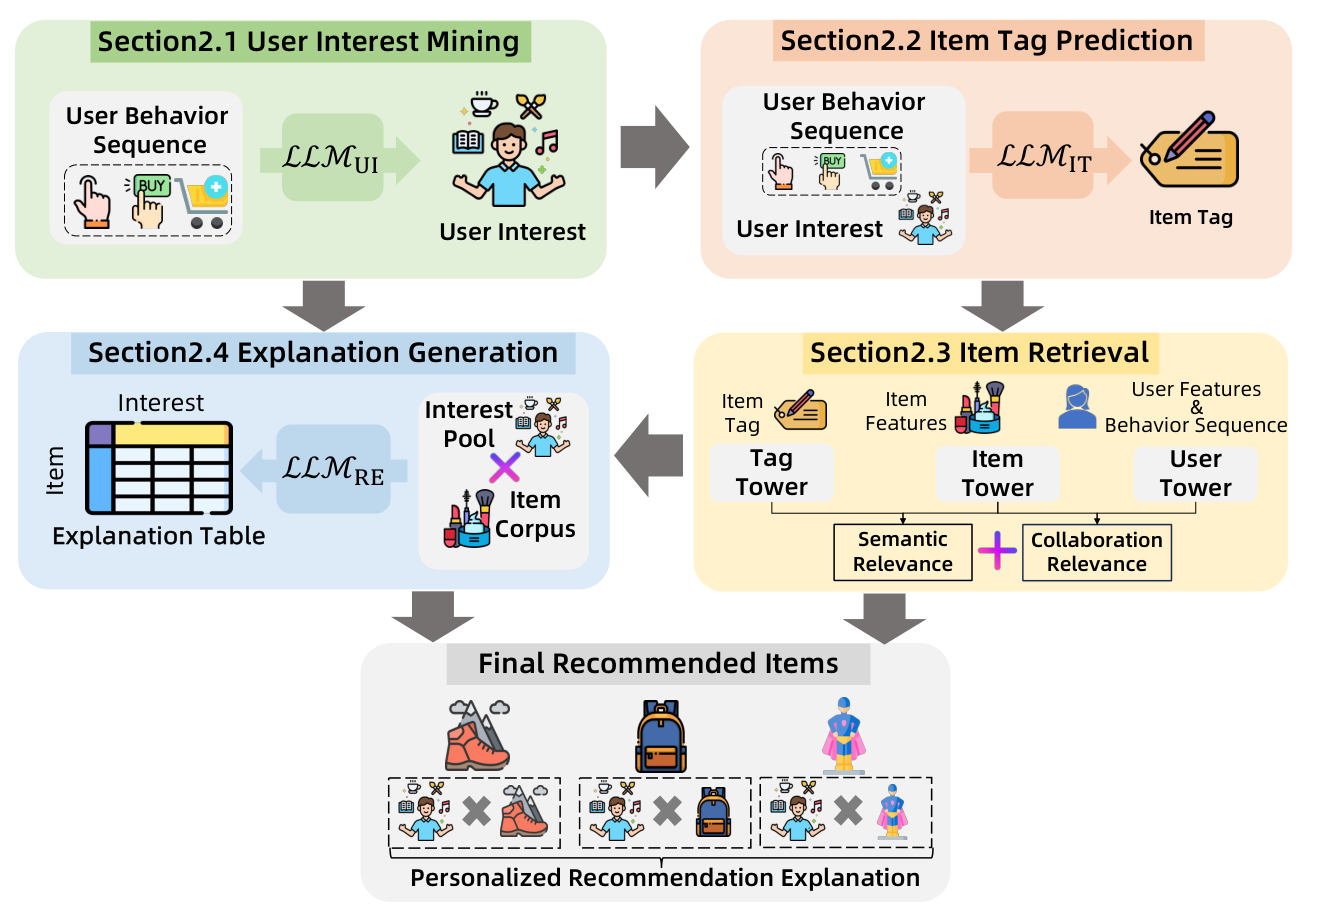
作者强调这种「显式文本化建模、拆分为清晰输入输出子任务」的路线有两个工程优势:中间过程可解释可监控(每段独立评估、独立优化)、便于专家知识以过程级监督注入。
3. 用户兴趣挖掘(User Interest Mining,§2.1)¶
目标是从用户终身多行为序列里显式挖掘多样兴趣,作者称之为 Generative User Profiling(生成式用户画像)。两个拦路挑战:(1) 上下文窗口限制——淘宝用户平均超 37k 条历史行为,远超 LLM 的 128k token 窗口;(2) 领域知识缺口——通用 LLM 不懂淘宝的领域特征。对应两招:可靠行为序列压缩(§2.1.1)+ 多阶段任务对齐(§2.1.2)。
3.1 可靠行为序列压缩(Reliable Behavioral Sequence Compression)¶
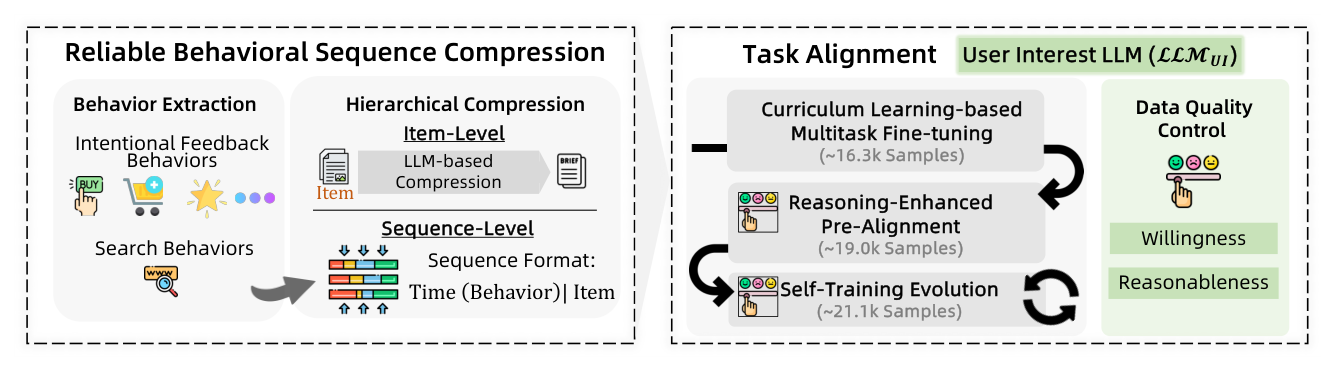
- Reliable Behavior Extraction:只保留高置信行为——「收藏/购买/加购」等意向反馈行为 + 「详情浏览/看评价」等深度点击 + 「搜索」等主动探索;剔除普通点击(噪声大、不反映真实兴趣)。
- Hierarchical Behavior Compression(层次化压缩):分两级——item 级用 LLM 把 item 详情压成核心属性(名称/品类/品牌等),提高信息密度;序列级做两步聚合:先按时间粒度分区(月内按天、跨月按月、超年按年),Step 1 时序-行为聚合(以「时间-行为类型」为 key 聚合当期交互的 item),Step 2 基于 item 的反向聚合(以 item 序列为 key 反聚合其时序-行为上下文)。最终格式:
"Time₁ (Behavior₁, Behavior₂, …), Time₂ (…) | Item₁, Item₂, …"。效果:压缩后 98% 用户行为能装进 128k 窗口(未压缩仅 88%),意图推断效率再 +29%。
3.2 多阶段任务对齐(三阶段)¶
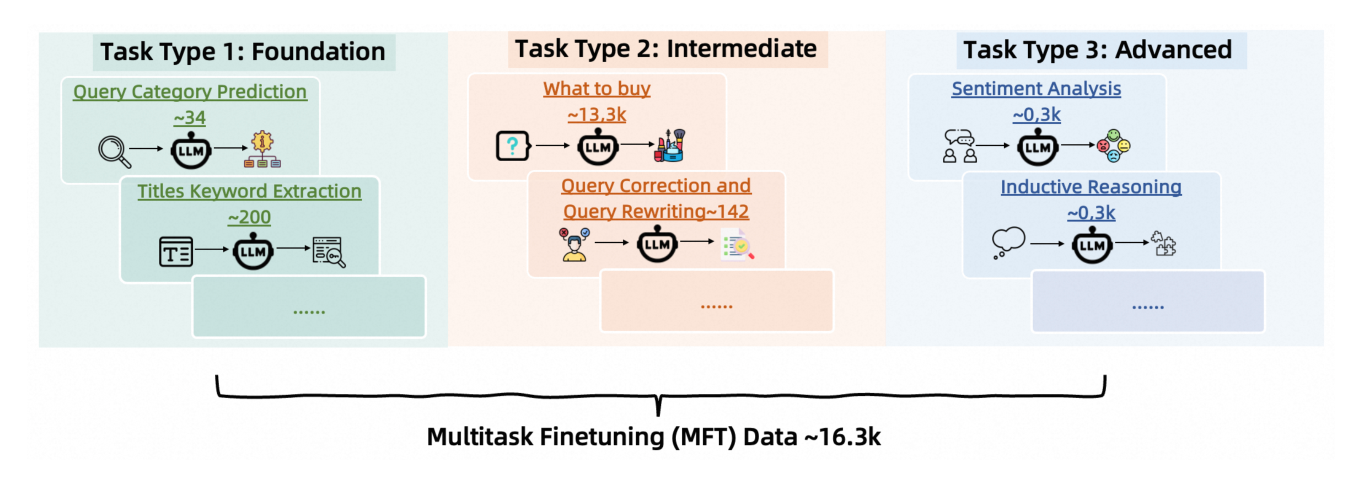
- Stage 1 课程学习多任务微调(CL-MFT):设计 16 个预备子任务(16.3k 样本),按难度拓扑排序、从基础电商概念逐步到复杂意图推理(详见附录 C / Figure 9),提升通用 LLM 的电商领域基础能力。
- Stage 2 推理增强预对齐:用 DeepSeek-R1 生成高质量兴趣挖掘数据(初始 90.0k 精炼到 19.0k),做知识蒸馏,让学生 $\mathcal{LLM}_{\text{UI}}$ 逼近教师。
- Stage 3 自训练进化:模型生成自身训练数据迭代自进化(收集 21.1k 高质量样本),用 LLM-as-a-Judge 低成本过滤与评估,构成反馈闭环(详见 §5)。
数据质控 用多维拒绝采样,两个维度:Willingness(意愿性)——兴趣是否源自主动喜好而非外部义务(Spontaneity ✓ / Necessity ✗);Reasonableness(合理性)——四档相关度(Strong / Weak / No Correlation / Hallucination),只保留 Strong Correlation。Table 1 给了逐类正反例(如「购网球拍→网球」为 Correct,「买瑜伽裤→瑜伽」因弱相关判 Incorrect)。
人工评测(Table 2):兴趣挖掘任务通过率——DeepSeek-R1 70.00% > Qwen3-Base 59.74%,验证「推理增强 LLM 更擅长从超长行为序列挖兴趣」;多阶段对齐后 Qwen3-SFT 达 77.28%(最高),TBStars-SFT 74.39%(TBStars-42B-A3.5B 是淘宝内部 MoE,每次推理仅激活 3.5B 参数,兼顾精度与在线时延)。线上部署用 $\mathcal{LLM}_{\text{UI}}$ 离线预测,人均 16.1 个兴趣,每两周刷新一次以保时效。
4. Item Tag 预测(Item Tag Prediction,§2.2)¶
基于挖出的兴趣,用 $\mathcal{LLM}_{\text{IT}}$ 预测「用户下一步可能交互 item」的细粒度 tag,格式为 「Modifier + Core-Word」(如 "Outdoor waterproof non-slip hiking boots")。同样两阶段对齐(推理增强预对齐 + 自训练进化),Prompt 里嵌五条约束:兴趣一致性、多样性增强(至少 50 个 tag 抗信息茧房)、语义精确性(禁「时尚运动装备」这类泛词)、时效新鲜度(避免重复推近期已交互品类)、季节相关性。输出 (Tag, Associated Interest, Rationale) 三元组供检索用。
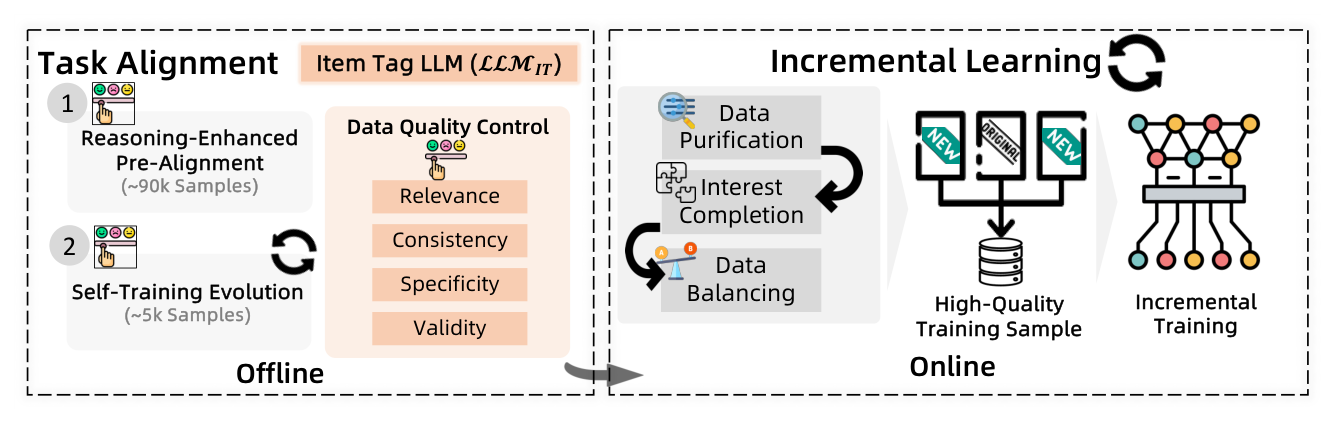
数据质控(Table 3) 四维拒绝采样:Relevance(tag 与兴趣是否直接对齐)、Consistency(是否引用了真实用户画像/历史)、Specificity(够不够具体,避免「登山户外运动装备」这种过宽 tag)、Validity(tag 是否对应真实存在的商品)。人工评测(Table 4):Qwen3-Base 仅 33.70%(裸 LLM 完全不够用)→ Qwen3-SFT 84.80%、TBStars-SFT 88.80%(最高)> DeepSeek-R1 80.00%——蒸馏 + 自训练让小模型反超强推理模型。
4.1 增量学习(Incremental Learning,§2.2.2)¶
为适配动态兴趣与分布漂移(如换季),$\mathcal{LLM}_{\text{IT}}$ 采用双周增量学习,取过去 14 天线上交互做增量训练。针对线上数据两个痼疾——大量噪声(误点/促销点击)与固有类别不均衡(热门 tag 主导、伤多样性),设计三步:Step 1 数据净化(用 QwQ-32B 当自动裁判按相关性/时效清洗);Step 2 兴趣补全(QwQ-32B 深推理把有效行为映射成三元组,直接用真实 item 标题作 tag);Step 3 数据平衡(两阶段重采样:先每人随机取 80 个 tag 对应行为,再用 Tag-to-Cate 模型 φ(·) 映射到品类、每品类至多采 2 样本以均衡)。效果(Table 5):HR@30 从 0.3671→0.3776(+1.05%)——工业规模下这一提升已有可观业务价值。
5. Item 检索(Item Retrieval,§2.3):User-Item-Tag 三塔¶
LLM 产出的抽象语义 tag 无法直接落到域内具体商品,需要一座桥。RecGPT 提出 Tag-Aware Retrieval(TAR):把传统 user-item 双塔扩成 Item / User / Tag 三塔,同时融合语义相关与协同信号。
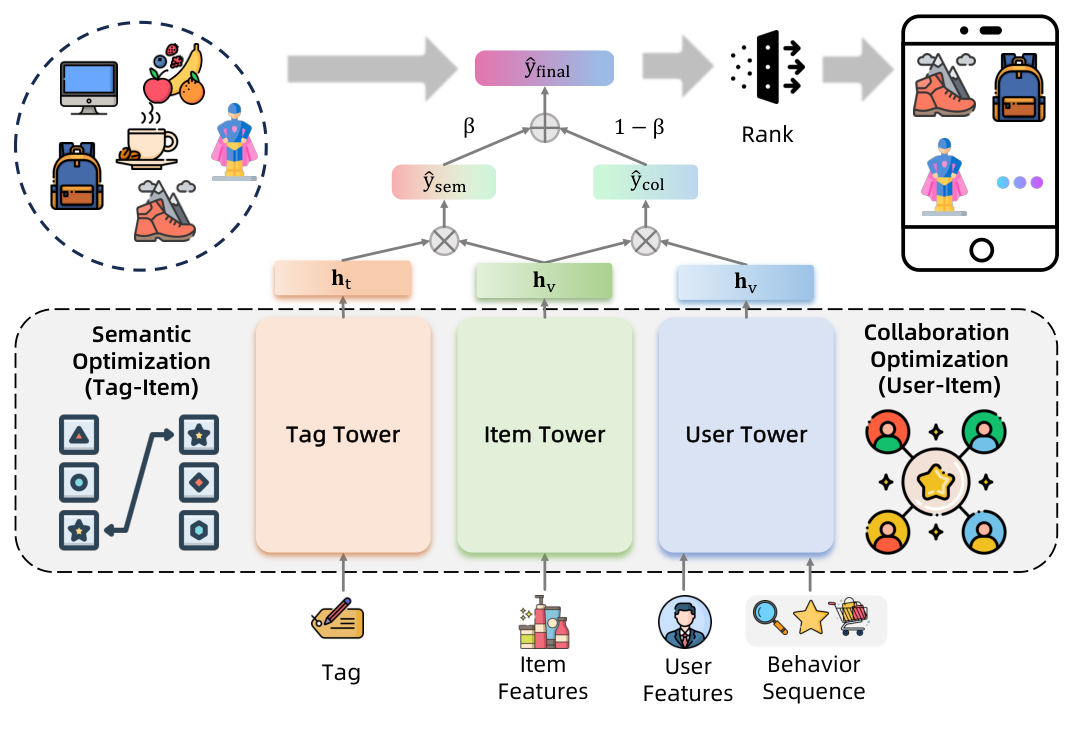
- 三塔结构:Item 塔对稀疏(item id/品类/品牌)+ 稠密(价格/销量,先离散化)特征过 DNN 得 $\mathbf{h}_v$;User 塔拼 user id emb 与各行为序列的 mean-pooling 得 $\mathbf{h}_u$;Tag 塔对 tag token emb 做 MEAN 再过 DNN 得 $\mathbf{h}_t$。两个互补打分:协同分 $\hat y_{\text{col}}=\mathbf{h}_u^\top\mathbf{h}_v$、语义分 $\hat y_{\text{sem}}=\mathbf{h}_t^\top\mathbf{h}_v$。
- 优化目标:协同优化 $\mathcal{L}_{\text{col}}$(点击为正、未点为负的对比学习);语义优化含两项——tag-item 对比 $\mathcal{L}_{\text{tag}}$ + 防止过拟合描述性 tag 的品类内对比 $\mathcal{L}_{\text{cate}}$(同品类为正、异品类为负,强化品类内细粒度语义区分)。总目标 $\mathcal{L}_{\text{TAR}}=\mathcal{L}_{\text{col}}+\alpha\mathcal{L}_{\text{tag}}+(1-\alpha)\mathcal{L}_{\text{cate}}$,取 α=0.5。
- 在线推理动态融合:$\mathbf{h}_{\text{fuse}}=\beta\mathbf{h}_u+(1-\beta)\mathbf{h}_t$,等价于 $\hat y_{\text{final}}=\beta\hat y_{\text{col}}+(1-\beta)\hat y_{\text{sem}}$——用 β 灵活调「协同 vs 语义」配比,适配不同场景在行为相关性与语义连贯间取舍。
6. 个性化解释生成(Personalized Explanation Generation,§2.4)¶
$\mathcal{LLM}_{\text{RE}}$ 回答「为什么给我推这个」。同两阶段对齐,Prompt 走两步 CoT(Context Understanding → Explanation Generation),要求 6-10 字、自然口语化、可用幽默/谐音等网感表达,禁编造功能/材质/品牌、禁口号套话、禁夸大、禁近似复制标题。
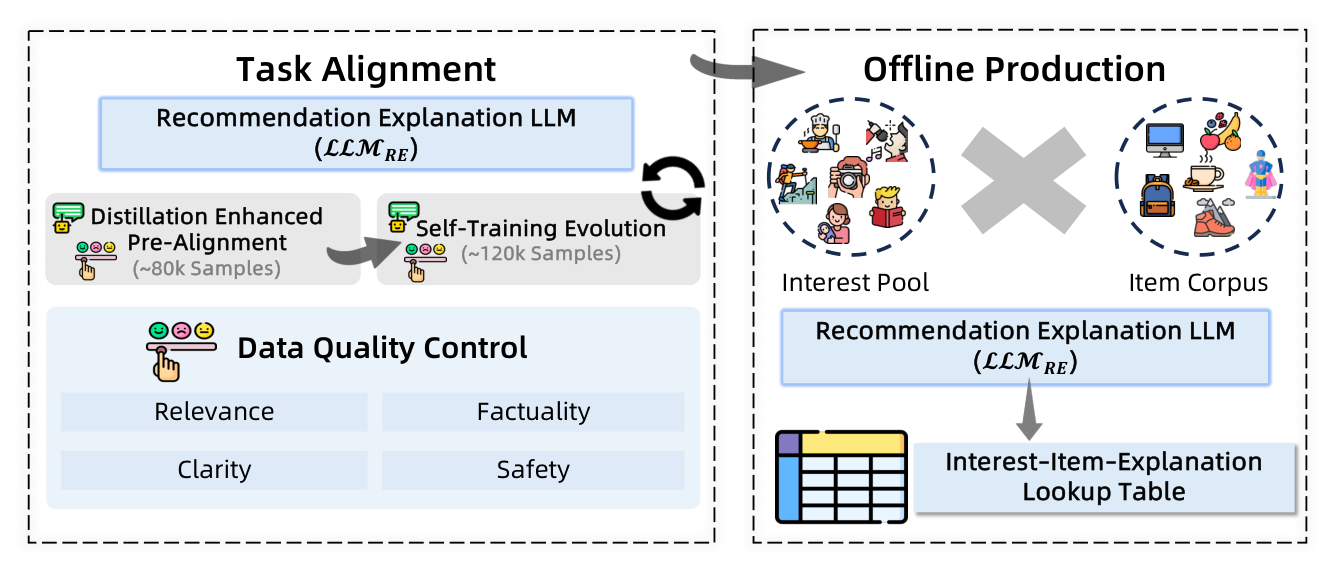
数据质控(Table 6) 四维:Relevance / Factuality(不夸大不编造)/ Clarity(流畅无重复)/ Safety(不泄隐私不硬广)。人工评测(Table 7):Qwen3-Base 仅 30.0% → Qwen3-SFT 95.8%(最高)> DeepSeek-R1 92.7%。离线生产(§2.4.2):实时逐 user-item 生成解释开销太大,改为用 Tag-to-Cate φ(·) 建立 interest-item 配对,离线预生成「Interest-Item-Explanation 查找表」,线上按当前推荐 item ∩ 用户兴趣直接查表,实现低时延实时解释。
7. Human-LLM Cooperative Judge(人机协同评审,§3)¶
三个生成任务都需对齐人类主观标准,但全靠众包人工评审在工业环境成本/周期不可承受,故引 LLM-as-a-Judge。但作者实证发现 LLM 裁判两大坑:Cognitive Bias(认知偏差)——推荐评审需领域知识与上下文,裸 LLM 因知识局限/预训练偏见评估不可靠;Temporal Misalignment(时序错配)——推荐生态动态演化(用户行为漂移、新品类、评估标准更新),静态 LLM 裁判会系统性退化。
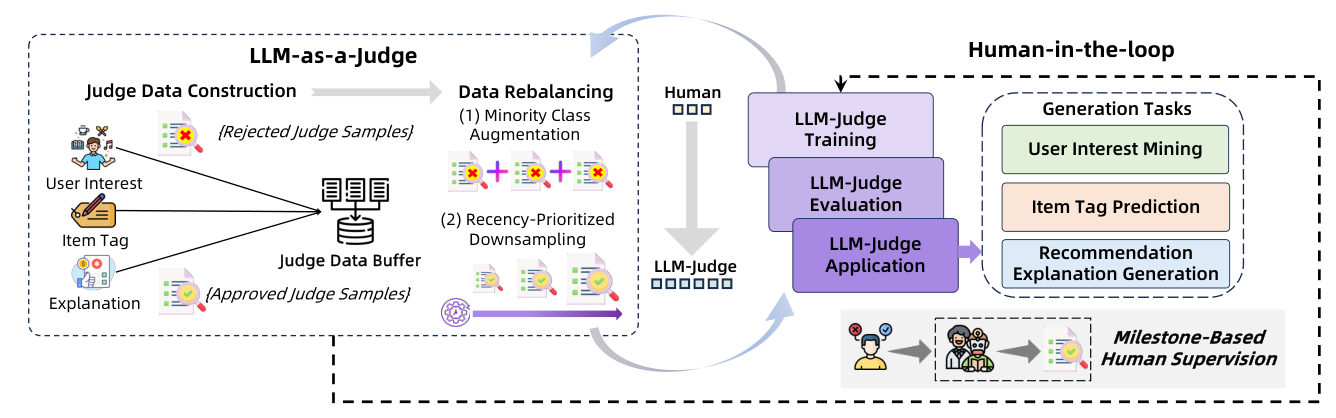
- LLM-as-a-Judge(§3.1):构建人工标注评估集微调裁判。任务分两类——二分类评估(如 item tag 的 Relevance 用 Yes/No)与多级评估(如解释 Truthfulness 用 Excellent/Good/Bad);训练数据来自预对齐数据(DeepSeek-R1 生成)+ 自训练数据。针对严重类别不均衡(Majority Class Bias),设数据再平衡策略:少数类累积增强 + 主类时效优先降采样。
- Human-in-the-Loop(§3.2):Milestone-Based Human Supervision——大版本更新时收专家标注、对比 LLM 裁判与人工,检测到显著退化就用新标注定向微调裁判,兼顾对齐与效率。
8. 实验(Evaluation,§4)¶
线上 A/B(§4.1-4.2,Table 8):淘宝「猜你喜欢」,一个月,实验/控制各 1% 流量,面向 Top 1/3 活跃用户;控制组 = 现有 base 推荐系统。基础设施用 FP8 量化 + KV cache + Megatron 分布式,推理速度 +57%。全指标正向:
| 场景 | DT | EICD | CICD | IPV | CTR | DCAU | ATC |
|---|---|---|---|---|---|---|---|
| Guess | +4.82% | +0.11% | +6.96% | +9.47% | +6.33% | +3.72% | +3.91% |
- 用户侧:DT +4.82%、CICD +6.96%——LLM 世界知识挖出更广兴趣,缓解信息茧房、带来「意外但相关」的发现。
- 平台侧:IPV +9.47%(更深参与)、CTR +6.33%(更精准)、DCAU +3.72%(更强粘性)。
- 商家侧(缓解马太效应):Figure 1 显示 RecGPT 在不同热度分组上 CTR 更均匀、长尾 PVR 分布被抬起,给中小商家更公平曝光,成 win-win-win 生态。
Human vs LLM-as-a-Judge(§4.3,Table 9):三任务上 Qwen3-Judge-SFT 全面超 Base——ACC 兴趣挖掘 67.77%→76.89%、tag 预测 87.41%→93.08%、解释生成 56.77%→89.76%,证明人工判定微调能把自动裁判对齐到人类水平、替代昂贵人工评审。
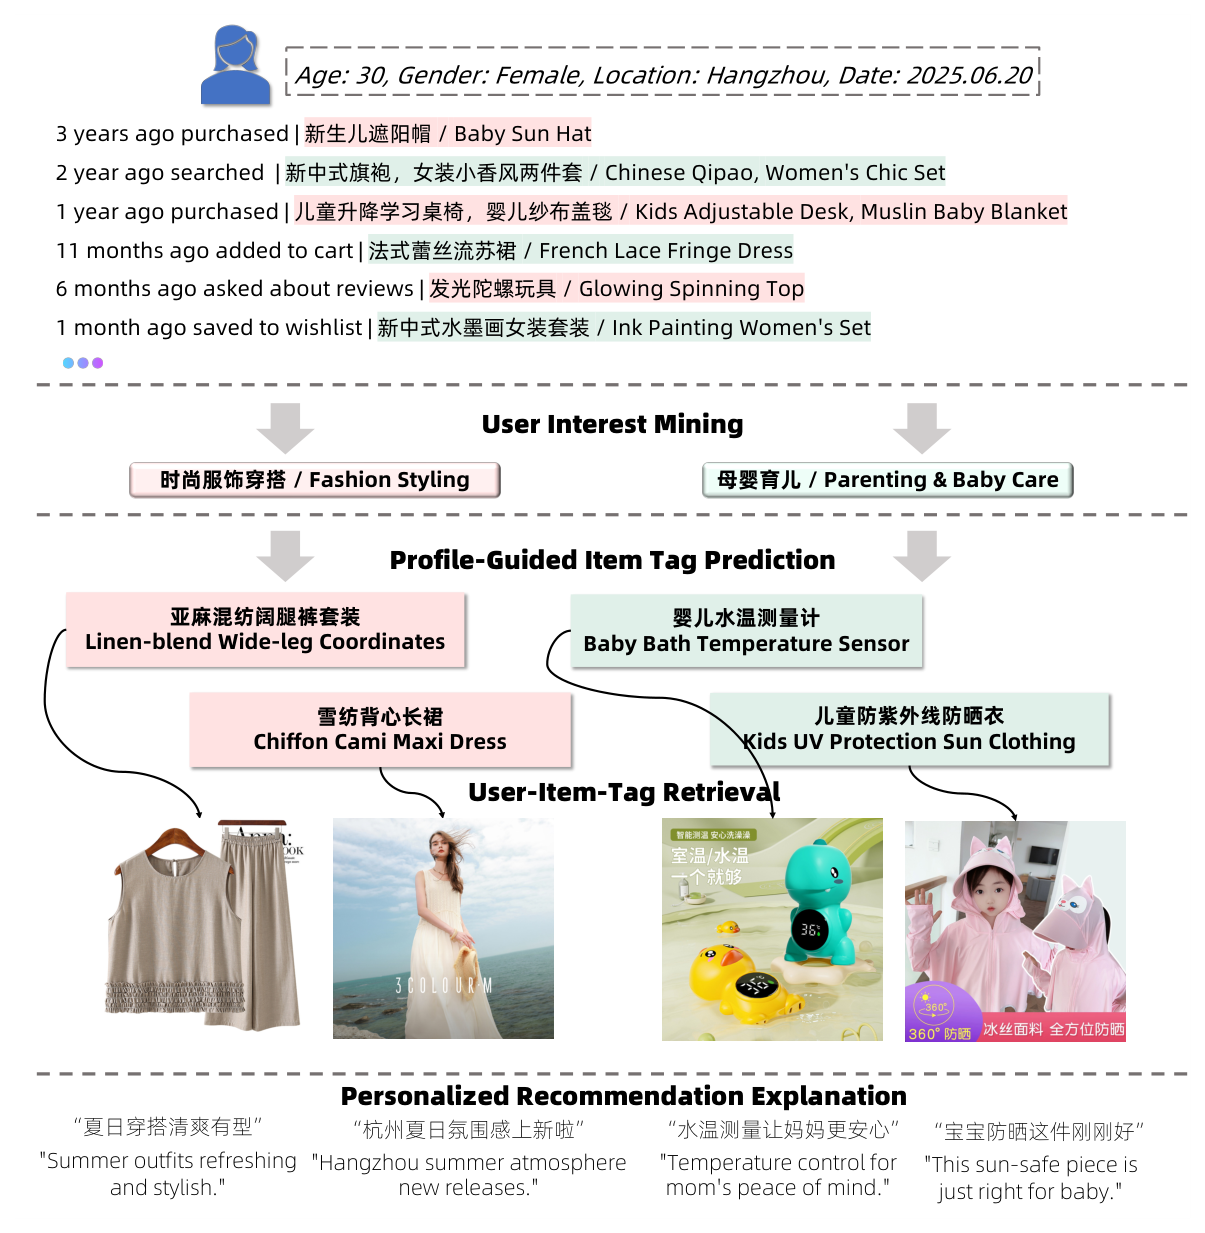
Case Study(§4.4,Figure 8):杭州 30 岁女性用户,三年行为跨「新中式服饰 + 母婴育儿」;UI 挖出「时尚服饰穿搭 / 母婴育儿」两大兴趣,IT 预测「亚麻混纺阔腿裤套装」「婴儿水温测量计」等 tag,检索落地具体商品,RE 生成「夏日穿搭清爽有型」「水温测量让妈妈更安心」等情境化文案——完整展示「行为→意图→商品→解释」闭环。
用户体验调研(§4.5):500 活跃用户做重复感知问卷(三评审员一致同意才计),实验组重复率 37.1%→36.2%,Top-4 位相似聚类 27.7%→25.3%;剔除广告卡干扰后,重复率改善从 0.88% 翻倍到 1.57%(Top-8 位最明显),说明 RecGPT 核心推荐能力确实在降同质化。
附录 C(Figure 9 / Table 10):课程学习三级——Foundation(Query 品类预测/标题关键信息抽取,34-200 样本)→ Intermediate(电商 What-to-Buy 13.3k、Query 改写等)→ Advanced(因果/归纳推理、情感分析等各 ~300),共 ~16.3k,引导 LLM 从简单匹配升到复杂意图推理。
核心贡献总结¶
- 范式转变:把工业推荐从「learn clicks from clicks」的隐式共现拟合,转成「LLM 显式推理用户意图」——用三个推理 LLM 重构「兴趣挖掘 → tag 预测 → 检索 → 解释」全链,是这条路线的开创性落地。
- 可靠行为压缩:行为抽取(剔普通点击)+ 层次化时序-item 双向聚合,把超长(人均 37k)行为压进 128k 窗口,98% 覆盖 + 意图推断 +29%——解「超长序列 × 有限上下文」的工程关键。
- User-Item-Tag 三塔(TAR):把 LLM 自然语言 tag 作为第三塔注入检索,融合语义分 + 协同分并动态加权,在不改下游基建下把候选生成意图化。
- 多阶段训练框架 + Human-LLM 协同评审:CL-MFT → 推理增强预对齐(DeepSeek-R1 蒸馏)→ 自训练进化;配可自我平衡、带里程碑人工校准的 LLM 裁判,把「专家评审」渐进过渡为「人机协同评审」,加速迭代守住质量。
- 工业落地:全量部署淘宝「猜你喜欢」,一个月 A/B CTR +6.33% / IPV +9.47% / CICD +6.96%,用户/商家/平台三赢,缓解信息茧房与马太效应。
局限与方法论可扩展性¶
作者自陈三条 limitation:(1) 超长序列建模——约 2% 序列仍超 128k,训练/推理算力负担重、超长序列上易被噪声带偏;(2) 多目标 + RL 联合学习缺失——现为监督学习 + 周期更新的静态训练,三个生成任务分开训、未做联合优化,拟引入 RL(ROLL 库)做多目标联合;(3) 端到端 LLM-Judge 缺失——现裁判按任务分开训、评估碎片化,拟用 RLHF + 推理扩展生成式奖励模型做统一多任务评审。
方法论可扩展性视角:RecGPT 走的是「LLM 生成自然语言 tag → 下游检索」的显式文本管线。优点是每段可解释、可独立监控/优化、专家知识易注入;但也埋下扩展性隐患——① tag 作为 lossy 文本信道:粗粒度自然语言 tag 承载不了 item 级细粒度证据,LLM 推断意图与最终检索商品间留信息缺口(此即 V3 的 C2 瓶颈,V3 引 Semantic ID 修复);② 无状态 one-shot 建模:每次请求从头重跑全量历史,既冗余又无法沉淀用户理解(V3 的 C1,V3 引 Memory Hub 修复);③ 显式 CoT 成本高:多路推理 + 全文编码使算力/时延偏高(V2 引原子化实体压缩降 GPU 60%、V3 引 latent 推理再降)。因此 V1 是扎实且开创性的系统级首作,但其显式文本表征路线在参数量 scaling 时「如何表征历史」与「如何高效推理」两条路径都有优化空间——恰是 V2/V3 逐一填坑的动机。
与已归档相关工作的对比¶
RecGPT-V2 RecGPT-V2 Technical Report(Alibaba,2025-12)¶
同系列第二代,直接承接本篇。V2 逐一对应 V1 的四个短板:V1 的多路孤立推理冗余 → V2 的分层多智能体(HMAS);V1 把全文行为喂 LLM、context 爆炸 → V2 的原子化实体压缩(~7× 压缩、GPU -60%);V1 纯 SFT 泛化受限 → V2 的约束式奖励塑形(CRS)解多目标 RL 梯度冲突;V1 的一步式 LLM-as-a-Judge 对齐差 → V2 的 Agent-as-a-Judge + Judge-as-a-Reward 飞轮。可视作:V1 立起「LLM 显式意图推理 + tag 检索 + 解释」的地基与 Human-LLM 评审雏形,V2 把每一块做扎实、并首次系统性降本。
RecGPT-V3 RecGPT-V3 Technical Report(Alibaba,2026-07)¶
同系列第三代。V3 明确点出 V1/V2 共有的三个结构性瓶颈并对症下药:C1 无状态建模 → Memory Hub(有状态记忆中枢,token 降 94.5%);C2 tag→item 信息瓶颈(正是 V1 首创的自然语言 tag 信道的 lossy 短板)→ 混合模态基础模型(文本 + Semantic ID);C3 低效显式推理 → Latent Intent Reasoning(把 CoT 压进 ~10 个可解码 latent token)。V3 相对 V2 再降 52.4% 算力,三代下来只用 V1 的 19% 算力——本篇正是这条降本增效演进曲线的起点。
RecGPT RecGPT: A Foundation Model for Sequential Recommendation(HKU & Tencent,2025)¶
同名但不同血统——这是港大 + 腾讯的学术 RecGPT(github.com/HKUDS/RecGPT),DAG 中为 RecGPT-HKU 节点,与本篇(Alibaba 淘宝 RecGPT 系列 V1)无任何传承关系,共享「RecGPT」之名纯属撞名。路线也根本不同:HKU 版是序列推荐基础模型(直接对 item ID 序列做生成式建模、追求跨域可迁移的推荐 foundation model);Alibaba 版(本篇)是「LLM 生成自然语言意图 tag → 三塔检索 → 解释」的工业管线,LLM 负责意图推理而非直接生成 item。引用时务必区分二者。
RecGPT-Mobile RecGPT-Mobile(Alibaba,2025)¶
同 Alibaba RecGPT 团队的端侧分支,把云端 RecGPT 的用户意图理解能力蒸馏/下沉到设备端。与本篇(云端首作)方向正交——一个奠定云端意图推理主链,一个探索端侧部署。