RecGPT-V3 Technical Report 精读¶
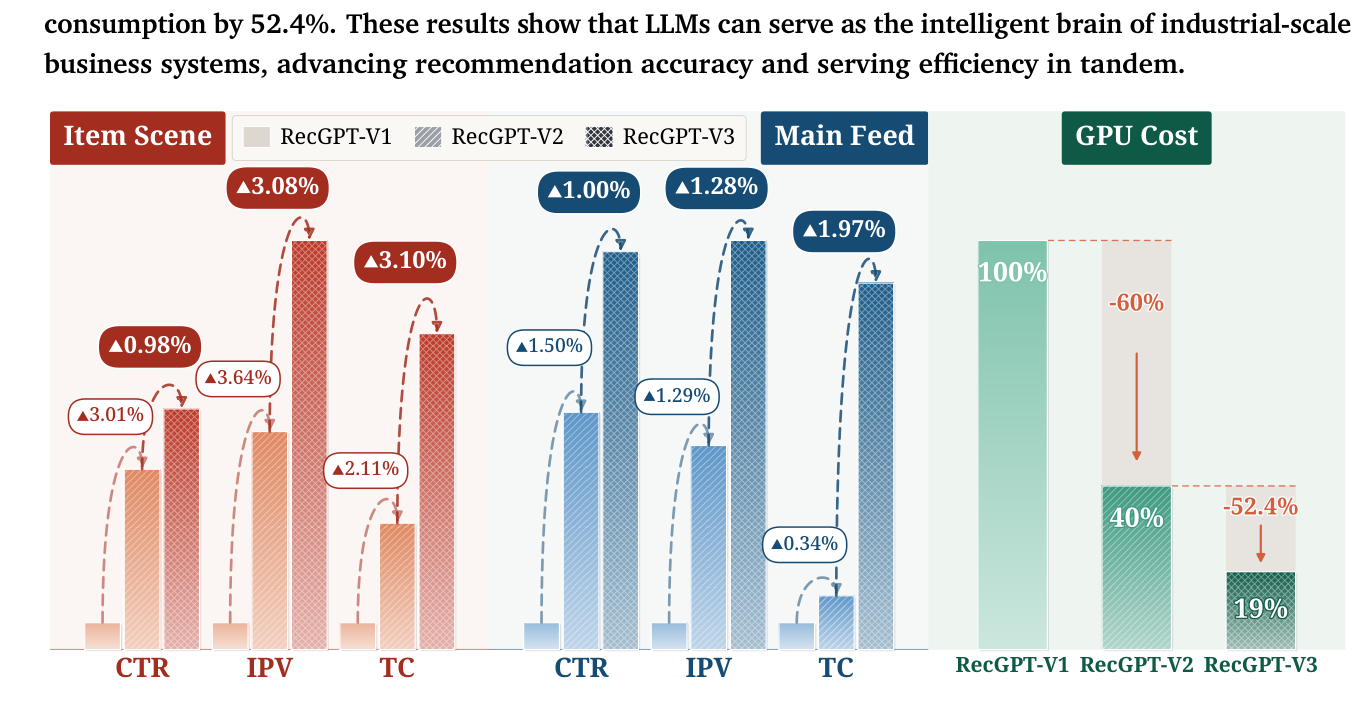
阿里巴巴 Taobao & Tmall Group 的 RecGPT 系列第三代。核心命题:把 LLM 从"匹配历史共现模式的相关性引擎"进一步推进为"能对用户意图做有状态、可落地、低成本推理的工业推荐大脑"。RecGPT-V1 首次把"真正理解用户"放到淘宝流水线中心,V2 用多智能体协同推理扩规模、降成本;但把 RecGPT 系列开到工业规模后暴露出三个结构性瓶颈——(C1) 无状态行为建模(每次请求从头重跑全量历史,浪费算力且丢弃已有分析)、(C2) tag→item 信息瓶颈(LLM 只吐自然语言 tag,作为一条 lossy 信道无法传达 item 级细粒度证据)、(C3) 低效显式推理(几千 token 的 CoT 在十亿用户/高 QPS 下延迟与算力不可承受)。RecGPT-V3 对症下三味药:Memory Hub(有状态记忆中枢)、Hybrid-modal Foundation Model(文本 + Semantic ID 混合模态基础模型)、Latent Intent Reasoning(潜在意图推理)。部署在淘宝首页"猜你喜欢",对 live 的 RecGPT-V2 做大规模在线 A/B:Feed 场景 +1.28% IPV / +1.00% CTR / +1.97% TC / +3.97% GMV,同时端到端服务算力下降 52.4%——三代下来 RecGPT-V3 只用 RecGPT-V1 的 19% 算力。
1. 研究动机与背景¶
理想的推荐系统应当抓住用户"真正想要什么",把满足其潜在需求的 item 推到面前。但从矩阵分解(Koren 2009;Rendle 2009)到深度序列网络(SASRec, Kang & McAuley 2018),主流模型共享同一个局限:它们匹配历史行为里的共现模式——学"哪些 item 一起出现",而非"行为背后的意图"。困在这种相关性信号里,模型只会放大用户已暴露的偏好,收窄曝光、强化 filter bubble、亏待长尾内容,最终侵蚀用户体验与推荐生态健康。
LLM 的出现给出了越过这一局限的路径:凭借广博的世界知识与审慎推理能力,LLM 能在上下文中解读用户行为、推断每个动作背后的动机与潜在兴趣,把推荐重塑为"对用户意图做推理"的问题。RecGPT 系列正是沿这条路走的:
- RecGPT-V1(Yi et al., 2025b, arXiv 2507.22879):围绕"理解用户为何行动,而非拟合他做过什么"这一原则重建工业流水线,把兴趣挖掘、item 检索、解释生成委托给 LLM。
- RecGPT-V2(Yi et al., 2025a, arXiv 2512.14503):在 V1 基础上引入一个 Global Planner(全局规划器) 与专门的多专家子智能体,协同分析用户意图,拓宽覆盖同时大幅降本。
两者都在淘宝大规模部署,为用户、商家、平台带来一致收益,证明 LLM 驱动的用户建模在生产中既有前景又可行。但把 RecGPT 系列开到工业规模,暴露三个约束进一步进步的关键挑战:
- C1 —— 无状态行为建模(Stateless behavior modeling):多数现有 LLM 推荐器(包括 V1/V2)对用户整段行为历史做 one-shot 推理。随着交互累积,每次请求都从头重新处理全量历史,既产生随序列增长的冗余计算,更根本地——系统无法把已经学到的用户理解沉淀下来、带到下次。
- C2 —— tag→item 信息瓶颈(Tag-to-Item information bottleneck):V1/V2 都让 LLM 预测用户接下来可能交互 item 的自然语言 tag,再由下游模型据此落地具体 item。这个文本接口在推理与检索之间形成一条 lossy 信道:一个粗粒度 tag(如 "rotating adjustable badminton racket stand")对应一大堆异质候选,无法传达 item space 依赖的细粒度 ID 级证据,在 LLM 预测的意图与最终检索到的 item 之间留下一道无法弥合的信息缺口。
- C3 —— 低效的显式推理(Inefficient explicit reasoning):显式 CoT 帮助 LLM 理解用户、挖掘隐性兴趣,但自回归生成冗长 rationale(本文任务中平均约 3,000 token)带来可观的推理延迟。在十亿用户规模、高 QPS 下这个成本无法承受,自然引出核心问题:如何在保留 RecGPT 系列一贯坚持的可解释推理能力的前提下削减延迟?
RecGPT-V3 沿三个维度改进——用户建模、意图表示、意图推理,对应三项关键技术创新(见 Figure 2)。
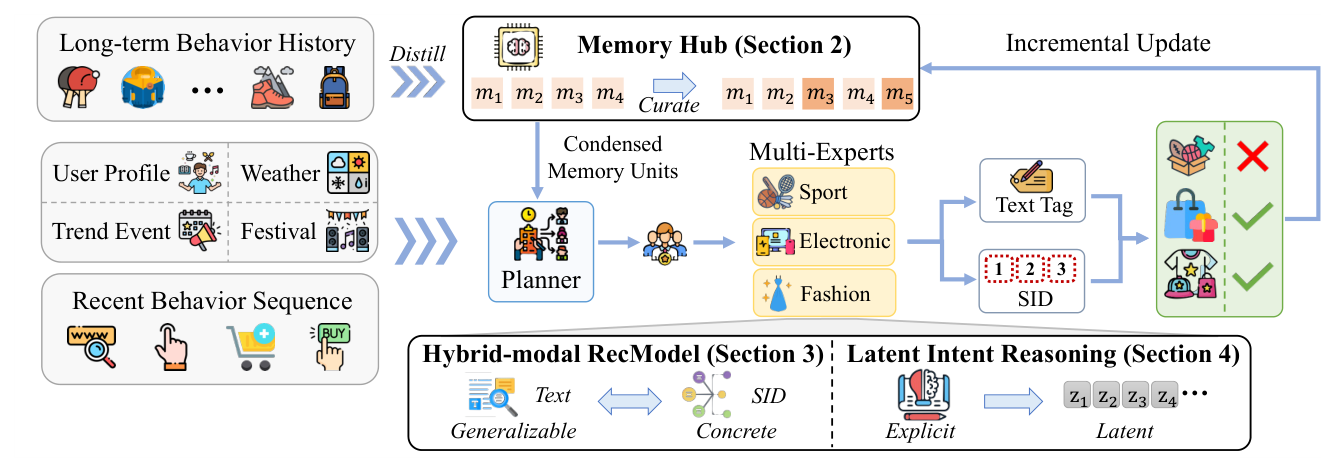
- S1 Memory Hub(§2):从 stateless、one-shot 用户建模转向 stateful、memory-augmented 推荐器——把结构化用户记忆放到流水线中心作为引擎。它把每个用户长程行为历史蒸馏成简洁记忆单元(condensed,token 压缩 94.5%),每个单元回链到其源行为以保证 provenance(traceable),并随新交互到来增量维护(evolvable),使对用户的理解随时间累积、不再每次从头重新发现。模型因此基于"沉淀记忆 + 近期行为增量"推理,而非原始全量历史,用户建模计算下降 55.8%。
- S2 Hybrid-modal Recommendation Foundation Model(§3):为跨过 tag→item 瓶颈,让 LLM 用 Semantic IDs(SIDs) 推理——离散码,编码 item 语义,作为自然语言之外的第二模态。两模态互补:自然语言用丰富开放式世界知识表达意图(generalizable),SID 把意图锚定到富含协同信号的语义 item 表示上(concrete)。模型因此原生生成与下游兼容的意图表示,为"意图推理→商品检索"开出一条高带宽信道,弥合纯语言接口留下的缺口。
- S3 Latent Intent Reasoning(§4):把冗长的显式 CoT 内化进紧凑可学习的 latent token,把一段冗长 rationale 折叠进几步 latent 推演。引入专用 latent
<cot>slot 编码整条推理链,token 成本降 200×(efficient)。关键是这些 latent token 可按需解码回可读 rationale(explainable),在低延迟推理与生产推荐所需的可解释性之间取得调和。
RecGPT-V3 部署于淘宝首页"猜你喜欢",服务数亿日活。与线上 RecGPT-V2 做大规模在线 A/B,取得 +1.28% IPV、+1.00% CTR、+1.97% TC、+3.97% GMV 的强劲增益,同时端到端服务算力下降 52.4%。
2. Memory Hub(S1:有状态记忆中枢)¶
在 RecGPT-V2 流水线里,Global Planner 分析用户行为历史、拆解成 intent persona、派发给多专家模块做 item tag 预测与检索。由于每次 pass 都重处理整段行为序列(高活跃用户约 55K token),Planner 独占约 95% 的智能体意图分析算力,而每次 pass 又冗余地重新发现诸如复购周期、品牌忠诚度、季节偏移等本可以持久化并跨会话更新的模式。为此引入 Memory Hub:一个持久的、结构化的记忆层,把 Planner 的输入从"无状态全序列编码"变为"有状态记忆驱动推理",同时达成三个性质:
- Condensed(凝练):把全量行为序列固结为一组 schema 定义的记忆单元,token 减少 80%(相对全序列输入;相对原始长程历史则达 94.5%),只保留连贯、高置信度的行为模式。
- Traceable(可追溯):每个记忆单元保留到其源行为的 provenance 链接,兼顾可解释性与下游推荐质量。
- Evolvable(可演化):通过选择性更新 + 新模式抽取增量纳入新行为,无需全量重新编码。
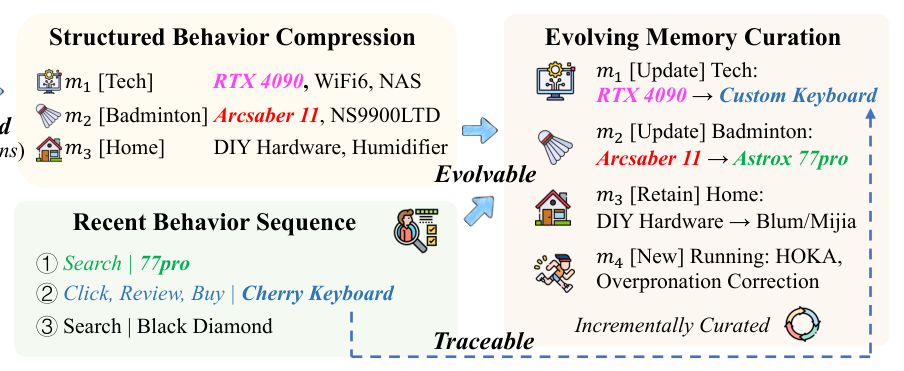
Memory Hub 由两个机制构建与维护:Structured Behavior Compression(§2.1) 做一次初始固结,把用户全量历史行为序列压成结构化记忆单元;Evolving Memory Curation(§2.2) 周期性地把新观测到的行为折进已有记忆,保持记忆时新。两者合起来把 Global Planner 算力降 55.8%,同时保住推荐质量。
2.1 Structured Behavior Compression(结构化行为压缩)¶
把用户全量行为序列 $\mathcal{B} = \{b_1, b_2, \ldots, b_N\}$ 固结为一小组结构化记忆单元 $\mathcal{M} = \{m_1, m_2, \ldots, m_K\}$,$K \ll N$。形式上定义为一个基于 LLM 的记忆构造函数:
$$\mathcal{F}_\phi : \mathcal{B} \longrightarrow \mathcal{M}, \qquad \mathcal{M} = \mathcal{F}_\phi(\mathcal{B}) = \{m_1, m_2, \ldots, m_K\} \tag{1}$$
它作为初始 pass 运行一次,产出一份持久记忆,为后续增量更新(§2.2)打底。每个单元围绕两个核心字段刻画一个行为模式:
- 行为模式标识符 $p_k$:从一套预定义分类法(数百个覆盖主要电商行为原型的模式)里抽出的类别标签,当没有现存模式能捕捉某个高置信度簇时允许受控扩展。
- 偏好摘要 $s_k$:用自然语言描述该模式内用户的偏好、趋势、消费特征。
除这两个字段外,每个单元还记录支撑元数据:用于 provenance 的代表性行为索引、偏好品牌、时间活动画像、时间戳。Table 1 给出一个完整示例("K-pop Fandom"模式):
| 字段 | 示例 |
|---|---|
| Behavior Pattern | K-pop Fandom |
| Preference Summary | Dedicated fan of a K-pop girl group. Full-lifecycle engagement from album pre-orders to merchandise collection and live concert participation. Strong focus on collection completeness and item preservation. |
| Representative Indices | 549, 553, 558, 563, 564, 565, … |
| Preferred Brands | SingBA, 时代良品, 珍藏, … |
| Temporal Activity | First appeared March 2023; peaked June and Aug–Oct 2023. |
| Timestamp | Created: 2023-10-31 |
2.2 Evolving Memory Curation(演化式记忆维护)¶
Structured Behavior Compression 建立了初始记忆状态,但用户兴趣会随时间漂移——偏好涌现、衰减、随人生阶段与季节变化。静态记忆会逐渐偏离用户、侵蚀推荐相关性。Evolving Memory Curation 通过周期性增量更新对抗这一漂移,把新观测行为折进已有记忆,让 Global Planner 基于"紧凑记忆 + 近期行为增量"推理,而非每次重新编码全序列。
设 $\mathcal{M}^{(t)} = \{m_1^{(t)}, \ldots, m_K^{(t)}\}$ 为时刻 $t$ 由初始压缩或前一轮维护产出的记忆状态,$\Delta\mathcal{B}^{(t,t+\delta)} = \{b_{N+1}, \ldots, b_{N+\Delta N}\}$ 为区间 $[t, t+\delta]$ 内新累积的行为交互。维护更新函数 $\mathcal{G}$ 定义为:
$$\mathcal{G} : \bigl(\mathcal{M}^{(t)}, \Delta\mathcal{B}^{(t,t+\delta)}\bigr) \longrightarrow \bigl(\mathcal{M}^{\text{update}}, \mathcal{M}^{\text{new}}\bigr) \tag{2}$$
其中 $\mathcal{M}^{\text{update}}$ 为经选择性更新或保留后的已有单元集合,$\mathcal{M}^{\text{new}}$ 为从此前未匹配行为中抽取的新建单元集合。最终维护记忆由两部分合并。关键:$\mathcal{G}$ 完全不接触全序列 $\mathcal{B}$,只依赖压缩记忆 $\mathcal{M}^{(t)}$ 与新增量 $\Delta\mathcal{B}^{(t,t+\delta)}$。
(1) 已有单元的选择性更新:对每个已有记忆单元 $m_k^{(t)}$,模型判断新行为增量里是否含与该模式相关的交互:
$$m_k^{(t+\delta)} = \begin{cases} \text{Update}(m_k^{(t)}, \Delta\mathcal{B}_k^{\text{rel}}), & \text{if } \Delta\mathcal{B}_k^{\text{rel}} \neq \emptyset, \\ m_k^{(t)}, & \text{otherwise,} \end{cases} \tag{3}$$
$\Delta\mathcal{B}_k^{\text{rel}} \subseteq \Delta\mathcal{B}^{(t,t+\delta)}$ 是语义上与 $m_k^{(t)}$ 相关的新行为子集,$\Delta\mathcal{B}^{\text{rel}} = \bigcup_{k=1}^K \Delta\mathcal{B}_k^{\text{rel}}$ 是分配给已有单元的所有新行为的并集。触发时 Update 刷新该单元摘要 $s_k$ 及所有支撑元数据;否则单元原样保留。此策略遵循 "有证据才更新,无关就不打扰"(updating with evidence and retaining without disturbance)。更新-或-保留后的记忆集合为:
$$\mathcal{M}^{\text{update}} = \{ m_k^{(t+\delta)} \}_{k=1}^K \tag{4}$$
(2) 新模式抽取:选择性更新后仍未分配给任何已有单元的交互,构成新行为集合:
$$\Delta\mathcal{B}^{\text{novel}} = \Delta\mathcal{B}^{(t,t+\delta)} \setminus \Delta\mathcal{B}^{\text{rel}} \tag{5}$$
新模式抽取在同一维护函数 $\mathcal{G}$ 内进行,$\mathcal{G}$ 识别连贯的未匹配行为并写入新记忆单元:
$$\mathcal{M}^{\text{new}} = \text{Extract}\bigl(\Delta\mathcal{B}^{\text{novel}}\bigr) \tag{6}$$
若未识别出连贯新模式,则 $\mathcal{M}^{\text{new}} = \emptyset$。最终记忆合并更新-或-保留单元与新抽取单元:
$$\mathcal{M}^{(t+\delta)} = \underbrace{\mathcal{M}^{\text{update}}}_{\text{updated or retained}} \cup \underbrace{\mathcal{M}^{\text{new}}}_{\text{newly extracted}} \tag{7}$$
实践中两个操作共享单次模型 forward——同时更新已有单元与抽取新单元,省去多次串行调用。
Table 2 给出增量维护的具体例子($m_1$ Infant Care 从"0–6 months"漂移到"6–12 months"并加入 toddler toys;$m_3$ Home Cooking 向 premium cookware 演进;$m_2$/$m_4$ 因无相关新行为而保留;$m_5$ Pet Parenting 作为首次兴趣新建):
| Unit | Pattern $p_k$ | Summary at $t$ | Summary at $t+\delta$ | Operation |
|---|---|---|---|---|
| $m_1$ | Infant Care | Frequent buyer of formula, diapers, baby clothing for 0–6 months. | Shifted to 6–12 months. Added toddler toys and walkers. | (1) Update |
| $m_2$ | Outdoor Running | Running shoes, GPS watches, marathon nutrition. | (Unchanged) | (1) Retain |
| $m_3$ | Home Cooking | Budget-friendly kitchen gadgets and baking supplies. | Shifted toward premium cookware and air fryer accessories. | (1) Update |
| $m_4$ | Photography | Mirrorless camera accessories and lens filters. | (Unchanged) | (1) Retain |
| $m_5$ | Pet Parenting (new) | — | Pet food and grooming supplies. First-time pet owner. | (2) New |
Semantic Continuity(语义连续性):每次选择性更新会把受影响单元重新合成为用户当前状态的一致快照,而不是把新行为往旧摘要后面追加,从而防止陈旧与新兴偏好在同一单元里堆积。生产中增量维护每两个月跑一次,把用户建模计算降 55.8%(详细效率分析见 §5.2)。
3. Hybrid-Modal Recommendation Foundation Model(S2:混合模态基础模型)¶
纯文本 LLM 专家通过一条自然语言信道与离散 item space 交互:它们预测自由形式 item tag,下游检索器据此落地 in-domain item。这种间接性造成 lossy 瓶颈——一个粗 tag(如 "lightweight running shoes for marathon training")匹配一大堆异质 item,无法传达检索所依赖的细粒度 item 级证据,松动了意图与最终 item 之间的耦合。
为跨过这个瓶颈,提出 Hybrid-Modal Recommendation Foundation Model:以 Qwen3-14B(Yang et al., 2025)为 backbone,用 Semantic IDs(SIDs)——编码 item 语义的离散码——作为自然语言之外的第二模态。推荐本质上要求同时对用户意图做推理并将意图锚定到具体 item,而没有任何单一表示能独力满足这一双重需求。两模态因此互补:
- Generalizable:自然语言凭丰富开放式世界知识表达意图。
- Concrete:SID 把意图锚定到富含协同信号的 item 表示上。
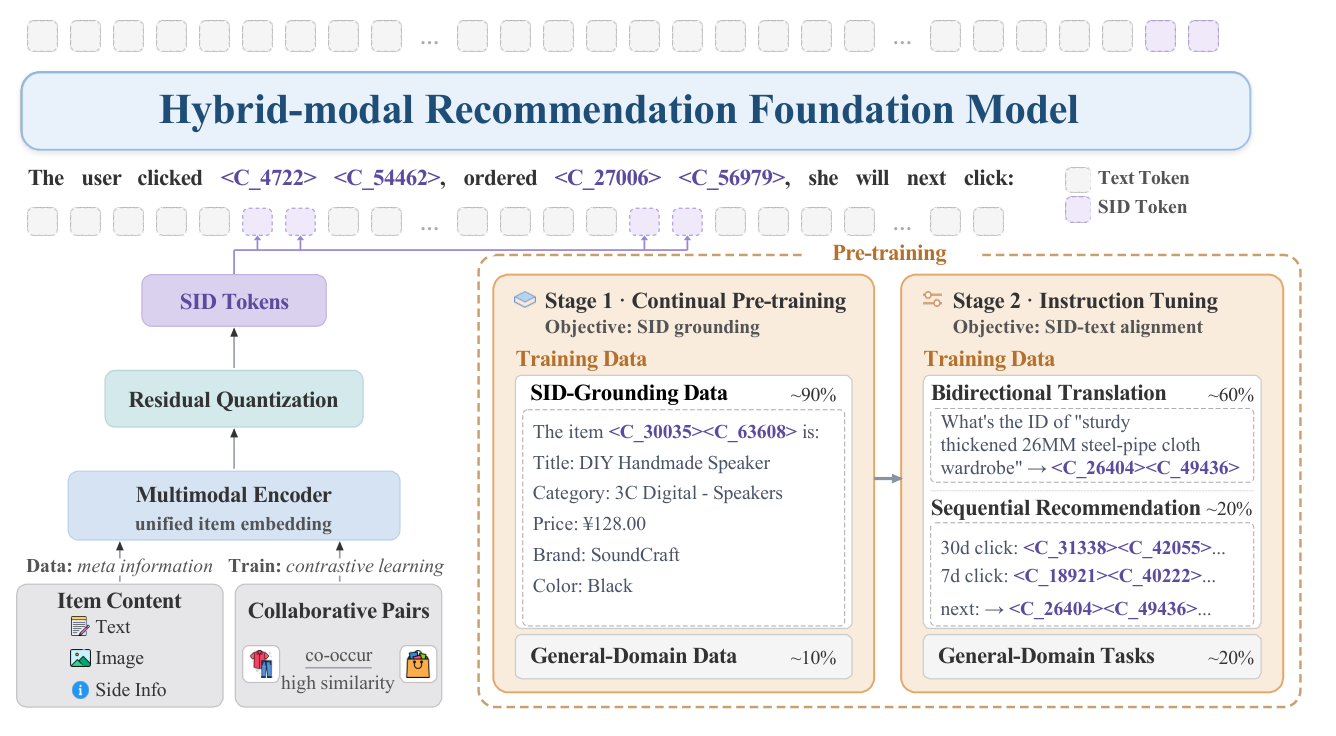
把两模态纳入统一词表,模型输出的是检索兼容的 identifier 而非粗 tag,从而向 item space 开出一条高带宽信道,同时保留完整自然语言能力。整体流水线含两个组件(Figure 4):混合分词方案(§3.1)构造语义锚定的 SID,随后两阶段训练(§3.2)把这些 token 锚定到语言、并让模型能联合推理 SID 与文本。
3.1 Hybrid Tokenization(混合分词)¶
混合分词用从 item 内容导出的 Semantic ID token 增广 LLM 原生文本词表,使语义相似的 item 收到相似码。构造分两步:先用对比学习学一个判别式多模态 item 表示,再用 Residual Quantization(RQ-VAE)(Lee et al., 2022;Chen et al., 2026)量化成离散分层码。
Multimodal Item Representation(多模态 item 表示):目标是融合文本、图像、side info 得到统一判别式 embedding。由于没有显式标签定义 item 相似性,直接从行为里挖正样本对——行为日志中频繁共现的 item 构成候选对,再丢弃多模态相似度低的对(防伪共现),存活对监督对比学习。对每个 item $i$,抽取文本描述 $I_{\text{text}}^i$、图像信息 $I_{\text{image}}^i$、辅助 side info $I_{\text{side}}^i$(item 属性/元数据)。采用 CN-CLIP(Yang et al., 2022)$\mathcal{E}$ 编码每个模态;side info 先转文本再编码。三路模态特征经 Q-Former(Li et al., 2023)$\mathcal{F}$ 融合为统一 item 表示:
$$\mathcal{H}^i = \mathcal{F}\bigl(\mathcal{E}(I_{\text{text}}^i), \mathcal{E}(I_{\text{image}}^i), \mathcal{E}(I_{\text{side}}^i)\bigr) \tag{8}$$
训练用 item $i^+$ 为正样本、同 batch 其他 item 为负样本 $i^-$,优化在融合层与各模态层同时作用的 InfoNCE loss:
$$\mathcal{L}_{\text{InfoNCE}} = f(\mathcal{H}^i, \mathcal{H}^{i^+}, \mathcal{H}^{i^-}) + f(\mathcal{H}_{\text{text}}^i, \mathcal{H}_{\text{text}}^{i^+}, \mathcal{H}_{\text{text}}^{i^-}) + f(\mathcal{H}_{\text{image}}^i, \mathcal{H}_{\text{image}}^{i^+}, \mathcal{H}_{\text{image}}^{i^-}) \tag{9}$$
$f$ 为 InfoNCE loss(Radford et al., 2021)。这个对比目标是后续量化稳定的关键:它产出的良好分离 embedding space 阻止了 RQ-VAE 否则容易陷入的 codebook collapse。
Residual Quantization(残差量化):给定多模态 item 表示 $\mathcal{H}^i$,用 RQ-VAE 把每个 item 映射为离散码序列 $\{c_1, c_2, \ldots, c_L\}$(即其 Semantic ID)。最终配置用 两级 codebook,每级词表 32,768,共 65,536 个新 token(记为 <C_0> 到 <C_65535>)加入词表。一个完整 SID 由两个 codebook entry 组成,例如 <C_18921><C_40222>:第一 token 是粗粒度语义簇,第二 token 在簇内做细粒度区分。这个两级设计把新增词表控制在可控规模同时保留细粒度 item 区分:相关 item 共享粗码,语义相似性在 SID space 里以共享前缀形式浮现,成为模型可利用来跨相关 item 泛化的结构。
3.2 Pre-training(预训练)¶
新 SID token 追加到 Qwen3-14B 原词表,embedding 随机初始化、训练中学习。为教模型理解和生成这个混合词表,采用两阶段流水线:Continual Pre-Training(§3.2.1) 把 SID token 锚定到 item 语义,随后 Instruction Tuning(§3.2.2) 教模型跨多种推荐任务应用它们。贯穿全程的核心顾虑是注入领域知识而不侵蚀模型既有通用能力——靠精心的数据构造与策略混合来达到平衡。
3.2.1 Continual Pre-training(持续预训练)¶
追求两个目标:❶ 把新增 SID token 锚定到自然语言空间以便模型能在上下文里理解和生成它们,❷ 保留 backbone 既有通用能力。语料因此结合两个互补成分:
- SID-grounding data(约 90%):把每个 SID 与其所指 item 的内容关联,教模型直接从这些 token 读出 item 语义。每个 grounding 样本构造成一条自然语言陈述,把 item 的 SID 与其文本属性(如 title、category)配对。例如:"The item with Semantic ID
<C_18921><C_40222>has the following information: Title: Insulated Lock Rod ... Category: Scaffolding." - general-domain data(约 10%):横跨数学推理、代码、科学文献、医学文本、指令跟随数据,防灾难性遗忘。
3.2.2 Instruction Tuning(指令微调)¶
持续预训练后做指令微调,教模型跨多种对齐任务应用 SID token。任务分三类:❶ SID↔文本双向翻译、❷ 直接在 SID space 里做序列推荐、❸ 保留既有能力的 general-domain 任务。Table 3 汇总前两类 SID 相关任务:
| Task | Mapping | Description | Proportion |
|---|---|---|---|
| sid2title | sid → title | 给定 SID 生成 item title | 13.8% |
| title2sid | title → sid | 给定 item title 预测 SID | 14.7% |
| sid2tag | sid → tag | 给定 SID 生成自然语言 tag | 11.5% |
| tag2sid | tag → sid | 给定文本 tag 预测候选 SID | 6.2% |
| sid2cmd | sid → cmd | 给定 SID 预测商品品类 | 13.8% |
| sid2sid | sid → sid | 给定用户点击历史预测 next-click SID | 20.0% |
- SID-Text Bidirectional Translation:把 SID 映射到/从其文本描述,链接 item title(title ↔ sid)、search query(tag ↔ sid)、commodity(sid → cmd)。双向覆盖同时教会"从 SID 读语义"和"为描述吐正确 SID"。
- Sequential Recommendation(sid → sid):把序列推荐完全放在 SID space 里做。给定按多粒度时间窗(如 3 天、2 天、1 天、12 小时、1 小时)组织的用户点击历史,模型预测用户接下来会点击的 SID。纯 SID token、无文本 item 描述,提供了模型已通过这些 token 内化协同过滤信号的最直接证据。
- General-Domain Tasks(约 20%):开放域监督任务(自然语言推理、实体抽取、电商相关任务),保持通用文本能力,尤其是产出良好 JSON 输出、遵守复杂多约束 prompt 的能力,同时不稀释推荐专用训练信号。
4. Latent Intent Reasoning(S3:潜在意图推理)¶
显式 CoT 已成 LLM 推荐器解读用户行为、挖掘隐性兴趣的常规配方,通过多步审议有效提升预测精度。但这一质量有陡峭代价:自回归生成一段数千 token 的 rationale——远长于最终输出——带来的延迟与算力在十亿用户/高 QPS 下不可承受。核心问题:能否在不付出 token 成本的前提下保留审慎推理的收益?
答案是 Latent Intent Reasoning——把冗长 trace 内化进一小段可学习 latent token,两个性质:
- Efficient:把数千步串行解码的 rationale 压进一撮 latent token,把成本从慢速自回归解码转向可并行 prefill,推理 token 成本降 200×、显著降延迟。
- Explainable:与不透明 latent 表示不同,这些 token 可按需解码回忠实、人类可读的 rationale,保住了 latent 推理通常为速度而牺牲的可解释性。
4.1 Reasoning Internalization(推理内化)¶
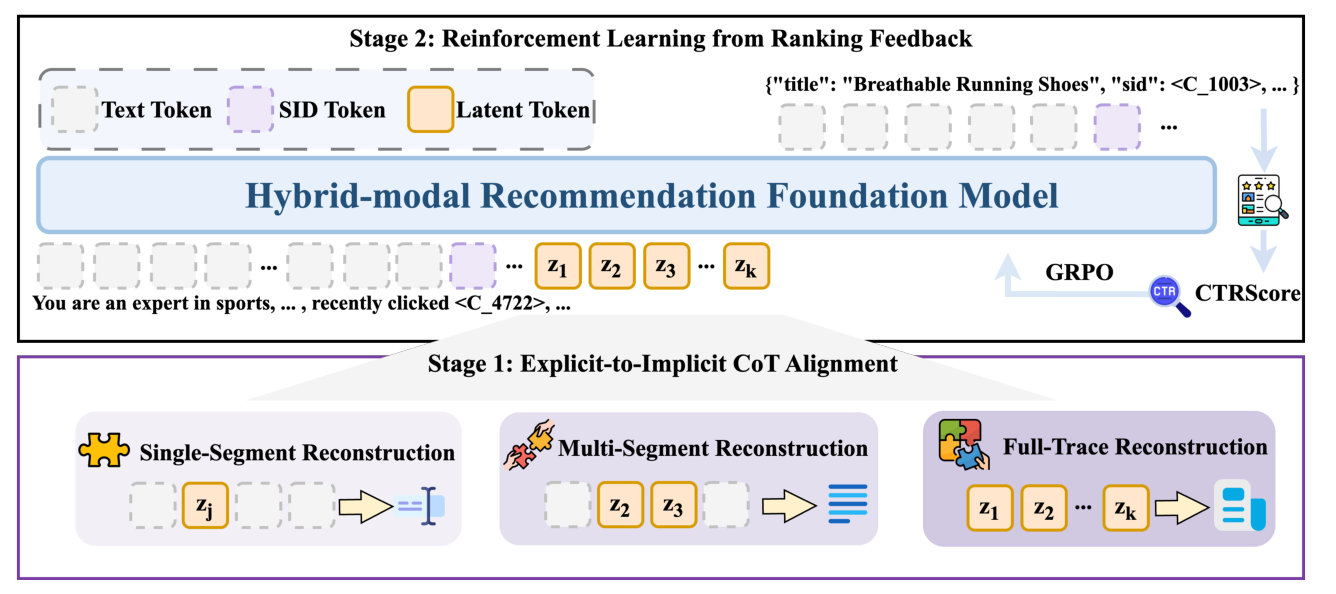
推理模型输入 $x$——Global Planner 分配的 persona 加用户近期点击历史(每个点击 item 用其 SID + 短 title 表示)。以 $x$ 为条件,一个显式-CoT 模型(实验中用 DeepSeek-V3.2)先生成 $N$ 个换行分隔步骤的推理 trace $R$,再输出 item tag $y$,联合分布因子化为:
$$p_\theta(R, y \mid x) = p_\theta(R \mid x)\, p_\theta(y \mid x, R) \tag{10}$$
但携带推理增益的 trace $R$ 也是成本集中处:其 $N$ 步自回归解码、通常远长于输出 $y$,使 $R$ 成为效率主瓶颈。因此把 $R$ 内化进一段短可学习 latent slot $z = (z_1, \ldots, z_K)$,$K \ll N$,作为新增词表 token(embedding 随机初始化)。这把 Eq. (10) 的显式因子化替换为其 latent 对应式:
$$p_\theta(z, y \mid x) = p_\theta(z \mid x)\, p_\theta(y \mid x, z) \tag{11}$$
latent 与隐式推导 trace 的关系用确定性位置划分指定:trace $R$ 切成 $K$ 个连续不重叠段 $R_1, R_2, \ldots, R_K$(每段至多 $C$ 步),latent token $z_j$ 编码段 $R_j$。latent token 数:
$$K = \min\!\left(\left\lceil \frac{N}{C} \right\rceil, K_{\max}\right) \tag{12}$$
$C$ 设定每个 latent token 的粒度(越大折叠越多步),$K_{\max}$ 限序列长度进而约束推理成本。trace 短于 $C \cdot K_{\max}$ 时尾部 latent token 覆盖较短或空段;超预算时覆盖止于前 $K_{\max}$ 段。
Latent Token Warm-up(latent token 热身):随机初始化的 latent embedding 远落后于预训练 token embedding——它们落在预训练 embedding 分布之外、尚无语义。为把它们校准进与语言 token 兼容的表示空间,随机选 trace $R$ 的一或多个连续 span 替换成 latent token 形成混合 trace $\tilde R$,在混合序列 $w = (x, \tilde R, y)$ 上优化标准自回归目标:
$$\mathcal{L}_{\text{warm}} = -\sum_{t \in \mathcal{T}} \log p_\theta(w_t \mid w_{<t}) \tag{13}$$
$\mathcal{T}$ 索引存活文本 token,latent 位置只作上下文贡献。从周围文本预测每个被掩 span 把 latent embedding 拉进预训练表示空间、赋予其粗上下文语义,为后续段级对齐给出良好初始化。
Multi-granularity Alignment(多粒度对齐):热身在表示层校准 latent embedding,但没决定每个 latent slot 应保留什么信息。位置划分只把段 $R_j$ 指派给 latent $z_j$ 作结构对应,须转成可学习信息约束——通过多粒度掩码重建实例化。给定掩码索引集 $\mathcal{J} \subseteq \{1, \ldots, K\}$,构造把未掩段保为文本、把每个被掩段替成其 latent token 的混合序列:
$$c(\mathcal{J}) = (x, e_1, \ldots, e_K, y), \qquad e_j = \begin{cases} z_j, & j \in \mathcal{J}, \\ R_j, & j \notin \mathcal{J}, \end{cases} \tag{14}$$
由任务专用指令 prompt $\mathcal{P}$ 提示要恢复哪些位置,训练模型从此上下文重建被掩段 $R_{\mathcal{J}} = \{R_j\}_{j \in \mathcal{J}}$:
$$\mathcal{L}(\mathcal{J}) = -\log p_\theta(R_{\mathcal{J}} \mid c(\mathcal{J}), \mathcal{P}) \tag{15}$$
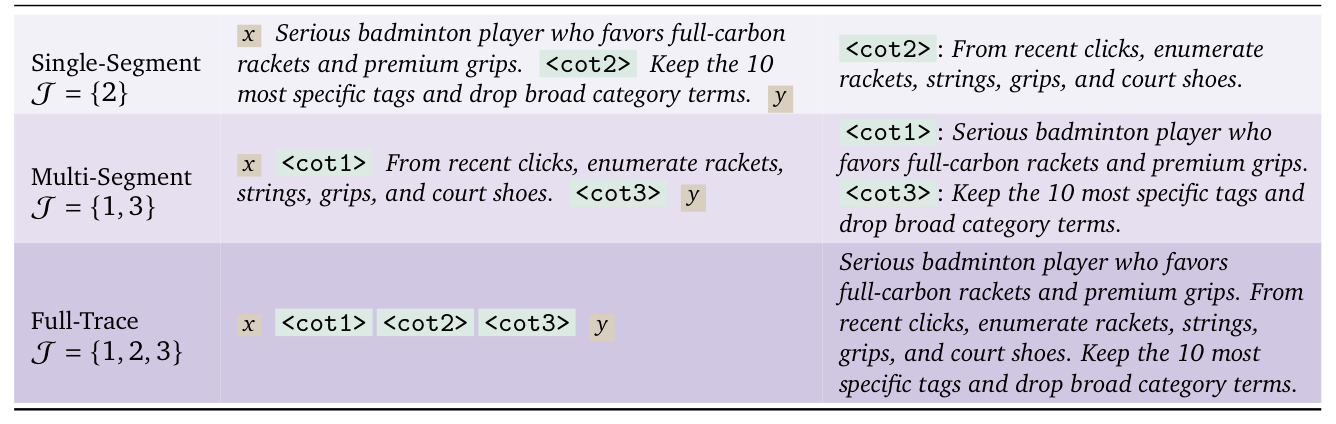
三个任务只在 $\mathcal{J}$ 抽取方式上不同,从单 latent token 扩到全序列(Table 4 以一个羽毛球装备专家为运行例):
- Single-Segment Reconstruction($\mathcal{J} = \{j\}$):只把单个段 $R_j$ 藏到其 latent token 后、其余 trace 保文本,模型重建 $R_j$。丰富上下文使重建直接,把每个 latent token 锚定到其自己的段、给出直接 per-position 编码信号。
- Multi-Segment Reconstruction($\mathcal{J} \subseteq \{1,\ldots,K\}, |\mathcal{J}| \geq 2$):把多个段同时藏到 latent token 后,模型只恢复被掩 $R_{\mathcal{J}}$。被掩 span 可能跨段边界,驱动每个 token 与周围文本共同保持信息、而非孤立。
- Full-Trace Reconstruction($\mathcal{J} = \{1,\ldots,K\}$):掩掉每个段,上下文缩到 $c = (x, z, y)$,目标 $\mathcal{L}(\{1,\ldots,K\}) = -\log p_\theta(R \mid x, z, y, \mathcal{P})$。这逼迫 latent 序列足以仅从 $(x, z, y)$ 恢复完整推理链。
超越压缩,重建目标保住 latent 推理的可解码性:因 $z$ 被训成 $R$ 的充分编码,模型能从 $(x, z, y)$ 恢复人类可读 rationale,以远低 token 成本保留显式 CoT 的透明度(Appendix C 给出 latent token 对应显式推理链的案例)。
4.2 Post-training(后训练)¶
后训练两阶段:(1) Explicit-to-Implicit CoT Alignment(§4.2.1) 从强 teacher 蒸馏推理进显式 trace 再压进 latent token;(2) Reinforcement Learning from Ranking Feedback(§4.2.2) 针对线上业务目标直接优化 latent 模型。
4.2.1 Stage 1:Explicit-to-Implicit CoT Alignment¶
(1) Reasoning Distillation(推理蒸馏):先在强 teacher 的显式 CoT 输出上微调模型来蒸馏推理。这些思考过程有效但低效——平均约 2,300 token,因此主导整体推理成本。
(2) Latent Internalization(latent 内化):用 §4.1 对齐课程把每条 trace 压进 latent token;取 $C = 20$、$K_{\max} = 10$,一条 trace 最多映射到 10 个 latent token,约 200:1 压缩。训练用一个多任务混合(Table 5),跨三个角色:❶ 把 trace 内化进 latent token 的三个 Reasoning-Alignment 任务、❷ 防灾难性遗忘的 General Reasoning 数据、❸ 匹配部署格式的 Tag Prediction(只监督输出 token 以免 latent 位置塌陷)。
Table 5(Stage 1 训练数据混合):
| Task | Prop. |
|---|---|
| ❶ Reasoning alignment | 21.43% |
| Single-segment recon. | 6.45% |
| Multi-segment recon. | 6.56% |
| Full-trace recon. | 8.42% |
| ❷ General reasoning | 69.58% |
| ❸ Tag prediction | 8.43% |
4.2.2 Stage 2:Reinforcement Learning from Ranking Feedback(RLRF)¶
监督阶段只模仿 teacher 轨迹、无法优化业务目标。RecGPT-V2(Yi et al., 2025a)用基于 HitRate(用户 held-out ground-truth item 落在输出检索候选里的比例)的精度奖励,但这个离线代理有两个局限:(1) Reward sparsity——GRPO 式目标下同组 rollout 常拿到相同奖励,优势坍缩到零、无学习梯度;(2) Pipeline inconsistency——输出须经服务流水线才触达用户,在流水线外算的奖励可能偏离真实排序表现。
为此提出 Reinforcement Learning from Ranking Feedback(RLRF):核心是直接从治理用户最终所见的生产排序模型取奖励,得到既稠密又与服务流水线一致的信号。具体地,把 HitRate 精度奖励替成从下游排序模型读取的 CTRScore。对生成输出 $y = \{t_1, \ldots, t_m\}$($m$ 个 item tag),用 $y$ 检索候选 item,用生产排序模型给每个打分,取 top-$K$ 均值:
$$r_{\text{ctr}}(y) = \frac{1}{K}\sum_{k=1}^K s_k \tag{16}$$
$s_k$ 是检索 item 里第 $k$ 大的 CTRScore(实验 $K = 100$)。这个设计同时对抗两个局限:对 top-$K$ 排序分求平均把稀疏 HitRate 信号变稠密;从生产排序模型读奖励让训练与输出实际经过的流水线对齐——只有当输出检索到的 item 被下游 ranker 青睐时才拿高奖励,把策略导向流水线更可能推给用户的候选。
其余奖励项沿用 RecGPT-V2 的 Constrained Reward Shaping(CRS) 框架——把 alignment score、diversity score、length score 作为主奖励上的质量约束:$r_{\text{ctr}}$ 只在三个阈值全满足时才传播。alignment score 由一个在人类偏好对上训练的奖励模型给出,评每个预测 tag 多符合人类质量标准。最终奖励:
$$\mathcal{R}(y) = r_{\text{ctr}}(y)\, \mathbb{1}\bigl[\text{align}(y) \geq \tau_{\text{align}}\bigr]\, \mathbb{1}\bigl[\text{div}(y) \geq \tau_{\text{div}}\bigr]\, \mathbb{1}\bigl[\text{len}(y) \geq \tau_{\text{len}}\bigr] \tag{17}$$
$\tau_{\text{align}}, \tau_{\text{div}}, \tau_{\text{len}}$ 为对齐/多样性/长度阈值(定义参考 RecGPT-V2)。用 GRPO(Shao et al., 2024)优化策略,对每个输入采样的一组输出计算 group-relative advantage。
5. 实验¶
在淘宝首页推荐场景(数亿日活)评估 RecGPT-V3,五个维度:(1) 对 RecGPT-V2 基线的整体在线 A/B(§5.1);(2) Memory Hub 评估——人工标注 + 算力效率分析(§5.2);(3) 基础模型评估——通用能力保留、SID-文本对齐、下游推荐质量(§5.3);(4) latent 推理评估——后训练有效性 + 推理效率(§5.4);(5) 进一步分析——SID 模态与案例研究(§5.5)。
5.1 Online A/B Test Results(在线 A/B)¶
实验设置:部署于淘宝首页"猜你喜欢",配置:流量分配——实验组与控制组各占全平台 1% 流量,既保统计显著又控部署风险;基线——RecGPT-V2 作控制组,直接评估 V3 引入的改进;评估场景——Item Scenario(网格布局的直接 item 推荐)与 Feed Scenario(主 feed 混合内容流,含 item、广告、直播等)。指标分两维:User Engagement(IPV item 详情页访问数、CTR 点击率、PV 页面浏览量、DAU 日活)与 Business Transaction(TC 成交笔数、GMV 成交总额)。
Table 6 汇总在线 A/B 结果(相对百分比提升):
| Scenario | IPV | CTR | PV | DAU | TC | GMV |
|---|---|---|---|---|---|---|
| Item | +3.08 | +0.98 | +2.02 | – | +3.10 | +7.51 |
| Feed | +1.28 | +1.00 | +0.83 | +0.56 | +1.97 | +3.97 |
(– 表示该指标在此场景不适用)
分析:RecGPT-V3 在两个场景所有指标上一致超越 V2。
- Item 场景增益更显著:+3.08% IPV、+0.98% CTR、+2.02% PV、+3.10% TC、+7.51% GMV。IPV/TC/尤其 GMV 相对更强的增益说明用户曝光后更可能进详情页、完成成交、产生更高交易价值——检索候选不仅在点击阶段更相关,更与用户购买意图对齐。
- Feed 场景反映整体平台体验:+1.28% IPV、+1.00% CTR,+0.83% PV,+0.56% DAU(平台留存健康增长,说明改进覆盖广泛用户群而非集中在窄子集),GMV +3.97%、TC +1.97%——更强意图理解直接转化为购买活动。
5.2 Memory Hub Evaluation¶
5.2.1 记忆质量评估:对 Structured Behavior Compression 产出的记忆单元做大规模人工标注(Table 7),评两方面——Behavior Pattern 衡量模式标识符是否正确归类用户行为簇;Behavior Index 衡量代表性索引是否正确指向属于该模式的交互:
| Evaluation Target | Annotations | Accuracy |
|---|---|---|
| Behavior Pattern | 2,514 | 82.89% |
| Behavior Index | 21,268 | 95.27% |
模式准确 82.89% 说明基于 LLM 的压缩能从噪声交互序列可靠识别连贯行为原型;索引准确 95.27% 更高,确认一旦模式被正确识别、支撑证据被准确归因(这对每个记忆单元只存原序列的整数指针至关重要)。
5.2.2 算力效率:Memory Hub 把 Global Planner 算力降 55.80%(相对 V2 基线,Table 8)。主要节省来自推理时——每次 pass 现在基于压缩记忆 + 近期行为增量而非重编码全序列,把 per-pass 成本降到 33.43%;周期性增量维护再贡献 10.77% 的成本(相对其带来的节省是不大的开销):
| System | Component | Cost |
|---|---|---|
| RecGPT-V2 | Full sequence | 100% |
| RecGPT-V3 | Per-inference | 33.43% |
| RecGPT-V3 | Memory curation | 10.77% |
| RecGPT-V3 | Total | 44.20% |
Memory Hub 把一项反复出现的 per-inference 开销转成摊销的记忆维护成本,得到随请求量友好扩展的算力画像。
5.3 Foundation Model Evaluation¶
两个问题:(1) 领域专用训练后模型是否保住强通用语言能力(§5.3.1)?(2) 是否达成准确跨模态 SID-文本对齐并转化为强下游推荐质量(§5.3.2)?为解耦 general-domain 数据混合的贡献,全程比较两个变体——w/ General-Domain Data(从 Qwen3-14B 初始化、SID-grounding + general-domain 数据训练)与 w/o General-Domain Data(同架构同 SID 数据、移除全部 general-domain 数据)。
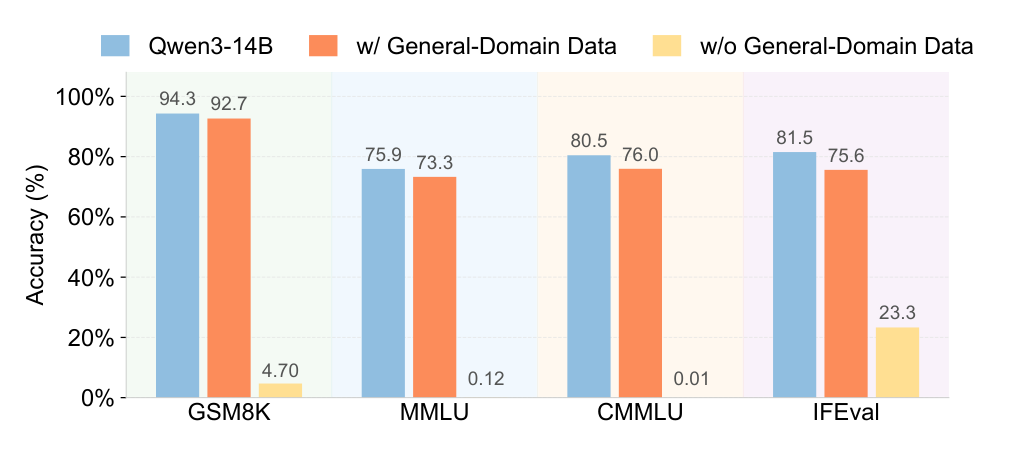
5.3.1 通用能力保留:跨四个 benchmark 评估——数学推理(GSM8K)、广知识(MMLU)、中文理解(CMMLU)、指令跟随(IFEval)(Figure 6)。general-domain 数据混合保住 backbone 绝大部分能力:GSM8K 只掉 1.66%(94.31→92.65),MMLU 2.65%,CMMLU 4.49%,IFEval 从 81.52 降到 75.60。移除 general-domain 数据则灾难性崩溃:w/o 变体 GSM8K 跌到 4.70、MMLU 0.12、CMMLU 0.01、IFEval 23.29,几乎失去所有推理/知识/指令跟随能力。general-domain 数据因此不可或缺——没有它提供的正则,持续预训练与指令微调会让模型过拟合领域模式、丢失真实部署所需的通用能力。
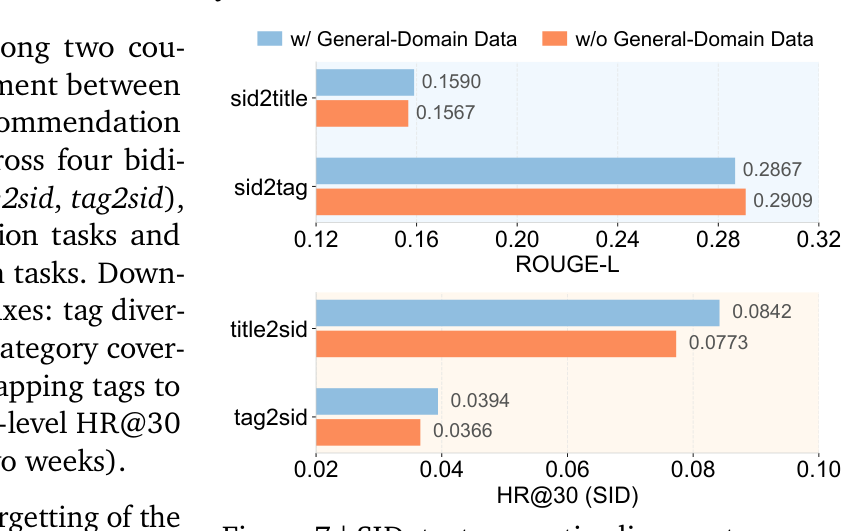
5.3.2 SID 对齐与推荐质量:沿两个耦合维度评估基础模型——SID-文本跨模态对齐、下游推荐质量。对齐用四个双向任务测(sid2title、sid2tag、title2sid、tag2sid),生成任务用 ROUGE-L、预测任务用 HR@30(SID)。下游质量测三轴:tag diversity(每用户平均唯一 tag 数)、category coverage(tag 映射到淘宝分类后的不同 item 品类数)、category-level HR@30(对两周实际点击的命中率)。
Figure 7 显示四个对齐指标在两变体间基本不变,说明混入 general-domain 数据不损害从 SID-grounding 数据学到的 SID-to-text 映射能力。Table 9 进一步显示这个数据混合把 category-level HR@30 提升 26.2%(0.2250→0.3050),同时 tag diversity 与 category coverage 也有可比增益:
| Model | Avg. #Tags | Avg. #Categories | HR@30 (Category) |
|---|---|---|---|
| w/ General-Domain Data | 28.77 | 41.73 | 0.3050 |
| w/o General-Domain Data | 23.88 | 32.49 | 0.2250 |
结论:general-domain 数据既保住语义对齐优势、又保留 backbone 通用知识,并把两者转化为更强下游表现——刻意整合 general-domain 数据是合理的。
5.4 Latent Reasoning Evaluation¶
两个视角:(1) 后训练有效性——每个训练阶段与 RL 如何贡献推荐质量;(2) 推理效率——显式 vs latent 推理的算力成本。
5.4.1 后训练有效性:渐进加训练阶段考察各自贡献(Table 10)。两组指标:HR@30(Category)(top-30 预测的品类级命中率)与 CTR(模型输出检索的 top-100 item 平均 CTR)。两组模型变体:第一组基于 Qwen3-14B(评 native reasoning 单独是否提升,CTR 不适用因未接线上反馈流水线);第二组基于混合模态基础模型渐进加推理组件。
| Setting | HR@30 (Category) | CTR |
|---|---|---|
| Qwen3-14B | 0.2276 | – |
| + Native Reasoning | 0.2347 | – |
| Hybrid-modal Foundation Model | 0.3050 | 0.0624 |
| + Explicit CoT (SFT) | 0.3508 | 0.0638 |
| + Latent Reasoning | 0.3462 | 0.0649 |
| + RL(完整 RecGPT-V3) | 0.3693 | 0.0679 |
分析:在 Qwen3-14B 上开 native CoT 只带来微弱 HR@30 提升(0.2347 vs 0.2276),确认无领域专用训练的推理收益有限。在混合模态基础模型上,explicit CoT 把 HR@30 从 0.3050 提到 0.3508,说明结构化推理带来更精准意图理解。latent reasoning 在把约 2,700 推理 token 压进 10 个 latent token 的同时达到可比质量(HR@30 0.3462,CTR 0.0649)。加 RL 后进一步提升到 HR@30 0.3693、CTR 0.0679,在两个指标上都超过 explicit CoT——RL 直接对齐业务奖励让 latent 策略比纯模仿 teacher 更优。
5.4.2 推理效率:Table 11 在 1,000 样本、同硬件上量化。latent 推理把 per-sample 输出长度从 2,840 降到 122 token(95.7% 减少),端到端 3.46× 加速(1,020s→295s);input throughput 从 166K 升到 498K tokens/min,确认瓶颈从输出解码有效转移到 input prefill:
| Mode | Output Length | Input TPM | Output TPM | Total Time (s) |
|---|---|---|---|---|
| Explicit CoT | 2,840 | 166K | 531K | 1,020 |
| Latent Reasoning | 122 | 498K | 66.7K | 295(↓71.1%) |
Serving Cost Analysis(服务成本分析):在输入输出都用 SID + latent 意图推理,增加 context 长度、给 expert 模型带来相对 V2 expert 约 15% 算力开销。但这一局部开销被 Global Planner 的系统级节省抵消——当前部署里 Planner 算力约为一个 expert 模型的 20 倍;配合 Memory 机制把 planner 侧算力降 55.8%,加权总体资源节省达 52.4%。
5.5 Further Analysis¶
5.5.1 SID 模态分析:混合模态基础模型同时生成文本 tag 与 SID 作为互补意图表示——tag 通过开放式世界知识提供可泛化的品类级覆盖,SID 用具体协同语义锚定用户兴趣。从三视角验证:
Coverage Breadth vs. User Specificity(覆盖广度 vs 用户特异性):每次推理 expert 模型生成 $N$ 个文本 tag $\{t_1, \ldots, t_N\}$ 及每 tag 的 $K$ 个 SID。把每 tag $t_i$ 映射到 item 品类集 $C_{\text{tag}}(t_i)$,把其共生 SID 品类聚合为 $C_{\text{sid}}(t_i) = \bigcup_{k=1}^K C(\text{SID}_k)$。定义平均品类广度 $\bar C$ 与跨用户重叠 $J$:
$$\bar C_{\text{tag}} = \frac{1}{N}\sum_{i=1}^N |C_{\text{tag}}(t_i)|, \qquad \bar C_{\text{sid}} = \frac{1}{N}\sum_{i=1}^N |C_{\text{sid}}(t_i)| \tag{18}$$
$$J_{\text{tag}} = \mathbb{E}_{(u,v)}\!\left[\frac{|C_{\text{tag}}^{(u)} \cap C_{\text{tag}}^{(v)}|}{|C_{\text{tag}}^{(u)} \cup C_{\text{tag}}^{(v)}|}\right], \qquad J_{\text{sid}} = \mathbb{E}_{(u,v)}\!\left[\frac{|C_{\text{sid}}^{(u)} \cap C_{\text{sid}}^{(v)}|}{|C_{\text{sid}}^{(u)} \cup C_{\text{sid}}^{(v)}|}\right] \tag{19}$$
结果(Table 12):品类广度 $\bar C_{\text{tag}} = 1.40$ 而 $\bar C_{\text{sid}} = 0.84$——即使每 tag 聚合 $K$ 个 SID,合并品类集仍窄于单个文本 tag,确认文本 tag 覆盖更广(跨多样兴趣范围),SID 聚焦更窄(特定品类簇)。跨用户重叠 $J_{\text{tag}} = 11.36\%$ vs $J_{\text{sid}} = 4.61\%$——SID 显著更低的重叠反映其更强用户特异性(协同语义捕捉用户特有信号),文本 tag 更高重叠源于对共享世界知识的依赖:
| Metric | Text Tag | SID |
|---|---|---|
| Category Breadth | 1.40 | 0.84 |
| Cross-User Overlap | 11.36% | 4.61% |
Embedding-Space Visualization:对每 tag 与其共生 SID 采样等量相关 item、取预训练检索模型 embedding、PCA 投影到 2D(Figure 8)。Tag-matched item 空间分散跨多样区域,SID-matched item 在特定邻域形成更紧簇——从视觉上再证文本 tag 的世界知识驱动覆盖 vs SID 的协同驱动特异性。
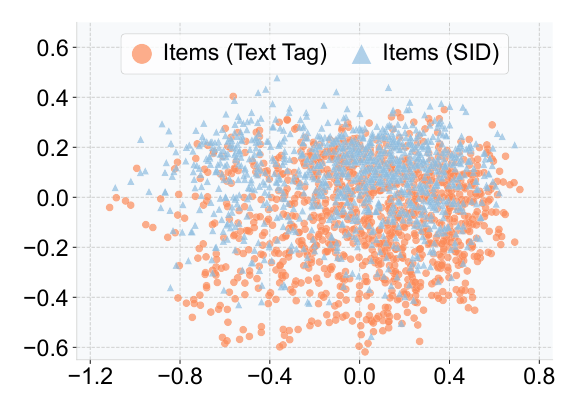
Retrieval Complementarity(检索互补性):Table 13 在离线测试集上量化端到端 item 级命中率——SID 检索(HR@500 0.1539)略优于 tag 检索(0.1503),Hybrid 配置进一步提升到 0.1571;HR@1000 上一致(0.2168 vs 0.2144 vs 0.2044),确认两模态互补。混合检索模型(§附录 B)联合消费两模态,结合文本 tag 的广覆盖与 SID 的协同精度:
| Configuration | HR@500 | HR@1000 |
|---|---|---|
| Tag | 0.1503 | 0.2044 |
| SID | 0.1539 | 0.2144 |
| Hybrid | 0.1571 | 0.2168 |
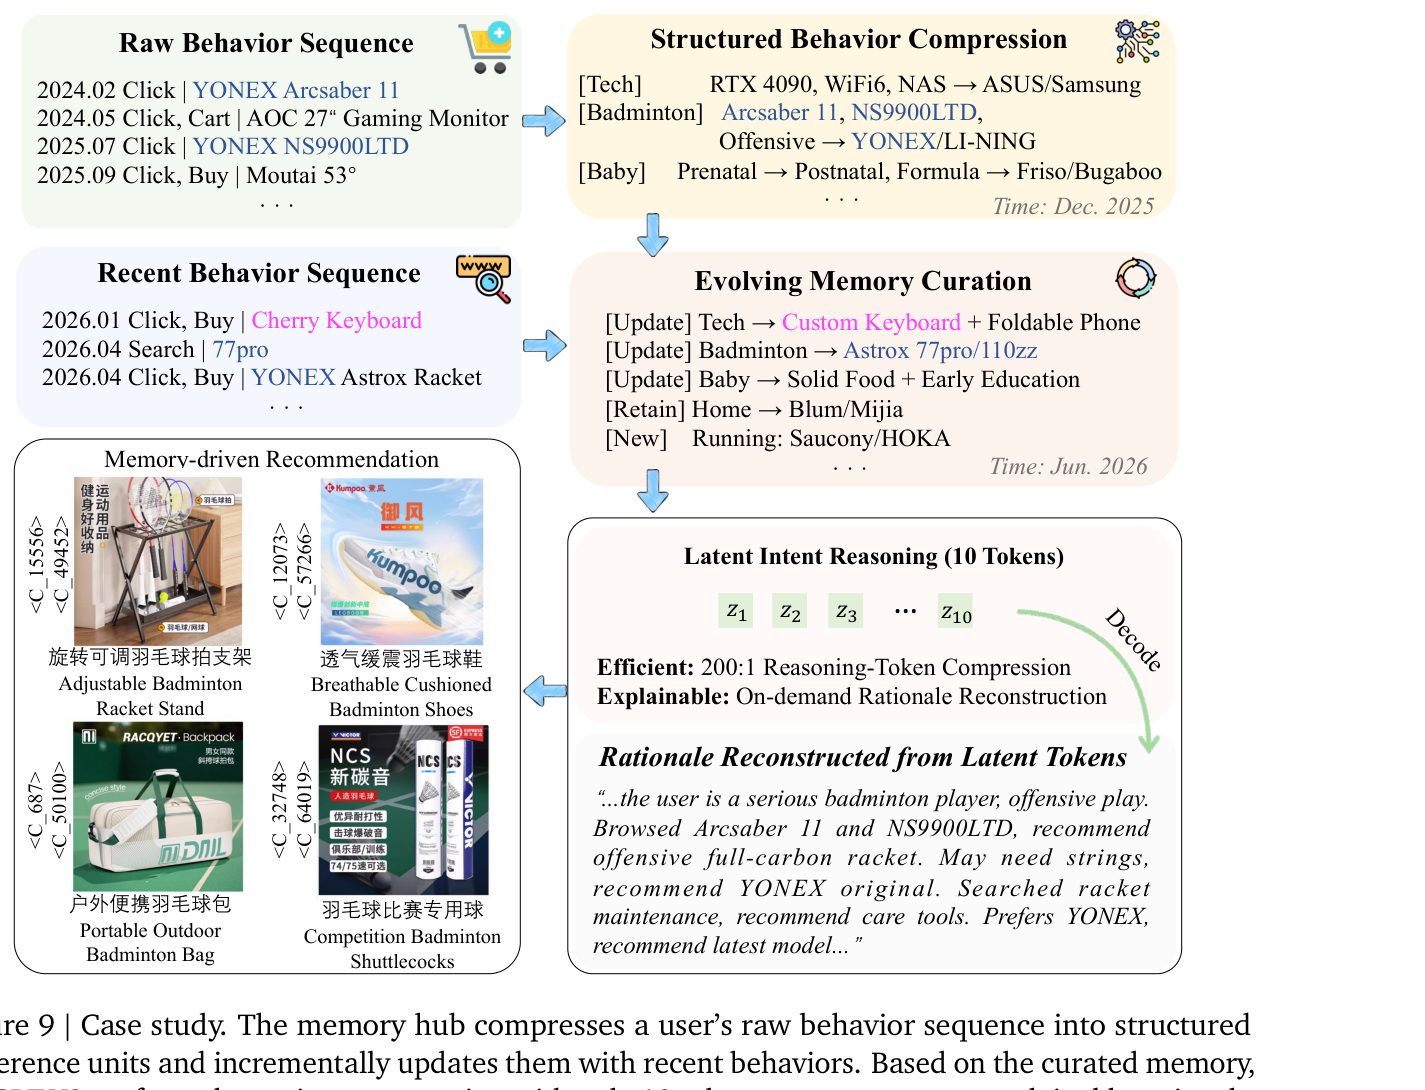
5.5.2 Case Study:Figure 9 给出一个匿名淘宝用户的端到端案例。Memory Hub 先把原始行为序列压成 tech、badminton、baby-care 等结构化偏好单元;新行为到来时选择性更新相关记忆(customized-keyboard 交互刷新 tech 单元、Astrox 相关搜索更新 badminton 单元、baby-care 向 solid food 与 early education 演进、stable home-improvement 保留、新建 running 偏好)。基于维护后的记忆,RecGPT-V3 只用 10 个 latent token 做 Latent Intent Reasoning,这些 token 在推理时替代冗长显式 CoT,但可解码回可读 rationale——本例重建的 rationale 识别出用户是偏进攻打法的严肃羽毛球玩家,推断出对全碳球拍、球线、维护工具及相关羽球装备的需求,随后落地为 SID 锚定的记忆驱动推荐。
6. 附录亮点:Intent-to-Item Retrieval(混合检索模型)¶
附录 B 补足了把 hybrid tag + SID 信号落地为准确 item 检索的下游模型。Hybrid Retrieval Model 同时以文本 tag 与 SID 为输入、学习候选 item 的偏好排序。架构上采用 dual-embedding:每个 tag $t_i$ 经文本 embedding 层 $\mathbf{e}_t^{(i)} = \text{Emb}_{\text{tag}}(t_i)$、每个 SID $d_i$ 经 SID embedding 层 $\mathbf{e}_d^{(i)} = \text{Emb}_{\text{sid}}(d_i)$,拼接后线性投影得统一意图表示:
$$\mathbf{q}_i = W_{\text{proj}} \cdot [\mathbf{e}_t^{(i)} \| \mathbf{e}_d^{(i)}] + \mathbf{b} \tag{20}$$
意图向量 $\{\mathbf{q}_1, \ldots, \mathbf{q}_M\}$ 作 Target-Attention 的 query,attend 候选 item 表示算检索分。这个双通道设计在早层保通道专属信息、又通过共享注意力实现跨通道交互,让检索器兼得语言的语义广度与离散 item 表示的协同精度。
训练配方(附录 B.2):单靠 click 信号监督不足——click 倾向与流行度混淆,纯 click 目标偏好全局热门 item 而非忠于条件意图。因此把检索训练建成一个 joint 目标,在候选 item 的显式偏好层级下调和 click utility 与语义相关性:
$$\textbf{Clicked} \cap \textbf{Relevant} \;>\; \textbf{Unclicked} \cap \textbf{Relevant} \;>\; \textbf{Unclicked} \cap \textbf{Irrelevant}$$
utility loss(标准 softmax,$C$ 为点击 item 集)与 relevance loss(多级对比,$\mathcal{P}(i)$ 为渐进粗化匹配构造的相关正集,负集按交互深度 clicked > exposed > non-exposed 分优先级)联合:
$$\mathcal{L}_{\text{util}} = -\frac{1}{|C|}\sum_{i \in C}\log\frac{\exp(s_i)}{\exp(s_i) + \sum_{j \notin C}\exp(s_j)} \tag{21}$$
$$\mathcal{L}_{\text{rel}} = -\frac{1}{N}\sum_{i=1}^N\frac{1}{|\mathcal{P}(i)|}\sum_{j \in \mathcal{P}(i)}\log\frac{\exp(s_j)}{\exp(s_j) + \sum_{k \in \mathcal{N}(i,j)}\exp(s_k)} \tag{22}$$
$$\mathcal{L} = \alpha\,\mathcal{L}_{\text{util}} + \beta\,\mathcal{L}_{\text{rel}} \tag{23}$$
生产实验取 $\alpha = 1, \beta = 0.5$,驱动检索器偏好既 click-worthy 又与上游意图语义对齐的商品。
核心贡献总结¶
- Memory Hub —— 把 LLM 推荐器从无状态变有状态:Structured Behavior Compression(一次性把全序列压成 schema 化记忆单元,token 降 94.5%)+ Evolving Memory Curation("有证据才更新、无关就不打扰"的两个月一次增量维护),把用户理解沉淀为可追溯、可演化的持久记忆,Global Planner 算力降 55.8%,人工标注 pattern/index 准确率 82.89%/95.27%。
- Hybrid-modal Foundation Model —— 跨过 tag→item 瓶颈:用 CN-CLIP + Q-Former 融合多模态、对比学习产判别式 embedding、两级 RQ-VAE(各 32,768 码、共 65,536 SID token)量化,扩 Qwen3-14B 词表;两阶段(持续预训练 SID-grounding + 指令微调六大 SID 任务),general-domain 数据(预训练 10% + 微调 20%)是避免灾难性遗忘与保留通用能力的关键(移除后 MMLU 从 73.3 崩到 0.12)。文本 tag 与 SID 互补:tag 覆盖广(品类广度 1.40)、SID 特异性强(跨用户重叠仅 4.61%),Hybrid 检索 HR@500 0.1571 优于单模态。
- Latent Intent Reasoning —— 保留可解释推理但削 200× token:把显式 teacher CoT(约 2,300–2,840 token)经"位置划分 + 热身 + 单/多/全段掩码重建对齐"压进最多 10 个可解码 latent
<cot>token(约 200:1);两阶段后训练(Explicit-to-Implicit CoT Alignment + RLRF)——RLRF 直接从生产排序模型读 CTRScore 作稠密一致奖励,配合 CRS 约束用 GRPO 优化。latent 推理输出长度降 95.7%、端到端 3.46× 加速,加 RL 后 HR@30 0.3693/CTR 0.0679 反超显式 CoT。 - 工业落地:淘宝首页"猜你喜欢" 1% 流量在线 A/B 对 V2 全面正向(Feed +3.97% GMV / Item +7.51% GMV),端到端服务算力降 52.4%,三代累计 RecGPT-V3 仅用 V1 的 19% 算力。
与已归档相关工作的对比¶
GR2 GR2: Generative Reasoning Re-Ranker (Meta AI, 2026-06-30)¶
关系:独立并发(本文未引用 GR2,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都直击"如何把 LLM 的显式 CoT 推理真正落进十亿级工业推荐流水线"这一 root cause,并共同识别两个孪生障碍——(a) 显式 CoT 的 serving 成本不可承受(GR2 讲低吞吐 + reward hacking,RecGPT-V3 讲约 3,000 token 的延迟税),(b) 非语义 item ID 与 LLM 词表错配(GR2 的 G2 vocabulary mismatch ≈ RecGPT-V3 的 C2 tag→item 瓶颈,都用 SID 桥接)。
- 相近的技术骨架:几乎逐段对应——① SID mid-training / 持续预训练把 item 目录塞进 LLM 词表(GR2 tokenizer ≥99% uniqueness;RecGPT-V3 两级 RQ-VAE 65,536 token);② teacher CoT 蒸馏(GR2 用 Qwen3-32B teacher + rejection sampling;RecGPT-V3 用 DeepSeek-V3.2 teacher);③ 可验证/业务奖励 RL(GR2 DAPO + AUC/NDCG verifiable reward;RecGPT-V3 RLRF 从生产 ranker 读 CTRScore + GRPO);④ 推理内化削 serving 成本(GR2 把 CoT 蒸进 non-thinking student 得约 15× serving ROI;RecGPT-V3 把 CoT 压进 latent token 得 200× token 压缩 / 3.46× 加速)。
- 本文的差异与推进:GR2 的"推理内化"是把 CoT 蒸成一个不思考的 no-think 策略(推理消失、不可解释);RecGPT-V3 的关键差异是把 CoT 压进可解码的 latent
<cot>token——推理仍在(只是移到 latent 空间),且能按需重建回可读 rationale,兼顾效率与可解释。另外 RecGPT-V3 多出一层 Memory Hub 有状态用户建模(GR2 无对应组件,仍是 one-shot),把 planner 侧算力再降 55.8%。GR2 聚焦漏斗最末的 re-ranking,RecGPT-V3 覆盖意图推理→检索的更前置环节。 - 可比的方法/实验差异:两者都在工业流量报强正向,但口径不同——GR2 报排序质量 +18.7% R@1 / +9.6% N@3 + 约 15× serving ROI(相对无 LLM 重排的 point-wise CTR 基线);RecGPT-V3 报业务指标 Feed +3.97% GMV / Item +7.51% GMV + 52.4% 算力下降(相对已经很强的 LLM 基线 V2)。GR2 用 verifiable AUC/NDCG reward,RecGPT-V3 直接用生产 ranker 的 CTRScore 作 pipeline-consistent reward——后者刻意对齐服务流水线以避 GR2 强调的 pipeline inconsistency / reward-hacking。
LASAR LASAR: Latent Adaptive Semantic Aligned Reasoning (北航 & 百度, 2026-05-11)¶
关系:独立并发(本文未引用 LASAR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:都攻"显式 CoT 在生成式推荐里 token-by-token 生成、延迟致命"这一 root cause,都主张把推理搬进 latent 空间以在保留推理增益的同时把成本降一个数量级;都在 SID 场景下踩到"新 SID 符号系统 grounding 与 latent 推理相互干扰"的坑,并都用先 grounding、后 latent 推理的解耦来化解(LASAR 的 two-stage decoupling ≈ RecGPT-V3 的持续预训练锚定 SID 后再做 latent 内化)。
- 相近的技术骨架:都是 SFT(蒸馏/对齐)-then-RL 两阶段:先把推理灌进 latent token、再用 RL 针对推荐目标精炼;都用 GRPO 家族做 RL;都强调 latent 推理相对显式 CoT 的约 20× / 3.46× 加速。
- 本文的差异与推进:机制路线不同——LASAR 走 Coconut 式 recurrent hidden-state feedback loop(把上一步最末层 hidden state 当下一步 input embedding 递归 N 次,中间态完全不可观测),并用 Policy Head + REINFORCE 做自适应步长;RecGPT-V3 走 reconstruction-based masked alignment(把 teacher trace 切段、每段压进一个固定 latent
<cot>slot,用单/多/全段掩码重建训练),关键差异是 latent token 可解码回可读 rationale(LASAR 的 hidden-state loop 不可观测、牺牲了可解释性)。此外 RecGPT-V3 是完整工业系统(含 Memory Hub + Hybrid-modal + 线上 A/B),LASAR 聚焦 latent 推理机制本身、在 Amazon 公开数据集上验证。 - 可比的方法/实验差异:LASAR 用 stepwise bidirectional KL 把每个 latent step 锚到对应 explicit CoT 段的 hidden state(对齐在 hidden-state 层);RecGPT-V3 用掩码重建把 latent token 锚到被掩文本段(对齐在 token 重建层,因此天然可解码)。LASAR 报 Beauty/Instruments/Sports 公开集 SOTA + 约 20× 加速;RecGPT-V3 报淘宝线上 GMV + 200:1 token 压缩。
(补注:本文在 C3 引用了 explicit-CoT 生成式推荐的前作 OneRec-Think OneRec-Think 一类工作作为"低效显式推理"的代表——OneRec-Think 把显式 in-text 推理引入生成式推荐但不做 latent 压缩、无记忆中枢,属被本文超越的显式推理路线,故不单列孪生子节。)
讨论与局限性¶
核心贡献与值得借鉴的设计:
- "有状态记忆"是本文最工程化、最可迁移的贡献。把"每次请求重跑全量历史"这个几乎所有 LLM 推荐器共有的隐性浪费,重构成"压缩记忆 + 增量维护"的持久层,且做到 condensed/traceable/evolvable 三性质兼顾(尤其 traceable 的整数指针 provenance,让记忆既省 token 又可回查审计)。55.8% 的 planner 算力下降与 82.89%/95.27% 的人工标注准确率支撑了这套抽象的可靠性。
- "可解码 latent 推理"漂亮地化解了效率-可解释的两难。业界主流要么走显式 CoT(可解释但慢)、要么走不可观测 latent(快但黑箱),RecGPT-V3 用 reconstruction 目标把 latent token 训成 trace 的"充分编码",一举拿下 200× token 压缩又保住按需重建 rationale——这对需要人工审计、可解释合规的工业推荐尤其有价值。
- RLRF 直接从生产 ranker 取 CTRScore 作奖励,把 RL 训练与真实服务流水线对齐,规避了离线 HitRate 代理的稀疏与 pipeline inconsistency——这是把 RL 落地工业推荐的务实一招。
局限与争议:
- 实验以工业口径为主,公开可复现性弱:全文无公开学术数据集(Amazon/MovieLens)的标准 benchmark,HR@30/CTR 均为内部离线口径,A/B 相对 V2 而 V2 本身未开源,外部难以独立复现或横向对比。相比之下同族孪生 LASAR/FLR 至少在 Amazon 公开集给了可比数字。
- "200× token 压缩"与"3.46× 加速"口径不一致:token 数确压 200:1(2,300→10 latent token),但端到端只快 3.46×——因瓶颈转移到 input prefill(input TPM 从 166K 升到 498K),真实延迟收益远小于 token 压缩比暗示的量级,论文对此坦诚但标题式的"200×"易造成误读。
- Memory Hub 两个月才增量维护一次:对快速漂移的兴趣(如临时活动、突发热点)可能存在最长两个月的记忆滞后;维护频率与新鲜度的权衡未做敏感性分析。
- 依赖强外部 teacher(DeepSeek-V3.2)蒸馏推理:latent 推理质量上限受 teacher CoT 质量约束,teacher 的选择/成本/许可未讨论;且 15% 的 expert 侧 context 开销是靠"Planner 是 expert 20 倍算力"这一当前部署特有比例才被系统级节省抵消,换部署形态该结论未必成立。
工业落地价值:这是一篇高完成度的重磅工业技术报告——三大机制各自独立可用、又在同一系统里协同(记忆降 planner 算力、SID 修检索带宽、latent 推理降 expert 延迟),并给出淘宝首页真实 1% 流量 A/B 的全指标正向(Feed +3.97% GMV、Item +7.51% GMV)与 52.4% 端到端算力下降。对"如何把 LLM 作为工业推荐大脑、在提升精度的同时反而降本"给出了一套可参照的系统级答案,是 LLM-for-RecSys 方向的必读参考。