RecGPT:用文本驱动的统一 tokenization 把序列推荐做成"真零样本"基础模型
HKUDS (HKU) & Tencent,arxiv 2506.06270,代码 github.com/HKUDS/RecGPT。 命名撞车提示:本文 RecGPT 与库里已有的阿里淘宝 RecGPT-V2/V3/RecGPT-Mobile 不是同一系统(后者是 Taobao & Tmall Group 的 LLM 工业推荐器谱系)。同名纯属巧合,二者无技术传承关系,因此 DAG 不连迭代边(详见文末"谱系澄清")。
研究动机
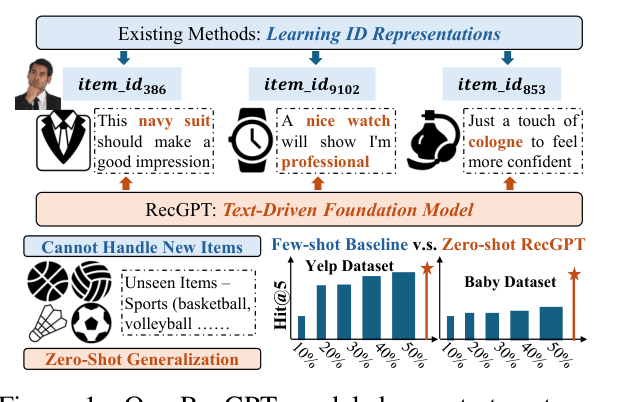
传统 ID-based 推荐(SASRec/BERT4Rec 等)给每个 item 学一个独立 ID embedding,天然被锁死在训练域里:
- 跨域彻底失效:不同平台(电商商品、视频、新闻)的 item 语义空间、描述格式、属性完全异构,ID 表示无法迁移。
- 冷启动 / 数据稀疏崩溃:新 item / 新用户没有足够交互历史来学 ID embedding。
作者提出的核心问题:能不能像语言 / 视觉基础模型那样,用大规模预训练造一个具备真·零样本泛化能力的序列推荐基础模型? 要做到这点,必须解决三个障碍:
- item 表示的语义异构——需要一个 domain-invariant 的 tokenization 把异构文本描述统一成标准离散 token,同时保住语义丰富度。
- item tokenization 的层级依赖——一个 item 被表示成多个 token,模型要同时建模 item 内 token 的语义连贯(micro)和 item 间的序列依赖(macro)。语言里"词→token"是单层的,item tokenization 是双层的。
- 解码效率瓶颈——token 组合空间远大于真实 catalog(50k 词表 × 4-token/item ≈ $6.25\times10^{18}$ 理论组合 vs 百万级真实 item),朴素搜索不可行。
核心方法
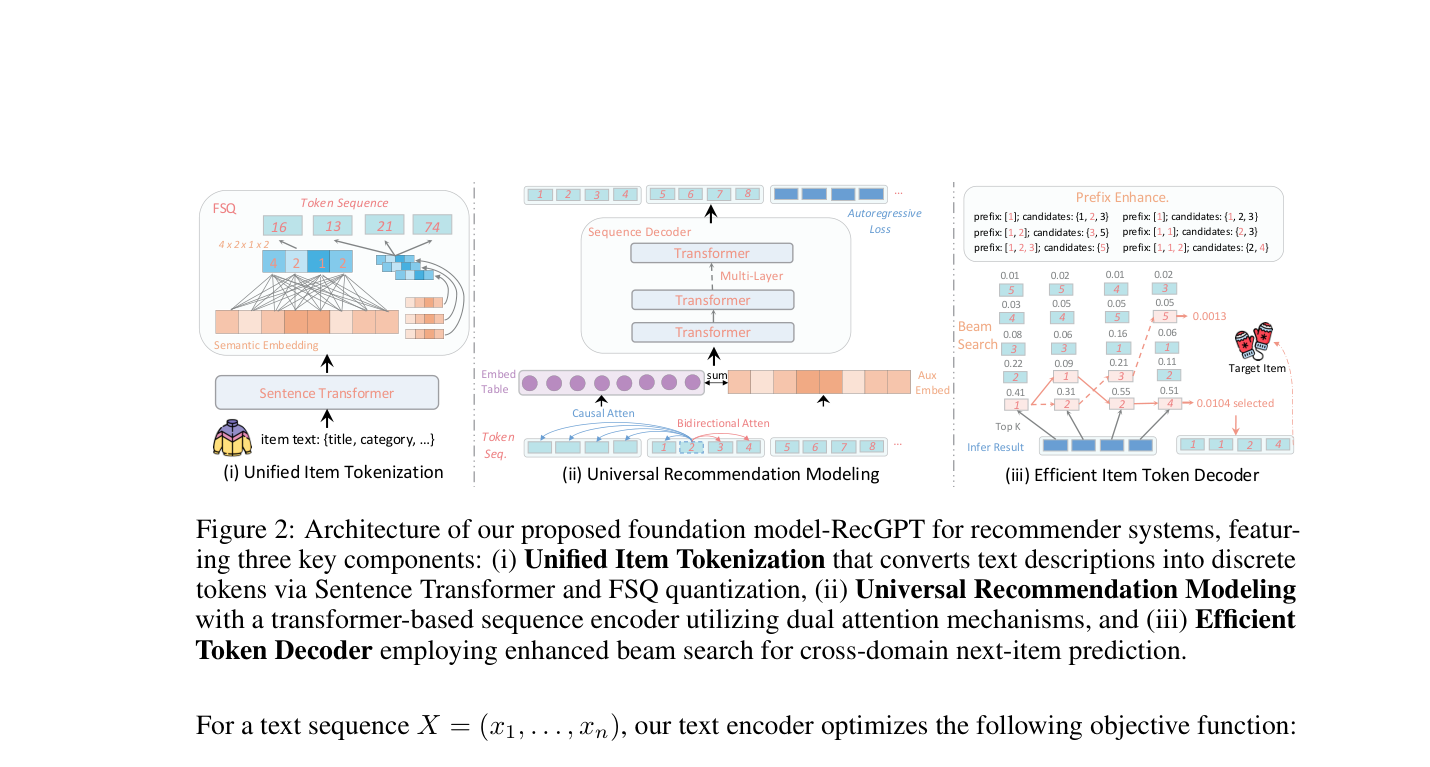
RecGPT 把序列推荐重构成自回归 next-item 生成,三个架构组件对应上面三个障碍。
1. Unified Item Tokenization(统一 item token 化)
把 item 表示完全从文本特征(标题、描述、类目)派生,不用任何 ID:
- 文本编码器:用 MPNet(融合 MLM + PLM 的排列语言建模,见公式 1)把 item 文本编成 $d_L$ 维语义 embedding $e_i=\mathrm{MPNet}(X_i)$(公式 2)。这一步产出跨域一致、domain-agnostic 的语义表示。
- FSQ 量化(关键设计):用 Finite Scalar Quantization 把连续 embedding 离散成定长 token 序列 $s_i=s_i^0\cdots s_i^{K-1}$。先把 $d_L$ 维 embedding 切成 $K$ 个子向量,每个子向量经线性降维 $\mathcal{T}_{in}$、sigmoid 归一化、再用带超参 $L$ 的取整 $R[\cdot]$ 映射到 $L$ 个离散整数(公式 3)。把每个子向量再切 $d_{fsq}$ 段,得到 $L^{d_{fsq}}$ 的巨大离散空间,实现近乎无损的语义→离散映射。选 FSQ 而非 VQ-VAE 是因为 FSQ 优雅规避了 codebook collapse。取整不可导用 STE(直通估计) 让梯度穿过(公式 4)。
- 量化优化:训练时用多层 transformer decoder 从离散 token 重建原 embedding $\hat e_i$,用 $L_1$ 重建损失(对 outlier 更鲁棒、偏好稀疏重建,公式 5)。
这套统一 token 化就是零样本能力的地基:任何新 item 只要有文本描述,就能立刻被 embed 成标准 token,无需重训。
2. Universal Recommendation Modeling(通用推荐建模)
用自回归 transformer 做 next-token 预测,但要解决两个由 tokenization 引入的问题:
- 混合双向-因果注意力:标准单向因果注意力会阻断同一 item 内 token 之间的信息流。RecGPT 对同一 item 内的 token 用双向注意力(保证 item 表示连贯),对item 之间用因果注意力(保证序列建模的时序因果性)。这个 hybrid 设计直接回应了障碍 2 的双层依赖。
- 辅助语义特征流(dual-stream):量化不可避免有信息损失,于是把原始连续语义 embedding $E_{aux}$ 和离散 token embedding $E_{wte}$ 两路并行,各自 LayerNorm 后再加位置编码 $E_{wpe}$ 组成最终输入(公式 6)。连续流补回被量化丢掉的语义细节。
- 训练目标:负对数似然的 next-token 预测(公式 7),用 floor 函数 $\lfloor t/K\rfloor\times K$ 维持 item 边界。双向注意力使得一次前向即可并行预测代表下一个 item 的全部 $K$ 个 token。
3. Efficient Item Token Decoder(高效 item token 解码器)
- 一次前向出 $K$ 个 token:因为架构能并行预测下一个 item 的全部 $K$ 个 token,直接在这 $K$ 个 token 的联合概率上做 beam search,避免逐 token 迭代生成,大幅降低推理时延和显存。
- Trie-based catalog-aware search:真实 catalog 只占理论 token 组合空间的极小一部分。把整个 catalog 的 token 词表编成 Trie(前缀树),beam search 每生成一个 token 就沿 Trie 只走能通向合法 item 的分支。两个好处:(1) 不浪费算力在永远无效的 token 序列上;(2) 保证最终推荐一定对应真实 catalog item。
关键实验与收益
评测设置:6 个公开数据集(跨域场景:Amazon 的 Baby/Games/Office;跨平台:Yelp/Washington/Steam),外加 1 个工业新闻平台(163,385 用户、455,372 item、999,140 交互)。核心指标 Hit@k / NDCG@k(k∈{1,3,5})。
跨域零样本(Table 1,主结果)
RecGPT 零样本(下游 0 训练数据) 对比 baseline few-shot(用 10% 目标域数据),仍全面领先(* 表示 p<0.05 显著)。例:
- Amazon-Baby:Hit@3 0.0281 vs 次优 0.0061(ICLRec/MAERec 量级),NDCG@3 0.0277。
- Amazon-Games:Hit@3 0.0374、NDCG@3 0.0370,均显著超全部 baseline。
- Steam:Hit@1 0.1237 vs 次优 0.1022,NDCG@3 0.1242。
结论:统一 FSQ token 化解决语义异构 + 混合注意力捕捉跨域模式,是零样本领先的两大来源。
冷启动(Table 2)
把用户序列随机截断到只剩 1-3 个 item 模拟冷启动。RecGPT 在 Baby/Office/Yelp 上多数指标 best/second-best 且显著,说明基础模型的预训练知识能从极少用户行为里识别通用偏好模式,绕开 ID-based 方法必须的域内大数据。
工业验证(Figure 3)
在千万级日活的生产新闻平台做零样本对比,Hit@5 与 NDCG@5 均显著高于 Bert4Rec/FDSA/CL4SRec/DuoRec/MAERec/S³-Rec。离线特征生成流水线 + 定时 embedding 更新(含冷启动 item),验证了满足工业时延/吞吐/可靠性要求。
消融(Table 3)
四个变体证明每个组件都必要(以 Baby Hit@5=0.0283 为满配):
| 变体 | 说明 | Baby Hit@5 |
|---|---|---|
| w/o FSQ | 随机 token 替代 FSQ 语义 token | 0.0178(跌最狠) |
| w/o Bidir | 去掉 item 内双向注意力 | 0.0279 |
| w/o Aux | 去掉辅助连续语义流 | 0.0191 |
| w/o Pref | 去掉 Trie 前缀约束 | 0.0282 |
| RecGPT | 满配 | 0.0283 |
w/o FSQ 崩得最厉害→统一语义 token 化是跨域泛化的基石;w/o Aux 明显掉→dual-stream 连续特征有效补偿量化损失。
Scaling law(Figure 4 & 5)
- 用 5/10/25/50/100% 训练数据训 5 个变体:零样本性能随数据量单调增强,10%→25% 有一个不成比例的跃升,暗示存在"涌现"数据阈值。
- 评估 loss 对 token 数呈可预测的幂律 scaling(拟合曲线能准确外推满配性能),说明推荐基础模型也遵循 LLM 式 scaling law。实践启示:扩数据比扩模型更划算(后者抬高推理成本)。
对比预训练序列推荐器(Figure 6 & 7)
对比 S³-Rec / UniSRec / VQ-Rec / TIGER / RecFormer / IDGenRec,RecGPT 全面领先。VQ-Rec 次优。RecGPT 优势三来源:(1) decoder-only 架构契合 scaling law、(2) 预训练数据量大得多(1000 万序列 vs UniSRec/VQ-Rec 的 100 万、RecFormer 的 300 万)、(3) 自回归目标更好捕捉序列依赖。受控实验(Figure 7):RecGPT-10%(同等训练数据、缩参)仍胜原版 VQ-Rec,而 VQ-Rec (Re-trained)(用更多数据)反而退化——证明优势来自架构而非单纯数据规模。
局限
- 强依赖 item 文本描述质量:文本缺失/低质的域(纯 ID 场景、隐私受限)无法直接受益。
- FSQ 量化仍有信息损失,靠辅助连续流缓解但未根除。
- 实验以 Hit/NDCG@小 k(1/3/5)为主,缺大 k 召回与多样性/新颖性等维度的评估。
- 工业验证只在一个新闻平台,跨行业工业泛化尚未充分展开。
谱系澄清(DAG 连边决策)
库里已有的 RecGPT-V2 / RecGPT-V3 / RecGPT-Mobile 均来自 阿里 Taobao & Tmall Group 的 LLM 工业推荐器 RecGPT 谱系(V3 用 Qwen3-14B + RQ-VAE SID + Memory Hub;Mobile 把 Qwen3-0.6B 下沉端侧)。本文 RecGPT 是 HKU+Tencent 的学术基础模型(MPNet+FSQ+AR transformer),两者仅同名、无技术传承与版本迭代关系。
按 CLAUDE.md / 精读规范"别硬造边、别过度分析",本次不连 RecGPT → RecGPT-V2/V3 迭代边(那会是虚假谱系)。DAG 仅补全本文 RecGPT stub 节点的元数据(category/paper_title/description)。若日后要区分两个 RecGPT,建议后续给本文节点改名(如 RecGPT-HKU),此处按 stub 已有名称保持不动。