RecGPT-V2 Technical Report 精读¶
Alibaba 淘天集团「RecGPT Team」,2025-12(arXiv:2512.14503)。RecGPT 系列(V1→V2→V3)的第二代:在 V1「LLM 做显式意图推理」的范式上,系统性修补 V1 的四个短板。全篇是一份工业技术报告,落地于淘宝首页「猜你喜欢」并做了两周线上 A/B。
1. 研究动机与背景¶
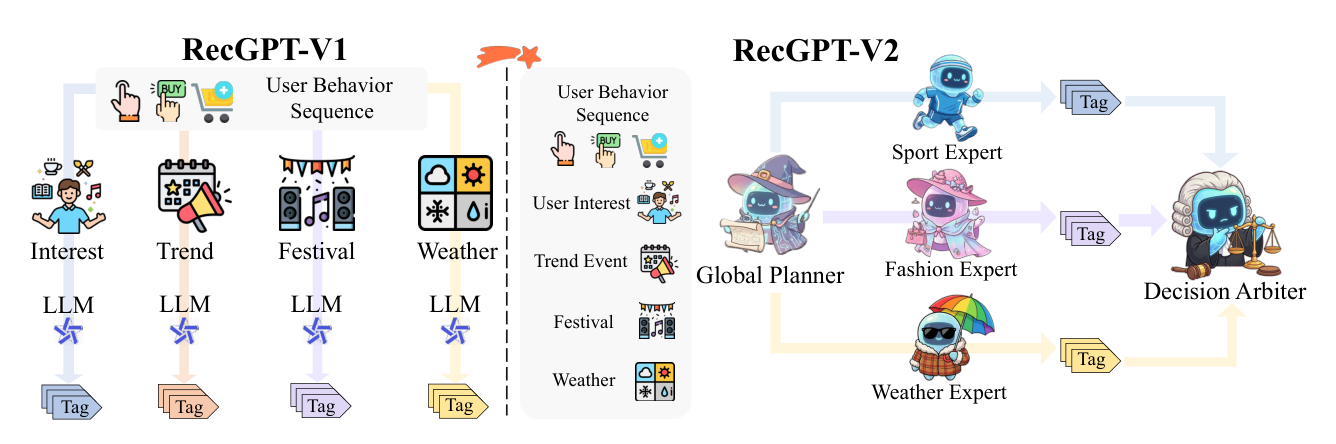
RecGPT-V1(Yi et al., 2025, arXiv:2507.22879)首次把 LLM 的显式推理接进推荐——用户兴趣挖掘 + item tag 预测都由 LLM 生成自然语言 tag 完成,把推荐从「隐式行为模式匹配」推向「显式意图推理」。但 V1 有四个根本瓶颈,V2 逐一对应四项创新:
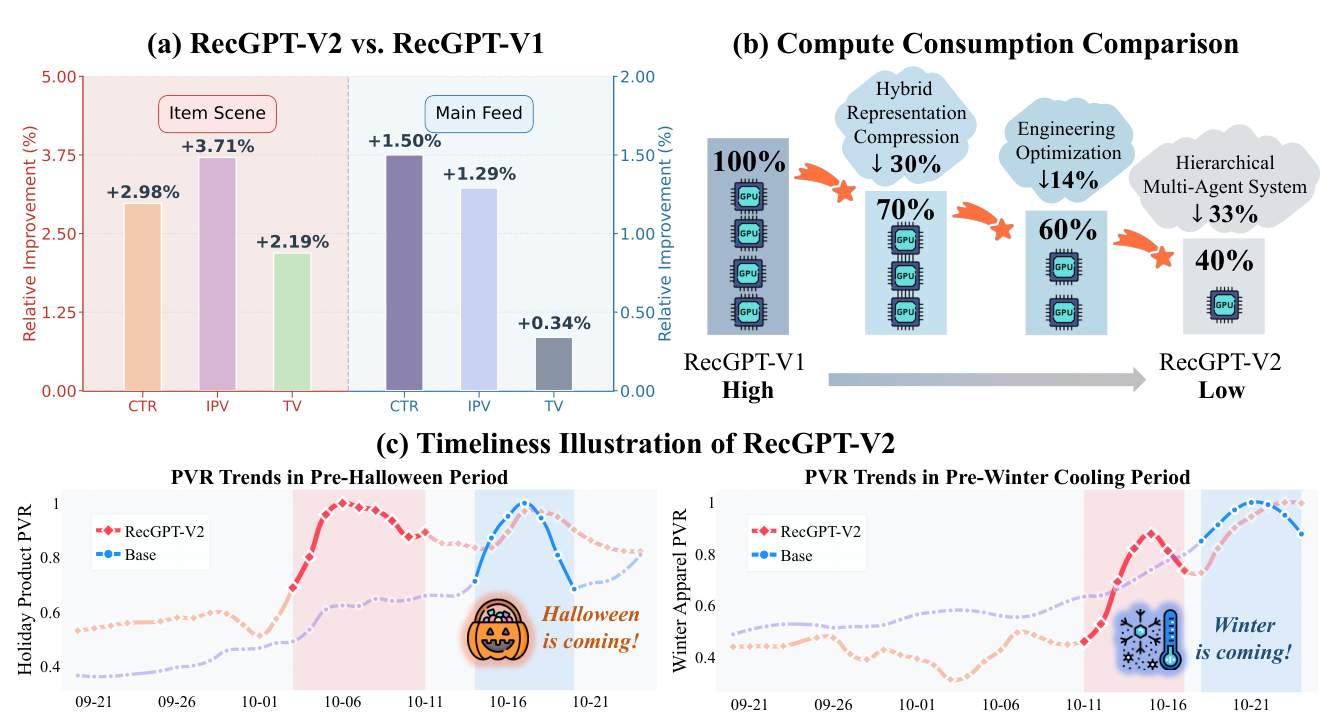
- 算力低效 + 认知冗余:V1 用多条相互隔离的推理路线(multi-route),彼此重复推理、上下文全文编码,成本高 → V2 的 Hierarchical Multi-Agent System (HMAS) + Hybrid Representation Inference,GPU 成本 -60%,exclusive recall 9.39%→10.99%。
- 解释多样性不足:V1 用固定模板生成解释,同质化 → V2 的 Meta-Prompting,解释多样性 +7.3%。
- 监督学习泛化受限:纯 SFT → V2 引入 约束式强化学习(CRS),tag 预测 +24.1%、解释接受率 +13.0%。
- 评估过于结果导向:V1 用一步式 LLM-as-a-Judge,与人类标准对齐差 → V2 的 Agent-as-a-Judge(多维分步推理)+ Judge-as-a-Reward(评估蒸馏成奖励模型)。
线上(淘宝,摘要口径):+2.98% CTR、+3.71% IPV、+2.19% TV、+11.46% NER。
2. 整体架构¶
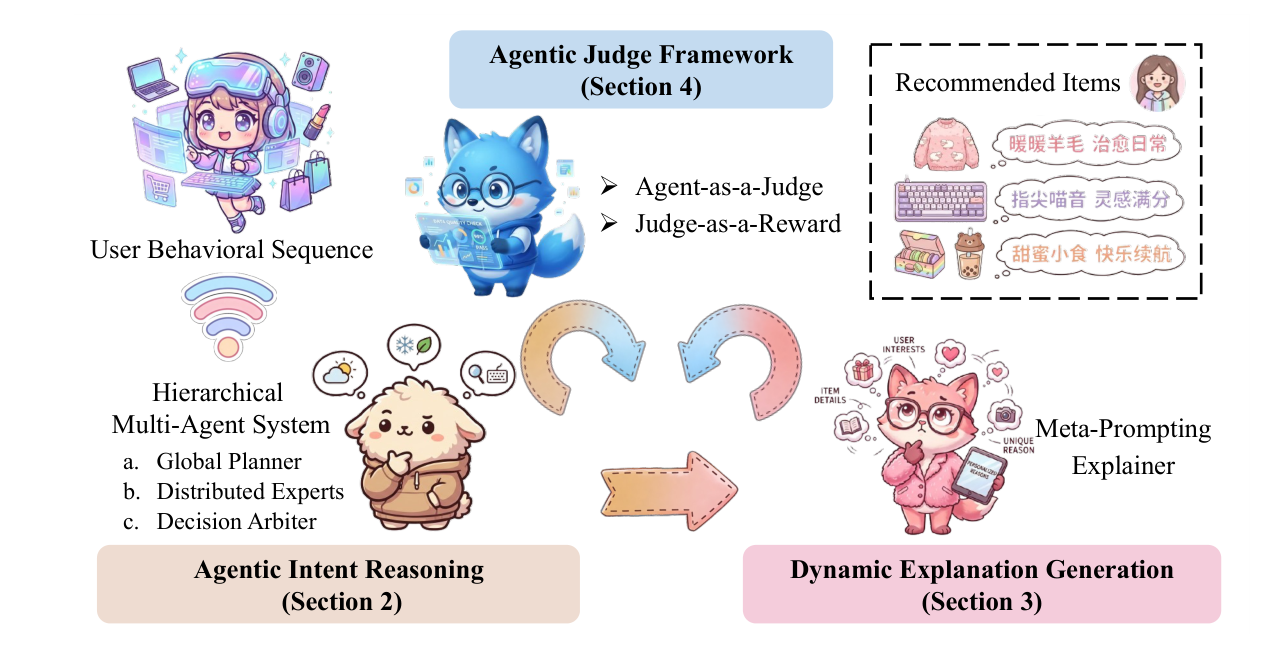
V2 保留 V1 的「LLM 生成意图 tag → tag 检索 item → 解释生成」主链,但把三段全部重构:认知推理换成分层多智能体(§3)、推理表示换成混合表示压缩(§4)、训练与评估换成 CRS + 智能体评审闭环(§5-6)。
3. Hierarchical Multi-Agent System(分层多智能体意图推理)¶
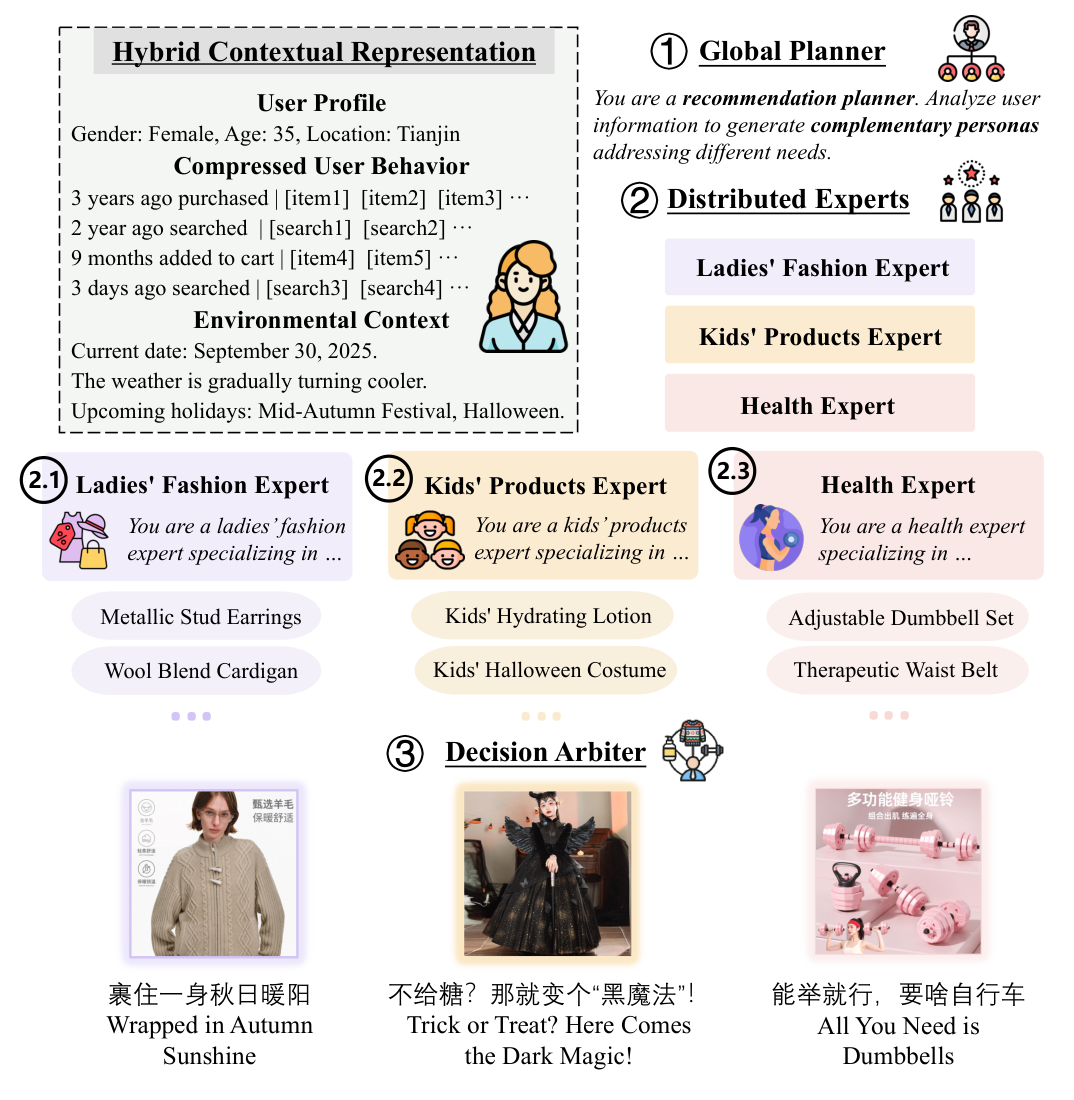
V1 的多路线推理是孤立并行的:每条路线独立走完整推理,彼此不知道对方在算什么,导致覆盖重叠又互相冗余。V2 用一个三层协作结构替代:
- Global Planner(全局规划器):分析用户信息,生成一组互补的 persona(人设),各自负责一类需求,从源头消除认知重复、显式规划覆盖面。
- Distributed Experts(分布式专家):每个 persona 实例化为一个专家 agent,在自己负责的兴趣面内独立做专项推理、生成 tag 集 $\mathcal{T}_k$。
- Decision Arbiter(决策仲裁器):对全部专家的候选池 $\mathcal{T}_{\text{all}}=\bigcup_k \mathcal{T}_k$ 做联合推理(而非逐个打分),基于混合上下文 $\mathcal{C}=\{\mathcal{B},\mathcal{U},\mathcal{E}\}$(行为/用户画像/环境)沿相关性、画像一致性、内容具体性、有效性多维筛出 top-N。联合评估能考虑 tag 间互补、避免冗余:$\mathcal{T}_{\text{final}}=f_{\text{arbiter}}(\mathcal{T}_{\text{all}},\mathcal{C})$。
这种「规划→分工→仲裁」的分层结构把 exclusive recall 从 9.39% 提到 10.99%(覆盖更广且不重复)。
拿到 $\mathcal{T}_{\text{final}}$ 后做在线 item 推荐,两个组件:
- Multi-Interest User Encoding(多兴趣用户编码):沿用 V1 的 user-item-tag 三塔,借 Poly-Encoder(Humeau et al., 2019)引入 $K$ 个可学习 context code,把用户行为聚合成 $K$ 个兴趣向量 $\{\mathbf{u}_1,\ldots,\mathbf{u}_K\}$,各表示一个偏好侧面;线上 tag 经 tag 塔编码后与 item 塔点积打分,实现细粒度多意图匹配。
- Traffic Allocation via Quadratic Programming(二次规划流量分配):在有限曝光预算下平衡「认知/探索通道」与「效用/成交通道」,建成一个 QP(式 13):目标 $\max_{\mathbf{x}}\sum_i x_i s_i-\frac{\lambda}{2}\lVert\mathbf{x}\rVert^2$,约束总成交收益下界 $C$、曝光条数落在 $[\mathcal{Q},\mathcal{P}]$。经 Lagrangian + KKT 得闭式解:复合分 $h_i\triangleq s_i+\alpha(o_i-\bar o)+r$(点击收益 + 高于均值的转化溢价 + 预算压力 $r=\mu-\nu$),$h_i>\lambda$ 全曝、$0\le h_i\le\lambda$ 按 $h_i/\lambda$ 部分曝、$h_i<0$ 剔除。线上为省延迟简化成硬阈值 $x_i^*=\mathbb{1}[h_i>\lambda]$,免去分支定界。
4. Hybrid Representation Inference(混合表示推理,效率核心)¶
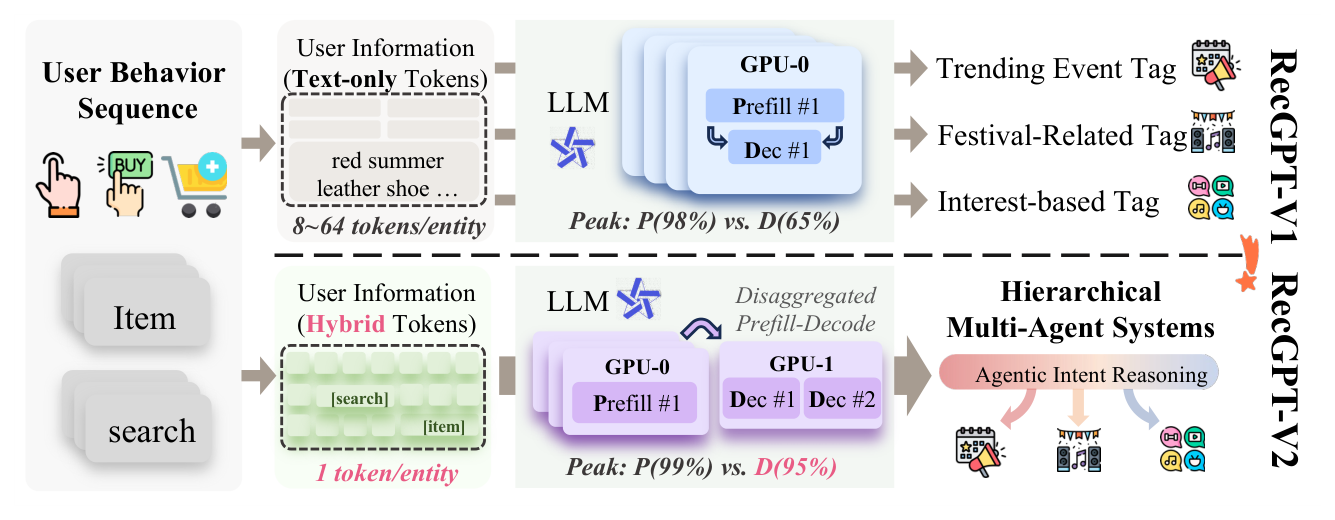
V1 把用户全量行为历史当全文自然语言喂进 LLM,context 极长、prefill 成本爆炸。V2 改用原子化实体压缩(Atomized Entity Compression):把 item 标题等实体用一个冻结的 LLM + 可训练 adaptor 压成紧凑表示,再喂给推理模型。上下文从约 32K token 压到 11K(≈7× 压缩,中文标题上可达 12:1),语义损失可控。
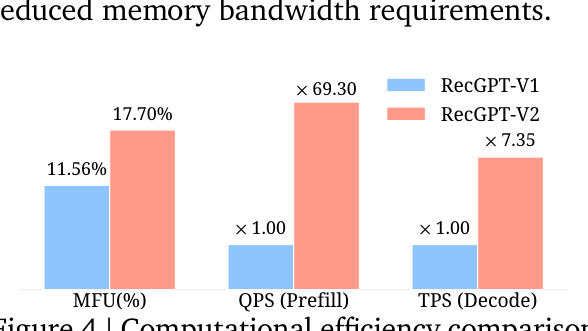
效果:MFU 11.56%→17.04%、GPU 消耗 -60%。服务侧再叠 disaggregated prefill-decode(DistServe, Zhong et al., 2024)分离 + XQA FP8 kernel,prefill QPS ×69.30、decode TPS ×7.35。
5. 约束式强化学习:Constrained Reward Shaping(CRS)¶
tag 预测的训练用 GRPO(式 6-7,带 KL 惩罚防 reward hacking)。多目标奖励含四项互补分量:
- Accuracy $R_{\text{acc}}$:预测 tag 映射到 item 品类后对真实交互品类的召回率。
- Alignment $R_{\text{align}}$:用一个基于 V1 质量准则构造的偏好对训练的奖励模型 $f_{\text{RM}}$,衡量 tag 与 persona 的人类质量对齐。
- Diversity $R_{\text{div}}$:BGE embedding 下 tag 间平均余弦距离,鼓励语义丰富、避免冗余。
- Length $R_{\text{len}}$:分段函数偏好 6–11 词的 tag(过短无信息、过长伤检索多样性)。
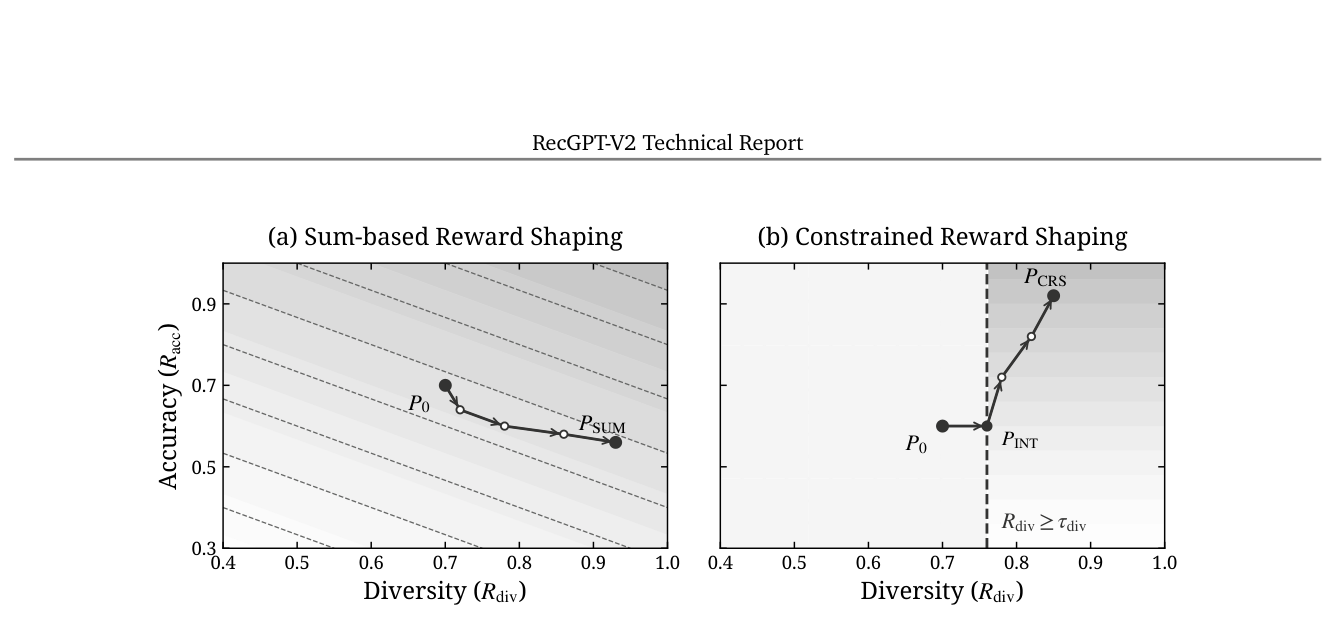
关键 insight:朴素地把四个奖励加和(SUM)会造成严重的多奖励冲突——不同维度的梯度混叠,优化轨迹被简单目标(如 diversity)主导,牺牲更关键的 accuracy(Figure 6a:从 $P_0$ 漂向低精度的 $P_{\text{SUM}}$)。
CRS 的解法:把次要奖励当硬约束(门控)而非加项—— $$R_{\text{total}}=R_{\text{acc}}\cdot\mathbb{1}[R_{\text{align}}\ge\tau_{\text{align}}]\cdot\mathbb{1}[R_{\text{div}}\ge\tau_{\text{div}}]\cdot\mathbb{1}[R_{\text{len}}\ge\tau_{\text{len}}]$$ 只有当所有次要约束都满足时,主 accuracy 奖励才被传播;任一约束违反则总奖励归零。这把「先满足约束、再优化主目标」解耦成两阶段(Figure 6b:先跨过可行边界 $P_0\to P_{\text{INT}}$,再沿主目标 $P_{\text{INT}}\to P_{\text{CRS}}$),避免梯度互相干扰。
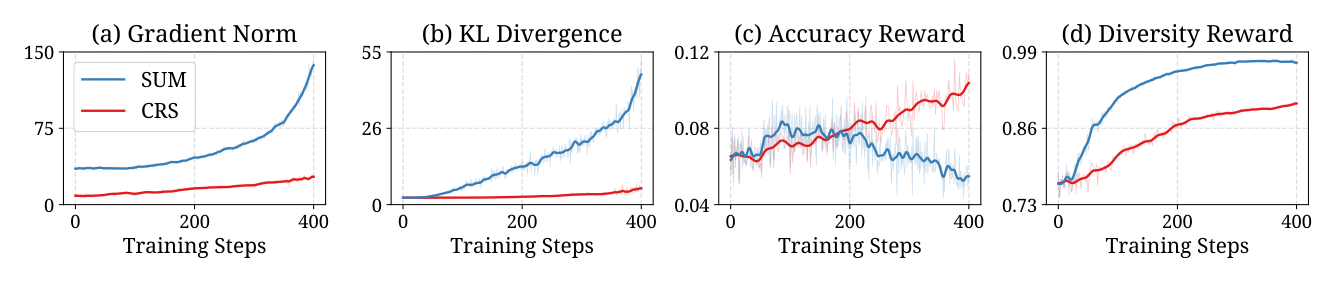
效果(Table 2,均基于 Qwen-14B):HR@30 —— RecGPT-V1 26.29% → V2 Base 23.08% → SFT 29.20% → GRPO(SUM) 27.38%(比 SFT 还退)→ GRPO(CRS) 32.60%(超 SFT +3.40pp、超 V1 +6.31pp)。SUM 反而不如 SFT,坐实了朴素加和的梯度冲突。
6. 动态解释生成:Meta-Prompting + 偏好感知 RL(§3)¶
V1 的解释有三个毛病:信息密度低(重复套话)、时效适配弱(不响应季节/热点)、表达同质。根因是静态模板约束了生成灵活性 + 评估维度不全。V2 两招:
- Meta-Prompting(元提示,两阶段):Stage 1 先由 $g=f_{\text{meta}}(\mathcal{U},\mathcal{I},\mathcal{S})$ 合成一条风格指引(语气、修辞、受众、情感共鸣,融入情境信号 $\mathcal{S}$ 如季节/节日);Stage 2 再 $e=f_{\text{exp}}(g,\mathcal{U},\mathcal{I},\mathcal{S})$ 按该风格生成解释。把生成从「模板实例化」变成「角色扮演式的动态推理」。评估维度从 V1 的 4 维(Relevance/Factuality/Clarity/Safety)扩到 7 维,新增 Timeliness / Informativeness / Attractiveness。
- 偏好感知 RL:同样 GRPO + CRS,奖励换成解释专用的两项——规则式 Diversity(IDF 启发,维护 160 容量的 FIFO 记忆缓冲,对稀有 token 给更高分)+ 模型式 Alignment(listwise 偏好训练的 $f_{\text{RM}}$);CRS 形式 $R_{\text{total}}=R_{\text{align}}\cdot\mathbb{1}[R_{\text{div}}\ge\tau_{\text{div}}]$,以 diversity 为门控。
效果(Table 3):解释 diversity 0.631→0.677(+7.30%)、quality 接受率 36.03%→40.73%(+13.04%)。
7. 智能体评审框架:Agent-as-a-Judge + Judge-as-a-Reward(§4)¶
V1 用端到端 LLM-as-a-Judge 直接出质量分,塌缩了人类评审的多步、分维审议过程,对齐差。V2 两个创新构成一个自增强飞轮:
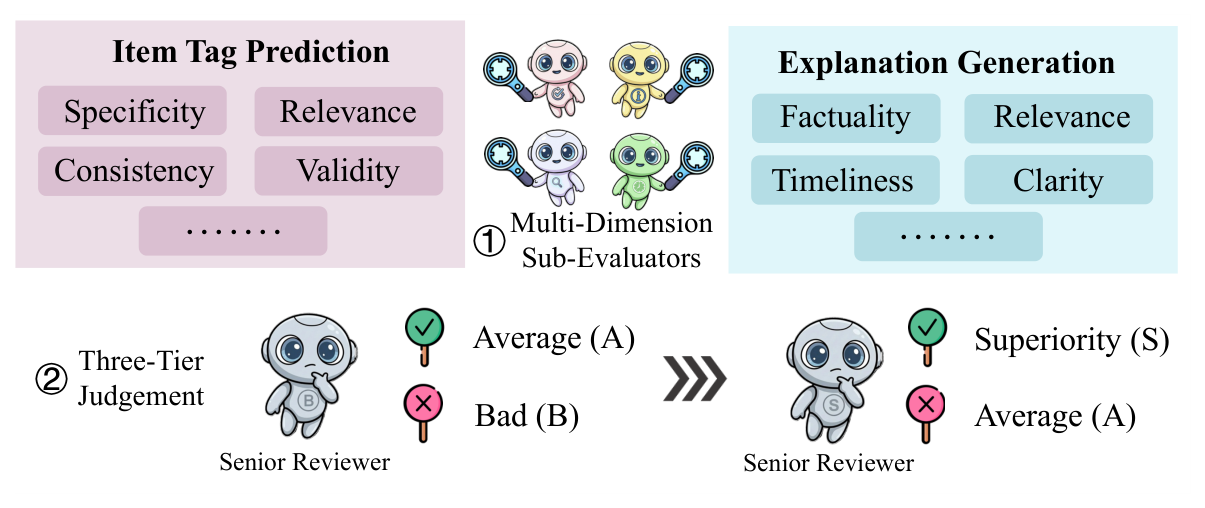
- Agent-as-a-Judge:把复杂质量评估拆成「多维子评审器(每维一个 sub-evaluator $s_i=\mathcal{E}_i(y,d_i)$)→ Senior Reviewer 做三层 S-A-B 判定」。判定两阶段:任一维触发负信号即判 B(Bad);无关键缺陷时再按正反馈比例用阈值 $\tau$ 区分 S(Superior)/A(Average)。评审 agent 用 Qwen3-32B-Instruct 在混合语料(含 DeepSeek-R1/Qwen3-235B 生成样本 + 人工标注)上 SFT。人机一致性(Table 4):item tag 预测三个模型上 accuracy 全面超 V1(+0.10/+0.20/+0.38pp);解释生成 GPT5-mini/Qwen3-SFT 上也占优。
- Judge-as-a-Reward:直接用 Agent-Judge 做 RL 有两难(离散标签粒度不足、多步评估在线开销大)。于是把 agent 评估蒸馏成轻量奖励模型——从 Agent-Judge checkpoint 初始化、换 scalar value head(sigmoid 到 [0,1]);用 listwise learning-to-rank 损失(式 12)保留三层偏好序(S≻A≻B),前缀共享加速训练。
- Flywheel Effect(飞轮):Policy 生成 → Agentic 评估 → Reward 蒸馏 → GRPO 优化 → 更强 policy……闭环自增强,初始人工标注后可自主运行。效果(Table 5):listwise RM vs pointwise RM vs V1 —— HR@30 32.60% / 31.24% / 26.29%,Quality 40.73% / 37.64% / 36.03%;listwise 建模完整偏好序,比 pointwise 提供更具判别力的优化信号。
8. 实验¶
线上 A/B(Table 6):淘宝首页「猜你喜欢」,两周,实验/控制各 1% 全平台流量,控制组 = RecGPT-V1。两场景:
| 场景 | IPV | CTR | TV | GMV | ATC | NER | LT-14 | LT-30 |
|---|---|---|---|---|---|---|---|---|
| Item | +3.64 | +3.01 | +2.11 | +3.39 | +3.47 | +11.46 | – | – |
| Feed | +1.29 | +1.50 | +0.34 | +1.53 | +0.99 | +4.49 | +0.04 | +0.05 |
(% 略)短期参与度全正;长期留存里 NER(新颖曝光率)item 场景 +11.46% 尤为突出,说明多智能体协作 + 环境信号显著缓解了信息茧房;LT-14/LT-30 绝对值小(+0.04/+0.05)但对平台健康是有意义的留存进步。
注:论文内部三处口径不完全一致——摘要 +2.98% CTR/+3.71% IPV,Table 6 item 场景 +3.01% CTR/+3.64% IPV,结论 +4.68% CTR/+3.40% IPV。NER +11.46% 三处一致。以 Table 6 的分场景数据为准。
离线:Table 2(CRS 32.60% HR@30)、Table 3(解释 diversity/quality)、Table 4(Judge 人机一致性)、Table 5(listwise RM 最优)已见上文。全篇无公开学术数据集(Amazon/MovieLens 等)实验,指标均基于淘宝内部数据与线上流量,故不录入公开 benchmark 榜。
Case Study(Figure 9):35 岁女性用户,Global Planner 从「转凉天气 + 中秋/万圣节」情境拆出「女装/母婴/健康」三专家,分别推出羊毛开衫(应对降温)、儿童保湿霜 + 儿童万圣节服(时效适配)、可调哑铃(天气驱动的健身需求),Arbiter 选定三品并配元提示生成的情境化文案——展示 V2 对动态意图 + 情境适配的能力。
核心贡献总结¶
- HMAS:用「全局规划→分布式专家→决策仲裁」三层协作替代 V1 孤立多路线,消认知冗余、扩覆盖(exclusive recall +1.6pp)。
- Hybrid Representation Inference:原子化实体压缩(冻结 LLM + adaptor)把 context 7× 压缩,叠 disaggregated serving + FP8 kernel,GPU -60%、MFU 11.56→17.04%。
- Constrained Reward Shaping:把多目标 RL 的次要奖励当硬约束门控主奖励,解掉朴素加和的梯度冲突(HR@30 SUM 27.38%→CRS 32.60%)——本篇最可迁移的方法论 insight。
- Agentic Judge 飞轮:Agent-as-a-Judge(多维分步 + 三层 S-A-B)+ Judge-as-a-Reward(listwise 蒸馏),把「评估」变成可自增强的稠密奖励来源。
- 落地:淘宝首页两周线上 A/B,Item 场景 CTR +3.01%、NER +11.46%。
与已归档相关工作的对比¶
RecGPT-V3 RecGPT-V3 Technical Report(Alibaba, 2026-07)¶
同系列下一代。V2 的贡献是「HMAS + CRS + Agentic-Judge」把认知推理与训练/评估做扎实;V3 在此之上换更优雅的机制——Memory Hub(结构化行为压缩,替代 V2 的原子化实体压缩,token 降 94.5%)、混合模态基础模型(SID + 文本,V2 仍是纯文本 tag)、Latent Intent Reasoning(把 CoT 压进 ~10 个 latent token,V2 是显式多智能体推理)。效率上 V3 相对 V2 再降 52.4% 算力。可视作:V2 打好「LLM 意图推理 + 约束 RL + 智能体评估」地基,V3 把推理表示从「自然语言/多 agent」推向「latent token + SID」。
RecGPT RecGPT: A Foundation Model for Sequential Recommendation(HKU & Tencent, 2025)¶
同名但不同血统——这是港大 + 腾讯的学术 RecGPT(github.com/HKUDS/RecGPT),DAG 中为 RecGPT-HKU 节点,与 Alibaba 淘宝 RecGPT 系列(V1 2507.22879 → V2 本篇 → V3)无传承关系。共享「RecGPT」之名纯属撞名。二者路线也不同:HKU 版是序列推荐基础模型(item ID 序列建模),Alibaba 版是「LLM 生成自然语言意图 tag → 检索」的工业管线。
RecGPT-Mobile RecGPT-Mobile(Alibaba, 2025)¶
同 Alibaba RecGPT 团队的端侧版本,从云端 RecGPT 蒸馏到设备端。与 V2 的云端方向正交(一个压表示上云、一个下端)。