GenPage: Towards End-to-End Generative Homepage Construction at Netflix¶
研究动机与背景¶
大型语言模型(LLM)确立了一个强有力的范式:单个生成式 Transformer 通过"对一段 prompt 生成 response"就能完成多样化任务。更广义地说,它重塑了人们对机器学习系统的认知——一个足够表达力的模型、端到端地训练,往往能省去大量手工设计的表示与特征工程。
传统推荐系统则一直被搭建为多阶段流水线(candidate generation → ranking → re-ranking),每个阶段各自独立优化 [4, 7]。而"构建一张首页"比排一个列表更复杂:首页的输出不是一个扁平的有序列表,而是一个结构化的多行布局——若干行(row,如"Korean TV Shows"),每一行内又有若干实体(entity,如某部剧 / 电影 / 游戏)。历史上这套结构由许多专门模型拼装而成(例如为行和实体分别建独立模型)。
本文提出 GenPage,把 Netflix 首页构建做成一个端到端的生成式方案。它不再搭建"专门模型 + 大量特征工程"的多阶段流水线,而是训练单个生成式模型去回答一个更简单、更直接的问题:
给定我们对该用户和该次请求所知的一切,应当生成怎样一张首页来最大化用户满意度?
GenPage 把用户与请求上下文当作 prompt,把整张首页当作 response 自回归地生成出来。作者列出了这一转变背后的几点动机:
- 端到端行为(End-to-end):单个 Transformer 直接消费原始输入信号,替代复杂的多阶段推荐栈——减少需要维护的 ML 模型数量,避免各阶段目标错配,消除大量传统特征工程。
- 更好的扩展行为(Better scaling):模型质量随更多数据、算力、模型容量而提升,无需重新设计系统。
- 通过 RL 做整页优化(Whole-page optimization via RL):在页面粒度上操作,使得可以用页面级 reward 做 RL——捕捉跨行、跨实体的交互,例如多样性(diversity),或平衡具有不同 stopping power 的行(stopping power 指一行/一个实体多强地抓住注意力、让用户停止继续下滑)[脚注:例如顶部的 Continue Watching 行 stopping power 很高——用户更倾向续看已开始的内容而非探索新内容;视觉呈现也有影响,大图行往往会减少进一步滚动]。这比生产系统中用的实体级目标(如影片级别)更贴合用户满意度与业务目标。
- 灵活性与可扩展性(Flexibility):prompt-response 范式对新产品特性很灵活,降低了新功能的接入门槛,天然支持整页优化,可以在不做大改架构的前提下支持新内容类型(直播、游戏、播客)、超出当前二维结构的新布局、个性化 UI 组件、乃至每个实体的个性化艺术封面(artwork)。
把 GenPage 带进 Netflix 生产环境还要解决一批工业特有的挑战:首页是实时生成的,用户对服务延迟敏感;需处理不断变化目录中的实体冷启动;需在趋势漂移中保持模型新鲜度;需强制执行复杂业务规则。
尽管有这些挑战,GenPage 已经产生了实质的生产影响:作者在一个成熟、已高度优化的多阶段生产推荐系统上做在线 A/B,验证了 WBC 后训练版本——它在用于上线决策的核心用户互动指标上取得 +0.24% 提升($p < 0.001$),同时把端到端服务延迟降低了 20%。基于 RL 的后训练尚未上线,但被视为实现 GenPage 完整愿景的关键路径。
本文的核心贡献:
- 把"结构化、多行的个性化界面构建"形式化为一个端到端生成式序列建模问题,用单个 Transformer 直接生成整页。这个问题为许多工业级推荐系统所共有(Netflix 首页、Amazon 首页货架、Spotify),它们的输出都是一个结构化的行/模块布局,元素之间会相互作用——例如平衡不同 stopping power 的行与实体、维持整页多样性——必须在产品约束下作为整体优化。这与以往生成式推荐工作 [1, 8, 10, 13, 26, 36, 39, 40] 不同,后者产出的是一个扁平的(排序)物品列表。
- 把 LLM 训练配方迁移过来:在正向互动的生产页面上做预训练学会首页构建的"语言",再通过 WBC(weighted binary classification)或 RL 做后训练,让页面对齐用户满意度。
- 一整套面向工业尺度的技术:为服务效率与产品控制设计的自定义 tokenization;针对实体冷启动的上下文注入 + 语义嵌入融合;为模型新鲜度设计的多节奏增量训练;为业务规则强制执行设计的约束解码(constrained decoding);为推理降延迟降本设计的混合行解码(hybrid row decoding)。
- 一系列离线实验刻画了预训练、模型扩展、上下文丰富度、RL 后训练的作用。两个发现尤为突出:在当前 regime 下,丰富 prompt 带来的收益大于扩大模型容量;RL 后训练会提升首页多样性,即便多样性并非优化目标。
- 在线 A/B 验证 GenPage 在互动与延迟两方面都能胜过多阶段生产栈。
数据表示与 Tokenization¶
从传统推荐模型转向生成式 Transformer,需要在数据表示上做根本性转变。正如 LLM 把文本表示为 token 序列,GenPage 把 Netflix 体验——用户上下文与最终首页——表示为统一的离散 token 序列(Figure 1)。首页本身(整个结构化多行布局)就活在这条 token 序列里,使模型能把页面作为整体生成,而非独立地为各行、各实体打分。
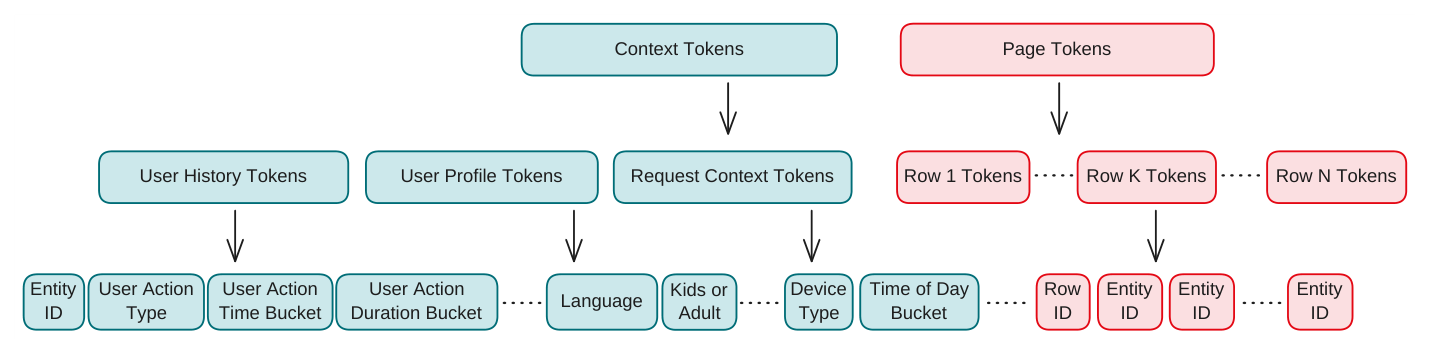
每个训练样本代表一次首页曝光(impression),由三部分组成:
- Context(上下文):用户互动历史、画像属性、请求上下文。
- Page(页面):按布局顺序展示在首页上的行与实体。
- Feedback(反馈):用户对该页面的互动,如播放、点赞(thumbs-up)、或放弃(abandonment)。
只有 Context 与 Page 被 tokenize 成模型的输入与输出;Feedback 用于通过内部 reward 系统(见下节)导出监督信号。
作者没有用现成的文本 tokenizer,而是为首页构建数据构建了领域专用 tokenizer——这在推荐系统 [16] 以及计算机视觉 [27]、生物 [28]、化学 [29] 等专门领域都是被验证过的做法。相比通用文本 tokenization 有两大优势:
- 计算效率:自定义 tokenization 显著缩短序列长度,从而降低推理成本与延迟。例如表示事件"用户 30 天前看了《Orange is the New Black》50 分钟",在 GPT-5 中需要 16 个 token,而本方案压缩到 4 个 token:
[Entity_ID]、[Action_Type]、[Action_Time_Bucket]、[Action_Duration_Bucket]。 - 产品控制:token 与产品概念(行与实体)之间是直接映射,因此很容易控制我们生成什么——这对强制执行业务规则至关重要。
Context Tokens¶
上下文 token 编码用户互动历史、用户画像、请求上下文:
- 用户历史表示为一串 tokenized 的行为 [11, 16, 32]。对每个行为,抽取关键元数据为 token:action type、entity ID、timestamp、duration。既包含显式行为(播放、加入 My List、点赞),也包含隐式信号(看预告片、访问详情页)。
- 用户画像 token 编码语言、画像类型等属性。
- 请求上下文 token 编码 time of day、day of week、device 等信号。
有些数据源太长,无法直接转成原始 token 序列。例如用户的完整曝光历史若全量 tokenize 会代价过高,此时作者 tokenize 一个摘要版本。作者坦承:这部分违背了"在原始输入上操作"的初衷——任何手工摘要都在本应端到端的流水线里重新引入了一种特征工程;如何端到端地学习压缩这些长数据源,是重要的未来方向。为帮助模型区分数据源,在每段数据源开头插入特殊 token;连续信号(时间戳、时长)被分桶(bucketize)成离散区间以保持有限词表。
Page Tokens¶
每个实体(剧/电影/游戏)、每个行(如"Korean TV Shows")都被表示为单个 token。首页按布局顺序 tokenize:从左到右、从上到下。实体与行的词表每天更新以纳入新增实体和行。服务时仍未进入词表的实体,通过语义嵌入融合(§冷启动)与 fallback token 处理。原则上,同一范式可扩展到任何能表示为线性 token 序列的输出:超出当前二维结构的布局(一维 feed 或混合布局)、个性化 UI 组件、每个实体的个性化 artwork——这些留作未来工作。
分页推荐(Paginated Recommendation)¶
为使推荐对会话内偏好敏感,首页往往增量生成,一次几行。在每次分页请求前,把此前已推荐行的 page token 追加到 prompt,连同用户对这些行的最新互动(来自 Netflix 实时事件日志基础设施)。这让模型能同时用用户的长期偏好和最近的会话内互动来生成下一批推荐。
Reward 系统¶
为量化一条推荐的长期价值,GenPage 依赖一个此前工作 [35] 描述的内部 reward 系统。该系统通过在线 A/B 调优,以对齐长期用户满意度,作为监督与强化学习的核心监督信号。
它处理用户反馈,为每个被曝光的实体输出一个标量 reward。例如一部一夜追完的剧反映了更高满意度,其 reward 高于只看了 10 分钟的电影;一个被曝光却被放弃的实体获得负 reward。
页面级 reward 定义为首页上所有被曝光实体 reward 之和:
$$R_{\text{page}} = \sum_{e \in \text{impressed entities}} r_e \tag{1}$$
模型架构¶
为处理表示为 token 序列的数据,作者采用先进 LLM 中标准的 decoder-only Transformer 架构 [25],看重其简洁性、灵活性与成熟生态。
一个关键设计是解绑输入 embedding 与输出投影权重(untied weights)[14, 24]:next-token-prediction 预训练(在词表上做 softmax)与 WBC 后训练(对每个 token 做 sigmoid)所需的最优 logit 尺度差异很大;解绑权重让模型能各自适配两个目标。
在最初几轮在线 A/B 中,作者使用约 200M 参数模型以留在服务延迟预算内。离线扩展趋势(见实验)表明,随着推理优化腾出延迟余量,还能获得进一步的质量提升。
训练配方¶
整条训练流水线复刻 LLM 配方:先通过预训练教模型 Netflix 首页的"语言",再通过后训练让输出对齐用户满意度。后训练有两条备选路径——WBC 与 RL:WBC 更易优化,且直接对齐生产排序模型的实体级目标;RL 更难评估与优化,但被视为实现 GenPage"页面级优化"完整愿景的关键路径(并具备接入 test-time reasoning 与多 token 实体表示的灵活性)。
预训练:Next-Token Prediction¶
用标准 next-token-prediction 目标预训练:给定 context token 与 page token 前缀,模型学习预测下一个 page token。这一阶段聚焦表示学习,教模型学会"用户上下文 ↔ 成功首页"之间的关系。作者指出,(context, page) 数据更像 LLM 有监督微调(SFT)里的 prompt-response 对,而非 LLM 预训练里的原始文本;但仍称此阶段为预训练,因为它是从零训练而非从已有 checkpoint 微调。
与 LLM 常面临高质量标注稀缺不同,这里有海量用户反馈数据。预训练用的是服务时收到正向反馈的首页曝光,把模型 bootstrap 到能生成与生产系统相似的页面。
然而,预训练在很大程度上只是模仿现有生产模型;而在没有外部反馈的情况下递归地在自生成数据上训练,会有模型退化(degeneration)的风险 [31];此外预训练并不直接优化 reward 的幅度。为解决这些局限,作者引入两条后训练路径。
后训练一:加权二分类(WBC)¶
WBC 是把生成式模型对齐到细粒度用户满意度的一条有效路径。高层想法:WBC 训练模型去预测生成下一个实体或行的即时价值(immediate value),同时仍以自回归方式解码整页。相比页面级 RL,这个实体级目标更易优化:它把页面分解成逐 token 的目标,WBC 在构造上就把 credit 分配到了 token 级,而不需要 RL 去学习这种分配。
具体地,模型逐 token 预测该价值,条件是用户上下文与此前已生成的 token,而非学习一个显式的生成策略。这种实体级训练由自定义 tokenization(每个实体/行是单 token)赋能——每 token 的模型输出与每实体(或每行)的 reward 一一对应。
回顾:每个训练样本是一次首页曝光。对页面上每个被曝光实体,reward 系统给出一个基于用户反馈的标量 reward;对每个被曝光的行,把行内实体的 reward 聚合得到行级 reward。从每个 reward 中:由符号导出二分类标签(播放 vs 放弃),由幅度导出权重(追剧比短播权重更高)。然后在对应 token 的 logit 上优化加权二元交叉熵:
$$\mathcal{L}_{\text{WBC}} = -\sum_{t} w_t \left[ y_t \log \sigma(z_t) + (1 - y_t)\log\big(1 - \sigma(z_t)\big) \right] \tag{2}$$
其中 $z_t$ 是目标 token 的 logit,$\sigma$ 为 sigmoid,$y_t \in \{0,1\}$ 为符号标签,$w_t$ 为幅度权重。在这套设置里,一个 token 的 logit 可被解读为模型对"在该位置生成该 token"的价值估计。
此外,对每个被曝光的实体与行目标,还采样随机 token 作为负目标。因为很少被曝光的 token 作为随机负样本出现的频率远高于它们作为正样本出现的频率,这向学到的价值中注入了一种温和的悲观(pessimism)[19, 33]——本质是一个流行度先验——防止模型自信地把高分给那些高分主要来自噪声的小众实体。
尽管作为价值模型训练,模型仍能自回归生成页面:每步计算所有候选 token 的价值(logit),贪心选取最大者,追加到前缀,逐 token 生成整页。
在生产排序模型的标准 held-out 评测集上,WBC 训练的生成式模型在 weighted AUC 等关键实体级指标上超过了生产排序器。这表明端到端生成式表述在标准实体级离线指标上能匹配甚至超过多阶段生产栈。
后训练二:强化学习(RL)¶
RL 是作者正在积极探索的后训练方向。WBC 虽能有效优化实体级指标,却无法把首页作为整体考虑。把页面生成视作序贯决策过程,RL 使整页优化成为可能,并具备如下灵活性:
- 整页优化:RL 直接优化聚合的页面级 reward,考虑跨行/跨实体的交互(多样性、平衡不同 stopping power 的行与实体)以及页面级业务约束。
- Test-time reasoning:类比 LLM,RL 可为生成式推荐优化推理能力 [21, 38];推理输出也可看作一种自动化特征工程。
- 多 token 实体支持:在自定义 tokenization 下,每个实体/行是单 token,per-entity reward 直接落到那一个 token,credit 分配立即可得。但在复杂目录中,单个实体可能由多个 token 表示(如
[Show_ID] + [Episode_#]表示某剧集,或多 token 的 semantic ID [26])。这时如何把单个实体级 reward 分摊到各构成 token 并不清楚,WBC 的逐 token 打标会失效。RL 优化的是序列级回报,因此天然处理变长、多 token 实体。
三者中本文只探索了整页优化;test-time reasoning 与多 token 实体支持是未来方向。
RL 具体做法:受 LLM 对齐的 RLHF [5, 23] 配方启发,采用两步法——先训练一个 reward model 从一个生成的页面预测其页面级结果 reward。注意这个 reward model 与 §Reward 系统里的 reward 系统不同:reward 系统把已展示页面上观察到的用户反馈转成标量 reward;而 reward model 预测一个生成页面在展示给用户前的页面级 reward。正是这个"预测"能力让 RL 能在训练中对任意候选页面做优化。相比在 logged/预测倾向性上做 off-policy 修正的高方差路线 [3],对着 reward model 训练回避了高方差,但引入了 reward hacking 风险。由于 reward model 训练于生产策略产生的数据,它在与生产策略相似的页面上最可靠。因此作者用 KL 惩罚把策略拉近预训练 checkpoint(后者本身被训练来模仿生产策略),把生成页面留在 reward model 的覆盖区内、限制 reward hacking 的机会。
可将 RL 目标概括为(对本文文字描述的形式化):
$$\max_{\theta}\ \mathbb{E}_{c \sim \mathcal{D},\, p \sim \pi_\theta(\cdot \mid c)}\big[\, R_\phi(p) \,\big] \;-\; \beta\, \mathrm{KL}\!\left(\pi_\theta \,\|\, \pi_{\text{ref}}\right) \tag{3}$$
其中 $c$ 为 context prompt,$p$ 为生成页面,$R_\phi$ 为 reward model,$\pi_{\text{ref}}$ 为参考模型(锚定 KL 惩罚),$\beta$ 为 KL 系数。
RL 算法采用 Dr. GRPO [22](GRPO [9] 的一个变体,缓解训练目标中的偏差);训练流水线基于 verl RL 库 [30],以 vLLM [20] 作推理引擎。需要以下组件:
- Prompts:生产用户请求,表示为 context token。
- Policy 与 reference 模型:均由预训练 checkpoint 初始化;reference 模型锚定上述 KL 惩罚。
- Reward model:一个专用的、基于 Transformer 的 reward model,同样由预训练 checkpoint 初始化,预测页面级结果 reward,以内部 reward 系统的实体级 reward 之和作为监督目标。此外还加入基于规则的 format reward 引导 RL 策略,例如"页面应形似一列行"、"业务关键的行/实体不应出现得太靠下"。
开放挑战:与 LLM RLHF 依赖稀缺的、人工标注的、对无结构文本回复的成对偏好比较不同,GenPage 的场景在实体与行级别有直接用户反馈。这更丰富的结构化信号带来两个挑战:
- 离线评估:当前页面级评估依赖的 reward model 正是策略在优化的对象,因而在很大程度上是自指的(self-referential);人工标注(LLM 评估里常见的替代)也有问题,因为每个用户的偏好取决于第三方标注者无法复制的个人上下文。候选方向包括:专用的 held-out reward model、基于规则的评估、反事实估计器 [2, 15, 34]。
- 分解 vs 联合建模:WBC 与页面级 RL 处于两个极端。WBC 把页面完全分解为实体级优化(简化了优化,但丢失了跨行/跨实体的交互);页面级 RL 联合优化整页、不做结构分解(捕捉所有交互,但更难优化、样本效率更低)。利用部分结构的中间地带——混合目标、结构化策略参数化、或引入用户行为模型(点击模型 [6] 或选择模型 [37])的假设——很有前景。
应对生产挑战¶
冷启动(Cold Start)¶
新实体缺乏学习稳健 token embedding 所需的丰富互动数据。作者用两个互补策略应对:
- 上下文注入(Context injection):把新实体或时效性实体(如 Live Now 事件)的元数据直接注入 context token,为模型提供语义与时效信息。
- 语义嵌入融合(Semantic embedding fusion):不再只依赖从用户互动数据学到的 entity ID embedding,而是把每个实体表示为其 ID embedding 与内容 embedding 的融合——内容 embedding 来自 synopsis、cast、transcript、genre、视频内容等语义信息。这个融合 embedding 作为该实体 token 在 Transformer 里的输入 embedding。训练时以小概率把 entity ID token 随机替换为通用 fallback token(见下),使模型学会仅凭内容 embedding 也能做推荐。这确保新实体一旦有内容元数据,就在与已有实体相同的隐空间里有了有意义的表示——即便它还没有任何互动数据。
多节奏增量训练(Multi-Cadence Incremental Training)¶
在 Netflix 尺度上,每天从零重训一个大 Transformer 代价过高,但推荐模型又必须保持新鲜以捕捉趋势漂移与新目录。作者用多节奏增量训练应对(Figure 2)。
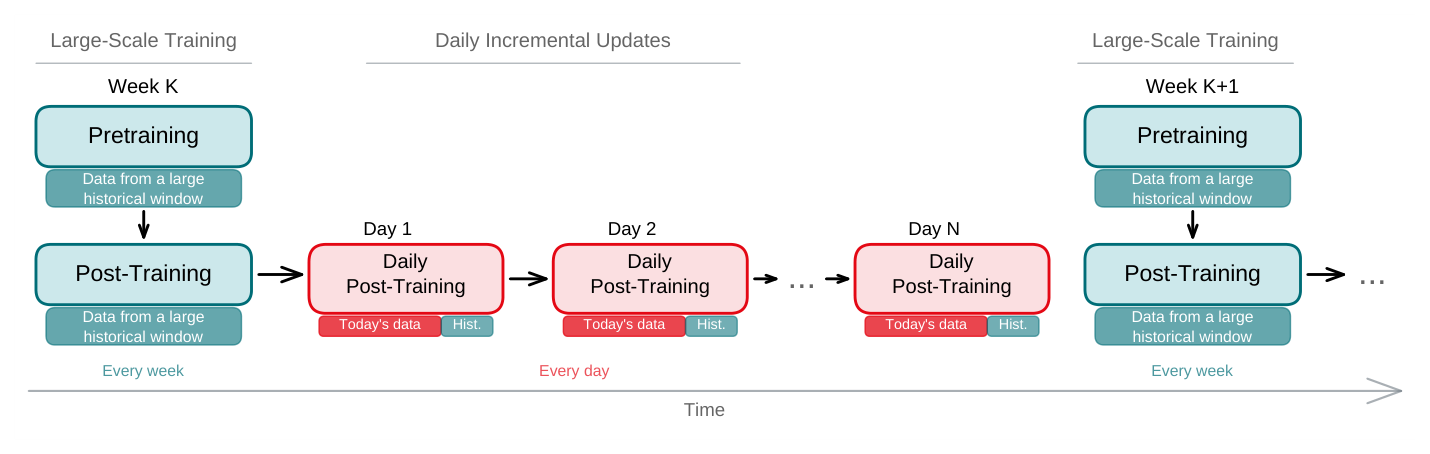
训练流水线以两种不同节奏的循环调度运行:在一个可调节奏(如每周)上,做一次基于宽历史窗口的大规模预训练 + 后训练;两次之间的每天,从前一天的 checkpoint 继续后训练做增量更新,用当天最新数据与过去数据采样子集的混合。这帮助模型跟上新趋势与目录变化,同时防止过拟合与灾难性遗忘 [18]。
为管理每天涌入的新 token(新实体、新行),采用 fallback token:新 token 用其类型的 fallback token 初始化(如新行用 [Row_Fallback_Token],新实体用 [Entity_Fallback_Token])。训练时随机把小比例已知 token 替换为 fallback token,教模型优雅地处理未知 token。
强制执行业务规则(约束解码)¶
Netflix 首页必须满足结构约束(组织成一列行)以及产品逻辑(去重、行钉住 pinning、类目一致——如 Comedy 行里的实体必须是喜剧)。训练信号可以鼓励规则遵从,但无法保证严格合规。
作者在推理时通过约束解码强制这些规则:在每个自回归生成步,基于适用业务规则计算一个合法 token 掩码,作用到输出 logit 上,只允许合规 token 被生成。自定义 tokenization 极大简化了这一点——因为每个实体/行是单 token,业务规则直接映射为 token 级掩码,避免了文本词表上约束解码所需的多 token 簿记。例如要把某个特定行(Popular Games)钉在固定位置(第 2 行),只需在该位置把所有其他 token 掩掉。
混合行解码(Hybrid Row Decoding)¶
自回归生成确保每个新 token 都以完整前文为条件,但一次一个地生成每个实体 token 代价高昂。作者利用首页结构在推理效率与"每个生成 token 可用的上下文信息"之间做权衡。
每行的前几个实体尤为重要:它们获得最多用户注意力,强烈塑造该行的感知质量与主题。为降低推理延迟,采用混合行解码:模型只自回归生成每行的前几个实体;条件于这段生成前缀,在一次前向里获得所有合法剩余实体的 logit,选出得分最高的剩余实体(同样受上述推理时业务规则约束)。这在最要紧处保留了自回归条件化,同时避免了逐 token 解码长行的延迟与成本。
离线实验¶
没有公开数据集能刻画"带行级/实体级用户互动的结构化首页构建",因此所有评估都用 Netflix 内部数据。因为系统是迭代开发的,各消融跨越不同训练配置与数据快照,作者只报告每项研究内部的相对比较。除非另有说明,实验用约 200M 参数模型、在 held-out 集上报告。
预训练有帮助吗?¶
作者比较 WBC 后训练有/无前置 NTP 预训练。Table 1 显示预训练在所有指标上带来实质改进。
Table 1: WBC 后训练性能(有/无预训练)。Loss 是加权二元交叉熵;Row/Entity AUC 是在行/实体目标上的样本加权 ROC-AUC。
| Metric | With Pretraining | Without Pretraining |
|---|---|---|
| Loss | 0.321 | 0.333 |
| Row AUC | 0.884 | 0.879 |
| Entity AUC | 0.920 | 0.910 |
结论分析:绝对数值看似小,但在生产 regime 里意义很大。作者举例:撇开样本加权,Entity AUC 从 0.91 提到 0.92,意味着对随机抽取的一对被曝光实体,模型的误排率从 9% 降到 8%——这种量级的提升在成熟生产系统上很少能靠单一改动获得。在 Netflix 首页的"语言"上做预训练,为后训练提供了强初始化,正呼应现代 LLM 的"预训练 → 后训练"配方。
性能如何随模型规模扩展?¶
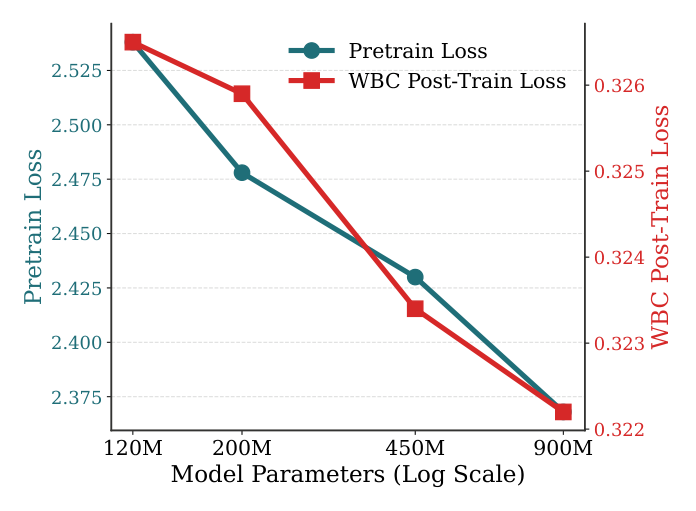
作者把模型从约 120M 扫到约 900M 参数(Figure 3),报告预训练的 NTP loss 与后训练的 WBC loss。两者都以幂律样式下降,与 LLM 的扩展趋势 [12, 17] 一致。这确认生成式方案随模型规模良好扩展,推荐质量可通过扩容进一步提升。
性能如何随用户上下文中的信息扩展?¶
在开发过程中,作者逐步丰富 prompt——既加入新数据源,也改进每个源的 tokenize 方式。固定模型规模,Figure 4 显示随着上下文变丰富,WBC 后训练 loss 大幅下降。
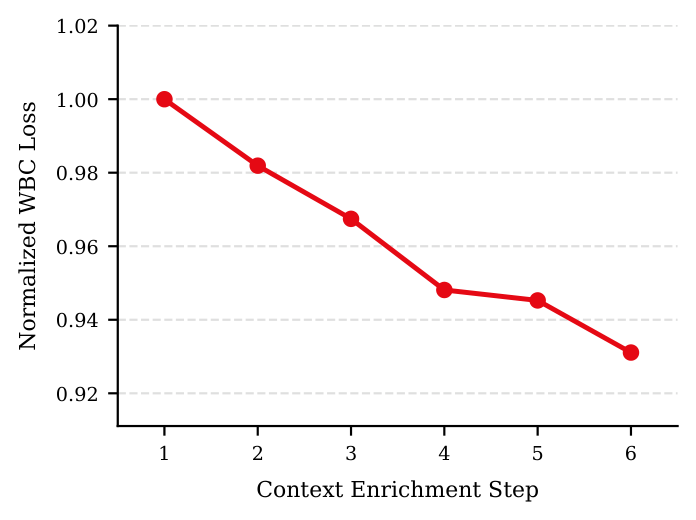
关键发现(本文两大发现之一):模型规模扫描与上下文丰富扫描沿不同轴、不严格可比——前者覆盖约一个数量级的参数,后者跨越整个 prompt 设计轨迹。即便如此,二者差距仍很惊人:把模型从 120M 扩到 900M 只降低 WBC loss 约 1.3%,而丰富上下文的累计效应约 6.9%。在若干情形下,单个精心设计的上下文增补带来的提升,超过了整个约 7.5× 的模型容量扩展。
这表明在当前 regime 下,丰富 prompt(放什么进上下文、如何 tokenize)带来的提升,实质上大于扩大模型容量。个性化质量似乎首先被"模型可用的信息与表示"所瓶颈,其次才是容量。作者预期上下文丰富将主导,直到上下文饱和,届时模型容量才成为主要驱动。
RL 后训练是否在页面级优化?¶
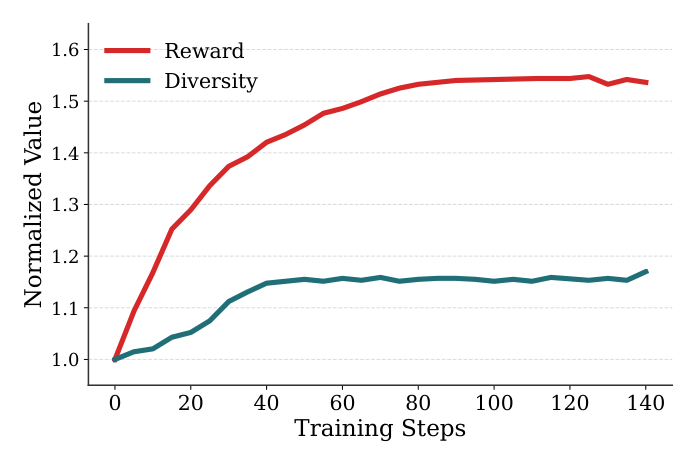
在离线评估中(Figure 5),RL 后训练一致地把页面级 reward 提升到预训练 checkpoint 之上,但这在很大程度上是确证性的——因为 reward 正是策略在对着优化的同一个模型算出来的。更有意思的是,尽管多样性不在 RL 目标里,首页多样性(用页面上实体间的成对 embedding 距离度量)也在训练过程中上升。这表明 RL 训练的策略是在把页面作为整体优化,而非短视地孤立优化每个 token。
在线评估¶
作者用约 200M 参数的 WBC 模型,对当前生产首页推荐器做在线 A/B。测试中,GenPage 在已有生产的行与实体候选集上解码(这有助于处理许多业务规则,如资格 eligibility)。只在线评估了 WBC 版本;把 RL 训练扩到数据量、精炼 reward model、加强离线评估都在进行中,计划在后续 A/B 中评估 RL 后训练。
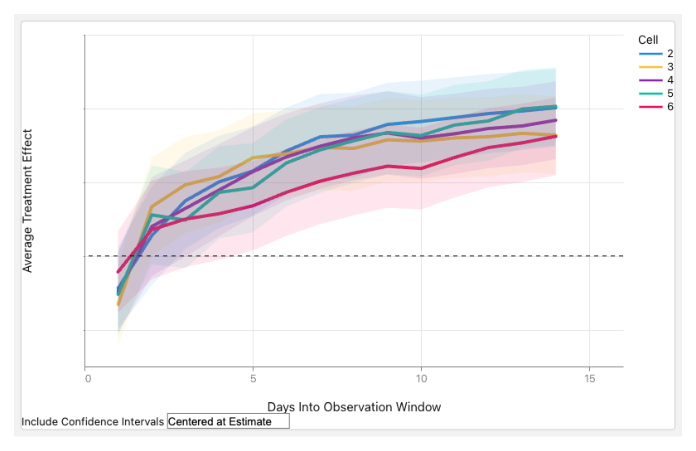
Figure 6 结果:五个变体全部在核心互动指标上取得统计显著提升($p < 0.001$),对手是一个成熟、已高度优化的多阶段生产 baseline。最佳变体取得 +0.24%(95% CI $[0.17\%, 0.30\%]$)。这些变体探索了不同的随机负样本量(见 WBC)与不同的"哪些生产曝光纳入训练"的过滤;五者提升相当,说明收益对这些设计选择是稳健的,而非依赖某个特定配置。
几个值得注意的观察:
- 意外的分布偏移:伴随互动提升,作者观察到被曝光实体类目分布的非预期偏移(新片 vs 老片、剧集 vs 电影)。这些偏移不一定是负面的,但并非显式优化目标,值得深究。作者怀疑这些偏移反映 GenPage 比生产栈个性化更精准——这与"首页曝光效率提升"(用户用更少曝光就参与到看到的内容)一致。这种更锐利的个性化似乎暴露了生产继承的组件(如 reward 系统)尚未对齐新生成式范式。计划刻画这些偏移的驱动因素并调优相关组件。
- 对会话内信号的强响应:最新的会话内行为很快影响后续推荐,并在一两天后淡回长期偏好,确认模型有效地关注了行为时间戳。这种响应性从生成式表述中自然涌现,无需生产栈里那种大量手工特征工程。
- 延迟不升反降:与"生成式模型更慢"的常见假设相反,GenPage 把端到端服务延迟降低了 20%。通过用单个 Transformer(在原始 tokenized 输入上操作)替代多个排序阶段与繁重特征计算,消除了大量服务复杂度与算力开销;自定义 tokenization 与混合行解码进一步减少解码步数、降低延迟。20% 的降低是在尚未穷尽可用优化的情况下达成的,还有进一步空间;这份余量可再投入到扩容或更丰富的 prompt。
核心贡献总结¶
- 范式:首次把"结构化多行首页构建"形式化为端到端生成式序列建模,用单个 decoder-only Transformer 把用户/请求上下文当 prompt、把整张首页当 response 自回归生成,塌缩掉传统多阶段推荐栈。
- 训练配方:迁移 LLM 的"预训练(NTP)→ 后训练",并给出两条后训练路线——WBC(实体级、易优化、已上线)与 RL(页面级、Dr. GRPO + reward model + KL 惩罚、面向整页优化的完整愿景)。
- 工业技术栈:自定义单 token tokenization(服务效率 + 产品控制)、上下文注入 + 语义嵌入融合(冷启动)、多节奏增量训练(新鲜度)、约束解码(业务规则)、混合行解码(推理效率)。
- 可迁移洞见:当前 regime 下丰富 prompt > 扩大模型容量(约 6.9% vs 1.3%);RL 会提升首页多样性即使多样性不在目标里。
- 生产验证:对成熟多阶段生产系统,核心互动指标 +0.24%($p<0.001$)且延迟 −20%。
与已归档相关工作的对比¶
GenRec GenRec: A Preference-Oriented Generative Framework(JD.com, 2026-04-16)¶
关系:独立并发(本文未引用 GenRec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在解决同一个结构性 root cause——把生成式推荐真正落到工业首页场景时,"逐 item / point-wise 建模"丢失了页面结构,且 SFT 只是模仿日志、不直接优化用户满意度,而朴素上 RL 又极易 reward hacking。两者都在"十亿级用户首页 + 严苛延迟 + 月/两周级在线 A/B"的真实生产约束下工作。
- 相近的技术骨架:技术流程图高度可抽象重合——(1) 页面级/整页 NTP 预训练(GenPage 的 page-token NTP ↔ GenRec 的 Page-Wise NTP,把监督粒度从单 item 抬到一整页);(2) GRPO 系 RL 后训练(GenPage 用 Dr. GRPO,GenRec 用 GRPO-SR);(3) 显式的 reward-hacking 抑制(GenPage 用 KL 惩罚把策略锚在"模仿生产策略的预训练 checkpoint"上 + 只信任 reward model 覆盖区;GenRec 用 gate 过滤 + NLL 正则把策略锚在"真实用户行为分布"上)。两者都是 decoder-only。
- 本文的差异与推进:
- 输出结构:GenPage 生成的是结构化二维多行页面(row + entity 双层,含 layout order),并把 whole-page RL 用于捕捉跨行/跨实体交互(diversity、stopping power 平衡);GenRec 面向的是 JD 首页 feed(一维有序列表),其"page-wise"指"一整页 K 个 item 的有序序列",不含二维行结构。GenPage 明确把自己与"产出扁平列表"的生成式推荐区分开,而 GenRec 恰属后者。
- 实体表示:GenPage 用单 token 表示实体/行,使约束解码(业务规则→token 掩码)与 per-entity reward 的 credit 分配都变得直接;GenRec 用 3 码 semantic ID(RQ K-means)+ Token Merger 压缩 prompt。有意思的是,GenPage 在讨论"多 token semantic ID 会让 WBC 的逐 token 打标失效"时,指的正是 GenRec 所处的多码 SID 世界——GenRec 用 GRPO 的序列级回报绕过了这个 credit 分配难题,而 GenPage 则用"单 token + WBC"从根上回避它。
- 后训练选择:GenPage 独有 WBC(判别式、实体级)作为 RL 之外更易优化、已上线的路线;GenRec 只有 GRPO-SR。
- 可比的方法差异(reward hacking 锚点):GenRec 明确论证"NLL 正则锚定真实用户行为分布比 KL 锚定 reference model 约束更硬(因为 reference 本身可能带偏)";GenPage 用的恰是被 GenRec 认为更弱的 KL-to-reference 路线——这是一处直接可对话的设计张力。
- 训练-推理对称性:GenRec 刻意做训练 list-wise、推理 point-wise beam search的非对称设计;GenPage 训练与推理都是自回归生成整页,并用 hybrid row decoding 压延迟。
OneRec-V2 OneRec-V2(Kuaishou, 2025-08-28)¶
关系:显式引用(本文引用 [40] OneRec-V2,但仅列于生成式推荐引文串 [1,8,10,13,26,36,39,40] 中,未展开方法/指标对比)· 已加载对方精读
- 共同关注的问题:两者都主张用单个生成式 Transformer 端到端替代多阶段级联推荐栈,并都以用户真实反馈驱动 RL 后训练来对齐满意度(OneRec-V2 的 reward 用真实反馈信号做 GBPO;GenPage 用内部 reward 系统 + reward model)。
- 相近的技术骨架:都走"生成式 NTP + RL 后训练"的 LLM 化配方;都在真实工业推荐系统上大规模部署 + 在线 A/B;都关注扩展性(GenPage 报告 120M–900M 幂律、OneRec-V2 主打把算力集中到 target decoding 的高效扩展)。
- 本文的差异与推进:
- 输出对象:OneRec 系列生成的是短视频信息流的 item 会话/列表(一维序列);GenPage 生成的是结构化多行首页布局,并显式把"整页联合优化"(跨行/跨实体交互、diversity、stopping power)作为核心动机——这是一维 list 生成不涉及的维度。
- 架构与实体表示:OneRec-V2 用 Lazy Decoder-Only + 3 码 semantic ID + Lazy Cross-Attention/KV-sharing/MoE,把 97%+ 花在 context encoding 上的算力重新集中到 target decoding;GenPage 用标准 decoder-only + 单 token 实体/行,靠自定义 tokenization 与 hybrid row decoding 控制序列长度与延迟。
- 后训练手段:OneRec-V2 用 GBPO(面向真实反馈、已上线);GenPage 提供 WBC(已上线)+ Dr. GRPO(研发中) 两条路,并把 WBC 作为"更易优化的实体级替代"。
- 约束与冷启动:GenPage 额外把约束解码(业务规则强制)+ 语义嵌入融合冷启动 + 多节奏增量训练作为一等工程问题成体系地处理,这在 OneRec-V2 里不是核心焦点。
讨论与局限性¶
核心贡献与值得借鉴之处。GenPage 最大的价值在于把 LLM 的"单模型端到端 + prompt→response"范式干净地映射到结构化整页推荐这个此前被多阶段流水线主导的问题上,并给出一整套让它在 Netflix 尺度跑起来的工程解法。几处设计尤其值得借鉴:(1) 单 token 化实体/行——一个看似朴素的表示选择,却同时解锁了 constrained decoding(业务规则→token 掩码)、per-entity WBC 的一一对应 credit 分配、以及短序列带来的低延迟,是全文的"真源"级设计;(2) WBC 作为 RL 的判别式替身——在页面级 RL 难优化、难评估时,用"逐 token 价值估计 + 随机负样本悲观先验"提供了一条已能上线、且在实体级指标上就超过生产排序器的稳健路径;(3) "丰富 prompt > 扩容"的实证——对当前工业推荐"该往哪投资源"给出了明确、可迁移的方向判断。
局限与争议。(1) 离线评估的自指性:RL 的页面级评估依赖策略正在优化的同一 reward model,作者自己承认这"largely confirmatory";diversity 上升虽有意思,但也是在同一评估框架下测得,说服力受限。(2) 尚未真正端到端:长数据源仍靠手工摘要 tokenize,作者坦承这在端到端管线里重新引入了特征工程。(3) RL 未上线:全文的生产收益全部来自 WBC 版本,页面级 RL 的完整愿景(whole-page 优化、test-time reasoning、多 token 实体)尚是"进行中"。(4) 实验严谨度:受"迭代开发、跨数据快照"所限,所有离线结果都是内部相对比较,没有公开 benchmark、也没有与具名 baseline 的头对头对比,外部可复现性弱。(5) 意外的类目分布偏移说明当前 reward 系统与新生成式范式尚未完全对齐,长期效应有待观察。
与已有工作的差异。相比 OneRec/OneRec-V2、GenRec、HSTU [39]、PLUM [8]、PinRec [10]、RankGPT [13] 等"产出扁平物品列表"的生成式推荐,GenPage 的独特定位是生成一张结构化、可施加产品约束、需整页联合优化的二维页面,并把 whole-page RL、约束解码、per-entity WBC 这些"页面结构原生"的机制作为一等公民。它更像是一篇范式确立 + 首次生产部署报告,思想密度与工业落地价值高,但严格实验深度略逊于同范式里 OneRec-V2、GenRec 这类以具体方法创新 + 消融见长的工作。
工业落地价值。真实线上收益明确:核心互动指标 +0.24%($p<0.001$)、端到端延迟 −20%,且延迟余量可再投入扩容/更丰富 prompt。对任何维护多阶段推荐栈、被"各阶段目标错配 + 特征工程沉重 + 整页无法联合优化"困扰的团队,GenPage 提供了一条可参考的"用单个生成式 Transformer 收敛为单一真源"的迁移路径。