TransRetrieval:把 Transformer 的 Scaling Law 搬进工业推荐的召回阶段¶
阿里巴巴淘天集团(Taobao & Tmall Group of Alibaba)联合中国人民大学高瓴人工智能学院,CIKM '26(Rome, Italy)· arXiv:2608.25528 · 2026-08-26 · cs.IR
作者:Zhifei Zheng*†、Yunfei Liu*、Bin Liu*、Qiren Zhu†、Hanbing Liu†、Ziru Xu、Han Zhu、Jian Xu、Qi Qi‡、Bo Zheng‡(* 共同一作,† 阿里实习期间完成,‡ 通讯作者)
一、研究动机与背景¶
1.1 推荐系统里缺席的 Scaling Law¶
Scaling law 是大语言模型快速进步的驱动力:性能随模型规模、数据量与算力可预测地提升 [8, Chinchilla]。推荐系统虽然坐拥海量数据与不断增长的算力预算,却基本没有表现出类似的 scaling 行为——近期研究反复确认这一鸿沟:传统深度推荐模型简单放大时只会拿到边际递减、甚至负收益的回报(Climber [22]、Wukong [24])。Transformer 在 NLP / CV 中已有成熟的幂律 scaling 性质,自然成为弥合这一鸿沟的候选骨干。
但作者指出,把 Transformer 放大到大规模召回(retrieval)上,面对三重具体挑战:
- 异构特征的尺度失配(Heterogeneous feature scale misalignment)。标准 Transformer 处理的是同质 token:NLP 中每个词嵌入来自同一张查找表 [20],视觉里每个 patch 走同一个投影 [5]。而推荐特征天然异构(用户画像、行为序列、物品属性),映射成 token 后产生严重的尺度失配 [27, RankMixer]。这种失配通过结构性地扭曲嵌入空间来悄无声息地降低表征质量。
- 紧算力预算 vs 延迟约束。召回要面对高达 $10^8$ 量级的候选库,QPS 期望极其苛刻 [4, 9],约束比排序阶段严格好几个数量级 [2]。
- 跨域的 scaling 成本乘数。工业系统通常同时服务多个业务域(首页、搜索、详情页)[10],行为分布各异。为每个域维护一个独立深模型会让训练与服务成本翻倍乘;而稀疏域数据量不足,单靠 scaling 也拿不到收益。朴素地把多域数据合并训练又会因分布冲突而失败。
1.2 已有工作为何不够¶
作者梳理了近期推动推荐 scaling 的工作——HSTU [23]、RankMixer [27]、MARM [14]、Climber [22]、MTGR [7],并给出一句尖锐的共同批评:
它们要么把异构特征集"拍平(flatten)",要么把它"预分组(pre-group)";而且全部瞄准排序(ranking)阶段——排序只给召回已经筛出来的候选打分。
具体地:Wukong [24] 首次系统诊断了深度推荐模型的 scaling 低效,把根因归结为「只扩嵌入表而不增强特征交互」的放大机制;HSTU [23] 把所有特征压平成单一行为序列以获得 token 同质性,代价是牺牲特征类型间的结构区分;RankMixer [27] 把特征预分组成固定语义通道,再用无参数 token mixing 处理;MARM [14] 要靠 60 TB 缓存基础设施才拿到可比增益;Climber [22] 聚焦多尺度序列抽取,但输入本身就是来自同一嵌入表的行为 token;MTGR [7] 在生成式范式下保留丰富特征。
因此,「在 $10^8$ 级候选库、严苛延迟预算下,如何保留完整异构特征集地把 Transformer scale 到召回阶段」 仍是空白。
1.3 本文的三根支柱¶
TransRetrieval 已部署在阿里展示广告平台,服务 4 个业务域。三个设计各对应上面一个挑战:
- 加权平均聚合(Weighted average aggregation):从源头解决尺度失配——把嵌入范数与特征基数(cardinality)解耦,恢复 Transformer 赖以工作的同质 token 假设。
- 目标 token 压缩(Target token compression):用一个轻量 MLP 把目标侧全部特征投影成单个 $D$ 维 token,把每候选 FLOPs 砍掉 85%,并使基于 HNSW 的次线性检索成为可能。推理成本再通过跨候选共享用户侧 KV cache 进一步压低:一个请求内所有候选打分面对的是同一个用户,用户侧 K/V 每请求只算一次、被所有候选复用。
- 位置式 domain embedding(Position-style domain embedding):以逐元素相加的方式注入域信息,类比位置编码。以可忽略的额外 FLOPs 把 4 个域统一进一个模型,并把多域数据变成 scaling 资产——稀疏域可以从跨域迁移中获益。
三个设计只用标准算子、不需要额外基础设施,作者把它定位为一份「在召回里部署 Transformer 的可迁移配方」。作者自称这是推荐架构召回阶段 scaling law 的首批系统性验证之一,与 Climber [22] 在排序阶段的结果互补。
二、核心方法 / 模型架构¶
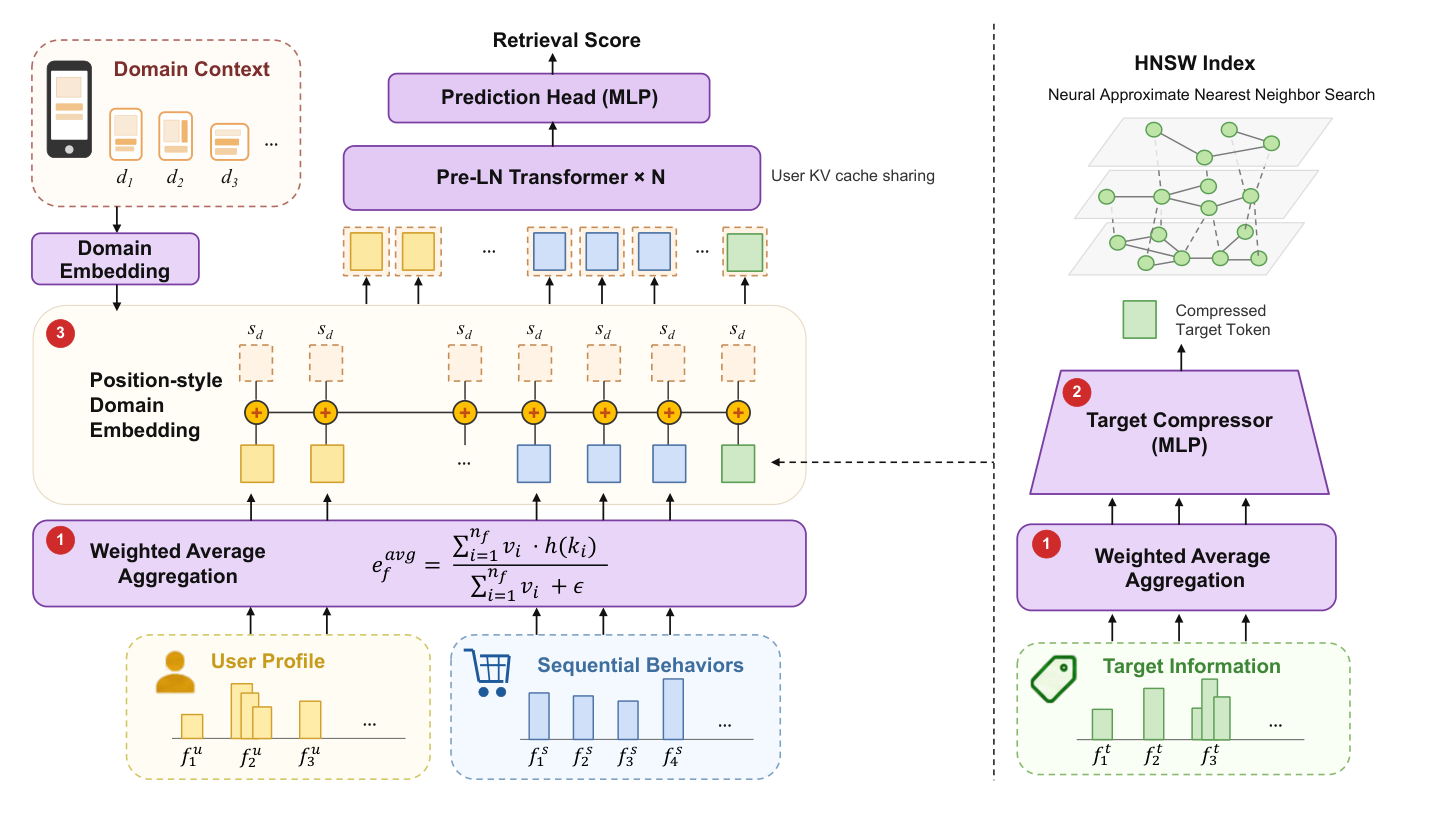
2.1 预备知识:Model-based Retrieval 范式¶
TransRetrieval 工作在 NANN [3] 确立的 model-based retrieval 范式下:一个 DNN 打分函数驱动 HNSW 图 [16] 上的 beam search,每个请求只访问语料的一小部分 $\rho$:
$$s(u,i)=F_\theta(u,i) \tag{1}$$
作者强调用比例 $\rho$ 而不是绝对数量来表达打分预算,因为决定单请求成本的是 $\rho$ 而非语料规模:对 $N$ 个物品的语料,模型执行 $\rho N$ 次前向而非 $N$ 次。实际取值约 $\rho\in[0.1\%,1\%]$;本文部署在 52 M 物品的语料上打分约 $4\times 10^4$ 个候选($\rho\approx 0.08\%$),同一套流水线可服务到 $10^8$ 量级。
与双塔模型 $s(u,i)=\langle f(u),g(i)\rangle$(交互被限制为内积)不同,model-based retrieval 允许任意跨特征交互,代价是每个候选一次前向——这使得每候选 FLOPs 成为支配性瓶颈,也正是历史上打分网络一直做不大的原因。
特征表示。每个特征域 $f$ 表示为一组 (key, weight) 对 $\{(k_i,v_i)\}_{i=1}^{n_f}$,其中 $k_i$ 索引嵌入表 $h:\mathcal{K}\to\mathbb{R}^D$,$v_i\in\mathbb{R}$ 是其权重。
架构总览(Figure 1)。四个阶段:(1) 每个特征域经加权平均聚合,产出 Transformer-friendly 的 token;(2) 目标侧 token 经轻量 MLP 压缩为单个 $D$ 维 token,用户侧每个特征域各成 1 个 token;(3) 一个可学习的 domain embedding 逐元素加到所有 token 上;(4) 得到的 token 序列进入 $N_{\text{layer}}$ 层 Pre-LN Transformer(FFN 用 ReLU),其中一个请求的用户侧 K/V 只算一次,被该请求的所有候选复用。
2.2 支柱一:加权平均聚合¶
作者对使用常规加权求和(weighted sum) 聚合的模型做 profiling,发现严重的尺度失配:用户侧 token 范数高达目标侧的 10 倍。这一失衡会让注意力权重被高范数 token 支配。根因是加权求和的输出范数随特征基数 $n_f$ 增长:用户侧的多值特征域天然会累积出远大于目标侧的范数。
解法就是把求和换成平均:
$$\tilde{e}_f=\frac{\sum_{i=1}^{n_f} v_i\cdot h(k_i)}{\sum_{i=1}^{n_f} v_i+\epsilon} \tag{2}$$
除以 $\sum_i v_i$ 同时抵消了两件事:$n_f$ 相关的累积、以及异构权重量级本身;输出范数被只由嵌入表的分布所界定,与域基数无关。
为什么不用其他聚合器? 作者逐一排除:
- Max pooling:引入随 $O(\sqrt{\ln n_f})$ 增长的极值偏置,并且丢弃了大部分特征信息;
- 聚合后接 LayerNorm [1]:实测更差(§4.4.1),因为它的中心化与重新缩放抹掉了区分异构域的"逐域量级信号";
- 加权平均:是唯一一个同时满足 (a) 输出尺度与 $n_f$ 无关、(b) 不需要任何学习或估计的统计量的算子——它是闭式线性组合,对任意 $D$ 都保持稳定。
2.3 支柱二:目标 token 压缩¶
因为一个请求内所有候选共享同一个用户,用户侧 K/V 每请求只算一次并被所有目标复用;每个候选只需要自己的 Q/K/V/输出投影加 FFN(每层 $16L_tD^2$),以及对长度为 $L_u$ 的完整用户序列做 cross-attention(每层 $4L_tL_uD$)。跨 $N_{\text{layer}}$ 层、$N_{\text{target}}$ 个候选求和:
$$\mathrm{FLOPs}_{\text{total}}\approx 4D\cdot N_{\text{target}}\cdot L_t\cdot\left(4D+L_u\right)\cdot N_{\text{layer}} \tag{3}$$
其中 $L_t$ 是目标 token 数、$L_u$ 是用户序列长度。作者逐项分析这个式子里哪个因子可以动:$D$ 与 $N_{\text{layer}}$ 是我们想最大化的 scaling 参数;$N_{\text{target}}=\rho N$ 已被 HNSW 压到语料的极小比例;$L_u$ 被 $4D$ 项支配。只剩 $L_t$ 有实质的压缩空间——在未压缩模型里 $L_t$ 随目标侧特征域数量增长,是天然的压缩对象。
于是引入 target compressor:一个 3 层 MLP,隐层尺寸 $[8D,4D,D]$,激活用 Parametric ReLU、层间插 LayerNorm(最后一层是普通线性投影),把所有目标侧聚合嵌入的拼接映射成单个 token:
$$\mathbf{t}=\mathrm{MLP}\left(\tilde{e}_{f_1},\tilde{e}_{f_2},\dots,\tilde{e}_{f_M}\right)\in\mathbb{R}^{D} \tag{4}$$
作者特别强调这里的取舍定位:
这一压缩不是妥协,而是一次策略性的算力再分配(strategic reallocation):省下的 FLOPs 被再投资到扩大 $D$ 与 $N_{\text{layer}}$ 上,在同一延迟包线内换来更深更宽的架构——用冗余的每候选 token 换取更丰富的跨特征交互。
附带好处:这个压缩后的单 token 天然就是一个定维向量,可直接用作 HNSW 索引,无需额外处理。
2.4 支柱三:位置式 Domain Embedding¶
统一多域模型是避免成本乘数的必需品,剩下的设计问题是如何注入域身份。直白做法是在输入序列后追加 $N_t$ 个编码域的 token,但这会把注意力成本从 $O(L^2)$ 抬到 $O((L+N_t)^2)$。
作者转而引入位置式 domain embedding:一个按域 $d$ 索引的可学习向量 $\mathbf{s}_d\in\mathbb{R}^D$,逐元素加到每个 token 上:
$$\tilde{\mathbf{e}}_f=\mathbf{e}_f+\mathbf{s}_d \tag{5}$$
类比位置编码 [20],域身份的注入不增加序列长度、不增加注意力复杂度。
关键 insight 在于这个设计如何开启跨域数据 scaling:因为域信息只通过逐元素加法进入,所有 Transformer 参数(每个注意力头、每个 FFN 层)都是跨域无条件共享的。来自每个域的每个训练样本都对同一套参数贡献梯度,稀疏域因此不再"饿死"。这与 MMoE [15] / PLE [19] 形成对比——后者的门控软路由隐式地划分了梯度流,稀疏域的门本身因数据有限而欠训练,反而无法充分利用共享容量。STAR [17] 用共享+域专属组件统一服务,但其星型拓扑并未被证明能让数据稀缺的域从跨域迁移中受益。
2.5 系统实现(§3.5)¶
把 TransRetrieval 推上生产需要推理系统与模型架构的协同设计:
硬件感知的推理优化。标准 LLM 推理框架会把用户 KV cache 为每个候选序列各复制一份;作者把 cache manager 换成一个 expand 算子,把单份用户 cache 广播给每个候选而不做拷贝,单次前向延迟降低 30%。目标压缩后,每个候选变成"单个 query token 去 attend 完整用户上下文",这种极端长宽比严重浪费为大矩阵运算优化的现代 GPU;作者把多个候选打包进一次批量计算并用 mask 保持候选间隔离,显著提升硬件利用率。再叠加 LayerNorm / 残差 / 激活的算子融合,模型前向延迟相对朴素实现下降 11 倍。
GPU 检索。Model-based retrieval 在 beam search 迭代中把打分与图搜索交织进行。索引若驻留 CPU,每次迭代都会产生多次 host-device 往返、割裂 GPU 计算图。作者把全部检索算子(邻居查找、距离计算、候选选择)迁到 GPU,把打分与搜索统一成单一驻留设备的流水线,检索延迟相对 CPU 检索下降 89%。全索引上 GPU 带来显存压力,作者通过跨请求共享推理引擎 + 静态索引数据量化降低显存,服务并发提升 3 倍。
近线更新(Near-line update)。target compressor 与 Transformer 在架构上解耦,作为独立子图部署。全量部署时该子图为所有目标计算表征以构建检索索引;为保持新鲜度,一个事件驱动的近线服务监听目标特征变更,调用同一子图只重算受影响的表征,异步推送到在线索引。
三、实验设置¶
作者围绕四个研究问题组织实验:RQ1 相近算力预算下与 SOTA 基线的对比;RQ2 是否呈现可预测的 scaling 行为;RQ3 三根支柱各自的贡献;RQ4 真实部署收益。
3.1 数据集¶
Table 1:两个数据集的统计(#f_user / #f_target 为用户侧 / 目标侧特征数,Len_seq 为用户行为序列长度)
| Dataset | #Domains | #Users | #Targets | #Interactions | #f_user | #f_target | Len_seq | Dom A/0 | Dom B/1 | Dom C/2 | Dom D/3 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Industrial | 4 | 250 M | 52 M | 40 B | 75 | 87 | 100 | 32% | 20% | 26% | 22% |
| KuaiRand | 4 | 24,943 | 536,491 | 152 M | 37 | 63 | 100 | 11.7% | 84.8% | 3.32% | 0.13% |
- Industrial:采样自阿里展示广告平台生产环境,400 亿次交互、5200 万广告物品语料,覆盖 4 个匿名业务域(A/B/C/D),含丰富用户行为历史、详细物品属性与实时上下文信号。域 C 聚合了多个更小的子域,内部分布方差显著。
- KuaiRand [6]:快手 App 的公开序列推荐数据集,含 12 类用户反馈信号。按已有召回工作 [21, 25] 的做法,用户按 1000 条点击记录、物品按 100 条曝光记录做频次过滤,取前 4 个域(tab=0,1,2,3)。Tab 3 极端稀疏(0.13%),是数据稀缺下泛化能力的严苛测试床。
两个数据集均采用时序切分避免数据泄漏,模拟"用历史训练、在未来评估"的真实部署。两者特征数量的差异也导致了后续实验中不同的算力成本。
3.2 评估指标与基线¶
主指标为 Recall@2000(简写 R@2000):真实正样本出现在 top-2000 召回候选中的比例。
基线四条:
- Production Baseline [12, BAR]:本工作之前服务阿里展示广告平台的 bidding-aware model-based retrieval 系统,一个高度优化的工业标准,也是线上 A/B 中被 TransRetrieval 替换的系统;
- KuaiFormer [13]:简单双塔召回基线,用户侧用 Transformer 编码、内积检索候选;
- HSTU [23]:把所有特征拍平成单一行为序列以获得 token 同质性,丢弃结构性特征区分;
- RankMixer [27]:为召回适配的可扩展排序架构,用无参数 token mixing 替代注意力,算力集中在 per-token FFN。
所有基线在本文框架内重实现,共享同一套预处理流水线,各自保留原始的特征处理设计。
3.3 实现细节¶
全部实验在 NVIDIA H20 GPU 集群上跑,PyTorch + RecIS [28]。所有模型与两个数据集共用一套调好的超参:AdamW、学习率 1e-3、weight decay 3e-5、损失为生产基线的 pairwise learning-to-rank (LTR) loss [12, 26]。负采样比例按数据集区分:Industrial 每正样本 5 个负样本,KuaiRand 200 个——反映训练数据规模差异(40 B vs 152 M),Industrial 的巨大数据量在低比例下已有充足负信号,KuaiRand 需要更高比例补偿正样本不足。所有运行训练至收敛,评估最终 checkpoint。
模型配置记法 $x$D-$y$L:$x$ 为嵌入维度、$y$ 为 Transformer 层数;RankMixer 用 $x$D-$y$T(T 为 token mixing block 数)。MFLOPs′ 衡量目标侧的每候选算力(百万 FLOPs / target)。
四、主要实验结果¶
4.1 整体性能(RQ1)¶
Table 2:跨数据集、跨域的整体召回性能(Recall@2000)。Overall 是按各域在评估交互中的占比加权的 per-domain Recall。
| Method | Ind. Dom A | Ind. Dom B | Ind. Dom C | Ind. Dom D | Ind. Overall | MFLOPs′ | KR Tab 0 | KR Tab 1 | KR Tab 2 | KR Tab 3 | KR Overall | MFLOPs′ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| KuaiFormer-128D5L¹ | 0.496 | 0.466 | 0.470 | 0.548 | 0.495 | 0.011 | 0.371 | 0.415 | 0.379 | 0.463 | 0.409 | 0.012 |
| Production Baseline (BAR) | 0.572 | 0.586 | 0.548 | 0.608 | 0.576 | 0.69 | 0.401 | 0.378 | 0.299 | 0.500 | 0.378 | 0.64 |
| HSTU-128D5L | 0.518 | 0.490 | 0.474 | 0.636 | 0.527 | 1.72 | 0.315 | 0.394 | 0.312 | 0.611 | 0.382 | 1.72 |
| RankMixer-128D8T | 0.445 | 0.419 | 0.437 | 0.512 | 0.452 | 2.10 | 0.406 | 0.357 | 0.384 | 0.518 | 0.364 | 2.10 |
| TransRetrieval-64D3L | 0.593 | 0.590 | 0.575 | 0.663 | 0.603 | 0.45 | 0.460 | 0.413 | 0.413 | 0.481 | 0.419 | 0.42 |
| TransRetrieval-128D5L | 0.644 | 0.641 | 0.634 | 0.719 | 0.657 | 1.91 | 0.526 | 0.465 | 0.479 | 0.537 | 0.473 | 1.81 |
¹ KuaiFormer 是双塔模型,其 MFLOPs′ 按"每用户编码成本摊到 HNSW 图遍历中实际打分的 ~4 万(Industrial)/ ~2.8 万(KuaiRand)个候选"计算。
结论分析(why,而非仅 what):
- 在可比的每候选预算下,TransRetrieval-64D3L(0.45 MFLOPs′)就已经在所有域上超过高度优化的 Production Baseline(0.69 MFLOPs′):Overall 0.603 vs 0.576,且算力少 35%。这说明加权平均 + 单 token 压缩带来的不只是省算力,而是在更低算力下把有限容量用得更有效。
- 放大到 128D5L(1.91 MFLOPs′)进一步把 Overall 拉到 0.657,比小配置再涨 5.4 pt——证明额外算力能可靠地转化为召回质量,这正是 scaling 主张的经验基础。
- 与可扩展基线 HSTU / RankMixer 在相近预算(~1.7–2.1 MFLOPs′)对比,TransRetrieval-128D5L 取得新 SOTA;即便 64D3L 也在约四分之一成本下超过两者。
- KuaiFormer 用表达力换取了摊薄成本(MFLOPs′ 仅 0.011),其 scaling 行为在 §4.2 单独考察。
值得注意的一处反常:在 Industrial 的 Domain D 上,HSTU(0.636)超过 Production Baseline(0.608);在 KuaiRand 的极稀疏 Tab 3 上,HSTU(0.611)甚至是全表最高,超过 TransRetrieval-128D5L(0.537)。作者没有讨论这一点,但它暗示:在极稀疏域上,把一切拍平成同质行为序列(HSTU 的做法)反而可能优于保留全部异构特征——异构特征在数据稀缺时可能是负担而非资产。
4.2 Scaling 行为(RQ2)¶
作者扫描嵌入维度(32D / 64D / 128D)与层数(1L / 3L / 5L)共 9 个配置,把 Recall@2000 对每 target FLOPs 作图:
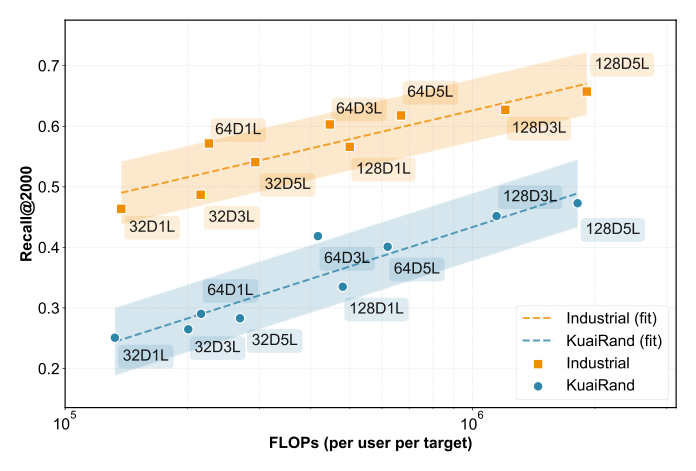
两个数据集都呈现干净的对数线性 scaling:骨干从 32D-1L 长到 128D-5L 时,Industrial 上 Recall@2000 从 0.464 → 0.657(+19.3 pt),KuaiRand 上从 0.251 → 0.473(+22.2 pt),拟合优度 $R^2$ 分别为 0.82 / 0.88。对应的算力区间是每 target 约 0.1 → 2 MFLOPs。
Table 3:各方法在不同配置下的 scaling 表现(R@2000)
| Model | Config | Industrial R@2000 | Industrial MFLOPs′ | KuaiRand R@2000 | KuaiRand MFLOPs′ |
|---|---|---|---|---|---|
| KuaiFormer | 64D5L | 0.485 | 0.003 | 0.357 | 0.004 |
| KuaiFormer | 128D5L | 0.495 | 0.011 | 0.409 | 0.012 |
| HSTU | 32D1L | 0.380 | 0.13 | 0.269 | 0.13 |
| HSTU | 64D2L | 0.437 | 0.30 | 0.298 | 0.30 |
| HSTU | 128D3L | 0.509 | 1.09 | 0.328 | 1.09 |
| HSTU | 128D5L | 0.527 | 1.72 | 0.382 | 1.72 |
| RankMixer | 128D8T | 0.452 | 2.10 | 0.364 | 2.10 |
| RankMixer | 768D8T | 0.468 | 75.50 | 0.420 | 75.50 |
| RankMixer | 768D16T | 0.531 | 150.99 | 0.453 | 150.99 |
| TransRetrieval | 32D1L | 0.464 | 0.14 | 0.251 | 0.13 |
| TransRetrieval | 64D3L | 0.603 | 0.45 | 0.419 | 0.42 |
| TransRetrieval | 128D5L | 0.657 | 1.91 | 0.473 | 1.81 |
结论分析:
- 最醒目的对比是 TransRetrieval-128D5L(1.91 MFLOPs′)在 Industrial 上比 RankMixer-768D-16T 高 12.6 pt(0.657 vs 0.531),而算力少了近两个数量级(1.91 vs 150.99 MFLOPs′,约 79×)。这说明在召回这个"每候选都要过一遍模型"的场景,算力分配方式比算力总量更重要。
- KuaiFormer 呈现近乎平坦的 scaling:维度翻倍(64D5L → 128D5L)只从 0.485 涨到 0.495。作者据此论证:双塔的内积瓶颈无法靠单独放大编码器来克服——表达力的天花板不在编码器容量,而在"交互只能是内积"这一结构限制。
对 Figure 2 的一处独立观察:散点相对拟合线的离散度不小。在 Industrial 上,64D-1L(约 0.572)明显高于算力相近的 32D-5L(约 0.541),128D-1L(约 0.566)也低于 64D-1L;在 KuaiRand 上更有一个点显著高于拟合线、另一个明显低于。这说明同等 FLOPs 下,宽度与深度的分配方式对 Recall 有实质影响,FLOPs 单一变量并不能决定性能。$R^2=0.82/0.88$ 对"scaling law"这一强主张而言只是中等——9 个点、跨越约一个数量级的算力,足以支撑"趋势是对数线性的",但不足以支撑一条可外推的预测律。
五、消融与分析(RQ3)¶
5.1 加权平均聚合的效果(§4.4.1)¶
Table 4:不同特征聚合策略的 Recall@2000(Industrial,统一 64D-5L 配置)
| Method | Dom A | Dom B | Dom C | Dom D | Overall |
|---|---|---|---|---|---|
| Weighted Average (ours) | 0.610 | 0.598 | 0.589 | 0.681 | 0.618 |
| Weighted Sum | 0.600 | 0.594 | 0.572 | 0.674 | 0.608 |
| LN + Weighted Sum | 0.582 | 0.575 | 0.568 | 0.656 | 0.593 |
| Max Pooling | 0.563 | 0.554 | 0.533 | 0.644 | 0.571 |
作者的解读:加权平均在每个域上都胜过全部替代方案。朴素加权求和落后(0.608 vs 0.618),因为特征数增长时范数无界增长;求和后加 LayerNorm 反而伤得更多(0.593 vs 0.618),因为其中心化与重缩放抹掉了 Transformer 用来区分异构域的逐域量级信号;Max Pooling 退化最严重(0.571 vs 0.618),因为极值选择丢弃了大部分特征信息。
5.2 目标 token 压缩的效果(§4.4.2)¶
Table 5:目标 token 压缩对召回性能与算力的影响
| Config | # Tokens | R@2000 | MFLOPs′ |
|---|---|---|---|
| 64D-3L | 8 tokens | 0.624 | 3.04 |
| 64D-3L | 4 tokens | 0.615 | 1.55 |
| 64D-3L | 1 token | 0.603 | 0.45 |
| 128D-5L | 1 token | 0.657 | 1.91 |
结论分析:在 64D-3L 内,把 8 个 token 压到 1 个使 MFLOPs′ 下降约 85%(3.04 → 0.45),只掉 2.1 pt Recall(0.624 → 0.603)——在"每个被检索到的候选都必须被模型打分"的场景下这是划算的交换。把省出的预算再投入 128D-5L + 1-token 压缩,得到严格更优的工作点:成本低于 64D-3L 的 8-token 配置(1.91 vs 3.04 MFLOPs′),Recall 却更高(0.657 vs 0.624)。这直接验证了「先压缩再放大」优于「更多 token + 更小骨干」。
5.3 多域建模策略的效果(§4.4.3)¶
Table 6:多域建模策略消融(Industrial,64D-3L,per-domain R@2000;FLOPs 只报用户侧,因为目标侧处理在各变体间相同,这样才能显式量化序列膨胀带来的开销)
| Method | A | B | C | D | Overall | MFLOPs |
|---|---|---|---|---|---|---|
| 按域训练(仅用本域数据) | ||||||
| Single Domain Data | 0.591 | 0.539 | 0.537 | 0.647 | 0.579 | 41.3 |
| 统一训练(合并全部域数据) | ||||||
| 0 Domain Tokens | 0.254 | 0.276 | 0.251 | 0.289 | 0.265 | 41.3 |
| 1 Domain Token | 0.321 | 0.349 | 0.339 | 0.345 | 0.337 | 41.8 |
| 20 Domain Tokens | 0.431 | 0.451 | 0.460 | 0.473 | 0.452 | 49.8 |
| TransRetrieval (ours) | 0.593 | 0.590 | 0.575 | 0.663 | 0.603 | 41.3 |
结论分析:
- 不给任何域信号地直接混合多域数据(0 Domain Tokens)造成灾难性退化(0.265,比单域训练的 0.579 低了 31.4 pt)——印证了引言中"朴素合并因分布冲突而失败"的判断;
- 加 1 个 domain token 只带来有限改善(0.337)却已引入额外计算;把域 token 重复 20 次进一步放大域信号(0.452),但算力涨到 49.8 MFLOPs,对大规模部署是不可承受的;
- 位置式 domain embedding 取得最佳 Overall(0.603),且推理成本与 0 Domain Tokens 完全相同(41.3 MFLOPs);
- Single Domain Data 一行是这张表里信息量最大的对照:单域训练 0.579 < 统一模型 0.603(+2.4 pt),证明跨域数据共享是净正收益,而不只是"省成本"。
六、线上 A/B 实验(RQ4)¶
Table 7:TransRetrieval 的线上 A/B 结果
| Metric | Dom A | Dom B | Dom C | Dom D | Overall Lift | 95% CI | p-value |
|---|---|---|---|---|---|---|---|
| Revenue | 1.72% | 2.51% | 5.39% | 0.87% | 2.53% | [2.22%, 2.70%] | < 0.0001 |
| RPM | 1.22% | 2.18% | 3.69% | 0.43% | 1.28% | [1.14%, 1.56%] | < 0.0001 |
实验设计:在阿里展示广告系统内、5% 生产流量上做了为期一个月的线上 A/B,召回模型是唯一被改变的变量。TransRetrieval-128D5L 以 230 QPS 服务,P99 延迟低于 40 ms,与生产基线持平,因此收益不是靠端到端延迟换来的。单引擎 QPS 从 300 降到 230,反映每 target 算力从 0.69 升到 1.91 MFLOPs′,这部分由水平扩容吸收。
结果:平台收入 +2.53%、RPM +1.28%,两者 p < 0.0001。日度收益在整月内保持稳定、无系统性衰减。同时生态健康:用户体验指标保持稳定,广告主 ROI 基本持平(+0.06%)。
按域看,收益分布很不均:Domain C(+5.39%)远高于 Domain D(+0.87%)。Domain C 正是 §4.1 提到的「聚合了多个更小子域、内部分布方差显著」的那个域——这与"统一模型 + 跨域迁移让内部异质/稀疏的域受益最多"的机制解释相吻合。
七、核心贡献总结¶
作者在结论里把经验教训归纳为三条:
- 架构重设计之前先做输入调理(Input conditioning before architecture redesign):scaling 的突破不是来自架构新颖性,而是来自一个无参数的一行修正(加权平均)恢复了同质 token 范数。
- 压缩是再分配而非牺牲(Compression as reallocation, not sacrifice):把 8 个目标 token 压成 1 个释放 85% FLOPs,把它们再投入深度/宽度(64D-3L → 128D-5L)换来 +3.3 pt Recall,且总成本更低。
- 域统一是 scaling 资产(Domain unification as a scaling asset):位置式 domain embedding 除了避免按域的成本乘数,还让稀疏域从跨域迁移中受益,而不是孤立地挨饿。
最终结论:三个设计共同解锁了召回阶段的 scaling law——400 亿交互工业数据集 + 公开 KuaiRand 上的对数线性 scaling($R^2=0.82/0.88$)、SOTA 召回、以及为期一个月线上 A/B 的 2.53% 平台收入提升。
八、与已归档相关工作的对比¶
MESH MESH: Scaling Up Retrieval with Heterogeneous Content Unification(Pinterest,2026-07-14)¶
关系:独立并发(本文未引用 MESH,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇是归档中仅有的一对把"异构性"直接指认为工业检索 scaling 失效 root cause 的工作,且都聚焦召回而非排序。MESH 在 Pinterest 十亿级 Related Pins 上观测到"scaling 发散":算力增大时常青(evergreen)内容稳步受益,而新鲜/长尾内容增益极小,命名为 The Scaling Bias of Heterogeneity;TransRetrieval 观测到的是"异构字段 → token 范数发散(用户侧最高 10× 目标侧)→ 注意力被高范数 token 支配"。两者都主张:扁平地把异构信号灌进一个共享交互骨干,是 scaling 拿不到收益的结构性原因。
- 相近的技术骨架:两者的解法都是「在进入共享交互空间之前,先在特征域/语义组层面做结构化处理」。MESH 把特征划成 user / item / context 三组($K=3$),每组先做组级流形初始化再经域专属编码器放大成"语义超级 token";TransRetrieval 把每个特征域先做加权平均聚合成一个 token、目标侧再压成单 token。两张方法流程图在"分组 → 组内规范化 → 送入统一骨干"这一段可以抽象重合。
- 两者的诊断其实是互斥的两种"异构性":MESH 的异构是内容层级的(evergreen / fresh / tail 的交互密度差异),机制是梯度耦合——扁平架构下 evergreen 的 L2 梯度范数是 fresh 的 12.4×,MESH 通过模块隔离把该比率改善 62%(降到 4.7×),使 $\beta_{\text{fresh}}$ 从 0.0059 提到 0.0826(14×)。TransRetrieval 的异构是特征字段的(多值用户域 vs 单值目标域),机制是前向范数支配。MESH 度量的是"谁的梯度被淹没",TransRetrieval 度量的是"谁的 token 范数更大"——同一句"异构性阻碍 scaling"下面是两套完全不同的因果链。
- 一处可直接对撞的实验冲突:MESH 的组级流形初始化明确采用 $H_k^0=\text{LayerNorm}(\text{Concat}(\{e_j\}))$,并论证"组内 LayerNorm 保证 item 域的内部方差独立于 user/context 域被保留"。而 TransRetrieval 的 Table 4 恰恰测出 LN + Weighted Sum(0.593)显著劣于 Weighted Sum(0.608)乃至 Weighted Average(0.618),理由是 LayerNorm 的中心化与重缩放抹掉了区分异构域的逐域量级信号。两篇对"该不该在聚合处上 LayerNorm"给出相反答案且各有实验支持,差异可能来自作用位置(MESH 是组内拼接后做 LN,TransRetrieval 是域内聚合后做 LN)——这是一个值得后续实证澄清的开放点。
- 架构赌注也相反:MESH 保留双塔 + ANN(架构改动仅限 request 级用户塔),而 TransRetrieval 明确论证双塔的内积瓶颈无法靠放大编码器克服(KuaiFormer 64D5L→128D5L 仅 0.485→0.495)。MESH 用"模块化 + 异步 collector"拿到 2.87× 服务效率,TransRetrieval 用"单 token 压缩 + KV cache 共享 + GPU 检索"把打分网络本身做大。两者对"召回该在哪里花算力"给出了对立的答案。
SpecFormer SpecFormer: Mitigating Embedding and Attention Collapse via Spectral-Aware Transformer for Recommendation(Zhejiang University + Alibaba Group,2026-07-27)¶
关系:独立并发(本文未引用 SpecFormer,且两者均出自阿里体系,相隔仅一个月)· 已加载对方精读
- 共同关注的问题:两篇给出的 root cause 陈述几乎可以互换——推荐数据的异构性(heterogeneity)破坏了 Transformer 赖以工作的前提,导致堆层拿不到收益。SpecFormer 的原始问题是"为什么 Transformer 搬到推荐特征交互上,效果反而不如精心设计的简单模型(如 RankMixer),且一堆层就崩";TransRetrieval 的原始问题是"为什么朴素堆 Transformer 层收益递减"。二者都把矛头指向"推荐 token 不是同质的"。
- 相近的技术骨架:两者都选择在把 token 送进注意力之前先做一次"表征调理",而不是改注意力的连接拓扑。SpecFormer 对输入做 SVD、用可学习幂指数 $\tau$ 压平奇异值谱(Learnable Spectral Softening),再用软化后的谱空间算 Q/K;TransRetrieval 用加权平均把 token 范数拉回同一量级,再进标准 Pre-LN Transformer。一个在谱域压平、一个在范数域拉齐,都是"先让 token 变得可比,再让注意力工作"。
- 本文的差异与推进:SpecFormer 的诊断显著更深也更可证伪——它测量了逐层的 fractional effective rank(Qwen3-0.6B 长期维持 0.2–0.3,OneTrans 全程 < 0.06),可视化了 token 语义空间的离散子空间结构,并给出前向(低秩注意力当低通滤波器)+ 反向(梯度被投影到主谱子空间、次要方向饥饿)的闭环恶性循环。TransRetrieval 只报告了一个静态数字("用户侧 token 范数最高达目标侧 10 倍"),没有度量范数差随层数如何演化,也没有注意力熵/有效秩证据。反过来,TransRetrieval 的推进在于它是召回而非排序:SpecFormer 的谱软化需要每层做 SVD,在"每个候选都要过一次网络"的召回预算下几乎不可行;TransRetrieval 的修正是无参数、零额外算力的一行式,这恰恰是召回场景倒逼出的约束。
- 一个耐人寻味的交叉:SpecFormer 的相关工作把 FAT(FAT,同为阿里)与 RankMixer 一起归为"仍然在原始空间域(spatial domain)操作,无法从根本上解决谱坍缩 root cause"的一类。按这个标准,TransRetrieval 的加权平均也属于纯空间域修正——它只重标定了范数,并未触及嵌入矩阵的谱结构。两篇同期同体系的工作,对"异构性造成的损害究竟发生在哪一层(范数 / 谱)"给出了不同深度的答案,而 TransRetrieval 的实测增益(+1.0 pt over Weighted Sum)也确实小于 SpecFormer 报告的量级(线上 CTR +1.34%、CVR +15.97%、Order +16.72%,仅 +5 ms)。
TMallGS TMallGS: Scaling Unified Feature and Sequence Modeling for Generative E-commerce Search(Taobao & Tmall Group of Alibaba,2026-07-15)¶
关系:独立并发(本文未引用 TMallGS,但两者同属淘天集团、相隔一个月)· 已加载对方精读
- 共同关注的问题:TMallGS 把它要解决的第一个瓶颈直接命名为「异构性鸿沟(The Heterogeneity Gap)」——"强行用统一注意力机制处理差异巨大的模态,会触发梯度冲突";TransRetrieval 的表述是"异构字段产生严重的 token 范数发散"。两篇是同一个集团、同一个季度、对同一个结构性瓶颈的两次独立命名。两者也共享同一个更高层的动机:从 memory-bound 的 DLRM 走向 compute-bound 的统一 Transformer 骨干,以换取可预测的 scaling。
- 相近的技术骨架:两者都在输入层做"分布校准"、并都构造请求级共享序列 + 候选独立的注意力结构。TMallGS 的 Request-Level Sequence Construction 把序列对齐到 user-query 请求,所有候选共享 $\mathbf{E}_{in}$,并用 Context-Dominant Visibility Mask 让候选之间严格不可见;TransRetrieval 的用户侧 KV cache 每请求算一次、被所有候选复用,并用打包 + mask 保持候选间隔离。这两段设计在机制上是同一件事的两种实现。
- 本文的差异与推进:修法方向恰好相反。TMallGS 认为异构性要靠给每个特征域一套独立的 QKV 投影(Per-Field 异构 QKV,"允许异构模态各自独立的语义旋转")来化解——即放弃参数共享;TransRetrieval 则坚持 Transformer 参数在所有域、所有 token 上无条件共享,把异构性问题下推到聚合算子里用一次除法解决。TransRetrieval 的立场更激进也更省:共享参数正是它跨域数据 scaling 的前提("每个域的每个样本都对同一套参数贡献梯度"),而 Per-Field QKV 会让参数量随字段数线性增长——在召回的每候选前向预算下不可承受。
- 又一处 LayerNorm 上的直接冲突:TMallGS 的 Distribution-Calibrated Projection 用 Calibrated-Swish $\phi_{cal}(\mathbf{H})=\mathbf{H}\odot\sigma(\text{LayerNorm}(\mathbf{H}))$,明确依赖 LayerNorm 来"标准化潜分布,确保自门控信号严格居中于梯度敏感区"。而 TransRetrieval 的 Table 4 测出 LN + Weighted Sum 是四种聚合器里的次差项。同一集团的两篇工作,一篇把 LayerNorm 当作分布校准的核心工具,另一篇把它当作会抹掉逐域量级信号的有害操作——这是本次对照里最值得记下的分歧。
九、讨论与局限性¶
9.1 对「scaling 由 weighted average 解锁」这一归因的独立核验¶
论文在摘要("The key enabler is (1) weighted average aggregation")和结论("the scaling breakthrough came not from architectural novelty but from a parameter-free one-line fix")里把 scaling 的解锁明确归功于加权平均。读完全部消融后,我认为这一归因没有被论文自己的数据支持,理由如下:
- 缺少最关键的那组实验:不同聚合器下的算力扫描。 要证明"加权平均解锁了 scaling",需要证明的是斜率差异——即加权求和版本随算力增长会更早饱和,而加权平均版本保持对数线性。但 Table 4 只在单一的 64D-5L 配置上比了四种聚合器,Table 3 的 scaling 扫描则只对完整的 TransRetrieval 做。论文从未展示过一条"weighted sum 版本的 scaling 曲线",因此无法区分加权平均带来的是曲线的截距平移还是斜率改变。
- 效应量与叙事严重不匹配。 加权平均相对加权求和的实测增益是 +1.0 pt(0.618 vs 0.608);而论文归给 scaling 的增益是 +19.3 pt(32D-1L → 128D-5L)。一个 1.0 pt 的聚合器差异在算术上根本承载不了 19.3 pt 的 scaling 收益。
- 不用加权平均的基线同样在 scale。 Table 3 里,HSTU 从 32D1L 的 0.380 涨到 128D5L 的 0.527(Industrial,+14.7 pt),KuaiRand 上 0.269 → 0.382(+11.3 pt),全程单调;RankMixer 也从 0.452(2.10 MFLOPs′)涨到 0.531(150.99 MFLOPs′)。在论文报告的算力区间内,没有任何一条基线真正展示出引言所断言的"朴素堆层收益递减"——那个作为全文出发点的反例从未被测量出来(引言处引用的是 Climber [22] 与 Wukong [24] 的结论,而非本文自己的实验)。
- 需要为论文说句公道话:HSTU 的同质性是构造性获得的(所有 token 来自同一嵌入表),这与"同质 token 假设"的论点其实是一致的。但若如此,论文真正成立的主张应当是"可以在保留完整异构特征的同时照样 scale",而不是"加权平均解锁了 scaling"。前者才是它与 HSTU 的真实分野。
- 三根支柱里,加权平均的实测贡献最小。 Table 6 中,位置式 domain embedding 相对单域训练是 +2.4 pt(0.579 → 0.603)、相对无域信号的统一训练是 +33.8 pt(0.265 → 0.603);Table 5 中目标压缩在固定骨干下倒扣 2.1 pt,靠算力再分配才净赚 +3.3 pt。加权平均的 +1.0 pt 是三者中最小的一项,却被写成 "the key enabler"。
- 因果链只测了两端。 论文主张的机制是「异构 → token 范数发散 → 注意力被高范数 token 支配 → 堆层收益递减」。实际被测量的只有第一环的一个静态数字(用户侧范数最高 10× 目标侧)和最后一环的 Recall,中间两环——注意力分布是否真的被高范数 token 支配、范数差是否随深度加剧——没有任何直接证据。同期的 SpecFormer(见 §8)就给出了逐层有效秩曲线,对比之下本文的机制论证明显偏薄。
- LayerNorm 的结果本身就暴露了故事不完整。 如果机制纯粹是"范数无界增长伤害注意力",那么在加权求和后接 LayerNorm 应当把范数问题修好并追回大部分差距。但实测 LN + Weighted Sum(0.593)比朴素 Weighted Sum(0.608)还差。论文对此的解释是"LN 抹掉了逐域量级信号"——这是一个与原假设相反方向的机制:一个说逐域量级差异有害(必须压掉),另一个说逐域量级差异有用(必须保留)。加权平均恰好同时做到两件事(把绝对尺度界定在嵌入表分布内,同时保留域内相对量级),但现有消融无法分离究竟是哪一个效应带来了增益。
结论:Table 4 支持的命题是"在固定模型尺寸下,加权平均是四种聚合器中最好的一个,相对加权求和值约 +1.0 pt";它不支持"加权平均是 scaling 的关键使能器"。按论文自己报告的数字,scaling 增益更自洽的解释是:目标 token 压缩释放算力、把算力回投到更大骨干(Table 5 的显式算力再分配论证)+ 跨域数据统一(Table 6),而加权平均更像是一项必要的输入卫生(hygiene)修正——没有它模型会更差,但它不是把曲线从平坦掰成对数线性的那只手。要坐实原归因,缺的实验很明确:在每种聚合器下各跑一遍 32D-1L → 128D-5L 的算力扫描,展示斜率而非截距的差异。
9.2 判别式检索 scaling vs 生成式检索:两条路线的赌注差异¶
本文是「判别式检索靠修正表征继续 scale」这条路线的代表,它与同期生成式检索路线对「工业检索的瓶颈在哪」的诊断是互斥的:
- 本文的赌注:瓶颈是每候选 FLOPs。既然 model-based retrieval 允许任意跨特征交互(不像双塔被内积锁死),那么只要把每候选成本压下来(单 token 压缩 + 共享 KV cache + GPU 检索),就能把打分网络本身做大,而 scaling 会自然兑现。它不需要离散 token 化、不需要自回归解码、不需要 token-to-item 的外部翻译层,索引仍是 HNSW,检索仍是打分 + beam search。
- 生成式检索路线的赌注:瓶颈是索引与打分的割裂。以语义 ID + next-token 为核心,把 "index → retrieve" 合并进一个可微模型。归档中同期同公司的 CQ-SID CQ-SID(Alibaba TmallAPP,2026-05-14)走的正是这条路,但它自己也明确后撤为"召回阶段的补充而非端到端替代",并主动放弃 SID 唯一性(多个语义相近 item 共享一个"语义簇 ID"),把 beam search 复杂度从 $O(N_{\text{items}})$ 降到 $O(N_{\text{clusters}})$——它的核心工程妥协恰恰也是"每候选/每步解码成本"。
- 两条路线在诊断上的真正分歧:本文认为召回的表达力上限来自"交互形式"(内积 vs 任意交互)与"算力分配",与是否离散化无关;生成式路线认为上限来自"打分与索引不可联合优化"。归档中 LLM-Native TT(Meta,2026-07-28,The Case Against Generation for Retrieval)把后者的代价说得最直白:生成式检索吐出的是离散文本 token 而非显式 item 标识符,token-to-item 的翻译必须发生在模型之外,对齐误差会在推理之后级联到下游;加上服务成本高、自回归解码引入延迟。Meta 的结论(复活双塔、用 LLM 当判别式语义骨干)与本文站在同一阵营,但连它也仍押注双塔+ANN;本文则更进一步,认为双塔的内积瓶颈本身也必须被放弃(KuaiFormer 64D5L → 128D5L 只从 0.485 涨到 0.495 是它的关键论据)。
- 因此,三条路线对"瓶颈在哪"的排序是:生成式(割裂的索引)< 双塔判别式(服务成本/陈旧化)< 本文(每候选 FLOPs 与内积表达力)。它们不是殊途同归,而是把同一份延迟预算押在了不同的地方。
9.3 其他局限¶
- 单一指标。全文离线评估只有 Recall@2000 一个指标,没有 NDCG / 分层召回率 / 多样性 / 覆盖率,也没有报告长尾物品召回。对一个宣称"跨域迁移让稀疏域受益"的系统,缺少长尾覆盖度量是明显的空白。
- scaling 区间偏窄。0.1 → 2 MFLOPs 只有约一个数量级、9 个配置点,$R^2=0.82/0.88$;相比之下 Table 3 里 RankMixer 被扫到了 150.99 MFLOPs′。论文没有把自己的模型推到饱和点,因此"对数线性"能外推多远是未知的。
- 域 C 的收益解释缺失。线上 A/B 中 Domain C 收入 +5.39% 是 Domain D(+0.87%)的 6 倍,论文完全没有分析。按 §4.1 的描述域 C 内部分布方差最大,这与"统一模型受益最多"的解释吻合,但未被验证。
- 极稀疏域上被 HSTU 反超。KuaiRand Tab 3(0.13% 占比)上 HSTU 得 0.611 而 TransRetrieval-128D5L 只有 0.537,是全表唯一一处本文模型不是最优的位置。这暗示保留全部异构特征在数据极稀缺时可能是负担——与全文主张(异构特征是应当保留的资产)构成张力,作者未予讨论。
- 基线均为自行重实现。四条基线都"在本文框架内重实现、共享同一预处理流水线、共用一套调好的超参"。共用超参对追求公平是合理的,但对 HSTU / RankMixer 这类有自己训练配方的架构可能不利,而 RankMixer 在 Table 2 上甚至跑输了 KuaiFormer 双塔(0.452 vs 0.495 Industrial Overall),这一异常结果没有解释。
- 工程增益与方法增益混在一起。§3.5 报告的 30% / 11× / 89% / 3× 全是系统侧优化的收益,与三根支柱的模型侧收益并列陈述;线上 +2.53% 收入是"模型 + 系统"整体替换的结果,无法拆分归因。
9.4 值得借鉴的设计¶
抛开归因问题,这篇论文有三处工程判断是干净且可迁移的:
- 用 $\rho$(打分比例)而非绝对候选数表达召回预算——这让"算力 × 语料规模"两个维度解耦,是分析 model-based retrieval 成本的正确坐标系;
- "压缩不是妥协而是再分配"这一显式论证(Table 5 把"8 token 小骨干"与"1 token 大骨干"放在同一张成本-效果表上比较),是本文方法论上最扎实的一段,也是唯一一处把"省下的算力去了哪里"完整闭环的实验;
- 把 KV cache 的 expand 算子替代拷贝:LLM 推理框架的默认行为(每序列一份 cache)在"一个用户 × 数万候选"的召回场景是纯粹浪费,改成广播即省 30% 延迟——这类"推荐场景与 LLM 场景的结构差异导致默认实现失效"的观察,比模型创新更容易迁移到其他系统。