The Case Against Generation for Retrieval: 判别式语言模型作为高效检索器¶
Zhe Xu、Prachi Agrawal、Kavosh Asadi、Tianyi Chen、Carl Hu、Justin Johnson、Wuwei Lan、Mingfu Liang、Xi Liu、Tik On Lui、Oladipo Ositelu、Sandeep Pandey、Ankit Peshin、Feng Qi、Anil Ramakrishna、Kaushik Rangadurai、Frank Shyu、Luke Simon、Yang Yang、Chiyu Zhang(按姓氏字母序),Meta。arXiv 2607.25346,2026-07-28。论文首页带 GR2 标识,属 Meta GR2(Generative Recommenders)系列的检索侧工作。
这是一篇立场鲜明的论文:标题直接写着"反对把生成用于检索"。在 TIGER / OneRec / PLUM 一路把推荐重写成语言建模问题的两年之后,Meta 站出来说:在 web-scale 检索这一层,生成范式是架构错配;真正该做的是把 LLM 当作判别式语义表征骨干,去复活那个被认为"过时"的双塔架构。论文的结论是——经典双塔在被现代表征学习增强后,仍然是工业检索"极具竞争力且实用"的方案。
研究动机与背景¶
生成式推荐的三重结构性代价¶
LLM 因其语义理解、指令遵循与开放世界知识被大量引入推荐系统。一条突出的路线是把推荐重述为语言建模 / 生成问题:模型直接预测 item 标题、文本回复、排序列表或离散 item 标识符。P5 把多种推荐任务统一到 text-to-text 框架下;TIGER 把推荐形式化为在语义 item ID 上的生成式检索;LLMRank 研究把 LLM 当作候选集上的 zero-shot ranker;TALLRec 用高效微调把 LLM 与推荐数据对齐。
尽管理论上很有吸引力,论文指出完全生成式或交互密集(interaction-heavy)的 LLM 推荐器在大规模检索上遭遇严重的运维瓶颈,具体是三条:
- 服务成本高得离谱(prohibitive serving costs);
- 依赖诱发延迟的自回归解码(latency-inducing autoregressive decoding);
- grounding 问题频发——生成的 token 常常映射不回一个合法的 item 标识符。
第三条是论文着力最重的一击,原文的措辞值得原样保留:
关键在于,因为生成式检索模型吐出的是离散文本 token 而非显式的 item 标识符,token-to-item 的翻译必须发生在模型之外(must occur outside the model)。这种结构性割裂会让对齐误差与预测损失在推理之后级联到下游(cascade downstream after inference)。
也就是说,生成式检索的"最后一公里"是一个模型无法端到端优化的外部翻译层,误差在这里被引入,且不可逆。
与之相对,双塔(two-tower / dual-encoder)架构仍是工业检索的基石:user 与 item 被分别映射进共享嵌入空间,item 表示因此可以离线预计算,并通过近似最近邻(ANN)检索高效服务。
这个二分对立引出了论文的核心研究问题(原文措辞):
能否在保留双塔"经生产验证的效率与可扩展性"的同时,用 LLM 时代的语义深度去复活并增强经典双塔架构?
本文的答案与四点贡献¶
论文的答案是 LLM-native two-tower:不用 LLM 做生成器,而是通过在领域数据上做有监督微调(SFT),把预训练 LLM 改造成丰富的语义表征骨干,专门服务于高效候选检索。具体沿两条线推进——先把 cross-encoder 教师做强,再把教师的排序能力蒸馏进双塔学生。
四点贡献:
- 从 LLM 表征学习视角重新审视经典双塔推荐架构,提供全生成式推荐之外的高效替代路线;
- 提出 teacher–student 的 LLM-native 检索框架:用 verbalized 相关性打分 + user-conditioned 语言建模强化 cross-encoder 监督,再把教师在候选集上的排序偏好迁移给高效的双塔检索器;
- 在三个真实数据集上做完整实验 + 详尽消融,逐组件分析有效性;
- 在真实生产条件下验证:极高的数据效率(仅用 0.5% 训练数据即可匹配经典双塔)、对模型陈旧化(staleness)的显著韧性、以及更优的数据 scaling 曲线。
相关工作定位¶
- LLM-based 推荐:P5 / M6-Rec / TIGER 代表生成式路线;工业规模上 PLUM 与 OneRec 系(OneRec、OneRec-V2、OneRec-Think)通过语义 ID 扩展生成式推荐,做统一的检索与排序、反馈对齐与显式推理。另一条线把 LLM 当 zero-shot ranker(LLMRank)或指令微调推荐器(TALLRec)。本文与它们的分野:保留因子化(factorized)双塔检索以支持大规模候选生成,用一个共享 LLM 作为语义编码器分别前向 user-history 与 item,再用 EOS pooling、跨数据集迁移、cross-encoder 蒸馏、以及只在 user 塔内的隐式推理来增强检索器。
- 神经检索:从 DSSM、Sentence-BERT、DPR 到 YouTube 双塔推荐模型,dual-encoder 因 item embedding 可预计算而适合候选生成。其代价是牺牲细粒度 user–item 交互;cross-encoder 更强但推理成本过高,late interaction(ColBERT)是折中点。已有工作通过负采样与蒸馏改进 dual encoder(Yi et al. 2019;Wang et al. 2021;Yang et al. 2020;Menon et al. 2022 的 In defense of dual-encoders)。本文沿这一范式,但换上现代共享 LLM 骨干,并把隐式推理限制在 user 塔以保住检索期的因子化结构。
预备知识与记号¶
设用户集合 $\mathcal{U}$、item 集合 $\mathcal{I}$。对每个用户 $u\in\mathcal{U}$,$x_u$ 是其文本化输入(历史交互、用户画像、偏好描述);对每个 item $i\in\mathcal{I}$,$x_i$ 是其文本化输入(标题、描述、类目、元数据)。目标是学一个打分函数 $s(u,i)$ 使相关 item 得分更高:
$$\mathcal{R}_u^K = \operatorname{TopK}_{i\in\mathcal{I}} s(u,i) \tag{1}$$
双塔(TT)模型。给定 user / item 编码器 $f_{\theta_u}$、$f_{\theta_i}$:
$$\mathbf{z}_u = f_{\theta_u}(x_u)\in\mathbb{R}^d,\qquad \mathbf{z}_i = f_{\theta_i}(x_i)\in\mathbb{R}^d \tag{2}$$
匹配分通常用内积定义:
$$s_{\mathrm{TT}}(u,i) = \mathbf{z}_u^{\top}\mathbf{z}_i \tag{3}$$
因为 item embedding 可预计算,双塔天然支持高效 ANN 检索。
Cross-Encoder(CE)模型。把 user 与 item 文本拼接后联合编码:
$$x_{u,i} = [x_u; x_i] \tag{4}$$
$$\mathbf{h}_{u,i} = f_\theta(x_{u,i}) \tag{5}$$
再经预测头(此处以单层线性变换为例)得到匹配分:
$$s_{\mathrm{CE}}(u,i) = \mathbf{w}^{\top}\mathbf{h}_{u,i} + b \tag{6}$$
CE 因为 user 与 item 的 token 在打分前经历了完整的 self-attention 交互,表达力强于双塔;但其表示依赖于具体的 $(u,i)$ 对,item embedding 无法独立预计算,因此 CE 通常只用于排序,或作为教师把更强的匹配信号蒸馏给高效检索模型。
对比目标。给定一个 mini-batch 的 $B$ 个正样本 user-item 对:
$$\mathcal{B} = \{(u_b, i_b^{+})\}_{b=1}^{B} \tag{7}$$
把配对 item $i_b^{+}$ 当作 $u_b$ 的正样本,同 batch 内其他 item 作 in-batch 负样本,故 $u_b$ 的候选集为:
$$\mathcal{C}_{u_b} = \{i_1^{+}, i_2^{+}, \dots, i_B^{+}\} \tag{8}$$
模型在候选 item 上定义 softmax 分布:
$$p(i_j^{+}\mid u_b,\mathcal{C}_{u_b}) = \frac{\exp(s(u_b,i_j^{+})/\tau)}{\sum_{k=1}^{B}\exp(s(u_b,i_k^{+})/\tau)} \tag{9}$$
$\tau$ 是温度超参。对比损失即交叉熵,鼓励每个 $u_b$ 给自己的正样本 $i_b^{+}$ 最高分:
$$\mathcal{L}_{\mathrm{con}} = -\sum_{b=1}^{B}\log\frac{\exp(s(u_b,i_b^{+})/\tau)}{\sum_{k=1}^{B}\exp(s(u_b,i_k^{+})/\tau)} \tag{10}$$
这个目标是模型无关的:只要骨干能对每个 user-item 对产出一个标量分数,同样的损失就能用。后文用 $\mathcal{L}_{\mathrm{con}}(s_{\mathrm{TT}})$ 这样的写法区分打分函数来源。
核心方法 / 模型架构¶
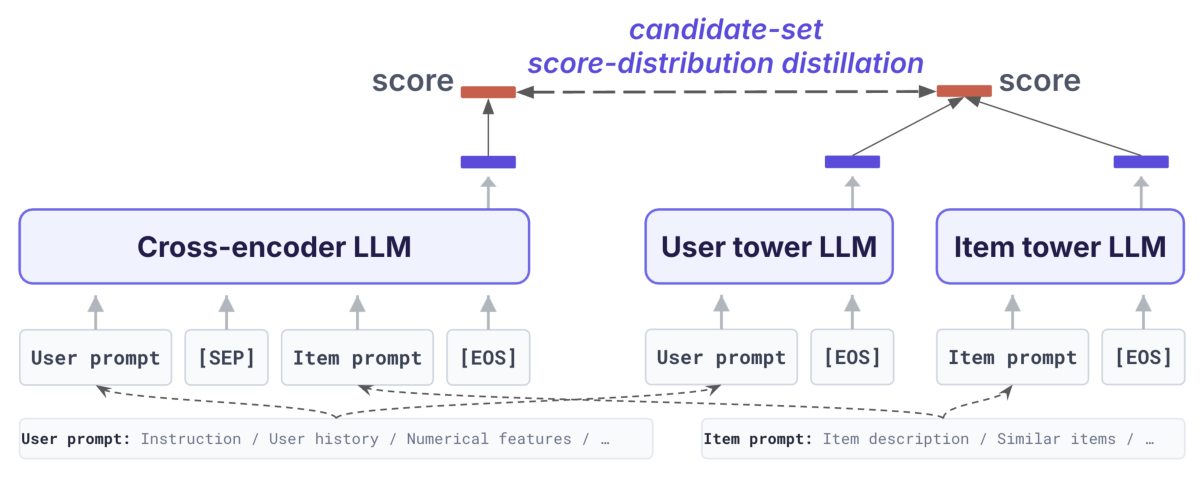
核心思路是把 cross-encoder 的强排序能力通过知识蒸馏迁移进高效的双塔模型。CE 联合编码每个 user-item 对,能捕获细粒度交互,但 pairwise 推理成本使其无法用于大规模检索;双塔独立编码 user 与 item,支持离线 item 索引与高效近邻检索。因此:CE 当高容量教师,TT 当高效学生。方法沿两个方向展开——(i) 把教师做强(教师性能就是蒸馏的经验上界),(ii) 把学生的蒸馏效果与泛化能力做强。
4.1 强化 Cross-Encoder 教师¶
教师提供学生的监督信号,教师变强直接意味着蒸馏用的软标签质量变高。论文从三个方面增强 CE:yes/no 输出头做相关性预测、item 文本上的辅助 next-token prediction 损失、把 decoder 式骨干转成双向编码器。三种技术分别引入,但可以最小改动地叠加以展示累积收益(第三项最终被证明无效,见"额外观察")。
4.1.1 Yes/No 输出头¶
给定 user-item 对 $(u,i)$,构造一个同时含 user 侧文本 $x_u$ 与 item 侧文本 $x_i$ 的文本 prompt:$x_{u,i}^{\mathrm{yn}} = \mathrm{Prompt}(x_u, x_i)$,prompt 要求模型判断 item $i$ 是否与用户 $u$ 相关,并以 "yes" 或 "no" 作答。沿用 MixLM 等 LLM 排序设计,相关性分数直接从两个 verbalized 标签的 next-token logits 计算。
具体地,CE 教师 $f_\theta^{\mathrm{CE}}$ 吃入完整 prompt 产出 next-token logits:
$$\boldsymbol{\ell}_{u,i} = f_\theta^{\mathrm{CE}}(x_{u,i}^{\mathrm{yn}}) \tag{11}$$
设 $\ell_{\mathrm{yes}}(u,i)$、$\ell_{\mathrm{no}}(u,i)$ 分别是 $\boldsymbol{\ell}_{u,i}$ 中对应 "yes" 与 "no" token 的分量,则相关性分数定义为二者的 logit 差:
$$s_{\mathrm{CE}}(u,i) = \ell_{\mathrm{yes}}(u,i) - \ell_{\mathrm{no}}(u,i) \tag{12}$$
这个设计的动机是:不再新学一个随机初始化的投影头,而是复用 LLM 预训练时就已经校准好的 yes/no 语义方向,把相关性判断嫁接到模型已有的语言先验上。
4.1.2 Item Prompt 上的辅助 Next-Token Prediction(NTP)¶
推荐数据往往含有丰富的 item 侧文本(标题、描述、类目、评论)。为把 CE 教师更好地适配到推荐域,论文在 item 文本上加一个辅助 NTP 目标。关键设计:这个目标不是无条件的语言建模,而是item 文本始终以对应的 user 侧文本为条件生成,使模型学到的是"item 语义在用户偏好语境下的样子"。
对训练对 $(u,i)\in\mathcal{S}$($\mathcal{S}$ 为训练 user-item 对集合),item 文本 tokenize 为 $x_i = [t_{i,1}, t_{i,2}, \dots, t_{i,L_i}]$。给定 user 侧文本 $x_u$,辅助 NTP 损失定义为:
$$\mathcal{L}_{\mathrm{ntp}} = -\sum_{(u,i)\in\mathcal{S}}\ \sum_{\ell=1}^{L_i-1}\log p_\theta\big(t_{i,\ell+1}\mid x_u, t_{i,1},\dots,t_{i,\ell}\big) \tag{13}$$
该目标沿用标准自回归语言建模范式,但把 item 文本生成条件化在用户上下文上。结果是教师不仅捕获 item 特有的术语与属性,还捕获这些属性如何与用户偏好关联。
教师最终训练目标是对比损失(式 10)与该辅助损失的加权和:
$$\mathcal{L}_{\mathrm{CE}} = \mathcal{L}_{\mathrm{con}}(s_{\mathrm{CE}}) + \lambda_{\mathrm{ntp}}\mathcal{L}_{\mathrm{ntp}} \tag{14}$$
$\lambda_{\mathrm{ntp}}$ 控制辅助目标强度(实验中取 0.5)。
4.2 增强双塔学生¶
教师做强之后,进一步增强学生,使其在保住高效检索的前提下更好吸收教师的排序知识。引入五项技术:共享 user-item 编码器、EOS pooling、跨数据集迁移学习、CE2TT 蒸馏、Coconut 式 user 塔隐式推理。同样是分别引入、可叠加。
4.2.1 共享 User-Item 编码器¶
传统双塔常用分离的 user / item 编码器。本文改用一个共享文本编码器 $f_\theta$ 同时处理两侧输入,$f_\theta(x)$ 记其 pooled 序列表示:
$$\mathbf{z}_u = f_\theta(x_u),\qquad \mathbf{z}_i = f_\theta(x_i) \tag{15}$$
参数共享鼓励 user 与 item 被嵌入同一个语义空间,沿用了语义匹配与检索里通行的 dual-encoder 设计(Sentence-BERT、DSSM),同时相比两个独立编码器减少了可训练参数量。
4.2.2 EOS Pooling¶
给定文本输入 $x$,LLM 编码器产出隐状态序列 $\mathbf{H}_x = [\mathbf{h}_{x,1}, \mathbf{h}_{x,2}, \dots, \mathbf{h}_{x,L_x}]$。对 decoder 式 LLM,在序列末尾拼接 EOS token,用其 embedding 作为序列级表示:$\mathbf{z}_x = \mathbf{h}_{x,L_x}$。
动机:在因果注意力下,最后一个 token 能聚合它之前的全部序列信息,这是把 decoder 式 LLM 改造成 embedding 模型时的常用做法(Wang et al. 2024;NV-Embed)。论文实测 EOS pooling 优于 mean pooling(见 §6.2.3 / Table 11 的 vanilla 对照)。
4.2.3 跨数据集迁移学习(TL)¶
为提升学生泛化能力,先在所有推荐数据集上 mid-train 共享 LLM 编码器,再在每个目标数据集上微调。设有 $R$ 个数据集 $\mathcal{D}_{\mathrm{all}} = \{\mathcal{D}_1,\dots,\mathcal{D}_R\}$,mid-training 目标为:
$$\mathcal{L}_{\mathrm{mid}} = \frac{1}{R}\sum_{r=1}^{R}\mathcal{L}_{\mathrm{con}}^{(r)}(s_{\mathrm{TT}}) \tag{16}$$
mid-train 之后,模型在特定目标数据集 $t$ 上进一步最小化 $\mathcal{L}_{\mathrm{con}}^{(t)}(s_{\mathrm{TT}})$。该策略沿用可迁移推荐(UniSRec、VQ-Rec)的直觉:跨数据集共享的行为与文本模式可以提升下游表现。
4.2.4 Cross-Encoder-to-Two-Tower(CE2TT)蒸馏¶
CE 教师产出更强的 user-item 相关性分数但检索代价过高。因此用候选集分数分布蒸馏把它的排序行为迁给学生。对每个用户 $u$ 与候选集 $\mathcal{C}_u$,教师产出 $s_{\mathrm{CE}}(u,i),\ i\in\mathcal{C}_u$。
教师的候选集分数分布定义为:
$$q_{\mathrm{CE}}(i\mid u,\mathcal{C}_u) = \frac{\exp(s_{\mathrm{CE}}(u,i)/T)}{\sum_{j\in\mathcal{C}_u}\exp(s_{\mathrm{CE}}(u,j)/T)}$$
其中 $T$ 是蒸馏温度。学生分布同理:
$$p_\theta^{\mathrm{TT}}(i\mid u,\mathcal{C}_u) = \frac{\exp(s_{\mathrm{TT}}(u,i)/T)}{\sum_{j\in\mathcal{C}_u}\exp(s_{\mathrm{TT}}(u,j)/T)}$$
蒸馏损失是两个分布间的 KL 散度:
$$\mathcal{L}_{\mathrm{KD}} = T^{2}\sum_{u}\mathrm{KL}\big(q_{\mathrm{CE}}(\cdot\mid u,\mathcal{C}_u)\ \|\ p_\theta^{\mathrm{TT}}(\cdot\mid u,\mathcal{C}_u)\big) \tag{17}$$
这个目标迁移的是 cross-encoder 的相对排序偏好(而不是绝对分数或表示本身)——这一点在 Appendix F 中被实验证实为关键(见后文"额外观察":直接在 embedding 层面用 $L_2$ 对齐反而更差)。学生总目标为 $\mathcal{L}_{\mathrm{TT}} = \mathcal{L}_{\mathrm{con}}(s_{\mathrm{TT}}) + \lambda_{\mathrm{KD}}\mathcal{L}_{\mathrm{KD}}$,其中 $\lambda_{\mathrm{KD}} = 0.2$。
4.2.5 User 塔中的 Coconut 式隐式推理¶
user 侧输入常包含多条历史交互与偏好信号,单个 EOS pooled 表示可能不足以概括用户意图。受 Coconut(Hao et al. 2024,在连续隐空间而非解码出的自然语言 token 上做推理)启发,论文只在 user 塔加一个轻量隐式推理步。item 塔保持标准 EOS-pooled 编码器 $\mathbf{z}_i = f_\theta(x_i)$,因此 item embedding 仍可预计算。两塔继续共享同一套参数 $\theta$。
设 $g_\theta$ 为 pooling 之前的共享 LLM 塔。user 侧先在不追加 EOS 的情况下编码 user 文本,取最后一个隐状态作为连续隐 token($[-1]$ 表示序列中最后一个隐状态):
$$\mathbf{H}_u^{(0)} = g_\theta(x_u),\qquad \mathbf{c}_u = \mathbf{H}_u^{(0)}[-1] \tag{18}$$
隐 token $\mathbf{c}_u$ 随后在 embedding 层面被追加回序列,再接一个 EOS token;最终 EOS 的隐状态作为 user 表示:
$$\mathbf{H}_u^{(1)} = g_\theta([x_u; \mathbf{c}_u; \mathrm{EOS}]),\qquad \mathbf{z}_u = \mathbf{H}_u^{(1)}[-1] \tag{19}$$
$\mathbf{c}_u$ 从不被解码成离散词 token,它扮演的是"一个连续的思维 token"(one continuous thought token),给 user 塔一次额外的机会去精炼偏好表示。检索分仍是标准双塔点积 $s_{\mathrm{TT}}(u,i) = \mathbf{z}_u^{\top}\mathbf{z}_i$,$\mathbf{z}_i$ 保持不变。这种非对称计算在提升 user 表示表达力的同时,完整保住了 item 塔的检索效率——这是本文把"推理"引入检索而不破坏因子化结构的关键取舍。
4.3 效率讨论:与生成式检索的正面对比¶
论文明确把在线服务效率与 OneRec-Think 这类生成式检索方法对比:
- 本文方法:每次用户请求,把 user prompt 编码一次,然后在预计算好的 item embedding 上做点积检索。开启隐式推理时,user 塔多做一次额外的 cached decoding step。随后的最大内积搜索可用 ANN 索引高效并行。
- 生成式检索:必须自回归解码一个可能包含推理轨迹 + 一个或多个语义 item 标识符的序列。设输出序列长度为 $N_{\mathrm{gen}}$,则需要一次 prompt-prefill 前向 + $N_{\mathrm{gen}}-1$ 个串行解码步。这些步骤无法跨输出位置完全并行,服务延迟随生成序列变长而增加。
一句话概括论文的效率立论:用"单次 user 侧编码 + 离线 item 索引上的向量检索"替换"迭代式 item 生成"。在需要对超大目录做低延迟检索时,这个设计尤其占优。
5 系统架构(生产部署)¶
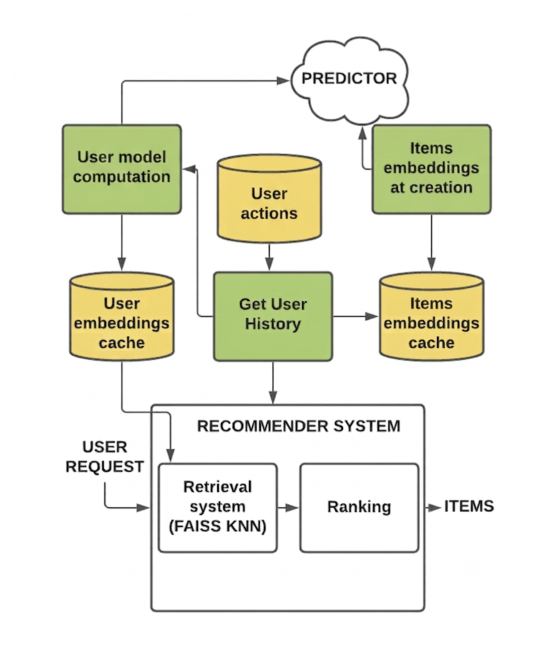
LLM-Native Two Tower 的服务架构设计目标是:在严格实时延迟约束下大规模服务高度定向的 item。做法是一个解耦、非对称的设计,把密集的语言模型推理从在线服务路径中隔离出去。整体分三块:item 近线 embedding 流水线、user 近线 embedding 流水线、高性能在线检索层。
- 5.1 Item Embedding 服务:当一个 item 被创建或更新,其特征被取出并填入 prompt 模板;一个 Predictor 服务异步生成该 item 的语义表示;生成的 embedding 实时入索引,从而支持在线服务时对海量候选池做 user-to-item 相似度计算。
- 5.2 User Embedding 服务:user embedding 周期性重算以反映平台上的新鲜互动。系统聚合用户交互历史,经 User LLM 处理;更新后的 embedding 被缓存进一个高吞吐分布式 KV 存储供快速在线查询。
- 5.3 在线候选检索:在线检索层在毫秒级从分布式存储取出预计算的 user embedding,用它查询 item 索引,在数百毫秒内取回相关候选。为满足这一延迟目标,引擎使用嵌入空间压缩加速 kNN 计算(Figure 2 中标为 FAISS KNN)。结果候选集送往下游排序阶段。
实验设置¶
公开数据集实验(§6.1)¶
- 数据集:沿用 TIGER 的三个 Amazon Reviews benchmark 与同一套预处理协议:Beauty、Sports and Outdoors、Toys and Games。按时间戳排序构造每个用户的商品序列,剔除评论少于 5 条的用户,采用 leave-one-out 协议(最后一个 item 测试、倒数第二个验证、其余训练)。在本文的 pointwise 设定下,时序 item 序列充当 user 侧输入。
| Dataset | # Users | # Items | Mean Len. | Median Len. |
|---|---|---|---|---|
| Beauty | 22,363 | 12,101 | 8.87 | 6 |
| Sports and Outdoors | 35,598 | 18,357 | 8.32 | 6 |
| Toys and Games | 19,412 | 11,924 | 8.63 | 6 |
- 预处理(Appendix A):把 user / item 特征转成自然语言。user 侧含两部分:(i)最近 5 个 item,每个格式化为
[Brand] Title (LeafCategory, L2Category) Price Rating;(ii)taste summary(历史 item ≥3 的用户):top-3 L2 类目及其占比(仅保留 ≥15% 的),top-2 品牌,价格区间(min–max)。item 侧含:核心信息(ASIN、标题、叶子类目、L2 类目、品牌、价格、平均评分数)、描述片段(描述前 100 字符,按词边界截断)、also-bought 信号(最多 3 个共购 item)。 - 骨干:所有 LLM 编码器统一用 Qwen3-0.6B,从官方 checkpoint 初始化。注意这是一个重要的对照条件——对比的 OneRec-Think 用的是 Qwen3-8B。
- 指标:Recall@K 与 NDCG@K,$K=5,10$,表中缩写 R@K / N@K。
$$\mathrm{Recall}@K = \mathbb{E}_{u\in\mathcal{U}}\big[\mathbb{1}(i_u^{*}\in\mathcal{R}_u^K)\big] \tag{20}$$
$$\mathrm{DCG}@K = \sum_{j=1}^{K}\frac{2^{\mathrm{rel}_{u,j}}-1}{\log_2(j+1)} \tag{21}$$
$$\mathrm{NDCG}@K = \mathbb{E}_{u\in\mathcal{U}}\left[\frac{\mathrm{DCG}@K}{\mathrm{IDCG}@K}\right] \tag{22}$$
其中 $\mathrm{rel}_{u,j}\in\{0,1\}$ 指示排在第 $j$ 位的 item 是否为 ground-truth 下一个 item。在标准 leave-one-out 协议下 $\mathrm{IDCG}@K = 1/\log_2(1+1) = 1$。
- 超参(Appendix D):bfloat16 混合精度、AdamW(weight decay 0.01)、前 10% steps 线性 warmup 后 cosine decay、全程 gradient checkpointing。硬件 NVIDIA A100-SXM4 80GB:CE 与 TT 预训练/微调用 4 卡,蒸馏阶段用 8 卡。Qwen3 tokenizer,query 截断 512、item 截断 128。
Table 9|Cross-Encoder(yes/no head + NTP loss)超参
| Hyperparameter | Value |
|---|---|
| Negatives per positive | 31 |
| NTP loss weight $\lambda_{\mathrm{ntp}}$ | 0.5 |
| Epochs | 10 |
| GPUs | 4× A100-80GB |
| Per-GPU batch | 32 |
| Effective batch | 128 |
| Learning rate | $2\times10^{-5}$ |
| Weight decay | 0.01 |
| Warmup ratio | 0.1 |
| Max length (query / item) | 512 / 128 |
| Precision | bf16 |
| Seed | 42 |
Table 10|双塔检索器超参
| Hyperparameter | Value |
|---|---|
| Embedding | raw 1024-d |
| Similarity / temperature $\tau$ | dot product / 0.07 |
| Pre-training & fine-tuning (transfer) | |
| GPUs / Per-GPU batch / Epochs / LR | 4× A100-80GB / 32 / 10 / $2\times10^{-5}$ |
| CE→TT distillation | |
| GPUs / Per-GPU batch | 8× A100-80GB / 32 |
| In-batch negatives | 31 |
| Teacher candidates $K$ | 50 |
| Epochs / LR | 5 / $1\times10^{-5}$ |
| KD loss weight $\lambda_{\mathrm{KD}}$ | 0.2 |
| Distill temperature $T$ | 1.0 (Beauty) / 0.5 (Sports, Toys) |
| Shared | AdamW (wd 0.01, warmup 0.1),max len 512/128,bf16,seed 42 |
内部生产数据实验(§7.1)¶
- 数据:内部检索系统。每条样本序列化为 user / item / task 三类结构化 block。连续特征用 FSQ(Finite Scalar Quantization)离散化;历史稠密 embedding 用 Q-Former 压成固定数量的可学习 query token;ID / event 序列被 verbalize 成短文本片段。这套统一表示允许新增特征 block 而不改动模型架构。除非另说,模型使用 8K token 上下文。
- 模型:内部模型同样用 Qwen3-0.6B 骨干,执行 prefill-only 判别式打分。检索用双塔,CE 提供蒸馏目标。容量 scaling 上另评估 4B dense 骨干与 Mixtral 式稀疏 MoE(8 experts, top-2 routing)。内部系统记为 LLM-native TT/CE,生产基线记为 DLRM。
- 基线:一个重度调优的生产双塔检索器,遵循标准 DLRM 实践(Naumov et al. 2019);user / item 塔独立,点积支持高效向量检索;大部分参数集中在 embedding 层,item-ID 词表规模达 $O(10\mathrm{M})$。
- 指标:主质量指标为 Normalized Entropy(NE),越低越好;报告相对 NE gain (%),即相对指定基线的 NE 下降百分比。泛化能力用训练截断日之后的 $ds+1, ds+2, \dots$ 评估日上的 NE 变化衡量;效率报告服务吞吐 QPS。
主要实验结果¶
6.2.1 与 SOTA 的对比¶
Table 1|三个 Amazon 数据集上的 SOTA 对比(baseline 数值取自 OneRec-Think 论文 Table 1;ORT = OneRec-Think,Qwen3-8B 骨干;本文所有变体为 Qwen3-0.6B。括号内为相对 ORT 的相对变化)
| Model | Beauty R@5 | R@10 | N@5 | N@10 | Sports R@5 | R@10 | N@5 | N@10 | Toys R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| BERT4Rec | 0.0232 | 0.0396 | 0.0146 | 0.0199 | 0.0102 | 0.0175 | 0.0065 | 0.0088 | 0.0215 | 0.0332 | 0.0131 | 0.0168 |
| HGN | 0.0319 | 0.0536 | 0.0196 | 0.0266 | 0.0183 | 0.0313 | 0.0109 | 0.0150 | 0.0326 | 0.0517 | 0.0192 | 0.0254 |
| GRU4Rec | 0.0395 | 0.0584 | 0.0265 | 0.0326 | 0.0190 | 0.0312 | 0.0122 | 0.0161 | 0.0330 | 0.0490 | 0.0228 | 0.0279 |
| SASRec | 0.0402 | 0.0607 | 0.0254 | 0.0320 | 0.0199 | 0.0301 | 0.0106 | 0.0141 | 0.0448 | 0.0626 | 0.0300 | 0.0358 |
| TIGER | 0.0405 | 0.0623 | 0.0267 | 0.0337 | 0.0215 | 0.0347 | 0.0137 | 0.0179 | 0.0337 | 0.0547 | 0.0209 | 0.0276 |
| HSTU | 0.0424 | 0.0652 | 0.0280 | 0.0353 | 0.0268 | 0.0343 | 0.0173 | 0.0226 | 0.0366 | 0.0566 | 0.0245 | 0.0309 |
| ReaRec | 0.0450 | 0.0704 | 0.0262 | 0.0344 | 0.0214 | 0.0332 | 0.0116 | 0.0154 | 0.0523 | 0.0764 | 0.0298 | 0.0376 |
| ORT | 0.0563 | 0.0791 | 0.0398 | 0.0471 | 0.0288 | 0.0412 | 0.0199 | 0.0239 | 0.0579 | 0.0797 | 0.0412 | 0.0482 |
| Ours (TT) | 0.0473 (−16.0%) | 0.0825 (+4.3%) | 0.0267 (−32.9%) | 0.0380 (−19.3%) | 0.0320 (+11.1%) | 0.0542 (+31.6%) | 0.0193 (−3.0%) | 0.0264 (+10.5%) | 0.0644 (+11.2%) | 0.1078 (+35.3%) | 0.0366 (−11.2%) | 0.0506 (+5.0%) |
| Ours (CE) | 0.0575 (+2.1%) | 0.0957 (+21.0%) | 0.0351 (−11.8%) | 0.0473 (+0.4%) | 0.0438 (+52.1%) | 0.0677 (+64.3%) | 0.0289 (+45.2%) | 0.0365 (+52.7%) | 0.0829 (+43.2%) | 0.1223 (+53.5%) | 0.0555 (+34.7%) | 0.0682 (+41.5%) |
结论分析。CE 教师在 12 个"数据集×指标"组合中的 10 个上取得最佳,整体 SOTA;相对 ORT 的收益在 Sports 与 Toys 上尤为夸张(R@10 分别 +64.3%、+53.5%)。高效的双塔学生也在全部三个数据集的 R@10 上超过 ORT(+4.3% / +31.6% / +35.3%),但 NDCG 结果明显更弱——Beauty N@5 −32.9%、N@10 −19.3%,Toys N@5 −11.2%。
论文对此的解读是"两个模型角色互补:CE 提供最高排序质量,TT 提供有竞争力的 top-10 检索性能且架构适合可扩展 item 检索"。这个解读有回避成分:R@10 高而 NDCG 低意味着双塔学生能把正确 item 捞进前 10,但排不到前列——这恰恰是双塔因子化结构缺乏细粒度交互的经典表现。作为召回层这是可接受的(下游还有排序阶段),但把它当作"SoTA-comparable"来陈述略显宽松。另一方面,用 0.6B 打赢 8B 是实打实的效率优势。
6.2.2 强化 Cross-Encoder 教师¶
Table 2|三个数据集上 CE 教师变体对比
| Dataset | Variant | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|
| Beauty | projection head | 0.0509 | 0.0862 | 0.0307 | 0.0420 |
| Beauty | yes/no head | 0.0535 | 0.0914 | 0.0328 | 0.0450 |
| Beauty | yes/no + NTP | 0.0575 | 0.0957 | 0.0351 | 0.0473 |
| Sports | projection head | 0.0391 | 0.0618 | 0.0245 | 0.0317 |
| Sports | yes/no head | 0.0317 | 0.0550 | 0.0195 | 0.0269 |
| Sports | yes/no + NTP | 0.0438 | 0.0677 | 0.0289 | 0.0365 |
| Toys | projection head | 0.0757 | 0.1134 | 0.0492 | 0.0614 |
| Toys | yes/no head | 0.0814 | 0.1203 | 0.0517 | 0.0643 |
| Toys | yes/no + NTP | 0.0829 | 0.1223 | 0.0555 | 0.0682 |
结论分析。yes/no 头相对投影头在 Beauty 与 Toys 上有提升,但在 Sports 上四个指标全部退化(如 R@10 从 0.0618 掉到 0.0550)——说明单靠 verbalized 相关性打分的收益是数据集依赖的,论文对此坦诚。
加上 user-conditioned NTP 目标之后这种不一致被消除:yes/no + NTP 在全部 12 个指标上取得最佳。具体地,相对 yes/no 头,R@10 从 0.0914→0.0957(Beauty)、0.0550→0.0677(Sports)、0.1203→0.1223(Toys),对应的 N@10 提升为 +0.0023 / +0.0096 / +0.0039。这说明"以用户上下文为条件预测 item 文本"提供了与相关性判别互补的、推荐特有的监督信号。因此最终选定 yes/no + NTP 作为蒸馏教师。
6.2.3 强化双塔学生¶
Table 3|TT 学生的留一消融(所有变体均使用 Shared+EOS;每个消融变体从完整模型中移除一个组件)
| Dataset | Variant | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|
| Beauty | Full | 0.0473 | 0.0825 | 0.0267 | 0.0380 |
| Beauty | w/o TL | 0.0431 | 0.0812 | 0.0241 | 0.0363 |
| Beauty | w/o CE2TT | 0.0427 | 0.0715 | 0.0252 | 0.0345 |
| Beauty | w/o Latent | 0.0463 | 0.0794 | 0.0269 | 0.0374 |
| Sports | Full | 0.0320 | 0.0542 | 0.0193 | 0.0264 |
| Sports | w/o TL | 0.0300 | 0.0515 | 0.0174 | 0.0243 |
| Sports | w/o CE2TT | 0.0258 | 0.0417 | 0.0160 | 0.0211 |
| Sports | w/o Latent | 0.0308 | 0.0530 | 0.0185 | 0.0257 |
| Toys | Full | 0.0644 | 0.1078 | 0.0366 | 0.0506 |
| Toys | w/o TL | 0.0604 | 0.1050 | 0.0346 | 0.0490 |
| Toys | w/o CE2TT | 0.0626 | 0.0992 | 0.0383 | 0.0502 |
| Toys | w/o Latent | 0.0650 | 0.1063 | 0.0370 | 0.0503 |
结论分析。CE2TT 是最关键的可选组件:移除后 R@10 分别下降 0.0110(−13.3%,Beauty)、0.0125(−23.1%,Sports)、0.0086(−8.0%,Toys)。TL 与隐式推理带来更小但互补的收益——移除任何一个都会在每个数据集上降低 R@10。因此完整模型在三个数据集上同时取得最佳 R@10 与 N@10。少数 top-5 指标偏好某个消融变体(如 Toys 的 R@5 与 N@5、Beauty 的 N@5),但完整配置提供最一致的 top-10 检索质量。
Table 11|完整组合消融(Appendix E;- 表示未启用。首行为 vanilla baseline:分离编码器 + mean pooling)
| Dataset | Shared+EOS | TL | CE2TT | Latent | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|---|---|---|
| Beauty | - | - | - | - | 0.0214 | 0.0389 | 0.0125 | 0.0180 |
| Beauty | ✓ | - | - | - | 0.0415 | 0.0672 | 0.0253 | 0.0337 |
| Beauty | ✓ | - | ✓ | - | 0.0429 | 0.0800 | 0.0241 | 0.0360 |
| Beauty | ✓ | ✓ | - | - | 0.0430 | 0.0714 | 0.0260 | 0.0351 |
| Beauty | ✓ | ✓ | ✓ | - | 0.0463 | 0.0794 | 0.0269 | 0.0374 |
| Beauty | ✓ | - | - | ✓ | 0.0425 | 0.0711 | 0.0251 | 0.0343 |
| Beauty | ✓ | - | ✓ | ✓ | 0.0431 | 0.0812 | 0.0241 | 0.0363 |
| Beauty | ✓ | ✓ | - | ✓ | 0.0427 | 0.0715 | 0.0252 | 0.0345 |
| Beauty | ✓ | ✓ | ✓ | ✓ | 0.0473 | 0.0825 | 0.0267 | 0.0380 |
| Sports | - | - | - | - | 0.0054 | 0.0109 | 0.0033 | 0.0050 |
| Sports | ✓ | - | - | - | 0.0205 | 0.0347 | 0.0131 | 0.0177 |
| Sports | ✓ | - | ✓ | - | 0.0298 | 0.0510 | 0.0175 | 0.0243 |
| Sports | ✓ | ✓ | - | - | 0.0261 | 0.0426 | 0.0166 | 0.0219 |
| Sports | ✓ | ✓ | ✓ | - | 0.0308 | 0.0530 | 0.0185 | 0.0257 |
| Sports | ✓ | - | - | ✓ | 0.0223 | 0.0387 | 0.0132 | 0.0184 |
| Sports | ✓ | - | ✓ | ✓ | 0.0300 | 0.0515 | 0.0174 | 0.0243 |
| Sports | ✓ | ✓ | - | ✓ | 0.0258 | 0.0417 | 0.0160 | 0.0211 |
| Sports | ✓ | ✓ | ✓ | ✓ | 0.0320 | 0.0542 | 0.0193 | 0.0264 |
| Toys | - | - | - | - | 0.0294 | 0.0489 | 0.0175 | 0.0237 |
| Toys | ✓ | - | - | - | 0.0600 | 0.0968 | 0.0367 | 0.0487 |
| Toys | ✓ | - | ✓ | - | 0.0614 | 0.1049 | 0.0353 | 0.0493 |
| Toys | ✓ | ✓ | - | - | 0.0563 | 0.0928 | 0.0332 | 0.0450 |
| Toys | ✓ | ✓ | ✓ | - | 0.0650 | 0.1063 | 0.0370 | 0.0503 |
| Toys | ✓ | - | - | ✓ | 0.0604 | 0.0946 | 0.0383 | 0.0493 |
| Toys | ✓ | - | ✓ | ✓ | 0.0604 | 0.1050 | 0.0346 | 0.0490 |
| Toys | ✓ | ✓ | - | ✓ | 0.0626 | 0.0992 | 0.0383 | 0.0502 |
| Toys | ✓ | ✓ | ✓ | ✓ | 0.0644 | 0.1078 | 0.0366 | 0.0506 |
这张表最重要的一行是每个数据集的第一行 vs 第二行:仅仅把"分离编码器 + mean pooling"换成"共享编码器 + EOS pooling",R@10 就从 0.0389→0.0672(Beauty,+72.8%)、0.0109→0.0347(Sports,+218%)、0.0489→0.0968(Toys,+98%)。换言之,本文最大的单点收益来自最朴素的两个改动——参数共享把 user 与 item 拉进同一语义空间,EOS pooling 正确地从 decoder 式 LLM 中抽取序列表示。后续的 TL / CE2TT / Latent 三件套是在此基础上的增量精修。
7 内部生产实验¶
7.2.1 LLM-native 双塔检索¶
(a)极低数据量下的 NE 平价。LLM-native TT 只用 0.5% 的训练数据就匹配了生产 DLRM 基线的 NE。在同一评估下,LLM-native CE 相对基线 NE 提升 +2.25%,说明通过 CE→TT 蒸馏,检索器还有可挖的空间(headroom)。
(b)分segment 分析。跨 user / item 互动分段评估:
- 尾部 item(按互动量排在最后 15%):相对 DLRM NE +5.5%——与"当交互历史稀疏时,语义表示的潜力最大"的直觉一致;
- 头部用户(按互动量排在前 12%):NE +2.3%——说明其序列建模能力在长交互历史中捕获了额外信号。
这两端同时改善是一个有说服力的信号:语义表征既补了长尾的冷启动,也没在头部因为丢掉 ID 记忆而退化。
(c)服务效率。
Table 4|在不损伤 NE 的前提下提升 LLM-native TT 的服务效率
| Technique | QPS Gain |
|---|---|
| Numerical Features FSQ Compression | 19.7% |
| Depth pruning | 10.6% |
| Static vocabulary pruning | 2.0% |
| Post-training Quantization | 13.6% |
细节:数值特征的 digit-level tokenization 会造成很长的输入,因此把连续特征量化成 64 个 FSQ bin 并注入其可学习 embedding 作为 soft token,该压缩使 QPS +19.7% 且 NE 还改善了 0.3%;用一个 search-proxy 指标挑出 28 层中的 3 层做剪枝并通过知识迁移恢复质量,QPS +10.6%;静态词表剪枝移除极少使用的 embedding 项以降内存,QPS +2.0%;训练后 FP8 量化 带来 QPS +13.6%,NE 仅回退约 0.003%。
7.2.2 LLM-native Cross-Encoder 的泛化与 Scaling¶
(a)陈旧化下的泛化能力。经典 DLRM 需要持续重训以防质量快速衰减。为评估这一性质,作者在截至日期 $ds$ 的数据上同时训练 DLRM 基线与 LLM-native 模型,然后在不更新任何参数的情况下评估其在 $ds+1$、$ds+2$、$ds+3$ 三天上的冻结推理表现。所有指标相对每日循环重训的、新鲜的生产 DLRM。
Table 5|Staleness(模型陈旧化)(负值 = 退化)
| Model | $ds+1$ (NE) | $ds+2$ | $ds+3$ |
|---|---|---|---|
| DLRM (production) | baseline | baseline | baseline |
| Frozen DLRM | baseline | −2.68% | −4.30% |
| Frozen LLM-Native CE | +2.25% | +2.21% | +2.23% |
结论分析。冻结的 DLRM 随时间严重退化($ds+2$ 掉 2.68%、$ds+3$ 掉 4.30%),根因是它依赖漂移中的、易逝的 item ID 分布。相反,冻结的 LLM-Native CE 在未来三天上保持稳健(+2.25% / +2.21% / +2.23%,几乎无衰减),因为它把表示接地在一个稳定的 token 词表上。
这是本文最有价值的工业发现:它把"LLM 语义表征"的收益从"效果提升"扩展到"运维成本结构的改变"——一个不随 ID 分布漂移而腐坏的检索器,意味着重训频率、训练算力、以及模型上线的 SLA 都可以重新设计。
(b)数据 scaling。LLM-Native TT 用 0.5% 数据达到 DLRM 生产基线的 NE 平价;而 LLM-Native CE 的样本效率与 scaling 轨迹更为夸张——仅用 0.15% 的训练数据就达到基线 NE 平价。进一步地,当数据量按 2×、3× 扩展时,LLM-Native CE 展现出复利式性能增长,超过其经典 DLRM 对照的 scaling 曲线。
Table 6|数据 Scaling(1× 数据时两模型性能相同;数值为各自相对自身 1× 起点的 NE 增益)
| Model | 2× | 3× |
|---|---|---|
| DLRM (production) | +1.30% | +1.80% |
| LLM-native CE | +1.59% | +2.19% |
论文把这种更优的 scaling 行为归因于 LLM 稳定的语义词表使得特征学习可以持续、累积,与传统 DLRM 对易逝 item ID 的脆弱依赖形成对比。
(c)模型 scaling 与容量。沿三条正交轴做 headroom 分析:(i)增大骨干 LLM 参数量;(ii)引入 MoE 层;(iii)通过隐式推理扩展计算量。
Table 7|Headroom Study:模型 Scaling 的收益
| Variant | NE gain |
|---|---|
| LLM-Native CE 0.6B | baseline |
| + Latent reasoning (residual-stream) | +0.41% |
| + Mixtral MoE (8 experts, top-2) | +0.91% |
| LLM-Native CE 4B | +1.90% |
三条轴各自都带来可观的 NE 提升。论文明确说明这些放大配置超出了当前的服务预算,因此没有进入主 benchmark 结果,但它们证明了在算力可用时架构仍有显著头寸。
额外观察与被否决的设计(Appendix F)¶
论文诚实地列出了几个"看起来合理但最终没有留下"的变体,这部分对复现者价值很高:
- 共享 user / item 编码器是有益的。评估过为两塔用分离的 LLM 编码器(容量更大、允许塔特有参数),但实验中共享编码器一致更优,说明参数共享更有效地把 user 与 item 表示对齐到同一语义空间。
- Embedding 层面的匹配效果更差。除 CE2TT 蒸馏外,还试过用 $L_2$ 损失在正样本 user-item 对上直接匹配 cross-encoder 与双塔的 EOS 表示。这个 embedding-level 目标反而降低了检索性能,表明匹配教师在候选集上的相对偏好,比直接对齐它们的 pooled 表示更有用。
- 增加隐式推理步数不改善检索质量。给 item 塔加隐式推理不带来提升,可能因为 item 侧输入相对简单;在 user 塔用多于一步的隐式推理会大幅增大计算图与显存占用,却没有可测收益。因此最终只在 user 塔用单步。
- Decoder-to-Encoder 转换不稳定有效。评估过 Dec2Enc 变体——移除因果注意力掩码以启用双向 token 交互。尽管这一改动对判别式表征学习看似合理,但它没有带来一致提升,且经常同时劣化 cross-encoder 与双塔模型,因此被排除在最终方法之外。(这是 §4.1 提到的"三项教师增强"中的第三项,实际被否决。)
核心贡献总结¶
- 一个明确的架构立场:在 web-scale 检索这一层,生成范式付出的三重代价(服务成本、自回归延迟、模型外 grounding 导致的误差级联)不划算;用 LLM 做判别式语义表征骨干去增强经典双塔,是更实用的路线。
- 一套 teacher–student 配方:CE 教师(verbalized yes/no logit 差 + user-conditioned NTP 辅助损失)→ 候选集分数分布 KL 蒸馏 → 双塔学生(共享编码器 + EOS pooling + 跨数据集迁移 + user 塔单步 Coconut 隐式推理),item embedding 全程可预计算。
- 完整的组件消融:从 vanilla(分离编码器 + mean pooling)到全配置的 8 种组合全部报告;证实"共享编码器 + EOS pooling"贡献最大的单点收益,CE2TT 是最关键的可选组件。
- 生产级验证与两个高价值发现:0.5% 数据达到 DLRM 平价(CE 仅需 0.15%);冻结模型对 staleness 的韧性(+2.2% 稳定三天 vs DLRM 的 −4.30%);以及优于 DLRM 的数据 scaling 曲线。
- 可落地的效率工程:FSQ 数值特征压缩(+19.7% QPS)、深度剪枝(+10.6%)、静态词表剪枝(+2.0%)、FP8 训练后量化(+13.6%,NE 仅 −0.003%)。
与已归档相关工作的对比¶
EGR EGR: Embedding-Native Generative Retrieval with a Shared LLM(Snap Inc.,2026-07-25)¶
关系:独立并发(本文未引用 EGR,两者殊途同归,投稿仅相隔 3 天)· 已加载对方精读
- 共同关注的问题。两篇论文指向同一个 root cause:把"检索"实现为"生成",会在模型之外强加一层不可端到端优化的接口。本文说这是"token-to-item 的翻译必须发生在模型之外,对齐误差与预测损失因此在推理之后级联到下游";EGR 说 SID-based GR 需要 item encoder / quantizer / generator / grounding layer 四件套同时在线,且目录更新意味着可变的 ID 词表。两者都主张:把 item 表示与 user 表示放进同一个连续空间、用 ANN 直接检索,这层接口就消失了。
- 相近的技术骨架。抽象成流程图后几乎重合:一个共享的 LLM backbone 同时编码 item 元数据与 user 交互历史 → 各自产出一个稠密向量 → item 向量离线写入 ANN 索引 → 在线只做一次 user 侧编码 + 最大内积检索。连"为什么共享"的论证都一致——本文说共享编码器"鼓励 user 与 item 被嵌入同一语义空间"且实验上一致优于分离编码器(Appendix F);EGR 说共享让"被索引的 item 空间与 query 空间是一起长出来的",并用消融对比了"不共享 backbone"。两者也都强调 item 侧必须保持可预计算(本文只在 user 塔加隐式推理,EGR 在目标 embedding 上加 stop-gradient)。
- 本文的差异与推进。(i)监督信号来源不同:EGR 完全靠两个对比目标自举(IRL 的 item-pair 对称 InfoNCE + NIP 的 history-to-target InfoNCE),本文额外引入一个更强的 cross-encoder 教师,把 teacher 在候选集上的相对排序偏好通过 KL 蒸馏(式 17)灌进双塔——消融显示这是最关键的可选组件(去掉 R@10 掉 8%–23%)。(ii)本文在 user 侧加了一步连续隐式推理(Coconut 式),EGR 的 user 路径是纯编码。(iii)立论姿态相反:EGR 保留了 "Generative Retrieval" 的名号,把自己定位成 GR 的第三种形态(embedding-native GR);本文直接标题反对生成("The Case Against Generation"),把自己定位成对经典双塔的复兴。
- 可比的方法 / 实验差异。两者都在 Amazon Reviews 上评估(EGR 三个类目,本文 Beauty / Sports / Toys),都做了工业验证:EGR 在 Snap DPA 上展示随数据单调 scaling(+27%)、冷启动仅退化 5.1%、并有线上 A/B CVR +2.91%;本文在 Meta 内部展示 0.5% 数据 NE 平价、尾部 item NE +5.5%、以及 staleness 韧性,但没有报告线上 A/B 业务指标。EGR 的两个稳定性设计(stop-gradient 防止逐样本目标侧拉扯 item 空间、warm-up 先只跑 IRL 10% steps)在本文中没有对应物——本文的 item 空间稳定性是靠 CE 教师的全局排序偏好隐式约束的。反过来,本文对教师侧的挖掘(yes/no verbalized 头 + user-conditioned NTP)是 EGR 完全没有涉及的维度。
DaV-Gen DaV-Gen:以"起草-验证"重构端到端生成式检索(阿里巴巴 HUJING,2026-07-09)¶
关系:独立并发(本文未引用 DaV-Gen)· 已加载对方精读
- 共同关注的问题。两篇都把矛头指向自回归解码在检索层的延迟瓶颈。DaV-Gen 的表述是"AR 逐 token 解码带来了难以承受的推理延迟,且缺乏对推荐列表长度的确定性控制";本文的表述是生成式检索"需要一次 prompt-prefill 前向 + $N_{\mathrm{gen}}-1$ 个串行解码步,这些步骤无法跨输出位置完全并行"。两者都明确把用 ANN 向量检索替换逐 token 生成作为破局点。
- 相近的技术骨架。两者的流程图共享同一个骨架:(1)用一个可预计算、可索引的稠密 item 表示做高召回的 ANN 候选获取 → (2)用一个表达力更强的交互式打分器把候选排好序。DaV-Gen 的 draft 阶段用 Hybrid Sparse-Dense embedding 做 MIPS,verify 阶段用一次并行前向做融合打分;本文的 TT 学生就是 draft,CE 教师就是 verify。
- 本文的差异与推进。最本质的分歧在于"verify 放在哪里":DaV-Gen 把验证器留在在线链路上(单次并行前向验证整批候选,$O(L)$ 降为 $O(1)$,但仍需为每个候选跑一次交互式打分);本文则把 cross-encoder 完全编译进离线训练——通过 CE2TT 分数分布蒸馏(式 17)把教师的排序偏好压进双塔参数,在线只剩一次 user 侧编码 + 点积。这是一个更彻底的效率取舍:本文放弃了在线的细粒度交互(代价体现在 Table 1 的 NDCG 上——TT 的 N@5 在 Beauty 上比 ORT 低 32.9%),换取了纯 ANN 的服务形态。此外 DaV-Gen 仍保留 RQ-VAE / SID 与生成式损失 $\mathcal{L}_{\mathrm{gen}}$,本文把离散标识符整条路径删掉。
- 可比的方法 / 实验差异。两者都用复合损失把"检索表示"与"排序偏好"对齐:DaV-Gen 用 $\mathcal{L}_{\mathrm{total}}=\lambda_1\mathcal{L}_{\mathrm{ret}}+\lambda_2\mathcal{L}_{\mathrm{gen}}+\lambda_3\mathcal{L}_{\mathrm{pair}}$ 在单一模型内对齐 draft 与 verify;本文用 $\mathcal{L}_{\mathrm{TT}}=\mathcal{L}_{\mathrm{con}}(s_{\mathrm{TT}})+\lambda_{\mathrm{KD}}\mathcal{L}_{\mathrm{KD}}$ 在两个模型之间对齐。DaV-Gen 报告了端到端延迟数字(视频搜索 ~70ms,相对级联 2.5×)与 +2.09% Avg Time Spent 的线上收益;本文报告的是 QPS 增益的分项拆解(Table 4)而非端到端延迟,且无线上业务指标。
VCG VCG:在"极端冷启动"下用多模态检索做电商短视频召回(Zalando / TU Wien,2026-06-17)¶
关系:独立并发(本文未引用 VCG)· 已加载对方精读
- 共同关注的问题。VCG 提供了本文标题命题的独立经验证据,且是从表征几何角度给出的:生成式(LLM)embedding 因各向异性(anisotropy)与表征坍塌——embedding 挤在向量空间一个狭窄的锥体里——而严重削弱判别力,不适合做向量检索;判别式对比模型才是召回引擎的正确选择。本文没有做这类嵌入空间分析,它的论证是运维与效果层面的(服务成本、解码延迟、grounding 误差级联)。两条论证互补地指向同一结论。
- 相近的技术骨架。同为双塔 + 离线预计算 item 侧 embedding + 在线点积/ANN 检索,且都刻意保证"在线只有一次向量相似度检索、没有任何排序模型在线打分"。VCG 的在线开销实测 P50 17.5ms / P99 30ms,与本文 §5.3 "数百毫秒内取回候选"的设计目标同构。
- 本文的差异与推进。训练信号完全不同:VCG 是 zero-shot 的——直接用在 2 亿图文对上微调过的领域适配 CLIP(zmCLIP)编码视频帧与商品,user 侧用时间衰减加权平均聚合(式 2),不需要任何交互训练数据;本文则是在推荐数据上做完整 SFT,且额外叠了 cross-encoder 教师蒸馏与隐式推理。因此 VCG 解的是"新内容零交互历史"的极端冷启动,本文解的是"如何在有充足交互数据时把双塔推到 SOTA-comparable"。两者在尾部 / 冷启动上的结论方向一致——本文报告尾部 item NE +5.5%,归因于"当交互历史稀疏时语义表示的潜力最大",这正是 VCG 的立论前提。
- 可比的方法 / 实验差异。VCG 记录了一个本文没有的负面经验:其 v1(复用主目录推荐系统的 user 塔 + 从零训 metadata video 塔)线上 A/B 失败,三条失效模式为语义鸿沟、metadata 稀疏、缺乏视觉信号——这与本文"共享编码器一致优于分离编码器"(Appendix F)指向同一件事:两塔若不在同一个语义流形上被塑造,双塔就退化为流行度偏置机。VCG 有线上收益(深度视频完播 +50%),本文无线上 A/B。
讨论与局限性¶
值得借鉴的设计¶
- "把强模型编译进弱模型"而非"在线跑强模型"。CE2TT 分数分布蒸馏(式 17)+ Appendix F 的负面结论(embedding-level $L_2$ 匹配更差)共同给出一个可复用的经验:蒸馏排序偏好(相对序)优于蒸馏表示(绝对位置)。这与检索任务的本质一致——ANN 检索只关心相对序。
- 非对称的推理位置。隐式推理只加在 user 塔、且只加一步,item 塔保持纯编码。这是"想给双塔加表达力但又不能破坏可预计算性"的标准答案,Appendix F 的消融(item 塔加隐推理无用、user 塔多步无用只涨显存)把这个设计的边界界定得很清楚。
- Staleness 韧性作为一个独立的价值维度。Table 5 把"不重训也不腐坏"量化成了可比数字。对任何在评估"要不要上 LLM 表征"的团队,这条比 NE 提升更值得算 ROI——它直接影响重训频率与训练算力预算。
- 数值特征的 FSQ soft-token 化。把连续特征 digit-level tokenize 会炸上下文,用 64 个 FSQ bin 的可学习 embedding 注入为 soft token,QPS +19.7% 且 NE 还改善 0.3%——这是把 LLM 塞进工业推荐链路时的一个实用小配方。
局限与可争议之处¶
- "SoTA-comparable"的措辞偏宽松。双塔学生的 R@10 全面胜过 ORT,但 NDCG 明显更弱(Beauty N@5 −32.9%、N@10 −19.3%;Toys N@5 −11.2%)。论文用"两模型角色互补"一句带过,但这恰恰暴露了因子化架构的固有上限:能召回、排不准。作为召回层这可接受,但摘要中"achieves SoTA-comparable retrieval performance"的表述掩盖了这个结构性代价。
- 没有线上 A/B 业务指标。摘要称内部实验产出 "substantial topline retrieval improvements",但正文报告的全是离线 NE(+2.25%、尾部 +5.5%、头部 +2.3%)与 QPS,没有任何 CTR / 时长 / GMV 类的线上收益,也没有说明系统是否已全量。相比 EGR(CVR +2.91% 并全量)与 DaV-Gen(Avg Time Spent +2.09%),本文的工业证据链在最后一环是断的。
- 公开实验的对比条件需要留意。所有 baseline 数值直接取自 ORT 论文的 Table 1 而非重跑,评估协议与负采样细节是否完全一致无法自证。"我们用 0.6B 打赢它的 8B"是有力的效率论点,但同时也意味着本文并未在同等骨干规模下与 ORT 对比——ORT 若换成 0.6B 会怎样、本文若换成 8B 会怎样,都没有数据。
- 数据集规模偏小。三个 Amazon 子集(1.9–3.6 万用户、1.2–1.8 万 item,序列中位长度仅 6)对"web-scale 检索"这个命题的支撑力有限;真正支撑立论的是内部实验,而内部实验的细节(数据规模、item 量级、模型是否上线)被抽象掉了。
- 方法本身的组件新颖性有限。共享编码器、EOS pooling、跨数据集 mid-train、KD、Coconut latent step 都是已有技术;本文的贡献主要在组合、消融的系统性、以及工业验证上,而非新机制。相对新的只有"verbalized yes/no logit 差 + user-conditioned NTP"这个教师配方,而其中 yes/no 头单独用时在 Sports 上还会全面退化。
- 方法论可扩展性的双面性。正面看,LLM 骨干提供了清晰的 scaling 轴(Table 7:0.6B→4B +1.90%,MoE +0.91%,latent reasoning +0.41%),且稳定 token 词表让数据 scaling 曲线优于 DLRM(Table 6)。负面看,检索期的因子化点积是一个硬天花板:无论骨干怎么放大,user 与 item 在打分时都不能交互,NDCG 的差距不会因为 scaling 而自动闭合;能扩的只有"如何表征",扩不了"如何交互"。论文自己也承认 CE 教师的 NE 领先(+2.25%)代表"检索器还有 headroom"——这个 headroom 本质上就是因子化损失,蒸馏只能逼近、不能消除。
与已有工作的差异(总结)¶
相对生成式路线(TIGER / OneRec 系 / PLUM),本文删掉了离散标识符与自回归解码整条路径,因此也删掉了 grounding 层与其误差级联;相对经典 DLRM 双塔,本文把 ID embedding 换成 LLM 语义表征,换来了数据效率、staleness 韧性与更好的 scaling 曲线;相对 dual-encoder 蒸馏的既有工作(Menon et al. 2022 等),本文的增量是把教师从 BERT 级 cross-encoder 换成 LLM 并额外挖掘 verbalized 打分与 user-conditioned NTP 两个新监督源。如果只带走一句话:在召回层,"把 LLM 用作编码器"目前仍然比"把 LLM 用作生成器"更划算——但代价是你要接受因子化打分的精度天花板,并把细粒度交互留给下游排序阶段。