EGR: Embedding-Native Generative Retrieval with a Shared LLM¶
Snap Inc. · arXiv 2607.23038 · 2026-07-25 · cs.IR
研究动机与背景¶
现代推荐与广告系统的召回层(candidate retrieval)面对的是一个动辄数亿量级、且持续变化的商品目录:每次请求都要在严格的延迟与可靠性预算下,从中挑出一小撮相关物品。一个可用的召回器必须同时兼顾个性化、目录覆盖率、内容新鲜度与运维简洁性四件事。
工业界的召回栈长期建立在双塔(two-tower)embedding 模型及其序列化扩展之上:把 query 与 item 编码进一个共享向量空间,用近似最近邻(ANN)检索候选。生成式检索(Generative Retrieval, GR)提出了另一条路线:让序列模型以用户历史为条件,直接产出下一个目标——要么是一串 item 标识符 token,要么是一个稠密检索表示。这条路线在学术 benchmark 和近期的工业部署中都已展现出说服力。
论文把已有 GR 方法归为两大家族,并指出各自的结构性代价:
(一)SID-based GR(基于语义 ID)。以 TIGER、PLUM、DAS、IDGenRec、GRLM 为代表,把 item 映射为离散的语义标识符序列,再训练一个生成器自回归地吐出这些序列。这条路线需要四个部件同时在线:item encoder、quantizer(量化器)、generator(生成器)、grounding layer(把生成的 token 序列接回真实 item 的对齐层)。更麻烦的是,目录更新(新品上架、属性变更)要求给新 item 或变更 item 重新分配标识符——这意味着可变的 ID 词表,牵一发而动全身。
(二)Embedding-based GR(基于嵌入)。以 Pinterest 的 PinRec、电商的 TBGRecall 为代表,直接产出连续向量做 ANN 检索,绕开了离散标识符。但这一族普遍采用两塔分离结构:item encoder 与 query generator 是分开训练的——item embedding 模型先训好或先预训练,然后在训练 query 侧时被冻结。其后果是:被索引的 item 空间在 query 侧开始学习之前就已经定形,item embedding 从来没有为生成式检索目标本身优化过,user-item 对齐因此受限。
论文把这两族的共同病根提炼为一句话:item 表示空间与 user/query 表示空间之间,要么隔着一层离散标识符(SID 路线),要么隔着一次"先冻结再训练"的时间割裂(embedding 路线)。二者都不是端到端地把两个空间一起塑形出来的。
由此提出 EGR(Embedding-Native Generative Retrieval):用一个共享的 LLM backbone同时走两条路径——item 路径把 item 元数据编码成稠密向量,直接写进 ANN 索引;user-history 路径把按时间排序的交互序列编码成一个稠密 query 向量。两条路径共享参数、共享投影头,并被联合优化,使得被索引的 item 空间与用户条件化的 query 空间是"一起长出来的",而不是分开训完再拼起来。
三族方法的对比可以画成:
flowchart LR
  subgraph A["(a) SID-based GR"]
    A1[Item] --> A2[Embedding Model] --> A3[Quantizer] --> A4[SID Vocab]
    A5[User History] --> A6[Generator] --> A7[Grounding] --> A8[Retrieved Items]
  end
  subgraph B["(b) Embedding-based GR"]
    B1[Item] --> B2[Embedding Model] --> B3[ANN Index]
    B5[User History] --> B6[Query Encoder] --> B7[ANN Search] --> B8[Retrieved Items]
    B2 -. frozen .-> B6
  end
  subgraph C["(c) Embedding-Native GR (EGR)"]
    C1[Item] --> C3["LLM / MLLM<br/>(shared, jointly trained)"]
    C2[User History] --> C3
    C3 --> C4[ANN Index]
    C3 --> C5[ANN Search] --> C6[Retrieved Items]
  end
(对应原文 Figure 1。(a) 训练生成器吐 SID token 序列,服务时需 grounding 回真实 item;(b) item encoder 先训好后冻结,索引空间不为生成式检索目标优化;(c) EGR 用一个共享 backbone 同时编码 item 与 user history,两个空间联合演化。)
论文的三点贡献:
- 提出 embedding-native GR 设计,同时移除了 SID 路线的量化与 grounding、以及 embedding 路线的 item/user 编码器分离,同时保留标准 ANN 服务;
- 用共享 LLM 在同一空间原生对齐 user 与 item 表示,借力预训练先验实现多模态与冷启动泛化,并用 item-pair 与 history-to-target 两个对比目标联合训练;
- 在公开 benchmark、工业规模数据与线上部署三个层面评估:在 Amazon Reviews 上超过已发表 baseline;在 Snap DPA 上(i)随数据量单调 scaling,(ii)冷启动 item 上依然强健,(iii)受益于多模态输入;线上 A/B CVR +2.91%。
核心方法 / 模型架构¶
总体框架¶
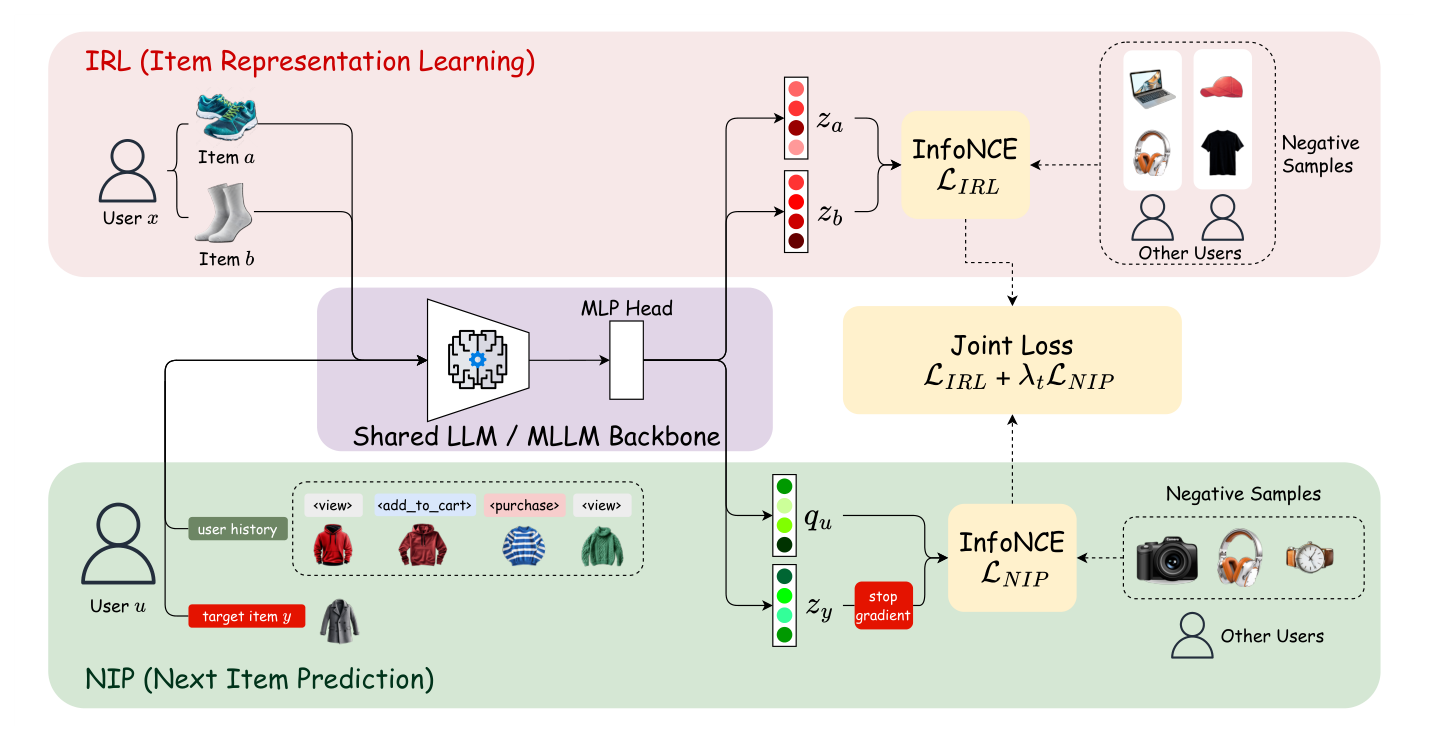
EGR 学习一个同时容纳 item 与 user-conditioned query 的共享嵌入空间。每个 item 由其元数据表示(title、brand、category、image);每个 user 由一串按时间排序的 engagement 事件表示,每个事件包含一个转化类型(conversion type)和一个 item。
一个共享 LLM backbone $f_\theta$ 编码两类输入,其后接一个投影头(projection head)$h_\phi$,把 backbone 的隐状态压到更低维的检索嵌入,以便紧凑地做 ANN 服务。item 路径把 item 元数据映射为被索引的 item embedding;user-history 路径把最近的 engagement 映射为 query embedding。
因为两条路径共享参数、且向量落在同一空间里,"预测下一个 item"这件事就退化成了"稠密检索":推理时 EGR 只需发出一个 query 向量,用最大内积(maximum inner product)取回 item。论文把这个设计称为 embedding-native——它从不预测 item 专属的 token、不量化 item 向量、也不把生成的标识符 ground 回 item。两条路径由下面两个对比目标联合优化。
Item Representation Learning(IRL)¶
Item encoder。设 item $i$ 的元数据为 $x_i$(title、brand、category、image)。IRL 用共现(co-engagement)对比学习训练 item embedding。编码器把 $x_i$ 序列化成一个定长 prompt,送入共享 LLM backbone $f_\theta$,再过投影头 $h_\phi$,产出一个 L2 归一化向量:
$$z_i = \frac{h_\phi(f_\theta(x_i))}{\|h_\phi(f_\theta(x_i))\|_2} \tag{1}$$
这个 $z_i$ 被直接插入 ANN 索引。与 SID 系统不同,$z_i$ 不被量化,因而不需要 token-to-item 的 grounding;一个新 item 或更新过的 item,只要它的元数据被编码完成,就可以立刻进入索引——这正是 EGR 在运维上最直接的收益。
Pair contrastive objective。对来自同一用户时序序列的一组连续共现 item 对 $(p_a, p_b)$,IRL 施加一个对称 InfoNCE 损失:
$$\mathcal{L}_{\text{IRL}} = \frac{1}{2}\big[\text{InfoNCE}(z_a, z_b) + \text{InfoNCE}(z_b, z_a)\big] \tag{2}$$
其中
$$\text{InfoNCE}(a, b) = -\log \frac{\exp(a^\top b / \tau)}{\sum_{b' \in \mathcal{N}} \exp(a^\top b' / \tau)}$$
$\mathcal{N}$ 是 in-batch 负样本集合,$\tau$ 是可学习的温度,所有向量均已 L2 归一化。IRL 用共现结构来塑造那个"之后会被索引用于检索"的 item 空间——注意它塑造的正是索引空间本身,而不是某个辅助空间。
Next Item Prediction(NIP)¶
History encoder。设用户 $u$ 由时序历史 $H_u = (e_1, \dots, e_T)$ 表示,其中每个 $e_t$ 是一个(转化类型,item)事件。NIP 训练 user-history 编码器产出一个能检索到目标 item 的 query。EGR 把 $H_u$ 按从旧到新的顺序序列化,并在每个事件前加上一个转化类型 token(<view>、<add_to_cart>、<purchase>)以反映不同的用户意图,事件之间用分隔符连接。序列化后的历史经过同一个 backbone 与同一个投影头编码:
$$q_u = \frac{h_\phi(f_\theta(H_u))}{\|h_\phi(f_\theta(H_u))\|_2} \tag{3}$$
服务时,$q_u$ 通过对已索引的 $z_i$ 做最大内积来检索 item。
History-to-target objective。NIP 损失是一个 history-to-target 的 InfoNCE,并在目标 embedding 上加 stop-gradient:
$$\mathcal{L}_{\text{NIP}} = \text{InfoNCE}\big(q_u, \text{sg}(z_y)\big) \tag{4}$$
其中 $y$ 是目标 item,$\text{sg}(\cdot)$ 表示 stop-gradient。
这里的设计动机值得展开:目标 embedding $z_y$ 在每一步都由当前 backbone 重新计算(因此它始终跟随 item 空间演化,不是一个陈旧的缓存),但 stop-gradient 阻止 $\mathcal{L}_{\text{NIP}}$ 对该样本的目标分支做参数更新。由于 backbone 是共享的,NIP 的梯度仍会经由 history 分支更新模型,并通过共享参数间接影响未来的 item embedding。stop-gradient 的作用是防止"逐样本的目标侧拉扯"把已索引的 item 空间搅得不稳定——即让 item 空间主要由 IRL 的全局共现结构决定,而不是被每一条训练样本的目标项直接拽动。
联合训练¶
总目标。EGR 在同一个共享 backbone 上联合优化 IRL 与 NIP:
$$\mathcal{L} = \mathcal{L}_{\text{IRL}} + \lambda_t \mathcal{L}_{\text{NIP}} \tag{5}$$
Warm-up schedule(热身调度)。训练分两阶段:前 10% 的步数只激活 $\mathcal{L}_{\text{IRL}}$(即 $\lambda_t = 0$),给 item 空间一个初始的共现结构;热身之后,$\lambda_t$ 从 0.1 线性上升到 1.0。
联合训练动力学。IRL 把 backbone 锚定在 item-pair 结构上,而 NIP 训练用户历史去检索未来 item。其结果是:被索引的 item 空间与 query 侧一起演化,而不是在 item 空间被冻结之后再强迫 query 侧去对齐它。§4.4.1 用消融对比了这一配置与"解耦任务""去掉 stop-gradient""不共享 backbone"三类替代方案。
服务架构¶
离线索引。EGR 把 item 索引构建与 query 生成解耦。item embedding 可以周期性或准实时地计算(取决于成本与新鲜度的权衡),写入 ANN 索引;因为 embedding 已 L2 归一化,最大内积检索等价于余弦检索。
Query 检索。EGR 支持两种 query 服务模式。在实际部署的流水线中(§4.5),每个用户的 query embedding 每天生成一次、存在服务层;每次请求时,系统载入这个预计算 embedding,在当前商品索引上做在线 ANN 检索,把 top-$K$ 商品送往下游排序。对于会话内意图会变化的场景,同一条编码路径也可以在请求时运行:实时序列化用户近期 engagement、在线跑 user-history 路径、取回 top-$K$,代价是更高的单请求服务成本。
三点运维优势(论文明确列出): 1. item encoder 在每次请求时都不产生成本——因为 item 是离线索引的; 2. 输出是稠密向量,服务可以复用标准 ANN 基础设施,而不需要 token 生成栈(beam search、trie 约束、grounding 全部不需要); 3. 新 item / 更新 item 可以直接重新编码后插入索引,无需重建 SID 词表,也无需为新增的 item 专属 token 重训生成器。
实验设置¶
数据集。公开 benchmark 用 Amazon Reviews 的三个类目:Beauty、Sports、Toys;沿用既有做法采用 5-core 过滤与 leave-one-out 划分。工业评测用 Snap Dynamic Product Ads(DPA) 的用户-商品互动日志(该节中 "product" 与 "item" 混用),留出 100 万条用户序列做评测,其余用于训练。
指标。离线检索报 Recall@10(R@10)。线上部署报 impressions、CTR、CVR 的相对提升;依 Snap 政策,Snap 数据上的实验只报相对数。
输入格式。两条路径都使用模型的 chat template。
- 商品路径:system instruction 为
"Represent this product for retrieval.",user message 形如Title: ..., Brand: ..., Category: ...。 - 用户历史路径:system instruction 为
"Predict the next product this user will interact with.",user message 逐条列出 engagement,每条为⟨conv_token⟩后跟商品文本,事件间用|分隔。例如:
<view> Title: Galaxy Watch, Brand: Samsung, Category: Electronics |
<add_to_cart> Title: Coffee Maker, Brand: Philips, Category: Kitchen |
<purchase> Title: Running Shoes, Brand: Nike, Category: Footwear
实现细节。
- Backbone:Qwen3-VL-Embedding 2B,last-token pooling;
- 投影头:两层 MLP(LayerNorm、GELU、dropout),从零训练,输出 L2 归一化的 512 维 embedding;
- LoRA:$r = 128$、$\alpha = 256$,作用于 q/k/v/o 注意力投影,可训练参数约 41M(主要在 LoRA 矩阵与投影头);
- 优化:用 AdamW 优化 LoRA 矩阵、投影头与可学习温度,学习率 $2\times10^{-5}$,短暂 warm-up 后 cosine decay;
- 规范配方:1 个 epoch,8 张 H100,每 GPU batch size 64,最大历史长度 20(平均约 4000 输入 token);
- 负样本:in-batch negatives 跨所有 DDP rank 聚合,本地 batch $B$、$W$ 张 GPU 时每个 anchor 得到 $B \times W$ 个负样本。
主要实验结果¶
公开 Amazon Reviews Benchmark¶
对比四个代表性序列推荐 baseline:
- BERT4Rec:双向 transformer,用 masked-item(cloze)目标经 item 词表 softmax 预测;
- SASRec:因果自注意力序列模型,next-item 预测,item embedding 作为模型参数;
- TIGER:SID-based 生成式检索器,把 item 内容 embedding 量化为离散语义标识符序列,训练 transformer 自回归生成;
- HSTU:工业规模生成式推荐的分层序列转换器。
Table 1:Amazon Reviews 上的 Recall@10(每列最优加粗)
| Method | Beauty | Sports | Toys |
|---|---|---|---|
| BERT4Rec | 0.0396 | 0.0175 | 0.0332 |
| SASRec | 0.0607 | 0.0301 | 0.0626 |
| TIGER | 0.0623 | 0.0347 | 0.0547 |
| HSTU | 0.0652 | 0.0343 | 0.0566 |
| EGR (ours) | 0.0655 | 0.0362 | 0.0807 |
结论分析。EGR 在三个类目上均取得最优。但幅度差异很值得注意:在 Beauty 上与 HSTU 基本打平(0.0655 vs 0.0652,+0.5%);在 Sports 上小幅超过 TIGER(0.0362 vs 0.0347,+4.3%);唯独在 Toys 上拉开明显差距(0.0807 vs 次优的 SASRec 0.0626,+28.9%)。论文本身对这个不均衡没有给出机制解释。一个合理的推测是:Toys 类目的商品标题/品牌/类目文本语义区分度更高,因此从预训练 LLM 继承的内容先验能提供更多增益;而在 Beauty 这类语义高度同质的类目里,内容先验的边际价值下降,EGR 就退化到与纯行为模型 HSTU 相当的水平。这也提示 EGR 的收益并非来自"生成式"本身,而是来自"共享 LLM 内容先验 + 联合对齐"。
Snap DPA 离线结果¶
数据 scaling¶
在 10K 到 10M 用户的四个 matched-event 子集上训练 EGR。
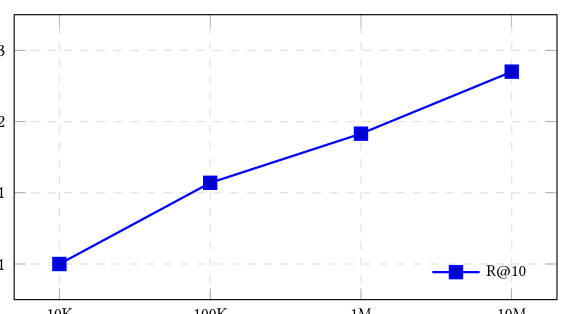
发现:R@10 随训练数据单调上升,从 10K 到 10M 用户增长 27%,且未观察到饱和。这说明在工业规模上继续加数据仍能持续改善检索质量——对一个只训 41M 参数(LoRA + 投影头)的配方来说,这个 scaling 行为是站得住的卖点。
冷启动与频次分层¶
按每个目标商品在训练输入中出现的频次对离线测试集分层(频次定义为该目标商品在训练数据中作为输入出现的次数)。冷启动层(频次 = 0)是模型从未在训练输入里见过的商品;头部层(频次 > 15)是最常见的商品。R@10 相对头部层归一化为 100%。
Table 2:按目标商品训练输入频次分层的 EGR 检索表现
| Count | % of test samples | rel R@10 |
|---|---|---|
| 0 | 31.3% | 94.9% |
| 1 | 8.0% | 99.1% |
| 2 | 6.0% | 111.5% |
| 3 | 4.3% | 112.7% |
| 4 | 3.6% | 117.6% |
| 5 | 2.8% | 115.4% |
| 6–10 | 9.4% | 119.1% |
| 11–15 | 5.3% | 116.8% |
| > 15 | 29.2% | 100.0% |
结论分析。EGR 检索从未见过的商品时只有有限退化:冷启动层的 R@10 仅比头部层低 5.1%。这直接印证了"item 由元数据经共享 LLM 编码、无需 item 专属参数或 SID 词表条目"带来的冷启动优势——这正是 atomic ID 与 SID 两条路线都要额外费力处理的问题。
但论文在此处的自我限定非常克制且诚实:中频层(2–15)得分最高,这个非单调模式说明"目标频次之外的其他因素"也在影响检索质量;由于分层完全按目标频次定义,该实验并不能隔离这些混杂因素。因此,强冷启动结果只能说明"对未见商品是稳健的",不能说明冷启动已与表现最好的中频层持平。
多模态输入¶
默认的 Qwen3-VL-Embedding 2B backbone 自带 vision tower,可接受多模态商品输入。在同一 backbone 上比较两种配置:text-only(用 title、brand、category 编码商品)与 multimodal(额外把商品图片喂进 vision tower)。
Table 3:同一 backbone 下多模态 vs 纯文本商品输入的 R@10(相对 text-only 归一化为 100%)
| Modality | rel R@10 |
|---|---|
| Text-only | 100.0% |
| Text+image | 106.9% |
结论分析。加入商品图片使 R@10 相对提升 +6.9%。关键点在于:EGR 不需要改动检索架构就能吃到多模态商品证据——因为多模态只是换了 item 路径的输入,embedding 的产出形式、索引方式、检索方式完全不变。这与 SID 路线形成对比:后者引入图像通常意味着要重训 tokenizer、重建码本、重新分配 SID。
Snap DPA 消融研究¶
联合训练的有效性¶
对比 EGR 与四种替代配置,R@10 相对完整 EGR 配方归一化为 100%。列含义:IRL(是否有 item 表示学习)、NIP(是否有 next-item 预测)、JT(是否在共享 backbone 上联合优化)、SG(NIP 中目标 embedding 是否加 stop-gradient)。
Table 4:联合训练消融
| Method | IRL | NIP | JT | SG | rel R@10 |
|---|---|---|---|---|---|
| EGR (ours) | ✓ | ✓ | ✓ | ✓ | 100.0% |
| EGR w/o stop-grad | ✓ | ✓ | ✓ | — | 95.3% |
| NIP only | — | ✓ | — | ✓ | 93.7% |
| IRL only | ✓ | — | — | — | 26.6% |
| Two models | ✓ | ✓ | — | — | 86.2% |
各配置说明:
- EGR (ours):共享 backbone 上 IRL + NIP 联合训练,NIP 目标 embedding 带 stop-gradient;
- EGR w/o stop-grad:同上但去掉 stop-gradient;
- NIP only:同一 backbone 只训 NIP;
- IRL only:同一 backbone 只训 IRL;
- Two models:模型 1 训 IRL 后冻结,模型 2 用模型 1 产出的 embedding 作为输入训 NIP(即复刻 embedding-based GR 的两塔分离范式)。
结论分析(四点,逐条对应论文 findings):
- 去掉 IRL 只留 NIP,相对 R@10 从 100.0% 掉到 93.7%——说明即使 history-to-target 损失已在起作用,item-pair 对比学习仍是必需的。也就是说,query 侧的监督并不足以自行把 item 空间组织好。
- 只有 IRL 仅达 26.6%——共现结构是一个有用的 item 空间锚,但远不足以完成 next-item 检索。这条结果排除了"EGR 的收益主要来自一个好的 item embedding"的解释。
- 去掉 NIP 目标分支的 stop-gradient,R@10 降至 95.3%——与"stop-gradient 稳定了被索引的 item 空间"这一设计动机一致。
- 冻结 item 侧、单独训一个 query 模型(Two models)只到 86.2%——这是全表最有分量的一条:它直接量化了 embedding-based GR 两塔分离范式的代价约为 13.8%。论文据此下结论:"联合塑造 item 与 query 空间、并在目标分支加 stop-gradient,比消融掉任一目标或让 query 生成器去对齐一个冻结的 item encoder 都更有效。"
损失调度¶
对比联合训练目标的三种损失调度:
- Joint(本文):IRL 权重全程固定为 1,NIP 权重 $\lambda_t$ 在热身后从 0.1 线性升到 1.0;
- Balanced:IRL 权重按 $1-\lambda_t$ 衰减、NIP 权重按 $\lambda_t$ 上升,故总损失权重恒定;
- Sequential:IRL 只在训练前半段激活,NIP 只在后半段激活,无重叠期。
Table 5:训练损失调度消融(相对 Joint 归一化)
| Variant | IRL Schedule | NIP Schedule | rel R@10 |
|---|---|---|---|
| Joint (ours) | fixed at 1 | $\lambda_t$: 0.1 → 1.0 | 100.0% |
| Balanced | $1 - \lambda_t$ | $\lambda_t$ | 97.9% |
| Sequential | first 50% only | last 50% only | 74.4% |
结论分析。全程维持 IRL 是关键。Balanced 只落后 Joint 约 2%,说明即使 IRL 权重被衰减,只要它没被完全关掉,item 空间就大体保持完整。而 Sequential 落后约 26%:当 IRL 在前半段之后被彻底关闭,NIP 就必须去对齐一个不再被共现结构直接锚定的商品空间。因此两个损失同时激活的"重叠期"才是训练配方的核心——这条消融比 Table 4 的 "Two models" 更细粒度地说明:问题不在"是否先训过 IRL",而在"IRL 是否在 NIP 学习期间仍然在场"。
线上 A/B 实验¶
在 Snap DPA 上进行了为期两周的线上 A/B。实验组把 EGR 作为一路额外的检索源加入,同时保持总候选配额不变;对照组维持不含 EGR 的现有生产检索栈。两组各获 10% 流量,通过 Snap 的实验平台分流。
EGR 以批量 + 在线混合的检索流水线运行:每个用户的 query embedding 每天计算一次并存储供服务使用;请求时系统用这个 embedding 做实时 ANN 检索,把取回的候选转交下游排序。下游排序、竞价策略与渲染在两组之间完全固定。
Table 6:Snap DPA 线上 A/B(10%/10% 用户流量)——EGR 实验组相对对照组的提升(依 Snap 政策隐去绝对值)
| Metric | Relative lift |
|---|---|
| Impressions | +0.15% |
| CTR | +0.23% |
| CVR | +2.91% |
结论分析。把 EGR 加进生产检索栈使 impressions +0.15%、CTR +0.23%、CVR +2.91%。论文强调一个重要的因果论证:由于总候选配额在两组之间是恒定的,CTR 与 CVR 的收益反映的是"检索质量变好",而不是"多分到了候选名额"——这排除了"多加一路召回自然多占坑"的平凡解释。
补充的源级别(source-level)数据更说明问题:在最终投放给用户的全部 impressions 中,5.3% 来自 EGR;而 EGR 这一路的 CTR 与 CVR 分别是全部生产检索源平均值的 1.55× 与 1.53×(这些源包括 user-to-item(U2I)、item-to-item(I2I) 与非个性化检索器)。A/B 之后 EGR 已在 DPA 全量推开,现服务 100% 用户。
核心贡献总结¶
- 诊断层面:把 SID-based GR 与 embedding-based GR 的痛点统一归因为"item 空间与 query 空间被离散标识符层或两阶段冻结所割裂",并用 Table 4 的 "Two models" 一行(86.2%)量化了这个割裂的代价。
- 方法层面:提出 embedding-native 范式——单一共享 LLM/MLLM backbone + 单一投影头同时产出 item embedding 与 user query embedding,IRL(对称 item-pair InfoNCE)+ NIP(history-to-target InfoNCE,目标侧 stop-gradient)联合训练,配合 IRL 全程在场的 warm-up/ramp 调度。
- 工程层面:彻底移除 quantizer、可变 SID 词表与 grounding 层,推理退化为标准 MIPS/ANN 检索,新品可即时入索引;训练只需 LoRA(~41M 可训练参数)+ 8×H100 × 1 epoch,成本极低。
- 验证层面:公开 benchmark(Amazon Reviews 三类目全面最优)、工业离线(数据 scaling +27% 无饱和、冷启动仅退化 5.1%、多模态 +6.9%)、线上 A/B(CVR +2.91%,已全量)三层闭环。
与已归档相关工作的对比¶
Semantic IDs for Recommender Systems at Snapchat: Use Cases, Technical Challenges, and Design Choices Semantic IDs for Recommender Systems at Snapchat(Snap Inc., 2026-04-05)¶
关系:同机构、同问题、相反技术路线(本文未引用该文,两者是 Snap 内部两条并行下注)· 已加载对方精读
- 共同关注的问题:两篇论文都出自 Snap Inc.,相隔仅 3.5 个月,且面对的是同一个 root cause——atomic ID 表示在大规模推荐中的三重失效:参数爆炸、冷启动无 embedding 入口、长尾因稀疏监督而欠训练。两文都试图用"由内容/基础模型导出的 item 表示"来取代 per-item 可学习 embedding,并且都把该表示同时用于排序特征与生成式检索目标这两类下游场景。
- 相近的技术骨架:两者的前半段几乎重合——用(多模态)基础模型把 item 的元数据/多模态内容编码成语义向量,再把这个语义向量作为检索侧的 item 身份。分歧发生在下一步。
- 本文的差异与推进:SID 论文选择继续往下走离散化:用 RQ-VAE 类 tokenizer 做残差量化(并需 STE 优化、多模态 embedding 融合来缓解 codebook collapse),最后还得靠启发式的 intra-bucket disambiguation 把 SID 解析回具体 item。EGR 的立论恰恰是这后半段全都不必要:既然语义向量已经在手,直接 L2 归一化写进 ANN 索引即可,量化、码本、可变词表、grounding 全部删除。尤其值得注意的是,SID 论文里花大力气工程化的 "SID-to-item resolution 启发式",正是 EGR 结构上根本不存在的那一层。
- 可比的方法/实验差异:SID 论文的核心工程负担集中在 tokenizer 侧(codebook collapse、bucket 冲突消解),EGR 的核心工程负担则转移到了联合训练的稳定性(stop-gradient、IRL 全程在场的调度)。两者对冷启动的解法也因此不同:SID 论文靠"新 item 也能被 tokenizer 分到语义相近的码字",EGR 靠"新 item 编码完即可入索引",后者在运维上更直接(EGR 冷启动层 R@10 仅比头部低 5.1%)。由于 EGR 未引用该文,也未做直接对比实验,Snap 内部这两条路线孰优并没有被同台量化——这是本文最遗憾的缺口。
DaV-Gen DaV-Gen: End-to-End Generative Retrieval via Draft-and-Verify(Alibaba HUJING, 2026-07-09)¶
关系:独立并发(本文未引用 DaV-Gen,两者相隔 16 天、殊途同归)· 已加载对方精读
- 共同关注的问题:两文都认定自回归 SID 解码是生成式检索的结构性负担,且都主张"生成式检索的价值不在于逐 token 生成,而在于统一的表示与统一的优化目标"。DaV-Gen 把矛头对准 AR 解码的延迟与列表长度不可控;EGR 把矛头对准 SID 带来的量化 + 可变词表 + grounding 三件套。两者的共同结论高度一致:把检索的最后一步交还给 ANN/MIPS。
- 相近的技术骨架:两者的方法流程图能够抽象重合——都把 item 压成一个定长稠密向量并预计算进向量索引;都用用户上下文 embedding 与 item 向量之间的 InfoNCE 对比损失(DaV-Gen 的 $\mathcal{L}_{\text{ret}}$,公式与 EGR 的 $\mathcal{L}_{\text{NIP}}$ 结构同型)来塑造这个可检索空间;都在单一模型内联合优化多个目标以消除阶段间的目标不一致;推理时都先做一次 ANN 检索。
- 本文的差异与推进:分歧在于"ANN 之后还要不要再来一刀"。DaV-Gen 认为 ANN 只是"起草"(draft),必须再接一个并行验证阶段——用广播式前缀缓存在一次前向里对 N 个候选算生成似然 $\mathcal{L}_{\text{gen}}$,并用融合网络 + pairwise hinge loss 把 match 分与 gen 分组合成最终分。EGR 则彻底不要验证阶段:ANN 的 top-$K$ 就是最终召回结果,直接交给下游排序。相应地,DaV-Gen 保留了 RQ-VAE 与 SID(其 hybrid embedding 是"量化前的稠密向量 + SID 序列过 backbone 的 mean-pooling"之和),而 EGR 完全移除量化。可以说 DaV-Gen 是"保留 SID 但绕过 AR 解码",EGR 是"连 SID 一起删掉"——EGR 在架构简化上更激进,DaV-Gen 在单次检索精度上更用力。
- 可比的方法/实验差异:DaV-Gen 的核心收益是延迟(视频搜索 ~70ms,较级联快 2.5×,线上 Avg Time Spent +2.09%),EGR 的核心收益是运维简洁性 + 冷启动 + 多模态(CVR +2.91%)。两者也都做了跨阶段的联合训练消融,但 DaV-Gen 消融的是"三个损失分量的配比",EGR 消融的是"两个空间是否共享 backbone、是否加 stop-gradient"。若把两者叠加,DaV-Gen 的 Draft-and-Verify 完全可以架在 EGR 的无量化索引之上——这是一个两文都未探索的自然组合。
ResRank ResRank: Unifying Retrieval and Listwise Reranking via End-to-End Joint Training(Alibaba Qwen, 2026-04-24)¶
关系:独立并发、跨领域(文本 IR 而非推荐;本文未引用)· 已加载对方精读
- 共同关注的问题:两文对"解耦训练限制了 encoder 的输出空间"这一 root cause 的表述几乎逐字同构。EGR 批评 embedding-based GR "train the item encoder separately from the query generator, which limits user-item alignment";ResRank 批评 PE-Rank "先训 projector 做表征对齐、再训 reranker 做排序"的两阶段流程——"单独训出的 passage embedding 未必适合下游任务"。两文都进一步认为,自回归解码在这类任务里是可以被完全删除的冗余。
- 相近的技术骨架:三处骨架级重合。其一,同源同尺寸的 LLM 让中间投影层变得不必要——ResRank 特意选 Qwen3-Embedding-4B 与 Qwen3-4B 同 hidden dim,从而"完全不需要中间 projector 或 alignment 模块";EGR 更进一步,两条路径直接共用同一个 backbone 与同一个投影头。其二,用向量相似度替代自回归生成——ResRank 的余弦打分使"生成 token 数 = 0",EGR 的 MIPS 检索同样零生成。其三,端到端联合训练 + InfoNCE 做"防退化"锚——ResRank 保留 $\lambda=0.1$ 的 InfoNCE 正是为了防止 encoder 退化为 reranker 的内部表示、丧失独立检索能力;EGR 全程维持权重为 1 的 $\mathcal{L}_{\text{IRL}}$,动机同构,都是"用一个独立的表示学习损失把共享 backbone 锚住"。
- 本文的差异与推进:领域与阶段不同——ResRank 处理的是文本 IR 的召回 + 列表重排(候选数十到上百,需要 cross-passage 交互),EGR 处理的是推荐/广告的亿级召回(需要可预计算的静态索引)。这导致一个关键架构分歧:ResRank 的 passage 表示必须在 query 到来后过一次 reranker 才能获得 cross-passage 上下文($\mathbf{r}_i = \mathbf{h}_i^p + \mathbf{e}_i$),因此无法预计算成静态索引;EGR 的 item embedding 则完全 query-无关、可离线索引。另一处差异是"防退化锚"的方向:ResRank 用小权重 InfoNCE 保住 encoder 的独立检索能力,EGR 用 stop-gradient 保住 item 空间的稳定性——前者防能力丢失,后者防空间抖动。
- 可比的方法/实验差异:ResRank 的消融证实"去掉 InfoNCE 后排序指标几乎不变,但 encoder standalone retrieval 能力崩溃";EGR 的消融证实"去掉 IRL 后 R@10 掉 6.3%、只留 IRL 则掉到 26.6%"。两者从相反方向验证了同一个命题:共享 backbone 上的两个目标必须同时在场,缺一个就会有一侧的能力塌陷。
(初筛中被剔除的近似候选与理由:VCG(2606.19627,Zalando)虽同为"共享流形 + 点积检索",但其 root cause 是极端冷启动、配方是零样本冻结 CLIP、没有 user-item 联合对比训练,恰与 EGR "联合训练才是关键"的核心主张相反;AsymRec(2605.14512)虽同样诊断出"离散输入是信息瓶颈、连续表示更优",但解法反而加重量化(PQ×RQ×EMA×正交约束)以产出高保真离散监督,仍属 SID-生成式路线;UniPinRec / UniR2 / UniSGR(2606.00422 / 2607.24439 / 2607.04068)虽共享"单 backbone 联合训练"骨架,但统一的是召回与排序两个阶段,而非 item 空间与 query 空间,root cause 不同;Cluster GOOBS(2607.00448,Meta)同为双塔稠密检索 + 对比负样本,但问题是难负样本采样质量而非空间耦合;GR4AD(2602.22732)被本文在 related work 引用,但属 SID 路线的 baseline 关系,交由 DAG 结构化对比处理。)
讨论与局限性¶
值得借鉴的设计。
- "共享 backbone + 共享投影头"作为对齐的最强形式。相比"两塔各自训练再对齐"或"加一个 projector 桥接",EGR 用参数完全共享把对齐问题从"损失函数问题"降级为"架构问题"——两个空间物理上就是同一个空间,无需任何显式对齐项。Table 4 中 Two models 只到 86.2%,是对这个选择最直接的支撑。
- stop-gradient 的用法值得单独记一笔。它不是常见的"防止表示坍塌"(如 BYOL/SimSiam),而是防止索引空间被逐样本抖动:目标 embedding 仍随 backbone 实时重算(不陈旧),但不接受来自 NIP 的直接梯度。这是一个"要新鲜度但不要拉扯"的精巧折中,5.3% 的增益(100.0% vs 95.3%)不算大但很干净。
- "IRL 必须全程在场"这条调度结论。Table 5 中 Sequential 掉 26% 说明:表示学习损失不是热身工具,而是贯穿训练的结构性锚。这个结论对任何"先训表示、再训任务头"的两阶段配方都有警示价值。
- 成本效率极高。LoRA 41M 可训练参数、8×H100、1 个 epoch,就换来了线上 CVR +2.91% 与全量推开。这对希望复现"LLM 做召回"的团队是一个非常友好的成本锚点。
局限与争议。
- Amazon 上的增益极不均衡且未被解释。Beauty 上仅 +0.5%(与 HSTU 打平)、Sports +4.3%,只有 Toys 是 +28.9%。论文没有分析这个差异的来源。这削弱了"embedding-native 范式普遍优于 SID 范式"的一般性主张——更谨慎的读法是"当 item 文本语义区分度高时,共享 LLM 先验带来大增益;否则退化到与纯行为模型相当"。
- 冷启动结论被论文自己限定,但仍容易被过度解读。Table 2 的非单调模式(中频层 > 头部层)说明分层混杂了目标频次之外的因素,论文明确承认"该实验不能隔离这些因素",因此冷启动的 94.9% 只能证明稳健、不能证明与最佳层持平。这一自我限定值得肯定,但也意味着冷启动优势尚未被干净地量化。
- 缺少与最相关基线的正面对比。EGR 的核心论敌应当是 PinRec / TBGRecall 这类 embedding-based GR(它们正是"两塔分离"的代表),但论文只在 related work 提及、未做实验对比——Table 4 的 "Two models" 是作者自己搭的复刻消融,而非真实的 PinRec 实现。同样地,Snap 自家的 SID 论文(2604.03949)也未被引用或对比。
- 只做了"增量召回源"的 A/B,未做"替换"实验。线上实验是把 EGR 加进现有栈并保持总配额不变,这能证明 EGR 提供了增量价值,但不能证明 EGR 可以替代 SID 或双塔召回。考虑到论文的核心卖点是"简化系统设计",缺少替换实验使这个卖点在证据上是不完整的——目前 EGR 只是又加了一路,系统整体反而更复杂了。
- 单向量表示的固有天花板。EGR 把用户历史压成单个 512 维向量做 MIPS。已归档的 LIMIT(2508.21038, Google DeepMind)从 sphere-packing 与 sign-rank 角度证明了固定维度单向量检索无法表达所有 top-k 集合。EGR 未讨论这一理论限制,而这恰恰是 SID 路线(组合式 token 空间)在表达力上的潜在优势所在。
- 可复现性受限。Snap DPA 的所有数字均为相对值(依公司政策),线上与工业离线结论均无法被外部独立验证;公开 benchmark 部分只报了 R@10 单一指标,未报 NDCG@10,也未给出多次运行的方差。
工业落地价值。EGR 的部署细节交代得相当具体:批量 + 在线混合流水线(query embedding 每日一次预计算 + 请求时实时 ANN)、总候选配额恒定的 10%/10% 两周 A/B、下游排序与竞价完全固定。收益方面除 CVR +2.91% 外,源级别数据(占最终 impressions 的 5.3%,CTR/CVR 为全源平均的 1.55×/1.53×)比整体 lift 更有说服力,且已全量服务 100% 用户。对于正在纠结"要不要上 SID"的广告召回团队,本文提供了一个有线上证据支撑的"先别上量化"的反方论据。