MESH:面向异构内容统一的检索扩展框架¶
MESH: Scaling Up Retrieval with Heterogeneous Content Unification(Pinterest,RecSys 2026 Industry Track,arXiv 2607.12392v1)
研究动机与背景¶
大语言模型(LLM)的成功激发了推荐系统对「判别式 scaling law」的强烈兴趣——人们期望推荐模型的性能能随参数量和训练数据的增加而可预测地提升。为此,近年的工业架构(RankMixer、OneTrans、Longer、LONGER 等)纷纷采用高容量神经骨干:从因子分解机、基于 MoE 的 mixer,到巨型 Transformer 序列,普遍寄希望于「用扩大的模型容量来解决稀疏性与冷启动问题」。
但本文提出了一个被主流 scaling 叙事忽视的关键问题:不同于 NLP 中文本的均质模态,推荐信号本质上是异构的——更大的模型真的能让所有内容受益均等吗?
作者在 Pinterest 十亿级 Related Pins(图到图推荐)平台上做了大规模实证研究,观测到一个系统性的 scaling 发散(scaling divergence) 现象:随着模型容量增大,高频「常青(evergreen)」内容的性能稳步提升,但稀疏的「新鲜(fresh)」和「长尾(long-tail)」内容的精度增益却明显小得多。作者把这一现象命名为 异构性 Scaling Bias(The Scaling Bias of Heterogeneity)。
这一发散揭示了统一检索系统的一个重要挑战:扩充算力主要被用来精修热门物品的表示,形成「富者愈富(rich-get-richer)」的反馈回路,而新鲜和长尾内容的探索被边缘化。新内容因此被困在次优的 scaling 区间里,在「原始模型容量」与「整体生态健康」之间拉开了一道鸿沟。
为了在各内容层级上维持分段精度,工业界的常见做法是维护一个碎片化的专用双塔(two-tower, TT)模型「动物园(zoo)」——例如专门为冷启动检索维护独立的候选生成器(Candidate Generator, CG)。虽然这些任务专用模型能带来临时缓解,但它引入了巨大的工程开销、额外基础设施成本和运维负担(论文估计约 4 倍运营成本)。这些低效驱动了对一个「能同时服务异构内容层级、又不牺牲可扩展性与运维效率」的统一骨干的需求。
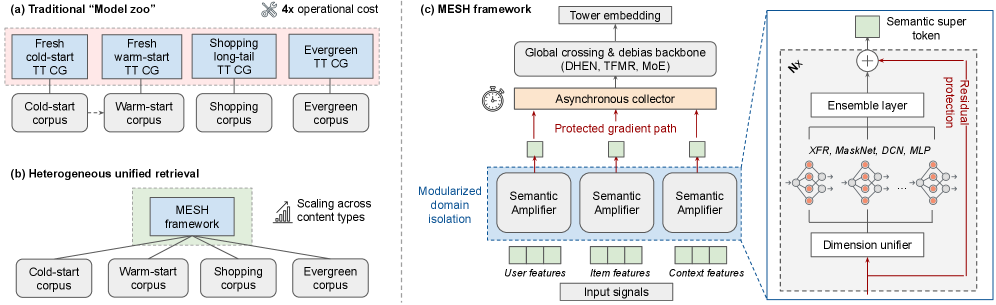
核心贡献三点:
- 异构检索 scaling(问题的发现与刻画):通过大规模实证研究,识别出扁平(flat)统一检索架构中的系统性 scaling 发散——容量增益在常青内容上显著强于新鲜和长尾内容,命名为「异构性 Scaling Bias」。
- 模块化统一检索架构(MESH):提出 MESH,一个在共享交互之前先解耦异构 user / item / context 信号的模块化统一检索架构,让单一检索骨干能更好地保留稀疏内容的学习信号,同时保持效率与可维护性。
- Pinterest 规模的工业验证:在十亿级 Related Pins 平台上验证 MESH,离线展示对新鲜内容改进的 scaling 行为,在线 A/B 测试在新鲜和长尾分段上取得实质增益,并带来 2.87× 服务效率提升。
论文的主张可概括为一句话:从「暴力的扁平 scaling」转向「结构化的语义 scaling」,为构建在异构内容上更公平扩展的统一检索骨干提供实用蓝图。
核心方法 / 模型架构¶
问题形式化:异构性 Scaling Bias 的成因¶
扩展判别式推荐模型的根本挑战在于「跨异构数据分布维持信号保真度」。工业平台的特征空间 $\mathcal{X}$ 由高度倾斜的分区构成:
$$\mathcal{X}=\{\mathcal{X}_{\mathrm{evergreen}}\cup\mathcal{X}_{\mathrm{fresh}}\cup\mathcal{X}_{\mathrm{tail}}\}$$
在传统扁平(flat)scaling 框架中,模型把一组「扁平」特征 $E=[e_{1},e_{2},\dots,e_{n}]$ 送入复杂的交互骨干 $H=\Phi(E;\Theta)$,其中 $\Phi$ 表示高阶交叉层(如 cross-network、Transformer、层级化演进结构)。损失 $\mathcal{L}$ 关于某个物品 embedding $e_{\mathrm{item}}$ 的梯度由链式法则决定:
$$\nabla_{e_{\mathrm{item}}}\mathcal{L}=\frac{\partial\mathcal{L}}{\partial H}\cdot\frac{\partial\Phi(E;\Theta)}{\partial e_{\mathrm{item}}} \tag{1}$$
在具有显式特征交叉的架构中(如 DCN、DHEN),这种「跨整个特征集的耦合」会让全局优化主要由高频常青内容驱动。结果是新鲜实体的梯度信号被 head 的统计特性有效地"掩盖(masked)"了。随着模型容量 $N$ 增大,这一结构性偏置导致常青实体的交互饱和、尾部信号被抑制,形成 scaling 差距:
$$\mathbb{E}_{\mathcal{X}_{\mathrm{fresh}}}[\|\nabla_{e_{\mathrm{fresh}}}\mathcal{L}\|]\ll\mathbb{E}_{\mathcal{X}_{\mathrm{evergreen}}}[\|\nabla_{e_{\mathrm{evergreen}}}\mathcal{L}\|] \tag{2}$$
这就是异构性 Scaling Bias 的本质:骨干网络为了最小化全局目标,学会了逐渐忽略稀疏信号、转而依赖占主导的 head 特征,从而导致实证中观测到的停滞 scaling 指数。MESH 的设计就是要作为一种「结构性归纳偏置」,把新鲜信号从全局梯度干扰中屏蔽出来,追求 scaling 公平性(scaling fairness)——即新鲜物品相对常青内容的容量增益能被保留。
这里的机制诊断是全文最锋利的 insight:scaling bias 不是数据问题、也不是简单的采样问题,而是扁平架构显式特征交叉带来的梯度耦合这一结构性根因。因此解药也必须是结构性的——在梯度层面为稀疏实体开辟一条「受保护的梯度路径(protected gradient path)」。
结构解耦:模块化子塔(Modularized Sub-Towers)¶
MESH 采用结构解耦策略对抗 scaling bias。核心哲学是:在异构信号进入全局交互空间之前,先在独立的、领域专属的子塔内隔离并富化它们。作者把特征集 $\mathcal{F}$ 划分为 $K$ 个语义组 $\mathcal{G}=\{G_u, G_i, G_c\}$,分别代表 user、item、context 三个域(生产环境采用 $K=3$)。
组级流形初始化(Group-wise Manifold Initialization)¶
不同于扁平架构,MESH 在任何跨域交互之前先施加组级归纳偏置。每个组 $G_k$ 先被变换成一个稠密流形:
$$H_{k}^{0}=\text{LayerNorm}\left(\text{Concat}(\{e_{j}\mid f_{j}\in G_{k}\})\right) \tag{3}$$
组内的初始 LayerNorm 确保 Item 域的内部方差独立于 user / context 域被保留,防止常青频率偏置污染新鲜物品的初始隐表示。
塔内信号放大(Intra-tower Signal Amplification)¶
对于历史交互有限的稀疏实体,原始 embedding 往往不足以在深层非线性变换中存活,会发生「语义坍塌(semantic collapse)」。为保留信号保真度,MESH 对每个组施加领域专属编码器 $\psi_k$(充当「信号放大器」),把原始组 embedding 扩展为高维「语义超级 token」$S_k$:
$$S_{k}=\psi_{k}(H_{k}^{0};\Theta_{k}) \tag{4}$$
MESH 对编码器选择是无关的(encoder-agnostic),但作者实例化 $\psi_k$ 时选用 DHEN(Zhang et al., 2022),因其在处理稀疏类别特征时具有更好的稳定性与表达力。每个子塔采用带层级归一化的递归残差结构,第 $l\in[1,L]$ 层执行一个「反复引入原始语义信号以防止信息衰减」的投影:
$$H_{k}^{l}=\text{Norm}\left(H_{k}^{l-1}+\Phi(H_{k}^{l-1},H_{k}^{l-1};\theta_{k}^{l})\right) \tag{5}$$
其中算子 $\Phi$ 建模显式特征交叉,可取 MaskNet、Transformer、DCNv2、MLP 等。
这一递归机制的作用是「信号放大器」:通过把原始语义流形 $H_k^0$ 反复投影回隐状态,确保内在物品特征在暴露于交叉骨干的全局互动偏置"噪声"之前被充分展开。这防止了深层扁平 MLP 在处理稀疏长尾特征时常见的语义坍塌,为稀疏实体提供了「受保护的梯度路径」,是 scaling 公平性改善的关键来源。
组间全局交叉与去偏:Residual Gated Bias Correction(RGBC)¶
模块化子塔保留了域专属信号的保真度,但最终的交互阶段还必须对生产环境中普遍存在的互动偏置(如设备、时段、用户意图)保持鲁棒。为防止外源上下文噪声污染内在的 user-item 匹配,MESH 提出 Residual Gated Bias Correction(RGBC,残差门控偏置校正) 机制。
首先,通过 user 与 item 超级 token 的逐元素 Hadamard 积,提取一个干净的、不受环境因素影响的潜在亲和度——这代表 MESH 想在整个 scaling 过程中保护的「内在相关性流形」:
$$\mathbf{X}_{ui}=T_{u}\odot T_{i} \tag{6}$$
context 超级 token $T_c$ 封装了「常与互动相关、但未必与内容效用相关」的环境元数据。用 $T_c$ 生成一个置信度门控 $\mathbf{g}\in(0,1)$,动态调节语义信号相对于观测到的上下文偏置的强度:
$$\mathbf{g}=\sigma\left(\text{MLP}_{\mathrm{gate}}(T_{c})\right) \tag{7}$$
其中 $\sigma$ 为 Sigmoid。送入全局交叉骨干的最终输入 $\mathbf{H}_0$,由「用门控调制语义核 + 残差引入上下文偏置 + LayerNorm」构成:
$$\mathbf{H}_{0}=\text{LayerNorm}((\mathbf{g}\odot\mathbf{X}_{ui})+T_{c}) \tag{8}$$
这一设计确保在高偏置场景下,$T_c$ 可以吸收互动方差,让 user 与 item 塔专注于纯粹的内容效用。这是 MESH 把「内在语义匹配」与「外源互动偏置」在结构上分离的关键一步。
关键技术细节:系统实现与服务效率¶
MESH 的模块化设计天然带来了推理并行化的机会,作者据此设计了一套系统级优化,把结构模块化转化为推理效率增益。
通过 TorchScript 实现算子间并行(Inter-Op Parallelization)。 MESH 的模块化引入了结构上相互独立、推理无数据依赖的多个塔。在朴素的 PyTorch eager 执行下,这些塔因 Python 级 dispatch 和隐式同步而被串行执行,导致 GPU 算力利用率低下——尤其在 kernel launch 与调度开销占主导的小 batch 服务负载下。作者用 TorchScript(JIT 即时编译) 启用跨塔的算子间并行,让子塔并发推理,改善 kernel 重叠、减少 GPU 空闲周期。形式化地,设 $T_k$ 为第 $k$ 个塔的推理延迟:串行执行的骨干延迟为 $\sum_{k=1}^{K}T_{k}$,而并行执行把关键路径缩短到 $\max_{k}(T_{k})+\epsilon$($\epsilon$ 为同步与调度开销),在编码阶段带来近 $K\times$ 的加速。
线程策略与资源争用。 部署中作者发现宿主机侧的算子间并行线程策略对尾延迟(P99)影响极大。虽然「每个子塔分配一个专用线程」看似直观,但实践中会因上下文切换开销和资源争用的级联反应而频繁引发延迟尖峰。改用由系统可用算力管理的更大线程池能有效抑制延迟尖峰,在不牺牲吞吐的前提下带来更稳定的尾延迟。
实验设置¶
系统架构与超参数。 检索系统采用双塔架构,解耦 query 与 candidate 表示以支持高效的近似最近邻(ANN)搜索。架构改动仅限于 request 级(user 塔)表示。扁平架构 baseline 把所有特征 embedding 拼成单个向量再进行全局 DHEN 交互;MESH 则用模块化编码器把异构信号划分到独立语义塔、再接门控偏置校正。两种架构都遵循一致的三阶段执行流水线: 1. 特征聚合:稀疏类别特征(如 semantic ID、user/item ID)经学习到的查表映射为稠密 embedding,连续特征(如互动统计量)直接拼接。 2. 全局交互:一个 DHEN 层捕获高阶非线性。 3. 投影:一系列带 ReLU 激活和 LayerNorm 的全连接层,把交互输出变换为最终的 L2 归一化 embedding $\mathbf{u},\mathbf{v}\in\mathbb{R}^{64}$。
训练中用基于物品频率的 in-batch negatives + logit 校正(Yi et al., 2019)缓解流行度偏置。
训练与评估数据。 收集 Pinterest Related Pins 平台 15 天 用户互动日志(query-candidate 对,用户对推荐 pin 有互动),与推理日志 join 获取物品特征、用户上下文与互动标签,经各种采样后得到约 10 亿(1B) 条训练记录。为保证无偏评估,离线评估集取训练期后一个独立的 3 天 窗口,用 5% 的 off-policy 均匀随机流量切片(消除生产 ranking 策略引入的选择偏置),得到 4.5 亿 测试样本。评估时把测试集分层为 evergreen 与 fresh 语料(age ≤ 28 天),fresh 内容指标(如 Recall@K)仅在 fresh 候选子空间内计算,防止 evergreen head 实体稀释性能信号。
作者特别论证了为何不用公开 benchmark(MovieLens、Amazon Reviews):它们缺乏两个本研究必需的属性——(1) 内容天然分层为交互密度差异巨大的异构层级(evergreen vs fresh vs long-tail);(2) 足够规模以在多个 FLOPs 配置上拟合可靠的幂律曲线(公开数据集在低容量就饱和,使 scaling law 分析统计上脆弱)。
内容分层(Corpus Tiering)。 论文按时间动态和交互稀疏度把生产内容生态划分为多层(见下表 Table 1 逻辑):
| 语料类型 | 概念性的选择 / 剪枝逻辑 |
|---|---|
| Fresh Cold-start | 选择:在短暂摄入窗口 $\Delta T_{\mathrm{new}}$ 内、曝光极少($I < $ 阈值)的物品;剪枝:超过最大延迟窗口仍未达互动下限的物品 |
| Fresh Warm-start | 选择:显示初始牵引力($I\geq\tau_{\mathrm{exp}}$)、基于相对转化率满足质量先验的内容;剪枝:高曝光但无法维持互动密度 $\rho_{\mathrm{min}}$ 的物品 |
| Shopping Long-tail | 选择:由语义购物意图指示器 $\mathbb{I}_{\mathrm{shop}}$ 识别的物品 |
| Evergreen | 选择:由带时间衰减因子的累计互动分数识别的高互动内容:$S_{\mathrm{evg}}=\sum v_{i}\cdot e^{-\lambda(T-t_{i})}$ |
fresh 段遵循「毕业式(graduation-based)」轨迹:Fresh Cold-start(新发布、近零信号)在越过特定互动阈值后转为 Fresh Warm-start。
离线指标。 主指标为 Recall@K,定义为 top-K 候选中检索到的真实相关物品比例:
$$\text{Recall@K}=\frac{|S_{K}\cap R|}{|R|} \tag{9}$$
训练正信号选 repin(用户把 pin 保存到自己的 board),因其是有机内容用户兴趣的最强指示。以 Recall@10 为主离线指标(与在线互动相关性最强)。scaling law 刻画时聚焦 evergreen 与 fresh 两个「内容原型」,刻意排除深尾 shopping 段(极端稀疏导致高方差、难以稳定拟合幂律),以 fresh 段作为更广尾部的「高熵代理」。
在线 A/B 测试。 在 Pinterest 生产 Related Pins 系统部署 MESH,跑 3 周,按用户级随机划分 control(生产中的扁平 baseline 模型,用相同日期的训练数据重训)与 treatment。主指标为 Related Pins 整体 repin 率(有机内容质量的核心指标)+ 分段内容互动,护栏指标为 P99 延迟与基础设施成本。
主要实验结果¶
判别式 Scaling Law:一般 scaling 效率¶
作者系统地改变结构超参:每域特征 / token 维度 $d$、DHEN 层输出 embedding 维度 $L$、每 DHEN 层交互模块数 $C$,用幂律形式建模算力预算与性能的关系:
$$y=\alpha x^{\beta}+\gamma \tag{10}$$
其中 $y$ 为性能指标,$x$ 为 scaling 因子(FLOPs 或参数量),$\beta$ 为 scaling 指数。Table 2 显示 MESH 随容量增大持续获得性能增益:
| 配置 | TFLOPs | Params | Recall@100 | ΔRecall |
|---|---|---|---|---|
| 改变每域特征维度 $d$ | ||||
| d = 16 | 2.8 | 17.8M | 0.835 | 0.00% |
| d = 32 | 3.2 | 25.7M | 0.870 | +4.19% |
| d = 64 | 3.4 | 48.0M | 0.886 | +6.11% |
| d = 128 | 6.6 | 118.2M | 0.888 | +6.35% |
| 改变每域输出维度 $L$ | ||||
| L = [16, 16] | 3.2 | 25.7M | 0.870 | 0.00% |
| L = [32, 32] | 4.2 | 43.8M | 0.873 | +0.34% |
| L = [64, 64] | 6.0 | 105.0M | 0.882 | +1.38% |
| L = [128, 128] | 10.8 | 328.2M | 0.893 | +2.64% |
| 加宽每 DHEN 层交互模块数 $C$ | ||||
| C = [16] | 2.0 | 7.3M | 0.866 | 0.00% |
| C = [16, 16] | 3.2 | 25.7M | 0.870 | +0.46% |
| C = [16, 16, 16] | 3.3 | 29.3M | 0.882 | +1.85% |
| C = [16, 16, 16, 16] | 3.4 | 34.7M | 0.883 | +1.96% |
结论:扩宽($d, L$)与加深($C$)都带来检索精度的稳健上升趋势;传统模型常因特征饱和撞上性能天花板,而 MESH 的结构化模块设计展现更持续的改进。但随 $x$ 增大,Recall@10 的边际增益开始放缓,反映向「收益递减」区间过渡——这本身是健康 scaling 曲线的特征。
Scaling 公平性评估(本文的核心证据)¶
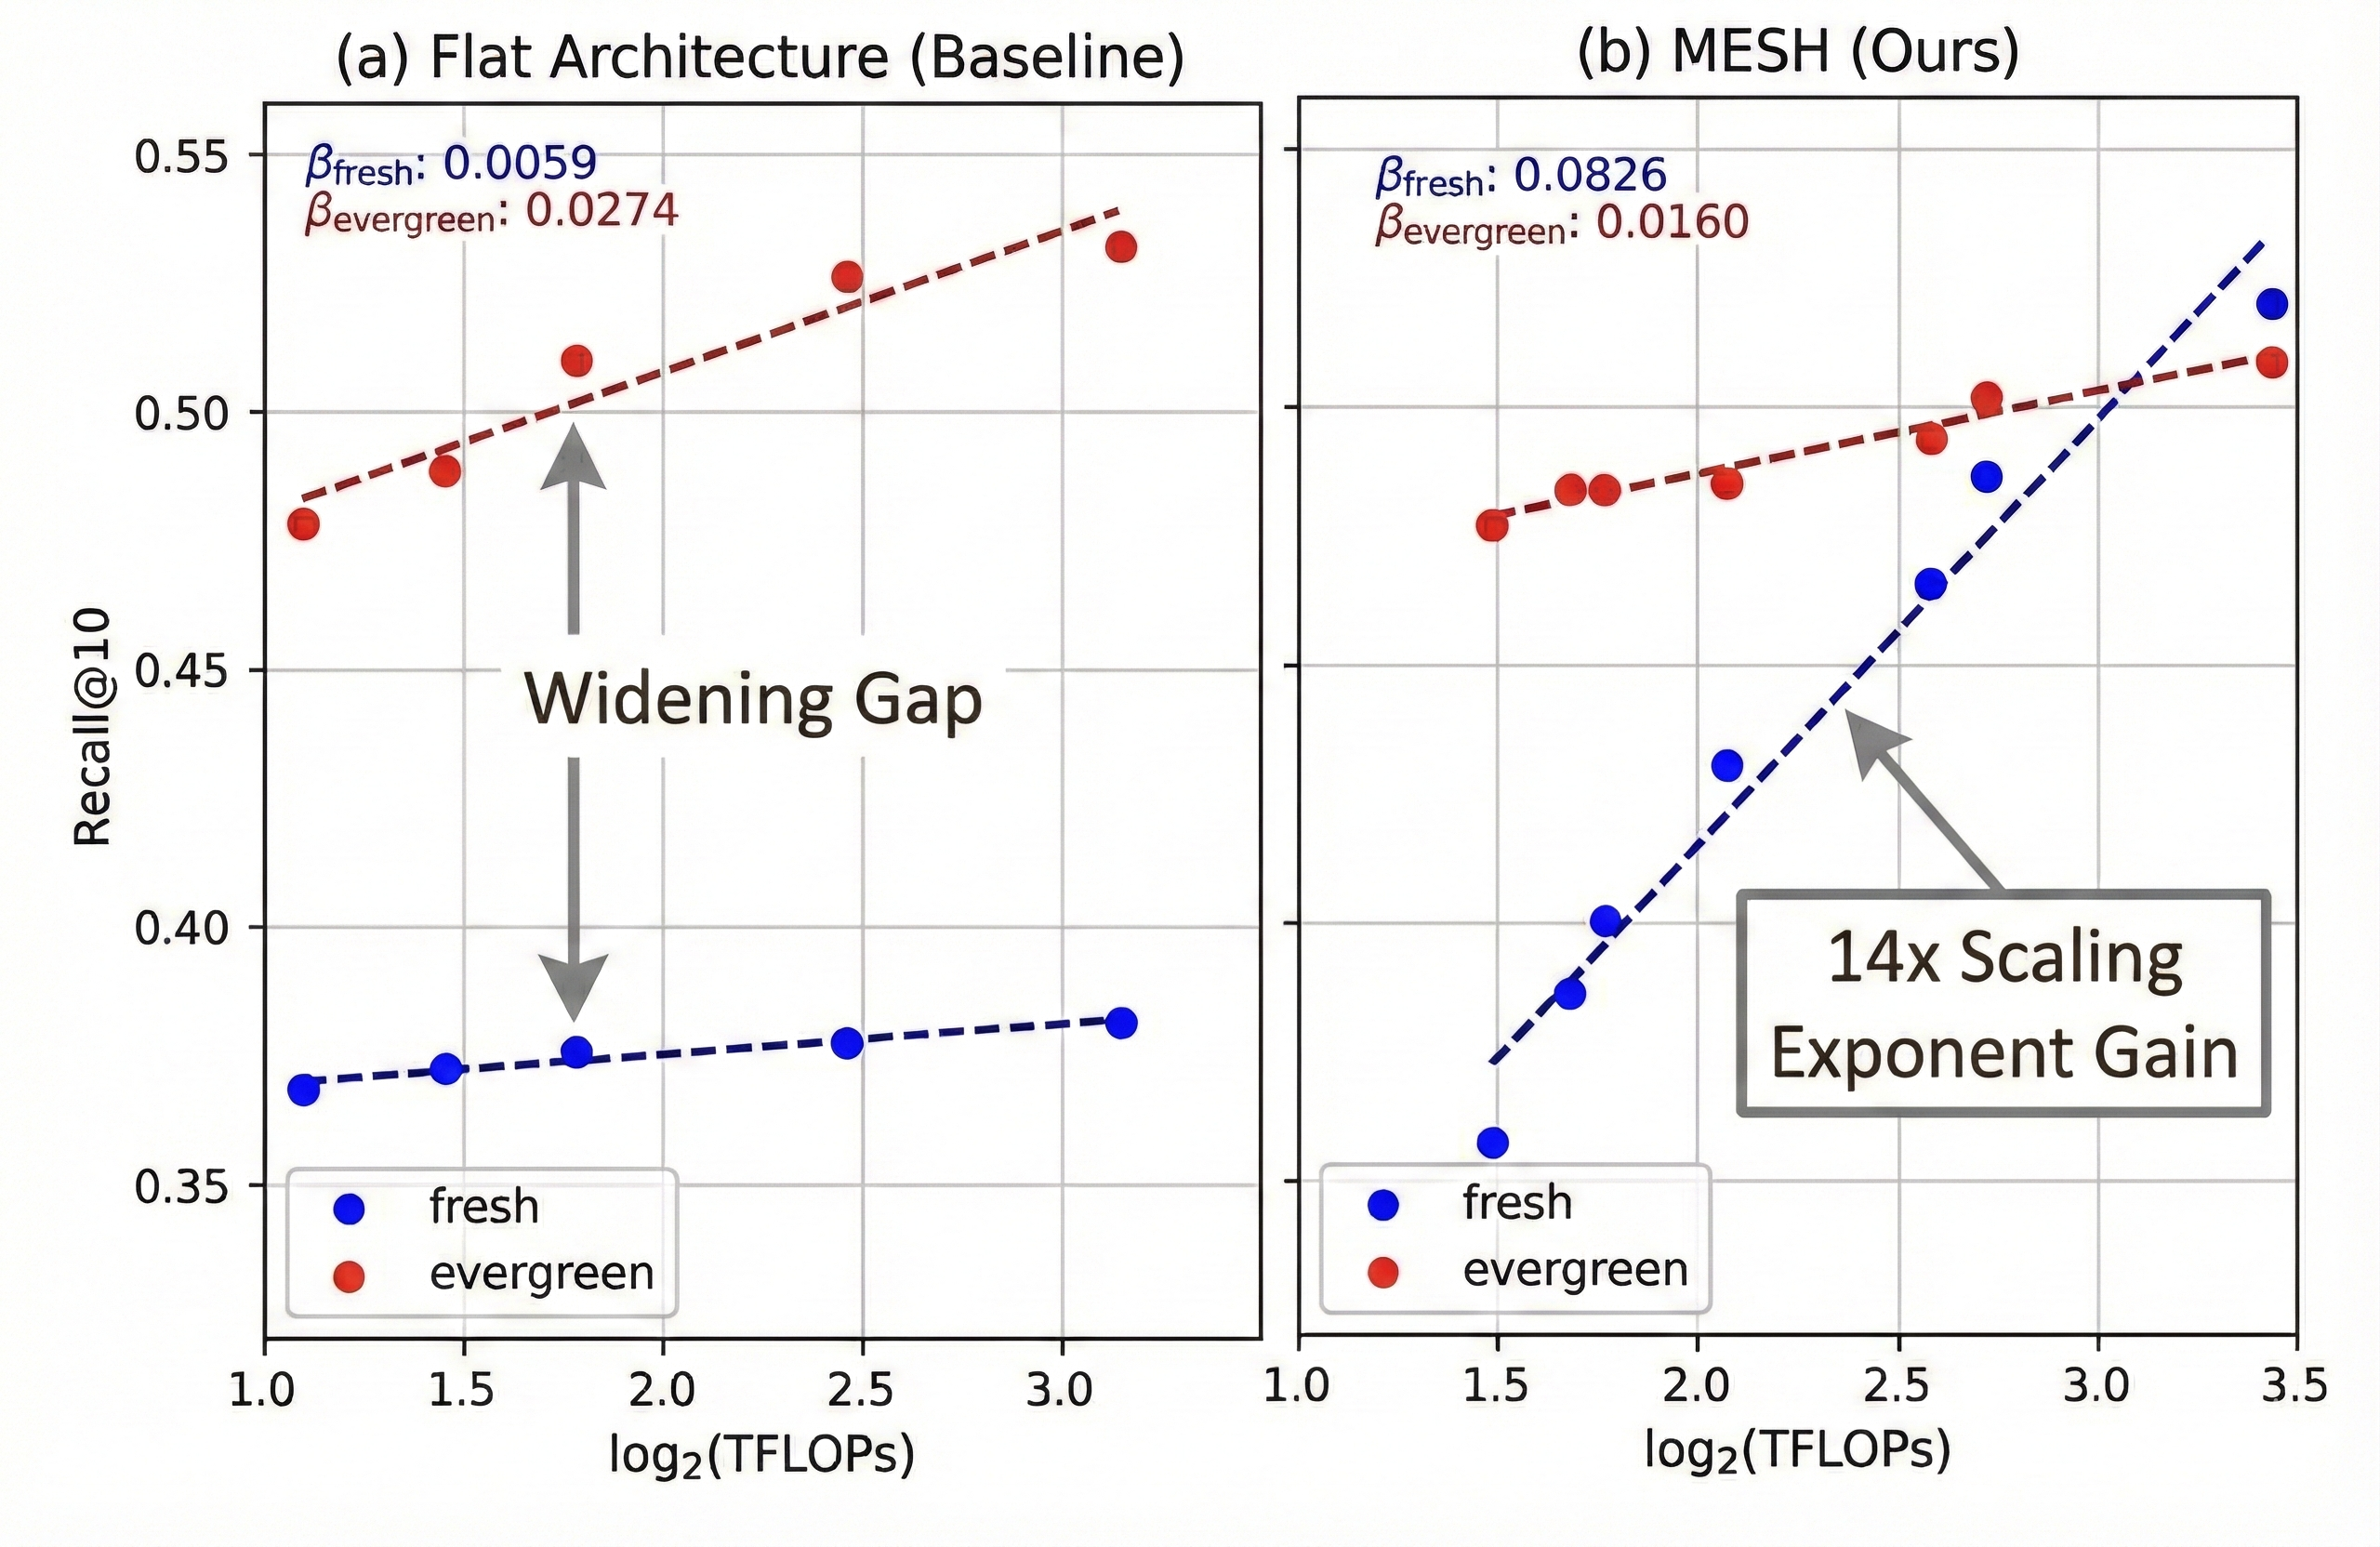
如 Figure 2 所示,扁平架构 baseline 的 scaling 轨迹被普遍的「head-bias」主导:
-
扁平 baseline:evergreen 段 scaling 指数相对稳健($\beta_{\mathrm{evergreen}}=0.0274$),而 fresh 段几乎停滞($\beta_{\mathrm{fresh}}=0.0059$)。这印证了 §2.1 的「梯度主导假说」——在全局耦合架构中,额外算力被高频实体不成比例地消耗,稀疏 fresh 信号在交互层中被有效掩盖,head 与 tail 的表示鸿沟随模型增大而拉宽,强化「富者愈富」的反馈回路。
-
MESH:$\beta_{\mathrm{fresh}}=0.0826$,相对 baseline 提升 14×。值得注意的是,MESH 下 fresh 段现在展现出比 evergreen 段($\beta_{\mathrm{evergreen}}=0.0160$)更陡的斜率——说明 evergreen 表示接近饱和点,而 fresh 段拥有高得多的 scaling 弹性。$\beta_{\mathrm{evergreen}}$ 的下降不代表性能牺牲,而是表征容量的更高效再分配:MESH 把模型容量从冗余的 head 拟合,重新分配到内容尾部的高增长潜力上。
机制直接验证("受保护梯度路径"的实证):
- 训练中测量 per-group 梯度统计——扁平 baseline 中 evergreen 的 L2 梯度范数是 fresh 的 12.4×,直接证实信号掩盖;MESH 下这一比率改善 62%(降到 4.7×),证明模块隔离主动保护了稀疏实体的学习信号。
- 用 Integrated Gradients 测量:MESH 相对扁平 baseline,内容特征归因分数提升 28%,证实从「流行度偏置」向「内在语义效用」的结构性转移。
- 统计鲁棒性:对幂律拟合做 1000 次 bootstrap 重采样,MESH 下 $\beta_{\mathrm{fresh}}$ 的 95% 置信区间为 $[0.0772, 0.0874]$,下界仍约为扁平 baseline(0.0059)的 ~13×,确认 14× 增益统计稳健、非稀疏数据点的假象。
消融实验¶
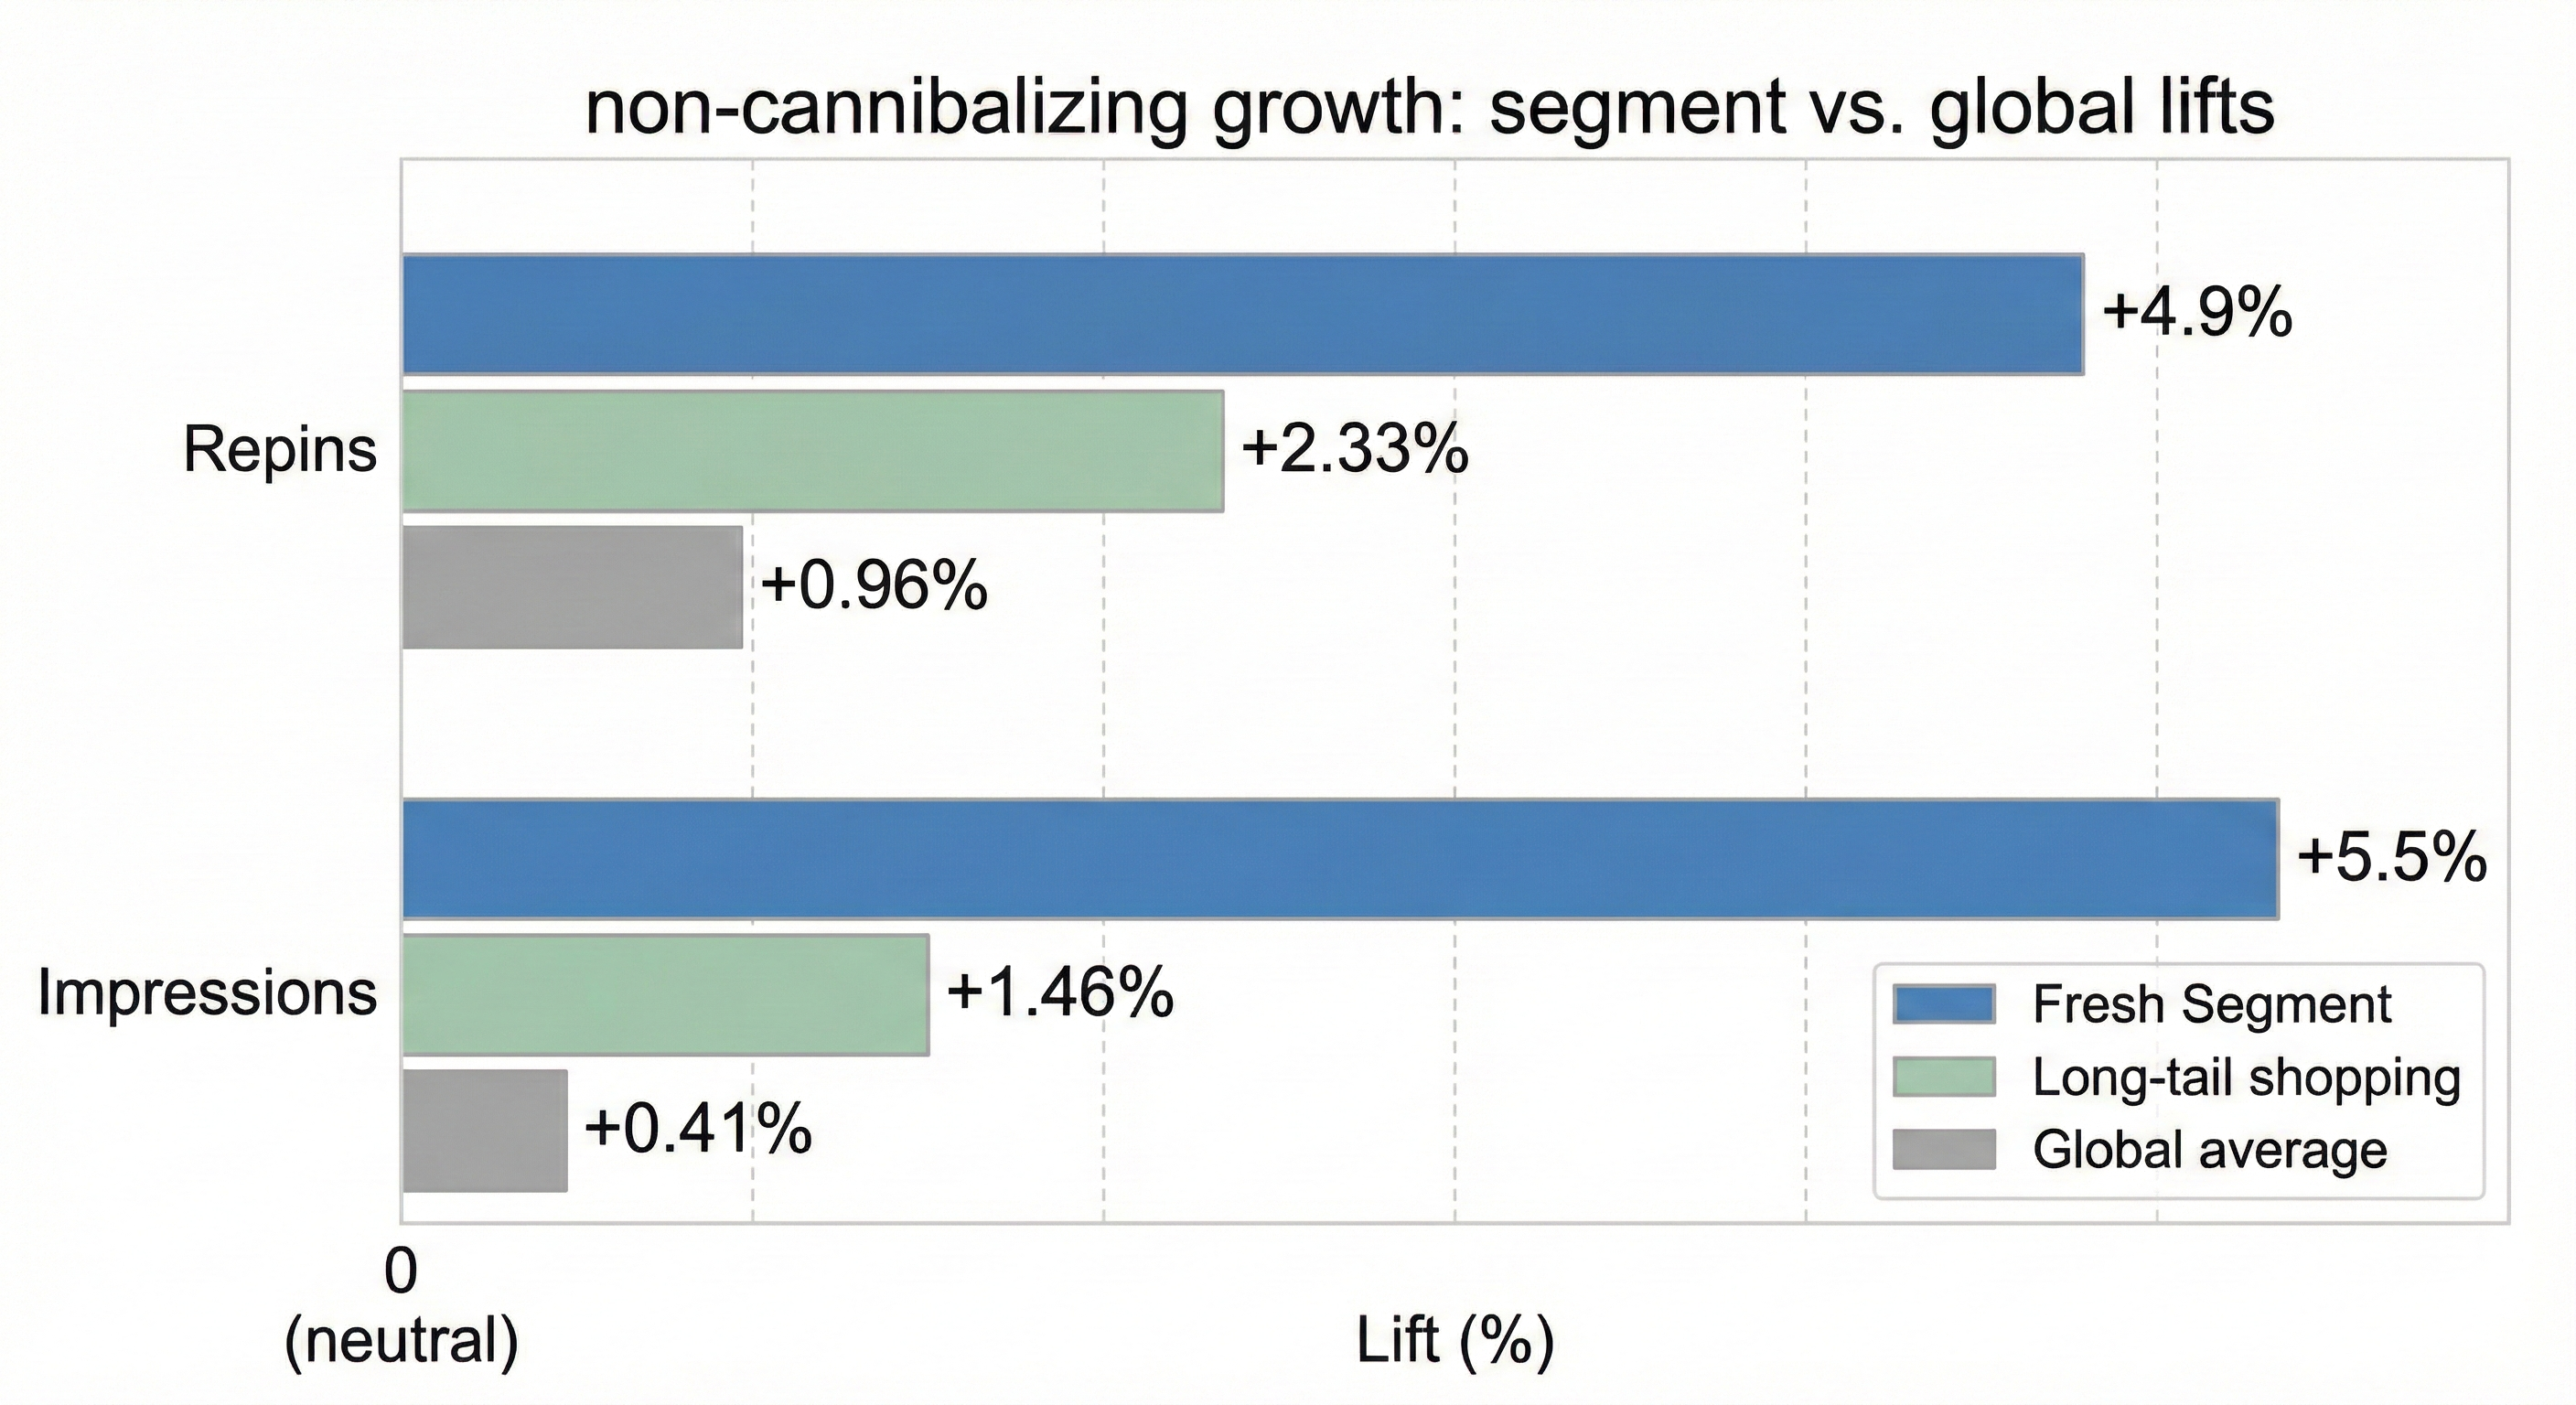
Table 3 逐项拆解 MESH 各组件对异构 scaling 的贡献:
| 配置 | Overall Recall@10 | $\beta_{\mathrm{fresh}}$ | $\Delta\beta_{\mathrm{fresh}}$ |
|---|---|---|---|
| MESH framework | 0.521 | 0.0826 | - |
| – w/o Semantic Amplifiers | 0.482 | 0.0071 | -91.4% |
| – w/o Modular Crossing Backbone | 0.495 | 0.0528 | -36.1% |
| – w/o RGBC mechanism | 0.509 | 0.0645 | -21.9% |
逐项分析:
- 移除语义放大器(Semantic Amplifiers) 造成最严重退化:$\beta_{\mathrm{fresh}}$ 从 0.0826 崩回 0.0071(-91.4%)。这证实输入层的模块化归纳偏置是恢复 scaling 的首要驱动——它防止了「语义冲刷(semantic washout)」。这是全文最强的消融信号:几乎所有 scaling 公平性收益都来自「在信号进入全局交叉前先在独立子塔内放大保护它」。
- 移除模块化交叉骨干(把 DHEN 层换成等参数量 MLP):$\beta_{\mathrm{fresh}}$ 降到 0.0528(-36.1%)。说明结构化输入提供了 scaling 的「机会」,但骨干中的层级残差连接对梯度保护同样必不可少。
- 移除 RGBC 机制(把门控层换成标准加法):$\beta_{\mathrm{fresh}}$ 降到 0.0645(-21.9%)。验证了「信号净化器」调制上下文噪声、保障 scaling 公平的必要性——没有 RGBC 时,增加的容量会部分浪费在拟合外源互动模式而非内在兼容性上。
子塔数量 $K$ 的敏感性:$K=3$ 对应检索的三个核心语义域(user/item/context)。测试 $K=4$(把 query pin 子塔进一步拆成 engagement 与 content 子塔)仅带来 +0.3% fresh impressions、+0.5% repins 的边际增益,说明性能随划分的"语义连贯性"而非单纯基数增长。生产选 $K=3$ 作为甜点,$K=4$ 的边际增益不足以抵偿高 QPS 约束下增加的服务复杂度。
编码器无关性:用 MLP 与 DCNv2 编码器的初步实验也展现一致的 scaling 公平性增益(幅度小于 DHEN),确认模块化域隔离才是 scaling 公平性的首要驱动,独立于编码器选择。
在线 A/B 测试结果¶
分段提升与生态影响(非蚕食性 scaling)。 在线结果揭示了一种「非蚕食(non-cannibalizing)scaling 效应」——MESH 在弱势分段取得显著增益,同时不回退全局性能(见 Figure 3):
- Fresh 段:impressions +5.5%,repins +4.9%。据 Table 4,增益主要由 7–28 天 warm-start 窗口驱动(模型成功恢复潜在信号)。
- 长尾 shopping pins(电商发现的关键分段):impressions +1.46%,repins +2.33%。
- 全局稳定性:总 impressions +0.41%、总 repins +0.96%(中性偏正)。
在十亿级推荐引擎语境下,「全局中性 + 分段增益」反映了流量的更公平分配——证明 MESH 不是简单地把互动从一个池子搬到另一个(蚕食),而是通过打破 §3.2.2 识别的「富者愈富」回路,改善检索覆盖、surface 出此前被 legacy 骨干服务不足的内容。
Table 4:按 pin 年龄分解的 freshness 影响(加粗为统计显著):
| Pin Age | 0–7 天 | 7–14 天 | 14–28 天 | 28–90 天 |
|---|---|---|---|---|
| Impressions | +0.11% | +1.60% | +2.00% | +0.55% |
| Engagement | +0.96% | +2.49% | +2.77% | +0.56% |
对比外部 scaling-aware 架构(vs RankMixer):以 MESH 为 baseline 做在线 A/B——RankMixer-small(28M) 得到 fresh repin −1.42%、fresh impression −1.18%;RankMixer-large(135M) 得到 −2.99% 和 −1.77%。关键在于:扩大 RankMixer 反而拉大了它相对 MESH 的性能差距、而非缩小,证实 Scaling Bias 是一个扁平架构无法靠暴力扩容解决的结构性问题。
生态级漏斗效率(Funnel Efficiency)。 作者定义两个工业指标衡量候选生成(CG)阶段健康度:
$$SR=\frac{|\mathcal{C}_{\mathrm{ranked}}|}{|\mathcal{C}_{\mathrm{total\_nominations}}|} \tag{11}$$
$$CE@50=\frac{|\mathcal{C}_{\mathrm{ranked}}\cap\mathcal{P}_{50}|}{|\mathcal{C}_{\mathrm{total\_nominations}}|} \tag{12}$$
- Survival Rate(SR):被提名候选中成功通过最终 ranking 阶段的比例,越高表示 retrieval 与 ranking 越对齐。
- CG Efficiency(CE@50):被提名候选中进入 top-50 最终排名列表的比例,代表「高效用」检索率。
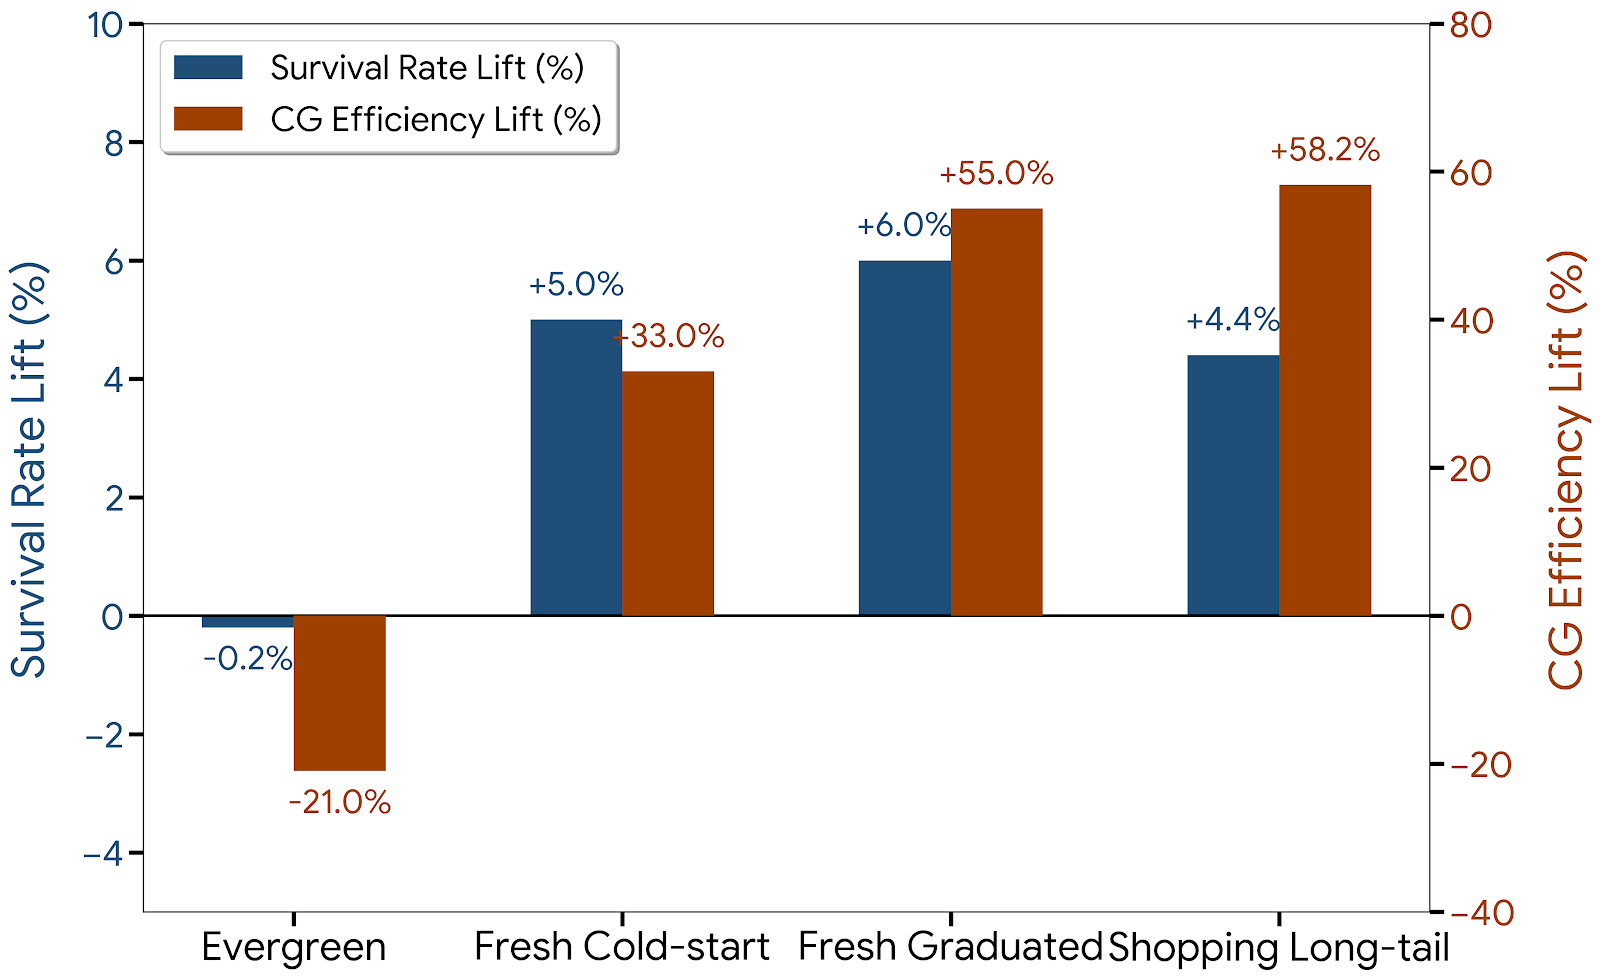
如 Figure 4:fresh warm-start 取得 CE +55.0%、SR +6.0%;shopping long-tail CE 增幅最大 +58.2%、SR +4.36%。这实证了 MESH 更好地保留了此前被抑制的稀疏信号,通过「受保护梯度路径」让高质量 fresh 与 long-tail 物品能在最终 ranking 阶段有效竞争。
关于 evergreen 语料:SR 中性(−0.21%),CE 下降 21.0%。作者解读这不是回退,而是对抗 evergreen 过拟合的策略性架构权衡——在高频 head 段,传统架构常为超热门物品过度优化、导致曝光冗余。evergreen CE 下降 + SR 稳定,说明 MESH 在通过把发现容量重分配给高潜力 fresh 与 shopping 内容来「多样化候选池」,优先长期生态健康而非对既有 head 实体的冗余过曝。
用户留存影响(Table 5)。 MESH 同时改善用户互动与长期留存(加粗为显著):
| 类别 | 指标 | 在线影响 |
|---|---|---|
| 用户留存 | Sessions > 5 mins | +0.46% |
| Successful Sessions (SSv2) | +0.19% | |
| 用户互动 | Total time spent in App | +0.45% |
| Time Spent (Related Pins) | +0.55% | |
| Time Spent (Search) | +0.49% | |
| Time Spent (Home Feed) | +0.41% |
跨 surface 的并发增长(Related Pins / Search / Homefeed 全部为正)说明 MESH 的增益不是以牺牲其他 surface 为代价;Sessions > 5 mins +0.46% 与 SSv2 +0.19% 表明改进延伸到长期用户留存。
系统效率与可扩展性¶
Table 6:不同执行策略的推理性能(十亿级检索、高 QPS 生产环境):
| 执行策略 | 线程数 $n$ | P99 延迟 (ms) | Speedup |
|---|---|---|---|
| Sequential Baseline | 1 | 42.5 | 1.00× |
| Sub-optimal Parallelism | 3 | 187.4 | 0.08× |
| MESH (Optimized) | 48 | 14.8 | 2.87× |
结论:朴素串行实现 P99 为 42.5ms;次优并行策略($n=3$,匹配子塔数)反而因严重资源争用把延迟飙到 187.4ms(0.08×,即慢了 12 倍!);而把算子间并行与硬件容量对齐(48 线程) 达到近最优的 14.8ms,相对串行 baseline 2.87× 加速,有效把「总模型容量」与「线性延迟累积」解耦。这个「$n=3$ 反而最慢」的反直觉结果,是本文系统部分最实用的工程教训——模块化架构的并行收益高度依赖线程池与硬件容量的对齐,天真的「一塔一线程」会因上下文切换与争用彻底翻车。
核心贡献总结¶
- 发现并刻画了「异构性 Scaling Bias」:首次系统性指出扁平统一检索架构中「容量增益在 evergreen 上远强于 fresh/long-tail」的结构性发散,并把根因定位到显式特征交叉带来的梯度耦合(fresh 梯度范数被 evergreen 掩盖 12.4×)。
- MESH 架构:模块化子塔(组级 LayerNorm + 递归残差信号放大器)+ RGBC 门控偏置校正,在梯度层面为稀疏实体开辟「受保护梯度路径」,把 fresh 的 scaling 指数提升 14×(0.0059→0.0826)。
- Pinterest 十亿级工业验证:离线 4.5 亿样本、在线 3 周 A/B——fresh repin +4.9%、long-tail shopping repin +2.33%、fresh warm-start CG 效率 +55%、留存(Sessions>5min)+0.46%,且服务吞吐 2.87×,全局中性证明「非蚕食」增长。
与已归档相关工作的对比¶
RankMixer RankMixer(ByteDance / 抖音,2025-07)¶
关系:显式引用且本文用作在线对比 baseline(原文 §3.3.1 有直接 A/B 数据)· 未加载对方精读
RankMixer 是本文明确对标的「SOTA scaling-aware 扁平架构」。原文报告:在 Pinterest Related Pins 上以 MESH 为 baseline,RankMixer-small(28M)fresh repin −1.42% / fresh impression −1.18%,RankMixer-large(135M)−2.99% / −1.77%。关键论点是扩大 RankMixer 反而拉大与 MESH 的差距——RankMixer 代表的「Flat Tokenization」路线(把异构特征当作均质序列喂给大 Transformer)恰恰是本文诊断的 Scaling Bias 病根:它优化全局指标却忽视 intra-corpus 分布偏移。MESH 与 RankMixer 构成「同问题(判别式推荐 scaling)、相反解法(结构模块化 vs 扁平 tokenization)」的直接对照。详见结构化对比边。
OneTrans OneTrans(同属 Flat Tokenization 路线)¶
关系:显式引用(related work §4 归为"Flat Tokenization"阵营)· 未加载对方精读
原文把 OneTrans(Zhang et al., 2025)与 RankMixer 并列为「Flat Tokenization」代表——用海量 Transformer 骨干处理均质化特征序列。本文的批评一致:这类方法证明了「更大更好」对全局指标成立,却系统性忽略 evergreen/fresh/long-tail 间的分布偏移。MESH 主张结构模块化是公平 scaling 的前提,与 OneTrans 属方法论上的正面分歧。
讨论与局限性¶
核心贡献与值得借鉴的设计。 本文最大的价值不在具体架构,而在把「scaling 公平性」提升为一等公民问题,并给出机制级诊断:scaling bias 的根因是显式特征交叉的梯度耦合,因此解药必须在梯度路径上做结构隔离。这一「先在独立子塔内放大保护稀疏信号、再进入全局交叉」的思路具有普适性,不局限于检索或 Pinterest 场景——任何面临 head/tail 分布倾斜的判别式模型(CTR 排序、召回、甚至广告)都可借鉴「模块化域隔离 + 门控去偏」。消融中「w/o Semantic Amplifiers → β_fresh 崩 91.4%」几乎单枪匹马地证明了输入层模块化归纳偏置是关键,这是极干净的因果证据。
值得称道的实证严谨性:per-group 梯度范数(12.4×→4.7×)、Integrated Gradients 归因(+28%)、1000 次 bootstrap 置信区间——三条独立证据链共同支撑「受保护梯度路径」的机制主张,远超一般工业论文「只报指标」的水准。系统部分「$n=3$ 反而最慢 12 倍」的反直觉教训也很有工程价值。
局限与争议: 1. 完全依赖 Pinterest 专有数据,无公开 benchmark。作者论证公开数据集缺乏异构分层与足够规模来拟合 scaling law——这个理由成立,但也意味着结论无法被外部独立复现,14× 这个数字的普适性存疑(它高度依赖 Pinterest 特定的 fresh/evergreen 划分阈值)。 2. evergreen CE −21% 被解读为「策略性权衡」而非回退,但这是一个需要 A/B 长期观测才能证伪的乐观解释——若下游依赖 evergreen 高效召回的业务受损,该权衡未必普适。 3. 架构改动仅限 user 塔,item 塔与 context 的模块化收益边界未充分探讨;$K=3$ 的语义划分(user/item/context)对 Pinterest 的图到图场景合理,迁移到其他场景时最优划分需重新设计。 4. RGBC 假设 context 与「内容效用无关、只与 engagement 相关」,这在某些场景(如时段本身携带内容偏好信号)可能过强。
工业落地价值。 MESH 已在 Pinterest 生产 Related Pins(十亿级 item-to-item)全量部署,是一篇成色很高的工业论文:它同时解决了「模型效果(scaling 公平性)」与「运维成本(统一骨干替代 model zoo,省约 4× 运营成本)」两个正交痛点,且给出了可复用的服务侧工程细节(TorchScript inter-op 并行 + 线程池对齐 → 2.87× 吞吐)。对任何维护着「召回模型动物园」的推荐团队,本文提供了一条「用结构化模块统一 + 保护稀疏梯度」的可行整合蓝图。