TM20K:教师保留全量 token,学生高效合并 —— 字节电商广告 20K 超长序列建模¶
研究动机与背景¶
超长用户行为序列建模已经被反复证明能同时刻画用户的长期与短期兴趣,是当前推荐系统最确定的一条 scaling 方向。但在字节的电商广告推荐系统里,把最大序列长度从 5K 推到 20K 的代价是灾难性的:即便已经上了 FlashAttention 与 M-Falcon serving,训练时间增加 3.5 倍、GPU 显存增加 49GB、线上推理延迟增加约 6.3 倍。论文用一句话概括这个结构性矛盾:effectiveness and efficiency for long sequence modeling constitute conflicting objectives——超长序列的效果与效率是一对天然冲突的目标,必须给出恰当的折衷。
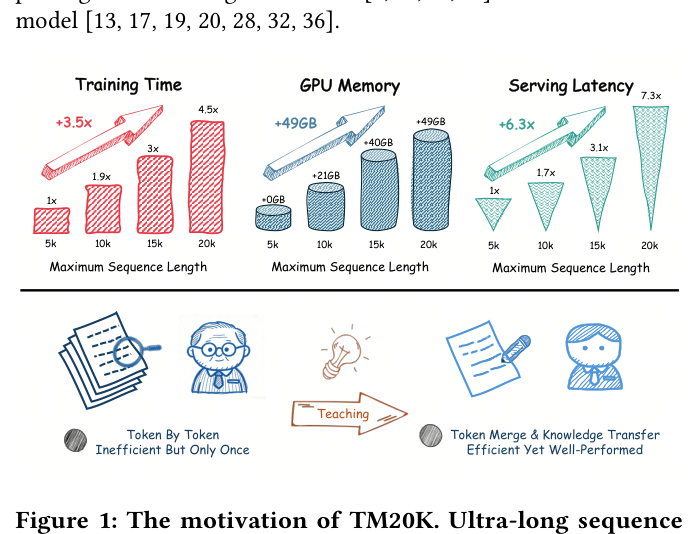
已有的折衷方案主要分两类,作者认为都不够:
- 序列长度压缩。search-based 方法(DIN/SIM/TWIN 一脉)为每个候选检索一个高相关子序列,不可避免地丢弃细粒度、潜在有价值的行为信息,而且与 M-Falcon serving 不兼容(因为每个候选的检索结果不同,无法共享用户侧计算);cluster-based 方法把超长序列聚合成更短的凝练表示,但依赖高质量的预训练 token embedding 才能保证聚类稳定。
- 轻量注意力架构。纯 target attention 或各种线性/稀疏注意力把二次复杂度降下来,但无法充分捕捉行为 token 之间的内在依赖,导致序列特征抽取不足。
除这两类端到端方案外,两阶段框架(知识蒸馏、foundation model)在平衡多种 scaling 方向时更灵活。TM20K 选择的正是这条路。
论文用 Table 1 系统对比了自己与既有工作在"序列长度压缩策略(LenCom)"与"注意力架构(AttnArch)"两个维度上的定位,并额外区分了最大原始序列长度 MaxLen 与压缩后真正参与计算的有效长度 EffLen——这个区分很关键,很多号称支持 $10^6$ 长度的方法,压缩后实际只算 $10^2$ 个 token。
Table 1: 序列长度压缩与注意力架构的对比
| Method | MaxLen | LenCom | EffLen | AttnArch |
|---|---|---|---|---|
| TWIN-V1 | $10^4$ | GSU | $10^2$ | ETA |
| TWIN-V2 | $10^6$ | HC & GSU | $10^2$ | ETA |
| EST | $10^6$ | SIM | $10^3$ | LCA & CSA |
| STCA | $10^4$ | LE | $2\times10^3$ | STCA |
| HyTRec | $10^4$ | - | $10^4$ | HA |
| HiSAC | $10^4$ | HC | $2\times10^2$ | MHA |
| HyFormer | $3\times10^3$ | - | - | CA |
| MTFM | - | - | - | GQA & HTA |
| LONGER | $2\times10^3$ | TM | $10^3$ | CA & SA |
| TM20K-S | $2\times10^4$ | TM | $2\times10^3$ | FA |
| TM20K-T | $2\times10^4$ | - | $2\times10^4$ | FA |
论文的核心比喻贯穿全文:老师需要逐字精读全部文献来积累知识(低效但只做一次),学生则在老师指导下快速扫读完成学习。据此,把 full transformer 的重计算全部下放给一个只训练一次、且永远不需要在线推理的教师模型;线上服务的学生模型通过 token merge 大幅压缩序列长度,再靠蒸馏把教师的知识拿回来。
前置:问题形式化与两个关键观察¶
问题形式化¶
在字节的广告 CVR 预估场景中,电商序列 $S=\{s_1,s_2,\cdots,s_L\}$ 的每个 token 由一个关键 ID 特征 $p_i$(如商品 ID)和其他特征 $o_i$ 构成,即 $s_i=[p_i,o_i]$。token 级特征先各自 embedding 再 sum pooling:
$$E_{s_i} = \mathrm{SumPooling}\left(E_{p_i},\, E_{o_i}\right) \tag{1}$$
所有 token embedding 堆叠为序列张量 $E_s\in\mathbb{R}^{L\times d}$,送入序列建模模块做 target-aware 特征抽取:
$$x_{\mathrm{seq}} = \mathcal{F}_{\mathrm{seq}}\left(e_t,\, E_s\right) \tag{2}$$
其中 $e_t\in\mathbb{R}^d$ 是目标候选广告的 embedding。随后序列表征与非序列特征通过 RankMixer 做高阶特征交互:
$$h = \mathcal{F}_{\mathrm{interaction}}\left(x_{\mathrm{non\text{-}seq}},\, x_{\mathrm{seq}}\right) \tag{3}$$
最终表征 $h$ 用于预测转化率,模型以交叉熵损失更新。
观察一:full attention 显著优于 target attention¶
论文首先要回答"$\mathcal{F}_{\mathrm{seq}}$ 到底该用什么"。Full attention(FA)把目标 token 与序列 token 拼在一起做完整自注意力:
$$E_c = \mathrm{Concat}\left(e_t,\, E_s\right) \tag{4}$$
$$A_c = \mathrm{Softmax}\left(\frac{E_cW^Q(E_cW^K)^T}{\sqrt{d}} + \mathcal{M}\right)E_cW^V \tag{5}$$
$$O_c = \left(A_cW^u \odot \mathrm{Swish}\left(A_cW^v\right)\right)W^d \tag{6}$$
其中 $\mathcal{M}$ 是因果 mask,禁止早期 token 关注后续 token——这既是语义要求,也是 M-Falcon serving 的硬性前提(有了因果结构,用户侧序列计算才能在同一请求的多个候选间复用)。
相比之下,target attention(TA)只算目标对序列的单向注意力,且只有目标特征过 SwiGLU FFN:
$$a_t = \mathrm{Softmax}\left(\frac{e_tW^Q(E_sW^K)^T}{\sqrt{d}}\right)E_sW^V \tag{7}$$
$$o_t = \left(a_tW^u \odot \mathrm{Swish}\left(a_tW^v\right)\right)W^d \tag{8}$$
这种设计的固有缺陷是序列特征抽取不足,尤其在超长序列上。
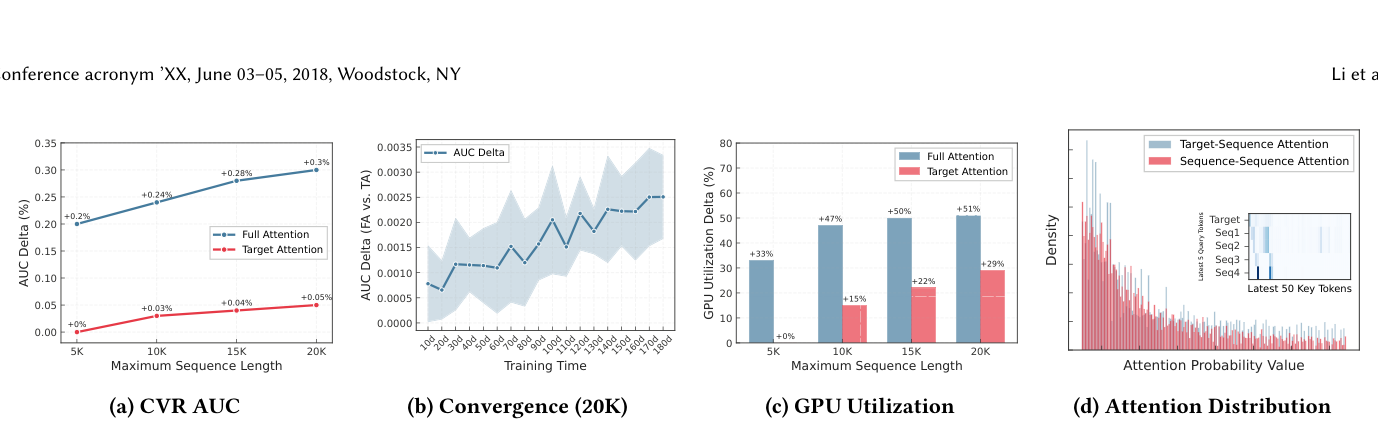
作者用 6 层 transformer 骨干在 5K/10K/15K/20K 四档长度上做了对照实验(相对 5K+TA 基线报告 AUC 相对增益):FA 在四档上分别取得 +0.2% / +0.24% / +0.28% / +0.3%,而 TA 只有 +0% / +0.03% / +0.04% / +0.05%——TA 几乎无法从更长的序列中获得增益,FA 在 20K 上的 AUC 优势可达 0.25%。Fig. 2(b) 用超过半年的训练数据显示 FA 对 TA 的优势随训练持续扩大(AUC Delta 从约 0.0008 单调升到 0.0025)。Fig. 2(c) 显示 FA 的 GPU 利用率也更高(20K 时 +51% vs TA 的 +29%),说明 FA 不只是"更贵",它把硬件用得更满。
Fig. 2(d) 是最关键的机制证据:把第一层的 target-sequence 注意力与 sequence-sequence 注意力分布分别画出来,两者没有明显差异;放大到 5 个 query token(1 个 target + 4 个序列 token)× 50 个 key token 的局部区域后可见,seq-seq 交互承载了不能直接丢弃的预测信息。作者指出这一结论与 EST 的发现略有出入,并推测原因是:EST 用了 search-based 压缩,这本身就强化了 target-sequence 交互,从而相对削弱了 seq-seq 依赖的重要性。
观察二:注意力分数的三条统计规律¶
在 FA 用完整 20K token 训练后,作者取注意力概率矩阵的一个局部子矩阵 $A\in\mathbb{R}^{m\times n}$($m=5$ 个 query,$n=L=20{,}000$ 个 key,只报第一个注意力头)做统计,得到三条直接驱动方法设计的观察(对应论文 Figure 3,本次图片提取未覆盖该图):
- 同 ID 的 token 注意力分数更接近。按 $p_i$ 是否等于 $p_j$ 把 $|A_{t,i}-A_{t,j}|$ 分成两组,同商品 ID 组的差值分布明显更集中 → 同 ID token 可以合并。
- 最近的 10% token 贡献了接近一半的注意力权重。按位置索引分桶累加 $\sum_{j=i_k}^{i_{k+1}}A_{t,j}$,累积概率曲线在前 10% 就冲到约 0.5 → 应该按位置施加不同的压缩强度。
- 上层注意力比底层更尖锐。用注意力概率的熵 $-\sum_i A_{t,i}\log A_{t,i}$ 度量,底层分布更均匀、上层更集中 → 可以逐层递进地加大压缩力度。
这三条观察分别对应下面三个 token merge 策略,方法与证据的对应关系非常干净。
核心方法:TM20K 框架¶
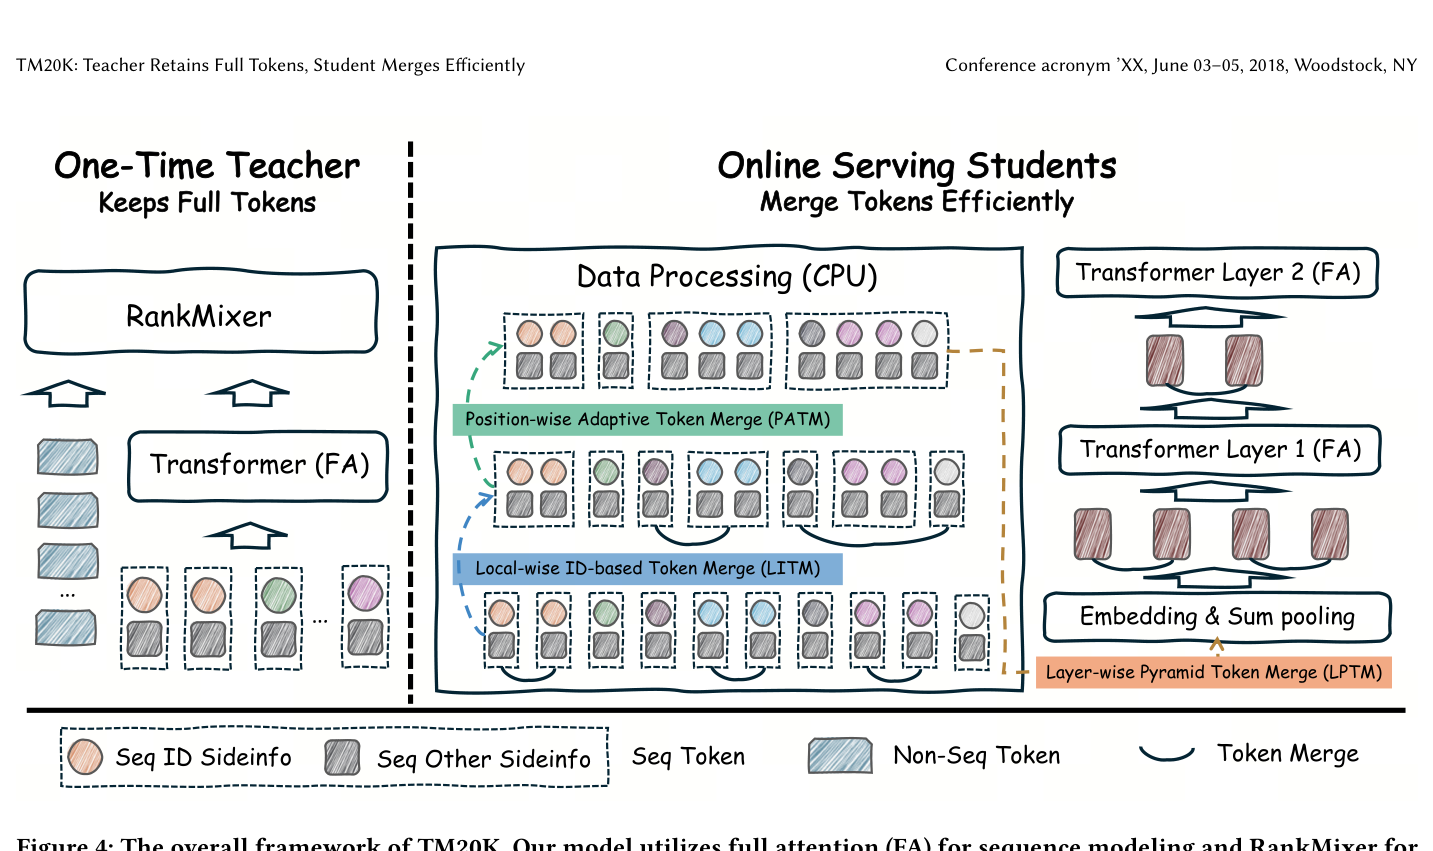
教师与学生共用同一套架构(FA transformer + RankMixer),区别只在于是否做 token merge。教师保留全部序列 token,虽然低效但只训练一次、且不需要在线部署,因此在大规模推荐场景下其开销近似可忽略;学生负责线上服务,通过三种 token merge 压缩序列。
Local-wise ID-based Token Merge(LITM)¶
用户常在短时间窗内对同一商品发生多次交互。LITM 沿序列扫描,把 ID 相同且位置间隔不超过阈值 $T$ 的 token 连续合并(求和):
Algorithm 1(LITM) 输入:$E\in\mathbb{R}^{L\times d}$,ID 列表 $p\in\mathbb{I}^L$,最大间隔阈值 $T$ 1. 初始化 id→index 映射 $\mathcal{P}$ 为空,合并列表 $\mathcal{G}$ 为空 2. for $j=0$ to $L-1$: 3. 若 $p_j\notin\mathcal{P}$ 或 $j-\mathcal{P}[p_j]>T$:把 $E_j$ 追加进 $\mathcal{G}$,并记录 $\mathcal{P}[p_j]\leftarrow|\mathcal{G}|-1$ 4. 否则:$\mathcal{G}[\mathcal{P}[p_j]]\leftarrow \mathrm{Sum}\left(\mathcal{G}[\mathcal{P}[p_j]],\,E_j\right)$ 5. 返回合并后的序列 $E_m\in\mathbb{R}^{L'\times d}$
实现中固定 $T=3$,只聚合短局部窗口内针对同一 key ID 的连续交互。LITM 的副产品有三个:产出更凝练的信息表征、滤掉异常行为噪声、以及进一步强化用户隐私保护(多次交互被压成一个 token)。
Position-wise Adaptive Token Merge(PATM)¶
PATM 按位置施加不同压缩强度:把长度 $L$ 切成 $B$ 个不相交段(段范围列表 $R$),每段用自己的压缩因子 $K_b$ 做 LONGER 式的 token merge。
Algorithm 2(PATM) 输入:$E\in\mathbb{R}^{L\times d}$,段数 $B$,段范围 $R$,压缩因子 $K$ 1. for $b=0$ to $B-1$:取 $(s,e)\leftarrow R_b$,$k\leftarrow K_b$ 2. $\hat{E}=\mathrm{Sum}\left(\mathrm{Reshape}(E[s:e],(-1,k,d)),\,\mathrm{dim}=1\right)$,即合并 $k$ 个连续 token 3. 追加进 $\mathcal{G}$ 4. 返回 $E_m\in\mathbb{R}^{L'\times d}$
约定位置索引越小表示交互越新,因此段范围与压缩因子只需满足一条核心原则:近期行为最少合并,久远历史激进压缩。论文给的例子是 $L=20{,}000$、$B=4$、$R=[[1,1000],[1001,5000],[5001,10000],[10001,20000]]$、$K=[1,2,3,4]$,合并后序列长度约 7,000。工程细节上,每段会用全零 token 补齐到能被自己的压缩因子整除。相较之下,LONGER 对整条序列做统一 token merge,等于给近期与久远 token 分配了相同的重要性——这正是 PATM 的差异点。
Layer-wise Pyramid Token Merge(LPTM)¶
LPTM 让序列长度沿层数形成金字塔:底层处理长序列,上层处理短得多的序列。设第 $n$ 层输出为 $\hat{E}_n\in\mathbb{R}^{L_n\times d}$,则第 $n+1$ 层输入为:
$$E_{n+1} = \mathrm{Sum}\left(\mathrm{Reshape}\left(\hat{E}_n,\,(L_n/2,\,2,\,d)\right),\,\mathrm{dim}=1\right) \tag{9}$$
即每两个相邻 token 求和,长度减半。
Algorithm 3(LPTM):for $n=0$ to $N-1$:$\hat{E}_n\leftarrow\mathrm{TransLayer}(E_n)$(按 Eq. 4–6),$E_{n+1}\leftarrow\mathrm{Merge}(\hat{E}_n)$(按 Eq. 9)
两个重要细节:只有历史序列 token 参与逐层合并,目标候选 token 永不被合并;Eq. 9 也可以每隔若干层执行一次以平衡效果与效率——本文用 6 层 transformer,每 2 层做一次。
工程实现¶
三个策略按 LITM → PATM → LPTM 的顺序作用。LITM 与 PATM 的计算放在 CPU 上,理由有二:一是这类规则型合并 CPU 友好、不适合 GPU 加速;二是不在 CPU 上合并 embedding,而是合并每个 token 的原始特征——先按 LITM/PATM 把 token 的特征分组,再去 embedding table 查表并 sum pooling,这样显著降低了 CPU 与 GPU 之间的通信带宽开销。LPTM 只需对标准 transformer 做小改动,Eq. 9 用张量算子在 GPU 上高效实现。
教师模型与蒸馏¶
教师完全不考虑效率,独立于所有学生训练,其预测 logits 被缓存下来监督学生训练。教师用二元交叉熵优化:
$$\ell_{ce} = -y\log q_{\mathcal{T}} - (1-y)\log(1-q_{\mathcal{T}}) \tag{10}$$
其中 $q_{\mathcal{T}}=\mathrm{Sigmoid}(g_{\mathcal{T}})$、$g_{\mathcal{T}}=\mathrm{MLP}(h_{\mathcal{T}})$ 是教师预测的转化率,被缓存用于 KD。
学生设两个独立预测头:一个主塔(main tower)负责线上服务,一个蒸馏塔(distillation tower)负责吸收教师知识:
$$\ell_{\mathrm{main}} = -y\log q_{\mathcal{S},\mathrm{main}} - (1-y)\log(1-q_{\mathcal{S},\mathrm{main}}) \tag{11}$$
$$\ell_{\mathrm{dis}} = \ell_{ce} + \lambda\,\ell_{kd} \tag{12}$$
$$\ell_{ce} = -y\log q_{\mathcal{S},\mathrm{dis}} - (1-y)\log(1-q_{\mathcal{S},\mathrm{dis}}) \tag{13}$$
$$\ell_{kd} = -q_{\mathcal{T}}\log q_{\mathcal{S},\mathrm{dis}} - (1-q_{\mathcal{T}})\log(1-q_{\mathcal{S},\mathrm{dis}}) \tag{14}$$
其中 $q_{\mathcal{S},\star}=\mathrm{Sigmoid}(\mathrm{MLP}_\star(h_{\mathcal{S}}))$,$\star\in\{\mathrm{main},\mathrm{dis}\}$,$\lambda$ 是蒸馏权重超参。这种双塔设计的意义是风险隔离:即使蒸馏信号延迟或不稳定,线上服务的主塔也不受影响。
其他工程设计¶
基线模型已经用上了 User-Level Training(类似 STCA 的 RLB)、FlashAttention、混合精度训练、Remove-Padding 与 M-Falcon Serving。本文额外引入两项:
- Stack Sequence:batch 内序列长度极不均匀,原始做法把所有序列 pad 到最长长度做 embedding 查表,得到 $E_s\in\mathbb{R}^{B\times L_{\max}\times d}$,但有效 token 总数 $L_{\mathrm{total}}=\sum_{i=1}^{B}L_{\mathrm{valid},i}$ 往往远小于 $B\times L_{\max}$,造成大量显存浪费。做法是把所有有效 token 在 batch 维度上均匀重分配并记录每个实例的有效 token 数,得到 $E_{\mathrm{stack},s}\in\mathbb{R}^{B\times L\times d}$,$L=\lceil L_{\mathrm{total}}/B\rceil$,随后在 GPU 上按记录的计数重建 remove-padding 张量。对完整 20K 序列可省下最多 10GB 显存。
- QK Norm:引入超长序列 + KD 损失后,学生模型频繁训练发散。借鉴 LLM 中缓解极端注意力分数不稳定的做法,在注意力计算前对 query 与 key 做归一化。代价是微小的显存与计算开销,收益是整个训练过程稳定。
实验设置¶
- 数据集:真实广告系统采集的工业级 CVR 预估数据集,训练语料跨连续两个月、含数十亿训练样本,超长序列由历史电商交互构成。除序列特征外还有用户、物品、上下文特征进入常规特征交互模块。所有数据经匿名化与 ID 哈希处理。
- 基线:baseline 是一个 6 层 FA transformer、最大长度 5K、已长期在线服务的成熟广告排序模型。对比方法包括 STCA(stacked cross attention + 长度外推)、LONGER(统一 token merge UTM + Perceiver)、MTFM(GQA + 混合 target attention)、HyFormer(专用交互块建模序列与非序列特征的交叉关系)。DIN 与 TWIN 也跑了,但由于序列建模范式过于简单(如只有一层交互)性能明显下降,论文未报告。EST 与 HiSAC 因依赖训练好的多模态 embedding 支撑其检索/聚类流程而被排除。
- 超参数:transformer 隐层维度 512,FFN 用 SwiGLU 激活、中间维度 1024,全局 batch size 320;教师因显存压力用更小的 batch size 96;实验在数百 GPU 的分布式集群上运行,采用 next-batch 评估机制。
- 指标:预测侧用 AUC 与 LogLoss;效率侧用训练吞吐(Thr)与峰值 GPU 显存(Mem);同时报告 MaxLen / AvgLen / P90 Len 三个序列长度统计量。
主要实验结果¶
Table 2: 所有方法的效果与效率对比(所有 AUC/LogLoss 的 delta 均相对长期在线服务的 5K 基线)
| MaxL | LenCom | AvgL | P90L | Method | AUC(↑) | ΔAUC(%) | LogLoss(↓) | ΔLogLoss(%) | Thr | Mem |
|---|---|---|---|---|---|---|---|---|---|---|
| 5K | LITM0 & UTM2 | 1.2K | 1.6K | Base | 0.8212 | – | 0.4917 | – | 88K | 52G |
| 5K | LITM0 & UTM2 | 1.2K | 1.6K | STCA | 0.8200 | -0.15% | 0.4931 | +0.29% | 137K | 40G |
| 5K | LITM0 & UTM2 | 1.2K | 1.6K | LONGER | 0.8215 | +0.04% | 0.4914 | -0.07% | 100K | 58G |
| 5K | LITM0 & UTM2 | 1.2K | 1.6K | MTFM | 0.8213 | +0.01% | 0.4916 | -0.02% | 105K | 37G |
| 5K | LITM0 & UTM2 | 1.2K | 1.6K | HyFormer | 0.8216 | +0.05% | 0.4913 | -0.08% | 80K | 55G |
| 20K | UTM2 | 4.4K | 10K | STCA | 0.8210 | -0.02% | 0.4920 | +0.05% | 58K | 68G |
| 20K | UTM2 | 4.4K | 10K | LONGER | 0.8221 | +0.11% | 0.4907 | -0.21% | 48K | 70G |
| 20K | UTM2 | 4.4K | 10K | MTFM | 0.8219 | +0.08% | 0.4909 | -0.16% | 27K | 81G |
| 20K | UTM2 | 4.4K | 10K | HyFormer | 0.8222 | +0.12% | 0.4906 | -0.23% | 36K | 75G |
| 20K | TM20K | 8.8K | 20K | TM20K-T | 0.8233 | +0.26% | 0.4890 | -0.55% | 11K | 86G |
| 20K | TM20K | 1.8K | 2.6K | TM20K-S | 0.8224 | +0.15% | 0.4903 | -0.29% | 83K | 74G |
| 20K | TM20K | 1.8K | 2.6K | TM20K-S w/ KD | 0.8230 | +0.22% | 0.4896 | -0.43% | 83K | 74G |
结论分析:
- 5K 档:STCA 掉 0.15% AUC,说明在相同层数与隐层维度下,stacked cross attention 的建模容量确实比不上原生 full attention——这与观察一互相印证。LONGER/MTFM/HyFormer 只有 +0.04%/+0.01%/+0.05% 的微弱增益。效率上 STCA 与 MTFM 省显存、提吞吐,HyFormer 则是"微弱增益 + 更低吞吐 + 更高显存"的亏本买卖。
- 20K 档:为了让对比方法能跑,统一施加 UTM2 压缩。除 STCA 外三个方法拿到 +0.08%~+0.12% 的正收益,证明更长的行为序列确实携带额外预测信号;但吞吐相对 5K 基线全部下跌超过 50%(48K/27K/36K vs 88K),实际不可上线。
- TM20K-T:拿到最大的 +0.26% AUC 与最低的 LogLoss(-0.55%),确认完整未压缩的 20K 序列才是预测质量的上限。代价是吞吐从 88K 崩到 11K、显存 86G,作为在线模型完全不可行——但作为一次性教师完全可以接受。
- TM20K-S:三种 token merge 把平均序列长度从教师的 8.8K 压到 1.8K(P90 从 20K 压到 2.6K),独立 AUC 增益回落到 +0.15%,但吞吐只从 88K 降到 83K,仅退化 5%。这一步把"长序列学生"与"短序列基线"之间的效率鸿沟几乎抹平。
- TM20K-S w/ KD:接入教师 logits 蒸馏后 AUC 增益升到 +0.22%,恢复了教师全部性能增益的约 85%,而吞吐与显存完全不变——蒸馏是纯粹的"训练期换效果",不增加任何在线成本。
消融与分析¶
Table 3: token merge 策略消融(结果相对各自的全序列基线)
| TM Strategy | AvgL | P90L | ΔAUC(↑) | Thr |
|---|---|---|---|---|
| 5K Full | 4K | 5K | – | 40K |
| +UTM2 | 2K | 2.5K | -0.03% | 72K |
| +LITM0 & UTM2 | 1.2K | 1.6K | -0.05% | 88K |
| 20K Full | 8.8K | 20K | – | 11K |
| +LITM | 5K | 11.3K | -0.02% | 25K |
| +PATM | 4.5K | 10.2K | -0.06% | 34K |
| +LPTM | 8.8K | 20K | -0.03% | 19K |
| +LITM & PATM | 1.8K | 2.6K | -0.07% | 68K |
| +LITM & PATM & LPTM | 1.8K | 2.6K | -0.11% | 83K |
分析:5K 档上 UTM2 单独用只掉 0.03% AUC 却把吞吐从 40K 提到 72K;再叠 LITM0 压到 1.2K,AUC 累计只掉 0.05%,吞吐到 88K——这正是当前线上基线的配置。20K 档上,LITM 把平均长度从 8.8K 降到 5K(-40%)、吞吐翻倍,AUC 只掉 0.02%,是三者中"性价比"最高的;PATM 压到 4.5K(-48%)、吞吐三倍,AUC 掉 0.06%;LPTM 不改变第一层的序列长度分布(表中 AvgL/P90L 保持 8.8K/20K,因为论文只报第一输入层的长度,中间层才被逐层减半),但带来明显吞吐提升(11K→19K)与 0.03% 的小幅 AUC 损失。三者叠加后总 AUC 损失 0.11%、吞吐 83K——损失并非严格可加(0.02+0.06+0.03=0.11 恰好相等属于巧合级的接近),但整体退化被控制在可接受范围。
Table 4: LITM 与 PATM 的超参数分析(相对 20K 全序列)
| Hyperparameter | ΔAvgLen(↓) | ΔAUC(↑) |
|---|---|---|
| LITM $T=1$ | −39% | −0.02% |
| LITM $T=3$ | −43% | −0.02% |
| LITM $T=10$ | −57% | −0.04% |
| PATM 2K:1,4K:2,8K:3,20K:4 | −55% | −0.09% |
| PATM 3K:1,5K:2,10K:3,20K:4 | −49% | −0.06% |
| PATM 4K:1,8K:2,12K:3,20K:4 | −40% | −0.05% |
$T$ 从 1 升到 3 时平均长度额外多压 4% 而 AUC 完全不变,因此选 $T=3$;升到 10 则多掉 0.02%。PATM 三组配置显示出清晰的正相关:压缩越激进 AUC 掉得越多。作者明确说明工业选型原则是"优先把线上服务延迟控制在可接受范围内,宁可容忍略高的 AUC 损失也要避免效率过度恶化",因此上线用的是中等压缩强度的配置。
Table 5: 蒸馏权重 $\lambda$ 的影响(相对 TM20K-S 模型的 AUC 增益)
| $\lambda=30$ | $\boldsymbol{\lambda=50}$ | $\lambda=75$ | $\lambda=100$ | $\lambda=150$ | |
|---|---|---|---|---|---|
| ΔAUC(↑) | -0.01% | +0.00% | -0.01% | -0.01% | -0.03% |
$\lambda=50$ 最优。作者进一步检查损失量级后发现:在 $\lambda=50$ 时,缩放后的蒸馏损失项 $\lambda\ell_{kd}$ 与 $\ell_{ce}$ 的量级几乎一致——这给出了一个可迁移的调参启发式:把两项损失对齐到同一数量级即可,而不必去搜索一个"和为 1"的权重。
Table 6: 其他实现细节的影响(相对 TM20K-S)
| Early ΔAUC(↑) | Late ΔAUC(↑) | Thr | |
|---|---|---|---|
| w/ MeanPooling & LogN | -0.01% | -0.01% | +0% |
| w/ PATM on SeqInc | +0.01% | +0.01% | +0% |
| w/o QK Norm | +0.00% | -0.45% | +2% |
| w/o KD in Late Period | +0.00% | +0.00% | +0% |
四条结论:(1)把 token merge 的 sum pooling 换成 mean pooling 并按 TWIN-V2 的做法在注意力权重里加入 $\log(n)$($n$ 为被合并 token 数),反而掉 0.01% AUC——求和本身携带了"合并了多少个 token"的强度信息,均值化会把它抹掉。(2)只对 5K 之外的增量 token 做 PATM 压缩能拿到 +0.01% 的微弱收益,但会大幅抬高开发的工程复杂度,不划算。(3)去掉 QK Norm 是全表最危险的一项:训练早期看不出差别(+0.00%),但随训练推进会出现训练发散,晚期 AUC 崩掉 0.45%——2% 的吞吐收益完全不值得。(4)训练后期移除蒸馏损失,最终效果几乎不变,说明学生在足够的蒸馏迭代后已经充分吸收了教师知识,蒸馏信号可以在后期安全下线(这对生产环境降低教师侧成本很有意义)。
线上 A/B 结果¶
Table 7: 工业广告场景线上 A/B
| ADSS | ADVV | Serving Latency | |
|---|---|---|---|
| TM20K-S | +0.881% | +0.515% | +5.6% |
| TM20K-S w/ KD | +1.036% | +0.780% | +5.6% |
对照组是长期在线服务、使用 5K 电商序列建模的成熟广告排序模型。TM20K 在所有核心业务指标上取得统计显著的正收益:ADSS(Advertiser Score)+1.036%、ADVV(Advertiser Value)+0.780%,而线上服务延迟只增加 5.6%。特别值得注意的是:蒸馏把 ADSS 从 +0.881% 抬到 +1.036%(相对多拿 17.6% 的收益)、ADVV 从 +0.515% 抬到 +0.780%(多拿 51.5%),而延迟一点没变——这是全文最有说服力的一组数字,直接证明了"把重计算下放给一次性教师"这条路线的工业经济性。
核心贡献总结¶
- 面向超长序列建模的两阶段蒸馏框架:一次性训练的教师保留全量序列 token,学生通过 token merge 高效在线服务,把"序列长度 scaling 的收益"与"在线推理成本"解耦。
- 三种简单但动机充分的 token merge 策略:LITM/PATM/LPTM 分别对应"同 ID 注意力接近""近期 token 权重占半""上层注意力更尖锐"三条实测观察,实现简单且效果有竞争力。
- 显著的效果提升:离线实验验证了框架优势,线上取得 ADSS +1.036%,额外开销可忽略。
与已归档相关工作的对比¶
CCFormer CCFormer: Efficient Cross-Field Interaction and Hierarchical Sequence Compression(Tencent PCG, 2026-07-30)¶
关系:独立并发(本文未引用 CCFormer,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把工业排序中"长行为序列 × 自注意力二次复杂度"当作首要瓶颈,且都明确拒绝 truncation / search-based 检索这条捷径——CCFormer 的原话是截断"不可避免地丢弃潜在有用的长期兴趣",TM20K 的原话是 search-based 方法"不可避免地丢弃细粒度、潜在有价值的行为信息"。两者的共同信念是:必须保留对全序列的访问,只能压缩,不能丢弃。
- 相近的技术骨架:CCFormer 的 Hierarchical Token Compression 在每个 block 之后沿序列维施加 $\mathrm{Conv1D}_{k,s}$ 下采样,感受野随层数扩张 3→7→15→31,序列长度 8→4→2→1;TM20K 的 LPTM 每 2 层做一次 $\mathrm{Sum}(\mathrm{Reshape}(\hat{E}_n,(L_n/2,2,d)))$ 让长度减半。两者本质上是同一个算子的两种参数化——跨层渐进的局部聚合,浅层保留细粒度短期模式、深层抽取抽象长期偏好。CCFormer 用可学习卷积核,TM20K 用零参数的求和,后者更廉价、也更容易在既有 transformer 上打补丁。
- 本文的差异与推进:分歧点在"序列内交互该怎么算"。CCFormer 彻底删掉了 intra-sequence self-attention,改用 Subspace Token Mixing(把 $m$ 条相邻行为与 $n$ 个隐藏维打包成子空间向量 + per-channel 门控 FFN)+ 三条有向 cross attention,把复杂度做到线性于 $L_s$;TM20K 则用 Fig. 2(d) 的注意力分布证据主张 seq-seq 交互不可删除,坚持 full attention,只在 token 数量上做文章。两者对"seq-seq 依赖是否重要"给出了相反的工程答案,是一组很干净的对照。此外 TM20K 多了一层 CCFormer 没有的东西:用一次性教师的蒸馏把压缩造成的精度损失补回来(+0.15%→+0.22%)。
- 可比的方法/实验差异:规模上完全不在一个量级——CCFormer 的工业序列长度是 1000、公开数据集截断到 200,TM20K 直接对 20K 原始序列作业;CCFormer 报训练加速 2.21× 与线上 +3.57% CTR / +1.71% 广告收入(腾讯两个场景全量部署),TM20K 报吞吐从 11K 恢复到 83K 与线上 ADSS +1.036% / 延迟 +5.6%。两者都没有公开数据集上的可比 benchmark 交集(TM20K 完全没跑公开数据集)。
Rec-Distill Rec-Distill: An Industrial Distillation Pipeline for Large-Scale Recommendation Models(ByteDance AML, 2026-05-28)¶
关系:显式引用但原文未展开对比(仅作为 KD 框架与双塔设计的出处被引 [7],无指标级或机制级比较)· 已加载对方精读
- 共同关注的问题:两篇同属字节,面对的是同一个"规模-效率"两难:模型(或序列)越大线上效果越好,但在线延迟与 ROI 不允许。解法的元结构完全一致——用解耦蒸馏把"模型规模"与"在线推理成本"拆开:教师只训不服务,学生只服务不承担教师的算力。
- 相近的技术骨架:细节级的重合度高得惊人。(a)都采用前向蒸馏 + logits 缓存,教师前向时就把 logits 写进外部存储供学生消费,而非 co-train;(b)都用黑盒 CE 蒸馏而非白盒中间特征对齐;(c)都用解耦双塔学生——主任务塔只用真实标签、负责线上,辅助/蒸馏塔吃蒸馏信号,共享 backbone,目的都是风险隔离;(d)都发现蒸馏损失与任务损失的量级比是关键超参:Rec-Distill 明确放弃了"两项权重和为 1"的传统约束、指出二分类下 $\mathcal{L}_{distill}$ 可能比 $\mathcal{L}_{task}$ 小两个数量级,TM20K 则从 $\lambda$ 扫描中得出"$\lambda=50$ 时 $\lambda\ell_{kd}$ 与 $\ell_{ce}$ 量级几乎相同"——这是同一条经验的两次独立落地。
- 本文的差异与推进:scaling 轴不同。Rec-Distill 沿稠密参数(TokenMixer-Large 到 24B)、序列建模(用 LONGER 做到 20K)、训练数据量三条轴同时放大教师,学生的省钱来自"整体更小的模型";TM20K 只沿序列长度这一条轴放大教师(教师就是原架构 + 完整 20K token),学生与教师同架构同参数量,省钱完全来自 token 数量的压缩。这意味着 TM20K 的师生容量鸿沟远小于 Rec-Distill——这也解释了为什么 TM20K 能拿到约 85% 的迁移率,而 Rec-Distill 报告的峰值可迁移性 $\eta$ 是 60%+:师生差异越窄,知识越容易迁移。另一方面 Rec-Distill 处理了 TM20K 完全没碰的问题:师生采样策略不同导致的去偏空间失配(把教师原始 logit $T_1$ 先过学生侧去偏函数 $f_S$ 再匹配),以及批流混合流水线;TM20K 则处理了 Rec-Distill 没碰的问题:学生侧序列压缩本身该怎么设计。两篇其实是同一套流水线的上下游,TM20K 可以看作 Rec-Distill 框架在"序列长度"这一 scaling 轴上的一次专门化实例化。
- 可比的方法/实验差异:Rec-Distill 的教师用的正是 LONGER 架构做 20K 序列,而 TM20K 的实验表明 LONGER(UTM2,20K)只拿到 +0.11% AUC、TM20K-T 拿到 +0.26%——如果这两组数字来自可比的场景,那么 TM20K-T 作为教师的绝对质量应当高于 Rec-Distill 所用的 LONGER 教师,$\Delta\mathrm{Gain}_{scale}$ 更大。可惜两篇没有共同的实验表,无法直接验证。
IAT IAT: Instance-As-Token Compression for Historical User Sequence Modeling(ByteDance, 2026-04-10)¶
关系:显式引用但原文未展开对比(§2.3 仅将其归入 "instance-as-token modeling" 的并发研究,一笔带过)· 已加载对方精读
- 共同关注的问题:两篇是同一批作者(Xinchun Li 均为第一作者)在同一个字节广告 CVR 场景上给出的两条不同路线,共享同一个底层困境:历史行为序列里有价值的信息远多于线上能负担的计算。IAT 把它表述为手工序列特征的"信息瓶颈",TM20K 把它表述为序列长度的"效率墙"——同一枚硬币的两面。
- 相近的技术骨架:两者的元架构是同一个——把重计算搬到一个离线/一次性阶段,把结果缓存起来喂给在线的轻量模型,且下游都是"序列建模模块 + RankMixer 特征交互"(TM20K 的 Eq. 1–3 与 IAT 的 Eq. 1 几乎是同一个 base model 的两次书写)。压缩的粒度也都是 token 级:IAT 把一整条历史训练样本压成一个 InsEmb token,TM20K 把若干个同 ID / 相邻位置的行为求和成一个 token。
- 本文的差异与推进:缓存的东西不同,决定了两条路线的上限不同。IAT 缓存的是表征(InsEmb 存进参数服务器,2 年 64 维的存储量级是数 TB),下游模型永远只能看到被压缩器固化过的 64 维表征,压缩器与下游模型无法端到端联合优化;TM20K 缓存的是教师的最终 logits,学生自己从原始特征端到端地重新学习整条序列,教师只提供软标签。因此 TM20K 不存在"表征被离线固化"这个结构性天花板——学生的表征能力和序列建模能力可以随参数量一起 scaling。代价是 TM20K 的教师必须持续训练以跟上数据分布,而 IAT 的 InsEmb 一旦写入就可以长期复用。
- 可比的方法/实验差异:两篇的线上收益不在同一口径(IAT 报的是跨多个字节广告场景的 in-domain / cross-domain A/B,TM20K 报的是单一电商广告场景的 ADSS/ADVV),无法直接比较。但一个有意思的对照是序列长度:IAT 的 InsEmb 序列长度是数百量级(流式阶段 SIT 输入截断到 256),TM20K 的学生有效长度是 1.8K、教师是 8.8K——IAT 用"每个 token 更重"换长度,TM20K 用"token 数量更多但更廉价"换信息量。
讨论与局限性¶
核心贡献与值得借鉴的设计。 这篇论文最值得学习的不是任何单个技术组件——LITM/PATM/LPTM 每一个单独看都朴素到近乎平凡(按 ID 求和、按位置分段求和、按层数减半求和,全是零参数的规则算子)——而是"观察→设计"的严密对应:三条注意力统计观察各自催生一个 merge 策略,每个策略都能在消融表里找到自己的效率/效果账单。这种做法在工业论文里非常稀缺,也让方法极易在别的系统上复现。另外三个工程细节值得单独记下来:(1)在 CPU 上合并原始特征而非 embedding,把合并做在查表之前,直接砍掉 CPU-GPU 通信带宽;(2)Stack Sequence 把 batch 内不等长序列的 token 重分配,对 20K 序列省下 10GB 显存;(3)QK Norm 的必要性只在训练晚期显现(早期 +0.00%、晚期 -0.45%),这类"早期看不出来的稳定性坑"是长序列 + KD 场景的典型陷阱。
工业落地价值。 部署路径非常清晰:教师用 batch size 96 在数百 GPU 上一次性训完、缓存 logits;学生沿用线上基线的全部优化(User-Level Training、FlashAttention、混合精度、Remove-Padding、M-Falcon Serving)加三个 merge 策略;A/B 拿到 ADSS +1.036%、ADVV +0.780%、延迟仅 +5.6%。"蒸馏是纯训练期成本、不增加任何在线开销" 这一点由 Table 7 中 TM20K-S 与 TM20K-S w/ KD 相同的 +5.6% 延迟直接坐实。Table 6 的最后一行还给出一个额外的运营优化空间:训练后期可以关掉蒸馏损失而效果不变,意味着教师侧的持续推理成本也能进一步压缩。
局限与争议。
- 规则型 merge 的可迁移性存疑。作者自己承认 LITM/PATM/LPTM 本质上是 rule-based,尽管在广告场景做了详尽的超参搜索,跨域部署仍需重新调参。PATM 的段边界与压缩因子($R$、$K$)尤其是场景相关的——它直接编码了"注意力质量如何随位置衰减"这一分布假设,换个场景(如短视频、直播)分布未必成立。一个自然的追问是:为什么不让 merge ratio 可学习?论文没有讨论。
- 未与稀疏注意力对比。论文明确把 NSA、Kwai Summary Attention 一类稀疏注意力留作 future work,理由是要让稀疏注意力算子与 User-Level Training、Remove-Padding、FlashAttention 同时兼容需要开发高度定制的 GPU kernel,工程成本过高。但这也意味着"token merge 是否真的优于稀疏注意力"这个核心问题在本文中悬而未决——两者都是在削减注意力的计算量,只是一个削 token 数、一个削注意力对数。
- 消融口径的不对称。Table 3 的 20K 档消融是相对"20K Full",而 Table 2 是相对"5K Base",两张表的 delta 不能直接相加;LPTM 那一行的 AvgL/P90L 仍写 8.8K/20K(因为只报第一输入层),容易造成"LPTM 不压缩序列"的误读,论文虽有脚注说明但表格本身不够自明。
- 完全没有公开数据集实验。全文只有一个工业 CVR 数据集,DIN 与 TWIN 的结果因"性能明显下降"而直接省略未报,EST 与 HiSAC 因依赖多模态 embedding 被排除在对比之外。这让方法的外部效度只能靠读者对字节工程团队的信任来支撑,也使得本文无法进入任何公开 benchmark 榜单。
- 教师的持续成本被低估。 论文反复强调教师"只训练一次",但推荐系统的教师必须跟随流式数据分布持续更新才不会退化(这正是 Rec-Distill 花大力气解决的问题)。TM20K 对教师如何在流式阶段维护、logits 缓存如何与流式训练对齐几乎没有着墨,"one-time"的措辞可能过于乐观。
与已有工作的差异定位。 相对 LONGER,本文的关键推进是把统一 token merge 换成位置自适应 + 层级金字塔的三重 merge,并叠加教师蒸馏;相对 TWIN/SIM 一脉的 search-based 路线,本文坚持不丢 token 且兼容 M-Falcon;相对 STCA/MTFM/HyFormer 一脉的轻量注意力路线,本文用注意力分布的实测证据主张 seq-seq 依赖不可省,坚持 full attention。整篇论文的方法论立场可以概括为一句话:在超长序列上,宁可减少 token 的数量,也不要削弱 token 之间的交互。