Parcae: Scaling Laws For Stable Looped Language Models¶
Hayden Prairie、Zachary Novack、Taylor Berg-Kirkpatrick、Daniel Y. Fu(UC San Diego + Together AI),arXiv 2604.12946v1,2026-04-14。
研究动机与背景¶
从 Kaplan 到 Chinchilla,scaling law 给出的处方是一致的:质量随训练 FLOPs 可预测地提升,而 FLOPs 主要靠"堆参数 + 堆数据"两条轴同步增长。这条路线的代价是模型的参数量、进而是部署时的显存占用一起膨胀。当推理开销在总算力中的占比越来越大、部署又开始往端侧走时,"不增加参数量却能增加算力"就成了一个有明确经济价值的问题。
层循环(layer looping)正是这样一条候选路径:把同一组层反复执行若干轮,FLOPs 随循环次数线性增长而参数量保持不变。这条线的代表工作包括 Universal Transformer、Geiping 等人的 recurrent depth model(RDM,即 Huginn)、Zhu 等人的 Ouro,以及 Saunshi 等人关于 looped transformer 与 latent reasoning 的分析。已有结果显示循环模型可以逼近更大的固定深度模型,并且天然具备 latent reasoning 与 per-token 自适应算力的潜力。
但本文(以及 Geiping、McLeish、Jeddi 等多份先前工作)观察到一个反复出现的障碍:循环架构的训练是不稳定的——残差状态爆炸、loss spike,训练要靠敏感的超参搜索和额外的残差归一化(Post-Norm)才能勉强收住。由于循环的对象是完整的非线性 transformer block,不稳定的来源在分析上很难被定位。更麻烦的是,即便某次训练收敛了,当模型按 Anil 等人的做法在训练中随机采样深度以换取更强的 test-time scaling 时,loss spike 仍会出现。
本文把问题收缩成一个明确的追问:如果能把循环模型训稳,循环能不能成为一条可预测的、正交于参数与数据的算力扩展轴?
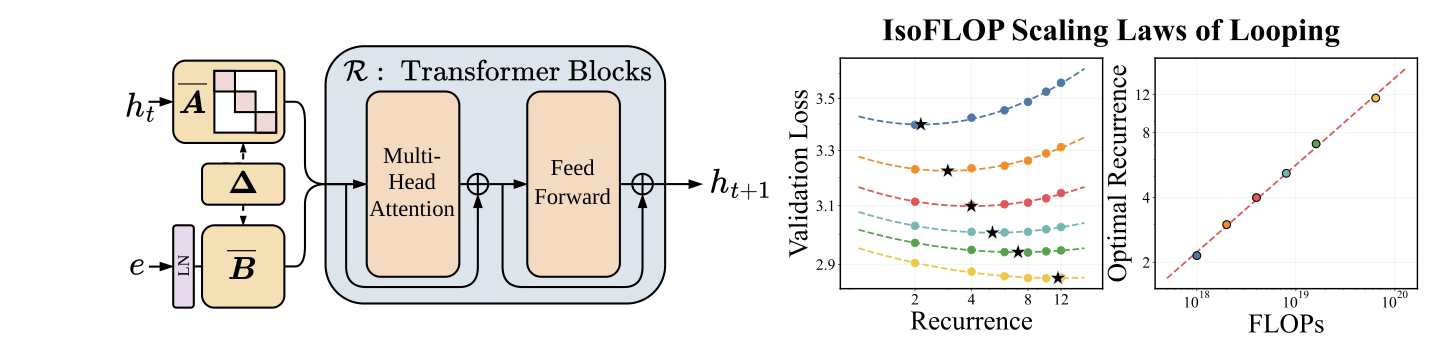
作者给出的分析入口是把前向过程重写为残差流上的动力系统:
$$h_{t+1} = \mathbf{A} h_t + \mathbf{B} e + \mathcal{R}(h_t, e) \tag{1}$$
其中 $e$ 是输入嵌入,$\mathbf{A}$ 控制前一时刻残差状态与当前状态之间的配比,$\mathbf{B}$ 控制输入对残差流的条件化,$\mathcal{R}$ 吞掉全部非线性算子(Attention、MLP)。把 $\mathcal{R}$ 丢掉做线性化,式 (1) 退化成一个离散线性时不变(LTI)系统——而 LTI 系统的稳定性在控制论里有一个干净的判据:由 $\mathbf{A}$ 的谱半径决定。作者随即发现,既有循环架构学到的 $\mathbf{A}$ 不满足这个判据,这正是残差爆炸的直接原因。
论文的三块贡献对应三组实验:
- 端到端质量:在参数与数据对齐的条件下,Parcae 相对 RDM 把验证集困惑度降低 6.2%(WikiText 上 9.1%);扩到 1.3B 参数 / 100B token 时,相对参数对齐的强 Transformer baseline,Core 与 Core-Extended 分别高 2.99 与 1.18 分,质量相当于两倍大小的 Transformer 的 87.5%。
- 训练 FLOP scaling:在固定参数、固定 FLOP 预算下做 isoFLOP 扫描,发现最优循环次数 $\mu_{\text{rec}}$ 与最优 token 数都随算力遵循幂律,即循环是与数据正交的一条扩展轴。
- Test-time scaling:推理时增加循环次数带来的收益遵循一条饱和指数衰减,其不可约下界正好等于训练律在 $T = \mu_{\text{rec}}$ 处的预测值,两者可以合并成一条统一律。
背景:中段循环架构与 LTI 系统¶
中段循环(middle-looped)架构¶
本文聚焦 Saunshi 等人论证过最有效的 middle-looped 形态:网络由三段构成——前奏单元 $P$、中段循环单元 $R$、终段 coda 单元 $C$。给定输入 $s \in V^n$($V$ 是词表,$n$ 是序列长度),输出 $p \in \mathbb{R}^{n \times |V|}$ 由下式给出:
$$e = P(s), \qquad h_{t+1} = R(h_t, e), \qquad p = C(h_T) \tag{2}$$
其中 $h_0 \sim \mathcal{N}(0, \sigma^2 I_{d \times d})$。直观上 $P$ 把输入嵌到潜空间,$R$ 以 $e$ 为条件把隐状态 $h_t \in \mathbb{R}^{n \times d}$ 迭代 $T$ 轮,$C$ 再把 $h_T$ 解码成 logits。
输入注入方式是各家的分歧点。已有两种:
$$\text{加法(Yang et al.):}\quad h_{t+1} = R(h_t + e), \qquad\qquad \text{拼接(Geiping et al.):}\quad h_{t+1} = R(W[h_t; e]) \tag{3}$$
其中 $W \in \mathbb{R}^{d \times 2d}$。
变深度训练:现代循环模型在训练时按 micro-batch 从分布 $\Lambda$(例如均值为 $\mu_{\text{rec}}$ 的 Poisson)采样深度 $T$,让模型见过多种深度,从而在推理时具备 test-time scaling 能力。同时借鉴 BPTT 的截断反向传播只对最后 $\mu_{\text{bwd}}$ 步回传梯度,把显存钉死在常数。
稳定性现状:Geiping 等人发现循环模型在规模上去后不稳定,于是采用了一种 Pre-Norm 与 Post-Norm 混合的 block 模式来强行归一化残差:
$$\bar{x}^{(\ell)} = \mathrm{LN}\big(\mathrm{MHA}(\mathrm{LN}(x^{(\ell-1)})) + x^{(\ell-1)}\big), \qquad x^{(\ell)} = \mathrm{LN}\big(\mathrm{FFN}(\mathrm{LN}(\bar{x}^{(\ell)})) + \bar{x}^{(\ell)}\big) \tag{4}$$
本文后面会证明:只要稳定性被正确地控制住,这层残差归一化就是多余的。
LTI 动力系统¶
连续时间 LTI 系统写作 $\dot{h}(t) = \mathbf{A}h(t) + \mathbf{B}e(t)$、$y(t) = \mathbf{C}h(t)$,其中 $\mathbf{A} \in \mathbb{R}^{d_h \times d_h}$ 决定系统自身动力学,$\mathbf{B}$ 决定外部输入如何影响状态,$\mathbf{C}$ 把状态投影到输出。用步长 $\Delta$ 离散化后得到 $h_t = \overline{\mathbf{A}} h_{t-1} + \overline{\mathbf{B}} e_t$,例如零阶保持(ZOH)给出
$$\overline{\mathbf{A}} = \exp(\Delta \mathbf{A}), \qquad \overline{\mathbf{B}} = (\Delta \mathbf{A})^{-1}\big(\exp(\Delta \mathbf{A}) - I\big)\cdot \Delta \mathbf{B} \tag{5}$$
LTI 系统按 $\mathbf{A}$ 的特征值分三种情形:稳定(有界收敛)、边缘稳定(振荡)、不稳定(爆炸发散)。连续系统要求 $\mathbf{A}$ 的特征值为负;离散系统要求 $\rho(\overline{\mathbf{A}}) < 1$($\rho$ 为谱半径),$\rho(\overline{\mathbf{A}}) > 1$ 即为不稳定。这条经典判据就是本文全部架构设计的支点。
Scaling law 的拟合方法¶
本文沿用 Hoffmann 等人(Chinchilla)的两类拟合:抛物线拟合——对每个 FLOP 预算拟合一条二次曲线,取极小值点估计最优模型尺寸或 token 数;参数化拟合——拟合 $\hat{L}(N, D) = E + X\cdot N^{-x} + Y\cdot D^{-y}$,用 Huber loss 在对数损失上做目标、L-BFGS 求解。
核心方法:不稳定性的动力系统诊断¶
把前向过程重写为动力系统¶
关键洞察是把前向过程看成残差流上的动力系统。沿用 Olsson 等人"残差流是通信通道、$h_T$ 是各层相对输出与原始嵌入之和"的解释,令 $\mathcal{R}$ 表示非线性算子的相对贡献:
$$\mathcal{R}(W_1 h_t + W_2 e) := R(W_1 h_t + W_2 e) - (W_1 h_t + W_2 e) \tag{6}$$
于是递推精确地改写为非线性时变动力系统 $h_t = \mathbf{A}h_{t-1} + \mathbf{B}e + \mathcal{R}(h_{t-1}, e)$、$y_t = \mathbf{C}h_t$,其中 $\mathbf{A} = W_1$、$\mathbf{B} = W_2$,$\mathbf{C} \in \mathbb{R}^{d_c \times d_h}$ 用来解耦 $C$ 与 $R$ 的嵌入维度(即 $p = C(\mathbf{C}h_T)$)。注意这一步没有做任何近似——非线性全部被塞进 $\mathcal{R}$。近似只发生在下一步:丢掉 $\mathcal{R}$ 做线性化,得到离散 LTI 系统
$$h_{t+1} = \mathbf{A}h_t + \mathbf{B}e \tag{7}$$
既有注入方式为什么不稳定¶
把式 (3) 的两种注入方式代进这个框架:
- 加法注入:$h_{t+1} = I h_t + I e + \mathcal{R}(I h_t + I e)$,线性化后 $\mathbf{A} = I$,全部特征值为 1,系统边缘稳定;
- 拼接注入:$h_{t+1} = W[h_t; e] + \mathcal{R}(W[h_t; e]) = W_1 h_t + W_2 e + \mathcal{R}(W_1 h_t + W_2 e)$,此时 $\mathbf{A} = W_1$ 完全无约束,训练中若不刻意维护就会把状态推向爆炸。
| 方法 | $\mathbf{A}$ | $\mathbf{B}$ | $\rho(\mathbf{A})$ | LTI 稳定性 |
|---|---|---|---|---|
| Addition | $I$ | $I$ | $\rho(\mathbf{A}) = 1$ | 边缘稳定 |
| Concatenation | $\mathbb{R}^{d_h \times d_h}$ | $\mathbb{R}^{d_h \times d_e}$ | $\rho(\mathbf{A}) \in \mathbb{R}$ | 不稳定 |
| Parcae (ours) | $\mathrm{ZOH}(\mathrm{Diag}(-\exp(\mathbb{R}^{d_h})))$ | $\mathrm{Euler}(\mathbb{R}^{d_h \times d_e})$ | $\rho(\mathbf{A}) < 1$ | 稳定 |
这套理论预测被两组实验直接验证:
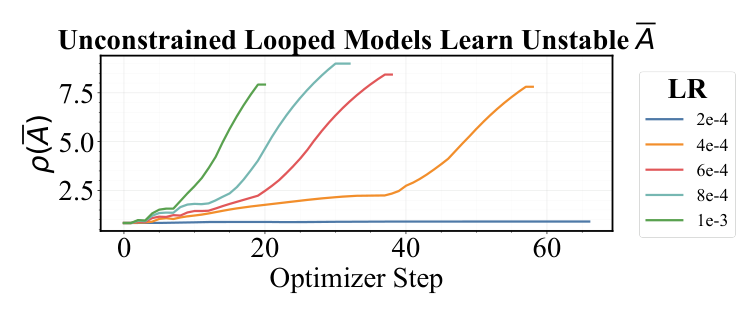
(a)谱半径与发散一一对应。 对一个 Pre-Norm RDM 在不同学习率下追踪训练过程中的 $\rho(\mathbf{A})$(原文 Figure 3),发散的 run 全部学到 $\rho(\mathbf{A}) \geq 1$(最高冲到 7 以上),收敛的 run 则保持 $\rho(\mathbf{A}) < 1$。
(b)不稳定表现为递归状态范数爆炸。 下图左侧是训练 loss,右侧是 $\|h_T\|_2$:baseline Pre-Norm 循环模型的状态范数冲到 $10^{17}$ 量级并发散,而残差归一化与 Parcae 都保持收敛。
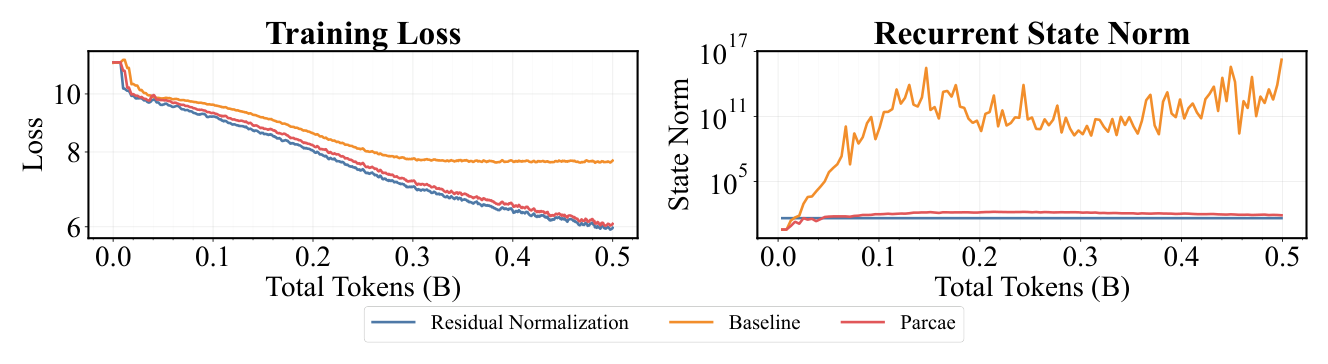
(c)超参鲁棒性。 在学习率 $\{2, 4, 6, 8, 10\}\times 10^{-4}$ 的扫描下(原文 Table 2):baseline 只在 $2\times 10^{-4}$ 收敛;残差归一化 RDM 撑到 $4\times 10^{-4}$;Parcae 五档全收敛。
| LR | Base | Res. Norm | Parcae |
|---|---|---|---|
| 2e-4 | ✓ | ✓ | ✓ |
| 4e-4 | ✗ | ✓ | ✓ |
| 6e-4 | ✗ | ✗ | ✓ |
| 8e-4 | ✗ | ✗ | ✓ |
| 1e-3 | ✗ | ✗ | ✓ |
此外在 1.3B 规模上,训练到 17 万步之后还会出现一类晚期 loss spike,作者把它单独归因到 $\mathbf{B}$ 的输入侧并用归一化解决(见后文附录 J 的诊断链条)。
Parcae:稳定的循环架构¶
参数化与离散化¶
Parcae 在连续形式下参数化 $\mathbf{A}, \mathbf{B}$,再用一个可学习的 $\Delta \in \mathbb{R}^{d_h}$ 分别以 ZOH 和 Euler 方案离散化(记号上约定 $\Delta \mathbf{A} = \Delta \odot \mathbf{A}$):
$$\overline{\mathbf{A}} = \exp(\Delta\mathbf{A}), \qquad \overline{\mathbf{B}} = \Delta \mathbf{B} \tag{8}$$
这一步沿用了 Mamba / SSD 一系的序列建模做法。为了把特征值逼到负半轴,$\mathbf{A}$ 被参数化为负对角矩阵:
$$\mathbf{A} := \mathrm{Diag}\big(-\exp(\log \mathbf{A})\big), \qquad \log \mathbf{A} \in \mathbb{R}^{d_h} \text{ 可学习} \tag{9}$$
$-\exp(\cdot)$ 强制负性,对角形式让"保证负特征值"这件事变得既简单又便宜——离散化后自动满足 $\rho(\overline{\mathbf{A}}) < 1$。作者明确说明,很多别的 $\mathbf{A}$ 形式也能work,选对角只是因为最省。
$\mathbf{B}$ 不加约束,取而代之的是在输入 $e$ 上加一层归一化。最终更新式为:
$$e = \mathrm{LN}(P(s)), \qquad h_{t+1} = \overline{\mathbf{A}}h_t + \overline{\mathbf{B}}e + \mathcal{R}(h_t, e), \qquad p = C(\mathbf{C}h_T) \tag{10}$$
其中 $h_0 \sim \mathcal{N}(0, \sigma I_{d_h \times d_h})$,$T$ 为循环次数。$P, R, C$ 分别用 $L_P, L_R, L_C$ 个 transformer block 实现。
两套对齐配置:(i)对 RDM 的对比中,Parcae 架构与 Geiping 等人的 RDM 完全一致,只差残差归一化与动力系统参数($\mathbf{A}, \mathbf{B}, \mathbf{C}, \Delta$);(ii)对 Transformer 的对比中,采用简化的 nanochat 配置,架构逐项对齐,只把中间三分之一的层拿去循环,并加上动力系统参数与 prelude norm。
完整前向过程(原文 Algorithm 1):
输入: 序列 s ∈ V^n, 循环步数 T
1. e ← LN(P(s))
2. h_0 ~ N(0, σ² I)
3. Ā, B̄ ← Discretize(A, B, Δ)
4. for t = 1..T:
5.     h_t ← Ā h_{t-1} + B̄ e + R(h_{t-1}, e)
6. return C(C h_T)
训练算法的两处修正¶
(1)Per-sequence 深度采样。 循环模型的训练目标是
$$\theta^\star = \arg\min_\theta \ \mathbb{E}_{(x,y)\sim \mathcal{D},\ T \sim \Lambda}\Big[\ell\big(f_\theta(x; T), y\big)\Big] \tag{11}$$
既然目标里对 $\Lambda$ 取期望,那么每个 global batch 里采到的深度种类越多,这个期望的估计就越忠实。既有做法是每个 micro-batch 采一个深度,本文改成在 micro-batch 内部按序列逐条采样。为了不牺牲效率,实现上取 batch 内最大深度 $T_{\max}$,对深度较浅的序列在递归开头空转(不更新状态):
Algorithm 2 高效的 per-sequence 随机深度训练
1. e^(i) ← P(s_i)                            # 逐序列嵌入
2. 对每个 i 采样 T^(i) ~ Λ(μ_rec)
3. T_max ← max_i T^(i);  τ^(i) ← T_max − T^(i)
4. h_0^(i) ~ N(0, σI)
5. Ā, B̄ ← Discretize(A, B, Δ)
6. for t = 0 .. T_max−1:
7.     若 t < τ^(i):                    h^(i)_{t+1} ← h^(i)_t          # 不更新
8.     若 τ^(i) ≤ t < T_max − μ_bwd:    正常递推,但不记录梯度
9.     若 t ≥ T_max − μ_bwd:            正常递推,记录梯度
10. return {C(C h^(i)_{T_max})}
这样既能在一个 batch 内覆盖多种深度,又能保持批处理效率与梯度流。代价只有 1.8% 的训练墙钟时间,作者认为还能靠更干净的实现进一步抹掉。
(2)采样分布的修正。 Geiping 等人的采样把总深度写成 $T = n + k$,其中 $k \equiv \mu_{\text{bwd}}$、$n$ 从一个以 $\mu_{\text{rec}} - \mu_{\text{bwd}}$ 为中心的 Poisson-lognormal 采出:
$$\tau \sim \mathcal{N}\Big(\log(\mu_{\text{rec}} - \mu_{\text{bwd}}) - \tfrac{1}{2}\sigma^2,\ \sigma\Big), \qquad n \sim \mathcal{P}(e^\tau) + 1, \qquad k \leftarrow \mu_{\text{bwd}} \tag{12}$$
这个写法为了钉死显存把 $k$ 固定,副作用是实际采到的总深度分布被 $\mu_{\text{bwd}}$ 截断并压缩了。本文改成先采总深度、再拆分:$T \sim \Lambda(\mu_{\text{rec}})$,$n \leftarrow \max(T - \mu_{\text{bwd}}, 0)$,$k \leftarrow \min(T, \mu_{\text{bwd}})$,从而把 $\mu_{\text{bwd}}$ 对 $\Lambda$ 的影响解耦掉。
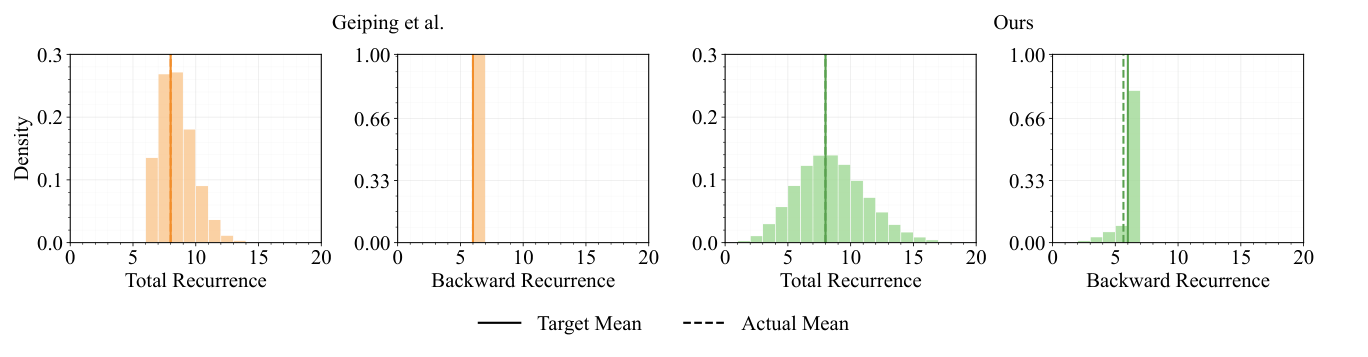
(3)$\mu_{\text{bwd}}$ 的取法。 与既有工作按 $\mu_{\text{bwd}}$ 截断 $\Lambda$ 不同,本文只用 $\mu_{\text{rec}}$ 参数化 $\Lambda$,并全程取
$$\mu_{\text{bwd}} = \left\lceil \frac{\mu_{\text{rec}}}{2} \right\rceil \tag{13}$$
FLOP 估计¶
固定深度架构常用 Kaplan 的 $C = 6ND$。循环架构有有效参数量 $\hat{N}$ 的概念(一层 $N$ 参数循环十次,有效参数是 $10N$),且截断反传使有效参数拆成两类:$\hat{N}_1$(不回传梯度)与 $\hat{N}_2$(回传梯度)。于是
$$C = (2\hat{N}_1 + 6\hat{N}_2)\, D \tag{14}$$
与 McLeish 等人的口径一致。$\hat{N}$ 中排除 embedding 参数、但按 nanochat 的做法包含 unembedding 参数,并额外按 PaLM / nanochat 的方式估算 attention FLOPs。
实验设置¶
两套 setup,互不混用:
- RDM setup:完全跟随 Geiping 等人,使用 Huginn 的数据集与 tokenizer。模型为 100M / 350M 两档。
- Transformer setup:跟随 Karpathy 的 nanochat,在 FineWeb-Edu 上训练。模型为 140M / 370M / 770M / 1.3B 四档。
关键的公平性设定:两套 setup 都只为 baseline 做超参搜索,然后把搜到的最优超参直接套给 Parcae,Parcae 自己不做任何扫描。作者明说这会低估 Parcae——"我们认为 Parcae 在更强的超参调优下还会更好"。
模型定义(RDM setup,原文 Table 17):
| Parcae-100M | Parcae-350M | RDM-100M | RDM-350M | |
|---|---|---|---|---|
| 参数量 | 114,242,560 | 378,558,464 | 114,242,560 | 382,765,056 |
| $L_P$ / $L_C$ | 1 / 1 | 1 / 1 | 1 / 1 | 1 / 1 |
| $L_R$ | 1 | 2 | 1 | 2 |
| $d_{\text{model}}$ | 1,024 | 2,048 | 1,024 | 2,048 |
| $d_{\text{inter}}$ | 3,520 | 7,040 | 3,520 | 7,040 |
| $\mu_{\text{rec}}$ | 16 | 8 | 16 | 8 |
| Backprop 深度 | 8 | 4 | 8 | 4 |
共用:因果自注意力 + SwiGLU MLP + RoPE($\theta$=50000) + RMSNorm + Pre-Norm block + 词表 65,536 + 绑定 embedding + Poisson 采样,初始化按 Takase 等人的 $\mathcal{N}(0, \tfrac{2}{5d})$。优化器为带解耦权重衰减的 Adam($\beta_1$=0.9, $\beta_2$=0.95),带 update clipping、去掉 $\epsilon$、梯度裁剪 1.0,warm-up + 4096 步 cool-down、常数学习率(100M 用 $4\times 10^{-3}$,350M 用 $2\times 10^{-3}$)。
模型定义(Transformer setup,原文 Table 18/19):Transformer 的层数为 6/12/18/24,Parcae 则拆成 $L_P = L_R = L_C = 2/4/6/8$——即总执行层数相同、但中间三分之一被循环。$d_{\text{model}}$ 为 768/1024/1280/1536,head dim 固定 128,词表 32,768,上下文 2,048,$\mu_{\text{rec}} = 8$、backprop 深度 4、per-sequence 截断 Poisson 采样。共用组件包括 QK-Norm、$\mathrm{ReLU}^2$ MLP、门控交替层 value embedding、RoPE、RMSNorm Pre-Norm、无 bias、scaled-zero 初始化、绑定 embedding。
Parcae 引入的额外参数量可以忽略:
| 140M | 370M | 770M | 1.3B | |
|---|---|---|---|---|
| Transformer 参数 | 143,141,184 | 385,903,104 | 773,375,040 | 1,333,868,544 |
| Parcae 参数 | 144,323,136 | 388,003,328 | 776,655,680 | 1,338,591,744 |
| 额外参数 | 1,181,952 | 2,100,224 | 3,280,640 | 4,723,200 |
| 额外占比 | 0.83% | 0.54% | 0.42% | 0.35% |
超参(Transformer setup,原文 Table 21):训练 token 分别为 11.2B / 29.6B / 61.6B / 104B;batch 256 序列 × 2048 长度;bf16 混合精度;AdamW 学习率 $8\times10^{-3}$(大模型 $6\times10^{-3}$)、$(\beta_1,\beta_2) = (0.8, 0.95)$、weight decay 0、$\epsilon = 10^{-10}$;Muon 学习率 $8\times10^{-3}$、动量 0.95、weight decay 0.2 线性衰减到 0、5 步 polar express 正交化;学习率固定(0% warmup、50% cooldown);梯度裁剪 1.0。参数分组遵循 nanochat:AdamW 管 embedding / LM head / 归一化层 / 全部 1D 参数(以及 Parcae 独有的 $\mathbf{A}, \Delta, \mathbf{B}, \mathbf{C}$),Muon 管注意力投影与 MLP 权重。
Transformer baseline 的学习率扫描相当彻底(AdamW 13 档 × Muon 9 档,1:20 参数-token 比),确保对手是强 baseline。
评测:Core 与 Core-Extended 来自 DataComp-LM,前者是 21 个任务的子集(HellaSwag 0/10-shot、Lambada、Winograd、WinoGrande、Jeopardy、ARC-e/c、COPA、CommonsenseQA、PIQA、OpenBookQA、SQuAD、CoQA、BoolQ、BIG-Bench 若干项等),后者含全部 46 个任务(额外含 MMLU、MathQA、LogiQA、AGI Eval、安全类任务等)。所有对 Transformer 的对比跑 3 个随机种子(种子同时改变初始递归状态与 few-shot 示例)。
自定义 tokenizer:32,768 词表的 byte-level BPE(GPT-4 风格配置 + byte fallback),在 FineWeb-Edu 的 20 亿字符上训练,压缩率 4.72 bytes/token(train)/ 4.65(val),介于 GPT-2(4.67/4.63)与 GPT-4 cl100k(4.81/4.76)之间。
主要实验结果¶
对比 RDM:更低困惑度 + 逐项消融¶
Table 3(零样本与困惑度,RDM setup):
| 规模 | 模型 | $T$ | Val. PPL | WikiText | HellaSwag | ARC-c | ARC-e | PIQA | BoolQ | SciQ | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 100M | RDM | 16 | 14.23 | 63.27 | 27.16 | 17.66 | 42.38 | 59.14 | 51.35 | 72.50 | 45.03 |
| 100M | Parcae | 16 | 13.59 | 60.33 | 27.18 | 18.09 | 43.10 | 59.30 | 61.83 | 71.50 | 46.83 |
| 350M | RDM | 8 | 10.76 | 41.31 | 28.55 | 20.90 | 47.26 | 61.75 | 61.53 | 76.70 | 49.45 |
| 350M | Parcae | 8 | 10.09 | 37.53 | 29.23 | 21.08 | 48.78 | 62.08 | 60.73 | 78.80 | 50.12 |
结论分析:困惑度降低 6.2%(验证集)与 9.1%(WikiText),下游平均分高 1.8 / 0.67 点。值得注意的是两处 Parcae 输掉的项(100M 的 SciQ、350M 的 BoolQ)都在方差较大的小样本 MC 任务上,而困惑度这类低方差指标是全胜。更重要的是,这个差距是在Parcae 完全没做超参搜索、直接复用 RDM 最优超参的条件下取得的。
Table 4(稳定性消融,Transformer setup):把一个 140M 的 baseline Transformer 改造成 RDM,然后逐项叠加本文的稳定性改进:
| 配置 | Val Loss $T$=1 | $T$=4 | $T$=8 | Core $T$=1 | $T$=4 | $T$=8 | Core Ext $T$=1 | $T$=4 | $T$=8 |
|---|---|---|---|---|---|---|---|---|---|
| RDM | 发散 | 发散 | 发散 | — | — | — | — | — | — |
| + 约束 $\mathbf{A}$ | 8.99 | 3.15 | 2.97 | $-2.0{\scriptstyle\pm0.1}$ | 11.0 | 13.2 | 0.5 | 7.8 | 9.1 |
| + Per-Seq. 采样 | 3.38 | 3.01 | 2.98 | 7.6 | 13.4 | 14.0 | 5.9 | 9.3 | 9.9 |
| + Prelude Norm | 3.28 | 2.97 | 2.95 | 7.5 | 13.5 | 14.0 | 5.8 | 9.4 | 9.7 |
结论分析:这张表把三个组件的分工切得非常清楚——
- 约束 $\mathbf{A}$ 是收敛的必要条件:不加它整个 run 直接发散,加了之后在 $T = \mu_{\text{rec}} = 8$ 上已经有 2.97 的损失;
- Per-sequence 采样修的是"浅深度":只看 $T=8$ 的话它几乎没变(2.97 → 2.98),但 $T=1$ 的损失从 8.99 暴跌到 3.38、Core 从 $-2.0$ 拉到 7.6。原因是 per-micro-batch 采样让一个 batch 内只有一种深度,对期望的估计噪声极大,模型对训练深度以外的 $T$ 泛化很差;
- Prelude norm 是全局小幅提质 + 大规模晚期稳定:三个深度的 loss 都再降一点(2.97→2.95),并且是 1.3B run 能跑完的唯一原因。
对比 Transformer:参数效率与规模外推¶
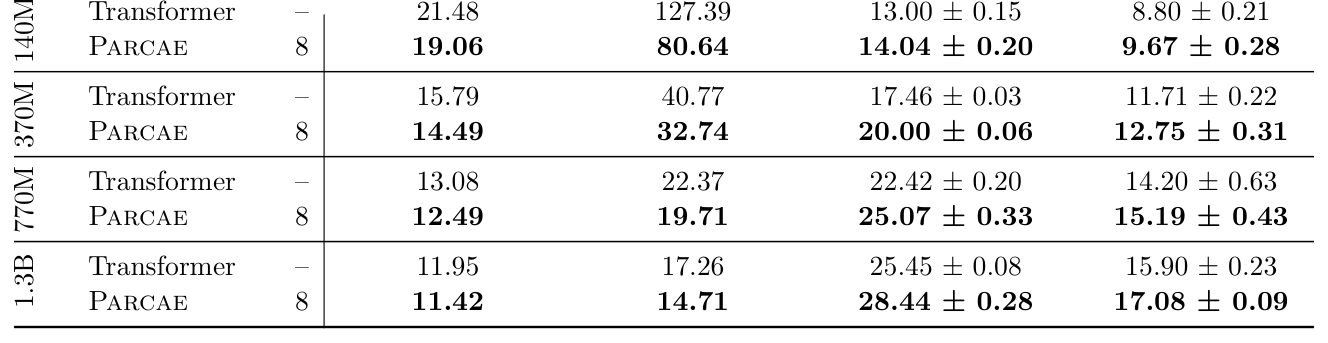
| 规模 | 模型 | $T$ | Val. PPL ↓ | Lambada PPL ↓ | Core ↑ | Core-Extended ↑ |
|---|---|---|---|---|---|---|
| 140M | Transformer | – | 21.48 | 127.39 | 13.00 ± 0.15 | 8.80 ± 0.21 |
| 140M | Parcae | 8 | 19.06 | 80.64 | 14.04 ± 0.20 | 9.67 ± 0.28 |
| 370M | Transformer | – | 15.79 | 40.77 | 17.46 ± 0.03 | 11.71 ± 0.22 |
| 370M | Parcae | 8 | 14.49 | 32.74 | 20.00 ± 0.06 | 12.75 ± 0.31 |
| 770M | Transformer | – | 13.08 | 22.37 | 22.42 ± 0.20 | 14.20 ± 0.63 |
| 770M | Parcae | 8 | 12.49 | 19.71 | 25.07 ± 0.33 | 15.19 ± 0.43 |
| 1.3B | Transformer | – | 11.95 | 17.26 | 25.45 ± 0.08 | 15.90 ± 0.23 |
| 1.3B | Parcae | 8 | 11.42 | 14.71 | 28.44 ± 0.28 | 17.08 ± 0.09 |
结论分析:验证集困惑度降低 4.3–9.2%,Core / Core-Extended 最多高 2.99 / 1.18 点,且四个规模全部单调获胜。作者用"占到下一档更大 Transformer 的多少比例"这个口径量化参数效率,例如 140M 的 Core-Extended:$\frac{9.67 - 8.80}{11.71 - 8.80} \times 100 \approx 29.9\%$。按这个口径 Parcae 在 Core 上取得 23.3%–87.5%、Core-Extended 上 29.9%–58.2% 的额外参数效率。最亮眼的一点是 770M Parcae 的 Core 分(25.07)已经逼近 1.3B Transformer(25.45),参数量只有一半。
需要留意的是:Lambada PPL 的改善幅度(例如 140M 的 127.39 → 80.64,降 36.7%)远大于验证集 PPL(11.3%)。Lambada 考的是需要长程篇章上下文的最后一词预测,这个不成比例的增益暗示循环带来的额外深度对需要多步整合的预测帮助最大——这与 latent reasoning 的叙事一致,但论文没有对此展开分析。
训练侧:循环是一条正交的扩展轴¶
isoFLOP 设置¶
在 140M 与 370M 两档上,固定参数量与 FLOP 预算,让 $\mu_{\text{rec}} \in \{2,4,6,8,10,12\}$ 变化并按比例缩减 token 数以维持 FLOP 恒定。140M 用 $\{1,2,4,8,16,64\}\times 10^{18}$ 六档预算,370M 用 $\{32,64,128\}\times 10^{18}$ 三档,分别得到 36 与 18 个训练好的模型,各自在 $T = \mu_{\text{rec}}$ 上评估。
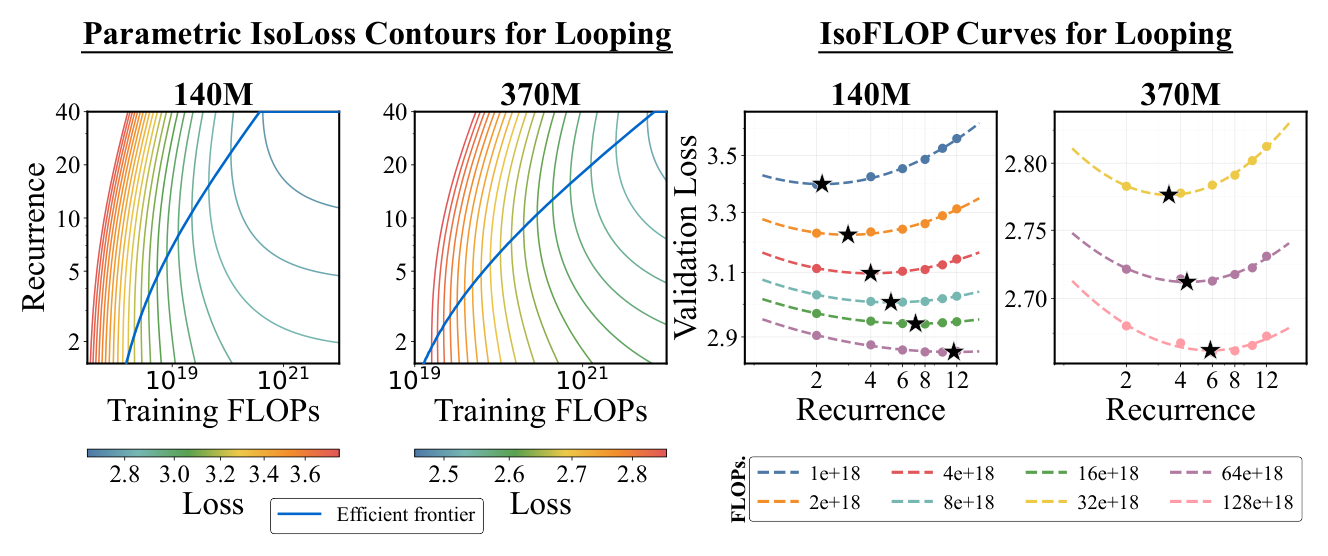
右图(isoFLOP 抛物线)是这一节的核心证据:每条 isoFLOP 曲线都有一个明确的内部极小值。如果循环只是"把算力浪费掉",曲线应该单调递增($\mu_{\text{rec}}$ 越大越差);如果循环能无限替代数据,曲线应该单调递减。出现内部极值意味着循环和数据之间存在一个最优配比——这正是"正交扩展轴"的操作性定义,和 Chinchilla 中参数与数据的关系在形式上完全一致。
最优循环次数与 token 数的幂律¶
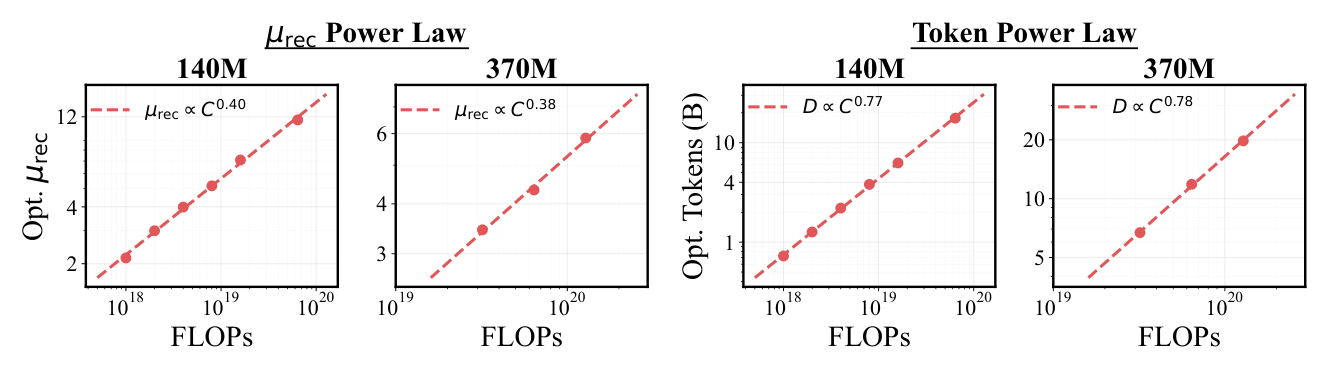
对每个 FLOP 预算的抛物线取极小值点,得到该预算下的最优 $\mu_{\text{rec}}^\star$ 与最优 token 数,两者都随算力 $C$ 遵循幂律:
$$\mu_{\text{rec}}^\star \propto C^{\gamma_\mu},\quad \gamma_\mu \approx 0.40 \qquad\qquad D^\star \propto C^{\gamma_D},\quad \gamma_D \approx 0.78 \tag{15}$$
具体地,140M 上 $\gamma_\mu = 0.40$、$\gamma_D = 0.77$,370M 上 $\gamma_\mu = 0.38$、$\gamma_D = 0.78$。两个规模上指数几乎一致是这个结论最有说服力的地方——它意味着这条律不是某个尺度下的偶然拟合。含义是:算力增加时,循环次数与数据量应当同时增加,就像 Chinchilla 里参数与数据同时增加一样。
参数化拟合¶
作者进一步套用 Chinchilla 的函数形式,只把 $N$ 换成"把所有循环展开后的有效参数量" $N(\mu_{\text{rec}})$:
$$\hat{L}_{\text{train}}(\mu_{\text{rec}}, D) = E + A \cdot N(\mu_{\text{rec}})^{-a} + B \cdot D^{-b} \tag{16}$$
用 Huber loss 在对数损失上拟合,L-BFGS 求解,500 次随机重启 × 每次最多 10000 迭代取最优。拟合系数:
| 模型 | $E$ | $A$ | $a$ | $B$ | $b$ | Huber ($\times 10^{-4}$) |
|---|---|---|---|---|---|---|
| Small (140M) | 2.662 | 522733.307 | 0.771 | 25420.102 | 0.525 | 0.44 |
| Medium (370M) | 2.439 | 832134.346 | 0.775 | 6386.865 | 0.448 | 0.01 |
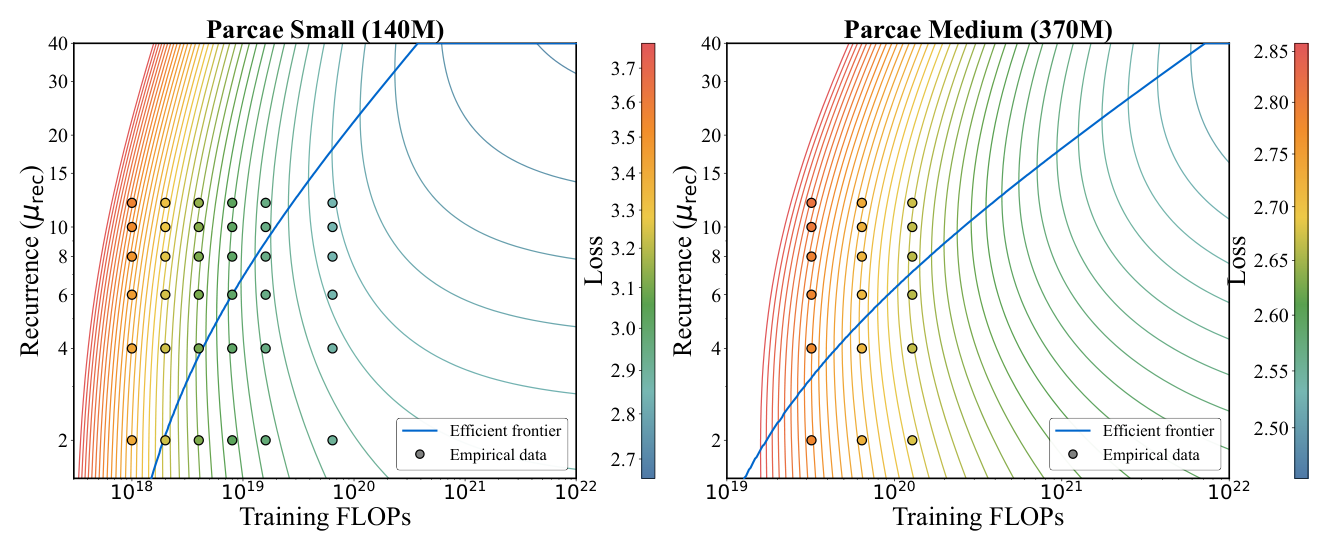
结论分析:两个规模的有效参数指数 $a$ 几乎相同(0.771 vs 0.775),而数据指数 $b$ 差异较大(0.525 vs 0.448)。作者用这个拟合去预测 §5.1 中未参与拟合的模型的验证损失,外推误差 1.3%(140M)与 0.8%(370M)——这个约 1% 的外推间隙后面会成为统一律误差的主要来源。
循环前沿 vs 纯堆数据¶
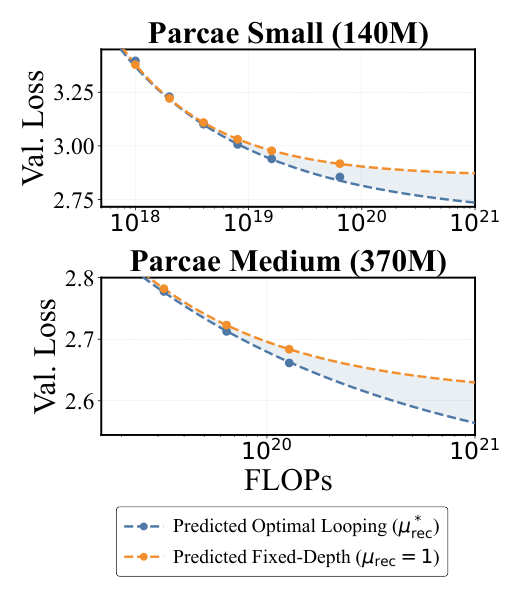
把每个 FLOP 预算下的最优循环模型与 $\mu_{\text{rec}} = 1$ 的固定深度模型(即把全部算力都花在数据上)对比,循环前沿的损失严格更低。这个损失优势翻译到下游是 1.2–2.0 个 Core 点:
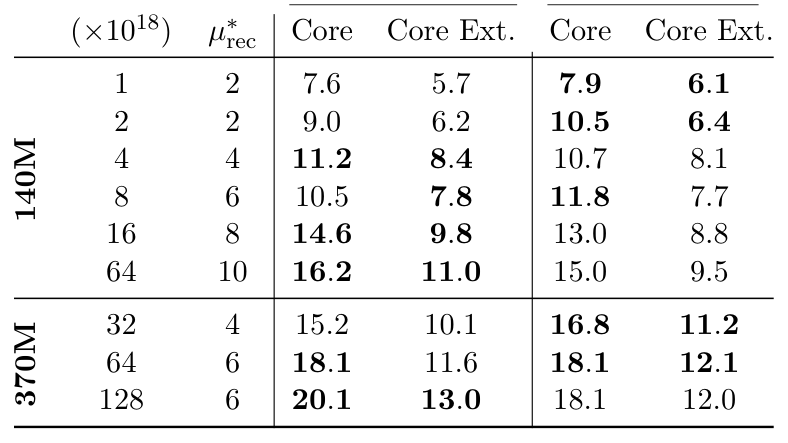
| 规模 | FLOPs ($\times10^{18}$) | $\mu^\star_{\text{rec}}$ | Core (最优循环) | Core Ext. | Core (固定深度) | Core Ext. |
|---|---|---|---|---|---|---|
| 140M | 1 | 2 | 7.6 ± 0.3 | 5.7 ± 0.5 | 7.9 ± 0.2 | 6.1 ± 0.1 |
| 140M | 2 | 2 | 9.0 ± 0.2 | 6.2 ± 0.1 | 10.5 ± 0.1 | 6.4 ± 0.2 |
| 140M | 4 | 4 | 11.2 ± 0.0 | 8.4 ± 0.2 | 10.7 ± 0.1 | 8.1 ± 0.3 |
| 140M | 8 | 6 | 10.5 ± 0.1 | 7.8 ± 0.2 | 11.8 ± 0.2 | 7.7 ± 0.2 |
| 140M | 16 | 8 | 14.6 ± 0.1 | 9.8 ± 0.4 | 13.0 ± 0.2 | 8.8 ± 0.4 |
| 140M | 64 | 10 | 16.2 ± 0.2 | 11.0 ± 0.1 | 15.0 ± 0.2 | 9.5 ± 0.4 |
| 370M | 32 | 4 | 15.2 ± 0.1 | 10.1 ± 0.2 | 16.8 ± 0.1 | 11.2 ± 0.4 |
| 370M | 64 | 6 | 18.1 ± 0.2 | 11.6 ± 0.2 | 18.1 ± 0.1 | 12.1 ± 0.2 |
| 370M | 128 | 6 | 20.1 ± 0.1 | 13.0 ± 0.1 | 18.1 ± 0.1 | 12.0 ± 0.1 |
结论分析(这张表值得诚实地读):论文正文说"最优 $\mu_{\text{rec}}$ 在两个规模上都带来更好的 Core / Core-Extended 分",但表格实际显示的是只在较大 FLOP 预算处成立:140M 的 1/2/8 三档 FLOPs 上固定深度反而更好(8 档甚至差 1.3 个 Core 点),370M 的 32/64 两档也是固定深度不输。真正稳定的赢面出现在每个规模的最高预算档(140M 的 16/64、370M 的 128)。作者自己在正文里也用了"at extended FLOP budgets"的限定语,但表述比数据允许的更乐观。更准确的读法是:循环的优势随算力预算增大而出现并放大,在小预算下反而是负收益——这与"最优 $\mu_{\text{rec}}$ 随算力增长"这条幂律其实是自洽的(小预算下最优循环次数只有 2,此时循环与不循环差别本就很小、噪声占主导)。
测试时:饱和的指数衰减律¶
饱和现象¶
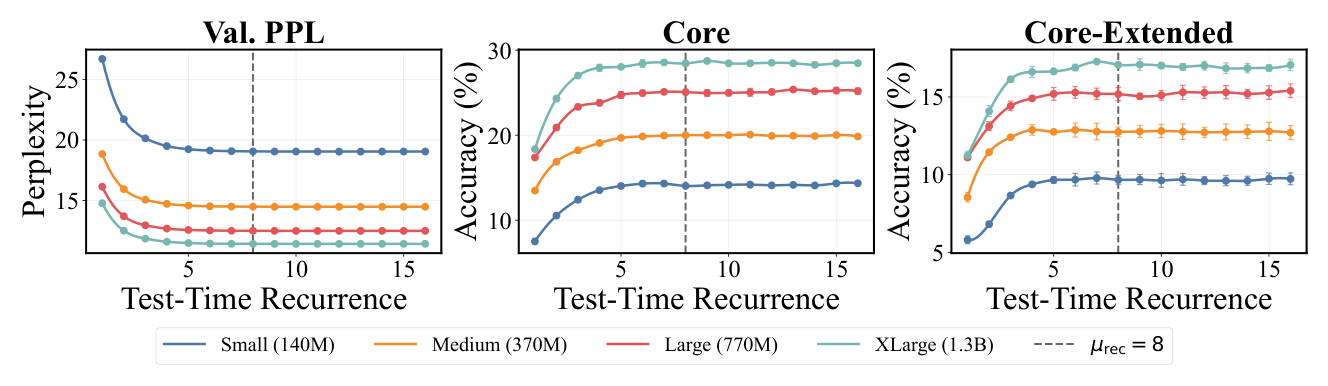
把 Table 5 的四个规模(都以 $\mu_{\text{rec}} = 8$ 训练)在 $T \in \{1,\dots,16\}$ 上评估,收益在 $T \approx \mu_{\text{rec}}$ 附近就基本走平。这与 Bansal、Yang 等人在小规模合成算法任务上观察到的"test-time 外推"形成对照:在大规模语言建模里,训练深度决定了 test-time scaling 的天花板。
函数形式的选择¶
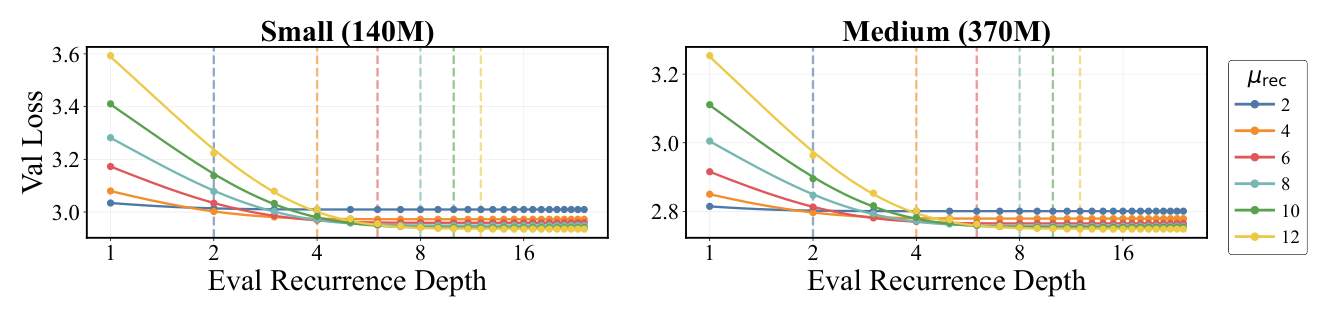
作者比较了四种候选函数形式:
$$\text{(a)}\ L(T) = L_\infty + Z e^{-zT} \quad \text{(b)}\ L_\infty + Z(1+T)^{-z} \quad \text{(c)}\ L_\infty + Z T^{-z} \quad \text{(d)}\ Z T^{-z} \tag{17}$$
平均 Huber loss($\times 10^{-7}$,越低越好):
| (a) 指数衰减 | (b) 平移幂律 | (c) 幂律 | (d) 无下界幂律 | |
|---|---|---|---|---|
| 分布内 140M | 2.52 | 5.42 | 11.11 | 112.89 |
| 分布内 370M | 1.88 | 5.26 | 10.77 | 104.95 |
| 外推 ($T > \mu_{\text{rec}}$) 140M | 3.18 | 21.41 | 43.99 | 397.90 |
| 外推 370M | 2.29 | 18.51 | 38.68 | 369.83 |
结论分析:指数衰减在分布内比次优形式好 2.3×、在外推上好 7.1×,且两个规模一致。去掉不可约下界 $L_\infty$(形式 d)误差爆炸 40 倍以上,证实 test-time scaling 收敛到一个由训练决定的有限损失。作者还给出一个(自称"纯属推测"的)漂亮联系:控制论里谱半径小于 1 的稳定离散线性系统,其状态范数指数收敛——观察到的指数衰减形式与 Parcae 的动力系统构造是自洽的。
统一训练律与测试时律¶
拟合出的 $L_\infty$ 与经验上 $T = \mu_{\text{rec}}$ 处的损失几乎相同(140M 平均误差 0.16%、最大 0.59%;370M 平均 0.05%、最大 0.22%),且各条曲线的衰减率随训练深度成反比。于是作者把训练律直接当作 test-time 律的地板,得到统一律:
$$\hat{L}_{\text{unified}}(T \mid \mu_{\text{rec}}, D) = \underbrace{E + X\cdot N(\mu_{\text{rec}})^{-x} + Y\cdot D^{-y}}_{\text{训练律地板 } \hat{L}_{\text{train}}(\mu_{\text{rec}}, D)} + \underbrace{Z\cdot \exp\!\left(-z\cdot \frac{T}{\mu_{\text{rec}}}\right)}_{\text{测试时衰减}} \tag{18}$$
测试时项只依赖比值 $T/\mu_{\text{rec}}$,即"推理时用掉了训练深度的多大比例"。这个 $\mu_{\text{rec}}$ 条件化是必需的,消融如下(总 Huber loss,越低越好):
| $Ze^{-z\mu^{-\gamma}T}$(学 $\gamma$) | $Ze^{-zT/\mu}$($\gamma$=1) | $Ze^{-zT}$(无条件化) | |
|---|---|---|---|
| 训练集 (isoFLOP) 140M | 0.001116 | 0.001177 | 0.003253 |
| 训练集 370M | 0.000229 | 0.000283 | 0.001438 |
| held-out 140M | 0.000207 | 0.000212 | 0.000266 |
| held-out 370M | 0.000133 | 0.000131 | 0.000189 |
结论分析:去掉 $\mu_{\text{rec}}$ 条件化使训练误差涨 3.5 倍、held-out 涨约 33%。学习的 $\gamma$ 只带来约 8% 的改善(拟合值 $\gamma = 1.19$ / $1.17$,两个规模一致),在 held-out 上与 $\gamma = 1$ 无法区分,因此为简洁起见采用 $\gamma = 1$。
统一律的 8 个参数在 isoFLOP 模型(每个规模约 540 个数据点,$T \in \{1,2,4,6,8,10,12,16,20,24\}$)上用 Huber loss + L-BFGS 1000 次随机重启联合拟合。
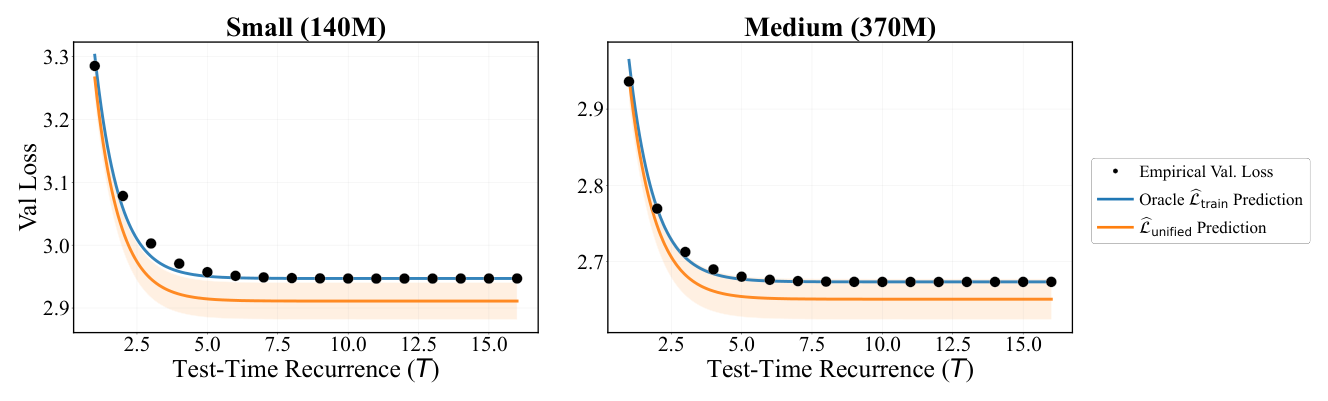
外推验证:拿这套拟合去预测 §5.1 中完全在 isoFLOP 扫描之外(固定数据预算训练)的 140M / 370M 模型,平均误差 0.85%–1.31%;如果把训练律地板替换成 $T = \mu_{\text{rec}}$ 处的经验损失(oracle),误差降到 0.10%–0.17%。这个对照相当有说服力:测试时衰减项本身几乎是精确的,剩下的误差全部来自训练律那约 1% 的外推间隙。
消融与附录分析¶
Per-sequence vs per-micro-batch 采样¶
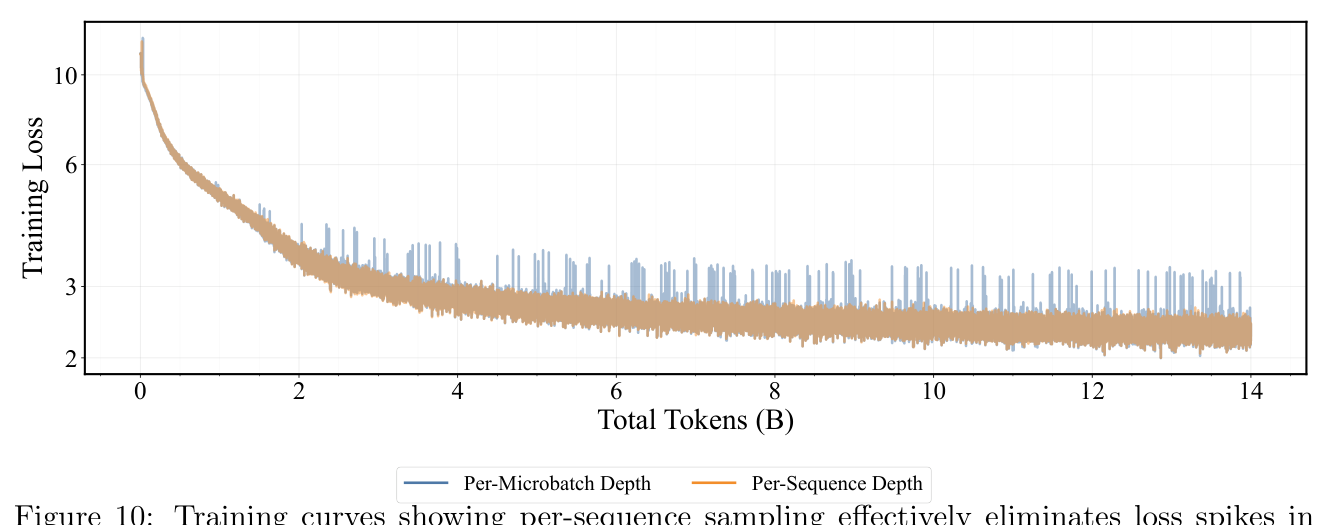
350M Parcae 上,per-micro-batch 采样的训练曲线有多处 loss spike,per-sequence 采样则完全没有。配套的诊断指标解释了原因:
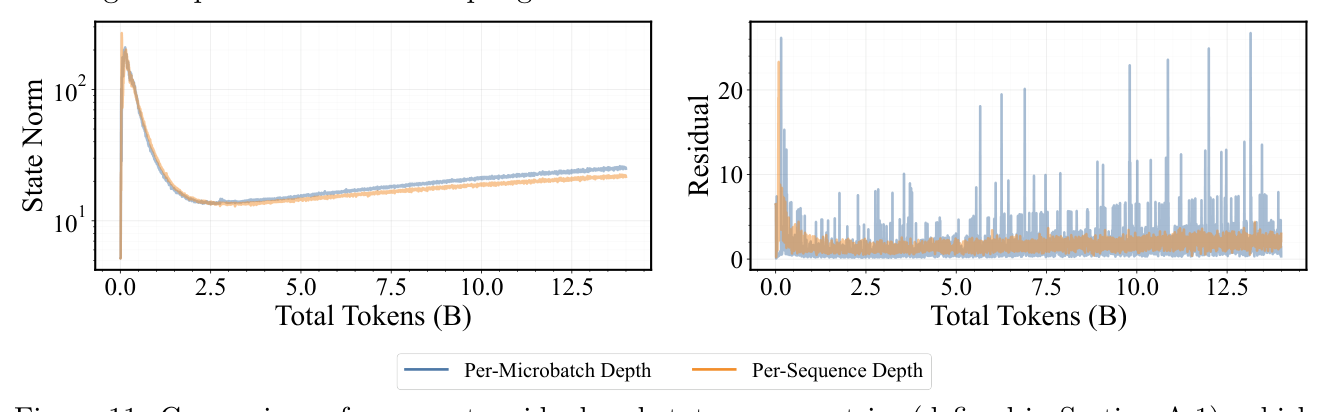
作者定义了两个诊断量:递归残差 $\|h_T - h_{T-1}\|_2$(末次递归的跳变幅度,过小说明 $R$ 什么也没学到、过大说明状态爆炸或学不到不动点动力学)与递归状态范数 $\|h_T\|$。spike 直接对应末次递归的巨大残差跳变——模型没有收敛到稳态不动点。per-sequence 采样给出更好的期望估计,从而恢复了不动点行为。
困惑度对照(原文 Table 8):
| 规模 | 方法 | $T$=1 | $T$=4 | $T$=8 | $T$=16 |
|---|---|---|---|---|---|
| 100M | Per-Batch | 300.32 | 36.75 | 16.65 | 13.81 |
| 100M | Per-Sequence | 70.47 | 17.15 | 14.08 | 13.59 |
| 350M | Per-Batch | 167.61 | 12.80 | 10.40 | 10.24 |
| 350M | Per-Sequence | 17.92 | 10.49 | 10.09 | 10.11 |
结论分析:改善在低 $T$ 上最惊人(350M 的 $T$=1 从 167.61 降到 17.92,接近一个数量级),在 $T$=16 上则基本持平甚至略输(10.24 vs 10.11 互有胜负)。这说明 per-sequence 采样买到的主要是跨深度的鲁棒性而非峰值质量——对于要在推理时自适应调节算力的场景,这恰恰是最关键的性质。
采样分布修正的效果¶
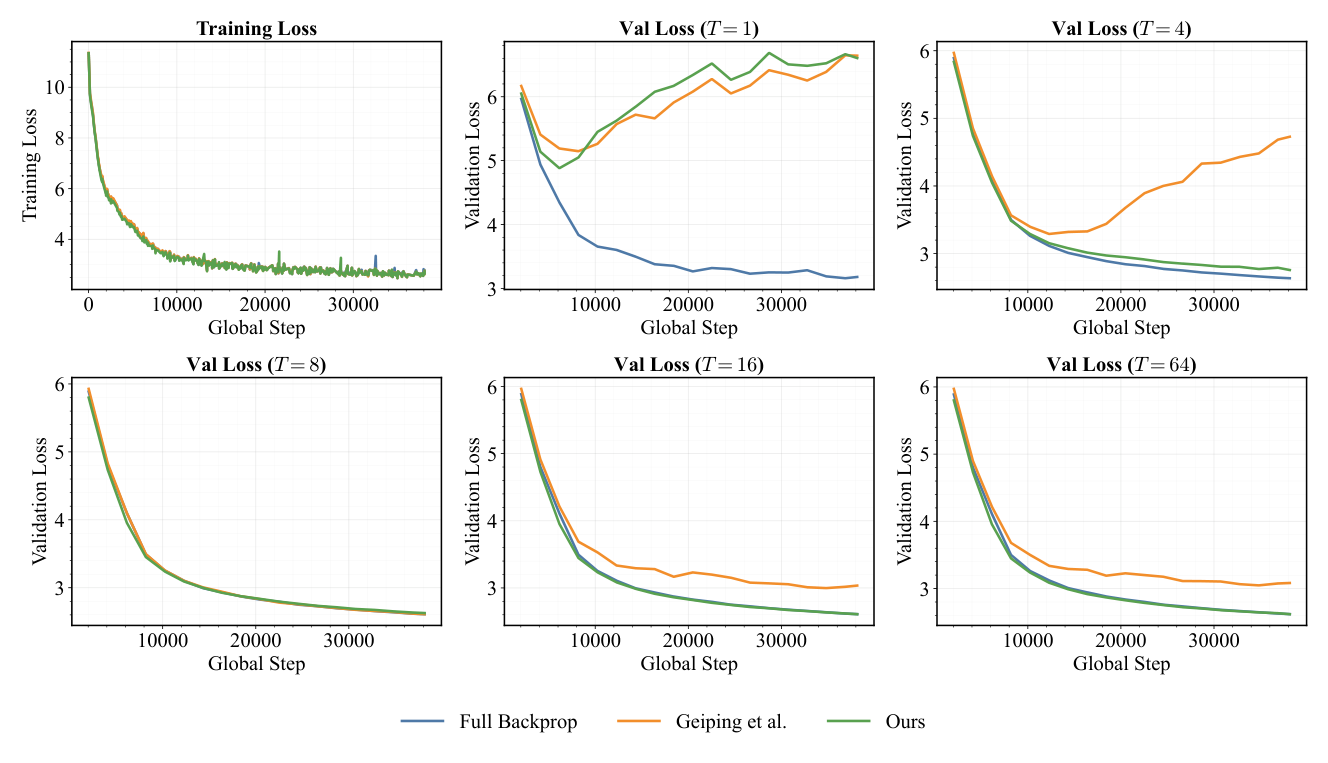
三个 100M Parcae 模型在 10B token 上对比:全量反传(无截断)、Geiping 的 Algorithm 3、本文的 Algorithm 4,全部 $\mu_{\text{rec}} = \mu_{\text{bwd}} = 8$、$\Lambda \sim$ Poisson。在 $T = 8$ 上三者几乎无差别,但在 $T \in \{4, 16, 64\}$ 上本文的实现明显更贴近全量反传的曲线,$T = 4$ 处改善最显著。原因就是 Geiping 的截断把实际见到的递归范围压窄了,损害了向更多 / 更少递归的泛化。
$\mu_{\text{rec}}$ 与 $\mu_{\text{bwd}}$ 的选择¶
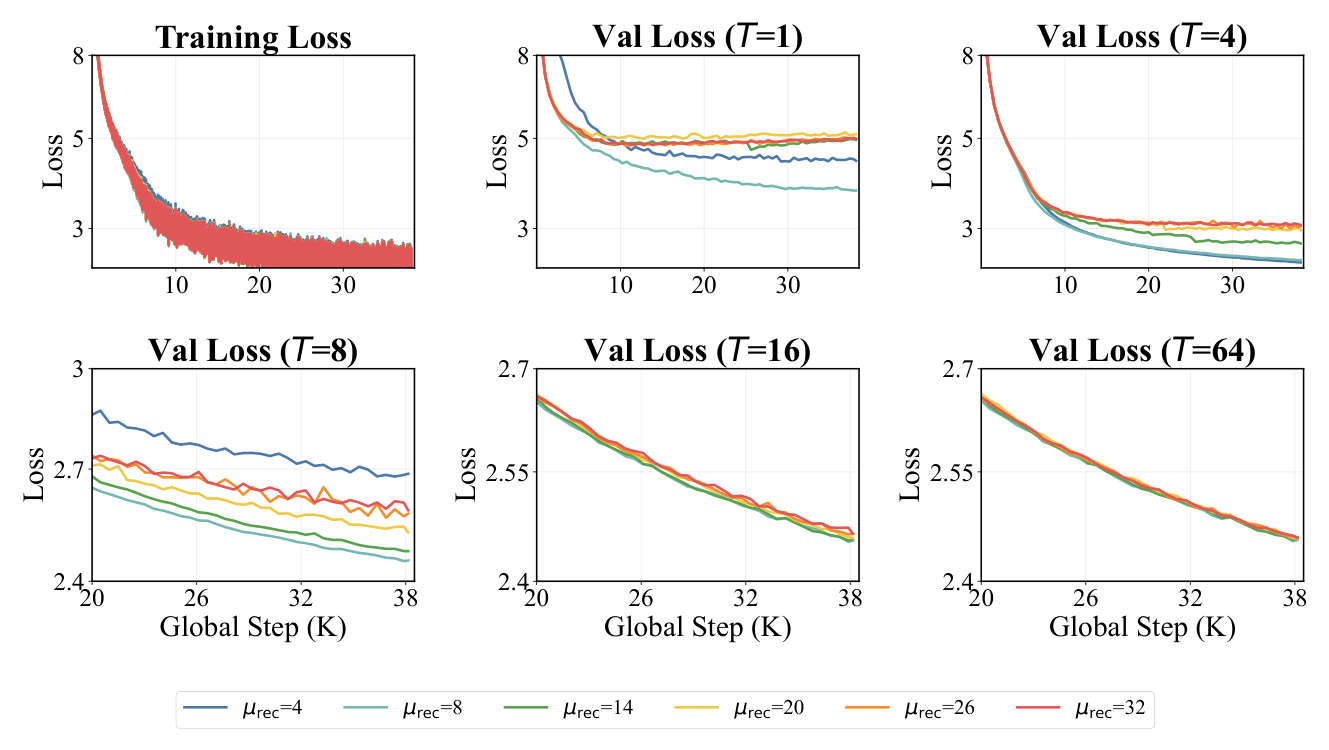
固定 $\mu_{\text{bwd}} = 4$,扫 $\mu_{\text{rec}} \in \{4, 8, 14, 20, 26, 32\}$(10B token):
| $\mu_{\text{rec}}$=4 | 8 | 14 | 20 | 26 | 32 | |
|---|---|---|---|---|---|---|
| Val Loss | 2.477 | 2.453 | 2.456 | 2.457 | 2.458 | 2.458 |
| Val PPL | 11.906 | 11.624 | 11.665 | 11.671 | 11.692 | 11.687 |
反直觉的结论:$\mu_{\text{rec}} = 8$ 最好,超过 8 之后即便花了更多预训练 FLOPs,在高 $T$(16、64)和低 $T$ 上都更差。作者追问这是循环模型容量的固有上限还是 $\mu_{\text{bwd}}$ 造成的假象,于是反过来固定 $\mu_{\text{rec}} = 20$、扫 $\mu_{\text{bwd}} \in \{4,6,8,10,12\}$(8.5B token):
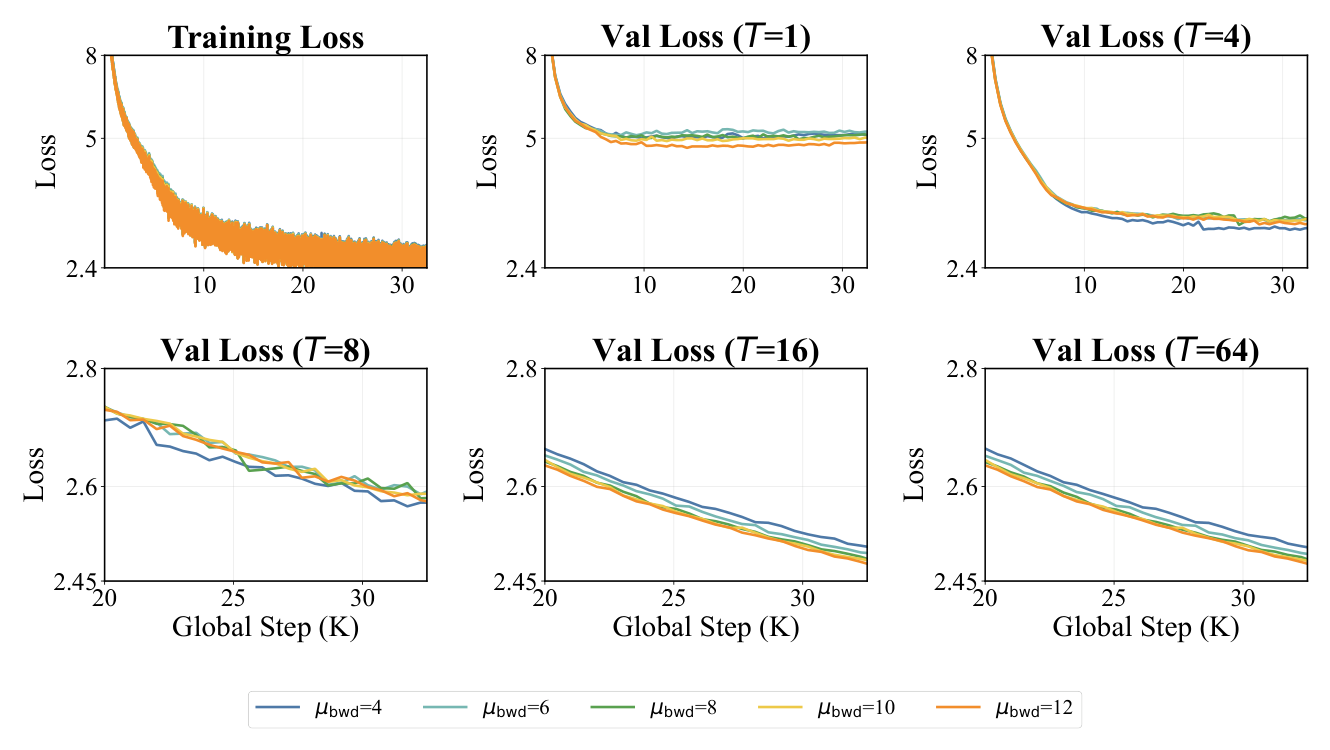
| $\mu_{\text{bwd}}$=4 | 6 | 8 | 10 | 12 | |
|---|---|---|---|---|---|
| Val Loss | 2.500 | 2.490 | 2.480 | 2.479 | 2.474 |
| Val PPL | 12.09 | 12.06 | 11.94 | 11.93 | 11.86 |
结论分析:$T = 16, 64$ 上的验证损失随 $\mu_{\text{bwd}}$ 单调改善——循环模型能不能用深递归,与 $\mu_{\text{bwd}}$ 紧耦合。也就是说前一个实验里 $\mu_{\text{rec}} > 8$ 的退化不是循环本身的上限,而是梯度只能回传 4 步造成的。但 $\mu_{\text{bwd}}$ 从 10 到 12 收益已经很小而 FLOPs 继续涨,故折中取 $\mu_{\text{bwd}} = \lceil \mu_{\text{rec}}/2 \rceil$。作者明确把"$\mu_{\text{rec}}$ 与 $\mu_{\text{bwd}}$ 的 FLOP 最优组合"留作未来工作。
Prelude Norm:一次完整的故障排查¶
这是全文最有工程参考价值的一段。140M/370M/770M 都训得稳,唯独 1.3B 在 15 万步之后出现 loss spike 与状态爆炸:
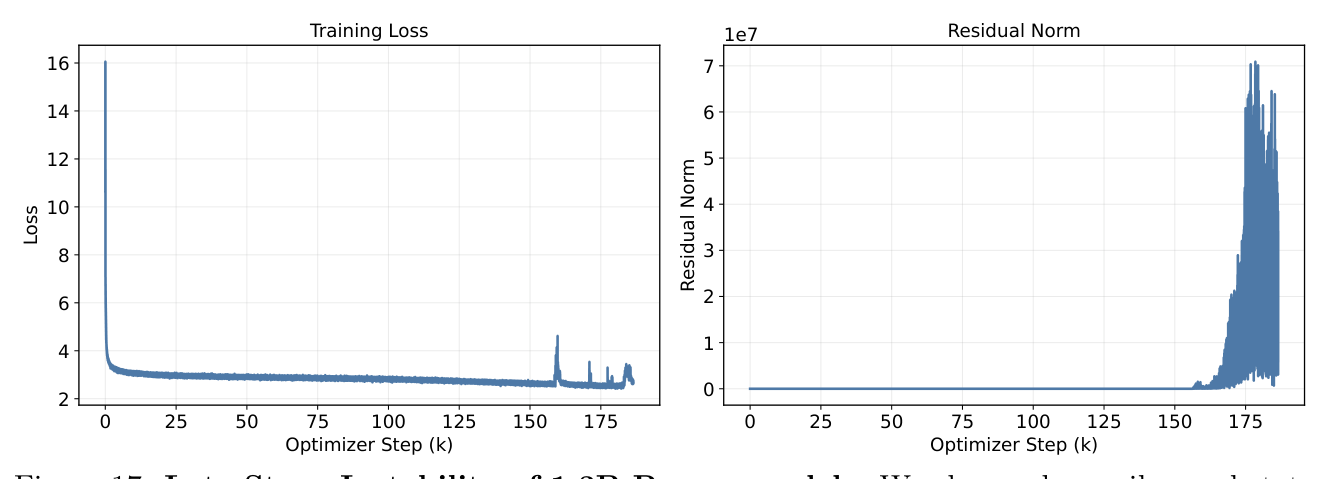
作者按下列顺序逐层排除:
- 查动力系统参数的谱范数:$\overline{\mathbf{A}}$ 与 $\overline{\mathbf{B}}$ 全程稳定($\max \exp(\Delta \mathbf{A})$ 稳在 0.5–0.9),但 $\mathbf{C}$ 的谱范数一路涨到 400+;
- 但 $\mathbf{C}$ 是虚警:拿真实激活过 $\mathbf{C}$ 测经验放大比 $\|\mathbf{C}(x)\|/\|x\|$,实际只有个位数且随训练缓慢下降——谱范数是最坏情况上界,真实激活并不落在那个方向上;
- 测递归过程中的状态范数:$T = 24$ 的逐步范数显示,爆炸只发生在第一次递归,之后反而稳定;
- 拆开第一次递归:追踪注入后与每个 transformer block 后的范数,发现非线性部分几乎不放大,爆炸源自 prelude 输出 $e$ 的注入;
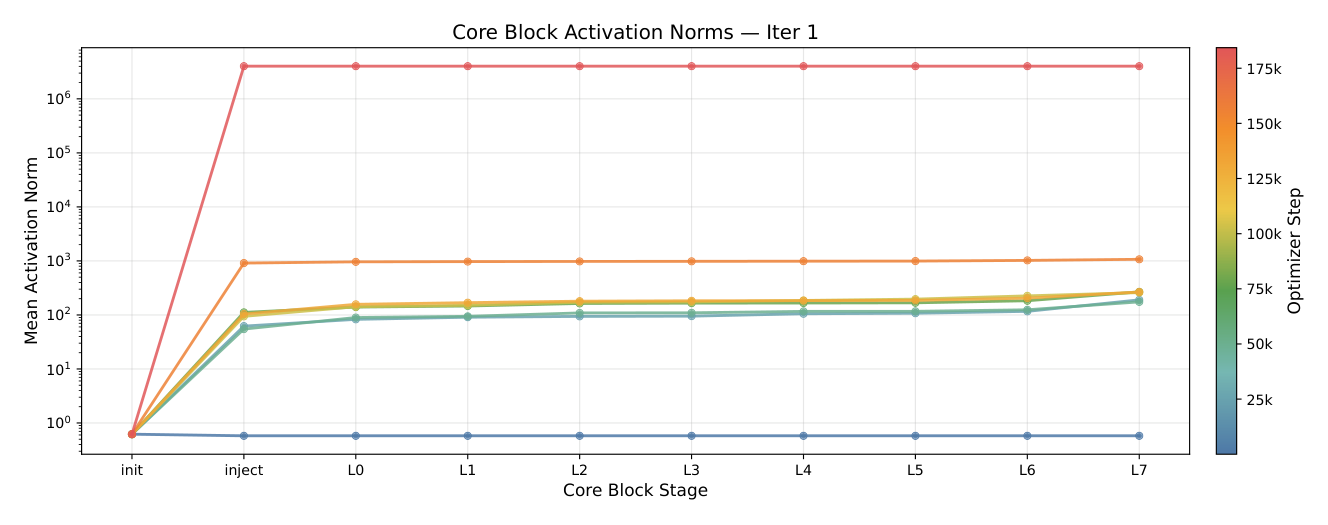
- 再拆开 prelude 内部:逐层测残差范数,单独一层就把残差范数炸到 $10^7$。
修复方式极简:在 prelude 输出上加一层归一化,即 $e \leftarrow \mathrm{LN}(P(x))$。它做两件事:(1) 归一化循环单元的输入,稳住循环动力学;(2) 稳定回传到 $P$ 的梯度流(作者坦承这一条没有直接证明,只是从归一化稳定 transformer 前后向的既有工作中推断)。
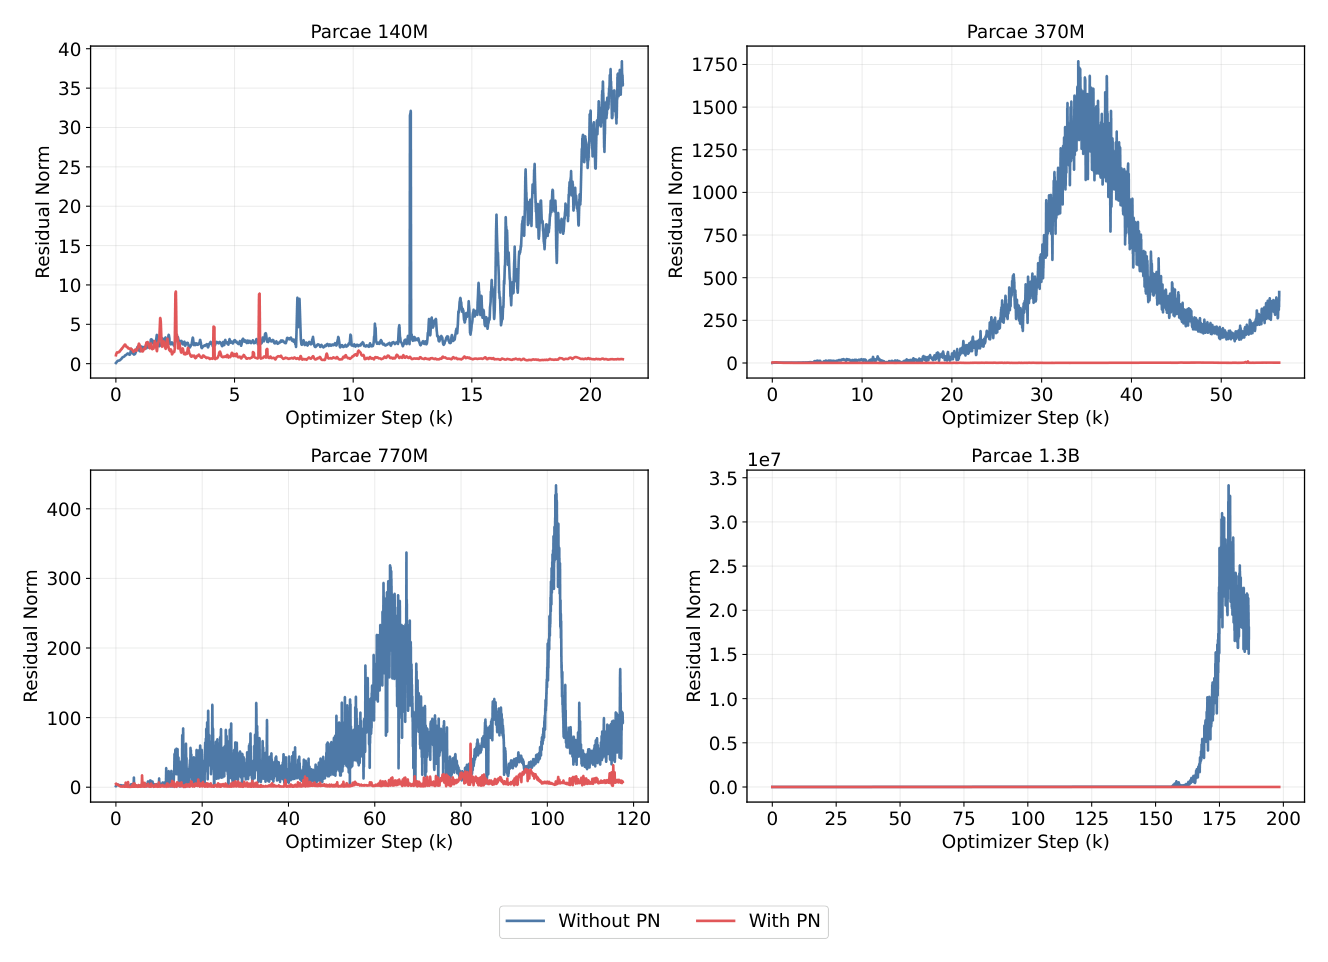
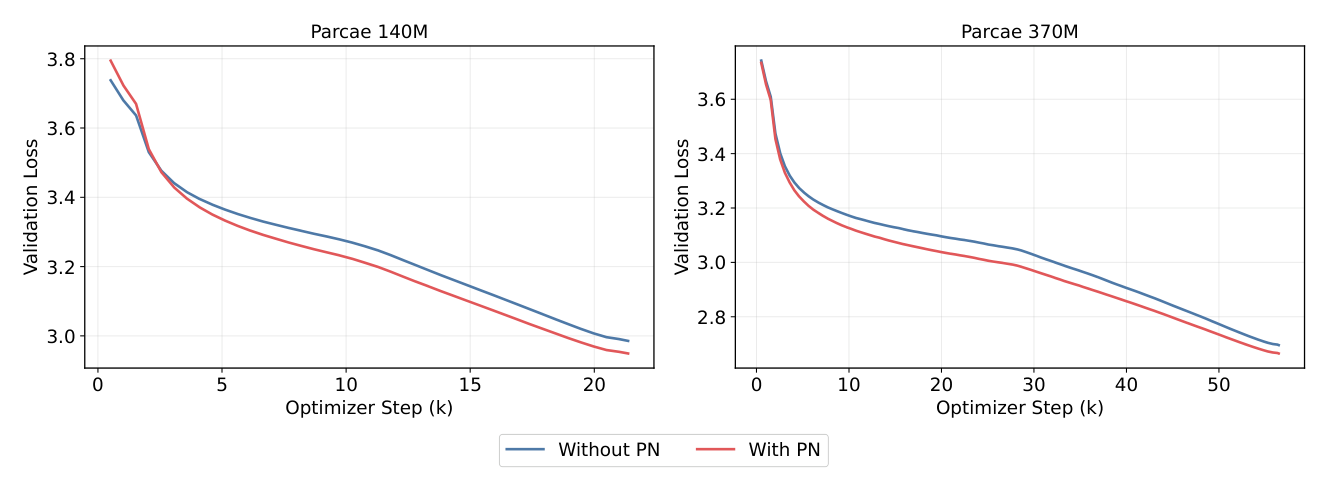
结论分析:prelude norm 在 140M/370M 上带来可见的收敛改善,在 770M/1.3B 上质量提升"可忽略"——但它是 1.3B run 能跑完的唯一原因。这构成一个很有代表性的规模效应:一个在小规模上看似无关紧要的归一化,在大规模上是从"跑不完"到"跑得完"的分界。这也顺带说明本文的 LTI 框架只覆盖了不稳定性的一半——$\mathbf{A}$ 的谱半径管的是递归内部的爆炸,而 $\mathbf{B}$ 侧的输入注入爆炸是框架之外的、靠经验诊断修掉的。
核心贡献总结¶
- 一个可分析的框架:把循环前向过程精确重写为残差流上的非线性时变动力系统,线性化后落到经典 LTI 稳定性判据 $\rho(\overline{\mathbf{A}}) < 1$ 上,把"循环模型为什么不稳"从玄学变成了可判定的谱条件,并用 Table 1 对既有注入方式给出统一分类(加法=边缘稳定、拼接=不稳定)。
- 一个便宜的架构修复:$\mathbf{A} = \mathrm{Diag}(-\exp(\cdot))$ + ZOH/Euler 离散化,额外参数占比只有 0.35%–0.83%,却把可用学习率范围拉宽 5 倍、并让残差归一化变得不必要。
- 两处训练算法修正:per-sequence 深度采样(消除 loss spike、把低 $T$ 的困惑度改善近一个数量级,代价 1.8% 墙钟)与采样分布解耦(修复 $\mu_{\text{bwd}}$ 对 $\Lambda$ 的截断)。
- 循环作为第三条 scaling 轴的量化证据:isoFLOP 曲线出现内部极小值,$\mu^\star_{\text{rec}} \propto C^{0.40}$、$D^\star \propto C^{0.78}$,两个规模指数一致,参数化拟合外推误差约 1%。
- 训练与推理律的统一:$L(T) = L_\infty + Ze^{-zT}$,且 $L_\infty$ 等于训练律在 $T = \mu_{\text{rec}}$ 的取值,合成一条 8 参数统一律,在完全 OOD 的模型上外推误差 0.85%–1.31%。
与已归档相关工作的对比¶
时序说明(重要):本文投稿于 2026-04-14,而本档案库的抓取覆盖起始于 2026-04-06,因此库内几乎不存在早于本文、又与本文问题+解法双同构的论文。经全量枚举 268 篇 deeply_read 论文并按发表日筛查,没有找到"早于本文且未被本文引用"的真正独立并发工作。以下三篇均晚于本文发表,本文在客观上不可能引用它们——因此"本文未引用"不构成任何"殊途同归"的证据,下面每一节都显式标注了双方日期与先后关系。本文实际引用的同谱系工作(Geiping 的 RDM/Huginn、Zhu 等的 Ouro、McLeish 的 retrofitted recurrence、Saunshi 的 looped transformer、Bae 的 Mixture-of-Recursions、Wu 的 Parallel Loop Transformer)目前均不在本库的 deeply_read 集合中。
LoopCTR LoopCTR: Unlocking the Loop Scaling Power for CTR Prediction(中国人民大学,2026-04-21)¶
关系:同期平行工作——LoopCTR 晚 7 天投稿,双方在时间上均不可能引用对方 · 已加载对方精读
- 共同关注的问题:两篇都把"循环复用共享层"当作独立于参数量与数据量的第四条/第三条扩展轴,都认为在参数预算或部署预算被钉死时,深度方向的递归复用是唯一还能换算力的自由度。两篇也都识别出同一个结构性障碍:一个被反复调用的共享 block,其固定的残差配比 $h + f(h)$ 会让不同 loop 深度的行为坍缩到同一模式——Parcae 说这个配比(即 $\mathbf{A}$)的谱不受控会导致状态爆炸,LoopCTR 说这个 1:1 固定配比会导致"重复即等价"的表达力退化。
- 相近的技术骨架:两者都把手术刀落在同一个位置——循环 block 的残差混合算子,都把原本固定的 $h + f(h)$ 参数化后再加约束。Parcae 把它写成动力系统的 $\overline{\mathbf{A}}$ 并用负对角参数化强制 $\rho < 1$;LoopCTR 的 Hyper-Connected Residuals (HCR) 把单流扩成 $n$ 流,用可学的 $\mathbf{A}_r$(流间残差混合)、$\mathbf{A}_m$、$\mathbf{B}$ 三个矩阵替换固定配比,并叠加输入相关的 $\tanh$ 动态扰动。两者也都在训练侧对"多深度"下功夫:Parcae 用 per-sequence 随机深度采样忠实估计 $\mathbb{E}_{T\sim\Lambda}$,LoopCTR 用多深度 process supervision 对每个 loop 深度都施加监督。
- 本文的差异与推进:最本质的差异是约束的方向相反。Parcae 的目标是收敛——把 $\rho(\overline{\mathbf{A}})$ 压到 1 以下让状态在深递归下不炸,代价是残差流被显式衰减;LoopCTR 的目标是分化——让共享层在不同深度表现出不同行为,因此它把系数放开成输入相关的动态量(初始化为恒等以塌缩回标准 Pre-Norm,再逐渐分化)。Parcae 有 LTI 稳定性判据作为理论支点并做到 1.3B / 104B token,LoopCTR 没有稳定性理论但有工业 CTR 的延迟约束与线上口径。另一处彻底相反的是推理侧策略:Parcae 主张推理时增加循环步数换质量(并给出饱和指数律),LoopCTR 则主张 infer-zero-loop——训练时多 loop、推理时直接跳过 Loop Block,把收益内化进一次前向以保住 P99 延迟(InHouse 上 9.26ms vs OneTrans 的 494.58ms)。这两条路线的分歧根源是场景约束不同:LLM 侧推理算力可以按需追加,CTR 侧推理预算是硬上限。
- 可比的方法 / 实验差异:Parcae 的实验全在语言建模(FineWeb-Edu / Huginn 语料,指标为 PPL / Core / Core-Extended),LoopCTR 全在 CTR(Amazon / TaobaoAds / KuaiVideo / InHouse,指标为 AUC / NE),没有任何共同数据集或指标,不存在可直接并列的数值。方法论上可以互补的一点是:Parcae 的 Table 4 显示 per-sequence 采样对低 $T$(即少循环)的改善最大(350M 的 $T$=1 PPL 从 167.61 降到 17.92),而这恰恰是 LoopCTR 的 infer-zero-loop 能成立的前提条件——LoopCTR 靠 process supervision 达成同一效果。反过来,LoopCTR 的 HCR 若要扩到 Parcae 的 $\mu_{\text{rec}} = 8$–32 深度,就会撞上 Parcae 诊断出的谱半径问题:$\mathbf{A}_r$ 是完全可学的 $n \times n$ 混合矩阵,按 Table 1 的分类正属于"不稳定"一档,只是 CTR 模型循环次数少($L \le 3$)尚未暴露。
Loopie Loop the Loopies!(IQuest Research,2026-07-17)¶
关系:后续工作——晚于本文 3 个月,本文不可能引用;两者结论存在实质张力 · 已加载对方精读
- 共同关注的问题:两篇的问题陈述几乎可以互换:循环模型宣称的优势,在把算力记账做对之后还剩多少?Loopie 把它挑明为"循环 $N$ 次,预训练算力也乘 $N$,所以不该跟同参数量的 Transformer 比,而该跟同算力预算的 Transformer 比"——按这个换算,Huginn-3.5B 用 32 步循环,对手应该是约 112B 参数的模型。Parcae 的 §5.2 做的正是这件事:固定 FLOP 预算下扫 $\mu_{\text{rec}}$,看循环与数据怎么分配才最优。
- 相近的技术骨架:两者都以"固定算力预算下的架构-资源分配"为分析框架,都用 isoFLOP/等成本对比来判定循环是否值得,也都需要处理循环带来的显存与梯度回传问题。
- 本文的差异与推进:结论方向存在张力,值得并置阅读。Parcae 在 140M/370M 上得到 $\mu^\star_{\text{rec}} \propto C^{0.40}$,即算力越多、最优循环次数越多;Loopie 则论证在大规模预训练下 $R = 2$ 才是合理选择,理由是"额外循环的边际收益必须超过把同样 FLOPs 分配给宽度、深度或数据的收益"。但两者其实不完全冲突:Parcae 的 $\mu^\star_{\text{rec}}$ 在其最高预算档($64\times10^{18}$,140M)也只有 10,而在最低档只有 2;Loopie 的算力尺度(150B–800B token、20B 参数)远在 Parcae 的扫描范围之外,且 Loopie 匹配的是实测 optimizer-step 墙钟时间(其名义 FLOPs 是参考模型的 1.424 倍)而非理论 FLOPs。也就是说 Parcae 给的是理论 FLOP 口径下的幂律外推,Loopie 给的是特定硬件/并行配置下的实测口径——两者的"算力"不是同一个量。另一处真正的分歧是循环的施加方式:Parcae 是 model-loop 式的中段循环($P \to R^{\times T} \to C$),Loopie 论证 layer-loop(每层就地循环再传下一层)在流水线并行下的局部性远优于 model-loop,因为 model-loop 要求每个 microbatch 反复遍历整条流水线并制造环形依赖。Parcae 的架构在生产级流水线并行下会撞上 Loopie 指出的这堵墙,而论文完全没有触及这一层(其最大规模 1.3B,尚不需要复杂的 PP)。
- 可比的方法 / 实验差异:Parcae 覆盖 140M–1.3B / 11.2B–104B token / $\mu_{\text{rec}}$ 2–32,Loopie 覆盖 1.34B–20B / 150B–3.5T token / $R = 2$–4,两者规模区间几乎不重叠,也无共同 benchmark(Parcae 用 Core/Core-Extended,Loopie 用 AIME/MMLU-Redux/IFEval 等)。一个可以互相补足的空白:Parcae 给出了 test-time 循环的定量饱和律($L_\infty + Ze^{-zT/\mu_{\text{rec}}}$),而 Loopie 自承"推理侧的自适应计算、早退一概未触及";反过来 Loopie 给出了显存-microbatch-吞吐的工程记账法,而 Parcae 的 FLOP 估计 $(2\hat{N}_1 + 6\hat{N}_2)D$ 是纯理论量、未与实测吞吐核对。
DeRes DeRes: Decoupling Residual Stability and Adaptivity for Scalable CTR Prediction(2026-06-06)¶
关系:后续工作——晚于本文近 2 个月,本文不可能引用;两者的谱分析视角恰好互补 · 已加载对方精读
- 共同关注的问题:两篇都把深度可扩展性的 root cause 定位到残差流线性传递算子的谱性质上,而不是定位到注意力或 FFN。Parcae:拼接式注入让 $\mathbf{A} = W_1$ 无约束,$\rho(\mathbf{A}) > 1$ 导致状态爆炸;DeRes 的 Proposition 2:最小奇异值小于 1 的可学习残差矩阵会随深度累积指数衰减(其 baseline mHC 的双随机残差矩阵实测 $\rho \approx 0.49$,在尾部 item 上劣于纯恒等残差的 OneTrans)。这是同一枚硬币的两面——谱半径大于 1 则爆炸、小于 1 则信息衰减,深度扩展要求对这个算子的谱做主动控制。
- 相近的技术骨架:两者的解法都是"给残差流的线性传递项一个显式的、受控的参数化",并都刻意保留一条结构上安全的通路。Parcae 把 $\mathbf{A}$ 约束到负对角、离散化后 $\rho < 1$,把自适应性全部留给非线性项 $\mathcal{R}$;DeRes 直接把两个职能拆成并行两路——Path 1 固定恒等残差(一阶 HORNN,负责稳定),Path 2 跨层块注意力(高阶 HORNN,负责自适应),再用向量门 $\boldsymbol{\gamma}_l$ 融合。"稳定性与自适应性不应共用同一个算子"这句 DeRes 的设计哲学,恰好也是 Parcae 隐含的分工($\overline{\mathbf{A}}$ 只管稳、$\mathcal{R}$ 只管学)。
- 本文的差异与推进:Parcae 处理的是同一组权重被反复调用的循环场景(权重共享,深度是执行次数),DeRes 处理的是层间连接拓扑(权重不共享,深度是物理层数)——这是问题设定上最大的分歧,DeRes 的 recursive-depth 属性来自 HORNN 的形式化视角而非真正的权重复用。方法上,Parcae 靠参数化约束(负对角 + ZOH)从构造上排除不稳定,DeRes 靠路径解耦 + 门控在运行时选择。另外 DeRes 用 SiLU 替换 Softmax 以支持并行多兴趣激活与负值软遗忘,这是 CTR 特有的诉求(一个用户同时持有多个兴趣),在语言建模里没有对应物。
- 可比的方法 / 实验差异:无共同数据集(DeRes 用 Criteo/Avazu/Industrial + AUC/NE,Parcae 用 FineWeb-Edu + PPL/Core)。两者都拟合了 scaling 指数但口径完全不同:DeRes 报告 $\gamma = 0.118$ vs OneTrans 的 0.071(AUC 随参数量),Parcae 报告有效参数指数 $a \approx 0.77$、$\mu^\star_{\text{rec}} \propto C^{0.40}$(loss 随算力),不可直接比较。一处可以互相印证的观察:DeRes 发现 8 层配 DeRes 即可匹配 16 层 OneTrans,Parcae 发现 770M Parcae 的 Core 分逼近 1.3B Transformer——两者都得到约 2× 的"等效深度/参数"收益,但对该收益的机制解释不同(DeRes 归因于跨层信息可达性,Parcae 归因于有效参数量 $N(\mu_{\text{rec}})$ 的增长)。
被剔除的近似候选(连同理由):
- CS3 CS3(快手,2026-04-21):带
recursive-depth标签,且同样在"参数/延迟预算受限下提升容量"的方向上,但解法是双塔的在线能力协同 + 蒸馏,与"共享层反复执行"的循环骨架无关,属于 tag 词根匹配的假阳性。 - WHALE WHALE(Meta,2026-07-19):
recursive-depth+parameter-scaling,但问题是推荐场景的统一模型与 Wukong 特征交互的扩展,root cause 是特征交互阶数而非残差流的深度递归稳定性;解法骨架不重合。 - Skaling: Chinchilla's Exponents Meet Kaplan's Coupling Skaling: Chinchilla's Exponents Meet Kaplan's Coupling(FAIR at Meta,2026-08-07)与 Small-Scale Experiments: Are We There Yet? Small-Scale Experiments: Are We There Yet?(FAIR at MSL Meta,2026-08-12):都是 scaling law 方法论论文,与本文 §5.2 共享 isoFLOP + 参数化拟合的工具箱,但问题不同构——它们研究的是拟合方法本身的可靠性与小规模外推的有效性,本文研究的是"引入一条新扩展轴之后律的形状",架构侧毫无交集。另外两篇均晚于本文近 4 个月,纳入对比只会制造"本文未引用"的伪并发假象。
- NQF NQF: Neural Quadratic Forms(MIT,2026-08-13):为 scaling law 与突现学习提供极简可解析模型,问题层面是"为什么会有幂律",与本文"某条具体轴的幂律指数是多少"是不同层次的追问;且晚 4 个月。
- In-Place TTT In-Place TTT(ByteDance Seed,2026-04-08):是少数早于本文的候选(早 6 天),同样"在不加参数的前提下增加推理期计算",但解法是把 MLP 的 $W_{\text{down}}$ 复用为 fast weights 做测试时权重更新,属于 test-time training 谱系,与"同一组权重在深度方向反复执行"的循环骨架不同构;本文正文也确未引用它,但两者的方法流程图无法抽象重合,不构成语义孪生。
- Arch-Warmup Arch-Warmup(Pluralis Research,2026-06-15):
training-stability+parameter-scaling,同样处理预训练稳定性,但手段是训练调度层面的架构 warmup,不触及残差流传递算子的谱结构;且晚于本文 2 个月。
讨论与局限性¶
核心贡献值得借鉴的地方。 这篇论文最大的方法论价值不在 Parcae 这个具体架构,而在于"把一个难以分析的非线性递归过程精确改写成动力系统、再线性化到有经典判据的子类上"这套路数。式 (6) 的相对贡献改写是无损的,近似只发生在丢掉 $\mathcal{R}$ 那一步,因此得到的稳定性条件是必要条件的良好代理而非粗糙类比——Figure 3 中"发散 run 全部 $\rho(\mathbf{A}) \ge 1$、收敛 run 全部 $< 1$"的一一对应就是这个代理有效的直接证据。任何要在深度方向做权重复用的架构(包括推荐侧的 LoopCTR 谱系)都可以照搬这个诊断流程:把层间更新写成 $h_{t+1} = \mathbf{A}h_t + \mathbf{B}e + \mathcal{R}$,检查 $\mathbf{A}$ 的谱。附录 J 的故障排查链条(谱范数 → 经验放大比 → 逐递归步范数 → 逐 block 范数 → prelude 内部逐层范数)同样是一份可复用的模板。
理论框架只覆盖了不稳定性的一半。 LTI 判据管住了 $\mathbf{A}$ 侧的递归爆炸,但 1.3B 上的晚期 spike 来自 $\mathbf{B}$ 侧的输入注入,是靠经验诊断加一层 LN 修掉的,框架本身没有预测到。作者对 $\mathbf{B}$ "不加约束"的选择也没有给出理由。此外线性化丢掉的 $\mathcal{R}$ 恰恰是模型的全部表达力所在——$\rho(\overline{\mathbf{A}}) < 1$ 是线性化系统的稳定条件,对完整非线性系统既非充分也非必要,论文对这一点只字未提。
Table 6 的表述比数据更乐观。 如前所述,"最优 $\mu_{\text{rec}}$ 在两个规模上都给出更好的 Core 分"这一说法在 9 个 (规模, FLOP) 组合中只有 3 个成立,且失败的全在低预算档。正确的读法是循环的收益随算力预算增大才显现。论文用"at extended FLOP budgets"做了限定,但摘要与正文的整体口吻仍偏强。
规模与可外推性。 全部 scaling law 实验只在 140M 与 370M 两档上做,最大的端到端模型是 1.3B / 104B token——对现代前沿模型而言这仍是小规模。$\mu^\star_{\text{rec}} \propto C^{0.40}$ 若外推到 $10^{24}$ FLOPs 会给出很大的循环次数,而附录 I 已经显示 $\mu_{\text{rec}}$ 超过 8 后若 $\mu_{\text{bwd}}$ 跟不上就会退化——这条幂律的可外推性实际上被 $\mu_{\text{bwd}} = \lceil \mu_{\text{rec}}/2 \rceil$ 这个未经 FLOP 最优化的启发式规则绑定着,而截断反传的显存开销随 $\mu_{\text{bwd}}$ 线性增长。作者自己也把"$\mu_{\text{rec}}$ 与 $\mu_{\text{bwd}}$ 的 FLOP 最优组合"列为未来工作,但这恰恰是这条 scaling law 能否成立的关键前提。
推理成本这一面被轻描淡写。 论文在 Discussion 里承认"$\mu_{\text{rec}}$ 越大,达到同等质量所需的 test-time 步数越多",但全文的参数效率叙事("770M 顶得上 1.3B")建立在参数量这一个维度上,没有给出等质量下的推理延迟或吞吐对照。而循环模型的每一步递归都是一次完整的 block 前向,$T = 8$ 意味着中段的 8 倍串行计算——对延迟敏感的部署,这个代价可能完全抵消掉参数量减半的收益。论文最初的动机是"推理开销占比越来越大、部署要往端侧走",而端侧的瓶颈往往是延迟而非显存。这是全文动机与实测口径之间最大的缺口。
无工业落地验证。 论文没有任何线上部署、A/B 实验或生产级吞吐数据,全部结论建立在学术规模的离线预训练上;其 FLOP 估计也是理论量,未与实测墙钟核对——这一点在与 Loopie 并置时尤其明显(后者证明理论 FLOPs 与实测 step 时间可以差 42%)。
对推荐系统方向的迁移价值。 直接迁移有限(纯语言建模),但有两条明确的线索:(1) $\rho(\overline{\mathbf{A}}) < 1$ 这个判据可以直接用来审计推荐侧的循环架构——LoopCTR 的 HCR、以及任何用可学习矩阵替换固定残差配比的设计,按本文 Table 1 的分类都落在"不稳定"一档,只是循环次数少($L \le 3$)尚未暴露问题;一旦推荐模型要把循环次数推到 8 以上,这个诊断就变成必需品。(2) per-sequence 深度采样对低 $T$ 的巨大改善(350M 上 PPL 167.61 → 17.92)为"训练时多 loop、推理时少 loop 甚至零 loop"这类推荐侧部署策略提供了一个训练目标层面的解释——它本质上是在更忠实地估计 $\mathbb{E}_{T \sim \Lambda}[\ell]$,而不是靠额外的监督信号硬凑。