Neural Quadratic Forms: A Unified Minimal Model for Sudden Learning and Scaling Laws¶
作者:Liu Ziyin (MIT)、Yizhou Xu (EPFL)、Tomaso Poggio (MIT)、Isaac Chuang (MIT),前两位共同一作 arXiv:2608.13335,cs.LG,2026-08-13 代码:https://github.com/xu-yz19/Neural-Quadratic-Forms
1. 研究动机与背景¶
神经网络的训练过程展现出两种表面上互不相容的规律性:
- 单条轨迹上的突变学习(sudden learning):损失在很长的区间内几乎不动(平台期 / plateau),然后在某个时刻突然断崖式下落,对应新特征被获取。这在深度线性网络、grokking、saddle-to-saddle 动力学里被反复观察到。
- 跨尺度的平滑幂律(neural scaling law):损失随模型规模、数据规模或训练算力在数个数量级上遵循光滑幂律,且对架构细节不敏感。这类律准确到足以指导大规模设计决策——compute-optimal scaling 会倾向于"较小的模型 + 大得多的数据"而不是"更大但欠训练的模型"(Chinchilla)。
关键在于,这两种行为都跨架构出现:MLP、CNN、MoE、Transformer 的微观结构差异极大,却都表现出这两类现象。作者指出,"尖锐的微观事件 + 对微观细节无所谓的宏观规律"正是物理学中少数集体变量(collective variables)存在的典型signature,因而值得构造一个最小模型(minimal model)。
论文明确借用了物理学的类比来组织叙事:
- 光滑的确定性动力学在不同模式逐个越过失稳阈值时,可以产生尖锐可复现的转变——如流体对流的起始;
- 长平台后的急剧变化像自催化反应的诱导期(induction period);
- 一个转变可以在参数的每个有限取值下都是光滑的,却只在某个极限区制下变尖锐——正如相变只在热力学极限下出现;
- 对微观细节的弱依赖暗示普适性(universality)。
要找到集体变量及其满足的方程,自然的出发点是对称性,而神经架构提供了一个异常干净的对称性:网络由重复的、可交换的组件装配而成——感知机的隐藏单元、注意力层的 head、混合专家里的 expert、卷积的 channel。重新标号这些组件不改变所表示的函数,所以宽度为 $d$ 的模块在对称群 $S_d$ 作用下不变,正如全同粒子系统在交换下不变。这个类比不只是修辞:两层网络的训练已被直接映射到相互作用粒子的 mean-field 动力学;置换对称性已被提议作为"神经元"的操作性定义;参数对称性的破缺与恢复被论证为组织特征获取顺序的机制。
这类对称性正是 Landau 构造的标准起点:确定对称群、确定一个让系统停留在构型空间某个特殊点附近的小参数、围绕该点展开、只保留对称性允许的最低阶项。在这里:群是 $S_d$,特殊点是参数空间的原点,小参数是初始化尺度 $\epsilon$。微观细节此后只应存活在展开的唯象系数中——这正是"跨架构普适性理应出现"的意义所在。
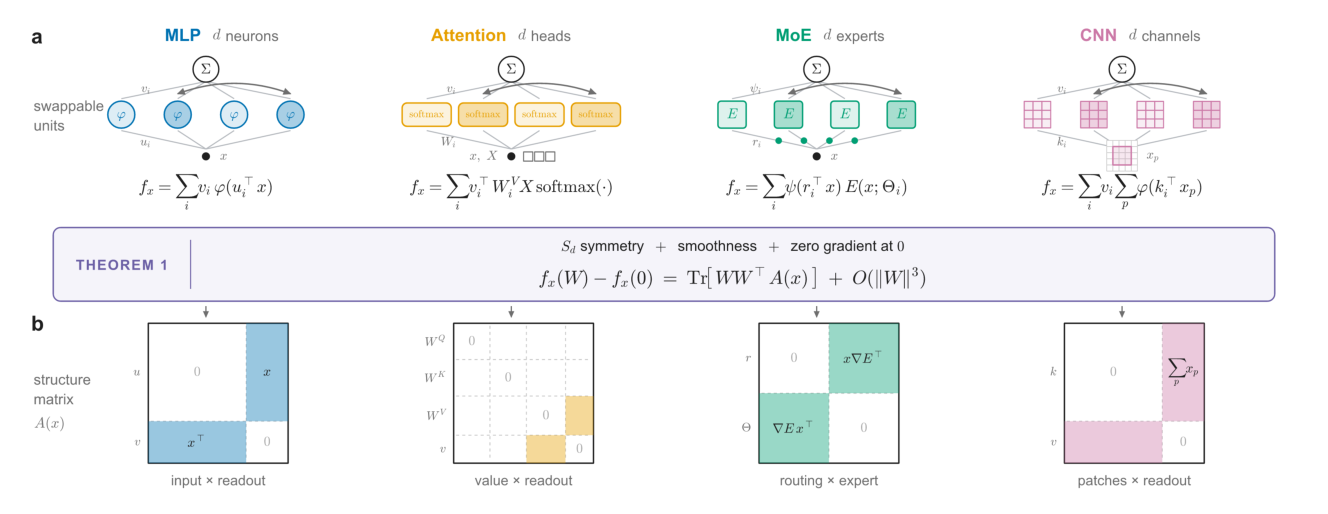
与最相近理论的定位。作者仔细区分了几种都叫"neural scaling law"的规律:(i) 单次运行内损失对优化时间的幂律;(ii) 训练后损失对模型/数据规模的幂律;(iii) compute-optimal 前沿上二者的权衡。本文只处理第一类——超额损失对重标定训练时间的律,但它由与另外两类相同的谱结构控制。作者明确声明"训练后损失如何依赖模型规模、数据规模与算力,以及这些资源该如何相互权衡,是我们不处理的另一个问题"。
- 最接近的是 Bahri 等人的理论,区分 variance-limited 区制(损失随模型/数据规模的倒数下降)与 resolution-limited 区制(指数由数据流形或切核谱决定)。他们的是"训练后损失 vs 规模",本文的是"损失 vs 时间"。
- Kernel / NTK 路线也能从谱结构得到幂律学习曲线,但它们在初始化附近线性化并冻结表征,压制了产生突变的特征增长;于是突变学习只能被单独处理(针对特定目标的 saddle-to-saddle 转变,或平凡对称解的失稳)。
- 本文的问题横跨二者:宏观律背后的谱能否从特征学习动力学内部涌现?同一个动力学能否同时产生个体模式的突然获取? 之所以可解,恰恰是因为该动力学可归约到少数集体变量。
二次型参数化本身并不新:矩阵感知、相位恢复、对角线性网络、二次网络都被各自单独分析过,用来解释隐式低秩偏置、谱初始化或特征增长;深度线性网络的精确分析展示了同样的模式化平台期;近期工作甚至论证二次模型对 LLM 都保持定量准确。本文新增的是:这些不是一族类比的模型,而是同一个模型;且耦合 $A(x)$ 可从架构算出。 17 个此前被当作独立可解代理研究的模型,都是同一式子在特定 $A$ 下的实例。一个实用推论是:$A(x)$ 可以在某个待选层被真正训练之前就被求值。
2. 核心结果一:置换对称性推出的神经二次型¶
2.1 记号与假设¶
$x$ 表示模块的单个输入;模块本身写作 $f_x$,是固定 $x$ 时参数的标量值函数。它的 $d$ 个组件各携带 $p$ 个参数,收集为 $w_1,\dots,w_d \in \mathbb{R}^p$,故 $f_x : \mathbb{R}^{p\times d}\to\mathbb{R}$。
Definition 1(置换对称性):$f_x$ 满足 $S_d$ 对称性,若对任意置换 $\sigma$ 有 $f_x(w_1,\dots,w_d) = f_x(w_{\sigma(1)},\dots,w_{\sigma(d)})$。
沿用 MLP 的术语,每个 $w_i$ 可看成隐藏层一个神经元的权重,因此论文统一称 $w_i$ 为"神经元"。任何构成置换对称性最小单元的权重子集都叫神经元——在这个意义下,一个自注意力 head 的全部权重也是一个"神经元"。
Property 1(ZGZ, Zero Gradient at Zero):对任意神经元 $i$ 与任意 $w_{j\neq i}$,有 $\nabla_{w_i} f_x(w_1,\dots,w_d)\big|_{w_i=0} = 0$。即某个神经元自身权重为零时,损失对它的梯度消失,与其他神经元取值无关。
2.2 Theorem 1(神经二次型)¶
设 $f_x:\mathbb{R}^{p\times d}\to\mathbb{R}$ 关于神经元 $W=(w_1,\dots,w_d)$ 三次连续可微,满足置换对称性与 ZGZ 条件,则
$$f_x(W) = f_x(0) + \sum_{i=1}^{d}\mathrm{Tr}\!\left[w_i w_i^{\top} A(x)\right] + O(\|W\|^3) \tag{1}$$
其中 $A(x)\in\mathbb{R}^{p\times p}$ 是只依赖于 $x$ 的对称矩阵。等价地,
$$\lim_{\phi\to\infty}\phi\left(f_x(\phi^{-1/2}W)-f_x(0)\right) = \sum_{i=1}^{d}\mathrm{Tr}\!\left[w_i w_i^{\top} A(x)\right] \tag{2}$$
论文把任何形如 (1) 的模型称为神经二次型(neural quadratic form, NQF),把 $A(x)$ 称为结构矩阵(structure matrix)。一个通用 NQF 可写成
$$f_x(W) = c_0 + \mathrm{Tr}\!\left[WW^{\top}A(x)\right] \tag{3}$$
以 $d$ 为宽度、$A$ 为"架构"。在最一般的引言式表述里(不假设 ZGZ 完全成立时的一阶残余项),
$$f_x(W)-f_x(0) = \mu^{\top}g(x) + \mathrm{Tr}\!\left[WW^{\top}A(x)\right] + O(\|W\|^3) \tag{4}$$
其中 $\mu = \sum_{i=1}^{d} w_i$。作者指出,对多数实用架构 $\mu^{\top}g(x)$ 项消失,故 NQF 常常只需写二阶矩项。
证明思路(Appendix A.3):三次可微给出绕原点的多元 Taylor 展开 $f_x(W)=f_x(0)+\sum_i(\nabla_{w_i}f_x(0))^{\top}w_i+\frac12\sum_{i,j}w_i^{\top}H_{ij}w_j+O(\|W\|^3)$,$H_{ij}=\partial^2 f_x/\partial w_i\partial w_j|_{W=0}$。 ZGZ 使一阶项消失($\nabla_{w_i}f_x(0)=0$);更关键的是,"只要 $w_i=0$ 梯度就为零、与 $w_j$ 无关"这一条对 $w_j$ 再求导,直接给出所有非对角 Hessian 块 $H_{ij}=0\ (i\neq j)$,交叉项被完全消掉。最后置换对称性要求所有对角块相同:$H_{11}=H_{22}=\cdots=H_{dd}$,令 $A(x)=\frac12 H_{ii}$ 即得 (1)。
Remark:ZGZ 并非必要条件,去掉它得到本质相同的结果但记号更复杂(见 §7.1)。此外实践中 ZGZ 可被更强但同样常见的逐神经元 $\mathbb{Z}_2$ 对称性替代($f_x(\dots,w_i,\dots)=f_x(\dots,-w_i,\dots)$),此时 Taylor 展开中一阶与三阶张量都为零,误差阶从 $O(\|W\|^3)$ 自动提升到 $O(\|W\|^4)$。
维度的物理含义:注意 $M$ 与 $A(x)$ 都是 $p\times p$,$p$ 是单个神经元的参数数——宽度 $d$ 已经被求和掉了。既然神经元可交换,它们可读作具有 $p$ 维状态空间的全同粒子,$\sum_i w_i$ 与 $M=\sum_i w_i w_i^{\top}$ 是其经验分布的一阶与二阶矩,$M$ 扮演密度矩阵的角色。模型只通过二阶矩 $M=WW^{\top}$ 依赖于神经元。
3. 各架构的结构矩阵 $A(x)$¶
作者强调一个"从业者常常不清楚"的点:置换对称性如此普遍,以至于任何有"宽度"概念的架构模块自动具有置换对称性,这使 Theorem 1 几乎适用于实践中遇到的任何神经模块。于是在 NQF 视角下,是结构矩阵决定了神经网络的学习动力学。
3.1 两层 MLP(Proposition 1)¶
$$f_x(w_1,\dots,w_d)=\sum_{i=1}^{d}v_i\,\varphi(u_i^{\top}x) \tag{5}$$
其中 $w_i=[u_i^{\top},v_i]^{\top}$,$u_i\in\mathbb{R}^k$ 为输入权重,$v_i\in\mathbb{R}$ 为读出权重。若 $\varphi$ 三次连续可微且 $\varphi(0)=0$,则
$$A(x)=\frac{\varphi'(0)}{2}\begin{bmatrix}0_{k\times k} & x\\ x^{\top} & 0\end{bmatrix} \tag{6}$$
3.2 多头注意力(Proposition 2)¶
输入查询 token $x\in\mathbb{R}^{D}$ 与上下文矩阵 $X\in\mathbb{R}^{D\times N}$,第 $i$ 个 head 的参数 $w_i=\mathrm{vec}(W_i^{Q},W_i^{K},W_i^{V},v_i)$:
$$f_x(w_1,\dots,w_d)=\sum_{i=1}^{d}v_i^{\top}W_i^{V}X\cdot\mathrm{softmax}\!\left(\frac{X^{\top}(W_i^{K})^{\top}W_i^{Q}x}{\sqrt{d_k}}\right) \tag{7}$$
$$A(X)=\frac12\begin{bmatrix}0&0&0&0\\0&0&0&0\\0&0&0&x_{\mathrm{avg}}\otimes I_{d_v}\\0&0&x_{\mathrm{avg}}^{\top}\otimes I_{d_v}&0\end{bmatrix},\qquad x_{\mathrm{avg}}=\tfrac1N X\mathbf{1}_N \tag{8}$$
这是全文最醒目的一个结论:到该阶为止,决定自注意力 head 行为的只有 value 与 output(读出)矩阵,自注意力表现得像一个平均算子;query 与 key 权重要到四阶才出现。
3.3 仅 Query-Key 的 head(Proposition 3)与单头注意力 logits(Proposition 4)¶
将读出向量与 value 矩阵固定并合并为常向量 $c\in\mathbb{R}^{D}$(注意力学习动力学的常见理论模型):
$$f_x(w_1,\dots,w_d)=\sum_{i=1}^{d}c^{\top}X\cdot\mathrm{softmax}\!\left(\frac{X^{\top}(W_i^{K})^{\top}W_i^{Q}x}{\sqrt{d_k}}\right) \tag{9}$$
$$A(X)=\frac{1}{2\sqrt{d_k}}\begin{bmatrix}0& xu^{\top}\otimes I_{d_k}\\ ux^{\top}\otimes I_{d_k}&0\end{bmatrix},\quad u=\Sigma_X c,\ \ \Sigma_X=\tfrac1N XX^{\top}-\left(\tfrac1N X\mathbf{1}_N\right)\left(\tfrac1N X\mathbf{1}_N\right)^{\top} \tag{10}$$
即 $u$ 由上下文的样本协方差作用在读出向量上给出。有趣的是,单头注意力也可被视作独立的 NQF——因为 $W^{Q},W^{K}$ 的行之间同样含置换对称性作为子群。把 $W^Q,W^K$ 的第 $i$ 行取作 $w_i\in\mathbb{R}^{2D}$,则
$$A(X)=\frac{1}{2\sqrt{d_k}}\begin{bmatrix}0&xu^{\top}\\ ux^{\top}&0\end{bmatrix}\in\mathbb{R}^{2D\times 2D} \tag{11}$$
3.4 混合专家(Proposition 5)¶
采用独立门控机制,$w_i=[r_i^{\top},\mathrm{vec}(\Theta_i)^{\top}]^{\top}$:
$$f_x(w_1,\dots,w_d)=\sum_{i=1}^{d}\psi(r_i^{\top}x)\,E(x;\Theta_i) \tag{12}$$
其中门控激活 $\psi$ 光滑且 $\psi(0)=0$,专家网络满足 $E(x;0)=0$。则
$$A(x)=\frac12\begin{bmatrix}0&\psi'(0)\,x\,\nabla_{\Theta_i}E(x;0)^{\top}\\ \psi'(0)\,\nabla_{\Theta_i}E(x;0)\,x^{\top}&0\end{bmatrix} \tag{13}$$
即 MoE 的领头行为由路由权重与专家在零点的梯度之间的交叉块决定。
3.5 单层 CNN(Proposition 6)¶
$w_i=[k_i^{\top},v_i]^{\top}$,全局求和池化覆盖 $P$ 个空间 patch:
$$f_x(w_1,\dots,w_d)=\sum_{i=1}^{d}v_i\sum_{p=1}^{P}\varphi(k_i^{\top}x_p) \tag{14}$$
$$A(X)=\frac{\varphi'(0)}{2}\begin{bmatrix}0_{m\times m}&\sum_{p=1}^{P}x_p\\ \sum_{p=1}^{P}x_p^{\top}&0\end{bmatrix} \tag{15}$$
3.6 完整模型清单(Table 1 / Table 3)¶
论文正文 Table 1 给出 6 个代表性模型,附录 Table 3 给出完整清单。完整表格如下($M=WW^{\top}$,唯二例外是 tied query-key 与 linear SSL 两行,其神经元是 $W$ 的行,故 $M=W^{\top}W$):
| 模型 | NQF 记法 | 结构矩阵 $A(x)$ |
|---|---|---|
| PSD 矩阵感知 / PSD 分解 | $\hat y_a=\langle S_a, WW^{\top}\rangle$ | $A_a=\mathrm{Sym}(S_a)$;若 $S_a=S_a^{\top}$ 则 $A_a=S_a$ |
| 矩形矩阵感知 / 矩阵分解 | $\hat y_a=\langle S_a, UV^{\top}\rangle=\mathrm{Tr}(U^{\top}S_aV)$ | $A_a=\frac12\begin{bmatrix}0&S_a\\ S_a^{\top}&0\end{bmatrix}$ |
| 矩阵补全 / 推荐系统单条目 | $\hat R_{ij}=u_i^{\top}v_j$ | $A_{ij}=\frac12\begin{bmatrix}0&e_ie_j^{\top}\\ e_je_i^{\top}&0\end{bmatrix}$ |
| 词-上下文嵌入打分 | $s_{wc}=u_w^{\top}v_c$ | $A_{wc}=\frac12\begin{bmatrix}0&e_we_c^{\top}\\ e_ce_w^{\top}&0\end{bmatrix}$ |
| 二次网络 | $f_W(x)=\sum_r(w_r^{\top}x)^2$ | $A_x=xx^{\top}$ |
| 相位恢复 | $\hat y_a=a^{\top}WW^{\top}a$ | $A_a=aa^{\top}$ |
| 对角线性网络(平方参数化) | $f_x(u)=\sum_k x_ku_k^2/4$ | $A_x=\frac14\mathrm{Diag}(x)$ |
| 对角线性网络(双因子带符号) | $f_x(u,v)=u^{\top}\mathrm{Diag}(x)v$ | $A_x=\frac12\begin{bmatrix}0&\mathrm{Diag}(x)\\ \mathrm{Diag}(x)&0\end{bmatrix}$ |
| 两层 MLP | $\sum_i v_i\varphi(u_i^{\top}x)$ | 见 (6) |
| 单层 CNN | $\sum_i v_i\sum_p\varphi(k_i^{\top}x_p)$ | 见 (15) |
| 混合专家 | $\sum_i\psi(r_i^{\top}x)E(x;\Theta_i)$ | 见 (13) |
| 多头注意力 | $\sum_i v_i^{\top}W_i^{V}X\cdots$ | 见 (8) |
| 仅 Query-Key 注意力 | $\sum_i c^{\top}X\cdot\mathrm{softmax}(\cdots)$ | 见 (10) |
| Tied query-key 注意力 | $\frac{1}{\sqrt{d_k}}u^{\top}W^{\top}Wx$ | $A^{\mathrm{tied}}_{x,X,c}=\frac{1}{2\sqrt{d_k}}(xu^{\top}+ux^{\top})$ |
| 双线性序列回归 | $x_s^{\top}Bx_t$,$B=UV^{\top}$ | $A_{s,t}=\frac12\begin{bmatrix}0&x_sx_t^{\top}\\ x_tx_s^{\top}&0\end{bmatrix}$ |
| 线性 SSL 数据增广 | $\|W\Delta\|^2=\mathrm{Tr}(W^{\top}W\Delta\Delta^{\top})$ | $A_{\Delta}=\Delta\Delta^{\top}$,$\Delta=x-\chi$ |
这张表有两种读法:许多通用架构近似归约为 NQF;许多此前彼此独立的可解模型是 NQF 的特例。
3.7 "层"与"表征"的可定义性¶
虽然 $\mathrm{Tr}[WAW^{\top}]$ 的形式是普适的,但 $A$ 总是取稀疏且强非对角的形式。对上述任何神经层,
$$A=\frac12\begin{bmatrix}0&C(x)\\ C^{\top}(x)&0\end{bmatrix} \tag{16}$$
$C\in\mathbb{R}^{d_1\times d_2}$ 是任意矩形矩阵。于是 $W$ 可相应分块 $W=\begin{bmatrix}Z_1\\ Z_2\end{bmatrix}$,
$$M=WW^{\top}=\begin{bmatrix}Z_1Z_1^{\top}&Z_1Z_2^{\top}\\ Z_2Z_1^{\top}&Z_2Z_2^{\top}\end{bmatrix} \tag{17}$$
模型输出只依赖 $Z_2Z_1^{\top}$:$f_x=\mathrm{Tr}[Z_2Z_1^{\top}C]$。当 $C=x$ 是向量时,$Z_1$ 也是向量,$f_x=Z_2Z_1^{\top}x$,即一个两层线性网络。因此可以抽象地把 $Z_1^{\top}$ 读作第一层权重、$Z_2$ 读作第二层权重,第一层的隐表征随之可定义:
$$h(x)=Z_1^{\top}C(x) \tag{18}$$
凡 $A$ 能写成 (16) 形式的模型,论文称之为"前馈(feedforward)"模型。
4. 核心结果二:学习动力学在序参量上闭合¶
本节回答"跟踪训练需要多少个数"这个问题。答案是:这个数不随模型增长——无论宽度多大,一个 NQF 的轨迹都是 $(M,\mu)$ 上的流。
工作在不假设 ZGZ 的最一般形式下:记 $M:=\sum_i w_iw_i^{\top}$,$\mu:=\sum_i w_i$,
$$f_x(W)=f_x(0)+g(x)^{\top}\mu+\mu^{\top}B(x)\mu+\mathrm{Tr}[MA(x)] \tag{19}$$
($A,B$ 不失一般性取对称。)
Theorem 2(NQF 的主定理)¶
在 SGD $\Delta W=-\eta\sum_{x\in\mathcal{B}}\nabla_W L(f_x(W))$ 下,若两个神经二次模型在初始化时满足 $M_a(0)=M_b(0)$、$\mu_a(0)=\mu_b(0)$,则在相同数据采样下任意时刻 $t$ 都有 $M_a(t)=M_b(t)$、$\mu_a(t)=\mu_b(t)$。学习动力学完全由 $M,\mu$ 决定:
$$\Delta\mu=-\eta\left(d\cdot v+H\mu\right) \tag{20}$$
$$\Delta M=-\eta\left(v\mu^{\top}+\mu v^{\top}+HM+MH\right)+\eta^{2}\left(d\cdot vv^{\top}+v\mu^{\top}H+H\mu v^{\top}+HMH\right) \tag{21}$$
其中 $d$ 是神经元数,$v:=\sum_{x\in\mathcal{B}}\ell'_x\left(g(x)+2B(x)\mu\right)$,$H:=\sum_{x\in\mathcal{B}}2\ell'_x A(x)$,$\ell'_x:=\partial L/\partial f_x$。
证明的核心是梯度的因子化:$\nabla_W L=v\mathbf{1}^{\top}+HW$——梯度是一个"秩一偏置项 + 线性算子作用在 $W$ 上",这使得二阶矩的更新自动闭合。$\eta^2$ 项来自 $\Delta W(\Delta W)^{\top}$,即离散 SGD 相对梯度流的修正。
该定理可推广到包括 vanilla SGD、带 weight decay 的 SGD、Polyak 动量在内的一大类优化方法。加 weight decay 时方程中只多出一个简单的衰减项 $-\gamma M$。
Theorem 3(NQF 的可压缩性)¶
Theorem 2 的一个关键推论是学习过程高度冗余。若两个网络对任意 $x$ 都有 $f_x(\theta_t)=g_x(\theta'_t)$,就说它们有相同的学习动力学(注意这个同一性定义在函数侧,两个模型参数不同也可以动力学相同)。
设一个 NQF 有 $d$ 个神经元,由 $g(x),B(x),A(x)$、学习率 $\eta$ 与初始统计量 $\mu(0),M(0)$ 定义。令
$$k_V:=\dim\left(\mathrm{span}\bigcup_{x\in\mathcal{X}}\left(\{g(x)\}\cup\mathrm{Col}(A(x))\cup\mathrm{Col}(B(x))\right)\right)\le p \tag{22}$$
为 $g(x)$ 与 $B(x),A(x)$ 所有列向量在整个训练集上张成的联合子空间维数。若 $d>k_V+1$,则存在一个只有 $d'=k_V+1$ 个神经元的更小 NQF,其参数为 $\tilde g(x)=g(x)$、$\tilde B(x)=B(x)$、$\tilde A(x)=\frac{d'}{d}A(x)$、$\tilde\eta=\frac{d}{d'}\eta$,使得:(1) 对所有 $x\in\mathcal{X}$ 有 $f_{d'}=f_d$;(2) 在相同数据采样的 SGD 下对所有训练步 $t\ge 0$ 都有 $f_{d'}=f_d$。
意义:与原始宽度 $d$ 无关,总存在一个有限尺寸的 NQF 其学习动力学与原模型完全相同。这部分解释了训练动力学被普遍观察到的低维性(gradient descent happens in a tiny subspace / intrinsic dimension),也被称作"动力学彩票假设(dynamical lottery ticket hypothesis)"。此外,当数据是低秩时,该定理断言学习动力学的维数至多是数据的维数——这是"数据中的结构让学习变简单"这一民间信念的一个直接解释。
5. 学习动力学的精确可解情形¶
NQF 的学习动力学没有一般解,但在特殊初始化或数据分布下可解。本节聚焦梯度流,考虑 $m$ 个样本上的经验 MSE:
$$L(W)=\frac1m\sum_{\mu=1}^{m}\left(\mathrm{Tr}[WW^{\top}A(x_\mu)]-y_\mu\right)^{2} \tag{23}$$
记残差 $\Delta_\mu(t)=\mathrm{Tr}[W(t)W(t)^{\top}A(x_\mu)]-y_\mu$,梯度流 $\dot W=-\nabla_W L$ 给出
$$\dot W(t)=-\frac4m\sum_{\mu=1}^{m}\Delta_\mu(t)A(x_\mu)W(t)=-H(t)W(t) \tag{24}$$
对 $M=WW^{\top}$ 求导,动力学自然在 $M$ 的空间闭合:
$$\dot M(t)=\dot WW^{\top}+W\dot W^{\top}=-H(t)M(t)-M(t)H(t) \tag{25}$$
作者指出这类方程在流体力学与聚合物物理中频繁出现——它可看作零维齐次流,而 $M$ 可辨识为雷诺应力(Reynolds stress)。
5.1 归约到广义 Lotka-Volterra 方程¶
Assumption 1(对易性):数据集由 $m$ 个相互对易的对称数据矩阵组成,$A(x_\mu)=P\Lambda_\mu P^{\top}$,$P$ 正交,$\Lambda_\mu=\mathrm{diag}(\lambda_{\mu,1},\dots,\lambda_{\mu,p})$。
在共同本征基下令 $\tilde M(t)=P^{\top}M(t)P$,残差变为
$$\Delta_\mu(t)=\sum_{k=1}^{p}\tilde M_{kk}(t)\lambda_{\mu,k}-y_\mu \tag{26}$$
输出与损失梯度只依赖 $\tilde M$ 的对角元。定义 $z_k(t):=\tilde M_{kk}(t)\ge0$ 为第 $k$ 个特征。
Proposition 7:非对角元被对角元"奴役(slaved)",不影响预测与损失,其演化解为
$$\tilde M_{ij}(t)=\tilde M_{ij}(0)\exp\!\left(-\int_0^t\left(\tilde H_{ii}(\tau)+\tilde H_{jj}(\tau)\right)\mathrm{d}\tau\right) \tag{27}$$
代入后第 $k$ 个特征的演化为
$$\dot z_k(t)=-\frac8m\sum_{\mu=1}^{m}\Delta_\mu(t)\lambda_{\mu,k}z_k(t) \tag{28}$$
展开 $\Delta_\mu$ 得到
$$\dot z_k(t)=\frac8m\left(\sum_{\mu=1}^{m}y_\mu\lambda_{\mu,k}-\sum_{j=1}^{p}\left(\sum_{\mu=1}^{m}\lambda_{\mu,k}\lambda_{\mu,j}\right)z_j(t)\right)z_k(t) \tag{29}$$
(29) 正是种群生态学的广义 Lotka-Volterra(GLV)方程。这一对应允许把 $z_k$ 解释为物种丰度,把 $C_{k,j}:=\sum_\mu\lambda_{\mu,k}\lambda_{\mu,j}$ 解释为物种间的竞争(为正时)与协作(为负时)。GLV 一般无解析解,但以下四种情形可解。
5.2 Theorem 4(成比例样本)¶
若数据矩阵可写作 $A(x_\mu)=c_\mu A$。定义 $\alpha:=\frac4m\sum_\mu c_\mu^2$,$\beta:=\frac4m\sum_\mu c_\mu y_\mu$,则
$$W(t)=P\exp(-\xi(t)\Lambda)P^{\top}W(0) \tag{30}$$
其中辅助标量 $\xi(t)$ 满足隐式积分方程
$$t=\int_0^{\xi(t)}\frac{\mathrm{d}s}{\alpha\sum_{j=1}^{p}\lambda_jz_j(0)\exp(-2\lambda_js)-\beta} \tag{31}$$
已有工作中 $\Lambda$ 只有两个本征值的精确解是本定理的特例(此时 (31) 可显式积出)。
5.3 Theorem 5(正交样本)¶
若 $A(x_\mu)A(x_\nu)=0\ \forall\mu\neq\nu$,则
$$W(t)=P\exp(-\Sigma(t))P^{\top}W(0),\qquad \Sigma(t)=\frac4m\sum_{\mu=1}^{m}\xi_\mu(t)\Lambda_\mu \tag{32}$$
每个 $\xi_\mu(t)$ 独立按下式演化:
$$t=\int_0^{\xi_\mu(t)}\frac{\mathrm{d}s}{\sum_{k=1}^{p}\lambda_{\mu,k}z_k(0)\exp(-\frac8m\lambda_{\mu,k}s)-y_\mu} \tag{33}$$
5.4 Theorem 6(正交特征)——最重要的可解情形¶
若进一步假设 $\sum_{\mu}\lambda_{\mu,k}\lambda_{\mu,j}=0\ \forall k\neq j$(特征间无竞争),定义
$$r_k:=\frac8m\sum_{\mu=1}^{m}\lambda_{\mu,k}y_\mu,\qquad C_{kk}:=\frac8m\sum_{\mu=1}^{m}\lambda_{\mu,k}^{2} \tag{34}$$
则 $W(t)=PD(t)P^{\top}W(0)$,$D(t)=\mathrm{diag}(d_1,\dots,d_p)$,$d_k(t)=\sqrt{z_k(t)/z_k(0)}$($z_k(0)\ne0$ 时),且
$$z_k(t)=\frac{r_kz_k(0)}{C_{kk}z_k(0)+\left(r_k-C_{kk}z_k(0)\right)\exp(-r_kt)} \tag{35}$$
若 $r_k=0$ 则 $z_k(t)=\frac{z_k(0)}{1+C_{kk}z_k(0)t}$。
(35) 是标准的 logistic(sigmoid)增长曲线:从 $z_k(0)$ 出发,经历指数增长期后饱和到 $z_k(\infty)=r_k/C_{kk}$。$r_k$ 本质上是输入特征与标签的相关度,$C_{kk}\ge0$ 本质上是输入方差。这正是"突变"的微观来源——每个特征的点火(ignition)是一次 logistic 转变。
5.5 Theorem 7(各向同性样本)¶
前面的解都依赖对易性。本情形下数据矩阵不对易,但满足各向同性条件:
Assumption 2:$m\ge p(p+1)/2$,且二阶矩张量满足
$$\frac1m\sum_{\mu=1}^{m}A_{ij}(x_\mu)A_{kl}(x_\mu)=\frac{c}{2}\left(\delta_{ik}\delta_{jl}+\delta_{il}\delta_{jk}\right) \tag{36}$$
令 $Y=\frac4m\sum_\mu y_\mu A(x_\mu)$,则 $M(t)=W(t)W(t)^{\top}$ 有闭式解
$$M(t)=\exp(Yt)\,M(0)\left[I+8c\,\Phi(t)M(0)\right]^{-1}\exp(Yt),\qquad \Phi(t)=\int_0^t\exp(2Y\tau)\,\mathrm{d}\tau \tag{37}$$
若 $Y$ 非奇异,$\Phi(t)=\frac12Y^{-1}(\exp(2Yt)-I)$。若 $M(0)$ 与 $Y$ 可同时对角化,则 $M(t)$ 的本征值按
$$z_k(t)=\frac{\gamma_kz_k(0)}{4cz_k(0)+\left(\gamma_k-4cz_k(0)\right)\exp(-2\gamma_kt)} \tag{38}$$
演化($\gamma_k$ 为 $Y$ 的第 $k$ 个本征值);$\gamma_k=0$ 时 $z_k(t)=\frac{z_k(0)}{1+8cz_k(0)t}$。形式与 (35) 完全一致,只是增长率与竞争系数换了来源。
附录 B.7 进一步给出一个统一 Theorem 6 与 Theorem 7 可同时对角化情形(以及深度线性网络精确解)的一般解(见 §7.7)。
6. 突变学习与神经 scaling law¶
当单个特征或数据点的学习是阶跃函数式的,它们可以自然复合出任意(单调下降的)学习曲线。本节的核心论点是:当数据相关性遵循幂律结构时,学习曲线自然成为幂律,且指数可预测。正文只给非正式陈述,形式陈述与证明在 Appendix A.17。
6.1 特征式下降(Feature-wise Descent)¶
在 Theorem 6(或 Theorem 7 且 $M(0),Y$ 可同时对角化)的条件下,定义有效增长率 $\zeta_k=r_k$(Theorem 6)或 $\zeta_k=\gamma_k$(Theorem 7)。当初始化尺度 $\epsilon\to0$,$z_k$ 被激活的特征时间为
$$t^{*}_{k}\sim\frac{1}{a\zeta_k}\ln\frac1\epsilon,\qquad a=1\ (\text{Thm 6}),\ a=2\ (\text{Thm 7}) \tag{39}$$
因此不同特征激活之间的间隔在小初始化极限下发散,呈现 saddle-to-saddle 动力学:
$$\lim_{\epsilon\to0}\left|t^{*}_{k'}-t^{*}_{k}\right|=\infty\quad(\zeta_{k'}\neq\zeta_k) \tag{40}$$
Theorem 8 的精确形式:令 $z_k(t^*_k)=\rho z_k(\infty)$($\rho\in(0,1)$ 固定),$z_k(0)=\Theta(\epsilon)$,则
$$t^{*}_{k}=\frac{1}{a\zeta_k}\ln\frac1\epsilon-\frac{1}{a\zeta_k}\ln\left(\frac{C_kc_k}{\zeta_k-C_kc_k\epsilon}\cdot\frac{1-\rho}{\rho}\right)=\frac{1}{a\zeta_k}\ln\frac1\epsilon+O(1) \tag{41}$$
Theorem 9(幂律):定义有效目标强度 $V_k:=\frac{r_k^2}{8C_{kk}}$(Theorem 6)或 $V_k:=\frac{\gamma_k^2}{16c}$(Theorem 7)。假设
$$\zeta_k=c_\zeta k^{-\alpha_2},\qquad V_k=c_wk^{-\alpha_1} \tag{42}$$
且 $\alpha_1>1$(保证初始超额损失有限)、$\beta\ge\alpha_1-\alpha_2$($\beta$ 为初始化剖面 $z_k(0)=\epsilon c_kk^{-\beta}$ 的衰减指数)。定义重标定时间 $\tau:=t/\ln(1/\epsilon)$,则在无限宽度 $p\to\infty$ 与小初始化 $\epsilon\to0^+$ 双极限下,超额损失有幂律衰减
$$E(\tau)=\Theta\!\left(\tau^{-\frac{\alpha_1-1}{\alpha_2}}\right) \tag{43}$$
证明骨架非常清晰:在两种区制下超额损失都可写成
$$E_\epsilon(t)=\sum_{k=1}^{\infty}V_k\left(1-\frac{z_k(t)}{z_k(\infty)}\right)^{2} \tag{44}$$
而在 $\epsilon\to0^+$ 下,"未学习分数" $f_{k,\epsilon}(\tau)=1-z_k/z_k(\infty)$ 逐点收敛到指示函数 $\mathbb{I}(\tau<\tau^*_k)$,$\tau^*_k=1/(a\zeta_k)$。于是超额损失退化为一个尾和 $E(\tau)=\sum_{k\ge K(\tau)}c_wk^{-\alpha_1}$,阈值 $k^*(\tau)=(ac_\zeta\tau)^{1/\alpha_2}$;用 Riemann 积分上下夹逼即得 (43)。幂律指数就这样从两个谱指数的比值中读出来了。
6.2 样本式下降(Sample-wise Descent)¶
在 Theorem 5 的条件下,设 $\zeta_\mu:=\frac8m\lambda_{\mu,\max}y_\mu>0$ 为第 $\mu$ 个样本的有效增长率。当 $\epsilon\to0$,经验 MSE 收敛到一条 saddle-to-saddle 轨迹:
$$\lim_{\epsilon\to0^+}L\!\left(\tau\ln\frac1\epsilon\right)=\frac1m\sum_{\mu=1}^{m}y_\mu^{2}\cdot\mathbb{I}(\tau<\tau^{*}_{\mu}),\qquad \tau^{*}_{\mu}:=\frac{1}{\zeta_\mu} \tag{45}$$
即损失走过 $m$ 个连续的平台。若 $\zeta_\mu$ 与 $y_\mu$ 呈幂律衰减
$$\zeta_\mu=c_\zeta\mu^{-\gamma_2},\qquad y_\mu=c_y\mu^{-\gamma_1}\qquad(\gamma_1>1/2,\ \gamma_2>0) \tag{46}$$
则在无限样本极限 $m\to\infty$ 与 $\epsilon\to0$ 下
$$L(\tau)=\Theta\!\left(\tau^{-\frac{2\gamma_1-1}{\gamma_2}}\right) \tag{47}$$
Theorem 10 的证明用了一个漂亮的技巧:把主导本征子空间的和 $Z(t):=\sum_{k\in\mathcal{K}_\mu}\lambda_{\mu,\max}z_k(t)$ 单独拎出来,证明它满足一个被扰动的 logistic 方程
$$\dot Z(t)=\zeta_\mu Z(t)\left(1-\frac{Z(t)+R(Z,\epsilon)}{y_\mu}\right) \tag{48}$$
其中残余项一致有界 $\kappa(\epsilon)=O(\epsilon^{\min(\delta,1)})\to0$($\delta:=\min_{\lambda_{\mu,k}>0}(1-\gamma_k)>0$,$\gamma_k=\lambda_{\mu,k}/\lambda_{\mu,\max}\in(0,1)$)。用两条 logistic 方程上下夹逼 $Z(t)$,再作时间重标定 $t=\tau\ln(1/\epsilon)$,两个界都收敛到同一个阶跃函数,从而挤出 (45)。
Theorem 4 的动力学在数学上等价于 Theorem 5 限制到 $m=1$,因此只有一个平台。
7. 附录中的扩展理论¶
7.1 去掉 ZGZ 条件(Theorem 12/13)¶
只假设置换对称性(不要 ZGZ)时,
$$f_x(W)=f_x(0)+\sum_{i}g(x)^{\top}w_i+\sum_{i}w_i^{\top}A(x)w_i+\sum_{i\neq j}w_i^{\top}B(x)w_j+O(\|W\|^3) \tag{49}$$
$A(x)$ 表示每个神经元的自相互作用,$B(x)$ 表示任意一对不同神经元之间的交叉相互作用。推导极其干净:置换对称性要求原点处一阶导对所有神经元相同($\nabla_{w_i}f_x(0)=g(x)$),Hessian 只能有两类块——对角块 $H_{ii}=2A(x)$ 全部相同、非对角块 $H_{ij}=2B(x)$ 全部相同。
Theorem 13 把展开推到任意 $K$ 阶:
$$f_x(W)=f_x(0)+\sum_{k=1}^{K}\sum_{\lambda\vdash k}\sum_{\substack{i_1,\dots,i_m\\ \text{distinct}}}T_\lambda(x)\left[w_{i_1}^{\otimes c_1},\dots,w_{i_m}^{\otimes c_m}\right]+O(\|W\|^{K+1}) \tag{50}$$
其中 $\lambda=\{c_1,\dots,c_m\}$ 是 $k$ 的整数分拆。这为"neural cubic form / quartic form"提供了形式框架。
7.2 多维输出(Corollary 1)¶
$F_x:\mathbb{R}^{p\times d}\to\mathbb{R}^{k}$ 时,$F_x(W)=F_x(0)+\sum_iA(x)[w_i,w_i]+O(\|W\|^3)$,$A(x)\in\mathbb{R}^{k\times p\times p}$ 是三阶张量,其第 $m$ 个切片为对称矩阵 $A^{(m)}(x)$。本质上不改变任何结论。
7.3 其他优化方法(Corollary 2)¶
任何更新规则形如 $\Delta W_t=\sum_k\alpha_k\nabla_WL_k+\beta_kW_k$($\alpha_k,\beta_k$ 是历史充分统计量 $\{M_\tau,\mu_\tau\}_{\tau\le t}$ 的任意标量函数)的学习算法,其 NQF 动力学都完全由 $\{M_\tau,\mu_\tau\}_{\tau\le t}$ 决定。归纳法证明 $W_t=P_tW_0+Q_t\mathbf{1}^{\top}$,进而 $\mu_t=P_t\mu_0+d\cdot Q_t$、$M_t=P_tM_0P_t^{\top}+P_t\mu_0Q_t^{\top}+Q_t\mu_0^{\top}P_t^{\top}+d\cdot Q_tQ_t^{\top}$。这覆盖 GD、weight decay、Polyak 动量,但不覆盖 Adam(Adam 的逐坐标自适应不属于这个"线性张成"类)。
7.4 多层 NQF(Theorem 14/15)¶
定义 $L$ 层深 NQF:$h^{(0)}(x)=x$,$h^{(l)}_k(x)=C^{(l)}_k+(g^{(l)}_k)^{\top}\mu^{(l)}+(\mu^{(l)})^{\top}B^{(l)}_k\mu^{(l)}+\mathrm{Tr}[M^{(l)}A^{(l)}_k]$,其中结构分量只依赖前一层输出 $h^{(l-1)}(x)$。Theorem 14 证明逐层的 $(\mu^{(l)},M^{(l)})$ 仍然构成闭系统,更新式与 (20)(21) 同构,只是 $v^{(l)},H^{(l)}$ 换成对 $\partial L/\partial h^{(l)}_k$ 加权求和。Theorem 15 把压缩性推广到多层,每层压到 $d'_l=k_l+1$。
7.5 压缩误差(Corollary 3)¶
对任意原始宽度 $d$ 的 NQF 与任意目标宽度 $d'\le p$,假设 SGD 更新局部 Lipschitz(常数 $L$),存在 $d'$ 神经元的压缩 NQF 使得
$$\left\|\frac{d'}{d}\tilde M_t-M_t\right\|_F+\left\|\tilde\mu_t-\mu_t\right\|_2\le\left(\sqrt{\sum_{k=d'}^{p}\lambda_k^{2}}\right)\exp(\eta Lt) \tag{51}$$
$\lambda_1\ge\cdots\ge\lambda_p\ge0$ 是初始协方差 $C:=\frac{d}{d'}\left(M(0)-\frac1d\mu(0)\mu(0)^{\top}\right)$ 的本征值。误差由被截断的谱尾控制——谱衰减快则压缩几乎无损。
7.6 NTK 与特征学习(Proposition 8/9)¶
经验 NTK $\Theta(x,x'):=\langle\nabla_Wf_x,\nabla_Wf_{x'}\rangle$ 同样只由 $\mu,M$ 决定:
$$\Theta(x,x')=d\cdot u(x)^{\top}u(x')+2u(x)^{\top}A(x')\mu+2\mu^{\top}A(x)u(x')+4\mathrm{Tr}\left(A(x)A(x')M\right) \tag{52}$$
其中 $u(x):=g(x)+2B(x)\mu$。这说明轨迹上任意一点的经验 NTK 都可以在不知道 $W$ 的情况下求值。
设 NQF 系数随宽度 $d$ 标度为 $g(x)=\Theta(d^{-\alpha_g})$、$A(x)=\Theta(d^{-\alpha_A})$、$B(x)=\Theta(d^{-\alpha_B})$,取 $\alpha_g=1/2$ 使初始 NTK 为 $\Theta(1)$。则 $\dot\Theta=O(d^{1-\alpha_B}+d^{-\alpha_A})$,于是(Proposition 9):
- 惰性训练(Lazy / 常数 NTK):若 $\alpha_A>0$ 且 $\alpha_B>1$,则 $\lim_{d\to\infty}\dot\Theta=0$。NTK 保持不变而损失下降 $O(1)$,NQF 有效地表现为线性模型。
- 特征学习(演化 NTK):若 $\alpha_A=0$ 或 $\frac12\le\alpha_B\le1$,则 $\dot\Theta=O(1)$,NTK 与损失在同一时间尺度上变化,模型学到数据依赖的表征。
这把 lazy 与 feature-learning 两个区制放进了同一个框架,由标度指数区分。
7.7 统一的一般精确解(Theorem 16)¶
定义经验协方差算子 $K(X):=\frac4m\sum_\mu\langle A(x_\mu),X\rangle_FA(x_\mu)$ 与 $Y:=\frac4m\sum_\mu y_\mu A(x_\mu)$。若存在两两正交的对称投影算子 $\{\Pi_a\}_{a=1}^{r}$ 与常数 $\gamma_a\in\mathbb{R}$、$\kappa_a\ge0$,使 $\Pi_a\Pi_b=\delta_{ab}\Pi_a$ 且
$$Y\Pi_a+\Pi_aY=2\gamma_a\Pi_a,\qquad K(\Pi_b)\Pi_a+\Pi_aK(\Pi_b)=2\kappa_a\delta_{ab}\Pi_a \tag{53}$$
且 $M(0)=\sum_az_a(0)\Pi_a$($z_a(0)\ge0$),则 $M(t)=\sum_az_a(t)\Pi_a$,且
$$z_a(t)=\frac{\gamma_az_a(0)}{\kappa_az_a(0)+\left(\gamma_a-\kappa_az_a(0)\right)e^{-2\gamma_at}}\quad(\gamma_a\ne0),\qquad z_a(t)=\frac{z_a(0)}{1+2\kappa_az_a(0)t}\quad(\gamma_a=0) \tag{54}$$
底层的 $M$ 方程是 $\dot M=YM+MY-K(M)M-MK(M)$。该定理同时包含 Theorem 6、Theorem 7 的可同时对角化情形,以及 Saxe 等人深度线性网络的精确解——学习动力学归约为一组独立的 logistic 方程。
8. 实验设置与主要结果¶
所有实验细节见 Appendix C,复现每张图的代码已开源。
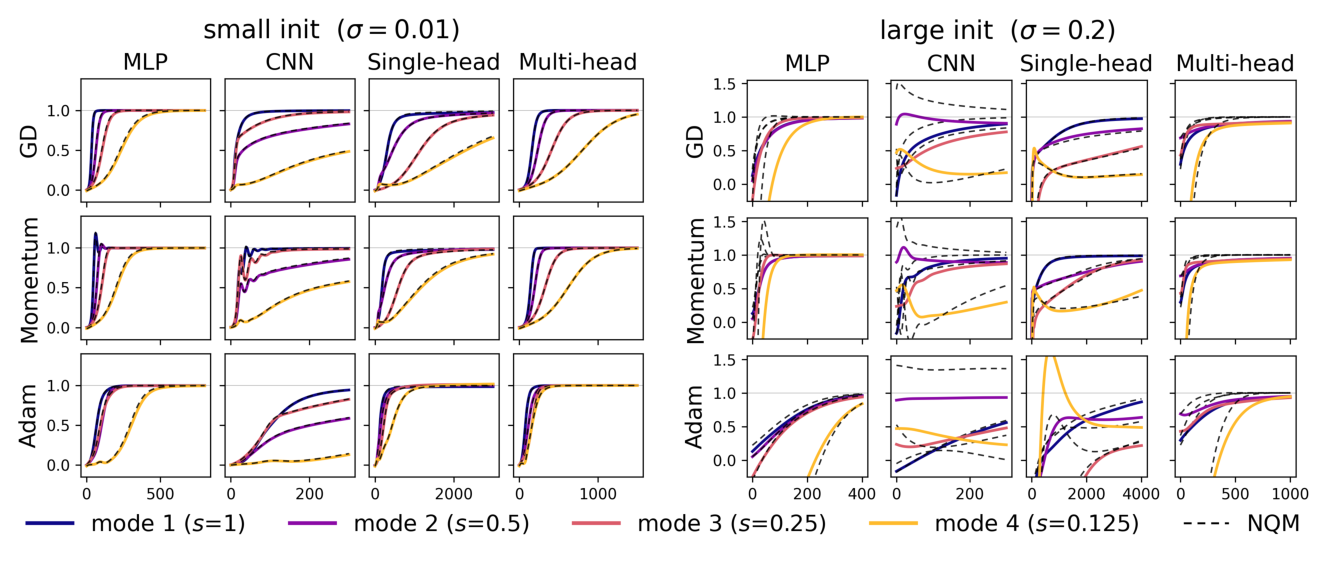
8.1 NQF 近似的有效性(Figure 2)¶
设置:训练两层 MLP(Prop 1)、单层 CNN(Prop 6)、仅 QK 注意力 head(Prop 3)与多头注意力(Prop 2),配三种优化器:梯度下降、Polyak 动量($\beta=0.9$)、Adam。所有模型输出维 8,MSE 损失,高斯初始化尺度 $\sigma$,全批量学习,600 个样本。教师是一个低秩 NQF,奇异值 $s=(1,\tfrac12,\tfrac14,\tfrac18)$。曲线画的是恢复出的第 $k$ 个奇异值 $\hat s_k(t)/s_k$ 随训练步的变化。
| 模块 | 结构细节 |
|---|---|
| 两层 MLP | 输入 20,隐藏 64,tanh,无 bias |
| 单层 CNN | 单通道 $5\times7$ 输入,64 个 $4\times5$ 卷积核,stride 1,无 padding,全局 sum-pooling |
| 单头 / 多头注意力 | 输入 20,隐藏 8,序列长 16;多头为 4 头,$d_v=20$ |
结果:在小初始化($\sigma=0.01$)下,NQF 几乎精确追踪原模型,跨所有架构与所有优化器都成立——包括理论上未覆盖的 Adam。在大初始化($\sigma=0.2$)下,NQF 明显偏离原模型。
结论分析:这正是理论对自身适用范围的预测。NQF 是绕原点的局部展开的领头非常数项,只在初始化尺度相对于数据设定的特征长度尺度足够小时准确。大初始化下失败不是反例,而是理论自洽性的验证。Adam 被准确追踪则是一个理论未解释的经验事实(Corollary 2 的线性张成类不含 Adam),作者把它列为开放问题。
8.2 特征式 saddle-to-saddle 动力学(Figure 3)¶
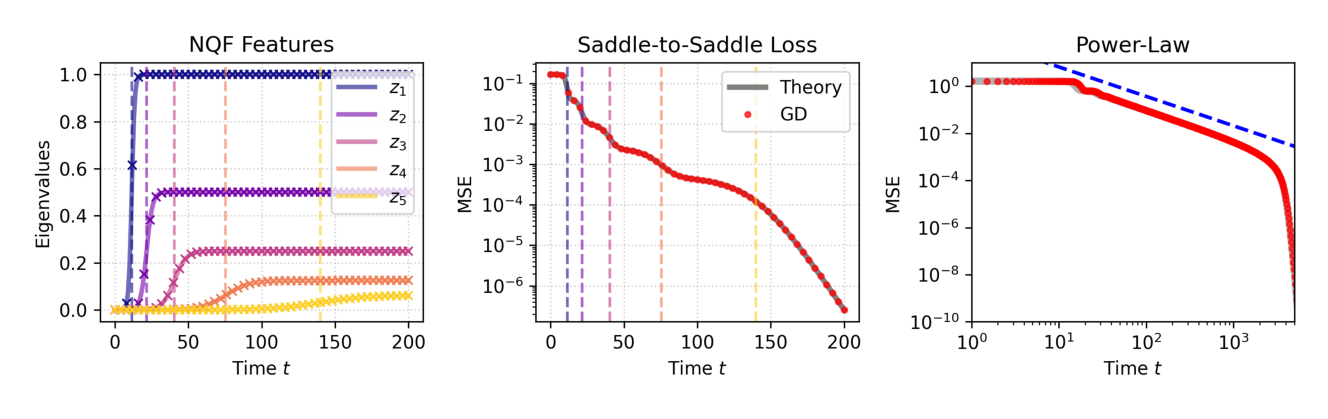
设置(左/中panel):取 $\{A(x_\mu)\}_{\mu=1}^{m}$ 为满足 Theorem 6 条件的对角矩阵,$m=5$,$r=\{1.0,0.5,0.25,0.125,0.0625\}$,$C_{kk}=1$,初始化尺度 $\epsilon=10^{-5}$,全批量 GD 学习率 0.01(逼近梯度流),初始化 $W(0)=\sqrt\epsilon I$ 使 $z_k(0)=\epsilon$。为满足 Theorem 6 的条件,随机生成一个 $m\times m$ 正交矩阵,用其第 $\mu$ 列作为 $A_\mu$ 的对角元。
结果:数值轨迹与 Theorem 6 的预测吻合;超额 MSE 损失在预测的特征时间 $t^{*}_{k}=\frac{1}{r_k}\ln\!\left(\frac{r_k}{C_{kk}\epsilon}\right)$ 处呈现顺序平台,每一次损失骤降都对齐一条 $t^*_k$ 竖虚线。
设置(右 panel):$m=1000$,每个 $A_\mu$ 只有一个非零元。先设 $r_k=k^{-\alpha_2}$、$V_k=k^{-\alpha_1}$($k=1,\dots,1000$,$\alpha_1=2$,$\alpha_2=0.8$),据此算 $C_{kk}=r_k^2/(8V_k)$,取 $A_{k,kk}=\sqrt{C_{kk}m/8}$,标签 $y_k=mr_k/(8A_{k,kk})$,初始化 $z_k(0)=10^{-6}k^{-1.2}$。
结果:GD 得到的损失曲线斜率与 §6 预测的 $-(\alpha_1-1)/\alpha_2=-1/0.8=-1.25$ 吻合,直到有限尺寸截断处。
结论分析:这张图是全文的靶心——它同时演示了"平台期是逐个模式点火的产物"和"当模式谱是幂律时,平台密到无法分辨就融合成幂律"。两个现象出自同一条方程,这正是论文的核心主张。
8.3 样本式 saddle-to-saddle 动力学(Figure 4)¶
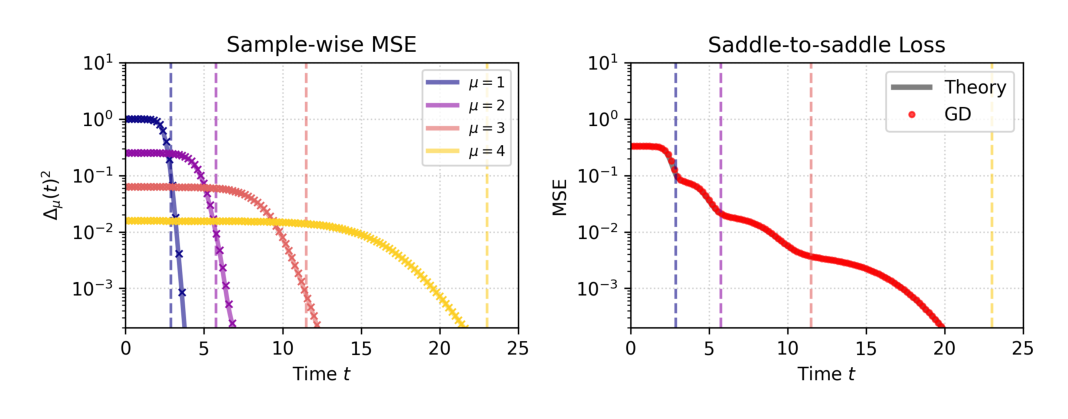
设置:构造 $m=4$ 个相互正交的数据矩阵——块对角、非零支撑互不相交:对给定样本 $\mu$,只有索引块 $[\mu K,\mu K+K-1]$ 内的对角元非零($K=3$,三个非零元为 $1,1.5,2$),保证 $A(x_\mu)A(x_\nu)=0\ \forall\mu\ne\nu$。此时 (33) 不可约、无闭式解,理论曲线由 Runge-Kutta 数值积分 $\{\xi_\mu(t)\}$ 得到。学生模型从小初始化用全批量 GD 训练。
结果:左图显示每个样本的 MSE $\Delta_\mu(t)^2$ 各自停滞在初始平台上,然后在 $t^{*}_{\mu}=\zeta_\mu^{-1}\ln(1/\epsilon)$ 附近突然陡降到零,彼此独立且顺序发生;右图显示总 MSE 因此走过 $m$ 个连续平台,每一次离散下降都对应一个 $t^*_\mu$。
结论分析:这验证了 §6.2 与 Theorem 10——"突变"不只发生在特征维度,也发生在样本维度:难度不同的样本被逐个学会。这为"emergence 是难度谱的产物"提供了一个完全可解的最小实例。
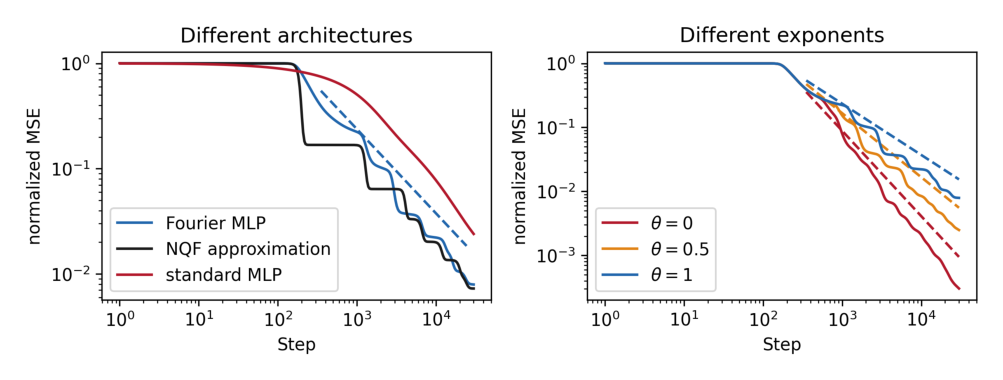
8.4 MLP 上的幂律(Figure 5)¶
设置:Fourier MLP
$$f(x)=\frac{1}{\sqrt P}\sum_{k=1}^{P}W_k\tanh\!\left(s_ka_k\psi_k(x)\right) \tag{55}$$
可训练参数 $w_k=[a_k,W_k]^{\top}$,$\psi_k(x)=\sqrt2\cos(2\pi kx)$ 是在均匀一维网格 $x_\mu\in\{0,1/M,\dots,(M-1)/M\}$ 上采样的正交 Fourier 特征。为诱导 §6 所需的幂律结构,取 $s_k=k^{-\theta}$,目标函数 $y(x)=\sum_kb_k\psi_k(x)$,$b_k=k^{-\beta}$。超参:$\beta=1.5$,$P=64$,$M=256$(即 256 个数据点),全批量 GD 学习率 0.02,30000 步,标准 MLP 对照有 256 个隐藏单元,所有模型初始化 $\mathcal{N}(0,\epsilon^2)$,$\epsilon=10^{-4}$。
Appendix C 验证了该 Fourier MLP 的 NQF 满足 §6(特征式下降)的条件:第 $k$ 个隐藏单元对应 $A_k(x)=\frac{s_k}{2\sqrt P}\begin{bmatrix}0&\psi_k(x)\\ \psi_k(x)&0\end{bmatrix}$,$A$ 块对角故 Assumption 1 成立;Fourier 模式正交故 $\sum_\mu\lambda_{\mu,k}\lambda_{\mu,j}=0\ (k\ne j)$ 成立。映射到 §6 的变量:
$$C_{kk}\propto s_k^2=k^{-2\theta},\qquad r_k\propto s_kb_k=k^{-(\theta+\beta)}\ \Rightarrow\ \alpha_2=\theta+\beta,\quad V_k=\frac{r_k^2}{8C_{kk}}\propto k^{-2\beta}\ \Rightarrow\ \alpha_1=2\beta \tag{56}$$
$$E(t)=\Theta\!\left(t^{-\frac{\alpha_1-1}{\alpha_2}}\right)=\Theta\!\left(t^{-\frac{2\beta-1}{\theta+\beta}}\right) \tag{57}$$
对照组:(1) 它的 NQF 近似(Prop 1);(2) 在原始输入 $x$ 上训练的标准 tanh MLP。
结果:左图($\theta=1$)显示 Fourier MLP 按预测的 $t^{-(2\beta-1)/(\theta+\beta)}$($\beta=1.5,\theta=1$ 时即 $t^{-0.8}$)下降,且被其 NQF 近似(黑线)紧密追踪;而在原始输入上训练的标准 MLP(红线)不呈现幂律。右图显示 Fourier MLP 的幂律指数在 $\theta\in\{0,0.5,1\}$ 三种设置下都与理论虚线吻合。
结论分析:两点值得强调。第一,对照组(标准 MLP 无幂律)证明幂律并非训练本身的产物,而是 §6 所要求的谱结构的产物——这是一个诚实且必要的负对照。第二,经验幂律相对理论有轻微的系统性变陡,作者归因于有限初始化效应并给出定量解释:定义有效斜率
$$k_{\mathrm{eff}}(k,\epsilon)=\frac{\alpha_1-1}{\alpha_2-\dfrac{\alpha_1-\alpha_2}{\ln\!\left(\frac{\zeta_k}{C_k\epsilon}\right)}} \tag{58}$$
由于实验中 $\alpha_2<\alpha_1$,有限 $\epsilon>0$ 时有效斜率大于理论预测,且 $k_{\mathrm{eff}}$ 随 $t$ 增大而增大——与 Figure 3(右) 和 Figure 5 观察到的现象一致,且 $\epsilon\to0$ 时消失。
8.5 附录中的补充实验(Figures 6-8)¶
Figure 6(teacher-student 下的 NQF 近似):左侧训练无 bias 的两层 tanh MLP(教师权重标准高斯;师生输入维 20、隐藏维 100、输出维 1),学生分别是同结构 MLP 与其 NQF 近似,在线 SGD 学习率 0.05、批量 64、2000 步,5 次独立运行取平均(阴影为 $\pm1$ 标准差)。右侧对仅 QK 注意力模型($D=16$,$N=10$,$d_k=8$,$H=4$ 头,SGD 学习率 0.02,批量 64,2000 步)做同样对比。学生初始化 $\mathcal{N}(0,\epsilon^2)$,$\epsilon=10^{-3}$。
结果与分析:两条轨迹在前 100 步精确重合,之后分离。这量化了 NQF 作为局部展开的有效时窗——一旦权重长大到离原点足够远,三阶项开始起作用。这是一个诚实的负面结果披露。
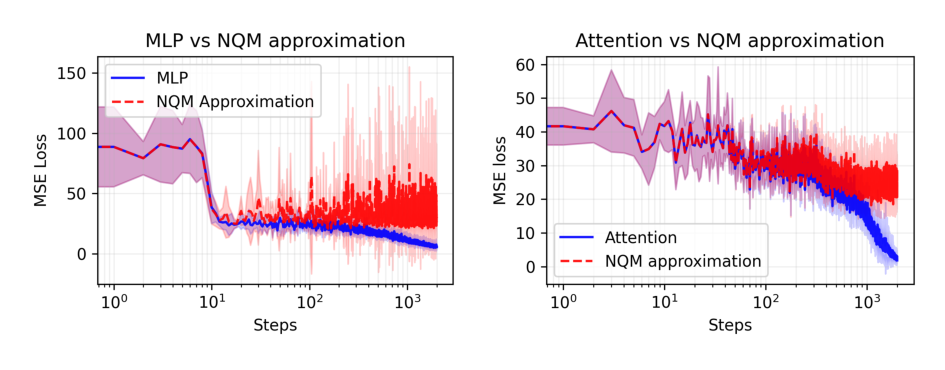
Figure 7(真实数据集:MNIST):构造两层 MLP(隐藏 20,tanh,无 bias)、单层 CNN(50 通道,$15\times15$ 卷积核)、单层自注意力(固定读出向量,10 头,$d_k=32$;把 $28\times28$ 图像视作 28 个 28 维 token)及其 NQF 对应物,NQF 与原模型用相同的小高斯初始化($\epsilon=0.01$)。任务是 MNIST 奇偶二分类,4000 个样本,Adam 全批量、MSE 损失、学习率 0.001。
结果与分析:三种架构下原模型与 NQF 在训练损失和测试精度上都给出难以区分的轨迹。这是全文唯一涉及真实数据的实验,说明 NQF 近似不只在合成教师上成立。但需要指出,MNIST 奇偶分类是一个极简单的任务,这一验证的说服力有限。
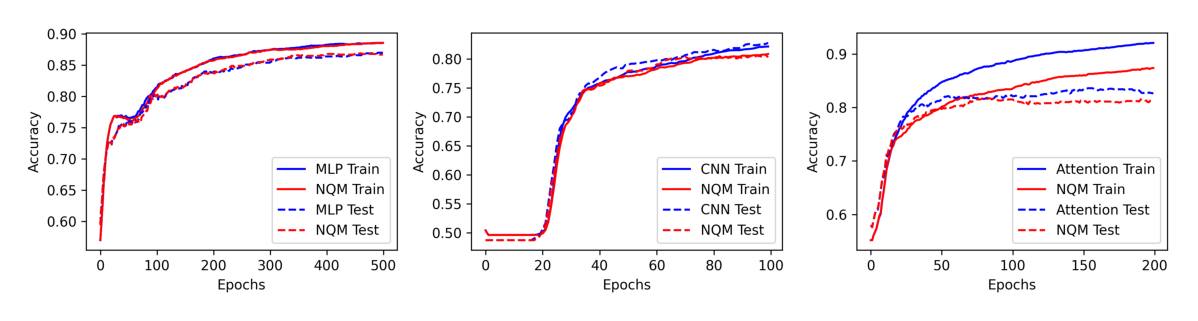
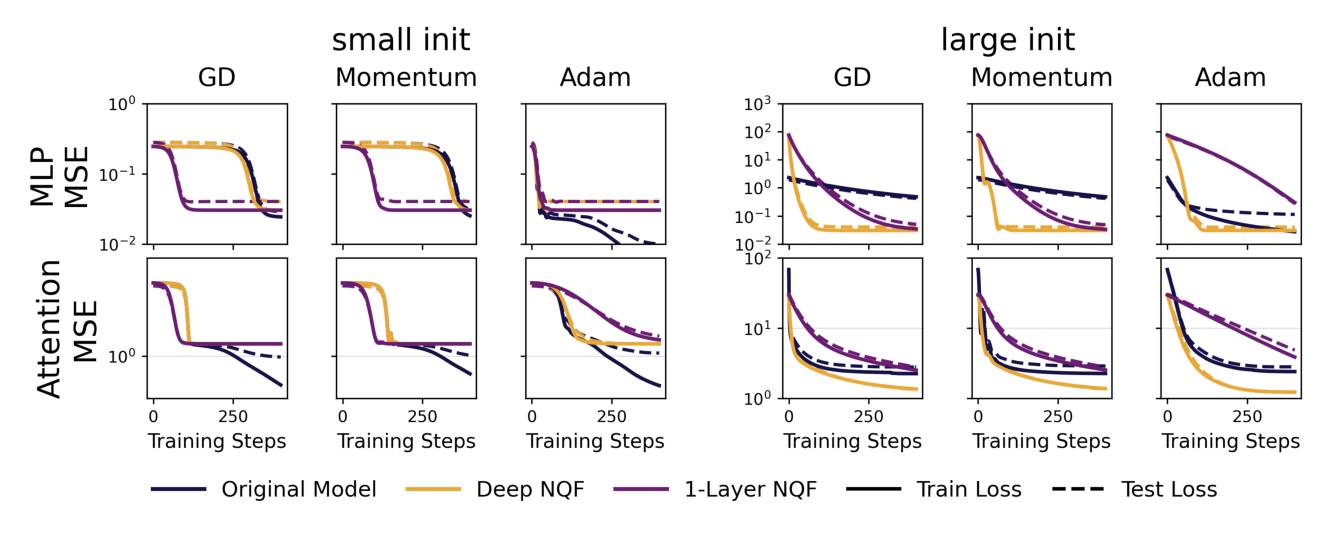
Figure 8(深层 NQF):teacher-student 回归。两种架构:4 层 MLP(输入 8,隐藏 16,输出 1;小初始化权重方差 0.05,大初始化 0.5)与 2 层单头注意力(输入/隐藏维 8,序列长 10,输出 1;小初始化方差 0.1,大初始化 1)。训练集 200 样本,测试集 1000 样本。同一初始化尺度与模型下,原模型、2 层 NQF、1 层 NQF 共享相同初始化与学习率。
结果与分析:小初始化下,两种模型的训练动力学都被 2 层 NQF 很好地近似,而不能被 1 层 NQF 近似。这验证了 Appendix B.4 的深层 NQF 理论——深度不能被压缩掉,一个 $L$ 层网络需要一个 $L$ 层(或至少 2 层)NQF 来匹配,序参量的层级结构是必要的。
9. 核心贡献总结¶
- 正规形(Theorem 1):仅从"层内重复组件可交换"这一条结构假设出发,配合光滑性与 ZGZ,推出所有此类模块绕近零初始化的领头非常数项唯一地是 $\mathrm{Tr}[WW^{\top}A(x)]$。架构差异被完全压缩进一个结构矩阵 $A(x)$ 的稀疏模式与耦合强度中。
- 架构字典(Prop 1-6 + Table 3):为 MLP、CNN、MHA、仅 QK 注意力、单头注意力、MoE 显式算出 $A(x)$;证明 17 个此前被独立研究的可解代理模型(矩阵感知/分解、矩阵补全、词嵌入、二次网络、相位恢复、对角线性网络、双线性序列回归、线性 SSL 等)都是同一模型在不同 $A$ 下的实例。实用推论:$A(x)$ 可在某个待选层被真正训练之前就求值。
- 注意力的结构性发现:到二阶为止,多头注意力只有 value 与读出块进入 $A(X)$,自注意力表现为平均算子,query 与 key 矩阵要到四阶才出现。
- 动力学闭合(Theorem 2)+ 可压缩性(Theorem 3):无论多少可训练参数,SGD 轨迹都闭合在 $(M,\mu)$ 上;宽度 $d$ 的模块存在宽度 $k_V+1$ 的等价压缩版本,逐步复现其在训练数据上的预测。这为训练动力学的低维性与"动力学彩票假设"提供了机制解释。
- 精确可解(Theorem 4-7 + 16):在共同本征基下动力学化为广义 Lotka-Volterra 方程,$z_k$ 是"物种丰度",$C_{kj}$ 是竞争/协作系数;四个区制下给出闭式或隐式积分解,且被 Theorem 16 统一为一组独立 logistic 方程。
- 突变与幂律的统一(Theorem 8-11):特征点火时间 $t^*_k\sim\frac{1}{a\zeta_k}\ln\frac1\epsilon$,间隔随 $\epsilon\to0$ 发散,给出 saddle-to-saddle;当 $\zeta_k\propto k^{-\alpha_2}$、$V_k\propto k^{-\alpha_1}$ 时,同一动力学叠加出 $E(\tau)=\Theta(\tau^{-(\alpha_1-1)/\alpha_2})$——幂律指数由两个谱指数的比值给出。样本维度有平行结论 $L(\tau)=\Theta(\tau^{-(2\gamma_1-1)/\gamma_2})$。
- lazy 与 feature learning 的统一(Prop 8/9):经验 NTK 也只由 $(\mu,M)$ 决定,两个区制由系数的宽度标度指数 $(\alpha_A,\alpha_B)$ 区分。
读作 Landau 构造的字典,作者在 Discussion 里作了一个特别值得记下的澄清,因为其中两条与初读的直觉相反:
- 对称群是 $S_d$;展开截断在对称性允许的最低非常数阶;架构只通过耦合 $A(x)$ 进入——就像微观细节只通过唯象系数进入 Landau 泛函。这部分是标准构造,也是"跨架构普适性是预期结果"的原因。
- 序参量 $M=WW^{\top}$ 是反直觉的第一条:它按构造是 $S_d$-不变的,且在更大的冗余 $W\mapsto WO,\ O\in O(d)$ 下也不变(二次型看不见这个自由度),因此它不像教科书 Landau 序参量那样按对称群的非平凡表示变换。它与自旋玻璃理论的 Edwards-Anderson 交叠、与 committee machine 在线学习的交叠 $w_i^{\top}w_j$ 共享的性质是:它是一个不变量,却在一个相中为零、另一个相中不为零——$z_k=0$ 是未学习态,$z_k>0$ 是已学习态。点火时破缺的对称性是 $W$ 自身的自由度,已被 $M$ 上的流商掉,而 $M$ 是登记这一破缺的不变量。
- 控制参数 $\epsilon$ 是反直觉的第二条:初始化尺度 $\epsilon$ 不是展开的小参数所对应的控制参数。$\epsilon$ 不决定一个特征是否被学会——只要 $r_k>0$,任何 $\epsilon>0$ 下它都会被学会;真正调控转变的是 $r_k$(或加了 weight decay 后的 $r_k-\gamma$),其符号决定 $z_k=0$ 的稳定性,方式与约化温度决定无序态的稳定性相同。$\epsilon$ 控制的是crossover 的尖锐程度,其自然对应物是系统尺寸:相继点火之间的间隔按 $\ln(1/\epsilon)$ 增长而转变本身的宽度不变,所以 $\ln(1/\epsilon)$ 扮演 $N$ 的角色,$\epsilon\to0$ 是热力学极限的类比。突变学习就是 $M$ 的个别模式的点火,$\epsilon\to0$ 是一个真正的奇异极限,光滑的流在其中获得尖锐转变——尖锐的原因与相变只在无限系统中尖锐的原因相同。
10. 讨论与局限性¶
10.1 作者自陈的局限¶
论文在 Discussion 中坦率列出五条:
- 小初始化。NQF 是局部展开的领头非常数项,只在初始化尺度相对于数据设定的特征长度尺度足够小时准确。Figure 2 展示了大初始化下近似的失效——这正是理论对自身的预测。Appendix B.6 通过在同一框架内处理 lazy 与 feature-learning 区制部分放松了这一限制。
- 光滑性。Theorem 1 假设三次可微。整流激活(ReLU)在原点、bias 项、归一化层,以及在聚合组件之后才施加非线性的模块,各自违反其中一条,需要额外处理。这是相当重的一条——现代网络里 ReLU 族与 LayerNorm 几乎无处不在。
- 其他平台期。实验中出现了 NQF 无法解释的平台期,作者归因于三阶及更高阶项。推广到 neural cubic / quartic form(Appendix B.1 的 Theorem 13 已给出形式框架)是自然的下一步,多层 NQF 的系统处理(Appendix B.4 已开头)亦然。
- 幂律谱是假设,不是预言。这是最要害的一条,作者自己也这么定位。从架构推出 $A(x)$ 固定了那个"其谱控制标度指数"的算子,但并不预言该谱有幂律尾巴。那条尾巴是 §6 标度定理的一个假设,而 Fourier 特征实验是刻意构造出来的。它对真实数据与真实架构是否一般地出现,是必须留给后续工作解决的问题。
- 自适应优化器。Appendix B.3 的线性更新推论覆盖 GD、weight decay 与 Polyak 动量,但不覆盖 Adam——尽管实验中 NQF 对 Adam 的追踪依然准确(Figure 2)。理论与经验之间存在一个未闭合的缺口。
10.2 我的补充评估¶
值得借鉴的设计:
- 从对称性而非从架构出发。这条路线的方法论价值超出本文结论本身:先问"什么变换保持函数不变",再问"对称性允许的最低阶项是什么",可以在不做任何架构特定推导的情况下得到普适结构。对做架构搜索/架构演进的工作,这提供了一个"先算 $A(x)$ 再训练"的廉价筛选原语——论文明确点出这一实用推论。
- 把"跟踪训练需要多少个数"作为第一性问题。Theorem 2/3 的答案(不随模型增长;$k_V+1$ 就够)为一大批经验现象(梯度在小子空间、intrinsic dimension、LoRA 有效、彩票假设)提供了同一个机制解释。
- 诚实的负对照。Figure 5 里"标准 MLP 在原始输入上不呈现幂律"这个对照,以及 Figure 6 里"前 100 步吻合、之后分离"的披露,都在主动划定理论边界,而不是只展示成功案例。
局限与争议(超出作者自陈的部分):
- 实验规模与理论野心不匹配。论文的叙事覆盖 MLP / CNN / MoE / Transformer 与 LLM scaling law 的动机,但唯一的真实数据实验是 MNIST 奇偶分类(4000 样本,隐藏维 20 的 MLP)。Figure 2/3/4/5 全部是合成数据。这不构成对结论的证伪,但意味着"NQF 是 LLM 训练的有用近似"这一暗示尚未被本文验证——作者引用了他人"二次模型对 LLM 保持定量准确"的工作,但那是引用不是自证。
- 限制 (2) 的严重性可能被低估。ReLU 在原点不可微、LayerNorm 在聚合后施加非线性——这两条几乎排除了所有现代生产网络。论文用 tanh 作激活并去掉 bias 与归一化,得到的是一个"理论上干净但工程上不存在"的模型类。把这条限制放松到 ReLU + 归一化,工作量可能不亚于本文本身。
- 限制 (4) 使 scaling law 部分的地位微妙。本文的幂律结果严格说是一个条件命题:若谱是幂律,则损失曲线是幂律且指数为 $(\alpha_1-1)/\alpha_2$。而"谱为何是幂律"恰恰是 Bahri 等人理论中由数据流形维数回答的部分。因此本文并未替代已有 scaling law 理论,而是补上了"从特征学习动力学内部(而非冻结的 kernel)产生同一条谱→曲线映射"的这一环,并额外证明同一动力学也产生突变。这个定位是准确且有价值的,但比标题给人的印象要窄。
- 序参量的"非标准性"值得警惕。作者自己指出 $M$ 不按对称群的非平凡表示变换,这意味着 Landau 类比在关键一步上是不严格的——它更接近自旋玻璃的交叠序参量而非铁磁的磁化强度。论文用"它在一相为零、另一相非零"来救场,是合理的,但读者不应把"Landau 构造"当作已经完成的严格映射。
- 与推荐系统的关联是间接的。Table 3 里"矩阵补全 / 推荐系统单条目"$\hat R_{ij}=u_i^{\top}v_j$ 确实是 NQF 的一个实例($A_{ij}=\frac12[[0,e_ie_j^{\top}],[e_je_i^{\top},0]]$),这意味着经典 MF 推荐的训练动力学落在本文框架内。但论文本身对推荐场景没有任何实验或讨论。
对推荐系统方向的潜在启示(我的外推,非论文主张):
- 初始化尺度是一个被长期忽略的调参轴。理论说 $\epsilon$ 控制的是特征点火的间隔($\propto\ln(1/\epsilon)$)而非是否点火。对训练预算受限、常常在损失还没走完平台期就停机的工业排序模型,这意味着较大的初始化可能不是"训练更快"而是"把本该分离的模式挤在一起同时学",其表征质量后果与小初始化不同。
- "扩参收益曲线"可能主要由数据谱而非模型容量决定。$(\alpha_1,\alpha_2)$ 是数据侧的量(特征-标签相关度谱与输入方差谱),$p\to\infty$ 只是让求和取到无穷。这与工业界反复观察到的"扩参在某个点后收益骤减"是相容的:若行为数据的谱尾比幂律衰减更快,超额损失曲线就不会有长幂律段。
- Theorem 3 给了"多宽才够"的一个上界:$k_V+1$,由数据张成的联合子空间维数决定,而非由参数量决定。对 embedding 维度、head 数这类宽度超参,这提示存在一个由数据秩设定的饱和点。
- MoE 的结构矩阵 (13) 说明领头阶只有"路由权重 × 专家零点梯度"的交叉块起作用,专家内部的深层结构在二阶不可见。这与工业界观察到的"MoE 早期训练由路由主导"是定性一致的。
11. 相关工作定位¶
二次与因子化模型类。二次参数化长期作为非凸学习的可解代理:低秩矩阵分解、相位恢复、对角线性网络、二次网络等,被用来解释隐式低秩偏置、谱初始化与特征学习;近期工作甚至论证二次模型可以准确近似 LLM。NQF 与这些模型特定分析的区别在于从架构导出二次特征 $A(x)$——矩阵感知、对角网络、MLP、CNN、注意力 head、MoE 分支都成为同一个局部正规形的实例。
学习动力学与特征学习。深度线性网络的精确分析展示了 GD 下模式化平台期之间的快速转变;NTK 与 lazy training 文献描述相反的区制(网络被初始化附近的线性化很好近似、训练被几乎固定的核支配);特征学习工作强调真实网络在训练中改变表征。NQF 位于两者之间:模型仍是小初始化附近的局部展开,但保留的二次项使核与表征通过有限维序参量 $M$ 演化,给出特征增长与竞争的闭合非线性动力学。
突变学习与 scaling law。经验 scaling law 显示损失常随数据/模型/算力呈幂律;多项理论工作通过谱结构解释这类律(高本征值模式更早被学会,幂律本征谱或 task-model alignment 诱导幂律学习曲线);突变学习也在 SGD 分析中被形式化为通过 saddle-to-saddle 转变顺序获取目标结构。NQF 视角连接了这两个观点:个体特征或样本在依赖初始化的时刻经历尖锐的激活事件,而特征对齐、方差或样本难度的幂律分布把这些转变聚合成光滑的 scaling law。
Outlook。作者指出,与物理的对应暗示为相互作用种群、流体力学失稳与聚合物流开发的技术机器可以用于学习动力学;反过来,训练好的网络为这些经典模型提供了一个"仪表异常完备的实验室"——每个模式振幅都直接可观测,耦合矩阵精确已知,控制参数可以在多个数量级上调节。他们认为最值得追问的两个问题是:这个映射能否越过二阶存活;以及特征间竞争的生态图景能否预言泛化(而不只是优化)的性质。