Skaling: Chinchilla's Exponents Meet Kaplan's Coupling
研究动机与背景
现代 LLM 开发建立在一个前提上:性能随规模的提升是可预测的。这个可预测性由 neural scaling law 形式化——用一小批低算力 run 外推高算力 run 的 loss,从而在烧掉几千万美元之前就把预训练预算、模型宽深比、token 配额等决策定下来。Kaplan 等 (2020) 最早把 loss 建模为模型规模 $N$ 与数据量 $D$ 的耦合函数;Hoffmann 等 (2022) 的 Chinchilla 律随后把可降低 loss(reducible loss)改写成两个独立幂律之和:
$$L(N, D) = E + \frac{A}{N^\alpha} + \frac{B}{D^\beta} \tag{1}$$
这个加性形式因数学便利、参数可解释、并直接给出"约 20 tokens/参数"的 compute-optimal 法则,成了领域默认选择。
但本文(FAIR at Meta,Videau / Youbi-Idrissi / Lopez-Paz / Ahuja)指出:Eq. (1) 的加性结构隐含了一条极强的结构性假设——$N$ 与 $D$ 对 loss 的作用完全独立,其数学后果是混合偏导恒等于零:
$$\frac{\partial^2 L}{\partial N \partial D} \equiv 0 \tag{2}$$
无论 $f(N)$、$g(D)$ 取什么幂律,只要形式是 $L = f(N) + g(D) + E$,该恒等式必然成立。换言之,加性律断言"多加一份参数的边际收益,与这些参数将要见到多少数据无关"。
这个假设的代价可以直接从残差图上看出来。作者把 Chinchilla 律与 Skaling 律同时拟合到 Farseer 网格,画出每个 $(N, D)$ 配置的带符号百分比误差:
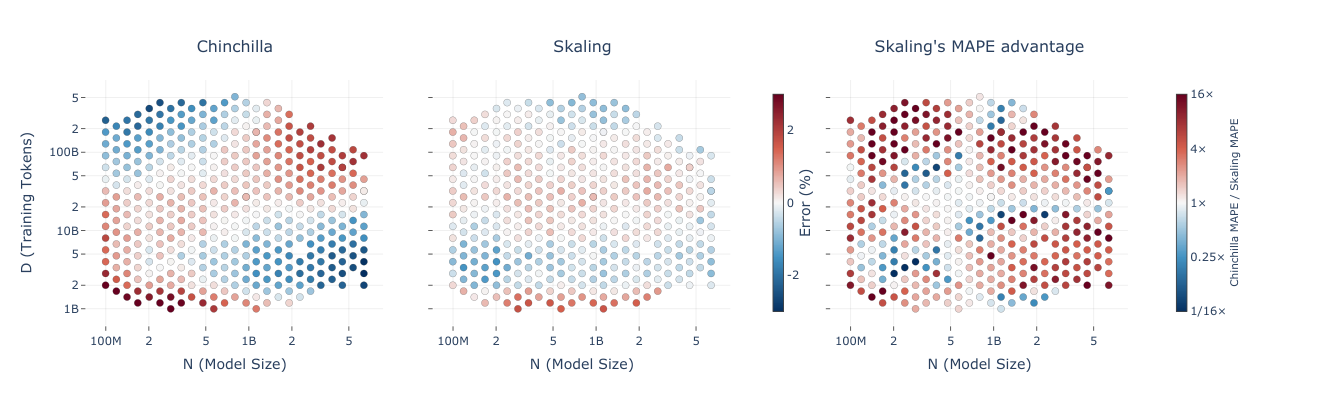
Chinchilla 在网格内部确实很准,但误差朝四角系统性增长,且呈鞍形(saddle-shaped)——一对角落高估(红)、另一对低估(蓝),在 $N$ 与 $D$ 最不平衡处(数据稀缺 / 严重过训)达到数个百分点。这正是"遗漏 $N$–$D$ 交互项"时应出现的残差形状;Skaling 的残差则整网格贴近零。右图给出逐 run 误差比值:Skaling 在 76% 的配置上更准,中位数优势 2.2×,三分之一配置优势 ≥4×,且增益最大处恰是最便宜的边缘——这对后文的稀疏采样策略至关重要。
论文的两条贡献可以概括为:
- C1 — Skaling:一个耦合的标度形式。 在 Chinchilla 形式外面加一个自由外指数,用单个额外参数恢复 Kaplan 式的 $N$–$D$ 耦合,修正加性律的边界偏差。
- C2 — 稀疏 profiling 网格。 由于耦合形式是由网格边界而非内部锚定的,可以只在低算力的两条边上采样("L 形"网格),用约 1/10 的拟合算力达到全网格 Chinchilla 的精度。
先验证据:loss 曲面上 $N$ 与 $D$ 确实在交互
论文没有直接跳到新形式,而是先问数据本身:$N$ 与 $D$ 到底交不交互?做法是对实测 loss 曲面做无参数的数值微分。因为网格是对数等距的,用 Moving Least Squares (MLS) 估计器(见后文"数值微分"一节)先得到 log-slope,再换算回实空间导数:
$$\frac{\partial L}{\partial N} = \frac{L}{N}\,\frac{\partial \ln L}{\partial \ln N}, \qquad \frac{\partial L}{\partial D} = \frac{L}{D}\,\frac{\partial \ln L}{\partial \ln D} \tag{3}$$
取导数的一个副产品是不可降低误差 $E$ 被自动消掉,因此这套诊断只反映 reducible loss 的结构,不受 $E$ 拟合不准的污染——这一点很关键,因为 $E$ 恰恰是全篇最难辨识的参数。
一阶结构:看起来几乎可分
先用一个 log-linear 诊断式概括一阶结构(注意作者反复强调这只是诊断式,不是标度律):
$$\ln\left|\frac{\partial L}{\partial N}\right| = \alpha_N \ln N + \gamma_N \ln D + c_N, \qquad \ln\left|\frac{\partial L}{\partial D}\right| = \gamma_D \ln N + \alpha_D \ln D + c_D \tag{4}$$
其中 $\alpha_N, \alpha_D$ 刻画同变量的主导衰减,$\gamma_N, \gamma_D$ 刻画对另一条轴的残余依赖。
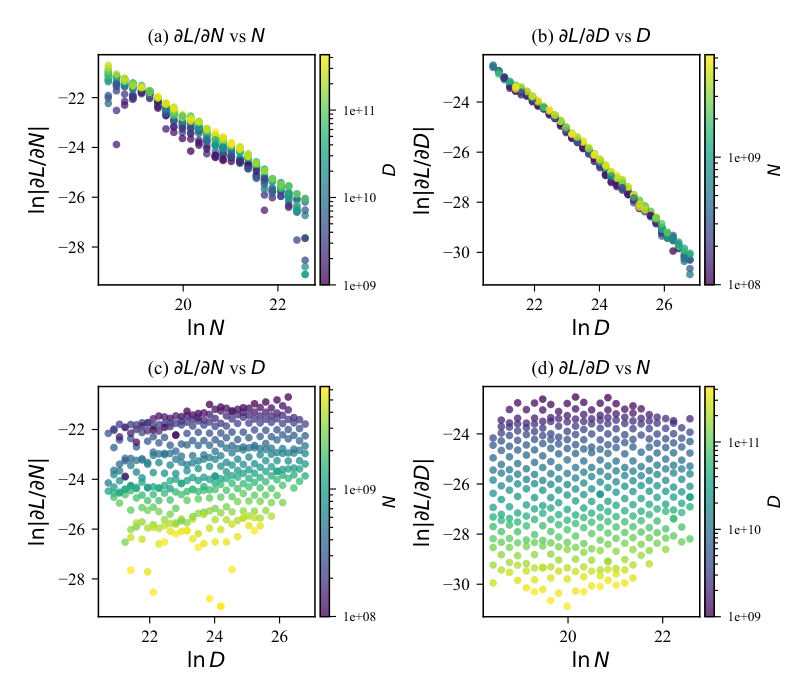
图 (a)(b) 的同变量投影接近直线,$\alpha_N \approx \alpha_D \approx -1.3$,说明边际导数近似按幂律衰减。图 (c)(d) 的跨变量投影则主要呈现水平条带(条带本身是由同变量依赖造成的),跨斜率很小:$\gamma_N \approx 0.13$、$\gamma_D \approx 0.07$。所以一阶看上去几乎可分——但作者明确指出,一阶投影无法排除更弱的交互。
二阶结构:决定性证据
真正的判决性检验是混合偏导。任何加性律都要求 Eq. (2) 恒成立,于是只要实测混合偏导显著非零,加性形式就被证伪。作者用局部二次拟合的二阶项估计它,并同样拟合幂律:
$$\ln\left|\frac{\partial^2 L}{\partial N \partial D}\right| = a \ln N + b \ln D + c \tag{5}$$
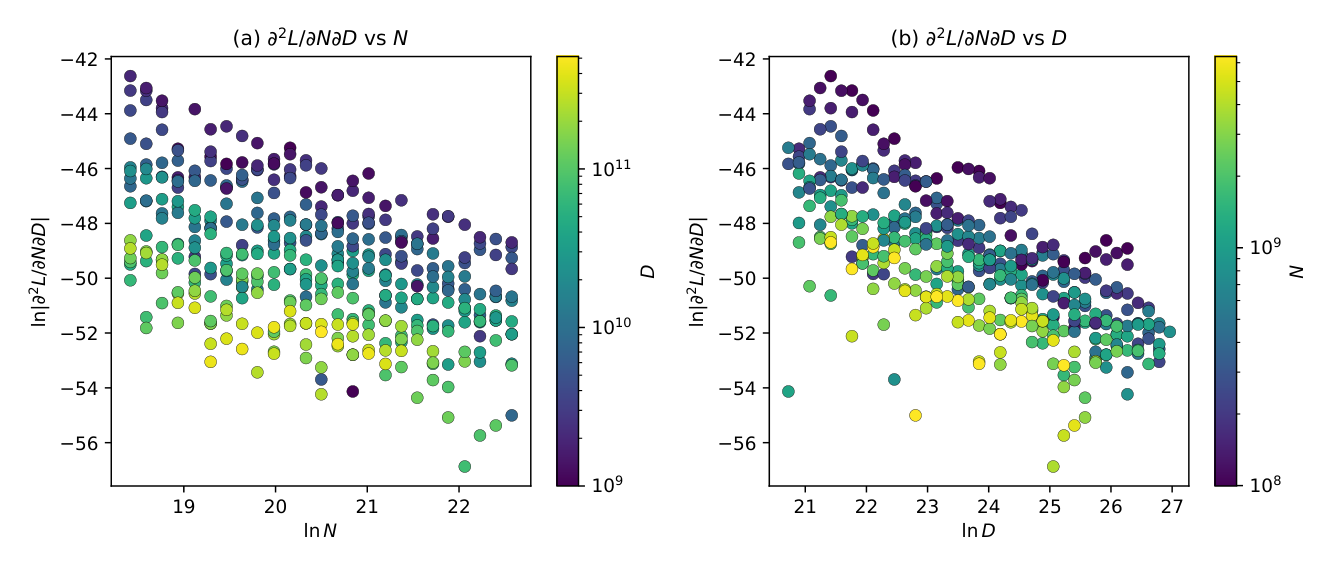
结果是:混合偏导在整个网格上都非零,自身也按幂律衰减($a \approx b \approx -1.1$),符号以负为主。负号的含义很直白——同时扩 $N$ 和 $D$ 所降低的 loss,比分别单独扩它们所降之和还多,即存在协同(synergy),这正是加性律结构上无法表达的。这一节的方法论价值超出本文:它把"该用哪个函数形式"从审美/习惯问题转成了可被数据证伪的假设检验。
核心方法:Skaling 形式
两种范式与它们的取舍
标度律文献里有两个锚点形式,区别就在 $N$ 与 $D$ 如何组合。Chinchilla(Eq. (1))把两者完全解耦:两个各自带独立内指数 $\alpha, \beta$ 的项相加,外加自由的不可降低常数 $E$。更早的 Kaplan 形式则走了相反的路:
$$L(N, D) = \left[\left(\frac{N_c}{N}\right)^{\alpha_N/\alpha_D} + \frac{D_c}{D}\right]^{\alpha_D} \tag{6}$$
这里外指数 $\alpha_D$ 扮演了 Skaling 中 $k$ 的角色,但 Kaplan 额外把内层两项通过比值 $\alpha_N/\alpha_D$ 绑在一起,导致两条轴的衰减率不再独立可调。
Skaling:只加一个参数
Skaling 的做法是把两者的优点各取其一——保留 Chinchilla 可解释的基础项与独立的内指数,同时按 Kaplan 的思路把它们的和整体抬到一个自由外指数 $k$ 上:
$$L(N, D) = \left(\frac{A}{N^\alpha} + \frac{B}{D^\beta}\right)^{k} + E \tag{7}$$
这单个参数在两种旧范式之间连续插值:
- $k = 1$ 时,Skaling 精确退化为加性 Chinchilla 律(因此 Chinchilla 是 Skaling 的一个特例,两者是嵌套关系,可以做严格受控对比);
- 任意 $k \neq 1$ 都重新引入 Kaplan 式耦合与非零混合偏导;
- 与 Kaplan 不同的是,耦合完全由外指数 $k$ 承担,内指数 $\alpha, \beta$ 仍然彼此独立。
尽管灵活度增加,Skaling 保留了加性律两条重要性质。其一,单调性:$k > 0$ 使函数对 $N$ 和 $D$ 都严格递减,加参数或加数据永远不会让预测 loss 变大。其二,可解释性:$k$ 只决定两个源项如何聚合,$A/N^\alpha$ 与 $B/D^\beta$ 各自含义不变。
为什么必须是乘性耦合,而不是加性交互项
这是全篇最漂亮的一段论证(Appendix A.2),也是它区别于其他"给 Chinchilla 打补丁"工作的关键。一个看起来更自然的替代方案是:保持 Chinchilla 加性结构,另外补一个乘积交互项:
$$L = \frac{A}{N^\alpha} + \frac{B}{D^\beta} + G\,N^{-\mu} D^{-\nu} + E \tag{8}$$
它确实能造出非零混合偏导,但符号立刻构成一个死结。对该模型:
$$\frac{\partial^2 L}{\partial N \partial D} = \mu\nu\, G\, N^{-\mu-1} D^{-\nu-1}, \qquad \frac{\partial L}{\partial N}\bigg|_{G N^{-\mu}D^{-\nu}} = -\mu\, G\, N^{-\mu-1} D^{-\nu} \tag{9}$$
于是 $G$ 的符号以相反方向同时控制两个量:要匹配实测的负混合偏导必须取 $G < 0$;但 $G < 0$ 时交互项对 $\partial L / \partial N$ 的贡献变成正的,与"loss 随模型增大而单调下降"冲突。
而且这不是局部小瑕疵:实测混合偏导衰减率意味着 $\mu \approx 0.1$,比主项的规模指数 $\alpha$ 还小,故这个正贡献在 $N$ 方向衰减得更慢,在大 $N$、小 $D$ 的角落会反超主项使 $\partial L/\partial N > 0$——预测出"模型越大 loss 越高"的荒谬结论。反过来取 $G > 0$ 保住了单调性,但混合偏导变正,协同效应消失。单个加性乘积项无法同时满足单调性与实测的负交互。
Skaling 绕开这个符号冲突的方式是:交互不由带符号的独立项引入,而由一个恒正的乘性因子引入。它的规模梯度是
$$\frac{\partial L}{\partial N} = -k\,\alpha A\, N^{-\alpha-1} u^{\,k-1}, \qquad \frac{\partial L}{\partial D} = -k\,\beta B\, D^{-\beta-1} u^{\,k-1}, \qquad u \equiv \frac{A}{N^\alpha} + \frac{B}{D^\beta} \tag{10}$$
对任意 $k > 0$ 都是负的,而对数据的依赖只通过恒正因子 $u^{k-1}$ 进入。当 $0 < k < 1$ 时,增大 $D$ 会减小 $u$,从而增大 $u^{k-1}$,也就放大了那个本来就是负的规模梯度的幅度——于是得到
$$\frac{\partial^2 L}{\partial N \partial D} = k(k-1)\, u^{\,k-2}\, \alpha A\, N^{-\alpha-1}\, \beta B\, D^{-\beta-1} < 0 \quad (0<k<1) \tag{11}$$
而 $\partial L/\partial N$ 的符号自始至终没有改变。在这个参数化里,单调性与协同性是"构造上相容"的,不需要任何额外约束。
同一个因子还顺带解释了 Figure 2 中不对称的一阶跨斜率。令 $w_D = (B D^{-\beta})/u$、$w_N = (A N^{-\alpha})/u$ 分别为内层和式中数据项与规模项的占比,对 Eq. (10) 取对数再求导可得:
$$\gamma_N = (1-k)\,\beta\, w_D, \qquad \gamma_D = (1-k)\,\alpha\, w_N, \qquad \frac{\gamma_N}{\gamma_D} = \frac{\beta}{\alpha}\cdot\frac{w_D}{w_N} \tag{12}$$
只要 $\beta > \alpha$ 且内层和式偏向数据项,这个比值就大于 1——恰好复现了实测的 $\gamma_N \approx 0.13 > \gamma_D \approx 0.07$,而且是靠单个耦合指数复现的,不需要引入任何偏斜的交互项。这是一次相当强的自洽性验证:同一个 $k$ 同时解释了二阶的负号和一阶的不对称。
计算最优分配:形式变了,公式没变
Skaling 的一个实用红利是:它继承了 Chinchilla 的闭式 compute-optimal 分配。在预算 $C = 6ND$ 下代入 $D = C/(6N)$,记 $Z(N) = A N^{-\alpha} + B\,(C/6N)^{-\beta}$,则
$$L(N) = Z(N)^k + E \tag{13}$$
$$\frac{dL}{dN} = k \cdot Z(N)^{k-1} \cdot Z'(N) \tag{14}$$
由于 $Z(N)$ 是严格正项之和、且实测 $k > 0$,前置因子 $k\, Z(N)^{k-1}$ 恒不为零,最小化 loss 严格等价于 $Z'(N) = 0$——也就是加性 Chinchilla 律的驻点条件本身。解 $Z'(N) = -\alpha A N^{-\alpha-1} + \beta B (6/C)^{\beta} N^{\beta-1} = 0$ 得 $N^{\alpha+\beta} = \frac{\alpha A}{\beta B}(C/6)^{\beta}$,代入 $D^* = C/(6N^*)$ 得最优 token/参数比:
$$R_{\rm opt} = \frac{D^*}{N^*} = 6^{\frac{\beta-\alpha}{\alpha+\beta}} \left(\frac{\beta B}{\alpha A}\right)^{\frac{2}{\alpha+\beta}} C^{\frac{\alpha-\beta}{\alpha+\beta}} \tag{15}$$
作者的总结很精辟:Skaling 干净地把"loss 曲面的形状"(由 $k$ 控制)与"最优分配的位置"(由 $Z'(N)=0$ 决定)分开了——单调外映射 $x \mapsto x^k + E$ 只给 loss 重新标度、不移动极小点,表达力上去了而可解析性没丢。
但有一个容易误读之处:代数公式相同不等于数值结果相同。$A, B, \alpha, \beta$ 在两种形式下拟合出的值并不互相转移,实际最优比值差别很大。$\alpha \approx \beta$ 时 Eq. (15) 中 $C$ 的指数趋于零,比值跨尺度恒定(正是 Chinchilla 观察到的现象);一旦 $\alpha \neq \beta$,比值就随算力漂移。
稀疏 profiling:L 形网格
标准做法是在对数等距方形网格上采 $N$ 与 $D$。问题在于总算力被右上角(最大模型 × 最长训练)压倒性主导,几何上就注定稠密采样极其浪费——与其把绝大部分预算花在少数几个巨型 run 上,不如把算力投到更有区分度的点上。Skaling 的结构本身提示了该往哪投。考察渐近行为:
$$\lim_{D \to \infty} L(N, D) = \left(\frac{A}{N^\alpha}\right)^{k} + E, \qquad \lim_{N \to \infty} L(N, D) = \left(\frac{B}{D^\beta}\right)^{k} + E \tag{16}$$
也就是说,增大 $D$ 会干净地隔离出 $N$ 相关的系数,反之亦然。实践中并不需要真的取到极限——固定一条轴、只扫另一条轴,就足以描出对应的衰减率。
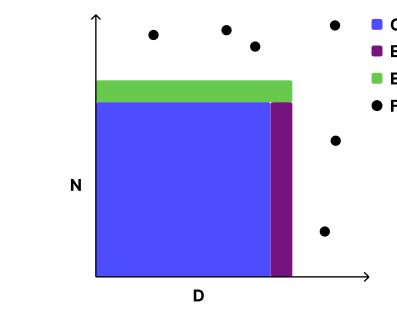
L 形策略(Figure 4a)把这个原理用在最低算力处:只对最小的模型扫数据量 $D$(D-band)来定 $(B, \beta)$;只在最短训练 horizon 上扫模型规模 $N$(N-band)来定 $(A, \alpha)$,网格内部一个点都不训。作者的措辞是:把两条独立衰减率锚在网格边界上,这个稀疏几何在同等算力约束下比全网格扫描更高效地刻画了 $N$–$D$ 交互。
评测协议
交叉验证的四类评测集
作者不用单一静态划分,而是反复重采样训练集并构造对应留出集(Figure 4b),以量化预测不确定性与参数方差:
- Validation(插值):随机留出、落在训练网格边界之内的点;
- Extrapolation N:训练集之外更大的模型规模;
- Extrapolation D:更大的数据量,测试更长训练 horizon;
- Far Extrapolation:最难的一档——最大模型 × 最大数据量,同时在两条轴之外。
所有折都报告每个评测集的 MAPE,但 $R^2$ 只在插值集上报告:
$$\mathrm{MAPE}(S) = \frac{100}{|S|} \sum_{i \in S} \left|\frac{\hat{L}_i - L_i}{L_i}\right| \ [\%] \tag{17}$$
限制 $R^2$ 的理由值得记下:外推集点数少、覆盖网格上一个狭窄且多少任意的切片,而 $R^2$ 用留出目标的方差归一化,在那里会不稳定且无信息(常很小甚至强烈为负),MAPE 则在所有 regime 上直接可比。
iso-ratio 算力外推
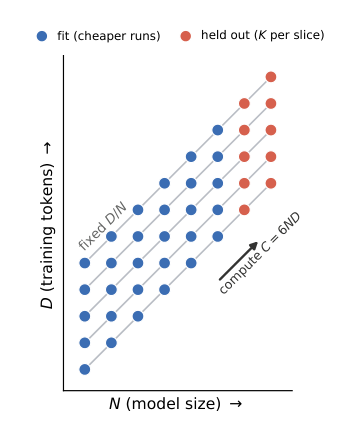
前沿实验室几乎只靠一维算力幂律预测大 run 表现,且模型通常沿固定 token/参数比缩放(如 DeepSeek)。作者据此设计了一个纯操作性测试(Section 3.4):把 run 按恒定 $D/N$ 分成 iso-ratio 切片,每片留出算力最高的 $K=8$ 个点;每个律在汇总后的低算力剩余点上重拟合一次(保证所有形式看到完全相同的训练集),再预测那些高算力留出点。作为强 baseline,另在每个切片内部单独拟合一维幂律 $L = A C^a + E$(复刻 DeepSeek 方法论)——它高度特化于单一配方、无法指导 $N$–$D$ 联合分配,但可作"专用一维律沿固定射线外推能做到多好"的经验上界。
实验设置
数据
所有标度律在两个预训练 run 网格上拟合与评测。
Farseer(Li et al., 2025a)记录 404 个 $(N, D)$ 配置的最终验证 loss,跨 25 个模型规模(100M–6.4B)与 55 个数据预算(1B–512B tokens),算力 $1.6\times10^{18}$–$4.1\times10^{21}$ FLOPs,序列长度统一 2048。留出三个评测集:Extrapolation N(最大的 3 个模型规模,4.5B–6.4B,36 点)、Extrapolation D(其余每个规模的 top-3 数据预算,66 点)、Far extrapolation(7 个额外 run,2.3B–25B 参数 × 126B–453B tokens,远超两条轴)。用于拟合的 302 个配置共计约 $5.0\times10^{22}$ FLOPs。
SK-Grid 是作者自建的互补网格,134 个配置跨 15 个模型规模(134M–4.9B)与 16 个数据预算(316M–316B tokens),算力 $9.0\times10^{16}$–$9.9\times10^{20}$ FLOPs。同样的留出方案给出 Extrapolation N 7 点(2.8B–4.9B)、Extrapolation D 33 点、far-extrapolation 3 个 run(约 $10^{22}$ FLOPs,5.8B–10.8B 参数)。拟合网格共约 $3.1\times10^{21}$ FLOPs。
Baseline 与优化器
对比两个最常用的 reducible-loss 形式:加性 Chinchilla 律与参数更多的 Farseer 律(9 参数,数据指数与幅度都依赖 $N$)。所有律用同一优化器与同一 log 空间目标拟合,确保精度差异反映函数形式而非拟合流程:log 空间最小化 Huber loss($\delta = 0.05$),带 basin-hopping 的 L-BFGS-B 加 autograd 解析梯度。
训练配方
网格中的模型按 StepLaw(Li et al., 2025b)超参处方训练,即把学习率与 batch size 写成模型规模与 token 预算的函数。作者强调其意义:每个 $(N, D)$ 都用近最优设置,保证测到的 loss 反映架构的标度行为而非超参失调,为拟合提供干净目标。
主要实验结果
Table 1:拟合质量与预测误差
Table 1 Fit quality and predictive error on the Farseer and SK-Grid datasets($R^2$ 仅报插值集;MAPE 为 5 折 CV 的 mean ± std,越低越好)
| 网格 | Law | Farseer $R^2$ | Farseer Interp. | Farseer Ext. N | Farseer Ext. D | Farseer Far | SK-Grid $R^2$ | SK Interp. | SK Ext. N | SK Ext. D | SK Far |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Full grid (5.0×10²² / 3.1×10²¹ FLOPs) |
Chinchilla | 0.995 | 0.77±0.04 | 1.48±0.03 | 1.98±0.08 | 2.46±0.19 | 0.992 | 0.81±0.14 | 0.83±0.11 | 1.44±0.03 | 5.17±0.28 |
| Farseer | 0.982 | 1.73±0.45 | 2.37±0.08 | 4.13±1.36 | 2.43±1.93 | 0.967 | 1.66±0.32 | 0.90±0.49 | 4.45±0.21 | 3.98±1.25 | |
| Skaling | 0.998 | 0.41±0.05 | 0.47±0.03 | 0.88±0.06 | 2.31±0.18 | 0.998 | 0.33±0.11 | 0.39±0.05 | 0.58±0.07 | 0.70±0.39 | |
| L-shape (5.1×10²¹ / 6.5×10²⁰ FLOPs) |
Chinchilla | 0.954 | 2.51±0.07 | 4.32±0.13 | 3.29±0.11 | 9.82±0.48 | 0.955 | 2.19±0.10 | 6.09±0.24 | 3.63±0.13 | 14.63±0.39 |
| Farseer | 0.974 | 1.81±1.23 | 2.07±1.72 | 2.52±1.95 | 2.37±1.33 | 0.987 | 0.82±0.52 | 1.19±0.82 | 2.66±2.42 | 4.64±1.31 | |
| Skaling | 0.995 | 0.85±0.10 | 0.89±0.23 | 1.35±0.20 | 1.51±0.67 | 0.998 | 0.33±0.03 | 0.77±0.44 | 0.55±0.08 | 1.15±0.53 |
边界误差。最清晰的增益出现在网格边界。加性 Chinchilla 在内部插值已经足够准,但误差在单轴外推与 far 外推上放大——正是 Figure 1 那个鞍形残差最显著的地方。Skaling 在全网格上把单轴 MAPE 从 1.48 降到 0.47、从 1.98 降到 0.88(Farseer),从 0.83 降到 0.39、从 1.44 降到 0.58(SK-Grid)。最不平衡的角落增益最大:SK-Grid 的 far 外推误差在全网格上从 5.17 降到 0.70,在 L 形网格上从 14.63 降到 1.15;L 形的最大-$N$ 误差从 6.09 降到 0.77。
稀疏 profiling 的可行性。这是 C2 的核心证据:用约 1/10 拟合算力的 L 形网格训练时,Skaling 在插值与单轴外推上仍然接近甚至优于全网格的 Chinchilla baseline(如 SK-Grid L 形 Skaling 插值 0.33,全网格 Chinchilla 0.81)。而 Chinchilla 在同样的限制下急剧退化:Farseer 上插值 MAPE 从 0.77 涨到 2.51,SK-Grid 上 far 外推从 5.17 涨到 14.63。原因也很清楚——耦合形式是由边界锚定的,把训练点集中到低算力边缘正好喂到它的强项上;加性形式则依赖内部信息去定 $E$ 与两个幅度。
插值好不等于律对。Chinchilla 在两个全网格上的插值 $R^2$ 都很高(0.995 / 0.992),但边界外推误差是 Skaling 的数倍。真正的失效模式不是"对内部拟合得差",而是"对 loss 曲面如何在观测区之外弯折的系统性误判"——只看 $R^2$ 或插值 MAPE 验证标度律是会被骗的。
Table 2:拟合出的系数
Table 2 Fitted coefficients(5 折 CV 的 mean ± std;Chinchilla 即 $k=1$ 的 Skaling 特例;9 参数的 Farseer 律略去)
| Setup | Law | $A$ | $B$ | $\alpha$ | $\beta$ | $k$ | $E$ |
|---|---|---|---|---|---|---|---|
| Farseer, full | Chinchilla | (4.8±1.2)×10¹ | (1.1±0.1)×10² | 0.27±0.01 | 0.24±0.00 | 1 | 0.45±0.01 |
| Skaling | (2.9±0.2)×10² | (6.0±0.3)×10³ | 0.32±0.01 | 0.39±0.00 | 0.41±0.01 | 0.03±0.02 | |
| Farseer, L-shape | Chinchilla | (2.6±0.6)×10² | (1.0±0.1)×10² | 0.39±0.02 | 0.24±0.00 | 1 | 0.59±0.01 |
| Skaling | (2.5±0.7)×10² | (1.7±0.4)×10³ | 0.32±0.01 | 0.33±0.01 | 0.45±0.03 | 0.05±0.06 | |
| SK-Grid, full | Chinchilla | (5.0±1.2)×10² | (7.1±0.8)×10² | 0.34±0.01 | 0.31±0.01 | 1 | 1.75±0.02 |
| Skaling | (5.3±1.8)×10⁶ | (7.1±2.8)×10⁶ | 0.73±0.01 | 0.63±0.01 | 0.31±0.02 | 1.14±0.06 | |
| SK-Grid, L-shape | Chinchilla | (1.0±0.0)×10⁴ | (1.7±0.4)×10³ | 0.52±0.00 | 0.36±0.01 | 1 | 2.16±0.02 |
| Skaling | (1.0±0.0)×10⁷ | (6.5±2.4)×10⁶ | 0.77±0.02 | 0.63±0.01 | 0.31±0.02 | 1.18±0.12 |
稳定的耦合。所有网格上 Skaling 都回收到一个明显小于 1 的耦合指数 $k \approx 0.31\text{–}0.45$,而不是塌回加性特例 $k=1$。这本身就是对"$N$–$D$ 确实耦合"的独立确认——因为两种形式嵌套,$k$ 完全有自由退回 1。
关于 $E \approx 0$ 的诚实讨论。拟合出的不可降低 loss 系统性低于 Chinchilla,在 Farseer 上几乎消失(全网格 0.45→0.03,L 形 0.59→0.05),SK-Grid 上仍可观(1.75→1.14)。作者明确拒绝把 $E \approx 0$ 读作"loss 地板消失",并给出机制解释:决定 loss 如何变平的两个量——耦合 $k$ 与地板 $E$——互相抵偿。$k<1$ 时凹的外映射让耦合后的 reducible 项在大尺度衰减更慢,于是能吸收掉加性律只能靠更大 $E$ 表达的那部分曲率。由于没有 run 达到真正饱和的尺度,数据只能定住总 loss,定不住"衰减项 vs 常数地板"的劈分,Skaling 把这个歧义解决成压低 $E$。除 $E$ 外其余参数在每次拟合内都很精确:指数与耦合的折间标准差仅百分之几,幅度最多约 40%。
参数量不是关键。参数更多的 Farseer 律并未靠自由度解决边界失效——它在 Table 1 多数 regime 都不如 Skaling,最大误差集中在数据外推(两个全网格 MAPE 4.13 与 4.45)。结论是:增益不来自"加参数",而来自函数形式的归纳偏置与实测 $N$–$D$ 交互相匹配。作者也坦承部分差距可能源于复杂形式更难拟合——试过包括 Farseer 自家 pipeline 在内的多种优化器都没能明显更好。
耦合强度决定增益大小。实测耦合更接近可加时优势减弱:Farseer-code 与原始 Chinchilla 实测上 $k \approx 0.77\text{–}0.90$,精度回落到 Chinchilla 水平。这正是嵌套形式该有的表现——数据支持耦合时偏离加性律,否则贴着加性走,因而是一个低风险替换。
Table 3:iso-ratio 算力外推
Table 3 Compute extrapolation on Farseer,按训练 regime 分组(iso-ratio 切片按 $D/N$ 分为欠训 1.8–7 / 最优 10–40 / 过训 56–158 三档,外加全部 14 个配置)。在 112 个最高算力 run 上评测(每片留出 8 个),所有律仅在低算力 run 上重拟合。$R^2$ 为组内均值,MAPE 为组内切片的 mean ± std。
| Law | 欠训 $R^2$ | 欠训 MAPE | 最优 $R^2$ | 最优 MAPE | 过训 $R^2$ | 过训 MAPE | 全部 $R^2$ | 全部 MAPE |
|---|---|---|---|---|---|---|---|---|
| Power law (per-ratio) | 0.94 | 1.32±0.87 | 0.96 | 0.77±0.39 | 0.97 | 0.86±0.75 | 0.95 | 0.99±0.69 |
| Chinchilla | 0.89 | 1.52±0.80 | 0.47 | 3.47±0.65 | 0.87 | 1.94±0.66 | 0.74 | 2.34±1.11 |
| Farseer | 0.99 | 0.46±0.20 | 0.94 | 1.20±0.20 | 0.99 | 0.73±0.23 | 0.97 | 0.80±0.38 |
| Skaling | 0.99 | 0.45±0.21 | 0.97 | 0.88±0.15 | 0.99 | 0.42±0.15 | 0.98 | 0.60±0.27 |
结论有三层。其一,Skaling 在每个 regime 与总体上都是最好的全局律(汇总 MAPE 0.60±0.27%,相对 Chinchilla 降幅 3.9×,也低于参数多得多的 Farseer 律),且最稳定——任何 regime 误差都不超过 0.9%。其二,Chinchilla 高度依赖 regime,在最优带上反而是所有律里最差的(3.47%,$R^2$ 掉到 0.47),汇总数字掩盖了失效位置——而最优带恰是实际训练最常落的地方,格外要命。其三,唯一压过 Skaling 的参照是 per-ratio 一维幂律,且仅在最优点附近(0.77 vs 0.88%);但它按配方逐一单独拟合,无法指导 $N$–$D$ 联合分配,不构成实际替代。
经验最优 token/参数比
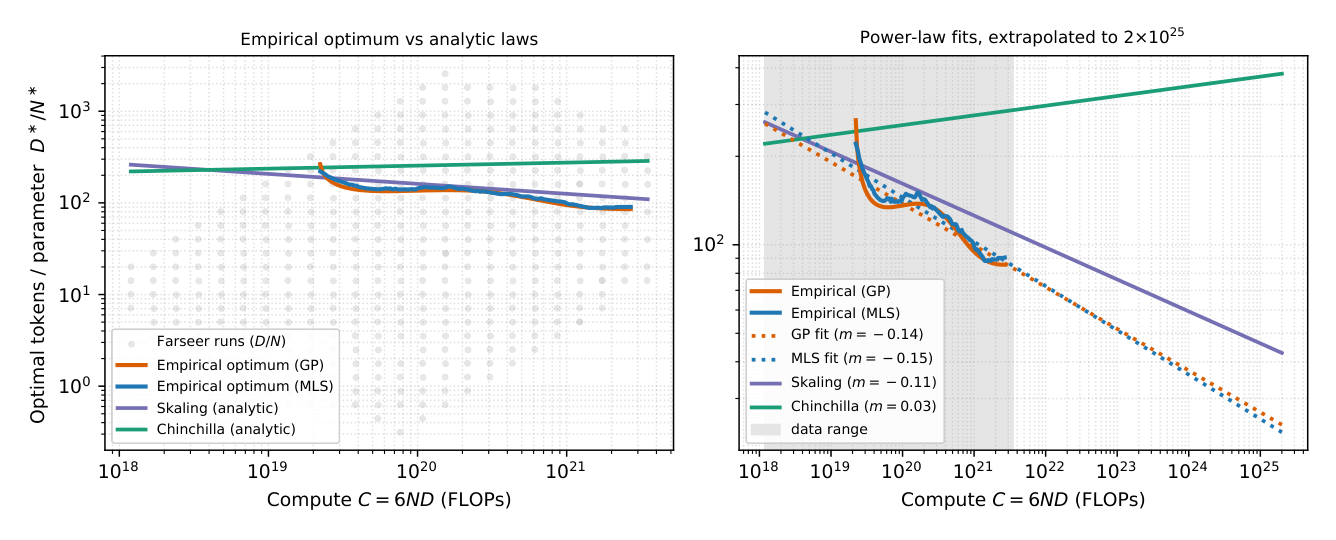
作者还用数值梯度做了一次完全不依赖参数化标度律的最优分配估计。固定预算 $C = 6ND$ 时可行配置落在一条 iso-compute 曲线上,把 Lagrangian $\mathcal{J} = L(N,D) + \lambda(6ND - C)$ 的两个驻点条件相除消掉乘子,得到只关于 loss 梯度的条件:
$$N \frac{\partial L}{\partial N} = D \frac{\partial L}{\partial D} \iff \frac{\partial \ln L}{\partial \ln N} = \frac{\partial \ln L}{\partial \ln D} \tag{18}$$
含义是:在 compute-optimal 点上,模型规模增加 1% 与数据量增加 1% 对 loss 的带符号效应完全相同。作者用 GP 与 MLS 两个独立的无网格代理曲面追踪该等式的零交叉线,得到两条独立的经验前沿。
两者定性一致:都给出随算力递减的比值,紧贴 Skaling 的解析 $R_{\rm opt}$,而 Chinchilla 预测几乎持平。把经验前沿拟合成幂律 $D^*/N^* \propto C^m$,得 GP 的 $m \approx -0.14$、MLS 的 $m \approx -0.15$,接近 Skaling 的 $-0.11$,而与 Chinchilla 的 $+0.03$ 符号相反。外推到数据范围之外一个数量级($2\times10^{25}$ FLOPs)时两种处方差出 10 倍以上:Chinchilla 逼近约 380 tokens/参数,经验拟合与 Skaling 落在 20–40。
这一节分量不小:DeepSeek 这类前沿模型通常锁定固定的 token/参数比,真实最优值必须知道才能量化次优训练的代价;Section 3.1 估计两律的最优比值漂移在前沿算力尺度会累积到 100 倍量级。
方向是数据相关的,不是耦合的普遍推论。 Farseer 上拟合出 $\alpha < \beta$,故解析 $D^*/N^*$ 随算力递减;但 SK-Grid 全网格与 L 形都拟合出 $\alpha > \beta$,同一闭式最优会给出递增的比值。稳健结论只是"耦合改变了大尺度分配",方向取决于拟合所用的数据与架构。
补充数据集与消融
更多数据集上的复现
Table 5 在另外两个数据集上重复 Section 3.3 的交叉验证协议。Farseer-code 是 Farseer 网格的代码域对应物:117 个 run,9 个模型规模(201M–3.18B)× 20 个 token 预算(2B–128B),算力 $2.4\times10^{18}$–$2.4\times10^{21}$ FLOPs,有网格结构故可做全网格与 L 形两种划分。Chinchilla loss 实测(Besiroglu et al., 2024)是 245 个散点(57M–16.2B 参数,245M–318B tokens,$1.4\times10^{18}$–$1.3\times10^{22}$ FLOPs),不在规则网格上,因此只能做全网格(随机)划分、没有 L 形。
| Law | code-full $R^2$ | code-full Interp. | code-full Ext. N | code-full Ext. D | code-L $R^2$ | code-L Interp. | code-L Ext. N | code-L Ext. D | Chin. $R^2$ | Chin. Interp. | Chin. Ext. N | Chin. Ext. D |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Chinchilla | 0.998 | 0.28±0.07 | 0.93±0.15 | 0.60±0.04 | 0.991 | 0.59±0.06 | 1.93±0.18 | 1.60±0.12 | 0.993 | 0.63±0.15 | 1.16±0.33 | 0.63±0.06 |
| Farseer | 0.983 | 0.89±0.12 | 1.01±0.04 | 3.74±0.23 | 0.993 | 0.53±0.16 | 0.96±0.27 | 0.91±0.68 | 0.955 | 1.27±0.55 | 1.23±1.10 | 1.12±0.21 |
| Skaling | 0.999 | 0.24±0.09 | 0.67±0.19 | 0.26±0.06 | 0.995 | 0.45±0.12 | 1.39±0.49 | 1.14±0.41 | 0.993 | 0.61±0.14 | 1.28±0.29 | 0.51±0.03 |
Table 6 给出对应系数,同样的模式成立($k < 1$ 且 $E$ 小于 Chinchilla),但耦合明显更弱:
| Setup | Law | $A$ | $B$ | $\alpha$ | $\beta$ | $k$ | $E$ |
|---|---|---|---|---|---|---|---|
| Farseer-code, full | Chinchilla | (1.8±1.1)×10³ | (5.6±0.8)×10² | 0.48±0.03 | 0.34±0.01 | 1 | 0.65±0.01 |
| Skaling | (4.2±2.8)×10³ | (2.0±0.2)×10³ | 0.52±0.03 | 0.40±0.01 | 0.77±0.03 | 0.60±0.02 | |
| Farseer-code, L-shape | Chinchilla | (5.4±1.2)×10³ | (1.5±0.1)×10³ | 0.55±0.01 | 0.39±0.00 | 1 | 0.71±0.00 |
| Skaling | (4.1±1.4)×10³ | (2.1±0.5)×10³ | 0.53±0.02 | 0.40±0.01 | 0.90±0.06 | 0.67±0.03 | |
| Chinchilla, full | Chinchilla | (7.0±1.5)×10² | (1.3±0.3)×10⁴ | 0.37±0.02 | 0.45±0.01 | 1 | 1.91±0.02 |
| Skaling | (4.9±3.0)×10³ | (1.1±0.7)×10⁵ | 0.45±0.04 | 0.53±0.03 | 0.77±0.06 | 1.85±0.01 |
这两个数据集上 $k \approx 0.77\text{–}0.90$,与 Farseer/SK-Grid 的 $0.31\text{–}0.45$ 形成鲜明对比,直接对应 Table 5 中更为混合的增益。作者没有掩盖这个负面结果,反而用它支撑"增益随耦合强度而变"的论断。附录 E.2 给出一个诱人的解释:loss 曲面形状对超参处方高度敏感,大范围失调的网格可能人为压低测到的交互,不同数据集耦合强弱的差异部分可归因于超参策略差异(原始 Chinchilla 配方 vs StepLaw 调优的 SK-Grid),因此跨数据集比较本质上反映的是各自的训练配方。
拟合的脆弱性与配置
作者用整节坦白拟合本身有多难:参数虽少,却是出了名脆弱的非凸问题。三个结构性因素——(i) 参数量级差异巨大($A, B$ 很大而 $\alpha, \beta$ 是分数),使问题对 L-BFGS 这类优化器病态;(ii) 景观极平坦,loss 按对数下降,优化器易过早停止,用有限差分梯度更糟;(iii) 参数间强补偿,尤其 $E$ 难估,其他系数容易挪动抵消它,造成大量"拟合几乎一样好"的宽阔局部极小谷。
Table 4 Per-law parameter bounds and fitting configuration(所有律用 2000 次 basin-hopping 重启、log 空间 Huber 目标、autograd 解析梯度)
| Law | Params | Log params | Bounds |
|---|---|---|---|
| Chinchilla | 5 | $A, B$ | $A\in[10^{-6}, 10^4]$, $B \in[10^{-6}, 5\times10^4]$, $\alpha, \beta \in[0, 1]$, $E \in[0, 3]$ |
| Skaling | 6 | $A, B$ | $A, B \in[10^{-6}, 10^7]$, $\alpha, \beta, k\in[0.01, 2]$, $E \in[0, 3]$ |
| Farseer | 9 | — | $E \in[0, 5]$, $s\in[-10, 10]$, $q \in[-0.5, 0.5]$, $S \in[-30, 10]$, $B_c \in[-10, 500]$, $b\in[-2, 0.5]$, $Q\in[-10, 15]$, $A_c \in[-25, 5]$, $a\in[-0.5, 0.2]$ |
作者实现了两套全局优化:带 basin-hopping 的 L-BFGS-B(起点取自 Sobol 拟随机序列)与无梯度的 BIPOP-CMA-ES(双倍种群、active CMA、9 次 BIPOP 重启)。两者达到同样好的拟合,差别是实践性的:L-BFGS 必须仔细调(初始化、重启、log 空间目标)才能可靠达到,而 CMA-ES 开箱即用就能到同一批解。论文正文结果统一用 L-BFGS-B + basin-hopping,因为文献里更常见。
Dominated-pair 拟合:把 $E$ 从目标里移除
针对"$E$ 只被弱辨识"这个反复出现的困难,作者设计了一个巧妙的消融。对任意一对满足支配关系的配置($F_i \geq F_j$、$D_i \geq D_j$ 且 $L_i < L_j$),加性地板在 loss 差里直接抵消:
$$L_j - L_i = \left(A F_j^{-\alpha} + B D_j^{-\beta}\right)^{k} - \left(A F_i^{-\alpha} + B D_i^{-\beta}\right)^{k} \tag{19}$$
于是可以先在所有这样的成对差上拟合形状参数 $(A, B, \alpha, \beta, k)$,再把地板作为中位数恢复出来:$E = \mathrm{median}_k\left[L_k - (A F_k^{-\alpha} + B D_k^{-\beta})^{k}\right]$,从而把"可降低部分的形状"与"常数偏移"解耦。
Table 9 Dominated-pair("+dom")拟合 vs 默认联合 L-BFGS 拟合
| Law | Farseer-full $R^2$ | Interp. | Ext. N | Ext. D | Far | Farseer-L $R^2$ | Interp. | Ext. N | Ext. D | Far |
|---|---|---|---|---|---|---|---|---|---|---|
| Chinchilla | 0.995 | 0.77±0.04 | 1.48±0.03 | 1.98±0.08 | 2.46±0.19 | 0.954 | 2.51±0.07 | 4.32±0.13 | 3.29±0.11 | 9.82±0.48 |
| +dom | 0.995 | 0.82±0.06 | 1.40±0.06 | 2.61±0.22 | 0.79±0.08 | 0.959 | 2.41±0.17 | 3.82±0.18 | 2.89±0.13 | 7.84±0.87 |
| Skaling | 0.998 | 0.41±0.05 | 0.47±0.03 | 0.88±0.06 | 2.32±0.18 | 0.995 | 0.84±0.10 | 0.87±0.23 | 1.35±0.20 | 1.57±0.62 |
| +dom | 0.998 | 0.41±0.04 | 0.39±0.01 | 0.71±0.07 | 1.55±0.17 | 0.996 | 0.67±0.09 | 0.80±0.25 | 2.29±0.79 | 5.87±1.79 |
| Law | SK-full $R^2$ | Interp. | Ext. N | Ext. D | Far | SK-L $R^2$ | Interp. | Ext. N | Ext. D | Far |
|---|---|---|---|---|---|---|---|---|---|---|
| Chinchilla | 0.992 | 0.81±0.14 | 0.83±0.11 | 1.44±0.03 | 5.17±0.28 | 0.955 | 2.19±0.10 | 6.09±0.24 | 3.63±0.13 | 14.63±0.39 |
| +dom | 0.991 | 0.80±0.19 | 0.59±0.05 | 1.38±0.13 | 3.67±0.20 | 0.971 | 1.70±0.15 | 4.96±0.39 | 3.07±0.20 | 13.07±0.60 |
| Skaling | 0.998 | 0.33±0.11 | 0.39±0.05 | 0.58±0.07 | 0.70±0.39 | 0.998 | 0.33±0.03 | 0.77±0.44 | 0.55±0.08 | 1.16±0.53 |
| +dom | 0.998 | 0.32±0.12 | 0.46±0.05 | 0.45±0.05 | 0.41±0.21 | 0.996 | 0.54±0.19 | 2.08±0.94 | 0.66±0.27 | 2.99±2.05 |
| Law | code-full $R^2$ | Interp. | Ext. N | Ext. D | code-L $R^2$ | Interp. | Ext. N | Ext. D | Chin.-full $R^2$ | Interp. | Ext. N | Ext. D |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Chinchilla | 0.998 | 0.28±0.07 | 0.93±0.16 | 0.60±0.04 | 0.991 | 0.59±0.06 | 1.93±0.18 | 1.60±0.12 | 0.993 | 0.63±0.15 | 1.16±0.33 | 0.63±0.06 |
| +dom | 0.998 | 0.29±0.06 | 0.80±0.06 | 0.65±0.05 | 0.991 | 0.61±0.06 | 1.99±0.09 | 1.60±0.11 | 0.991 | 0.59±0.26 | 1.52±0.14 | 0.47±0.02 |
| Skaling | 0.999 | 0.24±0.09 | 0.67±0.19 | 0.26±0.06 | 0.993 | 0.51±0.11 | 1.51±0.59 | 1.23±0.50 | 0.993 | 0.61±0.14 | 1.28±0.29 | 0.51±0.03 |
| +dom | 0.999 | 0.23±0.09 | 0.60±0.12 | 0.24±0.06 | 0.994 | 0.50±0.15 | 1.57±0.43 | 1.27±0.41 | 0.990 | 0.64±0.25 | 1.43±0.24 | 0.44±0.03 |
(Chinchilla 实测数据非网格结构,无 L 形与 far 集;Farseer-code 的 far 集只有一个留出 run,故略去。两个变体来自同一次拟合运行,故 baseline 数值与 Table 1 可能有微小出入。)
结论很有信息量:dominated-pair 拟合主要是给加性 Chinchilla 律做的一次矫正。它在两个数据集上都减小了 Chinchilla 的大部分外推误差,在最看重地板准确度的边界 regime 增益最明显——全网格 far 外推从 2.46% 降到 0.79%(Farseer)、从 5.17% 降到 3.67%(SK-Grid),佐证了"Chinchilla 相当一部分外推误差源于 $E$ 的弱辨识"。又因为 Chinchilla 形式本身没有完美刻画曲面全局形状,dominated-pair 目标实质上隐式重新加权了数据,迫使优化更多锚在极端边界点上。相比之下这个矫正对 Skaling 没有一致改善——某种意义上说明 Skaling 本就没有靠 $E$ 代偿曲率。
预训练细节(SK-Grid)
模型按宽度与深度同时增长缩放,$d_{\rm model}$ 从 672 到 3264,深度从 7 层到 34 层,统一用 Llama 3 tokenizer(词表 128,256)。每个规模在 316M–316B tokens 的几何阶梯上训练(每十倍 5 档);单 run 算力设了上限,越大的模型档数越少,形成阶梯状网格。
Table 7 SK-Grid model configurations
| $N$ | $d_{\rm model}$ | Layers | Heads | $d_{\rm head}$ | Budgets |
|---|---|---|---|---|---|
| 134M | 672 | 7 | 14 | 48 | 16 |
| 177M | 864 | 9 | 9 | 96 | 16 |
| 234M | 960 | 10 | 10 | 96 | 15 |
| 308M | 1056 | 11 | 11 | 96 | 14 |
| 407M | 1248 | 13 | 13 | 96 | 11 |
| 537M | 1440 | 15 | 15 | 96 | 11 |
| 708M | 1632 | 17 | 17 | 96 | 9 |
| 935M | 1824 | 19 | 19 | 96 | 9 |
| 1.23B | 2016 | 21 | 21 | 96 | 7 |
| 1.63B | 2208 | 23 | 23 | 96 | 5 |
| 2.15B | 2496 | 26 | 26 | 96 | 5 |
| 2.83B | 2688 | 28 | 28 | 96 | 4 |
| 3.74B | 2976 | 31 | 31 | 96 | 2 |
| 4.93B | 3264 | 34 | 34 | 96 | 1 |
两个 run 相关的超参(全局 batch size $B$ 与峰值学习率 $\eta$)按 StepLaw 处方给出,写成每 token 算力 $F$(模型规模的单调代理)与 token 预算 $D$ 的幂律,系数在本文自己的设置上重新拟合:
$$B = 896.07\, F^{0.231}, \qquad \eta = 0.0709\, F^{-0.4303} D^{0.2785} \tag{20}$$
Table 8 Fixed configuration shared by all SK-Grid runs
| 类别 | 项 | 取值 |
|---|---|---|
| Architecture | Position enc. | RoPE ($\theta = 10^4$) |
| Vocabulary | 128,256 | |
| Sequence len. | 2048 | |
| Optimization | Optimizer | AdamW |
| $(\beta_1, \beta_2)$ | (0.9, 0.95) | |
| Weight decay | 0.1 | |
| Grad. clip | 0.1 | |
| LR schedule | cosine | |
| Warmup | 10% | |
| Final LR | $1 \times 10^{-6}$ |
其余设置沿用 Meta Lingua 默认值。所有 run 同一数据配比:60% DCLM-Edu 网页文本 + 30% code + 10% math,拟合的 loss 是该混合的留出集验证 loss。
数值微分的两套估计器
Section 2 的诊断依赖两套无网格导数估计。MLS(局部)在每个查询点 $x^\star$ 邻域内拟合截断 Taylor 展开 $z(x_i) \approx c_0 + g^\top \Delta x_i + \frac{1}{2}\Delta x_i^\top H \Delta x_i + \cdots$,把系数摊平成向量 $c$,对 $k$ 近邻做距离加权岭回归:
$$\hat{c} = \left(\Phi^\top W \Phi + \lambda I\right)^{-1} \Phi^\top W z \tag{21}$$
$\Phi$ 是设计矩阵(每行为一个邻点的多项式基,含交互项 $\Delta x_{i,1}\Delta x_{i,2}$),$W$ 是高斯权重对角阵 $w_i = \exp(-\|\Delta x_i\|^2/\sigma^2)$(带宽 $\sigma$ 随邻域半径动态缩放),$\lambda I$ 保证数值稳定。解出后一阶块给出梯度,$\Delta x_{i,1}\Delta x_{i,2}$ 的系数正是所需的混合偏导。缺点是纯依赖局部几何,对噪声、邻域大小 $k$ 与多项式次数 $p$ 敏感。
GP(全局)对所有点拟合高斯过程再对后验均值闭式求导。微分是线性算子,GP 的导数仍是 GP,且权重 $\alpha = (K + \sigma_n^2 I)^{-1} z$ 与查询点无关:
$$\widehat{\frac{\partial z}{\partial x_j}}(x^\star) = \frac{\partial \hat{z}(x^\star)}{\partial x_j} = \frac{\partial k(x^\star, X)}{\partial x_j}\alpha \tag{22}$$
用 RBF 核时 $\partial k(x, x')/\partial x_j = k(x,x')(x'_j - x_j)/\ell_j^2$,计算精确。GP 还给出梯度的闭式预测方差
$$\mathrm{Var}\left[\frac{\partial z}{\partial x_j}(x^\star)\right] = \frac{\partial^2 k(x, x')}{\partial x_j \partial x'_j}\bigg|_{x = x' = x^\star} - \frac{\partial k(x^\star, X)}{\partial x_j}\left(K + \sigma_n^2 I\right)^{-1}\frac{\partial k(X, x^\star)}{\partial x_j} \tag{23}$$
与 MLS 需手调邻域和次数不同,GP 显式建模观测噪声并靠最大化边缘似然自动调长度尺度。两套估计器互相独立,在 Figure 6 给出两条彼此印证的经验前沿——这种用机制迥异的估计器交叉验证同一结论的做法,显著提高了 Section 2 的可信度。
核心贡献总结
- 把函数形式之争变成可证伪的实证问题:用无参数数值微分直接测混合偏导,证明加性律隐含的 $\partial^2 L/\partial N \partial D \equiv 0$ 被数据否定,符号为负(协同)。
- Skaling 形式(Eq. (7)):只加一个外指数 $k$,在 Chinchilla($k=1$)与 Kaplan(内指数绑定)之间架桥,既恢复耦合又保留独立内指数、单调性与可解释性。
- 乘性耦合优于加性交互项的机制论证:加性乘积项的符号无法兼顾单调性与负混合偏导;乘性因子 $u^{k-1}$ 构造上相容,并顺带解释一阶跨斜率的不对称。
- 闭式 compute-optimal 分配得以保留:外映射不移动极小点,$R_{\rm opt}$ 保持解析形式,但参数不转移使数值处方与 Chinchilla 差异巨大(前沿尺度 10×–100×)。
- L 形稀疏 profiling:耦合形式由边界锚定,只需扫两条低算力边,约 1/10 拟合算力即可复原全网格律。
- 诚实的负面结果:耦合弱的数据集上增益回落至持平;明确讨论 $E \approx 0$ 的辨识歧义,并指出分配趋势方向是数据集相关的。
与已归档相关工作的对比
Prescriptive Scaling Laws for Data Constrained Training Prescriptive Scaling Laws for Data Constrained Training (Cornell University, 2026-05-02)
关系:独立并发(本文未引用该工作,两者殊途同归甚至正面相左)· 已加载对方精读
- 共同关注的问题:两篇指向同一个 root cause——Chinchilla 的加性可分结构缺失了 $N$ 与数据轴之间的交互项,导致网格边界系统性偏差。Cornell 的说法是"更大的模型在同样的重复数据上过拟合更快,这种 model size × repetition 交互被既有 scaling law 完全错过";本文的说法是"$\partial^2 L/\partial N\partial D \equiv 0$ 是被数据否定的结构性假设"。两者都强调失效不在拟合流程而在函数形式。
- 相近的技术骨架:都走"残差诊断 → 定位缺失结构 → 加最少的参数补上 → 交叉验证外推误差验证"。Cornell 明确构造 1p/2p/4p 复杂度阶梯论证"一个参数就够",与本文"只加一个 $k$"姿态一致;两者也都强调新形式在退化点(Cornell 的 $R_D=0$、本文的 $k=1$)精确回落到 Chinchilla。
- 本文的差异与推进:修补方向恰好相反,且本文给出了拒绝对方那条路的机制论证。Cornell 的解法正是本文 Appendix A.2 否决的"加性交互项":$P \cdot R_D^\delta (N/U_D^\gamma)^\kappa$ 是符号为正的加性乘积项,让 loss 随 $N$ 增大而回升。本文论证加性乘积项无法同时保住单调性与负混合偏导,故改用恒正乘性因子。这个冲突并非谁错,而是两者刻画标度曲面上不同区域:本文网格是单 epoch、数据充足,测到协同(负混合偏导);Cornell 网格是多 epoch 重复(最高 16 epochs、$N \gg D$),测到拮抗。合起来看,$N$–$D$ 交互在不同 regime 下符号相反,说明单一固定符号的修补都是局部的。
- 可比的方法/实验差异:本文两个自由度、6 参数、按四类外推 regime 报 MAPE,最大网格 404 点 / $5\times10^{22}$ FLOPs;Cornell 引入第三轴($U_D$ 与额外 epoch 数 $R_D$),训练 300+ 模型(15M–1B),用 $R^2_{\rm multi}$ 与 Huber loss 评测,1p 形式把 multi-epoch $R^2$ 从 0.58 提到 0.95。本文完全未触及多 epoch(正文 "epoch" 一词不出现),Cornell 也没检验单 epoch 网格的混合偏导——实验覆盖近乎互补。
Practical Scaling Laws: Converting Compute into Performance in a Data-Constrained World Practical Scaling Laws: Converting Compute into Performance in a Data-Constrained World (Arena Physica, 2026-05-09)
关系:独立并发(本文未引用该工作)· 已加载对方精读
- 共同关注的问题:同样把矛头对准"Chinchilla 形式在被标定的 regime 之外结构性失效"。Arena Physica 列出三条结构性缺失(无基线饱和、过拟合不可达、没有独立于 $(N,D)$ 的算力轴),本文列出一条($N$–$D$ 不可分)。判据也一致:不看内部拟合优度,看留出外推——本文强调"Chinchilla 插值 $R^2$ 达 0.995 却在边界差数倍",对方以 5 个公开 LLM grid 的 held-out RMSE 为主战场。
- 相近的技术骨架:两者都在 Chinchilla 的内层和式外面套一个非线性外映射来引入耦合——本文是幂映射 $u \mapsto u^k$,对方是饱和包装器 $h \mapsto h/(1+h)$(也测试过 $1-e^{-h}$)。两者都证明形式在小参数极限下退化回 Chinchilla(本文 $k \to 1$;对方 $h \ll 1$ 线性展开),并据此论证是既有实践的严格推广;连"外映射不损失可解析性"这个卖点都共通。
- 本文的差异与推进:本文走极简主义——只加一个参数(共 6 个),并用 Farseer 9 参数律作反例论证"增益不来自参数量而来自归纳偏置匹配";对方走表达力最大化,8 个自由参数、三项分解(undercapacity / undertraining / overfitting)外加第三变量 $T$。更关键的是本文多了对方没有的一环:先用无参数数值微分确认交互存在、测出其符号与幂律衰减率,再据此挑形式——Skaling 的外指数是被数据"指认"出来的,而非从目标极限行为反推。反过来,对方的 $L_0$ 上界与过拟合 U 形是本文形式结构上表达不了的(Skaling 对 $N$ 严格单调递减,$D \to 0$ 时也不饱和到 $L_0$)。
- 可比的方法/实验差异:本文在 4 个数据集上交叉验证,最强结果是 SK-Grid far 外推 MAPE 从 5.17 降到 0.70;对方在 4 个 architecture-domain 对(MNIST / CIFAR-100 / Darcy / TinyStories)自训网格外加 5 个公开 LLM grid 重拟合,报告平均比第二名低 49% 的 held-out RMSE。本文额外贡献了对方完全没有的维度——采样几何(L 形网格把 profiling 算力降到约 1/10),这是从"形式由边界锚定"直接推出的工程红利。
讨论与局限性
值得借鉴的设计。 第一,先做假设检验再选形式:多数标度律论文的做法是"提出更花哨的形式 + 展示拟合更好",本文却先把"加性是否成立"变成可证伪判据($\partial^2 L/\partial N\partial D$ 是否为零),再让形式去满足测量结果。这套方法论可原样迁移到任何函数形式之争。第二,嵌套设计带来低风险:Chinchilla 是 $k=1$ 的特例,数据不支持耦合时 Skaling 自动贴回加性拟合,最坏情况持平。第三,形式的性质导出实验设计:L 形网格不是省钱技巧,而是从"耦合由边界锚定"推出来的,并有 Table 1 的 L-shape 面板佐证。第四,Appendix A.2 的符号论证是真正从机制上排除竞争方案,而非靠实验跑赢。
局限与争议。 其一,$E$ 的辨识歧义并未解决:Farseer 上 $E$ 被压到 0.03,作者自承是"没有 run 达到饱和尺度,数据定不住衰减项与地板的劈分",即强外推精度部分来自把曲率吸收进 $k$,该劈分在更大尺度是否仍成立本文无法回答;Table 9 中 Farseer L-shape 的 Skaling+dom far 误差反而从 1.57 恶化到 5.87,暗示某些自由度已被用尽。其二,增益高度依赖数据集:$k$ 在 Farseer/SK-Grid 上 0.31–0.45,在 Farseer-code 与原始 Chinchilla 实测上 0.77–0.90,增益回落到持平;作者归因于超参处方差异,但这也说明"$N$–$D$ 耦合"可能不是普适规律而是特定配方的产物。其三,分配方向不稳:Farseer 上 $\alpha<\beta$ 给出递减比值,SK-Grid 上 $\alpha>\beta$ 给出递增,实践者必须在自己的配方上重拟合,不能搬用论文数字。其四,只在 loss 上验证,无下游任务或线上指标,loss 外推准不等于能力预测准。其五,耦合缺机制解释:$k \approx 0.4$ 有用,但"为什么是幂映射、为什么在这个量级"没有回答,$k$ 仍是现象学参数。
工业落地价值。 本文无线上部署,但实用价值直接:只需改一行拟合代码(把内层和式抬到 $k$ 次幂)即可把边界外推误差降低 1.5–3.9×;配合 L 形采样,profiling 算力预算可从 $5\times10^{22}$ 量级降到 $5\times10^{21}$ 量级。考虑到前沿实验室通常锁定固定 token/参数比,而两种处方在前沿算力上可能相差 10 倍乃至累积到 100 倍,修正的潜在价值远超实施成本。对推荐系统扩参研究同样有借鉴:生成式推荐的规模-数据标度多沿用 Chinchilla 加性假设,本文的诊断方法(测混合偏导)可直接用来检验它在推荐场景是否成立。