Loop the Loopies!¶
IQuest Research,arXiv 2607.16051v2(2026-07-17 首版,07-20 更新)。开源模型 Loopie-20B-A2B / Loopie-6B-A0.6B,配套
megatron-loopie与vllm-loopie。
研究动机与背景¶
Looped Transformer(循环 Transformer)的思想最早由 Universal Transformers(Dehghani et al., 2019)确立:不再堆叠彼此独立的层,而是把同一组参数在一次前向里反复执行若干轮。这条线在语言建模、算法学习、抽象推理上都有亮眼结果,近年更被推到十亿参数级——Ouro 做到 1.4B / 2.6B、4 个循环步(Zhu et al., 2025),Huginn 做到 3.5B、32 个循环步(Geiping et al., 2025)。
但本文指出,这些成绩掩盖了一个算力记账问题:把模型循环 $N$ 次,预训练算力也随之乘以 $N$。因此循环模型不该只跟"同参数量的普通 Transformer"比,而必须跟"同预训练算力预算下的非循环 Transformer"比。按这个口径重新换算:
- Ouro-2.6B 用 4 个循环,对手应该是 $2.6\text{B} \times 4 = 10.4\text{B}$ 量级的模型;
- Huginn-3.5B 用 32 个循环,对手应该是约 112B 参数的模型。
这个换算一做,循环的优势就不再显然。既有文献本身也支持这个怀疑:在固定 FLOP 的对比下,循环模型的非循环容量反而少于标准 Transformer(Csordás et al., 2024;Frey et al., 2026b),主流观点是循环改善的是参数效率,而不是算力效率(Lan et al., 2020;Takase and Kiyono, 2023)。这正是循环模型迟迟无法通向旗舰级模型的原因。
于是本文把问题收缩成一句话:
在同一预训练算力预算下,循环 Transformer 能否追平甚至超过普通 Transformer?
除此之外还有第二个现实缺口:现代前沿模型几乎都是 MoE(Qwen3、Kimi K2.5、GLM-5、DeepSeek-V4、MiniMax-M2),而既有循环工作基本停留在稠密骨干上。一个能用的循环架构必须与 MoE 兼容,否则天花板早就被锁死。
Loopie 的回答是 Loopie Recipe——一套算力匹配的扩展配方,它把循环从"省参数的手段"重新定义为"算力匹配的扩展机制"。三项贡献:
- 算力匹配扩展:提出 Loopie Recipe 并用大量消融验证;
- 可扩展的循环 MoE:训出 Loopie-20B-A2B 与 Loopie-6B-A0.6B;
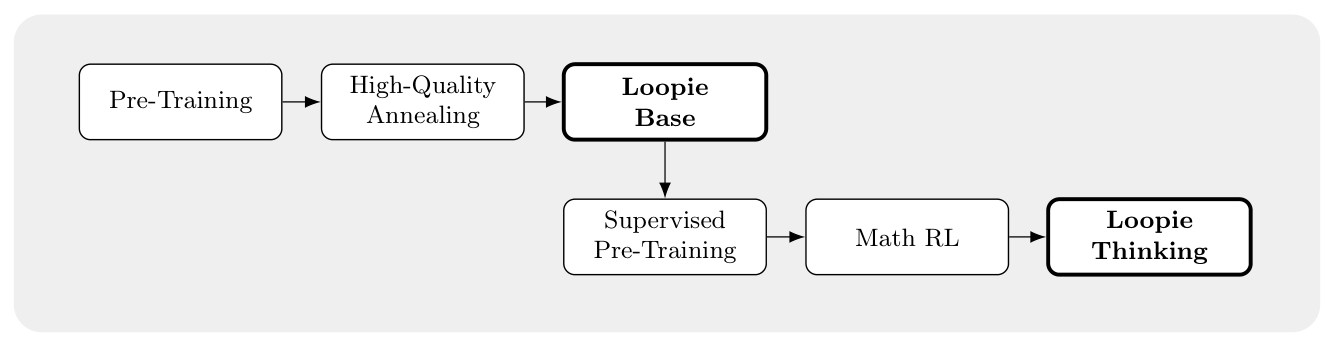
- 大规模后训练:引入 supervised pre-training(SPT)新阶段 + RL,拿到强推理能力。
核心方法 / 模型架构¶
架构:layer-loop 而非 model-loop¶
Loopie 骨干基本沿用 Qwen3-MoE:decoder-only MoE Transformer,注意力机制、稀疏模式等细节与 Qwen3-MoE family 一致(详见附录 Table 4)。唯一的关键差异在于循环怎么施加。
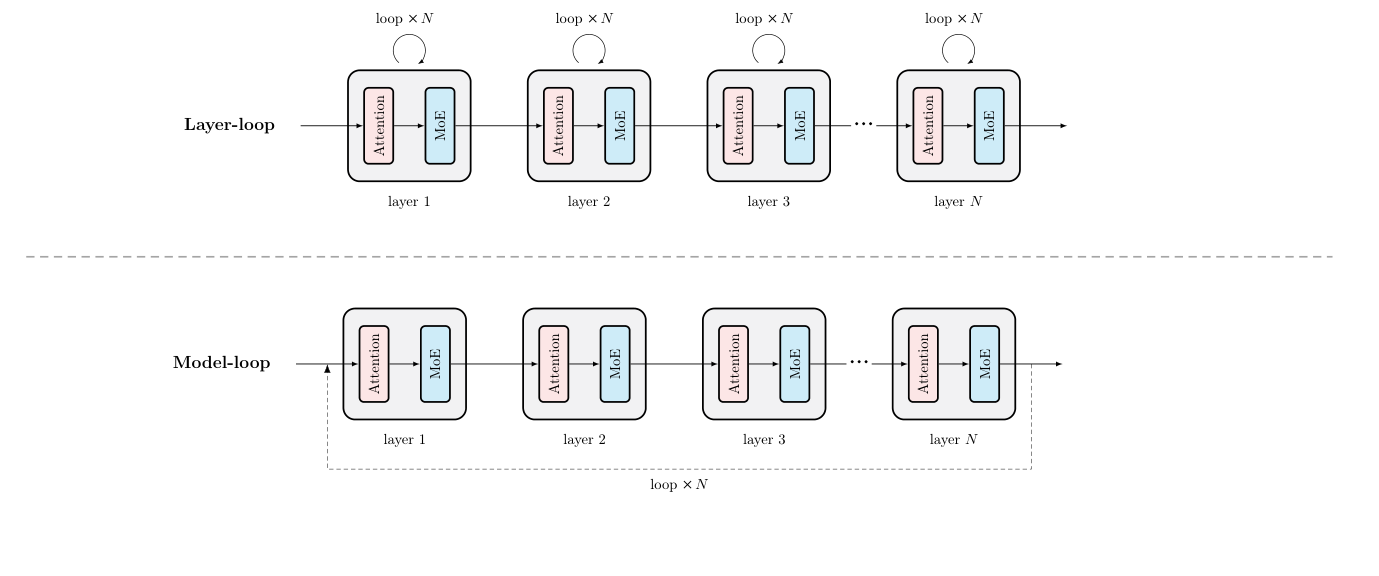
既有循环语言模型(Ouro、Huginn)用的是本文称为 model-loop 的模式:整个 Transformer 栈整体展开循环。三层模型循环两次的执行顺序是
$$\text{Layer 1} \to \text{Layer 2} \to \text{Layer 3} \to \text{Layer 1} \to \text{Layer 2} \to \text{Layer 3}.$$
Loopie 用的是 layer-loop:每一层就地循环完再传给下一层。同样三层两步,顺序变成
$$\text{Layer 1} \to \text{Layer 1} \to \text{Layer 2} \to \text{Layer 2} \to \text{Layer 3} \to \text{Layer 3}.$$
即每个 block 先对隐状态做局部迭代,再把精炼后的循环表示交给下一层。
为什么是 layer-loop?三条理由¶
layer-loop 并不只是循环计算的另一种排序——它改变了迭代精炼发生在模型的哪个位置,因而影响扩展行为、执行效率与跨有效深度的参数共享性质。
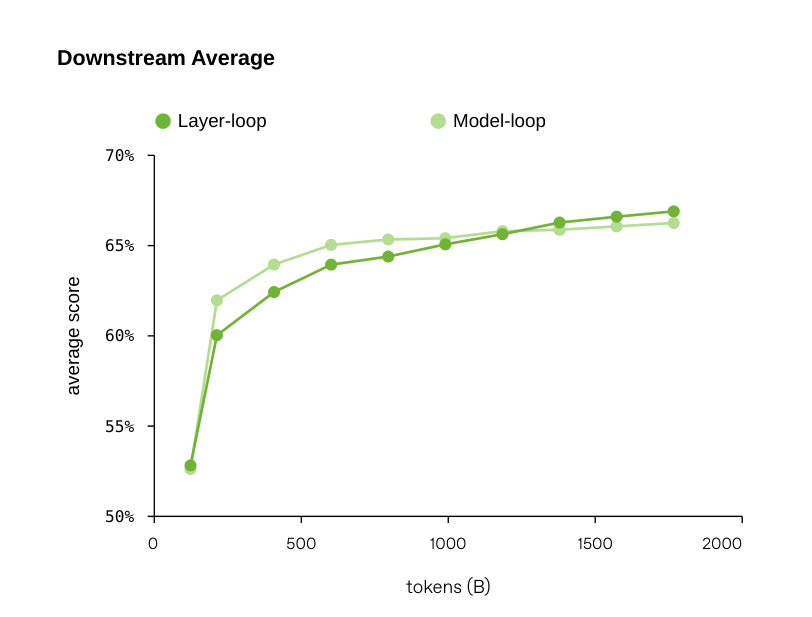
(1)经验扩展更好。 如 Figure 2,在 Loopie-6B-A0.6B 上,layer-loop 早期略落后于 model-loop,但在约 1.2 万亿 token 处反超,此后提升更快。model-loop 的早期优势不会随训练预算增长而保持。
(2)对基础设施友好。 两种模式的名义层执行次数与理论 FLOPs 相同,但 layer-loop 的执行局部性更好:同一层的多次调用在前向和反向计算图上都是相邻的,缩短了参数与梯度贡献的复用距离,简化了 activation checkpointing 和梯度累积——在参数分片或 offload 下尤其明显。对流水线并行的意义最大:一层的所有循环调用都留在同一个 pipeline stage 内,激活才被传往下游;而 model-loop 要求每个 microbatch 反复遍历整条流水线,并在每个循环边界把最后一个 stage 的输出送回第一个 stage,制造出环形依赖,进而恶化调度、增加通信开销与流水线气泡、拉低设备利用率。
(3)参数共享模式更自然。 以 48 层的 Qwen3-30B-A3B 做两步 model-loop 为例:第 3 个物理层会被用在有效深度 3 和 $48+3=51$ 两处。这两次调用前面积累的计算量差异巨大,拿到的隐状态处在相隔极远的有效深度上。已有分析表明 Transformer 表示沿深度的组织是不均匀的——底层与末层跟相对同质的中间层差别很大,不同语言学抽象在网络的不同阶段才最易被读出(Sun et al., 2025;Tenney et al., 2019;Jawahar et al., 2019)。本文谨慎地表述:这些观察并不直接证明存在梯度冲突,但提示相隔极远的有效深度未必该对同一份共享变换提出相同的功能要求。model-loop 等于要求一套参数兼顾异质的、依赖深度的角色;layer-loop 则只在相邻有效深度上复用同一层,共享模式更局部、也可能更自洽。
Loopie Recipe:把循环换成算力匹配的扩展¶
配方从一个强的非循环 MoE 参考模型出发,共三步:
- 构造循环种子模型:把存储层数减半,并设 $R=2$;
- 用 layer-loop 让每个存储层执行两次;
- 把由此得到的显存余量换成两倍的 per-device microbatch,再把实测到的训练效率增益回投为额外模型容量,同时保持 optimizer-step 时间与参考模型大致相等。
本文的匹配口径是实测预训练成本,而非精确的理论 FLOPs。每一组对比都固定硬件分配、序列长度、每个 optimizer step 的 token 数、activation-checkpointing 策略、优化器与训练数据;不同架构可按各自实测显存占用采用不同的 per-device microbatch,microbatch 变大时按比例减少梯度累积步数,使每步 token 数不变。最终架构由 Megatron-LM 中实测端到端训练时间选出。
激活显存与 microbatch 效率。 在本文的 checkpointing 实现下,一个存储层的所有循环调用被包在同一个 checkpoint 单元里,因此主导的激活显存项随存储深度而非执行深度变化:
$$M_{\text{act}} \propto s\,b\,D\,L, \tag{1}$$
其中 $D$ 为隐藏维、$L$ 为存储层数、$b$ 为 per-device microbatch、$s$ 为序列长度。循环次数 $R$ 只增加执行的计算量,并不引入 $R$ 份独立存储的层边界激活。
固定全局 batch $B$ 时,$g = B/b$;把 $DL$ 减小腾出的显存用于增大 $b$,并按比例减少 $g$,全局 batch 不变:
$$b_1 = 2b_0, \qquad g_1 = \frac{g_0}{2}. \tag{2}$$
对固定架构,microbatch 效率增益直接实测为
$$S_{\text{mb}} = \frac{t_{\text{step}}(D, L, R; b, g)}{t_{\text{step}}(D, L, R; 2b, g/2)}. \tag{3}$$
具体实例化。 以 Qwen3-like 30B-A3B 为非循环参考:$D_0=2048,\ L_0=48,\ R_0=1$。第一步构造种子:$D=2048,\ L=24,\ R=2$。领先阶预训练算力(Hoffmann et al., 2022)按
$$C(D, L, R) \propto L D^2 R \tag{4}$$
变化。固定宽度下这一变换保持 block 执行次数 $LR = 24\cdot 2 = 48 = L_0R_0$,从而保持领先阶算力代理 $LRD^2 = 48\cdot 2048^2$ 不变;而同 microbatch 下主导激活显存项减半:$\frac{DL}{D_0L_0} = \frac{2048\cdot 24}{2048\cdot 48} = 0.5$。
第二步把 microbatch 效率花在容量上。候选隐藏维限制为 128 的倍数,在种子附近扫 $(D,L)$,保留能支持两倍参考 microbatch 的候选,并报告两个归一化代理:
$$\hat{C} = \frac{LRD^2}{48\cdot 2048^2}, \qquad \hat{M}_{\text{act}} = \frac{DL}{48\cdot 2048}. \tag{5}$$
| Configuration | $D$ | $L$ | $R$ | $\hat{C}$ | $\hat{M}_{\text{act}}$ |
|---|---|---|---|---|---|
| Qwen3 30B-A3B | 2048 | 48 | 1 | 1.00× | 1.00× |
| Seed Loopie | 2048 | 24 | 2 | 1.00× | 0.50× |
| Loopie candidate 1 | 2176 | 25 | 2 | 1.18× | 0.55× |
| Loopie candidate 2 | 2304 | 27 | 2 | 1.42× | 0.63× |
| Loopie candidate 3 | 2432 | 28 | 2 | 1.65× | 0.69× |
(Table 1:由 Qwen3-like 30B-A3B 参考生成的候选配置。这两个代理只用来描述候选,不用来预测最终 optimizer-step 时间。)
在 Megatron-LM 中对参考模型与每个候选联合搜索 tensor parallelism、expert parallelism 与 microbatch,选出 optimizer-step 实测时间最接近参考的那个:
$$D_1 = 2304, \quad L_1 = 27, \quad R_1 = 2, \tag{6}$$
这就是 Loopie-20B-A2B。其激活显存代理为 $\frac{2304\cdot 27}{2048\cdot 48} \approx 0.633$,实测显存画像允许 per-device microbatch 翻倍;而其领先阶算力代理是
$$\frac{\hat{C}_1}{\hat{C}_0} = \frac{27\cdot 2\cdot 2304^2}{48\cdot 2048^2} \approx 1.424. \tag{7}$$
这是本文最需要看清的一点:Loopie 并不在理论 FLOPs 上与参考相等(它多做约 42% 的名义计算),匹配的是
$$t_{\text{step}}(D_1, L_1, R_1; 2b_0, g_0/2) \approx t_{\text{step}}(D_0, L_0, R_0; b_0, g_0), \tag{8}$$
即实测 optimizer-step 墙钟时间。多出来的名义计算被更高的实测硬件利用率抵消掉了,效率增益完全来自 microbatch 翻倍。本文对此非常坦率:领先阶算力代理忽略了低阶算子、路由与通信成本、优化器与 kernel 启动开销以及 microbatch 调度对实际硬件利用率的影响,因此只用于刻画名义工作量,不能替代端到端计时。作者称已在多个 GPU 平台上验证了这套配方并观察到一致的基础设施层收益。
关键技术细节:预训练¶
预训练分两阶段,全程使用 Megatron-LM 与 Qwen3 tokenizer。
初始化。 令 $d$ 为模型宽度。token embedding 矩阵 $E$ 与 LM head $W_{lm}$(权重绑定时为共享的 embedding/unembedding 矩阵)初始化为 $E_{ij}, (W_{lm})_{ij} \sim \mathcal{N}(0, d^{-1})$;输入侧查表得到的 embedding 在进入残差流前乘 $\sqrt{d}$,使 embedding 捷径的激活尺度为 $O(1)$,同时 $d^{-1}$ 的方差保证归一化隐状态下初始 logits $h^\top w$ 的方差为 $O(1)$。Transformer block 内部的隐-隐参数(注意力投影与 FFN)用 SmallInit:
$$W_{ij} \sim \mathcal{N}\!\left(0, \frac{2}{5d}\right), \qquad \operatorname{std}(W) = \frac{1}{\sqrt{2.5d}}. \tag{9}$$
这个尺度对应 FFN 扩张比为 4 的 Transformer 的 Xavier fan-in/fan-out($d_{in} + d_{out} = d + 4d = 5d$),并同样施加于注意力投影以压低残差分支子层的尺度。于是 embedding/unembedding 用 $d^{-1/2}$(决定捷径与 logit 尺度),block 子层用 $(2.5d)^{-1/2}$(其 Jacobian 应保持小以稳定预训练)。
学习率调度。 AdamW,峰值学习率 Loopie-6B-A0.6B 为 $5\times 10^{-4}$、Loopie-20B-A2B 为 $3\times 10^{-4}$;$\beta_1=0.9,\ \beta_2=0.95,\ \epsilon=10^{-15}$,weight decay 0.1,全局梯度裁剪 1.0。用 warmup-stable-only(无衰减)调度:20B 模型 warmup 6,000 步、6B 模型 2,000 步,之后学习率恒定不衰减。这样做是为了保持 warmup 后的有效更新尺度,避免退火调度下后期高质量数据影响力被稀释。Stage 2 高质量退火期同样用恒定学习率。全局 batch 1024,序列长度 8192。
Stage 1(多轮次高质量预训练)。 在 Nemotron-CC-v2-HQ(约 570B unique token)上训练 4 个 epoch,合计约 2.28T token。依据是作者此前的观察:在高质量数据上重复训练可能优于在平均质量更低的更大语料上单轮训练。
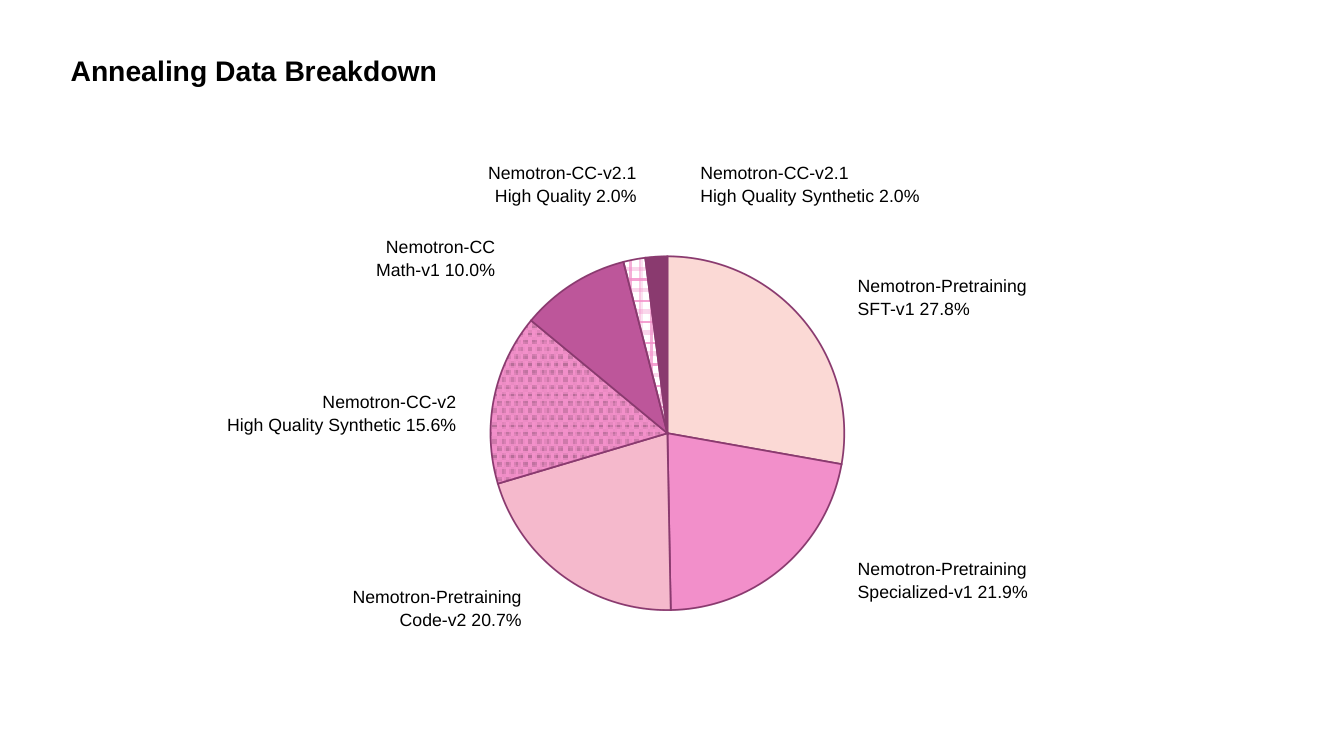
Stage 2(高质量退火)。 从 Nemotron 预训练数据集构造约 1.26T token 的退火混合:
| 来源 | token | 占比 |
|---|---|---|
| Nemotron-pre-training-SFT-v1 | 351B | 27.8% |
| Nemotron-pre-training-Specialized-v1 | 277B | 21.9% |
| Nemotron-pre-training-Code-v2(60% 采样) | 262B | 20.7% |
| Nemotron-CC-v2-HQ-Synthetic(16% 采样) | 197B | 15.6% |
| Nemotron-CC-Math-v1(质量分 ≥4) | 126B | 10.0% |
| Nemotron-CC-v2.1-HQ | 25B | 2.0% |
| Nemotron-CC-v2.1-HQ-Synthetic | 25B | 2.0% |
因此 预训练总量 = 2.28T + 1.26T ≈ 3.5T token——这个数字是后面 Table 3 里"token 效率"叙事的基础。
评测口径。 Section 2 的所有实验用 LM Evaluation Harness,报告八个 benchmark 的均值:ARC-Challenge、ARC-Easy、BoolQ、CommonsenseQA、HellaSwag、MMLU、OpenBookQA、WinoGrande。
主要实验结果¶
算力匹配对比:Loopie-20B-A2B vs Qwen3-30B-A3B¶
用 Qwen3-MoE 设计训了一个 vanilla 30B-A3B MoE,在与 Loopie-20B-A2B 相同的预训练算力预算下跑 800B token。结果:Loopie 训练早期落后于更大的 vanilla baseline,但在约 600B token 后反超,此后保持稳定优势。吞吐侧,Loopie-20B-A2B 达到 261.53 TFLOPS/s,Qwen3-30B-A3B 为 189.65 TFLOPS/s(Loopie 用 EP=8、MBS=2,Qwen3 用 EP=8、MBS=1,均为大规模 TP/PP/EP/MBS 网格搜索的最优点)。
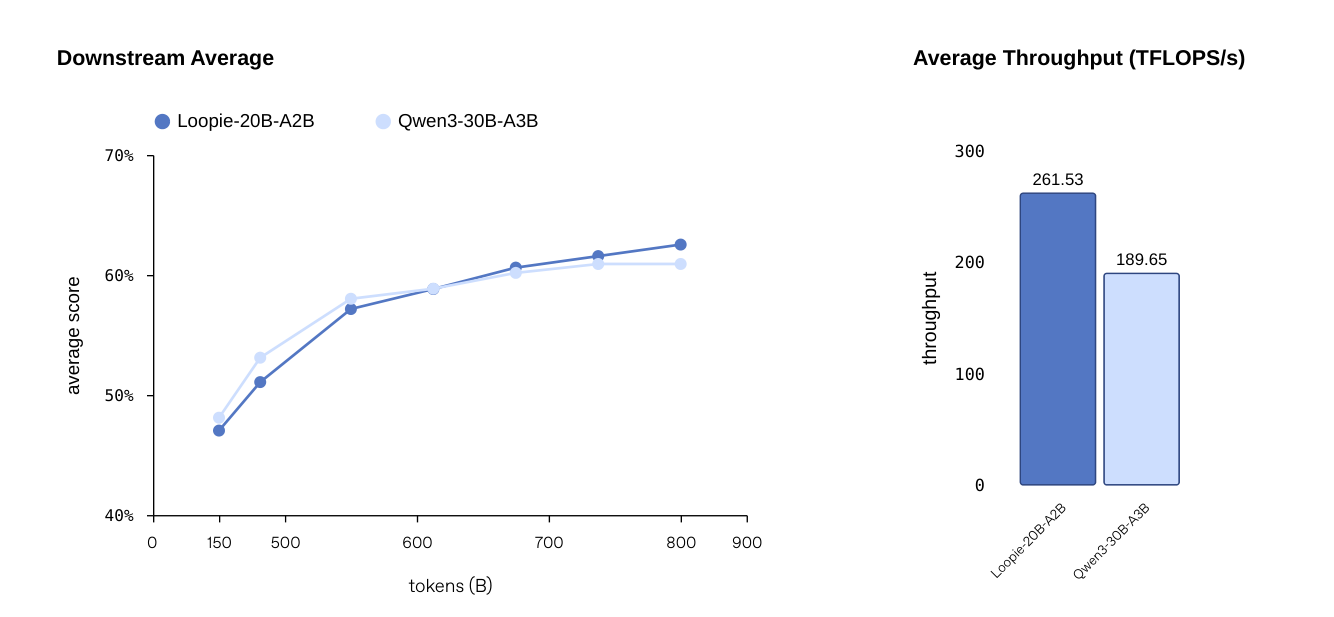
结论分析:+38% 的吞吐正是"多做 42% 名义计算却不多花墙钟时间"的来源。反超点出现在 600B token 而不是训练一开始,说明循环带来的不是即时增益,而是一种后期才兑现的容量优势——这与 Figure 2 里 layer-loop 1.2T token 才反超 model-loop 是同一种现象,也意味着小规模短训练的对比会系统性低估这条路线。
扩展阶梯(Scaling Ladder)¶
为验证优势不是单点巧合,本文构造了 4 级阶梯:4 个非循环 MoE baseline,以及用 Loopie Recipe 变换得到的 4 个算力匹配 Loopie 模型。每个参考模型的训练 token 数取其 活跃 MoE 参数量的 1000 倍,确保充分过训练、下游指标已趋稳;对应的 Loopie 用相同 token 预算(尽管其活跃参数更少)。
| Rung | Model | Total Params | Active Params | $L$ | $D$ | $D_{\text{MoE}}$ | Heads | Head Dim | $N$ | Width/Depth | Tokens |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Vanilla | 1.34B | 0.15B | 27 | 640 | 192 | 20 | 32 | 1 | 23.70 | 150B |
| 1 | Loopie | 1.08B | 0.11B | 15 | 704 | 256 | 22 | 32 | 2 | 23.47 | 150B |
| 2 | Vanilla | 2.37B | 0.25B | 30 | 768 | 256 | 24 | 32 | 1 | 25.60 | 250B |
| 2 | Loopie | 1.81B | 0.18B | 17 | 832 | 320 | 26 | 32 | 2 | 24.47 | 250B |
| 3 | Vanilla | 4.76B | 0.51B | 36 | 1280 | 320 | 32 | 40 | 1 | 35.56 | 500B |
| 3 | Loopie | 3.78B | 0.41B | 19 | 1280 | 384 | 32 | 40 | 2 | 33.68 | 500B |
| 4 | Vanilla | 9.14B | 1.00B | 46 | 1280 | 384 | 40 | 32 | 1 | 27.83 | 500B |
| 4 | Loopie | 6.36B | 0.68B | 25 | 1408 | 448 | 44 | 32 | 2 | 28.16 | 500B |
(Table 7:扩展阶梯的架构细节。$N$ 为 layer-loop 步数,Width/Depth = $D/(LN)$。注意 Loopie 一侧的存储参数量始终更少——匹配的是算力,不是参数。)
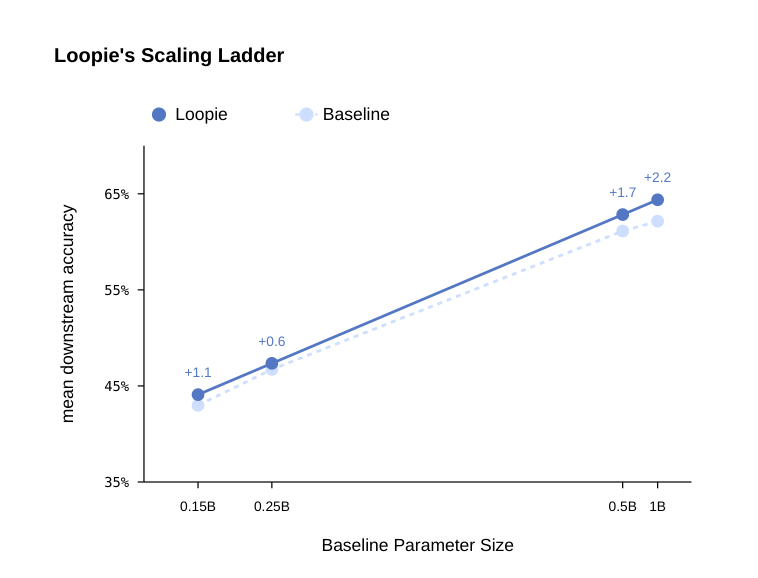
四级阶梯上的增益分别为 +1.1 / +0.6 / +1.7 / +2.2 分。
结论分析:关键不在于"每一级都赢",而在于 gap 没有随模型增大而消失(0.15B→1B 时增益从 +1.1 走到 +2.2,虽非单调但趋势向上)。这是对"小模型 artifact"这一最常见质疑的正面回应。需要留意 rung 4 因算力受限只训了 500B token(按 1000× 规则本应 1T),所以最大那一级实际是欠训的,其 +2.2 的增益读数应打一点折扣。
消融与分析¶
layer-loop 本身贡献多少?¶
训练一个 6B-A0.6B MoE,骨干、优化器、数据混合、token 预算都与 Loopie-6B-A0.6B 相同,只去掉 layer-loop 模式。图中标注 2.14× speedup。
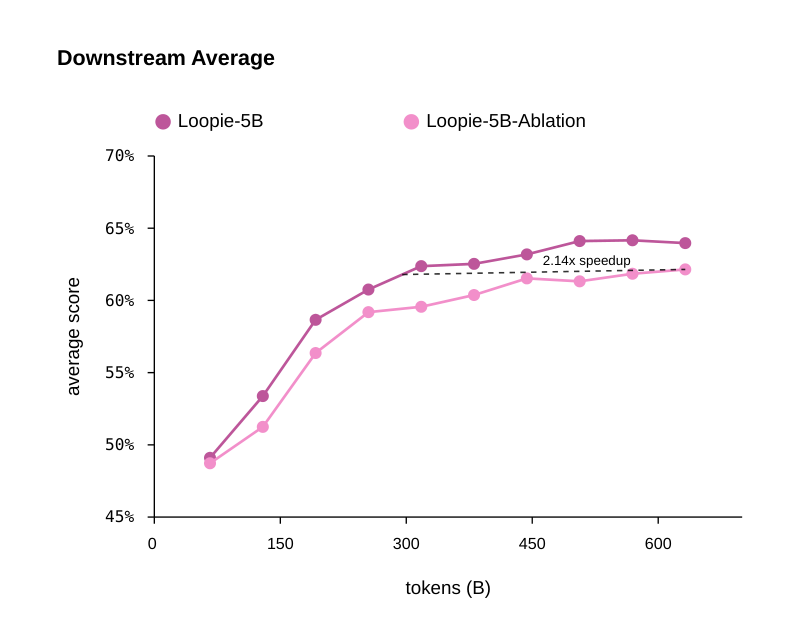
结论分析:作者强调"活跃参数量与总计算预算都没有增加,因此提升不能简单归因于额外计算"。但这里存在一处表述冲突:正文说消融模型"保留了整体循环计算预算(preserves the overall looped computation budget)",而图注说的是"去掉 layer-loop 循环"。若真的去掉循环而其余不变,计算量应当减半,两句话不能同时成立;论文没有给出消融模型的具体配置(是换成 model-loop?还是补足层数的非循环变体?)。这是全文实验描述最含糊的一处。此外图例写的是 "Loopie-5B / Loopie-5B-Ablation",与正文的 6B-A0.6B 命名不一致。
N× 循环 vs N× 存储层¶
为区分"收益来自循环"还是"来自单纯多堆不共享的层",本文把 $N\times$ layer-loop 与 $N\times$ 存储层数的模型在其余架构完全固定下对比,各训 250B token,$N = 2, 3, 4$。
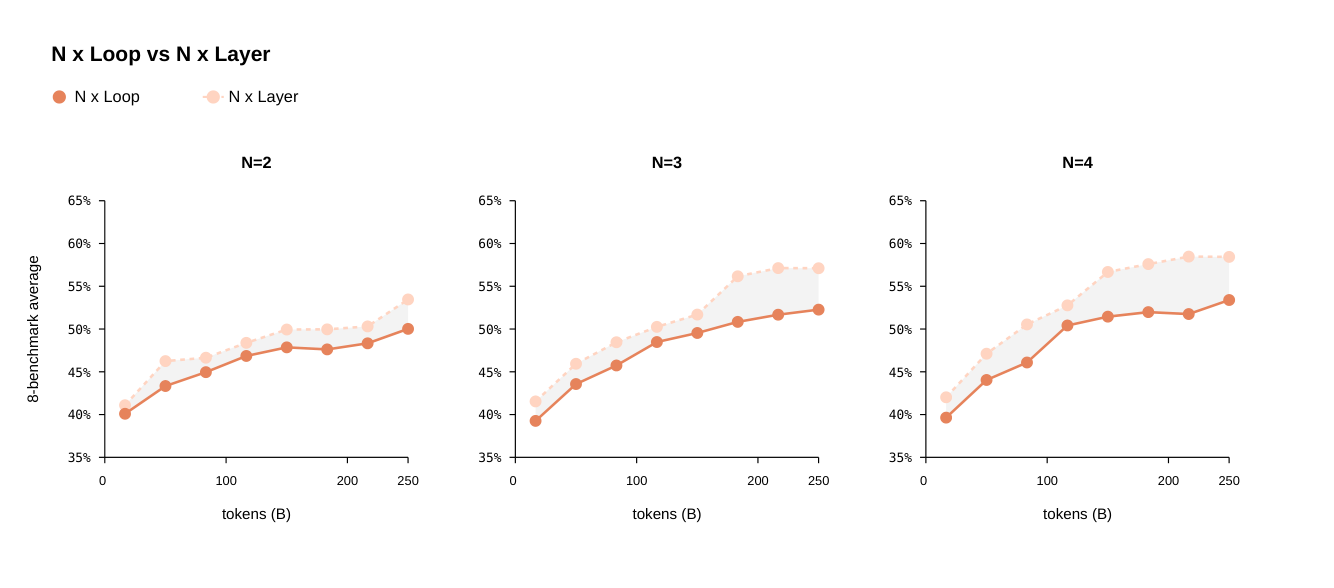
结论分析:作者自己给出了一个重要的免责声明——$N=2$ 那一组里,2× 存储层 baseline 只是"保守代理",因为该模型只有 0.25B 活跃参数,精确算力匹配困难,该 baseline 的实际训练算力明显高于 2× loop 模型。所以这张图不能被读成"2× 循环被 2× 层扩展压制";它要说明的是:在 $N\times$ 循环对 $N\times$ 存储层的横向比较中,循环的边际收益在 $R=2$ 时最大。这种主动标注不利读法的做法值得肯定。
为什么只用两个循环步?¶
既有循环/潜在递归模型常用 4、16 甚至 30+ 步。Loopie 只用 2,理由是它面对的是固定算力预算下的大规模预训练:循环步数不是普通架构超参,而是预训练 FLOPs 的直接分配。由 $C(D,L,R) \propto LD^2R$,每 token 训练成本随 $R$ 近似线性增长;同预算下要么少训 token、要么缩小存储架构、要么去对上一个把同样算力花在普通 Transformer 容量上的更强非循环模型。真正的问题不是"$R=4$ 在同存储尺寸下是否胜过 $R=2$",而是额外循环的边际收益是否超过把同样 FLOPs 重新分配给宽度、深度或数据所能得到的收益。
$R=2$ 是最小的非平凡循环设定:每层做一次普通变换 + 一次局部精炼。它让循环质变地改变计算,同时把算力乘数压到可扩展预训练能承受的范围,还保住了训练吞吐,并使"对上 Qwen3-like vanilla MoE"这个对比变得严苛——Loopie 必须靠少量循环用得更好取胜,而不是靠大量额外循环计算。作者同时声明这不等于"大 $R$ 无效":在推理算力便宜、有自适应计算、或研究目标本就是循环推理的场景下,更大的 $R$ 仍可能有用。
后训练:Supervised Pre-Training + RL¶
Supervised Pre-Training(SPT)¶
本文提出 SPT:把 SFT 的监督模式与语言模型预训练的优化规模结合。SPT 与 SFT 用完全相同的数据和 token 级目标(prompt 与 context token 不计损失,只有监督目标 token 参与优化),但采用预训练级别的全局 batch、序列长度与 token 预算。
三种范式共用同一个 token 级交叉熵:
$$\mathcal{L}_{\text{CE}}(\theta; w) = -\frac{\sum_{i=1}^{B}\sum_{t=1}^{T_i} w_{i,t}\log p_\theta(z_{i,t}\mid z_{i,<t})}{\sum_{i=1}^{B}\sum_{t=1}^{T_i} w_{i,t}}, \tag{10}$$
对 SPT 与 SFT,$w_{i,t}=1$ 仅当 $z_{i,t}$ 属于监督目标 $y_i$;传统 PT 则对所有非 padding token 取 $w_{i,t}=1$。所以 SPT 不是 SFT 损失与 PT 损失之间的插值——它把 SFT 式的监督目标放进 PT 规模的优化机制里。
| SPT | SFT | PT | |
|---|---|---|---|
| Loss function | Cross-entropy | Cross-entropy | Cross-entropy |
| Loss-bearing positions | 仅监督目标 token | 仅监督目标 token | 所有非 padding token |
| Pre-training metrics | ↑ | ↓ | ↑ |
| Reasoning metrics | ↑ | ↑ | ≈ |
| 多 epoch 后过拟合 | 未观察到 | 观察到 | 未观察到 |
| Global batch size | ≥1,024 | 32–128 | ≥1,024 |
| Sequence length | ≥128 K | 8–32 K | 4–8 K |
| 每 batch 名义 token 位置 | ≥128 M | 128 K–1 M | 8–32 M |
| 总训练 token 预算 | ≥2 T | 10–100 B | ≥4 T |
(Table 2。↑/↓/≈ 表示相对起始 checkpoint 的提升/退化/无实质变化;SFT 一列的代表性配置主要参照 OLMo 3、Nemotron 3 系列与 Step-3.5-Flash。)
SPT 每个全局 batch 处理 1.28 亿 token,约为常规 SFT 的 1000 倍。Loopie-6B-A0.6B 的 SPT 跑了 10 个 epoch、共 2T token,损失平滑下降,epoch 边界没有出现 loss cliff;推理指标(BBH / DROP / AIME / AMC)全程持续上升、无放缓迹象;预训练指标(ARC-Challenge / MMLU)不但没退化反而继续上升。
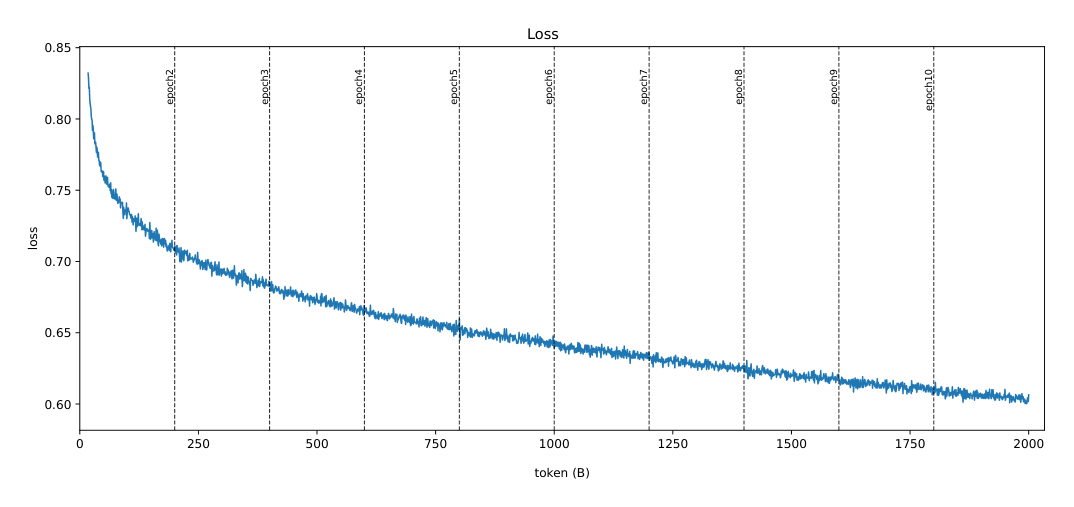
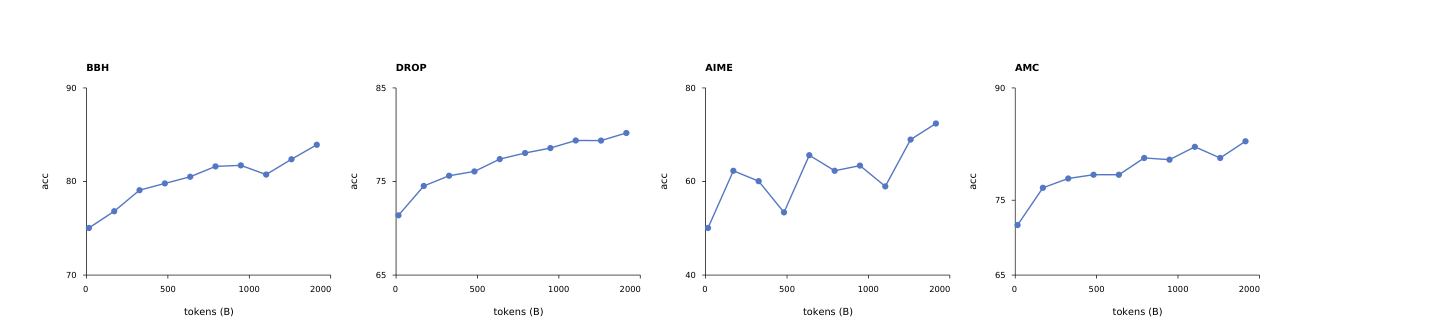
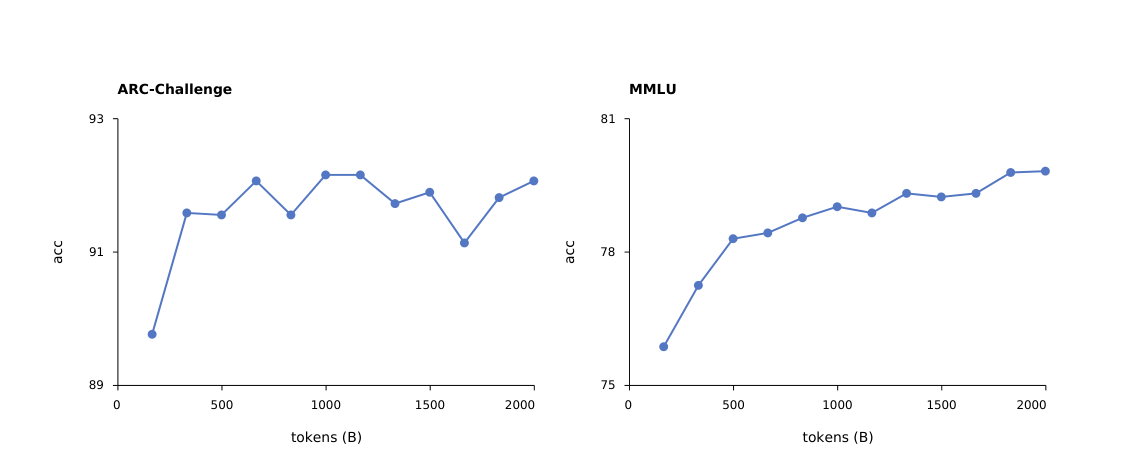
结论分析:这直接挑战了"SFT 必然导致灾难性遗忘"的常规认知。作者的解释是:常规规模 SFT 在第 2–4 个 epoch 之间就开始过拟合——小 batch 下每个 epoch 有大量由小批量算出的参数更新,反复接触相同样本导致快速特化与记忆;而 SPT 的每次更新聚合了一千条以上序列、上亿个名义 token 位置,这种宽梯度聚合加上长上下文与大 token 预算,缓解了重复 SFT 常见的过窄特化。作者明确把这一条写成"我们假设(we hypothesize)",没有当作已证结论。
SPT 超参(Table 8):全局 batch 1024,序列长度 131,072,学习率 $1\times 10^{-5}$,warmup-then-stable,warmup 500 步,MoE 辅助损失系数 0.01。
强化学习¶
SPT 之后做 RL 得到 Loopie Thinking。遵循既有工作,不混合多领域数据(领域特有的长度偏置会互相干扰):先在数学任务上做 RL,饱和后再接代码任务。
算法:基于 GSPO(Zheng et al., 2025),并采用 DAPO 的非对称裁剪与动态采样。对每个 prompt $q$,从旧策略采样 $G$ 条 completion 并由 verifier 打出结果奖励,组内归一化得到序列级优势:
$$\hat{A}_i = \frac{R_i - \operatorname{mean}(\{R_j\}_{j=1}^{G})}{\operatorname{std}(\{R_j\}_{j=1}^{G}) + \epsilon}. \tag{11}$$
GSPO 定义长度归一化的序列级重要性比(即 token 级重要性比的几何平均):
$$s_i(\theta) = \left(\frac{\pi_\theta(o_i \mid q)}{\pi_{\theta_{\text{old}}}(o_i \mid q)}\right)^{\frac{1}{|o_i|}} = \exp\left(\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}\log\frac{\pi_\theta(o_{i,t}\mid q, o_{i,<t})}{\pi_{\theta_{\text{old}}}(o_{i,t}\mid q, o_{i,<t})}\right). \tag{12}$$
长度归一化降低了序列级比值的方差,使不同长度的回复落在可比的数值范围内。序列级裁剪目标为
$$\mathcal{J}^{\text{GSPO}}_{\text{RL}}(\theta) = \mathbb{E}_{q\sim\mathcal{D},\ \{o_i\}\sim\pi_{\theta_{\text{old}}}}\left[\frac{1}{G}\sum_{i=1}^{G}\min\left(s_i(\theta)\hat{A}_i,\ \operatorname{clip}(s_i(\theta), 1-\epsilon_{\text{low}}, 1+\epsilon_{\text{high}})\hat{A}_i\right)\right]. \tag{13}$$
裁剪作用在整条回复上,同一回复的所有 token 共享同一个序列级重要性权重,使 off-policy 修正与优化的单位跟奖励的单位对齐。按 Clip-Higher 策略取 $\epsilon_{\text{high}} > \epsilon_{\text{low}}$:更大的上裁剪范围让正优势的探索性回复获得更强的提概率更新,更保守的下裁剪范围限制负优势回复的概率被过度压低。
再加 prompt 级动态过滤:仅保留采样组中同时含成功与失败样本的 prompt
$$0 < \sum_{i=1}^{G}\mathbf{1}\{R_i = R_{\text{pass}}\} < G, \tag{14}$$
全对或全错的组提供不了相对偏好信号,因此过采候选 prompt 并过滤掉这类组,直到有效 batch 填满。
训练数据:Guru-RL 语料的数学与代码子集(数学来自 OR1 / DAPO / DeepScaleR,代码来自 LeetCodeDataset、TACO-Verified、PrimeIntellect/SYNTHETIC-1 与历史 LiveCodeBench 训练题),并额外做了一遍清洗,去掉畸形 prompt、不可验证答案、flaky 测试、重复样本以及与留出评测集显著重叠的样本。数学奖励用规则化答案等价判定,代码奖励用沙箱单测执行。
训练调度:分两个上下文长度阶段。第一阶段最大回复长度 32K(多数 rollout 自然终止于此,算力高效);当 rollout 截断率超过 10% 时切到 64K 阶段。持续 RL 直到聚合验证分停止提升并开始下降,取持续退化之前的那个 checkpoint 作为 Loopie Thinking。全程监控验证准确率、平均回复长度、生成熵与截断率以侦测后期过优化。
最终评测结果¶
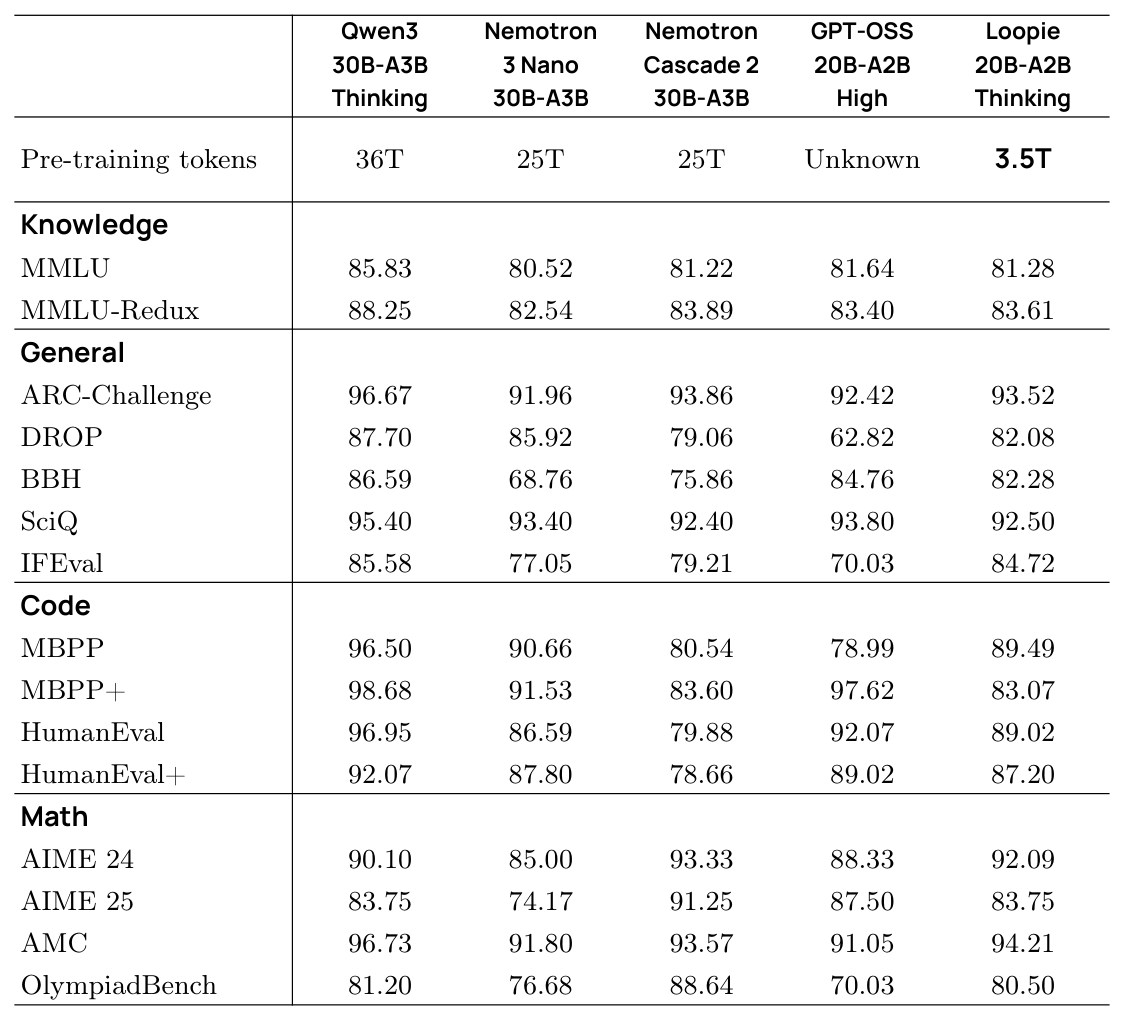
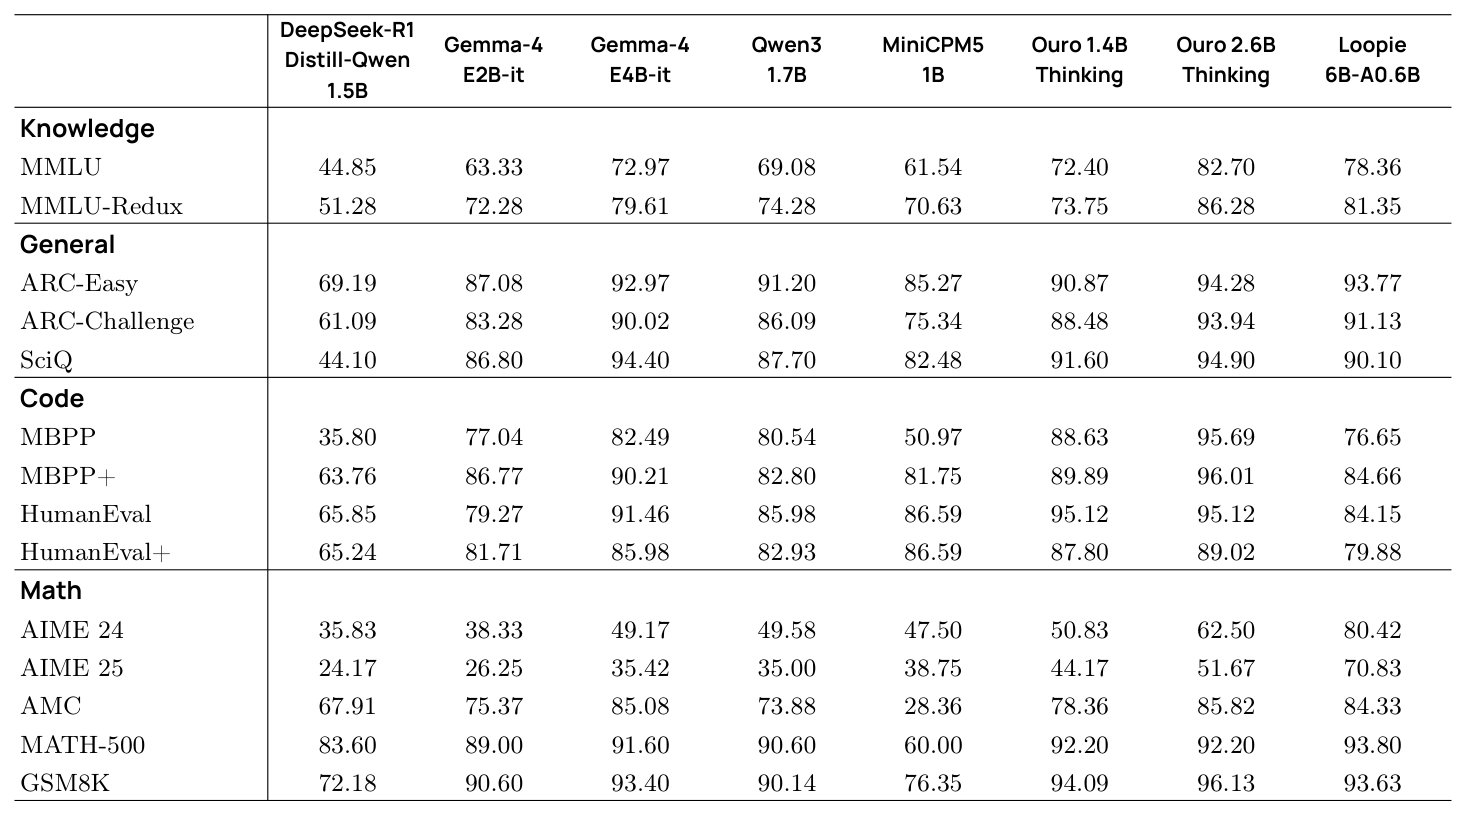
所有评测用 EvalScope 框架,IFEval 取 inst_level_loose,AIME 2024/2025 报 avg@8,其余报 pass@1。
Loopie-20B-A2B vs 同量级 MoE 推理模型¶
| Qwen3 30B-A3B Thinking | Nemotron 3 Nano 30B-A3B | Nemotron Cascade 2 30B-A3B | GPT-OSS 20B-A2B High | Loopie 20B-A2B Thinking | |
|---|---|---|---|---|---|
| Pre-training tokens | 36T | 25T | 25T | Unknown | 3.5T |
| Knowledge | |||||
| MMLU | 85.83 | 80.52 | 81.22 | 81.64 | 81.28 |
| MMLU-Redux | 88.25 | 82.54 | 83.89 | 83.40 | 83.61 |
| General | |||||
| ARC-Challenge | 96.67 | 91.96 | 93.86 | 92.42 | 93.52 |
| DROP | 87.70 | 85.92 | 79.06 | 62.82 | 82.08 |
| BBH | 86.59 | 68.76 | 75.86 | 84.76 | 82.28 |
| SciQ | 95.40 | 93.40 | 92.40 | 93.80 | 92.50 |
| IFEval | 85.58 | 77.05 | 79.21 | 70.03 | 84.72 |
| Code | |||||
| MBPP | 96.50 | 90.66 | 80.54 | 78.99 | 89.49 |
| MBPP+ | 98.68 | 91.53 | 83.60 | 97.62 | 83.07 |
| HumanEval | 96.95 | 86.59 | 79.88 | 92.07 | 89.02 |
| HumanEval+ | 92.07 | 87.80 | 78.66 | 89.02 | 87.20 |
| Math | |||||
| AIME 24 | 90.10 | 85.00 | 93.33 | 88.33 | 92.09 |
| AIME 25 | 83.75 | 74.17 | 91.25 | 87.50 | 83.75 |
| AMC | 96.73 | 91.80 | 93.57 | 91.05 | 94.21 |
| OlympiadBench | 81.20 | 76.68 | 88.64 | 70.03 | 80.50 |
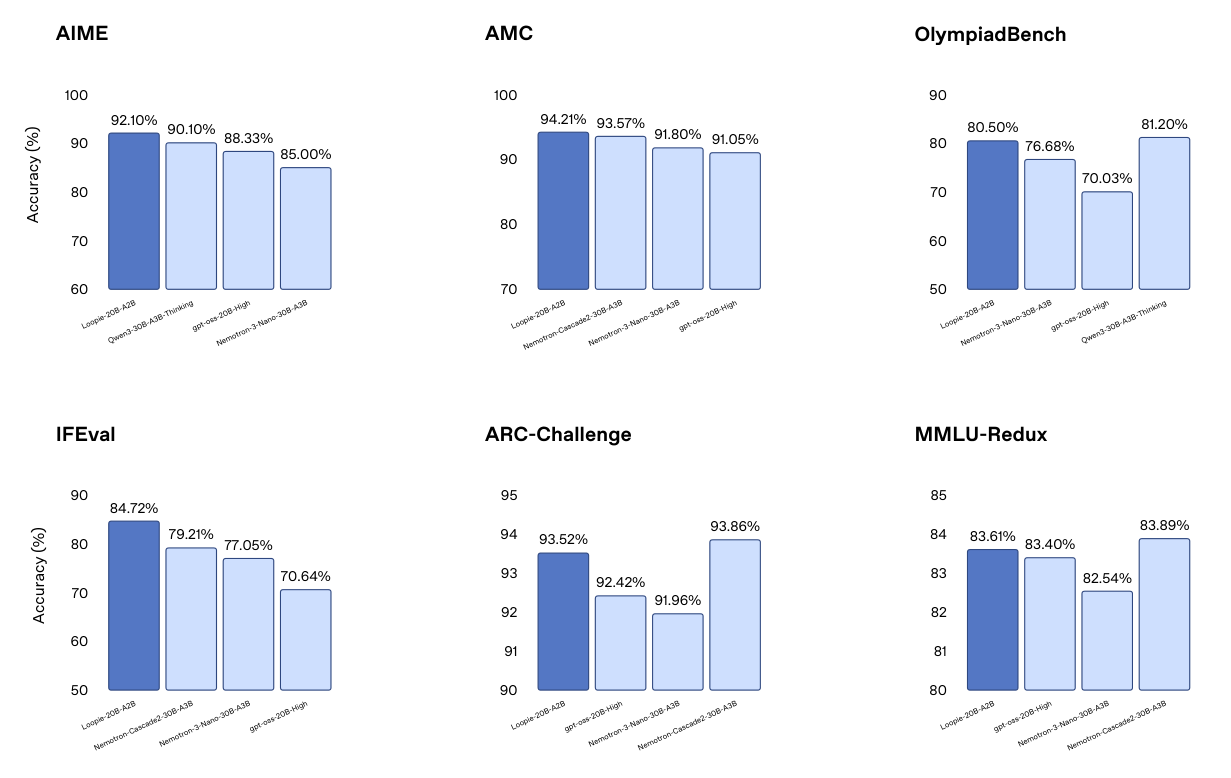
结论分析:论文强调的是 token 效率——Loopie 只用 3.5T token,而 Nemotron 3 Nano 与 Nemotron Cascade 2 各用 25T token 且来自同一预训练数据源,即不到七分之一。在此前提下:MMLU 81.28 高于两个 Nemotron(80.52 / 81.22);ARC-Challenge 93.52 超 Nemotron 3 Nano 1.56 分、距 Nemotron Cascade 2 仅 0.34 分;BBH 82.28 大幅领先(68.76 / 75.86);IFEval 84.72 同样大幅领先(77.05 / 79.21)。总体上 Loopie 在每一个知识/通用类 benchmark 上都至少胜过两个 Nemotron 之一,并在 7 个中的 5 个上同时胜过两者。推理侧 AIME 2024 92.09、AMC 94.21 在榜单中排第二,AIME 2025 的 83.75 与 Qwen3-30B-A3B Thinking 打平。
同时要看清没被强调的部分:Qwen3-30B-A3B Thinking(36T token)在 15 项里赢下 9 项,代码四项中 Loopie 有三项落后于它,MBPP+ 83.07 更是全场偏低;数学上 Nemotron Cascade 2 在 AIME 25 与 OlympiadBench 上明显更强。所以 Loopie 的主张准确说是"同数据源下 token 效率高得多",而不是"绝对更强"。
Loopie-6B-A0.6B vs 紧凑推理模型¶
| DeepSeek-R1 Distill-Qwen 1.5B | Gemma-4 E2B-it | Gemma-4 E4B-it | Qwen3 1.7B | MiniCPM5 1B | Ouro 1.4B Thinking | Ouro 2.6B Thinking | Loopie 6B-A0.6B | |
|---|---|---|---|---|---|---|---|---|
| MMLU | 44.85 | 63.33 | 72.97 | 69.08 | 61.54 | 72.40 | 82.70 | 78.36 |
| MMLU-Redux | 51.28 | 72.28 | 79.61 | 74.28 | 70.63 | 73.75 | 86.28 | 81.35 |
| ARC-Easy | 69.19 | 87.08 | 92.97 | 91.20 | 85.27 | 90.87 | 94.28 | 93.77 |
| ARC-Challenge | 61.09 | 83.28 | 90.02 | 86.09 | 75.34 | 88.48 | 93.94 | 91.13 |
| SciQ | 44.10 | 86.80 | 94.40 | 87.70 | 82.48 | 91.60 | 94.90 | 90.10 |
| MBPP | 35.80 | 77.04 | 82.49 | 80.54 | 50.97 | 88.63 | 95.69 | 76.65 |
| MBPP+ | 63.76 | 86.77 | 90.21 | 82.80 | 81.75 | 89.89 | 96.01 | 84.66 |
| HumanEval | 65.85 | 79.27 | 91.46 | 85.98 | 86.59 | 95.12 | 95.12 | 84.15 |
| HumanEval+ | 65.24 | 81.71 | 85.98 | 82.93 | 86.59 | 87.80 | 89.02 | 79.88 |
| AIME 24 | 35.83 | 38.33 | 49.17 | 49.58 | 47.50 | 50.83 | 62.50 | 80.42 |
| AIME 25 | 24.17 | 26.25 | 35.42 | 35.00 | 38.75 | 44.17 | 51.67 | 70.83 |
| AMC | 67.91 | 75.37 | 85.08 | 73.88 | 28.36 | 78.36 | 85.82 | 84.33 |
| MATH-500 | 83.60 | 89.00 | 91.60 | 90.60 | 60.00 | 92.20 | 92.20 | 93.80 |
| GSM8K | 72.18 | 90.60 | 93.40 | 90.14 | 76.35 | 94.09 | 96.13 | 93.63 |
结论分析:这张表最有意义的对手是 Ouro——同为循环语言模型、但走 model-loop 路线。Loopie-6B-A0.6B 在数学上碾压 Ouro 2.6B Thinking(AIME 24 80.42 vs 62.50,AIME 25 70.83 vs 51.67),但在知识(MMLU 78.36 vs 82.70)与代码(MBPP 76.65 vs 95.69、HumanEval 84.15 vs 95.12)上明显落后。考虑到 Loopie 的 RL 只做了数学与代码、且先数学后代码(代码阶段可能未充分收敛),这个"数学强、代码弱"的偏斜与其后训练配方是自洽的;但也说明本表不能读成 layer-loop 全面压过 model-loop——它更像是不同后训练侧重的结果。作者自己在 Future Work 里承认后训练只覆盖数学与代码。
核心贡献总结¶
- 把循环重新记账:明确指出循环模型必须在同预训练算力而非同参数量下对比,并给出 Ouro/Huginn 按此换算后的等效对手规模(10.4B / 112B)。这个框架本身比具体模型更有价值。
- layer-loop:把整模型循环换成逐层就地循环。三条理由中,流水线并行局部性是最硬的工程论据——它直接解释了循环模型此前为何扩不上去。
- Loopie Recipe:一条可操作的"减半存储深度 → 换显存余量 → 翻倍 microbatch → 回投为容量 → 按实测墙钟时间选型"的配方,并诚实声明匹配口径是墙钟而非 FLOPs。
- SPT:把 SFT 的监督掩码放进预训练规模的优化机制,观察到 10 epoch / 2T token 无过拟合且通用指标同步上升,对"SFT 必致灾难性遗忘"提出了反例。
与已归档相关工作的对比¶
Hidden Decoding Hidden Decoding: Latent Computation Scaling for Large Language Models(WeChat AI, Tencent, 2026-07-09)¶
关系:独立并发(本文未引用 Hidden Decoding,两者对同一 root cause 给出相反的解法轴)· 已加载对方精读
- 共同关注的问题:两篇的诊断几乎逐字相同——循环/递归深度是"固定参数、增加每 token 计算"的最直接手段,但它扩不上去,而卡点被双方同时定位到流水线并行:大规模 MoE 训练依赖每个输入单向流过各 stage 一次,循环模型把同一 hidden state 反复送回同一批 stage,破坏这个前提,造成流水线停顿与 GPU 空转。Hidden Decoding 明确写道"looping 缺一个既能 scale 到超大模型、又能高效利用 GPU 的现实路径"。
- 相近的技术骨架:都是"不加宽不加深骨干,靠复用同一套参数换取更多每 token 计算,并且必须自证这份计算比把同样预算花在更大模型上更值"。两者也都落在 MoE 骨干上、都要处理"额外计算带来的注意力/显存代价",并都用一个受限的注意力/执行布局把代价从二次压回近似线性或常数。
- 本文的差异与推进:解法轴正好相反。Hidden Decoding 判定深度轴无解,于是绕开——沿序列维把每个 token 展开成 $n$ 条 stream(独立 embedding 表、只监督最后一条),用 Stream-Factorized Attention 把跨 stream 注意力限制到少数层。Loopie 则正面修深度轴:把 model-loop 换成 layer-loop,让一层的所有循环调用留在同一个 pipeline stage 内,环形依赖随之消失。有意思的是 Hidden Decoding 在综述循环模型规模时点名了 IQuest 自家的 40B 稠密 LoopCoder 并注明"且未用 pipeline parallelism 训练"——这恰好是 Loopie 这篇要补上的那一环。
- 可比的方法/实验差异:Hidden Decoding 是持续预训练(CPT) 方法,作用在已有强骨干上,训到 WeLM-HD4-80B / 617B,是首个在 100B+ MoE 规模跑通的序列长度扩展方法,并报告收益随展开因子 $n$ 单调增长;Loopie 是从零预训练,最大 20B-A2B(3.5T token),并给出 0.15B→1B 的四级算力匹配扩展阶梯。两者的"算力匹配"口径也不同:Hidden Decoding 对的是"匹配的非 HD 对照",Loopie 对的是实测 optimizer-step 墙钟时间。两条路线在原理上并不互斥——layer-loop 解决了深度轴的流水线阻碍之后,序列轴展开仍可叠加,这是一个双方都没做的组合。
LoopCTR LoopCTR: Unlocking the Loop Scaling Power for Click-Through Rate Prediction(Renmin University of China + Alibaba, 2026-04-21)¶
关系:独立并发(本文未引用 LoopCTR;不同社区,殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把递归复用当作独立于 depth / width / input 的第四条 scaling 轴,都想让计算量随循环数增长而参数量不变,也都必须面对"共享层反复执行容易退化成重复等价"这一表达力风险。LoopCTR 的动机段与本文 §2.2 的"参数共享模式"论证指向同一个 root cause:被反复调用的同一份参数被迫承担异质角色。
- 相近的技术骨架:两者都把 MoE 塞进被循环的 block(LoopCTR 是 MoE-Augmented attention/FFN,Loopie 是 Qwen3-MoE 骨干整体循环),都拿"共享层先验 = 一种结构正则"作为收益来源之一,方法流程图都可以抽象成"入口编码 → 共享块迭代精炼 → 出口读出"。
- 本文的差异与推进:解表达力瓶颈的手段不同。LoopCTR 用 Hyper-Connected Residuals——把单流隐状态复制成 $n$ 条流,用输入相关的动态混合矩阵替换固定 1:1 残差,让同一层在不同循环深度表现出不同行为;Loopie 则不动残差,改循环的排布(layer-loop 使复用发生在相邻有效深度,天然规避异质角色问题)。解效率瓶颈的手段更是南辕北辙:LoopCTR 靠多深度 process supervision 实现 train-multi-loop / infer-zero-loop,把多循环训练的收益内化进一次前向,因为 CTR 的 P99 延迟不允许线上循环;Loopie 训练和推理都循环 2 次,它要省的是训练算力而非推理延迟。
- 可比的方法/实验差异:LoopCTR 的最强结论是"零循环推理已经打赢所有 baseline",即循环的价值可以完全转化为训练期正则;Loopie 的结论恰恰相反——循环带来的是后期才兑现的容量优势(Figure 3 要到 600B token 才反超,Figure 2 要到 1.2T token 才反超),必须保留在推理路径上。这个分歧很可能源于任务规模:CTR 数据稀疏、模型小,循环更像正则;LLM 预训练数据充足、模型大,循环更像容量。两者都在 $R$ 很小时收益最大(LoopCTR $L=1,2,3$;Loopie $R=2$),这是一个跨领域重合的经验事实。
初筛后被剔除的近似候选:SpecFormer SpecFormer(同样研究"深度 scaling 为何失效",但 root cause 定位在谱坍缩、解法是谱软化,与参数复用无关);Dynamic Short Convolutions Improve Transformers Dynamic Short Convolutions(同样用 scaling law 论证"新原语在匹配算力下更优",但引入的是新算子而非参数复用,问题不同构);LLaDA MoE v2 LLaDA MoE v2(同样做 MoE 的算力分配前沿,但轴是模型/数据而非计算复用);LASAR LASAR(同样是循环隐状态反馈,但目标是推理深度自适应而非预训练算力匹配)。
讨论与局限性¶
"算力匹配"的口径需要被反复强调。 全文最强的主张——"循环模型在同算力下赢过 vanilla"——建立在实测墙钟时间匹配上,而 Loopie 的名义 FLOPs 是参考模型的 1.424 倍。论文对此完全透明(§2.4 反复声明不主张理论 FLOP 相等),但这意味着结论是硬件与实现相关的:整个增益链条依赖"减半存储深度 → 激活显存降到 0.633× → per-device microbatch 能翻倍 → 吞吐 189.65→261.53 TFLOPS/s"。若在某套硬件/并行配置下参考模型本来就不受激活显存约束(例如显存充裕、或用了更激进的 checkpointing / offload),microbatch 就无从翻倍,这 42% 的额外计算将直接转化为 42% 的额外时间,结论可能反转。作者称在多个 GPU 平台上验证过一致的基础设施收益,但没有给出这些平台的具体数据。
"3.5T token"的口径同样值得追问。 Table 3 用"3.5T vs 25T,不到七分之一"作为核心 token 效率论据,但 SPT 阶段又消耗了 2T token——而 SPT 按作者自己的定义就是"预训练规模的优化"(全局 batch 1024、序列 128K、每 batch 1.28 亿 token 位置)。把这 2T 计入,Loopie 的实际训练 token 是 5.5T,效率优势从 7.1× 降到 4.5×。这仍然是显著优势,但"3.5T"这个数字在与"25T 全流程"对比时并非同口径。
消融的关键一环描述不清。 §2.7 的 layer-loop 消融是支撑"收益来自循环排布本身"的唯一直接证据,但正文"保留整体循环计算预算"与图注"去掉 layer-loop 循环"互相矛盾,且论文从未给出消融模型的实际配置。图例中的 "Loopie-5B" 与正文 "Loopie-6B-A0.6B" 命名也不一致。这一处如果澄清,全文的因果论证会牢固很多。
$R=2$ 的选择被论证得很好,但也限定了故事的边界。 本文对"为什么不用更大 $R$"给出了迄今最清晰的算力分配论证,且主动标注了 Figure 6 中 $N=2$ 对比不公平(2× 层 baseline 算力更高)——这种自曝不利读法的做法在技术报告里并不常见,值得肯定。但 $R=2$ 也意味着 Loopie 与 Huginn(32 步)那类"用循环换测试时算力"的路线不在同一个问题域里;本文的循环几乎纯粹是训练期的容量机制,推理侧的自适应计算、早退等能力一概没有触及,而这恰恰是循环架构最被期待的部分。作者在 Future Work 中承认未做推理算力的系统研究。
扩展阶梯偏小。 四级阶梯的最大 baseline 只有 1B 活跃参数,且这一级因算力受限只训了 500B token(按 1000× 规则本应 1T),实际处于欠训状态。而主实验的 20B-A2B 只做了单点对比、且只训到 800B token(远未到 3.5T 的完整预训练量)。"gap 不随规模消失"的结论建立在 0.15B–1B 这个区间上,外推到 100B+ 仍属推测。
值得借鉴的设计。 抛开循环本身,三点可以独立迁移:(a) 按实测 optimizer-step 时间而非理论 FLOPs 做架构选型,并把选型放进 Megatron-LM 的 TP/EP/MBS 联合搜索里,这是把"架构设计"与"并行配置"耦合起来的正确做法;(b) warmup-stable-only(不衰减)调度 + 恒定学习率退火,理由是避免后期高质量数据的影响力被学习率衰减稀释;(c) SPT 这个中间阶段——用预训练规模的 batch 跑 SFT 掩码,在本文的观察中同时提升推理与通用指标、10 epoch 不过拟合。(c) 的证据目前只有 6B 一个模型的曲线,作者自己也承认"因算力受限未能对 SPT 做足够全面的消融",但如果能被独立复现,它对后训练范式的影响可能超过 layer-loop 本身。
与本档案库的关联价值。 本文对推荐系统的直接迁移价值有限(纯 LLM 预训练),但两条线值得关注:其一,layer-loop 的流水线局部性论证适用于任何要在生产训练集群上跑循环/递归结构的场景,LoopCTR LoopCTR 那类工业循环模型若要扩大规模会撞上同一堵墙;其二,"参数复用作为第四条 scaling 轴"在推荐侧(受显存与延迟双重约束)比在 LLM 侧更有吸引力,而本文给出的"用显存余量换 microbatch 再换容量"的记账方式,是推荐模型做架构-并行联合选型时可以照搬的方法论。