SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers¶
清华大学 + ByteDance Seed + M-A-P + TokenWave.AI,arXiv 2609.01343v1,正文标注日期 2026-08-10,arXiv 提交 2026-09-01。核心作者 Shaowen Wang、Ge Zhang;通讯作者含 Shen Yan(ByteDance)、Jian Li(清华)。
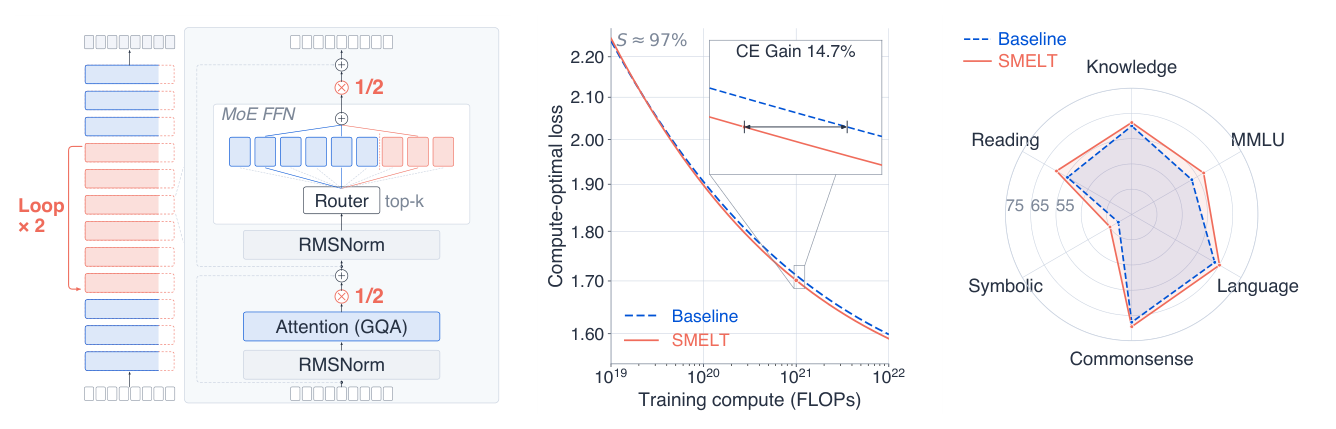
研究动机与背景¶
Looped Transformer(循环 Transformer)的思路来自 Universal Transformer [18]:不再堆叠彼此独立的层,而是把同一组共享参数在一次前向里反复执行,用「有效深度」换「存储参数量」。这条线近年成果密集——Huginn [22] 在 3.5B 规模用 prelude–recur–coda 布局循环中间 50%,Ouro [68] 在 1.4–2.6B 规模循环整个层栈,两者都报告循环模型能匹敌甚至超过数倍于自己参数量的非循环模型;Saunshi et al. [54] 进一步指出循环对推理类任务有额外的归纳偏置。由于有效深度决定了每个 token 能获得多少串行计算步[40, 43],循环看上去是一条「不加参数就能加推理能力」的路。
本文开篇就把这条叙事的记账问题挑明:
a fraction of the parameter count is not a fraction of the cost.
把一个 12 层模型循环成 24 层执行,只存了一半权重,却花掉了 24 层模型的 per-token FLOPs,并且需要它完整的 KV cache。既有评测大多在「固定存储参数量」的口径下增加循环深度 [22, 47],或者强调相对更大的非绑定模型的参数效率 [64, 68],两种做法都把架构优势与未受控的额外算力混在一起。于是「循环在扣掉这份额外算力之后还有没有优势」这个问题至今没有答案。
作者论证:一个干净的回答必须同时锁死三个预算——
- per-token FLOPs:决定训练与推理成本;
- 总参数量:决定知识容量上界;
- KV cache:决定部署能服务的最长上下文。
而 MoE 恰好让这个三重匹配变得可行:循环模型可以通过收窄隐藏维 $H$ 来支付第二次访问的 FLOPs,又因为 MoE 把总参数量与 per-token FLOPs 解耦 [20, 56],可以通过增加专家数把收窄损失的容量补回来,而不是直接放弃;KV cache 的对齐则单独靠调整 head size 与 GQA 比例完成。
在这个匹配框架下,本文用三组消融锁定一条配方 SMELT(Sparse MoE Transformer, middle layers Loop Twice),并把它推到 54B 非嵌入参数的规模,为两种架构各自独立拟合一条 Chinchilla 式标度面,最终把结论表述成一个可外推的算力节省数字:在算力最优前沿上节省 6.8–18.0% 的训练 FLOPs。
相关工作:「旧错」到底是什么,以及本文如何刻画它¶
这一节值得单独展开,因为本文整篇方法论的合法性都建立在「既有文献确实犯了对照口径的错」这个前提上。作者用 Table 1 把它量化成一张表——这也是本文最有价值的产出之一。
| Work | Arch. | Span | FLOPs | Params | KV | Scaling analysis | Key finding |
|---|---|---|---|---|---|---|---|
| Huginn [22] | Dense | Mid. 50% | ✗ | ✓ | ✗ | 固定尺寸 (3.5B) | prelude-recur-coda 提升推理;额外 FLOPs 未受控 |
| Ouro [68] | Dense | Full (100%) | ✗ | ✓ | ✗ | 固定尺寸 (1.4–2.6B) | 全栈循环提升推理;额外 FLOPs 未受控 |
| Saunshi et al. [54] | Dense | Mid. 33% | (✓)ᵃ | ✗ | ✗ | 固定尺寸 (170M–1B) | 中段循环降 perplexity;偏向推理的归纳偏置 |
| Schwethelm et al. [55] | Dense | Mid.ᶜ | ✓ | ✗ | ✓ | 等深度律 (25M–1.6B) | $r$ 次递归 ≈ $r^{0.46}$ 个独立块;循环输 |
| Prairie et al. [47] | Dense | Mid. 33% | ✗ | ✓ | ✗ | 固定参数下的标度律 (100M–1.3B) | 最优 $r$ 随算力增长;FLOPs 与 KV 随 $r$ 膨胀 |
| LoopMoE [10] | MoE | Mid. 33% | ✓ | ✓ | ✗ | 固定尺寸 (3B, 9B) | 3B 赢 8/9,9B 赢 9/9 |
| Gao et al. [21] | MoE | Each layer | (✓)ᵇ | ✗ | ✗ | 固定尺寸 (6B, 20B) | 赢;$r=2$ 最优;显存节省回投宽度 |
| SMELT (ours) | MoE | Mid. 50% | ✓ | ✓ | ✓ | 0.1B–54B 非嵌入参数的标度阶梯 | 赢;前沿上省 6.8–18.0% FLOPs;下游增益超出验证损失预测 |
ᵃ 只有 prefix-loop-suffix 布局的 perplexity 比较是匹配 FLOPs 的,accuracy-vs-循环次数结果仍在固定尺寸下;ᵇ 匹配的是墙钟训练时间而非 per-token FLOPs;ᶜ 物理跨度随循环次数变化($r$=2,3,4 时约 67%/50%/33%)。
这张表说明本文并没有把所有前人都打成稻草人。它明确承认:Schwethelm et al. [55] 已经在等 FLOPs 下做过控制,结论是循环输($N_{\text{once}} + r^{0.46} N_{\text{rec}}$,次线性指数意味着每次迭代的容量回报递减);Saunshi et al. [54] 也报告过 iso-FLOP 下循环模型 perplexity 劣于非循环 baseline;RINS [3] 通过减少训练 token 数来匹配总训练算力;LoopMoE [10] 已经同时匹配 FLOPs 和参数量。本文真正声称的增量是三条:(i)加上第三个预算 KV cache,(ii)用 MoE 作为让三重匹配可行的机制,(iii)从单点比较升级为跨四个规模的标度阶梯,且为两种架构各拟合一条独立的标度面,把点观测转成可归因、可外推的断言。
作者对 Schwethelm 与 Prairie 的定位很精确:「Schwethelm et al. 在固定深度下给循环定价,Prairie et al. 在固定参数下测循环的收益,两者从相反的两侧夹住了这个问题」,而 SMELT 要做的是把两侧同时封死。
预算匹配:把循环当成一个算力分配问题¶
训练协议¶
架构:decoder-only Transformer,FFN 全部换成稀疏 MoE 层,每层 top-8 路由,注意力用 GQA [2]。采用一个内部(proprietary)Baseline 家族,用其 active 非嵌入参数量标定四个规模:100M / 200M / 600M / 1.6B,物理深度 $L$ = 10 / 12 / 20 / 30。循环跨度 $m = L/2$,前置 $\lfloor (L-m)/2 \rfloor$ 层,1-based 索引下被循环的层是 3–7、4–9、6–15、8–22。
循环跨度内每个子层的残差更新都被缩放 $1/r$ [62],防止权重绑定带来的相关更新在多次访问间把残差流吹大。
compute-equivalent sparsity $S$:这是本文自造的一个关键量。设一个全激活对照(同规模、非循环、每 token 激活所有专家)的 per-token 训练 FLOPs 为 $F_0$、总非嵌入参数为 $N_0$,则对任意配置:
$$N^{\text{eq}}_{\text{act}} = \frac{F}{F_0} N_0, \qquad S = 1 - \frac{N^{\text{eq}}_{\text{act}}}{N} \tag{1}$$
即用 FLOPs 比例反推「等效激活参数量」,$S$ 是未激活份额。它与 Abnar et al. [1] 的参数比例稀疏度类似,但从 FLOPs 比例算出,因而把随上下文长度变化的注意力成本也计入。注意一个反直觉之处:匹配到 $S=0$ 的循环模型并不是稠密模型——匹配过程收窄了 $H$ 又加了专家,所以 $S=0$ 时循环模型仍在从一个更大的专家池里选 top-8(200M 规模是 16 个专家)。$S=0$ 只表示「每参数的算力强度与全激活 Baseline 相同」。
优化器与数据:AdamW [41] + WSD 调度 [28]。稳定期在恒定学习率下训 196,075 步,全局 batch 256 条序列(≈1M token/步),共 205B token。从稳定期的 6 个 checkpoint(10k / 20k / 50k / 100k / 150k / 196,075 步)分叉出 6 条 cosine 衰减分支,每条再训 10B 未见过的新数据,最长分支约 215B token,全程无数据重复。同一 (规模, 稀疏度) 格点下的 Baseline / SMELT 配对训练在完全相同的 token 序列上。
数据与评测:在内部语料上预训练。留出验证集覆盖 39 个来源,归为 Code / Math-STEM / Knowledge / Finance / Web 五类。训练序列打包成 4096-token 上下文,用 segment-level attention mask(每个 segment 是打包上下文里的一篇文档)。三个指标:验证损失(39 个来源的 token 加权交叉熵);DCLM Core(22 任务中心化准确率,DCLM-v2 参考基线映射到 0);DCLM Completion(其中 9 个自由生成任务的 gold answer token 上的微平均交叉熵,越低越好);外加单独报告的 MMLU 5-shot。few-shot 任务用 10 个随机种子。预训练前已过滤已知评测样本以防污染。
匹配的具体做法¶
标准 MoE Transformer 的 per-token 训练 FLOPs 正比于 $L \cdot H^2$。循环 $m$ 层 $r$ 次后有效深度变成 $L_{\text{eff}} = L + (r-1)m$,FLOPs 按比例增长而参数量不变。要把 FLOPs 压回去只能收窄 $H$ 或减少 $L$,而这又会同时砍掉总参数与 KV cache——所以必须三轴同时补偿:
| 预算 | 调整手段 | 典型残余错配 |
|---|---|---|
| Per-token FLOPs | 收窄 $H$,或改 $L$ | < 4% |
| 总参数量 | 增加专家数 | < 1% |
| KV cache | head size 或 GQA 比例 | < 4% |
一个具体实例(200M,$S \approx 95\%$,循环中间 6/12 层两次,执行 18 层):匹配的 Baseline 是 $L=12$、$H=1280$、每层 192 专家($1.33\times10^9$ FLOPs/token,$3.87\times10^9$ 总非嵌入参数)。6 次额外层执行要花 FLOPs,于是 $H$ 从 1280 收到 1056;收窄 $H$ 又缩小了每个专家的 FFN,于是每层专家数从 192 提到 288。最终 per-token FLOPs 落在 $1.37\times10^9$(+2.9%),总参数 $3.89\times10^9$(+0.4%),KV cache 在 4% 以内。两边的 FLOPs 都是在打包 4096-token 上下文内的平均文档长度处计算的(因为 segment mask 把注意力限制在单篇文档内),并包含随该长度变化的注意力成本。
匹配到底有多严(Appendix A 的实测错配表)¶
这是复核本文口径严格性的关键证据。Table 10 给出了每个格点上 SMELT 相对 Baseline 的 per-token 训练 FLOPs 比与 KV cache 比:
| Scale | $H$ | $L$ | 总专家 | Loop | Active params | $S$ | 总参数 | $F_{\text{SMELT}}/F_{\text{Base}}$ | $KV_{\text{SMELT}}/KV_{\text{Base}}$ |
|---|---|---|---|---|---|---|---|---|---|
| 100M | 576 | 10 | 16 | Mid.50%×2 | 0.071B | 0.0% | 0.10B | 1.081 | 1.018 |
| 100M | 576 | 10 | 96 | Mid.50%×2 | 0.067B | 86.8% | 0.71B | 1.024 | 0.964 |
| 100M | 576 | 10 | 288 | Mid.50%×2 | 0.069B | 95.5% | 2.12B | 1.031 | 0.964 |
| 100M | 576 | 10 | 504 | Mid.50%×2 | 0.070B | 97.4% | 3.70B | 1.039 | 0.964 |
| 200M | 1056 | 12 | 16 | Mid.50%×2 | 0.142B | 0.0% | 0.21B | 1.039 | 1.031 |
| 200M | 1056 | 12 | 96 | Mid.50%×2 | 0.140B | 84.6% | 1.32B | 1.021 | 1.031 |
| 200M | 1056 | 12 | 288 | Mid.50%×2 | 0.142B | 94.7% | 3.89B | 1.029 | 1.031 |
| 200M | 1056 | 12 | 504 | Mid.50%×2 | 0.145B | 96.9% | 6.78B | 1.037 | 1.031 |
| 600M | 1408 | 20 | 16 | Mid.50%×2 | 0.458B | 0.0% | 0.67B | 1.046 | 1.031 |
| 600M | 1408 | 20 | 96 | Mid.50%×2 | 0.443B | 85.1% | 4.31B | 1.007 | 1.031 |
| 600M | 1512 | 20 | 288 | Mid.50%×2 | 0.453B | 94.7% | 12.44B | 1.024 | 0.984 |
| 600M | 1512 | 20 | 504 | Mid.50%×2 | 0.459B | 96.9% | 21.70B | 1.031 | 0.984 |
| 1.6B | 1848 | 30 | 16 | Mid.50%×2 | 1.101B | 0.0% | 1.64B | 1.022 | 0.984 |
| 1.6B | 1848 | 30 | 96 | Mid.50%×2 | 1.081B | 84.6% | 10.45B | 1.000 | 0.984 |
| 1.6B | 1848 | 30 | 288 | Mid.50%×2 | 1.091B | 94.8% | 30.90B | 1.004 | 0.984 |
| 1.6B | 1848 | 30 | 504 | Mid.50%×2 | 1.103B | 97.0% | 53.90B | 1.008 | 0.984 |
对应的 Baseline 侧:$H$ = 672 / 1280 / 1792 / 2304,$L$ = 10 / 12 / 20 / 30,总专家 8 / 64 / 192 / 336,active params 0.100B / 0.207B / 0.665B / 1.632B,最大 total params 53.89B。
三个必须看清的事实:
- 循环的重复前传成本被完整计入。原文明确写道 $S$ 的计算里 FLOPs $F$ "count every block execution"——整套匹配流程存在的理由就是「额外访问要花 FLOPs」。这一点上本文的口径是过关的。
- FLOPs 是解析核算而非硬件实测,但不是粗糙的 $6N$:它按每个配置逐项算,包含在实测平均文档长度处的注意力成本,原文说明它因此超过 parameter-only 的 $6N$ 近似。
- 残余错配是单边的。16 个格点的 $F_{\text{SMELT}}/F_{\text{Base}}$ 全部 ≥ 1.000,12 个稀疏格点的均值约 +2.1%,最大 +4.6%(原文报告稀疏格点最大绝对错配为 FLOPs 3.9%、参数 1.0%、KV 3.6%)。也就是说 SMELT 在每一格上都拿到了不少于 Baseline 的算力。KV 侧则相反(多数 < 1,最低 0.964),SMELT 略吃亏。
本文对此有一段重要的方法论辩护:「这些残余差异在标度分析中并不被当作精确的预算相等:每个 run 都以它自己的实测 per-token FLOPs $F$ 进入拟合,算力效率比较是在共同的 $(C, S)$ 坐标上评估两条独立拟合的曲面」。这一处理是正确的——把 +2% 的错配吸收进拟合的横轴,头条 CE Gain 数字因此基本免疫。但需注意:Section 3 的三组消融表(Table 3–5)与 Section 5 的逐点胜率统计(96/96 等)并没有这层保护,它们比较的是名义匹配但实际相差百分之几算力的两个模型的原始损失。
设计消融:锁定三条规则¶
三组消融全部在 200M、双次访问下进行。
3.3 循环中间一半优于全栈循环¶
固定 $L=12$,扫描连续中段的循环长度(0 = Baseline,12 = 全栈):
| 循环层数 | Span (%) | 有效层数 | Val. loss ↓ | DCLM Core ↑ | DCLM Completion ↓ |
|---|---|---|---|---|---|
| $S \approx 85\%$ | |||||
| 0 | 0 | 12 | 1.9445 | 24.92 ± 0.13 | 2.2887 |
| 2 | 17 | 14 | 1.9384 | 26.20 ± 0.14 | 2.2824 |
| 4 | 33 | 16 | 1.9275 | 25.13 ± 0.16 | 2.2733 |
| 6 | 50 | 18 | 1.9257 | 27.57 ± 0.13 | 2.2635 |
| 8 | 67 | 20 | 1.9374 | 25.84 ± 0.10 | 2.2843 |
| 10 | 83 | 22 | 1.9413 | 24.45 ± 0.17 | 2.2835 |
| 12 | 100 | 24 | 1.9322 | 25.31 ± 0.17 | 2.2759 |
| $S \approx 95\%$ | |||||
| 0 | 0 | 12 | 1.8735 | 29.34 ± 0.10 | 2.2189 |
| 2 | 17 | 14 | 1.8562 | 30.84 ± 0.20 | 2.2022 |
| 4 | 33 | 16 | 1.8524 | 31.22 ± 0.18 | 2.1970 |
| 6 | 50 | 18 | 1.8517 | 29.68 ± 0.13 | 2.1917 |
| 8 | 67 | 20 | 1.8544 | 31.78 ± 0.18 | 2.1891 |
| 10 | 83 | 22 | 1.8572 | 31.49 ± 0.15 | 2.1964 |
| 12 | 100 | 24 | 1.8601 | 30.82 ± 0.14 | 2.2038 |
结论分析:验证损失在两个稀疏度下都在 50% 跨度取最小。作者诚实地指出 DCLM 指标并不跟随验证损失——$S\approx95\%$ 下 DCLM Core 在 67% 跨度达峰、在 50% 跨度反而下陷,与验证损失排序相反。因此选择标准明确落在验证损失上(因为它在数十亿 token 上平均,变化平滑),DCLM 列只当一致性检查。作者同时声明:±0.1–0.2 的标准误只反映 10 个评测种子的波动,不包含训练波动,因为每个配置只训了一次。这个 50% 的最优点与 Transformer 表示沿深度分化的既有观察 [34, 60] 以及部分循环研究 [9, 30, 54] 一致——首尾层承担专门角色,需要独立参数。
3.4 循环模型偏好更大的有效深度-宽度比¶
固定 50% 跨度、双次访问,在 200M / $S\approx85\%$ 下同时扫描两种架构的深宽比(每个深度都在三重约束下重新匹配其余超参):
| 物理深度 | 有效深度 | Val. loss ↓ | DCLM Core ↑ | DCLM Completion ↓ |
|---|---|---|---|---|
| Baseline | ||||
| 9 | 9 | 1.9638 | 24.01 ± 0.14 | 2.2983 |
| 12 | 12 | 1.9445 | 24.92 ± 0.13 | 2.2887 |
| 15 | 15 | 1.9457 | 25.84 ± 0.15 | 2.2824 |
| 18 | 18 | 1.9542 | 24.26 ± 0.14 | 2.2967 |
| Looped Transformer | ||||
| 8 | 12 | 1.9591 | 24.39 ± 0.17 | 2.2932 |
| 10 | 15 | 1.9389 | 25.93 ± 0.14 | 2.2871 |
| 12 | 18 | 1.9257 | 27.57 ± 0.13 | 2.2635 |
| 14 | 21 | 1.9433 | 26.55 ± 0.23 | 2.2766 |
结论分析:Baseline 峰值在物理深度 12,循环模型峰值在 12/18(物理 12、执行 18)——即循环模型的最优有效深宽比更大,但物理深度与 Baseline 相同。作者由此把循环模型的物理深度直接设为 Baseline 的最优值。给出的假说是:循环模型的额外执行深度不增加物理深度,共享层从多次访问收到梯度贡献,其中较晚的那次到输出的路径更短;这种多深度梯度信号可能让额外的串行计算比一叠独立参数化的深层更好优化。
3.5 两次循环优于三次或四次¶
| 模型 | 有效深度 | Val. loss ↓ | DCLM Core ↑ | DCLM Completion ↓ |
|---|---|---|---|---|
| Baseline (1×) | 12 | 1.9445 | 24.92 ± 0.13 | 2.2887 |
| Looped 2× | 18 | 1.9257 | 27.57 ± 0.13 | 2.2635 |
| Looped 3× | 24 | 1.9385 | 27.15 ± 0.20 | 2.2779 |
| Looped 4× | 30 | 1.9360 | 27.30 ± 0.19 | 2.2820 |
结论分析:两次访问三项全胜。三次与四次都回退,原因是匹配 FLOPs 的上限迫使模型变得更瘦。作者明确指出回退在循环次数上不是单调的(4× 的 1.9360 反而好于 3× 的 1.9385),因此只有「相对 2× 的共同差距」是有意义的信号,次序不可解读——这是一处值得肯定的自我约束。
三条规则合起来即 SMELT:循环中间一半(而非全栈)+ 比 Baseline 更大的有效深宽比 + 循环两次。
标度律与算力节省¶
网格与拟合形式¶
把配方铺到完整 4×4 网格:四个规模 ×($S=0\%$ 稠密参照 + 三个稀疏档 $S \approx \{85\%, 95\%, 97\%\}$)。每格训一对匹配的 Baseline / SMELT,每个 run 6 条衰减分支 → 32 个 run、96 对匹配、192 个评估端点。作者说明从一条稳定期 run 分叉衰减分支比每个 horizon 单独训一条便宜,且退火后的 checkpoint 才反映收敛损失 [28, 61]。
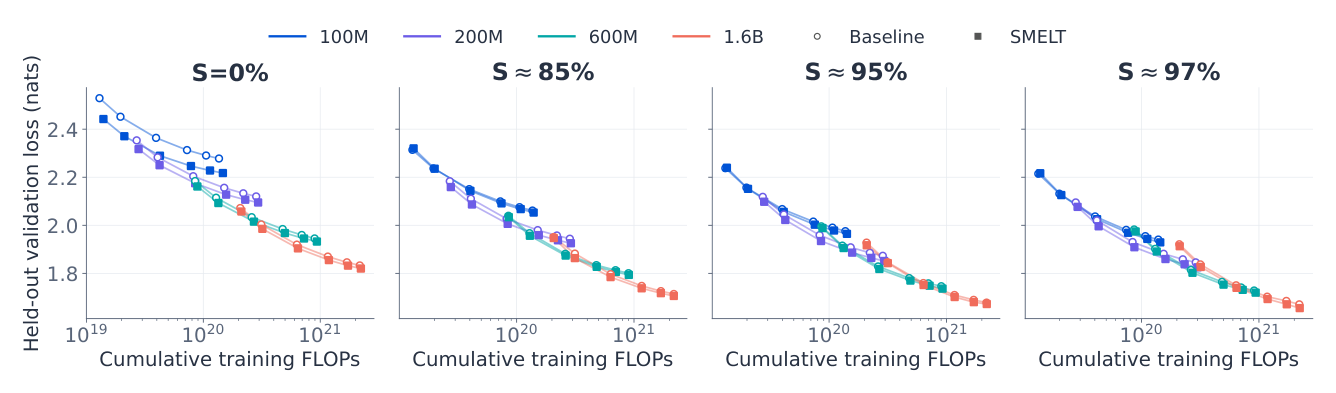
对 MoE 而言总参数量 $N$ 不能刻画每 token 实际激活多少,因此单一 $N$ 轴无法同时描述稠密与稀疏模型。既有 MoE 标度律的做法是给容量项补一个描述路由的变量:专家数 [12]、专家粒度 [42] 或稀疏度 [1]。本文沿这条线,把 $N$ 换成 per-token FLOPs $F$,并用式 (1) 的 $S$ 缩放容量项:
$$L(F, S, D) = E + \frac{A\,(1-S)^b}{F^{a}} + \frac{K}{D^{c}} \tag{2}$$
$E$ 是不可约损失;中间项是容量受限项($F$ 越大、$S$ 越高即 $1-S$ 越小,该项越小,因为更稀疏的模型在同样每 token 成本下存了更多总参数);末项是数据受限项。两种架构各自拟合六个系数 $(E,A,K,a,b,c)$,没有共享的 loop 指示变量。
给定总预算 $C$ 与稀疏度 $S$,按 Chinchilla Approach 3 [27] 在 $C = F\cdot D$ 约束下最小化 $L$,得算力最优的 per-token FLOPs:
$$F^{*} = \left(\frac{a\,A\,(1-S)^{b}\,C^{c}}{c\,K}\right)^{1/(a+c)} \tag{3}$$
回代得前沿损失:
$$L^{*}(C, S) = E + \underbrace{f(A, K, a, b, c, S)}_{\text{prefactor}}\; C^{-\gamma}, \qquad \gamma = \frac{a\,c}{a+c} \tag{4}$$
算力效率增益(CE Gain)定义为:在目标架构的预算 $C_{\text{tgt}}$ 处取其前沿损失,反解参照架构达到同一损失所需的 $C_{\text{ref}}$,则
$$\text{CE Gain} = 1 - \frac{C_{\text{tgt}}}{C_{\text{ref}}} \tag{5}$$
这与算法进步文献中 $C_{\text{ref}}/C_{\text{tgt}}$ 的乘数口径 [17, 26] 是同一量。
拟合协议与系数¶
两种架构用完全相同的流程拟合:对 log-loss 的 Huber 损失($\delta = 10^{-3}$)+ L-BFGS-B [27](作者引用 [46] 说明算力最优结论对拟合选择敏感,所以流程必须一致)。$S=0$ 参照档因为与三个稀疏档处在不同 regime、纳入联合拟合会恶化稀疏网格上的 RMSE,被排除在标度律拟合之外。稀疏拟合用 72 个 Baseline 端点 + 72 个 SMELT 端点,这 144 个端点覆盖 $1.3\times10^{19}$ 到 $2.2\times10^{21}$ 累计训练 FLOPs,也就是拟合面被支撑的窗口。
| Arch | $E$ | $A$ | $K$ | $a$ | $b$ | $c$ | RMSE |
|---|---|---|---|---|---|---|---|
| Baseline | 1.4439 | $1.366\times10^{3}$ | $1.975\times10^{6}$ | 0.3703 | 0.1530 | 0.6594 | 0.00554 |
| SMELT | 1.4493 | $1.963\times10^{3}$ | $5.264\times10^{6}$ | 0.3892 | 0.1460 | 0.7011 | 0.00952 |
(RMSE 单位是验证损失本身的 nats,而拟合目标是 log-loss 上的 Huber 损失。)
结论分析:SMELT 的容量指数 $a$ = 0.3892 > Baseline 的 0.3703,数据指数 $c$ = 0.7011 > 0.6594,两者都更大,所以 SMELT 的可约损失 $L-E$ 沿算力轴下降更快。合成前沿指数 $\gamma_{\text{base}} = 0.237$、$\gamma_{\text{SMELT}} = 0.250$,高 5.5%。作者注意到 $E_{\text{SMELT}}$(1.4493)比 $E_{\text{base}}$(1.4439)略高,但这 0.005 nats 的差距小于任一架构的拟合 RMSE,因此归为拟合噪声而非真实的渐近下界差异;并明确说明要预测 $C = 10^{25}$ 量级的前沿行为需要在那个规模上训练来锚定拟合。
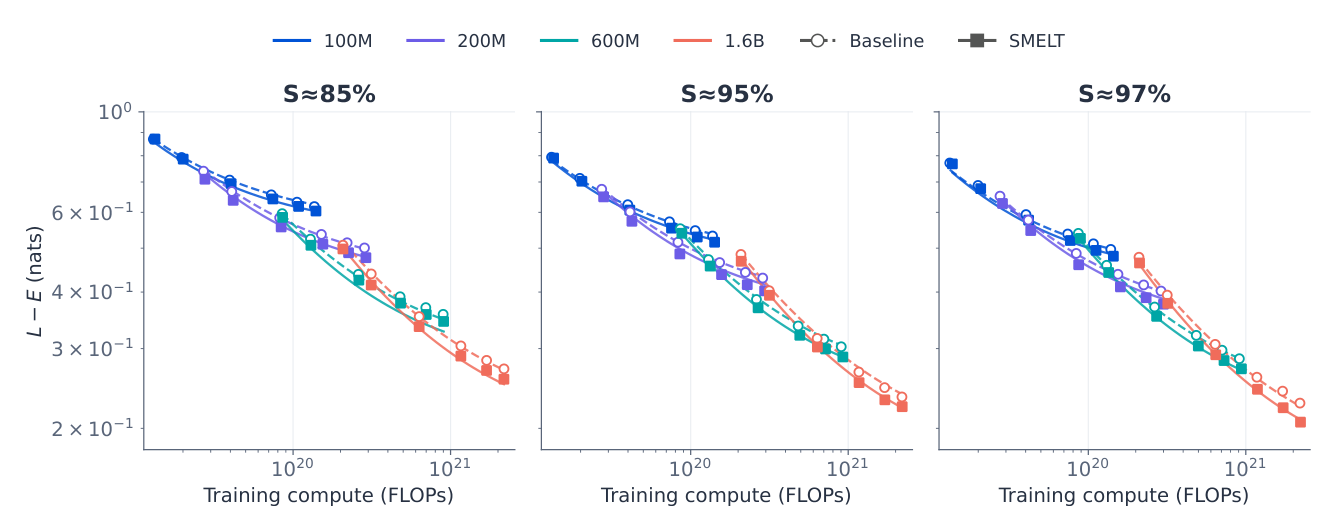
前沿上的算力节省¶
不确定性来自 cell bootstrap:对 12 个稀疏网格格点做有放回重采样,每次重采样重新拟合两条曲面、重算目标量,报告 2000 次抽样的 2.5 / 97.5 百分位。
| SMELT 预算 $C_{\text{tgt}}$ | $S \approx 85\%$ | $S \approx 95\%$ | $S \approx 97\%$ |
|---|---|---|---|
| $10^{20}$ FLOPs | 10.0% [1, 22] | 7.8% [3, 15] | 6.8% [4, 14] |
| $10^{21}$ FLOPs | 18.0% [8, 28] | 15.8% [10, 25] | 14.7% [8, 25] |
| $10^{22}$ FLOPs† | 23.5% [8, 42] | 20.9% [0, 48] | 19.6% [0, 51] |
† 外推到拟合窗口之外。
结论分析:因为 $\gamma_{\text{SMELT}} > \gamma_{\text{base}}$,两条前沿的差距在拟合区间内持续拉开(每列从 $10^{20}$ 到 $10^{21}$ 大约增加 8 个百分点)。$S$ 影响的是增益的水平而非增长率——$S \approx 85\%$ 的 CE Gain 最大,是因为稀疏项 $(1-S)^b$ 放大了差距,而不是差距拉开得更快。摘要引用的 6.8–18.0% 严格取自窗口内的两行,没有引用 $10^{22}$ 那行的 23.5%,且该行两列的 95% 区间下界已经触到 0——这是一处值得称许的克制。
算力最优分配¶
用「每稠密等效参数的 token 数」$\text{TPP} = D^*/(F^*/6)$ 衡量分配($F/6$ 用标准的每参数每 token 6 FLOPs 换算 [31]),在 $C = 10^{21}$ 处:
| $S$ | Baseline TPP | SMELT TPP |
|---|---|---|
| ≈85% | 56 [51, 65] | 56 [44, 77] |
| ≈95% | 78 [71, 90] | 75 [60, 101] |
| ≈97% | 91 [83, 104] | 86 [70, 114] |
结论分析:两种架构想要的分配几乎一样(点估计相差 < 6%,bootstrap 区间几乎完全重叠)。原因藏在 Table 6 里:SMELT 的数据系数 $K$ 更大($5.264\times10^6$ vs $1.975\times10^6$)使它在小 $D$ 时数据受限损失更高(交叉点在 $D \approx 1.6\times10^{10}$ token),但数据指数 $c$ 更大又使该项下降更快,两个效应方向相反、大致抵消。所以 SMELT 的算力节省来自在同一分配下达到更低的损失,而不是来自重新分配预算——这是一个干净且有价值的结论。两种架构的 TPP 都远高于 Chinchilla 对稠密模型报告的 ~20,与稀疏 MoE 偏好更多 token/激活参数的既有观察 [1] 一致。
下游表现与领域分析¶
增益超出验证损失所能预测的部分¶
SMELT 在 DCLM Completion 上赢 96/96 对;DCLM Core 上赢 83/96;MMLU 上在 Baseline 高于随机基线 10 个百分点以上的 30 对中赢 29 对(靠近 25% 随机地板时逐对比较不稳定,故限定范围)。
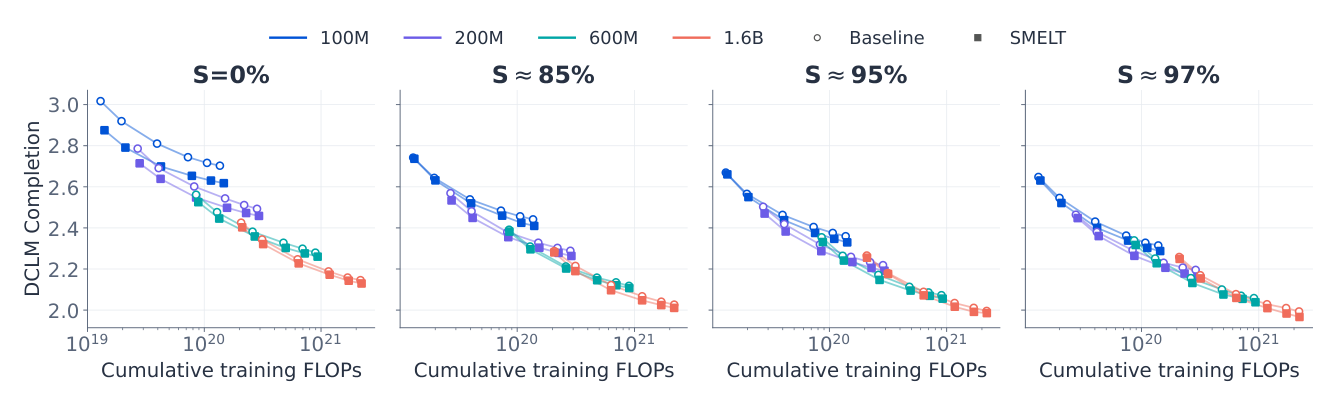
作者随即指出这些胜率只是重述了 Section 4,没有新增信息——验证损失更低的模型本来就该在任何跟随验证损失的 benchmark 上更好。真正的问题是:下游提升是正比于验证损失下降,还是超出它?为此用全部 96 个 Baseline 端点拟合一条从验证损失 $\ell$ 到 benchmark 分数 $y$ 的校准曲线,沿用任务标度工作 [7] 的四参数单调 sigmoid:
$$\hat{y}_m(\ell) = b_m + \frac{a_m}{1 + \exp\left[-d_m \alpha_m (\ell - \tau_m)\right]}, \qquad a_m, \alpha_m > 0 \tag{6}$$
其中 DCLM Completion(损失,随验证损失上升)取 $d_m = +1$,DCLM Core 与 MMLU(越高越好)取 $d_m = -1$。对每个 SMELT 端点 $i$ 定义残差:
$$\delta_i = s \cdot \left(y_i - \hat{y}(\ell_i)\right) \tag{7}$$
$s = +1$ 用于越高越好的指标,$s = -1$ 用于 DCLM Completion,使正的 $\delta_i$ 恒表示「SMELT 优于达到同样验证损失的 Baseline」。校准拟合的 $R^2$ 分别为 0.997 / 0.974 / 0.911。(需要强调:这三个 $R^2$ 属于这条 sigmoid 校准曲线,与式 (2) 的标度面拟合无关——后者只报告 RMSE,未报告 $R^2$。)
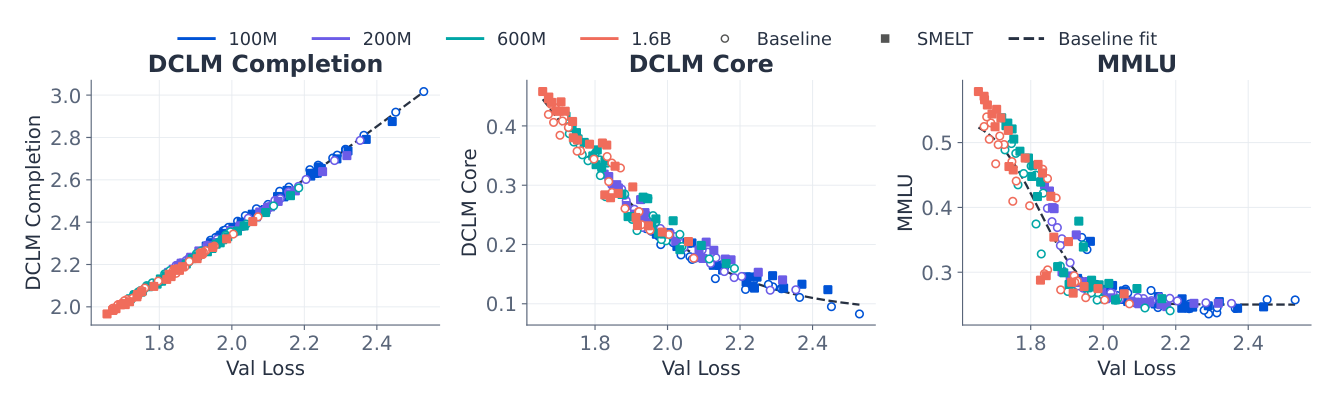
按规模拆分的平均残差(mn = 毫 nats,pp = 百分点):
| 规模 | DCLM Completion (mn) | DCLM Core (pp) | MMLU (pp) |
|---|---|---|---|
| 100M | +1.7 | +0.5 | +0.3 |
| 200M | +6.5 | +0.9 | +1.0 |
| 600M | +11.6 | +1.0 | +2.2 |
| 1.6B | +12.3 | +1.2 | +1.6 |
| All | +8.0 | +0.9 | +1.3 |
按 DCLM 领域类别拆分:
| 规模 | Reading Compreh. | World Knowledge | Commonsense | Language Underst. | Symbolic Problem |
|---|---|---|---|---|---|
| 100M | +4.7 | +0.7 | −0.6 | +1.0 | +0.3 |
| 200M | +1.7 | +0.2 | +0.4 | +0.7 | 0.0 |
| 600M | +1.5 | +0.3 | +2.4 | +0.4 | +0.9 |
| 1.6B | +1.3 | +0.1 | +1.0 | +1.0 | +1.9 |
| All | +2.3 | +0.3 | +0.8 | +0.7 | +0.7 |
结论分析:平均残差在每个 benchmark、每个规模上都为正,且在 DCLM Completion 与 DCLM Core 上随规模单调增长,MMLU 上两个大规模超过两个小规模。领域拆分显示 Reading Comprehension 在全规模池化时超额最大,但主导类别随规模迁移——1.6B 处 Symbolic Problem Solving 反超,暗示第二次访问随模型容量增长而越来越利好结构化推理。注意 100M 的 Commonsense 是 −0.6 pp,是全表唯一负值,说明小规模处这套残差信号本身不稳。
增益集中在结构化数据上¶
要在数据子集上算 CE Gain 就需要该子集的标度面,但单个子集不足以独立拟合六个系数。作者的做法是:共享聚合拟合的指数 $(a,b,c)$,只按子集拟合截距 $(E_s, A_s, K_s)$,两种架构分别拟合,然后在 $C=10^{21}$、$S\approx95\%$ 处套用 CE Gain 反演。
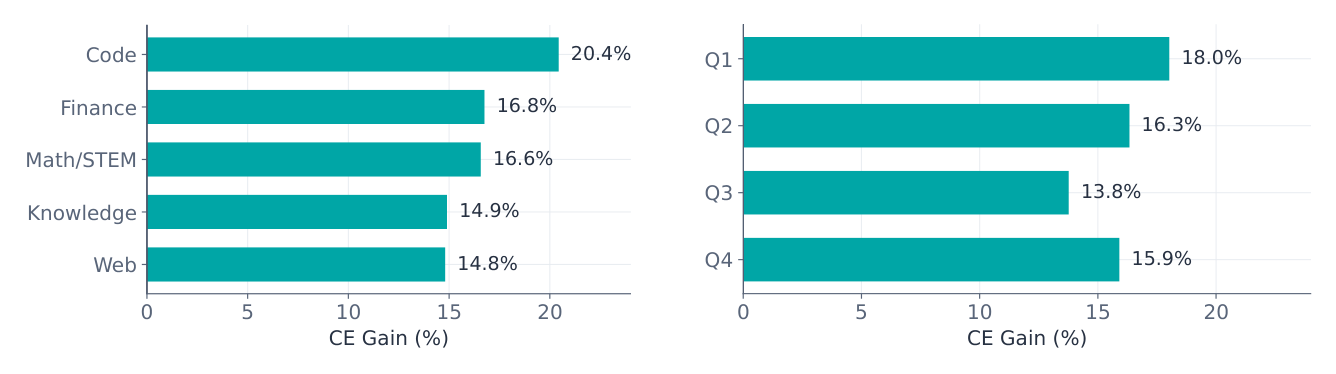
| 按领域 | CE Gain | 按 Baseline 损失分位 | CE Gain | |
|---|---|---|---|---|
| Code | 20.4% | Q1(Baseline 损失最低) | 18.0% | |
| Finance | 16.8% | Q2 | 16.3% | |
| Math/STEM | 16.6% | Q3 | 13.8% | |
| Knowledge | 14.9% | Q4(最高) | 15.9% | |
| Web | 14.8% |
结论分析:五类全为正,Code 领先,排序跟随内部结构强度——Code 有严格语法和长程依赖,Web 文本约束最弱。分位轴上不是单调的:从 Q1 降到 Q3 最低(13.8%)再在 Q4 反弹(15.9%)。作者选择只解读 Q1 端(它与领域拆分吻合,因为 Code 既结构最强、Baseline 损失也最低、CE Gain 也最高),并诚实地说 Q4 为什么反弹「不是我们的数据能定论的」,猜测 Q4 混杂了真正噪声的来源与「难但有结构」的来源。
增益随样本长度与 in-context 示例数增长¶
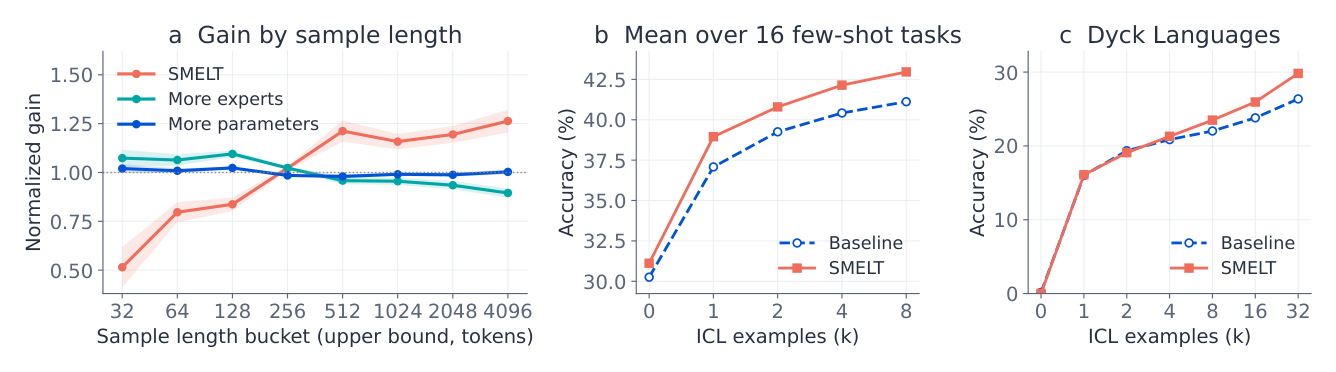
按文档自身 token 数分八个长度桶(上界 32, 64, …, 4096),构造三族对照并把每对的逐桶改善按其均值归一化,只比较形状:
- SMELT vs 匹配 Baseline:四个最长桶的平均归一化增益是四个最短桶的 1.52×;
- 对照族「加专家」(Baseline 内相邻稀疏档 $S$: 0%→85%→95%→97%):比值 0.88,甚至略偏好短样本;
- 对照族「加激活参数」(Baseline 内相邻规模):比值 0.98,长短几乎一样。
也就是说这种「向长样本倾斜」是循环特有的,不是任何形式的扩容都会带来的。
ICL 侧:在 16 个 few-shot 任务(15 个 DCLM 任务 + MMLU)上扫 $k \in \{0,1,2,4,8\}$(部分任务额外扫到 16、32),Baseline 与 SMELT 的差距在 $k=0$ 时是 0.9 pp,一旦有示例($k=1$)就扩大到 1.9 pp,并保持到 $k=8$。特别突出 Dyck Languages:这是一个示例敏感的精确匹配任务,两种架构在无示例时都接近 0%,唯一的提升途径是读示例答案;在这个任务上差距持续拉开而非饱和,$k=32$ 时 SMELT 29.8% vs Baseline 26.4%。附录 C 给出 16 个任务中 14 个(最大 shot 处增益在配对置换检验下 $p<0.05$)的逐任务曲线。
第二次访问内部发生了什么¶
用 1M-token 留出样本在所有匹配对上探测路由、残差流与注意力。
专家路由:复用核心子集,其余分散¶
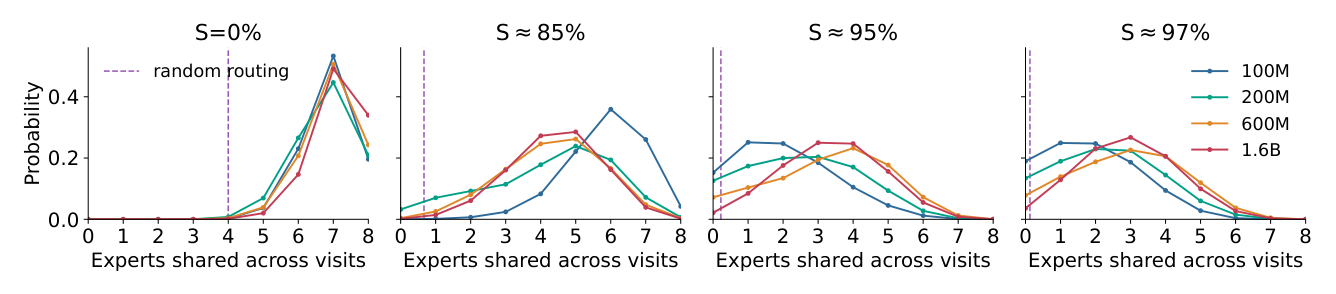
同一 token 在同一物理 MoE 层的两次访问中,top-8 专家集合的交集数:$S=0\%$(专家池最小)时几乎复用全部 8 个;随稀疏度上升、池子扩大一个数量级以上,重叠降到 2–3 个,但仍远高于独立随机路由的期望($8^2/n$)。结论:路由器有意复用一个核心子集,其余分散化。
残差流:第二次写得更多,且方向一致¶
在 pre-norm 分解下(实现用 RMSNorm [66]),循环跨度内每个子层更新按 $1/r$ 缩放:
$$\Delta x^{\text{attn}}_{\ell} = \frac{1}{r}\,\text{Attn}\big(\text{LN}(x_\ell)\big) \tag{8}$$
$$\Delta x^{\text{moe}}_{\ell} = \frac{1}{r}\,\text{MoE}\big(\text{LN}(x_\ell + \Delta x^{\text{attn}}_{\ell})\big) \tag{9}$$
完整层更新 $\Delta x_\ell = \Delta x^{\text{attn}}_\ell + \Delta x^{\text{moe}}_\ell$,MoE 子层看到的是已经被缩放过的注意力写入;跨度之外 $r=1$,退回标准 pre-norm 形式。
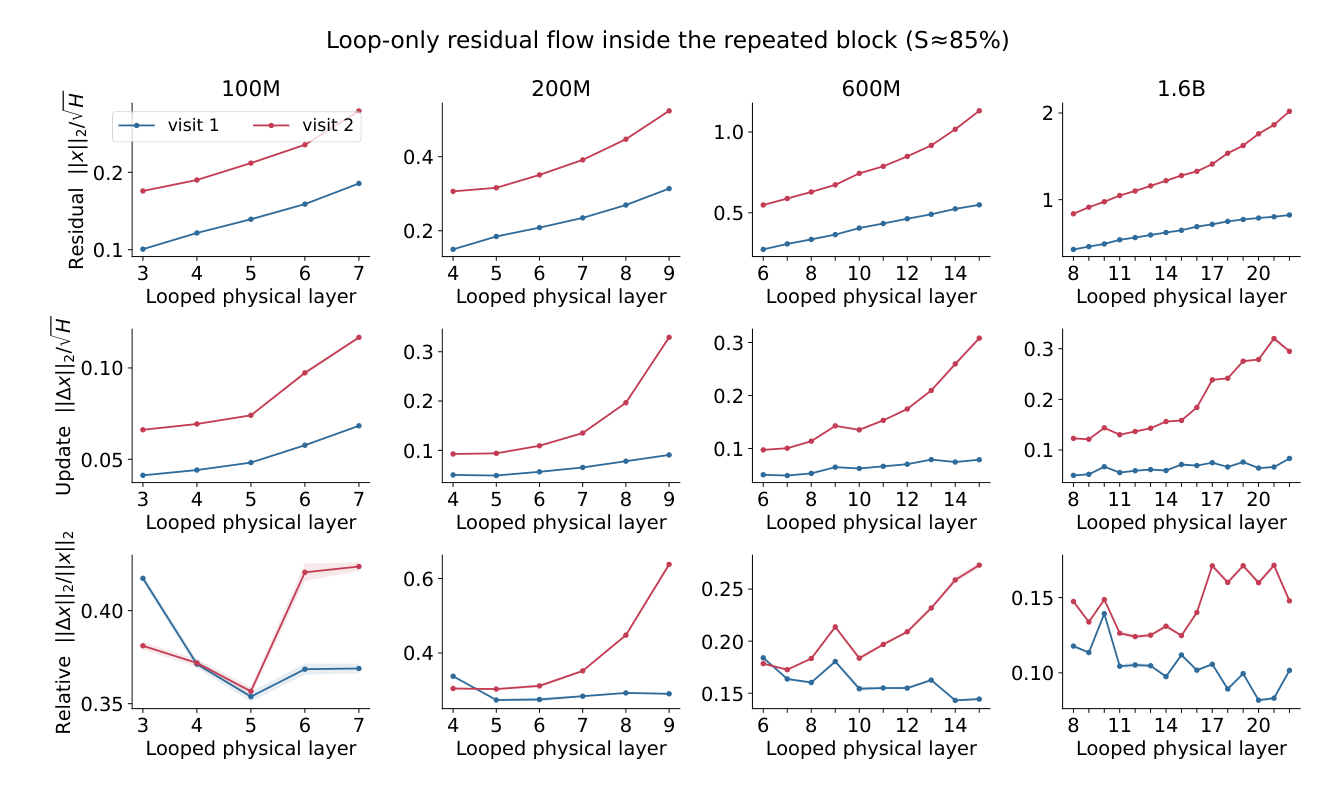
在全部 16 个格点上,四个范数比(完整更新 $\Delta x_\ell$、注意力写入、MoE 写入、喂给下一子层的 RMSNorm 输出)全部 > 1,范围 1.2–3.5×。具体地,1.6B / $S\approx97\%$ 处完整更新比达 3.25、注意力写入比 3.48、MoE 写入比 3.22、下一输入范数比 1.61。由于 RMSNorm 会消掉输入尺度,第 h 项(下一输入范数比 > 1)反映的是残差流方向发生了偏移——逐元素增益 $g$ 对不同维度放大不均,方向变化本身就改变了输出范数。
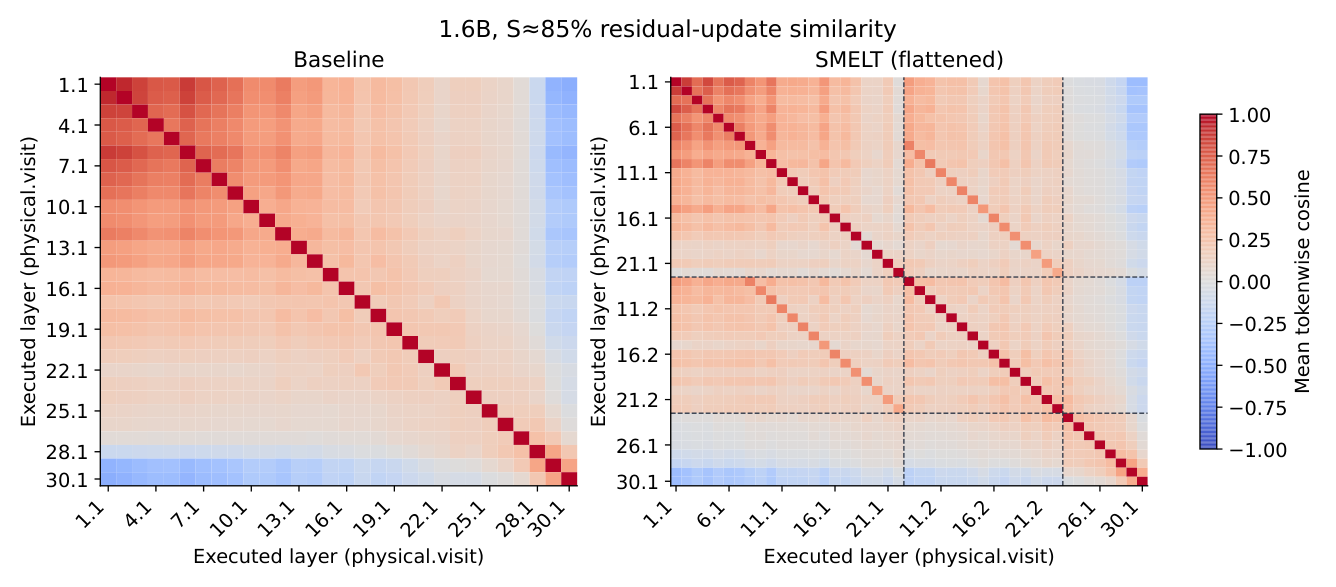
跨访问同物理层的残差更新余弦为 0.42–0.65(均值 0.56),而非匹配的跨访问对均值仅 0.16。第二次访问不是覆盖第一次,而是放大它。
注意力:检索坐标保留,读取内容改变¶
$$\hat{x}_\ell = \text{LN}(x_\ell),\quad Q = \hat{x}_\ell W_Q,\quad K = \hat{x}_\ell W_K,\quad V = \hat{x}_\ell W_V,\quad P = \text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right) \tag{10}$$
注意力上下文为 $PV$,写入残差流的输出为 $O = PV W_O$。对 $X, Q, K, V, PV, O$ 六个量分别算两次访问间的余弦:
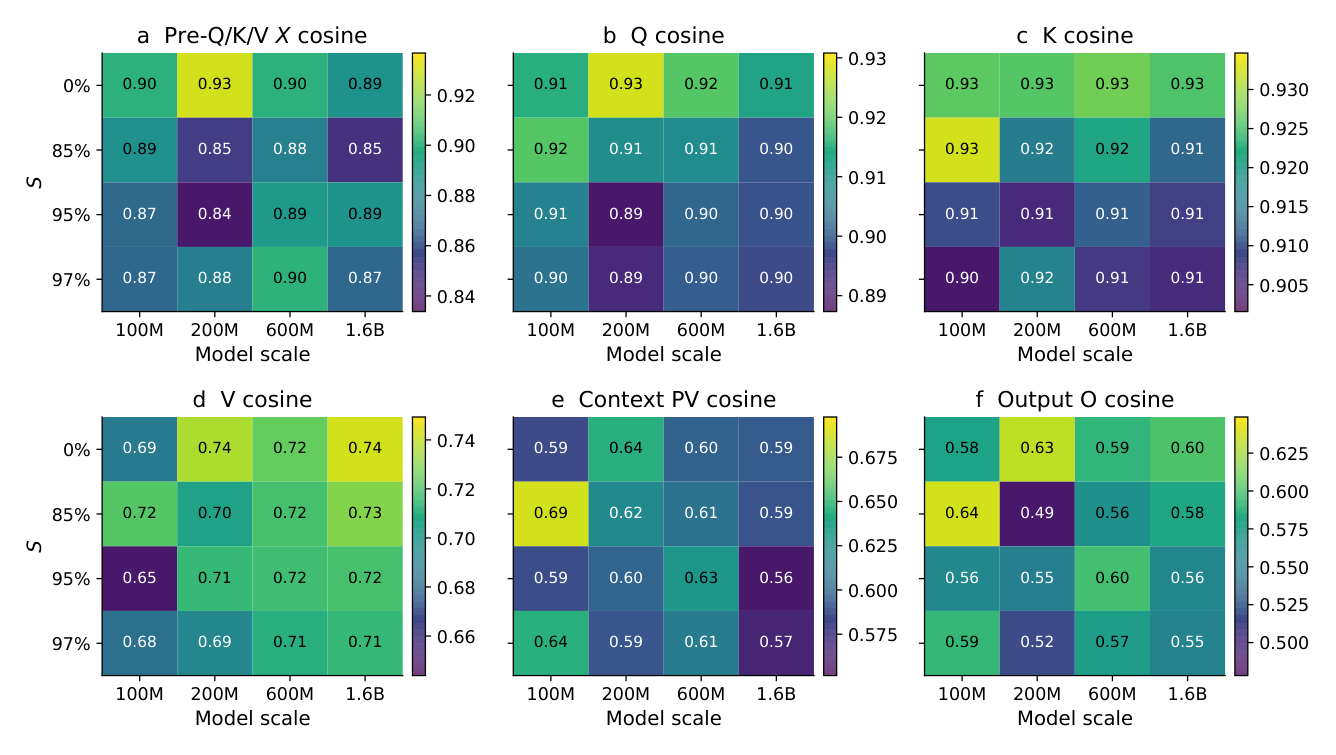
共享输入 $X$ 的跨访问余弦本身是 0.84–0.93;$Q$ 与 $K$ 在全部 16 格保持 0.89–0.93,达到或高于输入自身的水平;$V$ 掉到 0.65–0.74,$PV$ 与 $O$ 进一步发散到 0.56–0.69 与 0.49–0.64。发散来自 value 投影,而不是它读取的输入。
离散层面验证:每个 head 记录两次访问的 top-8 被注意 token 并算交集,跨访问重叠 56–66%,而「同层不同 head」的对照只有 28–34%。从最多 4096 个位置里选 8 个还能保住一半以上,说明检索模式被保留,且这种重叠是 head 特异的而非位置偏置的产物。
Dyck 案例与注意力汇聚的减弱¶
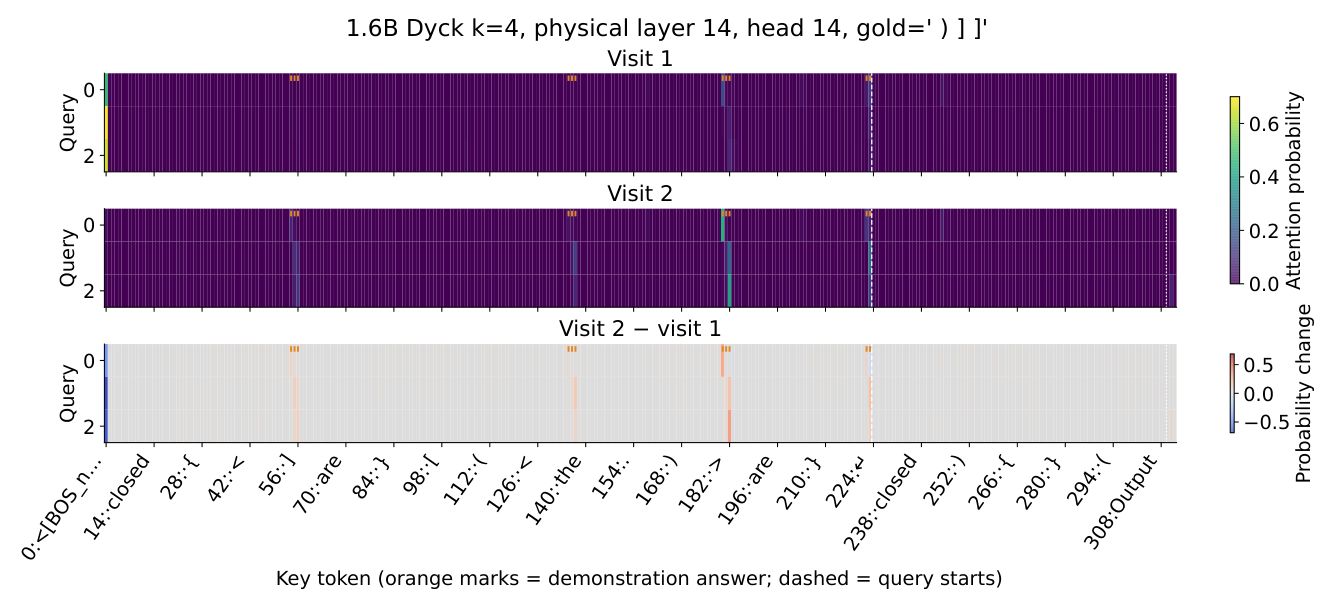
对每个规模,通过逐个消融循环块内的注意力头、选出消融后 Dyck 困惑度上升最多的那个「Dyck head」。在 1.6B、$k=4$ 的例子上:visit 1 把质量集中在 segment 起始的 BOS 汇聚点及邻近位置(仿佛还不知道该看哪儿);visit 2 汇聚几乎消失,质量转移到前缀里的示例答案。三个目标位置平均,BOS 质量从 0.60 → 0.02,示例答案质量从 0.24 → 0.85——汇聚失去的几乎恰好等于示例得到的。
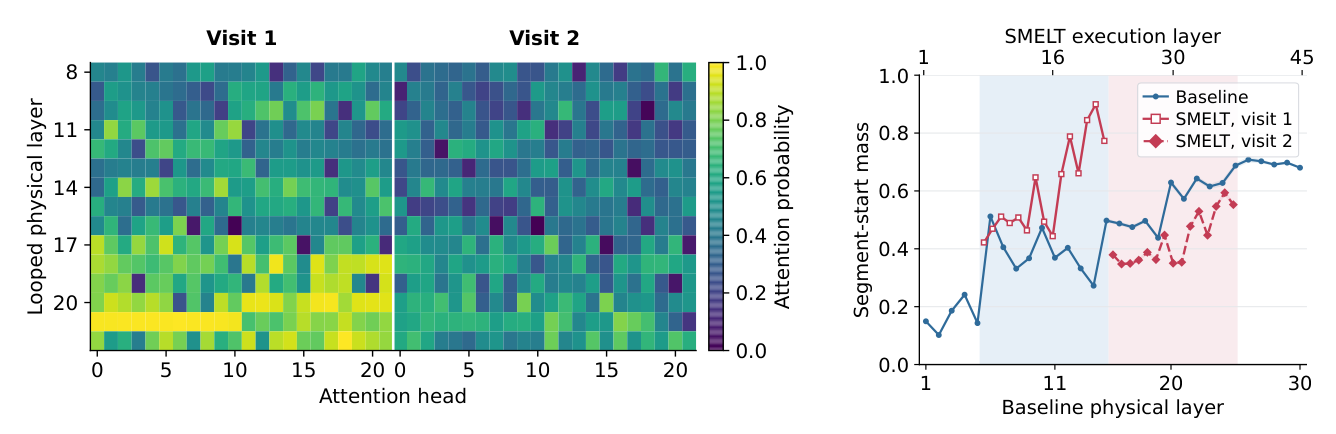
在覆盖全部五类来源的 1M-token 留出样本上重复测量,逐 head 热图显示 visit 1 中的高质量单元在 visit 2 普遍「冷却」。更关键的是,这个减弱逆着通常的深度趋势:在同物理深度对齐下,Baseline 的汇聚质量随层数增长(与标准 Transformer 中汇聚随深度加强的观察 [6, 52] 一致),而 SMELT 的 visit 2 在整个循环块内始终低于 visit 1。第二次访问因此没有继承它在执行序列中靠后的位置本应带来的更大汇聚。
核心贡献总结¶
- 一张把「对照口径」量化的表(Table 1):把七项 looped Transformer 研究按 FLOPs / 参数 / KV 三个预算是否匹配逐项打勾,这本身就是对领域的清理工作。
- 一套让三重预算匹配成为可能的机制:用 MoE 的「总参数 ⟂ per-token FLOPs」解耦性,把循环的额外算力用收窄 $H$ 偿还、把丢掉的容量用加专家补回、把 KV 用 head size + GQA 比例找平。
- SMELT 配方:循环中间 50% 两次 + 更大的有效深宽比 + $1/r$ 残差缩放,配方本身简单到可复制。
- 跨四个规模的双标度面:为两种架构各自拟合六系数曲面(无共享 loop 指示项),把「循环赢了多少」翻译成前沿上的算力节省 CE Gain,并用 cell bootstrap 给出区间。
- 一个「下游超额」的量化框架:用 Baseline 端点拟合 loss→benchmark 的 sigmoid,再看 SMELT 的残差——把「下游提升超出验证损失所能解释的部分」变成可测量的量。
- 一条机制层的内部签名:两次访问复用检索坐标($Q/K$ 高相似)、改变读取内容($V$ 低相似)、放大而非覆盖残差写入(范数比 1.2–3.5×、余弦 0.56)、并减弱注意力汇聚(BOS 0.60→0.02)。
与已归档相关工作的对比¶
Loopie Loopie: Loop the Loopies! (IQuest Research, 2026-07-17)¶
关系:显式引用但原文未展开对比(仅在 related work 两句 + Table 1 一行提及,无任何头对头数据)· 已加载对方精读
- 共同关注的问题:两篇的开场诊断几乎逐字同构。Loopie 也把既有循环成果归因于同一个记账错误——把模型循环 $N$ 次预训练算力就乘以 $N$,所以 Ouro-2.6B(4 步循环)真正的对手是 10.4B 量级、Huginn-3.5B(32 步)的对手是约 112B;它同样引用了「iso-FLOP 下循环模型容量反而更少」的既有结果,同样把主流认知概括为「循环改善的是参数效率而非算力效率」,并同样指出既有循环工作停在稠密骨干、必须与 MoE 兼容才有天花板。两篇都把结论表述为「把循环从省参数的手段重定义为算力匹配的扩展轴」。
- 相近的技术骨架:都是「取一个强的非循环 MoE 参考模型 → 减半存储深度、设 $R=2$ → 把省下的预算回投到容量 → 在同一预算下比」。两支团队独立地都把最优循环次数定在 2——SMELT 从 200M 消融(Table 5)得出,Loopie 从 6B/20B 得出,这是本文引用它的唯一理由("independently find two loop steps optimal, corroborating our loop-count ablation")。
- 本文的差异与推进:SMELT 匹配的是解析 per-token FLOPs + 总参数 + KV cache 三项;Loopie 匹配的是 Megatron-LM 里实测的 optimizer-step 墙钟时间,并且坦率承认自己不匹配理论 FLOPs——Loopie-20B-A2B 的领先阶算力代理是参考模型的 1.424×,即多做约 42% 名义计算,靠 microbatch 翻倍带来的 MFU 提升(261.53 vs 189.65 TFLOPS/s,+38%)抵掉。两者因此是互为盲区的一对:SMELT 的口径能干净归因架构效应但对硬件效率完全沉默(它自己在 Conclusion 里承认这点),Loopie 的口径直接对齐部署成本但无法区分「架构赢了」与「kernel 与调度赢了」。
- 可比的方法 / 实验差异:(a)循环形态相反——Loopie 论证 layer-loop(每层就地循环完再传给下一层)优于 model-loop(整段栈展开),理由包括流水线并行下 model-loop 会在每个循环边界把末 stage 输出送回首 stage、制造环形依赖;SMELT 用的正是中段的 model-loop,且没有讨论过这一层。(b)交叉点位置:Loopie 报告 Loopie-20B-A2B 在约 600B token 才反超 vanilla baseline,layer-loop 在约 1.2T token 才反超 model-loop,并由此推论「小规模短训练的对比会系统性低估这条路线」;SMELT 全部 run 的最长分支只到约 215B token,恰好落在 Loopie 所说的交叉点之前——两篇都得出循环赢,但 SMELT 的胜负是在 Loopie 认为尚未分晓的区间里判出来的。(c)Loopie 训到 3.5T token 并做了 SPT + RL 后训练与开源模型交付,SMELT 只做预训练评测、无后训练与部署。
Parcae Parcae: Scaling Laws for Stable Looped Language Models (UC San Diego + Together AI, 2026-04-14)¶
关系:显式引用但原文只取其标度律结论、完全未engage其稳定性贡献 · 已加载对方精读
- 共同关注的问题:两篇都在问「循环能不能成为一条正交于参数与数据的可预测算力扩展轴」,都用 Chinchilla 的两类拟合(isoFLOP 抛物线 + 参数化 $\hat L = E + X N^{-x} + Y D^{-y}$、Huber on log-loss + L-BFGS)来回答,也都聚焦 Saunshi 论证过最有效的 middle-looped(prelude–recur–coda)形态。
- 相近的技术骨架:SMELT 在 Section 3.1 用 $1/r$ 残差缩放,理由是「防止相关的权重绑定更新在多次访问间把残差流吹大」。Parcae 处理的正是同一个失效模式,但把它抬到了机制层:把前向重写为残差流上的动力系统 $h_{t+1} = \mathbf{A}h_t + \mathbf{B}e + \mathcal{R}(h_t, e)$,线性化成离散 LTI 系统后指出既有注入方式的谱半径不满足稳定判据——加法注入给出 $\rho(\mathbf{A}) = 1$(边缘稳定),拼接注入的 $\mathbf{A}$ 完全无约束(不稳定),并实证发散的 run 全部学到 $\rho(\mathbf{A}) \ge 1$(最高冲到 7 以上)、残差范数爆到 $10^{17}$ 量级。Parcae 的解法是把 $\mathbf{A}$ 参数化为负对角矩阵 $\text{Diag}(-\exp(\log\mathbf{A}))$ 再 ZOH 离散化,从而结构性保证 $\rho(\bar{\mathbf{A}}) < 1$,学习率从 2e-4 到 1e-3 五档全收敛(baseline 只在 2e-4 收敛)。
- 本文的差异与推进:SMELT 引用 Prairie et al. [47] 只用于标度律——Table 1 把它记为「固定参数下拟合最优递归次数,但深度、推理 FLOPs、KV cache 都随 $r$ 增长,因此无法把每参数的共享代价与膨胀的预算分离」,related work 里把它与 Schwethelm 并列为「从相反两侧夹住问题」的两个端点。SMELT 从头到尾没有提及 Parcae 的稳定性诊断,$1/r$ 缩放的出处标的是 [62] 而非 Parcae。这是一处真实的未打通:SMELT 用一个经验常数解决的问题,归档里已有一篇给出了谱半径层面的充分条件,两者本可互相加强(SMELT 的 $1/r$ 恰好把加法注入的 $\rho(\mathbf{A})=1$ 压到 $<1$,Parcae 的框架能解释为什么它有效)。
- 可比的方法 / 实验差异:Parcae 是稠密骨干、循环整个中段三分之一、最大 1.3B 参数 / 100B token,主打训练稳定性 + test-time scaling(推理时增加循环次数的收益遵循饱和指数衰减,其下界正好等于训练律在 $T=\mu_{\text{rec}}$ 处的预测值,两条律可合并);SMELT 是 MoE 骨干、固定 $r=2$ 不做 test-time 深度采样、最大 54B 总参数 / 215B token,主打预算匹配下的归因。SMELT 完全放弃了 Parcae 强调的「按 token 自适应算力」这条循环特有的能力——它的 $r$ 是硬编码的 2。
Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse MoE (Amazon AGI Foundations, 2026-08-11)¶
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇针对的是同一个 root cause 的两半——「算力预算是与架构无关的常数」这个从未被质疑的隐含假设。SMELT 攻击的是它的分子侧:既有 looped 评测把额外的 FLOPs 记成架构优势,所以必须把 FLOPs 锁死再比。MOSAIC 攻击的是它的分母侧:两个「预测 loss 相同」的架构,一旦算上各自能达到的 MFU 与最优并行布局,实际吞吐可差好几倍,所以 model-FLOPs 预算本身就不是公平的货币。两篇都明确把「per-token model FLOPs 作为公平性度量是否充分」当成待质疑的对象。
- 相近的技术骨架:都是「给 MoE 拟合一条带稀疏度变量的多维标度律,然后在拟合面上求最优配置」。SMELT 的 $L(F, S, D) = E + A(1-S)^b F^{-a} + K D^{-c}$ 与 MOSAIC 的四维 $L(N_{\text{tot}}, S, D, G)$ 是同一族构造(都承自 Clark / Abnar / Krajewski 那条给容量项补路由变量的线),两者甚至都用 Chinchilla 的 Huber-on-log-loss + L-BFGS 拟合协议,都在稀疏度轴上做 isoFLOP 式的扫描。
- 本文的差异与推进:MOSAIC 做了 SMELT 在 Conclusion 里明确承认自己没做的那一步——它把系统阶段折叠进标度律阶段,用一个算子级解析性能模型预测 MFU / 显存 / 最优并行布局(最高 18B 激活参数网格上 MAPE < 15%),再把可交付算力 $C_{\text{deliverable}} = C_{\text{peak}} \cdot \text{MFU} \cdot \eta_{\text{good}}$ 作为约束,联合优化架构、token 数与执行计划。SMELT 反过来做了 MOSAIC 没做的:它在同一条标度阶梯上并排放了两种架构,因而能把差异归因到一个具体的架构变换(循环)而非仅仅是配置搜索。
- 可比的方法 / 实验差异:MOSAIC 一个非常直接的发现值得对照 SMELT 读——在纯 model-FLOPs 预算下,MoE 稀疏度不存在内点最优:拟合 loss 随稀疏度单调下降,最优解永远贴在数据支撑的上边界;只有加上集群约束后内点最优才出现($S^*_{\text{cluster}}$ 处的 loss 比 $S=S_{\max}$ 处低 0.031 nats)。SMELT 的式 (2) 里 $b = 0.146$–$0.153 > 0$,容量项随 $1-S$ 减小而单调减小,结构上就是 MOSAIC 所说的边界解。更值得注意的是方向:SMELT 的 CE Gain 在 $S\approx85\%$ 最大(18.0%)、$S\approx97\%$ 最小(14.7%)——也就是说,FLOPs-only 的定律会把你往稀疏度上界推,而循环的相对收益恰好在那个方向上收缩。MOSAIC 还给了另一层压力:SMELT 的匹配把每层专家数从 192 提到 288、336 提到 504,这正是 MOSAIC(及归档里的 EMO EMO)指出的「FLOPs 不变但 all-to-all、优化器状态显存、小 per-expert GEMM 全部变贵」的那条轴。
Step 2.5 剔除的近似候选与理由:TokenMixer-Large(2602.06563,字节)——同样诊断「为什么堆不深」并同样引入 MoE,但 root cause 不同(mixing-reverting 导致的表示退化,解法是新增带层间残差的层),SMELT 是复用已有层且不涉及表示坍缩,域也从 CTR 排序跨到 LM,判为不同源,不拉入。LoopCTR(2604.19550,RUC)——解法骨架(共享 Loop Block + MoE + 多深度监督)确实相近,但问题陈述是「为 CTR 找第四条扩展轴」,不是「对照口径把额外算力误记为架构优势」,且其 train-multi-loop / infer-zero-loop 的目标与 SMELT 正相反。EMO(2605.13247,USC ISI)——问题高度同构(per-token FLOPs 只数 $k$ 个激活专家而实测墙钟跟随整个池子 $E$,$E$ 从 8 到 128 慢 1.72×),但解法是渐进式扩专家的训练课程,与 SMELT 的循环配方无抽象重合,只作为上文 MOSAIC 一节的佐证引用。Skaling(2608.07222,FAIR) 与 Small-Scale(2608.11859,FAIR MSL)——两篇都直接冲击 SMELT 的拟合方法论(前者证否加性 Chinchilla 形式的零交叉导数,后者证明标度律只在超参调优前沿上才浮现),但它们的解法是「换拟合形式 / 加密超参扫描」,与 SMELT 的「匹配预算 + 分别拟合」没有流程图层面的重合,属批评来源而非孪生工作,改在「讨论与局限性」中引用。DeRes(2606.07980)——修辞手法相同(用更陡的拟合标度指数 $\gamma$ 主张架构优越,0.118 vs 0.071),但解法是残差连接重设计,域为 CTR,不入选。
讨论与局限性¶
复核一:「旧错」是真实存在的,且被准确刻画,不是稻草人¶
这一点复核结果是成立的。三条理由:
- 算术上无可争议。「循环 12 层到 24 层执行,存一半权重却花 24 层的 per-token FLOPs 并需要完整 KV cache」这句话本身就是定义性的,不需要实验支持。Huginn / Ouro 这一路把成绩表述为「匹敌数倍于自己参数量的模型」,而参数量与算力在循环下确实脱钩,这个错位是真的。归档里的 Loopie Loopie 独立地做了同样的诊断,并把它换算成具体数字(Ouro-2.6B 的真正对手是 10.4B、Huginn-3.5B 的是约 112B),两支互不相关的团队指向同一处记账问题,这本身就是「旧错真实」的旁证。
- 本文没有把前人一律打成没做过控制。Table 1 明确给 Schwethelm et al.、Saunshi et al.(部分)、LoopMoE 打了 FLOPs ✓,并且照抄了对自己不利的结论——Schwethelm 在等 FLOPs 下发现循环输,Saunshi 在 iso-FLOP 下发现循环模型 perplexity 更差。一篇立稻草人的论文不会把两个反例写进引言。
- 但「旧错」的剩余空间比本文暗示的小。摘要写 "most evaluations compare at fixed model size",而它自己的 Table 1 里七项工作中已有三项做了某种算力控制,其中 LoopMoE 已经同时匹配 FLOPs 与参数(差的只是 KV),Loopie 匹配的是比 FLOPs 更贴近部署的墙钟。所以本文真正的增量并不是「第一个想到要匹配算力」,而是「第一个把三个预算同时封死 + 铺成标度阶梯」——正文的表述是准确的("the first multi-scale study that closes all three budgets simultaneously"),摘要的表述偏松。
一处真正的方法论缺口:SMELT 的结论(循环在匹配算力下赢)与 Schwethelm et al. 的结论(循环在匹配 FLOPs 下输)符号相反。本文把这个翻转归因于「Schwethelm 固定 FLOPs 的同时压缩了循环模型的独立参数,所以亏损可能来自参数损失而非循环本身」。这个解释合理,但没有被实验隔离:SMELT 与 Schwethelm 至少差了两个变量(MoE vs 稠密骨干;参数是否补齐),本文没有跑一个「MoE + 不补参数」或「稠密 + 补参数」的对照来指认哪一个变量翻转了符号。结论因此在逻辑上仍是「在我们的设定下赢」,而不是「Schwethelm 错在哪里」。
复核二:本文自己的 compute-matched 口径——比归档先例严,但仍不是实测¶
算力是解析核算,不是实测。 需要拆成三层看:
- 优于 $6N$:$F$ 不是 parameter-only 的 $6N$ 近似,而是逐配置核算、并在实测的平均文档长度处计入注意力成本(因为 segment mask 把注意力限制在单篇文档内),原文明确说它因此超过 $6N$。这比归档里 AMBER 与 Qwen3.8-Next 头条算力数字的推导方式更细。
- 循环的重复前传成本被完整计入 ✓。这是最关键的一条,也是本文口径最扎实的地方:$S$ 的定义里 FLOPs "count every block execution",整个收窄 $H$ + 加专家的匹配流程存在的唯一理由就是偿还额外访问的算力。这一点上不存在漏记。
- MoE 的路由与通信开销完全没有计入 ✗。FLOPs 核算只覆盖注意力 + 被选中的 top-8 专家权重 + norm + router 权重。all-to-all 通信、专家并行的 dispatch/combine、负载均衡代价、小 per-expert GEMM 的 kernel 效率损失全部在账外。这不是我推测——作者在 Conclusion 里主动写明:「our budget matching equates arithmetic FLOPs, parameters, and KV-cache size, not wall-clock cost; serial block re-execution and sparse routing might introduce hardware-efficiency gaps that require systems-level optimization to close.」 而这个缺口不是小事:SMELT 的匹配手段恰恰是把专家数从 192 提到 288、从 336 提到 504,也就是往 Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts MOSAIC 与 EMO EMO 都实测过「FLOPs 不变但墙钟显著变慢」的那条轴上加码(EMO 测到 $E$ 从 8 到 128 在激活参数固定时慢 1.72×)。同时 SMELT 的中段 model-loop 还带来 Loopie Loopie 指出的流水线环形依赖问题。因此 6.8–18.0% 的「训练 FLOPs 节省」不能直接读作 6.8–18.0% 的成本节省,两者之间隔着一个作者自己承认没测的 MFU 差。
一个作者没有点破的不对称:残余错配是单边的。 Table 10 的 16 个格点中,$F_{\text{SMELT}}/F_{\text{Base}}$ 无一低于 1.000,稀疏格点均值约 +2.1%,最高 +4.6%。也就是说每一次「匹配」都给了 SMELT 不少于 Baseline 的算力。作者报告的是绝对值上界(「最大 3.9%」),这个表述掩盖了符号的系统性。所幸头条数字基本免疫——原文明确说每个 run 以其实测 $F$ 进入拟合、CE Gain 在共同 $(C,S)$ 坐标上求值,+2% 被吸收进了横轴。但 Section 3 的三张消融表与 Section 5 的 96/96 逐点胜率没有这层保护:Table 3 里 50% 跨度对 Baseline 的验证损失优势是 1.9445−1.9257 = 0.019 nats,而该格点 SMELT 多花了约 2% FLOPs;96/96 的完胜同样是在名义匹配、实际 SMELT 略占优的条件下数出来的。这些数字不算作废,但它们的边际部分需要打折。
另有两处口径松动:(a)active params 不匹配且差距很大——1.6B 规模 SMELT 的 1.081B vs Baseline 的 1.632B,只有约 2/3。这是三重匹配的必然代价(收窄 $H$ 后每次执行激活的参数变少,但执行次数翻倍),逻辑自洽且已披露,但「激活参数量」是很多读者默认关心的第四个量。(b)每个配置只训一次,作者自己声明标准误只覆盖 10 个评测种子、不含训练波动。Table 5 里 3× 与 4× 的非单调回退就是这种噪声的直接证据。
总评:这套口径在归档里属于上游水准——它是归档中少数把「重复前传成本」明确计入而非绕过的工作,比 AMBER 与 Qwen3.8-Next 的推导式头条数字扎实;但它是解析 FLOPs 匹配,不是实测算力匹配,且在 MoE 通信开销、单边残余错配、单次训练三处留有可攻击面。作者对第一点和第三点主动披露,对第二点没有点破。
复核三:这是一条「够格的趋势」,还不是「律」¶
逐条核对:
- 拟合点数:144 个端点(每架构 72 个),拟合 6 个自由系数。但 6 条衰减分支来自同一条稳定期 run 的 6 个 checkpoint,不是独立训练。真正独立的样本单位是 12 个格点(4 规模 × 3 稀疏度)。作者显然清楚这一点——bootstrap 重采样的是格点而非端点,这是正确的重采样单位,值得肯定。但 12 个独立单元拟合 6 个系数,自由度是紧的。
- 跨越数量级:$1.3\times10^{19}$ → $2.2\times10^{21}$ FLOPs,即 2.2 个数量级(约 170 倍);active 参数 100M → 1.6B,仅 16 倍。作为对比,Chinchilla 跨 70M–16B 参数、$5\times10^{18}$ 以上的算力。SMELT 的窗口在标度律文献里属于偏窄的一档。
- $R^2$:本文没有为标度律报告 $R^2$,只给 RMSE(Baseline 0.00554 nats、SMELT 0.00952 nats)。文中出现的 $R^2 = 0.997 / 0.974 / 0.911$ 属于 Section 5.1 的 loss→benchmark sigmoid 校准曲线,是完全不同的一次拟合,不能拿来给标度面背书。这一点在快读时极易混淆,需要明确区分。
- 关键差异的量级:$\gamma_{\text{base}} = 0.237$ vs $\gamma_{\text{SMELT}} = 0.250$,相对差 5.5%;来源是 $a$ 差 0.019、$c$ 差 0.042。且 SMELT 的拟合 RMSE 是 Baseline 的 1.7 倍(0.00952 vs 0.00554)——整个「SMELT 前沿更陡」的论断压在两条曲面中噪声更大的那一条的指数上。本文没有给 $a, b, c, \gamma$ 单独的置信区间,只给了下游 CE Gain 的 bootstrap 区间。
- 区间宽度:$C=10^{20}$ 时 $S\approx85\%$ 的 10.0% [1, 22],下界几乎触零;外推到 $C=10^{22}$ 时两列的下界就是 0。也就是说这条律在窗口内能支持「有正收益」,但支持不了「收益是某个精确数值」。
- 一个结构性的尴尬:拟合出的 $E_{\text{SMELT}}$ (1.4493) 高于 $E_{\text{base}}$ (1.4439),字面上意味着 $C \to \infty$ 时 SMELT 反而输。作者的处理是诚实的(0.005 nats < 两者的 RMSE,归为噪声,并声明预测 $10^{25}$ 需要在那个规模上训练来锚定),但这也说明拟合面在不可约项上没有分辨力。
- 最弱的一环:Section 5.2 的分领域 / 分位 CE Gain(Code 20.4% 领先等)共享了聚合拟合的指数 $(a,b,c)$,只重拟合截距,且 Figure 10 没有给任何 bootstrap 区间。所以「Code 收益最大」这条被摘要点名的结论("is largest on Code")实际是一个借用曲率、只由截距驱动、且无区间的排序,是全文定量声明中最软的一条。
总评:介于「趋势」与「律」之间,更靠近一条纪律良好的趋势。支持「律」的一侧:两条曲面各自独立拟合六系数、不走共享系数捷径;两边用完全相同的拟合流程;bootstrap 重采样在格点这个正确的单位上;$S=0$ 因 regime 不同被排除并说明理由;摘要拒绝引用外推到 $10^{22}$ 的 23.5%。支持「趋势」的一侧:2.2 个数量级、16× 参数范围偏窄;独立单元只有 12 个;无标度面 $R^2$、无指数置信区间;关键指数差仅 5.5% 且落在噪声更大的那条曲面上;分领域结论借用曲率且无区间。值得注意的是,本文自身的措辞是克制的——正文一律说 "fitted surfaces"、"the window the fitted surfaces are supported on",「Scaling Laws」只出现在标题里。
补充一条归档内的交叉压力:Small-Scale Experiments: Are We There Yet?(FAIR MSL)证明标度律只在超参完全调优的前沿上才浮现,每个规模只有 4 个配置时律根本不可见、到 256 个才准确;SMELT 每个格点只训了一次,两种架构的超参是各自「按同一套 scaling rule 构造」而非各自调优到最优,因此两条曲面的差异原则上可能部分来自调参不对称而非架构。Skaling: Chinchilla's Exponents Meet Kaplan's Coupling(Skaling)则从另一侧施压:SMELT 用的正是加性 Chinchilla 形式,而 Skaling 用无参数数值微分证否了该形式隐含的零交叉导数(实测混合导数非零且为负,即 $N$-$D$ 存在协同),仅加一个外层指数就把内插与外推 MAPE 降低 1.5–3.9 倍。SMELT 的 $\gamma = ac/(a+c)$ 这个前沿指数完全依赖于加性可分性,若形式本身有偏,两条曲面的 $\gamma$ 差也会被这个偏差污染。这两篇都早于 SMELT 且未被引用。
其他局限与值得借鉴之处¶
- 可复现性受限:模型建在「无法公开的专有 Transformer 家族」上,训练语料是内部语料,Baseline 是内部调优过的 MoE 家族。作者披露了规模、$H$、$L$、专家数、active/total 参数与 $S$,但训练栈与数据配比不可得。这意味着 SMELT 的配方可迁移,但数字不可复现。
- 消融全在 200M:三条规则(50% 跨度、深宽比、$r=2$)都只在 200M / 主要在 $S\approx85\%$ 上验证过,作者自己承认最优跨度或次数在更大规模可能变化。配方在 4×4 网格上「有效」,但配方的选择没有在网格上重做。
- 只研究了最简单的循环形式:连续块 + 完全权重共享,固定 $r=2$。per-visit LoRA [4]、token 级自适应递归深度 [5]、learned halting [18,19]、块选择性共享 [30]、跨 token 状态复用 [9] 都留给未来。特别地,test-time scaling 这条循环架构最独特的能力被完全放弃了——$r$ 硬编码为 2,无法在推理时加深,而这恰是 Parcae Parcae 的主要卖点之一。
- 机制分析是描述性的,不是因果的:Section 6 的所有探针(专家重叠、残差范数比、$Q/K$ vs $V$ 余弦、汇聚减弱)都是相关性观察。作者措辞谨慎——注意力汇聚减弱与 ICL 优势之间用的是 "we suspect this pattern is related to"、"may underlie",并在 Conclusion 里明说因果解释留待未来。这份克制值得肯定,但也意味着「第二次访问减弱汇聚 → ICL 变强」目前只是一条待验证的叙事。唯一接近干预的实验是 Dyck head 的消融(用消融找出关键 head),但那只用于定位head,没有做「人为压制汇聚是否复现增益」这类反事实。
- 工业价值:字节 Seed 参与、内部语料、54B 总参数规模,符合「平台规模私有数据 + 内部 baseline 家族」的工业判定;但没有任何线上部署或 A/B 结果,也没有推理侧的吞吐/延迟测量。它是一份工业实验室出品的预训练架构研究,不是一份落地报告。
- 最值得借鉴的两件事:(1)Table 1 那种「按预算逐项打勾」的文献清理表,把一个模糊的方法论争论压缩成一张可核对的表格,任何做架构对比的工作都该配一张;(2)「下游残差」框架——先用 baseline 端点拟合 loss→benchmark 的映射,再看新架构相对这条曲线的残差,从而把「下游提升是否超出损失改善所能解释的部分」变成一个可测量、可按规模/领域拆分的量。这个框架与具体架构无关,可以直接搬到推荐、CTR 等任何「离线指标 → 业务指标」的场景。